GLM-5.3-Flash: что скрывалось под именем Ox Alpha и как выбрать способ запуска
Начните с официального API, если сервер не вмещает около 305,8 ГиБ FP8-весов плюс память для выполнения и кэша. 18 млрд активных параметров не означают, что модели достаточно одной обычной GPU.
Содержание
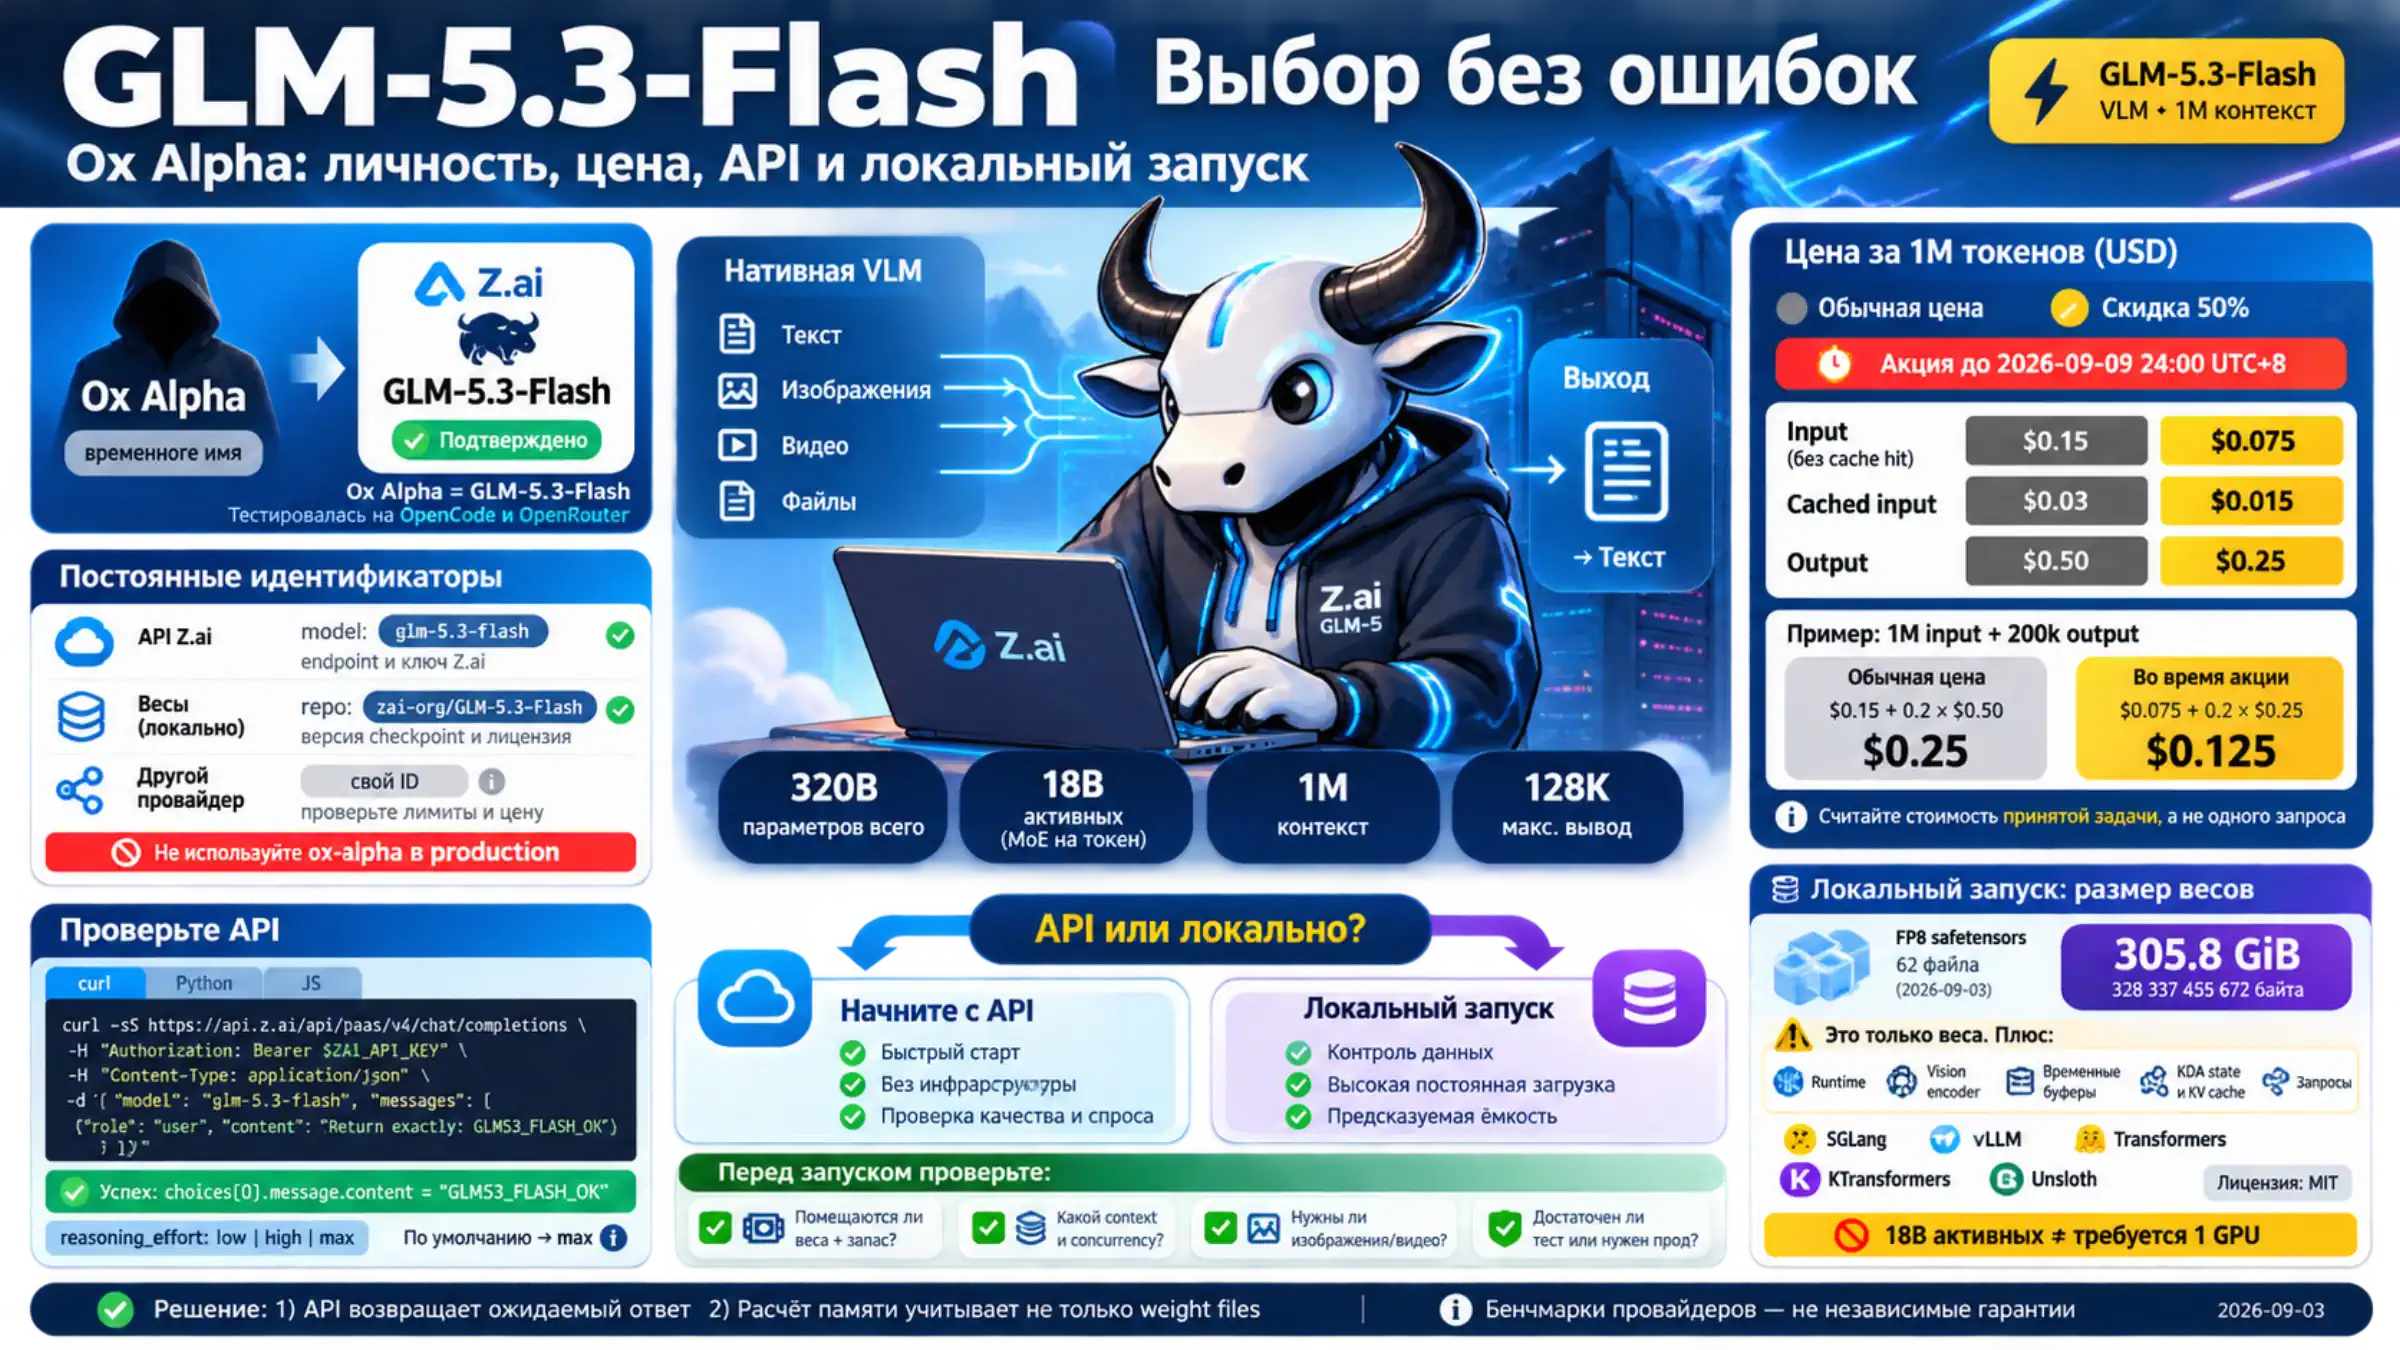
Ox Alpha был временным именем, а не отдельной моделью для долгосрочной конфигурации. Z.ai подтвердил, что под ним на OpenCode и OpenRouter тестировалась GLM-5.3-Flash. В официальном API теперь нужен glm-5.3-flash, а репозиторий весов называется zai-org/GLM-5.3-Flash.
Для первого знакомства разумнее использовать API. Открытые веса дают контроль над инфраструктурой, но только FP8-файлы занимают около 305,8 ГиБ. Показатель 18 млрд активных параметров описывает вычисления MoE на один токен, а не полный объём модели в видеопамяти.
После Ox Alpha осталось два постоянных идентификатора
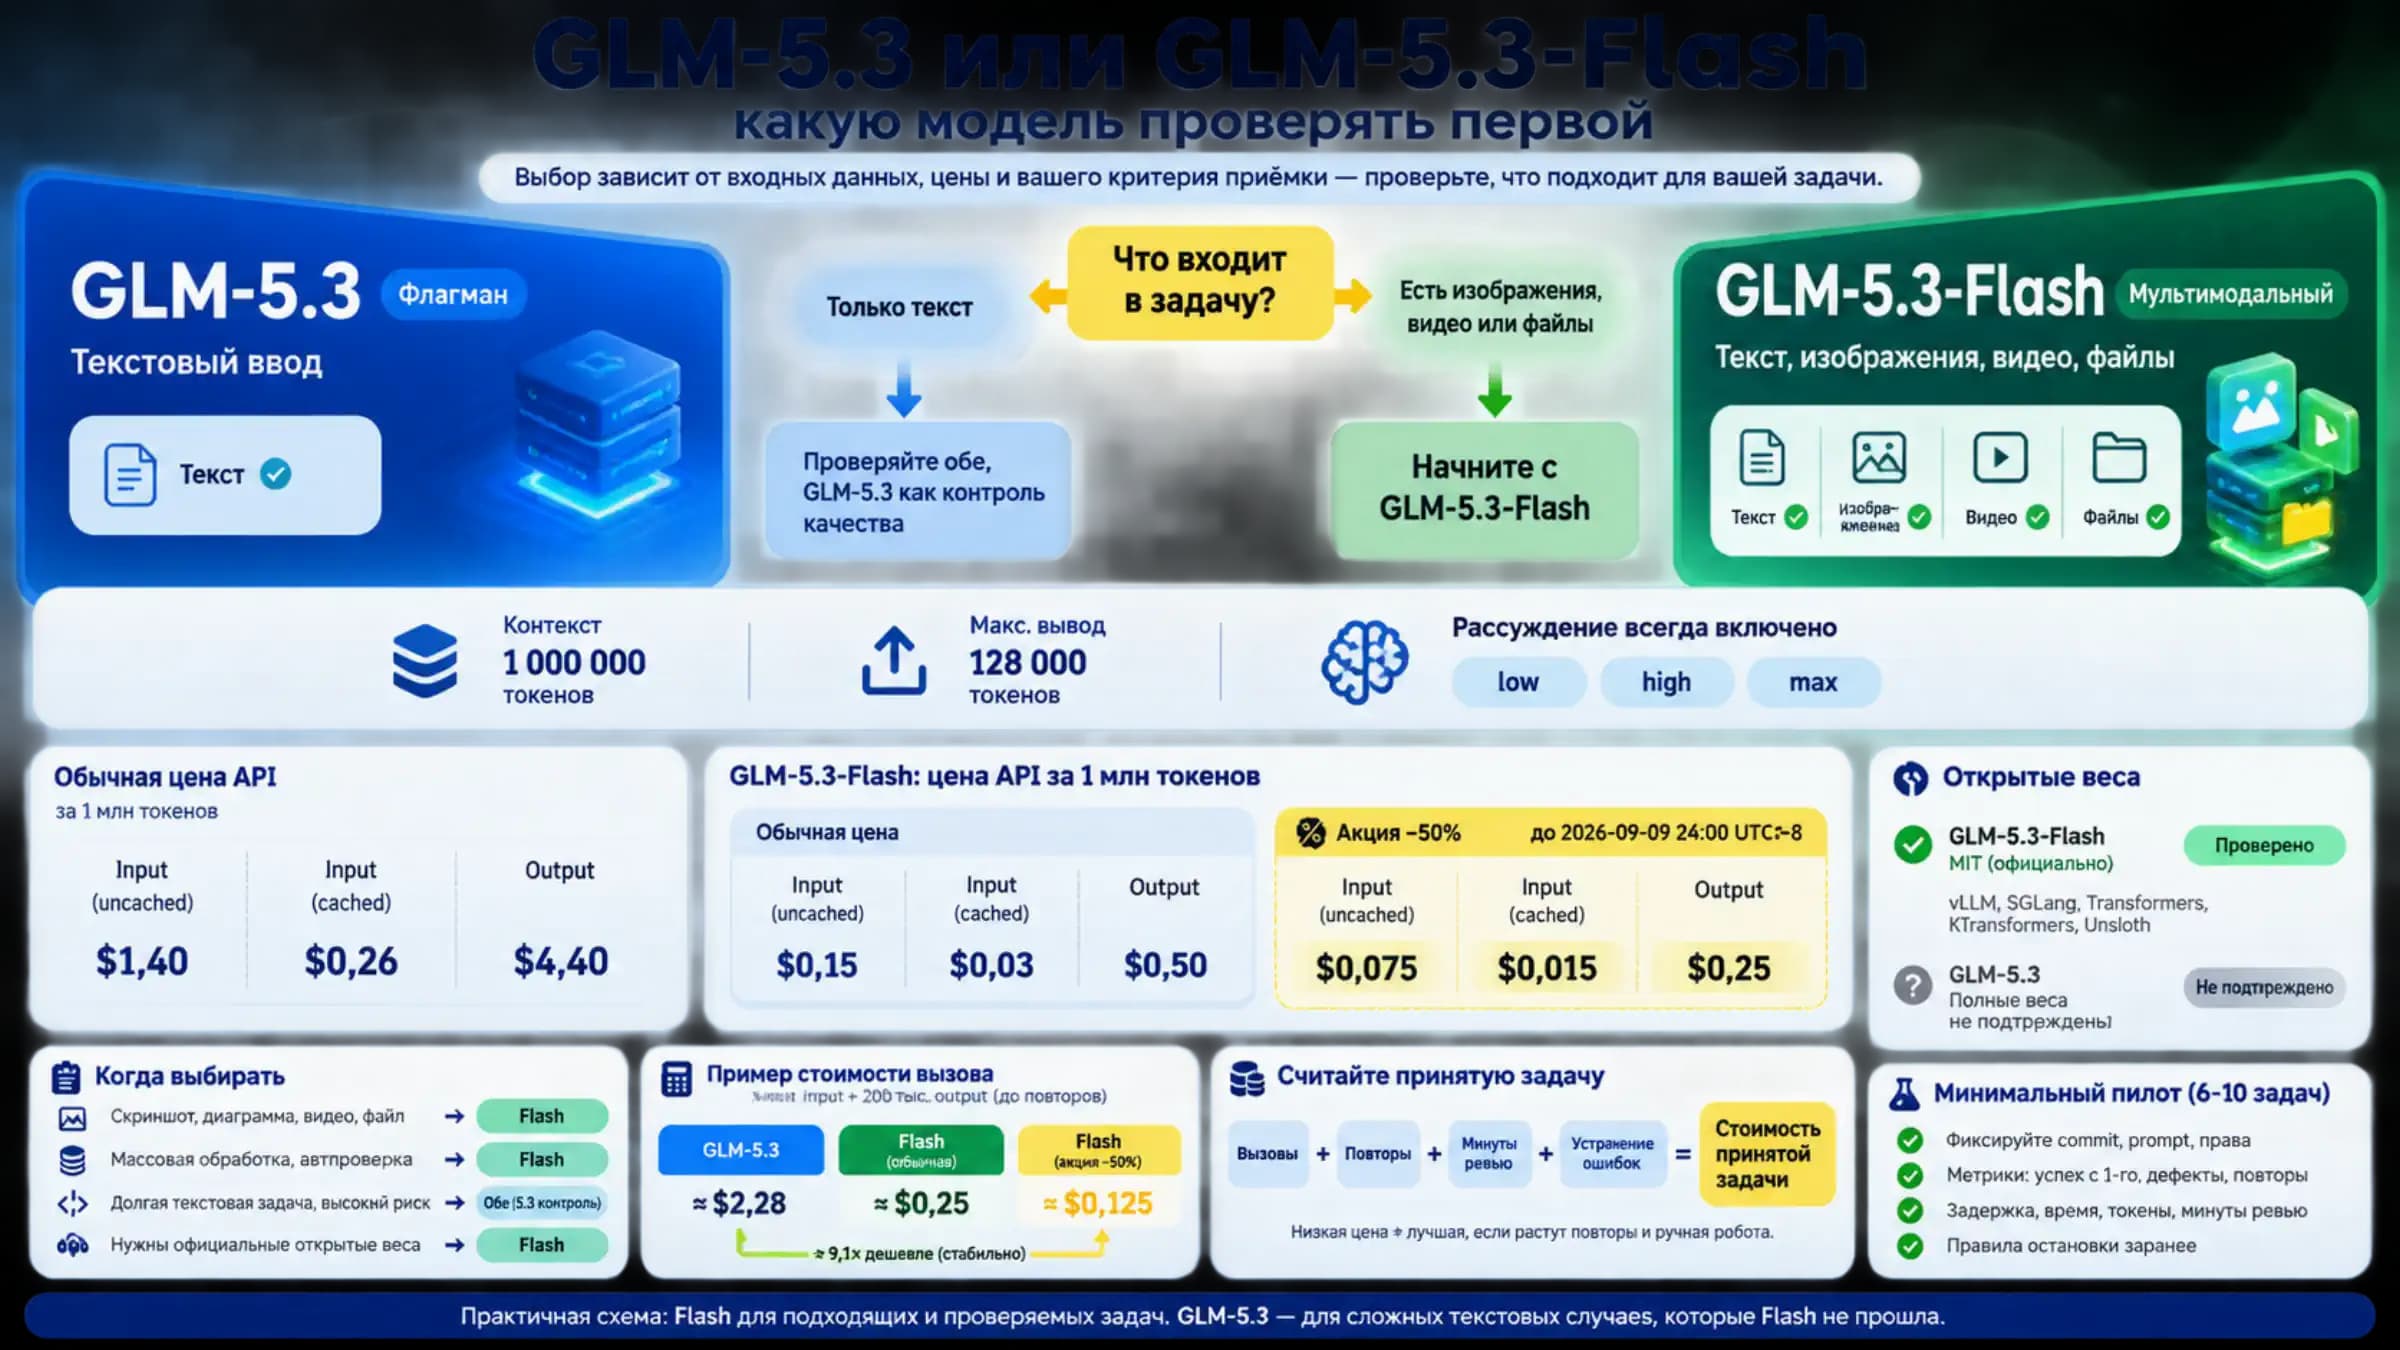
В официальном описании GLM-5.3-Flash названа первой нативно мультимодальной моделью семейства GLM-5. Она принимает текст, изображения, видео и файлы, а возвращает текст. Заявленный контекст — 1 млн токенов, максимальный вывод — 128 тыс. токенов.
Модель имеет 320 млрд параметров всего и 18 млрд активных. Z.ai также сообщает о сочетании разреженного и линейного внимания, а также о меньших затратах на вычисление внимания и KV-кэш по сравнению с GLM-5.3. Это объяснение архитектуры от разработчика, а не гарантия скорости или качества в вашем проекте.
Выбирайте имя по месту запуска:
| Способ | Идентификатор | Что проверить |
|---|---|---|
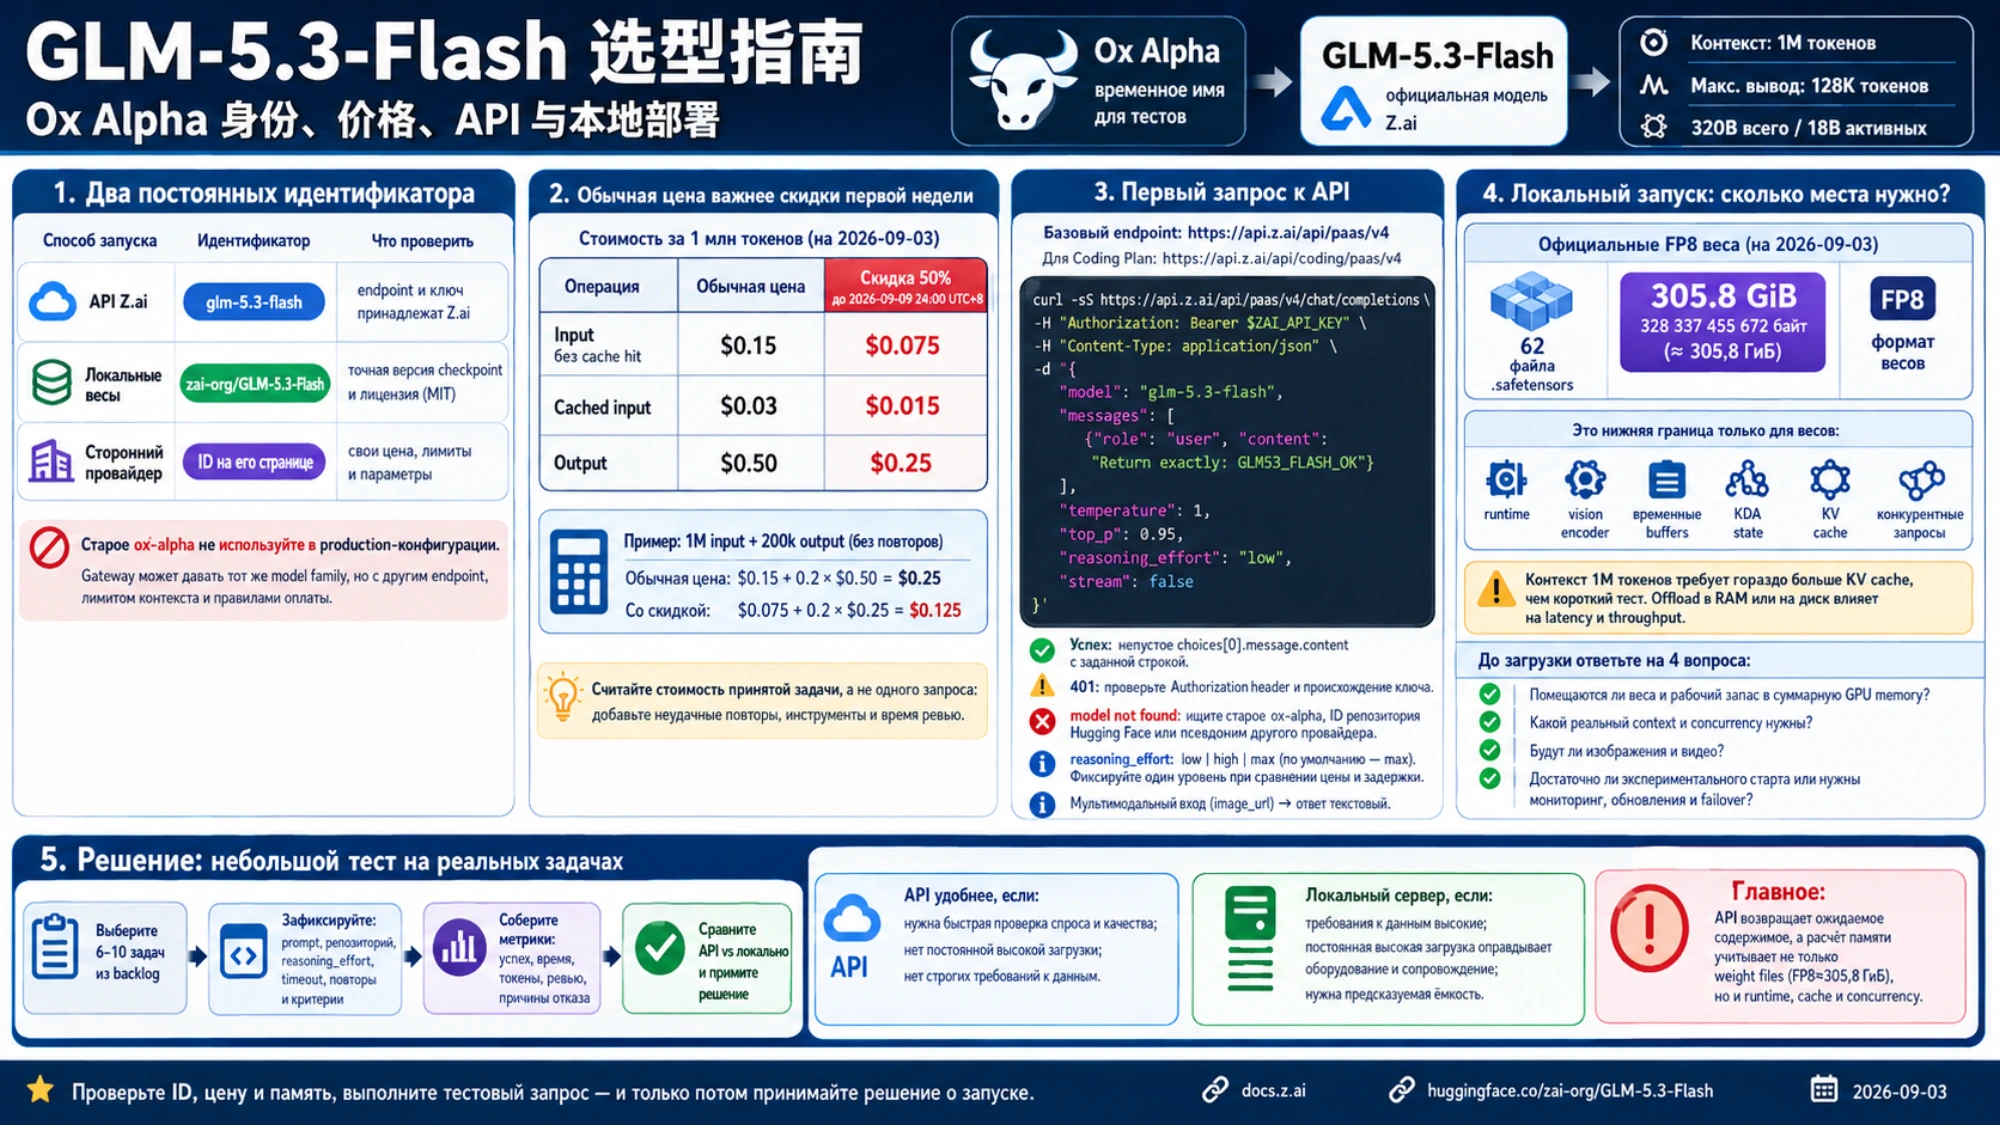
| API Z.ai | glm-5.3-flash | адрес API и ключ относятся к Z.ai |
| Локальные веса | zai-org/GLM-5.3-Flash | точная версия весов и лицензия |
| Сторонний провайдер | ID на его актуальной странице | собственные цена, лимиты и параметры |
Старое ox-alpha не стоит оставлять в рабочей конфигурации. Посредник может предоставлять модели того же семейства через свой адрес API, с другими лимитами контекста и правилами оплаты.
Обычная цена важнее скидки первой недели
На 3 сентября 2026 года официальный прайс Z.ai указывает стоимость за 1 млн токенов:
| Операция | Обычная цена | Историческая цена со скидкой 50% |
|---|---|---|
| Вход без кэширования | $0,15 | $0,075 |
| Кэшированный вход | $0,03 | $0,015 |
| Выход | $0,50 | $0,25 |
По условиям, опубликованным на 3 сентября, окончание акции было запланировано на 9 сентября 2026 года в 24:00 UTC+8. Продлевалась ли она, в рамках этого разбора не проверялось. Для постоянного бюджета используйте обычную цену, а скидку учитывайте только в счетах за период акции.
Задача с 1 млн обычных входных и 200 тыс. выходных токенов стоит до повторов $0,25 по прайсу: $0,15 + 0,2 × $0,50. По указанной акционной ставке такой объём обходился бы в $0,125. Отдельно учитывайте оплаченные повторные запросы и инструменты, а время проверки переводите в деньги по выбранной ставке труда. Поэтому полезная метрика — стоимость принятой задачи, а не одного запроса.
Первый запрос должен подтвердить не только HTTP 200
Для обычного приложения документация API задаёт базовый адрес https://api.z.ai/api/paas/v4. У Coding Plan другой адрес API — https://api.z.ai/api/coding/paas/v4; он предназначен для поддерживаемых инструментов программирования, а не для произвольного сайта, бота или SaaS.
Минимальная проверка:
curl -sS https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {"role": "user", "content": "Return exactly: GLM53_FLASH_OK"}
    ],
    "temperature": 1,
    "top_p": 0.95,
    "reasoning_effort": "low",
    "stream": false
  }'
Успех — это непустое choices[0].message.content с заданной строкой. При 401 сначала проверьте заголовок Authorization и происхождение ключа. При «model not found» ищите старое имя ox-alpha, ID репозитория Hugging Face или псевдоним другого провайдера.
Параметр reasoning_effort принимает low, high и max. По официальному описанию пропущенное или неизвестное значение приводит к max. При сравнении цены и задержки фиксируйте один уровень: иначе изменение глубины рассуждения будет выглядеть как изменение качества модели.
Для изображения используется массив messages[].content[] с блоком type: image_url. Мультимодальный вход не означает генерацию изображений: ответ модели текстовый.
Локальный запуск начинается с подсчёта файлов
Официальная карточка модели указывает лицензию MIT и поддерживаемые варианты SGLang, vLLM, Transformers, KTransformers и Unsloth. Список файлов репозитория на 3 сентября содержал 62 FP8-файла .safetensors общим размером 328 337 455 672 байта, или примерно 305,8 ГиБ.
Это нижняя граница только для весов. Дополнительная память нужна среде выполнения, кодировщику изображений, временным буферам, состоянию KDA, KV-кэшу и параллельным запросам. Контекст в миллион токенов требует гораздо больше кэша, чем короткий тест. Выгрузка части данных в оперативную память или на диск может позволить запустить модель, но задержка и пропускная способность окажутся неприемлемыми для задачи.
Руководство vLLM тоже называет около 306 ГиБ FP8 без учёта среды выполнения и KV-кэша; первый пример использует тензорный параллелизм на четырёх мощных GPU. Документация SGLang предлагает отдельные настройки для H100, H200, B200, B300, GB200 и GB300 и отмечает, какие комбинации проверены.
До загрузки ответьте:
- помещаются ли веса и рабочий запас в суммарную видеопамять;
- какие длина контекста и число параллельных запросов нужны;
- будут ли изображения и видео;
- достаточно ли экспериментального старта или требуются мониторинг, обновления и переключение при отказе.
Если веса уже не помещаются, начните с API. Если помещаются, выберите инструкцию именно для своей GPU, начните с короткого контекста и один запрос, затем увеличивайте нагрузку. Не переносите настройки KV-кэша FP8 или спекулятивной генерации с другого поколения ускорителей.
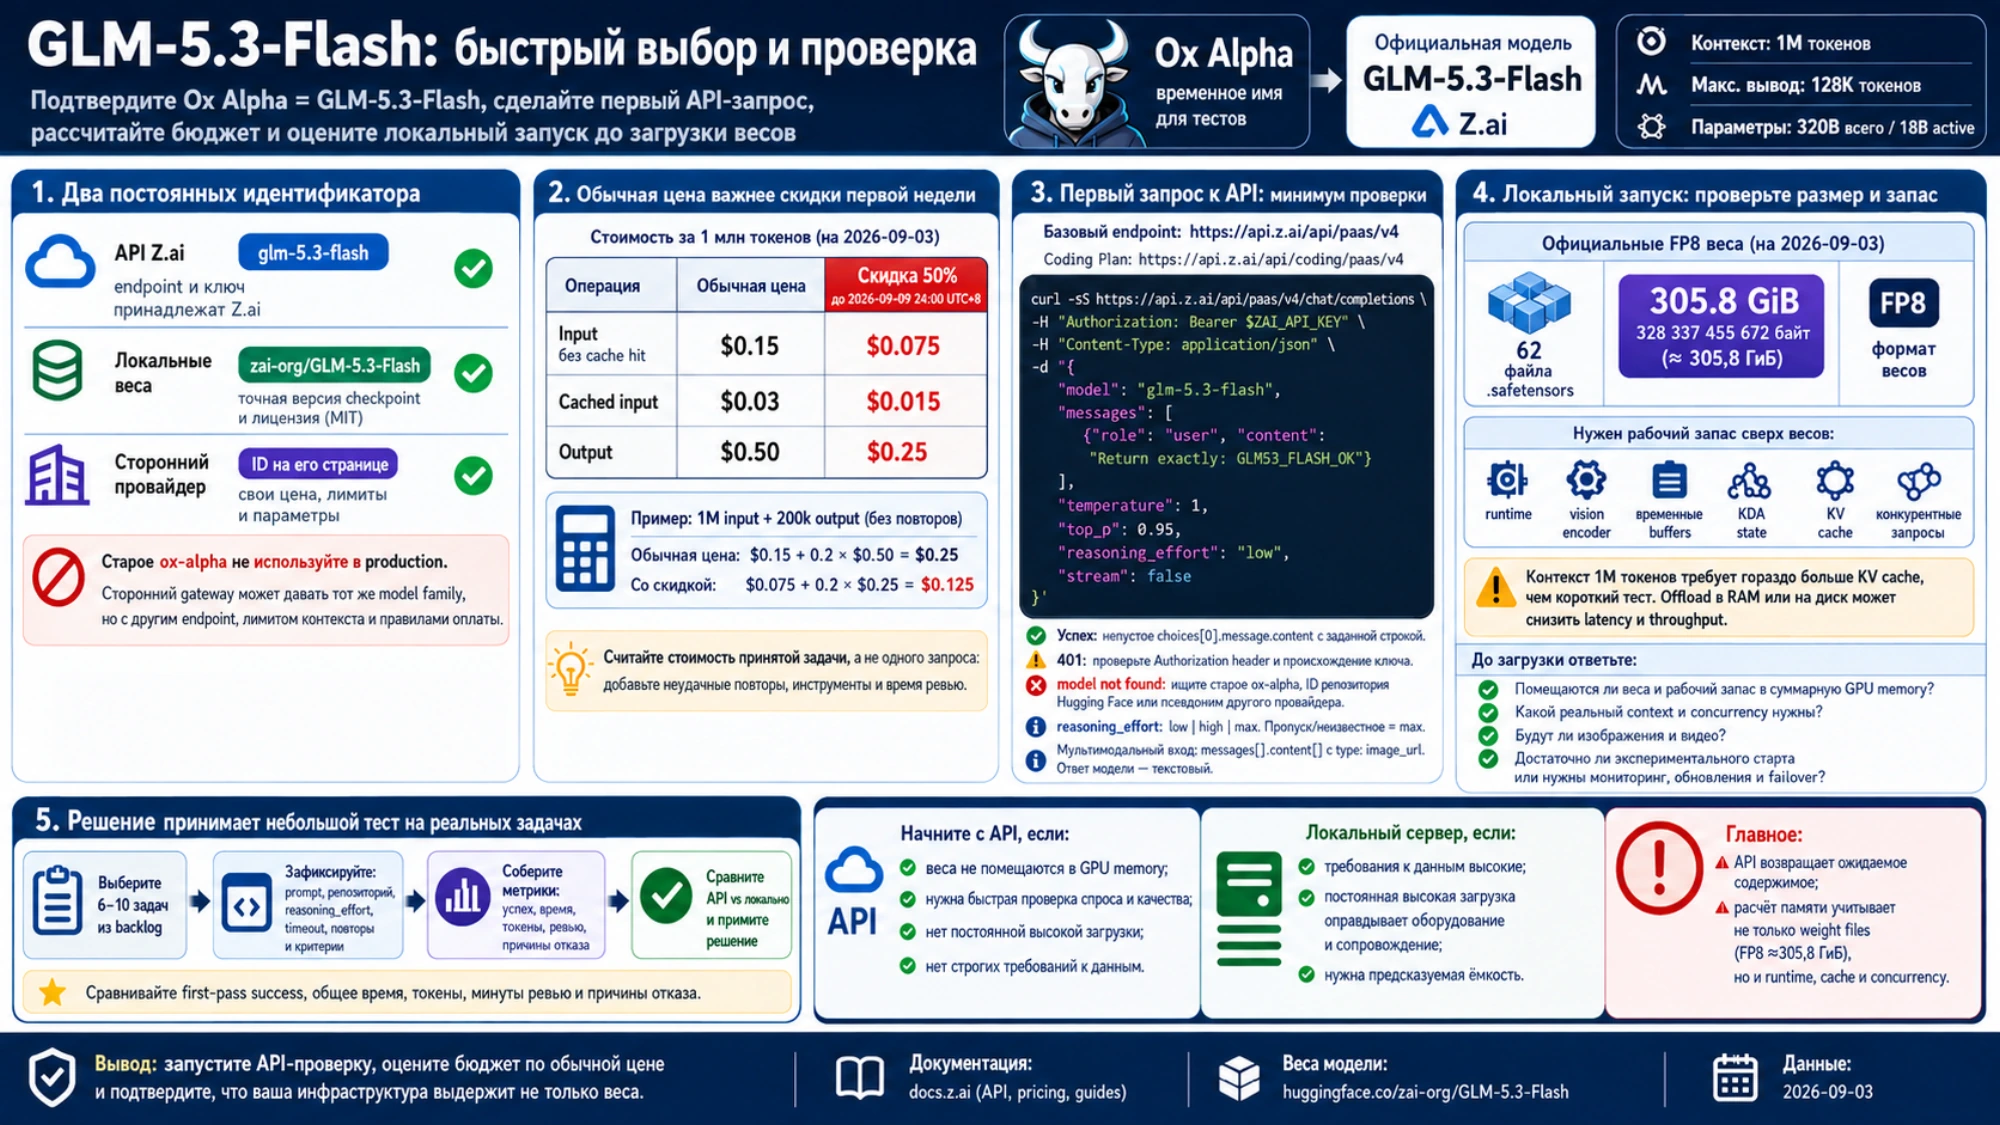
Решение даёт небольшой тест на реальных задачах
Возьмите 6–10 типичных рабочих задач: анализ длинного текста, вызов инструмента, разбор изображения и изменение кода с автоматической проверкой. Зафиксируйте текст запроса, состояние репозитория, reasoning_effort, тайм-аут, число повторов и критерии приёмки. Сравнивайте долю успеха с первой попытки, общее время, расход токенов, время проверки и причины отказа.
API удобнее для быстрой проверки спроса и качества. Локальный сервер имеет смысл, когда требования к данным, высокая постоянная загрузка или предсказуемая ёмкость действительно компенсируют оборудование и сопровождение. Простой ускорителей тоже стоит денег.
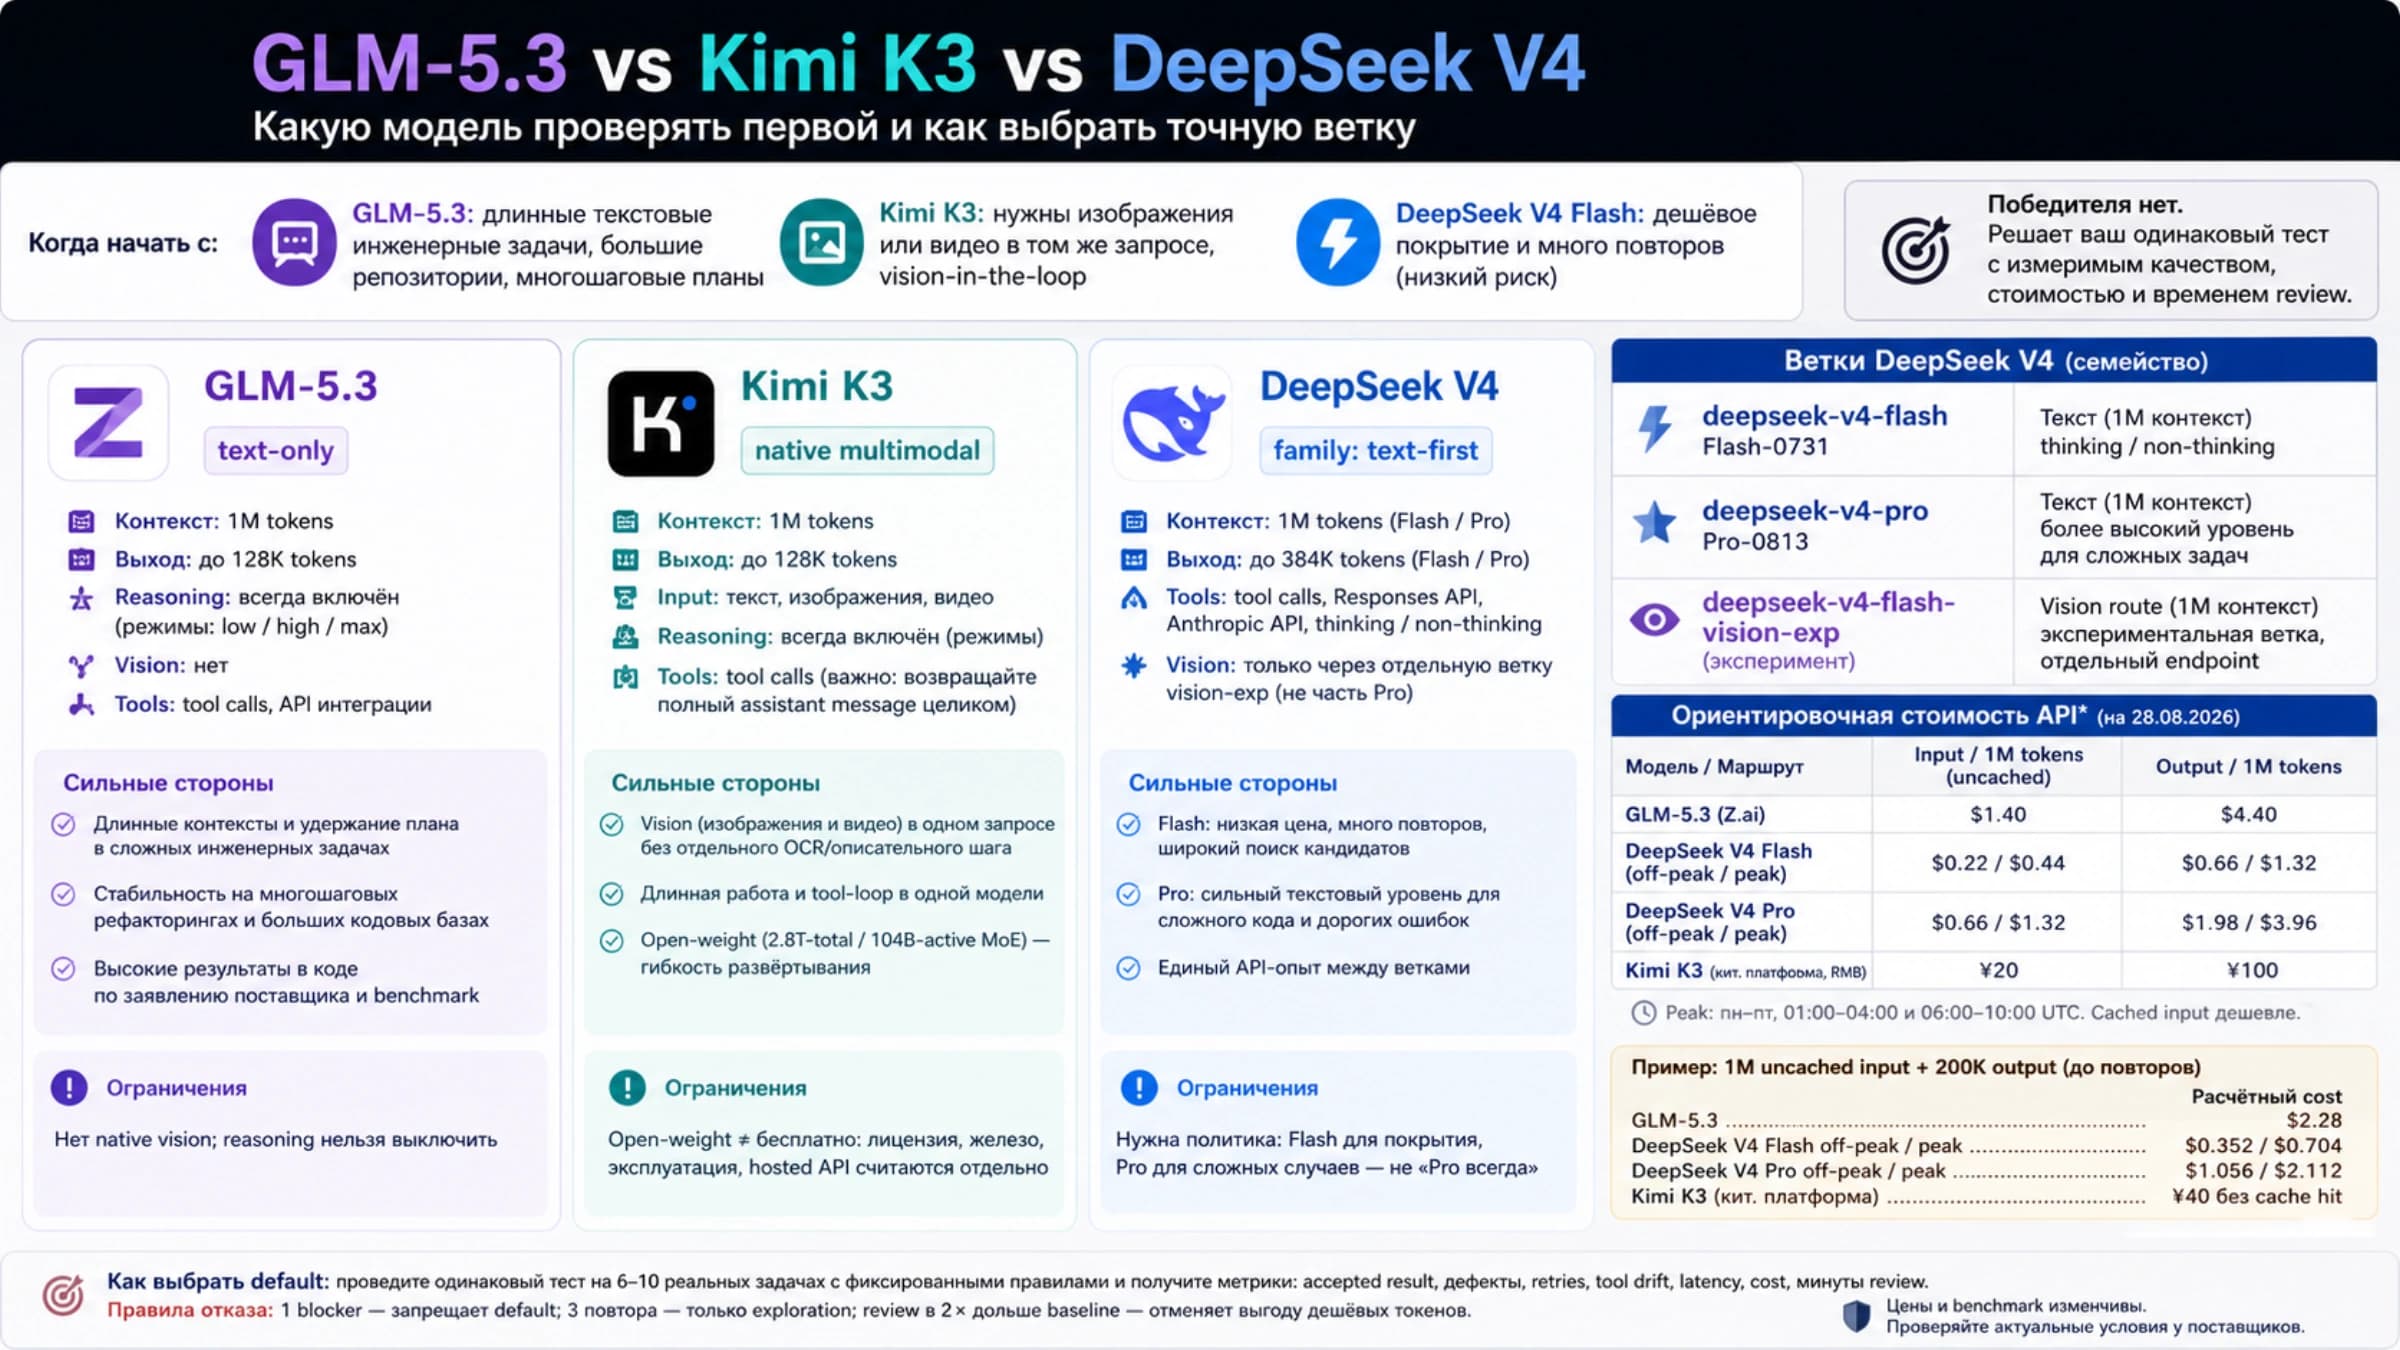
Если нужен отдельный контроль качества для сложных текстовых задач, используйте сравнение GLM-5.3 и GLM-5.3-Flash. Для решения только о Flash достаточно двух доказательств: API возвращает ожидаемое содержимое, а расчёт памяти учитывает не только файлы весов.
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 3 сент. 2026 г..
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 3 сент. 2026 г..
- 1.официальном описанииdocs.z.ai/guides/vlm/glm-5.3-flash
- 2.официальный прайс Z.aidocs.z.ai/guides/overview/pricing
- 3.документация APIdocs.z.ai/api-reference/introduction
- 4.Официальная карточка моделиhuggingface.co/zai-org/GLM-5.3-Flash
- 5.Руководство vLLMrecipes.vllm.ai/zai-org/GLM-5.3-Flash
- 6.Документация SGLangdocs.sglang.io/cookbook/autoregressive/GLM/GLM-5.3-Flash