Как выбрать видеокарту с 16 ГБ для локальной LLM и программирования
RTX 5070 Ti стоит включить в сравнение с RTX 5060 Ti и 5080. Выбирайте по рабочей длине контекста, времени выполнения задач и доле исправлений, прошедших проверку.
Содержание
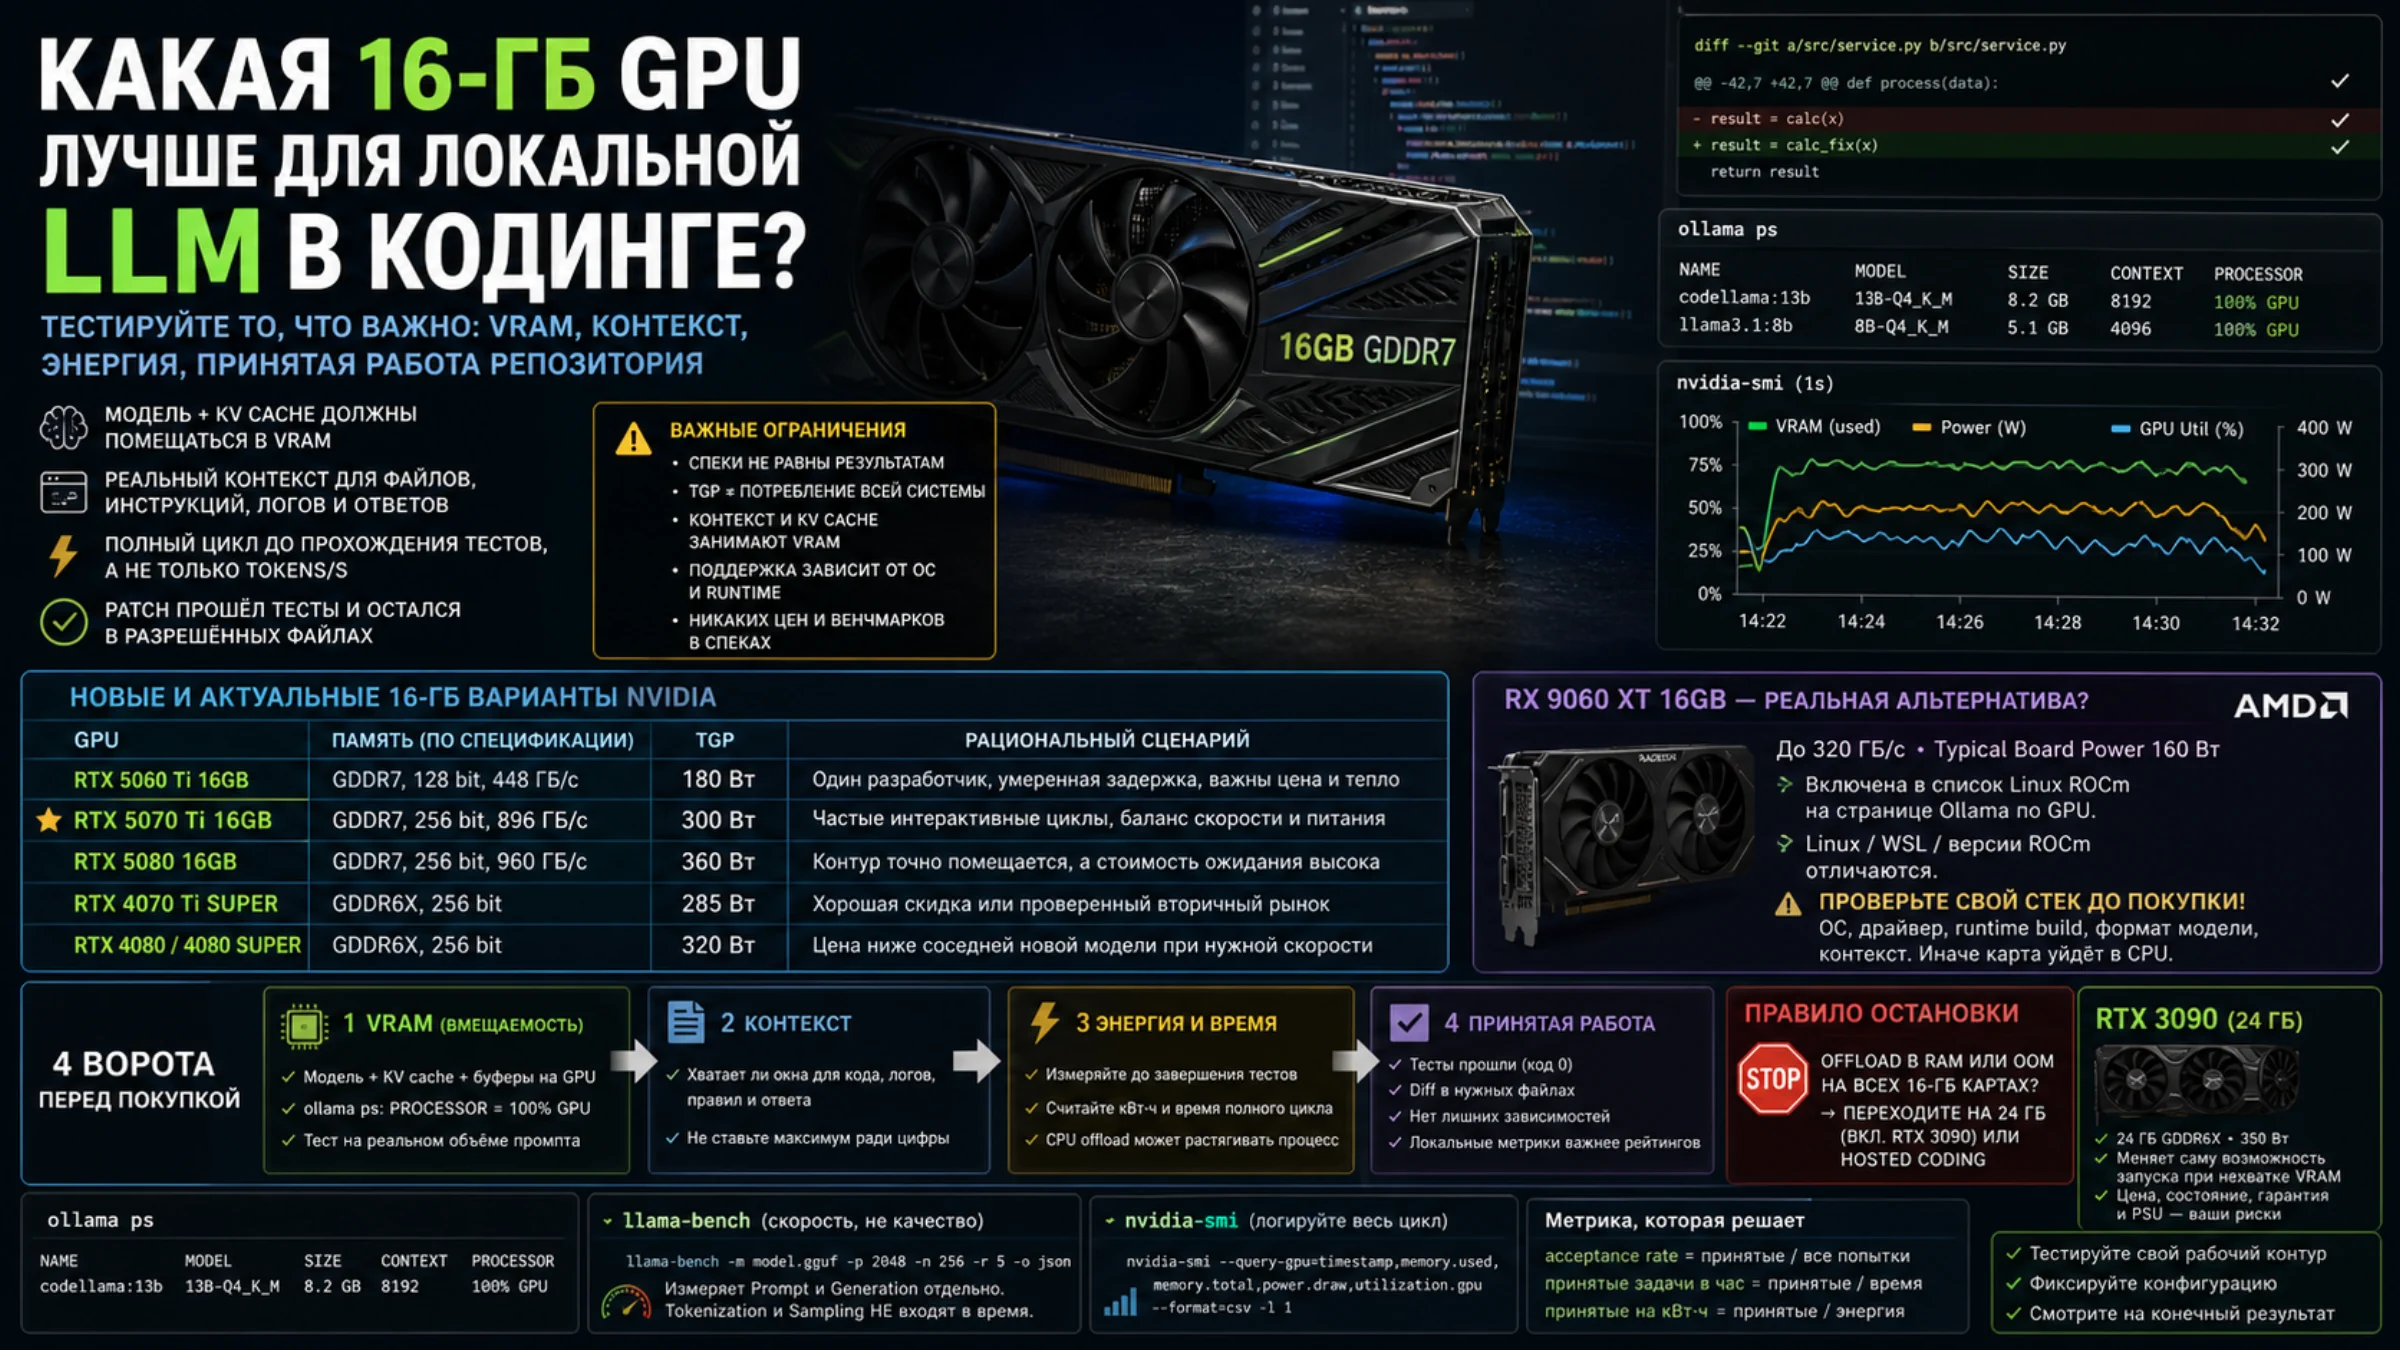
Для ежедневной локальной работы с кодом GeForce RTX 5070 Ti стоит включить в сравнение видеокарт с 16 ГБ, если нужно сократить время ожидания по сравнению с более доступными моделями. У него 256-битная шина, заявленная пропускная способность памяти 896 ГБ/с и TGP 300 Вт. У RTX 5080 выше заявленная пропускная способность памяти, но те же 16 ГБ, а RTX 5060 Ti 16GB заметно экономичнее и может быть правильнее, если её задержка уже приемлема.
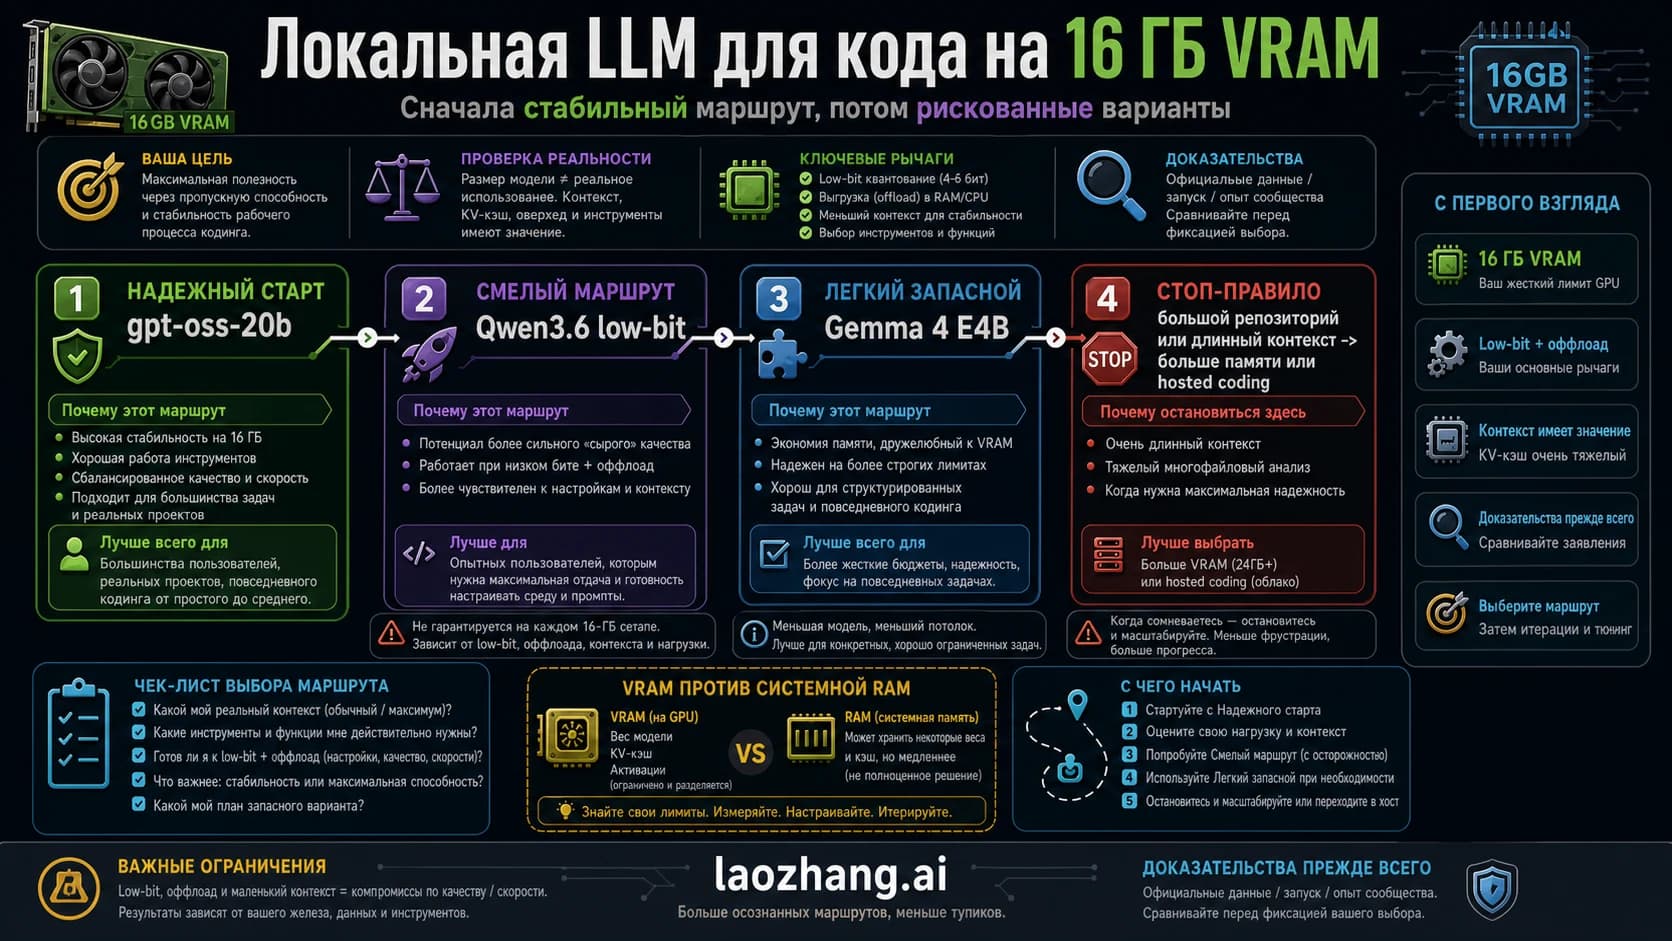
Главное условие сильнее названия карты: модель, KV-кэш и служебные буферы должны помещаться при рабочей, а не демонстрационной длине контекста. Если на всех 16-ГБ картах требуется выгрузка данных в оперативную память или возникают ошибки нехватки памяти, дорогая RTX 5080 не решит задачу вместимости. Тогда сравнивайте 24 ГБ, включая аккуратно проверенную б/у RTX 3090, либо облачный сервис программирования.
Четыре проверки перед покупкой
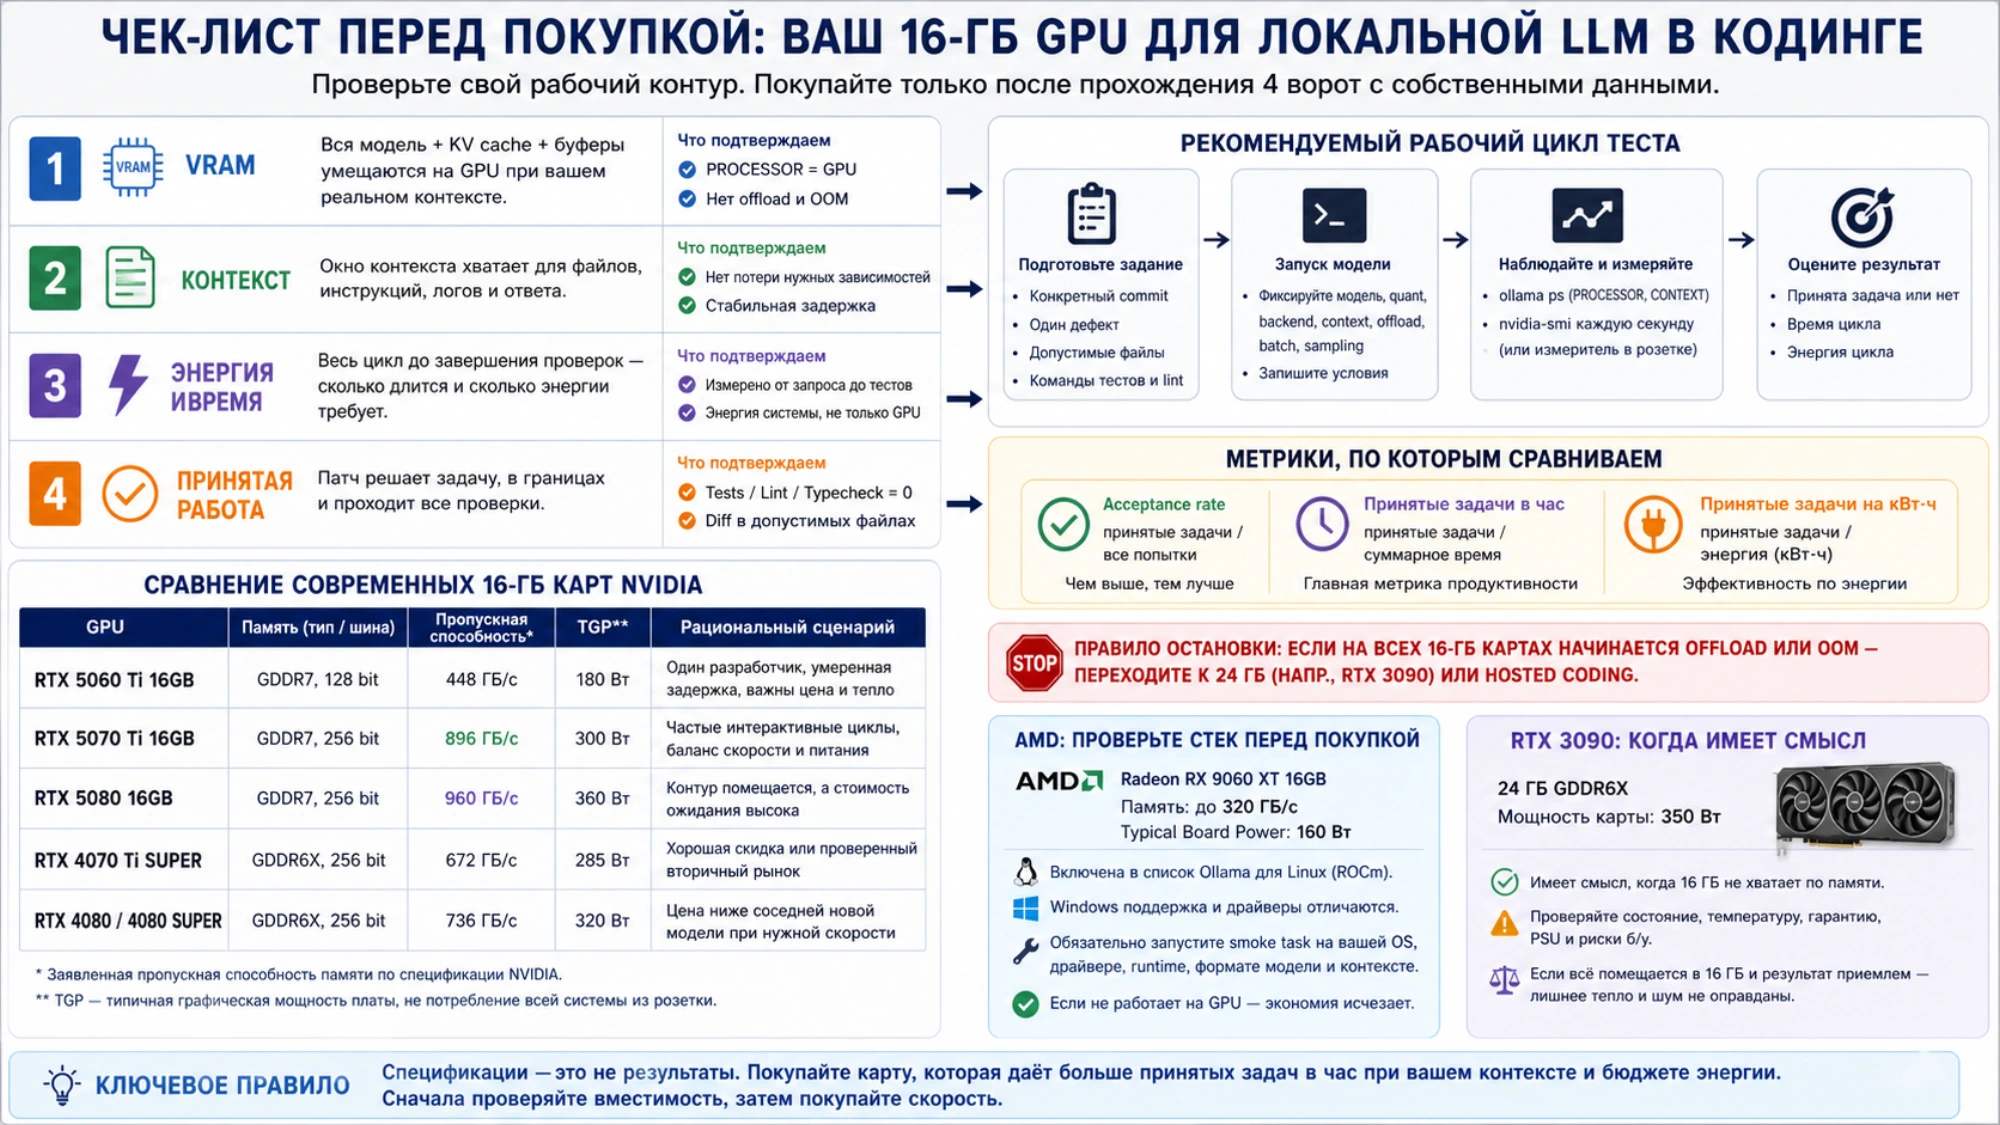
Перед покупкой последовательно проверьте четыре вещи:
- VRAM: вся ли модель остаётся на GPU вместе с контекстом и буферами.
- Контекст: хватает ли реального окна для файлов, инструкций, логов и ответа.
- Энергия и время: сколько длится весь цикл до завершения проверок и сколько энергии он требует.
- Принятая работа: решает ли изменение кода задачу, остаётся ли в разрешённых файлах и проходят ли тесты.
Скорость в токенах в секунду полезна для сравнения времени выполнения, но не показывает качество. Быстро сгенерированные изменения бесполезны, если они неверны или не применяются к проекту.
Что различает современные 16-ГБ карты
В актуальной таблице NVIDIA новые модели разделяются так:
| GPU | Тип и пропускная способность памяти | TGP | Рациональный сценарий |
|---|---|---|---|
| RTX 5060 Ti 16GB | GDDR7, 128 bit, 448 ГБ/с | 180 Вт | Один разработчик, умеренная задержка, важны цена и тепло |
| RTX 5070 Ti 16GB | GDDR7, 256 bit, 896 ГБ/с | 300 Вт | Частые интерактивные циклы, нужен баланс скорости и питания |
| RTX 5080 16GB | GDDR7, 256 bit, 960 ГБ/с | 360 Вт | Модель с рабочим контекстом точно помещается, а стоимость ожидания высока |
| RTX 4070 Ti SUPER | GDDR6X, 256 bit | 285 Вт | Хорошая скидка или проверенный вторичный рынок |
| RTX 4080 / 4080 SUPER | GDDR6X, 256 bit | 320 Вт | Цена ниже соседней новой модели при нужной скорости |
TGP помогает проверить блок питания, охлаждение и класс платы. Это не потребление всей системы из розетки. Спецификации также не доказывают скорость конкретной GGUF-сборки, квантизации или среды выполнения.
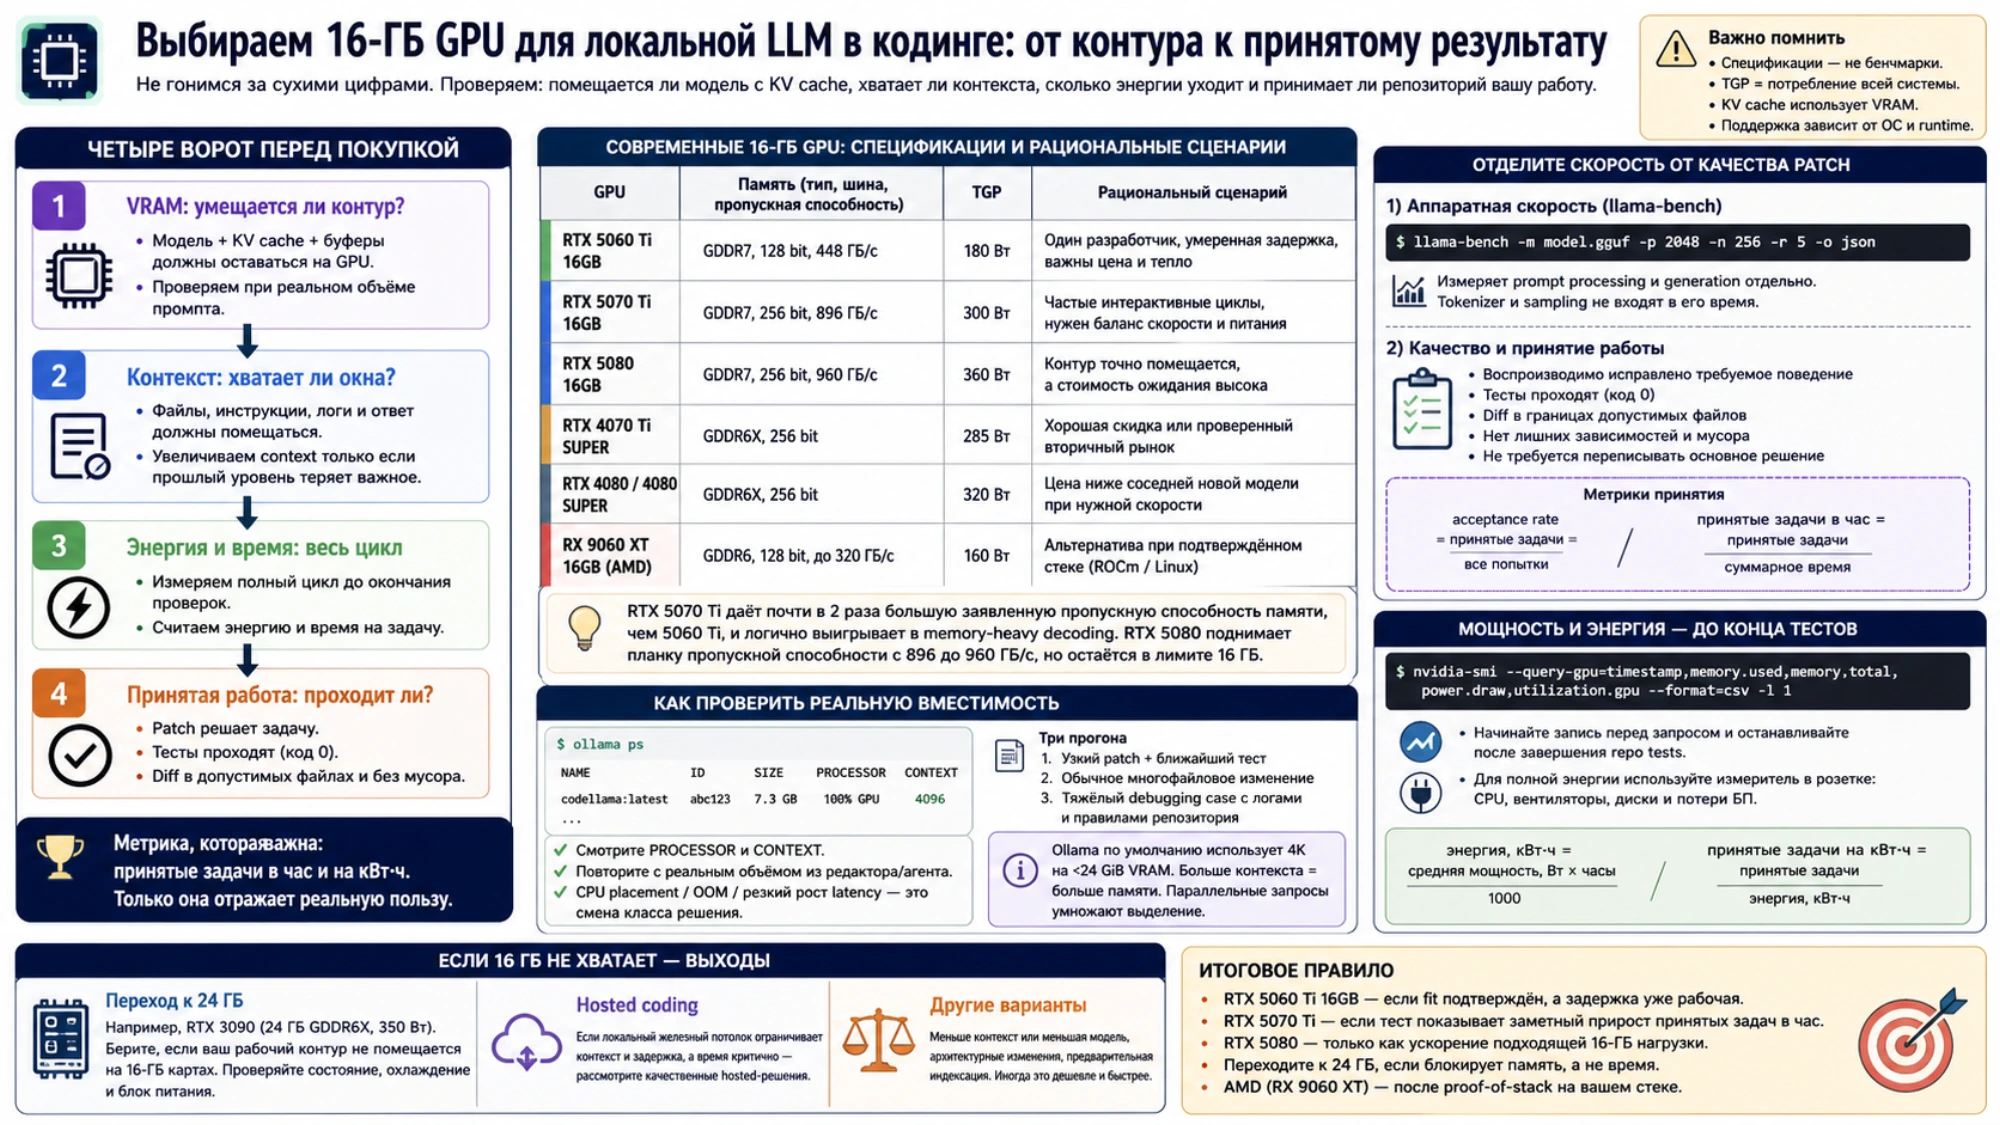
У RTX 5070 Ti вдвое выше заявленная пропускная способность памяти, чем у 5060 Ti. Поэтому её стоит проверить на генерации, скорость которой ограничена обменом данными с памятью. Но покупать это отличие вслепую нельзя: выгодой становится только сокращение времени до принятого результата. RTX 5080 прибавляет к 896 ГБ/с сравнительно небольшой шаг до 960 ГБ/с и поднимает TGP до 360 Вт, сохраняя потолок 16 ГБ.
Как проверить реальную вместимость
Файл модели делит память с KV-кэшем, вычислительными буферами, средой выполнения и другими процессами. Размер квантизированного файла меньше 16 ГБ не гарантирует рабочий запуск.
В текущей документации Ollama о длине контекста для систем с менее чем 24 GiB VRAM по умолчанию используется 4K. Увеличение контекста требует больше памяти. Во время активной задачи проверяйте:
ollama psСмотрите на PROCESSOR и CONTEXT. Если короткий запрос показывает 100% GPU, повторите с объёмом, который реально поступает из редактора или агента. Частичное размещение на CPU, нехватка памяти или резкий рост задержки — это не мелкая настройка, а изменение класса решения.
Проведите три прогона: небольшое исправление с соответствующим тестом; обычное многофайловое изменение; сложную отладку с логами и правилами репозитория. Не ставьте максимальное окно ради цифры. Увеличивайте контекст только когда предыдущий уровень теряет необходимые зависимости.
В FAQ Ollama отдельно предупреждается, что параллельные запросы умножают контекстное выделение памяти. Результат для одного сеанса VS Code нельзя переносить на сервер для команды без повторного теста.
Отделите скорость оборудования от качества изменений кода
Для повторяемой аппаратной базы используйте llama-bench:
llama-bench -m model.gguf -p 2048 -n 256 -r 5 -o jsonОн отдельно измеряет обработку запроса и генерацию, умеет повторять тесты и возвращать JSON. Зафиксируйте контрольную сумму модели, квантизацию, версию llama.cpp, контекст, размещение данных, размер пакета, настройки выборки токенов и параллельность. По документации время токенизации и выборки токенов в измерение не входит, поэтому тест не показывает полную задержку приложения.
Теперь подготовьте задания, которые имеют объективный финал. Укажите исходный коммит, один дефект, допустимые файлы и команды модульных тестов, линтера или проверки типов. Работа принимается, если:
- требуемое поведение воспроизводимо исправлено;
- заданные проверки завершаются с кодом 0;
- diff не выходит за границы;
- не появились лишние зависимости и сгенерированные файлы;
- разработчику не приходится переписывать основное решение.
Считайте не только успехи, но и неудачные попытки:
доля принятых результатов = принятые задачи / все попытки
принятые задачи в час = принятые задачи / суммарное время
Это локальная метрика вашего стека, а не универсальный рейтинг моделей. Именно поэтому она полезна при покупке: карта оценивается в том контуре, ради которого вы тратите деньги.
Мощность измеряется до конца тестов
Для NVIDIA можно раз в секунду записывать занятую видеопамять и мощность GPU:
nvidia-smi \
  --query-gpu=timestamp,memory.used,memory.total,power.draw,utilization.gpu \
  --format=csv -l 1
Начинайте запись перед запросом и заканчивайте после завершения repo tests. Если важны стоимость энергии, тепло и нагрузка на блок питания, добавьте измеритель в розетку: он увидит CPU, вентиляторы, накопители и потери блока питания. Телеметрия GPU этого не показывает.
энергия, кВт·ч = средняя мощность системы, Вт × часы / 1000
принятые задачи на кВт·ч = принятые задачи / энергия
Выгрузка данных в оперативную память иногда снижает видимую мощность GPU, но растягивает процесс. Поэтому сравнивайте полный цикл, а не пиковое показание мощности. Локальный тариф берите из собственного счёта.
Когда RX 9060 XT 16GB — реальная альтернатива
AMD указывает для Radeon RX 9060 XT 16GB пропускную способность до 320 ГБ/с и типичную мощность платы 160 Вт. По ёмкости и тепловому бюджету это интересный кандидат. Но его ценность зависит от программного пути.
Текущая страница Ollama по GPU включает RX 9060 XT в список ROCm для Linux; поддержка Windows и требования к драйверам отличаются. Матрицы Radeon ROCm также разделяют Linux, WSL и версии фреймворков. До покупки выполните пробную задачу с нужными ОС, драйвером, сборкой среды выполнения, форматом модели и длиной контекста. Если приложение переходит на CPU или нужное вычислительное ядро отсутствует, экономия на карте не превращается в рабочую производительность.
RTX 3090: не «лучшая вообще», а проверка потолка 16 ГБ
NVIDIA публикует для RTX 3090 24 ГБ GDDR6X и мощность карты 350 Вт. На вторичном рынке она может стоить рядом с новой быстрой 16-ГБ моделью, но цена зависит от региона, а риски включают состояние памяти, охлаждение, гарантию и блок питания.
Сравнивать её нужно, когда нужный контекст не помещается в 16 ГБ. Если всё помещается и RTX 5060 Ti даёт приемлемое число принятых задач в час, лишнее тепло 3090 не обязательно оправдано. Если каждая 16-ГБ карта вынуждена выгружать часть одной и той же модели в оперативную память, 24 ГБ меняют саму возможность запуска.
Финальное правило:
- берите RTX 5060 Ti 16GB, если модель и рабочий контекст помещаются, а задержка уже рабочая;
- доплачивайте за RTX 5070 Ti, если собственный тест показывает заметный прирост принятых задач в час;
- рассматривайте RTX 5080 только как ускорение подходящей 16-ГБ нагрузки;
- переходите к 24 ГБ, если блокирует память, а не время;
- выбирайте AMD после проверки всей программной конфигурации, а не по одной цене и VRAM.
После определения класса железа отдельно выберите модель и квантизацию. В этом поможет руководство по локальным LLM для программирования на 16 ГБ VRAM. Разделение двух решений не даёт быстрой карте скрыть нехватку памяти, а рейтингу моделей — навязать неподходящую видеокарту.
Источники7
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 29 авг. 2026 г..
Источники7
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 29 авг. 2026 г..
- 1.таблице NVIDIAnvidia.com/en-us/geforce/graphics-cards/compare
- 2.документации Ollama о длине контекстаdocs.ollama.com/context-length
- 3.FAQ Ollamadocs.ollama.com/faq
- 4.llama-benchgithub.com/ggml-org/llama.cpp/blob/master/tools/llama-bench/README.md
- 5.Radeon RX 9060 XT 16GBamd.com/en/products/graphics/desktops/radeon/9000-series/amd-radeon-rx-9060xt.html
- 6.страница Ollama по GPUdocs.ollama.com/gpu
- 7.Матрицы Radeon ROCmrocm.docs.amd.com/_/downloads/radeon/en/latest/pdf