Локальная LLM для кода на 16 ГБ VRAM: gpt-oss, Qwen3.8 и Gemma 4
На 16 ГБ VRAM начните с gpt-oss-20b (≈12,8 ГиБ при 64K по расчёту), для длинного контекста берите Gemma 4 12B, Qwen3.8-27B — только в 3-битном GGUF.
Содержание
По состоянию на 22 октября 2026 года на видеокарте с 16 ГБ VRAM (RTX 4060 Ti 16GB, 5060 Ti 16GB, 5070 Ti, 4080, 5080) первой локальной LLM для кода по-прежнему стоит ставить gpt-oss-20b: это единственная модель в этом классе, для которой сам разработчик пишет, что она работает «within 16GB of memory». Если нужен длинный контекст, второй кандидат — Gemma 4 12B в официальном квантовании QAT Q4_0. Самый сильный Qwen для пробы теперь Qwen3.8-27B, но на 16 ГБ он помещается только в 3-битном или IQ4-файле со сжатым KV cache.
Июльский список устарел в трёх местах. Qwen3.6 35B A3B уступил место «первого Qwen» модели Qwen3.8-27B (вышла 5 августа 2026 года). На картах 16 ГБ лёгкий ряд теперь возглавляет Gemma 4 12B, а Gemma 4 E4B осталась для 8 ГБ и ноутбуков. Вместо Qwen2.5-Coder, DeepSeek Coder и Qwen3-Coder-30B-A3B специализированными кодовыми моделями стали Devstral Small 2 и Qwen3.6-27B.
Память в программировании уходит не только на веса. Файл модели, KV cache на нужную длину контекста, буферы runtime и IDE-обёртка вместе решают, поместится ли модель в видеопамять. Ниже для каждой модели указан конкретный файл квантования и расчёт, который можно повторить. Это расчёт, а не замер: ни одна из моделей для этой страницы не скачивалась и не запускалась.
Короткий ответ: сначала выберите маршрут
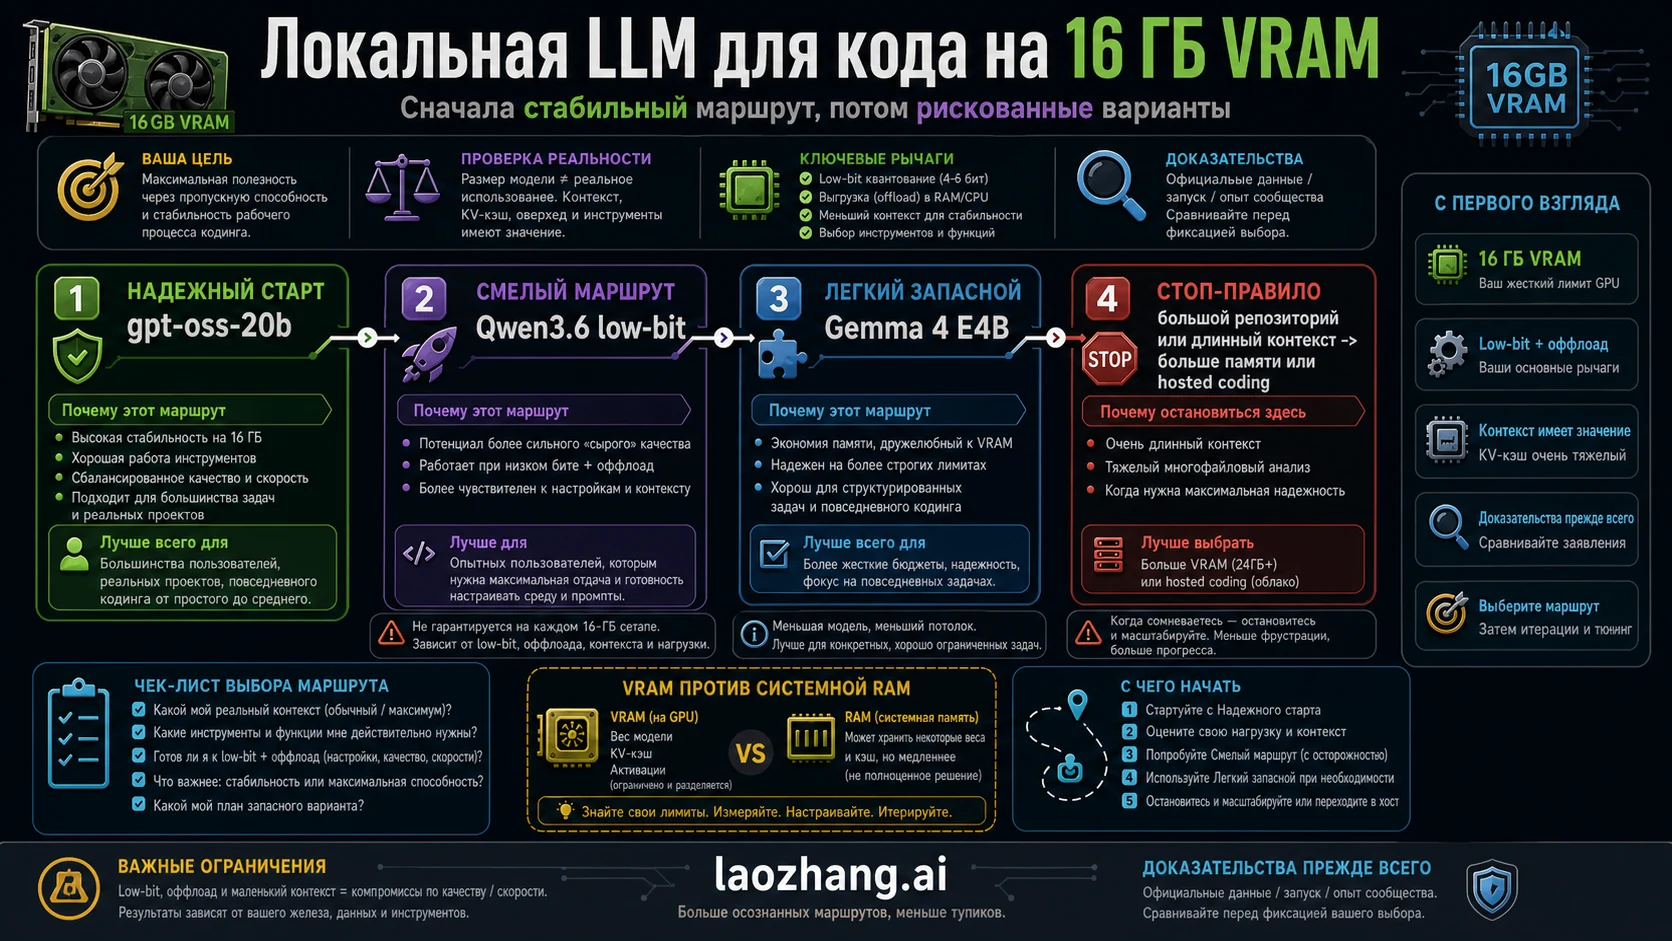
Схема показывает маршруты июля 2026 года; актуальный выбор моделей — в таблице и тексте ниже.
Таблица — не рейтинг, а карта решения: что поставить сегодня, что пробовать как эксперимент и где остановиться. Размеры файлов взяты из списков файлов на Hugging Face и в библиотеке Ollama; итоговая память посчитана по формуле из раздела о файлах квантования.
| Маршрут | Модель и файл | Память по расчёту | Главный риск | Следующее действие |
|---|---|---|---|---|
| Надёжный старт | gpt-oss-20b, MXFP4 (GGUF 12,11 ГБ; в Ollama gpt-oss:20b 14GB) | ≈12,8 ГиБ при 64K | мало запаса под второй большой контекст | установить и пройти smoke test |
| Длинный контекст и быстрый цикл | Gemma 4 12B, QAT Q4_0 (GGUF 6,98 ГБ) | ≈7,8 ГиБ при 64K, ≈8,8 ГиБ при 128K | слабее старших моделей в агентной работе по репозиторию | брать, когда нужны 64K–128K |
| Самый сильный Qwen | Qwen3.8-27B, UD-Q3_K_XL (13,15 ГБ) + KV q8_0 | ≈13,3 ГиБ при 32K, ≈14,4 ГиБ при 64K | 3-битный файл, оценки вендора к нему не переносятся | собирать вручную, не тегом по умолчанию |
| Агентный кодинг с коротким контекстом | Devstral Small 2, Q3_K_M (11,47 ГБ) + KV q8_0 | ≈13,4 ГиБ при 32K | дорогой KV cache, до 64K не дотягивает | только для коротких задач |
| MoE с выгрузкой экспертов | Qwen3.6 35B A3B, экспертные веса в ОЗУ | зависит от выгрузки | скорость падает вместе с долей весов в ОЗУ | только при большой системной памяти |
| Остановка | больше VRAM, модель меньше или облачный кодинг | — | упорство съедает время разработки | остановиться при OOM, задержке или потере контекста |
Если нужен один ответ без настройки: gpt-oss:20b в Ollama с контекстом 64000, затем smoke test на своём репозитории. Всё остальное в таблице — шаги на случай, когда первая модель упирается в качество или в контекст.
Граница доказательств: официальные данные, runtime и сообщество
У gpt-oss-20b стартовая позиция не потому, что она выигрывает все тесты, а потому что память подтверждена чище всего. В карточке gpt-oss-20b на Hugging Face OpenAI указывает 21B параметров, из них 3,6B активных, веса MoE в формате MXFP4 и работу «within 16GB of memory». Новой небольшой модели gpt-oss с тех пор не вышло; gpt-oss-safeguard-20b — это классификатор безопасности, а не помощник для кода.
Для остальных моделей официальные данные отвечают только за архитектуру и оценки вендора. Google в карточке Gemma 4 12B относит размеры 12B, 26B A4B и 31B к потребительским GPU и рабочим станциям, а E2B и E4B — к мобильным и периферийным устройствам. Qwen в карточке Qwen3.8-27B публикует оценки по коду, но измеряет их в полной точности и с окном 256K. На 16 ГБ модель работает в 3–4 битах и с контекстом 32–64K, поэтому переносить эти цифры на локальную сборку нельзя.
Файлы квантования — отдельный уровень. Для gpt-oss-20b есть MXFP4 GGUF от ggml-org, для Gemma 4 — официальные QAT Q4_0 от Google (QAT, quantization-aware training — квантование с дообучением). Сборки Qwen3.8-27B, Qwen3.6 и Devstral Small 2 вида UD-Q3_K_XL или IQ4_XS выпускает сообщество Unsloth, а не сами вендоры. Качество такой сборки на вашем коде не следует из карточки модели.
Сообщество полезно как карта попыток. Reddit, Хабр и YouTube показывают, какие видеокарты и файлы люди пробуют. Но без имени файла, длины контекста, типа KV cache, GPU и драйвера чужой опыт не становится гарантией.
На машине автора, Mac с M4 и 16 ГиБ единой памяти, проверены только две вещи: что в llama.cpp (сборка Homebrew 11429) есть флаги из команд ниже, и что llama.cpp видит устройство Metal с бюджетом 12 124 МиБ. Скорость, качество и загрузка моделей не проверялись.
Что на самом деле дают 16 ГБ VRAM
VRAM — это память видеокарты. Она не равна системной RAM и не равна единой памяти Mac. В локальном инференсе за неё конкурируют веса модели, KV cache, буферы runtime и всё, что ещё держит видеокарту: рабочий стол, браузер, второй процесс.
Кодовая нагрузка тяжелее обычного чата. Модель держит функцию, соседний тест, лог ошибки, требования рефакторинга и собственные прошлые ответы. Контекст растёт быстро, а KV cache растёт вместе с ним линейно: каждые дополнительные 32K токенов добавляют фиксированную для модели порцию памяти.
Выгрузка на CPU (offload) спасает от немедленного OOM, но часто превращает работу в ожидание. Для помощника в редакторе задержка критична: если каждое исправление занимает минуты, разработчик перестаёт пользоваться локальной моделью, даже если ответы иногда умнее.
Отсюда жалобы вида «на 5070 Ti с 16 ГБ не хватает памяти». Обычно виновата не сама модель, а пакет по умолчанию: тег qwen3.8:27b в Ollama весит 18GB, qwen3.6:35b — 23–24GB, а devstral-small-2:24b — 15GB ещё до KV cache. Такие пакеты частично уходят на CPU, и скорость падает.
| Источник давления | Что значит для кода | Как действовать на 16 ГБ |
|---|---|---|
| Веса модели | решают, загрузится ли модель и какое квантование нужно | выбирать файл по точному размеру, а не по названию семейства |
| KV cache | длинный контекст съедает остаток памяти | считать KV на нужную длину заранее, при нехватке — q8_0 |
| Слой инструментов | IDE, сервер и обёртка добавляют свои запросы и буферы | сначала проверять модель из командной строки |
| Offload | убирает OOM ценой задержки | оставлять только при приемлемой скорости |
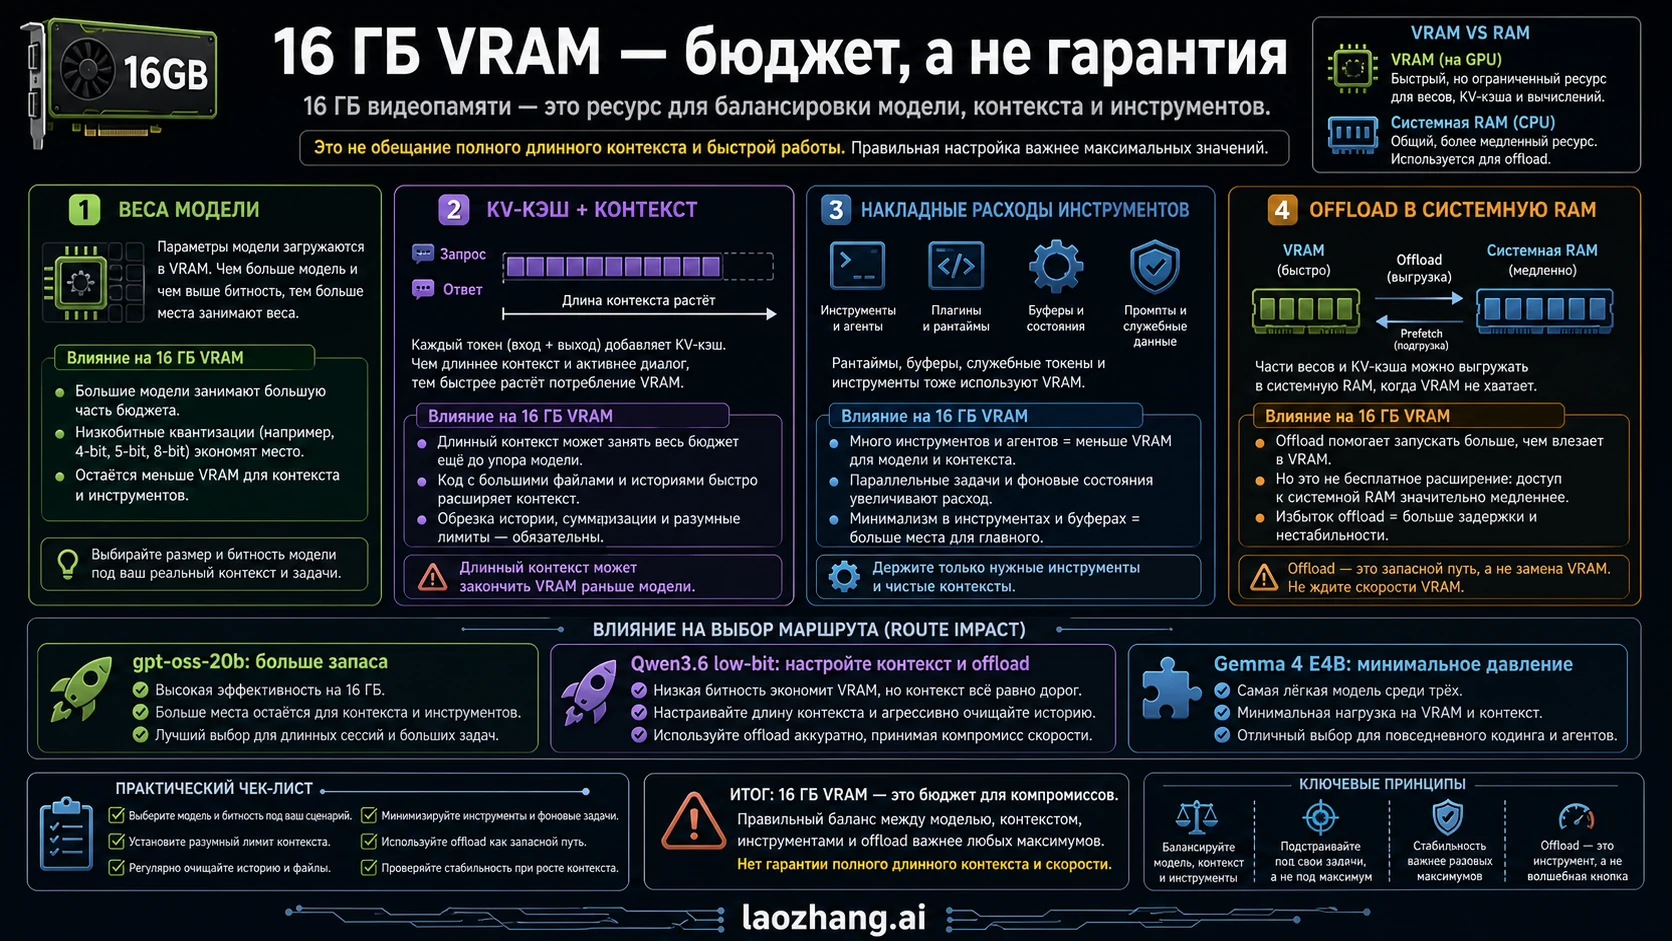
Схема показывает маршруты июля 2026 года; принцип бюджета не изменился, актуальные модели и цифры — в таблице ниже.
Сколько памяти занимает модель: файл квантования и KV cache на 32K и 64K
Формула простая: память ≈ размер файла весов + KV на токен × длина контекста, плюс буферы вычислений и память рабочего стола, которые в расчёт не входят. Размеры файлов на Hugging Face указаны в ГБ (10⁹ байт), runtime считает в ГиБ (2³⁰ байт), поэтому ниже веса переведены в ГиБ. KV на токен посчитан по config.json каждой модели: число слоёв с полным вниманием × KV-головы × размер головы × 2 (K и V) × 2 байта для F16. KV cache в q8_0 занимает примерно 0,53 от F16.
| Модель и файл | Веса | KV на токен, F16 | ≈ при 32K | ≈ при 64K | На 16 ГБ VRAM |
|---|---|---|---|---|---|
| gpt-oss-20b, MXFP4 GGUF (12,11 ГБ) | 11,28 ГиБ | 24 КиБ | 12,0 ГиБ | 12,8 ГиБ | помещается |
| Gemma 4 12B, QAT Q4_0 (6,98 ГБ) | 6,50 ГиБ | 16 КиБ + ≈0,31 ГиБ на скользящее окно | 7,3 ГиБ | 7,8 ГиБ | с большим запасом, 128K ≈ 8,8 ГиБ |
| Qwen3.8-27B, UD-Q3_K_XL (13,15 ГБ) | 12,24 ГиБ | 64 КиБ | 14,2 ГиБ в F16; 13,3 ГиБ в q8_0 | 14,4 ГиБ в q8_0 | только с KV q8_0 |
| Qwen3.8-27B, UD-IQ4_XS (14,25 ГБ) | 13,27 ГиБ | 64 КиБ | 14,3 ГиБ в q8_0 | 15,4 ГиБ в q8_0 | 32K — предел |
| Qwen3.8-27B, UD-Q4_K_M (16,46 ГБ) | 15,33 ГиБ | 64 КиБ | — | — | не помещается даже без контекста |
| Devstral Small 2, Q4_K_M (14,33 ГБ) | 13,35 ГиБ | 160 КиБ | 18,4 ГиБ в F16 | — | не помещается |
| Devstral Small 2, IQ4_XS (12,78 ГБ) | 11,90 ГиБ | 160 КиБ | 16K в F16 ≈ 14,4 ГиБ | — | только 16K |
| Devstral Small 2, Q3_K_M (11,47 ГБ) | 10,69 ГиБ | 160 КиБ | 13,4 ГиБ в q8_0 | 16,0 ГиБ в q8_0 | 32K — предел |
| Qwen3.6 35B A3B, UD-IQ3_XXS (13,21 ГБ) | 12,30 ГиБ | 20 КиБ | 12,9 ГиБ | 13,6 ГиБ | 128K в F16 ≈ 14,8 ГиБ, впритык |
Пример пересчёта для Qwen3.8-27B: 64 КиБ × 32 768 токенов = 2 ГиБ в F16; в q8_0 это ≈1,06 ГиБ; 12,24 + 1,06 ≈ 13,3 ГиБ. У Qwen3.8-27B 48 слоёв линейного внимания из 64 добавляют фиксированное состояние, которое в таблицу не входит. Проектор изображений (mmproj, ≈0,86 ГиБ) тоже не учтён: для кода его можно не загружать.
Отдельно стоит Gemma 4 12B: у неё только 8 слоёв из 48 используют глобальное внимание, остальные работают со скользящим окном в 1024 токена. Поэтому контекст 128K для неё дешевле, чем 32K для Devstral Small 2. Оценка для Gemma верхняя: расчёт предполагает отдельные K и V на глобальных слоях.
Чем ближе сумма к 16, тем вероятнее, что runtime молча выгрузит часть слоёв на CPU. Цифры около 14–15 ГиБ означают конфигурацию «впритык», которую надо проверять на своей машине, а не обещание работы.
Маршрут 1: начать с gpt-oss-20b
Начинайте с gpt-oss-20b, чтобы получить отправную точку, которую легче защитить. Она показывает не предел возможностей модели, а то, способны ли ваша машина, runtime и кусок репозитория дать полезный цикл правок. Модель не заменена: новой небольшой gpt-oss после неё не выходило, а заявление про 16 ГБ есть только у неё.
По расчёту MXFP4 GGUF (11,28 ГиБ) с контекстом 64K занимает ≈12,8 ГиБ: на 16 ГБ VRAM остаётся запас под буферы и рабочий стол. Пакет Ollama весит 14GB и рассчитан на окно до 128K, но на видеокарте меньше 24 ГиБ Ollama по умолчанию даёт только 4K контекста. Для кода это слишком мало, поэтому контекст надо поднять вручную:
# терминал 1: сервер Ollama с контекстом 64000
OLLAMA_CONTEXT_LENGTH=64000 ollama serve

# терминал 2
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
ollama ps   # колонка PROCESSOR: нет ли части модели на CPU
Не загружайте весь проект в первый запрос. Возьмите один файл, один соседний тест и короткое описание задачи. Попросите объяснить текущую логику, предложить минимальную правку и назвать тест, который должен измениться.
Если отправная точка уже медленная, уходит в OOM или теряет контекст, переход на более крупный Qwen главную проблему не решит. Сначала уменьшите контекст, проверьте ollama ps и отключите лишнюю IDE-обёртку. Если gpt-oss-20b проходит первый цикл, увеличивайте нагрузку постепенно: тест, затем соседний модуль, затем лог ошибки. На каждом шаге записывайте VRAM, системную RAM, задержку и качество правки.
Маршрут 2: Qwen3.6 35B A3B только как продвинутый эксперимент
Первым Qwen для пробы на 16 ГБ теперь стоит брать не Qwen3.6 35B A3B, а Qwen3.8-27B. Это плотная модель на 27B параметров, вышедшая 5 августа 2026 года под Apache-2.0, с нативным контекстом 262 144 токена. В таблице Qwen по коду она обходит Qwen3.6-27B во всех строках: Terminal Bench 2.1 — 73,0 против 63,4, SWE-bench Pro — 61,7 против 53,5, LiveCodeBench v6 — 90,3 против 83,9. Это оценки вендора в полной точности при 256K; 3-битная сборка на 16 ГБ их не гарантирует.
Тег Ollama по умолчанию qwen3.8:27b — это Q4_K_M на 18GB, и в 16 ГБ он не помещается. Рабочие варианты — сборки Unsloth: UD-Q3_K_XL (13,15 ГБ) с KV q8_0 на 32–64K или UD-IQ4_XS (14,25 ГБ) с KV q8_0 на 32K. Совсем экономный вариант — UD-IQ3_XXS (10,93 ГБ, 10,18 ГиБ): с 64K в q8_0 по расчёту ≈12,3 ГиБ, но качество 3-битного файла самого низкого класса придётся проверять особенно тщательно.
# llama.cpp: 3-битный файл, 32K контекста, KV cache в q8_0, без проектора изображений
llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XL \
  -c 32768 -ngl 99 -fa on -ctk q8_0 -ctv q8_0 --no-mmproj

# Ollama: тот же файл напрямую с Hugging Face
ollama run hf.co/unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XL
Флаги сверены с llama-server --help сборки 11429; сами команды с моделью не запускались. Расчёт с KV q8_0 относится к llama.cpp с флагами -ctk/-ctv. В Ollama с KV cache в F16 тот же файл на 32K займёт ≈14,2 ГиБ, поэтому после запуска проверьте ollama ps. Полный бюджет Qwen3.8-27B на 32 ГБ и двух видеокартах разобран в материале о том, сколько видеопамяти нужно Qwen3.8-27B на RTX 5090 и двух GPU.
Qwen3.6 35B A3B остаётся уместной в одном сценарии: у вас много системной RAM и вы готовы держать веса экспертов в ней. Это MoE на 35B параметров с 3B активных и 256 экспертами, а «A3B» обозначает активные параметры на токен, а не объём памяти. Файл UD-Q4_K_M весит 22,13 ГБ, UD-IQ3_XXS — 13,21 ГБ. Карточка Qwen советует держать контекст не меньше 128K, чтобы не ломать режим размышлений; на 128K KV cache в F16 занимает 2,5 ГиБ, и с UD-IQ3_XXS выходит ≈14,8 ГиБ — впритык.
В llama.cpp флаг --n-cpu-moe N оставляет веса экспертов первых N слоёв в системной памяти. У модели 40 слоёв, так что --n-cpu-moe 40 выносит в ОЗУ всех экспертов, а на видеокарте остаются внимание и KV cache:
llama-server -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_M \
  -c 131072 -ngl 99 -fa on --n-cpu-moe 40 --no-mmproj
Дальше N уменьшают, пока хватает VRAM. Этот путь подходит тем, кто готов читать графики памяти и мириться с падением скорости; разработчику, которому помощник нужен сегодня без настройки, он не подходит.
Маршрут 3: Gemma 4 E4B и компактные кодовые модели
На картах 16 ГБ этот ряд теперь возглавляет Gemma 4 12B, а Gemma 4 E4B осталась для 8 ГБ VRAM, ноутбуков и Mac на 16 ГБ. Модели 12B не было среди размеров Gemma 4 при мартовском запуске: она появилась на Hugging Face 23 мая 2026 года. Сейчас в семействе пять размеров: E2B, E4B, 12B, 26B A4B и 31B.
У Gemma 4 12B 11,95B параметров, контекст 256K и лицензия Apache-2.0. В собственной таблице Google она набирает 72,0 % в LiveCodeBench v6 и 1659 Эло на Codeforces против 52,0 % и 940 у E4B. Это не агентная работа по репозиторию: SWE-bench в таблице Google нет.
Главное преимущество 12B на 16 ГБ — запас. Официальный QAT Q4_0 GGUF весит 6,98 ГБ, и по расчёту модель занимает ≈7,8 ГиБ при 64K и ≈8,8 ГиБ при 128K. Так можно выполнить рекомендацию Ollama о 64000 токенах для coding-инструментов и при этом не упираться в потолок. Пакет gemma4:12b в Ollama весит 7,7–8,0GB и рассчитан на окно 256K.
ollama run gemma4:12bGemma 4 E4B по-прежнему полезна: её QAT Q4_0 весит 5,15 ГБ плюс 0,99 ГБ на проектор изображений, а контекст у неё 128K. На 8 ГБ VRAM или на ноутбуке это разумный выбор для объяснения функции, чтения stack trace и маленьких правок. На 16 ГБ VRAM держать E4B основной моделью нет смысла: 12B помещается с запасом и в кодовых тестах Google заметно сильнее.
Названия Qwen2.5-Coder, DeepSeek Coder и Qwen3-Coder-30B-A3B ещё встречаются в советах для 16 ГБ, но новых версий этих линеек в классе 16 ГБ не появилось. Их место заняли Devstral Small 2 и Qwen3.6-27B из следующего раздела. Если у вас уже стоит Qwen3-Coder-30B-A3B, выбор версий и требования к памяти разобраны в материале Qwen3-30B-A3B: выбор версии, локальный запуск и память.
Devstral Small 2 и Qwen3.6-27B: кодовые модели с коротким контекстом
Devstral Small 2 от Mistral (24B, Apache-2.0, контекст 256K) сделана для агентного кодинга. Mistral сообщает 68,0 % в SWE-bench Verified и сама пишет, что модель рассчитана на одну RTX 4090 или Mac с 32 ГБ, то есть на 24 ГБ, а не на 16.
Проблема Devstral на 16 ГБ — KV cache. Все 40 слоёв используют полное внимание, поэтому на токен уходит 160 КиБ в F16: 5 ГиБ на 32K и 10 ГиБ на 64K. Пакет devstral-small-2:24b в Ollama (Q4_K_M, 15GB) вместе с 32K в F16 по расчёту требует ≈18,4 ГиБ и не помещается. Реальные варианты — IQ4_XS (12,78 ГБ) с 16K контекста (≈14,4 ГиБ) или Q3_K_M (11,47 ГБ) с 32K в q8_0 (≈13,4 ГиБ):
llama-server -hf unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF:Q3_K_M \
  -c 32768 -ngl 99 -fa on -ctk q8_0 -ctv q8_0 --no-mmproj
Рекомендованных Ollama 64000 токенов Devstral Small 2 на 16 ГБ не достигает. Это модель для коротких агентных задач в пределах нескольких файлов, а не для долгой сессии по репозиторию.
Qwen3.6-27B (апрель 2026) — тот же класс размеров, что Qwen3.8-27B: Q4_K_M 16,82 ГБ, Q3_K_M 13,59 ГБ, UD-IQ3_XXS 11,99 ГБ. Ollama выпускает для неё тег qwen3.6:27b-coding, но он весит 19GB и в 16 ГБ не помещается. По таблице Qwen новая 3.8-27B сильнее во всех кодовых строках, поэтому 3.6-27B стоит оставить, только если она уже настроена и проходит ваш smoke test.
Ещё три новые модели подходят по размеру, но не меняют выбор:
- IBM Granite 4.2 (25 августа 2026 года, Apache-2.0): 8B в Q4_K_M — 5,35 ГБ, 30B в Q3_K_M — 14,13 ГБ.
- GLM-4.7-Flash (январь 2026, MIT): UD-Q3_K_XL — 13,78 ГБ, Q3_K_M — 14,61 ГБ, впритык.
- Gemma 4 26B A4B: QAT Q4_0 — 14,44 ГБ плюс 1,19 ГБ проектора; в тесте Qwen по SWE-bench Verified она набрала 17,4, но это замер конкурента в его собственной обвязке.
GLM-5.3-Flash, Qwen3.8-Flash-Next и Qwen3-Coder-Next не для 16 ГБ
Громкие новые названия часто появляются рядом с запросами про 16 ГБ, но ни одно из них не помещается в этот класс:
| Модель | Размер весов | Что это значит |
|---|---|---|
| GLM-5.3-Flash | официальные веса FP8 ≈305,8 ГиБ | сначала API или многокарточный сервер, см. как выбрать способ запуска GLM-5.3-Flash |
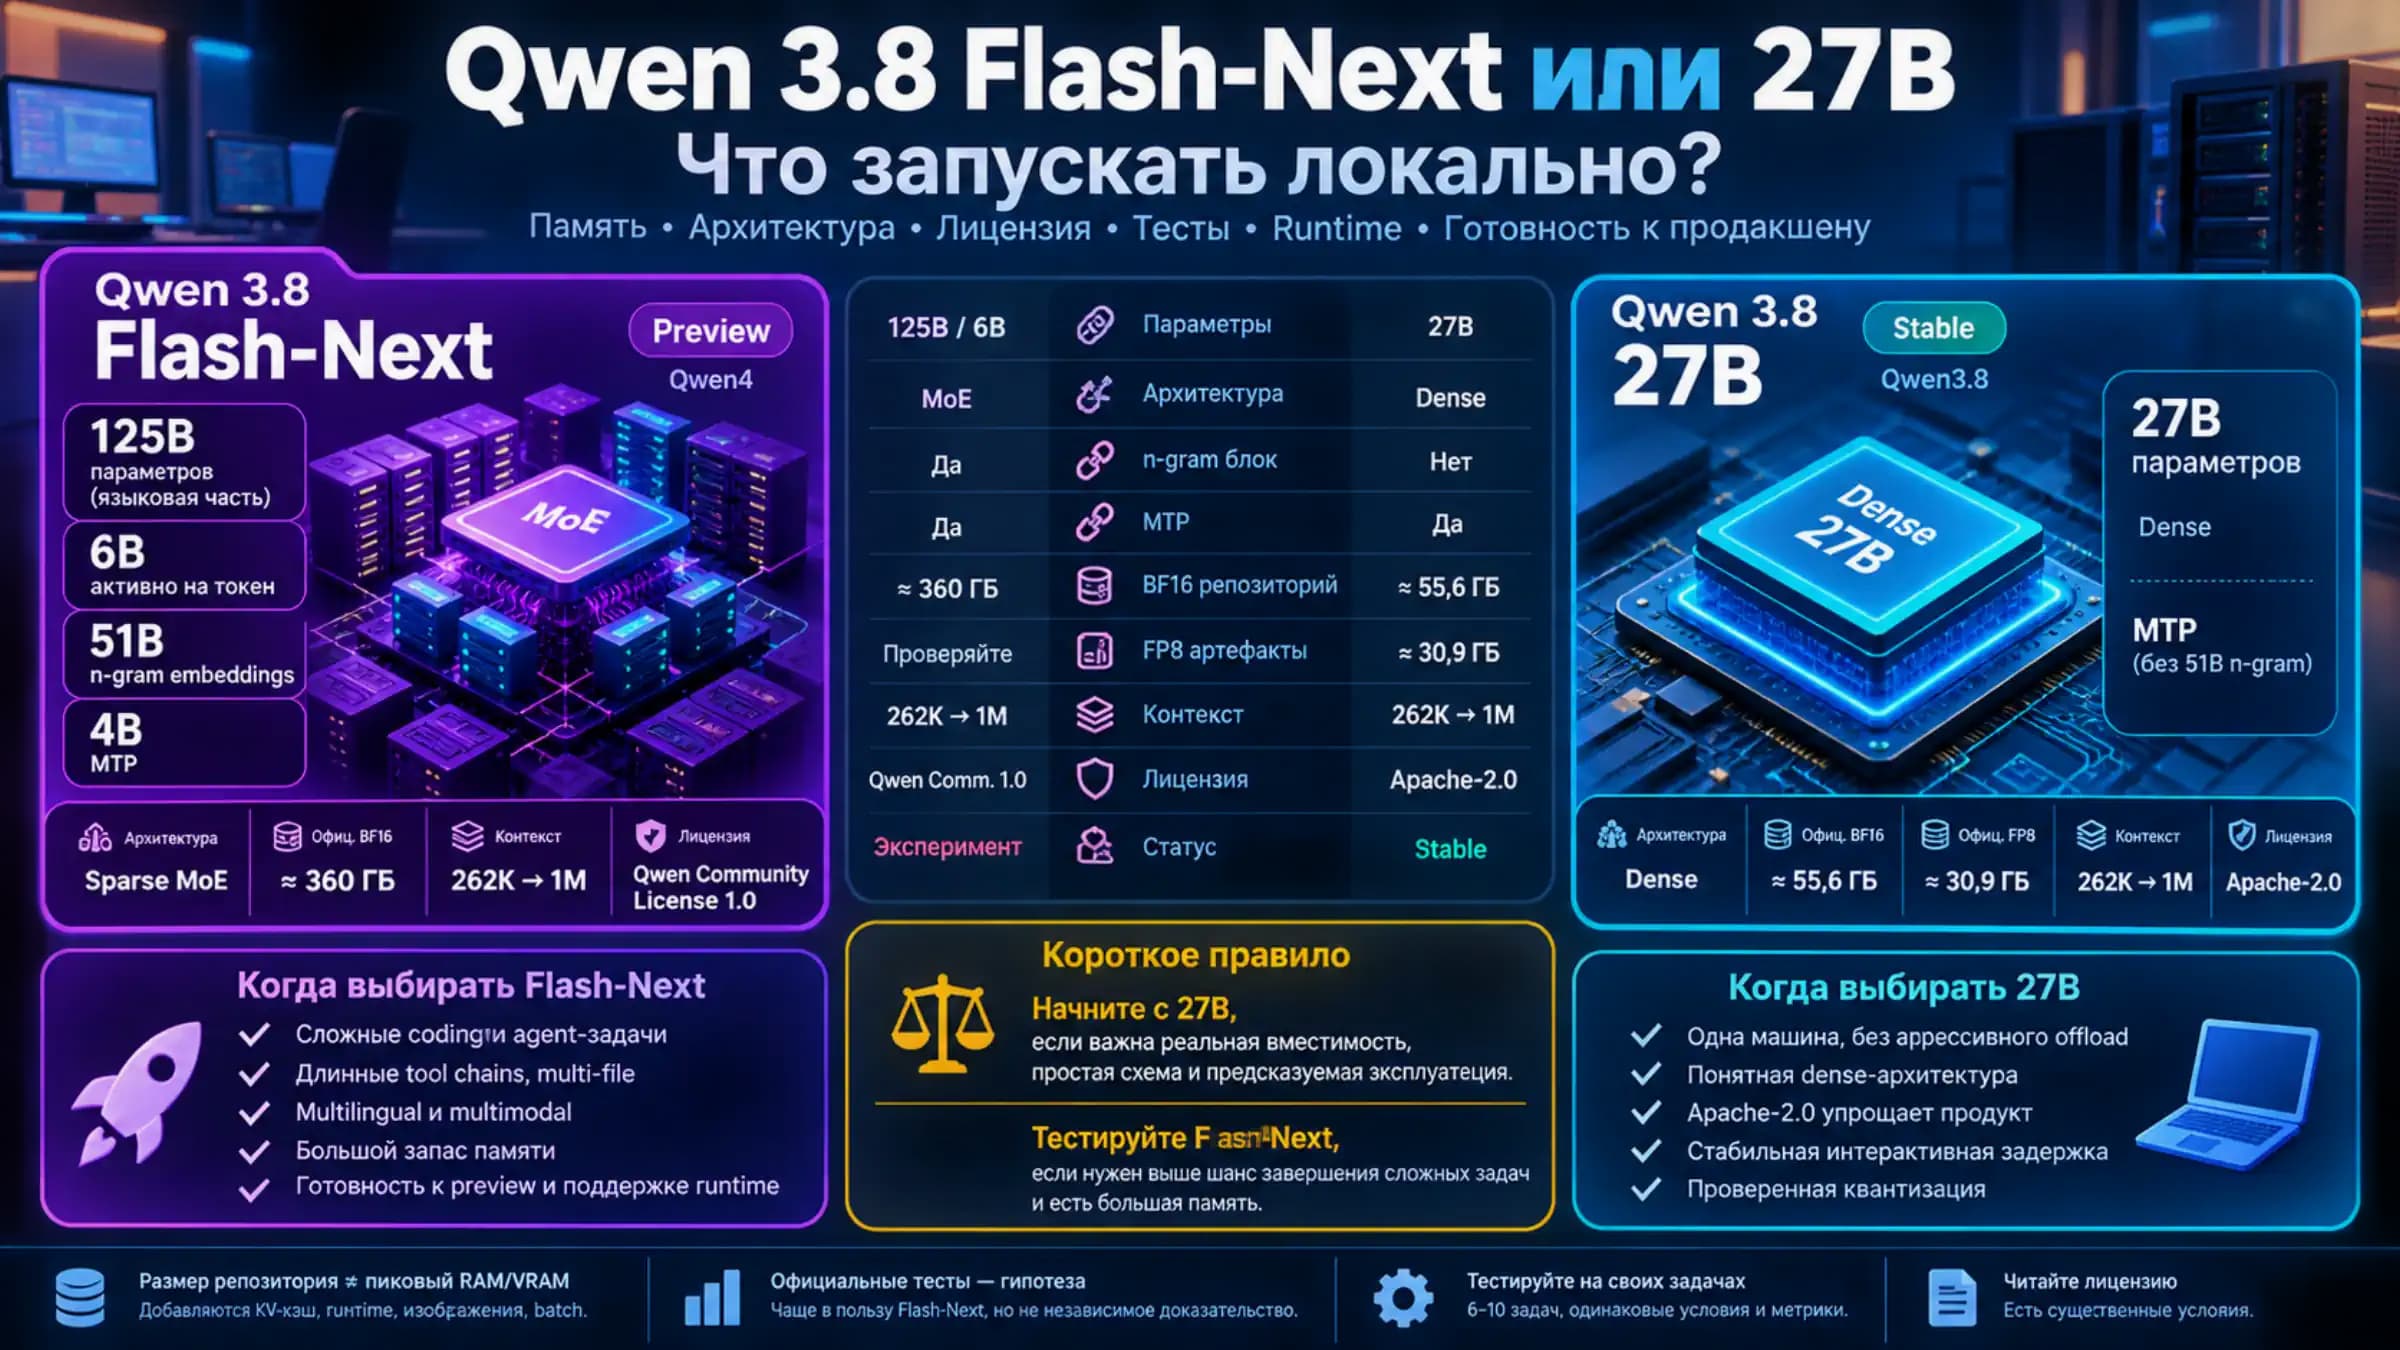
| Qwen3.8-Flash-Next | MoE на 125B с 6B активных, официальный BF16 ≈360 ГБ | «6B активных» — вычисления на токен, а не память, см. Qwen3.8 Flash-Next или 27B: что запускать локально |
| Qwen3-Coder-Next | GGUF Q4_K_M — четыре части, всего 48,4 ГБ | класс нескольких видеокарт или большой единой памяти |
Слово Flash в названии не означает «маленькая». Из семейства Qwen3.8 на 16 ГБ подходит только 27B, и то в 3-битном или IQ4-файле: моделей между 2B и 27B в линейке Qwen3.8 нет.
Runtime: Ollama, LM Studio, llama.cpp и обертки IDE
Runtime меняет ответ. Одно и то же название модели в разных runtime означает разные файлы и разный контекст по умолчанию, поэтому рекомендация должна включать путь запуска, а не только название.
Ollama удобна как первая проверка из командной строки, но у неё есть ловушка: при VRAM меньше 24 ГиБ контекст по умолчанию — 4K токенов (24–48 ГиБ — 32K, от 48 ГиБ — 256K). Сама Ollama в документации о длине контекста рекомендует для агентов и coding-инструментов не меньше 64000 токенов. Задать его можно ползунком в приложении или переменной OLLAMA_CONTEXT_LENGTH=64000 ollama serve. Если IDE-помощник «забывает» открытые файлы, первым делом проверьте именно это. Команда ollama ps показывает в колонке PROCESSOR, сколько модели осталось на GPU и сколько ушло на CPU.
Конкретный GGUF-файл, которого нет среди тегов Ollama, запускается напрямую с Hugging Face: ollama run hf.co/{user}/{repo}:{quant}. Так ставится, например, Qwen3.8-27B в UD-Q3_K_XL вместо тега на 18GB. Имя квантования должно совпадать с именем файла в репозитории.
LM Studio удобна, когда модель хочется выбрать через интерфейс и поднять локальный сервер: перед загрузкой смотрите размер выбранного файла и длину контекста. llama.cpp даёт самый тонкий контроль. На машине автора в сборке 11429 есть все флаги из команд в этом тексте: -c (контекст), -ngl (слои на GPU), -fa (flash attention), -ctk/-ctv (тип KV cache), --n-cpu-moe (эксперты MoE в ОЗУ), -hf user/repo:quant (загрузка с Hugging Face) и --no-mmproj (без проектора изображений).
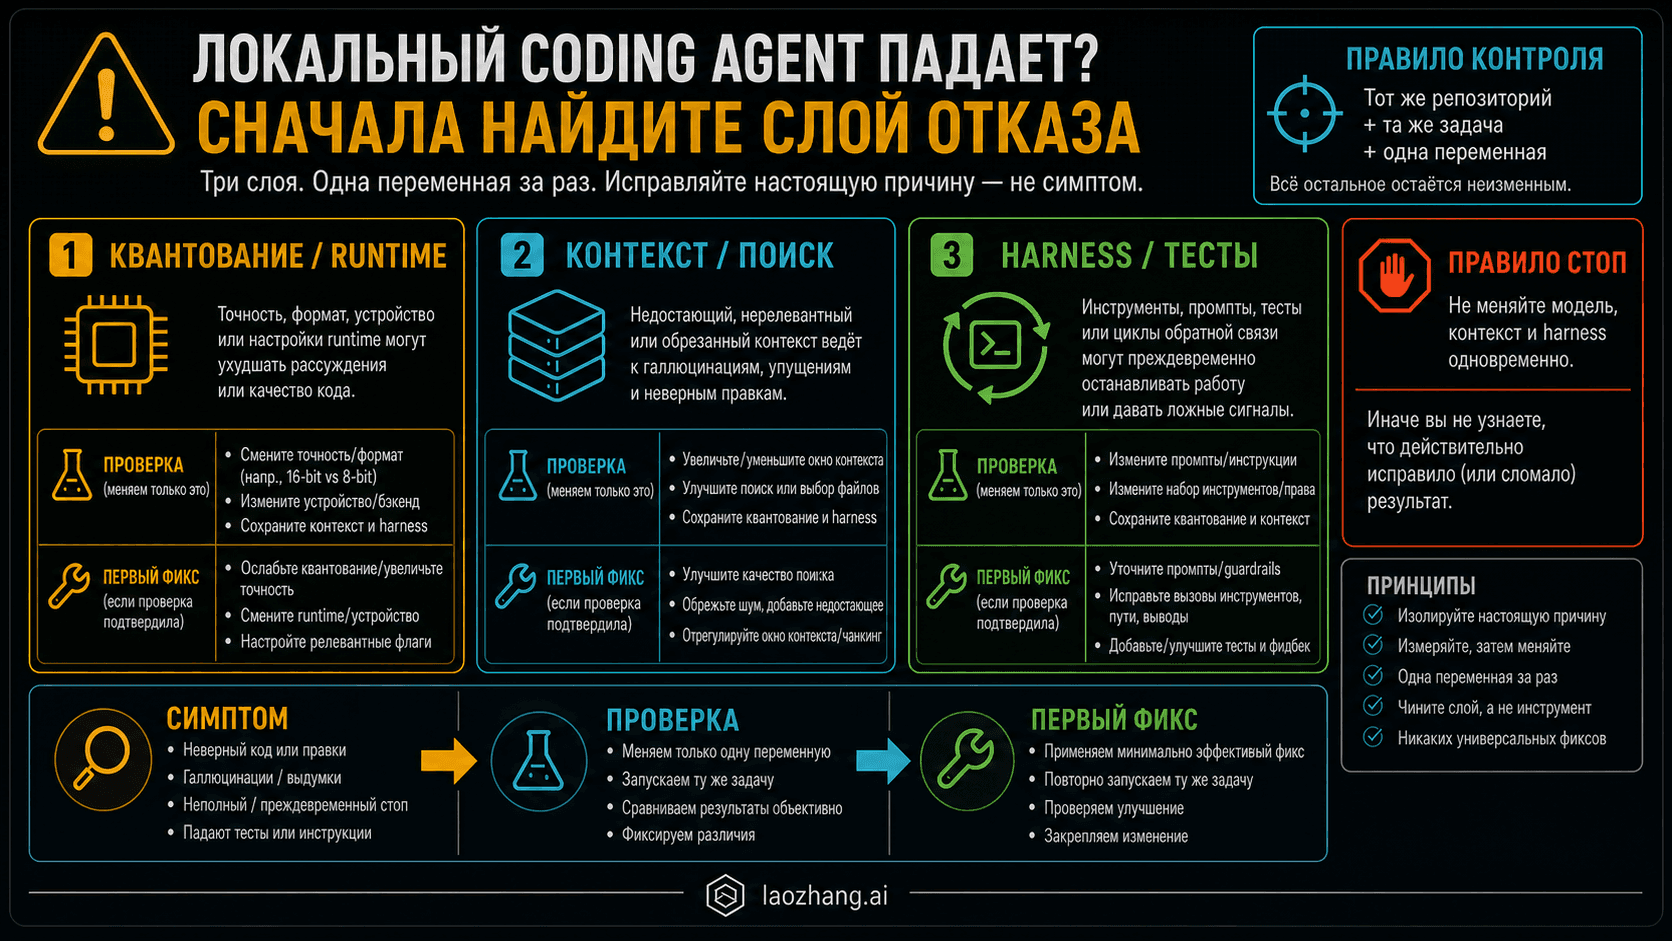
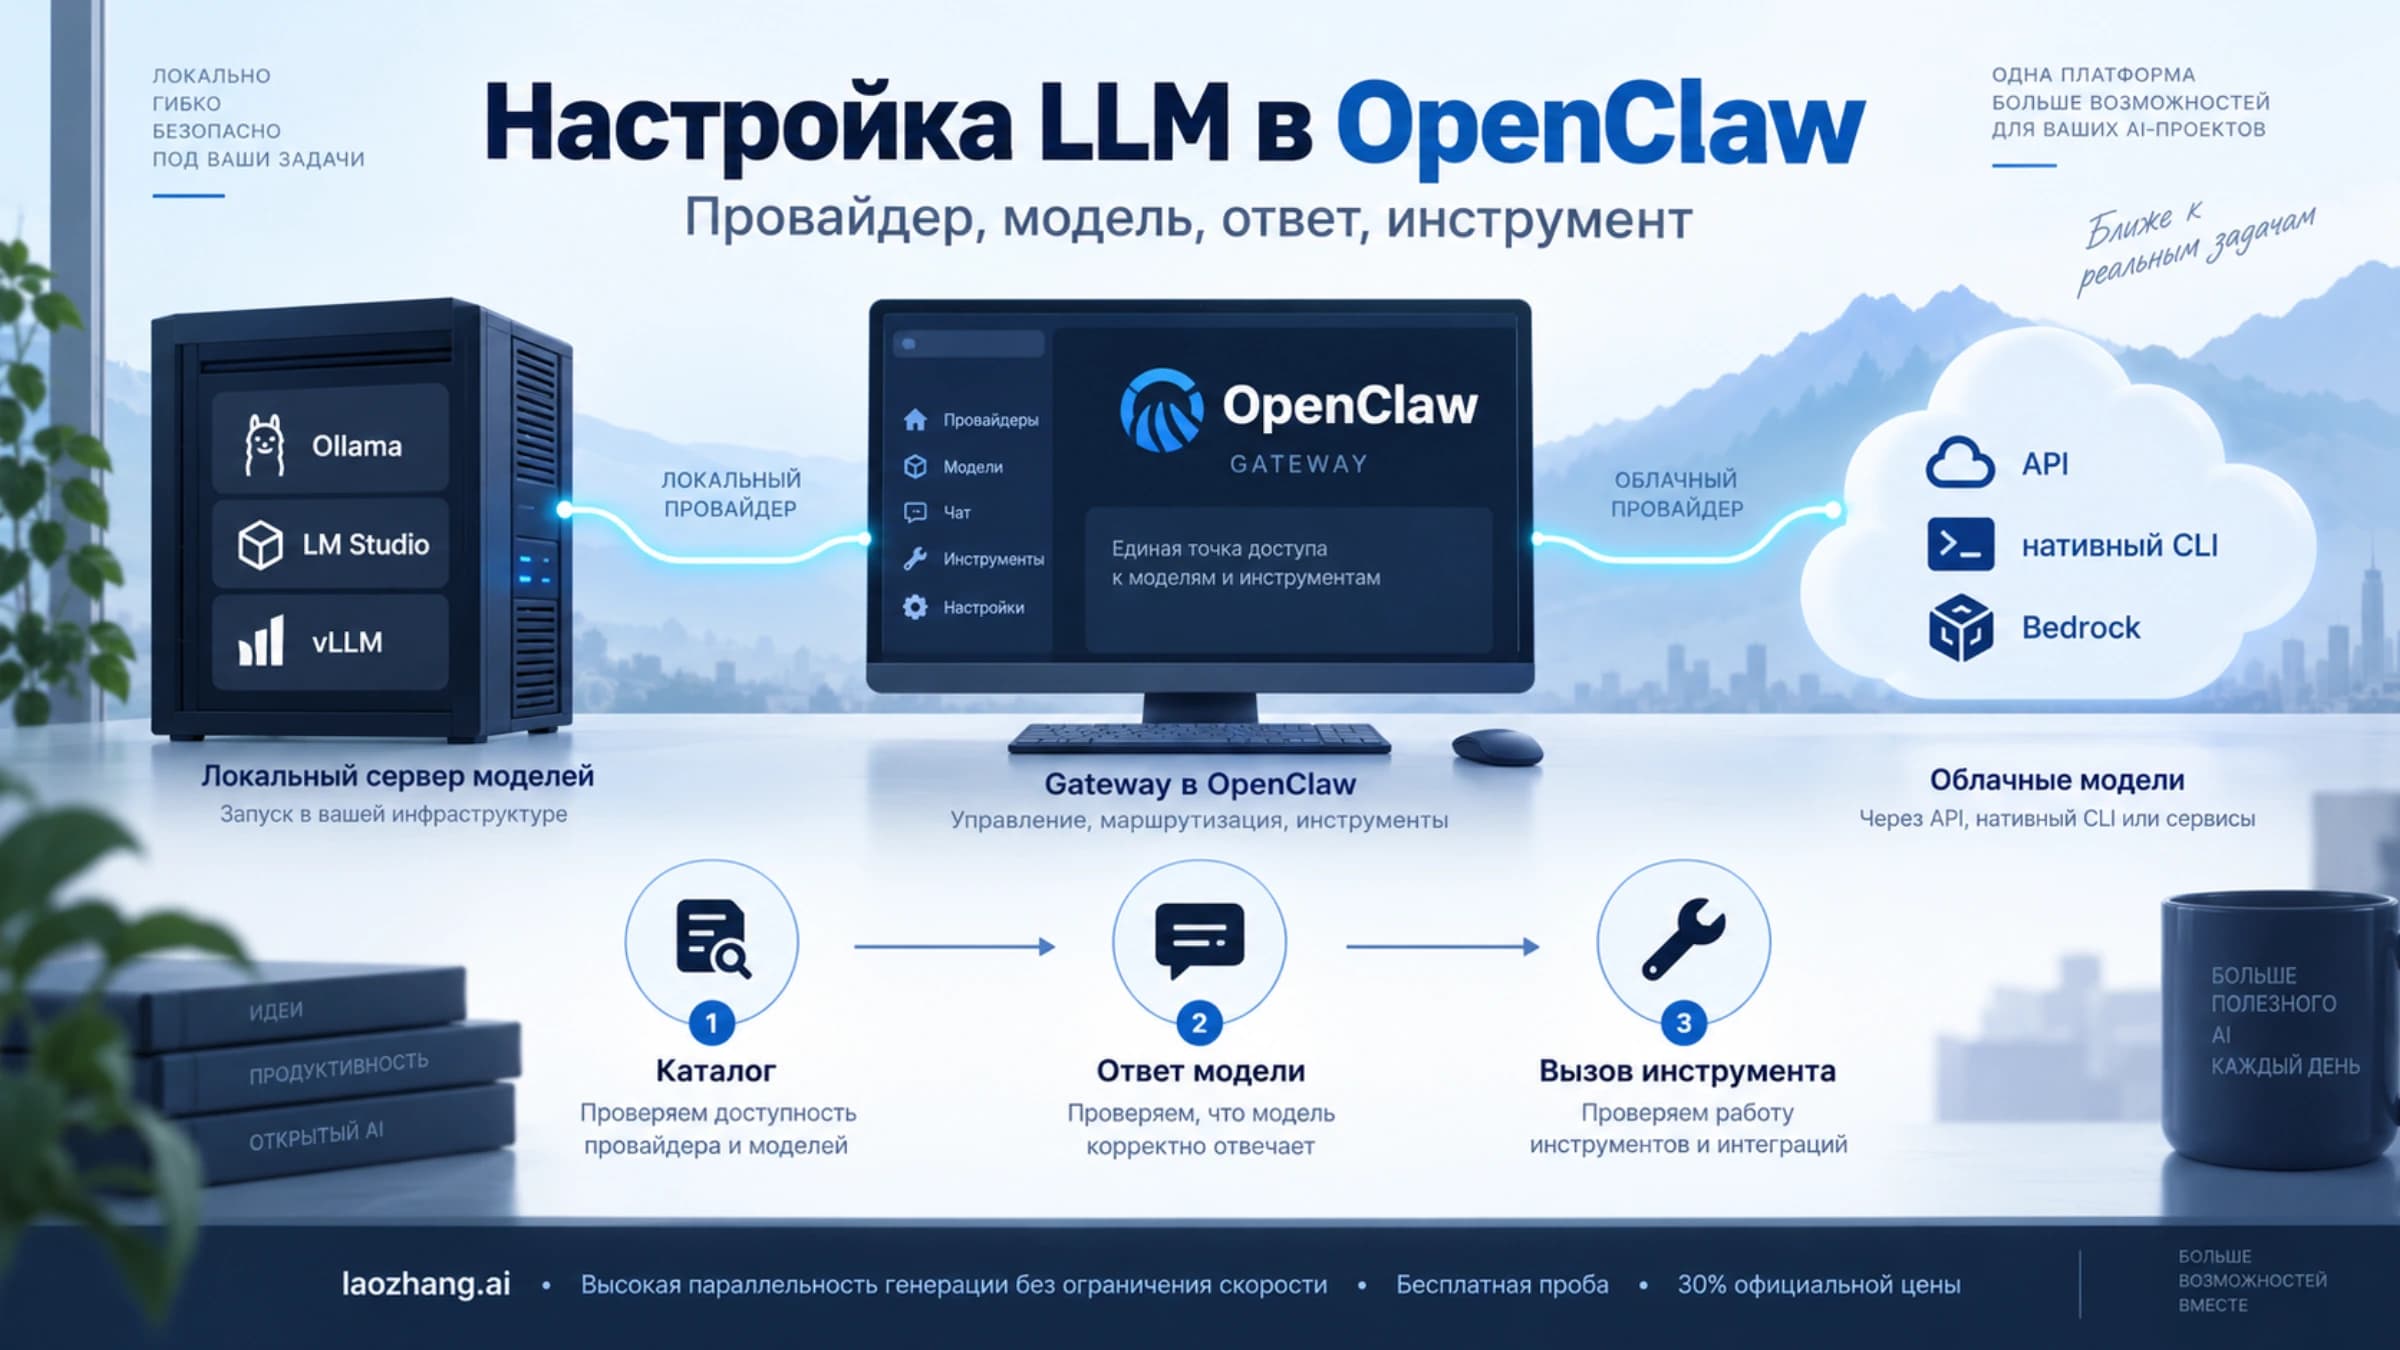
IDE-обёртки для VS Code и других редакторов обычно подключаются к локальному серверу Ollama, LM Studio или llama.cpp по адресу endpoint. Обёртка решает, какие файлы попадут в запрос, и сама не увеличивает контекст сервера. Если она скрывает нехватку памяти, временно вернитесь к командной строке: так проблема модели отделяется от проблемы редактора. Если модель загружается, но агент всё равно ошибается, разделить причины помогает разбор квантования, контекста и harness для локального coding agent.
16 ГБ оперативной памяти или Mac на 16 ГБ: бюджет Metal 12 124 МиБ
16 ГБ оперативной памяти — другой бюджет, не 16 ГБ VRAM. На ПК без большой видеокарты модель работает на CPU, и ограничением становится скорость. Реалистичный выбор здесь — небольшие модели: Gemma 4 E4B (QAT Q4_0 5,15 ГБ) или Granite 4.2 8B (Q4_K_M 5,35 ГБ). Gemma 4 12B по размеру файла (6,98 ГБ) в 16 ГБ RAM тоже помещается, но скорости на CPU в карточках моделей нет, и её придётся проверять самим.
На Mac с Apple Silicon память единая (unified memory), но видеоускорителю достаётся не вся. На Mac с M4 и 16 ГиБ памяти команда llama-cli --list-devices показала устройство MTL0: Apple M4 (12124 MiB, 12123 MiB free): llama.cpp видит около 11,8 ГиБ из 16. Это единственный замер на этой машине; инференс на ней не запускался, повышение системного лимита видеопамяти macOS тоже не проверялось.
По расчёту против бюджета 11,84 ГиБ:
| Модель и файл | Расчёт | Итог на Mac 16 ГБ |
|---|---|---|
| Gemma 4 12B, QAT Q4_0 | 6,50 ГиБ + KV ≈1,3 ГиБ при 64K ≈ 7,8 ГиБ | помещается с запасом |
| Gemma 4 E4B, QAT Q4_0 | 4,80 ГиБ весов | помещается |
| gpt-oss-20b, MXFP4 | 11,28 ГиБ весов; остаётся 0,56 ГиБ, а KV на 32K — 0,75 ГиБ | почти весь бюджет уходит на веса, длинный контекст не помещается |
| Qwen3.8-27B, UD-Q3_K_XL | 12,24 ГиБ весов | не помещается |
| Qwen3.8-27B, UD-IQ3_XXS | 10,18 + 1,06 (32K в q8_0) ≈ 11,2 ГиБ | формально на 0,6 ГиБ меньше бюджета, без буферов и состояния линейного внимания; для работы не годится |
Итог для Mac на 16 ГБ: Gemma 4 12B — основной кандидат, E4B — запасной. gpt-oss-20b, которая на видеокарте 16 ГБ служит отправной точкой, на таком Mac занимает весь бюджет Metal ещё до контекста.
Smoke test: докажите модель на своем коде
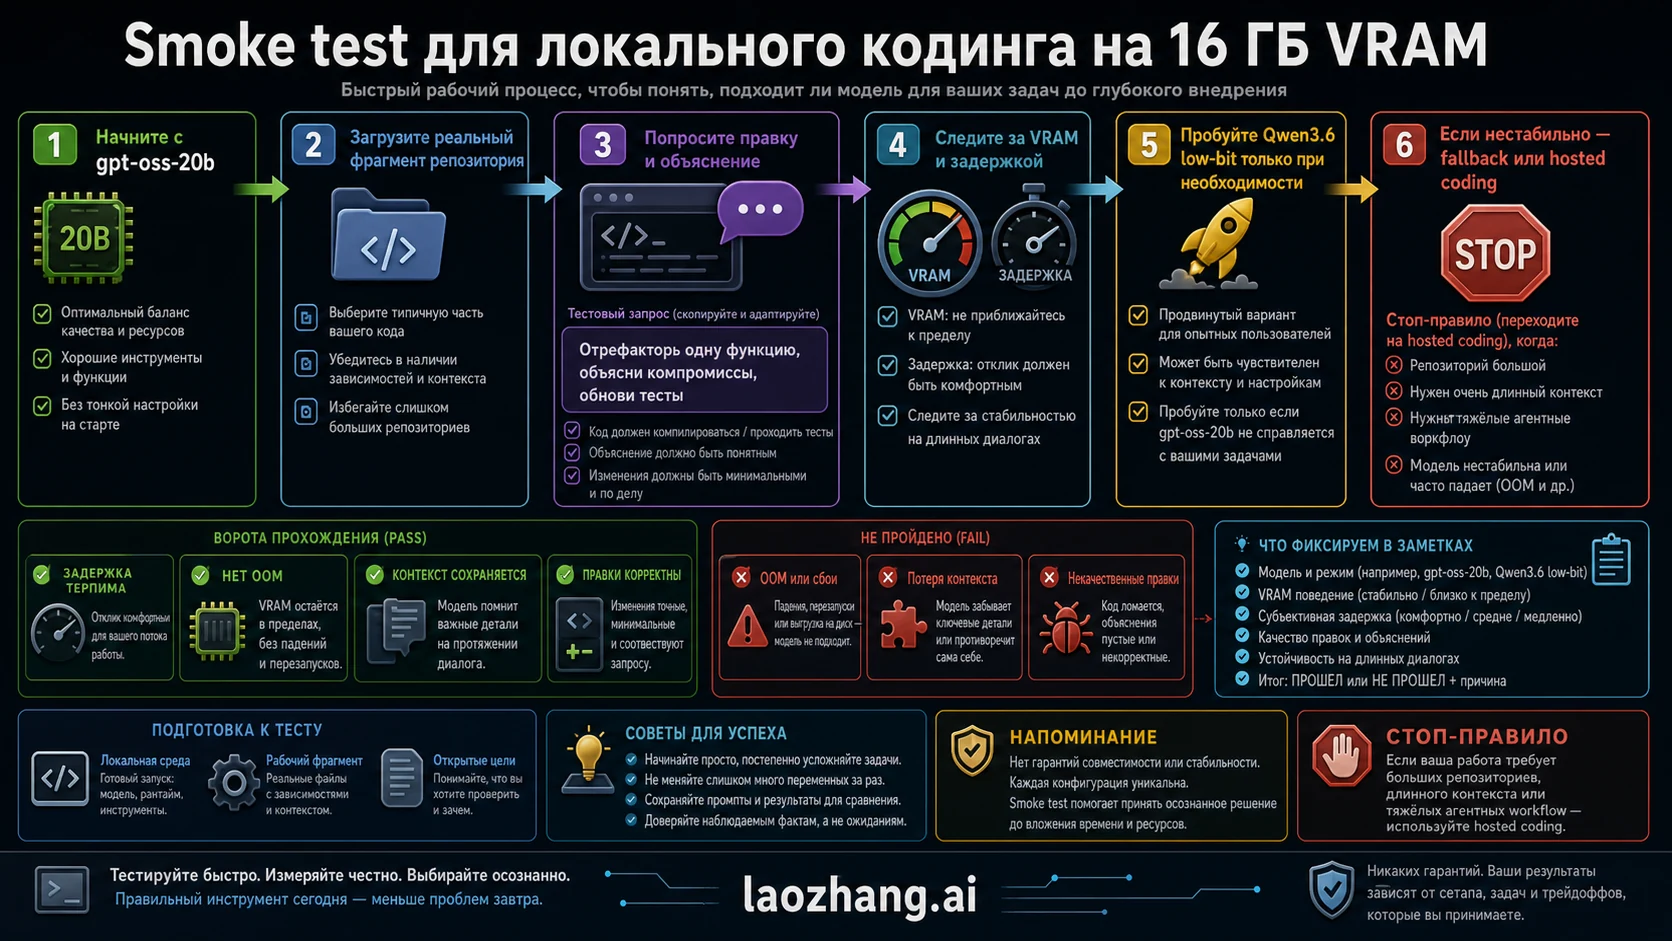
Схема показывает маршруты июля 2026 года; порядок проверки прежний, актуальные модели для каждого шага — в тексте.
Smoke test должен быть на вашем коде. Синтетические задачи не показывают, сохранит ли модель требования рефакторинга, соседний тест и формат правки.
Минимальный тест: один файл, один тест, короткое требование. Модель должна объяснить текущее поведение, предложить правку, назвать тест и признать, какой файл ей нужен, если контекста мало.
Given the files below, refactor one function without changing behavior.
Explain the tradeoff, show the patch, and name the test that should be updated.
If the context is insufficient, say exactly what file or symbol you need next.
Проход означает терпимую задержку, отсутствие неожиданной выгрузки на CPU (в ollama ps), сохранённый контекст функции и теста и маленькую правку, которую легко проверить. Провал означает, что маршрут не подходит для этой задачи, а не что модель плоха навсегда.
Порядок: gpt-oss-20b на 32K, затем на 64K; если не хватает качества — Qwen3.8-27B в UD-Q3_K_XL; если не хватает контекста — Gemma 4 12B на 128K. Меняйте одну переменную за раз, иначе настройку runtime легко перепутать с качеством модели.
Правила остановки: когда 16 ГБ уже не тот предел
Запишите правила остановки заранее. Самая дорогая ошибка на 16 ГБ — продолжать настраивать модель, которая загружается, но не помогает писать код.
Медленная генерация обычно означает дорогую выгрузку на CPU или слишком тяжёлый файл. Хорошие ответы на фрагменты и плохие на задачи по репозиторию указывают на нехватку контекста. OOM после увеличения контекста — это KV cache. Потеря состояния файлов в цикле правок значит, что рабочий процесс слишком тяжёл для этой конфигурации.
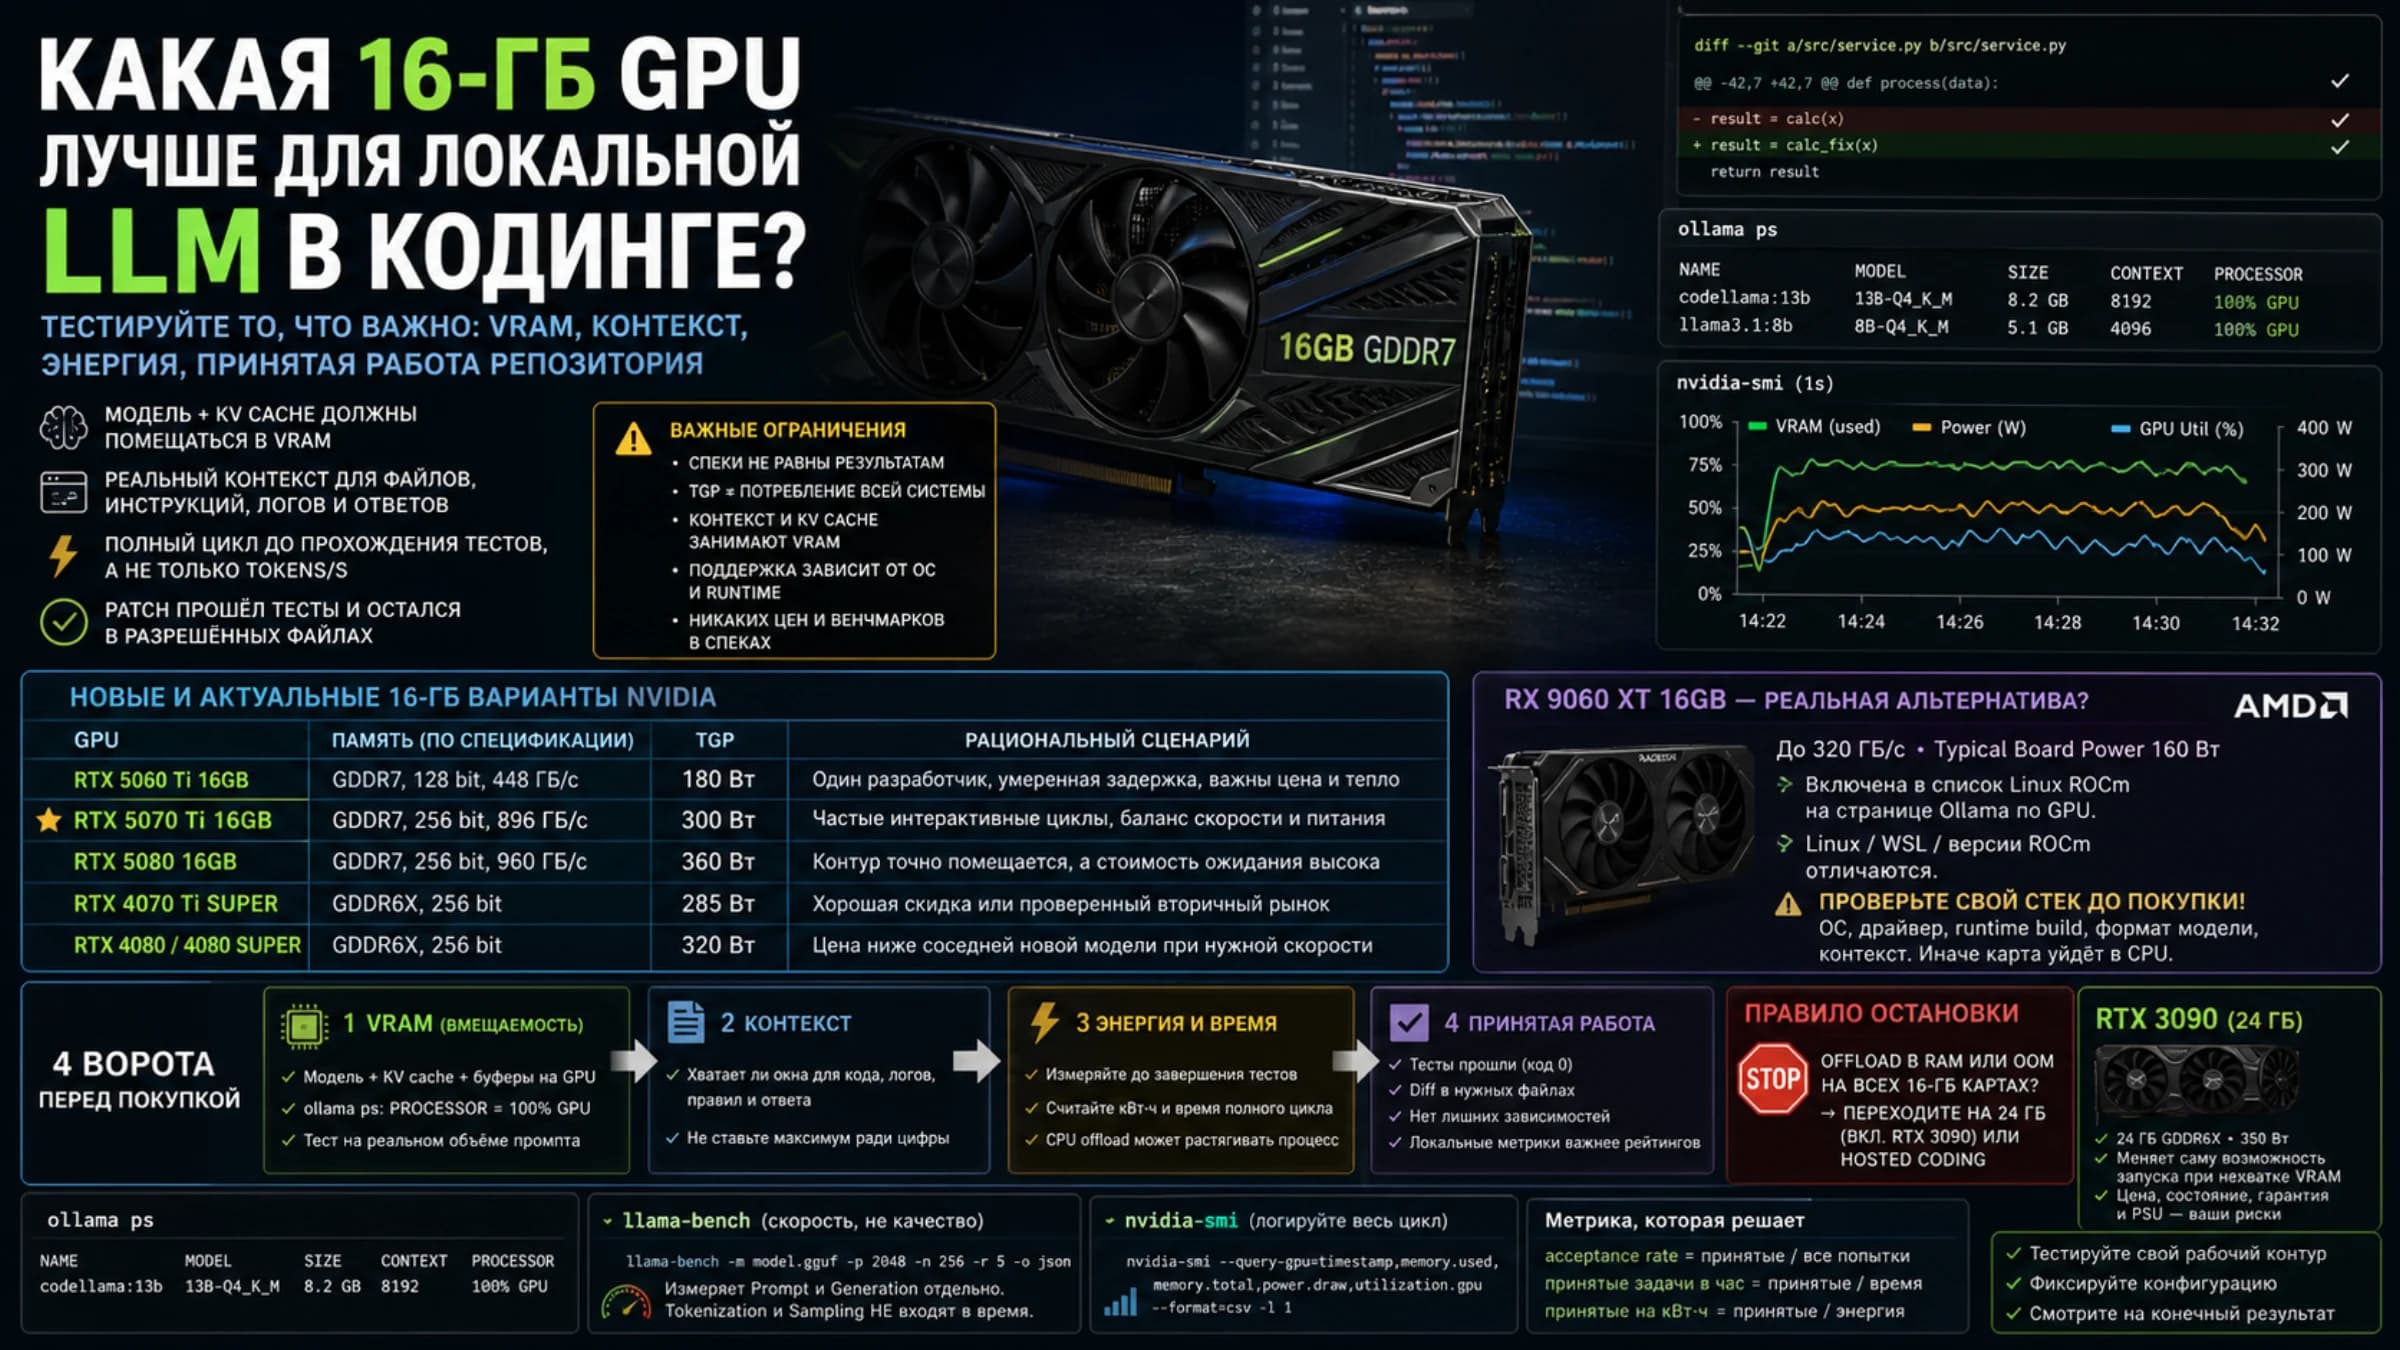
Нормальных решений несколько: уменьшить модель, сузить задачу, снизить контекст, перейти на 24 или 32 ГБ VRAM или отдать длинные многофайловые задачи облачному кодингу. Когда локальная модель для агентов выгоднее облака, а когда нет, разобрано в материале Локальная LLM для coding agents: когда она лучше Claude/Codex. Если упираетесь в саму видеокарту, сравнение карт — в руководстве как выбрать видеокарту с 16 ГБ для локальной LLM и программирования.
Цель не в том, чтобы доказать, что 16 ГБ могут всё, а в том, чтобы получить надёжную помощь в коде и не тратить день на настройку инференса.
| Симптом | Вероятная причина | Лучший маршрут |
|---|---|---|
| Медленно после загрузки | выгрузка на CPU или слишком тяжёлый файл | файл меньше, ollama ps, больше VRAM |
| Хорошо на фрагментах, плохо на репозитории | контекст 4K по умолчанию или не хватает окна | поднять контекст до 64000 или сузить задачу |
| OOM при росте контекста | KV cache съедает бюджет | KV в q8_0, меньше контекста или 24 ГБ+ |
| Цикл правок теряет состояние | агентный процесс слишком тяжёл | облачный кодинг или новая видеокарта |
Как вести локальный журнал проверки
Журнал проверки должен включать GPU, системную RAM, драйвер, версию runtime, точное имя файла модели и квантования, длину контекста, тип KV cache, вывод ollama ps или число слоёв на GPU, тип задачи, задержку, пик памяти и причину провала. Без этих полей следующий запуск не с чем сравнить.
Для каждой модели главный вопрос свой. Для gpt-oss-20b — какой кусок репозитория она стабильно удерживает на 64K. Для Qwen3.8-27B — насколько 3-битный файл и KV q8_0 портят правки по сравнению с gpt-oss. Для Gemma 4 12B — хватает ли качества, когда контекст 128K. Для Qwen3.6 35B A3B — во сколько обходится выгрузка экспертов в ОЗУ.
Пишите не «модель запустилась», а «модель изменила код правильно». Для помощника по коду важны правка, тест и способность признать нехватку контекста.
Часто задаваемые вопросы
Какую локальную LLM для кода сначала ставить на 16 ГБ VRAM?
gpt-oss-20b в MXFP4: GGUF весит 12,11 ГБ, по расчёту с контекстом 64K это ≈12,8 ГиБ. Это единственная модель класса, для которой разработчик заявляет работу в 16 ГБ. В Ollama не забудьте поднять контекст до 64000, иначе на 16 ГБ будет 4K.
Может ли Qwen3.6 35B A3B работать на 16 ГБ VRAM?
Только с компромиссами. UD-IQ3_XXS (13,21 ГБ) с рекомендованными Qwen 128K в F16 даёт ≈14,8 ГиБ, впритык. Другой путь — держать экспертов в ОЗУ через --n-cpu-moe в llama.cpp ценой скорости. Как первый Qwen для пробы её сменила Qwen3.8-27B.
Помещается ли Qwen3.8-27B в 16 ГБ VRAM?
Тег Ollama по умолчанию qwen3.8:27b (Q4_K_M, 18GB) — нет. Сборка Unsloth UD-Q3_K_XL (13,15 ГБ) с KV cache в q8_0 по расчёту занимает ≈13,3 ГиБ при 32K и ≈14,4 ГиБ при 64K. Оценки Qwen по коду измерены в полной точности и к такой сборке не переносятся.
Достаточно ли gpt-oss-20b для программирования?
Для точечных правок, объяснения кода, небольшого рефакторинга и предложений по тестам — это хорошая отправная точка. Для длинного многофайлового агентного кодинга нужен отдельный smoke test на вашем репозитории.
Зачем держать Gemma 4 E4B?
Для 8 ГБ VRAM, ноутбуков и Mac на 16 ГБ: QAT Q4_0 весит 5,15 ГБ. На видеокарте 16 ГБ её место заняла Gemma 4 12B, которая по расчёту укладывается в ≈8,8 ГиБ даже с контекстом 128K и в кодовых тестах Google заметно сильнее.
Ollama или LM Studio?
Ollama быстрее для первой проверки из командной строки, LM Studio удобнее для выбора модели через интерфейс и локального сервера. Важнее не инструмент, а выбранный файл, квантование и контекст: в Ollama на 16 ГБ по умолчанию стоит 4K.
Подойдет ли RTX 4060 Ti 16GB?
Да, все расчёты на этой странице одинаково относятся к RTX 4060 Ti 16GB, 5060 Ti 16GB, 5070 Ti, 4080 и 5080: они зависят от объёма памяти, а не от модели карты. Скорость у этих карт разная и здесь не измерялась. Пакеты на 18–24GB вроде qwen3.8:27b или qwen3.6:35b ни на одной из них целиком не поместятся.
Что делать с 8 ГБ VRAM?
Брать модели поменьше, короткий контекст и узкие задачи. Gemma 4 12B в QAT Q4_0 (≈7,3 ГиБ при 32K по расчёту) на 8 ГБ — впритык, разумнее начинать с Gemma 4 E4B. Маршруты с Qwen3.8-27B и Devstral Small 2 на 8 ГБ не повторить.
24 ГБ VRAM решают проблему?
24 ГБ снимают главные ограничения: по документации Ollama при 24–48 ГиБ VRAM контекст по умолчанию — 32K, а Q4_K_M-сборки Qwen3.8-27B и Devstral Small 2 помещаются вместе с KV cache на 32K, а Mistral прямо называет одну RTX 4090 целевой картой для Devstral Small 2. Smoke test всё равно нужен.
Что запускать на 16 ГБ оперативной памяти или на Mac с 16 ГБ?
На Mac с M4 и 16 ГиБ llama.cpp видит бюджет Metal 12 124 МиБ: в него с запасом помещается Gemma 4 12B, а gpt-oss-20b занимает его почти целиком ещё до контекста. На ПК с 16 ГБ RAM без большой видеокарты модель работает на CPU — начинайте с Gemma 4 E4B или Granite 4.2 8B.
Можно ли запустить GLM-5.3-Flash локально на 16 ГБ?
Нет. Официальные веса FP8 занимают около 305,8 ГиБ — это класс API или многокарточного сервера. То же относится к Qwen3.8-Flash-Next (≈360 ГБ в BF16) и Qwen3-Coder-Next (48,4 ГБ в Q4_K_M).
Когда остановить локальную настройку?
Когда OOM, задержка из-за выгрузки, потеря контекста или сбои цикла правок становятся основной работой. Тогда уменьшайте модель, расширяйте железо или переносите длинные задачи в облачный кодинг.
Можно ли доверять Reddit benchmark?
Как сигналу — да, как гарантии — нет. Нужны точное имя файла, квантование, тип KV cache, runtime, длина контекста и проверка на вашем коде.
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 22 окт. 2026 г..
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 22 окт. 2026 г..