나노바나나 2.1 캐릭터 일관성 유지 방법: 10회 실측, 매번 원본 레퍼런스로
2026년 11월 3일 나노바나나 2.1을 10회 호출해 보니 머리와 옷은 유지됐지만 오드아이와 흉터는 대부분 사라졌습니다. 직전 결과를 넘기면 더 흔들리니 매번 원본 레퍼런스를 첨부하세요.
목차
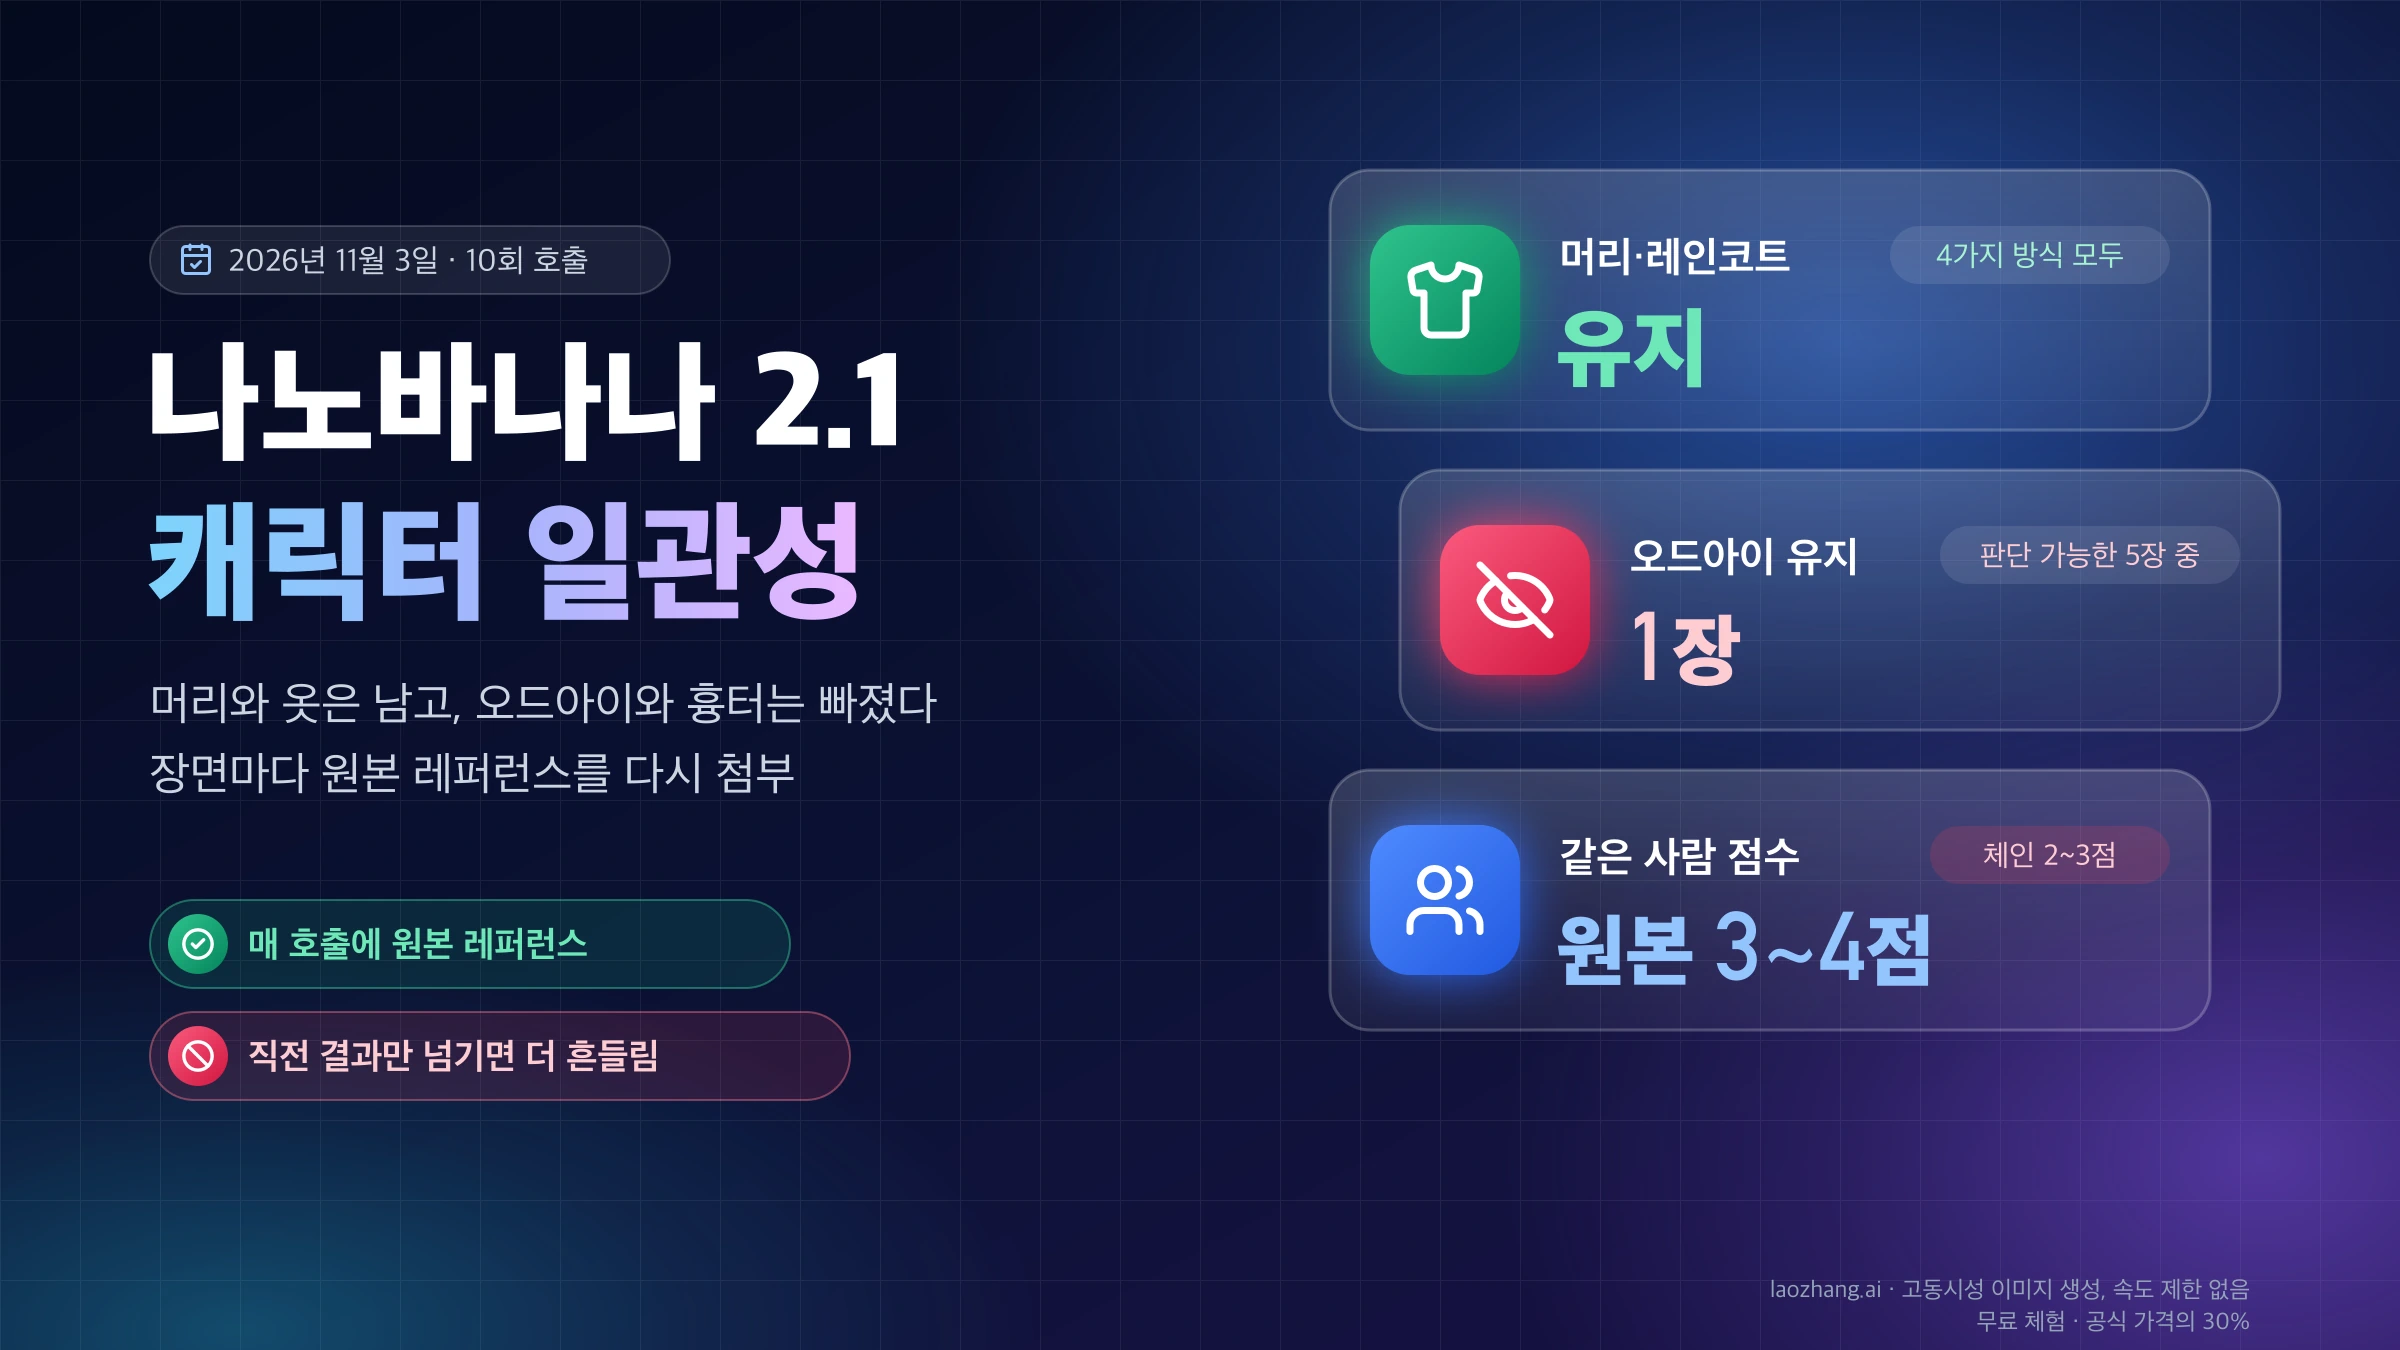
나노바나나 2.1(Nano Banana 2.1, gemini-nano-banana-2.1)에 같은 캐릭터를 다른 장면으로 다시 그려 달라고 하면, 머리 모양과 옷처럼 큰 특징은 대체로 따라오지만 얼굴의 작은 표식은 쉽게 빠집니다. 2026년 11월 3일 가상 캐릭터 한 명으로 10회 호출해 보니 은백색 단발과 겨자색 레인코트는 모든 장면에 남았고, 한쪽은 호박색이고 다른 쪽은 초록색인 오드아이와 광대뼈의 별 모양 흉터는 프롬프트에 직접 적어도 대부분 돌아오지 않았습니다. 직전 출력을 다음 레퍼런스로 넘긴 방식이 가장 약했습니다.
그래서 시작은 이렇게 하는 편이 낫습니다. 얼굴이 크게 보이는 기준 레퍼런스 이미지 한 장을 정해 매 호출에 그 원본을 첨부하고, 캐릭터를 알아보게 하는 요소는 머리 색과 모양, 옷 색, 소품처럼 원경에서도 보이는 곳에 둡니다. 이미지마다 같은 확인 목록으로 점검하다가 같은 작은 표식이 두 번 연속 빠지면 재생성을 멈추고 방식을 바꿉니다.
테스트는 LaoZhang API의 제미나이 네이티브 generateContent 엔드포인트에서 1K 출력, 기본 사고 수준(thinking level)으로 진행했습니다. 제미나이 앱과 Flow에서 같은 결과가 나오는지는 이 범위에 들어 있지 않습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
2026년 11월 3일 실측 조건: 캐릭터 1명, 장면 3개, 10회 호출
캐릭터는 말로만 정의한 20대 후반의 가상 여성입니다. 그 설명 문장으로 정면 기준 이미지를 먼저 만들고, 비 오는 밤거리의 옆모습, 카페에서 웃는 클로즈업, 일출의 산길에서 비스듬히 뒤돌아보는 전신이라는 세 장면을 네 가지 방식으로 생성했습니다. 10회 모두 HTTP 200이었고, 게이트웨이가 다른 모델을 돌려주지 않았는지 응답마다 modelVersion이 gemini-nano-banana-2.1인지 확인했습니다.
모델에 보낸 문장은 영어였습니다. 짧아서 그대로 옮깁니다.
캐릭터 설명(LOOK)
a woman in her late twenties with a short asymmetric silver-white bob that is
longer on one side, one amber eye and one green eye, a small star-shaped scar on
one cheekbone, a mustard-yellow rain jacket with four round copper buttons and a
teal knitted scarf

기준 이미지(1:1, 이미지 없이 텍스트만)
Character reference photo: {LOOK}. She stands against a plain light-grey studio
background, head and upper body fully visible, looking at the camera with a
neutral relaxed expression, soft studio light, natural photographic style.

유지 문장(KEEP)
Use the person in the reference image as the character. Keep her face, hair,
eye colours, scar, jacket and scarf identical to the reference.

장면(4:3)
S1 Show her walking along a rainy neon-lit city street at night, seen from a
   three-quarter side angle, holding a black umbrella.
S2 Close-up, head and shoulders, laughing in a warm cafe with a blurred background.
S3 Full-body shot standing on a mountain trail at sunrise, seen from
   three-quarter back, turning her head toward the camera.
기준 이미지에는 두 눈의 색이 다르게, 흉터는 화면 기준 오른쪽 뺨에 나왔고 청록색 목도리와 구리 단추도 그대로 그려졌습니다. 네 가지 방식은 A가 기준 이미지 + 유지 문장 + 장면(S1·S2·S3), B가 직전 출력을 유일한 레퍼런스로 넘기는 체인(A-S1 출력에서 S2, 그 결과에서 S3), C가 이미지 없이 캐릭터 설명 + 장면(S1·S3), D가 기준 이미지 + 유지 문장 + 캐릭터 설명 전체를 속성 목록으로 덧붙인 것(S1·S3)입니다. D는 첫 평가를 본 뒤 2회를 추가한 것입니다.
평가는 기준 이미지와, 순서를 섞고 이름을 바꾼 장면 이미지만 받은 AI 평가자 2명이 새 컨텍스트에서 따로 했습니다. 어떤 방식으로 만든 이미지인지는 알려 주지 않았고, 머리·눈·흉터·목도리·재킷을 항목별로 적은 뒤 "같은 사람인가"를 1~5점(5는 틀림없이 같은 사람, 3은 친척일 수도 있는 정도, 1은 다른 사람)으로 매기게 했습니다. 얼굴 인식 점수가 아니고 칸마다 이미지가 한 장이며, 캐릭터 한 명, 하루, 게이트웨이 하나의 결과이므로 아래 수치는 방향을 보여 줄 뿐 성공률이나 벤치마크가 아닙니다.
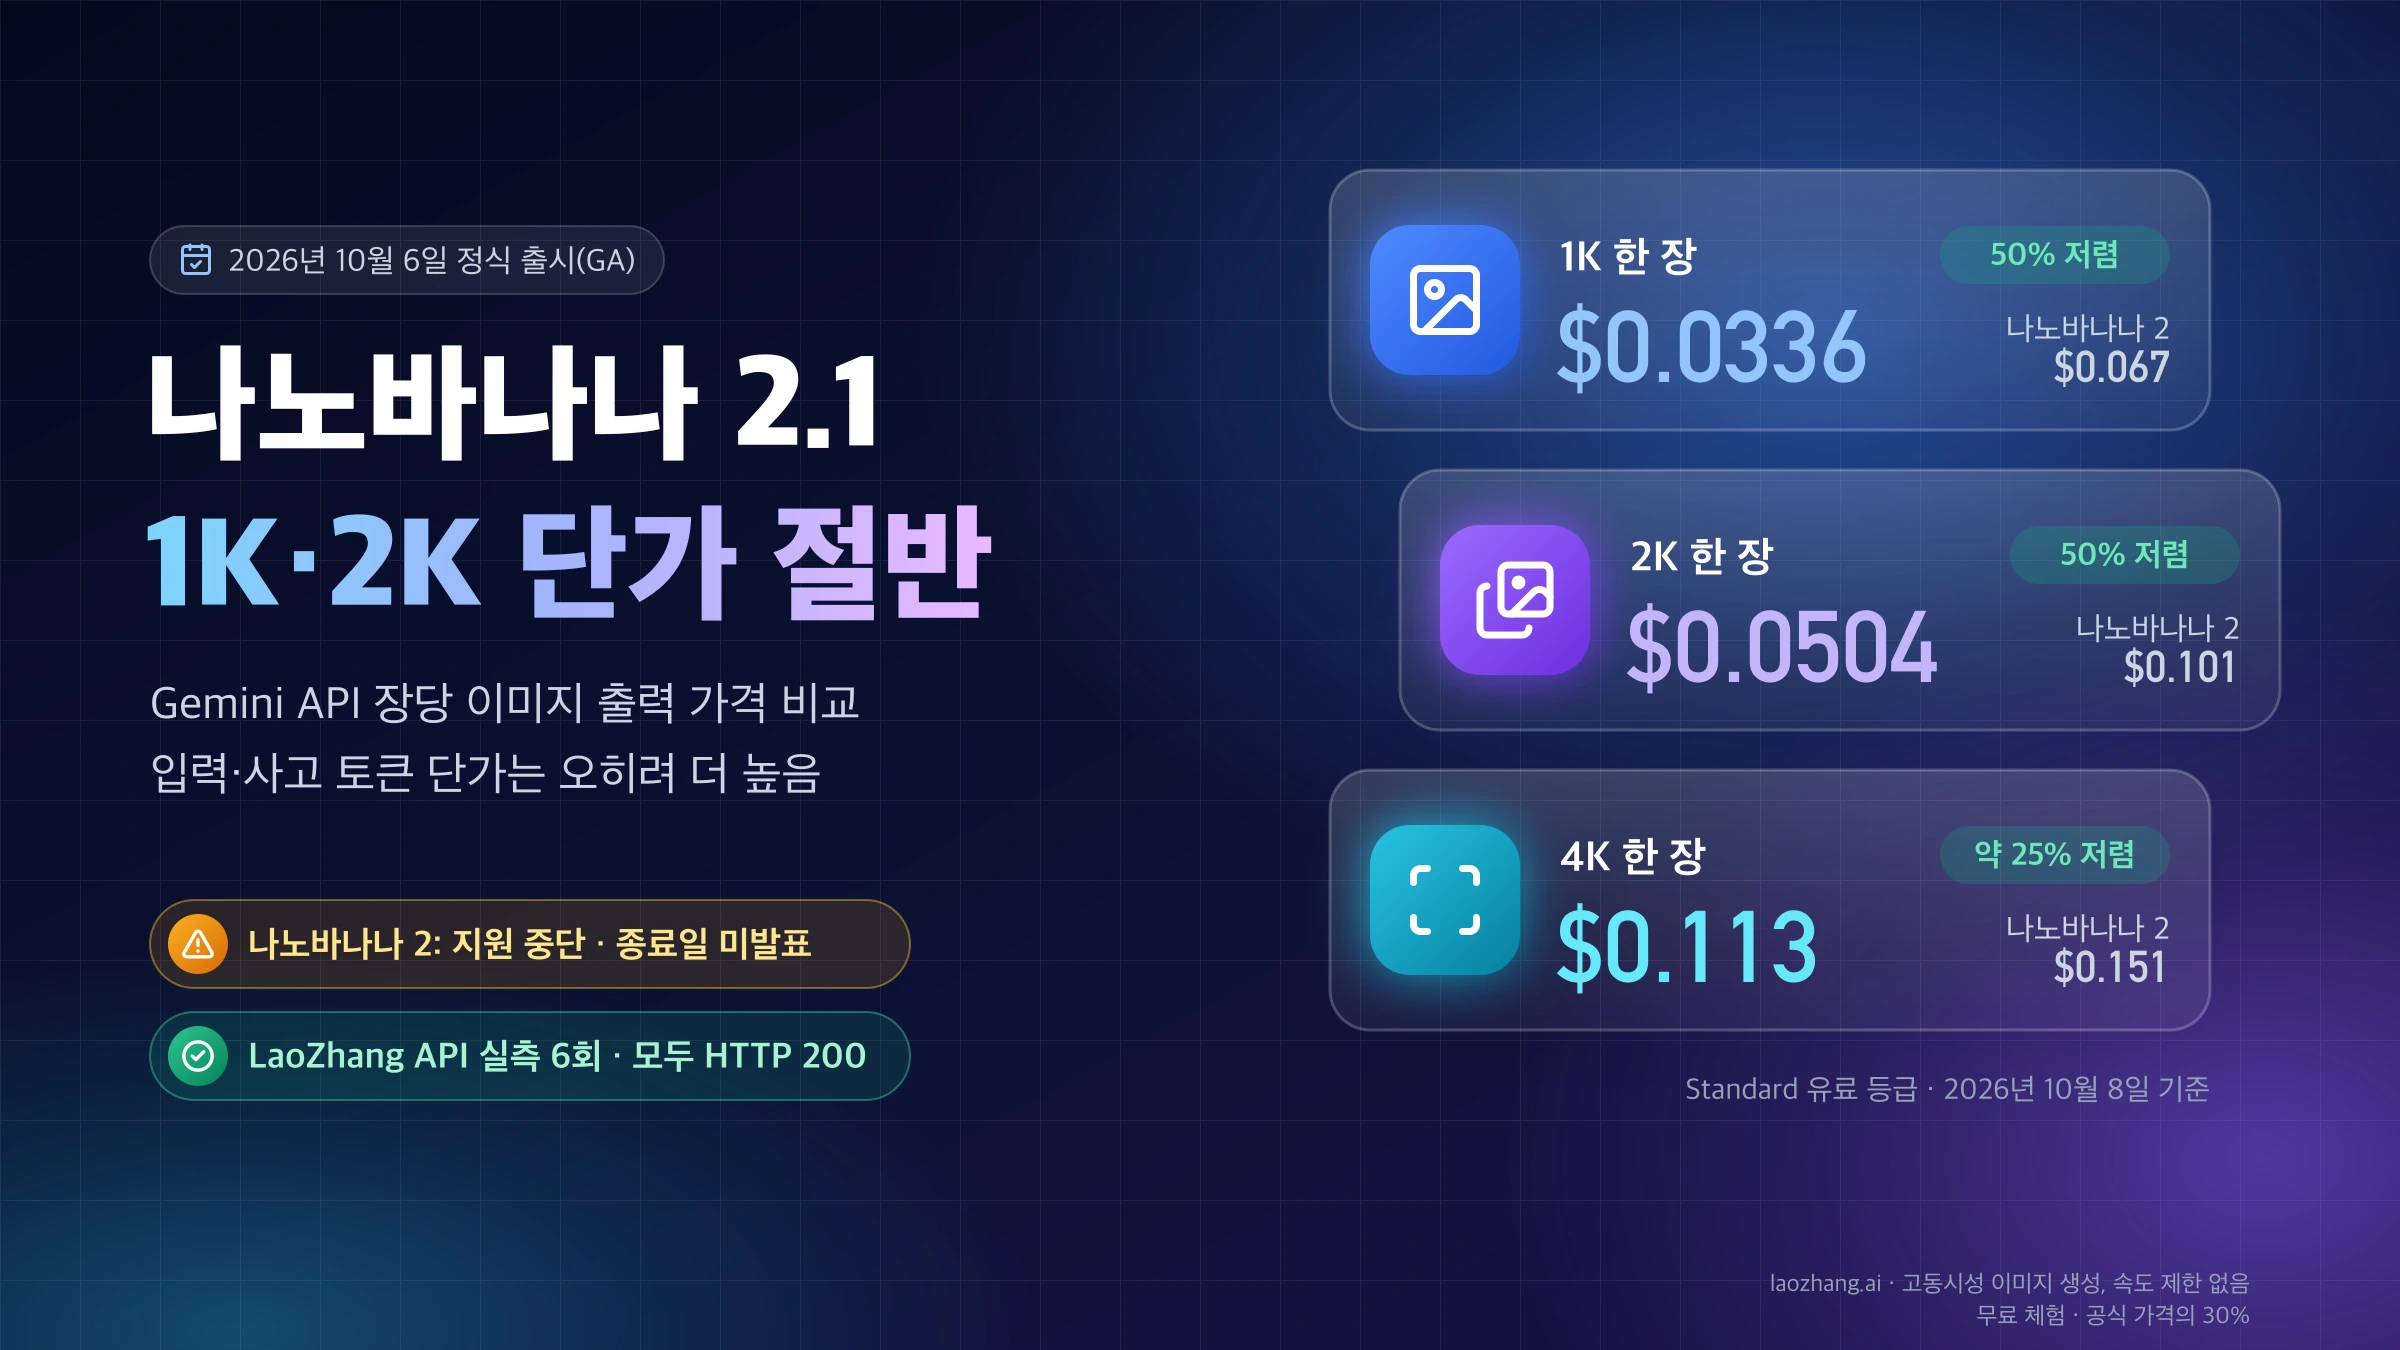
호출 한 번은 15.8~28.2초 걸렸습니다. 레퍼런스 이미지 한 장을 붙이면 입력 토큰이 약 1,080~1,090개 늘었고, 사고 토큰은 10회 중 1회(194개)만 보고됐습니다. LaoZhang 문서는 2.1을 해상도, 사고 수준, 레퍼런스 수와 관계없이 호출당 $0.045로 표시하므로 10회는 정가 기준 $0.45입니다. Google API의 해상도별 단가는 나노바나나 2.1 출시: 가격·사용법, 1K·2K 단가는 나노바나나 2의 절반에 정리돼 있습니다.
방식별 결과: 머리·옷은 남고 오드아이·흉터는 대부분 사라짐
네 방식 모두 은백색 단발과 겨자색 레인코트는 지켰고, 차이는 목도리 색, 단추, 얼굴 표식에서 났습니다. 원본 레퍼런스를 매번 넣은 A는 같은 사람 점수 3~4점, 직전 출력을 넘긴 B는 2~3점이었습니다. 오드아이는 눈을 판단할 수 있었던 다섯 장 가운데 한 장에만 남았고, 흉터가 기준 이미지와 같은 자리에 보인 것은 A의 클로즈업 한 장, 그것도 희미한 정도였습니다.
| 방식 | 머리 | 오드아이 | 별 모양 흉터 | 청록 목도리 | 레인코트·구리 단추 | 같은 사람 점수 |
|---|---|---|---|---|---|---|
| A. 원본 레퍼런스 + 유지 문장 | 3장 모두 은백색 단발, 밤거리 장면엔 연보라 기운 | 판단 가능한 1장(카페 클로즈업)에서 두 눈 모두 짙은 갈색 | 클로즈업에서 희미하거나 불분명, 나머지는 없거나 안 보임 | 클로즈업은 유지, 밤거리·산길은 어두워짐 | 겨자색 유지, 단추는 클로즈업에서만 보였고 구리색 | S1 3·3, S2 4·4, S3 3·3 |
| B. 직전 출력을 레퍼런스로 | 카페 장면에 연보라 기운, 산길은 더 밝고 부스스함 | 카페 장면에서 두 눈 같은 짙은 색(평가자 1명), 산길은 판단 불가 | 카페 장면에 없음 | 두 장 모두 짙은 녹색 | 카페 장면 단추가 회색 금속 | S2 2·2, S3 3·2 |
| C. 텍스트 설명만 | 두 장 모두 유지 | 밤거리 장면은 유지, 산길은 두 눈 같은 색 | 두 장 모두 반대쪽 뺨 | 두 장 모두 유지 | 구리 단추 유지, 산길은 재킷이 짧고 각진 형태 | S1 4·4, S3 4·4 |
| D. 원본 레퍼런스 + 속성 목록 | 밤거리 유지, 산길은 더 짧고 고른 단발 | 밤거리에서 두 눈 같은 색, 산길은 판단 불가 | 밤거리에 없음, 산길은 판단 불가 | 밤거리 유지, 산길은 어둡고 녹색 쪽 | 밤거리 장면 구리 단추 유지 | S1 4, S3 3(평가자 1명) |
점수는 장면별로 평가자 1, 평가자 2 순서입니다. 결과를 읽을 때 가장 먼저 걸리는 한계는 얼굴 크기입니다. 우산을 든 옆모습과 산길 전신 장면에서는 얼굴이 작아, 9장 중 4~5장은 평가자가 눈과 흉터를 아예 판단하지 못했습니다. 그래서 "A가 흉터를 지켰는가"에 대한 근거는 사실상 카페 클로즈업 한 장뿐이고, 목도리가 원경에서 어두워진 것도 역광과 조명 탓이 섞였을 수 있습니다.
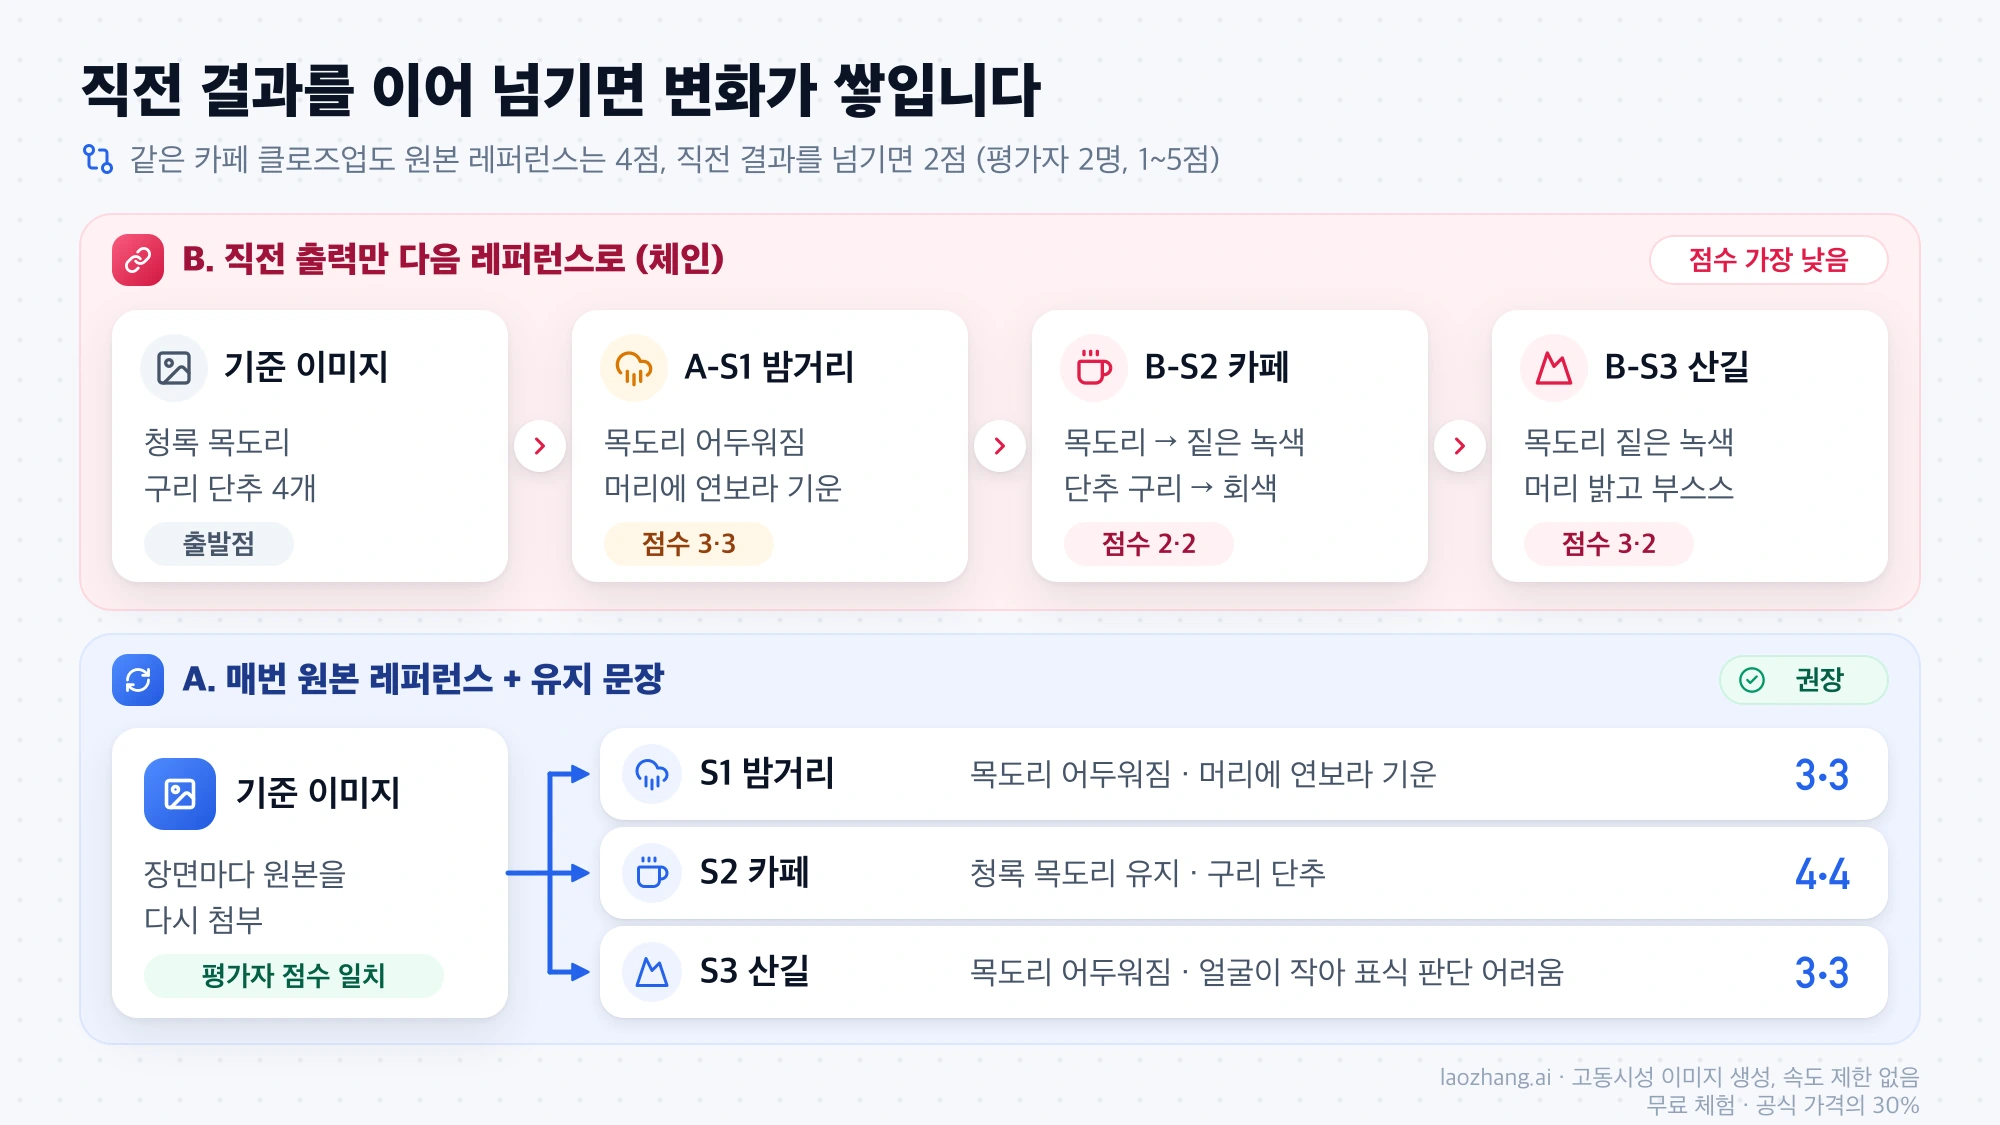
같은 카페 클로즈업이라도 A-S2는 4점, 원본 대신 A-S1 결과를 넘겨 만든 B-S2는 2점이었다는 점은 눈여겨볼 만합니다. 샷 거리가 같아도 레퍼런스가 원본이냐 아니냐에 따라 결과가 갈렸다는 뜻입니다. D는 오드아이와 흉터를 문장으로 하나하나 다시 적었지만 이 두 장에서는 둘 다 돌아오지 않았습니다. 작은 얼굴 표식은 프롬프트에 적는다고 나오는 디테일이 아니었습니다.
글로만 설명해도 같은 사람이 나오나: 점수는 높았지만 조건이 있습니다
이미지 없이 캐릭터 설명 문장만 넣은 C의 두 장은 두 평가자 모두 4점을 줬고, 청록 목도리와 구리 단추도 지켰습니다. 그렇다고 글이 레퍼런스 이미지보다 낫다는 뜻은 아닙니다. 기준 이미지 자체가 바로 그 문장으로 생성되었기 때문에, C에는 모델이 같은 문장을 받으면 늘 그리는 기본 얼굴을 다시 그린 몫이 섞여 있습니다. 실제로 C도 흉터는 두 장 모두 반대쪽 뺨에 그렸고, 오드아이는 두 장 중 한 장에서만 남았습니다.
이 지름길은 캐릭터가 프롬프트에서 태어났을 때만 통합니다. 사진이나 직접 그린 그림에서 온 캐릭터는 생김새를 글로 옮길 수 없어서 레퍼런스 이미지가 사실상 유일한 수단이고, 사진에서 온 캐릭터가 이번 테스트의 캐릭터와 같은 양상을 보이는지는 확인된 바 없습니다. 프롬프트로 만든 캐릭터라면 기준 이미지를 만든 설명 문장을 그대로 저장해 두고, 레퍼런스 이미지와 함께 쓸 수 있는 재료로 남겨 두세요. Astorie의 나노바나나 2.1 캐릭터 일관성 테스트도 이름과 옷 설명은 인물의 "유형"을 정할 뿐 같은 사람을 정하지 못한다고 정리합니다.
직전 결과를 넘길까, 원본으로 돌아갈까: 매번 원본 레퍼런스
장면을 새로 만들 때마다 처음 정한 원본 레퍼런스로 돌아가는 편이 안전합니다. 2026년 11월 3일 실측에서 직전 출력만 다음 레퍼런스로 넘긴 두 장은 같은 사람 점수가 2점과 2점, 3점과 2점으로 가장 낮았고, 목도리는 청록색에서 짙은 녹색으로, 카페 장면의 단추는 구리색에서 회색으로 바뀌었으며 머리에는 연보라 기운이 끼었습니다. 원본을 매번 넣은 A는 3점, 4점, 3점이었고 두 평가자의 점수가 장면마다 일치했습니다.
체인이 약한 이유는 한 장에서 생긴 작은 변화가 다음 장의 정답이 되기 때문입니다. A-S1에서 이미 목도리가 어두워지고 머리에 연보라 기운이 있었는데, 그 이미지를 레퍼런스로 받은 B-S2는 그 변화를 이어받은 채 더 멀어졌습니다. Astorie의 사례 연구도 체인 편집이 우연한 변화를 다음 장으로 넘긴다고 보고, 카메라 거리가 바뀌면 원본 레퍼런스로 돌아가라고 권합니다.
Google의 제미나이 API 이미지 생성 문서는 한 캐릭터의 360도 뷰를 만들 때 이전에 생성한 이미지를 다음 프롬프트에 포함하라고 하고, 이미지를 반복 수정하는 데는 멀티턴 대화를 권장합니다. 이 조언은 같은 캐릭터를 각도만 바꿔 가며 쌓는 경우를 다루고, 이번 B는 원본을 빼고 직전 결과 한 장만 넘긴 경우였습니다. 이전 결과를 함께 넣고 싶다면 원본 레퍼런스는 빼지 말고 늘 첫 번째로 포함하세요. 원본과 이전 결과를 함께 넣는 조합은 이번 10회에 들어 있지 않습니다. 또 Google의 2.1 예시는 Interactions API(client.interactions.create) 기준이라 이번에 쓴 generateContent와 요청 형식이 다릅니다. generateContent로 멀티턴 편집을 하다 두 번째 턴에서 400이 난다면 Nano Banana 2 Thought Signature 오류: 이미지 편집 두 번째 턴 400 해결을 보세요.
같은 캐릭터를 반복하는 레퍼런스·프롬프트 구성 순서
캐릭터를 설계하는 단계부터 원경에서도 보이는 특징에 정체성을 싣고, 기준 이미지 한 장을 정한 뒤 매 호출에 그 원본과 짧은 유지 문장을 함께 보냅니다. 순서는 다음과 같습니다.
- 캐릭터를 알아보게 할 단서를 머리 모양과 색, 옷의 주색, 늘 지니는 소품처럼 전신 컷에서도 보이는 곳에 둡니다. 오드아이, 작은 흉터, 주근깨 같은 얼굴 표식은 클로즈업에서만 확인되고 이번 실측에서 거의 돌아오지 않았으므로, 캐릭터를 구별하는 유일한 단서로 삼지 않습니다.
- 정면, 상반신, 단색 배경, 고른 조명으로 얼굴이 크게 보이는 기준 이미지를 한 장 만들거나 고릅니다. 사진이나 그림에서 온 캐릭터라면 원본 중에서 이런 컷을 고르고, 프롬프트로 만든 캐릭터라면 기준 이미지를 만든 설명 문장도 함께 저장합니다.
- 새 장면마다 기준 이미지 원본, 유지 문장, 장면 문장을 한 요청에 넣습니다. 직전 결과만 레퍼런스로 넘기지 않습니다.
- 장면 문장에는 카메라 거리와 각도를 적습니다. 얼굴 표식을 보여야 하는 컷은 클로즈업으로 따로 만들고, 복잡한 자세가 필요하면 Google 문서의 권장대로 그 자세의 레퍼런스 이미지를 추가합니다.
- 모델 ID, 해상도, 화면비, 사고 수준, 사용한 레퍼런스를 결과 이미지와 함께 기록해 두면 어느 조건에서 달라졌는지 나중에 되짚을 수 있습니다.
generateContent로 원본 레퍼런스를 붙이는 요청 본문은 이번 테스트에서 아래 형태였습니다. 이미지는 base64로 넣었고, 큰 파일은 LaoZhang 문서가 안내하는 대로 fileData URL로 넘길 수 있습니다(요청 본문 20MB 미만).
{
  "contents": [{
    "parts": [
      { "text": "Use the person in the reference image as the character. Keep her face, hair, eye colours, scar, jacket and scarf identical to the reference. Close-up, head and shoulders, laughing in a warm cafe with a blurred background." },
      { "inlineData": { "mimeType": "image/jpeg", "data": "<기준 이미지 base64>" } }
    ]
  }],
  "generationConfig": {
    "responseModalities": ["IMAGE"],
    "imageConfig": { "imageSize": "1K", "aspectRatio": "4:3" }
  }
}
장면 문장을 쓰는 방법 자체는 Nano Banana 프롬프트 작성법: 실전 가이드와 검증용 템플릿 50개를 참고하면 됩니다. 응답이 HTTP 200인데 이미지가 없다면 LaoZhang에서는 그 호출도 과금되므로, 원인은 Nano Banana API 이미지 안 나옴: 응답별 원인과 조치에서 응답 형태별로 확인하세요.
이미지마다 확인할 것과 재생성을 멈추는 기준
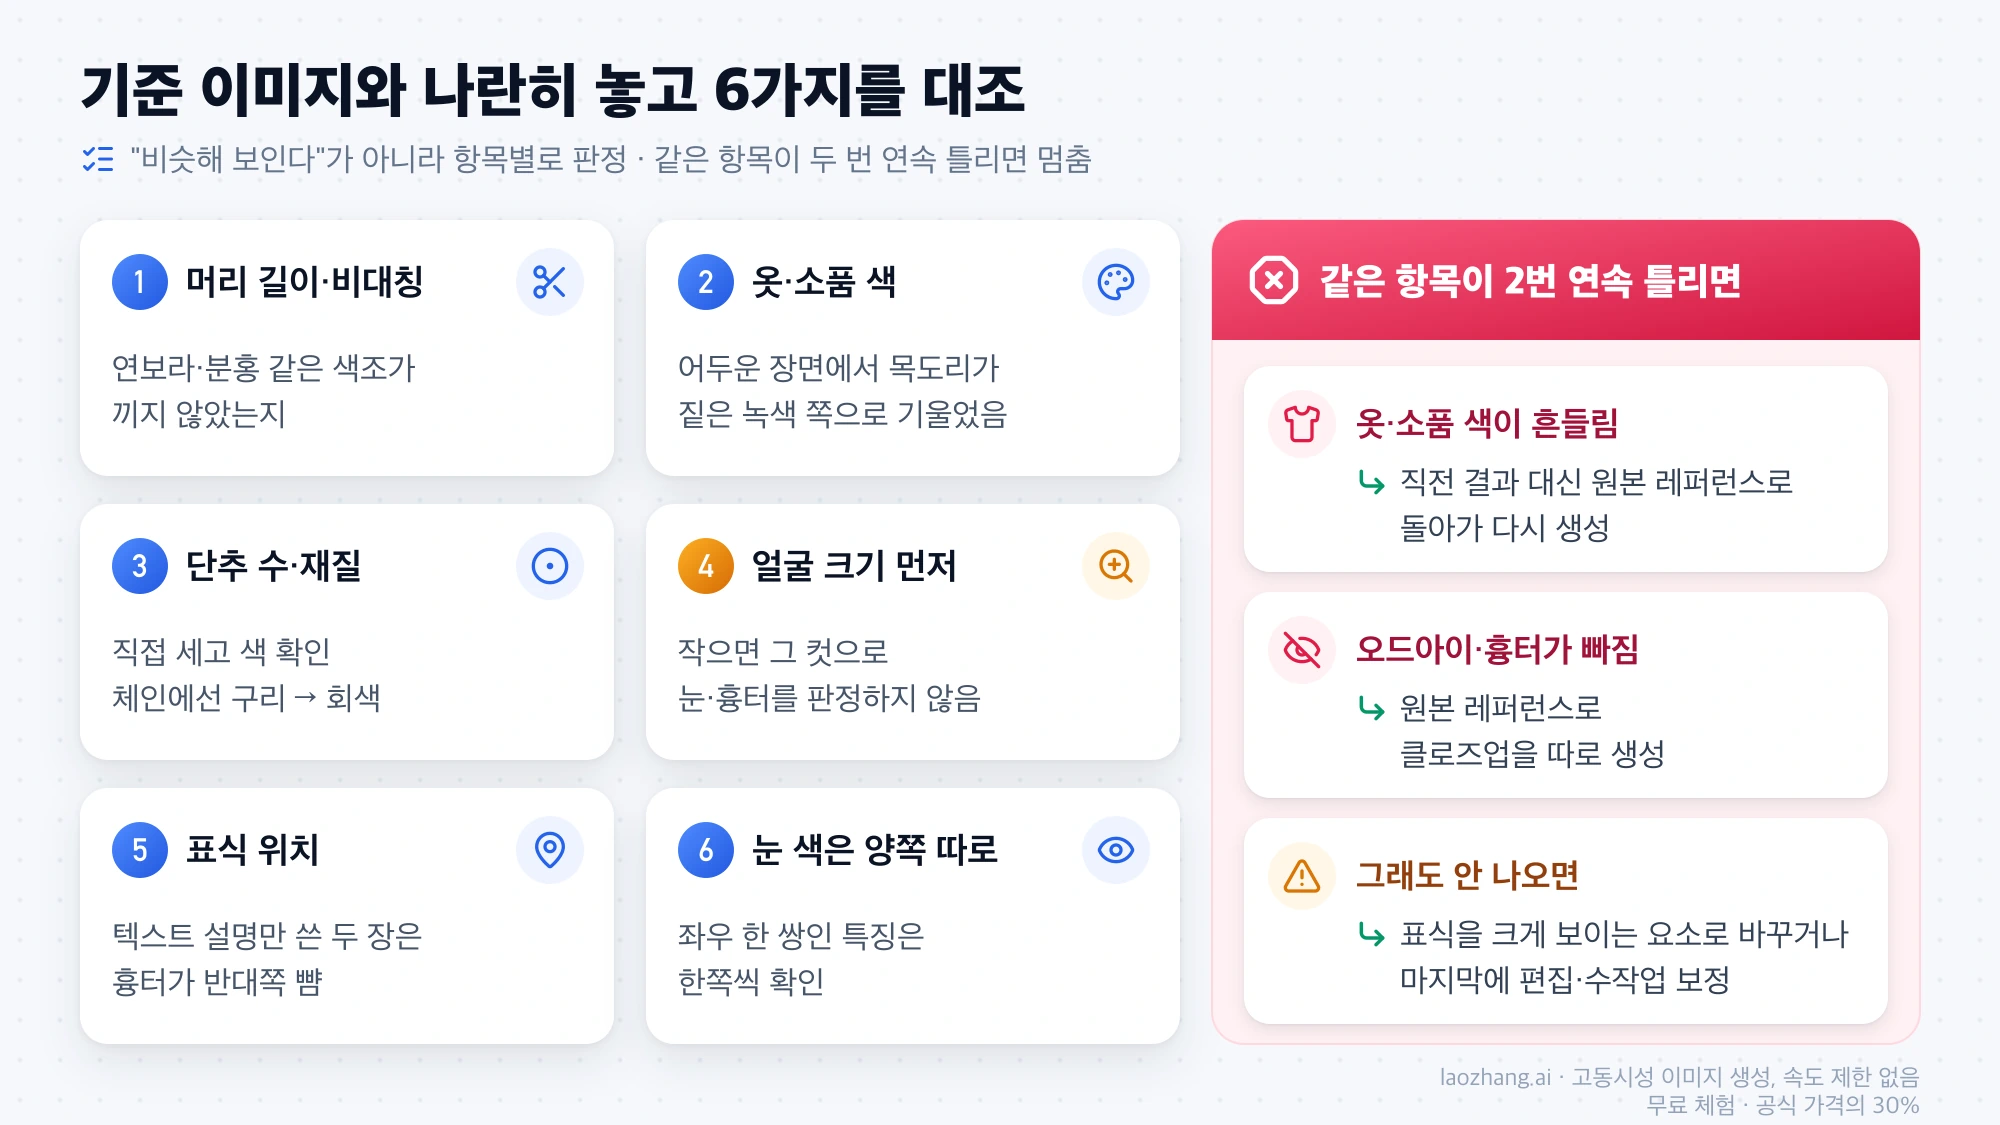
생성된 이미지는 "비슷해 보인다"가 아니라 기준 이미지와 나란히 놓고 항목별로 대조해서 판정합니다. 이번 실측에서 실제로 달라진 곳을 기준으로 하면 확인할 항목은 아래와 같습니다.
- 머리 길이와 비대칭이 그대로인지, 연보라나 분홍 같은 색조가 끼지 않았는지 봅니다.
- 옷과 소품의 색을 기준 이미지와 비교합니다. 밤거리와 역광 산길처럼 조명이 어두운 장면에서 목도리가 짙은 녹색 쪽으로 기울었습니다.
- 단추처럼 수와 재질이 정해진 디테일은 직접 세어 보고 색을 확인합니다. 체인 방식에서는 구리 단추가 회색으로 바뀌었습니다.
- 얼굴이 표식을 판단할 만큼 큰지부터 봅니다. 작다면 그 컷으로 눈이나 흉터를 판정하지 않습니다.
- 표식이 보이면 위치까지 대조합니다. 텍스트 설명만 쓴 두 장은 흉터를 반대쪽 뺨에 그렸습니다.
- 눈 색처럼 좌우 한 쌍인 특징은 양쪽을 따로 확인합니다.
같은 방식으로 다시 생성했는데 같은 항목이 두 번 연속 틀리면 그 방식으로는 더 돌리지 않습니다. 옷이나 소품 색처럼 큰 특징이 흔들린다면 직전 결과 대신 원본 레퍼런스로 돌아가 다시 만들고, 오드아이나 흉터 같은 작은 표식이 빠진다면 원본 레퍼런스로 클로즈업을 따로 만들어 봅니다. 그래도 나오지 않으면 생성 단계에서 기대하지 말고 표식을 더 크게 보이는 요소로 바꾸거나, 마지막에 별도 편집이나 수작업 보정으로 넣는 쪽으로 계획을 바꾸세요. 몇 번 재생성하면 표식이 돌아오는지, 2K·4K 출력이나 high 사고 수준이 작은 표식을 더 잘 지키는지는 이번 10회의 범위 밖입니다.
레퍼런스 한도와 프로 비교: 2.1은 캐릭터 4명, 프로는 5명
Google 제미나이 API 이미지 생성 문서 기준으로 나노바나나 2.1은 한 요청에 레퍼런스 이미지를 최대 14장까지 섞을 수 있고, 그중 캐릭터 이미지는 최대 4장(한 작업에서 캐릭터 4명까지 닮게 유지), 높은 충실도로 유지하는 오브젝트 이미지는 최대 10장입니다. 나노바나나 2(gemini-3.1-flash-image)도 같은 한도이고, 나노바나나 프로(gemini-3-pro-image)는 캐릭터 5장, 오브젝트 6장, 스타일 레퍼런스 3장입니다. 이 숫자는 한 요청에서 쓸 수 있는 작업 한도이지 같은 얼굴을 보장한다는 뜻은 아닙니다.
일관성 자체를 2.1과 프로 중 어느 쪽이 낫느냐는 질문에는 Google의 자체 평가만 있습니다. Google 딥마인드의 나노바나나 2.1 모델 카드(2026년 10월 기준)에서 단일 캐릭터 일관성 Elo는 2.1 사고 1028±14, 2.1 비사고 1021±14, 나노바나나 2 981±10, 프로 991±9이고, 다중 캐릭터 일관성은 1106, 1068, 978, 1011입니다. 단일 캐릭터 쪽 차이는 오차 범위에 비해 크지 않고, 같은 모델 카드도 한계로 "Character consistency is not always perfect between input images and generated output image"라고 적고 있습니다. 같은 프롬프트로 세 모델을 나란히 돌린 결과는 나노바나나 2.1 vs 프로 vs GPT Image 2.5 차이: 같은 프롬프트 9건 실측에서 볼 수 있습니다.
참고 자료3
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 3일.
참고 자료3
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 3일.