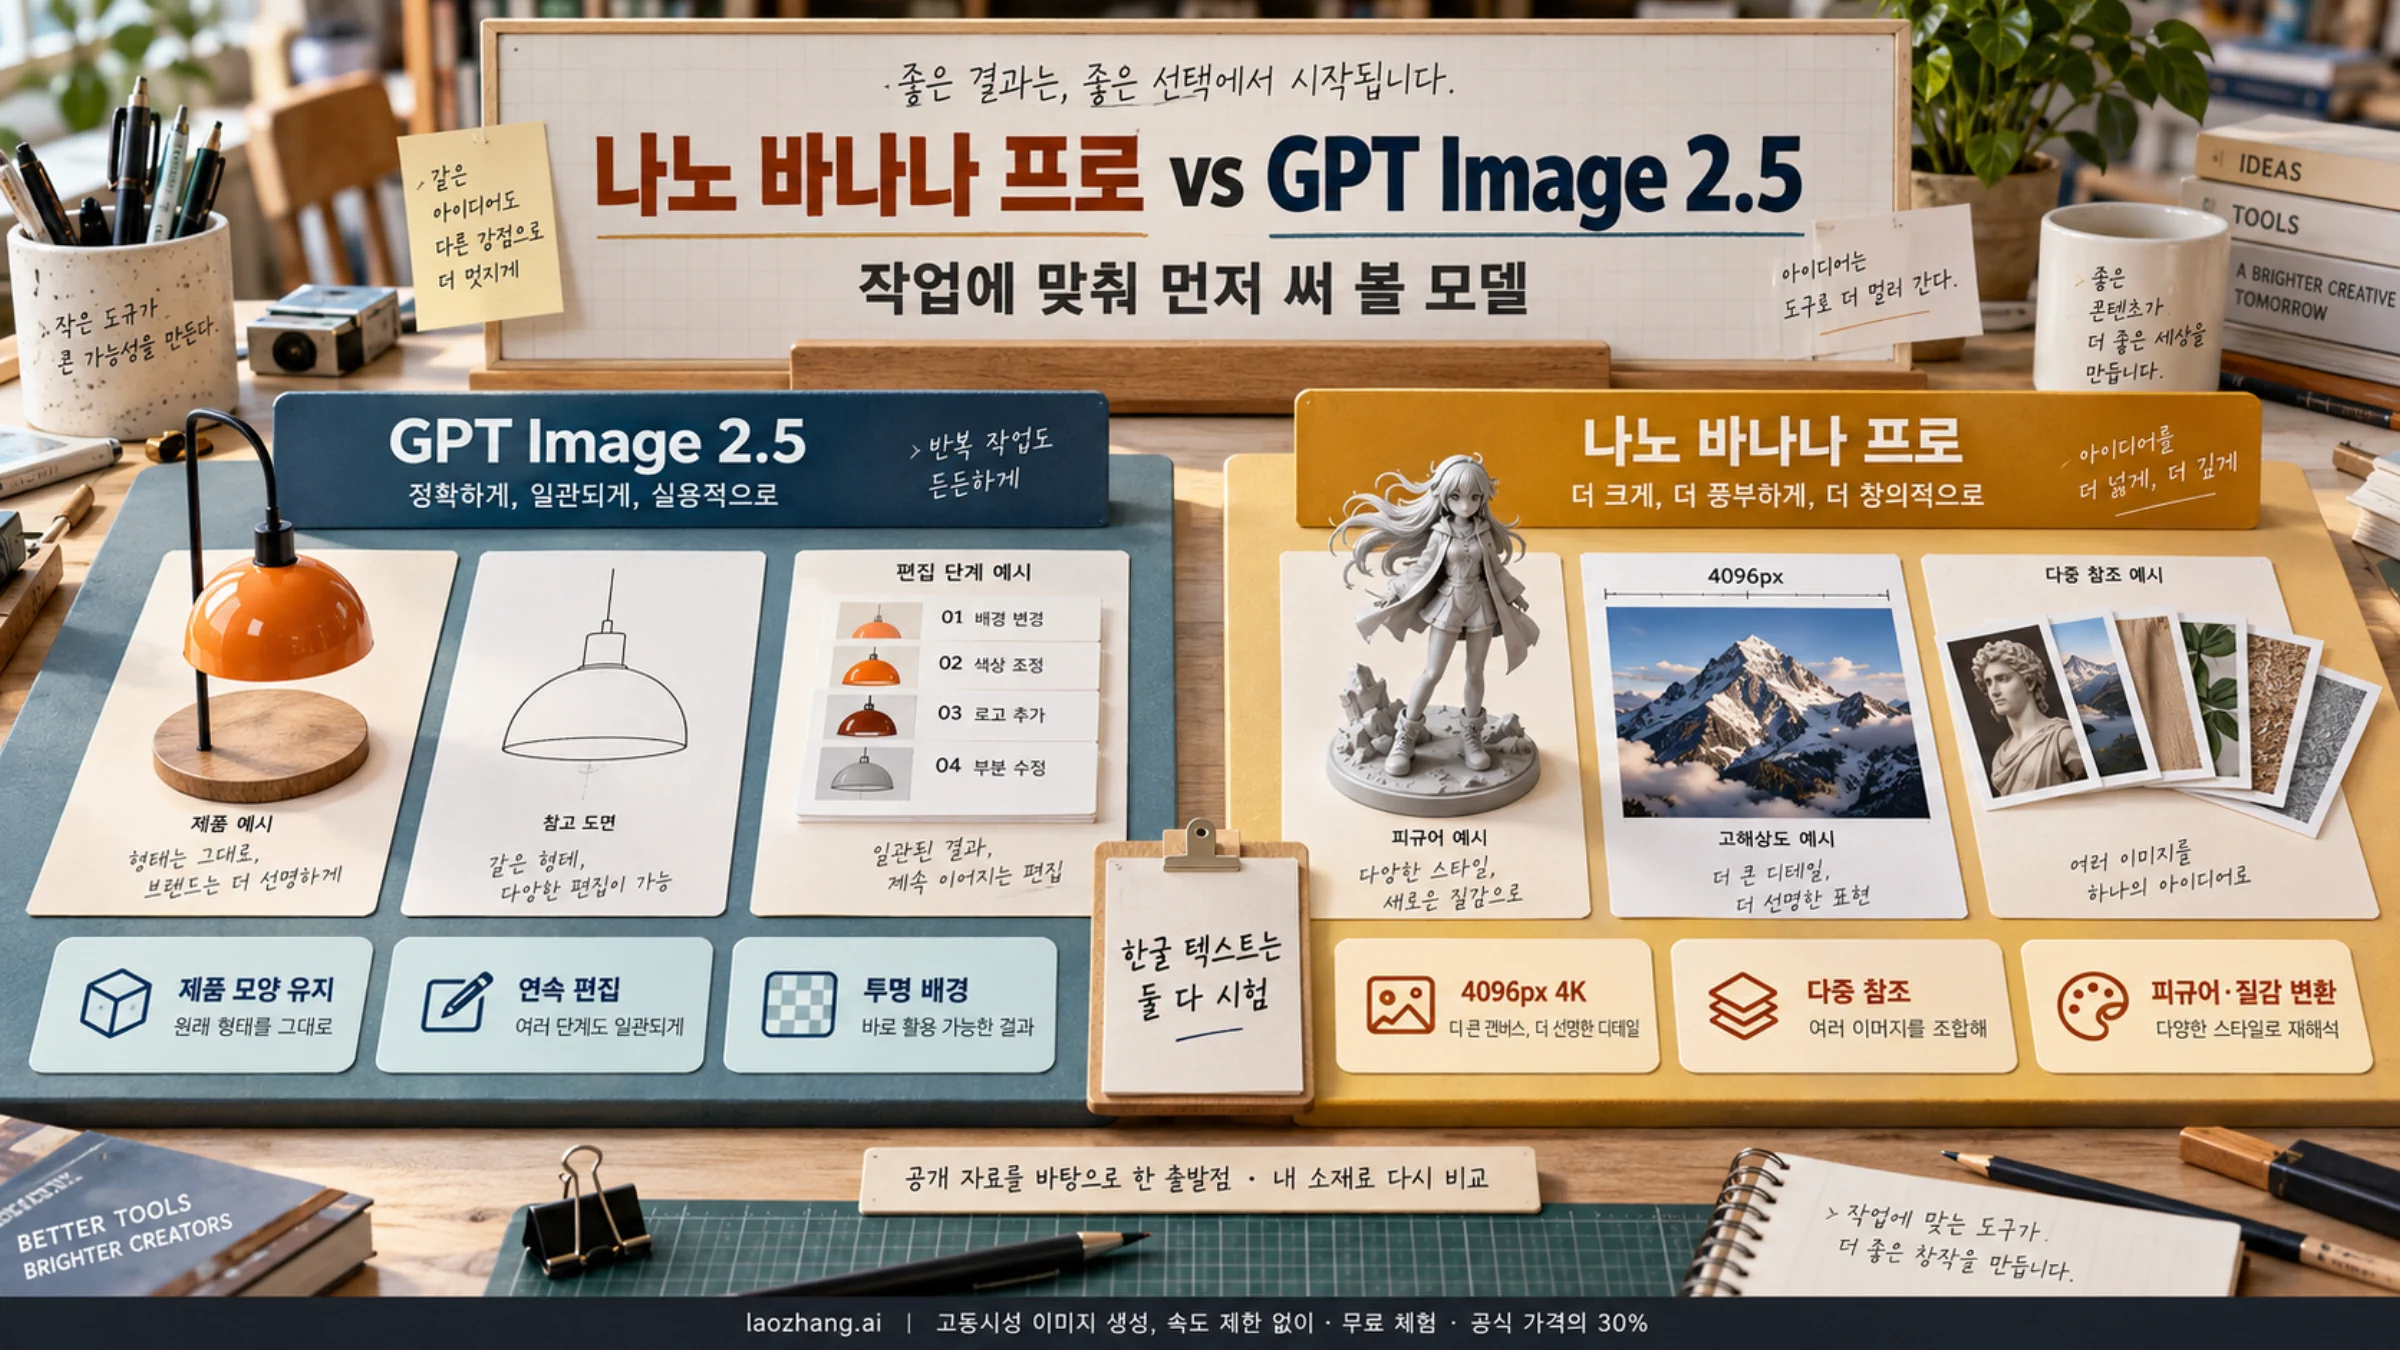
GPT Image 2.5와 나노 바나나 프로 사이에 "항상 이기는 쪽"은 없습니다. 지금까지 공개된 비교 테스트를 조건과 함께 읽으면, 제품 모양을 그대로 두는 편집과 여러 번 이어지는 연속 편집은 GPT Image 2.5(특히 Sunburst)가 먼저이고, 4096px 4K 납품과 5장 이상의 참조 이미지, 피규어처럼 질감을 새로 입히는 스타일화는 나노 바나나 프로가 먼저입니다. 비용은 동일 크기로 맞추면 1024×1024 한 장 출력에 2.5 high가 약 $0.053, 나노 바나나 프로 1K가 $0.134이며, 프로는 2.5의 xhigh($0.094)와 max($0.211) 사이에 놓입니다. 이 판단은 이 사이트의 자체 테스트가 아니라 두 회사의 문서와 가격표, 블라인드 투표 순위 두 곳, 국내외 비교 테스트 여섯 건(2026년 9월 22일 확인)에 근거하며, 각 결과에 출처와 조건을 함께 적었습니다.
비교는 API 모델 ID 기준으로 하고, 가격은 같은 픽셀 크기로 맞추며, 순위는 투표 수와 함께 읽어야 합니다. 앱에서 한 번씩 돌려본 비교나 나노 바나나 2를 대상으로 한 비교와는 대상과 조건이 다르므로, 다른 글의 결론을 옮겨 올 때는 그 점을 먼저 확인해야 합니다.
비교 대상부터 정확히: 2.5는 두 개, 나노 바나나는 네 개
이름이 겹쳐서 생기는 혼동을 먼저 풀어야 가격표와 테스트 결과를 제대로 읽을 수 있습니다.
GPT Image 2.5는 API 모델 두 개와 ChatGPT 기능 하나를 합쳐 부르는 이름입니다. API에서는 gpt-image-2.5-flare(스냅샷 gpt-image-2.5-flare-2026-09-08)와 gpt-image-2.5-sunburst(gpt-image-2.5-sunburst-2026-09-08) 두 ID만 존재하고, 접미사 없는 gpt-image-2.5는 모델 ID가 아닙니다. OpenAI 문서는 Flare를 "속도에 최적화된 작은 모델", Sunburst를 "품질에 최적화된 기본 모델"로 설명하며, 두 모델 모두 "정밀 편집과 피사체 보존이 개선됐다"고 적습니다. ChatGPT 안에서 쓰는 것은 Images 2.5라는 기능이며 어느 API 모델이 뒤에서 도는지 사용자가 고를 수 없습니다. OpenAI 모델 페이지: Sunburst, Flare, ChatGPT Images 2.5 소개
OpenAI의 표현에는 스스로 어긋나는 부분이 하나 있습니다. 프롬프트 가이드는 Flare의 화질이 "GPT Image 2와 비슷하다(comparable)"고 쓰고, 출시 글은 Flare가 "GPT Image 2보다 높은 화질을 50% 낮은 지연으로" 낸다고 씁니다. 두 문장 모두 OpenAI 쪽의 홍보 문구이고, 50%라는 수치는 GPT Image 2 대비이지 Google 모델 대비가 아닙니다. Flare와 Sunburst 사이의 선택 자체는 GPT Image 2.5 Sunburst vs Flare에서 따로 다룹니다.
나노 바나나는 Google 이미지 모델 네 개의 별칭입니다. 이 글의 대상인 나노 바나나 프로는 gemini-3-pro-image이며 GA(안정) 상태이고, 모델 페이지의 최신 업데이트 표기는 2025년 11월입니다. 그 아래로 나노 바나나 2(gemini-3.1-flash-image), 나노 바나나 2 Lite(gemini-3.1-flash-lite-image), 그리고 2026년 10월 2일 종료 예정인 원조 나노 바나나(gemini-2.5-flash-image)가 있습니다. Google의 안내는 나노 바나나 2를 "성능·지능 대비 비용과 지연의 균형이 가장 좋은 기본 선택"으로, 프로를 "가장 복잡한 시각 작업을 위한 프리미엄 선택"으로 나눕니다. Google 모델 페이지, Google 이미지 생성 가이드
"나노 바나나 2.5"라는 이름으로 소개되는 모델은 제품이 아닙니다. Google의 가격표, 모델 목록, 이미지 생성 가이드 어디에도 없고, 이를 다룬 Kie.ai 글조차 "Image Arena에서 'spicy-mayo'라는 이름으로 목격된 미확인 모델이며 공식 발표, 벤치마크, 가격, 출시일, API 사양이 없다"고 밝힙니다. 이 글은 그 이름을 비교 대상으로 삼지 않습니다. Google 가격표, Kie.ai 설명
작업별로 먼저 써 볼 모델: 공개된 근거로 말할 수 있는 범위
아래 표는 공개된 테스트가 실제로 다룬 작업에 한해서만 먼저 써 볼 모델을 적었습니다. 같은 소재로 먼저 돌려볼 쪽이라는 뜻이지, 다른 쪽을 배제한다는 뜻이 아닙니다. 각 행의 근거는 해당 저자의 관찰이고 시도 횟수가 매우 적으므로, 이 표는 자기 소재로 검증하기 전의 출발점으로만 쓰세요.
| 작업 유형 | 먼저 돌려볼 모델 | 근거와 조건 |
|---|---|---|
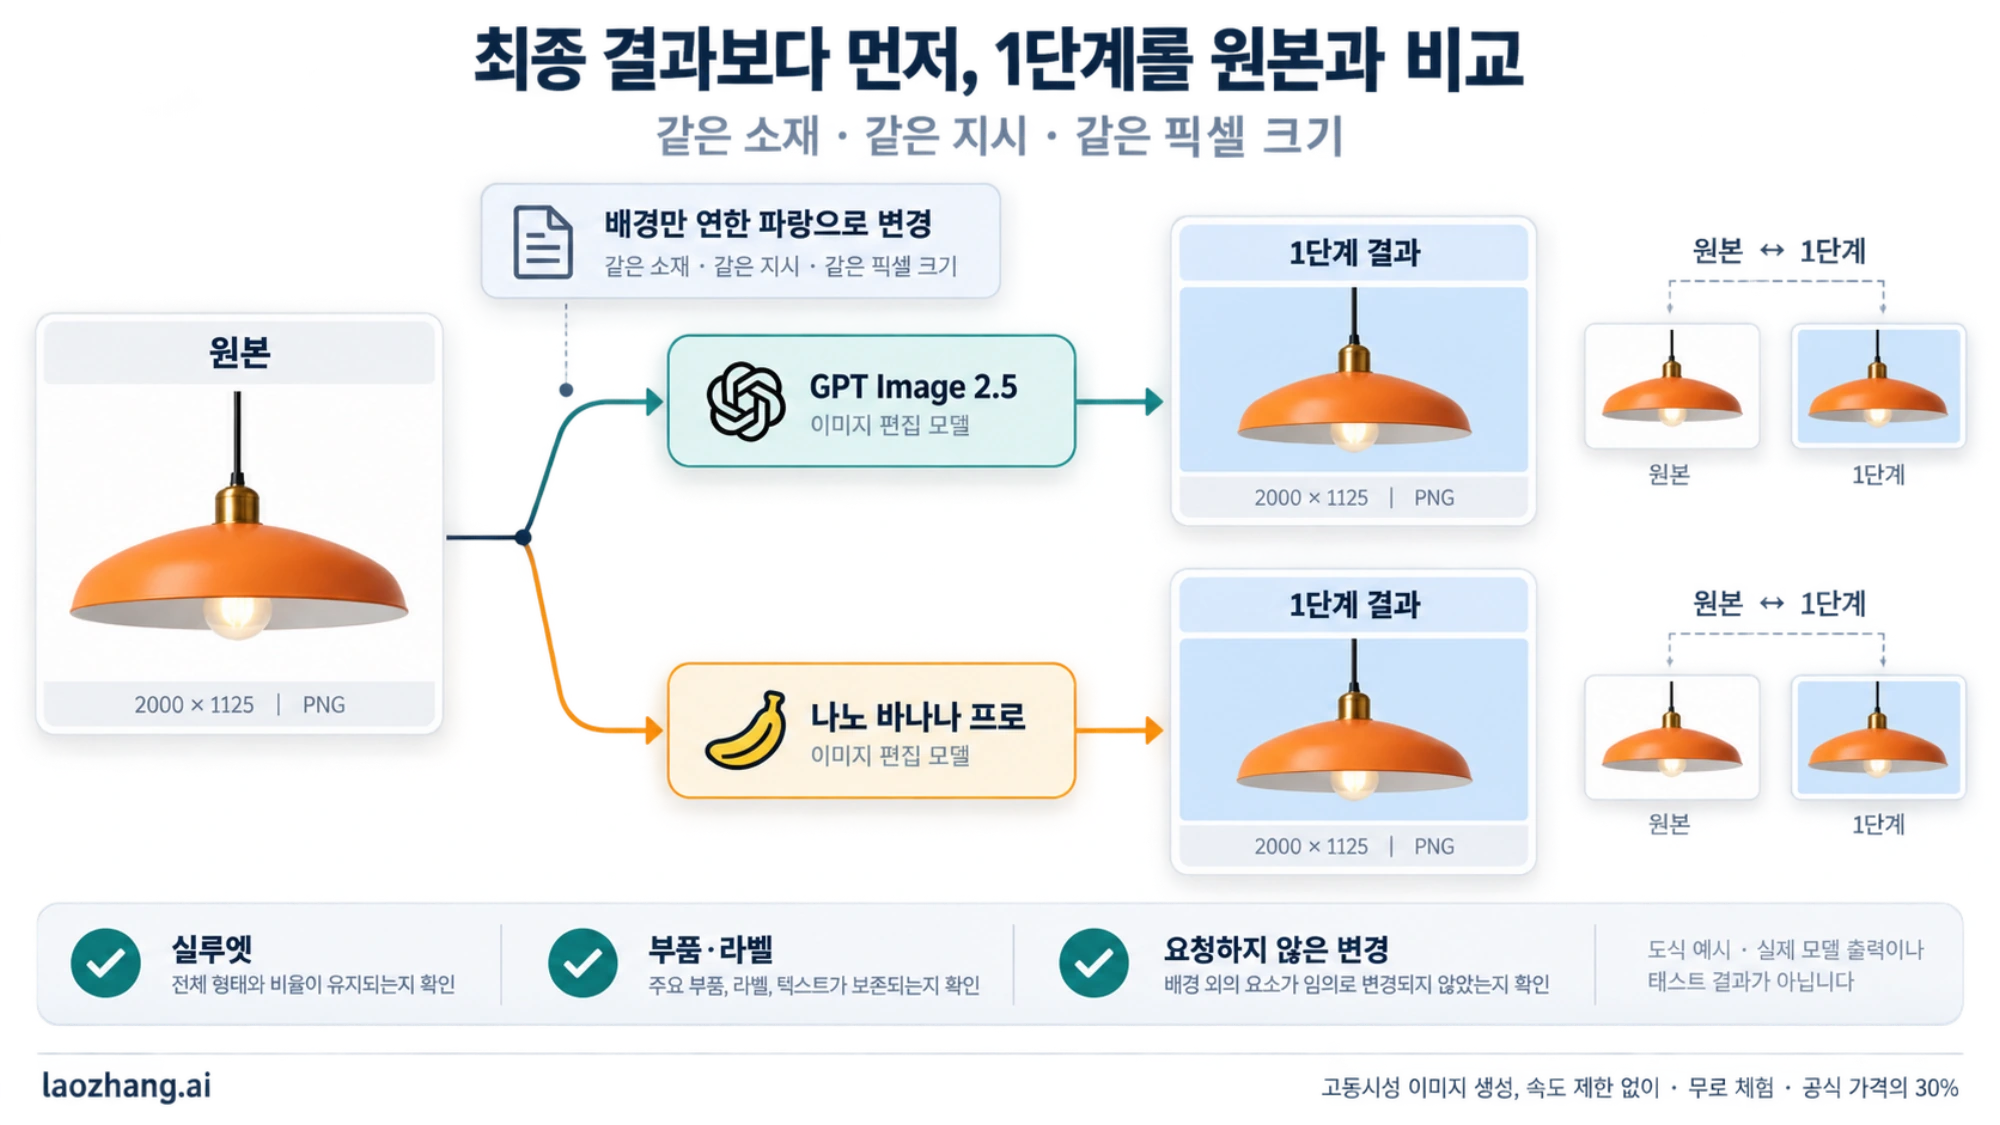
| 제품 모양을 그대로 두는 편집(실루엣·하드웨어·반복 레이아웃) | GPT Image 2.5 Sunburst | Ima Studio(9월 11~14일): 펜던트 조명 1개, 모델당 3체인×5단계 30장, Sunburst 1024² high vs 프로 1:1 1K. Sunburst는 얕고 넓은 갓을 3/3 유지, 프로는 3/3 모두 둥근 돔으로 바꿨고 그 변형이 후속 단계까지 이어짐 |
| 연속 편집(앞 단계 결과를 유지하며 5회 이상 수정) | GPT Image 2.5 | 다나와 DPG(9월 17일, 앱, 각 1회): 5회차 연속 편집에서 프로는 "지웠던 캐리어가 다시 나타났"고 Images 2.5는 이전 수정을 유지. Ima Studio에서 형태 변형이 후속 단계까지 이어진 관찰과 같은 방향 |
| 한글 텍스트 포스터·카드뉴스 | 어느 쪽도 우위 없음, 둘 다 시도 | 다나와: 한글 광고 포스터에서 양쪽 모두 오탈자 없음. 2.5는 요청하지 않은 이펙트를 더했고 프로는 "심심하다는 인상". 1회 시도이므로 우위 판단 불가. 일본어에서는 HSビル(9월 9일)이 프로의 글자 깨짐을 보고했으나 한글로 일반화할 수 없음 |
| 영문 텍스트(간판·라벨·헤드라인) | 동점 | JXP(9월 15일, Flare medium, 각 1회): 카페 간판·화장품 라벨 동점. Ima Studio: 양쪽 철자 정확, Sunburst 여백이 더 안전. HiAPI(9월 17일, 2장): 프로가 "SHIFT"를 한 번 더 넣음 |
| 다중 참조 인물 일관성 | 4장 이하는 둘 다, 5장 이상(객체 6장이나 인물 5장+스타일 3장 조합 등)은 프로 | 사양 차이(아래 절). OpenAI 문서는 참조 4장 예시만 있고 상한을 적지 않았으며, Google은 14장 조합의 상한을 문서화함. 다나와의 3인 합성은 2.5가 한 장의 애니메이션 그림으로 통일, 프로는 "미국 코믹스 느낌"에 원본에 없던 요소 추가(1회) |
| 4K 납품(정사각 4096px) | 나노 바나나 프로 | 사양 차이: OpenAI는 한 변 3840px, 정사각 최대 2880². JXP의 4K 매크로에서 프로 4096², 2.5 2880² |
| 스타일화·피규어 변환(질감을 새로 입히는 작업) | 나노 바나나 프로 | note てんねん(9월 11일, 6개 모델×4회 생성, 최고 1장 선정, 6항목 30점): 프로 30점, 2.5 24점. 2.5는 "원본 구도·얼굴·체형·장갑 정보를 높은 정밀도로 유지"했으나 "셀 셰이딩 3DCG처럼 보임". 2.5 전용 프롬프트로도 24점 |
이 표에서 눈여겨볼 것은 방향이 갈리는 지점입니다. Ima Studio와 다나와는 원본을 얼마나 그대로 두는가를 봤고, 그 기준에서는 2.5가 앞섰습니다. note의 피규어 테스트는 원본을 얼마나 다른 재질로 다시 만드는가를 봤고, 그 기준에서는 프로가 만점이었습니다. 같은 "정밀도"라는 말이 작업에 따라 반대 결과를 낳으므로, 자기 작업이 "유지"에 가까운지 "변환"에 가까운지에 따라 어느 쪽을 먼저 쓸지가 정해집니다. 출처: Ima Studio 한국어판, 다나와 DPG 비교 테스트, JXP, HiAPI, note てんねん, HSビルワーキングスペース
다나와 필자의 총평은 두 모델의 성격을 짧게 잡아줍니다. 2.5는 "요청하지 않은 문구나 이펙트까지 더해 퀄리티를 높여 완성하는 쪽", 프로는 "지시한 범위 안에서 깔끔하게 정리하는 쪽"이라는 것입니다. 다만 이 관찰은 ChatGPT Plus와 Gemini 앱에서 각 한 번씩 돌린 결과이고, API에서는 품질 설정과 참조 이미지 처리 방식이 달라 같은 성향이 그대로 나타난다고 보장할 수 없습니다. HiAPI 저자도 자기 글에 대해 "네 장으로 평균 화질, 속도, 일관성, 성공 확률을 추정할 수 없다"고 못 박았는데, 이 글의 표 전체에 같은 단서가 붙습니다.
사양이 답을 정하는 경우
테스트 결과와 달리 문서에 적힌 사양은 조건 없이 적용됩니다. 다음 항목 중 하나라도 작업에 필요하면 그 항목이 모델을 결정합니다.
| 항목 | GPT Image 2.5 (Flare·Sunburst) | 나노 바나나 프로 (gemini-3-pro-image) |
|---|---|---|
| 크기 지정 | 임의 WIDTHxHEIGHT(16의 배수, 비율 1:3 | image_size 1K/2K/4K(4K = 4096px), 비율 10종(1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) |
| 품질 단계 | low/medium/high/xhigh/max/auto | 크기 단계로만 구분, 별도 품질 라벨 없음 |
| 참조 이미지 | image[]로 여러 장(가이드 예시 4장). 문서에 최대 장수 없음 | 최대 14장 혼합: 고충실도 객체 6장 + 인물 일관성 5장 + 스타일 참조 3장 |
| 투명 배경 | background: "transparent" + PNG/WebP 출력 | 문서에 기재 없음 |
| 연속 편집 | Responses의 previous_response_id 또는 이전 출력을 다음 편집 입력으로 전달 | previous_interaction_id |
| 사고(thinking) | 해당 없음 | 기본 활성화, API에서 비활성화 불가. 구도 확인용 중간 이미지 최대 2장 생성(과금 없음) |
| 웹 정보 반영 | 문서에 기재 없음 | Google 검색 그라운딩 지원 |
| Batch(반값) | 2.5 두 모델 모두 v1/batch 미지원(2026년 9월 22일 기준). gpt-image-2만 Batch 요금표에 있음 | Batch API 지원, 출력 반값 |
| 수명 주기 | gpt-image-2와 2.5 두 모델 모두 지원 중단 목록에 없음 | GA(안정), 모델 페이지 최신 업데이트 표기 2025년 11월 |
출처: OpenAI 이미지 생성 가이드, OpenAI 이미지 프롬프트 가이드, OpenAI 가격표, OpenAI 지원 중단 목록, Google 이미지 생성 가이드
여기서 실무에 바로 걸리는 항목은 네 가지입니다. 첫째, 인쇄나 대형 디스플레이용으로 4096×4096이 필요하면 OpenAI로는 만들 수 없으므로 프로가 유일한 선택입니다. 둘째, 캐릭터 참조 5장에 스타일 참조 3장을 얹어 한 번에 넣는 워크플로우는 Google 문서만 상한을 보장합니다. OpenAI는 상한을 적지 않았을 뿐 불가능하다는 뜻은 아니지만, 예산과 품질을 미리 계산할 수 없습니다. 셋째, 누끼가 필요한 상세 페이지 소재는 OpenAI만 알파 채널 출력을 문서화했습니다. Google이 문서화하지 않았다는 것이 불가능하다는 뜻은 아니지만, 계약이나 납품 조건에 넣을 근거는 없습니다. 넷째, 프로는 사고 단계를 끌 수 없어 응답 시간에 그 시간이 항상 포함됩니다. 그 대신 중간 이미지에는 요금이 붙지 않습니다. 프로의 모든 출력에는 SynthID 워터마크가 들어간다는 점도 Google 문서에 명시돼 있습니다.
두 회사 모두 "어느 영역이 바뀌었는지"를 알려주는 편집 마스크나 변경 영역 맵을 반환하지 않는다는 점도 기억해 두세요. OpenAI 프롬프트 가이드는 "반복 편집은 유지하려던 세부도 바꿀 수 있으니, 픽셀 단위로 동일해야 하는 영역은 프롬프트에 의존하지 말고 승인된 편집 결과를 원본에 합성하라"고 안내합니다. 이 조언은 두 모델 모두에 해당합니다.
승인된 이미지 한 장당 비용: 라벨이 아니라 픽셀로 맞춰야 합니다
두 회사의 가격은 단위가 달라서 그대로 나란히 놓으면 틀린 비교가 됩니다. OpenAI는 이미지 출력 토큰 100만 개당 $30이고 품질 라벨과 크기에 따라 소모 토큰이 달라집니다. Google은 출력 토큰 100만 개당 $120이고 1K·2K는 1,120토큰, 4K는 2,000토큰으로 고정입니다. OpenAI 문서 스스로 "같은 품질 라벨이 모델 간 같은 화질이나 응답 시간을 뜻하지 않는다"고 적으므로, 비교는 라벨이 아니라 같은 픽셀 크기에서 해야 합니다.
아래는 2026년 9월 22일에 OpenAI 공식 계산기에서 직접 읽은 추정치와 Google 가격표의 공개 토큰 수를 곱한 값입니다. 모두 Standard 요금이며 이미지 출력만 포함합니다. 텍스트·이미지 입력, 스트리밍 부분 이미지(장당 100토큰), 프로의 사고 텍스트 출력, 재시도는 별도로 붙습니다.
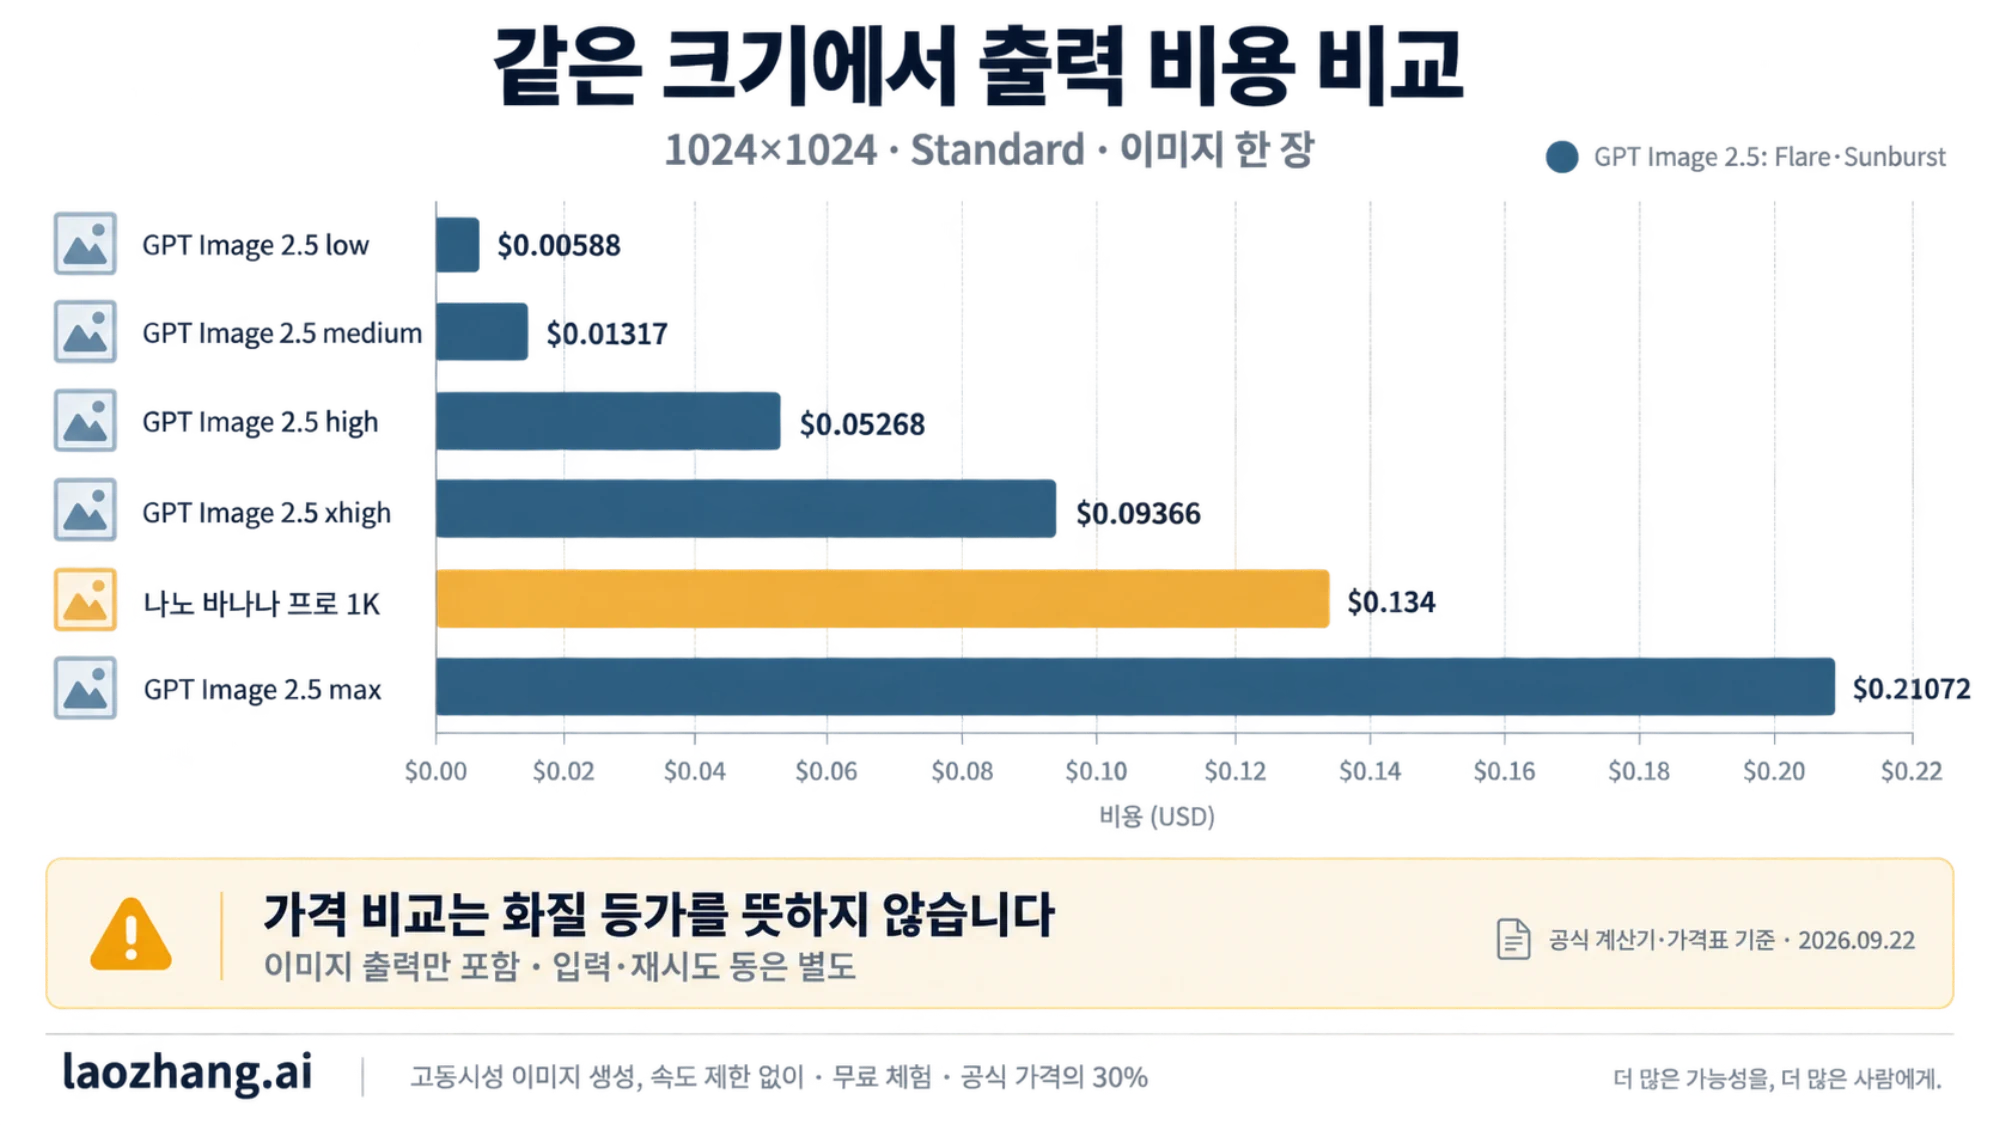
1024×1024 한 장 출력 비용
| 설정 | 출력 토큰 | 비용 |
|---|---|---|
GPT Image 2.5 low | 196 | $0.00588 |
GPT Image 2.5 medium | 439 | $0.01317 |
GPT Image 2.5 high | 1,756 | $0.05268 |
GPT Image 2.5 xhigh | 3,122 | $0.09366 |
| 나노 바나나 프로 1K | 1,120 | $0.134 |
GPT Image 2.5 max | 7,024 | $0.21072 |
2048×1152(16:9) 한 장 출력 비용
| 설정 | 출력 토큰 | 비용 |
|---|---|---|
GPT Image 2.5 low | 157 | $0.00471 |
GPT Image 2.5 medium | 367 | $0.01101 |
GPT Image 2.5 high | 1,413 | $0.04239 |
GPT Image 2.5 xhigh | 2,511 | $0.07533 |
| 나노 바나나 프로 2K | 1,120 | $0.134 |
GPT Image 2.5 max | 5,650 | $0.16950 |
출처: OpenAI 비용 계산기, Google 가격표 gemini-3-pro-image. 프로의 2K는 2048px 등급이지 2048×1152와 동일한 픽셀 수가 아니며, 계산기의 2.5 항목은 Sunburst와 Flare가 하나로 묶여 있어 두 모델의 추정치가 같습니다.
4K에서는 프로가 4096²에 $0.24(Batch $0.12)이고, 2.5의 3840×2160 값은 공식 계산기에 표시되지 않습니다(2026년 9월 22일 기준). 참고로 Tosea가 9월 9일에 2.5 high 3840×2160 응답의 usage로 보고한 값은 출력 3,336토큰(약 $0.10)이지만 이는 제3자의 한 건 판독이므로 예산은 직접 응답의 usage로 확인해야 합니다.
읽는 방법은 이렇습니다. 같은 1024²에서 프로 한 장 값이면 2.5 high를 두 장 반 만들 수 있고, 2.5 max는 프로보다 1.6배 비쌉니다. 그러나 이 표는 화질 등가를 뜻하지 않습니다. Artificial Analysis 순위의 2.5 항목이 max로 돌린 결과라는 점(다음 절)을 생각하면, 순위표의 화질을 기대하면서 high 가격을 예산으로 잡는 실수가 가장 흔합니다.
실제로 필요한 숫자는 승인된 이미지 한 장당 비용입니다. 계산식은 그 배치에 청구된 전체 금액(입력 + 출력 + 부분 이미지 + 재시도 + 사고 텍스트)을 승인된 장수로 나눈 값이며, 승인된 장수가 0이면 계산할 수 없습니다. 재시도율이 다르면 장당 단가가 싼 쪽이 더 비싸질 수 있고, 이것이 Ima Studio가 플랫폼 크레딧 기준으로 프로 10 대 Sunburst 31이라는 큰 단가 차이에도 모양을 유지해야 하는 작업에 Sunburst를 먼저 쓰라고 한 이유입니다. 크레딧은 그 플랫폼의 가격이지 OpenAI나 Google의 공식 가격이 아니라는 점은 별도입니다.
호출당 요금 경로까지 넣어 가상의 1만 회(단일 출력 1K, 재시도·입력 없음 가정)로 계산하면 프로 공식 Standard $1,340, 프로 공식 Batch $670, 프로 LaoZhang 호출당 $0.09 기준 $900, 2.5 high 1024² 공식 토큰 추정 약 $527, 2.5 max 약 $2,107입니다. 이 숫자는 예시 계산이며 실제 청구액은 응답의 usage와 콘솔에서 확인해야 합니다. 세부 가격 페이지는 GPT Image 2.5 API 가격과 나노 바나나 프로 가격에 있습니다.
블라인드 투표 순위와 직접 테스트가 엇갈리는 이유
블라인드 투표 순위 두 곳 모두 2.5를 1·2위에 두지만, 투표 수를 함께 읽어야 합니다.
Arena(arena.ai)의 텍스트→이미지 리더보드는 "2026년 9월 7일 최종 갱신"으로 표시된 상태(출시일인 9월 8일보다 앞선 날짜가 그대로 표시됨)에서 78개 모델 중 1위 gpt-image-2.5-sunburst 1421 ±13(3,149표, Preliminary), 2위 gpt-image-2.5-flare 1399 ±13(2,856표, Preliminary), 3위 gpt-image-2(medium) 1381 ±4(78,731표), 9위 나노 바나나 2 1261 ±5(41,957표), 14위 gemini-3-pro-image-2k(나노 바나나 프로) 1246 ±3(152,220표), 16위 프로 preview 1232 ±5(82,737표)입니다. 이미지 편집 리더보드도 순서가 같습니다. Sunburst 1520 ±9(6,704표, Preliminary), Flare 1491 ±9(5,676표, Preliminary), gpt-image-2 1461 ±3(235,928표), 프로 2k 9위 1390 ±3(556,580표). 2.5의 투표 수는 3천7천 건이고 프로는 15만55만 건입니다. Preliminary 표시는 Arena 스스로 순위가 아직 확정되지 않았다고 밝히는 것입니다. Arena 텍스트→이미지, Arena 이미지 편집
Artificial Analysis도 같은 방향입니다. 텍스트→이미지 1위 Sunburst(max) 1197 ±9(13,401회 비교), 2위 Flare(max) 1190 ±9, 3위 GPT Image 2(high) 1171 ±9, 6위 나노 바나나 2 1122 ±8, 10위 나노 바나나 프로 1100 ±8(15,977회). 편집은 Sunburst(max) 1180 ±8, Flare(max) 1161 ±8, 프로 13위 1096 ±8. 여기서 2.5 항목은 모두 max 품질(1024² 기준 7,024토큰)로 돌린 결과이고, Artificial Analysis가 표시한 1천 장당 $210.7이라는 가격도 그 설정을 반영합니다. high로 돌리면 비용은 4분의 1이지만 그 설정의 순위는 순위표에 없습니다. Artificial Analysis 텍스트→이미지, 편집
블라인드 투표가 측정하는 것은 평균적인 선호이지 속도나 비용, 특정 작업의 재시도율이 아닙니다. note의 피규어 테스트에서 프로가 만점이고 2.5가 24점이었던 것처럼, 특정 작업에서는 투표 순위와 반대 결과가 나옵니다. 투표 순위는 "평균적인 프롬프트에서 사람들이 어느 쪽을 더 좋아했나"에 대한 답이고, 자기 작업에 대한 답은 아래 방법으로 직접 얻어야 합니다.
자기 소재로 비교하는 방법
OpenAI 프롬프트 가이드는 자사 모델 간 비교 절차를 문서화했는데, 그 절차는 Google 모델과 비교할 때도 그대로 쓸 수 있습니다. 핵심은 비교 대상 외의 조건을 모두 고정하는 것입니다.
- 프롬프트, 참조 이미지, 출력 크기를 고정하고 2.5 쪽은
auto가 아닌 명시적 품질을 고릅니다. 크기는 라벨이 아니라 픽셀로 맞춥니다(예: 2.51024x1024vs 프로1K1:1). - 예산도 맞춥니다. 프로 1K $0.134에 맞추려면 2.5는
xhigh($0.094)와max($0.211) 사이이므로,high와xhigh두 설정을 함께 돌려 결과와 비용을 같이 기록합니다. - 채점 항목은 지시 이행, 정체성·제품 보존, 텍스트 정확도, 요청하지 않은 변경, 투명 배경(필요 시)입니다. Ima Studio의 조언대로 최종 결과만 보지 말고 1단계 결과를 원본과 대조하세요. 형태 변형은 1단계에서 생겨 끝까지 이어집니다.
- 같은 요청을 여러 번 반복해 일관성을 봅니다. 한 번 시도한 결과는 이 글에 인용된 테스트 대부분이 그렇듯 방향만 알려줍니다.
- 편집 작업이면 한 장이 아니라 실제 편집 순서 전체(예: 색 변경 → 배경 교체 → 문구 삽입 → 광고 레이아웃)를 두 모델에 같은 순서로 돌립니다. 다나와의 "지웠던 캐리어" 사례는 5회차에서 나타났습니다.
- 응답 시간은 평균과 느린 응답을 따로 기록하고, 실패와 재시도 횟수, 승인된 이미지 한 장당 비용을 계산합니다. JXP가 관찰한 "2.5 1K 20~40초, 프로 1분 미만에서 2분 이상까지 들쭉날쭉"은 그 플랫폼에서의 관찰일 뿐이며 p95 같은 수치가 아닙니다.
한글 텍스트에 대해서는 OpenAI 가이드의 텍스트 요령이 그대로 적용됩니다. 넣을 문구를 따옴표로 감싸고, 브랜드명은 한 글자씩 풀어 쓰며, 작은 글씨는 medium과 high를 나란히 비교하라는 것입니다. 다나와의 한글 포스터 결과는 1회 시도라, 카드뉴스나 상세 페이지처럼 문장이 길고 작은 글씨가 많은 소재에서는 두 모델 모두 최소 5~10장씩 돌려 오탈자율을 직접 세는 것이 안전합니다.
오늘 두 모델을 함께 쓰는 경로(2026년 9월 22일 기준)
같은 소재로 두 모델을 나란히 돌리려면 키가 두 개 필요하거나, 하나로 둘 다 호출할 수 있는 게이트웨이가 필요합니다. 어느 쪽이든 아래 상태를 알고 골라야 합니다.
공식 직접 경로. OpenAI는 gpt-image-2.5-flare·gpt-image-2.5-sunburst를 Images API(/v1/images/generations, /v1/images/edits)와 Responses 이미지 도구로 제공하며, Standard 토큰 요금은 세 모델(2, Flare, Sunburst) 모두 같습니다. Google은 gemini-3-pro-image를 Gemini Developer API로 제공하고 Batch API로 돌리면 1K·2K $0.067, 4K $0.12로 절반입니다. 하루치 상세 페이지 소재를 모아서 돌리는 팀에게는 이 Batch 가격이 프로의 실질 단가입니다. 가격표에 무료 등급 행은 없고 Google AI Studio에서 테스트할 수 있다고만 적혀 있습니다. 앱과 API의 한도 차이는 Gemini 나노 바나나 프로 무료 vs 유료 한도에 정리돼 있습니다.
LaoZhang 게이트웨이(키 하나로 둘 다). 베이스 URL은 https://api2.laozhang.ai/v1이고 두 모델을 다음 형태로 제공합니다. LaoZhang GPT Image 2.5 문서, LaoZhang 나노 바나나 프로 문서
- GPT Image 2.5: 공식 포워딩 경로로
gpt-image-2.5-flare와gpt-image-2.5-sunburst를 그대로 선택할 수 있고, 공식과 같은 Images API 형식으로 2K·4K 크기까지 지원합니다. 과금은 토큰 단위이며 문서상 "공식 포워딩gpt-image-2와 같은 토큰 요금"입니다. 사용량 과금 토큰을 공식 포워딩 그룹(Sora2Official또는GPTImage2 Sora2 Enterprise)에 두고 토큰 설정에서 그룹을 고르며,model값으로 고르는 것이 아닙니다. 실제 요금은 콘솔에서 확인하세요. - 호출당 $0.03이던
gpt-image-2.5-flare-vip·gpt-image-2.5-sunburst-vip는 2026년 9월 16일 공지로 "상위 용량 제한으로 일시 중단"이며 복구 시점이 확정되지 않았습니다. 다른 글에서 이 가격을 봤다면 지금은 쓸 수 없는 경로입니다. 대체로 안내된gpt-image-2.5-web은 생성 건당 과금이고size를 받지만 Flare/Sunburst를 고를 수 없으며 가격은 콘솔 표시를 따르므로 이 글에 고정 금액을 적지 않습니다. LaoZhang 공지 - 나노 바나나 프로: 모델
gemini-3-pro-image, 4K를 포함한 모든 해상도가 호출당 $0.09(별도 4K 등급 없음). 요청 형식은 두 가지인데, OpenAI 호환/v1/chat/completions는 1K·1:1로 고정이고, 비율과 4K를 쓰려면 Google 네이티브 형식/v1beta/models/gemini-3-pro-image:generateContent에imageConfig.imageSize: "4K"를 넣어야 합니다. 참조 이미지는 객체 6장 + 인물 5장까지입니다. 이 $0.09는 게이트웨이가 문서에 적은 가격이지 Google 가격이 아니며, 같은 문서의 "~10초"도 안내 문구이지 측정치가 아닙니다.
비교용으로 2.5 쪽 요청을 고정하는 최소 예시입니다. 공식 Images API와 같은 형식이며 quality를 auto가 아닌 값으로 명시해야 계산기 추정치와 대조할 수 있습니다.
bashcurl --fail-with-body "https://api2.laozhang.ai/v1/images/generations" \
  -H "Authorization: Bearer $LAOZHANG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.5-sunburst",
    "prompt": "주황색 펜던트 조명 제품 사진, 흰 배경, 정면",
    "size": "1024x1024",
    "quality": "high"
  }' -o generation.json
프로 쪽은 같은 키로 Google 네이티브 엔드포인트(/v1beta/models/gemini-3-pro-image:generateContent)를 호출하고 imageConfig.imageSize에 1K를 넣어 1:1로 맞추면 됩니다(대문자 K만 허용). 어느 경로든 게이트웨이가 요청 형식을 맞춰 준다고 해서 공식 API의 모든 기능·할당량·SLA가 보장되는 것은 아니며, 신규 계정은 Gmail 또는 기업 화이트리스트가 필요하고 테스트 크레딧은 연결 확인용입니다. 대량 전환 전에 콘솔의 현재 요금을 다시 확인하세요. 프로의 요청 형식 전체는 나노 바나나 프로 API 가이드에 있습니다.
Batch로 GPT Image 2를 돌리던 팀이라면 2.5로의 이동을 서두를 이유가 아직 없습니다. 2.5 두 모델은 Batch를 지원하지 않고 gpt-image-2는 중단 목록에 없으며, 계산기 기준으로 2.5 high의 토큰 수(1,756)가 GPT Image 2 medium과 같아 모델 문자열만 바꾸고 quality를 그대로 두면 예산이 크게 달라집니다. 이 차이는 GPT Image 2.5 vs GPT Image 2에서 다룹니다.
자주 묻는 질문
나노 바나나 프로는 아직도 최고의 이미지 모델인가요?
블라인드 투표 순위 두 곳에서는 2026년 9월 22일 기준으로 아닙니다. Arena에서 프로(2k)는 텍스트→이미지 14위, 편집 9위이고, 2.5 두 모델이 Preliminary 표시와 함께 1·2위입니다. 다만 프로의 투표 수는 15만55만 건, 2.5는 3천7천 건이라 순위는 아직 확정 전이고, 피규어 변환처럼 질감을 새로 입히는 작업(note, 6모델×4회)에서는 프로가 30점 만점으로 2.5(24점)를 앞섰습니다. 4096px 4K와 14장 참조 조합은 여전히 프로만 문서화한 사양입니다.
나노 바나나 2로 충분한 경우는 언제인가요?
Google 스스로 나노 바나나 2를 기본 선택으로 안내하며, 1K 출력이 $0.067로 프로의 절반입니다. Arena 텍스트→이미지에서는 나노 바나나 2(9위, 1261)가 프로 2k(14위, 1246)보다 위에 있습니다. 프로를 고를 근거는 Google이 프로를 "전문 자산 제작과 복잡한 지시"용으로 안내한다는 점, note 피규어 테스트의 근소한 차이(프로 30점, 나노 바나나 2 29점), 그리고 프로 가격에 4K가 포함된 LaoZhang 경로처럼 4K 단가가 유리한 경우 정도이며, 참조 이미지 상한은 오히려 나노 바나나 2가 객체 10장으로 더 많습니다. 두 모델의 차이는 나노 바나나 프로 vs 나노 바나나 2에 정리돼 있습니다.
GPT Image 2.5 안에서는 Flare와 Sunburst 중 무엇을 쓰나요?
OpenAI 문서 기준으로 Flare는 속도 우선의 작은 모델, Sunburst는 품질 우선의 기본 모델이며 API 토큰 요금과 계산기 추정 토큰 수는 같습니다. 즉 공식 경로에서는 같은 설정이면 비용이 같고 속도와 화질만 다릅니다. 제품 모양이 승인 기준이라면 Ima Studio가 테스트한 Sunburst high에서 시작하고, 초안 탐색은 Flare medium부터 올리는 것이 비용 순서에 맞습니다. 두 모델의 차이는 GPT Image 2.5 Sunburst vs Flare에서 더 자세히 다룹니다.
ChatGPT에서 본 Images 2.5 결과가 API에서도 똑같이 나오나요?
보장되지 않습니다. ChatGPT의 Images 2.5는 어느 API 모델과 품질 설정이 쓰이는지 사용자가 고를 수 없고, 다나와 테스트 같은 앱 비교는 API의 quality·size·참조 이미지 처리와 조건이 다릅니다. API로 전환할 때는 명시적 품질을 고정하고 같은 소재로 다시 확인하세요. ChatGPT 쪽 기능과 한도는 ChatGPT Images 2.5에 있습니다.
이커머스 상세 페이지 편집에는 어느 쪽을 먼저 써야 하나요?
지금까지 공개된 유일한 반복 테스트(Ima Studio, 조명 1개 SKU, 30장)에서는 제품 실루엣과 반복 레이아웃이 승인 기준일 때 Sunburst가 모양을 3/3 유지했고 프로는 3/3 변형됐습니다. 그 저자는 1단계 결과를 원본과 대조할 수 있는 워크플로우라면 프로도 쓸 수 있다고 했습니다. 다만 한 SKU, 영문 카피 결과이므로 의류 착장, 한글 라벨, 여러 SKU에는 그대로 적용할 수 없습니다. GPT Image 2 시절의 이커머스 비교는 나노 바나나 프로 vs GPT Image 2 이커머스에 있습니다.
"나노 바나나 2.5"와 비교한 글은 믿어도 되나요?
그 이름의 제품은 없습니다. Google 가격표와 모델 목록에 없고, Arena에서 미확인 코드명으로 목격됐다는 제3자 서술만 있습니다. 공식 발표, 가격, API 사양이 나오기 전까지는 비교 대상이 될 수 없으므로, 그 이름으로 가격이나 성능을 제시하는 페이지는 근거를 확인하세요.