Claude APIの529 overloaded_error対処法:SDKの再試行と過負荷を制御する
529 overloaded_errorが返ったら、APIの過負荷として扱い、再試行を増やす前にSDKの設定と送信中の並列数を確認します。待機時間を含めた予算を決め、同じ接続先で正常な応答を確かめてから負荷を戻してください。
目次
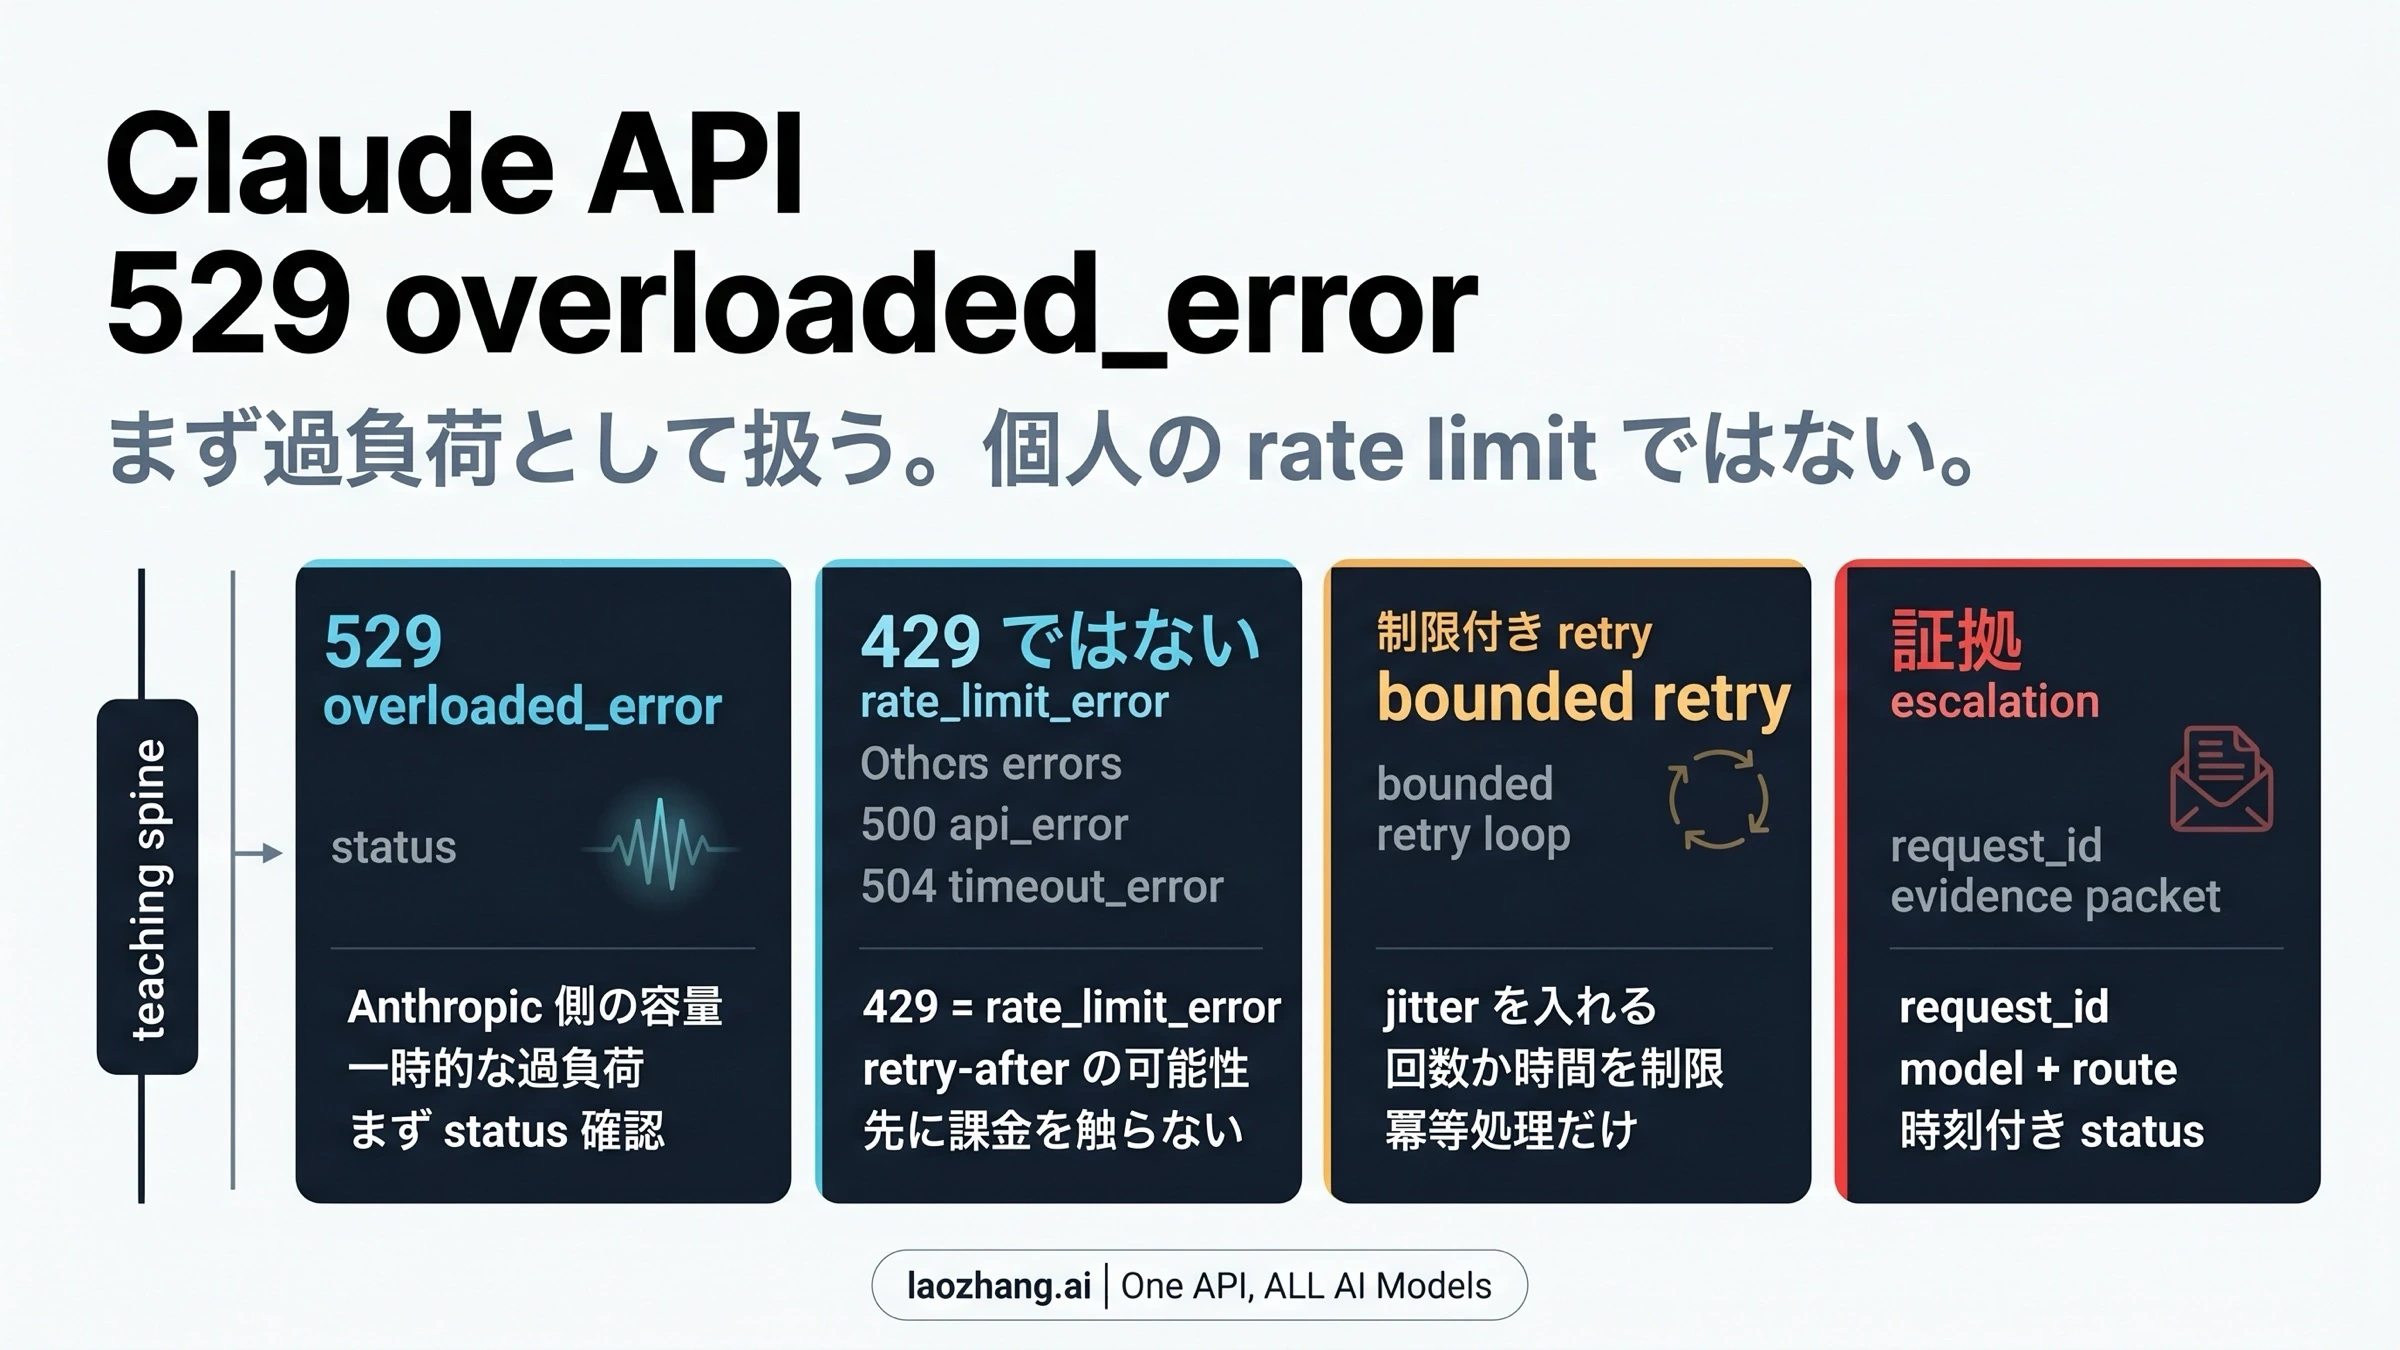
Claude APIから529 overloaded_errorが返ったときは、一時的な過負荷として、送信を抑えながら回復を待ちます。 エラーの時刻とリクエストIDを残し、接続先の稼働状況を確認してください。再試行を重ねる前にSDKが何回送信済みかを調べ、並列数を下げます。AnthropicのAPIエラー一覧では、529は過負荷、429はレート制限や一部の支出上限として区別されています。
公式Python SDKは一時的な失敗を既定で2回再試行します。アプリがさらに送り直すと、その回数も加わります。まず再試行を担当する箇所を一つに決め、回数と待機時間を制限しましょう。予算が尽きたら送信を止め、利用者へ失敗を返すか、期限の残ったジョブを後で処理します。過負荷が解消したかは、元のモデルと接続先で応答が完了したことを確認して判断します。Python SDKの再試行設定
529かどうかを、表示文ではなくレスポンスで確認する
send failed: overloaded claudeのような表示は、送信失敗の手掛かりです。ただし、アプリが要約した一行だけではHTTP 529を受信したとは断定できません。HTTPステータス、JSONのerror.type、実際の接続先を確認します。以下はAnthropic APIへ直接接続した場合の分類です。中継サービス独自のエラーには、そのサービスの説明を使ってください。公式のエラー分類
| 確認できたエラー | 意味 | 最初にすること |
|---|---|---|
529 overloaded_error | APIが一時的に過負荷 | 再試行を制限し、並列送信を減らす |
429 rate_limit_error | レート制限、利用階層の月間支出上限、またはClaude Codeワークスペースの支出上限 | 本文と制限情報を確認し、待てば再開できる制限か判断する |
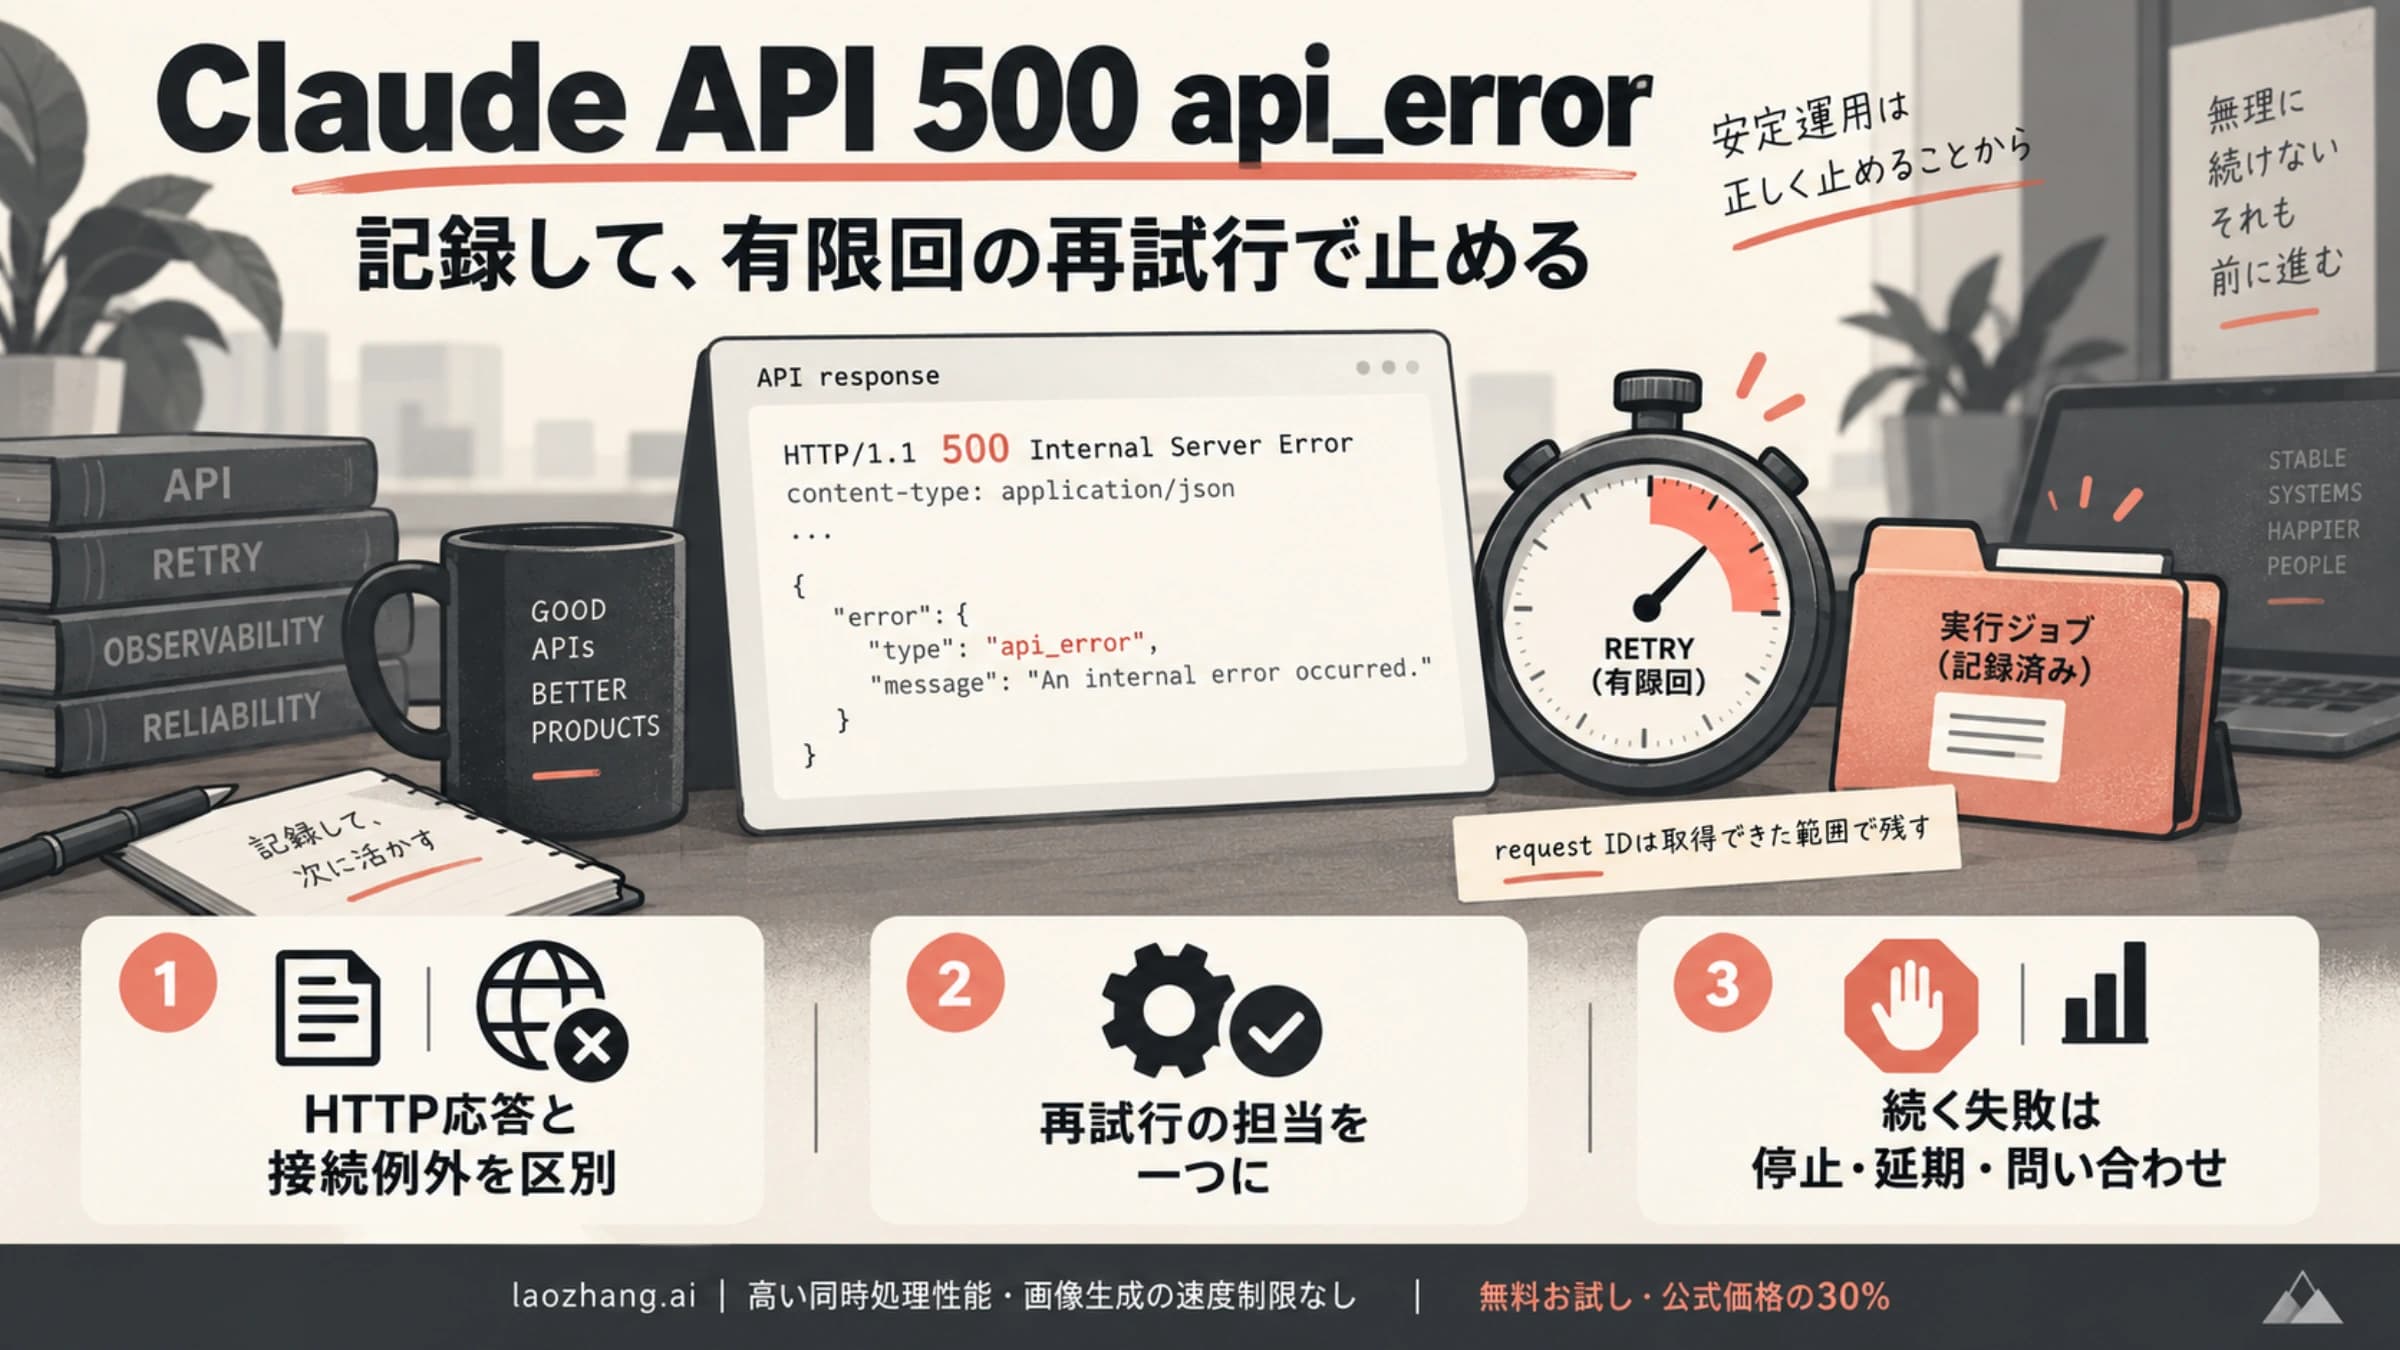
500 api_error | Anthropic内部で予期しないエラーが発生 | リクエストIDを残し、安全な処理だけ再試行する |
504 timeout_error | APIで処理中にタイムアウト | 長い処理ならストリーミングなどを検討する |
| HTTPレスポンスが得られていない | 接続やクライアント側のタイムアウトなど | SDKの例外と接続環境を調べる。529と決めつけない |
reached concurrency limitは「同時実行数の上限に達した」という意味ですが、その文言だけでは529の証拠になりません。 アプリ、ジョブ実行基盤、中継サービスなどが独自の上限を設けている場合があります。どこが拒否したのかをログで確かめ、そのサービスの制限を確認してください。
429にも待機だけでは解消しないものがあります。利用階層の月間支出上限による429はretry-afterを伴わず、アクセスが再開するまで失敗し続けると公式文書に記載されています。529への対策としてAPIキーを交換したり、プランを上げたりする前に、エラー型が変わっていないかを見ます。429の支出上限と529の定義
エラーが500に変わった場合は、Claude APIの500 api_errorへの対処へ進めます。Web画面や連携アプリの表示しか分からない場合は、Claudeのエラーを利用画面と接続先から切り分ける方法が起点になります。
Python SDKの再試行を設定し、529で止まった結果を受け取る
公式Python SDKのmax_retries=2は、最初の送信に加えて最大2回の再試行です。接続エラー、408、409、429、500以上のエラーが既定の対象で、指数バックオフを使います。常に3回送るという意味ではなく、成功や再試行を拒否する条件によって早く終了します。設定はクライアント全体、またはwith_optionsで呼び出しごとに指定できます。Python SDKの仕様
次の関数は、SDKに再試行を任せ、アプリ側に追加の再試行ループを置かない例です。公式anthropicパッケージで認証・接続先を設定済みのAnthropicクライアントと、利用可能なモデルID、入力テキストを渡します。非ストリーミングの単純な文章生成を想定しており、ツールの外部操作を再実行するためのコードではありません。
from anthropic import (
    Anthropic,
    APIStatusError,
    APITimeoutError,
    APIConnectionError,
)


def generate_text(client: Anthropic, model: str, text: str) -> dict:
    try:
        message = client.with_options(
            max_retries=2,
            timeout=20.0,
        ).messages.create(
            model=model,
            max_tokens=512,
            messages=[{"role": "user", "content": text}],
        )
        return {"state": "completed", "message": message}
    except APIStatusError as exc:
        return {
            "state": "overloaded" if exc.status_code == 529
                     else "other_http_error",
            "status": exc.status_code,
            "request_id": getattr(exc, "request_id", None),
            "retry_after": exc.response.headers.get("retry-after"),
            "retry_after_ms": exc.response.headers.get("retry-after-ms"),
        }
    except APITimeoutError:
        return {"state": "timeout"}
    except APIConnectionError:
return {"state": "connection_error"}completedならSDKの応答オブジェクトを使います。overloadedなら、この呼び出しの再試行が終わった結果として扱い、直後に同じ関数を無条件で呼び直さないでください。利用者への案内、ジョブの延期、問い合わせの判断へ進みます。other_http_errorは529処理から外し、返されたコードに対応した処理へ渡します。timeoutとconnection_errorだけでは、APIが529を返したとは分かりません。
この関数は構文と結果の分岐を模擬クライアントでオフライン確認しました。実際のモデルへの送信、SDK内部の待機動作、障害からの回復は試験していません。timeout=20.0も「関数全体が20秒で必ず終了する」という指定ではありません。
529をInternalServerErrorだけで捕まえない
上の例はAPIStatusErrorを捕まえ、status_code == 529で分岐します。2026年10月4日に確認した公式Python SDKのmainソースでは、529は専用のOverloadedErrorへ割り当てられています。これはAPIStatusErrorを継承しますが、InternalServerErrorの子クラスではありません。InternalServerErrorだけを捕まえる実装では、このソースの529を取り逃すことがあります。例外の割り当て、例外クラス
これは開発ブランチの確認結果です。すべての公開版や、利用中の環境に同じクラスがあると確認したわけではありません。導入済みのSDKの版と例外の仕様を確認し、メッセージ文字列だけに依存した判定を避けてください。
回数の上限と、処理全体の待機予算を分ける
SDKの再試行回数を有限にしても、アプリ全体の待機時間はそれだけでは決まりません。キューでの待機、各リクエストの通信、バックオフ、サーバーが指定した待機時間が加わるためです。
公式Python SDKのタイムアウトは既定で10分です。timeoutで変更でき、タイムアウトも既定では2回再試行されます。ただし、これはアプリの受付から結果を返すまでの一括した期限ではありません。単一のリクエストでも通信の各段階に時間を使うため、「20秒×3回で必ず60秒以内」とは計算できません。SDKのタイムアウト設定
再試行を外側にも置いた場合、対象の失敗が続き、途中で停止しないという条件では、外側の呼び出し回数をN、SDKの再試行回数をrとして、HTTP送信は最大N × (r + 1)回になります。たとえば外側が合計3回、SDKが2回再試行するなら最大9回です。これは設定からの計算例で、実測した送信回数ではありません。さらにゲートウェイやキューが再送するなら、それらの動作も確認します。
使い方に合わせて、次のいずれかを選びます。
| 運用上の必要条件 | 再試行を担当する箇所 | 設定・処理の方針 |
|---|---|---|
| SDKの待機を許容できる単発処理 | SDK | max_retriesを有限に設定。外側ではその結果を受け取り、再送を重ねない |
| ジョブの有効期限と再実行を一元管理したい | アプリのスケジューラー | SDKをmax_retries=0にして、送信回数・次回送信時刻・期限をジョブに保存する |
| 利用者へ一定時間内に結果を返す必要がある | アプリと実行基盤 | 通信タイムアウトに加え、キューを含む期限と実行中処理の取消しを設計する。期限切れ後の結果や重複も管理する |
送信前に残り時間を確認するだけでは、すでに実行中の処理を止めることはできません。厳密な終了期限が必要なら、使う非同期ランタイムやワーカーの取消し方法まで含めて実装します。取消しを要求したことも、サーバー側の生成や外部操作が必ず取り消されたことを意味しません。
Retry-Afterが予算を超えたら、早めに再送せず止める
サーバーから待機時間が指定された場合は、その時間を縮めて再送しないでください。残り予算が15秒なのに60秒の待機を求められたなら、この処理の即時再試行は終了します。ジョブがまだ有効なら60秒以降に延期し、有効期限を過ぎるなら失敗として返します。この数字は判断を説明する例です。
2026年10月4日に確認したPython SDKのmainソースは、retry-after-msをミリ秒として優先し、次にretry-afterの秒数またはHTTP日付を読みます。正の値なら、OSの待機上限の範囲で従う実装です。「60秒を超える値は常に無視する」という古い説明を、このソースに当てはめることはできません。同じソースでは非標準ヘッダーx-should-retry: falseがあれば再試行しません。待機時間と再試行判定の実装
この動作も利用中のSDKの版で確認してください。アプリ側で制御する場合は、正しく解釈できる待機指定を尊重し、明示的な再試行禁止、送信回数の上限、ジョブの期限を先に確認します。待機指定がない場合は指数バックオフにジッターを加え、次の送信をずらします。最後の失敗で終了すると決まっているなら、次の送信のための待機を追加する必要はありません。
並列数とキューを抑え、同じ接続先で回復を確かめる
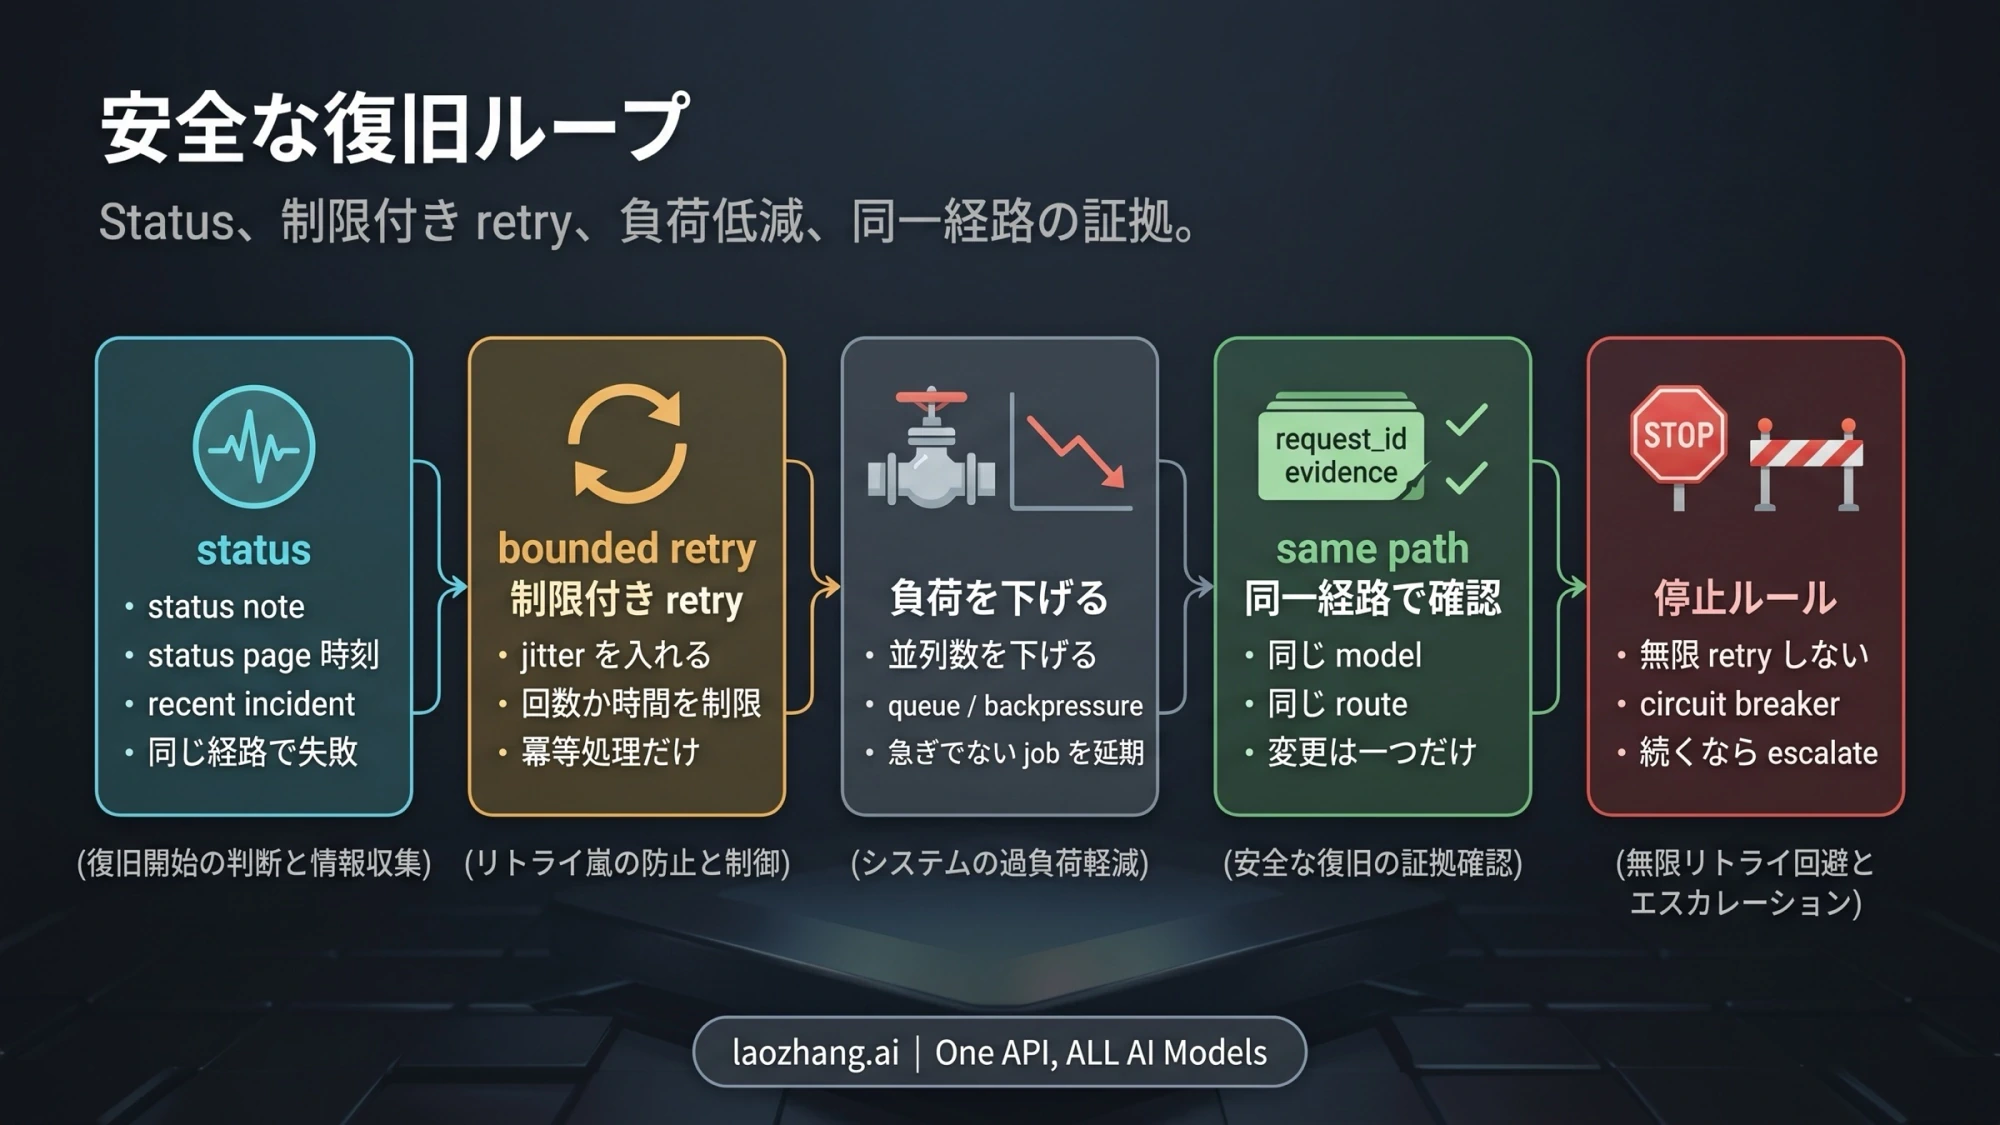
過負荷の間は、新しいリクエストと再試行が同時に増えないようにします。自分のアプリが障害の原因だと断定するための操作ではなく、失敗中のAPIへ追加の送信を集中させないための運用です。
- 非緊急の処理を止めます。 バッチや任意の追加生成を延期し、対話など優先度の高い処理に利用可能な枠を残します。
- 送信中の並列数を減らします。 再試行も同じ並列数の制限に含めます。通常処理だけを制限して再試行を別枠にすると、混雑時に送信が膨らみます。
- キューにも上限を設けます。 長さ、ジョブの期限、再実行回数を管理します。期限切れのジョブを回復後にまとめて送り直さないようにします。
- 失敗が集中したら、一時的に新規送信を止めます。 サーキットブレーカーを使う場合は、停止の条件と再開確認の少数リクエストを決めます。
- 少量から再開します。 元のモデルと接続先で応答が完了したことを確かめ、529率、最終的な失敗率、待機時間を見ながら並列数を戻します。
固定間隔で大量のジョブを再送すると、次の試行も同じ時刻に集中します。ジッターはその集中を分散するための制御です。ここで示す方法は一時的な失敗に対する運用上の提案であり、一定の回復率や応答時間を保証するものではありません。
確認時はモデル、APIのホストとエンドポイント、認証方式、ゲートウェイ、クラウドのリージョン、入力の大きさを記録します。まず元の条件のまま少数の安全な処理を送ります。診断のために条件を変える場合は一つずつ変え、何を確かめたのかを残してください。
Claude Statusの表示が正常でも、特定のモデルや接続経路の回復はそれだけでは証明できません。クラウドや中継サービスを使う場合は、そのサービスの状態も確認します。別モデルで成功したことは、代替処理が動いた証拠であり、元のモデルが回復した証拠とは分けて記録します。
別モデルやプロバイダーへの切り替えは、作業がその変更を許容するときの選択肢です。利用権限、ツール、出力形式、品質要件が合うかを確かめてから使います。キーを変えるだけで独立した処理容量が得られるとは限りません。
HTTP 200の後で途切れた応答は、そのまま再送しない
ストリーミングでは、HTTP 200を返した後にもエラーが発生することがあります。したがって200だけで「生成成功」と記録せず、SDKやストリームの終了状態まで確認してください。開始時のHTTP例外を処理するコードだけでは、途中の失敗をすべて扱えません。ストリーミング時のエラーに関する公式説明
途中まで受け取った文章と、完了した結果を区別して保存します。新しい生成結果を、前の断片へ無条件で追加すると、同じ説明が重複したり内容が食い違ったりします。再生成するなら、どちらを採用するかをアプリ側で決めます。
ツールを使う処理なら、送信前に注文、ファイル変更、外部サービスへの書き込みなどの結果を照合します。応答が届かなかったことだけでは、その操作が失敗したとは分かりません。業務上のジョブIDと実行結果を対応付け、済んだ操作を除いて未完了部分を進めます。新しいリクエストIDは別の送信を識別するもので、業務処理の重複防止キーの代わりにはなりません。
Claude Codeのターミナルで不完全な応答や繰り返す529が表示されている場合は、元のセッションと実行結果を確認して作業を続ける手順を使ってください。Claude Codeの再試行や会話の再開と、直接APIを呼ぶPython SDKの設定は別の仕組みです。
529が続くとき、問い合わせ先へ渡す情報
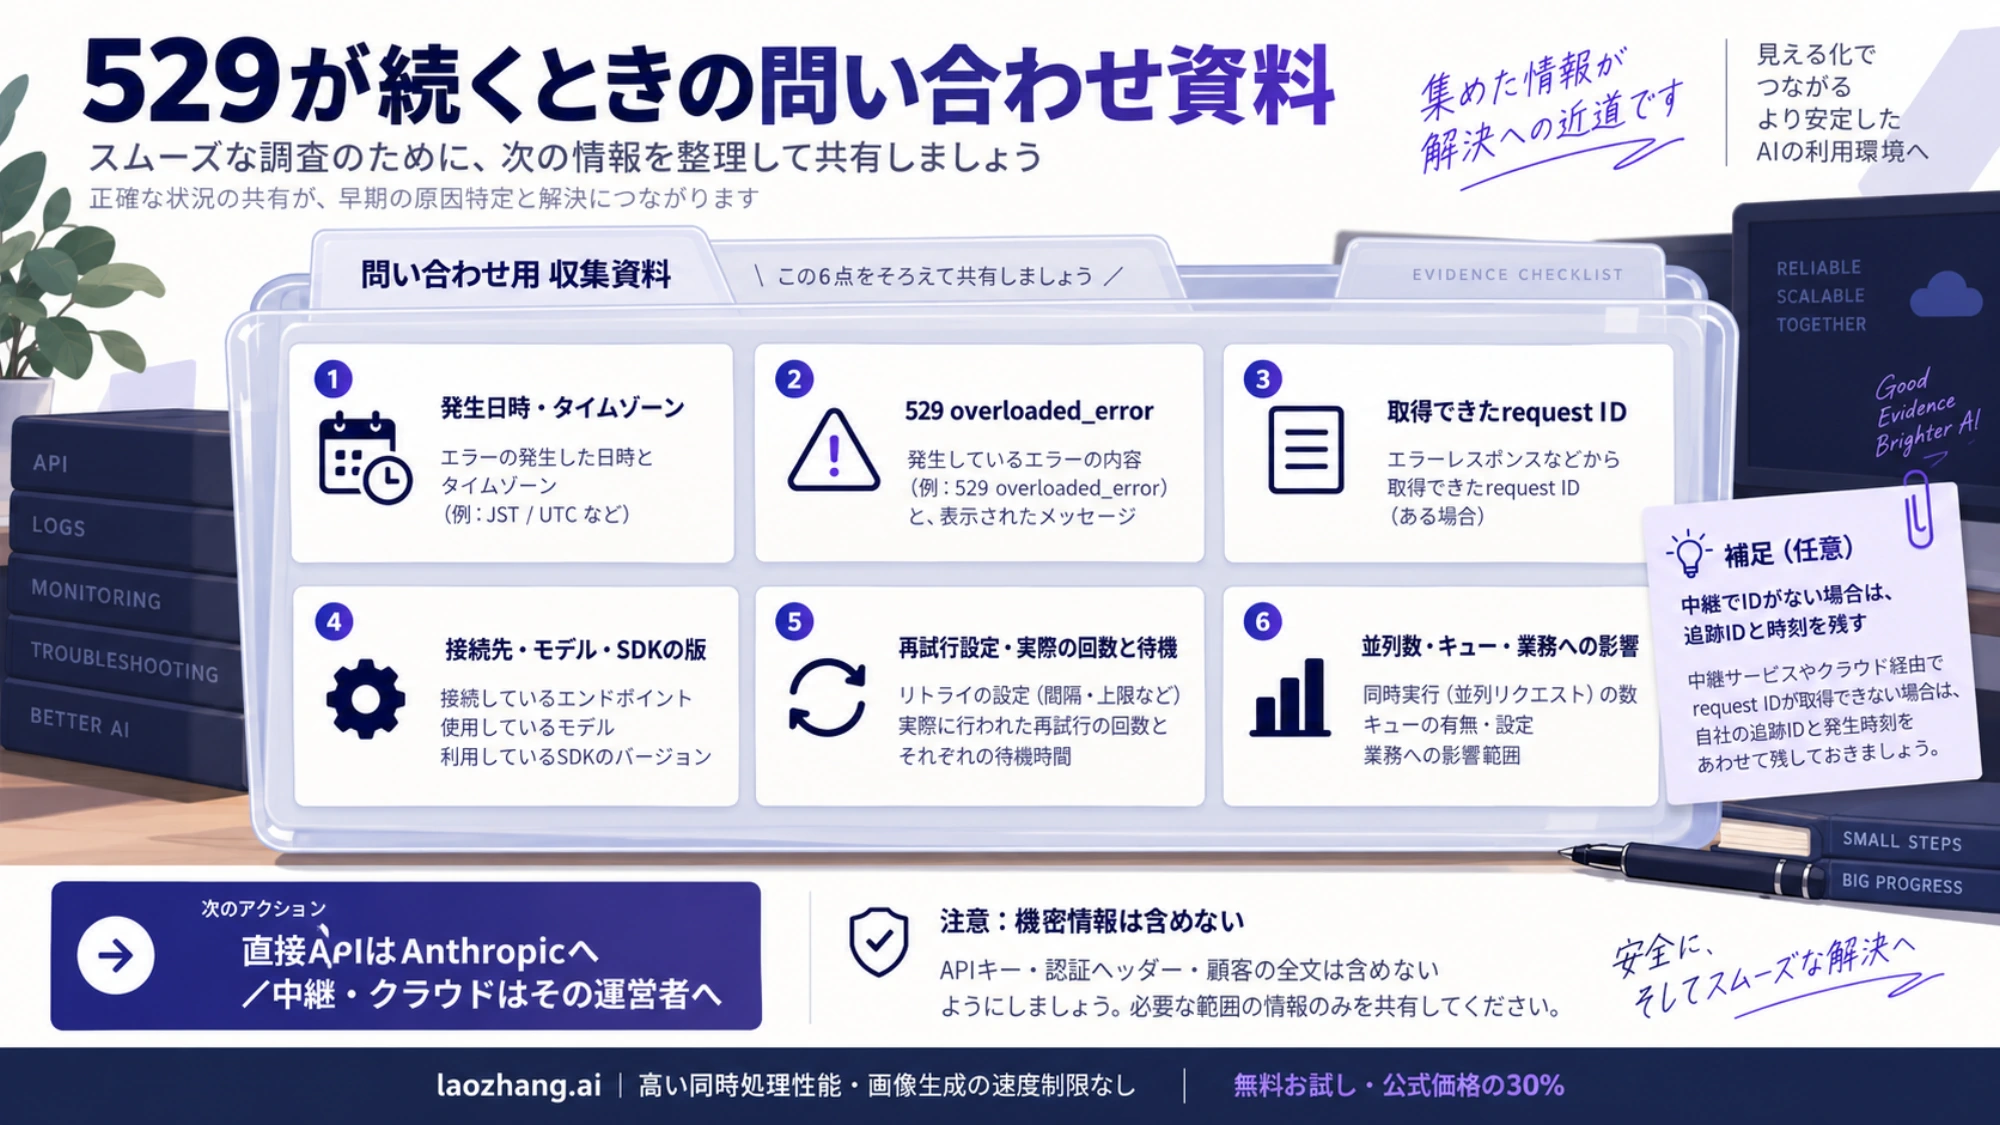
再試行の上限まで失敗したら、そのジョブの即時送信を止めます。稼働状況と負荷を確認し、少数の同じ経路での確認でも529が続くなら、ログをまとめて問い合わせます。Anthropicへ直接接続している場合と、中継サービスやクラウドを使っている場合では、調査できる運営者が違います。
次の情報を一組にしておくと、発生したリクエストを追いやすくなります。
- 発生日時とタイムゾーン、HTTPステータス、
error.type、エラーメッセージ。 - 利用可能な
request_idまたはrequest-idヘッダー。各試行を区別できる記録。 - モデル、接続先、SDKの版、クラウドやゲートウェイの有無。
- SDK・アプリ・ゲートウェイごとの再試行設定、実際の回数と待機時間。
- 発生時の並列数、キューの状態、稼働状況を確認した時刻。
- 機密情報を除いたリクエストの形と、遅延・失敗した業務の範囲。
公式APIではエラーJSONのrequest_idとレスポンスのrequest-idヘッダーを使って問い合わせできます。成功したPython SDKの応答では_request_idを取得できます。中継サービスがIDを返さない場合は、そのサービス側の追跡IDと時刻も残してください。リクエストIDの公式説明
APIキー、認証ヘッダー、顧客の入力全文をログや問い合わせへそのまま貼る必要はありません。再現に必要な形式や大きさを残し、内容は機密性に合わせて削除します。
よくある質問
Claude APIの529は、利用上限に達したという意味ですか?
529自体はAPIの一時的な過負荷です。直接APIの公式分類では429がレート制限や一部の支出上限を表します。reached concurrency limitなどの文言だけが出た場合は、拒否したサービスとHTTPレスポンスを確認してから分類してください。529と429の定義
529は何分待てば直りますか?
一律の復旧時間は決められません。待機ヘッダーがあれば従い、ない場合は有限の指数バックオフとジッターで再試行します。利用者やジョブが待てる期限を超えるなら、送信を止めて失敗を返すか延期します。状態ページが正常でも、元の接続先で応答が完了するまで回復済みとは判断しません。
Python SDKは529を何回再試行しますか?
現在の公式文書では、一時的な失敗を既定で2回再試行します。529は500以上のエラーに含まれるため、対象の呼び出しは最初の送信と合わせて最大3回です。ただし、成功や再試行を拒否する条件によって減ります。max_retriesで変更でき、アプリやゲートウェイの追加再試行は別に数えます。Python SDKの再試行設定
timeoutを20秒にすれば、20秒以内に処理が終わりますか?
いいえ。SDKの通信タイムアウトだけでは、再試行や待機、キューを含む全体の終了期限になりません。アプリが結果を返す期限、実行中処理の取消し、期限切れジョブの扱いを別に設計します。SDKのタイムアウト仕様
HTTP 200を受け取った後でも、過負荷の処理が必要ですか?
ストリーミングでは200の後にエラーが起こり得るため、応答が完了したかを確認する必要があります。途中の文章や外部操作の結果を残し、再送する前に重複を防いでください。200だけで成功件数に数えると、利用者が完成した結果を受け取れなかった失敗を見落とします。ストリーミングのエラー境界
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月5日。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月5日。
- 1.AnthropicのAPIエラー一覧platform.claude.com/docs/en/api/errors
- 2.Python SDKの再試行設定platform.claude.com/docs/en/api/sdks/python
- 3.例外の割り当てgithub.com/anthropics/anthropic-sdk-python/blob/main/src/anthropic/_client.py
- 4.例外クラスgithub.com/anthropics/anthropic-sdk-python/blob/main/src/anthropic/_exceptions.py
- 5.待機時間と再試行判定の実装github.com/anthropics/anthropic-sdk-python/blob/main/src/anthropic/_base_client.py
- 6.Claude Statusstatus.claude.com