ClaudeとOpenAIのAPI料金比較:同額でも差が出る条件
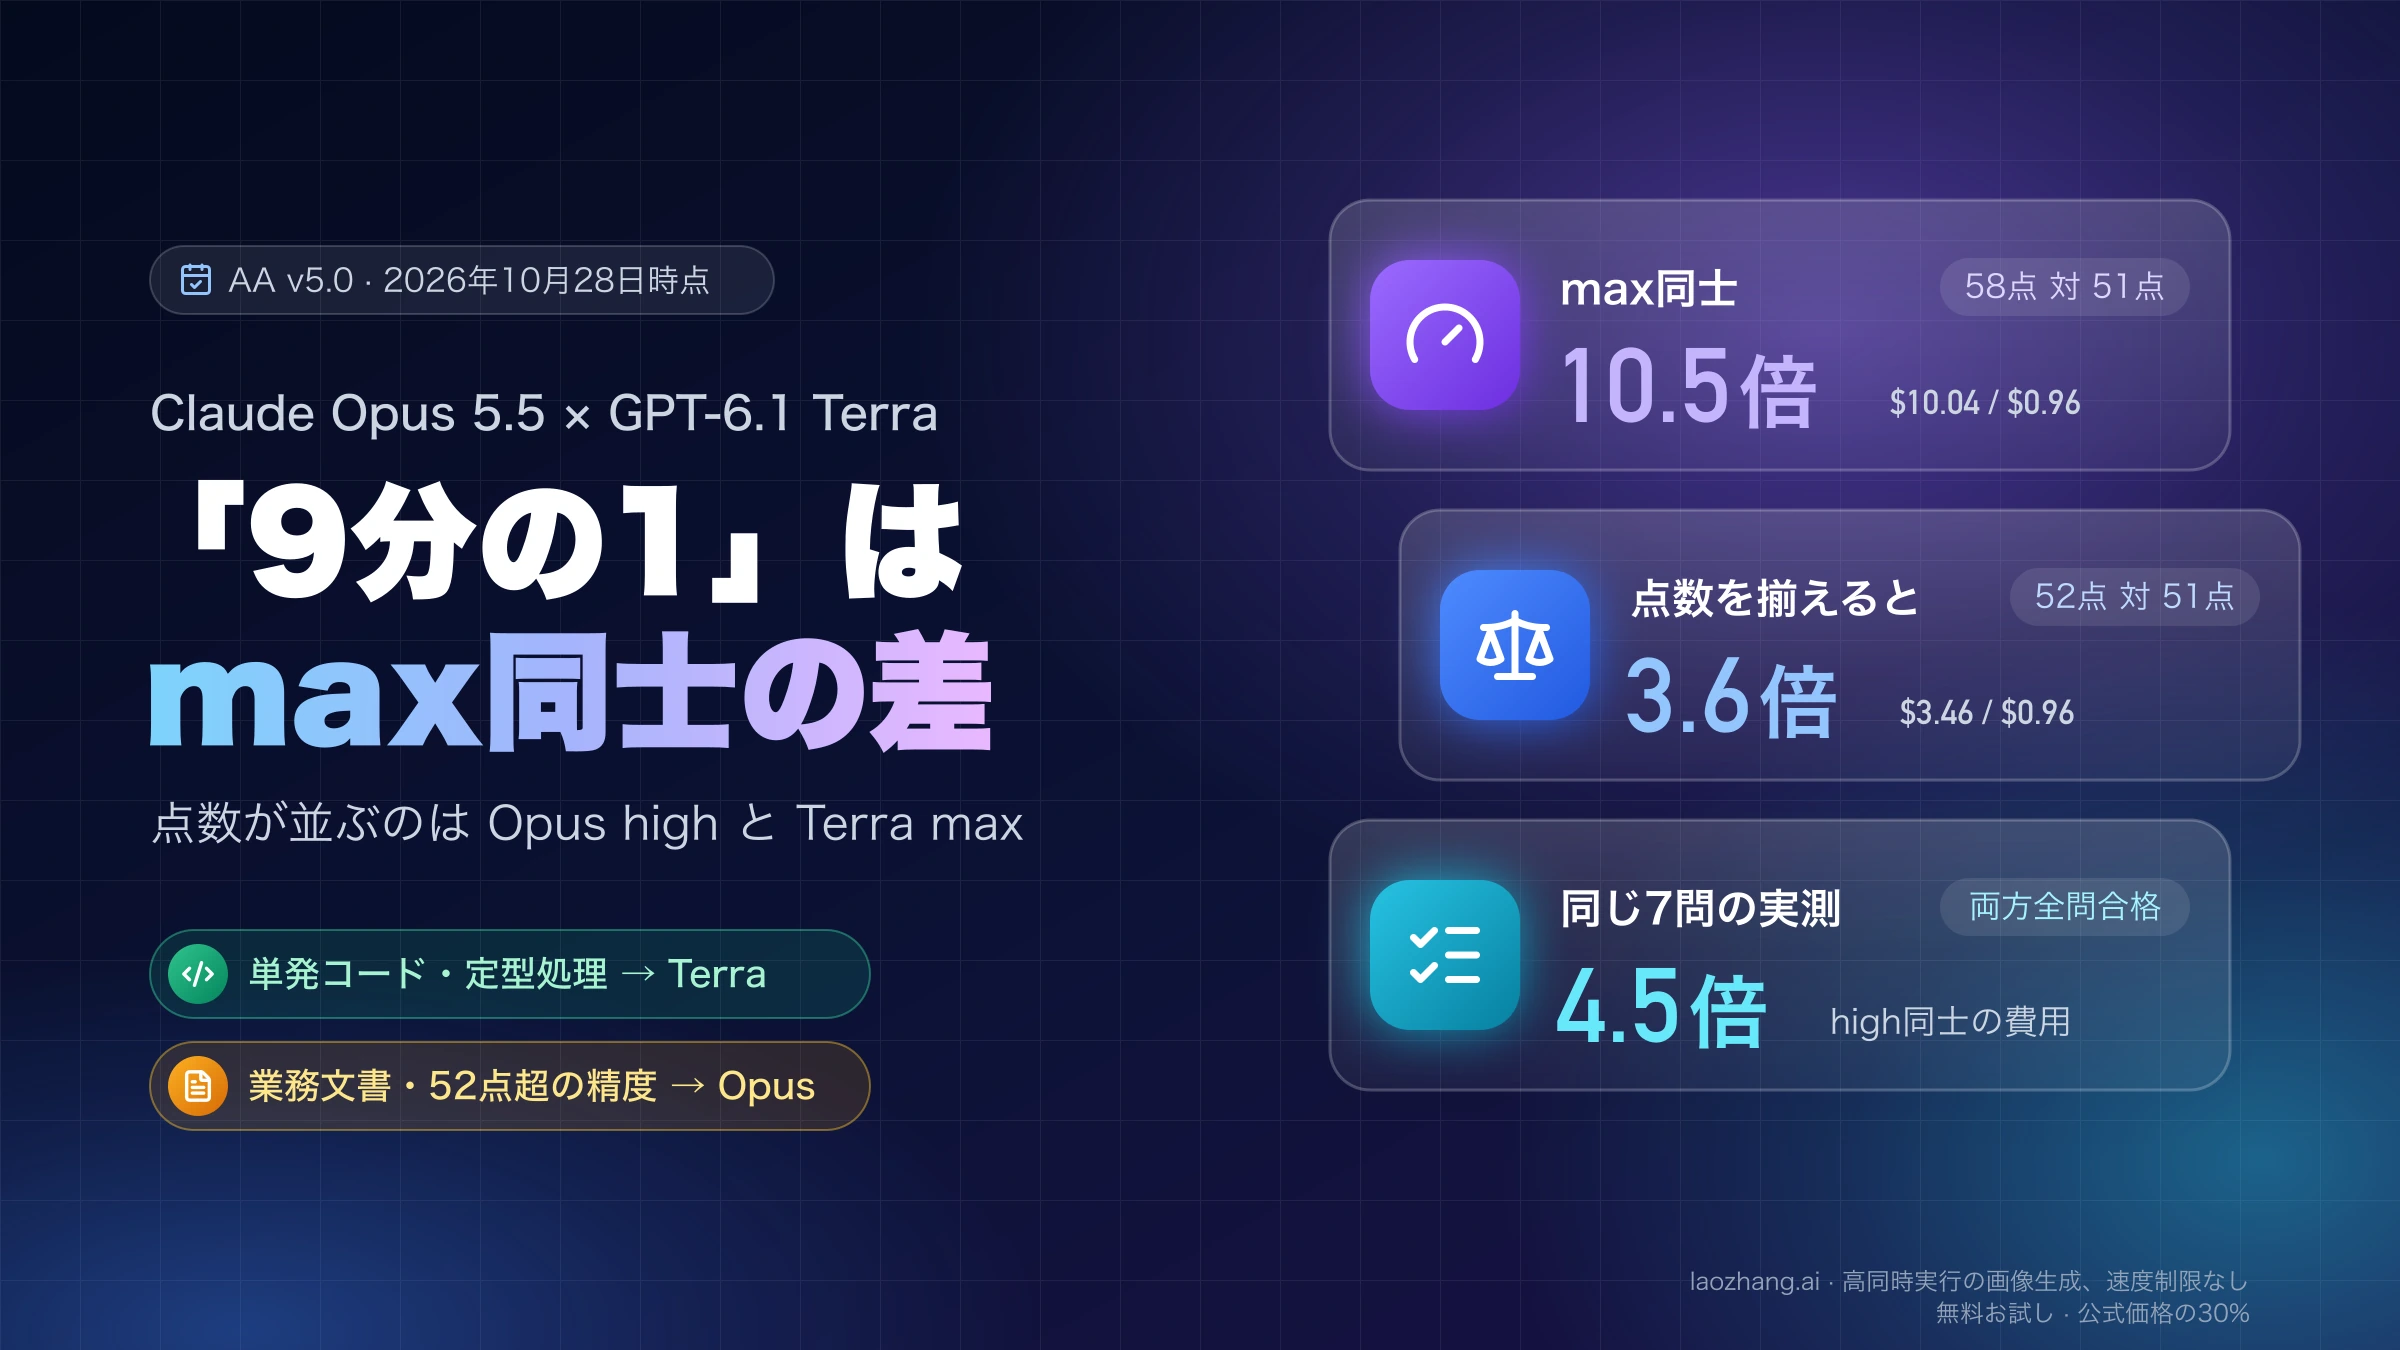
GPT-6 SolとSonnet 5、AstraとFable 5.1は単価が同じです。長文はClaude、キャッシュ多用はFable 5.1、最安はGPT-6 Lunaが有利です。
目次
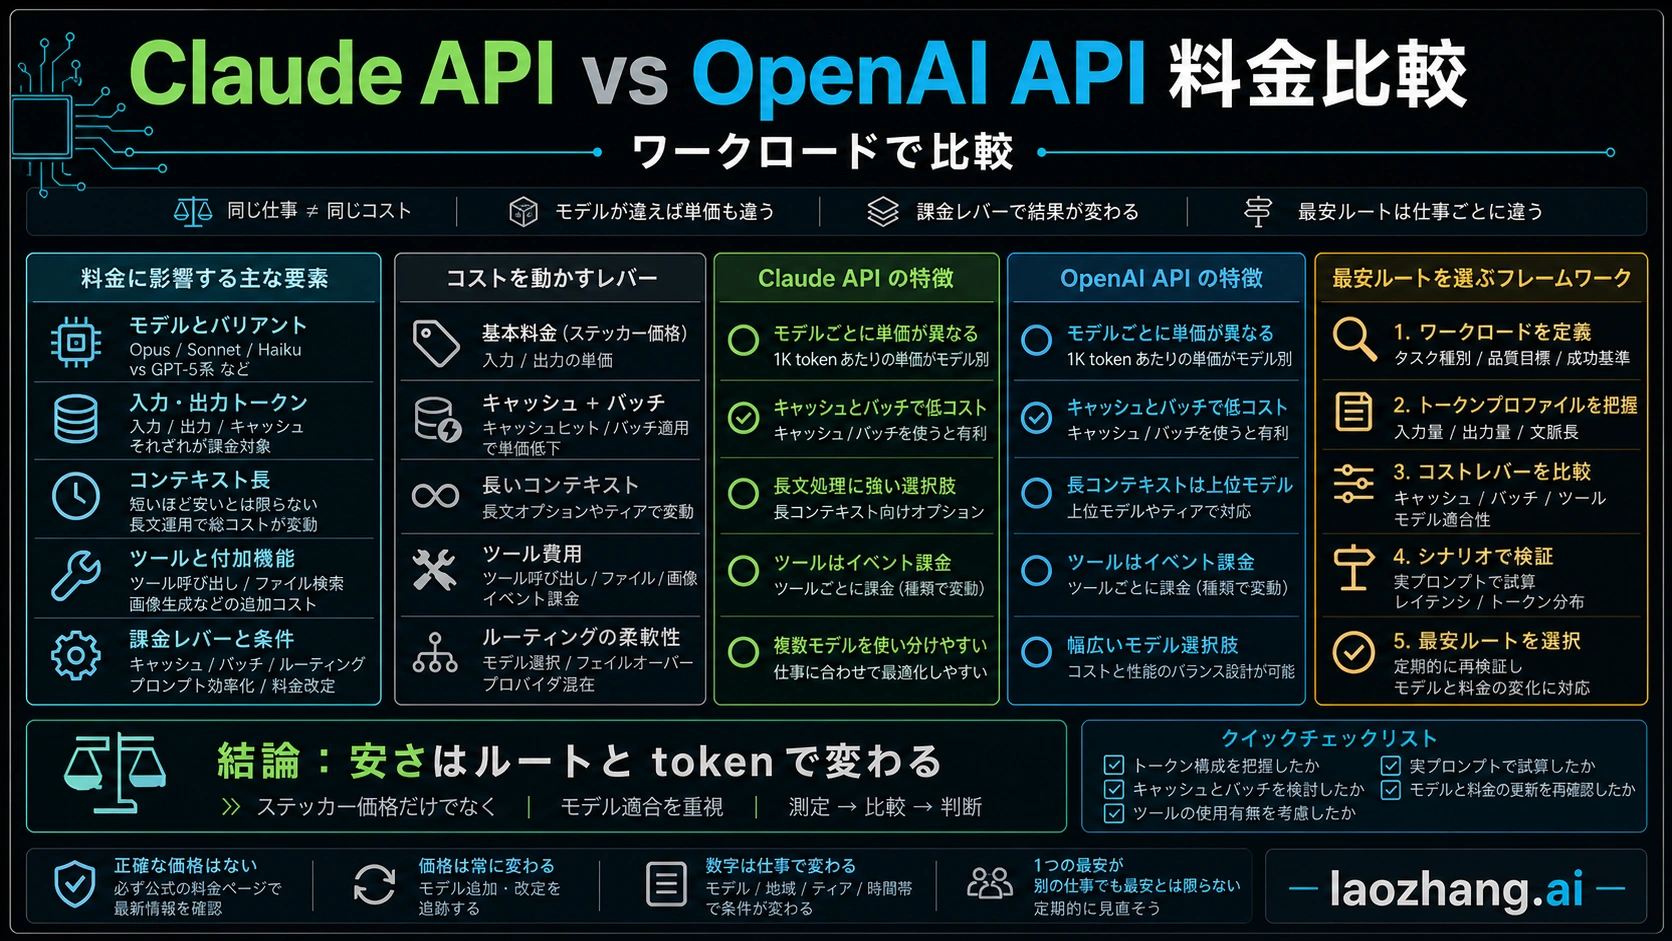
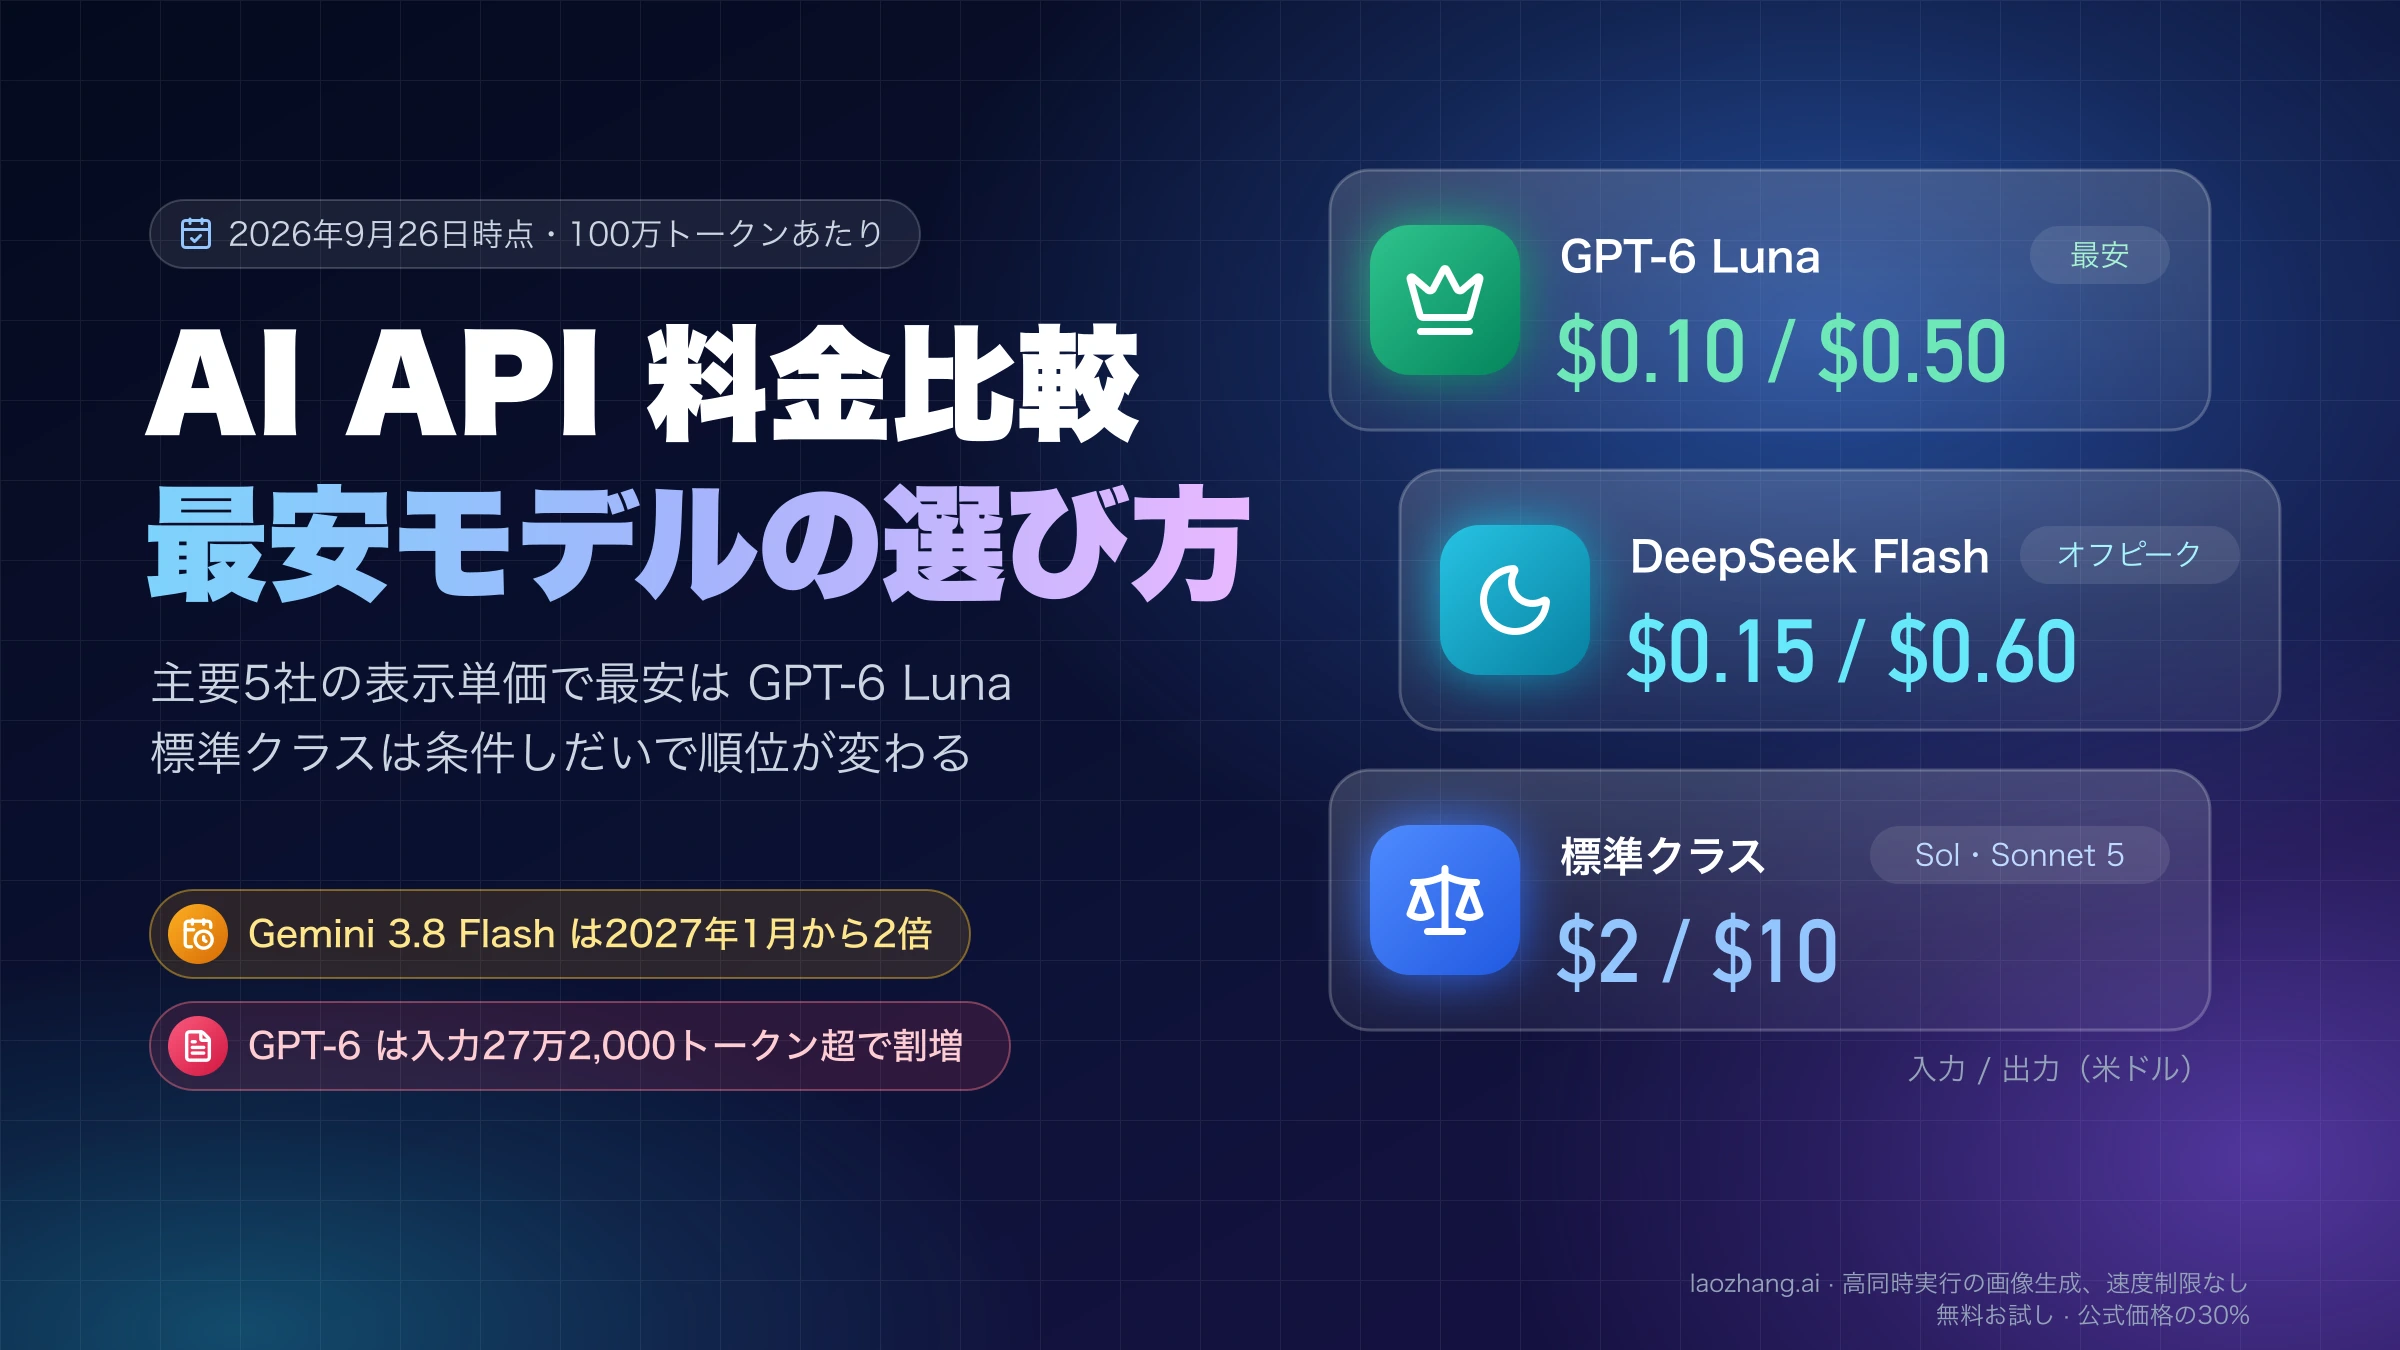
2026年9月26日時点の公式料金(100万トークンあたり、米ドル)では、OpenAIのGPT-6 SolとClaude Sonnet 5がどちらも入力$2/出力$10、GPT-6 AstraとClaude Fable 5.1がどちらも入力$10/出力$50です。この2組は、短い入力をキャッシュなしで送るなら、同じトークン数に対する請求額がまったく同じになります。単価が同じなのはこの2組だけで、GPT-6 LunaはClaude Haiku 4.5の10分の1、Claude Opus 5.5と同じ単価のGPT-6モデルはありません。
単価が同じ2組で差が出るのは、長い入力とキャッシュです。1リクエストの入力が27万2,000トークンを超えるとGPT-6はリクエスト全体が割増になり、割増のないClaudeが安くなります。キャッシュを何度も読む処理では、Fable 5.1のキャッシュヒット単価がAstraの4分の1で、Fable 5.1が安くなります。いちばん下の価格帯は単価そのものが違い、GPT-6 Lunaを持つOpenAIが圧倒的に安くなります。処理区分では、待てる処理は両社ともBatchで半額、速さを買うFast modeは対象モデルと倍率が違います。
比較できる組み合わせと公式単価
価格はOpenAIの料金ページとAnthropicの料金ページに載っている通常処理の単価です。ここでの組み合わせは価格帯上の位置をそろえたもので、性能が同じという意味ではありません。
| 価格帯 | モデル | 入力 | キャッシュヒット | キャッシュ書き込み | 出力 | 入力27万2,000トークン超 | コンテキスト上限(トークン) |
|---|---|---|---|---|---|---|---|
| 最安帯 | GPT-6 Luna | $0.10 | $0.01 | $0.125(30分)/$0.25(12時間) | $0.50 | 全体が$0.20/$0.75 | 105万 |
| 最安帯 | Claude Haiku 4.5 | $1 | $0.10 | $1.25(5分)/$2(1時間) | $5 | 送れない | 20万 |
| 標準 | GPT-6 Sol | $2 | $0.20 | $2.50(30分)/$5(12時間) | $10 | 全体が$4/$15 | 105万 |
| 標準 | Claude Sonnet 5 | $2 | $0.20 | $2.50(5分)/$4(1時間) | $10 | 割増なし | 100万 |
| 中間 | Claude Opus 5.5 | $4 | $0.20 | $5(5分)/$8(1時間) | $20 | 割増なし | 100万 |
| 最上位 | GPT-6 Astra | $10 | $1.00 | $12.50(30分)/$25(12時間) | $50 | 全体が$20/$75 | 105万 |
| 最上位 | Claude Fable 5.1 | $10 | $0.25 | $12.50(5分)/$20(1時間) | $50 | 割増なし | 100万 |
GPT-6の12時間キャッシュ書き込みは2026年10月20日に追加された区分で、Responses APIでのみ使えます。「入力27万2,000トークン超」の列は入力/出力の単価です。GPT-6ではキャッシュヒットと書き込みの単価も2倍になります。コンテキスト上限は、GPT-6の3モデルが105万トークン、Fable 5.1・Opus 5.5・Sonnet 5が100万トークン、Haiku 4.5だけが20万トークンです。最大出力はGPT-6とClaude 5系が12万8,000トークン、Haiku 4.5が6万4,000トークンです。
組ごとに見ると、関係は次のとおりです。
- 最安帯:LunaとHaiku 4.5はどちらも各社でいちばん安いモデルですが、単価は同じではありません。入力・出力ともLunaがHaiku 4.5の10分の1です。
- 標準:SolとSonnet 5は入力、キャッシュヒット、5分キャッシュの書き込み、出力の4項目すべてが同額です。
- 中間:Opus 5.5はSolの2倍、Astraの4割の単価で、GPT-6にはこの価格帯のモデルがありません。キャッシュヒットは$0.20でSolやSonnet 5と同じです。Solとの比較はOpus 5.5とGPT-6 Sol比較:料金2倍はどこに効くかが詳しいです。
- 最上位:AstraとFable 5.1は入力、書き込み、出力が同額で、キャッシュヒットだけが$1.00と$0.25で違います。
各モデルの単価をさらに細かく見たい場合は、GPT-6 Sol・Luna・AstraとTerraの違い:API料金と用途から選ぶ、GPT-6 Astra API料金:10種類の単価と長文・Batch・Fastの計算方法、Claude Fable 5.1のAPI料金:単価と月額の目安、Claude Sonnet 5の値上げは撤回。現在のAPI料金と予算の見直し方が役に立ちます。
短い入力でキャッシュなしなら、SolとSonnet 5、AstraとFable 5.1は同額
キャッシュを使わず、入力も27万2,000トークン以下なら、費用は「入力トークン×入力単価+出力トークン×出力単価」だけで決まります。月に入力1億トークン、出力2,000万トークンを使う場合の計算は次のとおりです。
| モデル | 月額の計算 | 月額 |
|---|---|---|
| GPT-6 Luna | 100×$0.10+20×$0.50 | $20 |
| Claude Haiku 4.5 | 100×$1+20×$5 | $200 |
| GPT-6 Sol | 100×$2+20×$10 | $400 |
| Claude Sonnet 5 | 100×$2+20×$10 | $400 |
| Claude Opus 5.5 | 100×$4+20×$20 | $800 |
| GPT-6 Astra | 100×$10+20×$50 | $2,000 |
| Claude Fable 5.1 | 100×$10+20×$50 | $2,000 |
計算式の100と20は、それぞれ100万トークン単位の入力量と出力量です。この表はトークン数が両社で同じと仮定しています。実際の請求では、同じ文章を何トークンと数えるかが会社ごとに違うため、単価が同額の組ではこの差がそのまま請求の差になります。
日本語では文字数とトークン数が比例しないうえ、会社ごとの数え方の比率も公開されていません。AnthropicはClaude 4.7以降のモデルが新しいトークナイザーを使い、同じテキストで従来より約30%多くトークンを数えると説明しています。Sonnet 5、Opus 5.5、Fable 5.1は新しいトークナイザー、Haiku 4.5は従来のトークナイザーです。仮に自社の日本語プロンプトでClaude側が1割多く数えるなら、単価が同じでもSonnet 5の請求はSolより1割高くなります。逆の結果が出ることもあるため、実際のプロンプトを数十件ずつ両方のAPIに送り、レスポンスのusageに返る入力・出力トークン数を比べるのが確実です。
出力の長さと再試行の回数も請求を動かします。同じ指示でも答えが長いモデル、形式崩れで送り直しが多いモデルは、単価が同じでも高くつきます。
入力が27万2,000トークンを超えるならClaudeが安い
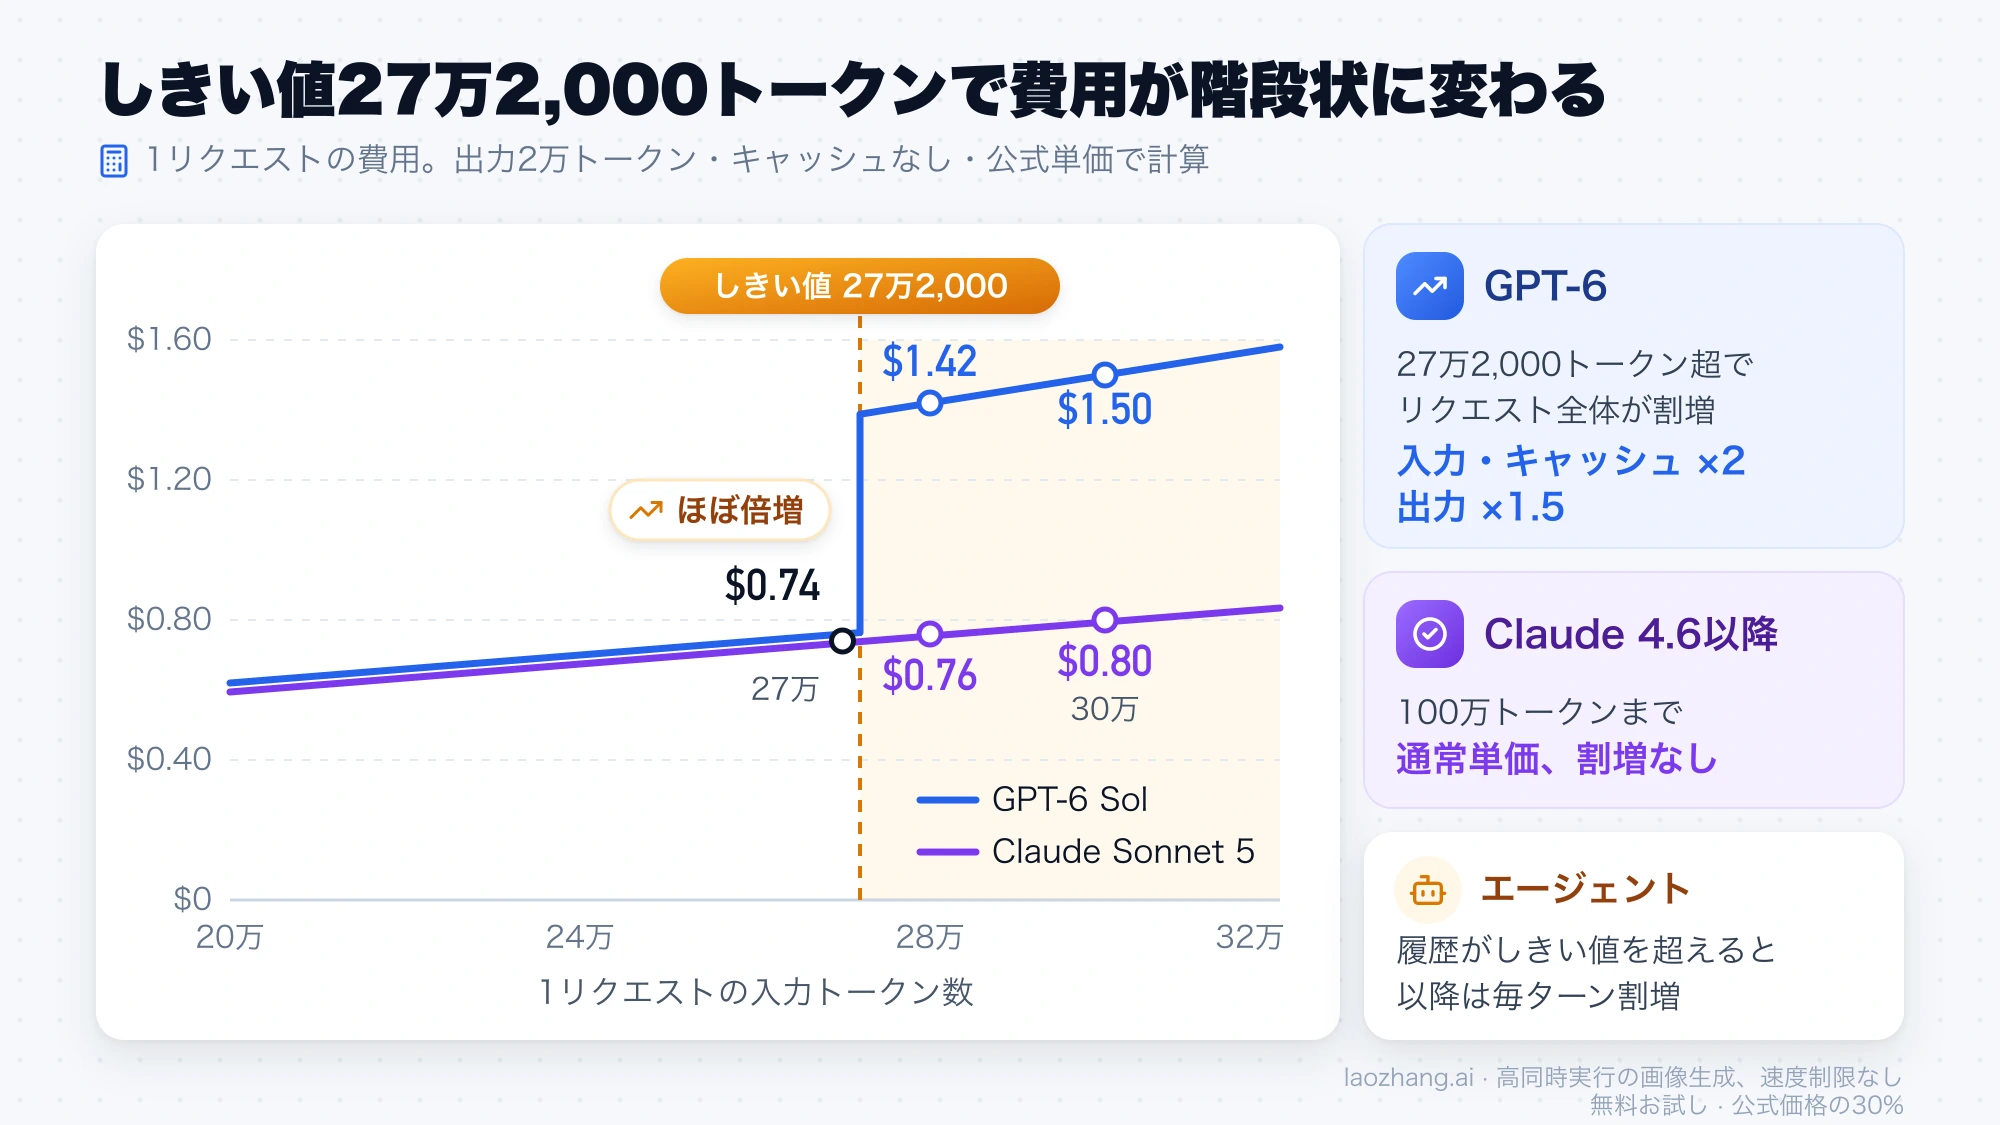
GPT-6は、1リクエストの入力が27万2,000トークンを超えると、そのリクエスト全体の入力とキャッシュの単価が2倍、出力が1.5倍になります。超えた部分だけではありません。一方、Claude 4.6以降のモデルは100万トークンのコンテキスト全体を通常単価で請求します。
入力30万トークン(キャッシュなし)、出力2万トークンのリクエスト1回で比べると次のようになります。
| モデル | 計算 | 1回あたり |
|---|---|---|
| GPT-6 Luna(割増後) | 0.3×$0.20+0.02×$0.75 | $0.075 |
| Claude Sonnet 5 | 0.3×$2+0.02×$10 | $0.80 |
| GPT-6 Sol(割増後) | 0.3×$4+0.02×$15 | $1.50 |
| Claude Opus 5.5 | 0.3×$4+0.02×$20 | $1.60 |
| Claude Fable 5.1 | 0.3×$10+0.02×$50 | $4.00 |
| GPT-6 Astra(割増後) | 0.3×$20+0.02×$75 | $7.50 |
| Claude Haiku 4.5 | 上限20万トークンのため送れない | ― |
標準の組ではSonnet 5がSolのほぼ半額、最上位の組ではFable 5.1がAstraの約半額です。割増後のSolは入力単価が$4でOpus 5.5と同じになり、差は出力単価の分だけになります。長い入力を送る処理でSolとOpus 5.5を比べるなら、単価の差は通常時の2倍ではなく、ほぼ同じと考えて品質で選べます。
しきい値の前後で費用は階段状に変わります。出力2万トークンのままSolの入力を27万から28万トークンに増やすと、1回あたり$0.74から$1.42にほぼ倍増します。Sonnet 5なら同じ変化で$0.74から$0.76です。会話履歴を毎回送り直すエージェントは、ターンを重ねるうちに入力がしきい値を超え、以降は毎ターン割増の単価になります。長い文書やリポジトリ全体を読ませる処理、長時間のエージェントは、入力の最大値を先に測っておくと見積もりが外れません。
なお、割増後のLunaでも1回$0.075で、最安であることは変わりません。長い入力でも品質が足りる処理なら、Lunaを最初に試す価値があります。
キャッシュを多用するなら最上位の組で差が開く
固定のシステムプロンプト、ツール定義、参照文書を毎回送る処理では、キャッシュヒットの単価が効きます。9万トークンの固定部分がキャッシュ済みで、毎ターン1万トークンの新しい入力と5,000トークンの出力がある場合、1ターンの費用は「0.01×入力単価+0.09×ヒット単価+0.005×出力単価」です。
| モデル | 1ターン | 9万トークンの書き込み(5分) | 書き込み1回+20ターン | キャッシュなしで20ターン |
|---|---|---|---|---|
| GPT-6 Luna | $0.0044 | $0.0113 | $0.099 | $0.25 |
| Claude Haiku 4.5 | $0.044 | $0.1125 | $0.99 | $2.50 |
| GPT-6 Sol | $0.088 | $0.225 | $1.985 | $5.00 |
| Claude Sonnet 5 | $0.088 | $0.225 | $1.985 | $5.00 |
| Claude Opus 5.5 | $0.158 | $0.45 | $3.61 | $10.00 |
| Claude Fable 5.1 | $0.3725 | $1.125 | $8.575 | $25.00 |
| GPT-6 Astra | $0.44 | $1.125 | $9.925 | $25.00 |
20ターンの列は、最初に固定部分を1回書き込み、その後の20ターンがすべてキャッシュに当たる前提です。キャッシュなしの列は、毎ターン10万トークンを通常の入力単価で送った場合です。
SolとSonnet 5は、ヒット単価も5分キャッシュの書き込み単価も同じなので、この計算でも同額です。Sonnet 5で1時間キャッシュを使うと書き込みが$0.36に上がり、20ターンで$2.12になります。Anthropicの説明では、5分キャッシュは1回読めば、1時間キャッシュは2回読めば書き込みの割増を回収できます。呼び出しの間隔が5分を超えがちなバッチ的な処理では、1時間キャッシュのほうが結果的に安くなることがあります。
最上位の組では、1ターンあたり0.09×($1.00−$0.25)=$0.0675の差がつき、20ターンで$1.35になります。書き込み単価は同じなので、差はすべてヒット単価から来ています。キャッシュを読む量が多いほど、Fable 5.1のほうが安くなります。
Opus 5.5はヒット単価が入力の5%で、Sonnet 5と同じ$0.20です。キャッシュ済み部分が大きく、新しい入力と出力が少ない処理ほど、Sonnet 5との差は2倍より小さくなります。Fable 5.1との使い分けはClaude Fable 5.1とOpus 5.5を比較:普段はどっちを使うべき?を参照してください。
Batch・Flex・Fast modeと地域指定の倍率
同じモデルでも、処理の区分と地域指定で単価が変わります。
| 条件 | OpenAI(GPT-6) | Claude |
|---|---|---|
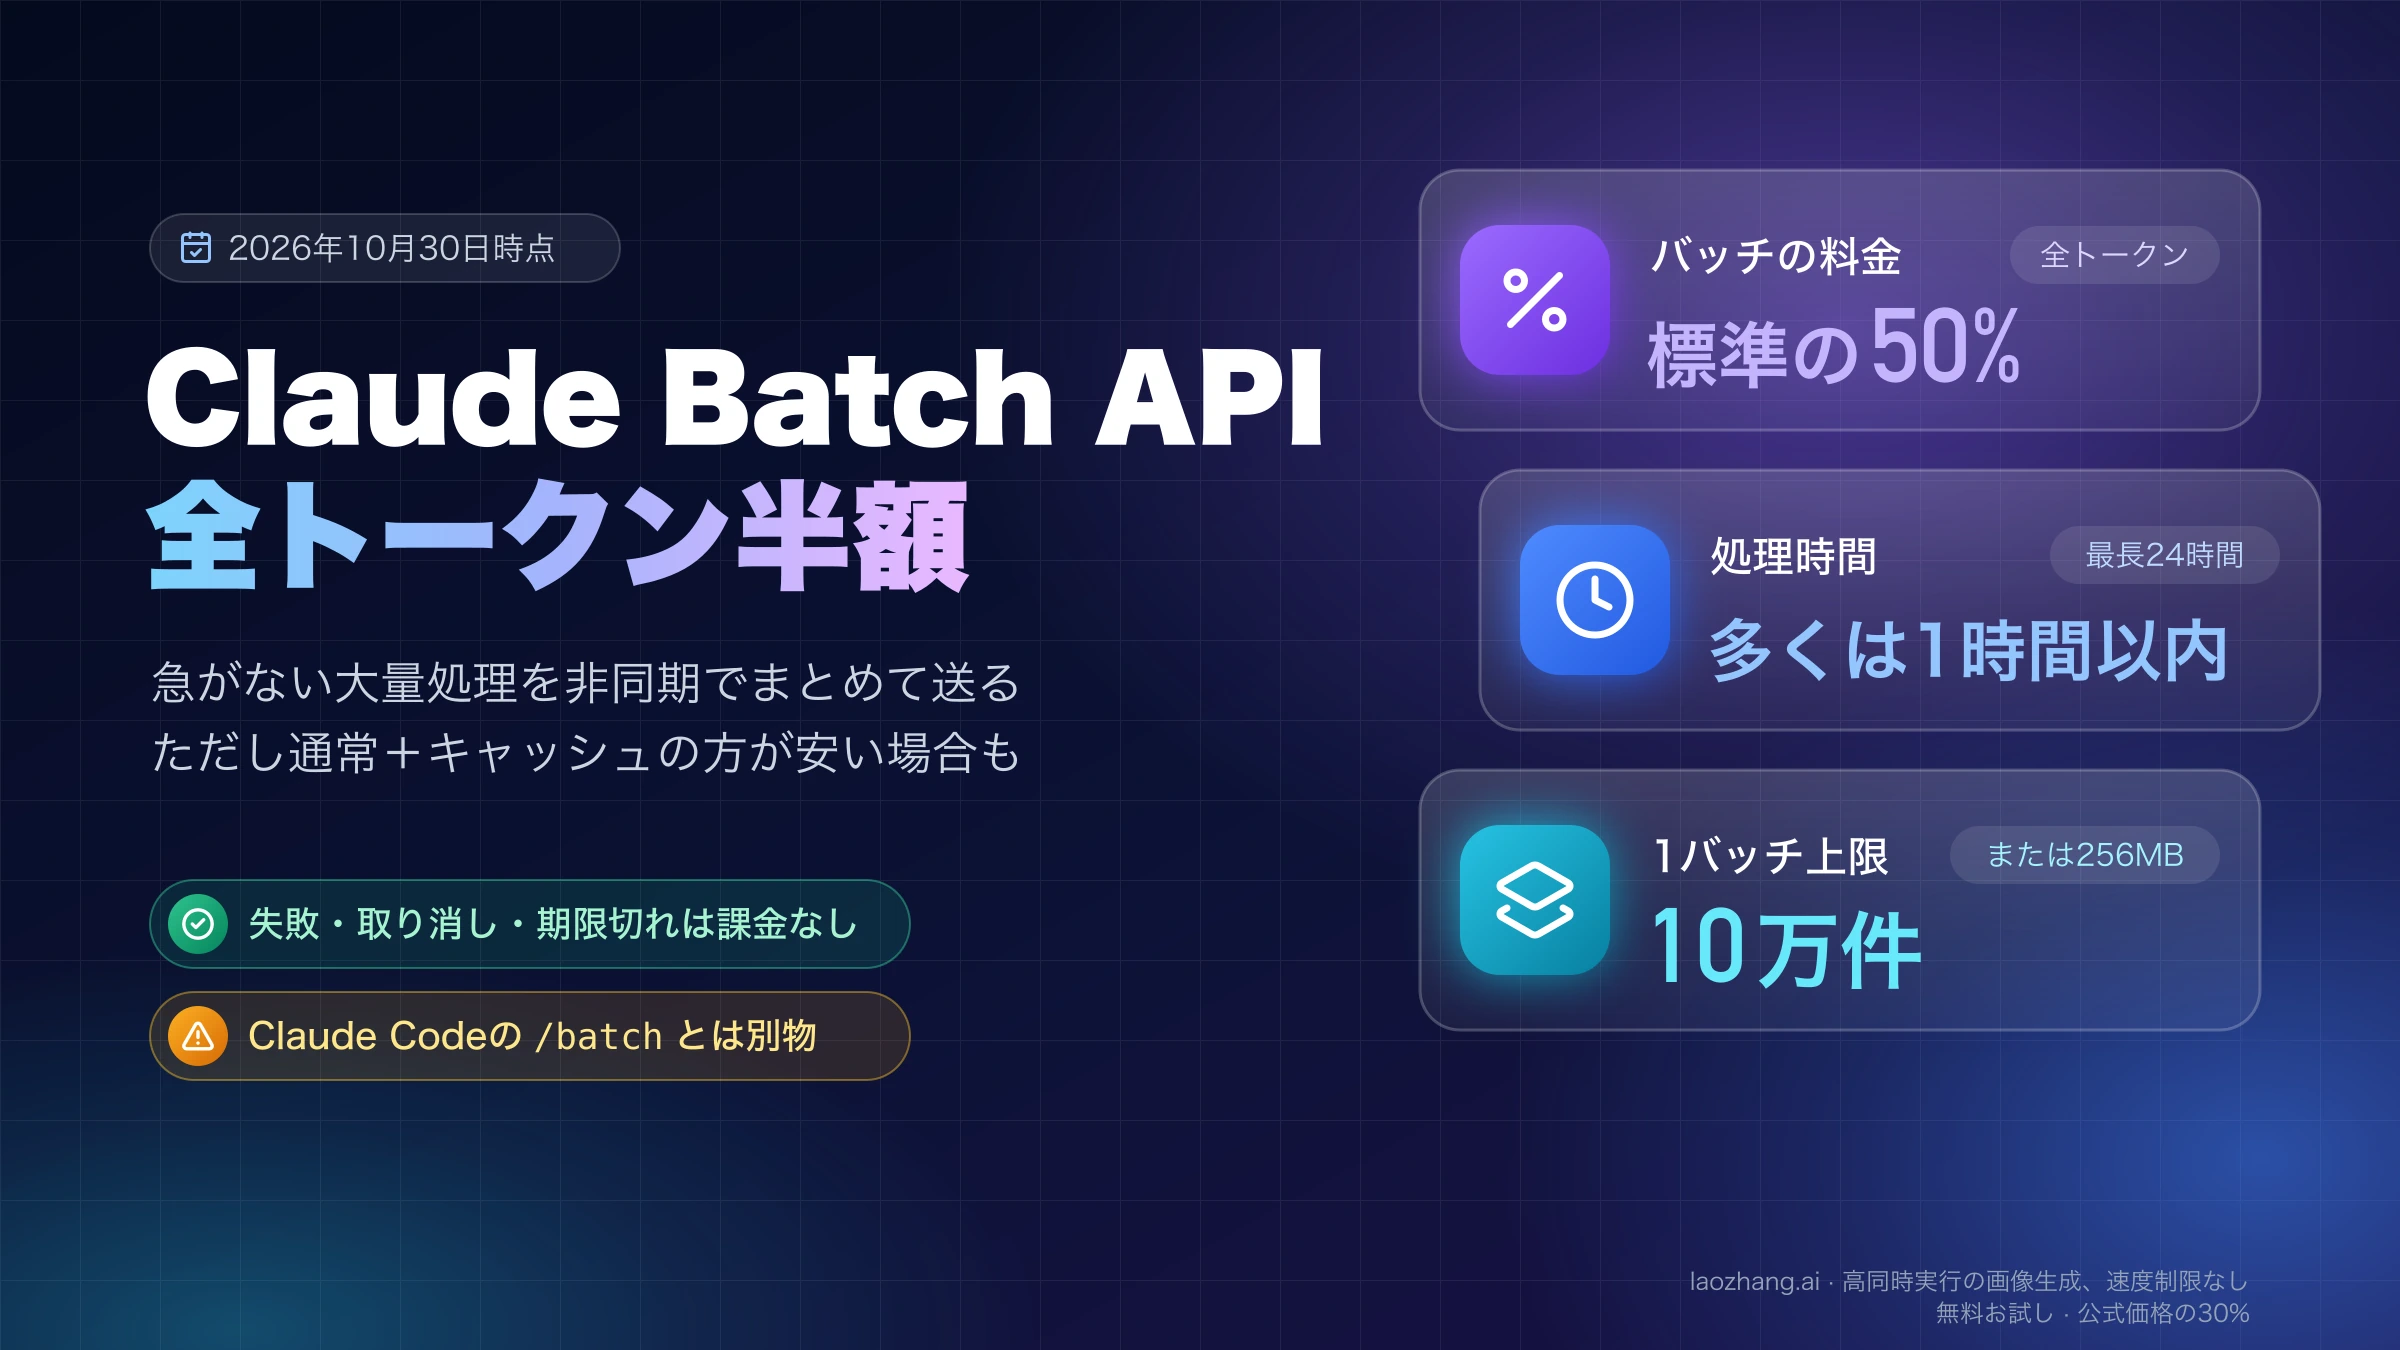
| 結果を待てる非同期処理 | Batchで半額(Sol $1/$5、Luna $0.05/$0.25、Astra $5/$25) | Batchで半額(Sonnet 5 $1/$5、Haiku 4.5 $0.50/$2.50、Opus 5.5 $2/$10、Fable 5.1 $5/$25) |
| Batch以外の割引区分 | Flexで半額 | 料金ページに該当する区分はありません |
| 速さを優先 | Fast modeで全GPT-6が2倍(例:Sol $4/$20) | Fast mode(研究プレビュー)は4モデルのうちOpus 5.5のみで$8/$40。Claude APIの直接利用だけで、Batchとは併用できません |
| 地域を指定した処理 | データレジデンシー対応エンドポイントは10%増し | inference_geo: "us"で米国内推論を指定すると1.1倍 |
評価、分類、大量の要約のように結果を待てる処理は、どちらのAPIでもBatchに回すだけで半額になります。Claudeはキャッシュの倍率とBatchの割引が重ねて適用されます。OpenAIのBatchの表でも、キャッシュヒットと書き込みの単価がそれぞれ半額になっています。文章を返す必要がない振り分けや採点だけなら、決めた選択肢と確率だけを返す判断モデルもあり、TypeSafe JevとLLMの使い分けで料金と向き不向きを解説しています。
OpenAIのFast modeは、2026年7月30日にPriority processingから名前が変わったものです。APIではservice_tier: "priority"とservice_tier: "fast"のどちらも使えます。
自分の使い方で見積もり、試す順番を決める
1リクエストの費用は、両社とも次の式で計算できます。
費用 =(キャッシュなし入力×入力単価
      +キャッシュヒット×ヒット単価
      +キャッシュ書き込み×書き込み単価
      +出力×出力単価)÷ 1,000,000
GPT-6で入力が27万2,000トークンを超えるリクエストは、4つの単価をすべて割増後の値に置き換えます。月額はこれにリクエスト数を掛け、再試行の分を上乗せし、地域指定があれば1.1倍にします。
見積もりの手順は次のとおりです。
- 実際の日本語プロンプトを数十件用意し、比べたい組の両方に送って
usageのトークン数を記録します。 - 入力のうちキャッシュに載せられる固定部分の割合、1回の出力の長さ、入力の最大値を記録します。
- 上の式で1リクエストあたりの費用を出し、月間の件数を掛けます。
- 結果を待てる処理を分けて、Batchの半額で計算し直します。
そのうえで、最初に試すモデルは次の条件で決まります。
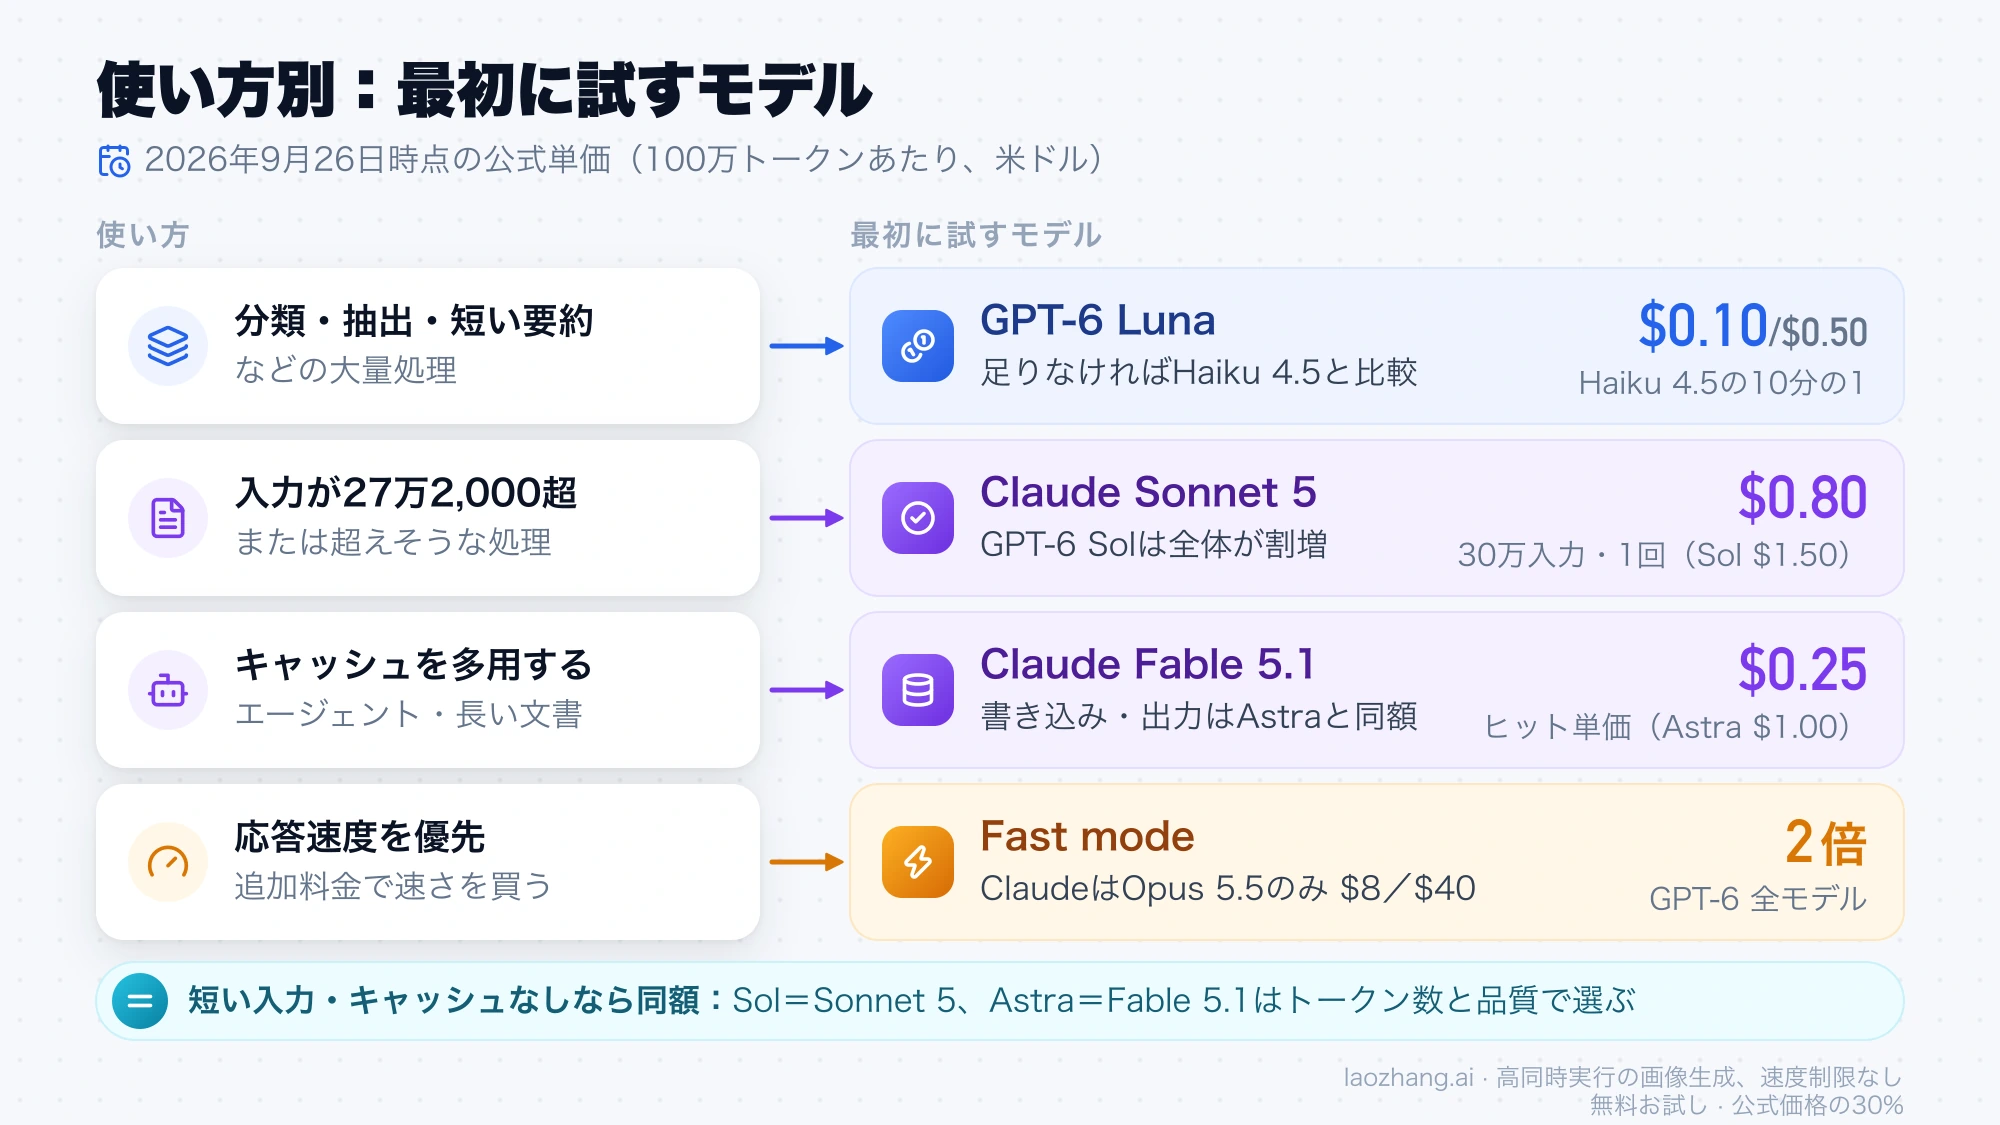
- 分類、抽出、短い要約などの大量処理は、単価がHaiku 4.5の10分の1のGPT-6 Lunaから試します。品質が足りない場合に、Haiku 4.5か標準の組と比べます。
- 日常の本番処理でSolとSonnet 5を比べる場合、短い入力なら単価は同じなので、手順1のトークン数と出力の品質で決めます。入力が27万2,000トークンを超える、または超えそうな処理はSonnet 5を先に試します。
- 最上位の組では、キャッシュを多用するエージェントや長い文書にはFable 5.1が有利です。短い入力でキャッシュが少ないならAstraと同額なので、品質で選びます。
- 応答速度を優先するなら、GPT-6は全モデルでFast mode(2倍)が使え、ClaudeはOpus 5.5だけがFast mode($8/$40)に対応しています。
主要5社を横断して最安モデルを探す場合は、AI API 料金比較:主要5社の単価と最安モデルの選び方を参照してください。
旧モデルから移る場合の単価の変化
GPT-5.6の各モデルもOpenAIの料金ページに引き続き掲載されています。GPT-5.6 Solは入力$4/出力$20で、この価格は少なくとも2026年11月21日まで適用される販促価格です。GPT-5.6 SolからGPT-6 Solに移ると、入力・出力とも単価は半分になります。GPT-5.6 Solの$4/$20はOpus 5.5と同じ単価ですが、GPT-6の世代ではありません。GPT-5.6 Terraは$2/$12、GPT-5.6 Lunaは$0.20/$1.20です。
Claude側では、Opus 5.5の$4/$20がOpus 5の$5/$25より2割安くなっています。Haiku 4.5からSonnet 5以降に切り替える場合は、単価の差に加えて、新しいトークナイザーでトークン数が増える点も見込んでおく必要があります。Opus 5.5の単価と利用枠の詳細はClaude Opus 5.5の料金と上限リセット権:API単価、使える枠、確認手順にあります。
公式API以外の請求
ここまでの数字は、OpenAIとAnthropicのAPIを直接使う場合の公式単価です。ChatGPTやClaudeの月額プランはAPIの請求とは別で、Claude Codeを大量に使う場合の選び方はClaude Code はサブスクと API どっち:重度ユーザーの損益分岐を参照してください。
クラウド経由の場合、Amazon Bedrock上のOpenAIモデルは商用リージョンでOpenAIの直接価格と同じ単価をAWSが請求します。Bedrock上やGoogle Cloud上のClaudeは各社が独自の地域別価格を設定しています。中継サービスやゲートウェイの価格は、それぞれの事業者との別契約で決まります。選び方は最安の LLM API プロバイダー:価格、品質、遅延、Gateway リスクで選ぶを参照してください。
よくある質問
Claude APIとOpenAI APIはどちらが安いですか?
価格帯によって違います。最安帯ではGPT-6 LunaがClaude Haiku 4.5の10分の1で、OpenAIが安くなります。標準のSolとSonnet 5、最上位のAstraとFable 5.1は通常単価が同じで、入力が27万2,000トークンを超える処理ではClaudeが安く、キャッシュを多く読む最上位の処理ではFable 5.1が安くなります。
GPT-6 SolとClaude Sonnet 5は同じ性能ですか?
同じ単価で並んでいるだけで、性能が同じという意味ではありません。短い入力では請求が同額になるため、実際のタスクでの品質、出力の長さ、同じ日本語テキストのトークン数で比べて選びます。
27万2,000トークン超の割増はキャッシュにもかかりますか?
かかります。GPT-6では入力が27万2,000トークンを超えたリクエスト全体で、入力・キャッシュヒット・キャッシュ書き込みが2倍、出力が1.5倍になります。GPT-6 Solならキャッシュヒットが$0.40、書き込みが$5になります。
日本語だとどちらがトークンを多く使いますか?
両社間の比率は公開されていないため、自分のテキストで測るしかありません。AnthropicはClaude 4.7以降の新しいトークナイザーが従来より約30%多くトークンを数えると説明しています。同じプロンプトを両方のAPIに送り、レスポンスのusageで入力トークン数を比べてください。
参考資料2
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月26日。
参考資料2
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月26日。