Qwen 4 Max vs Opus 5.5: cuál conviene y cuándo Qwen sale más caro
Qwen 4 Max ahorra en peticiones cortas si puedes esperar; en la batería difícil de Artificial Analysis, Opus 5.5 en medium puntúa más y cuesta menos.
En esta página
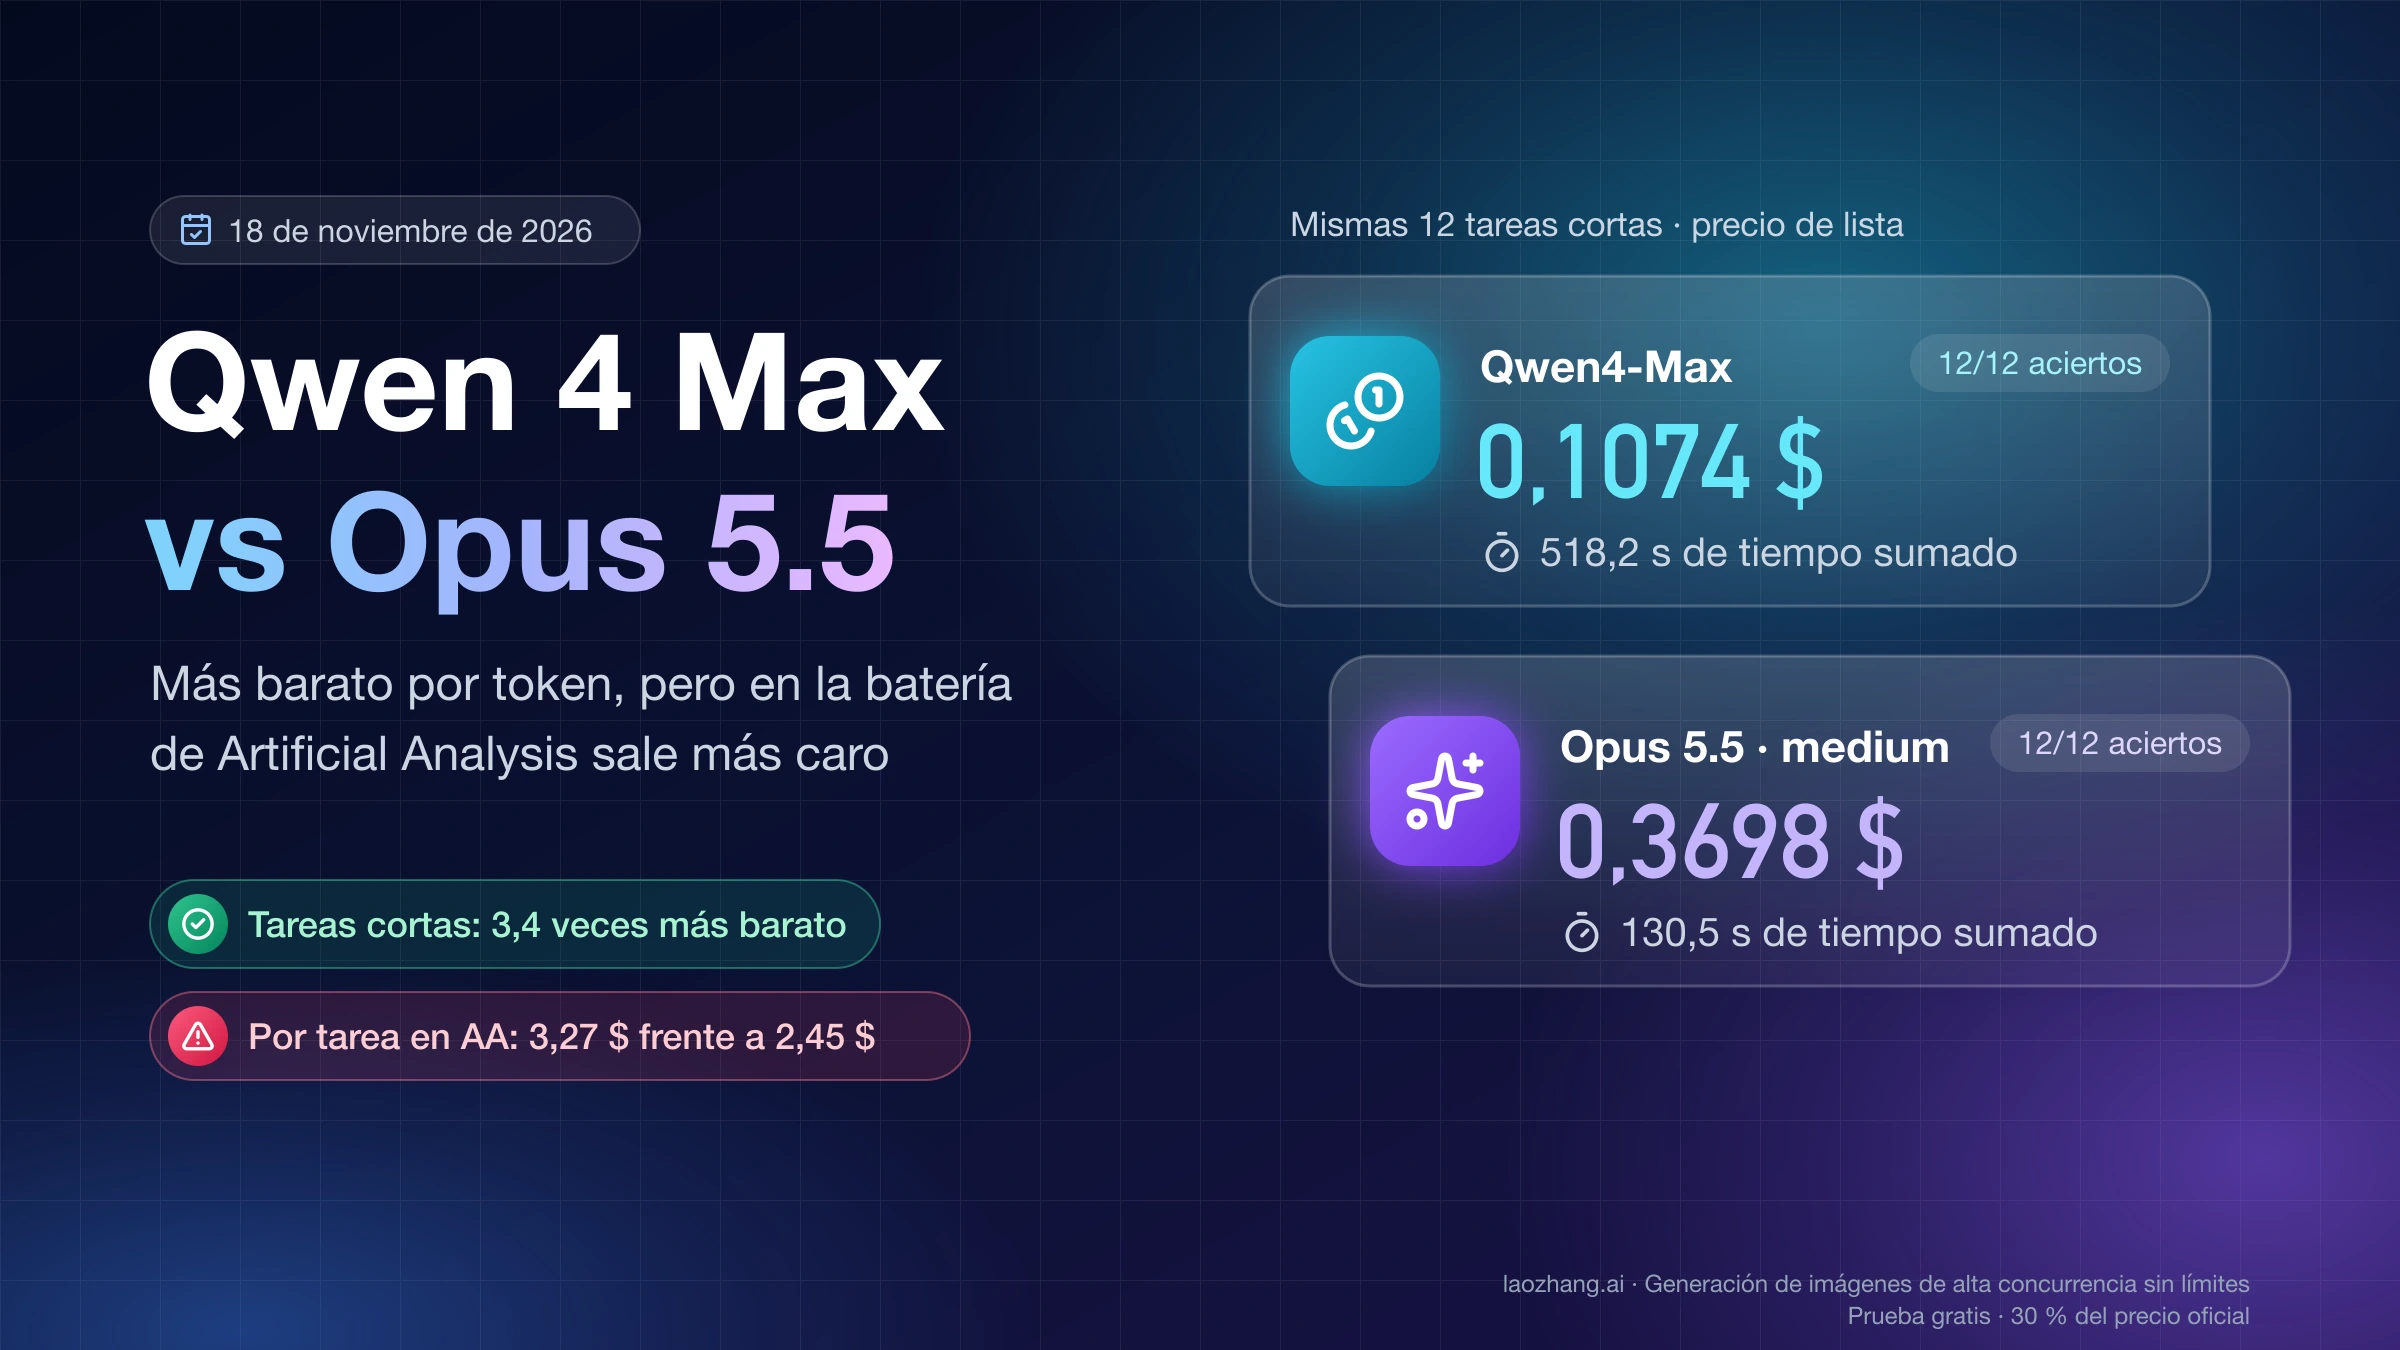
Si pagas Claude Opus 5.5 por token, Qwen 4 Max (qwen4-max en la API de Alibaba Cloud) te ahorra dinero en las peticiones cortas que corren en segundo plano, sin nadie esperando la respuesta. El razonamiento largo y difícil y el uso interactivo siguen saliendo mejor con Opus 5.5 en medium, que puntúa más y responde mucho antes. El 18 de noviembre de 2026 se pasaron las mismas 12 tareas cortas por los dos modelos: Qwen4-Max, con su configuración por defecto, acertó las 12 igual que Opus y costó 3,4 veces menos a precio de lista, pero hizo esperar unas 4 veces más.
En la batería larga y difícil de Artificial Analysis la cuenta se da la vuelta. Qwen4-Max razona por defecto y ese razonamiento se cobra como tokens de salida, así que en su Intelligence Index (v5.0.1, a 18 de noviembre de 2026) cada tarea le cuesta 3,27 $ y 32,3 minutos con 43 puntos, mientras que Opus 5.5 en medium saca 48 puntos con 2,45 $ y 6,9 minutos. Ahí, que su token sea entre 2,7 y 4,4 veces más barato no compensa todo lo que genera. No es una regla general: en una tarea de agente de programación medida por atomicagent.io, Qwen costó menos que Opus en medium, aunque tardó unas 6 veces más.
Si decides mover parte del trabajo a Qwen, limita su razonamiento con enable_thinking: false o con thinking_budget, porque en la misma prueba reasoning_effort: "low" no ahorró nada. Qwen4-Max está disponible desde el 16 de noviembre de 2026, así que las cifras de Artificial Analysis corresponden a sus dos primeros días y pueden cambiar.
¿Qwen 4 Max u Opus 5.5? Qué usar según tu tipo de trabajo
La regla corta: manda a Qwen4-Max lo que es corto, comprobable y puede esperar, y deja en Opus 5.5 lo que es largo, difícil o tiene a alguien delante de la pantalla esperando. Qwen 4 Max, Qwen4-Max y qwen4-max son el mismo modelo; «Qwen 4» a secas abarca también Qwen4-Flash y Qwen4-27B, que son modelos distintos y más pequeños.
| Si tu trabajo es… | Empieza con | Por qué |
|---|---|---|
| Muchas peticiones cortas de un turno (extraer datos, clasificar, funciones pequeñas, resúmenes) que se procesan en segundo plano | Qwen4-Max con el razonamiento limitado | En la prueba de 12 tareas acertó lo mismo que Opus por bastante menos dinero |
| Chat, asistentes de código o agentes en los que alguien espera cada paso | Opus 5.5 en medium | Qwen tardó mucho más en las mismas tareas y, en Artificial Analysis, necesita unos 149 s hasta el primer token de la respuesta |
| Razonamiento largo y difícil, código de varios pasos, ciencia | Opus 5.5 en medium o high | En el índice de Artificial Analysis, Opus en medium puntúa más y cuesta menos por tarea |
| Agentes de programación que trabajan solos, sin nadie esperando cada paso | Prueba los dos con tus tareas | En una prueba de agente de atomicagent.io, Qwen salió más barato gracias a la caché, pero mucho más lento |
| Logs y documentos largos de los que hay que sacar cifras exactas | Qwen4-Max, si puedes esperar | En un log de 146 KB acertó igual por menos de la mitad del coste, con seis veces más espera |
| Automatización de flujos de trabajo y documentos de negocio, finanzas o estrategia | Prueba Qwen4-Max con tus casos | Son sus mejores subpuntuaciones en Artificial Analysis, por encima de Opus en medium |
| Entrada de vídeo | Qwen4-Max | Opus 5.5 solo acepta texto e imagen |
| Gastar lo mínimo con una calidad aceptable | Compara también con Opus 5.5 en low | Es la configuración más barata por tarea en Artificial Analysis, aunque con menos puntos |
Al comparar, empareja bien los niveles de razonamiento. Qwen4-Max solo tiene low, high y xhigh, y si no indicas nada usa high (un medium se convierte en high); Opus 5.5 tiene low, medium, high, xhigh y max. Los nombres no equivalen entre modelos, así que tanto la prueba de 12 tareas como Artificial Analysis enfrentan Qwen por defecto con Opus en medium y en high, y lo que cuenta en cada caso es el resultado, el coste y la espera, no que dos niveles se llamen igual.
Mismas 12 tareas cortas: ¿quién acierta, cuánto cuesta y cuánto tarda?
En peticiones cortas de un turno, Qwen4-Max por defecto resolvió lo mismo que Opus 5.5 en medium por 3,44 veces menos dinero y con casi 4 veces más espera. Las llamadas pasaron por la pasarela de LaoZhang con los mismos enunciados y los mismos correctores automáticos (tests ocultos o respuestas exactas). Qwen4-Max se ejecutó el 18 de noviembre de 2026 por Chat Completions en streaming, sin reasoning_effort (es decir, en high) y con low; las filas de Opus 5.5 en medium y high son de las mismas tareas, ocho ejecutadas el 11 de noviembre y cuatro el 18.
Las tareas eran un problema de enunciado, fusionar intervalos, un parser de duraciones, las palabras más frecuentes de un texto, un resumen en cinco puntos de un documento de unos 11.000 tokens, un evaluador de expresiones, un separador de líneas CSV, un razonamiento con sumas de dígitos, comparar versiones semver, comprobar rangos semver, aritmética a partir de unas notas y un ejercicio solo con la biblioteca estándar.
| Configuración | Aciertos | Tokens de salida (de ellos, razonamiento) | Tiempo sumado | Coste a precio de lista |
|---|---|---|---|---|
Qwen4-Max por defecto (high) | 12/12 | 15.915 (10.465) | 518,2 s | 0,1074 $ |
Qwen4-Max low | 12/12 | 16.924 (11.237) | 567,3 s | 0,1119 $ |
Opus 5.5 medium | 12/12 | 11.833 (sin desglose) | 130,5 s | 0,3698 $ |
Opus 5.5 high | 12/12 | 13.674 (sin desglose) | 159,3 s | 0,4067 $ |
Qwen generó más tokens que Opus en medium (15.915 frente a 11.833, 1,34 veces más) y dos tercios eran razonamiento. Aun así salió más barato, porque su salida cuesta 4,44 veces menos por token. La diferencia de precio pesa más en las tareas con entrada larga: en el resumen del documento de 11.000 tokens, Qwen costó 0,0201 $ y Opus en medium 0,0907 $, 4,5 veces más. Pesa menos en la tarea que más razonamiento pidió: comprobar rangos semver le llevó a Qwen 5.317 tokens y 113,9 s, frente a 2.503 tokens y 22,6 s de Opus, y la ventaja de coste se quedó en 2,1 veces (0,0246 $ frente a 0,0528 $). Es la misma tendencia que, a mayor escala, aparece en Artificial Analysis. Frente a Opus en high, Qwen por defecto salió 3,79 veces más barato.
Casi toda esa espera es razonamiento previo: de los 518,2 s de Qwen por defecto, 443,5 s pasaron antes de que llegara el primer token de la respuesta. Para un proceso en lote da igual; para alguien que espera delante de un chat, no.
Esta prueba tiene límites claros. Hay una sola muestra por celda y son tareas pequeñas y bien definidas que las cuatro configuraciones resolvieron, así que mide coste, tokens y espera, no cuál de los dos es más capaz. Los tiempos son la duración total de cada llamada en la pasarela, con Qwen servido desde un proveedor en China continental y Opus medido otros días y en parte sin streaming, de modo que la diferencia de espera indica un orden de magnitud y no la latencia oficial de cada proveedor. Los costes salen del uso que devolvió cada llamada multiplicado por el precio de lista.
Un log de 146 KB: el 40 % del coste y 6 veces la espera
Con una entrada larga se repite el patrón. Los dos modelos tenían que sacar siete cifras exactas de un log de 146 KB y 1.500 líneas, unos 76.000 tokens de entrada, y las cuatro configuraciones acertaron las siete.
| Configuración | Fecha | Tokens de salida | Tiempo | Coste a precio de lista |
|---|---|---|---|---|
| Qwen4-Max por defecto | 18 de noviembre de 2026 | 16.767 | 352,5 s | 0,1895 $ |
Qwen4-Max low | 18 de noviembre de 2026 | 21.158 | 364,1 s | 0,2093 $ |
Opus 5.5 medium | 11 de noviembre de 2026 | 7.699 | 57,6 s | 0,4681 $ |
Opus 5.5 high | 11 de noviembre de 2026 | 8.136 | 59,0 s | 0,4769 $ |
Qwen por defecto costó 0,40 veces lo de Opus en medium, pero generó 2,2 veces más tokens y tardó 6,1 veces más: casi seis minutos frente a uno. Con low produjo todavía más tokens y costó más. Como 76.000 tokens quedan muy por debajo del millón de contexto que admiten los dos, este resultado no dice nada sobre entradas realmente largas.
¿Por qué Artificial Analysis dice que Qwen 4 Max cuesta más por tarea?
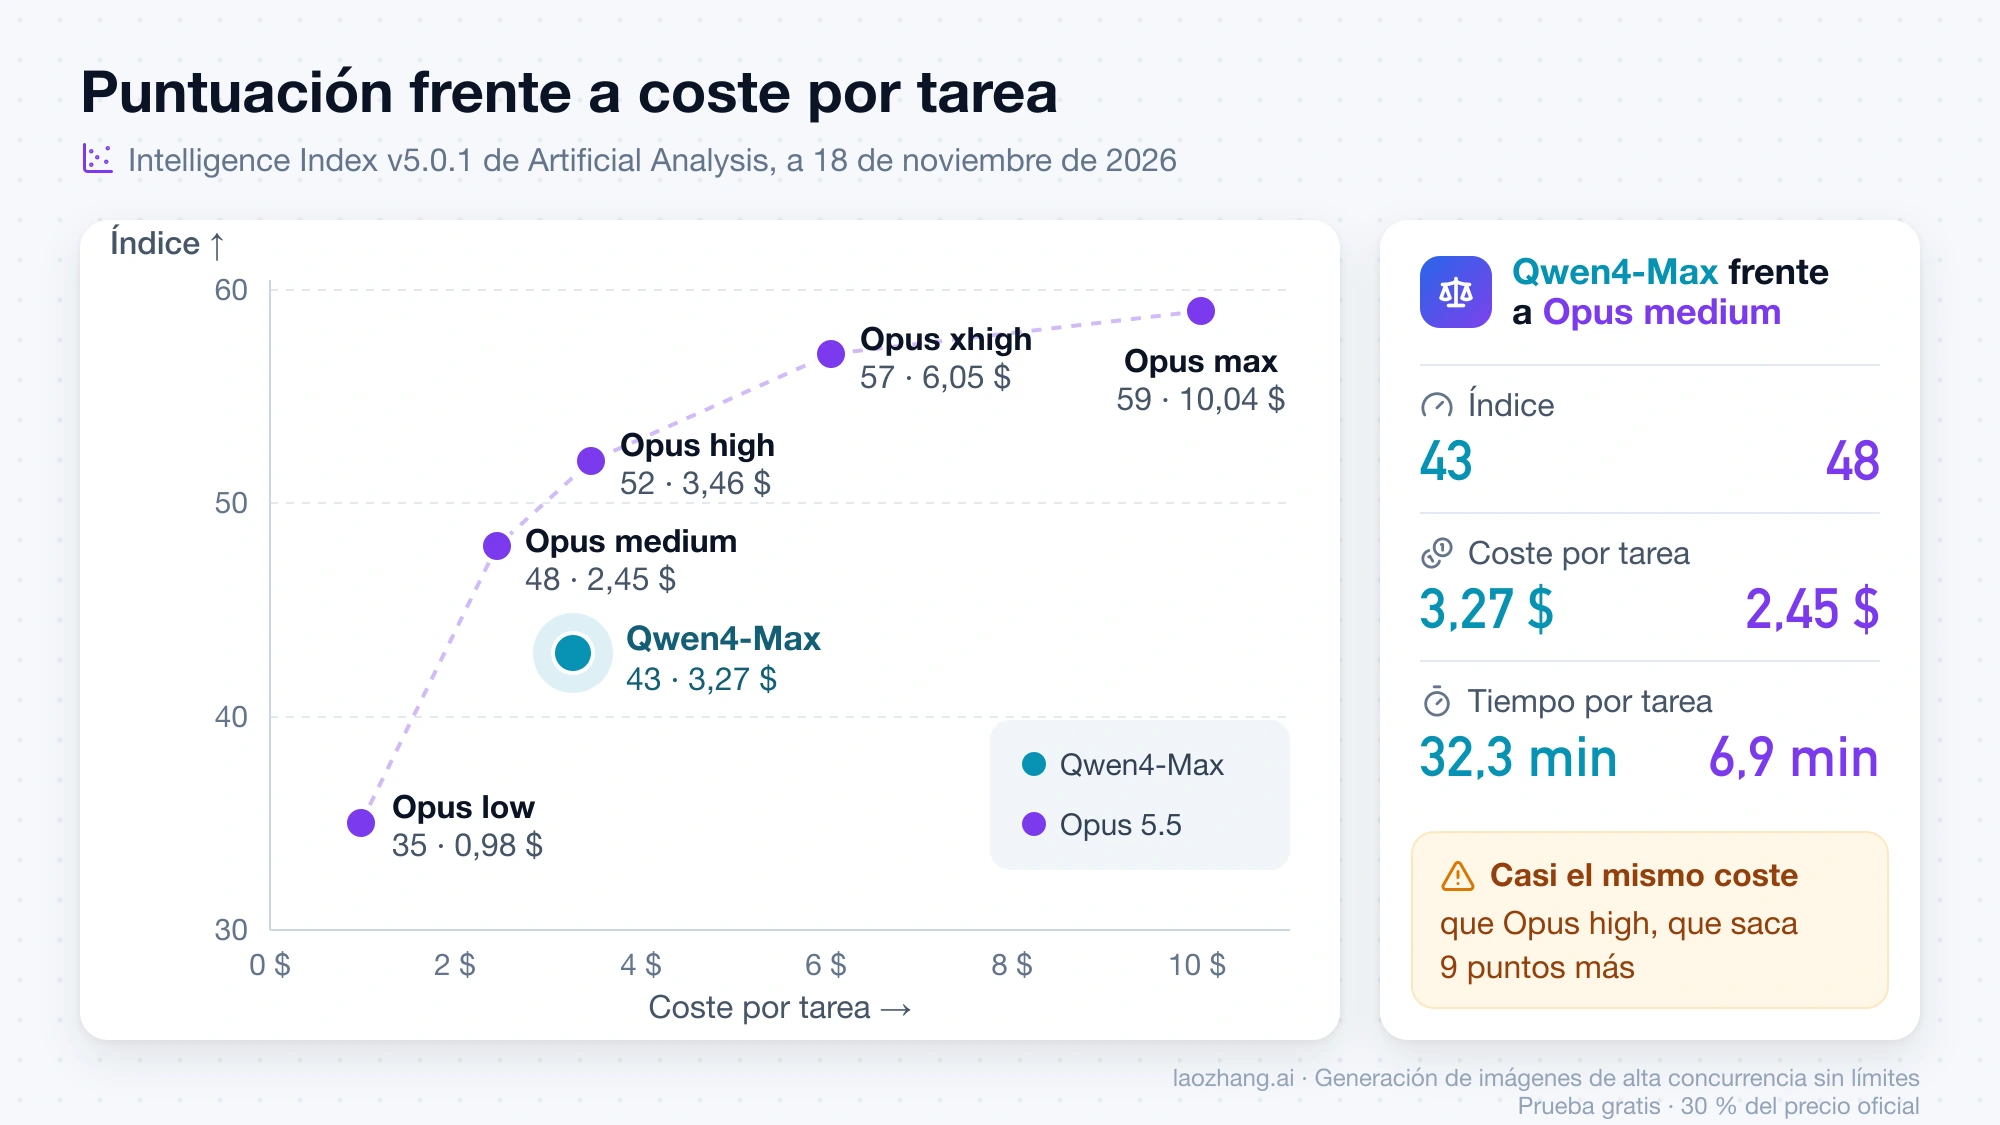
Porque en las tareas largas y difíciles de esa batería Qwen4-Max genera muchísimo más texto, casi todo razonamiento cobrado como salida. Artificial Analysis lo describe como «notablemente lento por tarea y muy verboso»: para completar su índice generó 127 millones de tokens, cuando la mediana es de 65,1 millones, y su tiempo por tarea multiplica por 2,6 la mediana de 12,4 minutos de los modelos comparables. Estas son las seis configuraciones de la comparativa de Artificial Analysis entre Qwen4-Max y Claude Opus 5.5, índice v5.0.1, a 18 de noviembre de 2026:
| Configuración | Índice | Coste por tarea | Tiempo por tarea | Velocidad de salida |
|---|---|---|---|---|
| Qwen4-Max | 43 | 3,27 $ | 32,3 min | 54 tokens/s |
Opus 5.5 low | 35 | 0,98 $ | 3,0 min | 105 tokens/s |
Opus 5.5 medium | 48 | 2,45 $ | 6,9 min | 106 tokens/s |
Opus 5.5 high | 52 | 3,46 $ | 9,3 min | 108 tokens/s |
Opus 5.5 xhigh | 57 | 6,05 $ | 15,8 min | 109 tokens/s |
Opus 5.5 max | 59 | 10,04 $ | 24,6 min | 117 tokens/s |
Qwen4-Max queda entre Opus en low y en medium por puntuación, pero cuesta casi lo mismo que Opus en high, que saca 9 puntos más y tarda 3,5 veces menos. Frente a medium, Opus puntúa 5 más con el 75 % del coste y alrededor de una quinta parte del tiempo. Artificial Analysis publica una sola entrada de Qwen4-Max sin indicar el nivel de razonamiento; el valor por defecto de la API es high. Para el uso interactivo importa además otra cifra de la ficha de Qwen4-Max en Artificial Analysis: 148,57 s hasta el primer token de la respuesta, casi dos minutos y medio de pensamiento antes de ver nada.
Ese resultado vale para la batería de Artificial Analysis, no para cualquier tarea larga. En la comparativa de Qwen 4 Max y Opus 5.5 de atomicagent.io, un agente de programación tenía que corregir 13 errores y añadir una función en una biblioteca de Python de unas 1.400 líneas, con 59 tests ocultos y tres ejecuciones por ajuste (Opus medido el 9 de noviembre y Qwen el 16, a través de OpenRouter). Todas las ejecuciones aprobaron, y Qwen en high costó unos 0,65 $ y 25 minutos por tarea frente a 0,97 $ y 4,2 minutos de Opus en medium: alrededor de un tercio menos de dinero y unas 6 veces más de tiempo. Los autores atribuyen buena parte del ahorro a la caché implícita de Alibaba, que en cada ejecución sirvió unos 2,7 millones de tokens de entrada desde caché; sin ella, solo la entrada habría superado los 4 $. Es una sola tarea, y ellos mismos advierten de que no dice cuál de los dos modelos es más capaz, pero muestra que en un agente que relee el mismo código una y otra vez la caché puede compensar la verbosidad.
Las cifras de «3 veces» o «10 veces más barato» que circulan en vídeos y redes miden otra cosa: el precio por token o una sola tarea. En X, por ejemplo, un usuario publicó una generación que le costó 6,53 $ con Qwen y 72,28 $ con Opus, unas 11 veces menos. Ese caso, la prueba de 12 tareas y el índice de Artificial Analysis pueden ser ciertos a la vez porque miden trabajos distintos: cuanto más razonamiento exige una tarea, más se come Qwen su ventaja de precio, salvo que la caché le devuelva parte. Lo que no funciona es mezclar fuentes, por ejemplo el coste por tarea de Artificial Analysis con el gasto de llamadas sueltas, porque cada batería tiene sus propias tareas y ajustes.
Benchmarks: dónde gana Qwen 4 Max y dónde Opus 5.5
Qwen4-Max destaca en automatización de flujos de trabajo y en tareas con documentos de negocio, y se queda atrás en ciencia, código difícil y conocimiento factual. Estas son las subpuntuaciones del índice v5.0.1 de Artificial Analysis a 18 de noviembre de 2026, con Opus 5.5 en medium y en max:
| Prueba | Qwen4-Max | Opus 5.5 medium | Opus 5.5 max |
|---|---|---|---|
| AutomationBench-AA | 72,6 % | 61,2 % | 69,5 % |
| AA-Briefcase | 1.686 | 1.617 | 1.800 |
| GDP.pdf | 26,2 % | 25,6 % | 26,2 % |
| Terminal-Bench 4.0 | 48,5 % | 52,5 % | 59,6 % |
| FrontierCode-AA 2.0 | 26,5 % | 33,1 % | 46,4 % |
| HLE-Diamond | 44,9 % | 51,4 % | 67,9 % |
| CritPt v2 | 43,0 % | 54,0 % | 68,0 % |
| Terminal-Bench-Science | 23,3 % | 43,3 % | 59,0 % |
| AA-Omniscience | 28 | 40 | 48 |
En AutomationBench-AA, Qwen4-Max saca la mejor nota de las seis configuraciones, por encima incluso de Opus en max, y en AA-Briefcase supera a Opus en medium aunque no a max. Por áreas, frente a Opus en medium queda ligeramente por delante en finanzas (54 frente a 51) y en estrategia y operaciones (57 frente a 56), empata en derecho (50) y queda por detrás en salud (48 frente a 51), ingeniería (50 frente a 54) y economía (51 frente a 53). La distancia grande está en ciencia y en código difícil: en Terminal-Bench-Science, Opus en medium casi dobla a Qwen.
Alibaba da otras cifras, que conviene leer como suyas. Según la información del lanzamiento recogida por la prensa, Qwen4-Max saca 75,7 en DeepSWE v1.1, la nota más alta entre los modelos comparados, Opus 5.5 incluido, y en Terminal-Bench 4.0 queda por detrás de Opus 5.5. El «62 % menos de coste por tarea» que se repite en redes compara Qwen4-Max con el anterior Qwen3.8-Max en Work360, una evaluación interna de Alibaba, no con Opus. El «50 % menos de tokens» que acompaña a esa cifra en una publicación muy compartida de Facebook no indica frente a qué se mide, y choca con la verbosidad que registra Artificial Analysis. Entre los usuarios, en un hilo de r/LocalLLaMA con más de 110 comentarios, uno lo resume de forma parecida al índice: Qwen 4 Max queda algo por debajo de Opus 5.5 en medium y claramente por encima de low.
Precio de la API de Qwen 4 Max y Opus 5.5 por millón de tokens
Qwen4-Max es más barato que Opus 5.5 en todas las columnas de la tarifa, y la diferencia es mayor en la salida, que es donde se cobra el razonamiento en los dos modelos. Estos son los precios de la ficha de Qwen4-Max en Alibaba Cloud Model Studio y de la página de precios de la API de Claude a 18 de noviembre de 2026:
| Por millón de tokens | Qwen4-Max | Claude Opus 5.5 |
|---|---|---|
| Entrada | 1,50 $ (International) · 1,413 $ (China y Global) | 4,00 $ |
| Salida, razonamiento incluido | 4,50 $ (International) · 4,24 $ (China y Global) | 20,00 $ |
| Lectura de caché | 0,075 $ en International, según Artificial Analysis y OpenRouter; caché explícita e implícita en todas las regiones | 0,20 $ |
| Escritura de caché | Sin dato en la ficha | 5,00 $ (5 minutos) · 8,00 $ (1 hora) |
| Batch: entrada / salida | Solo en la región China (Pekín): 0,707 $ / 2,12 $; sin batch en International ni en Global | 2,00 $ / 10,00 $ |
| Cuota gratuita | 1 millón de tokens durante 90 días, solo en International | — |
La región International se sirve desde Singapur. La región China (Pekín) y el ámbito Global (Hong Kong, Fráncfort, Virginia y Tokio) cobran algo menos, pero la inferencia por lotes de Qwen4-Max solo existe en Pekín, donde cuesta la mitad (en el modo Batch Chat, como descuento temporal): con una cuenta International no hay batch de Qwen, mientras que la API de Claude ofrece Batch para Opus 5.5 a mitad de precio. El precio de Qwen4-Max es el mismo con y sin razonamiento y vale para peticiones de hasta 1 millón de tokens, que es también su contexto máximo; la salida llega a 131.072 tokens, o 262.144 en modo de pensamiento. En OpenRouter, qwen/qwen4-max cuesta 1,425 $ de entrada y 4,275 $ de salida. Para el resto de la tarifa de Opus y cómo se reinician sus límites en los planes de Claude, consulta Claude Opus 5.5: precio de la API y restablecimiento de límites.
Cómo limitar el razonamiento de Qwen 4 Max: low no basta
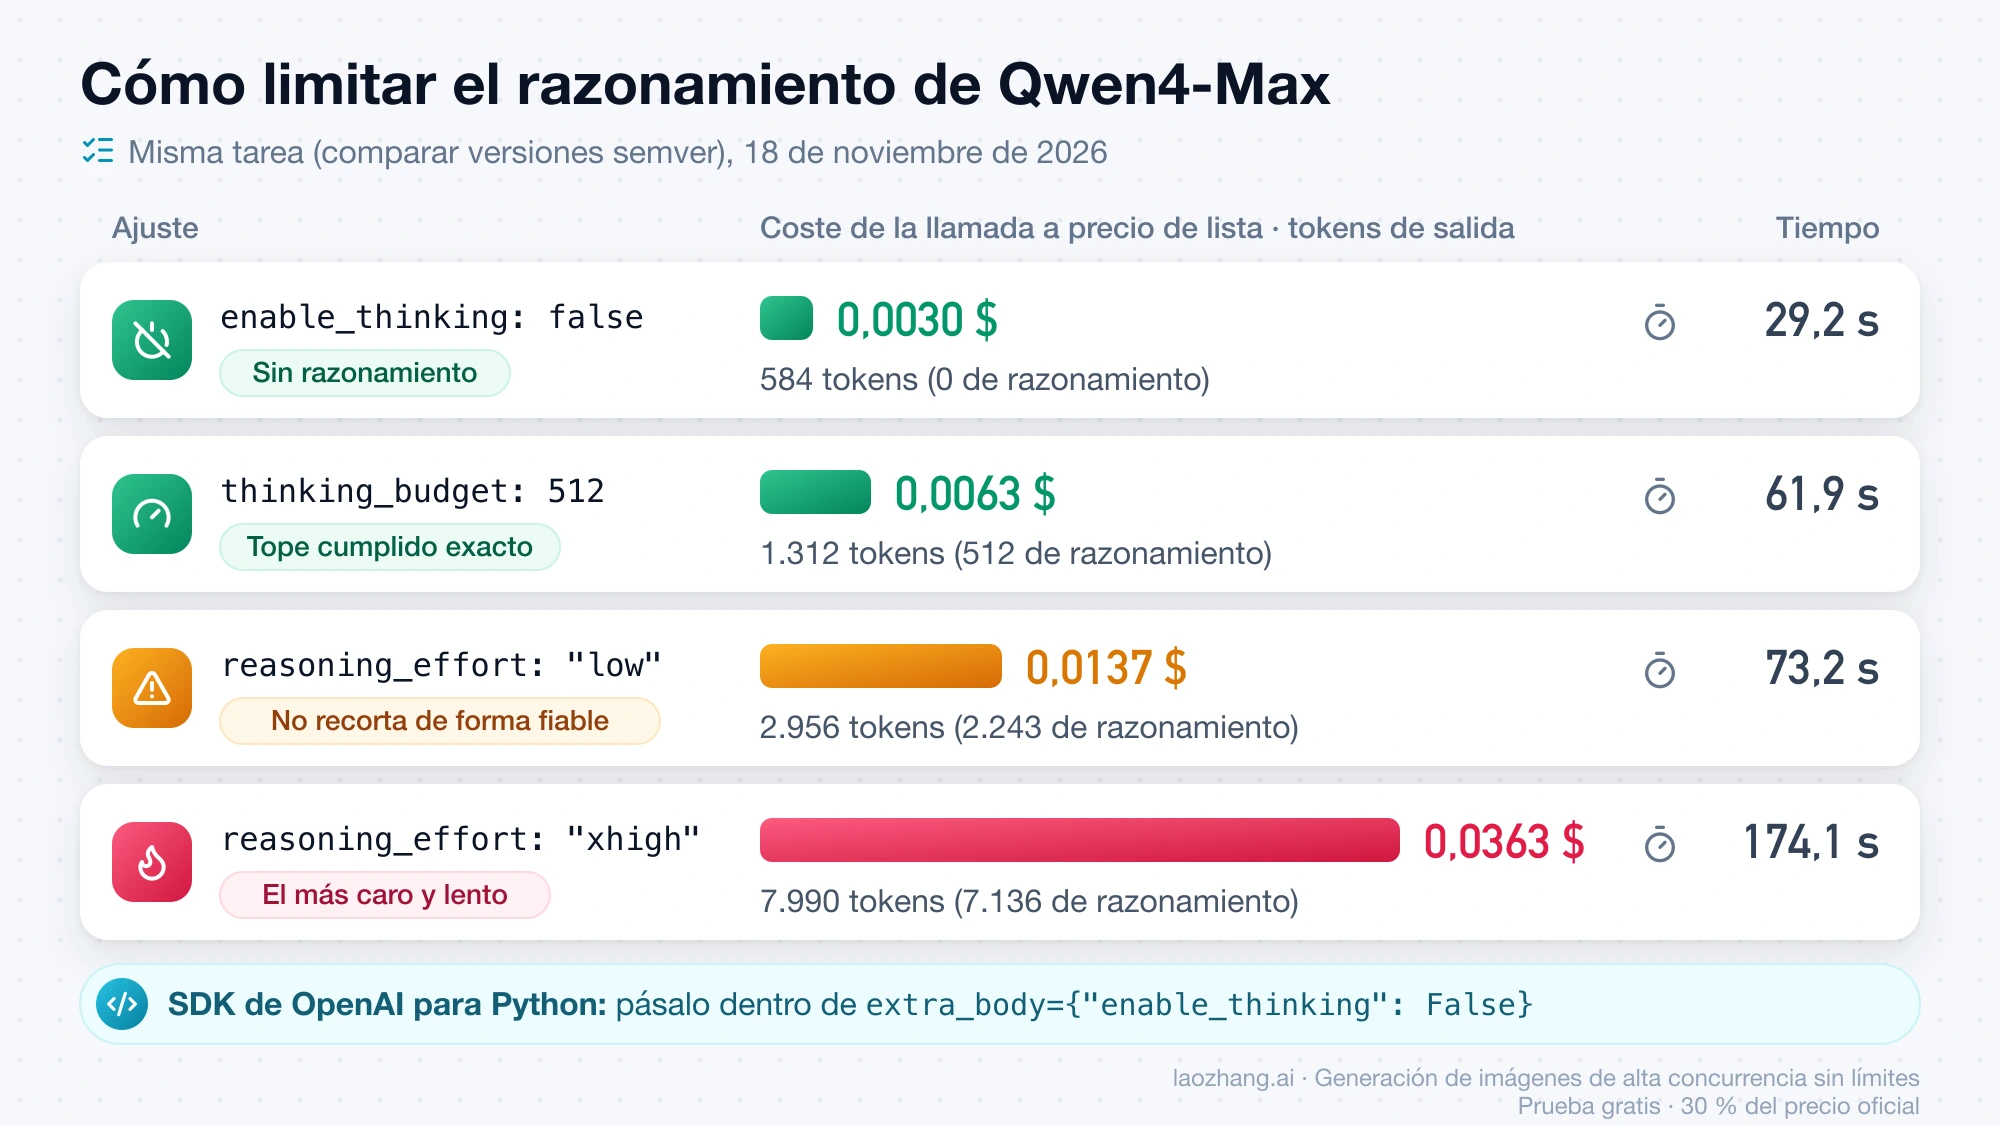
Para que Qwen4-Max gaste y tarde menos, desactiva el razonamiento con enable_thinking: false o ponle un tope con thinking_budget; bajar reasoning_effort a low no lo recortó de forma fiable. Según la ficha de Model Studio, el modelo trae por defecto enable_thinking activado, reasoning_effort en high y un thinking_budget de 131.072 tokens, y traduce minimal a low, medium a high y max a xhigh. El 18 de noviembre de 2026 se comprobó qué hace cada ajuste con una misma tarea, comparar versiones semver, a través de la pasarela de LaoZhang:
| Ajuste | Tokens de salida (de ellos, razonamiento) | Tiempo | Coste a precio de lista |
|---|---|---|---|
enable_thinking: false | 584 (0) | 29,2 s | 0,0030 $ |
thinking_budget: 512 | 1.312 (512) | 61,9 s | 0,0063 $ |
reasoning_effort: "low" | 2.956 (2.243) | 73,2 s | 0,0137 $ |
reasoning_effort: "xhigh" | 7.990 (7.136) | 174,1 s | 0,0363 $ |
Con el razonamiento desactivado, la llamada costó menos de una cuarta parte que con low, y el tope de 512 tokens se cumplió exactamente. low, en cambio, varía mucho de una muestra a otra: en el lote de 12 tareas, esta misma tarea gastó 1.506 tokens por defecto y 949 con low, y en la llamada aislada low subió a 2.956. Un valor no válido (reasoning_effort: "bogus") devolvió un error 400 invalid_parameter_error, señal de que estos campos llegan tal cual al validador de Alibaba.
En una petición compatible con OpenAI, el campo va en el cuerpo junto a los demás:
{
  "model": "qwen4-max",
  "messages": [{ "role": "user", "content": "Tu petición" }],
  "enable_thinking": false
}
Para poner un tope en lugar de apagarlo, cambia la última línea por "thinking_budget": 512 o el límite que te convenga. Con el SDK de OpenAI para Python, estos campos no estándar se pasan dentro de extra_body, por ejemplo extra_body={"enable_thinking": False}: el 18 de noviembre de 2026, con la versión 2.24.0 del SDK y una petición trivial por caso, tanto enable_thinking como thinking_budget llegaron al modelo por esa vía: con enable_thinking desactivado, la respuesta no trajo ningún token de razonamiento. Que la respuesta siga siendo correcta sin razonamiento solo se comprobó en esta tarea, y sin corrector: la respuesta estaba, pero no se calificó. Antes de apagarlo en producción, pasa tus propios casos con respuesta conocida y compara aciertos con y sin razonamiento.
Dónde usar Qwen 4 Max y Opus 5.5
Qwen4-Max se usa sobre todo por API: en Alibaba Cloud Model Studio, con la suscripción Token Plan, en las herramientas de Alibaba QwenWork, Qoder y Qwen Studio, y en OpenRouter. En Qwen Chat, a 18 de noviembre de 2026 y sin iniciar sesión, el selector solo ofrecía Qwen3.7-Plus y Qwen3.8-Max; lo que permite ese chat gratis está en ¿Qwen es gratis? Límite diario, avisos y planes Go, Plus y Pro. Claude Opus 5.5 está en las apps de Claude con plan de pago (el plan Free no lo incluye), en Claude Code, en la API de Claude, en Amazon Bedrock, en Google Cloud y en Microsoft Foundry; qué plan necesitas y cómo probarlo está en Cómo usar Claude Opus 5.5: qué plan pide y cómo probarlo gratis.
Si quieres repetir la comparación con tus propias tareas, en LaoZhang API puedes llamar a qwen4-max y a claude-opus-5-5 con una sola clave, que es como se hizo la prueba del 18 de noviembre. Allí Qwen4-Max figura a unos 1,43 $ de entrada y 4,29 $ de salida por millón de tokens; a esa tarifa, las 12 tareas cortas habrían salido por 0,1022 $. La documentación de LaoZhang API explica cómo configurar la clave y los modelos.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Preguntas frecuentes sobre Qwen 4 Max y Opus 5.5
¿Qwen 4 Max es de código abierto? ¿Se puede ejecutar en local?
No. A 18 de noviembre de 2026, los pesos de Qwen4-Max no se pueden descargar y Model Studio no permite ajustarlo ni desplegarlo por tu cuenta, así que solo se usa como servicio, igual que Opus 5.5. Según Alibaba, es un modelo de mezcla de expertos (MoE) con 2,4 billones de parámetros en total y unos 71.000 millones activos por token, y los modelos Qwen4 más pequeños se publicarán en abierto más adelante, sin fecha anunciada.
¿Es verdad que Qwen 4 supera a Opus 5.5 por 49,9 a 47,2?
Esa cifra no es de Qwen4-Max. Entre el 6 y el 10 de noviembre de 2026, antes del lanzamiento, la prensa china publicó que una versión preliminar llamada Qwen-4-Flash-Early sacó 49,9 puntos en una prueba de creación de juegos frente a 47,2 de Opus 5.5 en xhigh, y que Qwen4-Flash costaba 0,4 $ por tarea frente a 2,6 $ de Opus. Son modelos más pequeños de la misma familia; Qwen4-Max, publicado el 16 de noviembre, queda por debajo de Opus 5.5 en medium en el índice de Artificial Analysis.
¿Cómo queda Qwen 4 Max frente a Kimi K3.1 Pro, GPT-6.2 Sol o Sonnet 5.5?
Cada pareja tiene su propia comparativa con Opus 5.5 como referencia. El otro modelo chino de gama alta está en Kimi K3.1 Pro vs Claude Opus 5.5: ¿cuesta la mitad por tarea?. GPT-6.2 Sol vs 6.1 Sol vs Opus 5.5: prueba real y cuál usar usa las mismas 12 tareas y las mismas cifras de Opus 5.5, así que sus resultados se pueden poner junto a los de Qwen4-Max. Si lo que buscas es bajar de modelo dentro de Anthropic, mira Claude Sonnet 5.5 vs Opus 5.5: cuál gasta menos por tarea.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 18 nov 2026.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 18 nov 2026.
- 1.comparativa de Artificial Analysis entre Qwen4-Max y Claude Opus 5.5artificialanalysis.ai/models/comparisons/qwen4-max-vs-claude-opus-5-5
- 2.ficha de Qwen4-Max en Artificial Analysisartificialanalysis.ai/models/qwen4-max
- 3.la comparativa de Qwen 4 Max y Opus 5.5 de atomicagent.ioatomicagent.io/blog/qwen-4-max-vs-opus-5-5
- 4.ficha de Qwen4-Max en Alibaba Cloud Model Studiodocs.modelstudio.console.alibabacloud.com/en/model-studio/qwen4-max
- 5.página de precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing