Gemini 4 Carbon vs GPT-6.1 Sol para programar: coste por tarea
Hasta el 30 de noviembre cuestan lo mismo por token, pero en 7 tareas de código con tests Carbon gastó 7 veces más que GPT-6.1 Sol. Desde diciembre, 14 veces.
En esta página
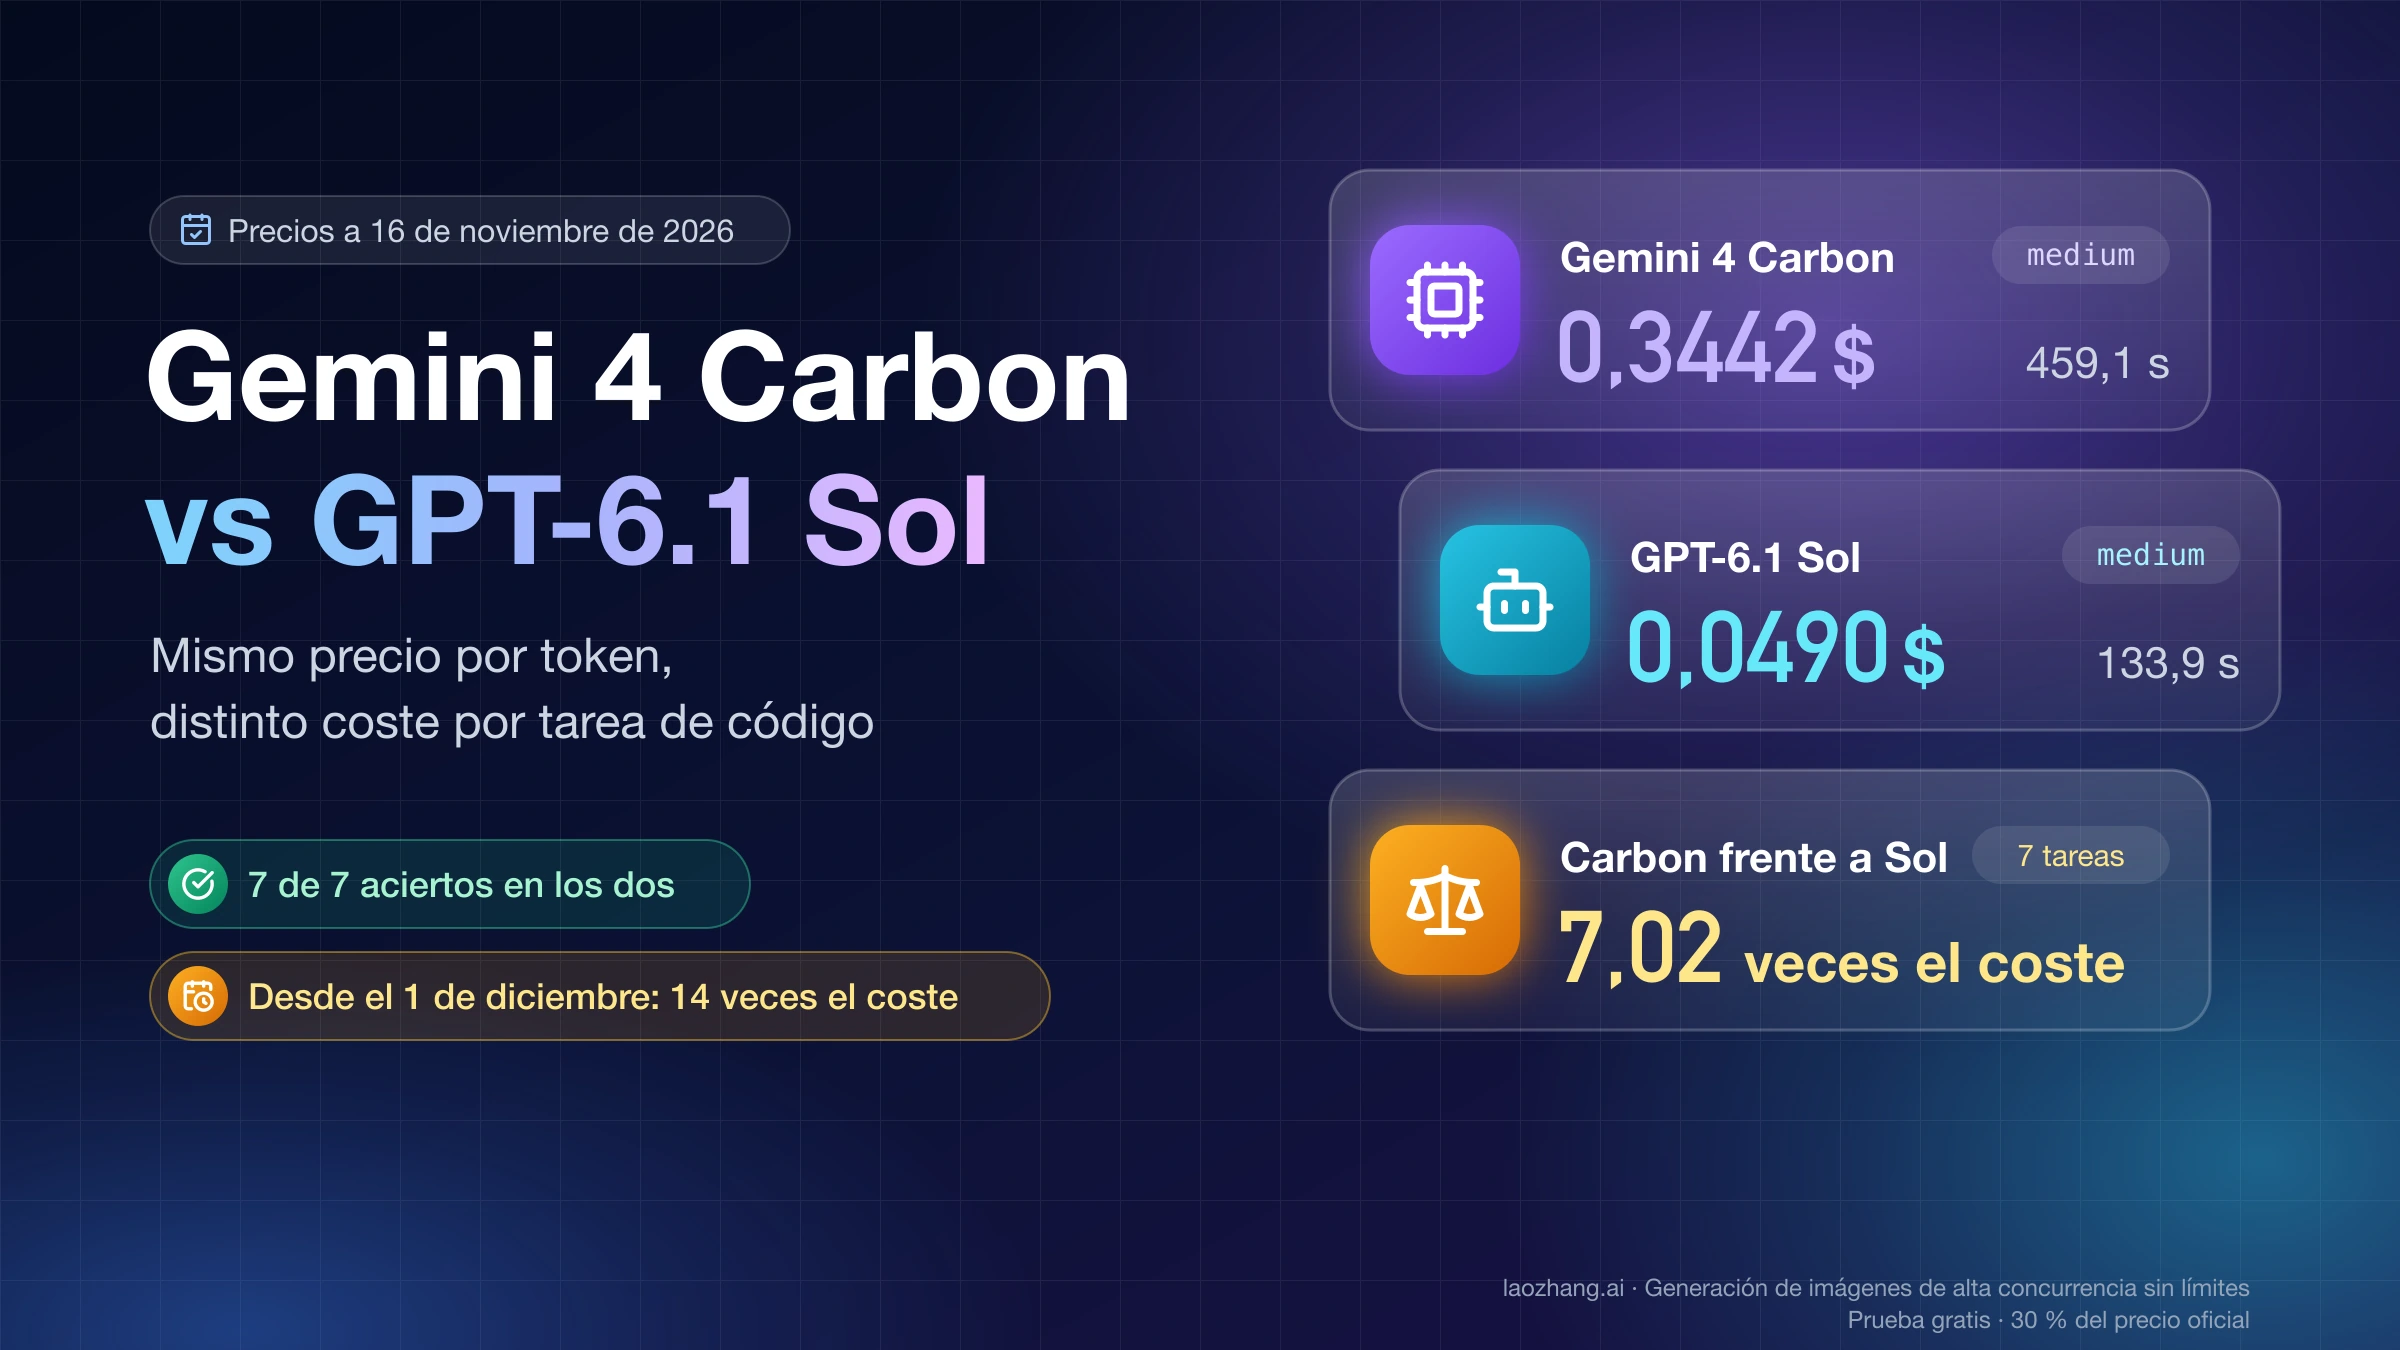
Para programar, prueba primero GPT-6.1 Sol (gpt-6.1-sol) en su nivel por defecto, medium, y deja Gemini 4 Carbon (gemini-4-carbon), también en su medium por defecto, para las tareas de terminal y de agente largo en las que Sol se quede corto aunque subas a xhigh o max. Hasta el 30 de noviembre de 2026 los dos cobran lo mismo por token, 2,00 $ de entrada y 10,00 $ de salida por millón, pero la misma tarea no cuesta lo mismo. En siete tareas de código con tests ocultos, llamadas a través de la pasarela de LaoZhang (GPT-6.1 Sol el 28 de octubre, Carbon el 11 y el 16 de noviembre), los dos aprobaron las siete con su nivel por defecto; Carbon gastó 0,3442 $ y 459,1 s, y Sol 0,0490 $ y 133,9 s: 7,02 veces el coste y 3,43 veces la espera.
Lo que compra el dinero de más está en el trabajo difícil, no en el corriente. En el Intelligence Index v5.0.1 de Artificial Analysis, a 16 de noviembre de 2026, Carbon saca 60 puntos en high y 58 en medium, por encima de los 55 de Sol en max, y la ventaja en código se concentra en las pruebas de terminal (65,2 % frente a 56,1 % en Terminal-Bench 4.0). En FrontierCode-AA 2.0 empatan arriba con un 40,6 %, y cada tarea del índice le cuesta a Carbon entre 4,68 $ y 5,48 $, frente a 1,27 $ de Sol en max.
Gemini 4 Carbon ya se puede usar: está en disponibilidad general en el nivel de pago de la API de Gemini desde el 10 de noviembre de 2026, sin nivel gratuito. El 1 de diciembre su precio se duplica, mientras GPT-6.1 Sol sigue igual, así que en las mismas siete tareas Carbon pasaría a costar 14 veces lo que GPT-6.1 Sol. Si quieres medirlo con tu propio código, hazlo antes de esa fecha.
¿Gemini 4 Carbon o GPT-6.1 Sol? Depende del tipo de tarea de código
La regla práctica se decide por el tipo de trabajo, no por la puntuación global. Si tu código se puede comprobar con tests y la tarea está bien acotada, GPT-6.1 Sol en medium resuelve lo mismo que Carbon por una fracción del coste; si la tarea pasa por la terminal, encadena muchos pasos o Sol ya falla en xhigh o max, Carbon es el que tiene margen. Esta tabla resume dónde empezar y cuándo cambiar a 16 de noviembre de 2026; los datos de cada fila se desarrollan en las secciones siguientes.
| Si tu trabajo es… | Prueba primero | Cuándo cambiar o qué vigilar |
|---|---|---|
| Funciones, módulos y correcciones que se comprueban con tests | GPT-6.1 Sol en medium | Sube Sol a high o xhigh antes de cambiar de modelo; en las siete tareas de la prueba, Carbon acertó lo mismo por 7 veces el coste |
| Scripts, comandos y tareas que se resuelven en la terminal | Gemini 4 Carbon en medium | Es donde Carbon saca más ventaja en los benchmarks, con un coste por tarea del índice 3,7 veces mayor que Sol en max |
| Leer un log de decenas de miles de tokens | GPT-6.1 Sol en medium | En el único log de la prueba (una sola ejecución), Sol acertó los siete datos en 45,7 s; Carbon por defecto también, pero en 213,9 s, y en high no llegó a responder |
| Entradas de más de 272.000 tokens, como un repositorio entero | Los dos, con tu propio caso | Sol cobra toda la petición a tarifa larga; Carbon no tiene recargo, pero desde diciembre cuesta el doble. Este caso no está probado |
| Mucho volumen o presupuesto ajustado | GPT-6.1 Sol en low o medium | Carbon no tiene un nivel barato: en el índice, su low cuesta más por tarea que su medium |
| Un agente de código como Codex o Antigravity | El agente que ya pagas | Antigravity CLI con Carbon puntúa 55,5 y Codex con Sol 52,2, pero cada tarea costó 7,13 $ frente a 1,51 $ |
El cálculo del 3,7 de la segunda fila es el coste por tarea de Carbon en medium (4,68 $) dividido entre el de Sol en max (1,27 $) en el índice de Artificial Analysis. Si lo que te frena de GPT-6.1 Sol es la espera, en GPT-6.1 Sol lento en Codex y API: qué lo frena y cómo acelerarlo están las causas y los ajustes. Si las dos opciones te salen caras, GPT-6.1 Terra vs Sol: diferencias y cuándo Terra sale más barata explica cuándo compensa bajar a Terra, y Gemini 4 Argon vs Claude Opus 5.5 vs GPT-6.1 Sol: cuál usar hoy añade a la comparación el otro modelo de Google y el de Anthropic.
Mismas 7 tareas de código: las dos aprueban, Carbon gasta 7 veces más
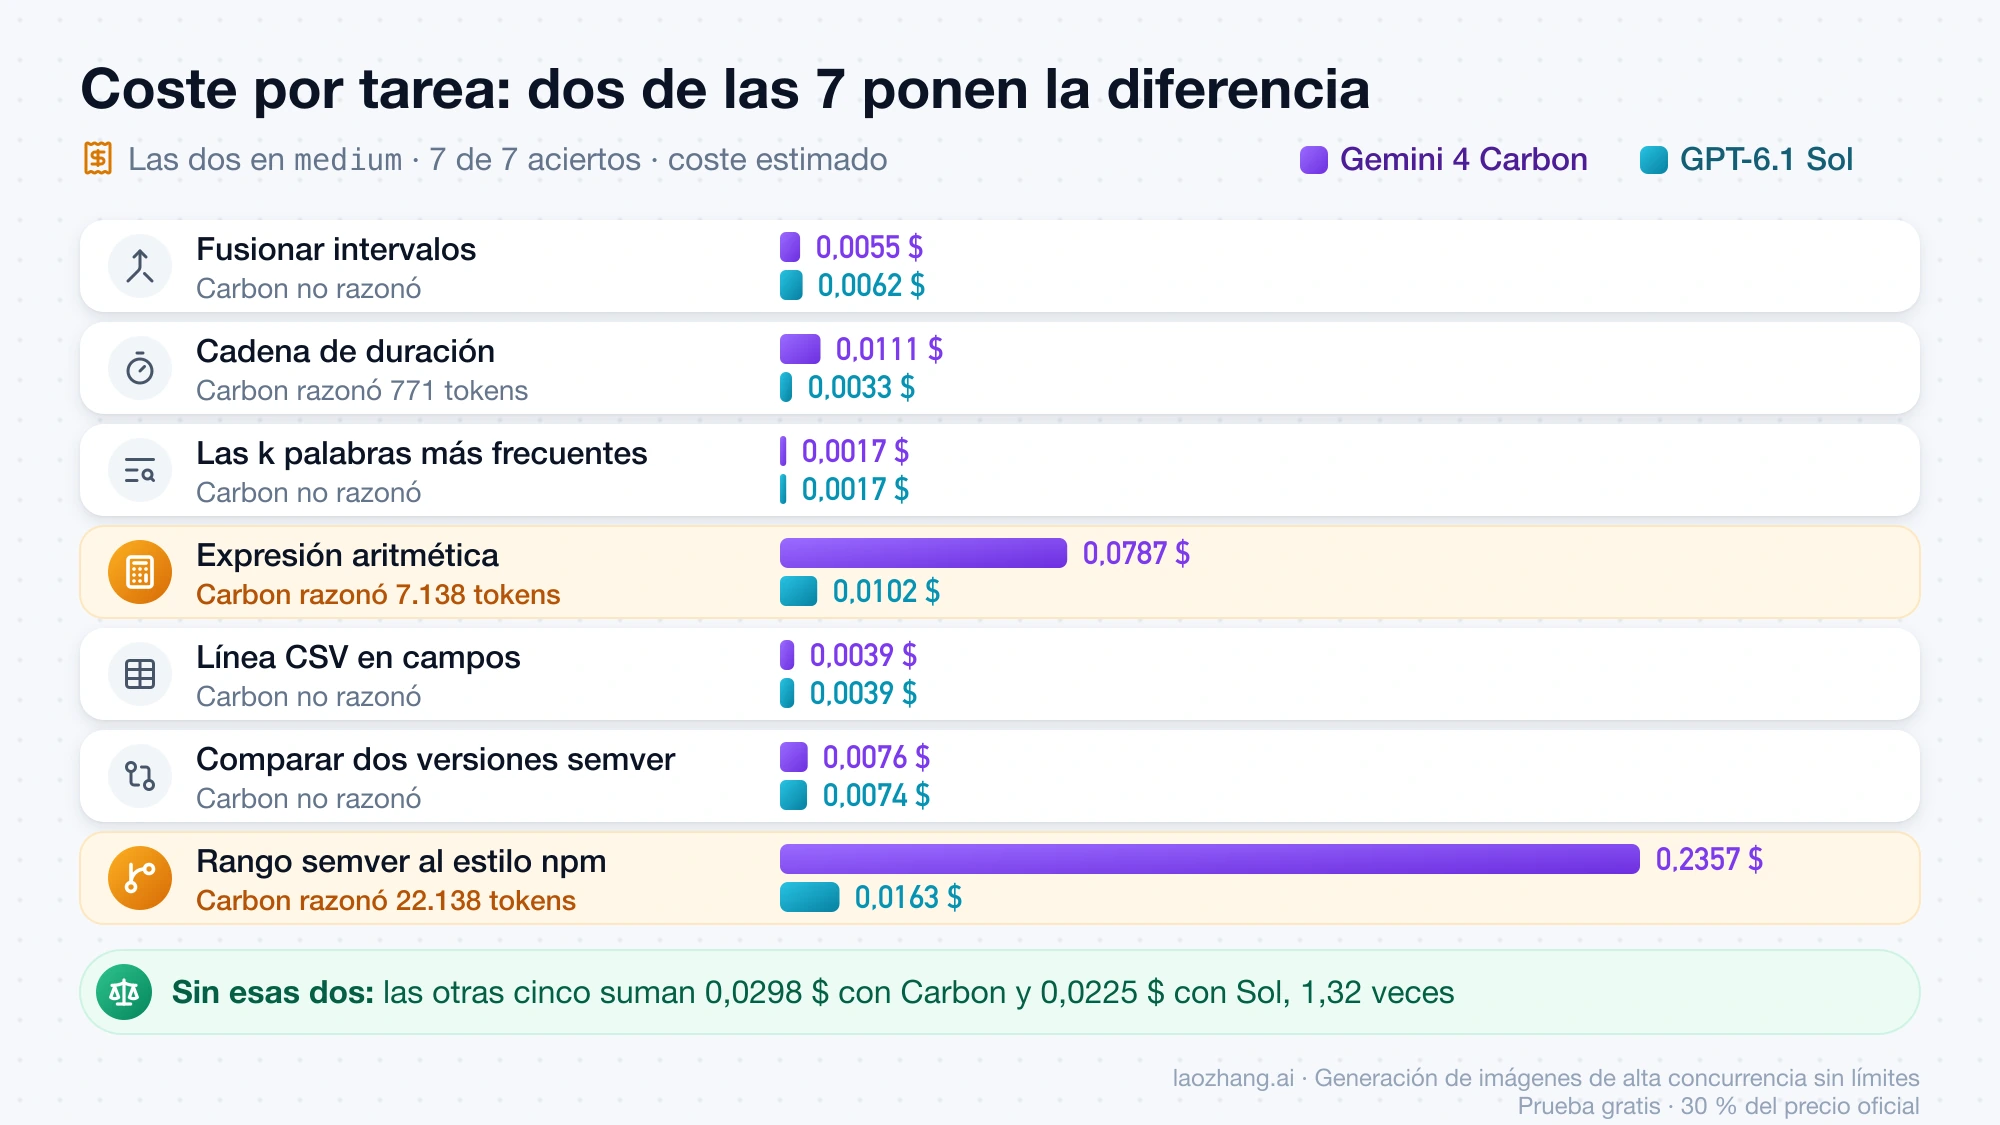
En tareas pequeñas y bien definidas, los dos modelos aciertan y la diferencia está solo en lo que gastan y en lo que tardan. Siete problemas de programación con tests ocultos se lanzaron con el mismo enunciado, palabra por palabra, y se corrigieron con los mismos tests. GPT-6.1 Sol se llamó el 28 de octubre de 2026 a través de la pasarela de LaoZhang con POST /v1/chat/completions; Gemini 4 Carbon, por la misma pasarela con la ruta nativa de Gemini (generateContent), el 11 de noviembre para cinco tareas y el 16 de noviembre para las dos de semver. Fue una sola llamada por tarea, sin mensaje de sistema ni herramientas, sin indicar nivel de razonamiento (los dos usan medium por defecto), y el coste es una estimación con los tokens que devuelve cada respuesta y el precio de lista de noviembre, no una factura.
| Tarea, con tests ocultos | Carbon medium | GPT-6.1 Sol medium | Tokens de razonamiento de Carbon |
|---|---|---|---|
| Fusionar intervalos | 0,0055 $ | 0,0062 $ | 0 |
| Interpretar una cadena de duración | 0,0111 $ | 0,0033 $ | 771 |
| Las k palabras más frecuentes | 0,0017 $ | 0,0017 $ | 0 |
| Evaluar una expresión aritmética | 0,0787 $ | 0,0102 $ | 7.138 |
| Separar los campos de una línea CSV | 0,0039 $ | 0,0039 $ | 0 |
| Comparar dos versiones semver | 0,0076 $ | 0,0074 $ | 0 |
| Comprobar un rango semver al estilo npm | 0,2357 $ | 0,0163 $ | 22.138 |
| Total, 7 de 7 aciertos en los dos | 0,3442 $ en 459,1 s | 0,0490 $ en 133,9 s | 30.047 |
La media engaña, porque la diferencia la ponen dos tareas. En cuatro de las siete el coste es prácticamente el mismo, y en esas Carbon contestó sin razonar. En la del rango semver, Carbon escribió 23.481 tokens de salida (22.138 de razonamiento), tardó 284,0 s y gastó 0,2357 $, mientras GPT-6.1 Sol la resolvió con 1.547 tokens de salida en 45,0 s por 0,0163 $; en la de la expresión aritmética, Carbon razonó 7.138 tokens. Sin esas dos, las otras cinco suman 0,0298 $ con Carbon y 0,0225 $ con Sol, 1,32 veces. Con las siete, Carbon generó 34.088 tokens de salida, de ellos 30.047 de razonamiento, frente a 4.613 de Sol: 7,39 veces más texto, que es lo que se acaba pagando. Por eso el múltiplo cambia según qué tareas mezcles, y en tu caso dependerá de cuántas obliguen a Carbon a pensar a fondo.
Las mismas llamadas incluyeron otras cuatro preguntas que no son de código: un problema de enunciado, un conteo de sumas de dígitos, un resumen en cinco puntos de un texto de 6.723 palabras y una pregunta sobre la biblioteca estándar de CPython 3.13 con dos funciones inventadas. En esta última, el 16 de noviembre, Carbon en medium contestó que functools.memoize_method no existe, pero describió statistics.winsorized_mean como si existiera («It returns the arithmetic mean of a data set after replacing…»), en una llamada de 5,2 s sin ningún token de razonamiento. GPT-6.1 Sol, el 28 de octubre, respondió en sus dos niveles que ninguna de las dos funciones existe. Es una sola muestra y no basta para afirmar que Carbon se invente APIs, pero en esta ejecución falló justo cuando decidió no razonar. En el total de las 11 preguntas, Sol acertó 11 de 11 por 0,0897 $ y 182,1 s, y Carbon 10 de 11 por 0,4421 $ y 574,8 s, 4,93 veces el coste.
Lee estas cifras con sus límites. GPT-6.1 Sol y Carbon no se midieron el mismo día, cada celda es una sola muestra y las tareas son pequeñas y tienen solución clara, así que los dos aprueban casi todo: la prueba compara gasto, volumen de salida y espera, no cuál de los dos es más inteligente. Para la capacidad en tareas difíciles están los benchmarks de más abajo. Fuera de estas pruebas, según la prueba única de un usuario de X (notjazii) con el mismo prompt y el razonamiento al máximo en los dos, Sol tardó 30 minutos y gastó unos 1,4 $, y Carbon 40 minutos y unos 2,9 $; otro usuario de X (EnvolDev) cuenta 8,83 $ y 2 h 39 min con Carbon frente a 3,11 $ y 54 min con Sol en un encargo de generación 3D. Son ejecuciones únicas de tareas creativas, no de código con tests, aunque apuntan en la misma dirección.
Un log de 1.500 líneas: GPT-6.1 Sol acierta en 45,7 s y Carbon high no responde
En la única tarea de entrada larga que se probó se repite el patrón: GPT-6.1 Sol acertó antes y más barato, Carbon en medium acertó a cambio de mucho más razonamiento y Carbon en high no llegó a dar respuesta. La tarea consistía en leer un log de aplicación de 146 KB y 1.500 líneas y devolver siete datos: cuántas veces aparece cada uno de cinco códigos de error, cuántos usuarios distintos recibieron un E503 y qué ID de petición acumuló más reintentos. Carbon la hizo el 11 de noviembre de 2026 y GPT-6.1 Sol el 16 de noviembre, los dos a través de la pasarela de LaoZhang y con una llamada por configuración.
| Configuración | Datos correctos | Tiempo | Coste estimado |
|---|---|---|---|
GPT-6.1 Sol medium | 7 de 7 | 45,7 s | 0,1654 $ |
GPT-6.1 Sol high | 7 de 7 | 87,7 s | 0,1983 $ |
Gemini 4 Carbon medium | 7 de 7 | 213,9 s | 0,4281 $ |
Gemini 4 Carbon high | Sin respuesta en dos intentos | 507,6 s en el segundo | 0,4863 $ y 0,8140 $ |
Carbon en high gastó todo el límite de salida pensando. El primer intento se cortó a los 32.765 tokens de razonamiento, y el segundo, en streaming y con maxOutputTokens en 65.536, se detuvo en 65.533 sin escribir la respuesta; los tokens de los dos intentos cuentan en el coste aunque no haya respuesta. Carbon en medium razonó 26.867 tokens y GPT-6.1 Sol en medium, 2.527. Entre las dos configuraciones por defecto, Carbon costó 2,59 veces más (0,4281 $ / 0,1654 $) y tardó 4,68 veces más (213,9 s / 45,7 s); con el precio de diciembre, Carbon pasaría a 0,8563 $, 5,18 veces lo de Sol.
El mismo archivo no pesa lo mismo para los dos. Carbon contó 79.312 tokens de entrada y GPT-6.1 Sol 55.843, así que Carbon ve 1,42 veces más tokens, porque cada uno usa su propio tokenizador, así que con el mismo precio por token Carbon ya paga más por leer el mismo texto. En el caso de Sol, la pasarela registró casi toda la entrada (55.840 tokens) como escritura en caché, y el coste de la tabla aplica esa tarifa de 2,50 $ por millón; con la de entrada normal, Sol en medium saldría a 0,1375 $.
Esta prueba no dice nada del umbral de 272.000 tokens en que GPT-6.1 Sol encarece toda la petición, porque 55.843 tokens quedan muy por debajo. Tampoco permite concluir que Sol sea mejor con entradas largas en general: es una sola tarea de conteo. Lo que sí muestra es que con Carbon en high y un log largo conviene fijar un límite de salida alto y aun así contar con que se puede quedar sin respuesta.
Dónde gana Gemini 4 Carbon en los benchmarks de código y dónde empata
Según Artificial Analysis, la ventaja de Carbon en programación está en las tareas de terminal, no en escribir código a partir de un enunciado. En Terminal-Bench 4.0, cualquiera de los tres niveles de Carbon supera a Sol en max; en FrontierCode-AA 2.0 empatan arriba y Carbon en low queda por debajo de Sol en medium. Estas son las subpuntuaciones relacionadas con código de la comparativa de Artificial Analysis entre Gemini 4 Carbon y GPT-6.1 Sol, con el Intelligence Index v5.0.1, a 16 de noviembre de 2026:
| Prueba | Carbon high | Carbon medium | Carbon low | Sol max | Sol high | Sol medium |
|---|---|---|---|---|---|---|
| Intelligence Index v5.0.1 | 60 | 58 | 54 | 55 | 50 | 46 |
| Terminal-Bench 4.0 | 65,2 % | 60,6 % | 62,6 % | 56,1 % | 51,5 % | 48,0 % |
| Terminal-Bench-Science 0.1 | 64,8 % | 62,4 % | 61,9 % | 58,1 % | 46,2 % | 37,1 % |
| FrontierCode-AA 2.0 | 40,6 % | 39,5 % | 29,6 % | 40,6 % | 36,7 % | 33,4 % |
| Capacidad de ingeniería | 65 | 64 | 60 | 59 | 55 | 52 |
| AA-Omniscience v1.1 (preguntas de conocimiento) | 54 | 47 | 39 | 42 | 41 | 40 |
Las dos pruebas de terminal miden tareas que se resuelven ejecutando comandos en un entorno real, y ahí la distancia en Terminal-Bench 4.0 es de 9,1 puntos entre los mejores niveles (65,2 % frente a 56,1 %). FrontierCode mide la escritura de código difícil y es donde Carbon no compra nada: en high iguala a Sol en max con un 40,6 %, en medium (39,5 %) queda 1,1 puntos por debajo de él y en low (29,6 %) cae 3,8 puntos por debajo de Sol en medium. En preguntas de conocimiento, Carbon en high saca 54 frente a 42, pero en medium la ventaja baja a 47 frente a 40, el nivel en que se produjo el error con la función inventada de la prueba anterior.
Sobre el papel, por tanto, Carbon es el más capaz de los dos, y la diferencia se nota en el tipo de trabajo que un agente hace en la terminal: instalar, ejecutar, leer la salida y corregir. Si tus tareas son sobre todo escribir funciones a partir de una especificación, los números no justifican pagar más, y las siete tareas de la prueba por la pasarela apuntan a lo mismo.
Qué nivel de razonamiento usar en Carbon y en Sol: las escalas no equivalen
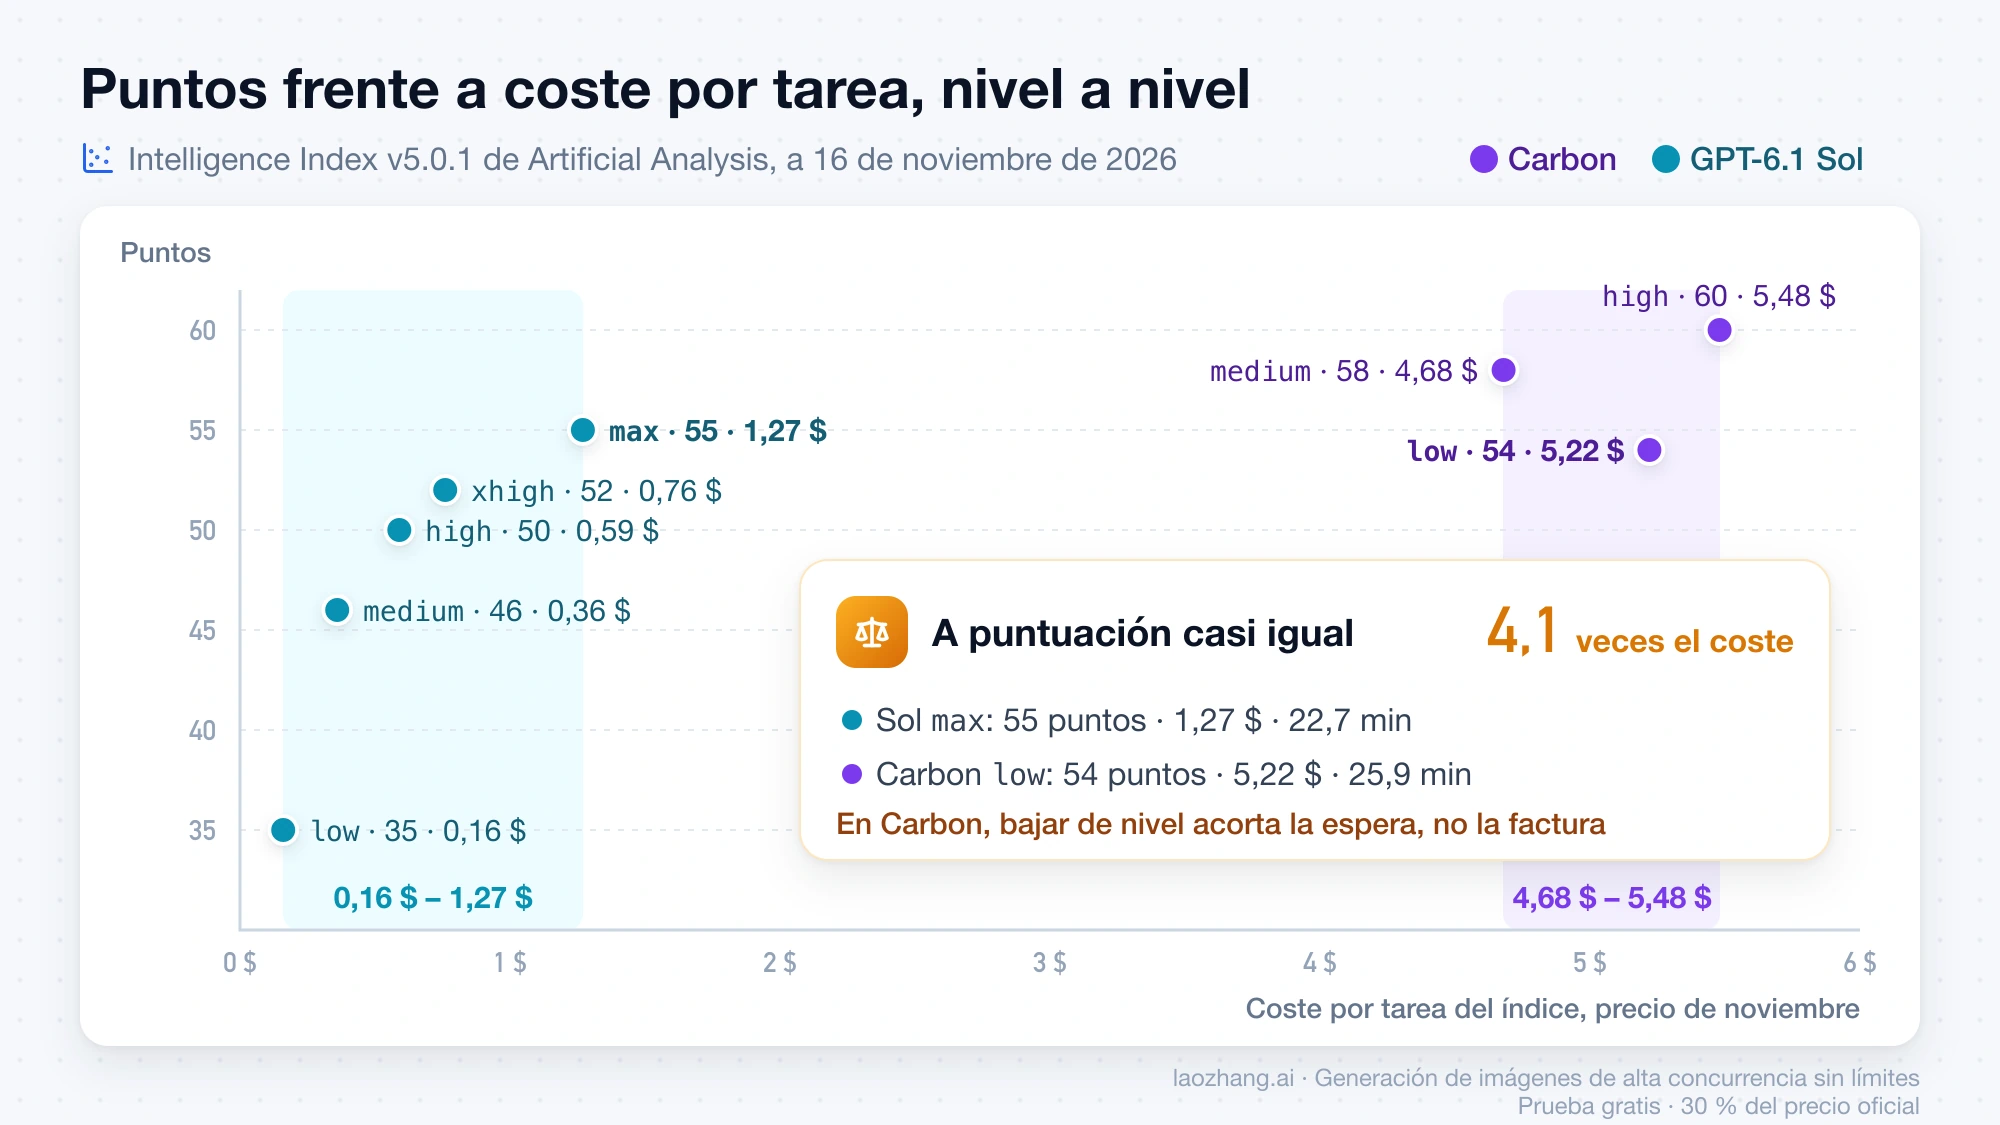
Los nombres de nivel no se corresponden entre un modelo y otro, así que high en Carbon no es el mismo esfuerzo que high en Sol. Carbon tiene tres niveles de pensamiento (thinkingLevel: low, medium y high) y GPT-6.1 Sol cinco de esfuerzo de razonamiento (reasoning.effort: low, medium, high, xhigh y max); los dos usan medium por defecto. Para Carbon, quédate en medium, porque es su nivel más barato y bajar no ahorra; para Sol, empieza en medium y sube un escalón solo cuando una tarea falle. Así quedan los ocho niveles en el índice de Artificial Analysis a 16 de noviembre de 2026, con los dos modelos calculados a 2,00 $ y 10,00 $ por millón:
| Configuración | Puntos | Coste por tarea del índice | Tiempo por tarea | Primer token |
|---|---|---|---|---|
Carbon high | 60 | 5,48 $ | 32,1 min | 73,49 s |
Carbon medium | 58 | 4,68 $ | 28,0 min | 20,89 s |
Carbon low | 54 | 5,22 $ | 25,9 min | 10,90 s |
Sol max | 55 | 1,27 $ | 22,7 min | 166,70 s |
Sol xhigh | 52 | 0,76 $ | 9,8 min | 68,00 s |
Sol high | 50 | 0,59 $ | 7,6 min | 32,56 s |
Sol medium | 46 | 0,36 $ | 4,4 min | 4,81 s |
Sol low | 35 | 0,16 $ | 1,9 min | 3,01 s |
En Carbon, los tres niveles cuestan entre 4,68 $ y 5,48 $ por tarea, y low sale más caro que medium con 4 puntos menos: bajar de nivel acorta la espera, no la factura. En Sol, de low a max el coste se multiplica por unas 8 (1,27 $ / 0,16 $), así que el nivel sí es la palanca de gasto. A puntuación casi igual, Sol en max (55 puntos) cuesta 1,27 $ y tarda 22,7 min, y Carbon en low (54 puntos) cuesta 5,22 $ y tarda 25,9 min, 4,1 veces más. Carbon solo ofrece algo que Sol no alcanza por encima de los 55 puntos, en medium y high. El «coste por tarea» de esta tabla es la media de la batería de Artificial Analysis, no el de una petición tuya, y no se mezcla con las cifras de las pruebas por la pasarela de LaoZhang. Artificial Analysis recalculó además los costes de Carbon: el 11 de noviembre mostraba 7,76 $, 6,59 $ y 7,19 $ para high, medium y low, cifras que ya no son las actuales.
Las pruebas por la pasarela de LaoZhang confirman lo que cuesta subir Carbon a high. En las cinco tareas de código que se hicieron con los cuatro niveles, todas las configuraciones aprobaron las cinco: GPT-6.1 Sol gastó 0,0252 $ y 72,1 s en medium y 0,0387 $ y 109,5 s en high (28 de octubre), y Gemini 4 Carbon 0,1009 $ y 169,7 s en medium y 0,6121 $ y 614,5 s en high (11 de noviembre). Carbon en high costó 15,82 veces lo de Sol en high (0,6121 $ / 0,0387 $) y tardó 5,61 veces más, con 16,40 veces más tokens de salida, para el mismo resultado; entre los niveles por defecto la relación es de 4,00 veces el coste y 2,35 veces el tiempo.
Si sumas el log en que Carbon high se quedó sin respuesta, la conclusión práctica es usar high en Carbon solo cuando medium falle en una tarea concreta, y con maxOutputTokens en 65.536, el máximo de salida de una respuesta síncrona. En GPT-6.1 Sol, high y xhigh son escalones razonables antes de pensar en cambiar de modelo; para el resto de cambios que trae Sol al migrar, consulta GPT-6.1 Sol: qué cambia, cuánto cuesta y qué revisar al migrar.
¿Cuestan lo mismo? Precio por token hasta el 30 de noviembre y después
Por token, sí, pero solo hasta el 30 de noviembre de 2026 y con entradas de hasta 272.000 tokens. Desde el 1 de diciembre, Carbon duplica todas sus tarifas y GPT-6.1 Sol no cambia. Estos son los precios en dólares por millón de tokens de la página de precios de la API de Gemini y de la ficha de gpt-6.1-sol en la documentación de la API de OpenAI, a 16 de noviembre de 2026:
| Por millón de tokens | Carbon hasta el 30 de noviembre | Carbon desde el 1 de diciembre | GPT-6.1 Sol |
|---|---|---|---|
| Entrada | 2,00 $ | 4,00 $ | 2,00 $ |
| Salida | 10,00 $ | 20,00 $ | 10,00 $ |
| Entrada en caché | 0,10 $ | 0,20 $ | 0,10 $ |
| Petición con más de 272.000 tokens de entrada | Sin recargo | Sin recargo | 4,00 $ de entrada y 15,00 $ de salida en toda la petición |
| Batch | Mitad de precio | Mitad de precio | Mitad de precio, también en Flex |
En Carbon, la salida incluye los tokens de pensamiento, que es lo que hace subir la factura cuando razona mucho. GPT-6.1 Sol cobra además 2,50 $ por millón por las escrituras en caché. Carbon no tiene nivel gratuito en la API, y por encima de 272.000 tokens de entrada es el más barato de los dos por token hasta el 30 de noviembre; desde diciembre iguala a Sol en entrada y le supera en salida.
Aplicado a las tareas de las pruebas por la pasarela, el precio de diciembre duplica cada cifra de Carbon y deja igual la de Sol. El coste de Carbon desde el 1 de diciembre es el de la prueba multiplicado por 2:
| Misma tarea | Carbon hasta el 30 de noviembre | Carbon desde el 1 de diciembre | GPT-6.1 Sol | Veces, antes y después |
|---|---|---|---|---|
7 tareas de código, medium en los dos | 0,3442 $ | 0,6884 $ | 0,0490 $ | 7,02 y 14,05 |
Las mismas 7, frente a Sol en high | 0,3442 $ | 0,6884 $ | 0,0859 $ | 4,01 y 8,01 |
11 preguntas, medium en los dos | 0,4421 $ | 0,8842 $ | 0,0897 $ | 4,93 y 9,86 |
Log de 1.500 líneas, medium en los dos | 0,4281 $ | 0,8563 $ | 0,1654 $ | 2,59 y 5,18 |
5 tareas de código, high en los dos | 0,6121 $ | 1,2242 $ | 0,0387 $ | 15,82 y 31,63 |
En el índice de Artificial Analysis, que calcula Carbon con el precio de noviembre, el doble daría unos 10,96 $, 9,36 $ y 10,44 $ por tarea para high, medium y low, suponiendo la misma proporción de caché; es una estimación, no una cifra publicada. La subida no cambia qué modelo conviene para cada tipo de trabajo, pero duplica lo que pagas por cada tarea que mandes a Carbon. Si lo reservas para las tareas en que Sol falla, lo que más pesa en la factura es cuántas son, no el precio por token; si pensabas usarlo para todo, desde diciembre la diferencia con Sol en las siete tareas de código de la prueba pasa de 7 a 14 veces. Para trabajos que no necesitan respuesta inmediata, el modo Batch de los dos cobra la mitad.
Codex, Antigravity o tu IDE: qué compara el Coding Agent Index
Si programas dentro de un agente, la cifra publicada no enfrenta dos modelos en el mismo agente, sino dos productos: cada modelo en el agente de su propio fabricante. En el Coding Agent Index v2.1 de Artificial Analysis, a 16 de noviembre de 2026, Antigravity CLI con Gemini 4 Carbon en high saca 55,5 puntos, con 7,13 $ y 33,6 min por tarea y una media de 186 pasos; Codex con GPT-6.1 Sol en max saca 52,2, con 1,51 $, 21,9 min y 43 pasos. El índice combina, con el mismo peso, 132 tareas de FrontierCode-AA 2.0, 66 de Terminal-Bench 4.1 y 124 de SWE-Atlas-QnA-AA, cada una repetida tres veces.
El reparto confirma lo que dicen las subpuntuaciones del modelo. En Terminal-Bench, Antigravity con Carbon aprobó 129 de 198 intentos frente a 107 de Codex con Sol; en FrontierCode, Codex con Sol aprobó 183 de 396 frente a 166. Carbon da 3,3 puntos más a cambio de 4,72 veces el coste por tarea (7,13 $ / 1,51 $), calculado con el precio de noviembre, y de 4,3 veces más pasos. No existe una fila con Carbon dentro de Codex ni con Sol dentro de Antigravity, y Sol solo aparece en max, así que el índice no separa cuánto aporta el modelo y cuánto el agente.
En la práctica, el agente que ya pagas suele decidir. Gemini 4 Carbon dentro de la app de Gemini y de Antigravity exige una suscripción a Google AI Ultra, cuyos límites de uso no se han publicado. GPT-6.1 Sol en Codex trabaja con 500.000 tokens de contexto por defecto y, dentro de la suscripción, sin recargo por contexto largo. Si tu IDE o tu agente llama a GPT-6.1 Sol por la API con herramientas, ten en cuenta que las llamadas a herramientas de Sol requieren la Responses API; Carbon admite llamadas a funciones, ejecución de código, uso del ordenador y fundamentación con la Búsqueda de Google desde la API de Gemini.
Dónde usar Gemini 4 Carbon hoy y cómo comparar los dos con tu código
Gemini 4 Carbon se usa hoy con una clave de la API de Gemini en el nivel de pago, sin nivel gratuito, y en la app de Gemini o Antigravity con Google AI Ultra; GPT-6.1 Sol, con la API de OpenAI o dentro de Codex. Quién tiene acceso a Carbon en cada plan, incluidas las cuentas de empresa, está en Gemini 4 Carbon: cuándo sale (10 nov.), acceso y precio vs Argon. Los dos aceptan algo más de un millón de tokens de contexto (1.048.576 en Carbon, con entrada y salida sumadas, y 1.050.000 en Sol), pero difieren en la salida máxima por respuesta: 65.536 tokens en Carbon frente a 128.000 en Sol.
Como el múltiplo depende de qué tareas mezcles, la única forma de saber cuánto te cuesta Carbon es medirlo con tu propio código. El orden que funciona:
- Elige entre cinco y diez tareas reales que puedas comprobar con tests o con una respuesta conocida, y mezcla tareas sencillas con alguna de terminal o de varios pasos.
- Lanza cada una con
gemini-4-carbonygpt-6.1-solenmedium, con el mismo enunciado y sin cambiar nada más. - Apunta de cada respuesta los tokens de entrada, de salida y de razonamiento, el tiempo hasta la respuesta completa y si pasa los tests.
- Calcula el coste con el precio de lista y repite la cuenta con el de Carbon desde el 1 de diciembre, que es el doble.
- Sube de nivel solo en las tareas que fallen: Sol a
highoxhigh, y Carbon ahighconmaxOutputTokensen 65.536.
Las rutas oficiales son el nivel de pago de la API de Gemini para Carbon y la API de OpenAI para Sol. Si prefieres lanzar los dos con una sola clave, el catálogo de LaoZhang API incluye gemini-4-carbon y gpt-6.1-sol a 16 de noviembre de 2026, y es la pasarela por la que se ejecutaron las pruebas de esta comparación; la documentación de LaoZhang API explica cómo llamar a cada modelo. Si haces la medición antes del 30 de noviembre, cada tarea de Carbon te costará la mitad que en diciembre.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Fuentes4
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 16 nov 2026.
Fuentes4
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 16 nov 2026.
- 1.comparativa de Artificial Analysis entre Gemini 4 Carbon y GPT-6.1 Solartificialanalysis.ai/models/releases/comparisons/gemini-4-carbon-vs-gpt-6-1-sol
- 2.página de precios de la API de Geminiaistudio.google.com/docs/pricing
- 3.ficha de gpt-6.1-sol en la documentación de la API de OpenAIdevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 4.Coding Agent Index v2.1 de Artificial Analysisartificialanalysis.ai/agents/coding-agents