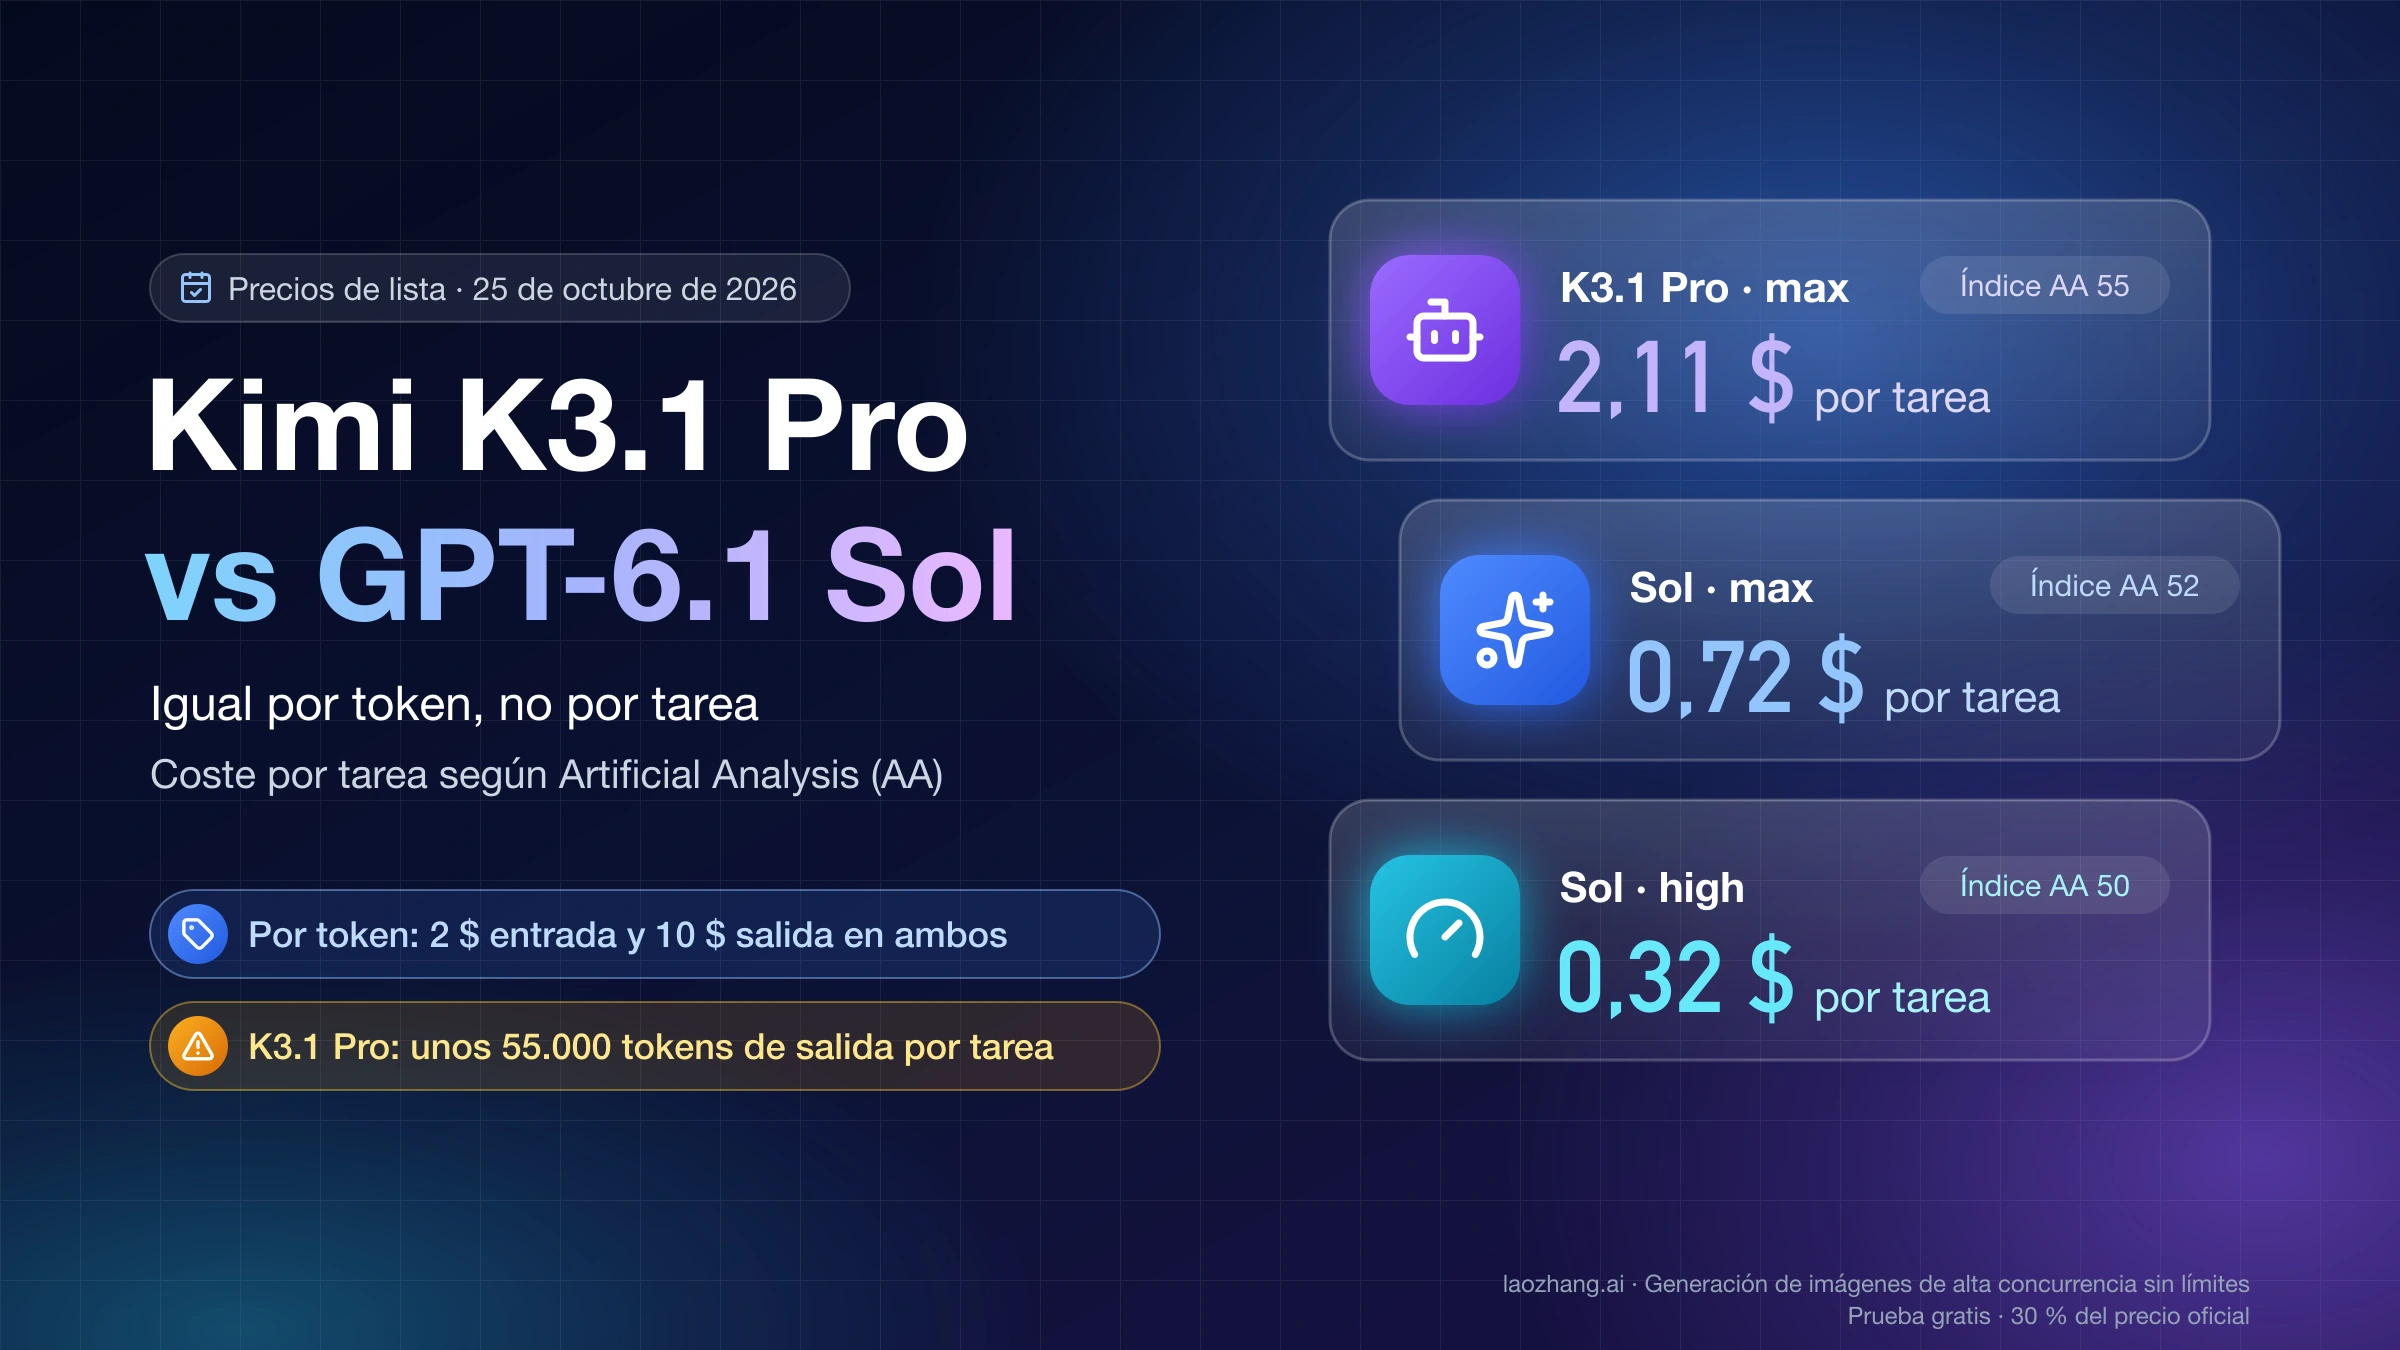
GPT-6.2 Sol vs 6.1 Sol vs Opus 5.5: prueba real y cuál usar
GPT-6.2 Sol cobra lo mismo que 6.1 Sol, puntúa más por nivel y en 12 tareas tardó 4 veces menos. Opus 5.5 compensa en agentes largos y en lo más difícil.
En esta página
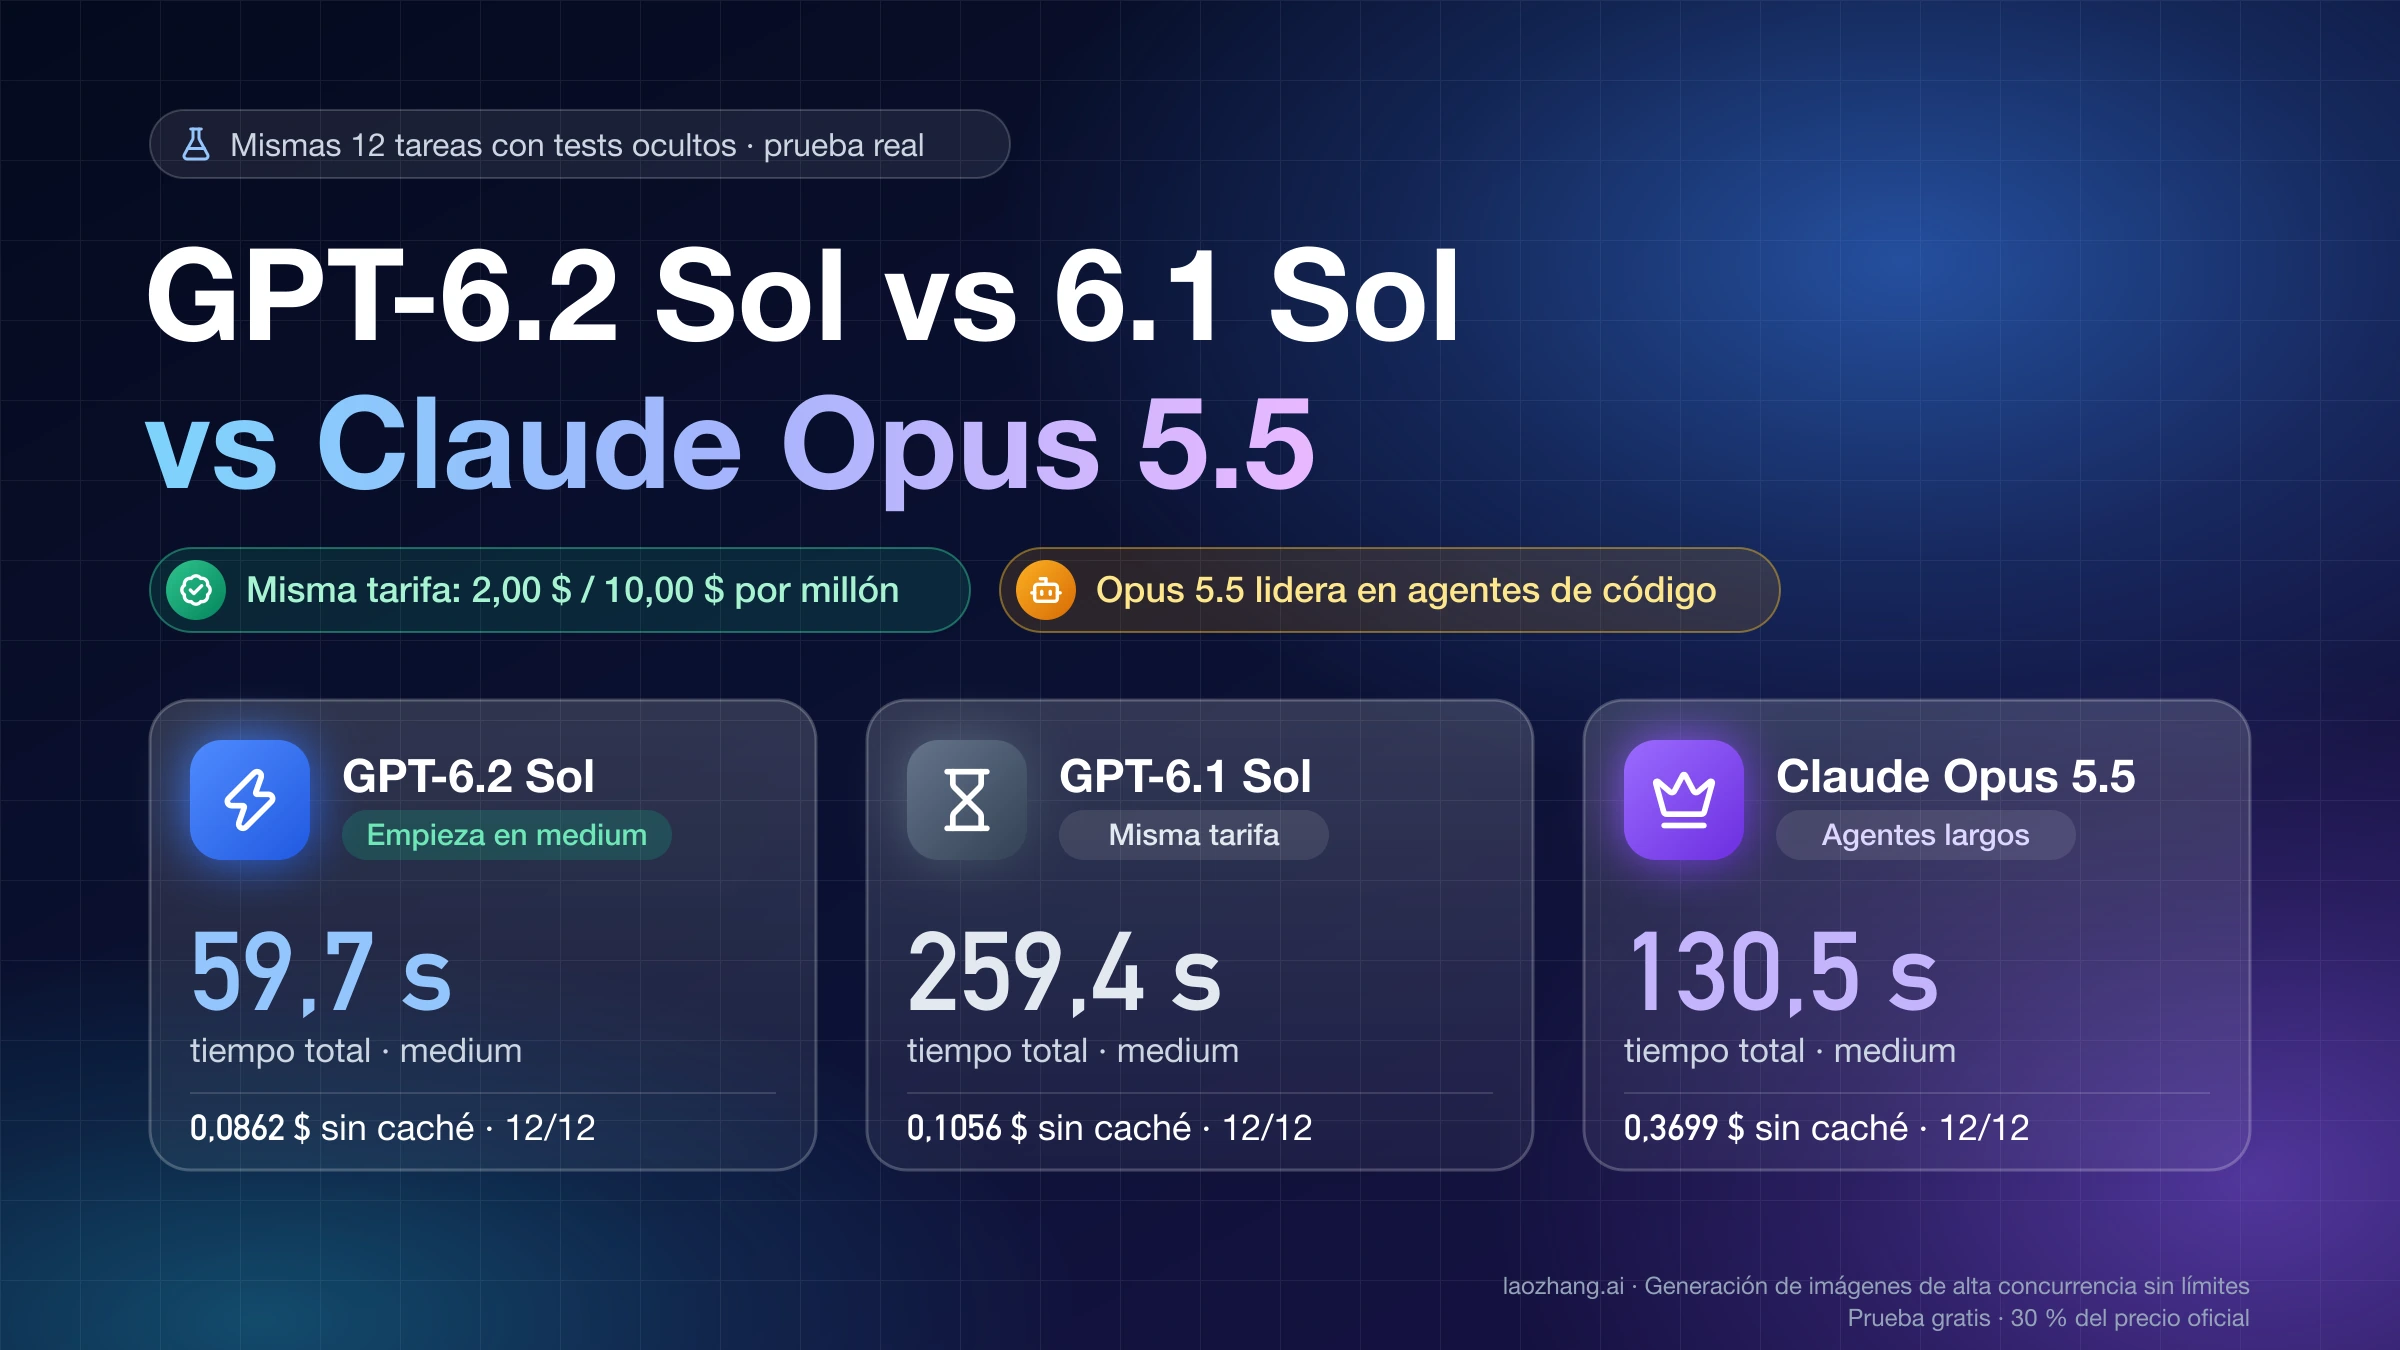
Si usas gpt-6.1-sol en la API o en Codex, cambia a gpt-6.2-sol y empieza en medium, su nivel de razonamiento (effort) por defecto. OpenAI lanzó GPT-6.2 Sol el 17 de noviembre de 2026 con la misma tarifa Standard que 6.1 Sol, 2,00 $ de entrada y 10,00 $ de salida por millón de tokens, y en el índice de inteligencia de Artificial Analysis puntúa más en los cinco niveles: en high saca los 55 puntos que 6.1 Sol solo alcanzaba en max, por el 44 % del coste por tarea. Con las mismas 12 tareas de programación y cálculo con tests ocultos (los dos GPT, el 18 de noviembre; Opus, 8 tareas el 11 de noviembre y 4 el 18), los tres acertaron las 12, y 6.2 Sol tardó 59,7 s en total frente a 259,4 s de 6.1 Sol y 130,5 s de Claude Opus 5.5 en medium.
Claude Opus 5.5 sigue siendo la opción para sesiones largas de agente de código en las que un fallo cuesta más que el modelo. En el índice de agentes de programación de Artificial Analysis, Claude Code con Opus 5.5 en max saca 58,2 puntos frente a 49,8 de la mejor configuración de Codex con 6.2 Sol, pero gasta 12,61 $ por tarea frente a 0,90 $. En razonamiento general, código corto con tests y lectura de documentos largos, 6.2 Sol en medium iguala o supera a Opus en high por una fracción del coste, así que ese es el trabajo que puedes mover.
La queja de que «6.2 Sol programa peor que 6.1» tiene una base concreta: en ese índice de agentes, 6.1 Sol en max marcaba 52,2 y 6.2 Sol no pasa de 49,8, aunque cuesta un 40 % menos por tarea. Si tu flujo son sesiones largas de Codex en max, compáralos en tus propias tareas antes de cambiar, y con 6.2 Sol usa xhigh como techo. Al migrar por API, revisa además tres cosas: 6.2 Sol, como 6.1 Sol, rechaza el effort none, que sí aceptan otros modelos y que puede llegarle desde ajustes o código compartidos con ellos; las instrucciones reutilizables deben ir en un mensaje developer al principio de input para entrar en la caché, y las llamadas a herramientas requieren la Responses API.
¿Pasar de GPT-6.1 Sol a 6.2 Sol? Misma tarifa, más puntos por nivel
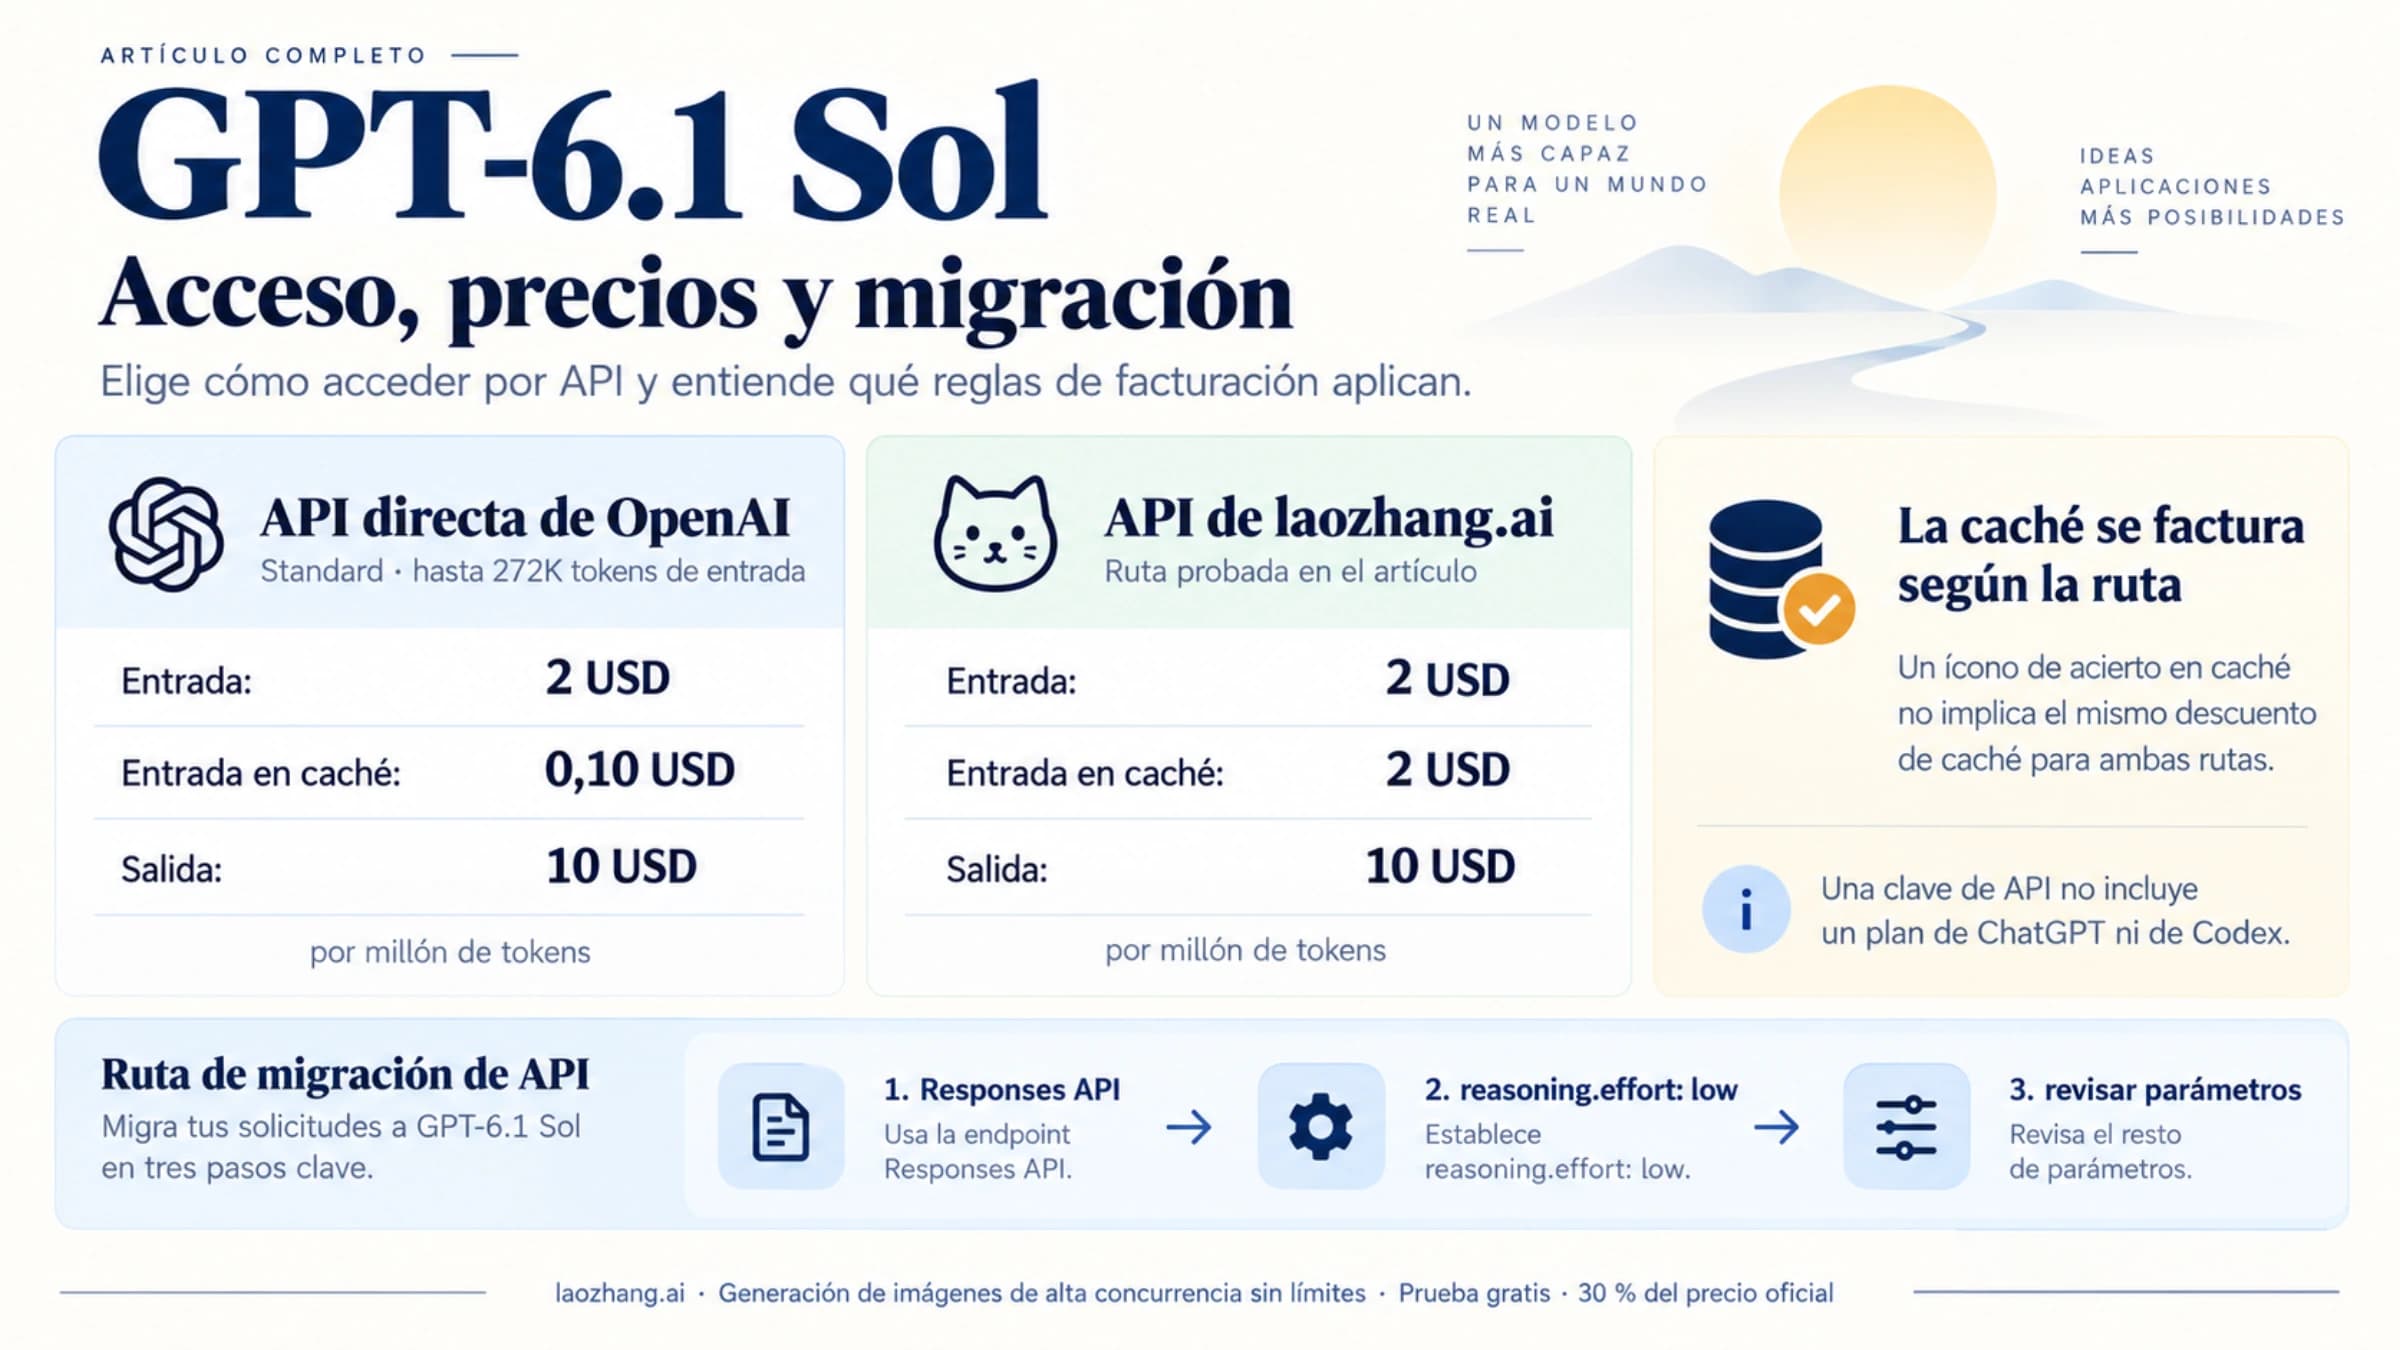
Para casi cualquier carga en la API, sí: pagas lo mismo por token y obtienes más puntuación en cada nivel de effort. A 18 de noviembre de 2026, la página de precios de la API de OpenAI pone a gpt-6.2-sol y gpt-6.1-sol en la misma fila Standard: 2,00 $ de entrada, 0,10 $ de entrada en caché, 2,50 $ por escritura en caché de 30 minutos, 5,00 $ por la de 12 horas y 10,00 $ de salida por millón de tokens, con Batch a 1,00 $ / 5,00 $ y Fast a 4,00 $ / 20,00 $ en los dos. Solo cambian dos cosas: Ultrafast cuesta en 6.2 Sol 6,00 $ / 30,00 $ (el triple de Standard hasta el 28 de febrero de 2027 y el séxtuple desde el 1 de marzo), frente a 12,00 $ / 60,00 $ en 6.1 Sol, y los descuentos por completar en segundo plano (30 % con una ventana de 2 horas, 40 % con una de 8) se aplican a 6.2 Sol y no a 6.1 Sol.
La ficha de gpt-6.2-sol mantiene el contexto de 1.050.000 tokens y la salida máxima de 128.000, y adelanta la fecha de corte de conocimiento al 1 de junio de 2026 (6.1 Sol se quedaba en el 30 de abril). OpenAI la describe en su registro de cambios como el modelo «para programación diaria y flujos de agentes».
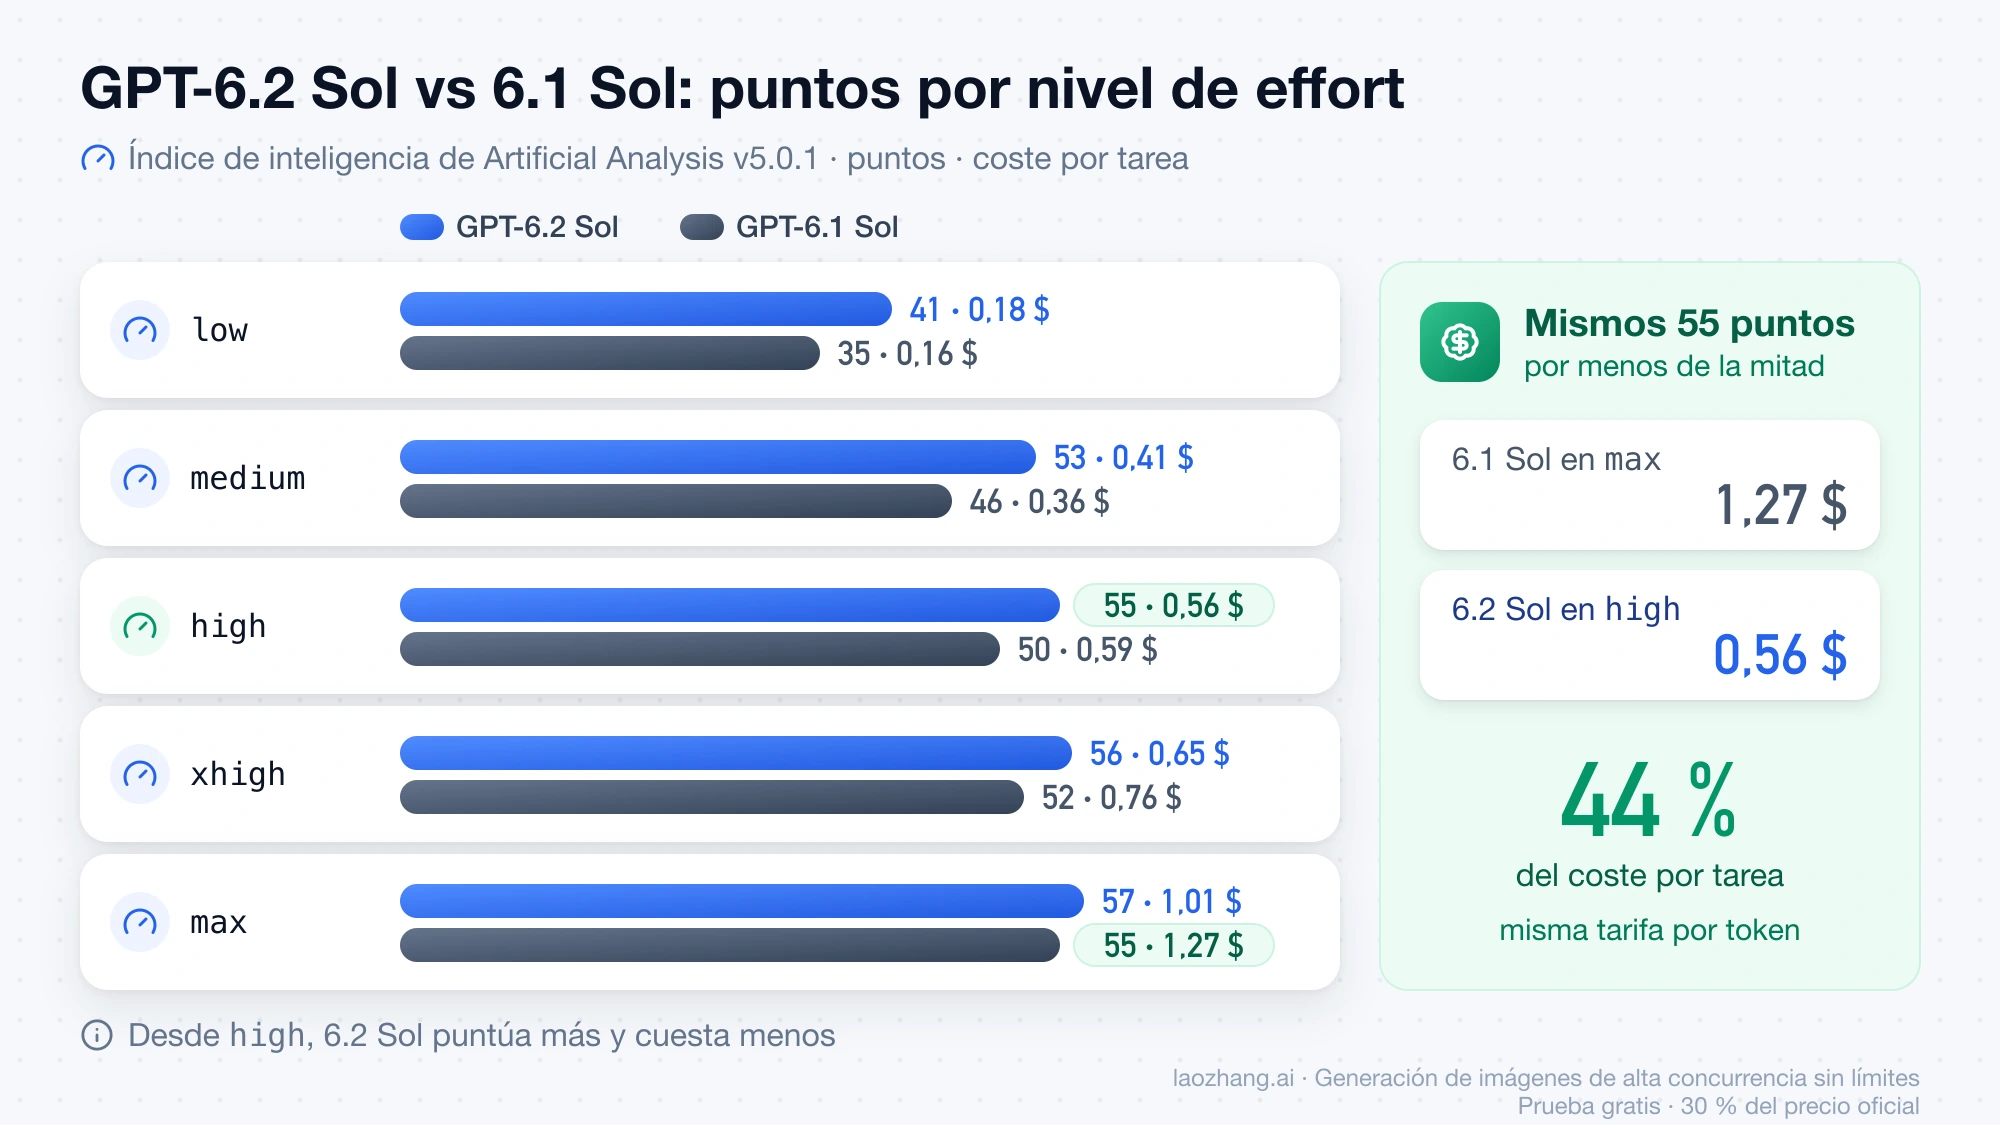
La diferencia por nivel se ve en el índice de inteligencia de Artificial Analysis (AA), versión 5.0.1. Las cifras de 6.2 Sol son de la comparativa de AA entre Claude Opus 5.5 y GPT-6.2 Sol a 18 de noviembre; las de 6.1 Sol, las que AA publicaba a 4 de noviembre (la de max, a 11 de noviembre):
| Nivel de effort | GPT-6.2 Sol: puntos · coste por tarea | GPT-6.1 Sol: puntos · coste por tarea | Qué cambia con 6.2 Sol |
|---|---|---|---|
low | 41 · 0,18 $ | 35 · 0,16 $ | 6 puntos más por 0,02 $ más |
medium | 53 · 0,41 $ | 46 · 0,36 $ | 7 puntos más por 0,05 $ más |
high | 55 · 0,56 $ | 50 · 0,59 $ | 5 puntos más y algo más barato |
xhigh | 56 · 0,65 $ | 52 · 0,76 $ | 4 puntos más por 0,11 $ menos |
max | 57 · 1,01 $ | 55 · 1,27 $ | 2 puntos más por 0,26 $ menos |
La mejora es mayor abajo y se estrecha arriba. En low y medium, 6.2 Sol cuesta entre un 12,5 % y un 14 % más por tarea, porque razona algo más, pero sube 6 y 7 puntos; desde high es más barato y puntúa más. La comparación que más ahorra es otra: si hoy usas 6.1 Sol en max, 6.2 Sol en high da la misma puntuación por 0,56 $ en lugar de 1,27 $, el 44 % del coste. El 18 de noviembre AA ya marca 6.1 Sol como «deprecated» en su catálogo y retiró sus páginas de comparación; es una etiqueta de AA, no un aviso de OpenAI.
En la API, OpenAI mantiene gpt-6.1-sol en su tabla de precios a 18 de noviembre de 2026 y su registro de cambios no le pone fecha de retirada; si seguirá seleccionable en Codex o en ChatGPT no consta en ninguna fuente oficial. Si vienes de un modelo anterior a 6.1 Sol, lo que cambió en esa versión está en GPT-6.1 Sol: qué cambia, cuánto cuesta y qué revisar al migrar.
¿GPT-6.2 Sol programa peor que 6.1? El 52 frente a 49 de los agentes
En parte sí, y solo en un tipo de medición: el trabajo de agente de código de larga duración. El índice de agentes de programación de Artificial Analysis, que combina FrontierCode 2.0, SWE-Atlas QnA y Terminal-Bench v4 con Codex CLI 0.166.0, daba a 18 de noviembre de 2026 a Codex con 6.1 Sol en max 52,2 puntos, y ninguna configuración de Codex con 6.2 Sol llega ahí. De ese 52 frente a 49 salen los hilos que dicen que el modelo nuevo programa peor.
| Agente y modelo (nivel) | Índice | Coste por tarea | Tiempo por tarea |
|---|---|---|---|
Codex + GPT-6.1 Sol (max) | 52,2 | 1,51 $ | 21,9 min |
Codex + GPT-6.2 Sol (xhigh) | 49,8 | 0,90 $ | 12,6 min |
Codex + GPT-6.2 Sol (max) | 48,6 | 1,22 $ | 17,5 min |
Codex + GPT-6.2 Sol (high) | 47,5 | 0,76 $ | 10,6 min |
Codex + GPT-6.2 Sol (medium) | 45,4 | 0,57 $ | 8,4 min |
Claude Code + Claude Opus 5.5 (max) | 58,2 | 12,61 $ | 65,3 min |
Leída entera, la tabla dice tres cosas. La mejor fila de 6.2 Sol queda 2,4 puntos por debajo de 6.1 Sol en max, pero cuesta un 40 % menos por tarea (0,90 $ frente a 1,51 $) y tarda un 42 % menos (12,6 frente a 21,9 minutos). En Codex, 6.2 Sol en max puntúa menos que en xhigh y cuesta más, así que xhigh es el techo útil. Y AA solo publica la fila max de 6.1 Sol, de modo que si usabas 6.1 Sol en medium o high dentro de Codex, este índice no dice si 6.2 Sol es peor en tu nivel. La etiqueta «Default Fallback» que acompaña a Opus 5.5 en la tabla de AA es suya, no un ajuste de Anthropic.
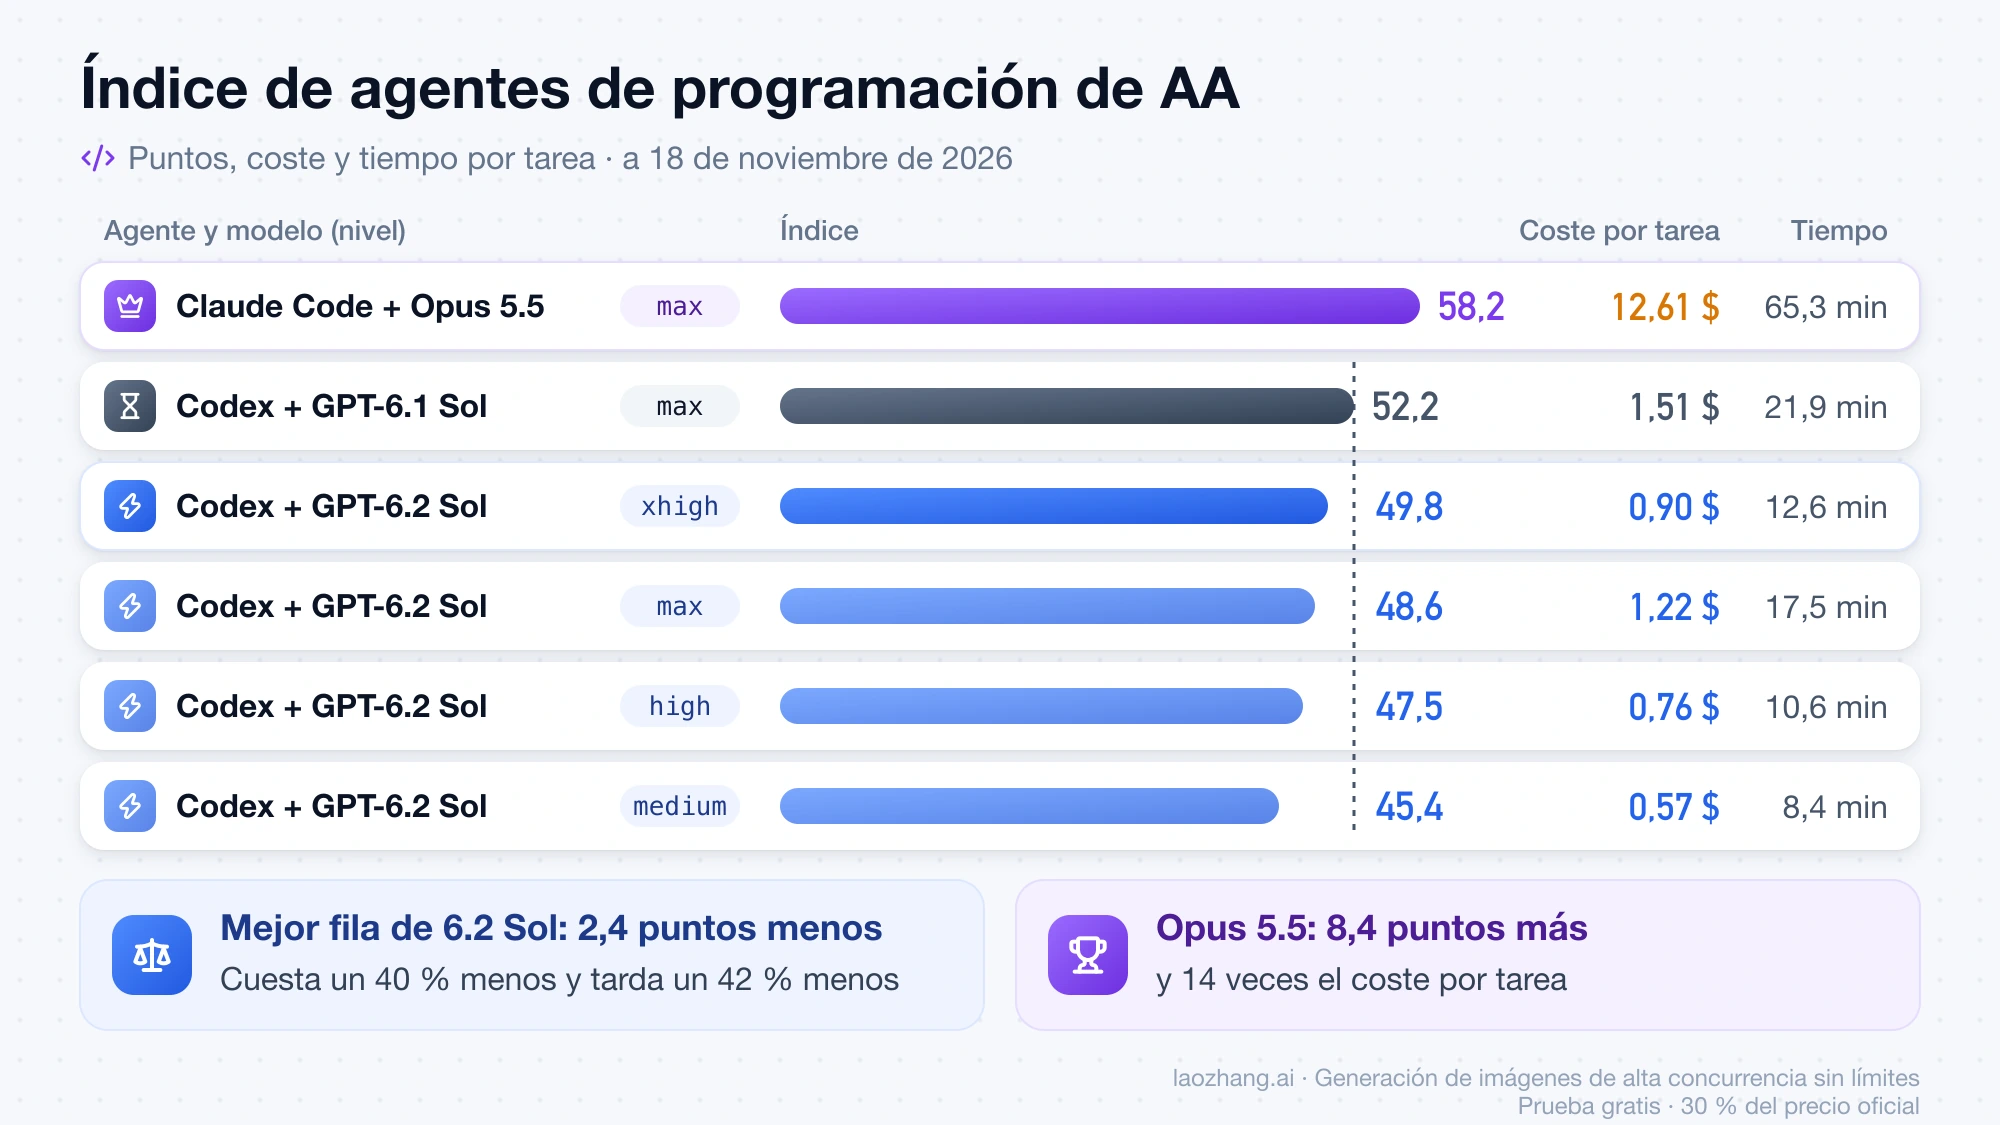
Las reacciones de los usuarios van en las dos direcciones. En r/codex, un hilo titulado «6.2 Sol is worse than 6.1» reunía 305 votos, y VentureBeat tituló «Essentially unusable» su crónica sobre la mala acogida de GPT-6.2 Astra y Sol entre los usuarios avanzados; en el hilo del lanzamiento en Hacker News, en cambio, otro usuario contaba que su coste pasó de 2,6 $ con 6.1 Sol a 1,2 $ con 6.2 Sol, con una precisión parecida. Son testimonios sin método publicado. Si tu flujo son sesiones largas en max y la puntuación pesa más que el coste, prueba 6.2 Sol en xhigh con tus tareas antes de cambiar; si necesitas más que 6.1 Sol sin salir de OpenAI, Codex con GPT-6.2 Astra en xhigh marca 53,1 por 3,20 $ por tarea.
Mismas 12 tareas: los tres aciertan y 6.2 Sol tarda 4 veces menos que 6.1
Las mismas 12 tareas de un solo turno se enviaron a los tres modelos a través de la pasarela de laozhang.ai: funciones de programación evaluadas con tests ocultos (unir intervalos, comparar versiones semver, evaluar expresiones, partir líneas CSV) y problemas con respuesta exacta. GPT-6.1 Sol y 6.2 Sol se llamaron el 18 de noviembre de 2026 por /v1/chat/completions, sin reasoning_effort (equivale a medium) y en high; Opus 5.5, con razonamiento adaptativo en medium y high, resolvió 8 de las tareas el 11 de noviembre y las otras 4 el 18. Los tres aprobaron las 12 en los dos niveles, así que la prueba no separa su capacidad: mide tiempo, tokens y dinero para el mismo resultado.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Modelo y nivel | Aciertos | Tokens de salida | Tiempo sumado | Coste facturado | Coste sin caché |
|---|---|---|---|---|---|
GPT-6.2 Sol, por defecto (medium) | 12/12 | 4.220 | 59,7 s | 0,0721 $ | 0,0862 $ |
GPT-6.2 Sol, high | 12/12 | 6.765 | 76,6 s | 0,1217 $ | 0,1116 $ |
GPT-6.1 Sol, por defecto (medium) | 12/12 | 6.167 | 259,4 s | 0,1158 $ | 0,1056 $ |
GPT-6.1 Sol, high | 12/12 | 10.380 | 363,1 s | 0,1579 $ | 0,1477 $ |
Claude Opus 5.5, medium | 12/12 | 11.833 | 130,5 s | 0,3699 $ | 0,3699 $ |
Claude Opus 5.5, high | 12/12 | 13.674 | 159,3 s | 0,4067 $ | 0,4067 $ |
Con el nivel por defecto, 6.2 Sol escribió un 32 % menos de tokens que 6.1 Sol (4.220 / 6.167 = 0,68) y tardó 4,3 veces menos (259,4 / 59,7); en high, 4,7 veces menos. En dinero la ventaja es menor de lo que sugiere la columna facturada: esa columna incluye las escrituras en caché que cobró la API en las dos tareas con unos 10.000 tokens de entrada (2,50 $ por millón en vez de 2,00 $) y, en 6.2 Sol, una lectura de caché de 10.103 tokens que se produjo porque el mismo enunciado acababa de enviarse en high. Con toda la entrada a precio normal, 6.2 Sol costó un 18 % menos que 6.1 Sol (0,0862 $ frente a 0,1056 $). Opus 5.5 en medium escribió 2,8 veces más tokens que 6.2 Sol, tardó 2,2 veces más y costó 4,3 veces más sin caché: una parte se explica porque su precio por token dobla el de Sol, y el resto, por los tokens de más.
La segunda prueba fue contar siete cifras exactas en un log de 146 KB y 1.500 líneas. Los tres acertaron las siete. GPT-6.2 Sol tardó 13,6 s y costó 0,158 $ el 18 de noviembre; GPT-6.1 Sol, 45,7 s y 0,165 $ el 16 de noviembre; Claude Opus 5.5 en medium, 57,6 s y 0,468 $ el 11 de noviembre. El mismo archivo ocupó 78.537 tokens de entrada en Opus y 55.843 en Sol, 1,41 veces más, así que en documentos largos Opus no solo cobra el doble por token, también cuenta más tokens. El log está muy por debajo de los 272.000 tokens en los que sube la tarifa de Sol, de modo que esta prueba no dice nada sobre ese tramo.
Los límites pesan tanto como las cifras. Cada combinación se ejecutó una vez; 8 de las 12 tareas de Opus son del 11 de noviembre con respuesta en streaming y las otras 4 del 18 sin streaming; Opus en high aprobó la tarea de intervalos tras separar la función y los tests en dos archivos; los tiempos son de reloj en la pasarela, no la latencia del fabricante, y los costes salen de multiplicar los tokens devueltos por el precio de lista. No se probaron sesiones de agente con herramientas, cambios en varios archivos ni entradas de más de 272.000 tokens, que es justo donde el índice de agentes de AA ve ventaja para 6.1 Sol y para Opus. Por qué 6.1 Sol tardaba tanto, y cómo acelerarlo si te quedas en él, se explica en GPT-6.1 Sol lento en Codex y API: qué lo frena y cómo acelerarlo.
¿GPT-6.2 Sol en low o medium supera a Opus 5.5 en medium?
En low, no; en medium, sí, y también supera a Opus en high. En el índice de inteligencia de AA (v5.0.1) a 18 de noviembre de 2026, GPT-6.2 Sol en low saca 41 puntos y Claude Opus 5.5 en medium, 48 con 2,45 $ y 6,8 minutos por tarea, así que el nivel más barato de Sol se queda 7 puntos por debajo. Subiendo un nivel, 6.2 Sol en medium saca 53 puntos en 3,1 minutos, por encima de Opus en medium y de Opus en high (52 puntos, 3,46 $, 9,3 minutos), que cuesta 8,4 veces más (3,46 / 0,41). Al mismo nombre de nivel, Sol puntúa siempre más hasta high; aun así, los nombres no significan lo mismo en dos fabricantes distintos, y la comparación justa es a igual puntuación.
A igual puntuación, Sol es más barato en todo el tramo que cubren los dos. Opus en low saca 35 puntos por 0,98 $ y 3,0 minutos, menos que Sol en low por más de cinco veces su coste. Los 57 puntos de Opus en xhigh cuestan 6,05 $ y 15,6 minutos por tarea; Sol en max llega a los mismos 57 con 1,01 $ y 7,9 minutos, un sexto del coste (6,05 / 1,01 = 6,0) y la mitad del tiempo. Solo arriba del todo cambia el reparto: Opus en max saca 59 puntos con 10,04 $ y 24,5 minutos, y Sol no tiene ninguna configuración que llegue ahí.
Donde Opus conserva ventaja es en las pruebas más duras. En el nivel máximo de cada uno, Opus saca un 46,4 % en FrontierCode-AA 2.0 frente al 44,4 % de Sol y un 67,9 % en HLE-Diamond frente al 64,0 %, mientras que en Terminal-Bench 4.0 empatan en la práctica (59,6 % frente a 60,1 %). Es decir, hasta 57 puntos no hay configuración de Opus que no tenga una de Sol igual o mejor y más barata; por encima, los 59 puntos de Opus en max no tienen equivalente en Sol. AA mide con sus propios enunciados y ajustes, así que estas cifras sirven para decidir qué probar, no para saltarte la prueba con tus tareas.
Qué trabajo de Opus 5.5 pasar a GPT-6.2 Sol y qué pierdes
Pasa a GPT-6.2 Sol todo el trabajo cuyo resultado puedes comprobar de forma barata (código con tests, cifras exactas, extracción de documentos) y en el que el volumen pesa; deja en Claude Opus 5.5 las sesiones largas de agente y los problemas que Sol no resuelve tras varios intentos. Por token, Opus 5.5 cuesta exactamente el doble: 4,00 $ de entrada y 20,00 $ de salida por millón según la tarifa de Anthropic, que se aplica igual en todo su contexto de 1 millón de tokens. Lo que pierdes al cambiar son los puntos de más en agentes de código y en razonamiento muy difícil.
| Si tu trabajo es… | Empieza con | Qué vigilar |
|---|---|---|
| Funciones, scripts o transformaciones de datos con tests | GPT-6.2 Sol en medium | En las 12 tareas, mismo acierto que Opus por menos de una cuarta parte del coste |
| Leer logs, contratos o documentos largos y extraer cifras | GPT-6.2 Sol en medium | Por encima de 272.000 tokens de entrada, Sol cobra 4,00 $ / 15,00 $ en toda la petición; Opus mantiene 4,00 $ / 20,00 $ pero cuenta más tokens por el mismo texto |
| Sesiones largas de agente en Claude Code, cambios en muchos archivos | Claude Opus 5.5 si el presupuesto lo permite | Su ventaja en el índice de agentes de AA es de 8,4 puntos y cuesta 14 veces más por tarea; prueba antes 6.2 Sol en xhigh en Codex |
| Razonamiento difícil sin herramientas, análisis largos | GPT-6.2 Sol en high | Si te faltan los últimos puntos, Opus en max es el único que llega a 59 |
| Mucho volumen, respuestas rápidas | GPT-6.2 Sol en low | Es la configuración más barata de las diez del índice de AA y aun así supera a Opus en low |
La diferencia de coste en tareas de agente largas puede ser mayor que en las pruebas cortas. Un usuario de X (EnvolDev) contó que el mismo prompt de una escena 3D («Alpine Gold») le costó 2,07 $ y 30 minutos y 47 segundos con 6.2 Sol y 31,85 $ y 2 horas y 45 minutos con Opus 5.5; el comentario de Hacker News que veía a 6.2 Sol más barato que 6.1 con una precisión parecida terminaba, aun así, con «Opus 5.5 is just the better model» (Opus 5.5 es, sin más, el mejor modelo). Son casos sueltos, pero marcan bien el dilema: Opus cuesta mucho más por tarea larga, y hay quien considera que el resultado lo compensa.
Si decides quedarte con Opus o probarlo por primera vez, los planes que lo incluyen y cómo acceder están en Cómo usar Claude Opus 5.5: qué plan pide y cómo probarlo gratis. Si comparabas Opus con la generación anterior de Sol, las cuentas de entonces siguen en Claude Opus 5.5 vs GPT-6 Sol y 6.1 Sol: cuál probar y qué pagas.
Qué cambiar en las peticiones al pasar a gpt-6.2-sol
En una llamada simple basta con cambiar el nombre del modelo, pero varios detalles cambian el comportamiento o la factura. La guía de migración de OpenAI a GPT-6.2 recoge la mayoría, y las respuestas de la API a través de laozhang.ai del 18 de noviembre de 2026 confirman los que afectan al effort y a la caché:
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
- Si una configuración compartida o código escrito para modelos que aceptan
noneenvíareasoning.effort: "none"(oreasoning_efforten Chat Completions) a 6.2 Sol, la petición falla con un 400: «Unsupported value: 'none' is not supported with the 'gpt-6.2-sol' model. Supported values are: 'low', 'medium', 'high', 'xhigh', and 'max'.» OpenAI recomienda pasar alowsi usabasnoneominimal, y empezar enmediumen integraciones nuevas. - Si tienes instrucciones largas y repetidas en el campo
instructionsde la Responses API, muévelas a un mensajedevelopercomo primer elemento deinput, porque desde GPT-6.2 las instrucciones de nivel superior se colocan después de la entrada y OpenAI indica que, para que entren en la caché de prompts, deben ir en ese mensaje inicial. En la prueba, un bloque de unos 9.000 tokens enviado tres veces comoinstructionsno leyó ni un token de caché, ni por laozhang.ai ni directamente en OpenAI, lo que encaja con ese cambio. - Si usas llamadas a herramientas, hazlo por la Responses API, que OpenAI exige para ellas; Chat Completions sigue aceptando texto, imagen y streaming. Para
maxusa también Responses, porque en la misma pruebareasoning_effort: "max"falló por Chat Completions. - Si editas mensajes anteriores de la conversación o cambias de modelo a mitad de ella (bajar a otro modelo incluido), la Responses API descarta los elementos de razonamiento previos; OpenAI avisa de que la calidad puede bajar y el modelo gastar más tokens repitiendo trabajo, así que mantén el prefijo intacto.
- Si migras peticiones de Chat Completions, quita
temperature,top_p,logprobsytop_logprobs. - Si una petición supera los 272.000 tokens de entrada, toda ella se cobra a 4,00 $ de entrada y 15,00 $ de salida por millón, así que conviene trocear los documentos que rozan ese tamaño.
Un detalle más: por Chat Completions, las respuestas de 6.2 Sol llegaron con "model": "gpt-6.2-sol-2026-11-17", pero OpenAI no publica ninguna versión con fecha de este modelo, así que no la uses para fijar la versión en tu código. Mientras no tengas tus propias cifras, la configuración razonable es gpt-6.2-sol en medium para el trabajo diario, xhigh como techo en Codex y Opus 5.5 reservado para las tareas largas que Sol no cierre.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 18 nov 2026.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 18 nov 2026.
- 1.página de precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing
- 2.ficha de gpt-6.2-soldevelopers.openai.com/api/docs/models/gpt-6.2-sol
- 3.comparativa de AA entre Claude Opus 5.5 y GPT-6.2 Solartificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-2-sol
- 4.índice de agentes de programación de Artificial Analysisartificialanalysis.ai/agents/coding
- 5.guía de migración de OpenAI a GPT-6.2developers.openai.com/api/docs/guides/latest-model