Gemini 4 Hydrogen: precio de la API y coste real por llamada
Gemini 4 Hydrogen cuesta 1,50 $ y 7,50 $ por millón de tokens, pero el razonamiento se cobra como salida: una llamada corta costó de 0,0016 $ a 0,0495 $.
En esta página
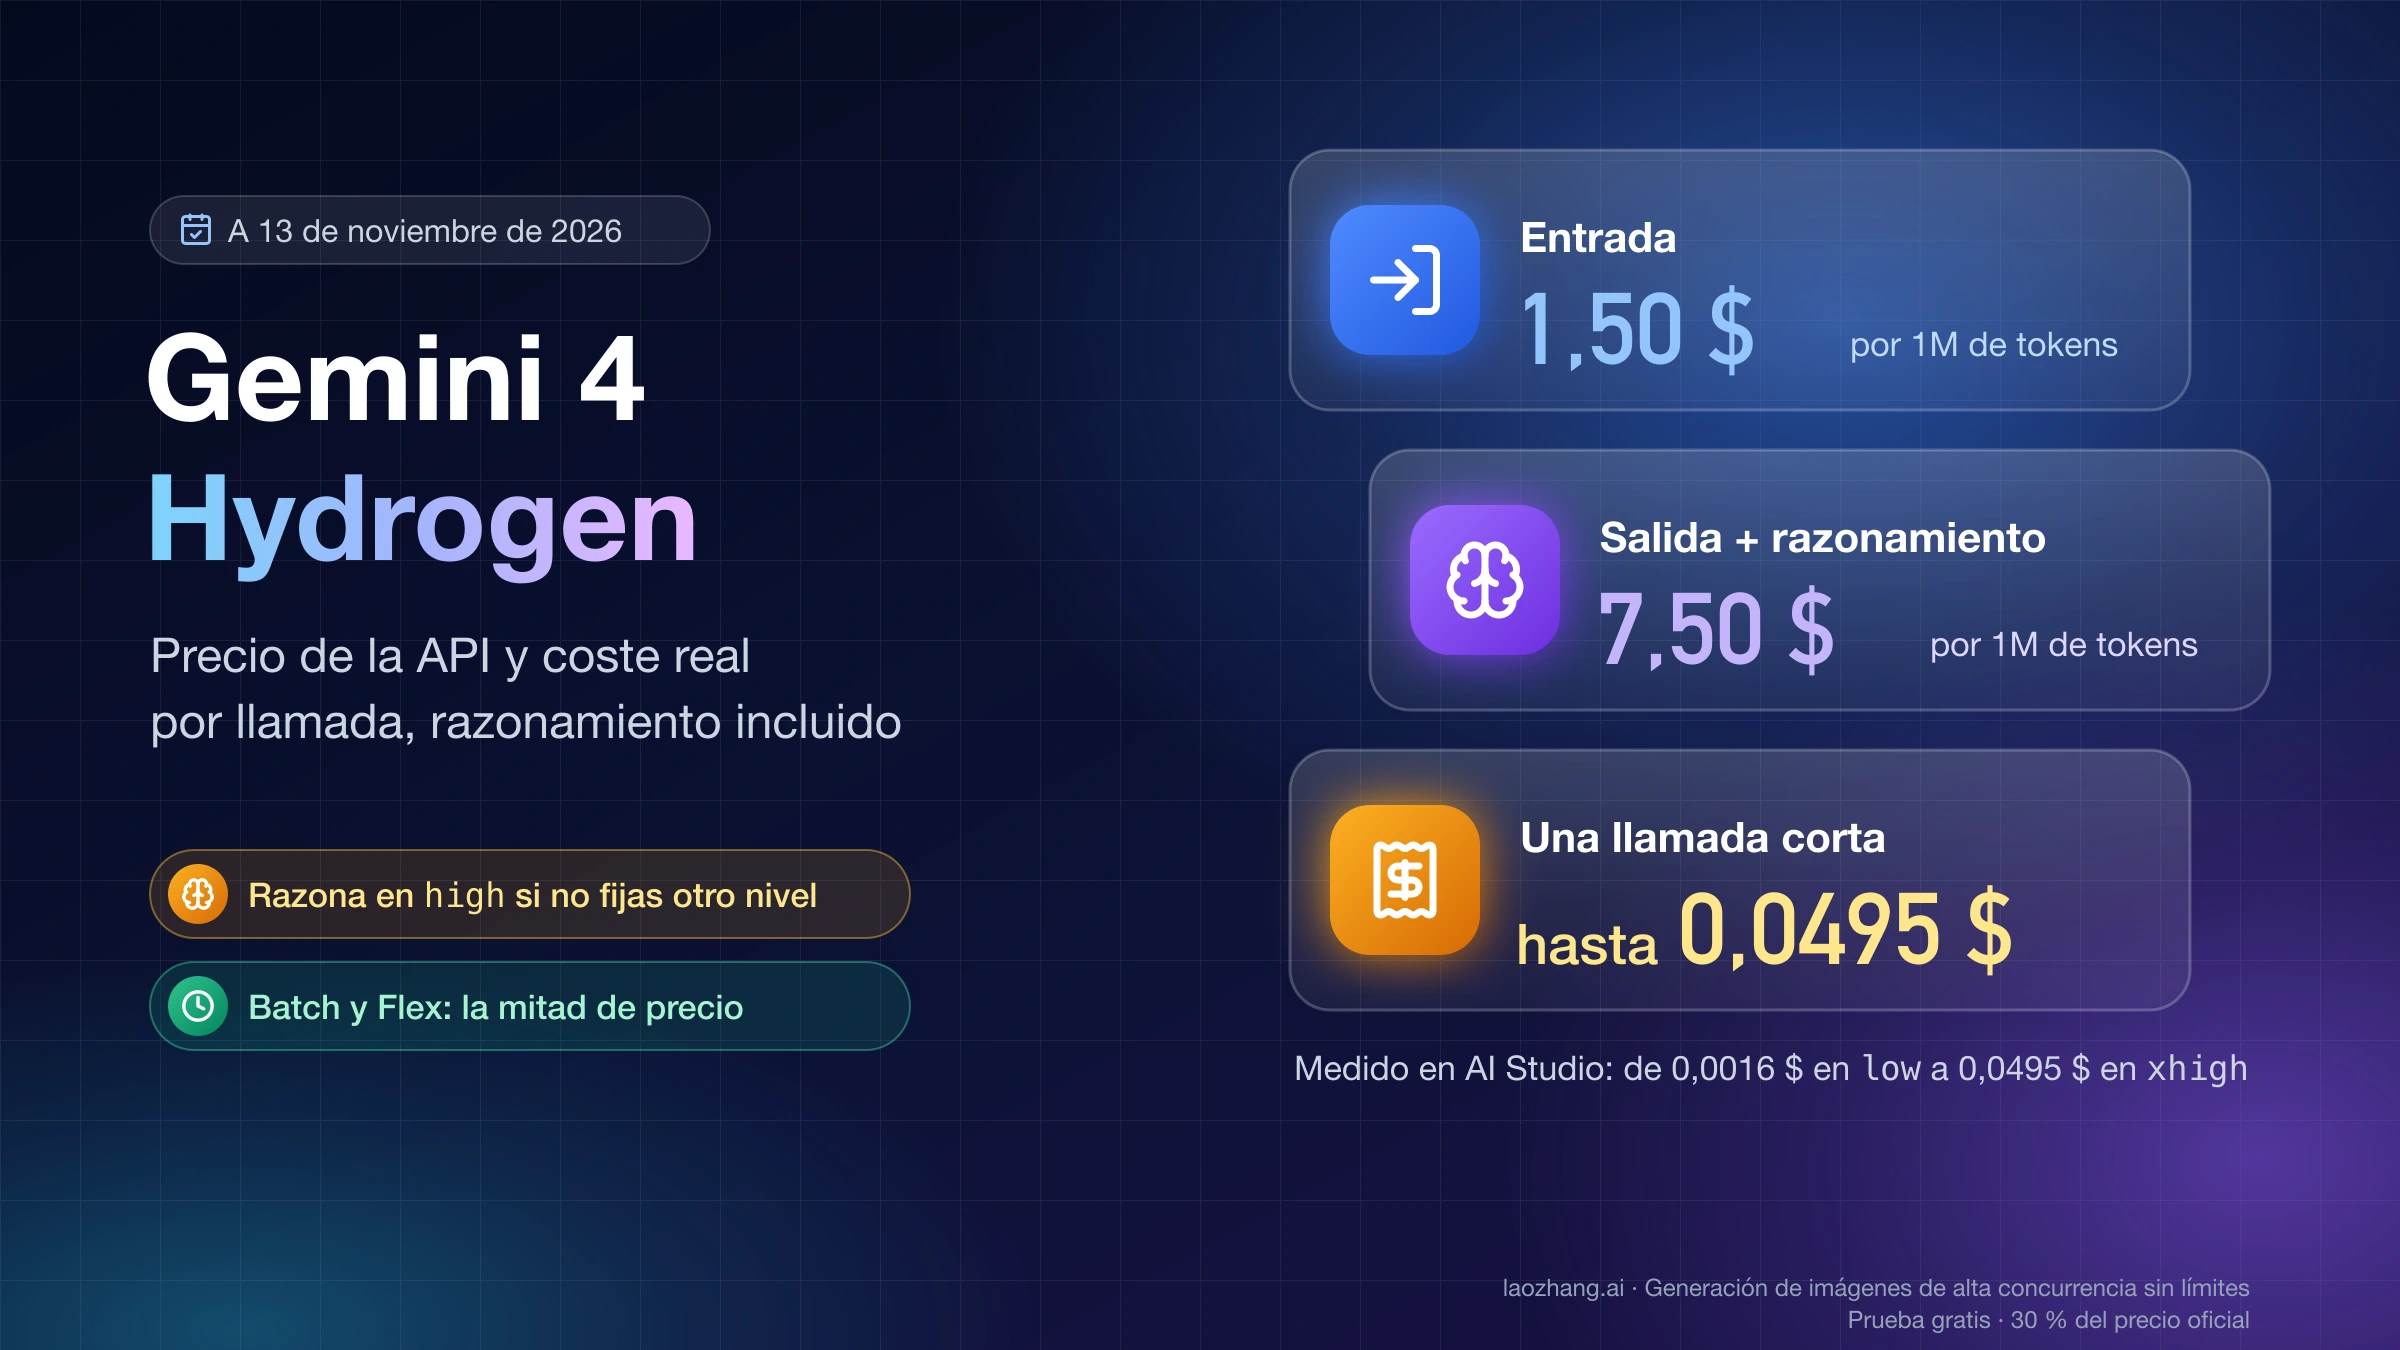
Gemini 4 Hydrogen (gemini-4-hydrogen) cuesta en la API de Gemini 1,50 $ por millón de tokens de entrada y 7,50 $ por millón de tokens de salida, con el mismo precio en toda su ventana de 1 millón de tokens. A 13 de noviembre de 2026, un día después del lanzamiento, la página de precios de la API de Gemini aclara que la salida incluye los tokens de razonamiento, y el modelo razona en nivel high si no le indicas otro. Por eso la tarifa no es la factura: en una prueba en Google AI Studio ese mismo día, una llamada corta costó entre 0,0016 $ y 0,0495 $ según el nivel de razonamiento, y la salida supuso entre el 89 % y el 99,7 % de cada importe.
Para presupuestarlo, cuenta los tokens de salida con el razonamiento dentro y fija thinking_level en cada petición: low o medium para tareas sencillas y de mucho volumen, high para código y agentes complejos, y xhigh solo donde high se quede corto, porque en esa prueba multiplicó por 3 o por 4 la salida de high. Lo que no necesite respuesta inmediata puede ir por Batch o Flex, que cobran la mitad.
La comparación con otros modelos depende de la fecha. Hoy Hydrogen cuesta por token el doble que Gemini 3.8 Flash, pero Flash sube a la misma tarifa el 1 de enero de 2027, y Gemini 4 Argon y Carbon duplican su precio el 1 de diciembre de 2026. Para probarlo sin pagar, el nivel gratuito de AI Studio y de la API incluye Hydrogen, a cambio de que Google use esos datos para mejorar sus productos.
Precio de Gemini 4 Hydrogen en la API: Standard, Batch, Flex y Priority
En la API de Gemini, Hydrogen tiene un nivel gratuito y varias modalidades de pago, y todas cobran el razonamiento al precio de la salida. Standard es la tarifa normal; Batch y Flex cobran la mitad a cambio de no responder al momento; Priority cuesta un 80 % más que Standard. Estos son los precios en USD por millón de tokens a 13 de noviembre de 2026, según la página de precios de la API de Gemini y la página de precios de IA generativa de Google Cloud para Vertex AI:
| Modalidad | Entrada | Salida (razonamiento incluido) | Entrada leída de caché |
|---|---|---|---|
| Nivel gratuito (AI Studio y API) | Gratis | Gratis | Gratis |
| Standard | 1,50 $ | 7,50 $ | 0,075 $ |
| Batch y Flex | 0,75 $ | 3,75 $ | 0,0375 $ |
| Priority | 2,70 $ | 13,50 $ | 0,135 $ |
| Vertex AI, Standard con endpoint Global | 1,50 $ | 7,50 $ | 0,075 $ |
| Vertex AI, Standard con endpoint Non-global | 1,65 $ | 8,25 $ | 0,0825 $ |
No hay un tramo más caro para contextos largos: el precio es el mismo hasta el millón de tokens. La caché solo es implícita. Según la guía de novedades de Gemini 4 Hydrogen, se activa sola en peticiones de al menos 4.096 tokens y descuenta un 95 % los tokens de entrada que aciertan en caché, pero no puedes crear una caché explícita para forzar ese descuento.
En Google Cloud, Global y Non-global indican la región del endpoint, no un plan distinto. Un endpoint regional (Non-global) cuesta un 10 % más en todas las modalidades: Batch y Flex pasan a 0,825 $ y 4,125 $, y Priority a 2,97 $ y 14,85 $. Si viste 0,75 $ y 3,75 $ como precio de Hydrogen, son las cifras que circularon en X el 12 de noviembre, antes del lanzamiento, y coinciden con Batch y Flex, no con la tarifa Standard.
Coste real por llamada: prueba en AI Studio con los cuatro niveles
Una llamada corta a Gemini 4 Hydrogen costó en esta prueba entre una fracción de céntimo y unos 5 céntimos de dólar, y lo que decidió el importe fue el nivel de razonamiento. El 13 de noviembre de 2026 se lanzaron en Google AI Studio, con una cuenta de Google en el nivel gratuito y el modelo gemini-4-hydrogen, dos tareas fijas en los cuatro niveles (en el menú de AI Studio se llaman Low, Medium, High y Extra High), cada una en un chat nuevo, y se anotó el recuento de «Token Usage» que muestra AI Studio en cada respuesta. La tarea A pide una función de Python parse_duration y solo el código; la tarea B pide calcular, en cinco líneas como máximo, la factura mensual de un SaaS. El coste está calculado a precio Standard:
| Tarea y nivel | Tokens de entrada | Tokens de salida (con razonamiento) | Coste por llamada | Por 1.000 llamadas |
|---|---|---|---|---|
A, código, low | 85 | 732 | 0,0056 $ | 5,62 $ |
A, código, medium | 85 | 1.169 | 0,0089 $ | 8,89 $ |
A, código, high | 85 | 1.588 | 0,0120 $ | 12,04 $ |
A, código, xhigh | 85 | 6.586 | 0,0495 $ | 49,52 $ |
B, cálculo, low | 118 | 187 | 0,0016 $ | 1,58 $ |
B, cálculo, medium | 118 | 906 | 0,0070 $ | 6,97 $ |
B, cálculo, high | 118 | 651 | 0,0051 $ | 5,06 $ |
B, cálculo, xhigh | 118 | 2.053 | 0,0156 $ | 15,57 $ |
Cada fila se recalcula así: tokens de entrada × 1,50 / 1.000.000 + tokens de salida × 7,50 / 1.000.000. El nivel xhigh generó 4,15 veces la salida de high en la tarea A y 3,15 veces en la B, y unas 9 y 11 veces la de low. Pagar más no cambió la respuesta en estas dos tareas: B dio el resultado correcto, 2.916 $, en los cuatro niveles, y A devolvió en todos un analizador basado en una expresión regular; xhigh solo cambió detalles como precompilar el patrón. En low, la tarea B ni siquiera mostró un bloque de razonamiento.
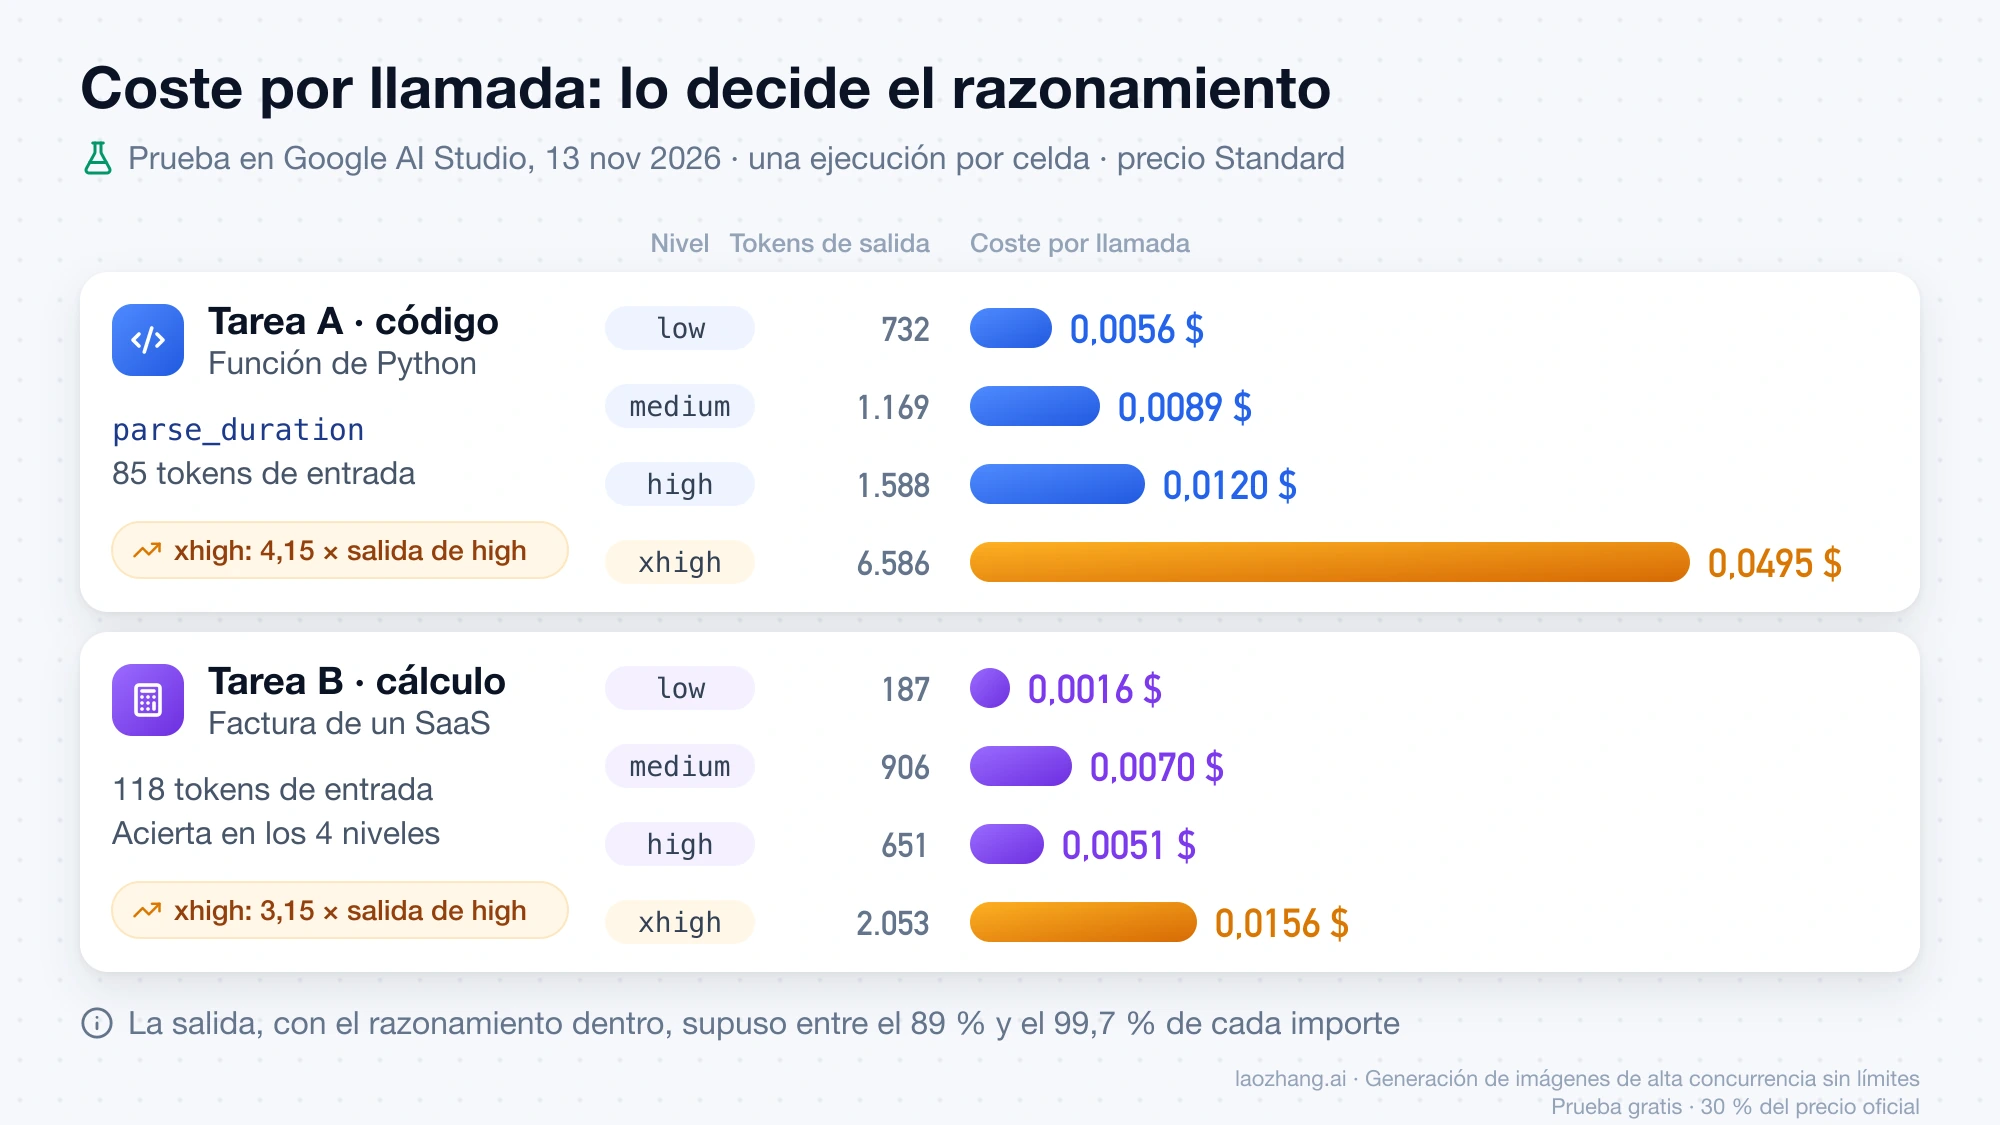
Hay límites que conviene tener en cuenta antes de extrapolar. Cada celda es una sola ejecución, y por eso en la tarea B medium gastó más que high (906 frente a 651 tokens): un nivel más bajo gasta menos de media, no en cada llamada. Las cifras son lecturas de la interfaz de AI Studio, no una factura de la API, aunque la página de precios dice que el nivel de pago cobra cada token procesado, razonamiento incluido. El código de la tarea A se leyó pero no se ejecutó, y la caché no se probó: con entradas de menos de 120 tokens no llega al mínimo de 4.096.
Coste mensual: la cuenta con los tokens de razonamiento dentro
El coste mensual de Gemini 4 Hydrogen es el número de peticiones por la suma de entrada y salida de cada una, y la salida tiene que llevar el razonamiento. La fórmula a precio Standard es: peticiones al mes × (tokens de entrada × 1,50 + tokens de salida con razonamiento × 7,50) / 1.000.000. Con la API puedes medir tu propio razonamiento: la guía de razonamiento de la API de Gemini explica que el precio de la respuesta suma los tokens de salida y los de razonamiento, y que el total de estos últimos llega en el campo total_thought_tokens.
El ejemplo de la tarea B sirve como plantilla. Un SaaS con 12.000 usuarios que hacen 40 peticiones al mes suma 480.000 peticiones; si cada una lleva 1.800 tokens de entrada y 450 de respuesta visible, la entrada cuesta 1.296 $ (864 millones de tokens × 1,50 $) y la salida 1.620 $ (216 millones × 7,50 $), en total 2.916 $ al mes. Esa cifra solo vale si el modelo no razona. Cada 500 tokens de razonamiento de media por petición añaden 240 millones de tokens de salida, es decir, 1.800 $ más al mes; con 2.000 de media, la factura llegaría a 10.116 $. Mide tu media con tráfico real en dos o tres niveles antes de fijar el presupuesto, porque en la prueba anterior la salida de una misma tarea varió entre 187 y 2.053 tokens.
¿Qué nivel de razonamiento sale más barato? El más bajo que acierte
El nivel más barato es siempre low, pero el que te conviene es el más bajo que resuelva bien tus propias tareas, porque casi toda la diferencia de precio entre niveles está en los tokens de salida. Google recomienda en la guía de novedades evaluar los cuatro niveles con un max_output_tokens alto y quedarse con el más bajo que cumpla tu criterio de calidad. Como regla de partida: si la tarea es corta y fácil de comprobar (extraer datos, clasificar, un cálculo como la tarea B), empieza en low; para código interactivo y chat con respuesta rápida, medium; para código complejo, agentes y uso de herramientas, high, que es el valor por defecto; y xhigh solo cuando high falle, porque Google advierte que en preguntas sencillas puede razonar de más.
La medición de Artificial Analysis sobre Gemini 4 Hydrogen, a 13 de noviembre de 2026 (índice v5.0.1, a precios de lista), muestra el mismo patrón a escala de benchmark: low saca 27 puntos con 0,29 $ por tarea, medium 41 puntos con 0,80 $, high 51 puntos con 1,87 $ y xhigh 54 puntos con 3,16 $. Pasar de high a xhigh cuesta 1,7 veces más por tres puntos; bajar a medium cuesta el 43 % de high pero pierde diez. Son tareas del índice de Artificial Analysis, no las tuyas, así que úsalas para ordenar los niveles, no para presupuestar.
¿Hydrogen es más barato que 3.8 Flash o Argon? Depende de la fecha
Por token, Hydrogen es hoy el doble de caro que Gemini 3.8 Flash y más barato que Gemini 4 Argon y Carbon, y las dos diferencias cambian antes de que acabe el año. Según la página de precios de la API de Gemini, a 13 de noviembre de 2026, Argon y Carbon duplican su tarifa el 1 de diciembre, y 3.8 Flash termina su precio de lanzamiento el 31 de diciembre y desde el 1 de enero de 2027 cuesta lo mismo que Hydrogen. La tabla da la tarifa de entrada y salida por millón de tokens y, entre paréntesis, lo que costarían los tokens de la llamada A en high de la prueba anterior (85 de entrada y 1.588 de salida):
| Modelo | Hasta el 30 de noviembre de 2026 | Del 1 al 31 de diciembre de 2026 | Desde el 1 de enero de 2027 |
|---|---|---|---|
| Gemini 4 Hydrogen | 1,50 $ / 7,50 $ (0,0120 $) | Sin cambios | Sin cambios |
| Gemini 3.8 Flash | 0,75 $ / 3,75 $ (0,0060 $) | Sin cambios | 1,50 $ / 7,50 $ (0,0120 $) |
| Gemini 4 Argon y Gemini 4 Carbon | 2 $ / 10 $ (0,0161 $) | 4 $ / 20 $ (0,0321 $) | 4 $ / 20 $ (0,0321 $) |
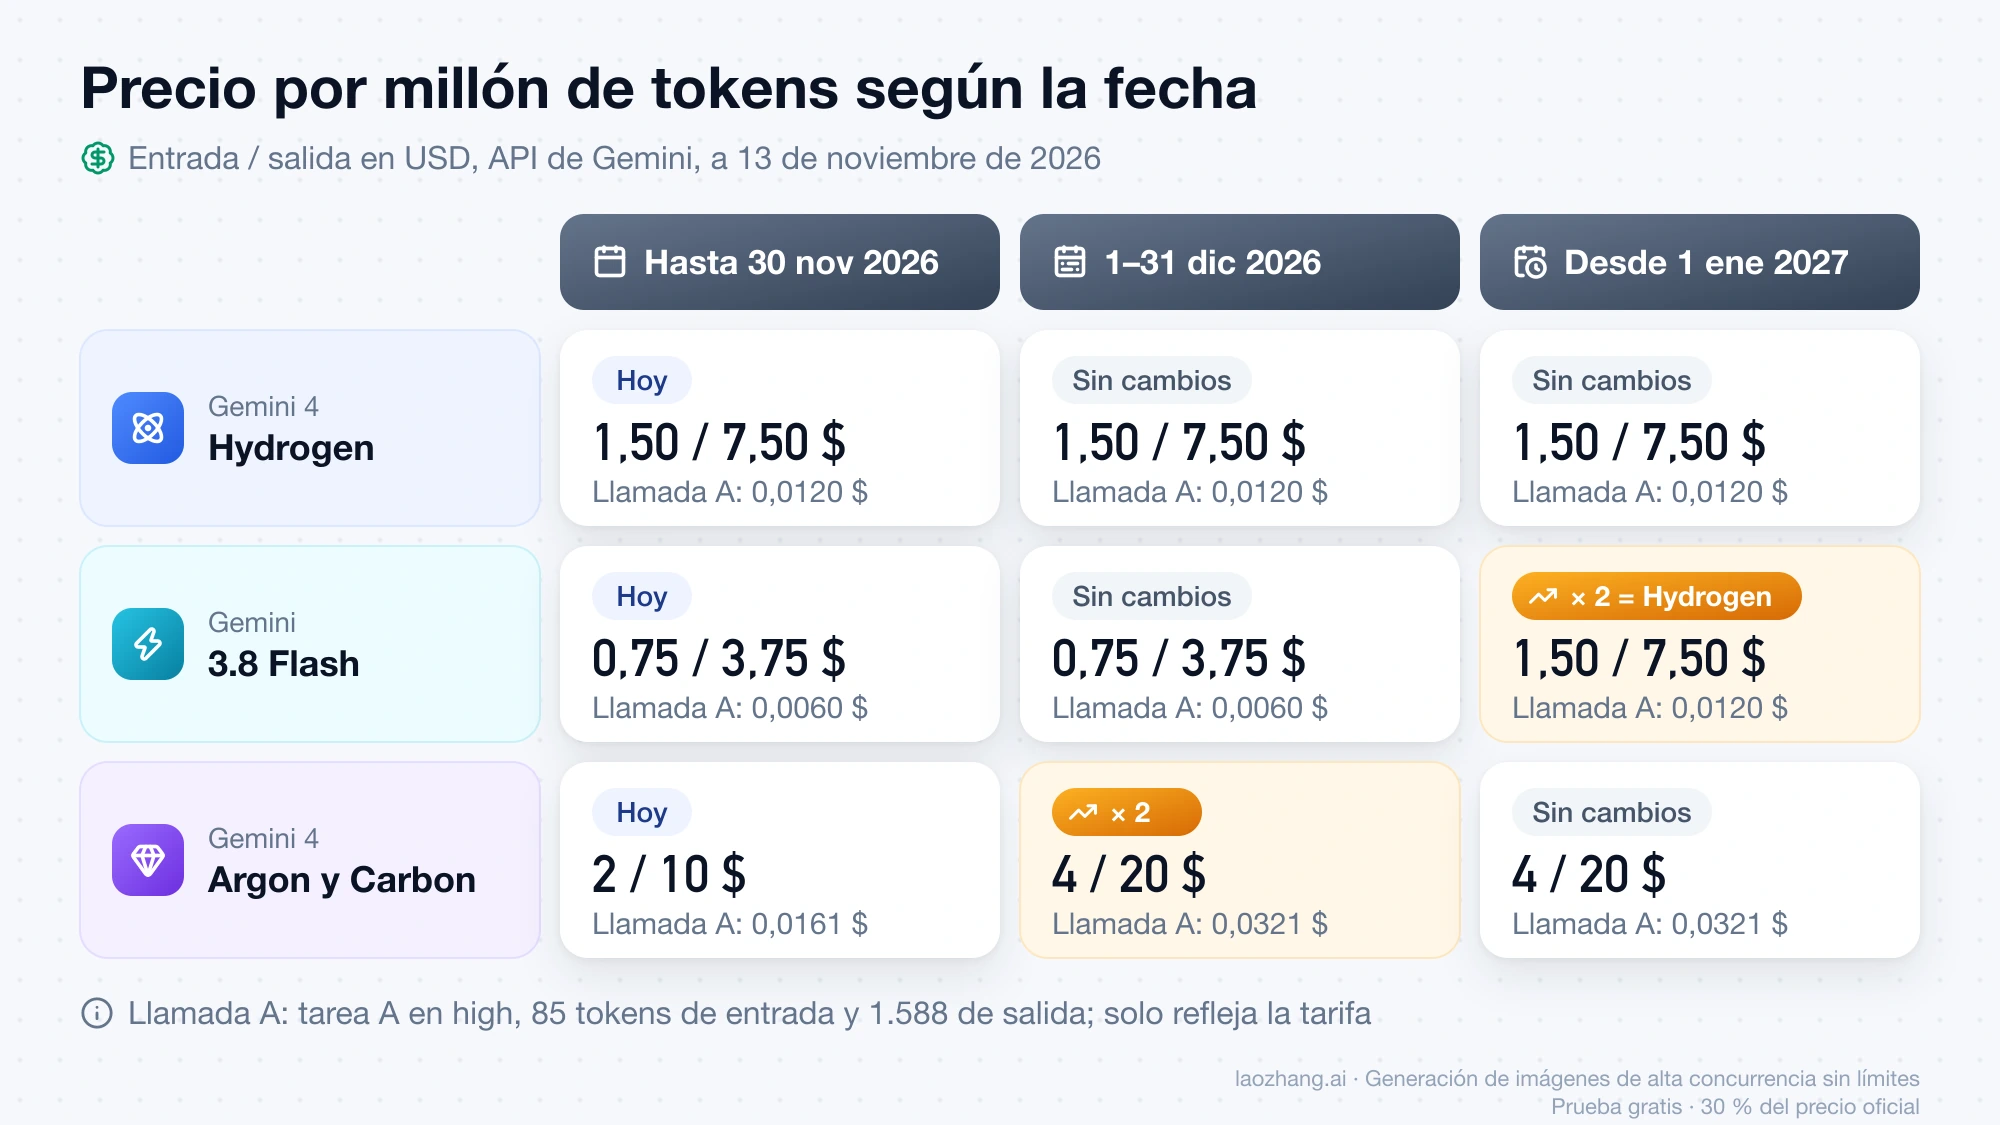
La columna entre paréntesis solo muestra el efecto de la tarifa, porque cada modelo genera una cantidad distinta de tokens para la misma tarea. En el índice de Artificial Analysis, Hydrogen en high costó 1,87 $ por tarea y 3.8 Flash en high 7,77 $, con Flash todavía a su precio de lanzamiento y 31 puntos frente a 51; desde enero, el coste por tarea de Flash se duplicaría con la misma cantidad de tokens. En su anuncio, Google afirma además que sus socios vieron entre un 12 % y un 23 % menos tokens que con Flash 3.8, una cifra del fabricante. Hay mediciones de Argon y Flash por nivel en Gemini 4 Argon vs 3.8 Flash: coste real por tarea y cuál usar, y la comparación de los dos modelos grandes en Gemini 4 Carbon vs Argon: dónde gana, cuánto cuesta y si cambiar.
Pasar de Gemini 3.8 Flash a Hydrogen: qué cambia en la factura
Si cambias gemini-3.8-flash por gemini-4-hydrogen sin tocar nada más, lo más probable es que gastes más tokens de salida por petición, porque Hydrogen razona en high por defecto y 3.8 Flash lo hace en medium, según la lista de migración de la guía de novedades. Fija thinking_level en cada petición y prueba medium y high con tus tareas antes de cambiar el tráfico; si tu código aún envía minimal heredado de modelos anteriores como 3.6 Flash o 3.5 Flash-Lite (3.8 Flash ya no lo admitía), Hydrogen devuelve un error. La caché también cambia: Hydrogen no admite caché explícita (cachedContents ni caches.create), así que hay que quitar cached_content de las peticiones y depender de la caché implícita, que se activa sola a partir de 4.096 tokens pero no garantiza aciertos.
El tope de salida también se comporta distinto. En Hydrogen, max_output_tokens limita el razonamiento y la respuesta juntos, con 65.536 tokens por petición síncrona como valor por defecto y máximo, y Google recomienda quitar topes bajos como 8.192 para no cortar respuestas. Si lo haces, controla el gasto bajando el nivel de razonamiento, no el tope. Los parámetros temperature, top_p y top_k se ignoran, así que no sirven para acortar respuestas. Para el precio de la API de Gemini en conjunto y lo que sube con Flash en 2027, consulta Clave de API de Gemini gratis y precio: qué sube en 2027.
Gemini 4 Hydrogen gratis: nivel gratuito de AI Studio y de la API
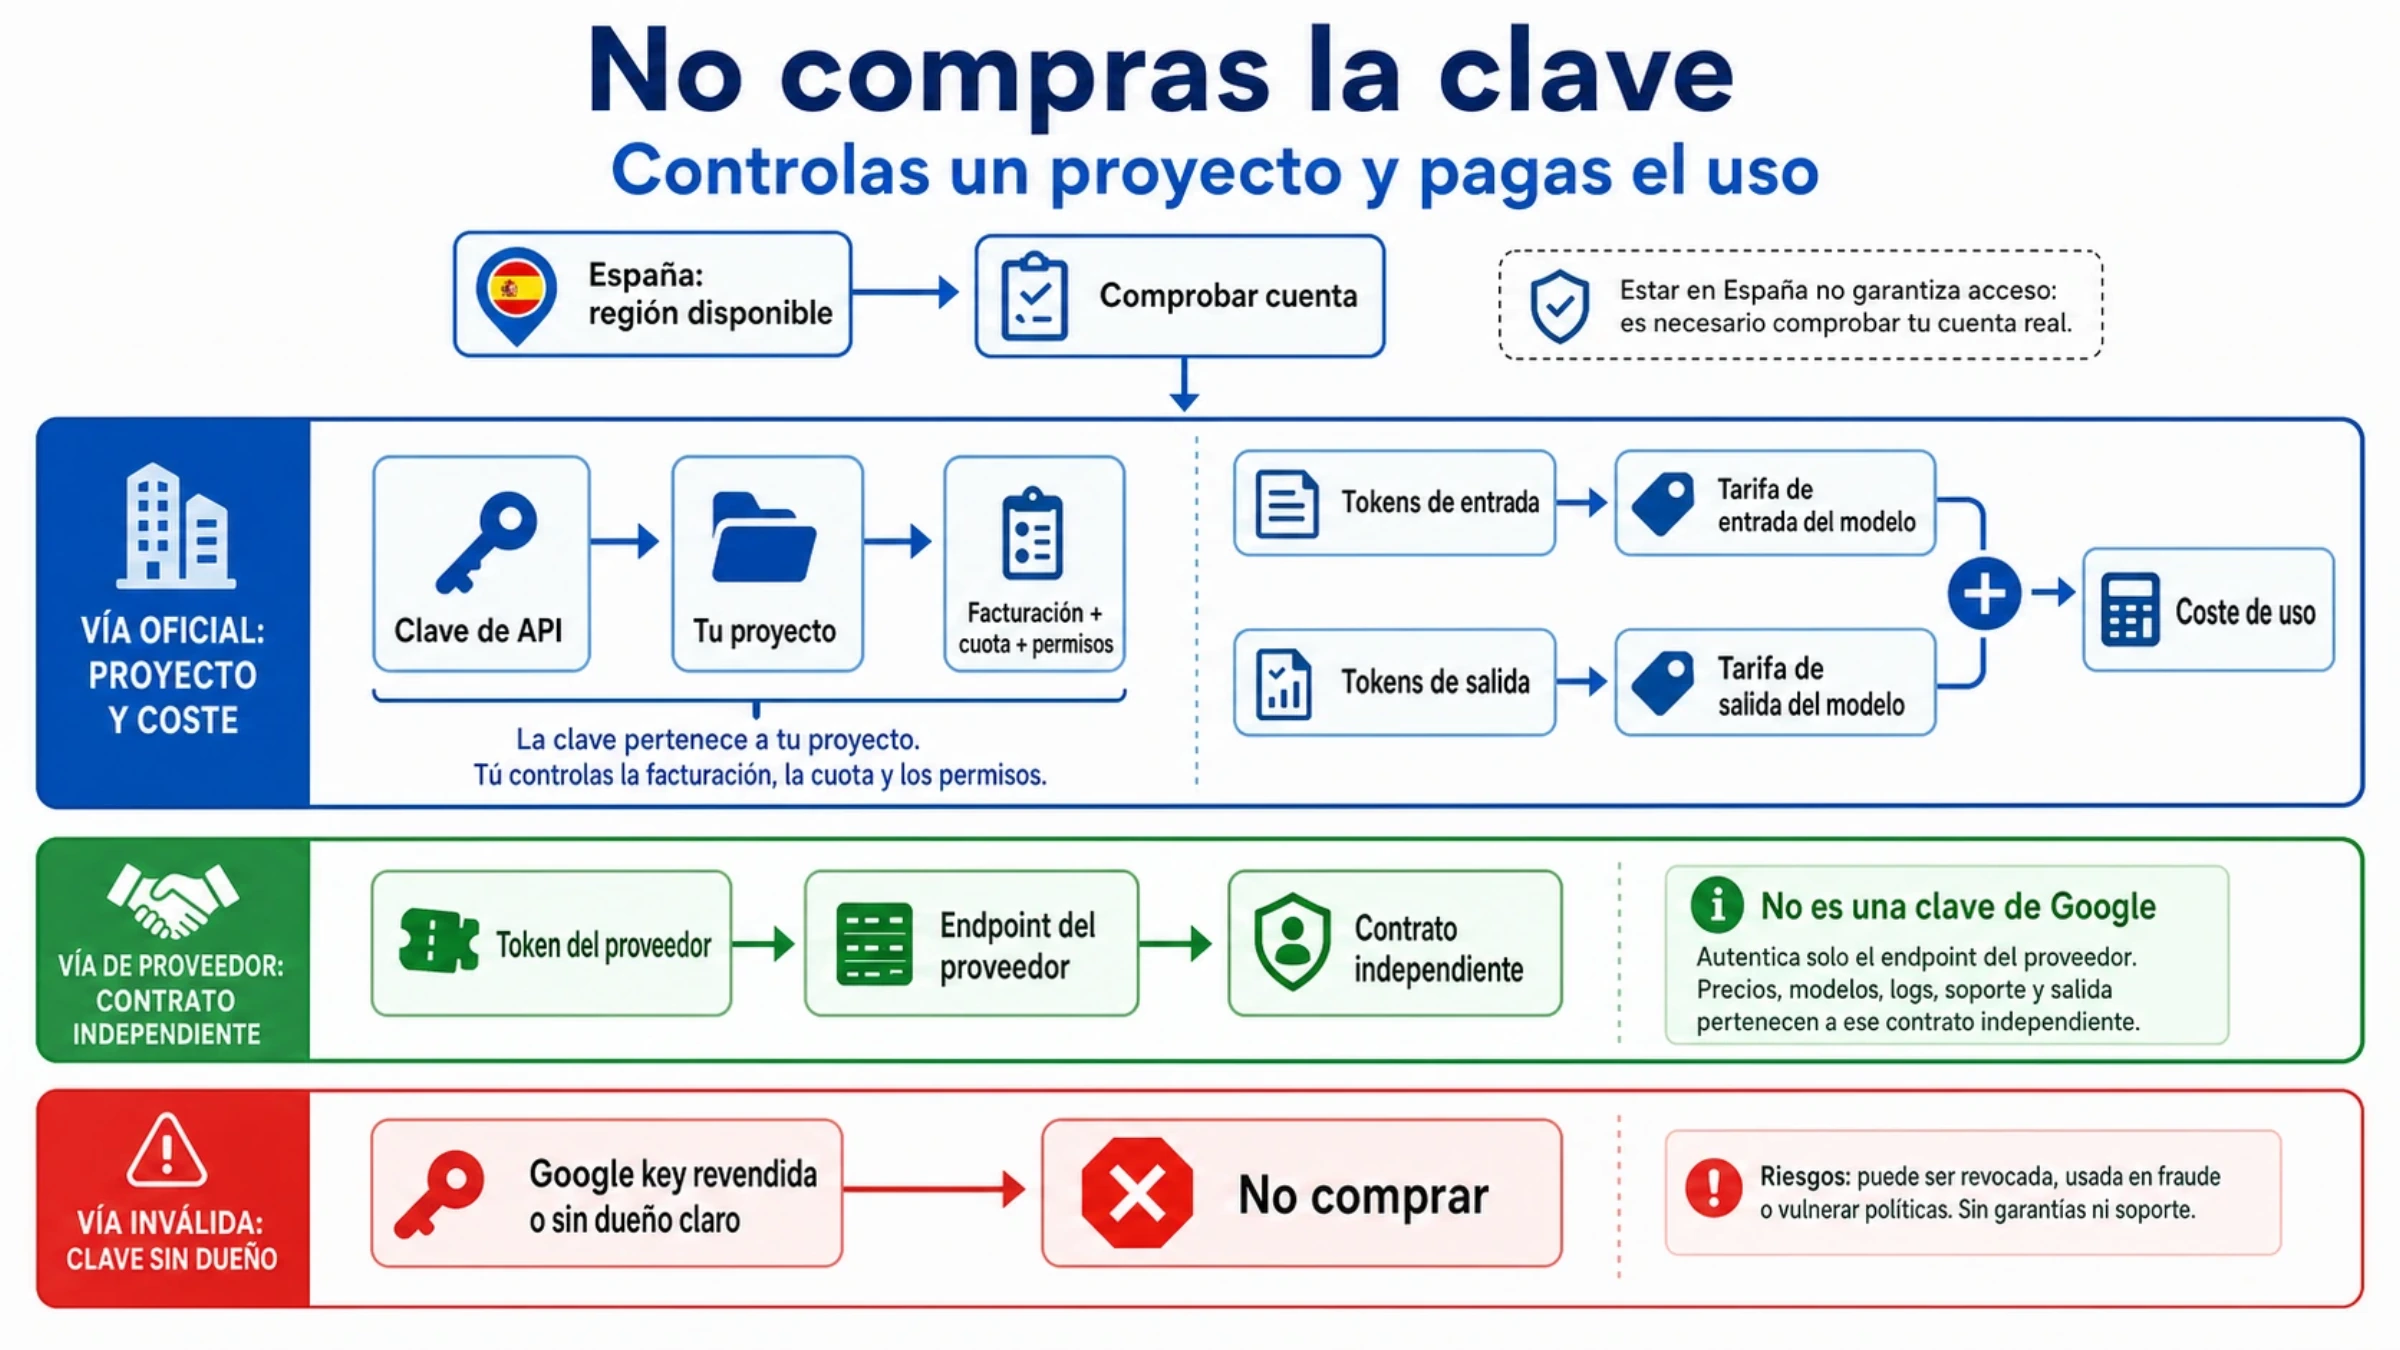
Gemini 4 Hydrogen se puede usar gratis en Google AI Studio y en el nivel gratuito de la API de Gemini, con dos condiciones que conviene conocer antes de enviarle datos reales. La página de precios marca la entrada, la salida y la caché como gratuitas en ese nivel, pero indica también que esos datos se usan para mejorar los productos de Google, cosa que no ocurre en el nivel de pago, y que la Fundamentación con la Búsqueda de Google no está disponible. España figura, a 13 de noviembre de 2026, en la lista de regiones disponibles de la API de Gemini.
Google no publica cuántas peticiones por minuto o por día da gratis Hydrogen. Según la documentación de límites de frecuencia de la API de Gemini, los límites se aplican por proyecto y no por clave, el cupo diario se reinicia a medianoche, hora del Pacífico, y los límites activos de cada proyecto aparecen en la página de límites de AI Studio (aistudio.google.com/rate-limit). Lo que incluye el nivel gratuito para otros modelos está en Gemini API free tier 2026: modelos gratis, límites y API key, y los niveles de pago y el error 429, en Límites de la API de Gemini: niveles, topes de gasto y error 429. En la app Gemini, Hydrogen aparece en el selector de modelos para todos y la página de planes lo incluye en Google AI Plus por 4,99 € al mes, pero eso no cambia lo que pagas en la API.
Cargos de Gemini 4 Hydrogen que no aparecen en la tarifa por token
Además de los tokens, hay tres cargos que pueden aparecer en la factura, y dos de ellos solo si usas Hydrogen desde Google Cloud. Todos figuran, a 13 de noviembre de 2026, en las páginas de precios de la API de Gemini y de Google Cloud:
- En Vertex AI, desde el 13 de noviembre de 2026, cuando una respuesta de un modelo Gemini 4 supera los 32.000 tokens y la petición falla porque se agota el tiempo de espera (timeout) en el cliente o en el servidor, se cobran igualmente los tokens que se puedan recuperar. Fuera de ese caso, Vertex solo cobra las peticiones que terminan con éxito (código 200).
- En Vertex AI, escribir en la caché tendrá precio propio desde el 12 de enero de 2027: 1,875 $ por millón de tokens con endpoint Global y 2,0625 $ con Non-global. La página de la API de Gemini no incluye ese cargo.
- La Fundamentación con la Búsqueda de Google (Grounding with Google Search) incluye 5.000 consultas gratis al mes, compartidas entre todos los modelos Gemini 3 y posteriores, y después cuesta 14 $ por cada 1.000, con un tope de 1.500 peticiones al día. Una petición tuya puede lanzar varias búsquedas y se cobra cada una; la Fundamentación con Google Maps tiene las mismas 5.000 gratis y 14 $ por cada 1.000, y las instrucciones internas de estas herramientas cuentan como tokens.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 13 nov 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 13 nov 2026.
- 1.página de precios de la API de Geminiai.google.dev/gemini-api/docs/pricing
- 2.página de precios de IA generativa de Google Cloudcloud.google.com/vertex-ai/generative-ai/pricing
- 3.guía de novedades de Gemini 4 Hydrogenai.google.dev/gemini-api/docs/whats-new-gemini-4-hydrogen
- 4.guía de razonamiento de la API de Geminiai.google.dev/gemini-api/docs/thinking
- 5.Artificial Analysis sobre Gemini 4 Hydrogenartificialanalysis.ai/models/gemini-4-hydrogen
- 6.lista de regiones disponibles de la API de Geminiai.google.dev/gemini-api/docs/available-regions
- 7.documentación de límites de frecuencia de la API de Geminiai.google.dev/gemini-api/docs/rate-limits