Gemini 3.1 Pro API: guía de acceso, precios, límites y migración
Gemini 3.1 Pro sigue en Preview y su API no tiene nivel gratuito: USD 2/12 por millón de tokens hasta 200.000. 3.8 Flash cuesta menos y tiene nivel gratuito.
En esta página
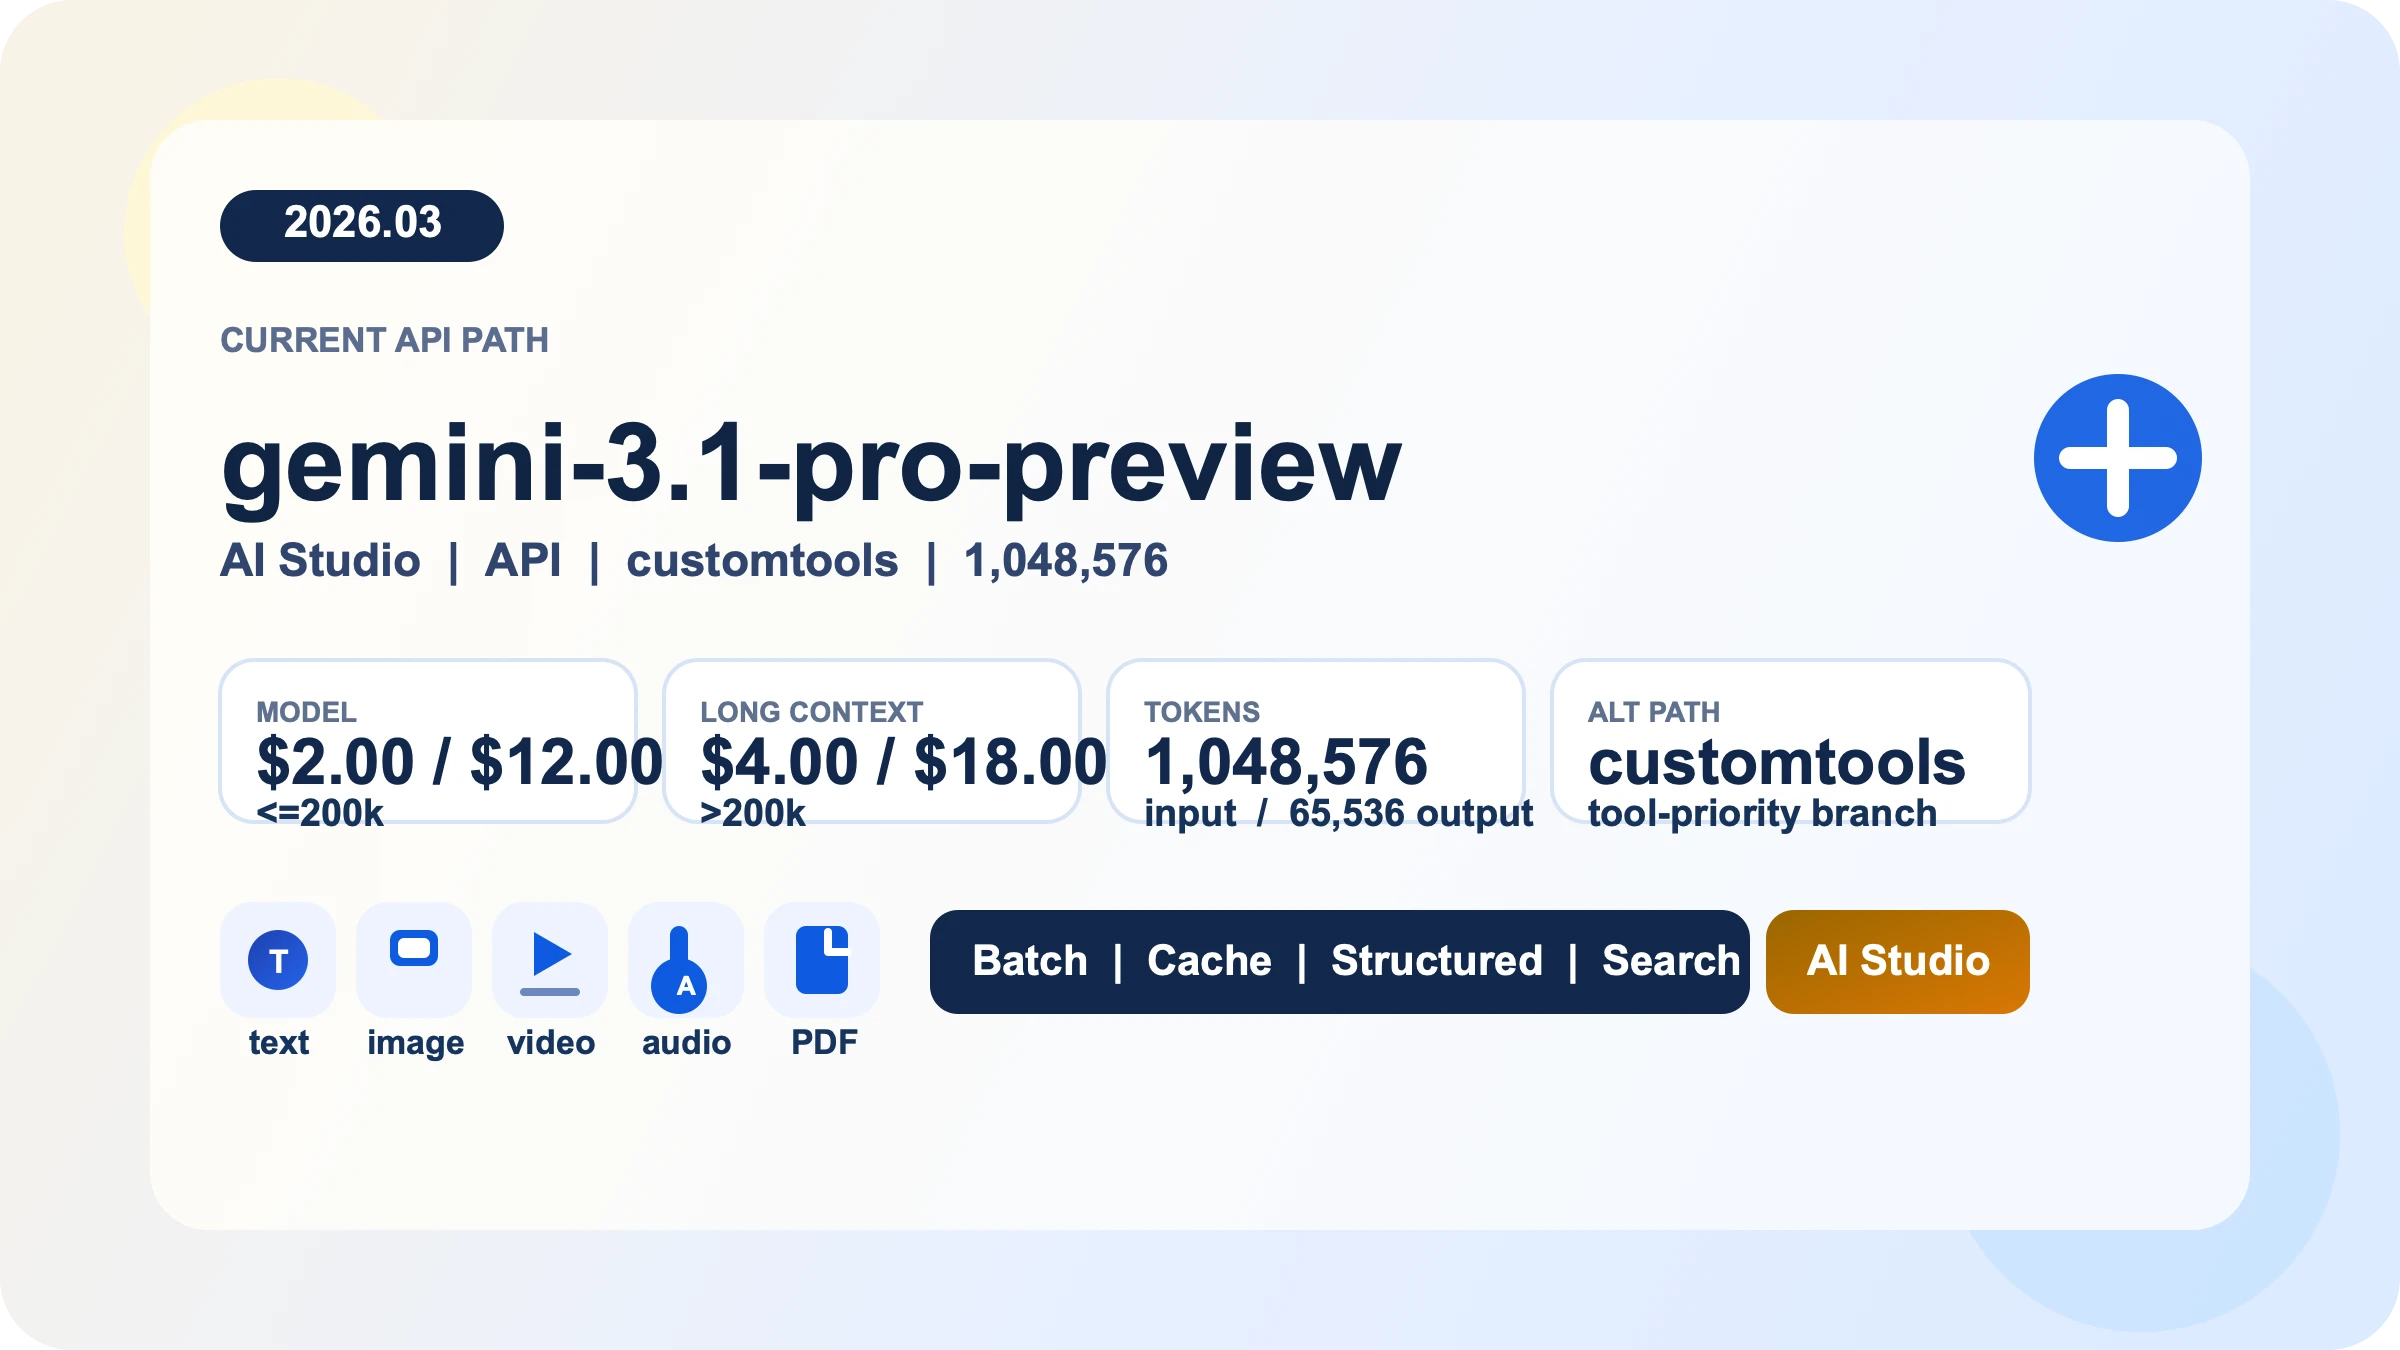
A 10 de octubre de 2026, Gemini 3.1 Pro se llama en la API gemini-3.1-pro-preview y sigue siendo un modelo Preview: Google lo publicó el 19 de febrero de 2026, no ha anunciado fecha de cierre y no tiene sucesor. En la API de Gemini no existe un Gemini 3.6 Pro, 3.8 Pro ni Gemini 4; los modelos nuevos de 2026 son Flash. La variante gemini-3.1-pro-preview-customtools cuesta lo mismo y sirve para agentes que mezclan bash con herramientas propias.
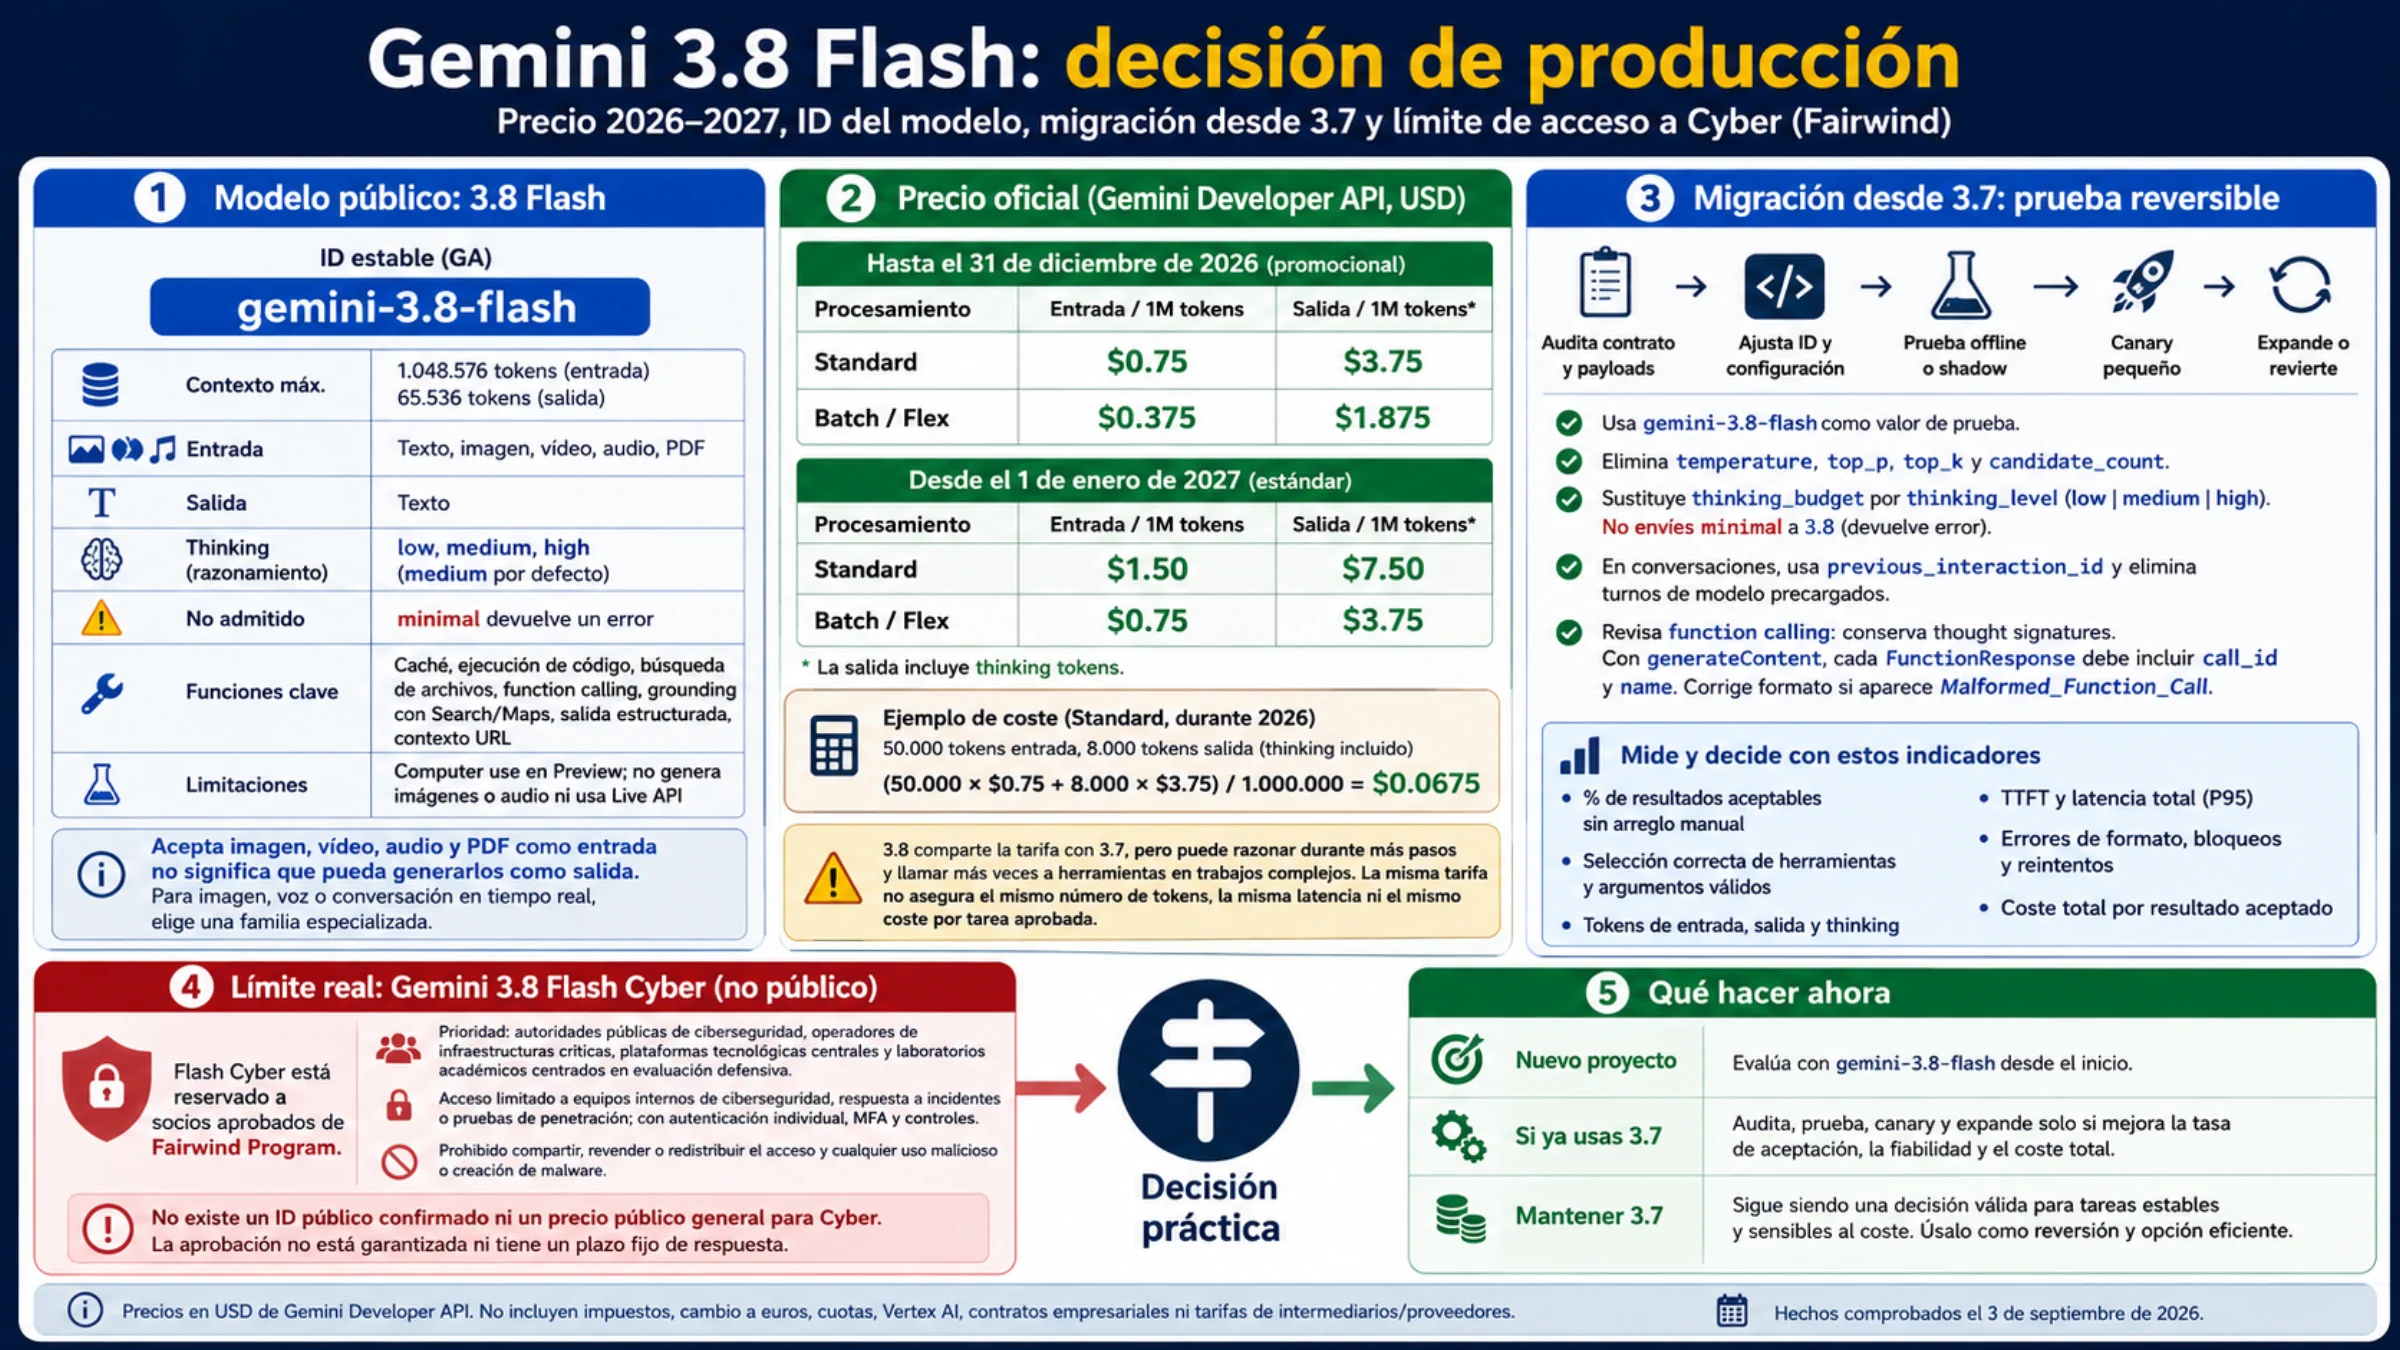
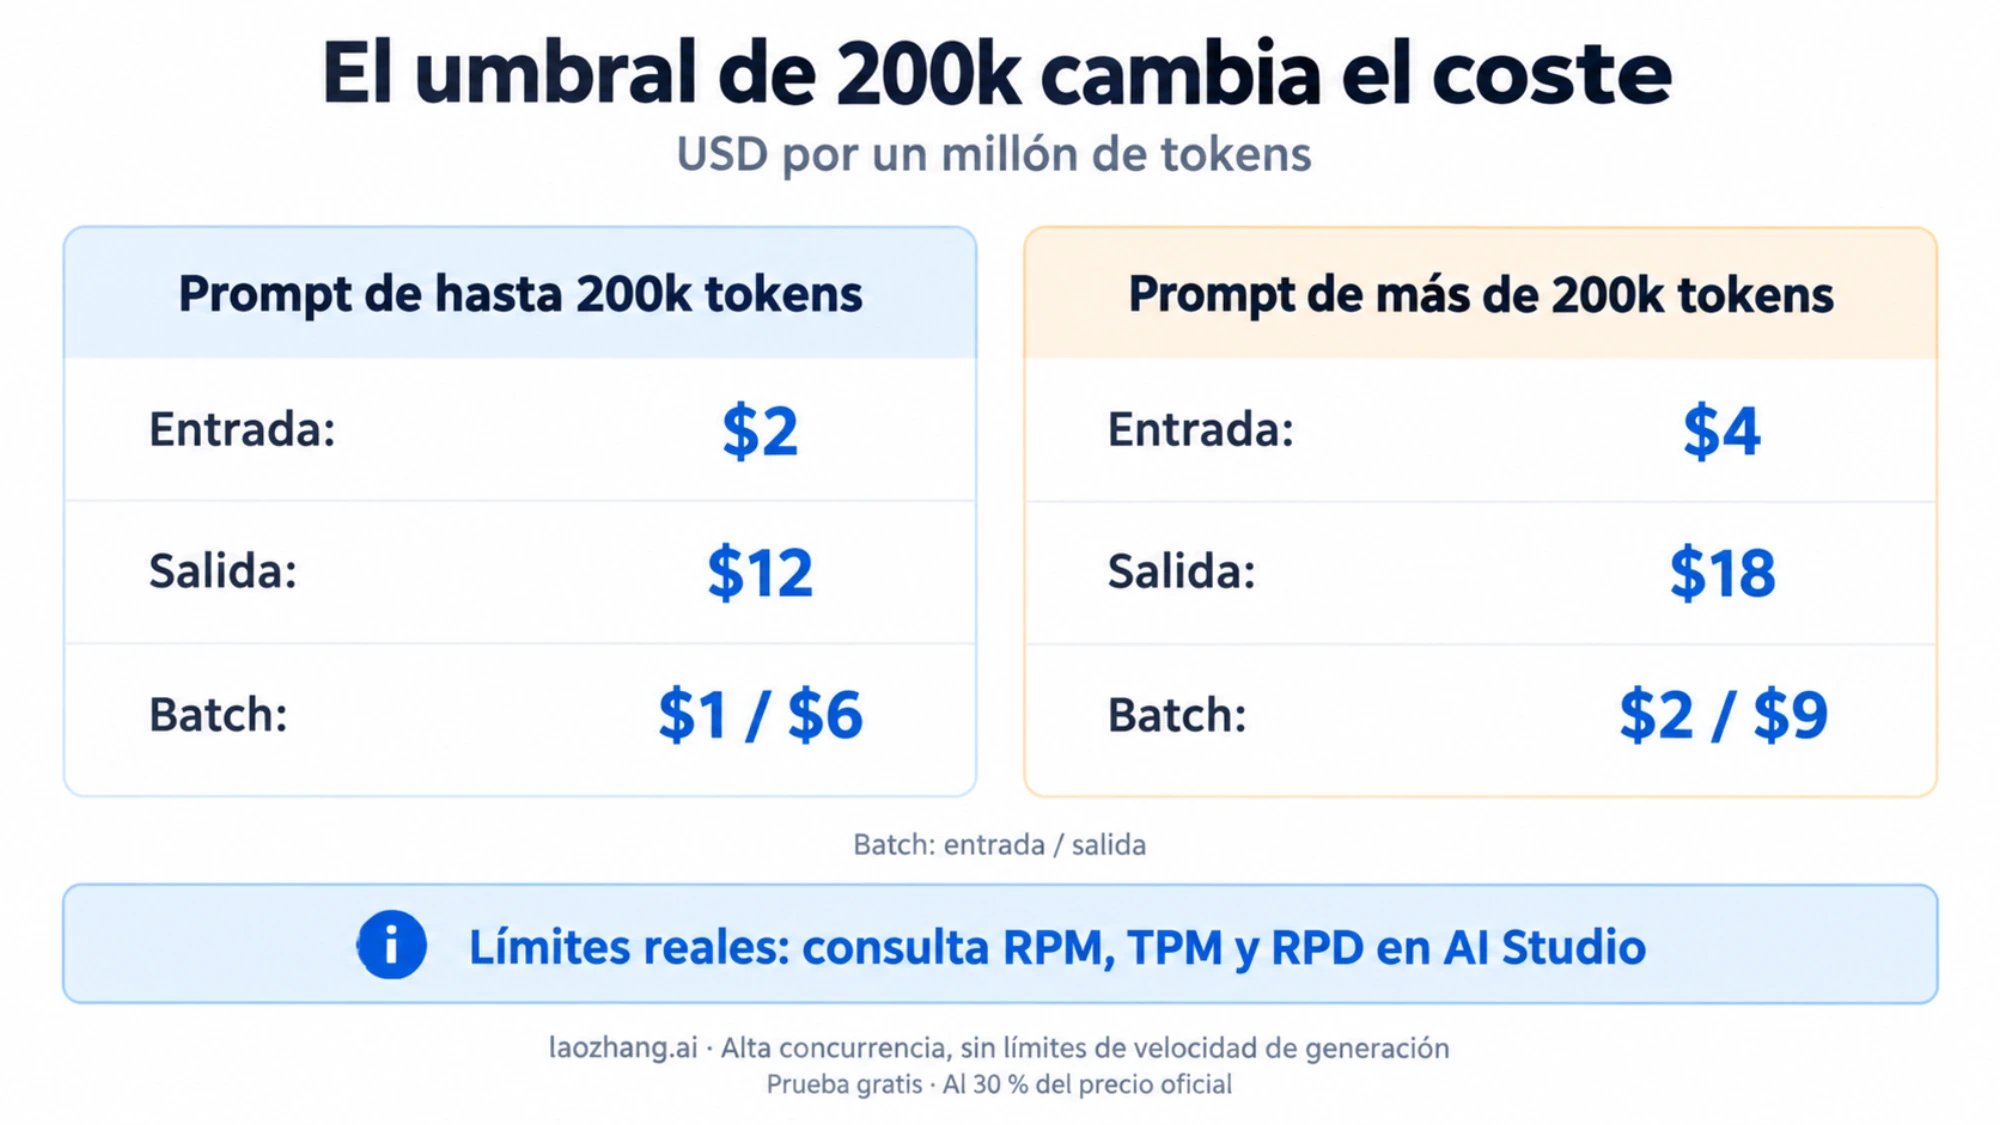
La API de 3.1 Pro no tiene nivel gratuito. Según la página de precios de la API de Gemini, pagas USD 2,00 por millón de tokens de entrada y USD 12,00 por millón de salida con prompts de hasta 200.000 tokens, y USD 4,00 / USD 18,00 por encima. Batch y Flex cuestan la mitad. Si te basta un modelo más barato o necesitas uno con nivel gratuito, Gemini 3.8 Flash cuesta USD 0,75 / USD 3,75 hasta el 31 de diciembre de 2026 y el doble desde el 1 de enero de 2027.
Si tu integración todavía utiliza gemini-3-pro-preview, ese modelo ya no responde: consulta Gemini 3.1 Pro vs Gemini 3 Pro: qué cambió y qué usar hoy y la lista de migración más abajo.
TL;DR
| Pregunta | Respuesta a 10 de octubre de 2026 |
|---|---|
| ¿Qué model ID uso? | gemini-3.1-pro-preview; -customtools solo si la prioridad de tus herramientas es el problema |
| ¿Sigue en Preview? | Sí, sin fecha de cierre anunciada; Google avisa con al menos dos semanas antes de retirar un modelo Preview |
| ¿Es gratis la API? | No. Crear la clave es gratis; las llamadas a 3.1 Pro necesitan facturación con saldo |
| ¿Cuánto cuesta? | USD 2,00 / USD 12,00 hasta 200.000 tokens de prompt; USD 4,00 / USD 18,00 por encima; Batch y Flex, la mitad |
| ¿Hay algo más barato? | Gemini 3.8 Flash y 3.6 Flash: USD 0,75 / USD 3,75 hasta el 31 de diciembre de 2026, USD 1,50 / USD 7,50 desde 2027, con nivel gratuito |
| ¿Dónde veo mis límites? | En AI Studio, por proyecto; Google no publica una tabla de RPM por nivel |
¿Qué pasa con gemini-3-pro-preview? | Se apagó el 9 de marzo de 2026; el reemplazo es gemini-3.1-pro-preview |
Gemini 3.1 Pro gratis: no en la API; en AI Studio, con límites
En la página de precios, todas las filas de Gemini 3.1 Pro Preview marcan «Not available» en la columna del nivel gratuito, y la FAQ de la guía de Gemini 3 de Google lo dice sin rodeos: «there is no free tier available for gemini-3.1-pro-preview in the Gemini API». Lo mismo vale para -customtools. Las cifras de «15 RPM gratis» que circulan para 3.1 Pro no tienen respaldo en la documentación actual.
AI Studio es otra superficie. La página de facturación de la API de Gemini dice que el uso de AI Studio «remains free of charge unless users link a paid API key for access to paid features». Sobre 3.1 Pro en concreto, las páginas de Google no dicen lo mismo:
- La guía de Gemini 3, que Google ya marca como obsoleta, dice que puedes probar Gemini 3.1 Pro sin coste en Google AI Studio.
- La página de planes de Google AI para desarrolladores asigna a la cuenta gratuita una «Modest quota» y presenta Google AI Pro como el plan que da «Access to premium models like Gemini Pro» en el Playground.
- A 10 de octubre de 2026, el Playground de AI Studio en una cuenta personal sin plan ni clave abre con Gemini 3.1 Pro Preview seleccionado, sin candado en la ficha del modelo, junto a un aviso «Upgrade to unlock more — Access higher limits, Pro models, and more». No muestra ninguna cifra de cuota gratuita.
- El 19 de febrero de 2026, día del lanzamiento, usuarios del foro de Google AI Developers informaron del mensaje «You are out of free generations today» al usar 3.1 Pro sin clave propia.
En la práctica: puedes intentar 3.1 Pro en AI Studio sin pagar, con una cuota diaria pequeña que Google no publica; Google lo presenta como modelo de plan de pago y la API no tiene nivel gratuito. Ni siquiera pagar Google AI Pro o Ultra cambia eso, porque esas ventajas son «AI Studio UI only» y el uso directo de la API «is billed and managed separately».
La app Gemini es un producto distinto: allí eliges «Pro» en el selector de modelo. La tabla de ayuda de Google marca Pro como disponible sin plan, pero la página de suscripciones de EE. UU. solo lista «Access to 3.1 Pro» desde Google AI Plus. Cuenta con que el acceso gratuito a Pro en la app es limitado y que los planes de pago dan más uso.
¿Qué API de Gemini es gratis, entonces? Las de la familia Flash: Gemini 3.8 Flash, 3.6 Flash, 3.5 Flash-Lite, 3.1 Flash-Lite y 3 Flash Preview tienen nivel gratuito en la API, con límites por proyecto que ves en AI Studio y con la condición de que Google puede usar ese contenido para mejorar sus productos. El detalle está en Gemini API free tier 2026: modelos gratis, límites y API key. Ojo también con la prueba de USD 300 de Google Cloud: desde marzo de 2026 excluye expresamente el uso de la API de Gemini.
La forma más rápida de poner a funcionar tu primer request
La clave se crea en Google AI Studio, dentro de un proyecto de Google Cloud. Desde el 28 de mayo de 2026, las claves nuevas de AI Studio son claves de autenticación ligadas a una cuenta de servicio y limitadas a la API de Gemini; la API rechaza las claves estándar sin restricciones. Guárdala en local como GEMINI_API_KEY (las bibliotecas oficiales también leen GOOGLE_API_KEY, que tiene prioridad si existen las dos).
Antes de llamar a 3.1 Pro necesitas facturación. Las cuentas nuevas empiezan en prepago: compras saldo desde USD 5 y el consumo se descuenta casi en tiempo real. Con saldo cero, todas las claves de los proyectos vinculados a esa cuenta de facturación dejan de funcionar a la vez y devuelven 402 Payment Required hasta que recargas.
Con eso, la entrada más limpia es el SDK oficial de Google GenAI. Estos fragmentos usan la sintaxis documentada de generateContent, con el model ID y el nivel de razonamiento escritos de forma explícita; ejecútalos con tu clave antes de copiarlos a producción.
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.1-pro-preview",
    contents="Review this API design and list the main tradeoffs.",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium")
    ),
)

print(response.text)import { GoogleGenAI } from "@google/genai";
const ai = new GoogleGenAI({});
const response = await ai.models.generateContent({
model: "gemini-3.1-pro-preview",
contents: "Review this API design and list the main tradeoffs.",
config: {
thinkingConfig: {
thinkingLevel: "medium",
},
},
});
console.log(response.text);curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.1-pro-preview:generateContent" \
-H "x-goog-api-key: $GEMINI_API_KEY" \
-H "Content-Type: application/json" \
-X POST \
-d '{
"contents": [{
"parts": [{"text": "Review this API design and list the main tradeoffs."}]
}],
"generationConfig": {
"thinkingConfig": {
"thinkingLevel": "medium"
}
}
}'Fíjate en lo que no aparece: ni temperature, ni top_p, ni top_k. Google los declaró obsoletos el 21 de julio de 2026. Y si no indicas thinking_level, Gemini 3.1 Pro usa high, el nivel más caro en tokens de salida.
Los ejemplos más recientes de la documentación de Google usan la Interactions API (client.interactions.create en Python, POST /v1beta/interactions en REST, con generation_config.thinking_level). generateContent sigue funcionando; la diferencia práctica está en las conversaciones de varios turnos, que verás en la sección de migración.
Antes del prompt hay que elegir bien el model path
La primera decisión no es el prompt, sino la variante del modelo.
La ruta base es gemini-3.1-pro-preview. Según la ficha de Gemini 3.1 Pro Preview, acepta texto, imagen, vídeo, audio y PDF, devuelve texto, admite hasta 1.048.576 tokens de entrada y 65.536 de salida, y soporta Batch API, inferencia Flex y Priority, caché de contexto, ejecución de código, llamadas a funciones, fundamentación con Google Search y Maps, salidas estructuradas, razonamiento y contexto de URL. File Search solo funciona dentro de AI Studio. Google lo describe como un modelo con mejor razonamiento y eficiencia de tokens, optimizado para ingeniería de software y flujos agénticos que exigen un uso preciso de herramientas.
Lo que no hace también decide: nada de generación de imágenes ni de audio, ni Live API. Si tu trabajo es generar imágenes, conversar por voz en tiempo real o procesar mucho texto al menor coste, Pro no es el punto de partida.
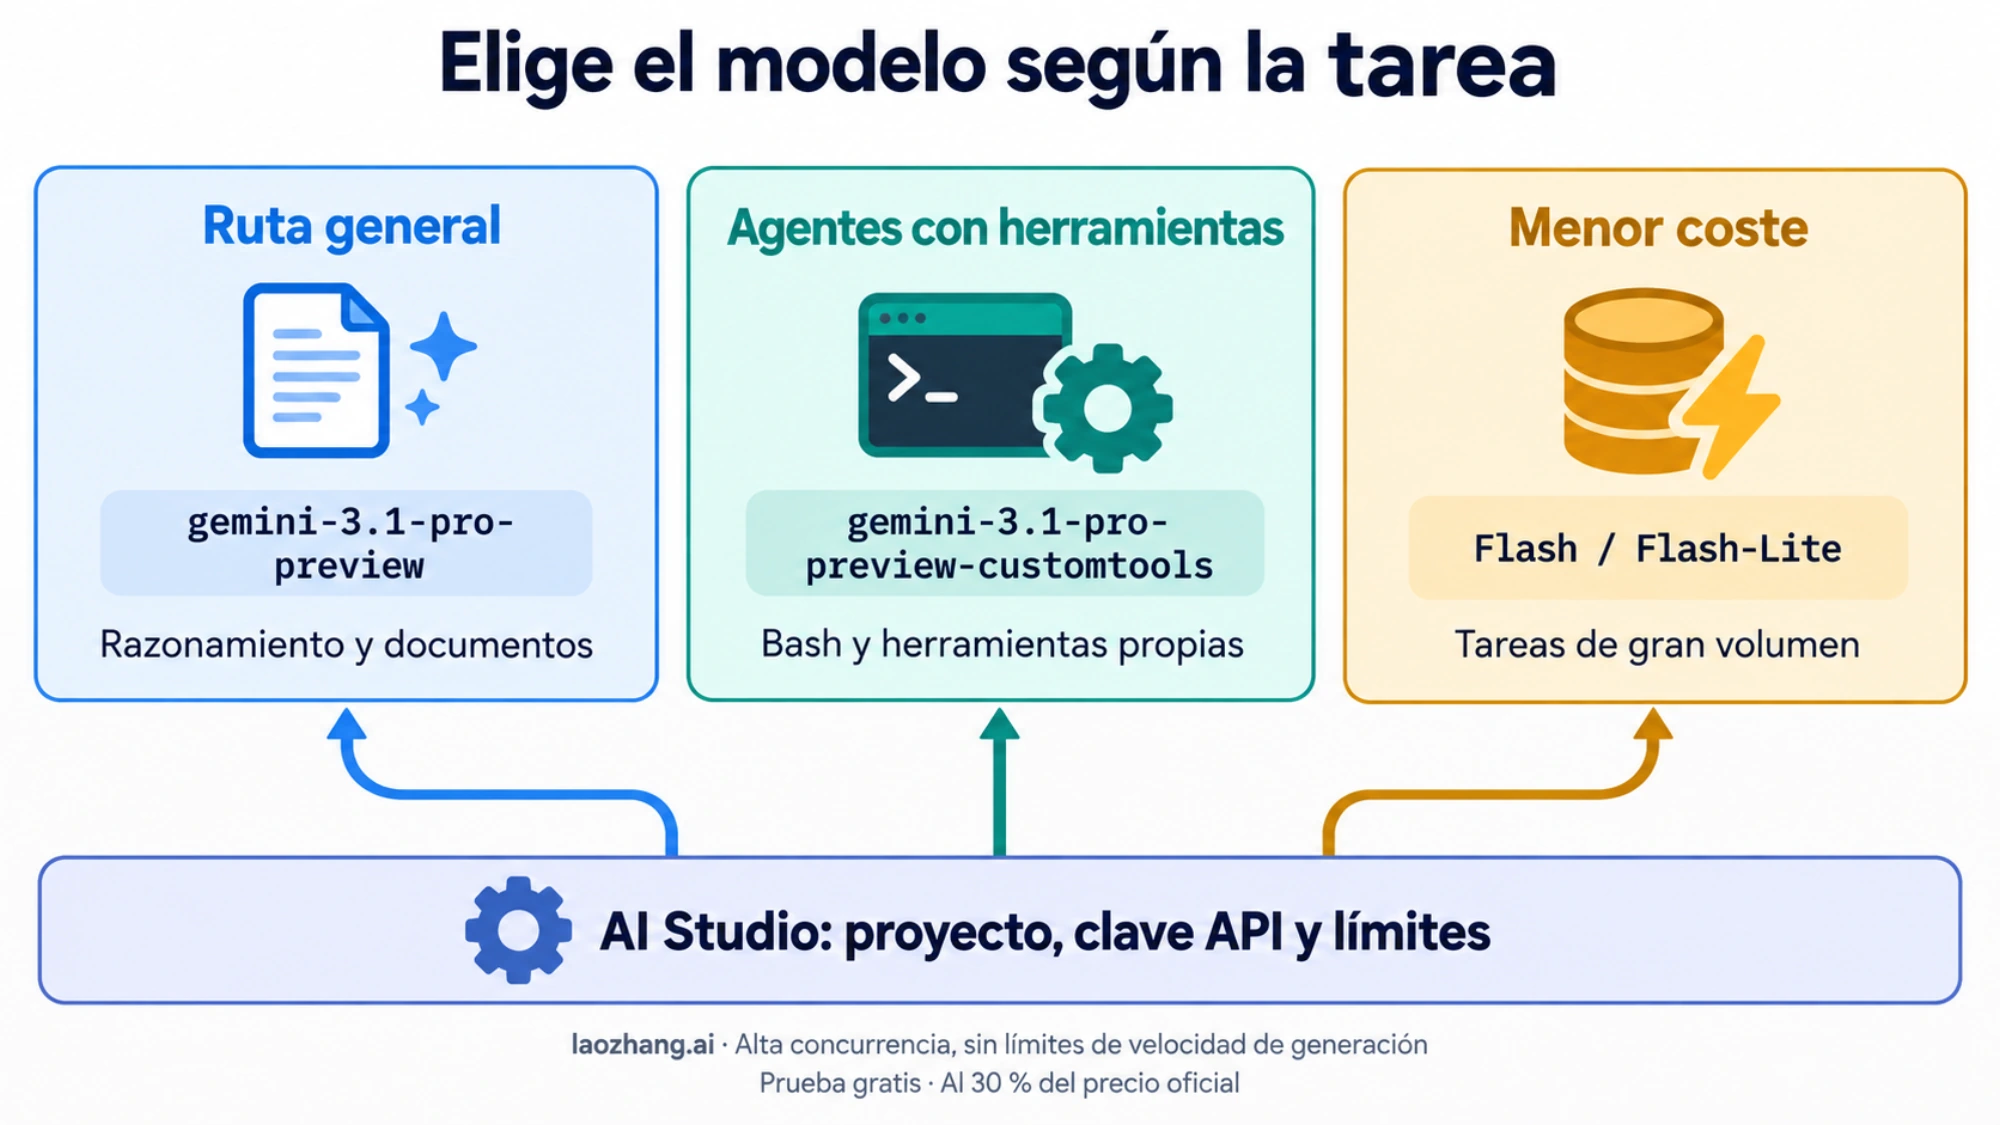
La otra bifurcación es gemini-3.1-pro-preview-customtools. No es otro modelo con precio o contexto distintos, sino una variante para agentes que combinan bash con herramientas registradas. La ficha del modelo explica que da más prioridad a tus herramientas propias, por ejemplo view_file o search_code, y avisa de que la calidad puede fluctuar en casos que no se benefician de ello. Si la prioridad de herramientas es parte del problema, customtools tiene sentido; para razonamiento general, chat o análisis de documentos, quédate en la variante estándar.
Y una cuestión cerrada: según la página de retiradas de modelos de la API de Gemini, gemini-3-pro-preview se apagó el 9 de marzo de 2026 y su reemplazo es gemini-3.1-pro-preview. Las previews antiguas de Gemini 2.5 Pro también remiten a 3.1 Pro. Como 3.1 Pro sigue en Preview, Google puede aplicarle límites más estrictos que a los modelos estables y retirarlo con un aviso mínimo de dos semanas; no hay fecha anunciada.
Gemini 3.6 Flash vs 3.1 Pro: cuál es mejor y cuánto cuesta
Para la mayoría de cargas, la respuesta a «¿qué es mejor, Gemini 3.6 Flash o 3.1 Pro?» ya no enfrenta esos dos modelos: el Flash más reciente es Gemini 3.8 Flash, disponible de forma general desde el 2 de septiembre de 2026, y 3.6 Flash pasó a ser el Flash de la generación anterior. Los dos Flash tienen el mismo precio. Desde el 8 de octubre de 2026, las llamadas a gemini-3.5-flash se envían a gemini-3.6-flash y las de gemini-3.7-flash a gemini-3.8-flash.
| Gemini 3.1 Pro Preview | Gemini 3.8 Flash | Gemini 3.6 Flash | |
|---|---|---|---|
| Estado | Preview, sin fecha de cierre | Disponible de forma general desde el 2 de septiembre de 2026 | Disponible de forma general desde el 21 de julio de 2026; generación anterior |
| Entrada / salida por millón de tokens, hasta el 31 de diciembre de 2026 | USD 2,00 / USD 12,00 (prompt de hasta 200.000) | USD 0,75 / USD 3,75 | USD 0,75 / USD 3,75 |
| Desde el 1 de enero de 2027 | Sin cambio anunciado | USD 1,50 / USD 7,50 | USD 1,50 / USD 7,50 |
| Batch y Flex | La mitad | La mitad | La mitad |
| Nivel gratuito en la API | No | Sí | Sí |
| Razonamiento por defecto | high | medium | — |
| Cómo lo presenta Google | Mejor razonamiento; ingeniería de software y flujos agénticos con herramientas precisas | «Our most intelligent Flash model», para ingeniería de software de largo recorrido y agentes autónomos | Más eficiente en tokens y mejor en planificación de código y agentes que 3.5 Flash, a menor precio |
La diferencia de precio cambia con la fecha. Hasta el 31 de diciembre de 2026, la entrada de 3.1 Pro cuesta 2,00 / 0,75 = 2,67 veces la de 3.8 o 3.6 Flash, y la salida 12,00 / 3,75 = 3,2 veces. Desde el 1 de enero de 2027, con Flash a USD 1,50 / USD 7,50, la distancia baja a 2,00 / 1,50 = 1,33 veces en entrada y 12,00 / 7,50 = 1,6 veces en salida.
Un ejemplo para recalcular con tus cifras: 1.000 solicitudes de 50.000 tokens de entrada y 5.000 de salida cada una son 50 millones de entrada y 5 millones de salida.
- Gemini 3.1 Pro: 50 × 2,00 + 5 × 12,00 = USD 160.
- Gemini 3.8 Flash en 2026: 50 × 0,75 + 5 × 3,75 = USD 56,25.
- Gemini 3.8 Flash en 2027: 50 × 1,50 + 5 × 7,50 = USD 112,50.
El ejemplo supone los mismos tokens en los dos modelos, y eso no se cumple del todo: la salida incluye los tokens de razonamiento, y Google advierte que 3.8 Flash «can use more tokens on longer running and complex tasks, by design». Para tareas cotidianas recomienda bajarle el nivel de razonamiento o usar 3.6 Flash. Mide tus propias solicitudes antes de dar por buena la proporción de la tabla.
Sobre calidad, Google no publica una tabla oficial que compare 3.8 o 3.6 Flash con 3.1 Pro, y las comparativas de terceros no coinciden entre sí. La regla útil es de uso: empieza con 3.8 Flash si tu carga es de volumen, sensible al presupuesto o necesitas nivel gratuito; pasa a 3.1 Pro cuando tus pruebas muestren que Flash falla en razonamiento de varios pasos, documentos muy largos o agentes con herramientas, y el coste extra compense. Si mantienes los dos, enruta por tipo de tarea en lugar de elegir uno para todo.
¿Y «Gemini 3.6 Thinking» frente a 3.1 Pro? En la app Gemini no son dos modelos comparables. El razonamiento («Standard» o «Extended thinking») es un ajuste que se aplica al modelo elegido, sea Flash o Pro; Deep Think requiere Pro y AI Ultra. Así que «3.6 Thinking» es 3.6 Flash con más razonamiento, y 3.1 Pro es otro modelo. Google avisa de que los modelos más avanzados y los niveles de razonamiento más altos consumen más de tu límite de uso. En la API, el equivalente es el parámetro thinking_level.
Cómo leer precios y límites sin engañarte
Tarifas de Gemini 3.1 Pro Preview por millón de tokens, a 10 de octubre de 2026 (las mismas para -customtools; la salida incluye los tokens de razonamiento):
| Modalidad | Entrada, prompt de hasta 200.000 | Entrada, más de 200.000 | Salida, hasta 200.000 | Salida, más de 200.000 |
|---|---|---|---|---|
| Standard | USD 2,00 | USD 4,00 | USD 12,00 | USD 18,00 |
| Batch y Flex | USD 1,00 | USD 2,00 | USD 6,00 | USD 9,00 |
| Priority | USD 3,60 | USD 7,20 | USD 21,60 | USD 32,40 |
El umbral de 200.000 tokens es lo que más se pasa por alto. Gemini 3.1 Pro acepta casi 1,05 millones de tokens de entrada, pero en cuanto el prompt supera 200.000 pagas el doble por la entrada y un 50 % más por la salida. Batch y Flex dan el mismo descuento del 50 %; úsalos para todo lo que no necesite respuesta inmediata. Priority cuesta 1,8 veces la tarifa Standard y solo tiene sentido si la latencia garantizada vale ese recargo.
Dos líneas más que suelen quedar fuera del presupuesto:
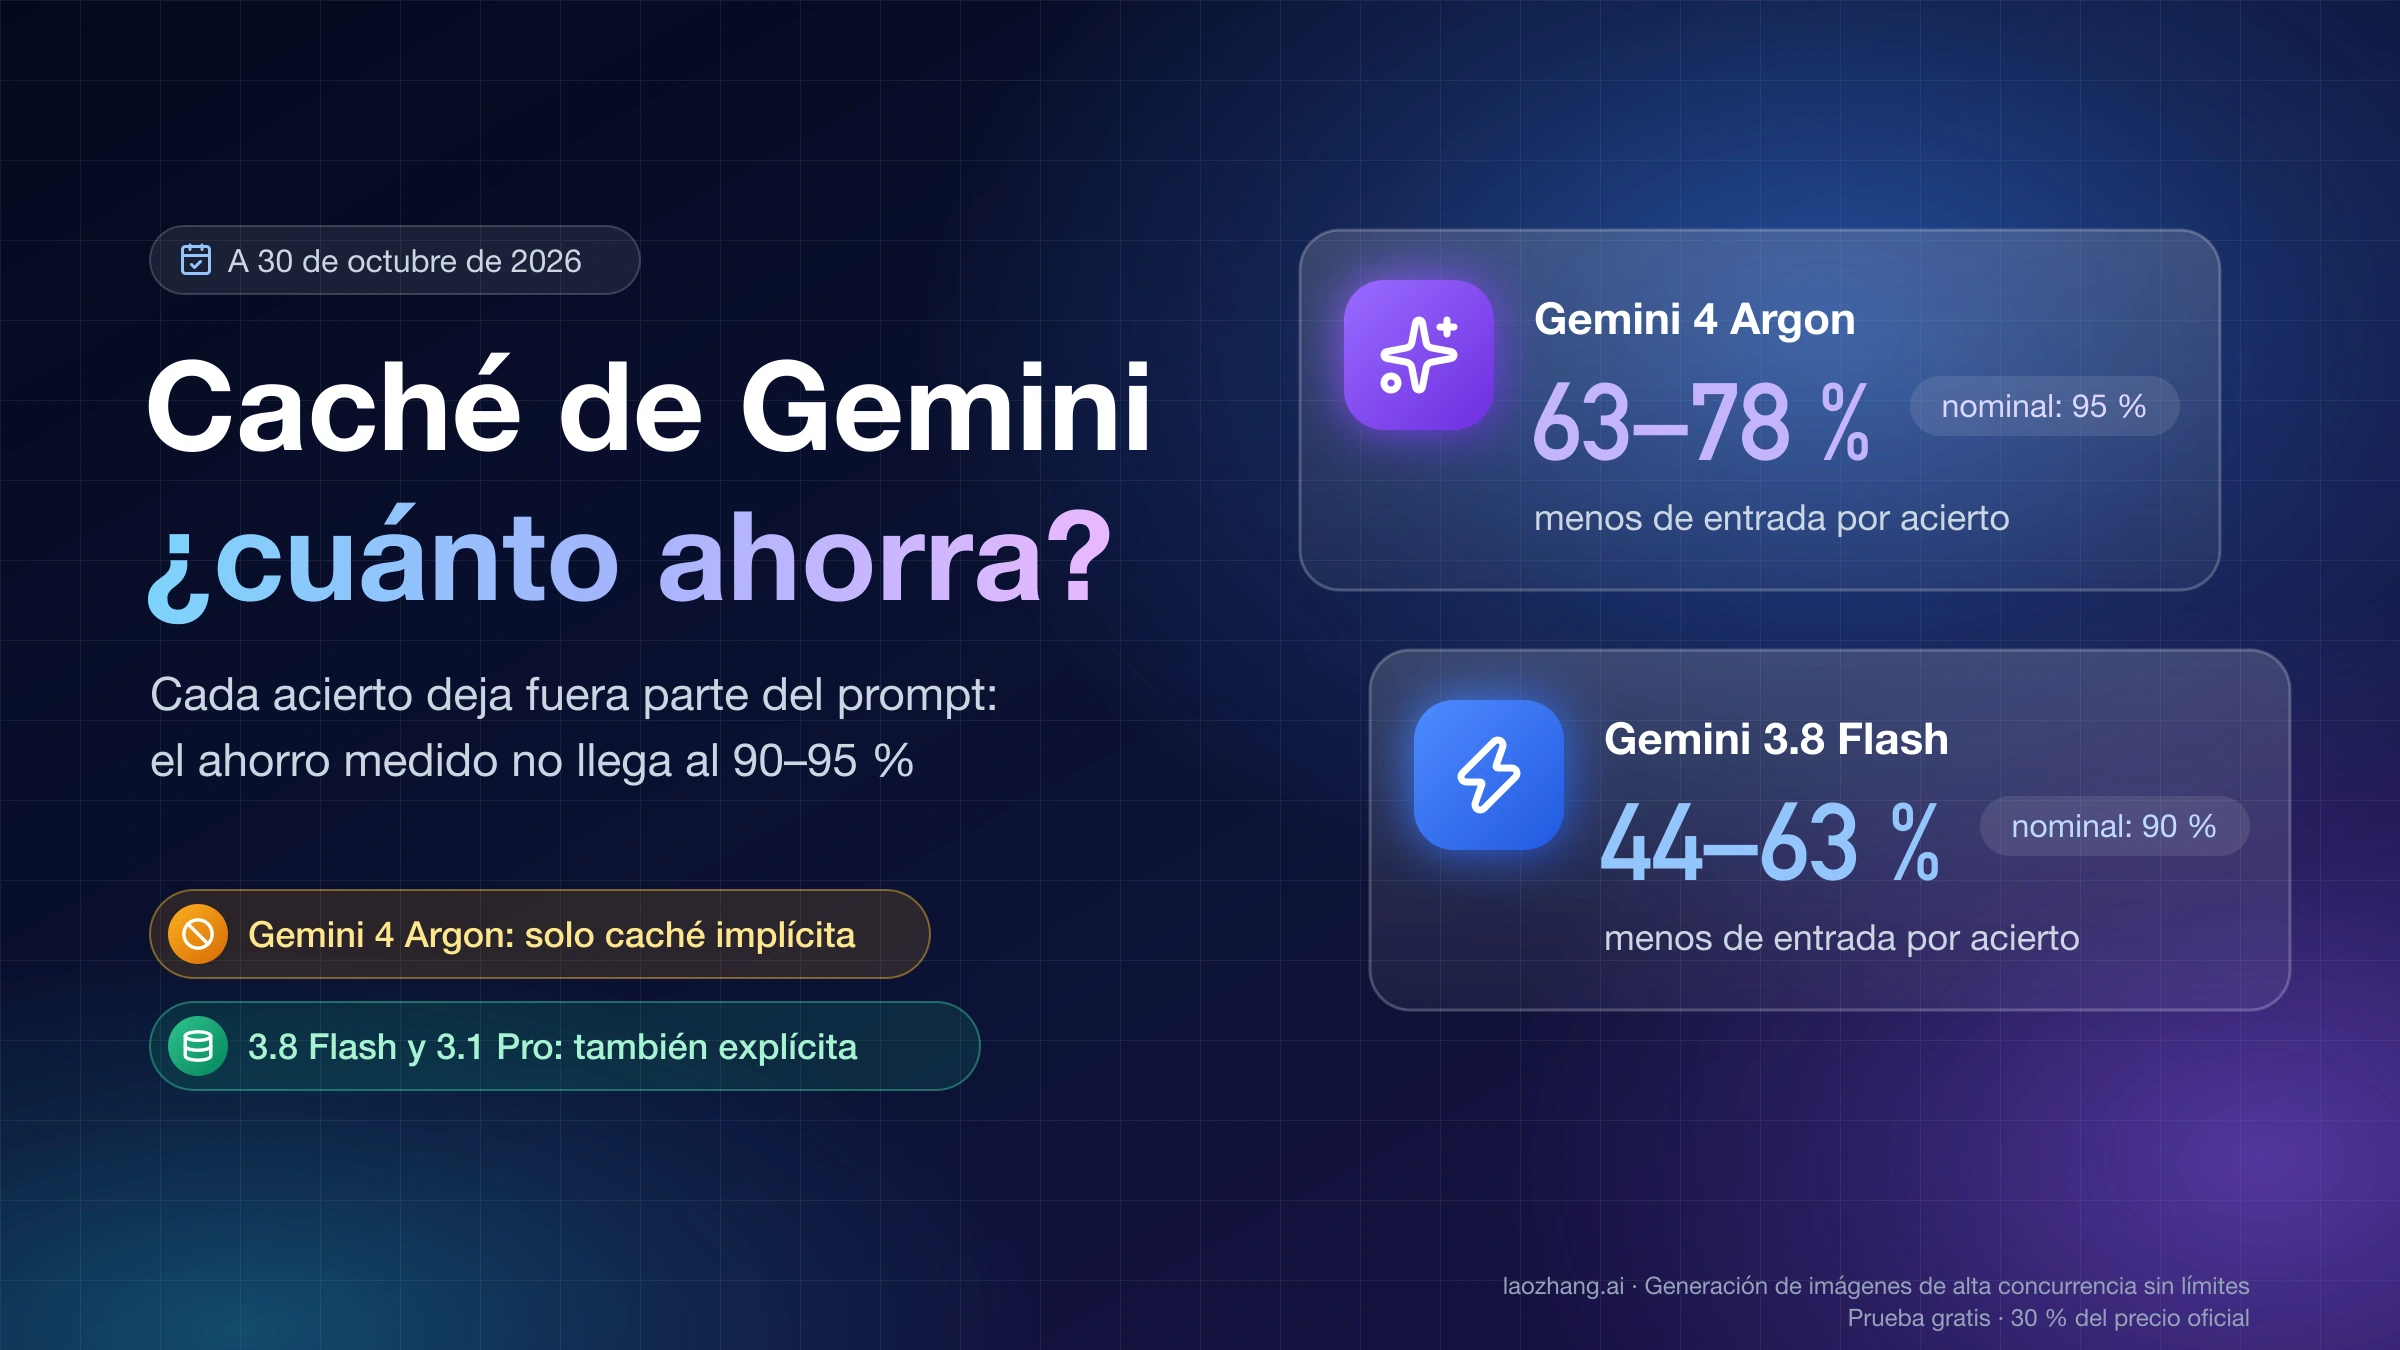
- Caché de contexto: USD 0,20 / USD 0,40 por millón de tokens (hasta / más de 200.000) más USD 4,50 por millón de tokens y hora de almacenamiento en Standard, Batch y Flex; en Priority, USD 0,36 / USD 0,72 más USD 8,10 por hora. Compensa si reutilizas bloques grandes; no si cada prompt es distinto.
- Fundamentación con Google Search y Maps: 5.000 solicitudes gratis al mes, compartidas entre todos los modelos Gemini 3 y posteriores; después, USD 14 por cada 1.000. Si no necesitas datos web en tiempo real, es un coste evitable.
Los límites funcionan de otra manera. Google no publica una tabla de RPM, TPM o RPD por modelo y nivel: los límites activos de tu proyecto se ven en la página de límites de AI Studio. Se aplican por proyecto, no por clave, así que crear más claves en el mismo proyecto no te da más cuota. Los modelos Preview como 3.1 Pro pueden tener límites más estrictos que los estables. El mecanismo completo, con el error 429, está en Límites de la API de Gemini: niveles, topes de gasto y error 429.
El nivel de uso depende de tu cuenta de facturación. Tier 1 llega al vincular una cuenta de facturación (tope mensual de USD 250); Tier 2 exige haber pagado USD 100 y que pasen 3 días desde el primer pago (USD 2.000), y Tier 3, USD 1.000 y 30 días (de USD 20.000 a más de 100.000). Además hay un tope de gasto en ventanas móviles de 10 minutos, de USD 10, 50 y 200 según el nivel, que devuelve 429 RESOURCE_EXHAUSTED al superarse. Las cuentas antiguas de pospago pasan a prepago: Impress Watch informó de que el plazo que comunica Google es el 12 de octubre de 2026, y la documentación remite a la fecha de tu propio aviso. Lo explica Facturación de Gemini API: prepago, pospago y niveles (402 y 429).
Si vas a abrir 3.1 Pro a un equipo, AI Studio permite fijar topes de gasto por proyecto. Google los califica de experimentales y limitados, y no están disponibles en cuentas con facturación por factura, pero son una barrera razonable antes de la primera carga pesada de contexto largo. Las tarifas del resto de modelos Gemini están en Clave de API de Gemini gratis y precio: qué sube en 2027.
Thinking, contexto largo y caché: dónde de verdad se mueve la factura
Según la guía de Gemini 3 de Google, 3.1 Pro admite low, medium y high como thinking_level, con high como valor por defecto y dinámico. minimal no está soportado en 3.1 Pro (sí en 3.1 Flash-Lite y 3 Flash Preview; tampoco en 3.8 Flash, donde devuelve error). Y no puedes enviar thinking_level junto al parámetro heredado thinking_budget en la misma solicitud: la API responde con un error 400. thinking_budget sigue aceptándose por compatibilidad, pero en código nuevo usa solo thinking_level.
Como los tokens de razonamiento se cobran como salida, el nivel es una palanca de coste directa. Una pauta razonable, que es una inferencia a partir de la estructura de precios y no una recomendación literal de Google: empieza en medium para el trabajo diario, baja a low en extracción, clasificación y transformaciones cortas, y reserva high para análisis complejos, revisión de bases de código grandes o razonamiento en varios pasos. Que high sea el valor por defecto significa que, si no fijas nada, pagas el máximo.
Con el contexto largo pasa lo mismo. La ventana de 1.048.576 tokens es una de las mejores razones para elegir 3.1 Pro, pero la pregunta útil no es si cabe, sino cuántas veces vas a pagar la banda de más de 200.000 tokens y qué partes podrías cachear o resumir antes. Reenviar una y otra vez el mismo prompt de sistema enorme, el mismo paquete de documentos o el mismo repositorio convierte la implementación más cómoda en la más cara.
Tres reglas resumen la sección: fija el razonamiento de forma explícita, vigila el umbral de 200.000 tokens y cachea lo que repites.
Cómo migrar si venías de Gemini 3 Pro Preview o ya trabajas con OpenAI SDK
Si usabas gemini-3-pro-preview, el primer cambio es el model ID: ese modelo se apagó el 9 de marzo de 2026, así que escribe gemini-3.1-pro-preview de forma explícita y decide si tu carga va a la variante estándar o a -customtools. Después, repasa la lista de migración que Google publica para Gemini 3 y posteriores:
- Sustituye
thinking_budgetporthinking_level(low,mediumohighen 3.1 Pro). Mandar los dos a la vez da error 400. - Quita
temperature,top_pytop_k: están obsoletos desde el 21 de julio de 2026. La guía de Gemini 3 ya advertía de que bajartemperaturede 1.0 podía causar bucles. - Quita
candidate_count, que no se admite en Gemini 3 y posteriores, y los turnos del modelo prellenados (prefill). - Conserva las firmas de pensamiento (thought signatures). Gemini 3 las usa para mantener el contexto de razonamiento entre llamadas. Con la Interactions API y
previous_interaction_id, el servidor las gestiona; si mantienes tú el historial, debes reenviar los bloques de pensamiento con sus firmas en las solicitudes siguientes. - Unifica las conversaciones de varios turnos en
previous_interaction_id, del lado del servidor, si pasas a la Interactions API. - Si sigues en
generateContent, comprueba que cadaFunctionResponsellevacall_idyname. - Rehaz el presupuesto con la tabla de precios actual y prueba prompts representativos antes de volver a producción.
Si tu equipo trabaja con el SDK de OpenAI, la capa de compatibilidad de Google es el puente con menos fricción: cambias la clave, la URL base y el nombre del modelo.
from openai import OpenAI

client = OpenAI(
    api_key="GEMINI_API_KEY",
    base_url="https://generativelanguage.googleapis.com/v1beta/openai/"
)

response = client.chat.completions.create(
    model="gemini-3.1-pro-preview",
    reasoning_effort="medium",
    messages=[
        {"role": "user", "content": "Summarize the migration risks in this API design."}
    ]
)

print(response.choices[0].message.content)
Según la documentación de compatibilidad con OpenAI de la API de Gemini, reasoning_effort se traduce automáticamente al thinking_level equivalente. Usa low, medium o high para no depender de cómo se traduce minimal, que 3.1 Pro no admite, y no combines reasoning_effort con otra configuración de razonamiento propia de Gemini en la misma solicitud.
Es también buen momento para revisar tutoriales y fragmentos internos antiguos. En un modelo Preview no caduca solo el nombre: también parámetros, supuestos de coste y la forma de facturar.
Cuándo Gemini 3.1 Pro es la API correcta y cuándo no lo es
Gemini 3.1 Pro tiene sentido cuando tu carga necesita a la vez razonamiento fuerte, contexto largo y entrada multimodal con herramientas: revisión de documentos grandes, análisis de bases de código amplias, extracción estructurada sobre entradas mixtas y agentes que dependen de ejecución de código, llamadas a funciones, fundamentación o contexto de URL. También tiene que encajar la realidad de un modelo Preview de pago: sin nivel gratuito, con límites que pueden ser más estrictos y con retirada posible tras un aviso de dos semanas.
- Elige
gemini-3.1-pro-preview-customtoolscuando tu agente combine bash con herramientas registradas y el problema sea la prioridad de esas herramientas. - Elige Gemini 3.8 Flash o 3.6 Flash cuando pesen más el presupuesto, la latencia o el volumen, o cuando necesites nivel gratuito para empezar. Hasta el 31 de diciembre de 2026, Pro cuesta 2,67 veces más por token de entrada y 3,2 veces más por token de salida; en 2027, la distancia se reduce a 1,33 y 1,6 veces.
- Cambia de familia si necesitas generar imágenes o audio en directo.
- Si lo que quieres es empezar con una API gratis, Pro no es el sitio: empieza por la familia Flash.
España está en la lista de regiones disponibles de la API de Gemini; China continental, Hong Kong y Rusia no aparecen en ella, y no hay una vía legítima para usar la API desde regiones que no figuran en esa lista.
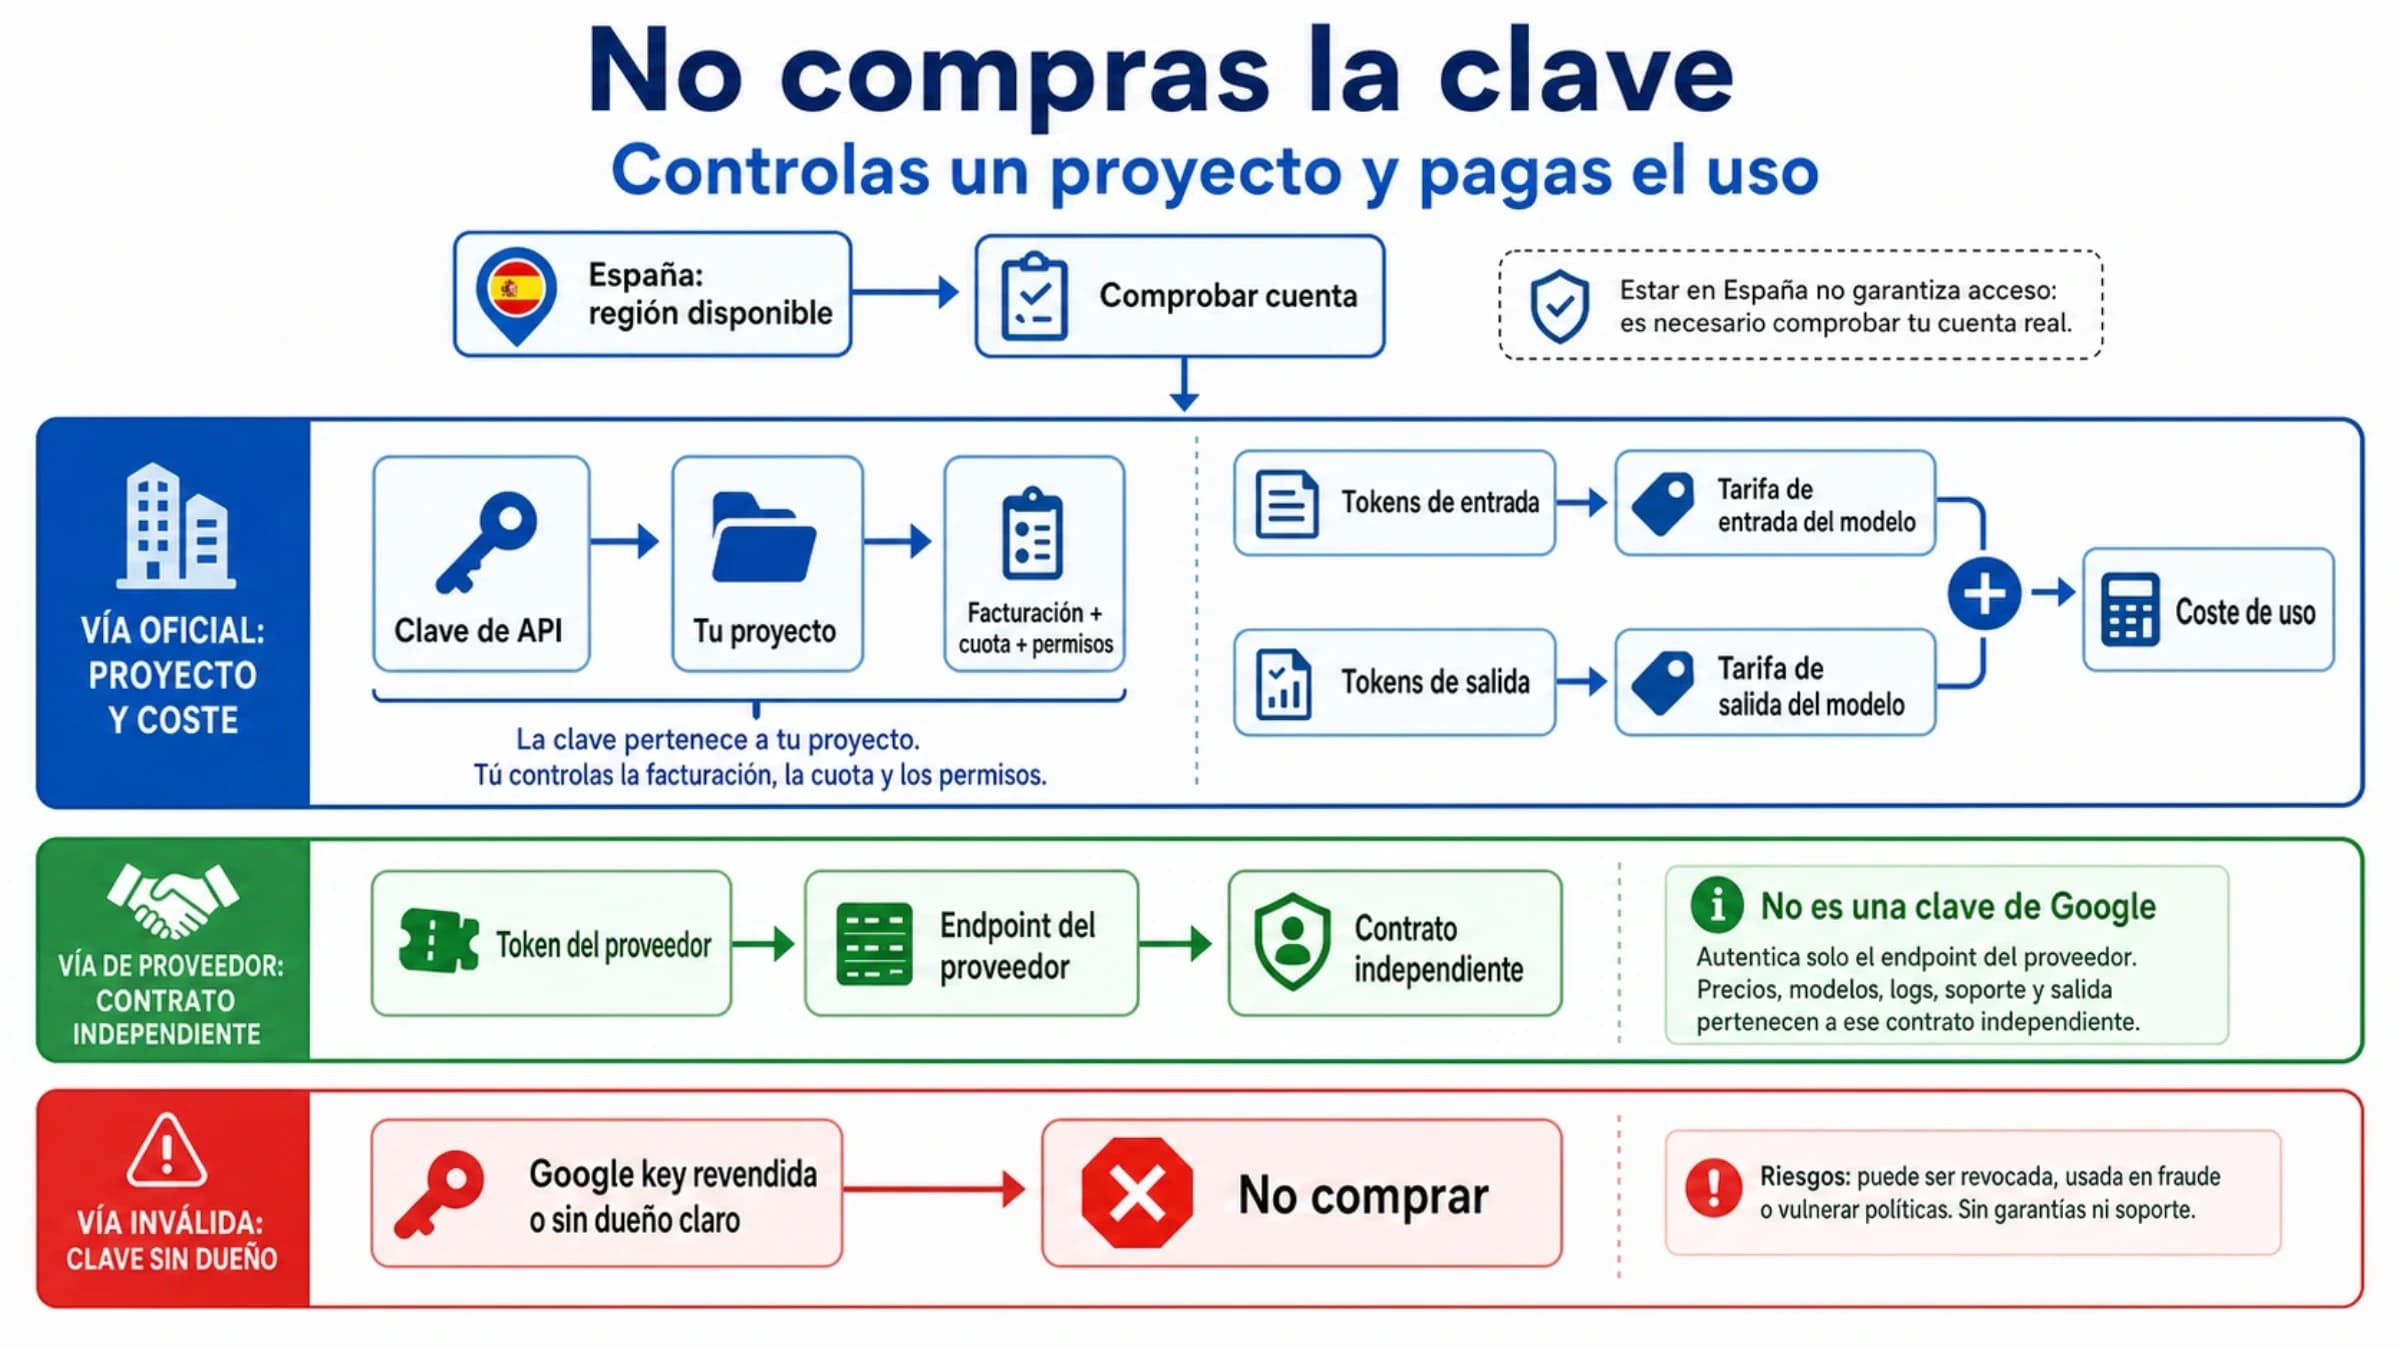
Si comparas proveedores detrás de una sola capa compatible con OpenAI, laozhang.ai lista gemini-3.1-pro-preview a USD 2,00 / USD 12,00 por millón de tokens, con su propia clave y saldo (un contrato aparte, no una clave de Google) y URL base https://api.laozhang.ai/v1.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
La conclusión es corta: paga Gemini 3.1 Pro cuando necesites lo que lo distingue y no solo su nombre. Para texto barato, rápido y de mucho volumen, 3.8 Flash cubre el caso a menor coste.
FAQ
¿Gemini 3.1 Pro API es gratis? No. La página de precios de Google marca el nivel gratuito como «Not available» para Gemini 3.1 Pro Preview y su variante customtools. Crear la clave es gratis, pero las llamadas necesitan facturación con saldo. En AI Studio puedes intentar usarlo sin pagar con una cuota pequeña que Google no publica.
¿Qué API de Gemini es gratis? La familia Flash: Gemini 3.8 Flash, 3.6 Flash, 3.5 Flash-Lite, 3.1 Flash-Lite y 3 Flash Preview tienen nivel gratuito en la API, con límites por proyecto visibles en AI Studio. Gemini 3.1 Pro y los modelos de imagen no lo tienen.
¿Qué es mejor, Gemini 3.6 Flash o 3.1 Pro? Depende de la tarea. 3.1 Pro es el modelo de razonamiento más fuerte de la API, pero cuesta USD 2,00 / USD 12,00 por millón de tokens frente a USD 0,75 / USD 3,75 de 3.6 Flash y 3.8 Flash hasta el 31 de diciembre de 2026. Para volumen y presupuesto, Flash (hoy mejor 3.8 Flash); para razonamiento difícil y contexto muy largo, Pro.
¿Sigue funcionando gemini-3-pro-preview?
No. Google lo apagó el 9 de marzo de 2026 y da gemini-3.1-pro-preview como reemplazo. Cambia el model ID en tu código de forma explícita.
¿Tiene Gemini 3.1 Pro fecha de cierre o un sucesor? A 10 de octubre de 2026, no. Sigue en Preview sin fecha de cierre anunciada y no hay un modelo Pro más nuevo en la API de Gemini. Google se reserva retirar los modelos Preview con al menos dos semanas de aviso.
¿Debo usar gemini-3.1-pro-preview-customtools en todos los proyectos?
No. Solo tiene sentido cuando la prioridad de las herramientas propias es parte real de la carga. Google advierte de posibles fluctuaciones de calidad en casos que no se benefician de ello.
¿Dónde veo mis RPM, TPM y RPD reales? En la página de límites de AI Studio, para el proyecto seleccionado. Google no publica una tabla fija por nivel y aplica los límites por proyecto, no por clave.
¿Puedo llamar a Gemini 3.1 Pro desde OpenAI SDK?
Sí. Con la capa de compatibilidad de Google cambias la clave, la URL base (https://generativelanguage.googleapis.com/v1beta/openai/) y el nombre del modelo; reasoning_effort se traduce a thinking_level.
¿Gemini 3.1 Pro soporta image generation o Live API? No. La ficha del modelo marca la generación de imágenes, la generación de audio y la Live API como no soportadas.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 10 oct 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 10 oct 2026.
- 1.página de precios de la API de Geminiai.google.dev/gemini-api/docs/pricing
- 2.página de facturación de la API de Geminiai.google.dev/gemini-api/docs/billing
- 3.página de planes de Google AI para desarrolladoresai.google.dev/gemini-api/docs/google-ai-plans
- 4.ficha de Gemini 3.1 Pro Previewai.google.dev/gemini-api/docs/models/gemini-3.1-pro-preview
- 5.página de retiradas de modelos de la API de Geminiai.google.dev/gemini-api/docs/deprecations
- 6.página de límites de AI Studioaistudio.google.com/rate-limit
- 7.documentación de compatibilidad con OpenAI de la API de Geminiai.google.dev/gemini-api/docs/openai