Cómo generar imágenes con Claude Code: SVG, script o MCP
Claude Code no genera píxeles: las imágenes salen de código que escribe y ejecuta, o de un modelo externo vía script o MCP. Qué vía elegir y cuánto cuesta.
En esta página
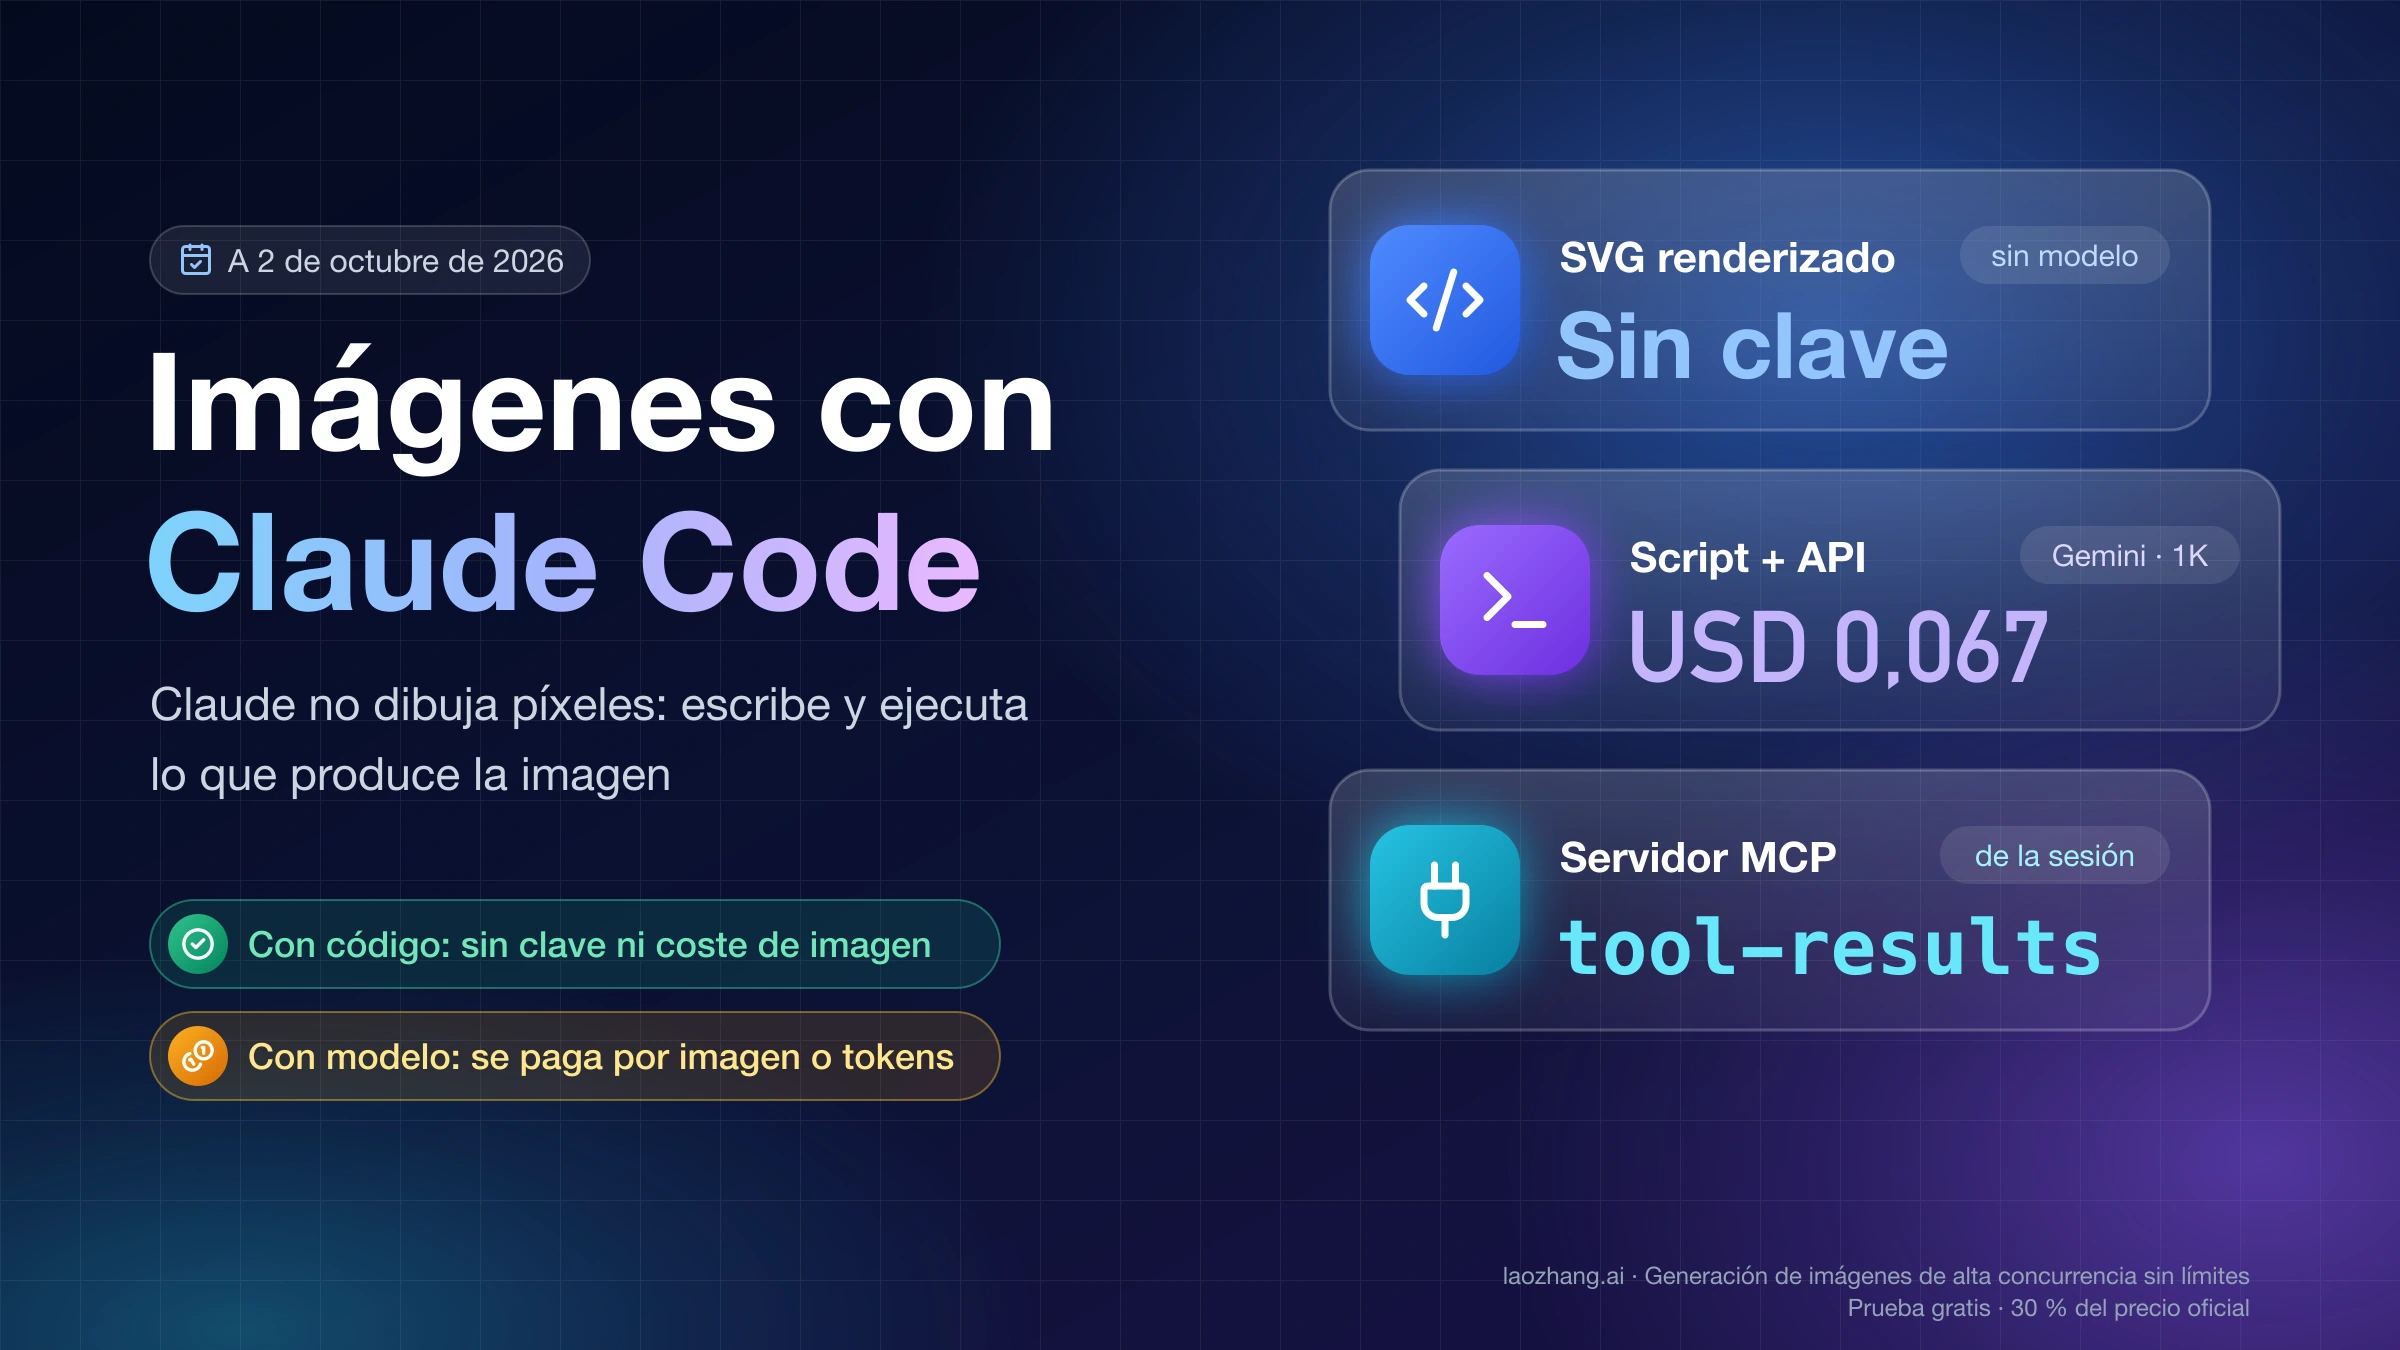
Claude Code no produce imágenes por sí mismo. Lo que sí hace, y muy bien, es escribir y ejecutar lo que las produce. A 2 de octubre de 2026, una imagen que aparece en tu proyecto durante una sesión tiene uno de estos dos orígenes:
- Código que Claude escribe y renderiza: un SVG, un HTML o un script de Python que se convierte en PNG o WebP. Sirve para diagramas, gráficos, iconos sencillos y portadas con texto. No necesita clave ni cuesta nada aparte de la propia sesión.
- Un modelo de imagen externo: GPT Image de OpenAI, los modelos de imagen de Gemini, FLUX y similares. Claude Code llega a ellos con un script que llama a la API o con un servidor MCP. Es la única vía para fotografía e ilustración, y casi siempre se paga por imagen o por tokens.
La decisión, por tanto, empieza por el tipo de imagen y sigue por dos condiciones tuyas: si puedes activar una API de pago y si trabajas solo o en un repositorio compartido.
Claude Code no dibuja píxeles: quién genera realmente la imagen
Ningún modelo ni plan de Claude devuelve imágenes. El centro de ayuda de Anthropic lo dice así: «Claude doesn't generate photos or illustrations the way image-generation tools do», y añade que puede crear gráficos y diagramas como HTML o SVG (artículo de ayuda). La documentación de la API es más tajante: Claude es «an image understanding model only» y no puede generar, editar ni manipular imágenes (documentación de Visión).
Conviene separar tres cosas que suelen mezclarse:
- Leer imágenes sí es una capacidad de Claude Code: puedes arrastrar un archivo, pegarlo con Ctrl+V (Alt+V en Windows y WSL) o darle la ruta, y la herramienta Read le muestra el contenido.
- Generar imágenes no lo es. Cuando alguien dice que «Claude genera imágenes», lo que ocurre es que Claude Code ejecuta algo que las genera.
- Las aplicaciones de chat de Claude son otra superficie, con sus propias opciones. Para ellas tienes la guía ¿Puede Claude generar imágenes?.
Anthropic tampoco ofrece un conector ni una skill propios con un modelo de imagen. Los conectores relacionados con imágenes que aparecen en su directorio, como los de Adobe, Canva o Hugging Face, están hechos por esas empresas. Y las skills de imagen del repositorio oficial anthropics/skills (canvas-design, algorithmic-art, slack-gif-creator) renderizan con código, sin llamar a ningún modelo de imagen.
Qué vía elegir según la imagen que necesitas
Si la imagen se puede describir con formas, texto y datos, usa código; si necesita textura fotográfica o trazo de ilustración, necesitas un modelo. El resto de la elección depende del acceso y del equipo.
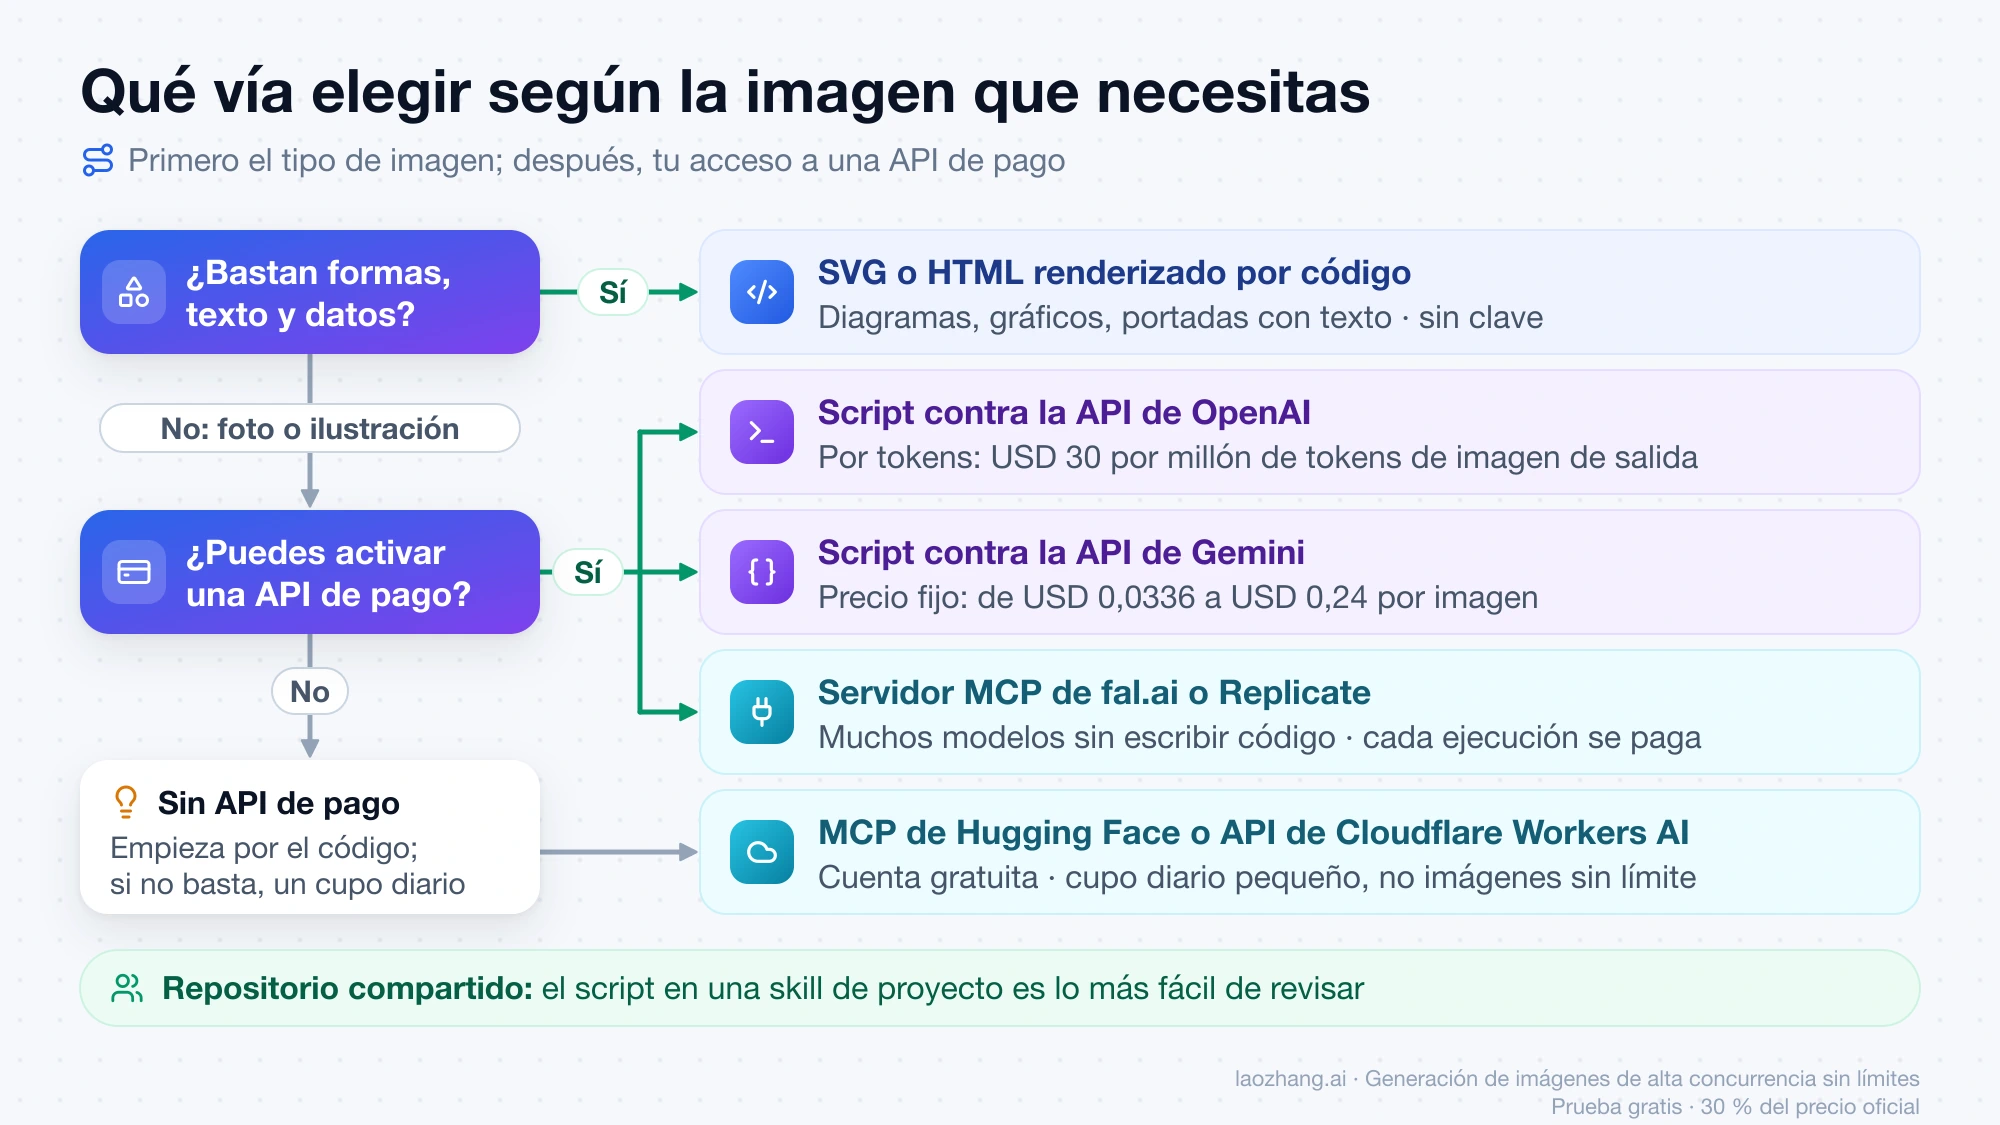
| Lo que necesitas | Vía | Qué hace falta | Coste | Dónde queda el archivo |
|---|---|---|---|---|
| Diagrama, gráfico, portada con texto, icono geométrico | SVG o HTML renderizado por código | rsvg-convert, cwebp o Pillow instalados | Solo la sesión de Claude Code | En la ruta del proyecto que indiques |
| Foto o ilustración, con control de modelo, tamaño y calidad | Script contra la API de OpenAI | OPENAI_API_KEY; puede exigir verificar la organización | Por tokens: USD 30 por millón de tokens de imagen de salida | En la ruta que pases en --out |
| Foto o ilustración con precio fijo por imagen | Script contra la API de Gemini | Clave de Gemini con facturación activada | De USD 0,0336 a USD 0,24 por imagen según modelo y resolución | En la ruta que elija el script |
| Probar modelos abiertos sin pagar al principio | Servidor MCP de Hugging Face o API de Cloudflare Workers AI | Cuenta gratuita | Cupo diario pequeño, no imágenes sin límite | MCP: carpeta de la sesión, fuera del proyecto |
| Elegir entre muchos modelos sin escribir código | Servidor MCP de fal.ai o Replicate | Cuenta y saldo en esa plataforma | Cada ejecución de modelo se paga | Carpeta de la sesión, fuera del proyecto |
Dos reglas prácticas salen de la tabla. En un repositorio compartido, el script dentro de una skill de proyecto es lo más fácil de revisar: todo el equipo ve qué modelo se llama, con qué parámetros y dónde se guarda el resultado. Y si no puedes activar ninguna API de pago, empieza por la vía de código; cubre más casos de los que parece.
Diagramas, gráficos y portadas con texto: SVG renderizado sin modelo de imagen
Para todo lo que sea estructura y texto, pídele a Claude Code que escriba un SVG y lo convierta a PNG o WebP con una herramienta local. El texto sale nítido y exacto, el tamaño es el que pidas al píxel y puedes corregir un detalle editando una línea en lugar de volver a generar.
Las imágenes de este blog se hacen así, sin ningún modelo de imagen: Claude escribe el SVG, rsvg-convert lo renderiza a un PNG de tamaño exacto y cwebp lo convierte a WebP. Las portadas miden 2400×1350 y las imágenes de cuerpo, 2000×1125. Los 18 archivos WebP de un artículo publicado el 2 de octubre de 2026 pesaron entre 136 KB y 192 KB cada uno. En una prueba del día anterior, un SVG de 911 bytes escrito a mano se renderizó a un PNG de 1600×600 en 135 ms, y Pillow se encargó del recorte, el paso a escala de grises y la conversión a WebP. Son datos de un solo sitio y una sola máquina, pero dan una idea del orden de magnitud.
Una petición suficiente para empezar:
Escribe assets/arquitectura.svg (1600×900) con el flujo: navegador → API → cola → worker.
Renderízalo a PNG con rsvg-convert al mismo tamaño, conviértelo a WebP,
abre el PNG con Read y corrige solapes de texto o elementos fuera del lienzo.
El límite es claro: esta vía compone, recorta y convierte, pero no puede crear una fotografía ni una ilustración nueva. Si lo que buscas es un retrato, un producto en una escena o un estilo pictórico, pasa a la siguiente.
Fotos e ilustraciones con un script: generate.py y la API de OpenAI
La forma más controlable de usar un modelo de imagen desde Claude Code es un script pequeño que Claude ejecuta con Bash. Los modelos de imagen vigentes de OpenAI son gpt-image-2.5-flare (rápido, para uso diario) y gpt-image-2.5-sunburst (más preciso en edición), y se llaman con POST /v1/images/generations según su guía de generación de imágenes. La API no devuelve un archivo ni una URL, sino la imagen en base64 dentro de data[0].b64_json, PNG por defecto: alguien tiene que decodificarla y escribirla en disco. Eso es lo que hace este script, que solo usa la biblioteca estándar de Python:
#!/usr/bin/env python3
"""Generate one image with the OpenAI Images API and save it to disk.

Standard library only. Reads the key from OPENAI_API_KEY; never prints it.
"""
import argparse
import base64
import json
import os
import pathlib
import sys
import urllib.error
import urllib.request

MODELS = ("gpt-image-2.5-flare", "gpt-image-2.5-sunburst")


def main() -> int:
    parser = argparse.ArgumentParser()
    parser.add_argument("--prompt", required=True)
    parser.add_argument("--out", required=True, help="output file, e.g. assets/hero.png")
    parser.add_argument("--model", default="gpt-image-2.5-flare", choices=MODELS)
    parser.add_argument("--size", default="1536x1024")
    parser.add_argument("--quality", default="low")
    args = parser.parse_args()

    key = os.environ.get("OPENAI_API_KEY")
    if not key:
        print("OPENAI_API_KEY is not set. Export it in the shell before starting claude.", file=sys.stderr)
        return 2

    out = pathlib.Path(args.out)
    if out.exists():
        print(f"{out} already exists. Choose another --out so nothing is overwritten.", file=sys.stderr)
        return 2

    base = os.environ.get("OPENAI_BASE_URL", "https://api.openai.com/v1").rstrip("/")
    body = json.dumps({
        "model": args.model,
        "prompt": args.prompt,
        "size": args.size,
        "quality": args.quality,
    }).encode()
    request = urllib.request.Request(
        f"{base}/images/generations",
        data=body,
        headers={"Authorization": f"Bearer {key}", "Content-Type": "application/json"},
    )
    try:
        with urllib.request.urlopen(request, timeout=300) as response:
            payload = json.load(response)
    except urllib.error.HTTPError as error:
        print(f"HTTP {error.code}: {error.read().decode(errors='replace')[:600]}", file=sys.stderr)
        return 1
    except urllib.error.URLError as error:
        print(f"Request failed: {error.reason}", file=sys.stderr)
        return 1

    out.parent.mkdir(parents=True, exist_ok=True)
    out.write_bytes(base64.b64decode(payload["data"][0]["b64_json"]))
    print(json.dumps({"saved": str(out), "bytes": out.stat().st_size, "usage": payload.get("usage")}))
    return 0


if __name__ == "__main__":
    sys.exit(main())
Guárdalo, por ejemplo, en .claude/skills/image/scripts/generate.py. Exporta la clave en la terminal antes de arrancar claude (Claude Code lee las variables de entorno al iniciarse, así que un cambio de clave exige reiniciarlo) y pídele la imagen con una ruta de salida concreta. La llamada que acabará ejecutando tiene esta forma:
python3 .claude/skills/image/scripts/generate.py \
  --prompt "Fotografía de producto: taza de cerámica blanca sobre mesa de roble, luz lateral suave" \
  --out assets/hero.png
Si todo va bien, el script imprime una línea JSON con saved, bytes y usage, y Claude sabe exactamente dónde está el archivo.
Qué está comprobado del script y qué no
El alcance de la verificación es limitado y conviene saberlo: a 2 de octubre de 2026 el script solo se ejecutó en sus rutas de rechazo, sin clave real, y no generó ninguna imagen. Esto es lo observado:
| Condición | Resultado |
|---|---|
OPENAI_API_KEY sin definir | Mensaje de error, código de salida 2, ninguna llamada de red |
| Clave falsa | La petición llega a api.openai.com y vuelve HTTP 401 con invalid_api_key; salida 1, ningún archivo |
--model dall-e-3, fuera de la lista permitida | argparse lo rechaza con «invalid choice» |
--out apunta a un archivo que ya existe | Mensaje de error, salida 2, ninguna llamada de red |
Queda sin comprobar una generación correcta, la forma real del campo usage, el coste por imagen, la latencia y si tu cuenta acepta los valores por defecto. Esos valores (1536x1024 y calidad low) son parámetros documentados por OpenAI: los tamaños recomendados son 1024x1024, 1536x1024 y 1024x1536, y la calidad admite low, medium, high, xhigh, max y auto.
Tres detalles de OpenAI que cambian el resultado
- Verificación de la organización. OpenAI avisa de que puede exigir la verificación de la organización antes de usar los modelos GPT Image. Requiere un documento de identidad físico emitido por un país admitido, y una persona solo puede verificar una organización (ayuda de OpenAI). Si no puedes completarla, esta vía no te sirve con tu propia clave.
- Tiempo de espera. Un prompt complejo puede tardar hasta unos 2 minutos, por eso el script espera 300 segundos antes de rendirse.
- Ritmo. En el nivel 1 de uso el límite es de 5 imágenes por minuto. Un lote de 30 imágenes no termina antes de 6 minutos.
Convierte el script en una skill /image para todo el repositorio
Una skill hace que Claude use el script sin que tengas que explicárselo en cada sesión. Las skills de proyecto viven en .claude/skills/NOMBRE/SKILL.md y las personales en ~/.claude/skills/NOMBRE/SKILL.md; Claude decide cuándo usarlas a partir de description, o las invocas tú escribiendo /image (documentación de skills).
---
name: image
description: Genera una fotografía o ilustración con la API de imágenes de OpenAI y la guarda en el proyecto. Úsala cuando se pida una imagen que no pueda resolverse con SVG.
allowed-tools: Bash(python3 ${CLAUDE_SKILL_DIR}/scripts/generate.py *)
---

Ejecuta `python3 ${CLAUDE_SKILL_DIR}/scripts/generate.py --prompt "..." --out RUTA`.

- Guarda en `assets/` salvo que se indique otra carpeta. El script no sobrescribe: elige un nombre nuevo.
- Usa el modelo y la calidad por defecto salvo petición expresa.
- Tras generar, abre el archivo con Read y describe lo que ves antes de darlo por bueno.
- No generes más de una imagen por petición sin preguntar: cada ejecución es una llamada de pago.
La variable ${CLAUDE_SKILL_DIR} se expande tanto en el cuerpo como en las reglas Bash de allowed-tools; la línea de arriba sigue el formato del ejemplo oficial, adaptado a la ruta de este script. Añadir o editar una skill surte efecto en la sesión en curso, salvo que la carpeta skills no existiera al arrancar: entonces hace falta /reload-skills.
Dos matices de allowed-tools que importan aquí. El permiso solo vale para el turno en que se invoca la skill y se retira con tu siguiente mensaje, de modo que no equivale a una autorización permanente. Y la documentación advierte de que el allowed-tools de una skill de proyecto no pasa por el control de confianza del espacio de trabajo: antes de ejecutar una skill que viene en un repositorio ajeno, lee qué comandos se concede.
Las skills personales no llegan a Cowork ni a las sesiones en la nube. Si quieres ideas sobre qué más instalar, mira las mejores skills de Claude Code para instalar primero.
Con la API de Gemini: tres modelos vigentes y sin nivel gratuito
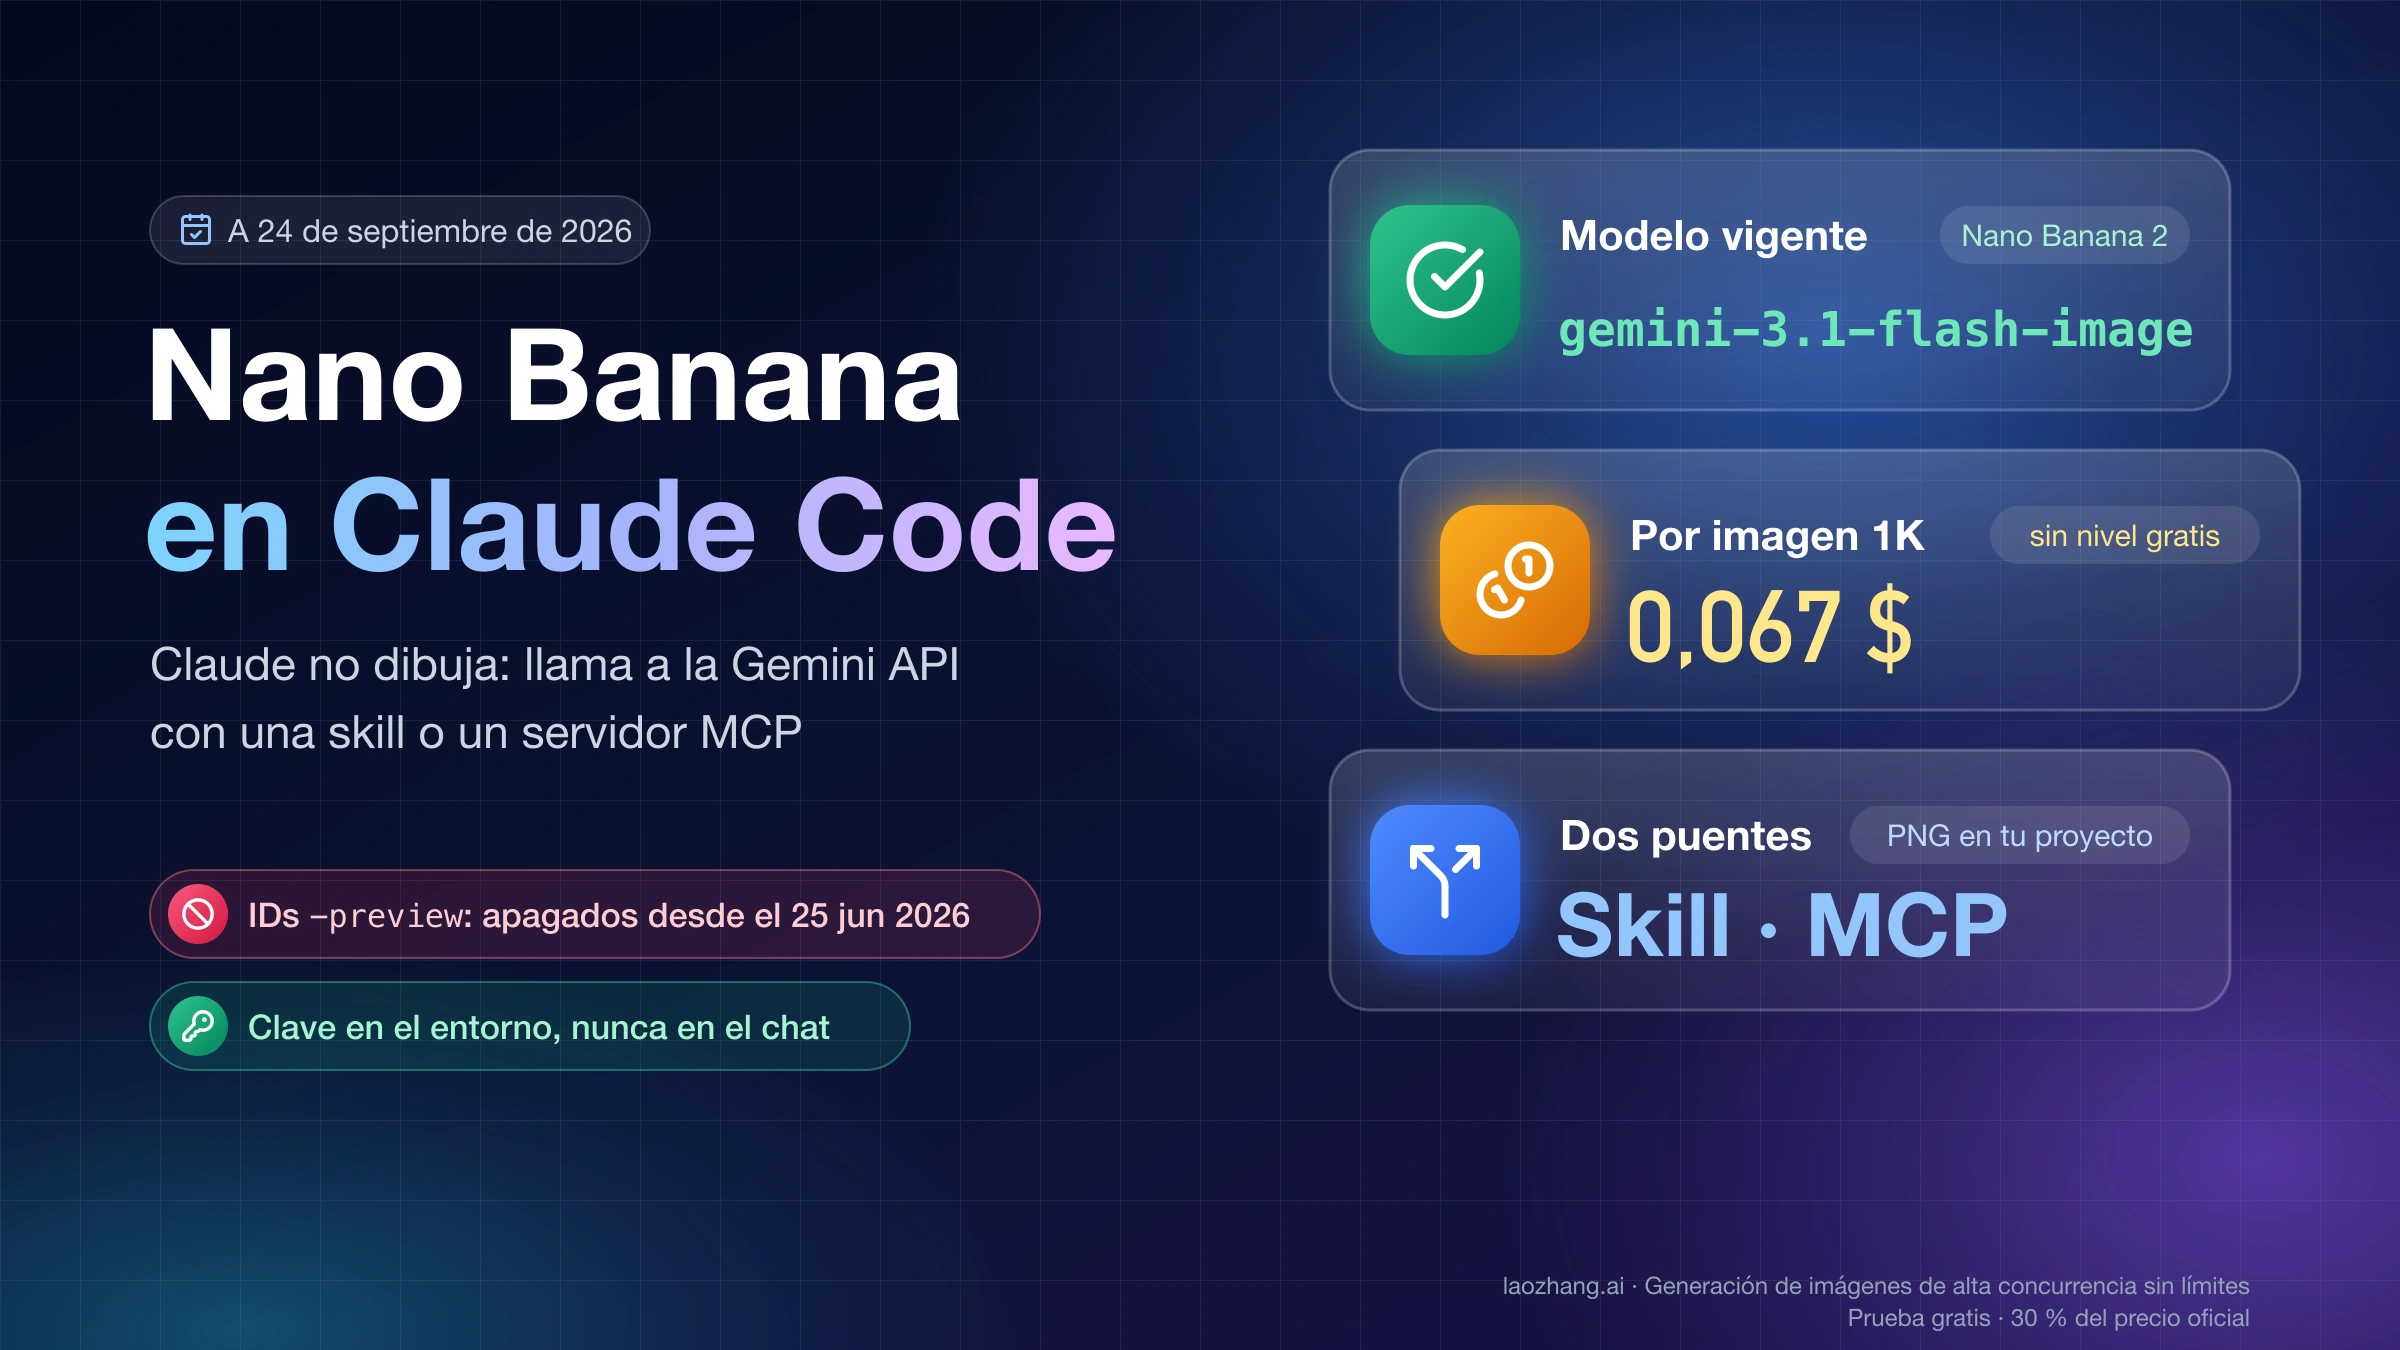
Si prefieres un precio fijo por imagen, los modelos de imagen de Gemini (la familia Nano Banana) son la alternativa directa, pero exigen facturación activada: la tabla de precios de Google marca el nivel gratuito como «Not available» para los tres (precios de la API de Gemini).
Los ID vigentes son gemini-3.1-flash-lite-image, gemini-3.1-flash-image y gemini-3-pro-image. Cuidado con los tutoriales antiguos: gemini-2.5-flash-image se retira el 2 de octubre de 2026, los ID de vista previa se apagaron el 25 de junio de 2026 y los de Imagen 4, el 17 de agosto de 2026 (calendario de retiradas). Un script que llame a uno de esos nombres fallará aunque la clave sea válida.
El ejemplo REST que Google publica hoy usa la API de Interactions: una petición POST a https://generativelanguage.googleapis.com/v1beta/interactions, con la clave en la cabecera x-goog-api-key y un cuerpo como este:
{
  "model": "gemini-3.1-flash-image",
  "input": [{"type": "text", "text": "Ilustración isométrica de un servidor en una sala de máquinas"}]
}
generateContent sigue funcionando, aunque Google lo describe ya como la vía heredada. Todas las imágenes de salida llevan la marca de agua SynthID. La carpeta de la skill, el script completo y la extensión MCP de Google están explicados paso a paso en Nano Banana en Claude Code: skill o MCP con modelos vigentes.
Servidores MCP de Hugging Face, fal.ai y Replicate: dónde queda el archivo
Un servidor MCP te ahorra escribir el script: Claude Code ve las herramientas del servidor y las llama directamente. A cambio, controlas menos dónde se guarda la imagen y cómo se almacena la clave. Los comandos siguientes proceden de la documentación de cada proveedor.
Hugging Face. El servidor oficial tiene instrucciones propias para Claude Code:
claude mcp add hf-mcp-server -t http "https://huggingface.co/mcp?login"Las comillas evitan que zsh interprete el signo de interrogación. Después arrancas claude y completas la autenticación. La generación de imágenes funciona a través de los Spaces que añadas en huggingface.co/settings/mcp; los ejemplos de Hugging Face incluyen Spaces de FLUX y de Qwen. Lo que se anuncia como gratis es un cupo diario de GPU en ZeroGPU: 2 minutos sin autenticar, 5 minutos con cuenta gratuita y 40 con PRO, que se renueva 24 horas después del primer uso (documentación de ZeroGPU).
fal.ai. Servidor alojado con cabecera de autorización:
claude mcp add --transport http fal-ai https://mcp.fal.ai/mcp --header "Authorization: Bearer YOUR_FAL_KEY"El servidor es gratuito y pagas las ejecuciones de modelo que lances; entre sus herramientas están run_model y get_pricing, así que puedes pedirle a Claude que consulte el precio antes de generar (documentación de fal). Este comando deja la clave escrita en claro en la configuración.
Replicate. Su comando oficial es claude mcp add replicate https://mcp.replicate.com/sse --transport sse --scope user, seguido de /mcp para autenticarte. Usa el transporte SSE, que la documentación de Claude Code marca como obsoleto frente a HTTP.
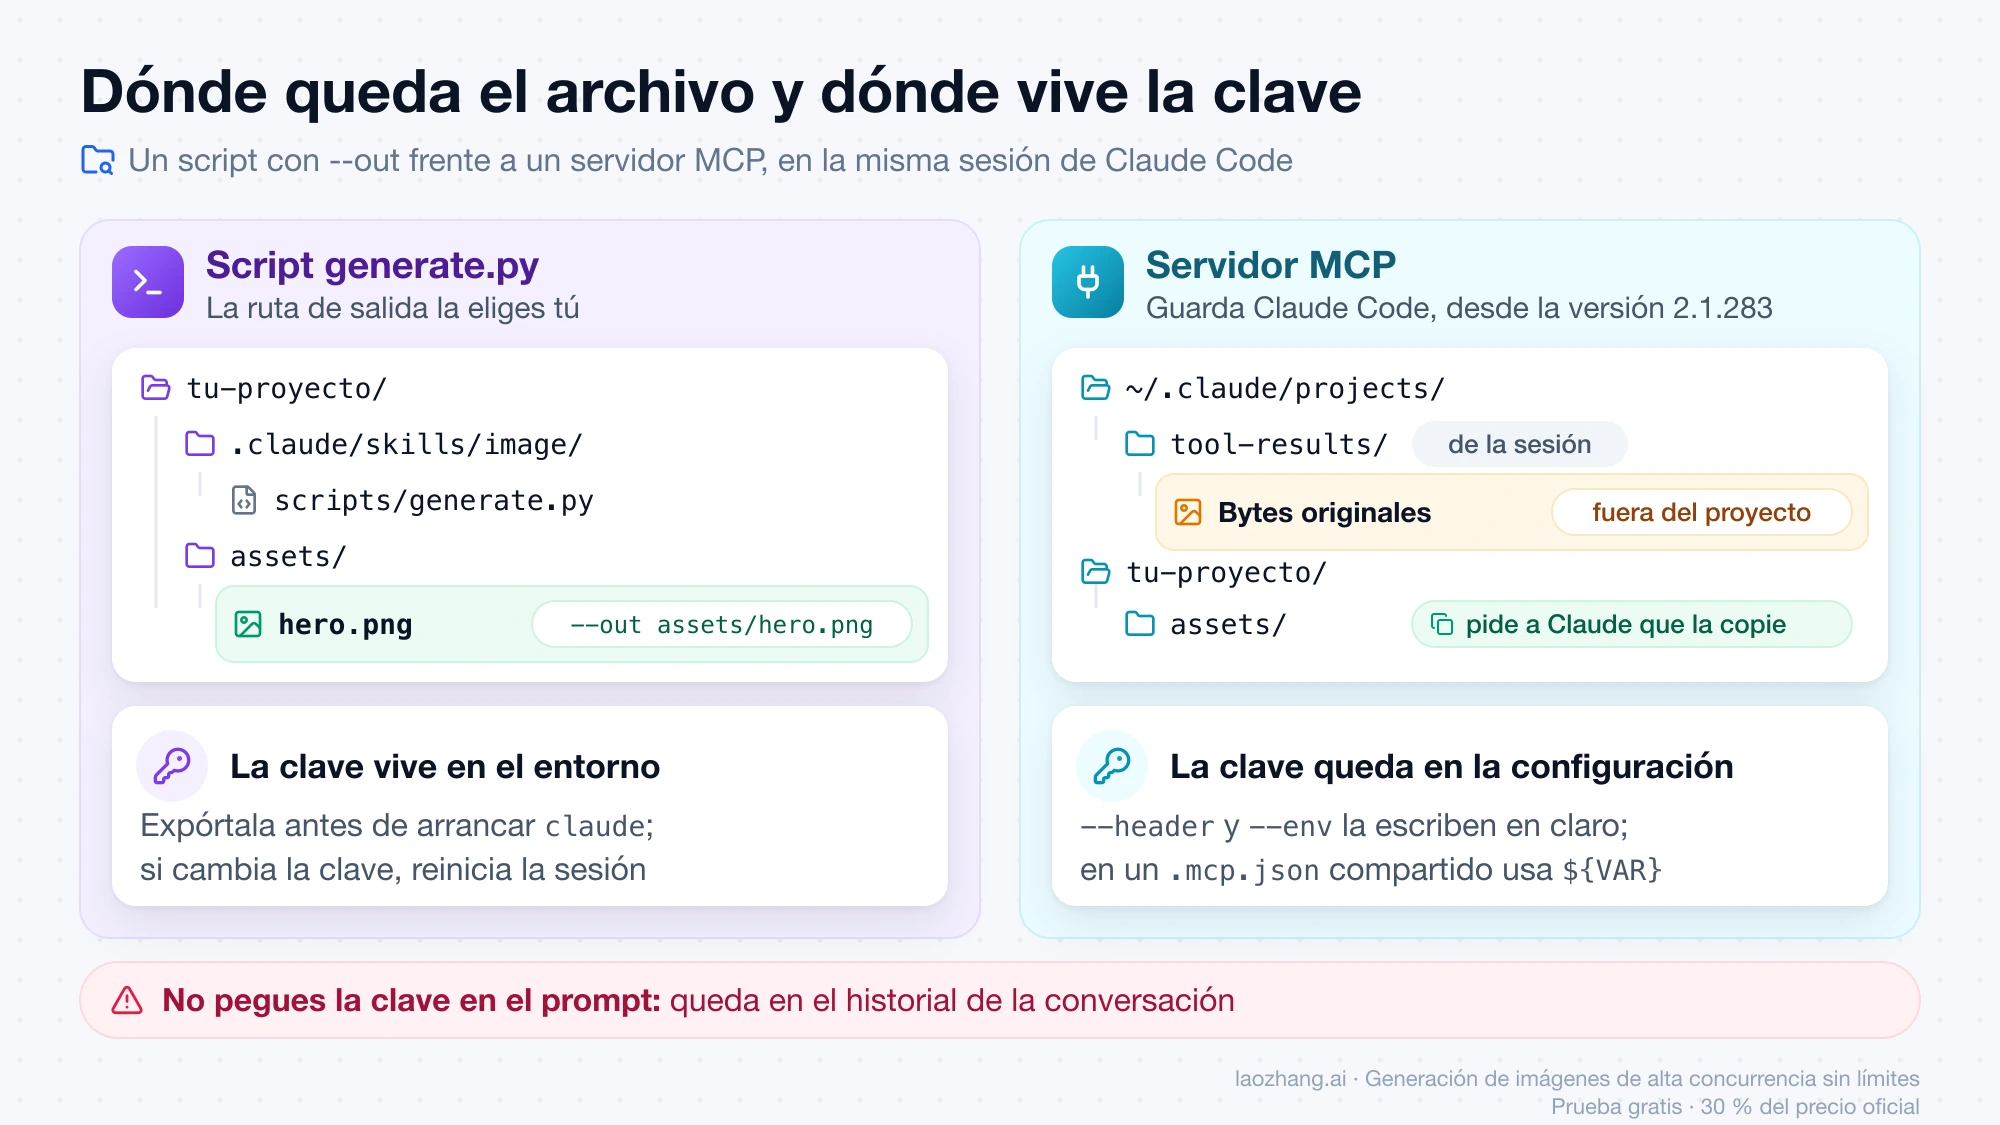
Con cualquiera de ellos, cuando una herramienta MCP devuelve un PNG, JPEG, GIF o WebP, Claude lo ve en línea y Claude Code guarda los bytes originales en la carpeta tool-results de la sesión, bajo ~/.claude/projects/, y le pasa la ruta a Claude. Esto exige la versión 2.1.283 o posterior (documentación de MCP). El archivo no está en tu proyecto: pídele a Claude que lo copie a la carpeta que necesites. Además, las herramientas que devuelven imágenes siguen sujetas al límite de salida de MCP, 25.000 tokens por defecto con aviso a partir de 10.000; si una imagen grande se corta, la única opción es subir MAX_MCP_OUTPUT_TOKENS. Lo que cada servidor devuelve exactamente, imagen en línea o URL, no figura en la documentación de Claude Code y depende del proveedor.
Los conectores de claude.ai, entre ellos el de Hugging Face, solo aparecen en Claude Code si inicias sesión con una cuenta de claude.ai; con ANTHROPIC_API_KEY no están.
Cuánto cuesta cada imagen: tarifas oficiales y cómo calcularlo
El coste depende de la unidad de cobro de cada proveedor, y no todas permiten dar una cifra por imagen. Tarifas a 2 de octubre de 2026:
| Proveedor y modelo | Unidad de cobro | Tarifa | 100 imágenes |
|---|---|---|---|
| Código (SVG, Pillow) | Ninguna | Sin coste de imagen | Sin coste de imagen |
OpenAI gpt-image-2.5-flare y gpt-image-2.5-sunburst | Tokens | USD 30 por millón de tokens de imagen de salida; USD 5 por millón de texto de entrada; USD 8 por millón de imagen de entrada | Depende de los tokens que consuma cada imagen |
Gemini gemini-3.1-flash-lite-image | Imagen | USD 0,0336 (1K) | USD 3,36 |
Gemini gemini-3.1-flash-image | Imagen | USD 0,045 (0,5K), USD 0,067 (1K), USD 0,101 (2K), USD 0,151 (4K) | USD 6,70 a 1K |
Gemini gemini-3-pro-image | Imagen | USD 0,134 (1K y 2K), USD 0,24 (4K) | USD 13,40 a 1K o 2K |
Cloudflare @cf/black-forest-labs/flux-1-schnell | Neurons | 10.000 al día sin coste; después, USD 0,011 por 1.000 | Dentro del cupo diario |
OpenAI no publica un precio fijo por imagen. El consumo de tokens varía con el tamaño y la calidad, y la única cifra fiable es la de tu propia respuesta. Por eso el script imprime usage: multiplica los tokens de imagen de salida por 30 y divide entre 1.000.000 para obtener el coste en dólares de esa llamada. El procesamiento por lotes baja la salida de imagen a USD 15 por millón. El desglose completo está en Precio de GPT Image 2.5 Sunburst: por imagen, llamada y mes.
Cloudflare se calcula con su tarifa de Neurons. El modelo cobra 4,80 Neurons por cada bloque de 512×512 y 9,60 por paso, con 4 pasos por defecto (ficha del modelo). Una imagen de 1024×1024 son 4 bloques: 4 × 4,80 + 4 × 9,60 = 57,6 Neurons. Con 10.000 Neurons diarios salen 10.000 ÷ 57,6 ≈ 173 imágenes al día, siempre que la cuenta no gaste el cupo en nada más. Es una estimación sobre la tarifa publicada. Superado el cupo, las peticiones fallan salvo que tengas Workers Paid, y entonces cada imagen así cuesta 57,6 × 0,011 ÷ 1.000 ≈ USD 0,0006. La llamada oficial es:
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/black-forest-labs/flux-1-schnell \
  -X POST \
  -H "Authorization: Bearer $CLOUDFLARE_API_TOKEN" \
  -d '{ "prompt": "cyberpunk cat" }'
Devuelve un JPEG en base64, así que también necesita un paso de decodificación.
Una opción de terceros con precio por llamada. Si no puedes completar la verificación de OpenAI ni activar la facturación de Gemini, o quieres saber de antemano lo que cuesta cada llamada, laozhang.ai, el servicio de API de los autores de este blog, documenta puntos de acceso compatibles con la API de imágenes de OpenAI en https://api2.laozhang.ai/v1. Sus precios publicados eran de USD 0,03 por llamada para gpt-image-2.5-flare-vip y gpt-image-2.5-sunburst-vip a 12 de septiembre de 2026, y de USD 0,025, USD 0,055 y USD 0,09 por llamada para los tres modelos de imagen de Gemini a 24 de septiembre de 2026 (documentación). Es un intermediario, no OpenAI ni Google: sus condiciones, compromisos de datos y garantías de servicio no son los de esos proveedores. Para usarlo con generate.py habría que añadir esos ID a la tupla MODELS y definir OPENAI_BASE_URL, una combinación que no se ha probado.
La clave y la aprobación automática: llamadas de pago sin supervisión
La clave debe vivir en el entorno, no en la conversación ni en el repositorio, y el permiso para ejecutar el script debe seguir pidiéndose mientras cada ejecución cueste dinero.
Dónde poner la clave. Expórtala en la terminal antes de arrancar claude, o usa la clave env de la configuración, que define variables para la sesión y sus subprocesos. No la pegues en el prompt: queda en el historial de la conversación. Si la guardas en un .env, añade una regla deny como Read(./.env) para que Claude no pueda leer el archivo (documentación de permisos). Con MCP, claude mcp add --env CLAVE=valor y las cabeceras --header escriben el valor literal en la configuración; en un .mcp.json compartido usa la expansión ${VAR} para que cada persona aporte la suya y la clave no acabe en un commit.
Qué significa «no volver a preguntar». La primera vez que Claude quiera ejecutar el script, verás una petición de permiso de Bash. Si eliges «Yes, and don't ask again», Claude Code escribe una regla allow en .claude/settings.local.json. Una regla como esta, construida con el formato documentado y la ruta del script:
{
  "permissions": {
    "allow": ["Bash(python3 .claude/skills/image/scripts/generate.py *)"]
  }
}
autoriza cualquier ejecución futura con cualquier argumento. A partir de ahí, cada vez que Claude decida generar o regenerar una imagen, lo hará sin consultarte y será una llamada facturada. La propia documentación advierte de que las reglas que intentan restringir argumentos de Bash son frágiles, así que no cuentes con limitar el modelo o la calidad desde ahí.
Un criterio razonable: mantén la confirmación manual mientras ajustas prompts, porque es cuando más regeneraciones hay. Si necesitas un lote sin supervisión, fija un límite de gasto en la consola del proveedor, deja la calidad en low y elimina la regla cuando termines. El allowed-tools de la skill es más prudente que una regla permanente precisamente porque caduca con el turno.
Que Claude mire su propio resultado y lo corrija: el límite de Read
Claude Code puede abrir la imagen que acaba de producir y juzgarla, y eso convierte la generación en un ciclo de generar, mirar y corregir. La herramienta Read devuelve los PNG, JPG y formatos similares como contenido visual (referencia de herramientas).
El matiz documentado es que Claude no ve el archivo a resolución completa. Las imágenes grandes se escalan y se recomprimen, y desde la versión 2.1.196 las que siguen pasando de 500 KB tras el escalado se recodifican como JPEG de menor calidad. Para revisar detalle fino, como texto pequeño, bordes o artefactos, la documentación sugiere recortar: pídele a Claude que recorte la zona dudosa y abra solo ese fragmento.
El ciclo rinde de forma distinta según la vía. Con SVG, corregir es editar el código y volver a renderizar, sin coste. Con un modelo de imagen, cada corrección es otra llamada de pago y el resultado no es determinista: limita los intentos en la skill, como en el ejemplo de arriba.
Cuándo cambiar de vía
Cambia cuando el fallo sea de la vía y no del prompt:
- El texto dentro de la imagen sale mal o el diagrama no cuadra tras dos intentos con un modelo: pásalo a SVG. El texto será exacto.
- El SVG queda plano para lo que quieres comunicar: genera la base fotográfica o ilustrada con un modelo y compón el texto encima con código.
- El script devuelve
HTTP 401: la clave es incorrecta o no está en el entorno de la sesión; reiniciaclaudetras exportarla. Si el rechazo se debe a la organización sin verificar, pasa a Gemini o a un cupo diario de Hugging Face o Cloudflare. - El script de Gemini falla con un modelo que funcionaba: comprueba si el ID sigue vigente antes de tocar nada más.
- La imagen de MCP no aparece en el proyecto: está en la carpeta de la sesión. Si ni siquiera se guarda, revisa que tu versión de Claude Code sea la 2.1.283 o posterior.
- Se agota el cupo diario: en Cloudflare las peticiones fallan hasta las 00:00 UTC; en ZeroGPU, hasta 24 horas después del primer uso.
Preguntas frecuentes
¿Claude Code puede generar imágenes?
No directamente. Los modelos de Claude solo entienden imágenes; no las producen. Claude Code obtiene imágenes escribiendo código que se renderiza (SVG, HTML, Python) o llamando a un modelo externo con un script o un servidor MCP. En ambos casos el archivo acaba en tu disco y Claude puede abrirlo para revisarlo.
¿Cómo poner imágenes en Claude Code para que las analice?
Arrastra el archivo a la terminal, pégalo con Ctrl+V (Alt+V en Windows y WSL) o escribe la ruta en tu mensaje. Eso es leer una imagen, no generarla: sirve para que Claude revise una captura, un diseño o el resultado de una generación.
¿Se pueden generar imágenes con Claude Code sin pagar?
Sin modelo de imagen, sí: la vía de SVG no tiene coste aparte de la sesión. Con modelo de imagen, lo verificable son cupos diarios: de 2 a 5 minutos de GPU al día en ZeroGPU de Hugging Face sin plan de pago, y 10.000 Neurons diarios en Cloudflare Workers AI, unas 173 imágenes de 1024×1024 con flux-1-schnell a 4 pasos. Los modelos de imagen de Gemini no tienen nivel gratuito y OpenAI cobra por tokens.
¿Qué es más barato, la API de Gemini o GPT Image?
Con Gemini lo sabes antes de llamar: USD 0,0336 por imagen a 1K con gemini-3.1-flash-lite-image y USD 0,067 con gemini-3.1-flash-image. Con GPT Image 2.5 depende de los tokens de cada imagen, a USD 30 por millón de tokens de salida, y OpenAI no publica una cifra fija. Genera una imagen con tu tamaño y calidad habituales, lee usage y compara con esos números.
¿Hace falta un servidor MCP o basta con un script?
Basta con un script. Te da una ruta de salida elegida por ti, parámetros fijados en el código y algo que el equipo puede revisar en el repositorio. El servidor MCP compensa cuando quieres probar muchos modelos sin escribir nada, a cambio de que la imagen quede en la carpeta de la sesión y de vigilar cómo se guarda la clave.
¿Y generar imágenes a través de Codex CLI con una suscripción de ChatGPT?
Es un método que circula en vídeos y foros, pero la documentación de Claude Code no lo describe, de modo que falta una referencia oficial con la que contrastar cómo funciona y en qué condiciones se permite. Las vías respaldadas por documentación de primera mano son las tres anteriores: código, script contra una API y servidor MCP.