Qwen4-Max 和 Claude Opus 5.5 对比:实测省七成,等待约 4 倍
同一批 12 道短题,Qwen4-Max 花费约为 Opus 5.5 medium 的 29%,等待约 4 倍;AA 长难题上它每任务反而更贵,能等的短活再换。
文章目录
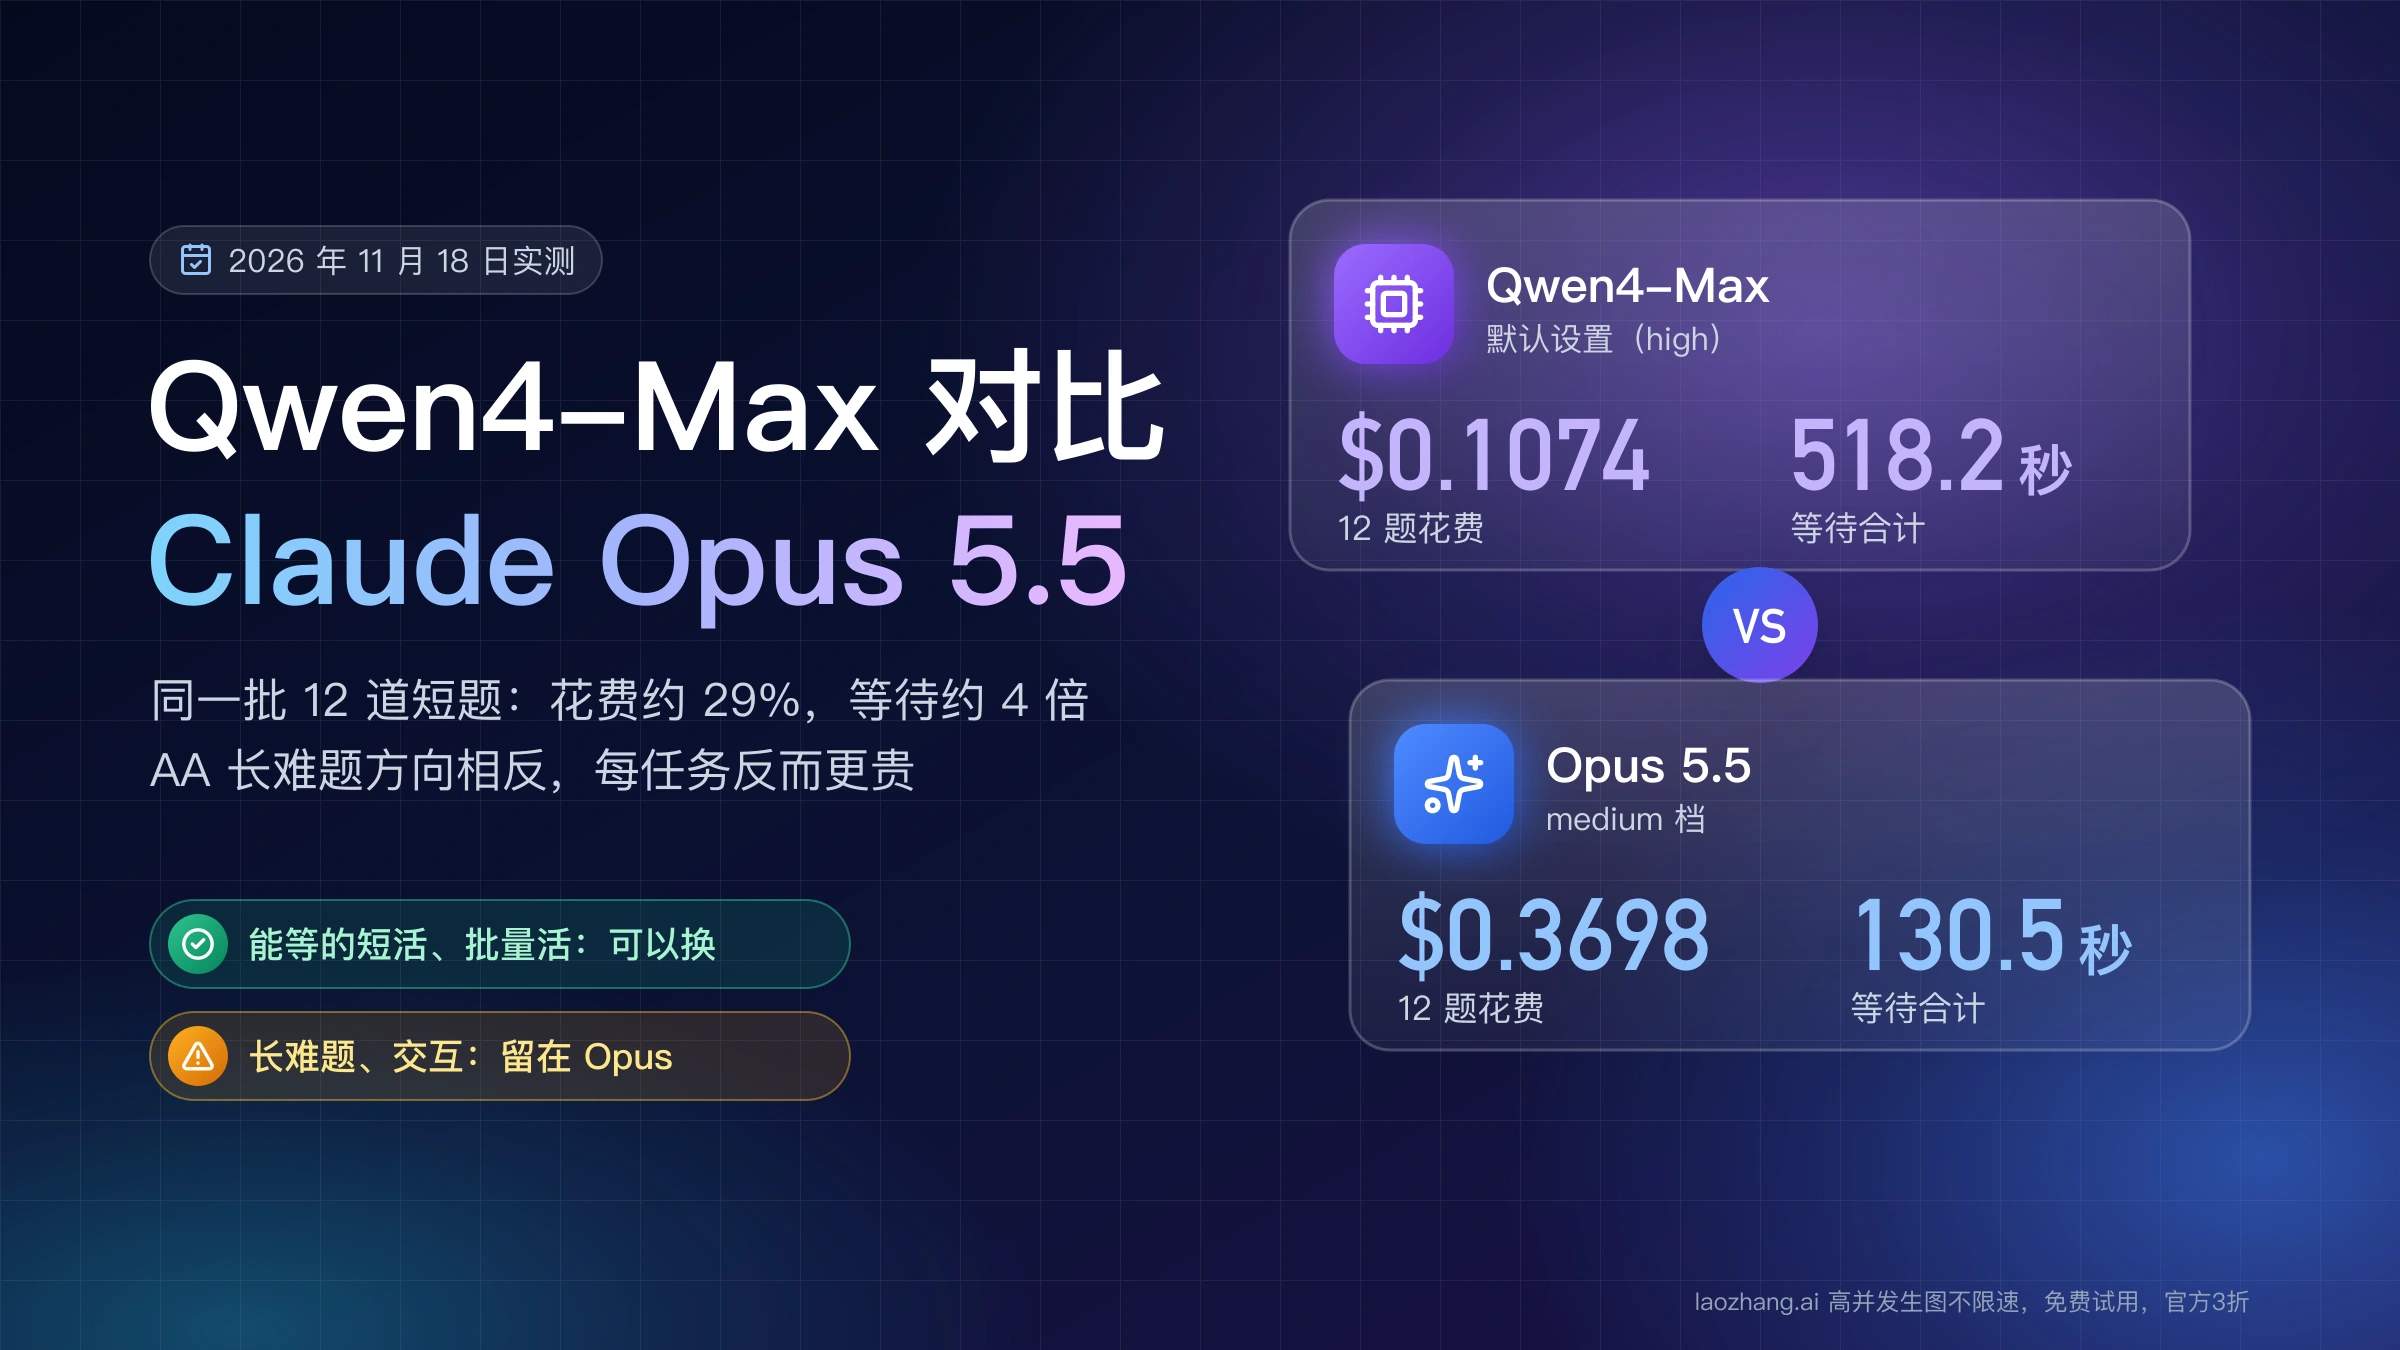
阿里在 2026 年 11 月 16 日正式发布 Qwen4-Max(API 模型 ID qwen4-max),国际版标价每百万 token 输入 $1.50、输出 $4.50,Claude Opus 5.5 是 $4 和 $20。2026 年 11 月 18 日,同一批 12 道短的单轮题,Qwen4-Max 默认设置和 Opus 5.5 medium 全部答对,Qwen 的花费约为 Opus 的 29%,省下约七成,但 12 次调用的等待时间加起来是 Opus 的约 4 倍。换到 Artificial Analysis(以下简称 AA)的长难题套件上,方向反过来:截至 11 月 18 日,Qwen4-Max 每任务 $3.27、平均 32.3 分钟、智能指数 43 分,Opus 5.5 medium 是 $2.45、6.9 分钟、48 分。
所以可以换,但只换一部分。短的单次请求、大量的抽取和改写、长日志统计这类能接受每条等几十秒到几分钟的后台活,可以改调 qwen4-max,并用 thinking_budget 或 enable_thinking: false 给它的思考封顶;对等待敏感的交互、长而难的推理和多步 Agent 任务,继续用 claude-opus-5-5,从 medium 档起步。两个模型一起用、按活分流,比整体替换更稳。
有两种情况会直接替你做决定。输入里有视频,只能选 Qwen4-Max,Opus 5.5 只收文本和图片;团队在中国内地、没有可用的 Claude 官方入口,Qwen4-Max 是现成的官方选择。另外,11 月 6 日到 10 日“千问 Qwen4 首超 Opus 5.5”“成本暴降 85%”的新闻,说的是发布前的 Qwen4-Flash 预览版,不是这里比较的正式版 Qwen4-Max。
哪些活可以换给 Qwen4-Max:看任务长短和能不能等
Qwen4-Max 省钱的前提是任务短、思考量有上限、调用方能等;任务一旦变长变难,它默认开启的思考会把单价差吃掉,等待也会拉长到分钟级。下表的依据来自 2026 年 11 月 18 日的同题实测和截至同日的 AA 智能指数 v5.0.1,各项依据在后面几节展开。
| 你的活 | 先用 | 依据,以及什么时候换 |
|---|---|---|
| 短的单次请求:抽取、改写、小函数、算术和格式化,量大 | qwen4-max,设 thinking_budget | 12 道短题花费约为 Opus medium 的 29%;如果每条要在十几秒内返回,就留在 Opus |
| 长输入、短输出:日志统计、长文档摘要 | qwen4-max,前提是能等几分钟 | 146 KB 日志两边全对,Qwen 花费 0.40 倍、等待 6.1 倍 |
| 长而难的推理、多步 Agent、终端和代码任务 | claude-opus-5-5 medium,不够再 high | Opus 更快,AA 分数高 5 分;花费不一定更省,AA 套件上 Qwen 每任务更贵,一项第三方编程代理测试里 Qwen 便宜约三分之一 |
| 对等待敏感的交互:客服对话、编辑器里来回改 | claude-opus-5-5 | AA 测得 Qwen 首个回答 token 要 148.6 秒,实测单题平均约 43 秒对 11 秒 |
| 业务流程自动化类 Agent | 两个都在自己的任务上试 | Qwen 在 AA 的 AutomationBench-AA 上 72.6%,高于 Opus 5.5 全部五档 |
| 输入里有视频 | qwen4-max | Opus 5.5 不收视频 |
如果你嫌 Opus 贵、又不想离开 Claude,先比较同家的 Sonnet 5.5,见Sonnet 5.5 和 Opus 5.5 怎么选:半价未必更省。另一款国产旗舰 Kimi 对 Opus 的情况相似,单价便宜、按任务未必省,见Kimi K3.1 Pro 对比 Claude Opus 5.5:token 半价,按任务未必省。
同一批题实测:都答对,Qwen4-Max 花费约 29%,等待约 4 倍
2026 年 11 月 18 日,经 laozhang.ai 的 API 网关用同一个 key 调用 qwen4-max,跑了 12 道带隐藏测试或标准答案的单轮题,Qwen4-Max 默认设置(不传 reasoning_effort,按阿里云文档即 high)和 low 都是 12 题全对,Opus 5.5 的 medium 和 high 也全对。题目包括应用题、区间合并、时长解析、词频统计、一篇约 1.1 万 token 文档的五点摘要、表达式求值、CSV 行拆分、语义化版本比较和范围匹配等。Opus 的数据沿用同一批题、同一套评分在 11 月 11 日和 11 月 18 日跑出的结果,和GPT-6.2 Sol 和 6.1 Sol 区别:同价实测快 4 倍,Opus 5.5 还值不值里的 Opus 数字是同一批。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
12 道短题:Opus medium 花费是 Qwen 默认的 3.44 倍
花费按各家标价和接口返回的 token 用量计算,Qwen 用国际版价格(思考 token 按输出计费),Opus 用 $4 / $20。耗时是经网关的整次调用时间,包含排队和网络,不等于厂商自己公布的延迟。
| 配置 | 通过 | 输出 token(含思考) | 其中思考 | 12 次调用耗时合计 | 按标价花费 |
|---|---|---|---|---|---|
| Qwen4-Max 默认(high) | 12/12 | 15,915 | 10,465 | 518.2 秒 | $0.1074 |
Qwen4-Max low | 12/12 | 16,924 | 11,237 | 567.3 秒 | $0.1119 |
| Opus 5.5 medium | 12/12 | 11,833 | 接口未单列 | 130.5 秒 | $0.3698 |
| Opus 5.5 high | 12/12 | 13,674 | 接口未单列 | 159.3 秒 | $0.4067 |
$0.3698 ÷ $0.1074 = 3.44,Opus medium 的花费是 Qwen 默认的 3.44 倍,反过来说 Qwen 约为 Opus 的 29%;对 Opus high 是 3.79 倍。Qwen 的输出 token 比 Opus medium 多约 35%,其中三分之二是思考,但输出单价只有 Opus 的 22.5%,多出来的 token 远不足以抵消单价差。等待则相反:518.2 秒对 130.5 秒,约 4 倍,折合每题平均约 43 秒对 11 秒;Qwen 的 518.2 秒里有 443.5 秒(约 86%)花在出第一个回答 token 之前,也就是先思考的时间。low 在这批题上没有省下任何东西,花费、token 和耗时反而略高。
这组结果有明确的边界。每个格子只跑了 1 次;12 道题都短而规范,四个配置全部通过,所以它比出来的是花费、token 和等待,不能说明谁更聪明。Qwen 的请求走的是中国内地的上游渠道;Opus 有 4 道题(两道版本号题、笔记算术题和标准库题)和 Qwen 同在 11 月 18 日跑,其余 8 道是 11 月 11 日跑的,所以耗时差里有一部分来自线路和日期,不全是模型本身。按 laozhang.ai 接入 qwen4-max 时的平台报价(每百万 token 约 $1.43 / $4.29)计算,Qwen 默认这一行是 $0.1022。
146 KB 日志统计:两边全对,Qwen 花费 0.40 倍、等待 6.1 倍
第二个测试是一份 1,500 行、146 KB 的日志,要求算出 7 个精确数字,输入约 7.6 万 token。Qwen4-Max 在 11 月 18 日跑,Opus 5.5 在 11 月 11 日跑,四个配置 7 个数字全对。Qwen4-Max 默认输入 76,037 token、输出 16,767 token,用了 352.5 秒,按标价 $0.1895;low 输出 21,158 token,用了 364.1 秒,$0.2093。Opus 5.5 medium 输入 78,537 token、输出 7,699 token,57.6 秒,$0.4681;high 输出 8,136 token,59.0 秒,$0.4769。
长输入让输入单价差的作用变大,Qwen 默认的花费仍只有 Opus medium 的 0.40 倍;但它的输出 token 是 Opus 的 2.2 倍,等了将近 6 分钟,Opus 不到 1 分钟,等待相差 6.1 倍。low 又一次比默认多用了 token。7.6 万 token 离两边 100 万的上下文都很远,所以这组结果说明不了几十万 token 级别的超长输入。
token 更便宜,为什么 AA 算出 Qwen4-Max 每任务更贵
每百万 token 的单价差和每件事的花费差是两回事,中间隔着“这件事用了多少 token”。Qwen4-Max 默认开思考,思考 token 按输出价计费;任务越长越难,它想得越多。截至 2026 年 11 月 18 日,AA 的模型页给它的评语是每任务明显偏慢、非常啰嗦:跑完智能指数一共生成了 1.27 亿 token,可比模型的中位数是 6,510 万。
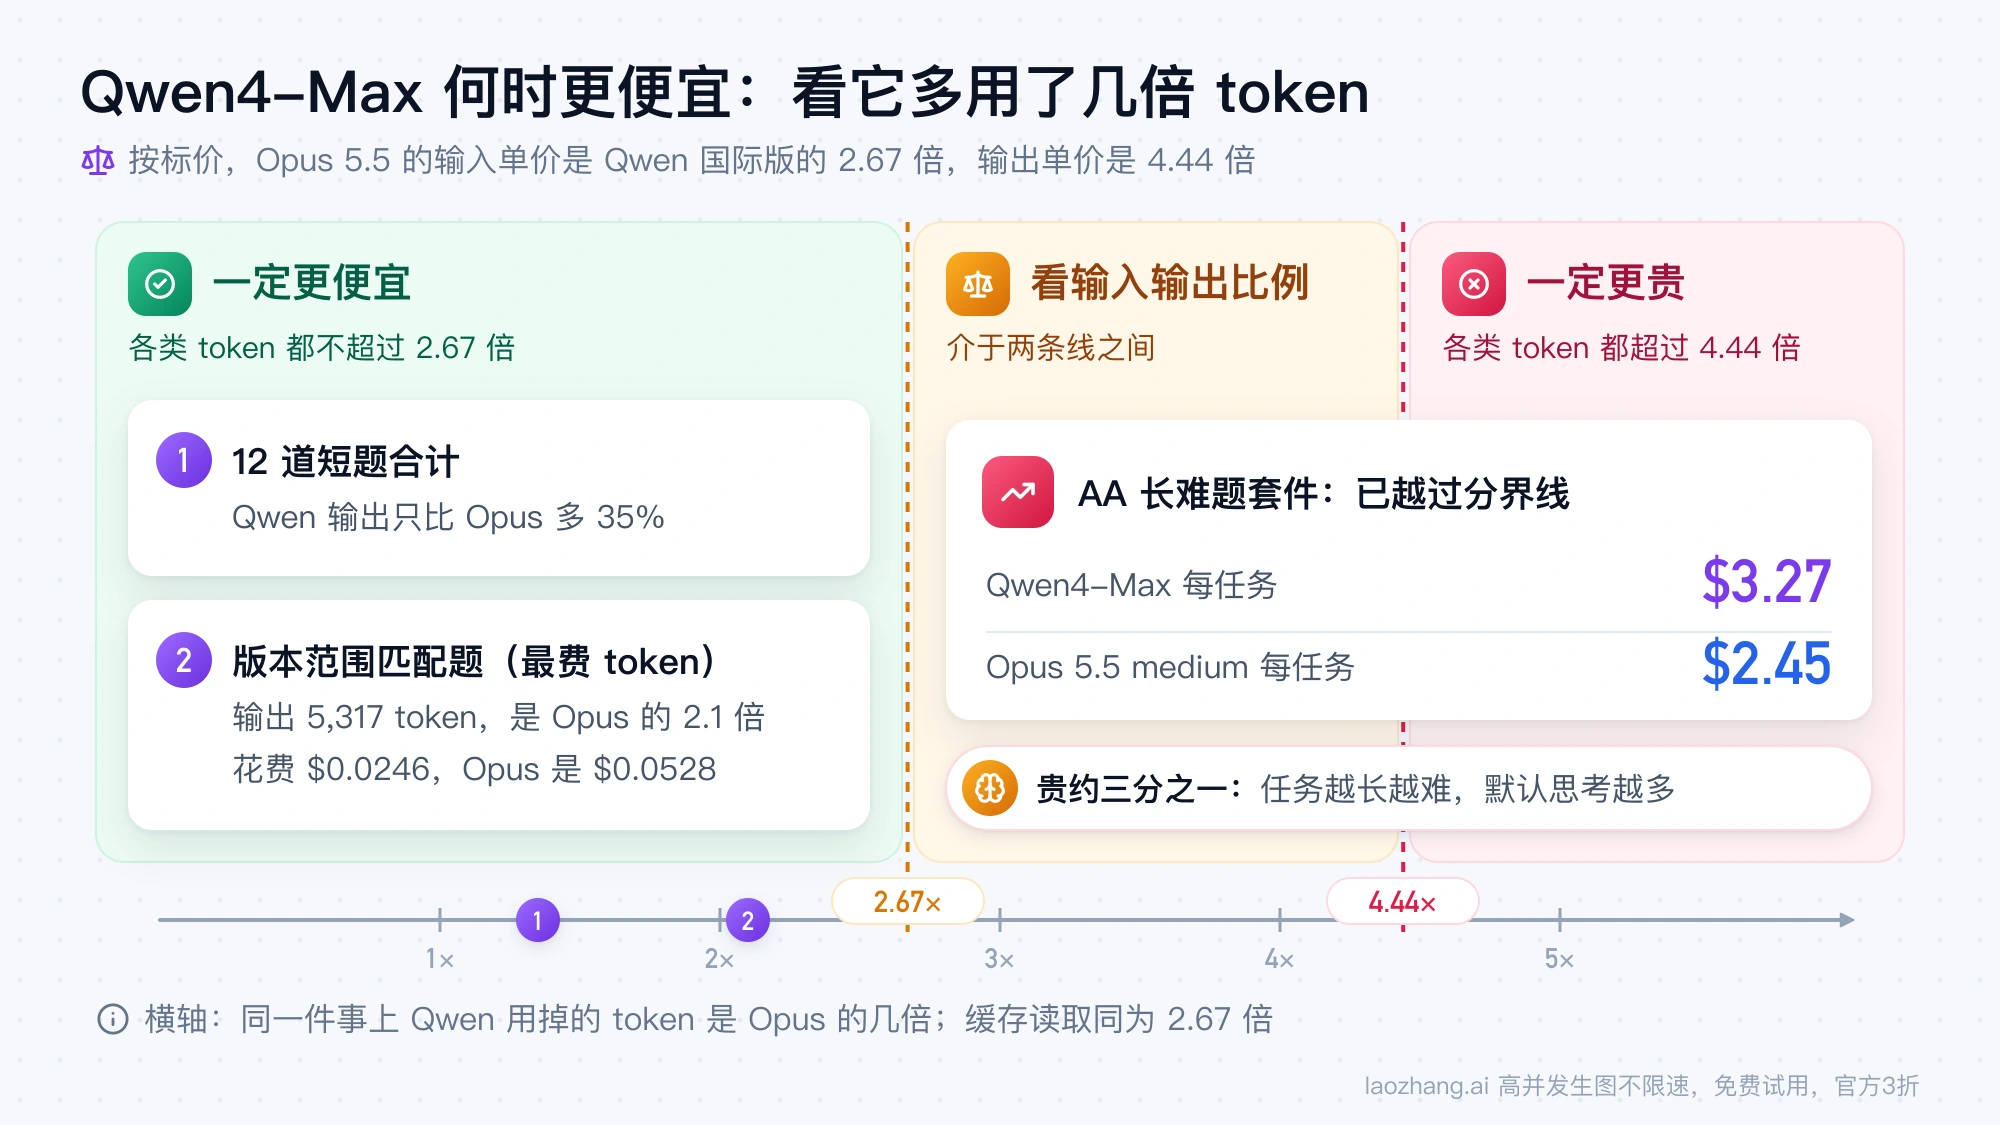
可以用单价算出分界线。Opus 5.5 的输入价是 Qwen 国际版的 2.67 倍($4 ÷ $1.50),输出价是 4.44 倍($20 ÷ $4.50),缓存读取是 2.67 倍($0.20 ÷ $0.075)。所以同一件事上,Qwen 用掉的各类 token 都不超过 Opus 的 2.67 倍时一定更便宜,都超过 4.44 倍时一定更贵,中间看输入和输出的比例。12 道短题里 Qwen 的输出只比 Opus 多 35%,离分界线很远;单看其中最费 token 的版本范围匹配题,Qwen 输出 5,317 个 token、是 Opus medium 的 2.1 倍,花费 $0.0246 仍不到 Opus 的 $0.0528 的一半。AA 套件里多是长而难的多步任务,Qwen 每任务 $3.27,比 Opus medium 的 $2.45 高出约三分之一,说明在 AA 这套题上它多用的 token 已经越过了分界线。
长而难的任务也不总是 Opus 更省。atomicagent.io 的 Qwen 4 Max 与 Opus 5.5 编程代理对比用自家的 Atomic Agent 0.7.0 经 OpenRouter 跑了一项多步编程任务:修好一个约 1,400 行 Python 库里埋的 13 个 bug 并补一个功能,用 59 个隐藏测试验收,Opus 5.5 在 2026 年 11 月 9 日、Qwen4-Max 在 11 月 16 日各档跑 3 次,全部通过。Qwen4-Max high 每任务约 $0.65、25 分钟,Opus 5.5 medium 约 $0.97、4.2 分钟,Qwen 便宜约三分之一,但慢约 6 倍。作者认为一个原因是阿里侧的隐式缓存:Qwen 每次运行约有 270 万输入 token 按缓存价读取,不算缓存的话光输入就超过 $4。这只是一项任务,作者也提醒它说明不了哪个模型更聪明;和 AA 放在一起看,Qwen 按任务省不省钱取决于任务形态和缓存命中,AA 套件上更贵,不等于所有 Agent 任务都更贵,但两项测试里 Opus 都快得多。
下表是 AA 智能指数 v5.0.1 的数字,截至 2026 年 11 月 18 日,来自 Artificial Analysis 的 Qwen4 Max 与 Claude Opus 5.5 对比页。“每任务花费”是 AA 用自己的题目和设置跑出来的加权平均,不能和上一节的实测花费相加或相除。
| 模型与档位 | 智能指数 | 每任务花费 | 每任务耗时 | 输出速度 |
|---|---|---|---|---|
| Qwen4-Max | 43 | $3.27 | 32.3 分钟 | 54 token/秒 |
| Opus 5.5 low | 35 | $0.98 | 3.0 分钟 | 105 token/秒 |
| Opus 5.5 medium | 48 | $2.45 | 6.9 分钟 | 106 token/秒 |
| Opus 5.5 high | 52 | $3.46 | 9.3 分钟 | 108 token/秒 |
| Opus 5.5 xhigh | 57 | $6.05 | 15.8 分钟 | 109 token/秒 |
| Opus 5.5 max | 59 | $10.04 | 24.6 分钟 | 117 token/秒 |
读这张表有三点。第一,Opus medium 比 Qwen4-Max 高 5 分,每任务花费是它的 75%,耗时约为五分之一。第二,Qwen 的分数落在 Opus low 和 medium 之间,比 low 高 8 分,但 Opus low 每任务只要 $0.98。第三,AA 只列了一个 Qwen4-Max 条目,没有写用的是哪一档思考强度,API 默认是 high。这些数字是 Qwen4-Max 发布第 2 天的结果,AA 之后可能重算。
两边的档位不是同一把尺子。Qwen4-Max 的思考强度只有 low、high、xhigh 三档,默认 high,传 medium 会被映射成 high;Opus 5.5 有 low、medium、high、xhigh、max 五档。实测里拿 Qwen 默认去对 Opus medium,是按“各自常用的起点”配对,不代表两者同档。
跑分各自强在哪:Qwen4-Max 赢在自动化流程,科研难题和代码落后
在 AA 的分项上,Qwen4-Max 的长处集中在业务流程类任务:AutomationBench-AA 拿到 72.6%,比 Opus 5.5 的 max 档还高,是两款模型全部六个配置里最高的;AA-Briefcase 也高过 Opus medium。弱项是科研级难题、代码和知识可靠性,HLE-Diamond、CritPt、Terminal-Bench-Science、FrontierCode 和 AA-Omniscience 都明显落后于 Opus medium。下表截至 2026 年 11 月 18 日,同样来自上面的 AA 对比页。
| AA 分项 | Qwen4-Max | Opus 5.5 medium | Opus 5.5 max |
|---|---|---|---|
| AutomationBench-AA | 72.6% | 61.2% | 69.5% |
| AA-Briefcase | 1686 | 1617 | 1800 |
| GDP.pdf | 26.2% | 25.6% | 26.2% |
| Terminal-Bench 4.0 | 48.5% | 52.5% | 59.6% |
| FrontierCode-AA 2.0 | 26.5% | 33.1% | 46.4% |
| AA-Omniscience | 28 | 40 | 48 |
| HLE-Diamond | 44.9% | 51.4% | 67.9% |
| CritPt v2 | 43.0% | 54.0% | 68.0% |
| Terminal-Bench-Science | 23.3% | 43.3% | 59.0% |
按行业领域的分指数看,两者和 Opus medium 相差不大:Qwen4-Max 在金融(54 对 51)、策略与运营(57 对 56)上略高,法律持平(50 对 50),医疗(48 对 51)、工程(50 对 54)、经济(51 对 53)略低。如果你的活主要是文档处理和流程自动化,Qwen4-Max 值得放进候选;如果是终端里的长链路编程或需要靠模型自身知识回答事实问题,Opus 5.5 的优势在 AA 上是成片的。
阿里自己公布的数字要单独看。据发布时的报道,阿里称 Qwen4-Max 在 DeepSWE v1.1 上得到 75.7,是包括 Claude Opus 5.5 在内的对比模型里最高的,同一份对比里 Terminal-Bench 4.0 是 48.5,落后于 Opus 5.5 的 59.6;阿里还称,在自家的 Work360 评测里,它的平均任务成本比上一代 Qwen3.8-Max 低 62%。这个 62% 比的是阿里自己的上一代,不是 Opus。
“千问 Qwen4 首超 Opus 5.5”“成本降 85%”说的是哪个模型
说的是发布前的 Qwen4-Flash 预览版,不是正式版 Qwen4-Max。2026 年 11 月 6 日到 10 日的多篇中文报道,引用的是一个叫 Qwen-4-Flash-Early 的早期版本:它在一项游戏创意基准上得到 49.9 分,Opus 5.5 的 XHigh 档是 47.2 分;同一批报道里的成本对比是 Qwen4-Flash 每任务 $0.4、Opus 5.5 $2.6,Qwen4-27B 是 $0.16。“成本暴降 85%”就是 $0.4 对 $2.6 算出来的。Flash 和 27B 是 Qwen4 家族里更小的型号,这些数字不能套到 Qwen4-Max 上。
社区里关于 Qwen4-Max 的“便宜 3 倍”“便宜 11 倍”也要看口径。X 上一条中文帖说,在一个生成任务上 Qwen 4 Max 花了 $6.53、Opus 5.5 花了 $72.28,约 11 倍;海外视频标题里常见的“便宜 3 倍”,多是按 token 单价或单个任务算的。这和上面 12 道短题约 3.4 倍的结果方向一致,但和 AA 长难题套件的方向相反,差别就在任务长短和思考量。Facebook 上流传的“少用 50% token”和 AA 测到的“非常啰嗦”也对不上,后者有公开的方法说明。
Qwen4-Max 和 Opus 5.5 的 API 价格:输出单价差 4.44 倍
截至 2026 年 11 月 18 日,按阿里云百炼 Qwen4-Max 模型文档和Claude API 定价文档,两者的标价如下,单位是美元 / 每百万 token。Qwen4-Max 在 100 万 token 以内思考和不思考同价,思考 token 计入输出;Opus 5.5 的思考 token 同样按输出计费。
| 计价项 | Qwen4-Max 国际版(新加坡) | Qwen4-Max 北京地域,香港、东京等同价 | Claude Opus 5.5 |
|---|---|---|---|
| 输入 | $1.50 | $1.413 | $4 |
| 输出(含思考) | $4.50 | $4.24 | $20 |
| 缓存读取 | $0.075 | 未单列 | $0.20 |
| 批量:输入 / 输出 | 不支持 | 仅北京:$0.707 / $2.12 | $2 / $10 |
批量推理只在中国内地(北京)地域开放,新加坡、香港、法兰克福、弗吉尼亚和东京都不支持,所以国际版账号没有批量选项;北京的批量价 $0.707 / $2.12 是在 $1.413 / $4.24 基础上限时 5 折。显式缓存和隐式缓存所有地域都支持,表里国际版的缓存读取价 $0.075 按 AA 和 OpenRouter 标注的输入价 5% 计算。国际版另有 100 万 token 免费额度,开通后 90 天内有效,只限国际版。北京地域在阿里云中文站按人民币计价,表里的 $1.413 / $4.24 是它的美元口径;laozhang.ai 接入 qwen4-max 用的就是北京地域渠道,按每百万 token 输入 ¥10、输出 ¥30 计,平台报价约 $1.43 / $4.29。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
Opus 5.5 的缓存写入、fast mode 价格和 Claude 订阅里的用量重置,另见Claude Opus 5.5 价格与用量重置:API 账单怎么算,重置卡怎么用。
怎么让 Qwen4-Max 更省更快:用 thinking_budget 或关掉思考,别指望 low
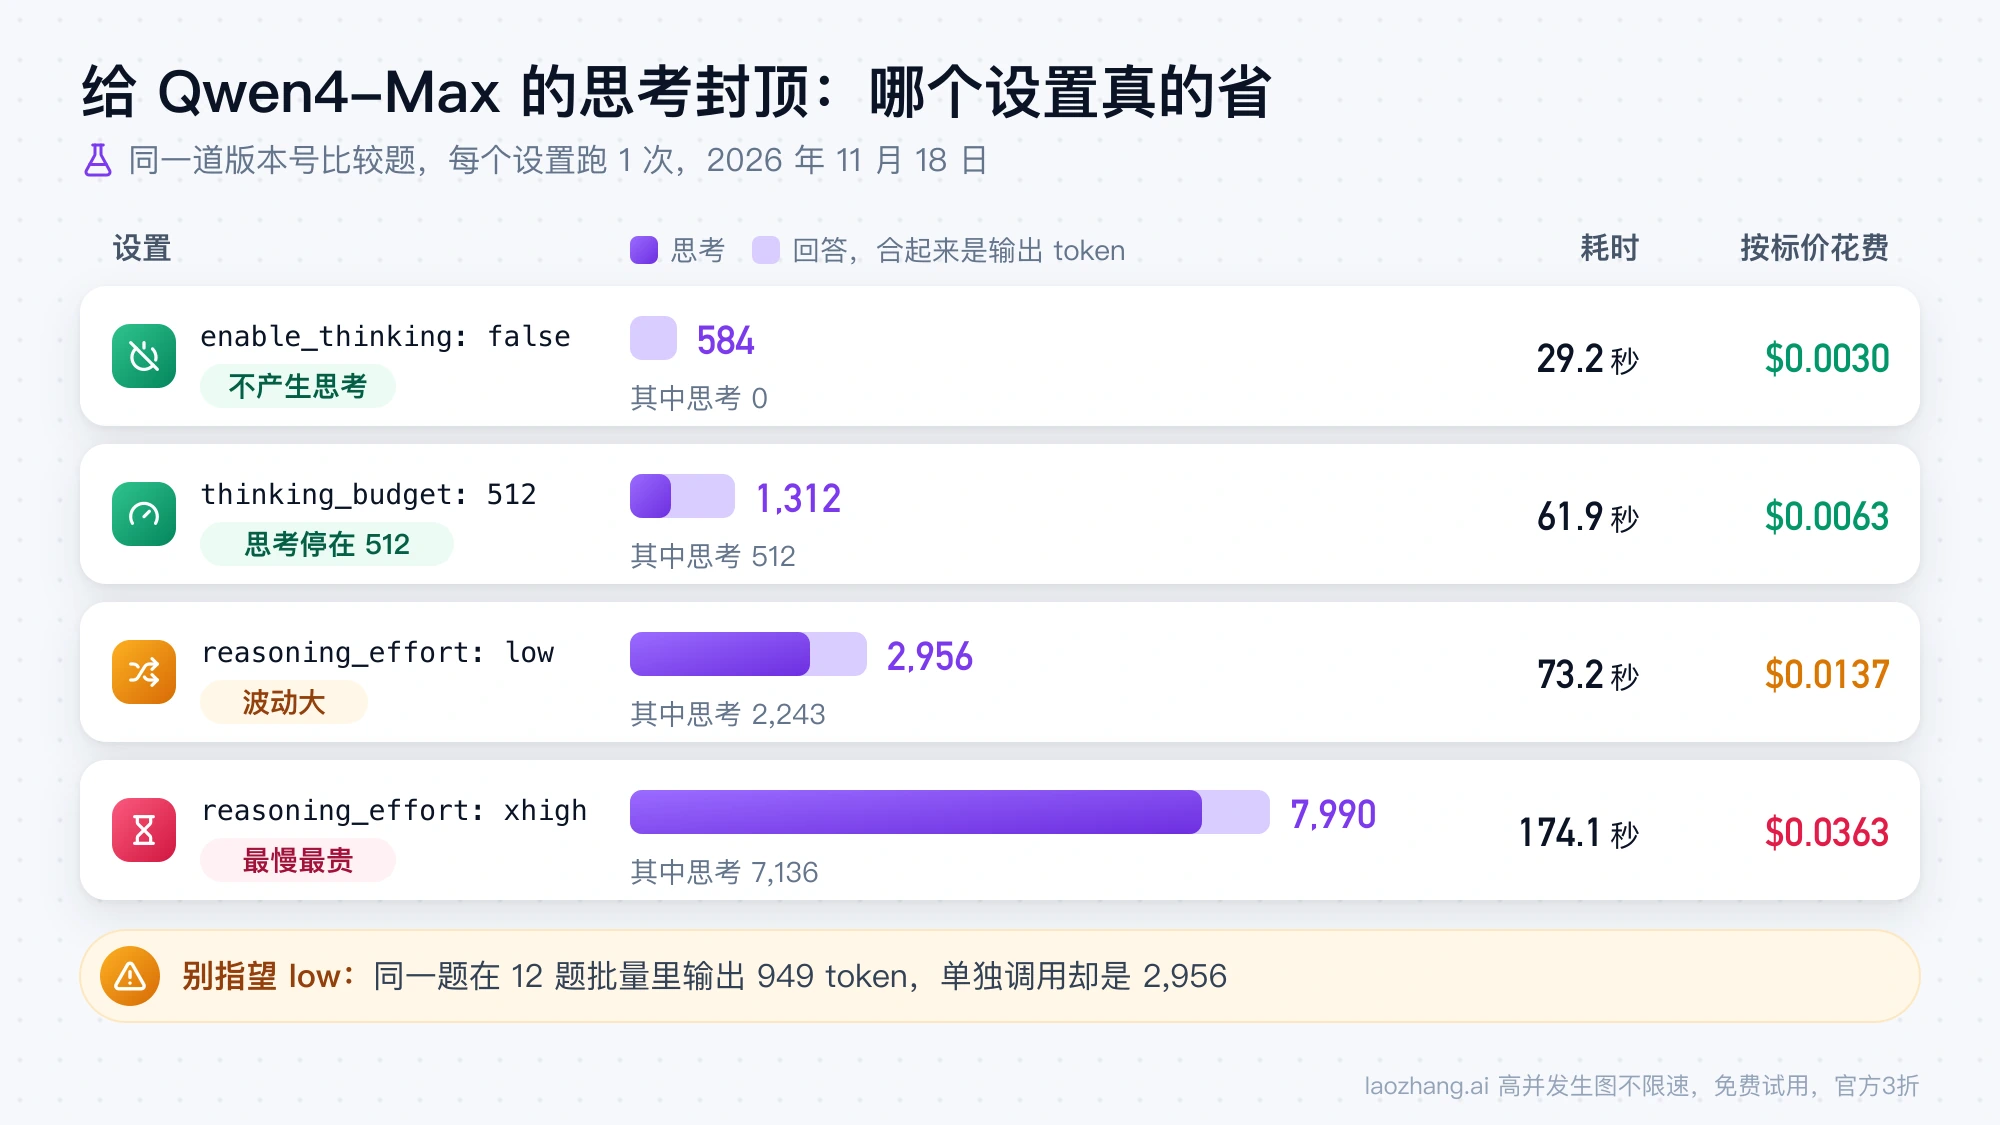
Qwen4-Max 默认 enable_thinking: true、reasoning_effort: high、thinking_budget: 131072,也就是每次请求都先思考,最多可以想 13 万多 token。真正能封顶思考的是 thinking_budget 和 enable_thinking: false 两个参数;low 在实测里没有稳定地减少思考。
2026 年 11 月 18 日,经 laozhang.ai 网关拿版本号比较这道题把几种设置各跑了 1 次。先传一个不存在的 reasoning_effort 值,返回 400 invalid_parameter_error,说明参数确实传到了阿里云的校验层;各设置的结果如下。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 设置 | 输出 token | 其中思考 | 耗时 | 按标价花费 |
|---|---|---|---|---|
enable_thinking: false | 584 | 0 | 29.2 秒 | $0.0030 |
thinking_budget: 512 | 1,312 | 512 | 61.9 秒 | $0.0063 |
reasoning_effort: low | 2,956 | 2,243 | 73.2 秒 | $0.0137 |
reasoning_effort: xhigh | 7,990 | 7,136 | 174.1 秒 | $0.0363 |
thinking_budget: 512 让思考正好停在 512 个 token,关掉思考则完全不产生思考 token,两者都把花费压到了 low 的一半以下。low 的问题是波动大:同一道题在 12 题批量里用 low 只输出 949 个 token,这次单独调用却输出了 2,956 个,比默认档那次的 1,506 个还多。关掉思考后这道题给出了完整答案,但没有评分,也只试了这一道,所以“关思考不影响正确率”还不能下结论;先在自己的任务上抽样对比答案再推开。还要注意,即使关掉思考,这次调用也用了 29.2 秒,等待不会因此降到 Opus 的水平。
在 OpenAI 兼容的 Chat Completions 接口里,这两个参数直接放在请求体顶层,写法和实测时一致,thinking_budget 的数值按任务调。用 OpenAI 官方 Python SDK 时,把它们放进 extra_body:2026 年 11 月 18 日用 SDK 2.24.0 经 laozhang.ai 网关各试了一次,extra_body={"enable_thinking": False} 返回的结果里没有思考 token,extra_body={"thinking_budget": 2048} 也被接受并正常返回,两次答案都对,但都只是一道很短的算术题,只说明参数能传到,不说明答案质量。
{
  "model": "qwen4-max",
  "messages": [{"role": "user", "content": "..."}],
  "thinking_budget": 2048,
  "stream": true,
  "stream_options": {"include_usage": true}
}
不需要推理的抽取、改写、格式转换,可以把 thinking_budget 换成 "enable_thinking": false。思考强度的取值在三种接口里都是 low、high、xhigh:Chat Completions 用 reasoning_effort,Responses 用 reasoning.effort,Anthropic Messages 兼容接口用 output_config.effort;传 minimal 会变成 low,medium 变成 high,max 变成 xhigh。
在哪里能用 Qwen4-Max 和 Opus 5.5
Qwen4-Max 的官方入口是阿里云百炼(国际版叫 Model Studio)的 API,接口兼容 OpenAI 和 Anthropic 两种格式;据发布时的报道,阿里自家的 QwenWork、Qoder 和 Qwen Studio 也接入了它,OpenRouter 上的 ID 是 qwen/qwen4-max。截至 2026 年 11 月 18 日,未登录访问 Qwen Chat(chat.qwen.ai)时,模型列表里只有 Qwen3.7-Plus 和 Qwen3.8-Max,登录后是否能选 Qwen4-Max 还不清楚。
Opus 5.5 可以在 Claude 付费套餐的应用、Claude Code、Claude API,以及 Bedrock、Google Cloud、Microsoft Foundry 上使用。中国内地和香港不在 Anthropic 的支持地区名单里,具体入口见Claude Opus 5.5 怎么用:6 个入口怎么选,免费只有限时限额试用。想在自己的任务上并排比较两者,可以像上面的实测那样,用一个 laozhang.ai 的 API key 分别调用 qwen4-max 和 claude-opus-5-5,只改 model 字段。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
Qwen4-Max 和 Opus 5.5 的其他问题
Qwen4-Max 能本地部署吗,有没有开源?
不能。截至 2026 年 11 月 18 日,Qwen4-Max 是闭源模型,只能通过 API 调用,阿里云文档也写明它不支持微调和自行部署。据发布时的报道,阿里表示之后会开源更小的 Qwen4 模型,但没有给出日期。
Qwen4-Max 的上下文有多长,能读视频吗?
阿里云文档写的上下文长度是 100 万 token,思考模式下单次最多输入 983,616 token、最多输出 262,144 token。输入支持文本、图片和视频,还支持联网搜索、工具调用和结构化输出;Claude Opus 5.5 的上下文同样是 100 万 token,输入只有文本和图片。
Qwen4-Max 和 Qwen4-Max-Preview 是一回事吗?
不是同一个版本。阿里在 2026 年 11 月 11 日先上线了预览版 qwen4-max-preview,11 月 16 日才发布正式版 qwen4-max。11 月 16 日以前的视频和实测,比如“Qwen-4 Max 预览版 vs Claude Opus 5.5”的前端对比,用的都是预览版。
参考来源4
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月18日。
参考来源4
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月18日。
- 1.atomicagent.io 的 Qwen 4 Max 与 Opus 5.5 编程代理对比atomicagent.io/blog/qwen-4-max-vs-opus-5-5
- 2.Artificial Analysis 的 Qwen4 Max 与 Claude Opus 5.5 对比页artificialanalysis.ai/models/comparisons/qwen4-max-vs-claude-opus-5-5
- 3.阿里云百炼 Qwen4-Max 模型文档docs.modelstudio.console.alibabacloud.com/en/model-studio/qwen4-max
- 4.Claude API 定价文档platform.claude.com/docs/en/about-claude/pricing