Nano Banana 2.1 角色一致性实测:衣服发型保得住,异色瞳常丢
2026 年 11 月 3 日 10 次调用实测:每次回到原始参考图,发型和雨衣都认得出;把上一张输出接着喂会越画越走样,异色瞳和疤痕写进提示词也没回来。
文章目录
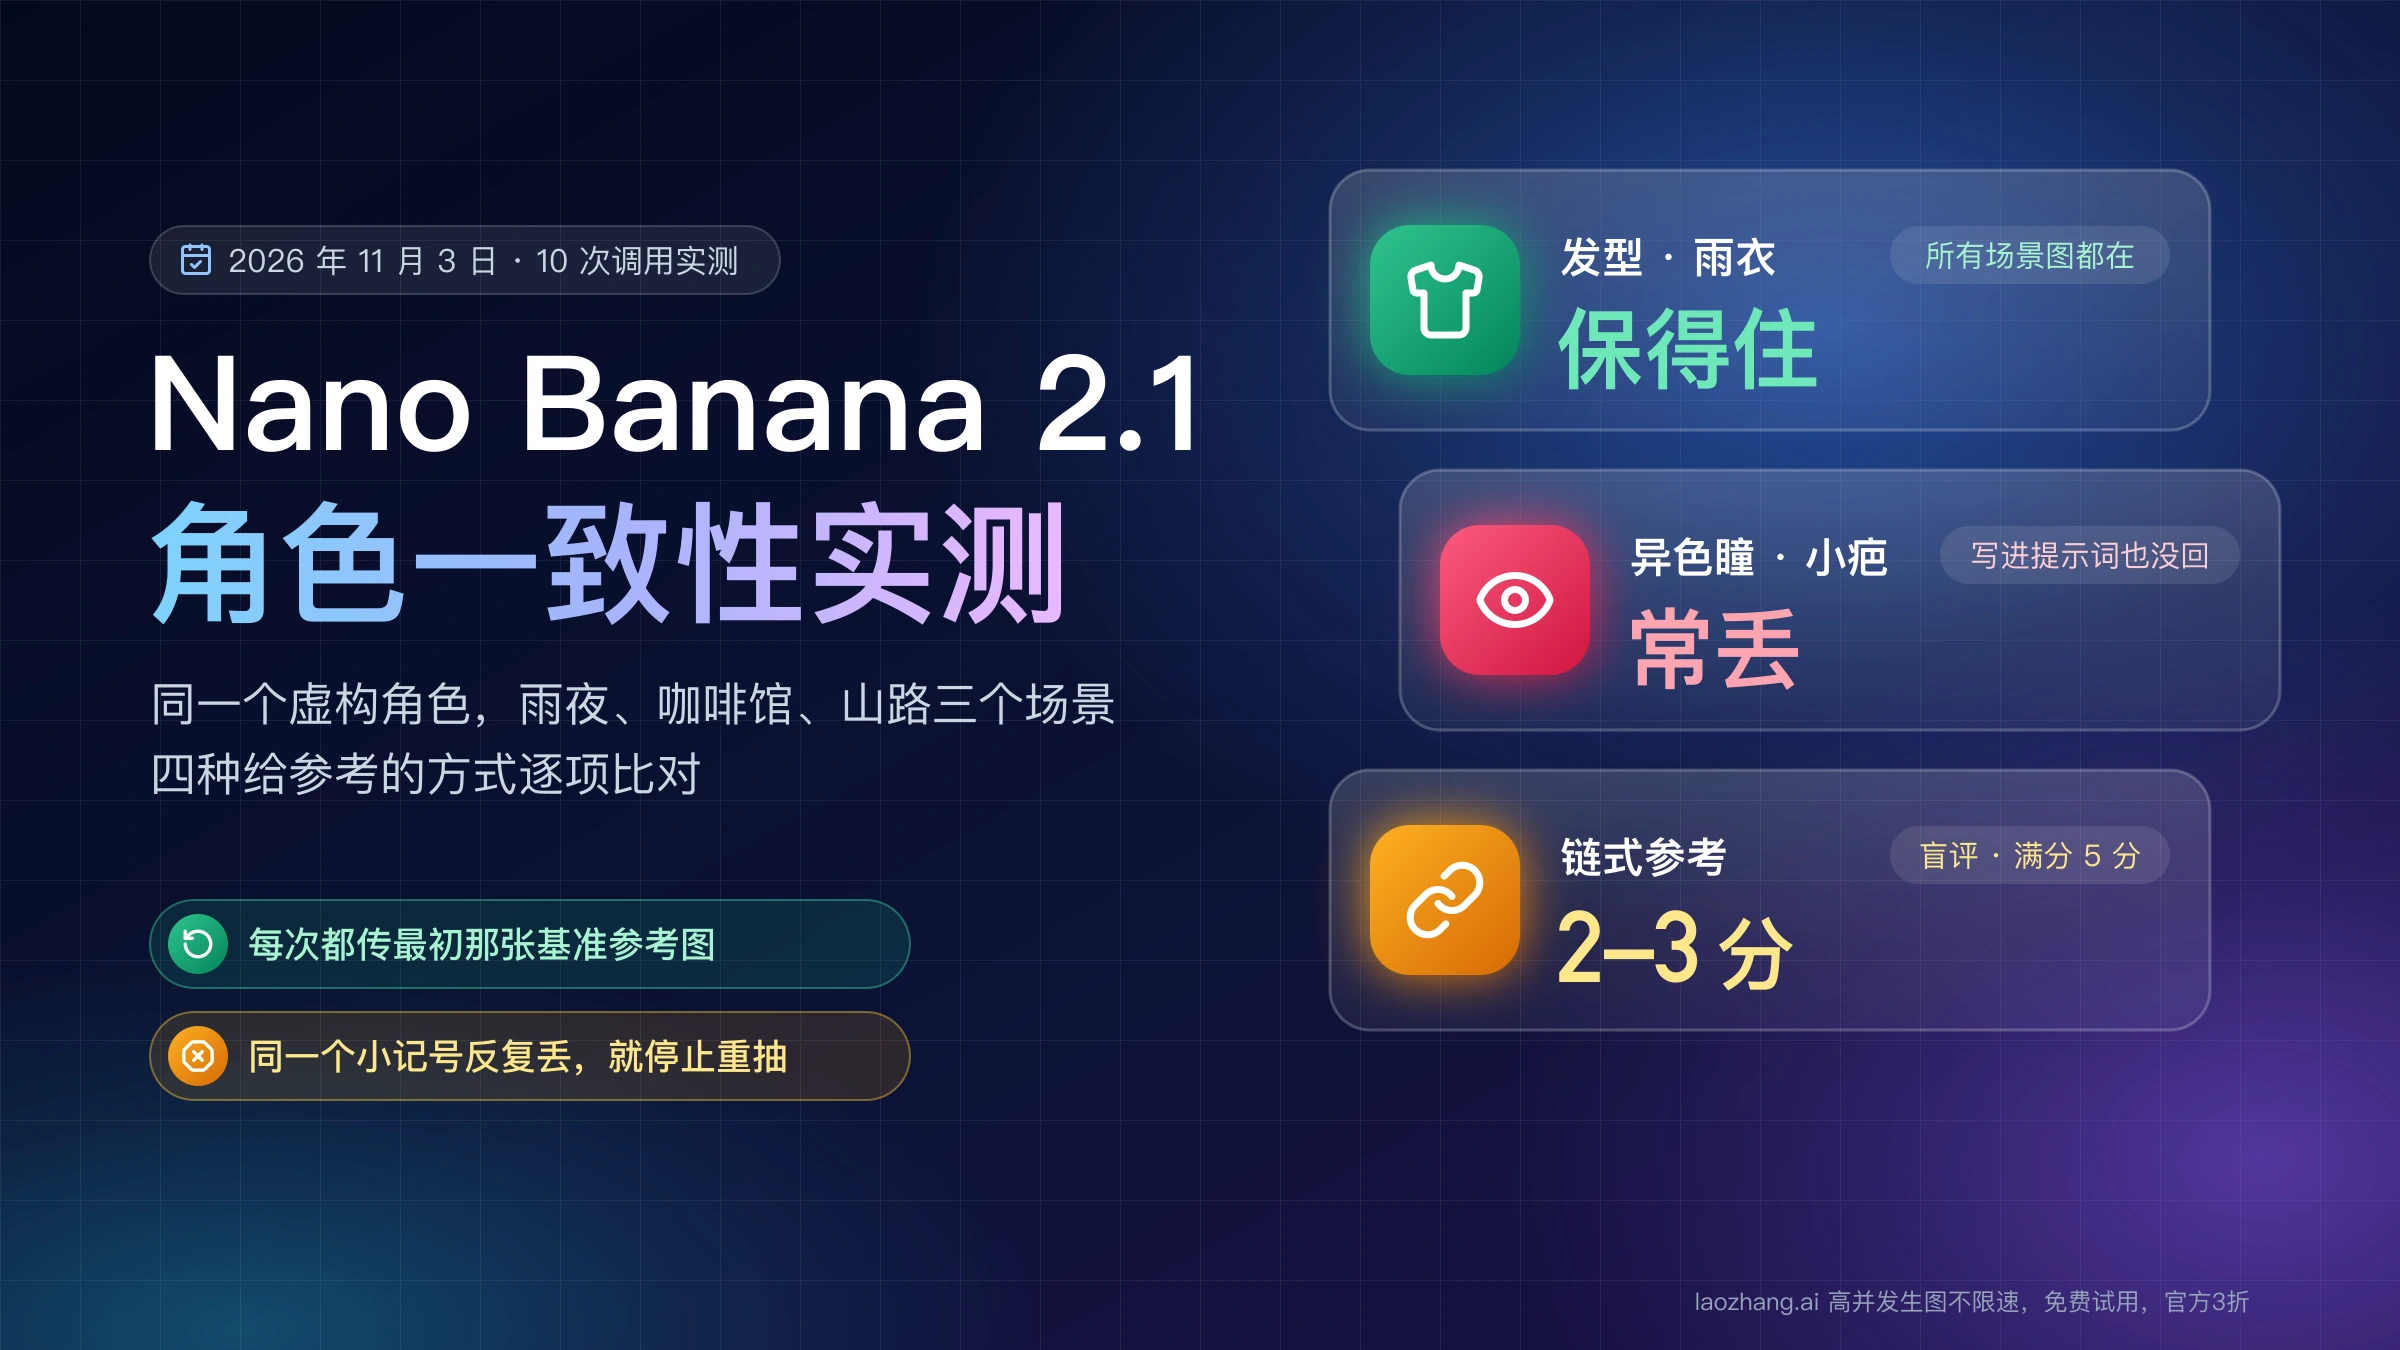
想让 Nano Banana 2.1(gemini-nano-banana-2.1)把同一个角色放进别的场景,关键是每一次都把最初那张基准参考图传进去,不要拿上一张输出接着当参考。2026 年 11 月 3 日,用一个虚构角色在 Gemini API 上跑了 10 次调用:每次回到原图时,银白色不对称波波头和芥末黄雨衣在三个场景里都认得出来;改成链式参考后,围巾从青绿漂成墨绿,其中一张的铜扣变成灰色,两位盲评者给"像同一个人"的打分降到 2–3 分(满分 5 分)。
所以角色的身份要押在发型轮廓和衣服配色这类大而醒目的特征上。异色瞳、颧骨上的星形小疤这种脸上的小记号,在能看清脸的图里多数没有画对,把它们逐项写进提示词,补测的两张图里也没有让它们回来。每张新图出来先按发型、服装、配件、脸部记号逐项核对;同一个小记号反复丢,就别再重抽,改角色设计或者放弃这一项。
这些结论来自一个由文字定义的角色、1K 分辨率、默认思考档位,每种做法每个场景只有一张图。角色如果来自真人照片或手绘稿,就没法像这次一样靠一段文字复现,结论只能部分套用;Gemini 应用和 Flow 里的表现不在这次测试范围内。
2026 年 11 月 3 日的 10 次测试:一个角色、三个场景、四种做法
测试先用一段英文描述生成一张角色基准图,再让同一个角色出现在雨夜街头、咖啡馆和山路日出三个场景里,比较四种给参考的方式:只给原始参考图、把上一张输出当参考(链式)、只用文字描述、原始参考图加属性清单。10 次调用全部返回 HTTP 200,每次都核对了响应里的 modelVersion 确实是 gemini-nano-banana-2.1,单次耗时 15.8–28.2 秒。
调用走的是老张 API(laozhang.ai)转发的 Gemini 原生 generateContent 接口,imageSize 为 1K,不设置思考档位(2.1 的默认档是 medium),输出 JPEG。Google 在 Gemini API 图片生成文档里给 2.1 的示例用的是 Interactions API(client.interactions.create),两条路径不完全一样,所以下面的结果只说明 generateContent 这条路径上的表现,不代表直连 Google 的结果。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
角色是一位二十八九岁的女性,五个识别特征都写在同一段描述里:一边长一边短的银白色波波头、一只琥珀色一只绿色的眼睛、一侧颧骨上的星形小疤、带四颗圆形铜扣的芥末黄雨衣、青绿色针织围巾。下面是实际发送的英文原文:
角色描述(LOOK):
a woman in her late twenties with a short asymmetric silver-white bob that is longer on one side, one amber eye and one green eye, a small star-shaped scar on one cheekbone, a mustard-yellow rain jacket with four round copper buttons and a teal knitted scarf

基准图(1:1,不带参考图):
Character reference photo: {LOOK}. She stands against a plain light-grey studio background, head and upper body fully visible, looking at the camera with a neutral relaxed expression, soft studio light, natural photographic style.

保持句(KEEP):
Use the person in the reference image as the character. Keep her face, hair, eye colours, scar, jacket and scarf identical to the reference.

场景(4:3):
S1  Show her walking along a rainy neon-lit city street at night, seen from a three-quarter side angle, holding a black umbrella.
S2  Close-up, head and shoulders, laughing in a warm cafe with a blurred background.
S3  Full-body shot standing on a mountain trail at sunrise, seen from three-quarter back, turning her head toward the camera.
基准图一次就生成成功:画面左侧那只眼睛是琥珀色、右侧是绿色,星形疤在画面右侧的颧骨上,围巾青绿,铜扣清楚。之后的 9 次调用分成四组。原始参考图组把 KEEP 加场景句、基准图作为唯一参考,跑了 S1、S2、S3 三张;链式组的 S2 用原始参考图组的 S1 输出当参考,S3 再用链式 S2 的输出当参考,共两张;纯文字组只发 LOOK 加场景句、不带任何图,跑 S1 和 S3;参考图加属性清单组在 KEEP 后面追加一句 Keep these identifying details exactly as in the reference: {LOOK}.,再加场景句和基准图,跑 S1 和 S3,这一组是第一轮评分之后补测的。
评分由两位盲评者完成,两者都是全新上下文的 AI 模型评审,只看到基准图和打乱顺序、重新命名的场景图,不知道每张图是怎么生成的。评分表逐项记录发型、眼睛、疤痕、围巾、雨衣和铜扣是否保住,再给"像同一个人"打 1–5 分:5 分是一眼就是同一个人,3 分像亲戚,1 分是另一个人。这是按评分表做的视觉判断,不是人脸识别的相似度分数。前三种做法的 7 张图两位都评了,补测的参考图加属性清单两张只有第二位评过。9 张场景图里有 4–5 张脸太小或侧向一边,眼睛和疤痕根本没法判断,主要是山路全身照和打伞的侧面街景。
用量方面,纯文字请求的输入是 84–98 个 token,带一张参考图后升到 1,169–1,246 个,一张参考图大约增加 1,080–1,090 个输入 token;每张图的输出是 1,259–1,544 个 token。10 次里只有补测的山路那一次报告了思考 token(194 个),其余都没有。老张 API 的 2.1 文档标价每次调用 $0.045,与参考图数量无关,按这个标价,10 次调用合计 0.45 美元。
四种做法各保住了什么:发型和雨衣稳,眼睛和疤痕不稳
四种做法里,链式参考最差,只给原始参考图居中,纯文字描述的打分反而最高,但纯文字的高分有一个混淆,下面单独说明。所有场景图里,银白波波头和芥末黄雨衣都还在;真正拉开差距的是围巾颜色、铜扣,以及脸上的两个小记号。
| 做法(场景) | 发型 | 异色瞳 | 星形疤 | 青绿围巾 | 雨衣与铜扣 | 像同一个人 |
|---|---|---|---|---|---|---|
| 只给原始参考图(S1、S2、S3) | 保住,夜景 S1 发色偏薰衣草 | 唯一能看清的近景 S2 两眼都成深棕 | S2 似有似无,S1 没看到,S3 看不到 | 近景 S2 保住,S1、S3 偏暗偏绿 | 黄色保住,近景铜扣保住,远景看不到扣子 | 3、4、3 |
| 链式:上一张输出当参考(S2、S3) | S2 偏薰衣草,S3 变得更蓬 | S2 两眼同色,S3 看不到 | S2 没有 | 两张都漂成墨绿 | 黄色保住,S2 铜扣变灰色金属 | S2:2、2;S3:3、2 |
| 只用文字描述(S1、S3) | 保住 | S1 保住,S3 两眼同为榛色 | 两张都有,但在参考图疤痕的另一侧脸颊 | 两张都保住 | 铜扣保住,S3 画了约 7 颗扣子 | 4、4 |
| 原始参考图 + 属性清单(S1、S3) | S1 保住,S3 变短变齐 | S1 两眼同为榛色,S3 看不到 | S1 没有 | S1 保住,S3 偏暗偏绿 | 黄色保住,S1 铜扣保住 | S1:4;S3:3(一位评分) |
只给原始参考图时,参考图带过去的是发型、雨衣,以及近景里的围巾颜色。"异色瞳丢了"的判断只来自咖啡馆近景这一张,它也是这一组唯一能看清眼睛的图:两只眼睛都画成了深棕色,疤痕在两位盲评者那里一个判"不清楚"、一个判"有,但很淡"。雨夜侧面和山路背影两张里,围巾都偏暗偏绿,脸太小,眼睛和疤痕无法核对,所以不能说远景里这些特征丢了,只能说看不出来。
纯文字描述得分最高,但这不说明文字比参考图更好用。基准图本身就是用这段文字生成的,纯文字组等于让模型再画一次它对同一段文字的默认长相,所以脸型、围巾和铜扣自然接近。疤痕的位置也要这样理解:描述里只写了 "on one cheekbone",没有指定哪一侧,参考图把疤痕放在画面右侧的脸颊,两张纯文字图都放在另一侧,这并不违背文字描述,只是和参考图不一致;如果侧别对你重要,就要在描述里写明是左脸还是右脸,不过这一点没有在测试里验证。角色来自照片或画稿时,长相没法完整写成文字,这条捷径就不存在了。
参考图加属性清单的两张,并没有把脸上的记号带回来。山路那张得 3 分、围巾偏暗;雨夜街景那张得 4 分,围巾青绿、铜扣和发型都对,但两只眼睛同为榛色,脸上也没有疤,而异色瞳和疤痕都明明白白写在提示词里。两张图、一位评分者,样本很小,能确定的只是:在这两张图里,把小记号写进提示词没有让它们出现。
把上一张输出接着喂,还是每次回到原图?
每次回到原始参考图。测试里链式参考是漂移最重的一种做法,原图组的雨夜那张也有发色偏薰衣草、围巾偏暗,但链式把偏差叠得更深:从雨夜 S1 的输出出发画咖啡馆,围巾变成墨绿、铜扣变灰、头发带上薰衣草色,两位盲评者都只给 2 分;再从这张出发画山路,围巾几乎成了绿色,得分 3 分和 2 分。同样三个场景,每次都用原始参考图时是 3、4、3 分。
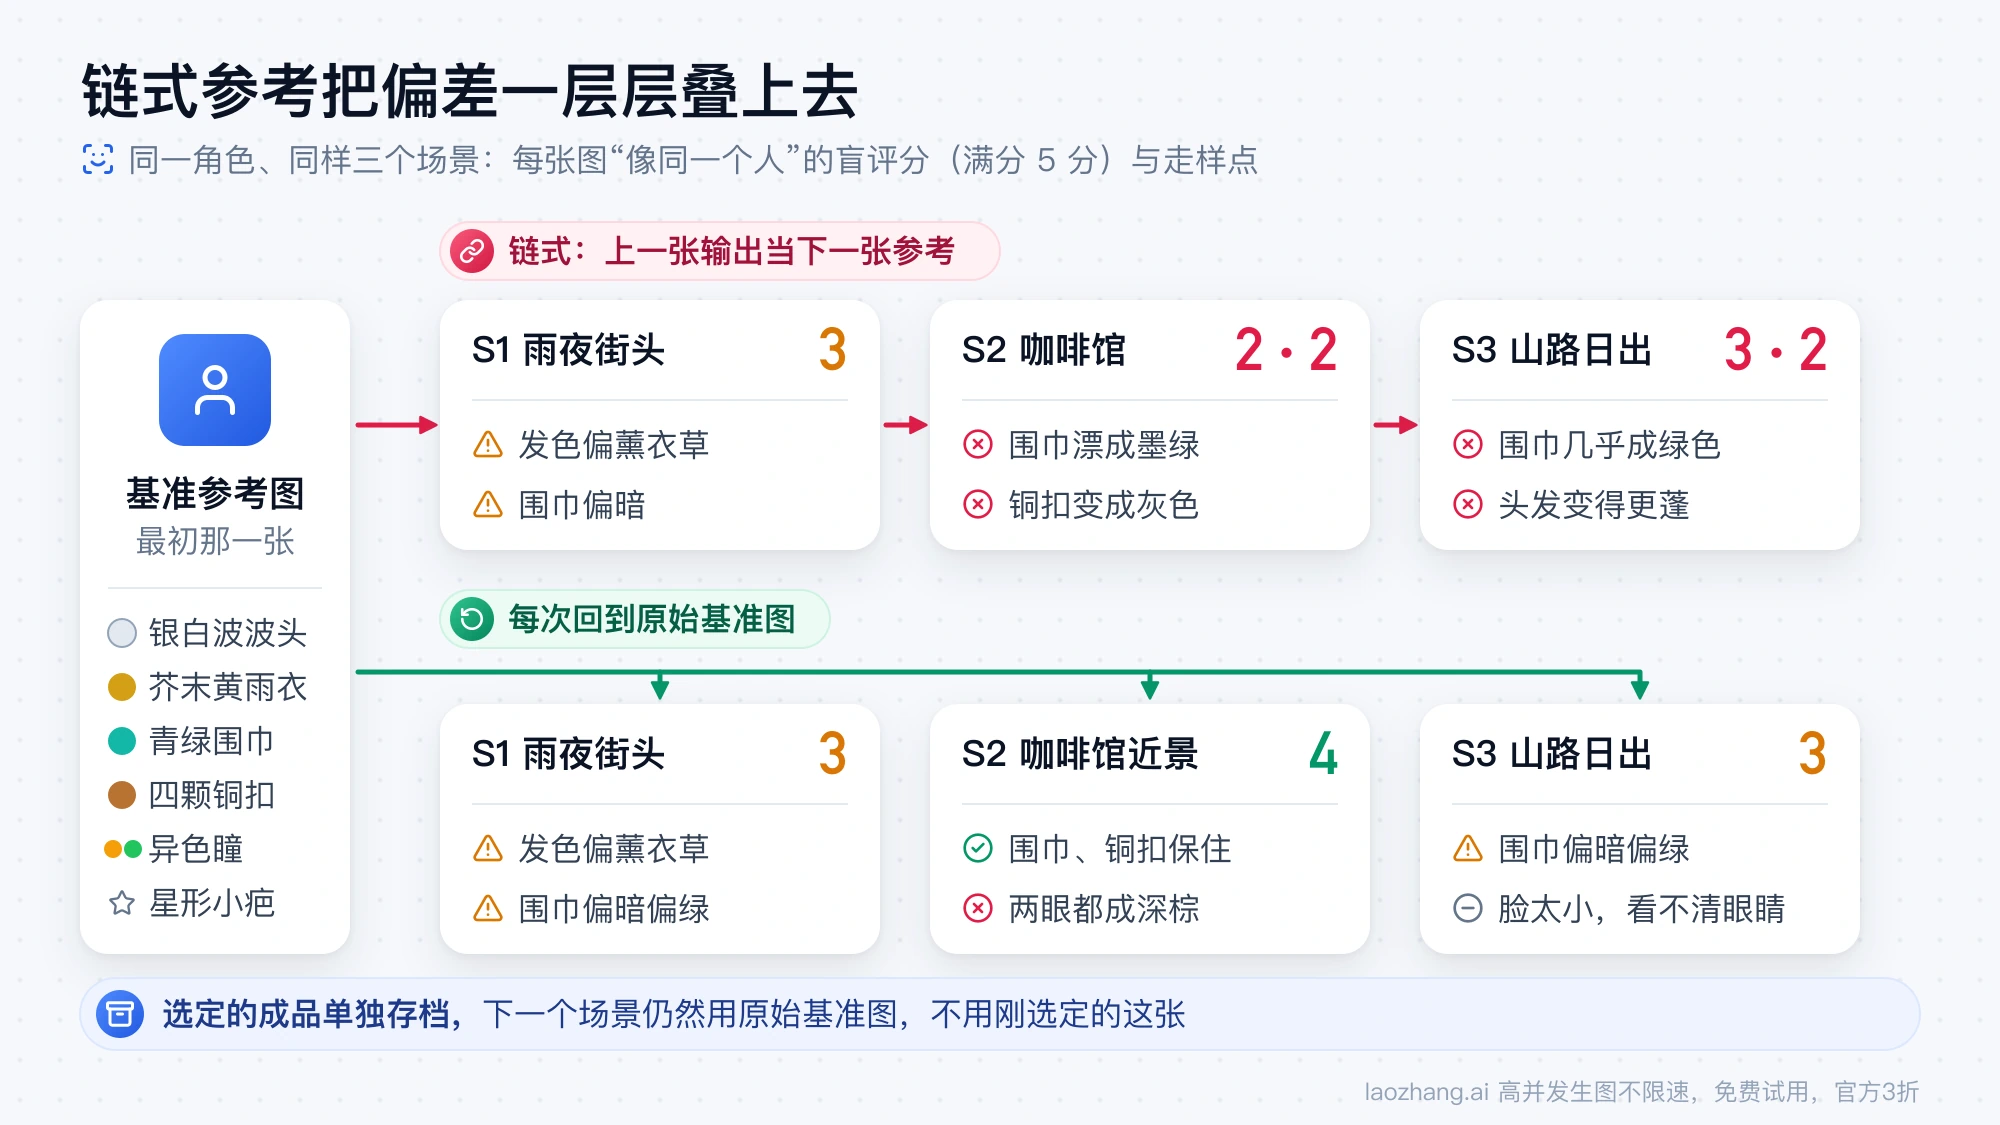
原因不难理解:每张输出都会带一点偏差,链式参考把这点偏差当成新的"标准答案"交给下一次,偏差就一层层叠上去。第三方画布工具 Astorie 在 2026 年 10 月 19 日更新的 Astorie 的 Nano Banana 2.1 角色一致性案例里得出的方向相同:它用 4K、High 思考档做单角色连续场景,每个节点只选一张输出,建议换新的镜头距离时回到原始参考图,并且在相近的脸部大小下对比。这个案例没有公布生成次数和相似度分数,只能说明方向一致,不能说明差距有多大。
Google 文档的说法看起来相反,其实讲的是另一件事。Gemini API 图片生成文档在 Character consistency: 360 view 一节建议通过逐步换角度来生成同一角色的多视角,并在后续提示里带上之前生成的图;它推荐的迭代方式是多轮对话。这和"只拿上一张输出当唯一参考"不同。如果你按 Google 的方式在多轮对话里迭代角度,仍然把原始基准图留在请求里,让它一直作为身份来源;两种参考同时放进去的组合,这次没有测。
什么样的角色容易保持同一个人:把身份放在发型和衣服上
容易保住的角色,靠的是从远处也能认出来的特征:发型轮廓、发色、衣服主色、围巾这类大面积配件。测试里这些特征在 9 张场景图里大体都在,只有色相会随灯光偏移;脸上的异色瞳和星形疤在能看清的图里多数没有画对,远景里则连判断都做不了。
原因有两层。第一层是画面占比:全身照和侧面街景里,脸只占很小一块,几像素宽的瞳孔颜色和小疤既难画出来,读者也看不出来,这类记号天生只在近景里有意义。第二层是颜色会被场景带偏:用参考图生成的雨夜和山路远景里,围巾有三张偏暗偏绿,夜景还把银白头发染上一层薰衣草色。同样的场景里也有保住青绿的图,所以偏色不是每次都会发生,但它集中出现在远景和强色光里,核对时要重点看。
设计角色时,就把识别点放在这些稳的地方:一个从侧面和背后都看得出的发型(这次的长短边不对称,在评分者能判断的图里大多保住,例外是属性清单组的山路图变短变齐、链式组的山路图变得更蓬),一件主色鲜明的外衣,再加一件颜色和外衣反差大的配件。脸上的小记号可以保留,但当作近景里的加分项,不把"是不是同一个人"押在它上面。如果某个小记号必须出现,比如吉祥物的标志性伤疤,就在需要它的那几张安排头肩近景,出图后逐张核对,必要时用局部编辑单独补上。
角色从哪里来也会改变做法。由提示词生成的角色,可以把那段描述一字不改地存起来,每次和基准图一起发,测试里文字和参考图组合的那一组至少没让衣服颜色变差。来自真人照片或画稿的角色,长相写不成文字,身份只能靠参考图承担,那就更要挑一张正面、光线均匀、脸部够大的图当基准;发型和衣服仍然可以写成文字一起发。Google 文档允许 2.1 每次放最多 4 张角色参考图,给同一个角色放几张不同角度的参考是否更稳,这次没有测。
照着做:基准参考图、提示词和每次要重复写的内容
可重复的流程分三块:先做一张合格的基准参考图,再写好一段固定的保持句和角色描述,之后每个新场景只换场景那一句。顺序不能乱,因为后面每一张图都以这张基准图为准,它本身有错,后面只会把错误照搬下去。
- 生成或挑选基准参考图:正面或微侧、头部到上半身完整入画、纯色浅灰背景、表情放松、柔和均匀的光。上面测试用的基准图提示词可以直接套用,把
{LOOK}换成你的角色描述。 - 拿到基准图先逐项核对,你要保住的每个特征都必须在这张图里清楚可见。缺了就重做基准图,不要指望后面的场景图把它补上。
- 把角色描述存成一段固定文字,以后每次一字不改地复用。描述里能写侧别的就写明侧别,比如疤痕在哪一侧脸颊、哪只眼睛是什么颜色。
- 每个新场景的请求都由四部分组成:原始基准图(作为唯一的角色参考图)、保持句、角色描述、场景句。场景句写清镜头距离和角度;需要核对脸上记号的镜头,用头肩近景。
- 复杂姿势按 Google 文档的建议,再附一张所选姿势的参考图。
- 选定的成品单独存档,下一个场景仍然用原始基准图,不用刚选定的这张。多个角色时,每个角色各备一张基准图,2.1 每次请求最多接受 4 张角色参考图。
一个场景请求的提示词结构如下,场景句换成你的场景即可:
Use the person in the reference image as the character. Keep her face, hair, eye colours, scar, jacket and scarf identical to the reference.
Keep these identifying details exactly as in the reference: {LOOK}.
{场景句:镜头距离 + 角度 + 动作 + 环境 + 光线}
第二行在测试里没有让脸部记号回来,但也没有让衣服变差,作为固定写法留着,成本只是多几十个 token。场景句和光线词的更多写法,可以参考如何给 Nano Banana 写提示词:实用方法与 50 个可测试模板。
每张图的核对清单,以及什么时候停止重抽
新图出来先逐项核对,再决定要不要重抽。核对时把新图和基准图放在相近的脸部大小下对比,远景图先裁出人物再看,否则很容易把"看不清"误当成"保住了"。
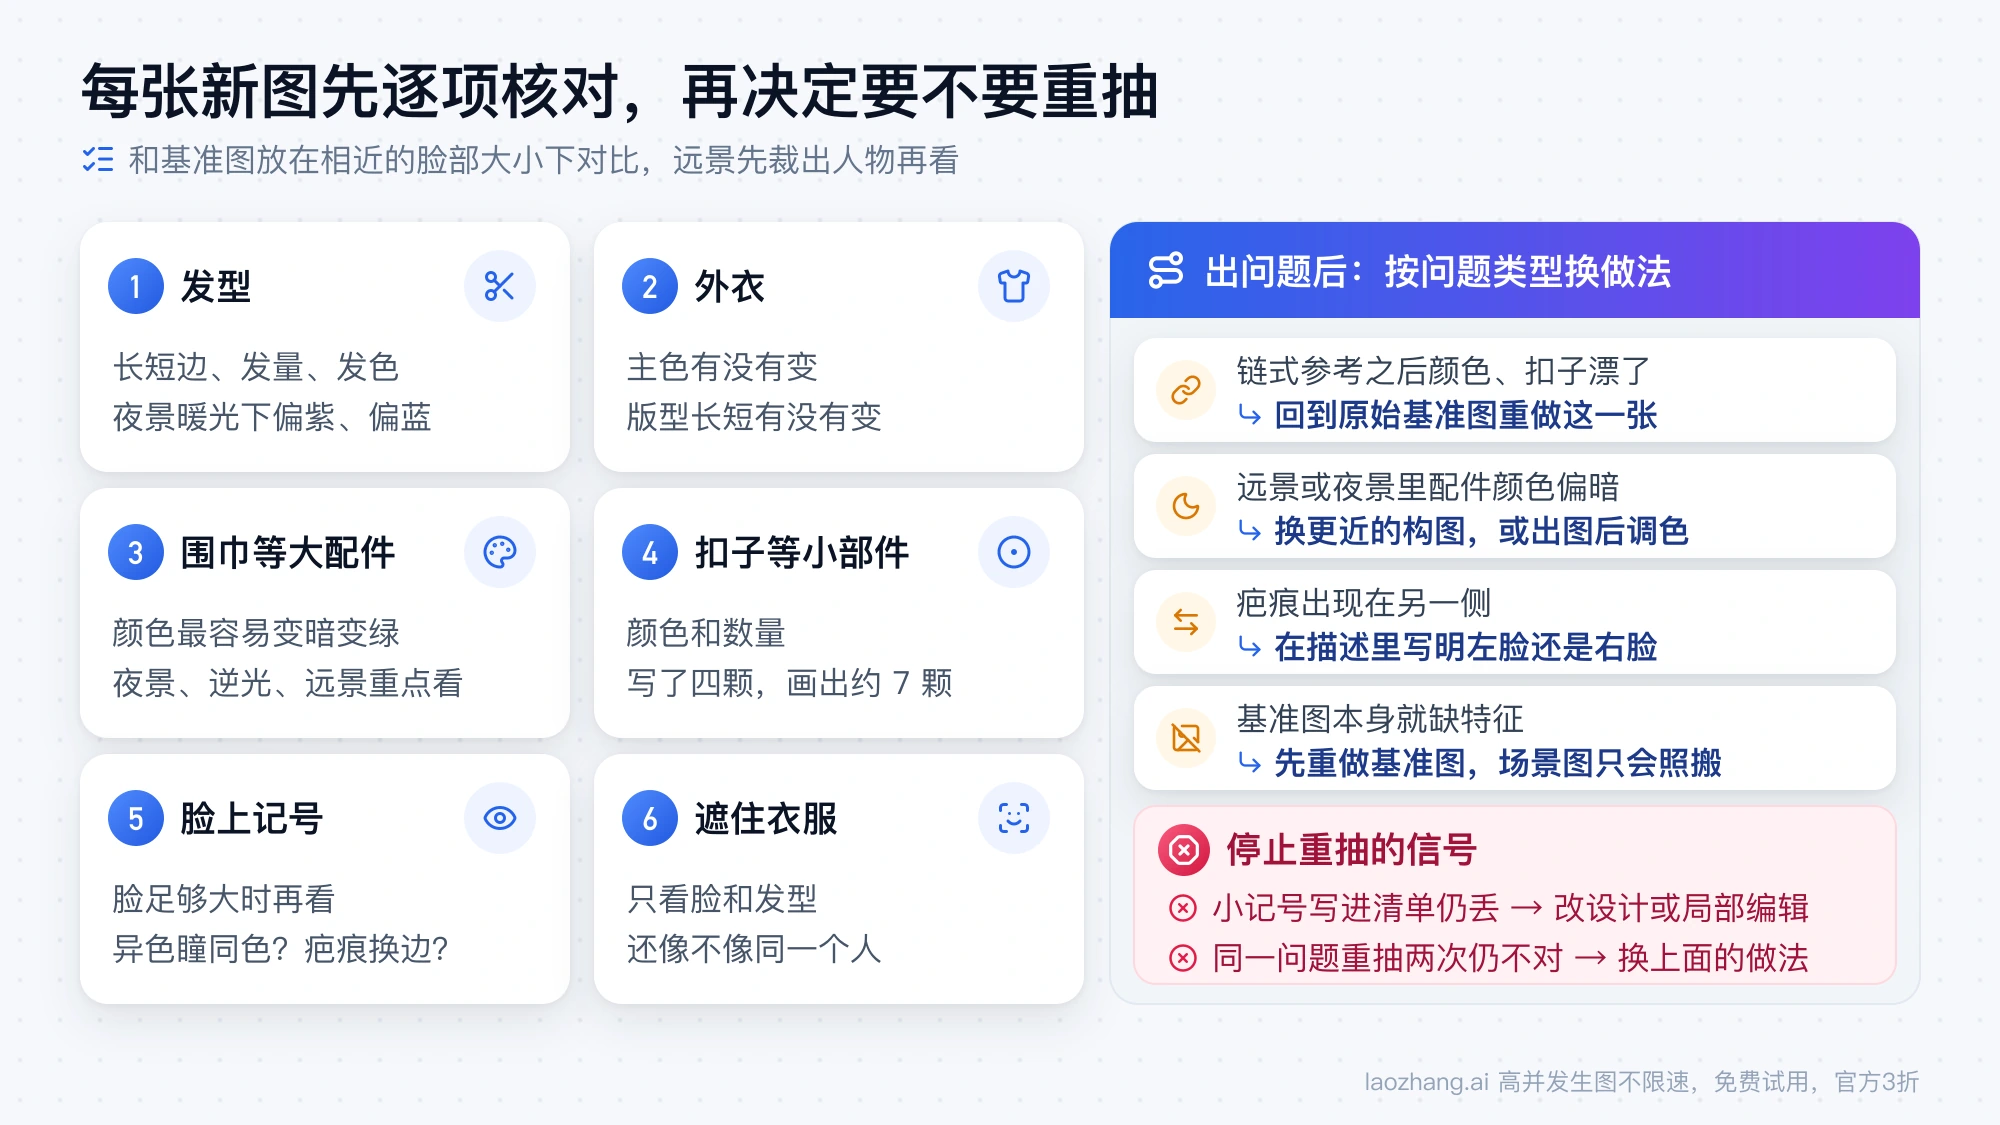
- 发型的长短边、发量和发色是否和基准图一致,夜景、暖光下有没有偏紫、偏蓝。
- 外衣的主色和版型长短有没有变。
- 围巾这类大面积配件的颜色,在夜景、逆光和远景里它最容易变暗变绿。
- 扣子等小部件的颜色和数量,描述里写了四颗,纯文字组的山路图画了约 7 颗。
- 脸足够大时再看脸上记号:异色瞳有没有变成两眼同色,疤痕有没有跑到另一侧。
- 遮住衣服只看脸和发型,判断还像不像同一个人。
核对出问题之后,按问题类型决定下一步。共同的原则是:在已经走样的图上继续修,或者原样重抽同一个请求,都不太可能修好结构性的问题。
| 看到的问题 | 下一步 | 理由 |
|---|---|---|
| 颜色、扣子在链式参考之后漂了 | 回到原始基准图重做这一张 | 测试里链式参考是漂移最严重的做法 |
| 远景或夜景里配件颜色偏暗 | 换一张更近的构图,或者出图后调色 | 用参考图的雨夜和山路远景里,有三张围巾偏暗偏绿 |
| 异色瞳、小疤在原图加属性清单的近景里仍然丢 | 停止重抽,改设计或用局部编辑补 | 写进提示词的两张图都没有让它们回来 |
| 疤痕出现在另一侧 | 在描述里写明侧别再试 | 原描述没写侧别,模型自己挑了一侧 |
| 基准图本身缺特征 | 重做基准图 | 场景图只会照搬基准图 |
重抽要事先定上限,比如同一张图因为同一个问题重抽两次仍然不对,就按上表换做法。这次测试每种做法每个场景只跑了一张,没有测到要重抽几次才能稳定画出异色瞳和疤痕,也没测 2K、4K 或 high 思考档会不会更好,所以上限是按成本给的经验做法,不是测出来的次数。
Nano Banana 2.1 角色一致性的其他问题
Nano Banana 2.1 一次最多能放几个角色、几张参考图?
截至 2026 年 11 月 3 日,Gemini API 图片生成文档写明 Nano Banana 系列一次最多混合 14 张参考图。对 Nano Banana 2.1 和 Nano Banana 2 来说,其中最多 10 张物体图、4 张角色图,不支持风格参考图;Nano Banana Pro(gemini-3-pro-image)是 6 张物体图、5 张角色图和 3 张风格参考图,所以"5 个角色"是 Pro 的上限,不是 2.1 的。这些是单次请求的工作上限,不保证每个角色都和参考图一模一样。
Nano Banana 2.1 的角色一致性比 Nano Banana Pro 好吗?
按 Google 自己的评测是略好:Google DeepMind 的 Nano Banana 2.1 模型卡(截至 2026 年 10 月的结果)里,单角色一致性 Elo 为 2.1 开启思考 1028、不开思考 1021、Pro 991,多角色一致性为 1106、1068、1011,但单角色的差距和 2.1 约 ±14 的置信区间相比并不大,模型卡也写明 "Character consistency is not always perfect"。三个模型同题出图的对比见 Nano Banana 2.1 vs Pro vs GPT Image 2.5 对比:9 组同题实测,仍在用 Pro 的话,参考图参数和走样诊断见 Nano Banana Pro 人脸一致性完全指南。
多放几张参考图会多花钱吗?
在老张 API 上不会:它的 2.1 文档写明每次调用同价,与分辨率、思考档位和参考图数量都无关,但每张参考图会增加约一千个输入 token。按 Google 官方价格计费时的每张图价格与调用入口,见 Nano Banana 2.1 价格与入口。
多轮编辑到第二轮返回 400 怎么办?
在多轮对话里继续编辑上一张图时,如果没有把上一轮响应里的 thought signature 原样带回去,第二轮会直接返回 400,修法见 Nano Banana 2 Thought Signature 错误:上一张图丢了签名怎么修。
返回 HTTP 200 却没有图片是怎么回事?
请求成功但响应里没有图片数据时,先看 finishReason:只回了文字、NO_IMAGE、被安全拦截、模型 ID 已下线,各有各的处理;在老张 API 上,上游返回 200 即使没有出图也照常计费,排查步骤见 Nano Banana API 不出图:按返回字段逐项排查。