Nano Banana 2.1 vs Pro vs GPT Image 2.5 对比:9 组同题实测
同题各出一张 1K 图:要一字不差的海报和菜单,选 Pro 或 GPT Image 2.5;2.1 按官方单价最便宜、出图快,但三道文字题都有偏差。三者都把“单”写成了“単”。
文章目录
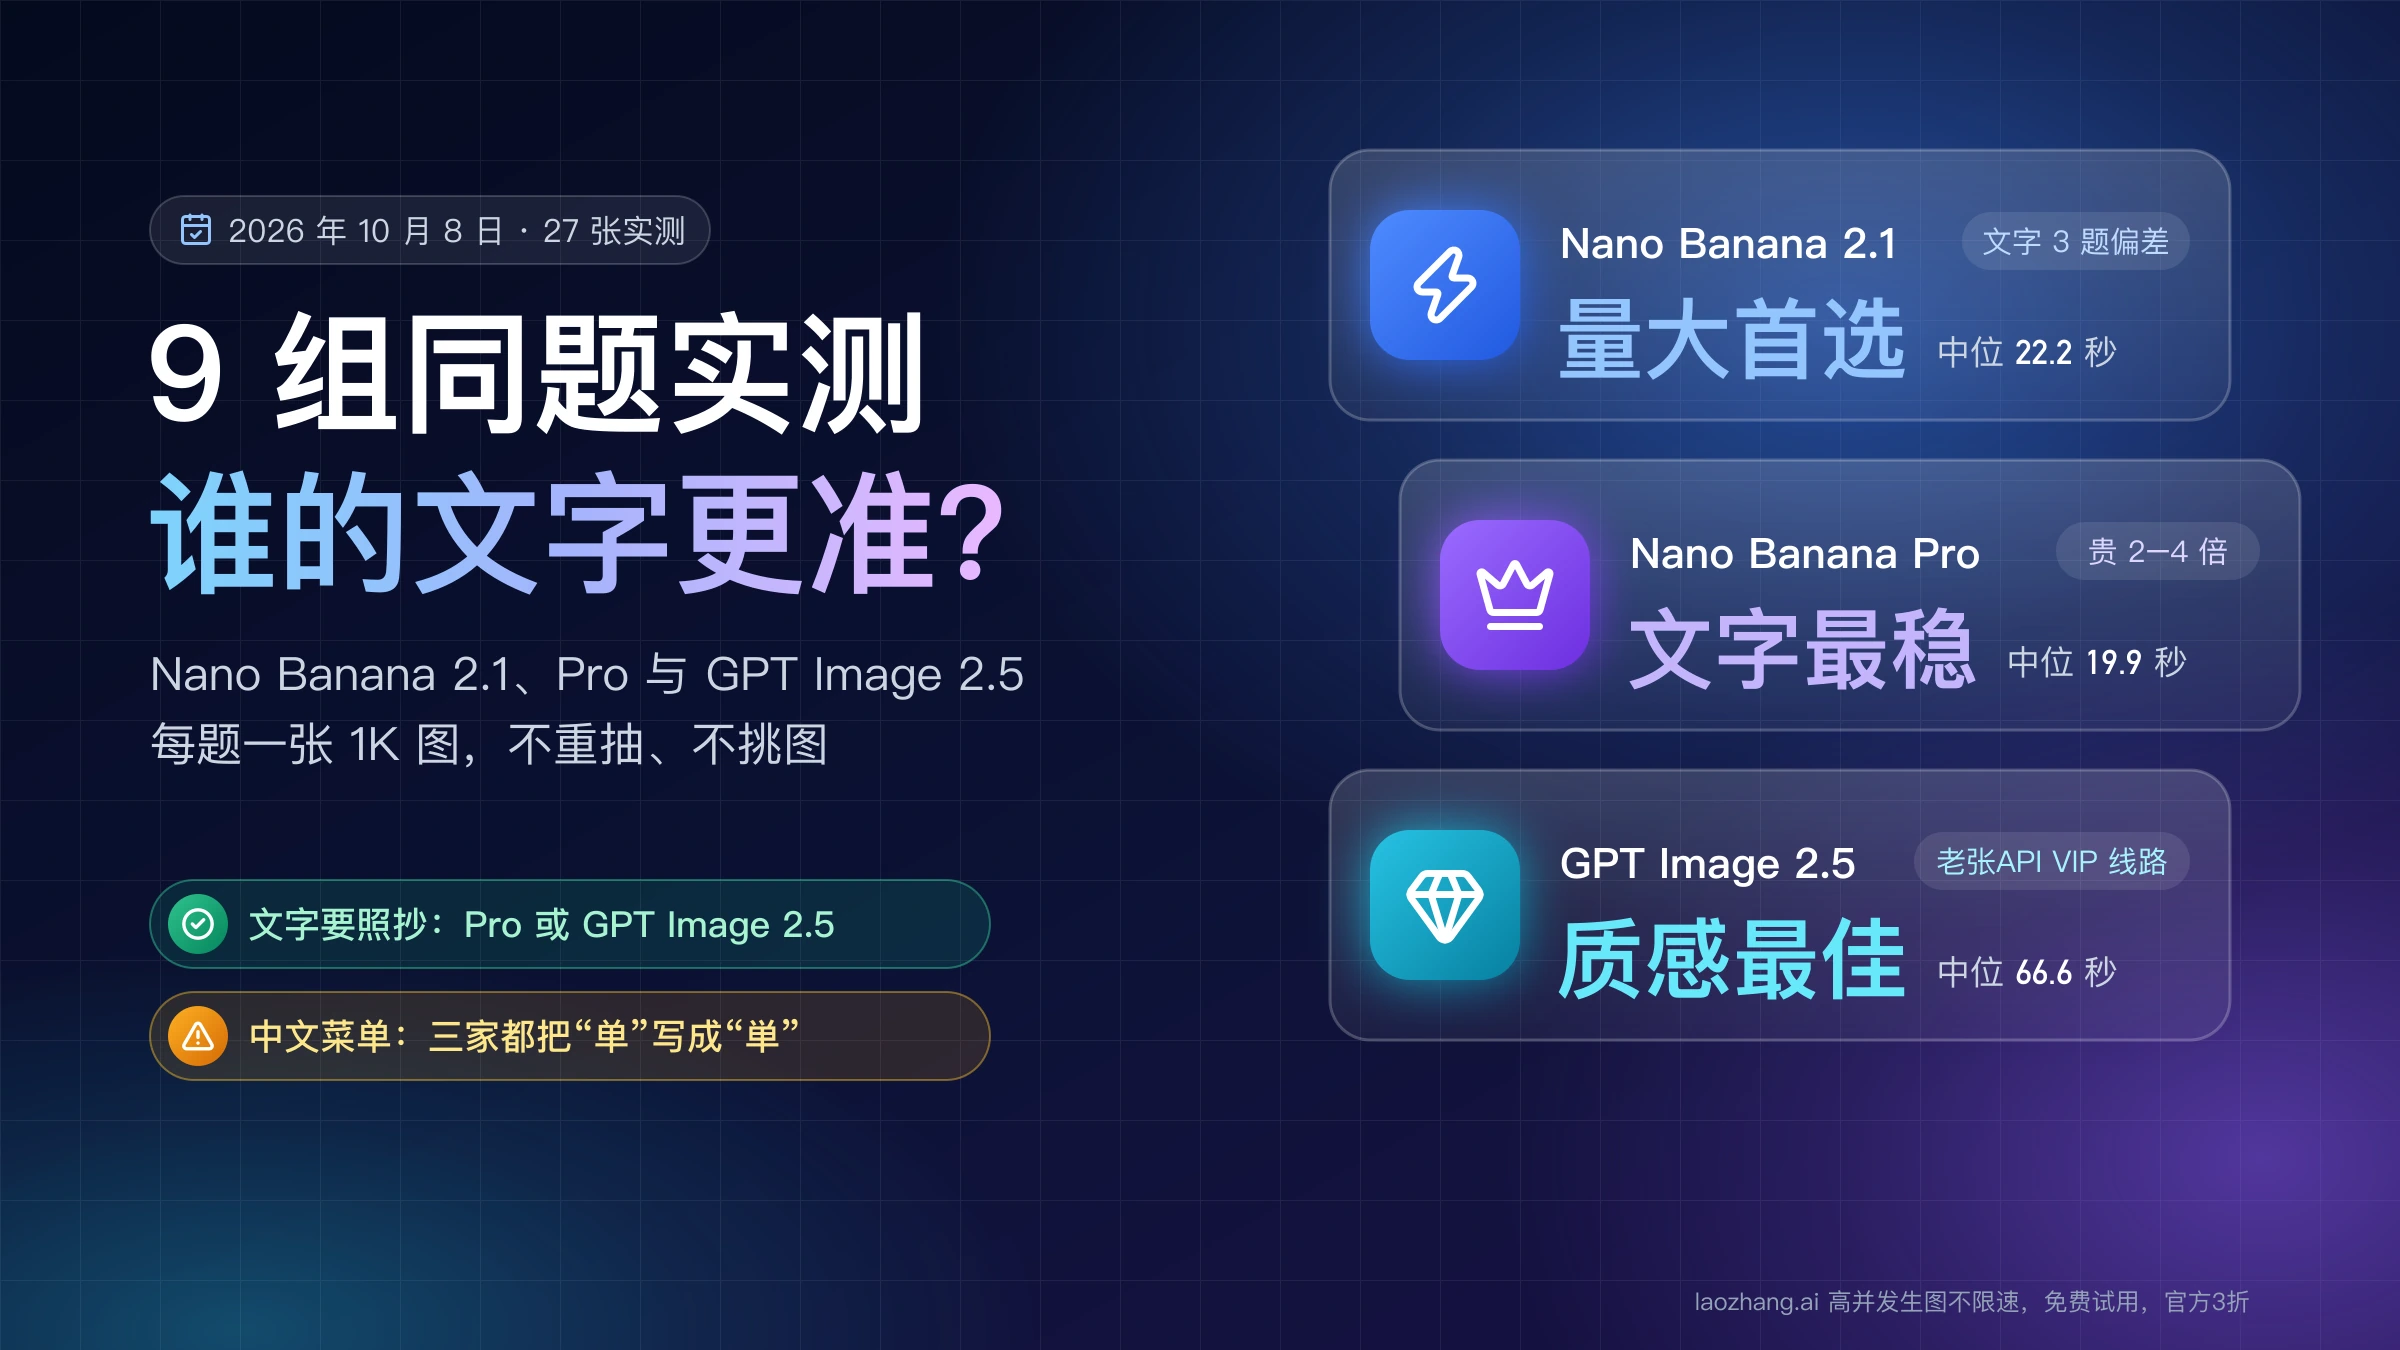
2026 年 10 月 8 日,Nano Banana 2.1、Nano Banana Pro 和 GPT Image 2.5 Sunburst 用同样的 8 个提示词各生成一张 1K 图,再对同一张产品图做同一个改色指令,一共 27 张,不重抽、不挑图。结论按任务分:
- 海报、招牌、菜单这类文字必须一字不差:用 Pro 或 GPT Image 2.5。三道精确文字题里,这两个模型保留了每个指定的词和数字,只是和 2.1 一样把菜单上的“单”写成了“単”;2.1 三道都有额外偏差,改了标点和大小写、多写了一个词、把“38元”写成“三十八元”。
- 中文菜单不管用哪个都要人工校字:三个模型都把“今日茶单”的“单”写成了日文字形“単”。
- 信息图、计数、按指定数值画界面:三个模型都答对了,2.1 按官方单价每张最便宜、出图速度和 Pro 相当,适合当默认;走老张API 按次计费时,GPT Image 2.5 VIP 线路的 $0.03 更低。
- 要电商主图那种精修质感:GPT Image 2.5 的画面最“贵”,但通过 VIP 线路每张要等 1 分钟左右。
- 改图保留构图:三个都做到了,差别只在细节理解。
每个判断只基于一张样图,说明的是“这一次出了什么”,不是“哪个模型稳定更好”。GPT Image 2.5 的结果来自老张API 的 VIP 按次线路,不是 OpenAI 官方 API 直连,下文“测试条件”一节写明了区别。
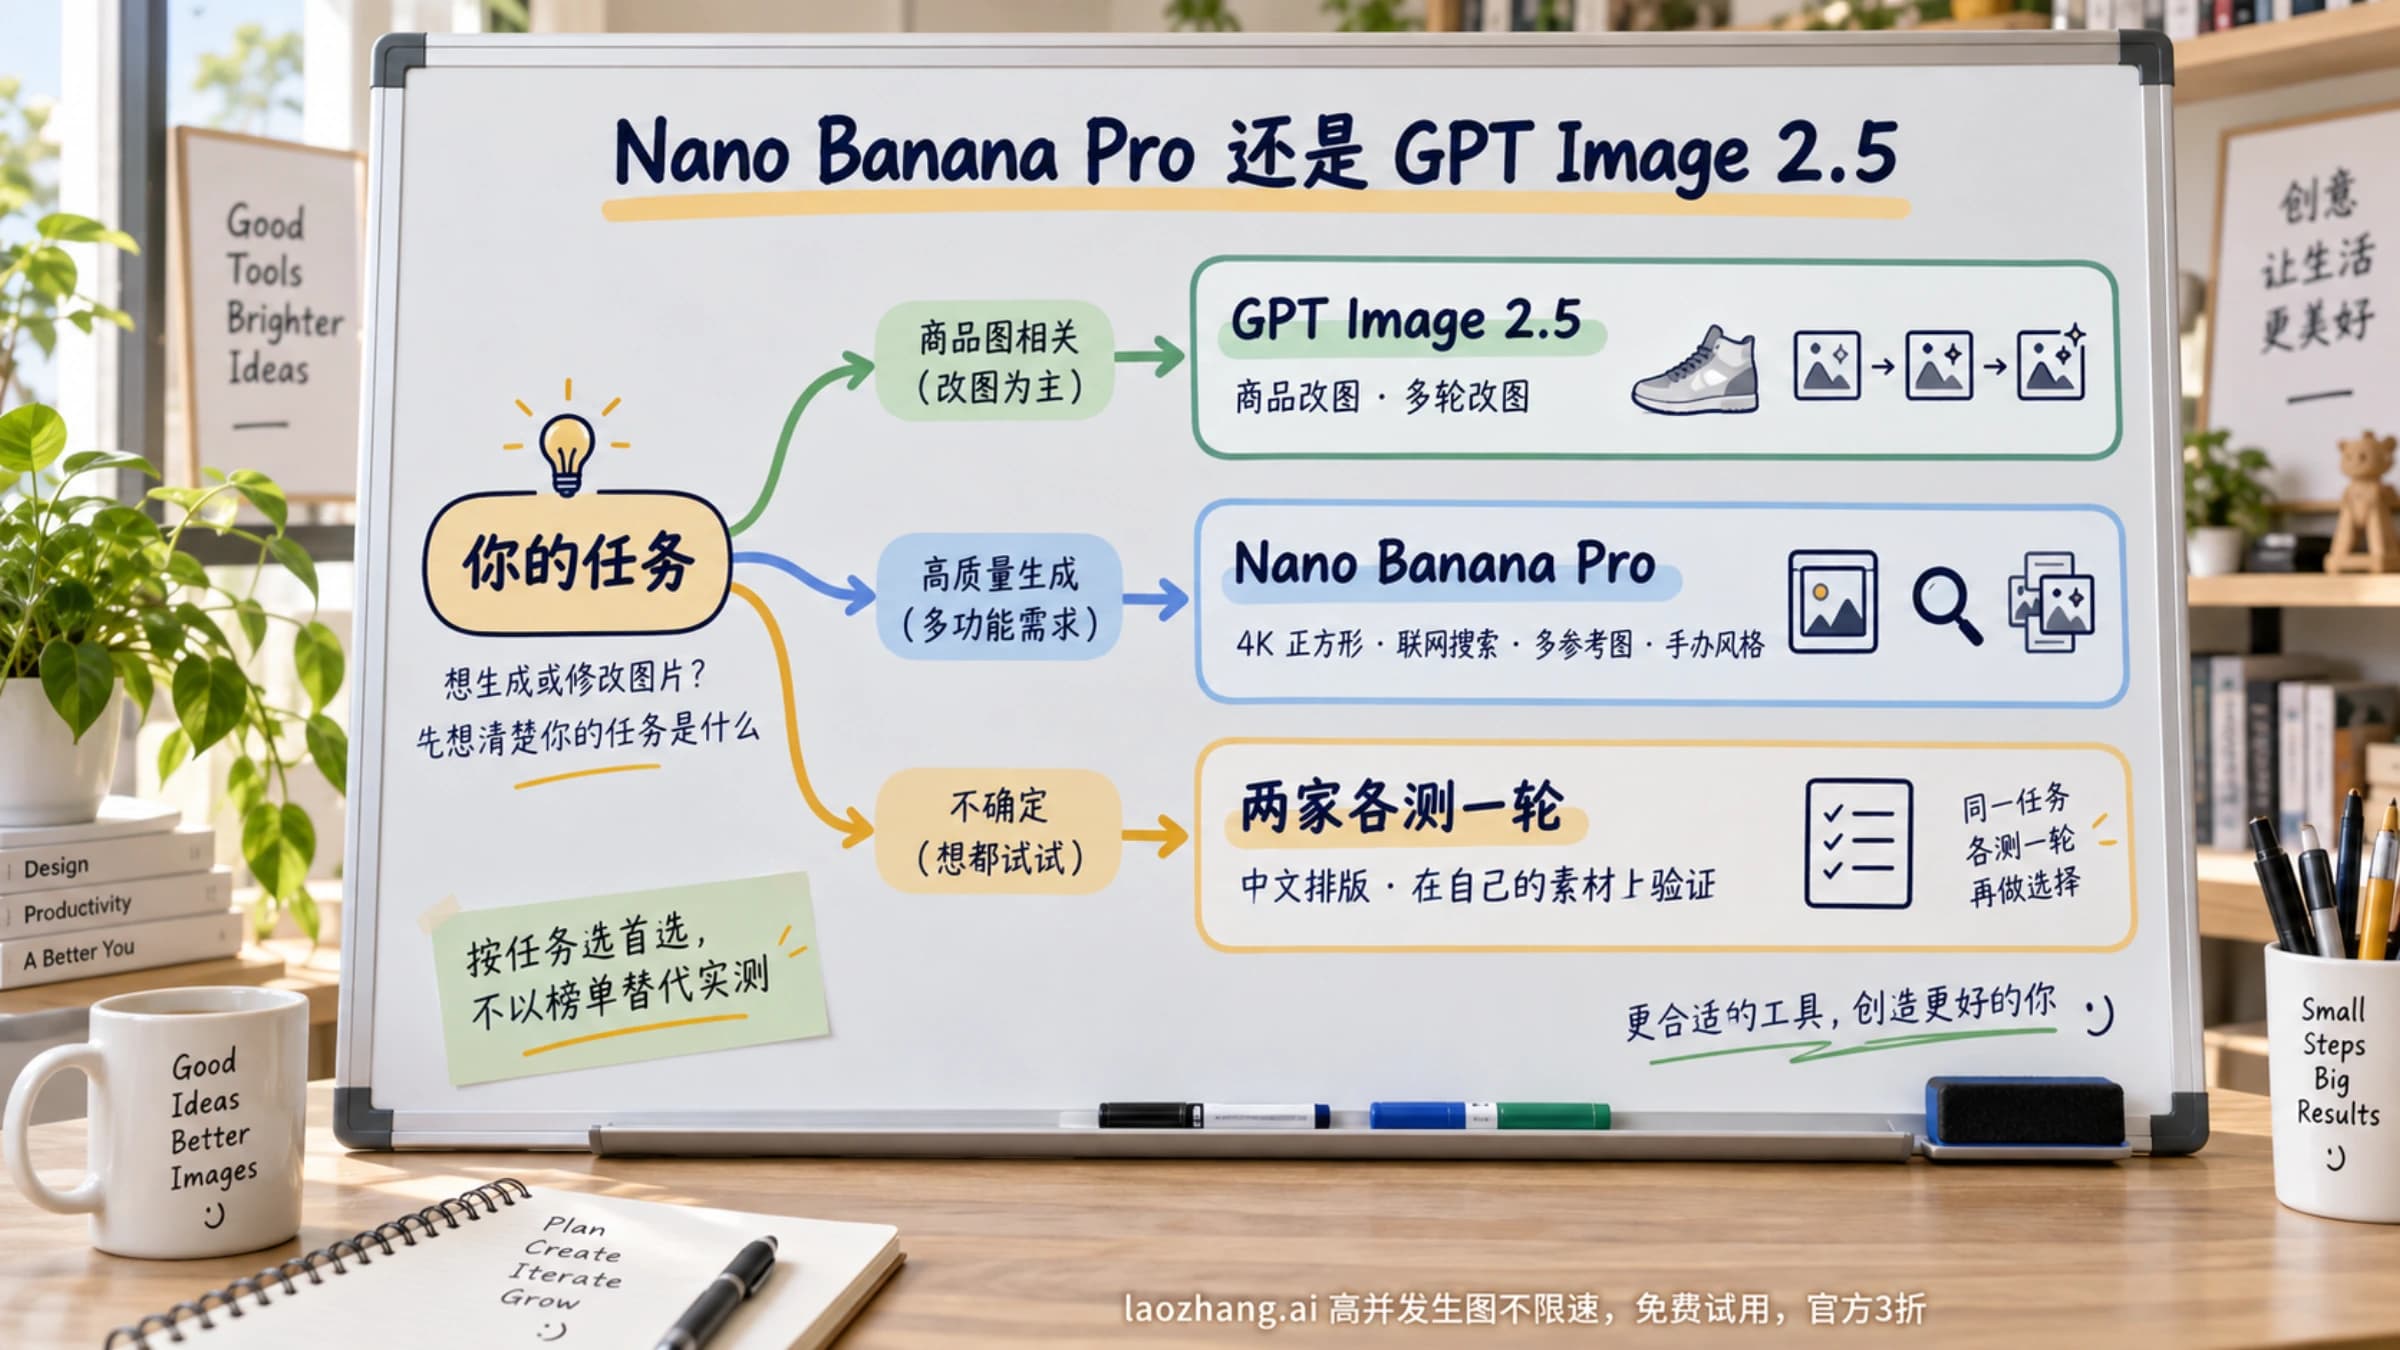
怎么选:按任务对照 Nano Banana 2.1、Pro 和 GPT Image 2.5
| 你的任务 | 先用 | 这组测试里看到的 | 证据强度 |
|---|---|---|---|
| 英文海报、日文招牌,文字要照抄 | Pro 或 GPT Image 2.5 | 两者保留了全部指定的词和数字,但菜单上的“单”也写成“単”;2.1 三道都有额外偏差 | 每题一张,方向一致 |
| 中文菜单、价目表 | Pro 或 GPT Image 2.5,出图后校字 | 价格只有 2.1 写错;“单”三家都写成“単” | 一道题一张 |
| 信息图、流程图 | 2.1 | 三家 5 个步骤都准确;GPT Image 2.5 多加了一句没要的口号 | 一道题一张;Google 自测也偏向 2.1 |
| 按数量、左右位置摆放物体 | 任一,按官方价 2.1 最便宜 | 三家都画对 3 个红杯在左、2 个蓝杯在右 | 一道题一张 |
| App 界面、带指定数字的小字 | GPT Image 2.5 或 2.1 | 指定内容全对;Pro 和 2.1 自己加了不少没要的字段,GPT Image 2.5 最少 | 一道题一张 |
| 电商产品图、人像 | 要质感选 GPT Image 2.5,要量选 2.1 | 三家都够真实;GPT Image 2.5 光影最戏剧化 | 主观观感 |
| 只改颜色、其余不动 | 三个都可以 | 构图、耳机、石面、光线都保住;内盖颜色理解不同 | 一道题一张 |
| 批量出图、要快 | 2.1 | 2.1 和 Pro 约 20 秒一张;GPT Image 2.5 VIP 线路 58–76 秒 | 单次计时,含网关与网络 |
如果只能记一条:文字要准用 Pro,量大按官方价计费用 2.1。GPT Image 2.5 在文字和质感上与 Pro 同一档,走老张API VIP 线路时按次价最低,但等待最长。
测试条件:每题一张、只测 1K,GPT 走老张API VIP 线路
三个模型都通过老张API 调用:
- Nano Banana 2.1:
gemini-nano-banana-2.1,Gemini 原生generateContent接口,1:1、imageSize1K,思考等级用默认值medium。 - Nano Banana Pro:
gemini-3-pro-image,同一接口,1:1、1K,默认思考设置。 - GPT Image 2.5 Sunburst:
gpt-image-2.5-sunburst-vip,/v1/images/generations和/v1/images/edits,size为 1024x1024,quality为 high。
关于 GPT Image 2.5 的线路要单独说清楚。老张API 有两条 GPT Image 2.5 线路:一条是按 OpenAI 价格计费的官方转发线路 gpt-image-2.5-sunburst,需要单独的分组权限,普通分组的 key 调用会返回 503 “no available channels”(不扣费);另一条是 VIP 按次线路 gpt-image-2.5-sunburst-vip,每次 $0.03。这组测试用的是 VIP 线路。它不是 OpenAI 官方 API 直连,同一提示词在 OpenAI 直连下出的图可能不同,下文所有 GPT Image 2.5 的画面、耗时和失败次数都只代表这条线路。两条线路的说明见老张API 的 GPT Image 2.5 文档。
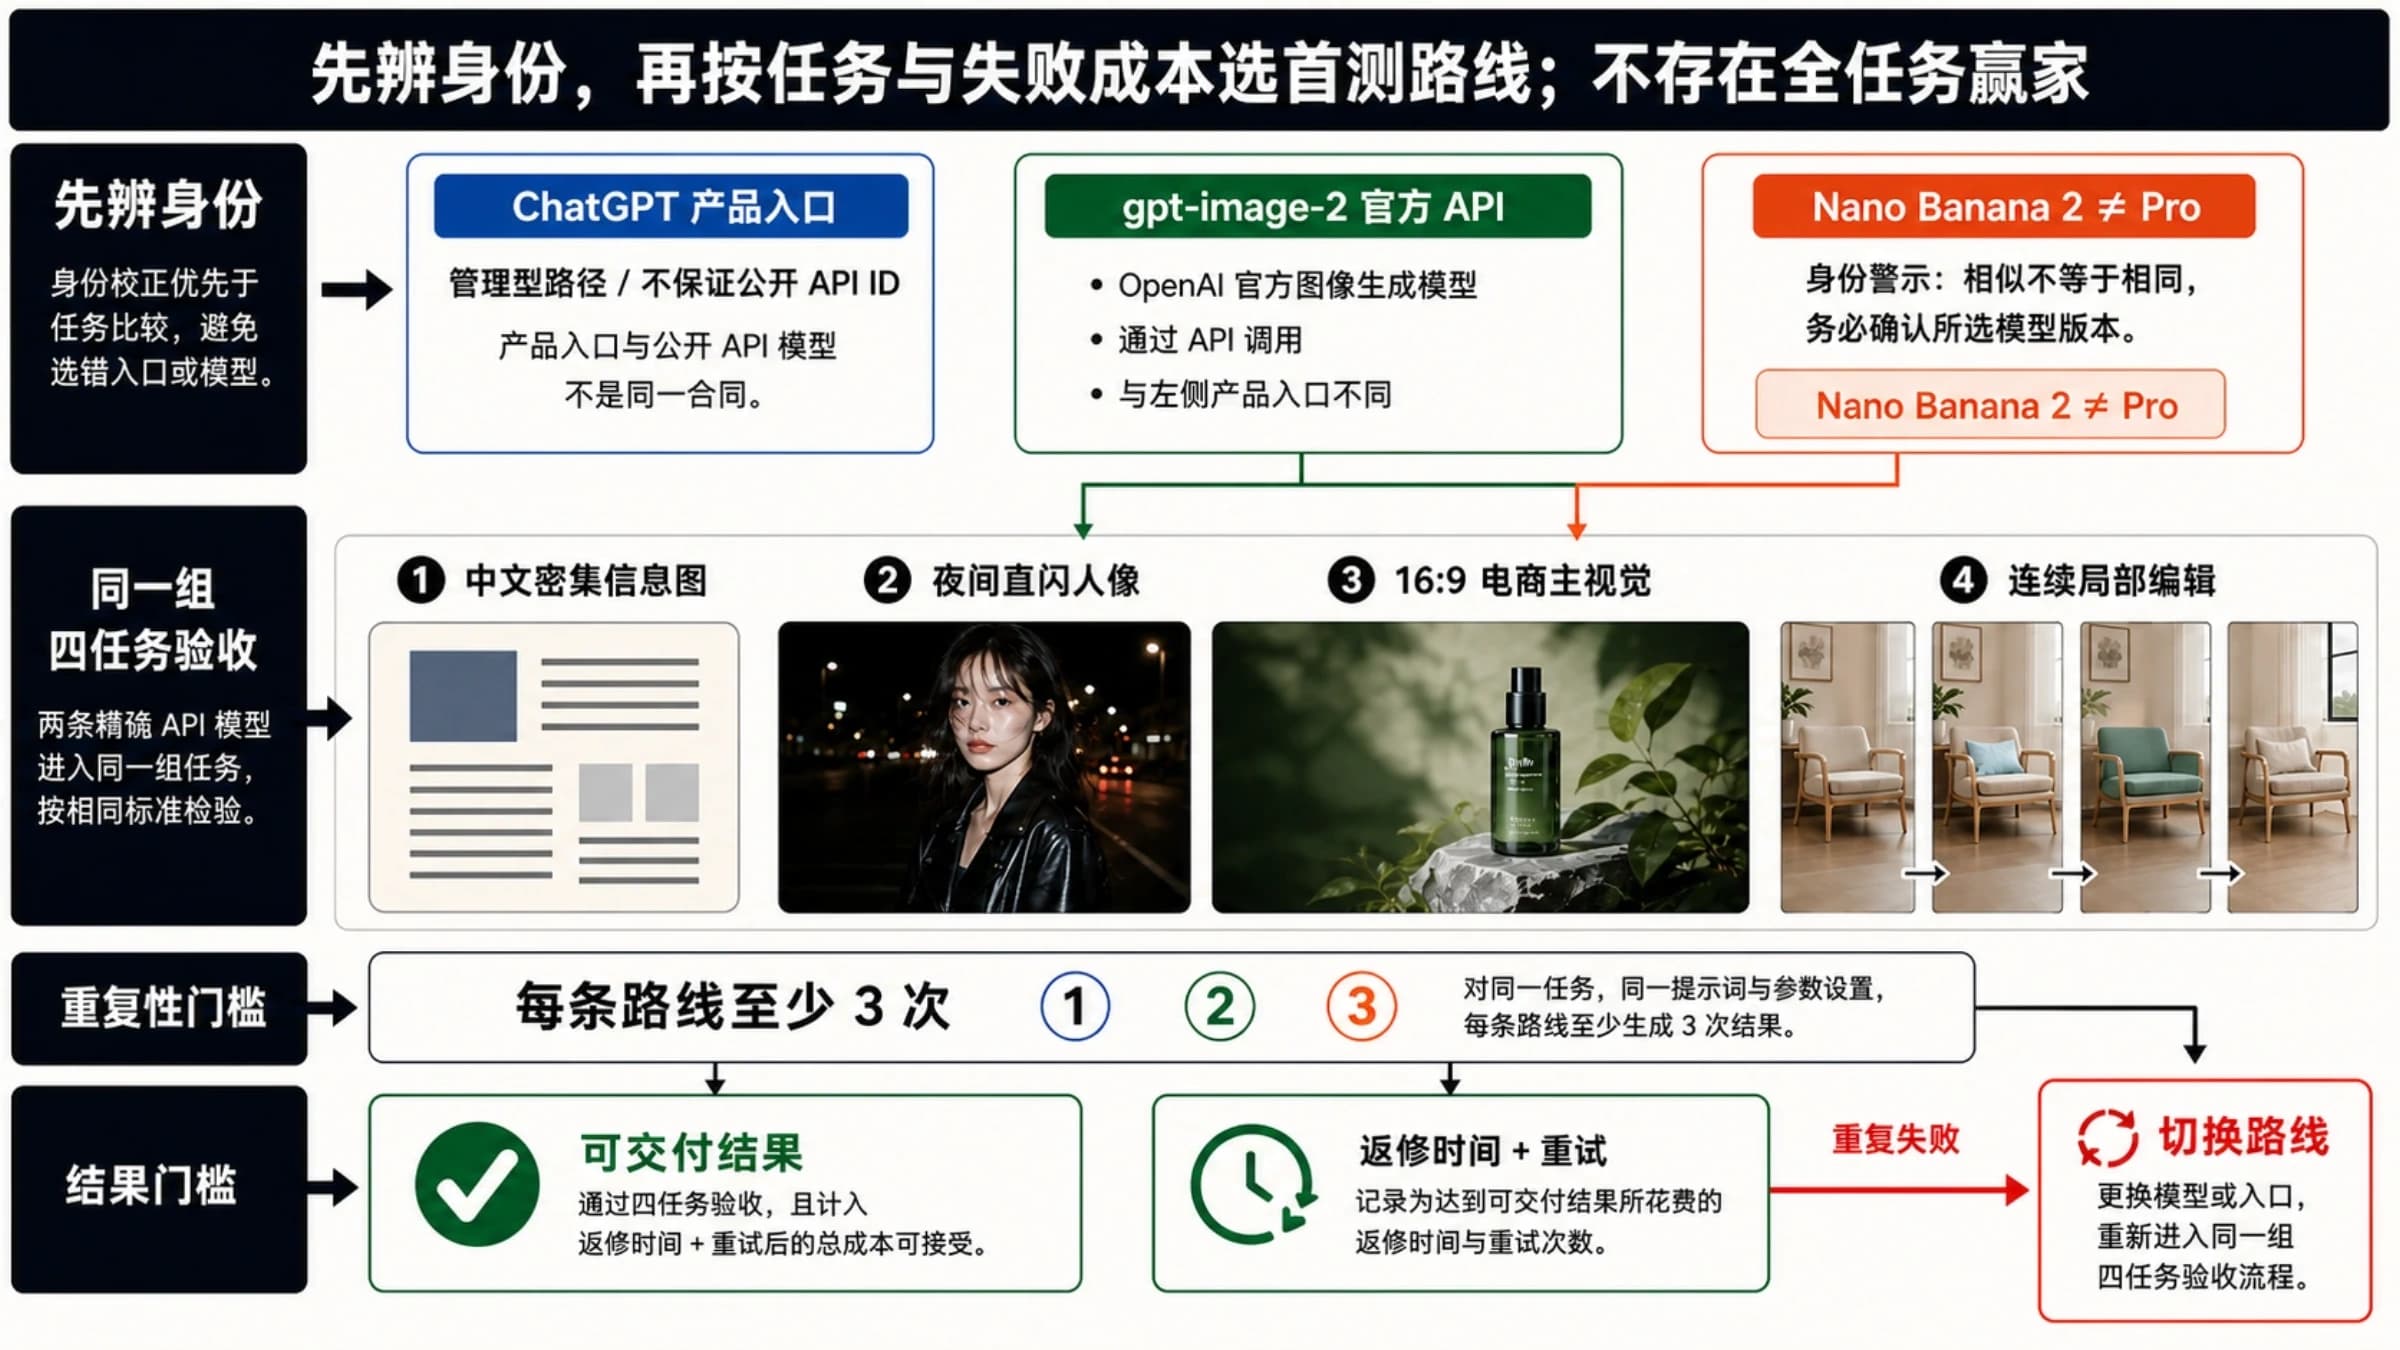
8 个提示词覆盖英文海报、美国立法流程信息图、耳机盒产品图、东京拉面店招牌(日文)、中式茶馆菜单(中文)、3 红 2 蓝杯子的计数与左右位置、老渔夫人像、带指定数字的天气 App 界面。改图题把 2.1 生成的黑色耳机盒照片原样交给三个模型,指令是“把充电盒改成亮面白色,耳机、机位、石面、光线和阴影都保持不变”。
这组测试的边界:
- 每题每个模型只出一张,没有重抽,所以单题结果可能是运气好或运气差。
- 只测 1K,2K、4K 的小字清晰度没有覆盖。
- 没测多图参考、角色一致性、使用 Google 搜索建立依据,也没测 Batch。
- 耗时是从调用端测到的总时间,包含老张API 网关和网络,不等于 Google 或 OpenAI 直连的速度。
27 次成功调用按老张API 标价合计 $1.485,即 9 ×($0.045 + $0.09 + $0.03)。
谁的文字更准:Pro 与 GPT Image 2.5 照抄原文,2.1 常改写
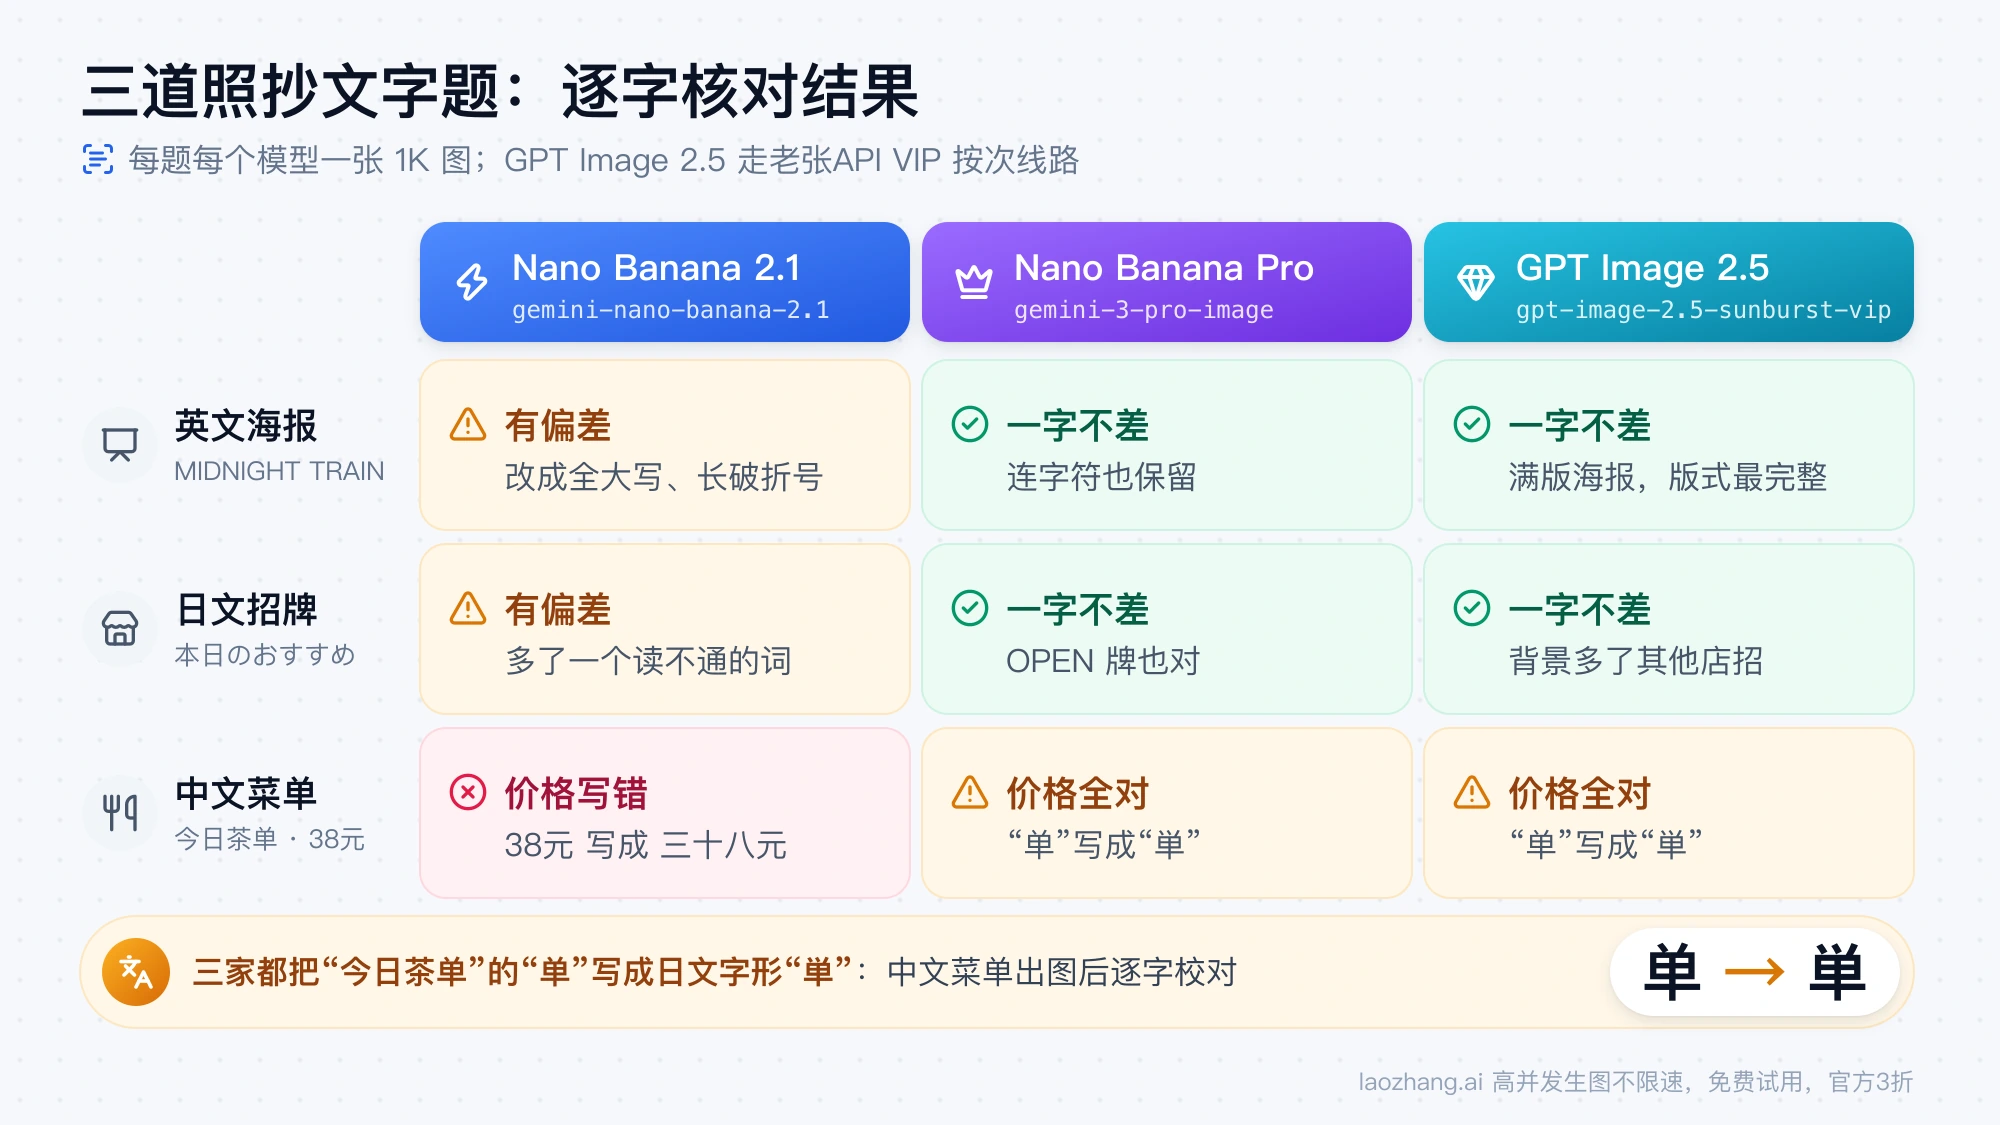
三道题要求模型照抄指定文字。结果逐字核对如下:
| 提示词要求的文字 | Nano Banana 2.1 | Nano Banana Pro | GPT Image 2.5(VIP) |
|---|---|---|---|
| 英文海报:MIDNIGHT TRAIN / Live at Hall 7 - Nov 14, 2026 - Doors 19:30 | 单词都对,但副标题改成全大写,连字符换成长破折号 | 一字不差,连字符保留 | 一字不差,版式最完整 |
| 日文招牌:本日のおすすめ ラーメン 980円,门边 OPEN | 指定文字都在,但招牌上多了一个没要求、读不通的词(形似“エソープ”) | 一字不差,OPEN 牌也对 | 一字不差,OPEN 竖排;背景多了“麺”“やきとり”等店招 |
| 中文菜单:今日茶单 / 龙井 38元 / 普洱 42元 / 茉莉花茶 28元 | “38元”写成“三十八元”;“单”写成“単” | 价格全对;“单”写成“単” | 价格全对;“单”写成“単” |
2.1 的偏差有一个共同点:它不是写错字,而是“改写”了原文,把连字符改成破折号、把阿拉伯数字改成汉字、在招牌上补词。这类问题在海报初稿里不显眼,印出来才发现。2.1 在这三道题上的思考 token 有 1,209–1,552 个,远多于 Pro 的 122–252 个,想得多并没有让它更忠于原文。思考 token 是模型出图前先用文字推理的部分,2.1 按文本输出单独计费,见下文价格一节。
Google 在 2.1 的模型卡里也写了已知局限:1K 下的小字可能模糊。需要小字清楚的图,先试 2K。
英文海报的画面也有差别:2.1 和 Pro 都把海报画成摆在背景上的一张纸(2.1 是黑底,Pro 是灰底),GPT Image 2.5 直接出满版海报,还加了铁轨和红日的图形,构图最接近能直接用的成品。
中文菜单用哪个:2.1 把 38元写成三十八元,“单”三家都写错
中文菜单题是这组测试里最能直接用的结论:
- 价格:Pro 和 GPT Image 2.5 把 38元、42元、28元都照写;2.1 把第一项写成“三十八元”,后两项又是阿拉伯数字,同一张菜单里格式不一致。
- “单”字:三个模型都把“今日茶单”的简体“单”写成了日文字形“単”(上面两点写成了三点)。毛笔字风格下乍看不明显,放大后很清楚。
- 其余字:龙井、普洱、茉莉花茶都写对了。
做中文海报、菜单、价目表,结论是 Pro 或 GPT Image 2.5 打底,出图后逐字校对,尤其是“单、团、乐、对”这类简体与日文字形不同的字。同样有日文写法的“龙”(日文作“竜”)三家都写对了,所以这不是整篇换成日文字形,而是个别字出错,哪些字会出错只能逐字看。在提示词里写明“简体中文”能否避免,这组测试没有覆盖。
信息图、计数和天气界面:三家都对,差别在多画的内容
美国法案成为法律的 5 个步骤:三个模型的步骤都准确。2.1 是“提出法案、委员会审议、全院辩论表决、送另一院、总统签署或否决”,标签清楚、图标贴切。Pro 把参众两院表决合成一步,单独加了“两院协商委员会”一步,事实上也成立。GPT Image 2.5 每一步配了较长的说明文字,但多加了一句提示词没要的副标题和底部口号“A LAW FOR A STRONGER TOMORROW”。
3 个红杯在左、2 个蓝杯在右:三家都画对了数量和位置。Google 在模型卡里提到 2.1 有左右混淆的已知局限,这一张没有出现,但一张不足以说明它已解决。
天气 App 界面:提示词指定了“Lisbon 23°C Sunny”和周一到周五的 23、21、19、22、24,三家都写对。差别在没要求的内容:
- 2.1 加了空气质量、湿度 42%、风速 12 km/h;
- Pro 加得最多,体感温度、紫外线指数、每天的最高最低温、逐小时预报、风速气压,周五那张卡片还超出了手机屏幕边缘;
- GPT Image 2.5 只加了状态栏和城市风景,最干净。
做界面示意图或带数据的图,模型自行补的数字是风险:它们看起来像真数据,其实是编的。用 Pro 和 2.1 时可以在提示词里写明“不要添加其他字段”,这一招在这组测试里没有验证,出图后仍要检查一遍。
电商产品图和人像:都够真实,GPT Image 2.5 最像精修广告
黑色耳机盒放在灰色石面上:三张都能当产品图用。2.1 和 Pro 的盒子、耳机形状接近,光线柔和。GPT Image 2.5 画出的是另一种盒型和耳机,光影对比更强,最像广告精修图。如果你要的是某个具体产品,三家都需要配合参考图,单靠文字描述不能保证外形。
港口补网的老渔夫:三张皮肤纹理和光线都自然。2.1 和 Pro 偏纪实;GPT Image 2.5 把夕阳放进画面、调色更浓,更像商业摄影。
这两题没有对错,只有风格偏好。要做大批量商品图,2.1 的成本优势更重要;要做主视觉,GPT Image 2.5 的质感值得多等一会儿。
改图用哪个:耳机盒改成白色,三家都保住了构图
把同一张 2.1 生成的黑色耳机盒照片交给三个模型,要求只把充电盒改成亮面白色。结果:
- 三家都完成了改色,耳机仍是黑色,机位、石面纹理、光线和阴影与原图基本一致。
- 2.1 和 Pro 把盒盖内侧也改成了白色;GPT Image 2.5 保留了盒盖内侧的黑色。
哪种算“对”取决于你怎么理解“充电盒”:要整个盒子统一变白,2.1 和 Pro 更合适;只想改外壳、内衬保持原样,GPT Image 2.5 的处理更贴近。改图时把要改和不改的部位写具体,比换模型更有效。
Google 在模型卡里给出的自测分数也偏向 2.1:通用编辑 1026 对 Pro 的 939,蒙版或涂抹编辑 1049 对 927。但 Google 同时写明 2.1 对蒙版编辑的指令只能部分遵循。这些是 Google 自己的评测,不是独立测试。
哪个最快、最稳:2.1 和 Pro 约 20 秒,GPT VIP 线路要 1 分钟以上
| 指标 | Nano Banana 2.1 | Nano Banana Pro | GPT Image 2.5(VIP) |
|---|---|---|---|
| 9 次调用耗时 | 17.4–33.1 秒 | 17.7–22.3 秒 | 57.6–75.7 秒 |
| 中位数 | 22.2 秒 | 19.9 秒 | 66.6 秒 |
| 首次即成功 | 9/9 | 9/9 | 11 次请求中 2 次返回 503 “Upstream model service error”,重试后成功 |
| 思考 token | 146–1,704 | 122–252 | — |
2.1 最慢的一张是中文菜单(33.1 秒),这道题它的思考 token 也有 1,352 个;文字越多,2.1 想得越久,耗时和费用都会上去。Pro 的思考 token 少得多,耗时也更平稳。
GPT Image 2.5 慢了约 3 倍,而且偶尔需要重试。写批量脚本时要把超时设到 2 分钟以上,并对 503 自动重试。注意这只是 VIP 线路的表现,OpenAI 直连的速度不在这组测试的范围内。
每张多少钱:官方单价与老张API 按次价
| 每张图 | Nano Banana 2.1 | Nano Banana Pro | GPT Image 2.5 Sunburst |
|---|---|---|---|
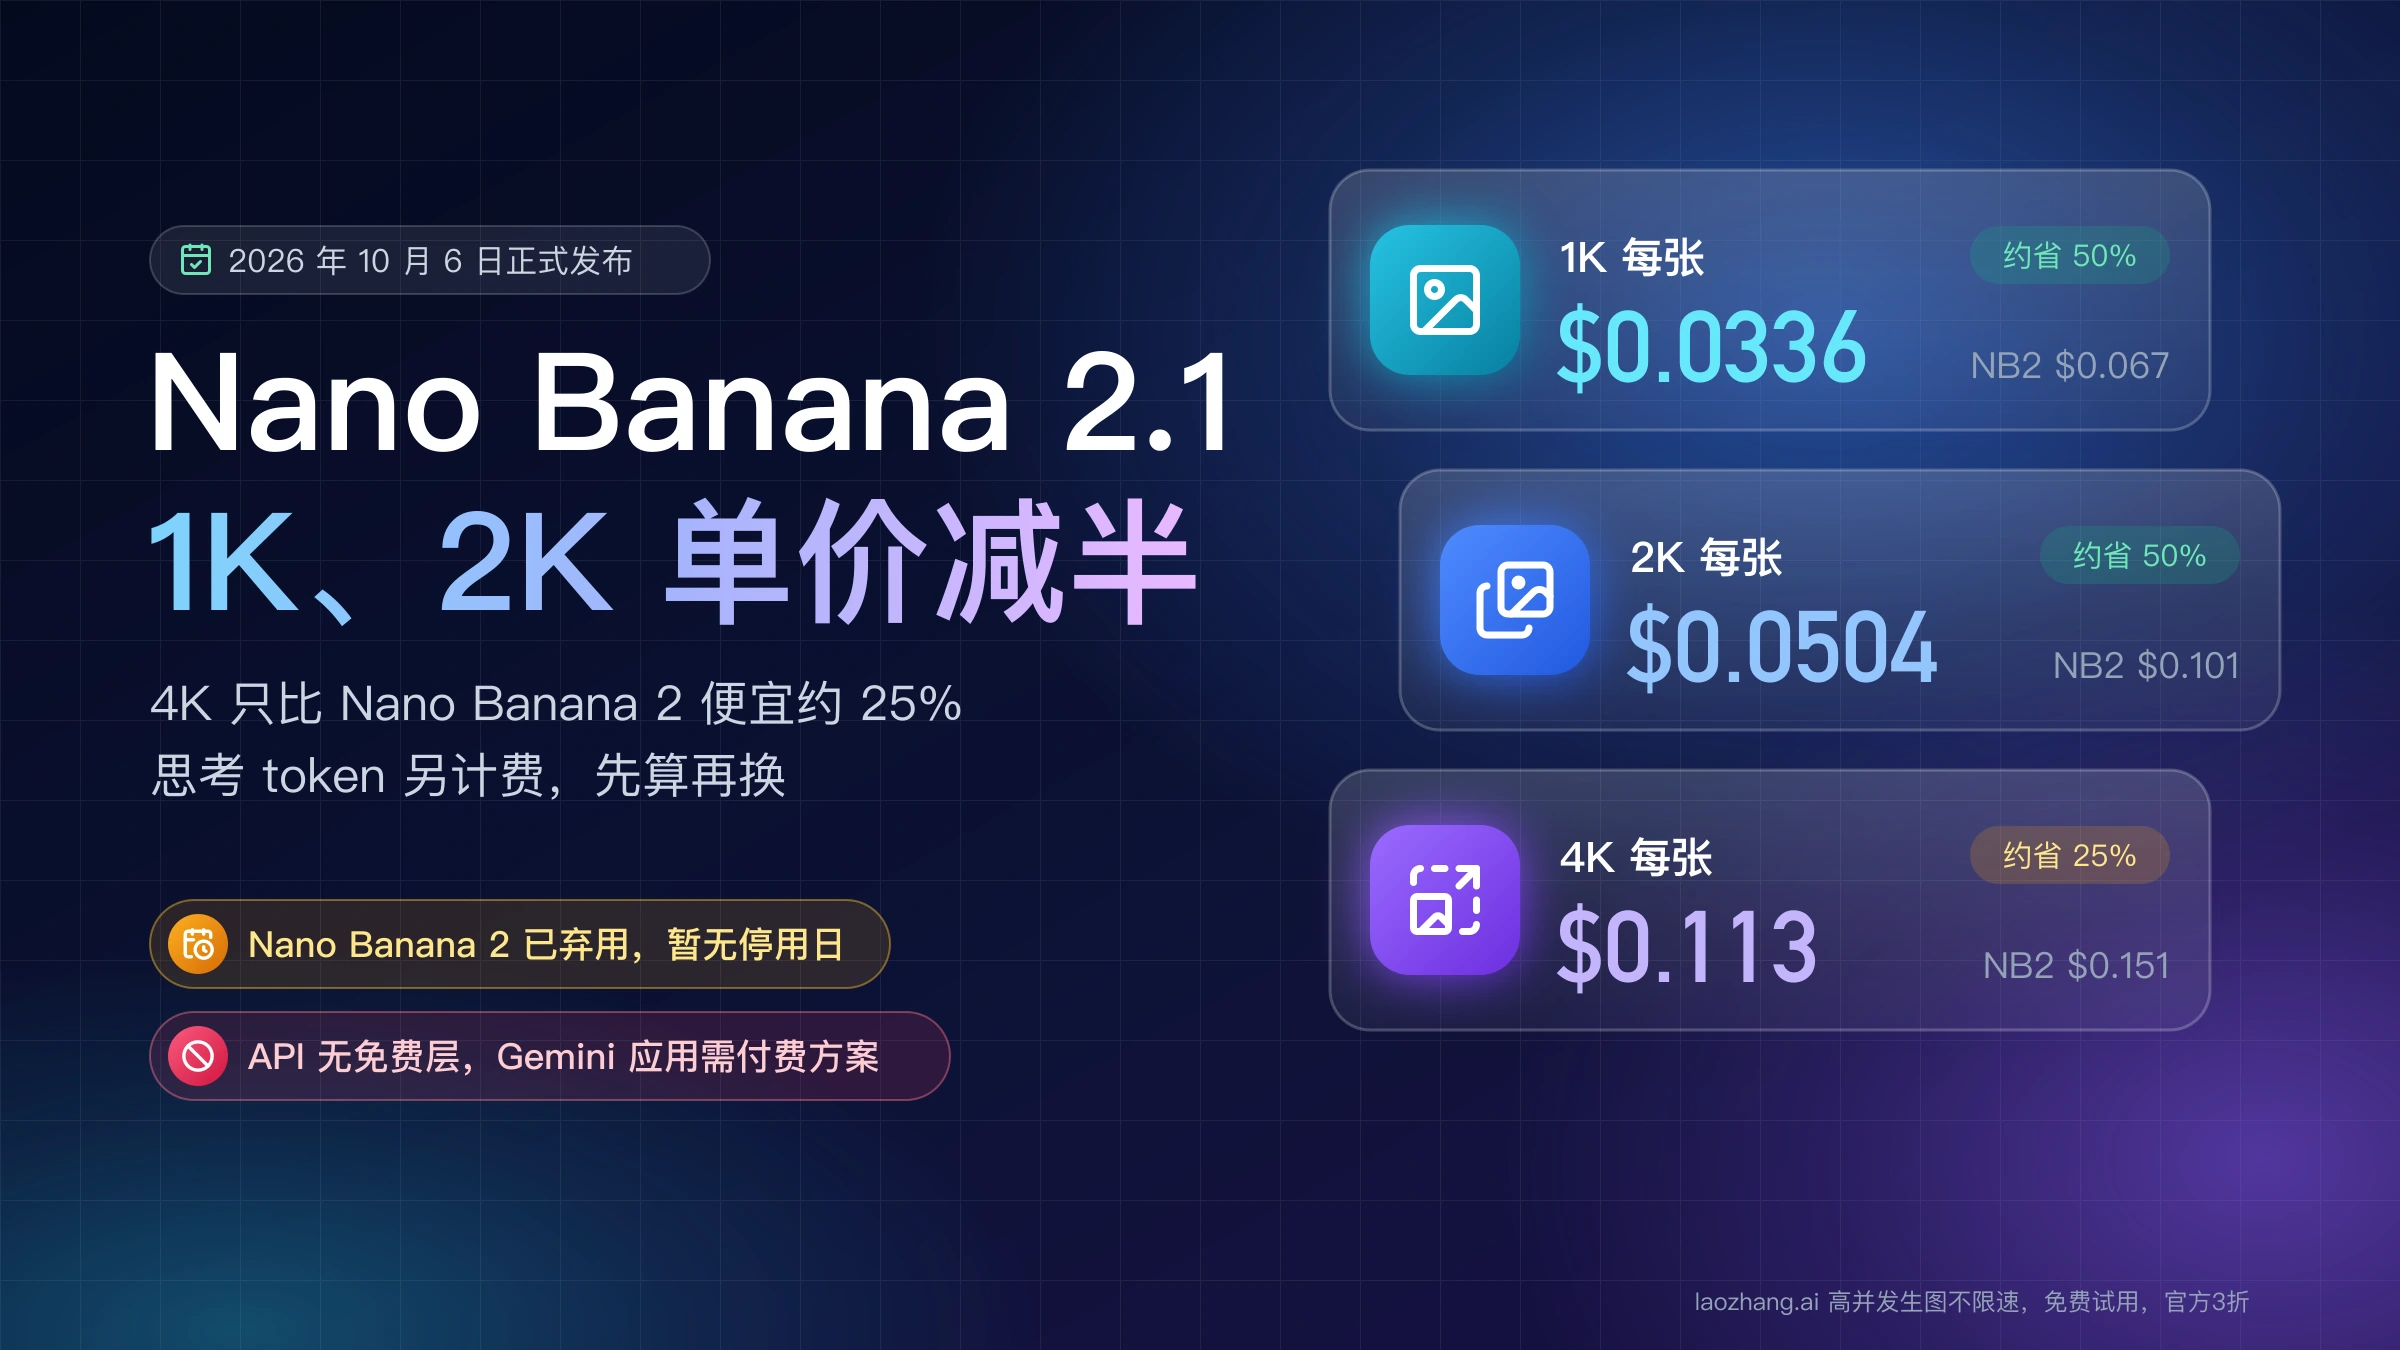
| 官方 1K | $0.0336 + 思考 token | $0.134 | 约 $0.053(high,推算) |
| 官方 2K | $0.0504 | $0.134 | 按 token 计 |
| 官方 4K | $0.113 | $0.24 | 按 token 计 |
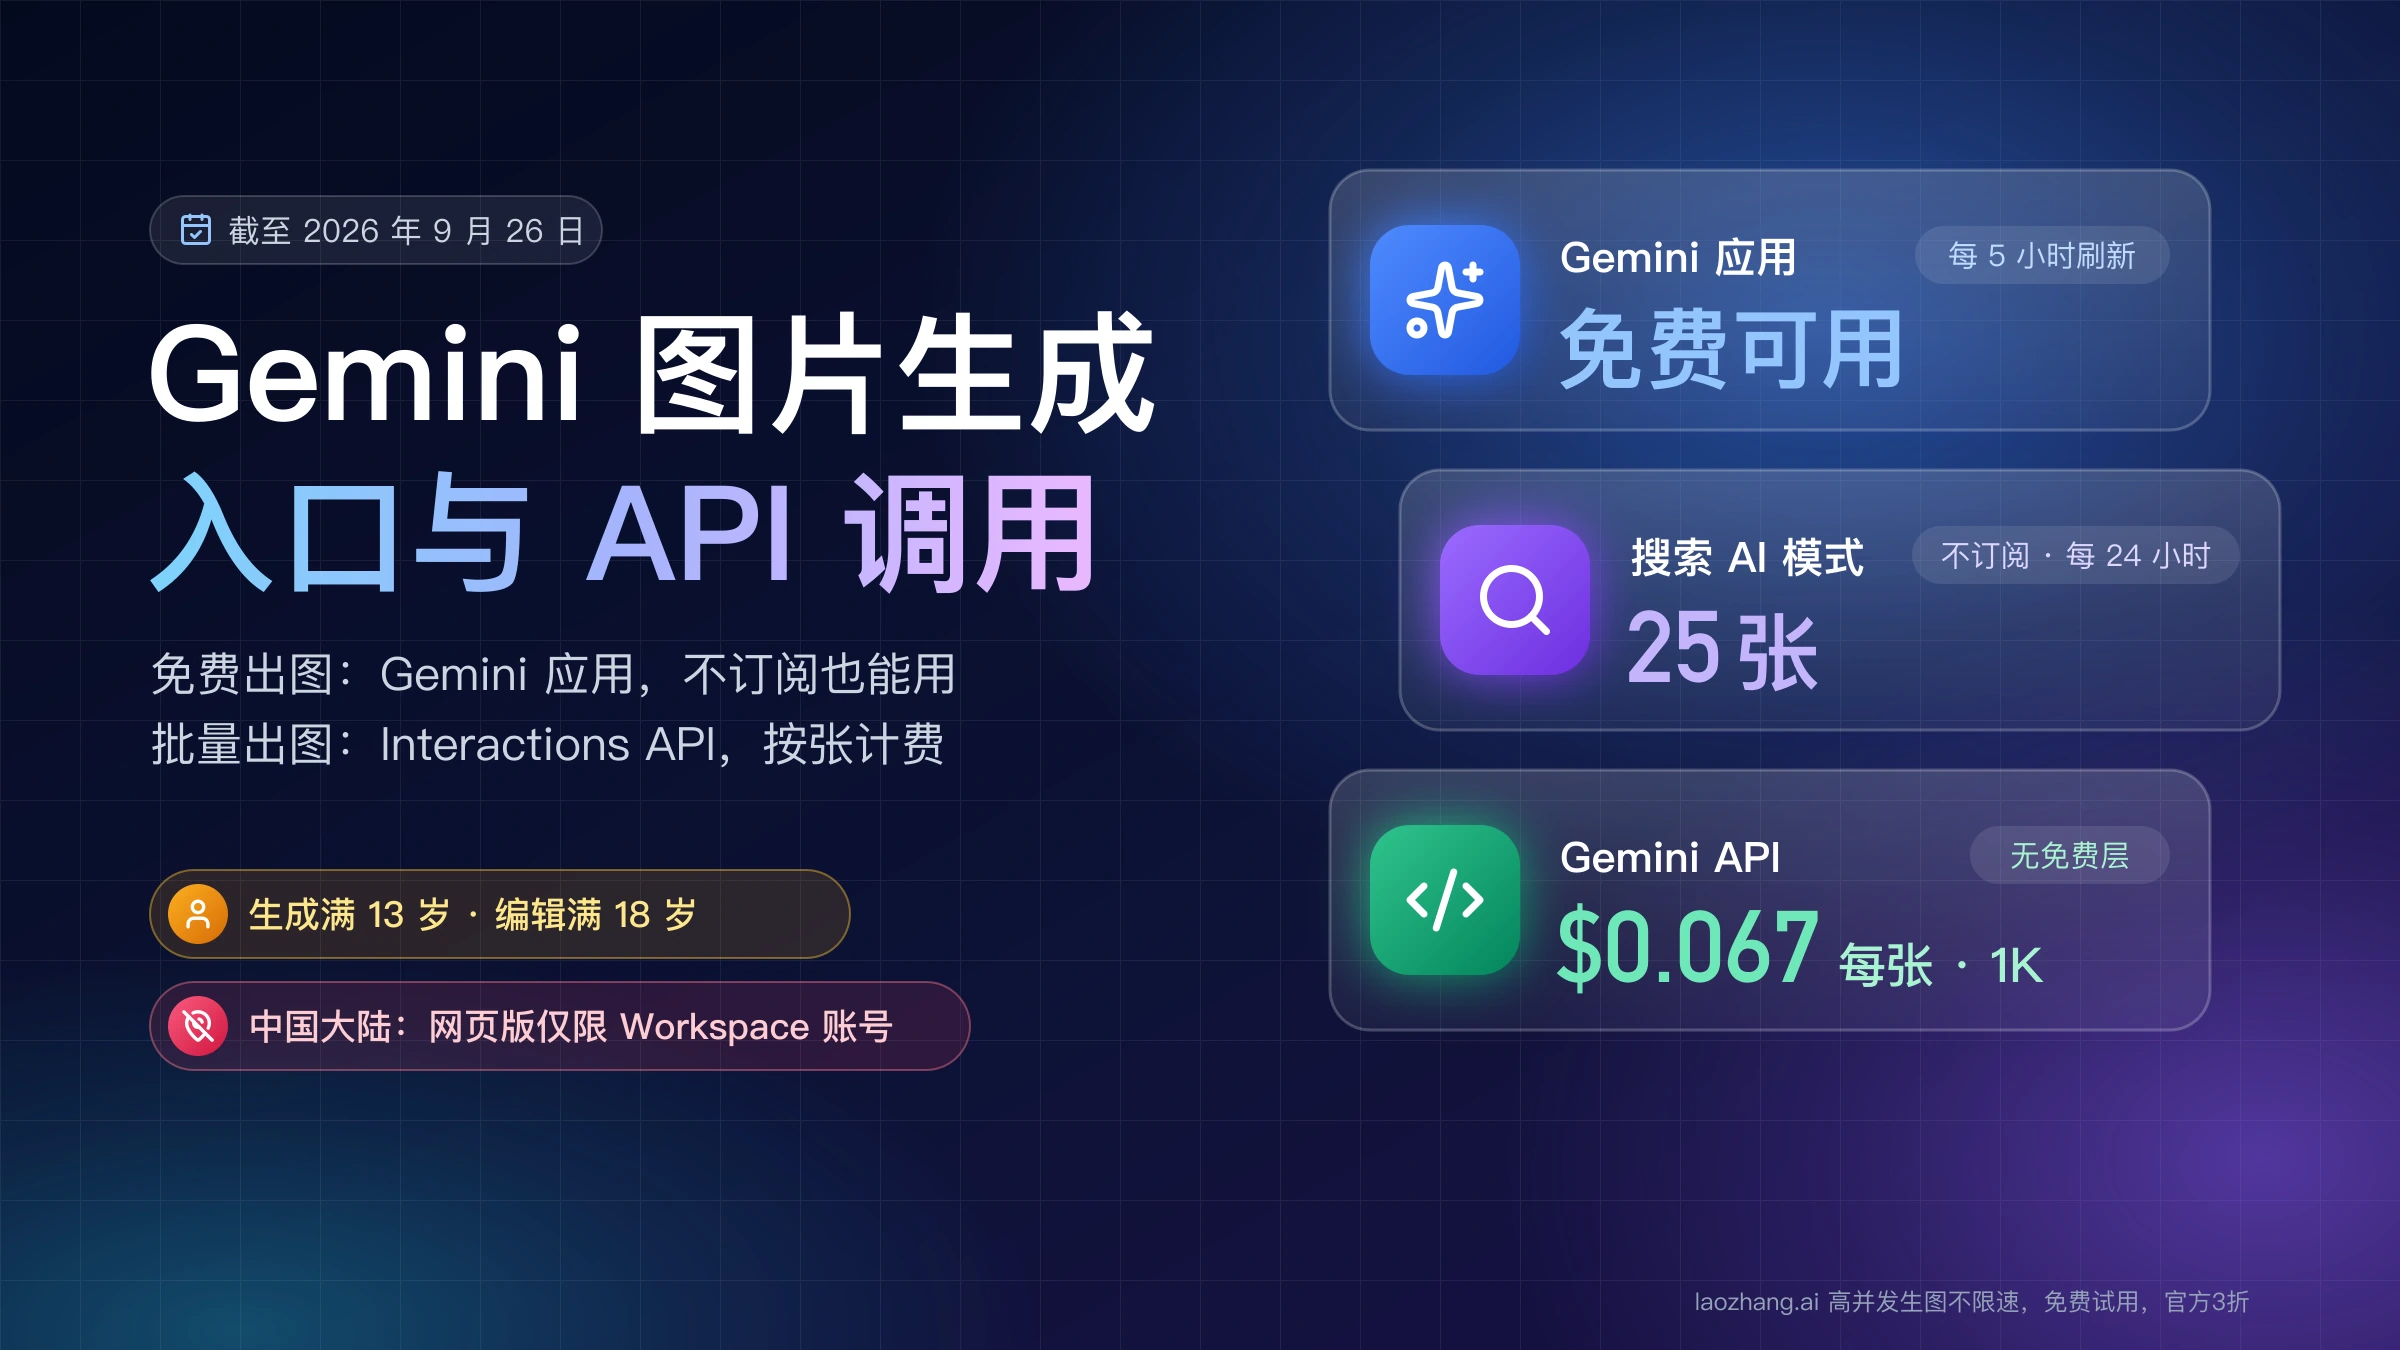
| 老张API 按次 | $0.045(任意尺寸) | $0.09 | $0.03(VIP 线路) |
| 100 张 1K,官方 | $3.36 起 | $13.40 | 约 $5.27 |
| 100 张,老张API | $4.50 | $9.00 | $3.00 |
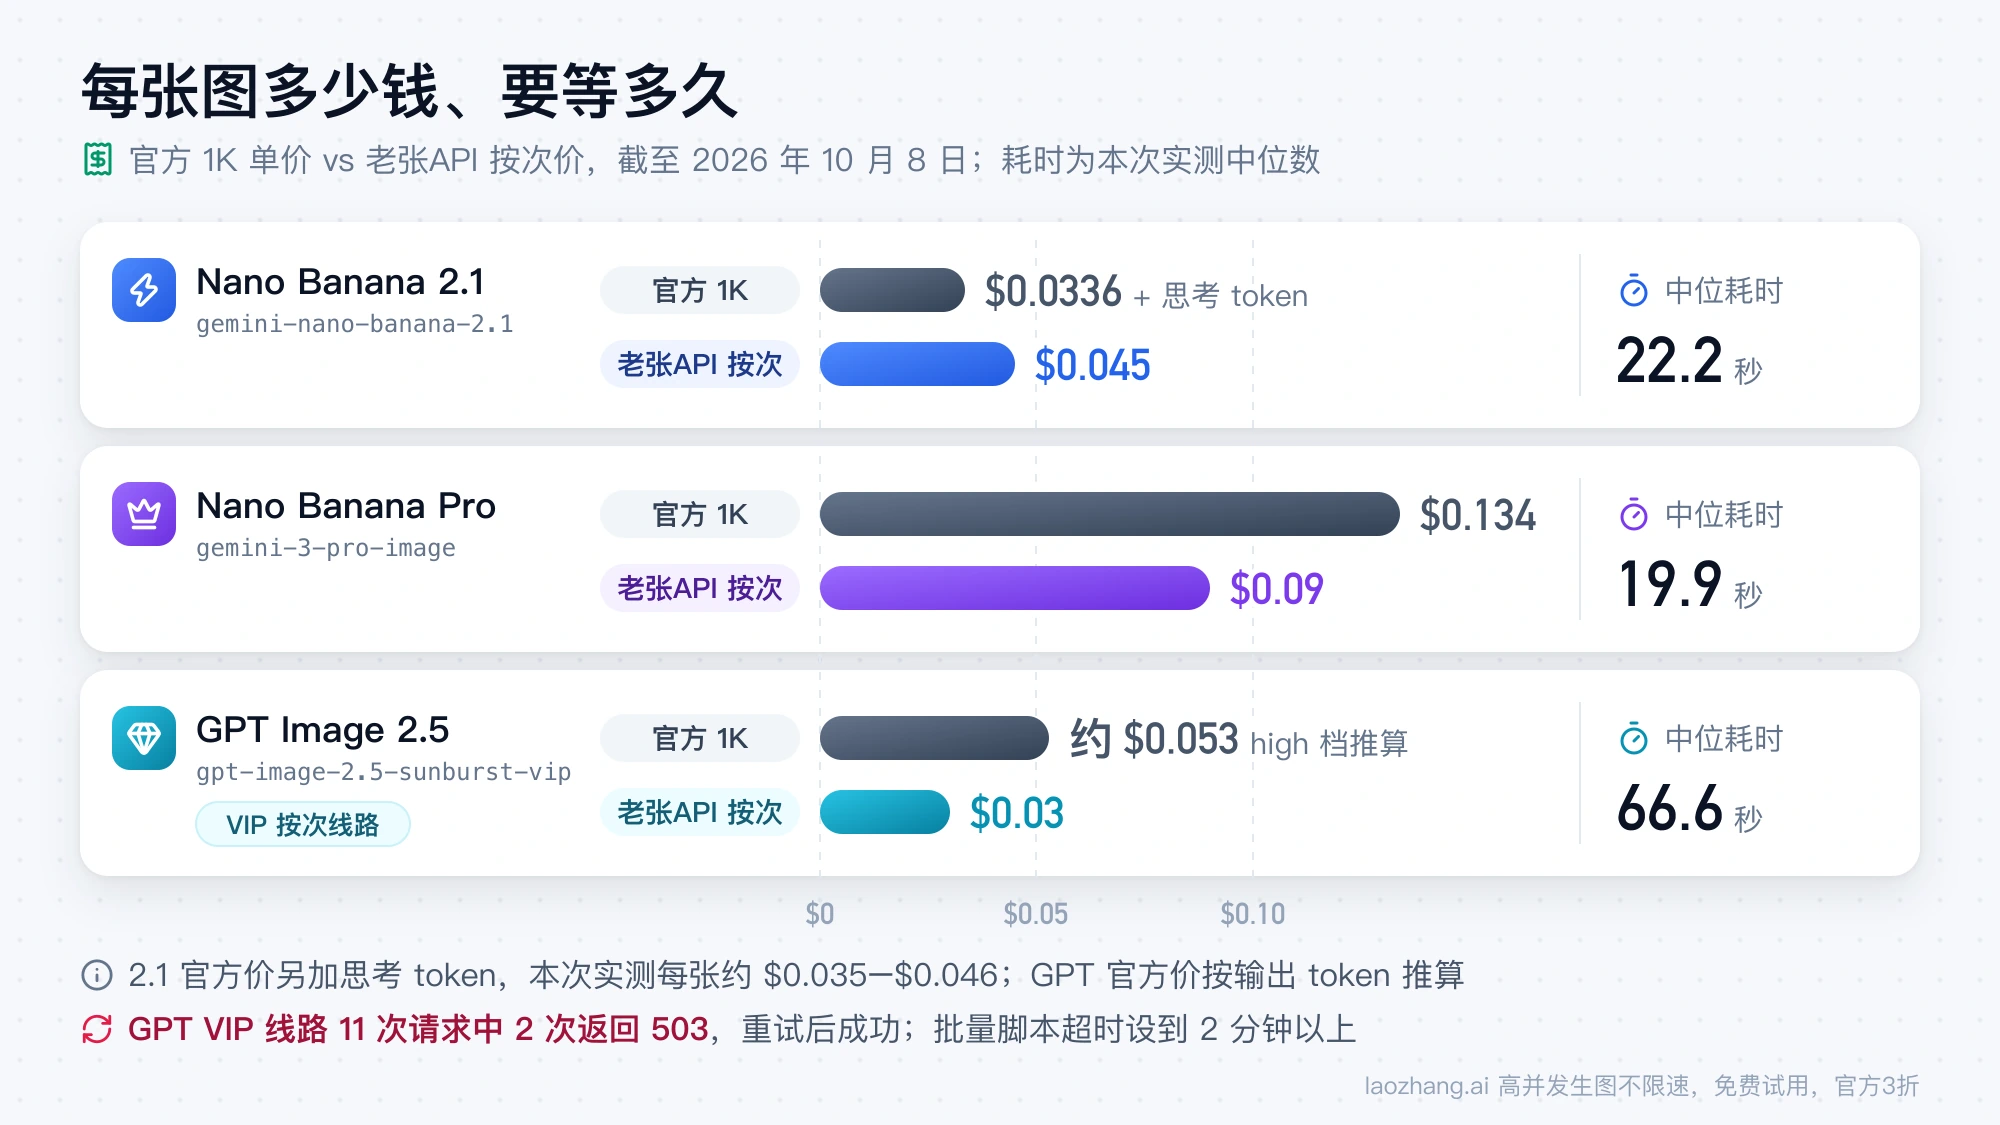
几个口径说明:
- Google 官方价取自 Gemini API 价格页的标准档图片输出单价,截至 2026 年 10 月 8 日;Batch 模式各档减半。输入和思考 token 另计:2.1 的文本与思考输出是每 100 万 token $7.50。按这组测试的 146–1,704 个思考 token 算,2.1 一张 1K 图的官方实际成本约为 $0.0336 + $0.0011 至 $0.0128,也就是 $0.035–$0.046;文字越多越接近上限。
- GPT Image 2.5 官方价按 OpenAI API 价格页的图片输出 $30/100 万 token 计。VIP 线路回报的每张输出图片 token 是 1,756,1,756 × $30 ÷ 1,000,000 ≈ $0.053,未含输入 token,是推算不是账单。OpenAI 计算器对 1024×1024 的估算从 low 档 $0.0059 到 max 档 $0.2107,画质档位对成本影响很大。
- 老张API 按次价是每次成功调用固定扣费,2.1 不分尺寸都是 $0.045,所以出 2K、4K 时比官方便宜;1K 时官方价通常更低,文字多、思考 token 高时两者接近。
Pro 和 2.1 的价差:官方 1K 约 4 倍($0.134 对 $0.0336),2K 约 2.7 倍,4K 约 2.1 倍;老张API 按次是 2 倍($0.09 对 $0.045)。
各模型的完整价格拆分见 Nano Banana 2.1 价格与入口和 Nano Banana Pro 多少钱?API、订阅与每张合格图成本。还在用 Nano Banana 2 的,可以对照 Nano Banana 2 API 价格,它已弃用,同尺寸下 2.1 更便宜。
不写代码、只在 Gemini 应用里用的话:截至 2026 年 10 月 8 日,2.1 需要 Google AI Pro、Plus 或 Ultra 订阅,免费用户用的是 Nano Banana 2;付费用户还可以把不满意的图交给 Pro 重新生成(英文界面里叫“Redo with Pro”)。
Nano Banana 2.1 和 Pro 的区别:Pro 贵 2–4 倍,照抄文字更稳
把上面的结果合在一起,2.1 和 Pro 的区别可以这样理解:
- 价格:Pro 每张贵 2–4 倍,取决于尺寸和计费方式。
- 文字:这组测试里,Pro 三道精确文字题都保留了每个指定的词和数字,只有菜单上的“单”写成了“単”;2.1 三道都有额外偏差。只要图上的字要原样交付,Pro 更省返工。
- 信息图、改图、计数:两者都做对了,2.1 更便宜。
- 速度:两者都在 20 秒左右,Pro 更平稳。
- 规格:2.1 最多 14 张参考图,可保持最多 4 个角色和 10 个物体,支持 1:8、8:1 等 14 种比例,支持用 Google 网页搜索和图片搜索建立依据,但没有 0.5K;Pro 支持 6 个物体、5 个角色的参考,只支持网页搜索。多角色、多商品合成的需求,规格上 2.1 更宽,但这组测试没验证。
Google 自己的评测和这组测试有一处看似矛盾:Google 模型卡里,2.1(开启思考)的总体偏好分是 1050,Pro 是 935;信息图事实准确率 0.521 对 0.265。这是 Google 的内部人工评测,衡量的是整体观感和信息图事实,不是“照抄指定文字”。两者并不冲突:2.1 整体画得更好,但更爱自行调整文字。
第三方的 Arena 文生图盲评榜(榜单页显示 2026 年 10 月 6 日更新)也是同样的方向:GPT Image 2.5 Sunburst 第 1(1425 分),2.1 第 5(1328 分),Pro 2K 第 16(1248 分)。GPT Image 2.5 Sunburst 和 2.1 的分数仍标为初步结果,票数少、名次每天会变,而且盲评只看单张图的观感,不反映文字准确度、改图和成本。
GPT Image 2.5 只测了 Sunburst:Flare 和 GPT Image 2 另看
这组测试只跑了 Sunburst。GPT Image 2.5 另有一个 Flare 变体,两者在速度、编辑精度和价格上的取舍见 GPT Image 2.5 Flare 与 Sunburst 对比;如果你现在用的是 GPT Image 2,是否值得换见 GPT Image 2.5 与 GPT Image 2:换还是留。
GPT Image 2.5 的尺寸上限是 3840×2160 或 2880×2880,支持自定义尺寸,画质从 low 到 max 可调。要输出大尺寸横幅或特殊比例,它比两个 Nano Banana 模型更灵活。
常见问题
Nano Banana 2.1 和 Pro 哪个更好?
看任务。图上的文字要一字不差,Pro 更稳;信息图、批量产品图、改图,2.1 做得一样好,价格只有 Pro 的四分之一到二分之一。Google 自己的评测里 2.1 总体得分高于 Pro,但这组同题测试里 2.1 三道文字题都改写了原文。
2.1 和 GPT Image 2.5 谁的文字更准?
这组测试里 GPT Image 2.5 更准:英文海报、日文招牌一字不差,中文菜单的价格也照原文写对,2.1 三题都有偏差。不过 GPT Image 2.5 也把“单”写成了“単”,而且结果来自老张API 的 VIP 线路,每题只有一张。
做中文海报、菜单用哪个模型?
用 Pro 或 GPT Image 2.5 出图,价格和数字更可靠;然后逐字校对,三个模型都把简体“单”写成了日文字形“単”。2.1 可能把阿拉伯数字改写成汉字。
三个模型哪个最便宜?
按老张API 按次价,GPT Image 2.5 VIP 线路 $0.03 最低,2.1 $0.045,Pro $0.09。按官方 1K 单价,2.1 的 $0.0336 最低(另加思考 token),GPT Image 2.5 high 档约 $0.053,Pro $0.134。
参考来源3
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月8日。
参考来源3
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月8日。