Nano Banana API 不出图:按返回字段逐项排查
Nano Banana API 没拿到图,先看 finishReason 或 status:只回文字、NO_IMAGE、安全拦截、模型下线各有对应处理,拦截类原样重试无效。
文章目录
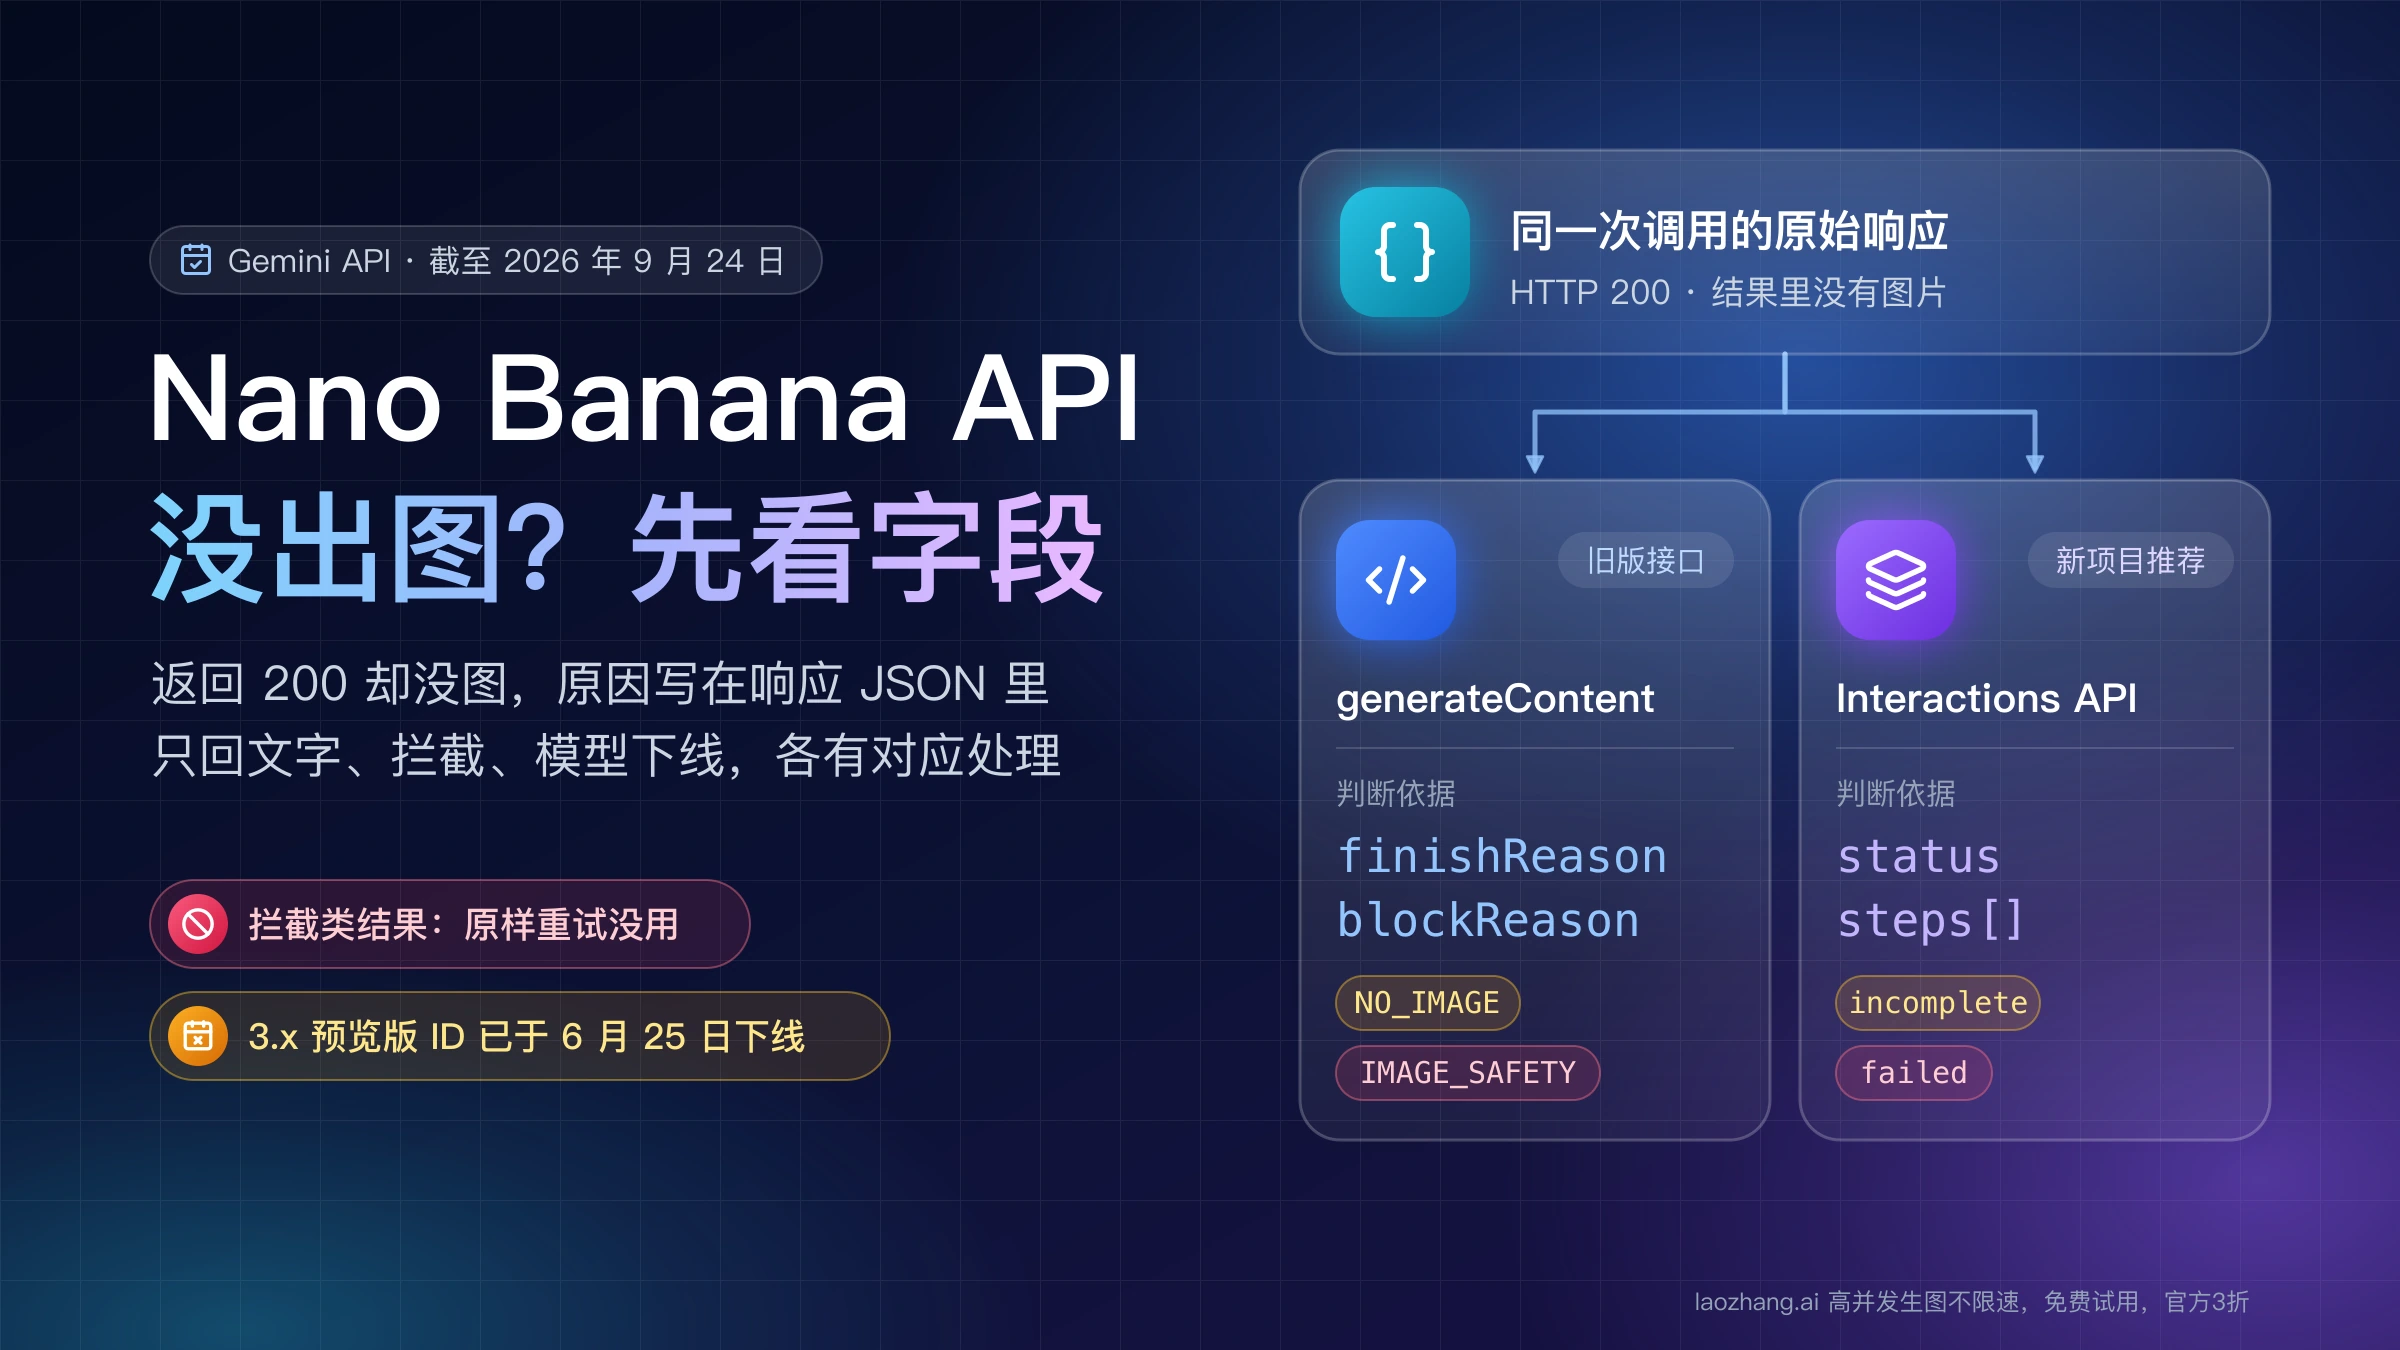
Nano Banana 的 API 调用返回了 200,却没有图片,原因要到返回的 JSON 里找:用 generateContent 就看 promptFeedback.blockReason 和每个候选的 finishReason,用 Interactions API 就看 status 和 steps。只回了文字、finishReason 是 NO_IMAGE、被 IMAGE_SAFETY 一类规则拦下、模型 ID 已经下线,这几种情况的处理办法各不相同;其中拦截类结果,原样重试多少次都一样。下面的对照表和检查脚本对应截至 2026 年 9 月 24 日的 Gemini API 文档。
在 Gemini 网页版或 App 里直接生成图片、不写代码的情况,请看 Nano Banana 无法生成图片?Gemini 图片错误的 12 个修复分支。这里只处理 Gemini API、AI Studio、官方 SDK,以及基于 API 的客户端和工具。
先排除模型 ID 已下线
模型 ID 停止服务后,请求会直接报错,而不是“返回了但没图”。如果你的代码、教程或客户端预设是今年 6 月以前写的,先看一眼模型名:
| 名称 | 模型 ID | 状态(截至 2026 年 9 月 24 日) |
|---|---|---|
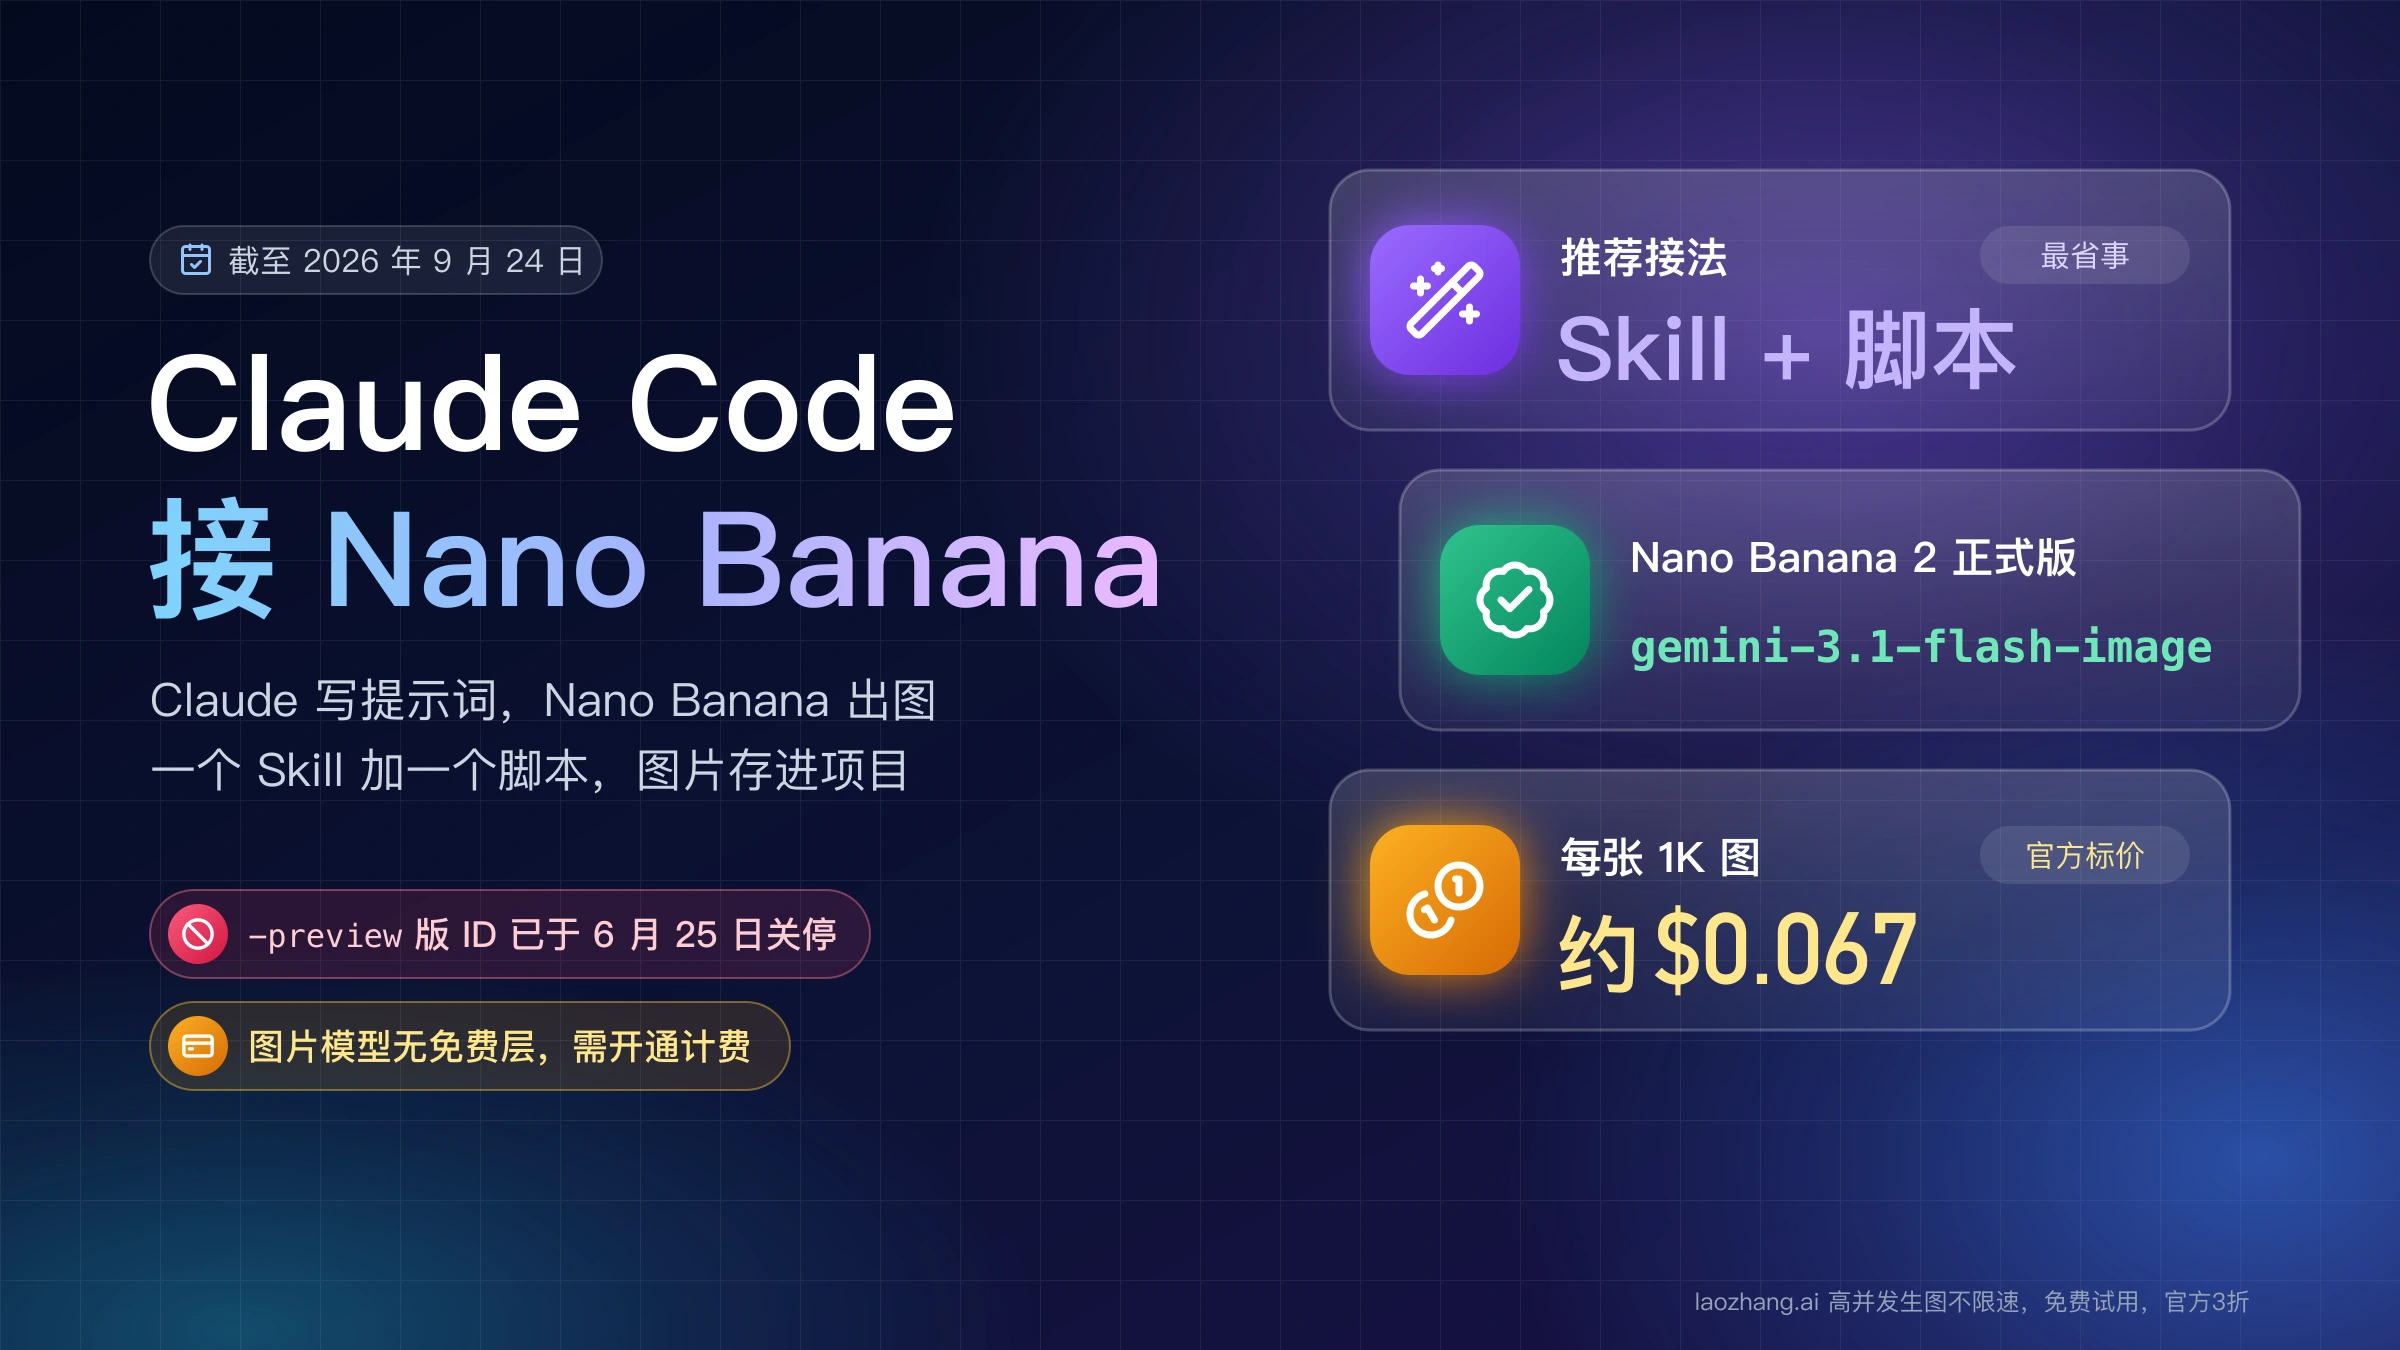
| Nano Banana 2 | gemini-3.1-flash-image | 2026 年 5 月 28 日正式发布,未公布下线日期 |
| Nano Banana Pro | gemini-3-pro-image | 2026 年 5 月 28 日正式发布,未公布下线日期 |
| Nano Banana 2 Lite | gemini-3.1-flash-lite-image | 2026 年 6 月 30 日正式发布 |
| Nano Banana(原版) | gemini-2.5-flash-image | 2026 年 10 月 2 日下线 |
| 已停止服务 | gemini-3.1-flash-image-preview、gemini-3-pro-image-preview | 2026 年 6 月 25 日下线,改用上面对应的正式版 ID |
| 已停止服务 | gemini-2.5-flash-image-preview | 2026 年 1 月 15 日下线 |
| 已停止服务 | gemini-2.0-flash-preview-image-generation | 2025 年 11 月 14 日下线 |
来源:Google 的 Gemini API 弃用时间表 与 图片生成文档。
从 -preview 版迁到正式版,只需要换模型 ID,请求和解析代码不用改。原版 gemini-2.5-flash-image 在 2026 年 10 月 2 日下线,还在用的要尽快迁移:Google 在图片生成文档里建议换到 Nano Banana 2 Lite(gemini-3.1-flash-lite-image);弃用表给原版列的替代 ID 却是 gemini-3.1-flash-image-preview,这个 ID 本身已经停止服务,照抄会再失败一次。迁移时选哪个模型,见 Nano Banana 2、2.1、Pro 和 Lite 区别怎么选:2 已弃用。用 generateContent 时,响应里的 modelStatus 字段如果带有 retirementTime,就是当前模型的退役时间,可以顺手记进日志。
存下一次失败的原始响应
SDK 的便捷属性(Python 的 response.parts、Interactions 的 interaction.output_image)会替你挑内容,排查时要看完整的 JSON。Gemini API 现在有两套接口,结构不同,不能混着判断:
- generateContent:图片在
candidates[].content.parts[]的inlineData里,每个候选有自己的finishReason;提示词被拦时,candidates为空,原因写在promptFeedback.blockReason。Google 已把它标为旧版接口,但仍然完整支持。 - Interactions API:2026 年 6 月正式发布,Google 建议新项目使用。结果看顶层
status,图片是steps[]中type为model_output的那一步里、type为image的内容块。
最直接的办法是用 curl 按原参数重发一次,把 HTTP 状态码和响应体分开保存:
# generateContent
curl -s -X POST \
  "https://generativelanguage.googleapis.com/v1/models/gemini-3.1-flash-image:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [{"parts": [{"text": "生成一张图片:雨后的老街,暖色路灯,电影感构图"}]}],
    "generationConfig": {"responseModalities": ["TEXT", "IMAGE"]}
  }' \
  -o resp.json -w "HTTP %{http_code}\n"

# Interactions API
curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.1-flash-image",
    "input": [{"type": "text", "text": "生成一张图片:雨后的老街,暖色路灯,电影感构图"}]
  }' \
  -o interaction.json -w "HTTP %{http_code}\n"
用 Python SDK 调 generateContent 的,可以把响应对象直接写成文件:open("resp.json", "w").write(response.model_dump_json(exclude_none=True)),导出的字段名是 finish_reason 这类下划线写法,后面的脚本两种写法都认。
HTTP 状态码不是 200 时,问题出在请求本身,不属于“没图”。429 是额度或速率限制,见 Nano Banana 2 限制与每日额度:按算力还是按张;Nano Banana 2 和 Pro 在价格表的免费层一栏都标为不可用。其他 4xx 先核对模型 ID 和参数。
按响应形态对照下一步
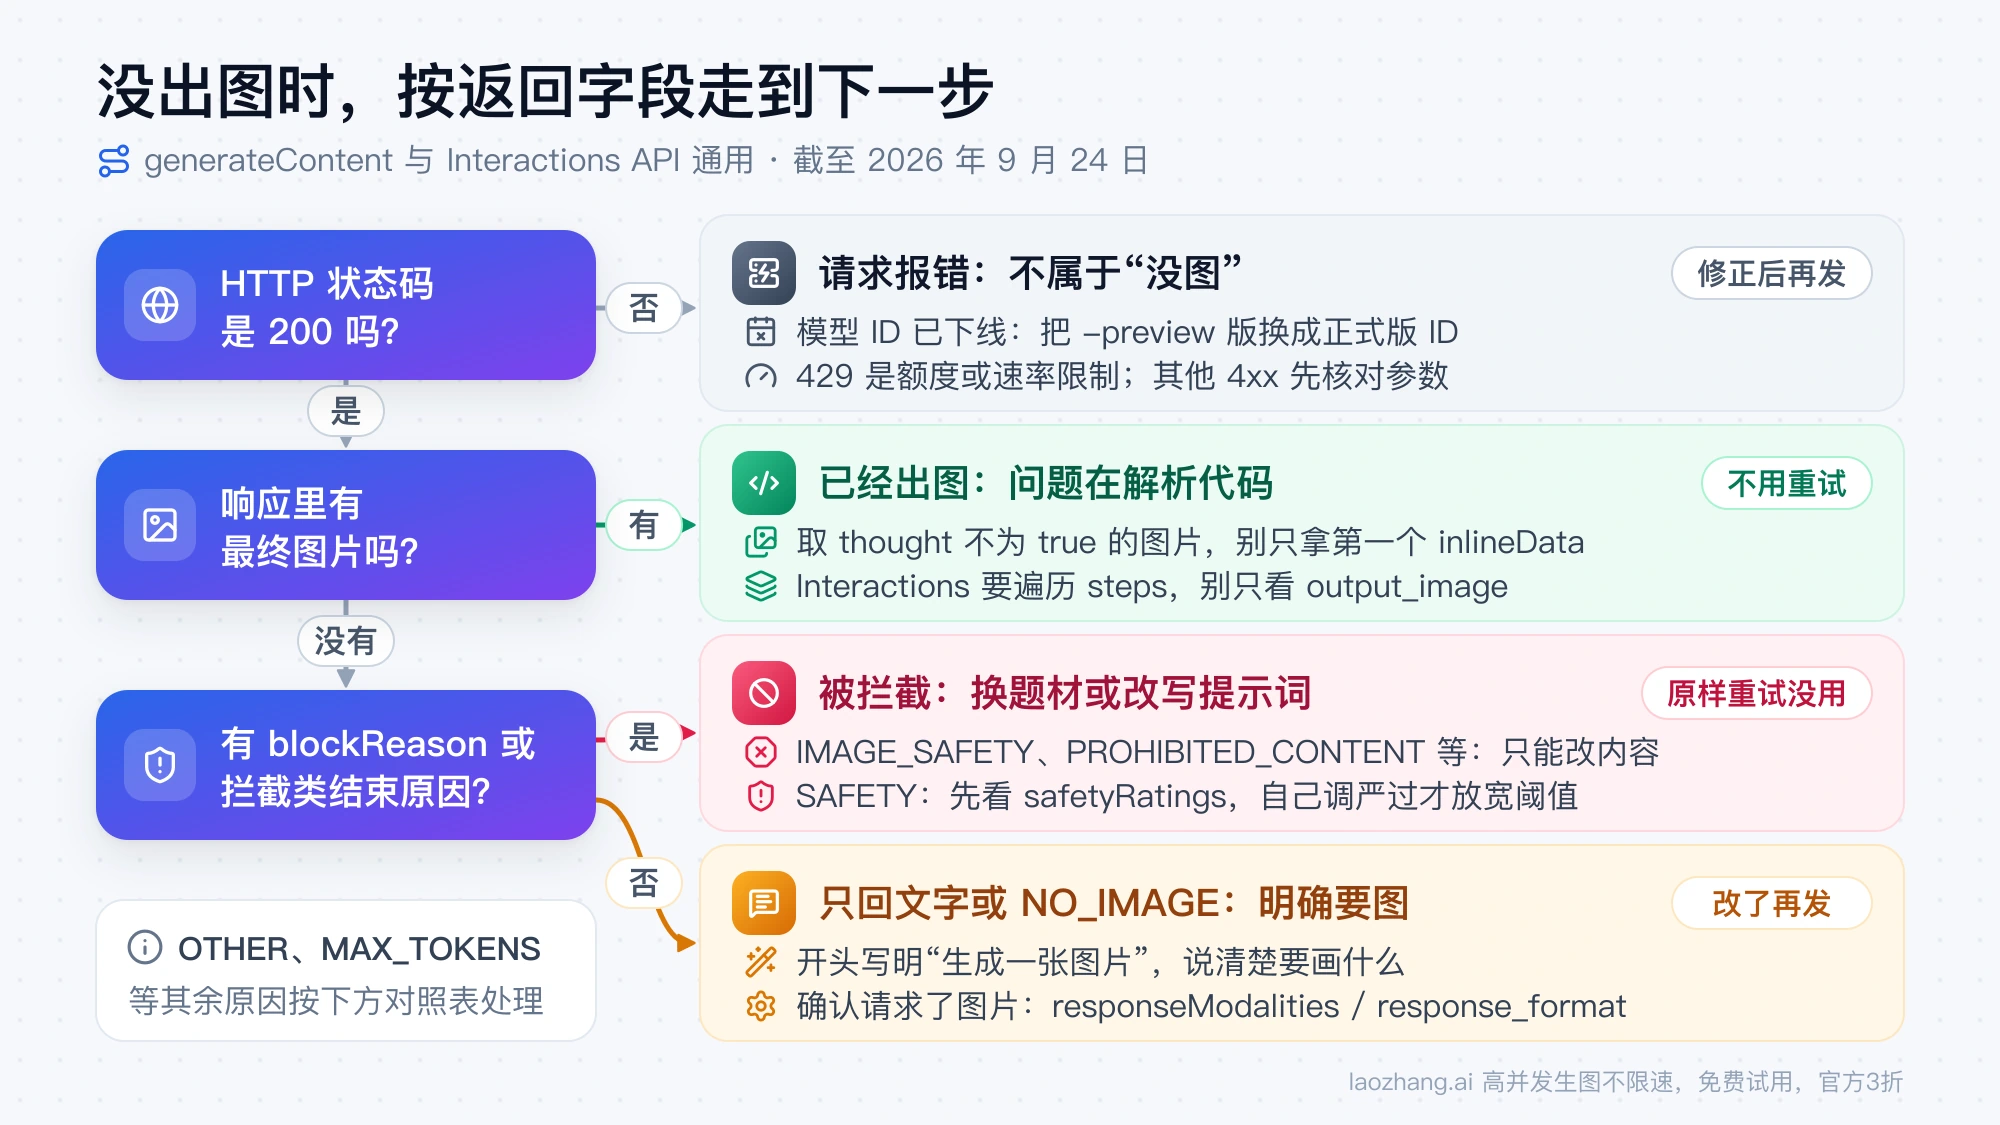
generateContent
| 你看到的 | 含义 | 下一步 | 原样重试 |
|---|---|---|---|
candidates 为空,promptFeedback.blockReason 有值 | 提示词在生成前就被拦下 | 按 blockReason 改写提示词 | 没用 |
finishReason: STOP,parts 里只有文字 | 模型把请求当成了对话 | 明确写出“生成一张图片”,确认请求了图片输出 | 改了再发 |
NO_IMAGE | 按请求本该出图,但模型没生成 | 同上,并把请求拆简单 | 可以再试一次 |
IMAGE_SAFETY、IMAGE_PROHIBITED_CONTENT | 生成的图片触犯安全或禁止内容规则 | 换题材或描述方式 | 没用 |
SAFETY | 内容被安全过滤器标记,类别看 safetyRatings | 自己设过阈值就核对设置,否则改写内容 | 没用 |
PROHIBITED_CONTENT、BLOCKLIST、SPII | 禁止内容、屏蔽词、敏感个人信息 | 删掉相关内容 | 没用 |
IMAGE_RECITATION、RECITATION | 输出与已有素材过于相似 | 让描述更原创,少复刻具体作品 | 改了再发 |
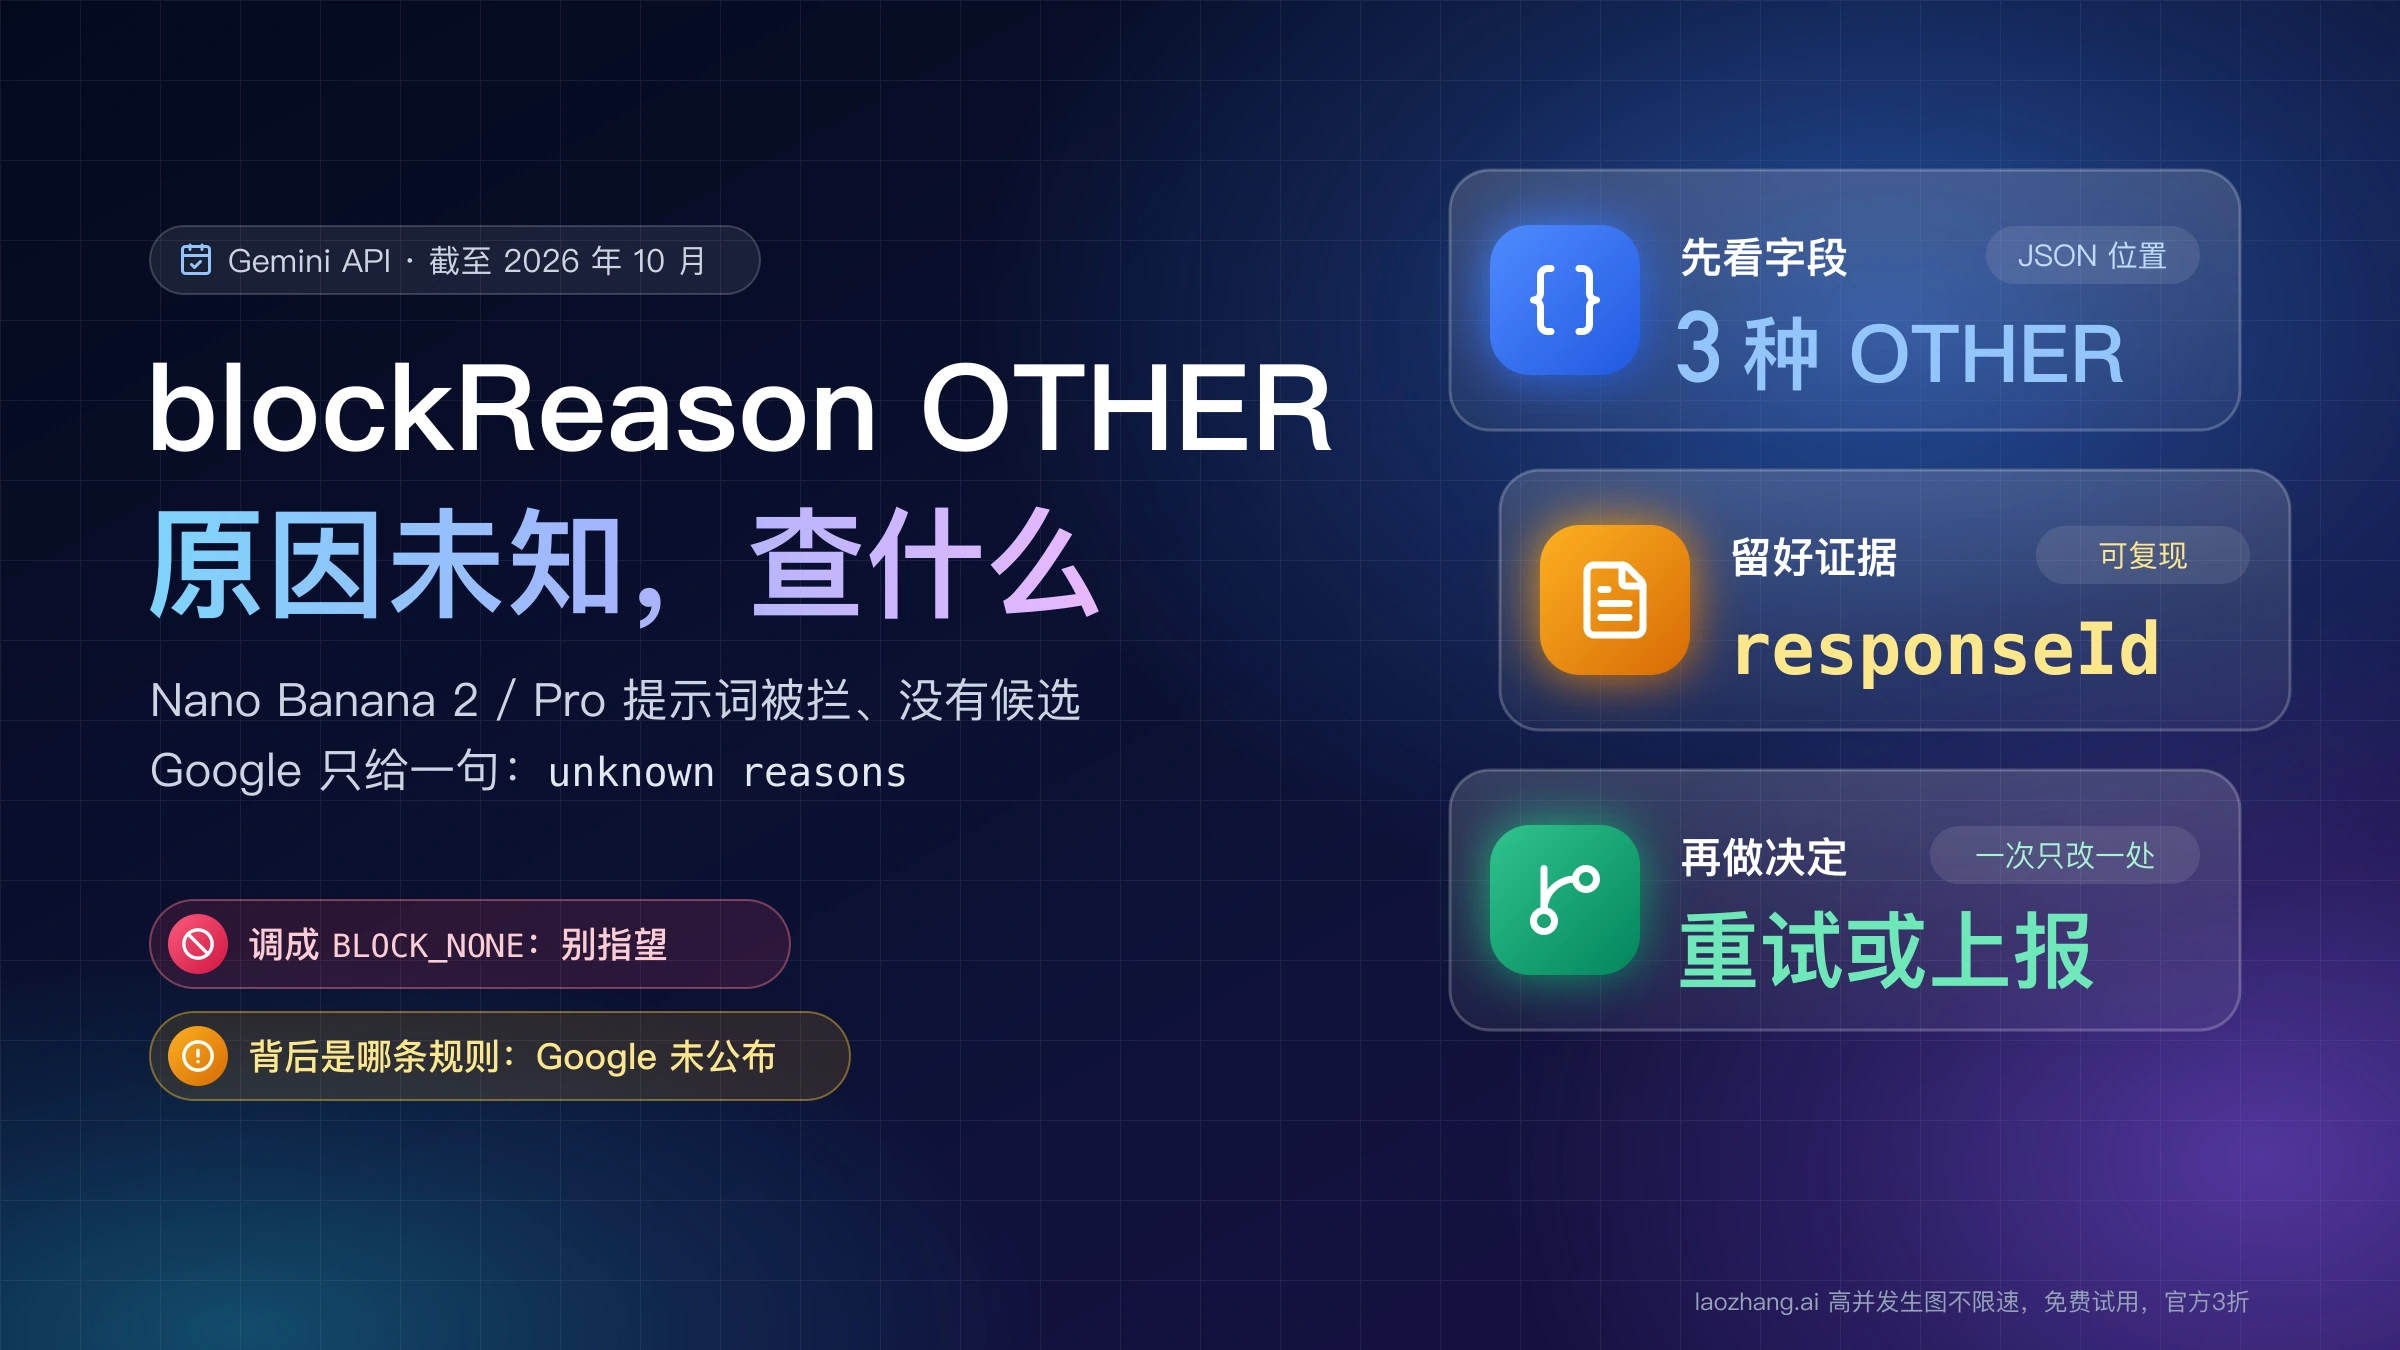
IMAGE_OTHER、OTHER | 文档只写“其他原因” | 保存响应,重试一次;再出现就改提示词 | 最多一次 |
MAX_TOKENS | 触到输出 token 上限 | 去掉或调高 maxOutputTokens | 改参数后再发 |
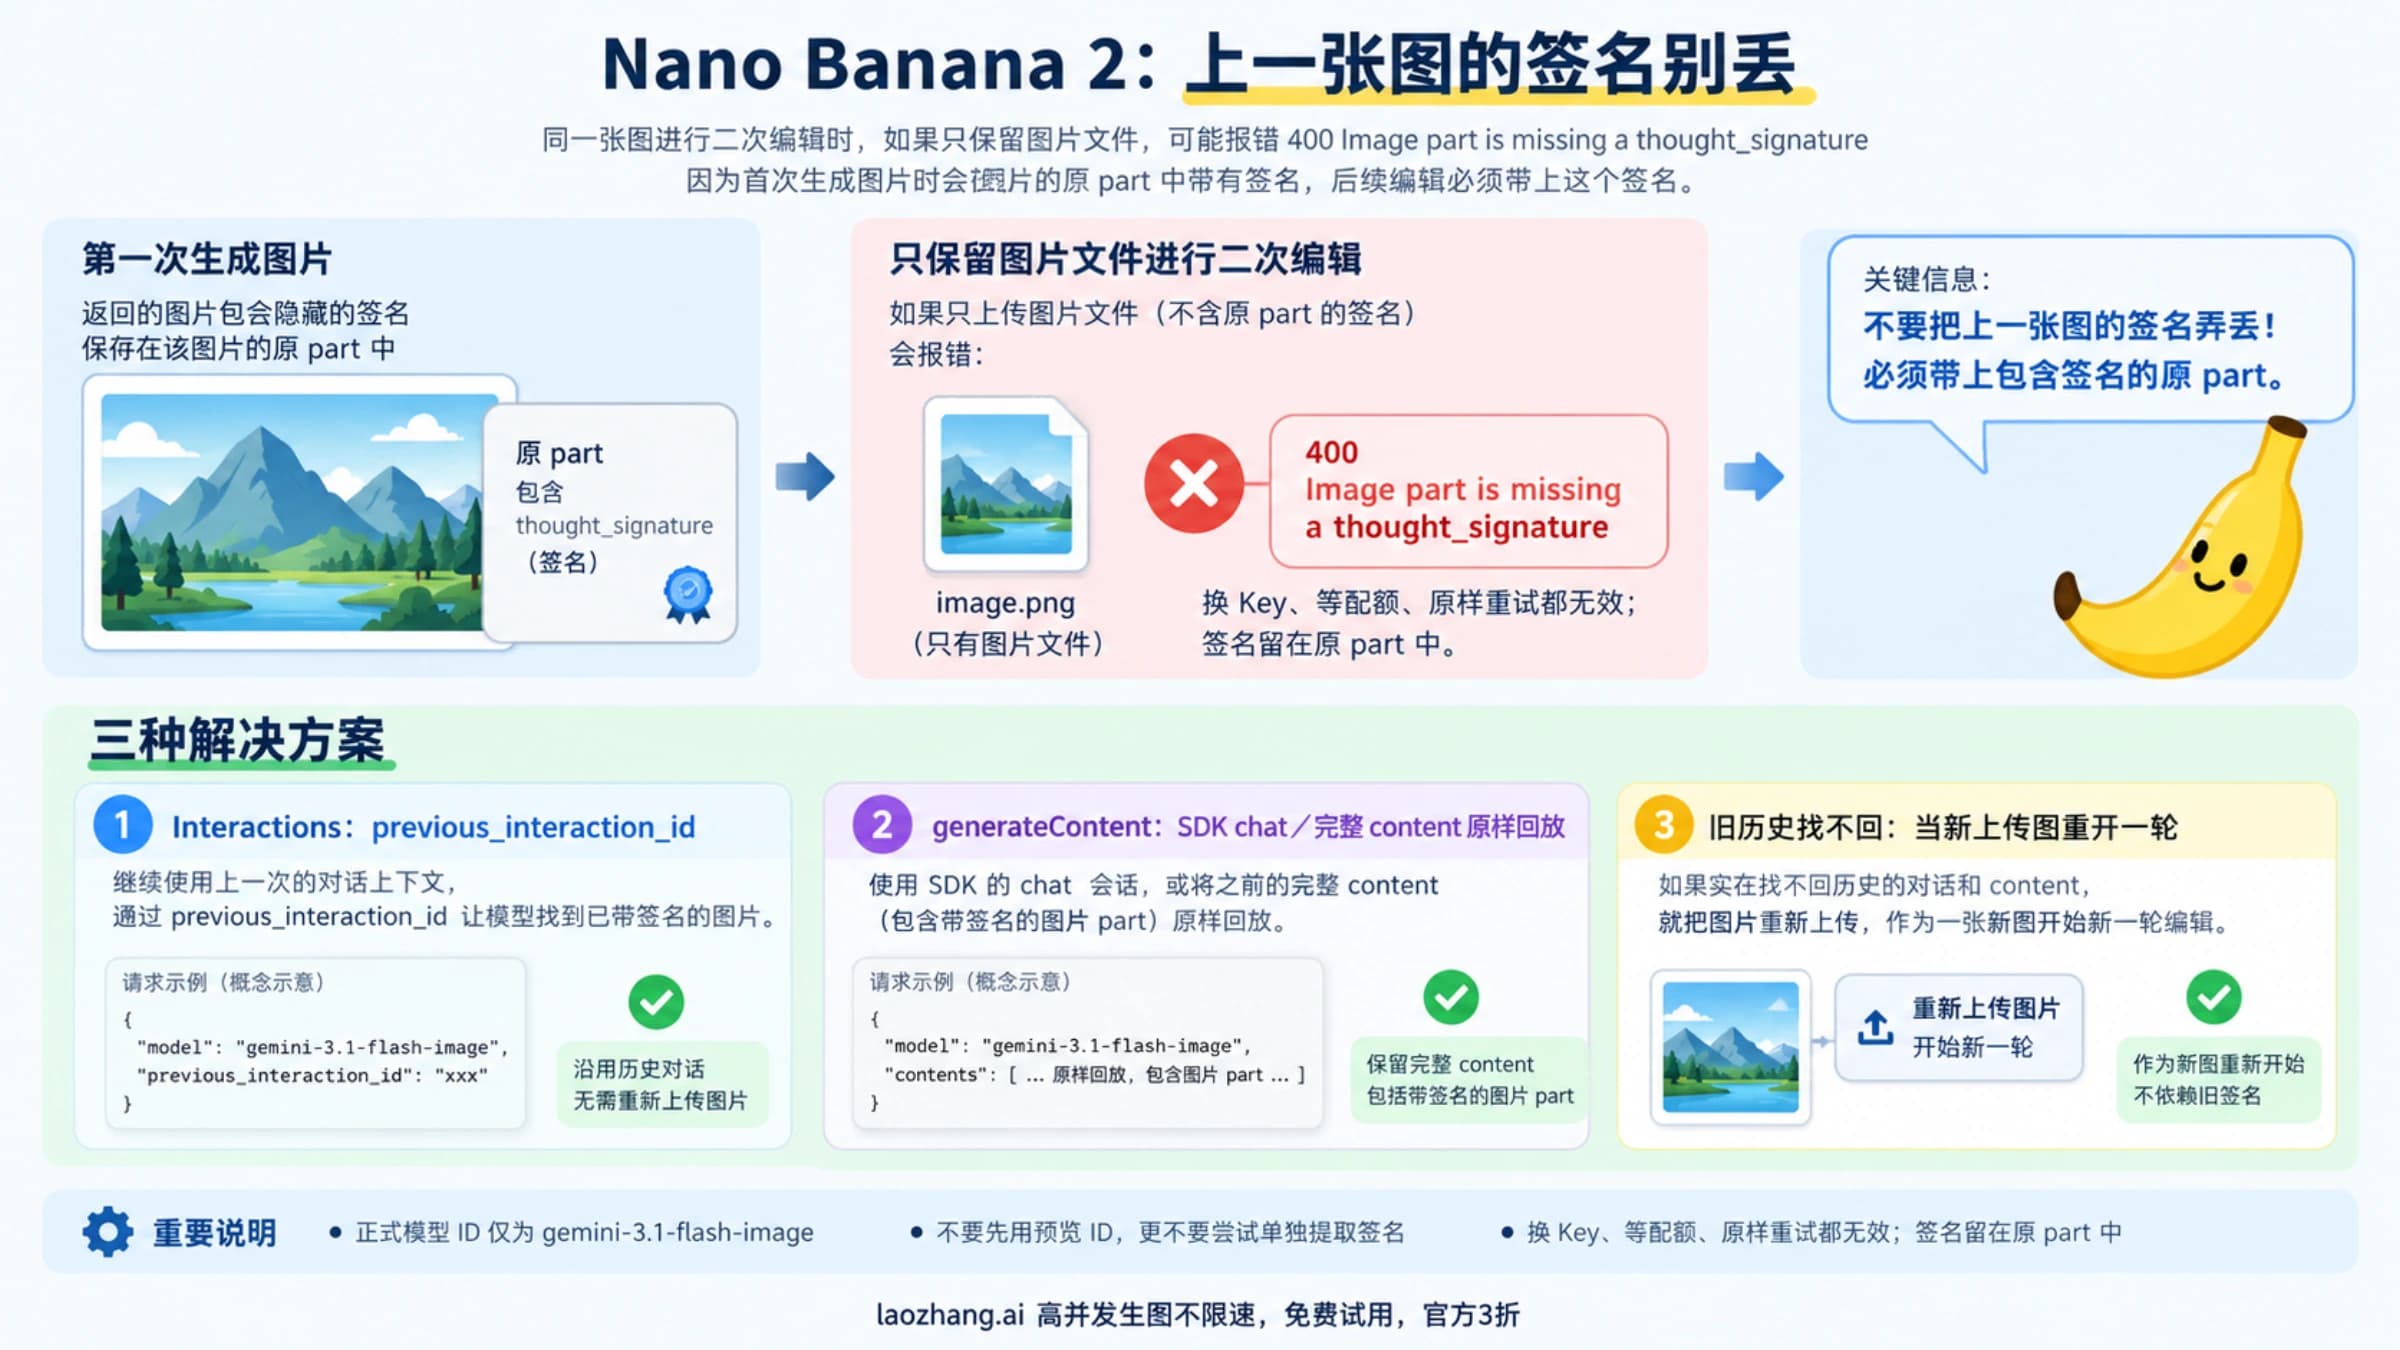
MISSING_THOUGHT_SIGNATURE | 多轮编辑时漏传了 thought signature | 修正多轮历史的传法 | 改代码后再发 |
既没有 candidates 也没有 blockReason | 响应里没有给出原因 | 记下 responseId,重试一次 | 最多一次 |
枚举值的定义见 generateContent API 参考。finishReason 有值时,候选里还可能带一条 finishMessage,把它和 responseId 一起记进日志。枚举表以后还会增加新值,代码里遇到不认识的值要原样保留,不要一律当成“安全拦截”。
提示词级拦截里最难懂的是 blockReason: OTHER,它的排查见 Nano Banana 2 blockReason OTHER:官方只写「原因未知」,该查什么。多轮编辑中签名丢失的写法问题,见 Nano Banana 2 Thought Signature 错误:全场景修复指南(2026);用官方 SDK 的 chat 功能,或把上一轮的完整响应对象放回历史,签名会自动处理。
Interactions API
status | 含义 | 下一步 |
|---|---|---|
completed,model_output 里有 image 块 | 已出图 | 程序仍说没图,就是解析代码的问题(见下一节) |
completed,只有 text 块 | 只回了文字 | 同 generateContent 的“只有文字” |
incomplete | 已结束但结果不完整,例如触到 max_tokens | 调高或去掉 generation_config.max_output_tokens |
failed | 调用失败 | 保存完整 interaction,看 steps 原文,不要循环重试 |
in_progress、queued | 还没做完(常见于后台运行) | 稍后按 id 取回再判断 |
requires_action | 在等你提交工具调用结果 | 按工具调用流程补齐 |
cancelled | 已取消 | 重新发起 |
状态定义见 Interactions API 参考。图片安全拦截在 Interactions API 里具体落在哪个字段,现有文档没有写明;遇到 failed 或只有文字时,以保存下来的 status 与 steps 原文为准,不要照搬 generateContent 的字段名去找。
只回文字:先确认请求了图片
Nano Banana 默认同时返回文字和图片,所以“先回一段话、没附图”并不说明代码坏了,更可能是模型没把这句话当成出图请求。两个接口限定输出的方式不同:
- generateContent 用
generationConfig.responseModalities,官方示例写["TEXT", "IMAGE"],只要图可以写["IMAGE"]。API 参考说明这个列表要与响应的模态完全一致,传空列表等于只要文字,传了模型不支持的组合会直接报错。 - Interactions API 用
response_format:写{"type": "image"}只返回图片,写成[{"type": "text"}, {"type": "image"}]就是图文都要。
这两项限定的是“可以返回什么”,并不保证每次都出图,同一个请求仍可能以 NO_IMAGE 或拦截结束。配合提示词一起改:把“生成一张图片”写在开头,说清楚要画什么,不要只写一个名词或只问“能不能画”。
简体中文(zh-CN)在 Google 列出的最佳效果语言里。有用户反映非英文提示词更容易只回文字,这属于个人经验,没有官方说明;想验证的话,把同一需求改成明确的出图指令再发一次,成本最低。另外,文档写明模型不一定严格按你要求的张数出图,要 4 张只来 1 张也属于正常结果。
被拦截:改提示词还是改安全设置
安全设置能管的范围很窄。按 安全设置文档,可调的只有四个类别:骚扰、仇恨言论、露骨色情、危险内容;对 Gemini 2.5 和 3 系列模型,这些过滤器在你不设置时默认就是 OFF。所以没设过阈值的人再加一遍 BLOCK_NONE,不会多出任何放行空间。
另外两条限制:
- 危害儿童安全这类核心危害始终拦截,无法调整。
IMAGE_SAFETY、IMAGE_PROHIBITED_CONTENT、PROHIBITED_CONTENT都不属于那四个可调类别,文档里也没有任何能关掉它们的参数。 - Interactions API 不支持自定义安全设置。
所以碰到 SAFETY,先看 safetyRatings 里标记的类别:如果那是你自己调严过的类别,放宽阈值会有效果;其余拦截只能改内容:把可能触及规则的元素从描述里拿掉,或者换一个题材。官方 SDK 会对超时、网络问题、429 和 5xx 自动重试(Python SDK 默认最多重试四次),拦截结果却是一份正常返回的响应,原因写在响应体里,不会触发这层重试;如果你自己写了重试循环,要把拦截类的 finishReason 排除在外。
IMAGE_RECITATION 表示生成结果与某些已有内容过于接近。Google 对 RECITATION 的建议是让提示词和上下文尽量独特;照这个思路,出图时少用“画一个和某部作品一模一样的角色”这类要求,改成描述你自己的设定。
有图却被代码漏掉
检查脚本报告“有最终图片”、你的程序却说没图,问题通常在解析方式。下面几种情况来自文档描述的响应结构,属于推断,排查时值得逐一对照:
- 只取第一个图片部分。 Gemini 3 系列图片模型默认开启思考,而且无法关闭;思考过程中最多生成两张中间图。在 generateContent 里打开
includeThoughts后,这些中间内容会以thought: true的部分出现在parts里。只拿第一个inlineData,拿到的可能是草稿;最终图应取thought不为 true 的图片部分。 - 只看便捷属性。 Interactions 的
interaction.output_image只返回最后一个图片块。Nano Banana Pro 这类模型可以输出图文交错的内容(例如带插图的故事),这时便捷属性抓不全,要遍历steps,在model_output步骤的content里逐块处理;thought步骤的summary里也可能有图片,那是中间图。 - 按旧写法读字段。 官方文档现在的示例都基于
google-genai(from google import genai)和@google/genai。沿用旧 SDK 或旧教程的字段路径,可能拿到空值而误判为没图。 - 没检查 MIME 类型。 图片部分可能是
image/png,也可能是image/jpeg(Interactions 的response_format可以指定mime_type)。写死扩展名不影响数据本身,但写死“只认 PNG”的判断会把 JPEG 当成没图。
用脚本判断一次响应
下面的脚本只用 Python 标准库,读入上一步保存的 JSON,自动识别是 generateContent 还是 Interactions 的结构,输出:属于哪种形态、最终图片几张、中间图几张、token 用量、按公开单价估算的费用和下一步动作。有最终图片时退出码为 0,没有为 1,无法识别为 2,方便接进 CI 或批处理脚本。
#!/usr/bin/env python3
"""检查一次 Nano Banana 调用的原始 JSON:有没有最终图片、属于哪种“没图”、下一步做什么。
用法:python3 nb_inspect.py resp.json [--save DIR]   只用标准库;退出码 0=有图 1=没图 2=无法识别"""
import base64, json, pathlib, sys

PRICE = {  # 美元 / 100 万 token:输入、文字与思考输出、图片输出(Gemini API 付费层 Standard)
    "gemini-3.1-flash-image": (0.50, 3.0, 60.0),
    "gemini-3-pro-image": (2.0, 12.0, 120.0),
}
POLICY = {"PROHIBITED_CONTENT", "BLOCKLIST", "SPII", "IMAGE_SAFETY", "IMAGE_PROHIBITED_CONTENT"}
ACTION = {
    "prompt_blocked": "提示词在生成前被拦截:看 blockReason,改写内容后再发,不要原样重试",
    "policy_block": "输出被图片安全或政策规则拦截:换题材或描述方式;原样重试没用,四个可调安全类别也不包括它",
    "safety_filter": "可调安全过滤器拦截(SAFETY):看 safetyRatings;若是你自己设的阈值,放宽它或改写内容",
    "no_image": "模型该出图却没出(NO_IMAGE):把“生成一张图片”写明,确认请求了图片模态,可再试一次",
    "text_only": "正常结束但只有文字:明确要求出图,并在请求里指定图片输出",
    "recitation": "输出与已有素材过于相似:去掉对具体作品、角色的复刻要求,描述写得更原创",
    "other": "原因未说明(OTHER / IMAGE_OTHER):保存原始响应,可重试一次;重复出现再改提示词",
    "max_tokens": "输出不完整,常见原因是触到输出上限:去掉或调高 maxOutputTokens / max_output_tokens",
    "thought_signature": "多轮编辑缺少 thought signature:把上一轮响应完整放回历史,或改用 SDK 的 chat",
    "not_finished": "interaction 还没结束:稍后按 id 取回结果再判断",
    "failed": "interaction 失败:保存完整 JSON,查看 steps 与错误信息,不要盲目循环重试",
    "empty": "没有候选也没有拦截原因:保存 responseId 与原始响应,重试一次,重复出现就改提示词",
    "http_error": "请求本身报错(不是“没图”):429 看额度,其他先核对模型 ID 与参数",
    "ok": "拿到了最终图片;如果你的程序仍说没图,问题在解析代码",
    "unknown": "未知的结束原因:保留原始值,按文档最新枚举核对",
}

def g(d, *keys):
    """同时兼容 REST 的 camelCase 和 SDK 导出的 snake_case。"""
    for k in keys:
        if isinstance(d, dict) and d.get(k) is not None:
            return d[k]
    return None

def by_modality(items):
    return {str(g(i, "modality")).upper(): g(i, "tokenCount", "token_count", "tokens") or 0
            for i in items or []}

def inspect_generate_content(r):
    finals, thoughts, texts, reasons = [], 0, 0, []
    for c in g(r, "candidates") or []:
        reasons.append(g(c, "finishReason", "finish_reason"))
        for p in g(g(c, "content") or {}, "parts") or []:
            blob = g(p, "inlineData", "inline_data")
            is_img = blob and str(g(blob, "mimeType", "mime_type")).startswith("image/")
            if is_img and g(p, "thought"):
                thoughts += 1
            elif is_img:
                finals.append(blob)
            elif g(p, "text") and not g(p, "thought"):
                texts += 1
    fb = g(r, "promptFeedback", "prompt_feedback") or {}
    block = g(fb, "blockReason", "block_reason")
    reason = next((x for x in reasons if x and x != "STOP"), reasons[0] if reasons else None)
    if finals:
        shape = "ok"
    elif block:
        shape = "prompt_blocked"
    elif not reasons:
        shape = "empty"
    elif reason in POLICY:
        shape = "policy_block"
    else:
        shape = {"STOP": "text_only" if texts else "empty", "SAFETY": "safety_filter", "NO_IMAGE": "no_image",
                 "RECITATION": "recitation", "IMAGE_RECITATION": "recitation",
                 "OTHER": "other", "IMAGE_OTHER": "other", "MAX_TOKENS": "max_tokens",
                 "MISSING_THOUGHT_SIGNATURE": "thought_signature"}.get(reason, "unknown")
    u = g(r, "usageMetadata", "usage_metadata") or {}
    out = by_modality(g(u, "candidatesTokensDetails", "candidates_tokens_details"))
    total_out = g(u, "candidatesTokenCount", "candidates_token_count") or 0
    usage = {"input": g(u, "promptTokenCount", "prompt_token_count") or 0,
             "thought": g(u, "thoughtsTokenCount", "thoughts_token_count") or 0,
             "image_out": out.get("IMAGE", 0)}
    usage["text_out"] = total_out - usage["image_out"]
    detail = {"finish_reason": reason, "block_reason": block, "text_parts": texts}
    return shape, finals, thoughts, usage, detail, g(r, "modelVersion", "model_version")

def inspect_interaction(r):
    finals, thoughts, texts = [], 0, 0
    for s in g(r, "steps") or []:
        blocks = g(s, "content") if g(s, "type") == "model_output" else g(s, "summary")
        for b in blocks or []:
            if g(b, "type") == "image" and g(s, "type") == "model_output":
                finals.append(b)
            elif g(b, "type") == "image":
                thoughts += 1
            elif g(b, "type") == "text" and g(s, "type") == "model_output":
                texts += 1
    status = g(r, "status")
    if finals:
        shape = "ok"
    elif status in ("in_progress", "queued", "requires_action"):
        shape = "not_finished"
    elif status in ("failed", "cancelled"):
        shape = "failed"
    elif status == "incomplete":
        shape = "max_tokens"
    elif status == "completed":
        shape = "text_only" if texts else "empty"
    else:
        shape = "unknown"
    u = g(r, "usage") or {}
    out = by_modality(g(u, "output_tokens_by_modality"))
    usage = {"input": g(u, "total_input_tokens") or 0, "thought": g(u, "total_thought_tokens") or 0,
             "image_out": out.get("IMAGE", 0), "text_out": out.get("TEXT", 0)}
    return shape, finals, thoughts, usage, {"status": status, "text_blocks": texts}, g(r, "model")

def estimate(model, usage):
    key = next((k for k in PRICE if model and str(model).split("/")[-1].startswith(k)), None)
    if not key:
        return None
    p_in, p_text, p_img = PRICE[key]
    usd = (usage["input"] * p_in + (usage["thought"] + usage["text_out"]) * p_text
           + usage["image_out"] * p_img) / 1e6
    return round(usd, 6)

def main(argv):
    if len(argv) < 2:
        print(__doc__)
        return 2
    r = json.loads(pathlib.Path(argv[1]).read_text(encoding="utf-8"))
    if isinstance(g(r, "error"), dict):
        e = r["error"]
        print(json.dumps({"api": "error", "shape": "http_error", "code": e.get("code"),
                          "status": e.get("status"), "next": ACTION["http_error"]},
                         ensure_ascii=False, indent=2))
        return 1
    if any(g(r, k) is not None for k in ("candidates", "promptFeedback", "prompt_feedback",
                                         "usageMetadata", "usage_metadata", "modelVersion")):
        api, res = "generateContent", inspect_generate_content(r)
    elif g(r, "steps") is not None or g(r, "status"):
        api, res = "interactions", inspect_interaction(r)
    else:
        print("无法识别:既不是 generateContent 响应,也不是 interaction")
        return 2
    shape, finals, thoughts, usage, detail, model = res
    if "--save" in argv and finals:
        d = pathlib.Path(argv[argv.index("--save") + 1])
        d.mkdir(parents=True, exist_ok=True)
        for i, blob in enumerate(finals, 1):
            ext = str(g(blob, "mimeType", "mime_type") or "image/png").split("/")[-1]
            (d / f"image_{i}.{ext}").write_bytes(base64.b64decode(g(blob, "data")))
    print(json.dumps({"api": api, "model": model, "shape": shape, "final_images": len(finals),
                      "thought_images": thoughts, **detail, "usage_tokens": usage,
                      "estimated_usd": estimate(model, usage), "next": ACTION[shape]},
                     ensure_ascii=False, indent=2))
    return 0 if finals else 1

if __name__ == "__main__":
    sys.exit(main(sys.argv))
用法:
python3 nb_inspect.py resp.json                    # 只判断
python3 nb_inspect.py interaction.json --save out  # 有最终图片时存到 out/ 目录
对一份模拟 IMAGE_SAFETY 的测试 JSON(手写的示意数据:输入 12 token、思考 180 token、没有图片输出),输出如下:
{
  "api": "generateContent",
  "model": "gemini-3.1-flash-image",
  "shape": "policy_block",
  "final_images": 0,
  "thought_images": 0,
  "finish_reason": "IMAGE_SAFETY",
  "block_reason": null,
  "text_parts": 0,
  "usage_tokens": {
    "input": 12,
    "thought": 180,
    "image_out": 0,
    "text_out": 0
  },
  "estimated_usd": 0.000546,
  "next": "输出被图片安全或政策规则拦截:换题材或描述方式;原样重试没用,四个可调安全类别也不包括它"
}
这个脚本基于离线 fixture 测试,没有对 Google 的实时调用测试。测试用的是 23 份手写 JSON(fixture):generateContent 覆盖正常出图、思考中间图加最终图、只有文字、只有中间图、NO_IMAGE、IMAGE_SAFETY、IMAGE_PROHIBITED_CONTENT、SAFETY、IMAGE_RECITATION、IMAGE_OTHER、MAX_TOKENS、MISSING_THOUGHT_SIGNATURE、提示词被拦、没有候选、未知枚举值和 SDK 导出的下划线字段;Interactions 覆盖出图、只有文字、failed、incomplete、in_progress;另有 HTTP 错误体和无法识别的 JSON。形态判断、退出码、token 汇总、费用估算和 --save 存图全部通过(Python 3.12,5 组 unittest)。真实响应里如果出现文档之外的字段或新的枚举值,脚本会报 unknown,这时以原始 JSON 为准。
失败的调用计了多少费
Google 的价格表按 token 和模态计费,没有单独说明被拦截或没出图的响应怎么收费,既没写按整张图收,也没写免费。能确定的只有这次调用的用量字段记了什么:
- generateContent 的
usageMetadata:promptTokenCount(输入)、thoughtsTokenCount(思考)、candidatesTokenCount(输出合计),candidatesTokensDetails按模态拆出其中的文字和图片。 - Interactions 的
usage:total_input_tokens、total_thought_tokens,output_tokens_by_modality按模态拆分输出。
按 Gemini API 价格表(付费层 Standard,截至 2026 年 9 月 24 日)的单价:
| 模型 | 输入 | 文字与思考输出 | 图片输出 | 一张 1K 图 |
|---|---|---|---|---|
Nano Banana 2 gemini-3.1-flash-image | $0.50 / 100 万 token | $3 / 100 万 token | $60 / 100 万 token | 1,120 token,约 $0.067 |
Nano Banana Pro gemini-3-pro-image | $2 / 100 万 token | $12 / 100 万 token | $120 / 100 万 token | 约 $0.134(2K 同价) |
估算公式:输入 token × 输入单价 +(思考 token + 文字输出 token)× 文字单价 + 图片输出 token × 图片单价。思考 token 不论是否返回思考内容都计费;文档另外写明思考过程中的中间图不收费。
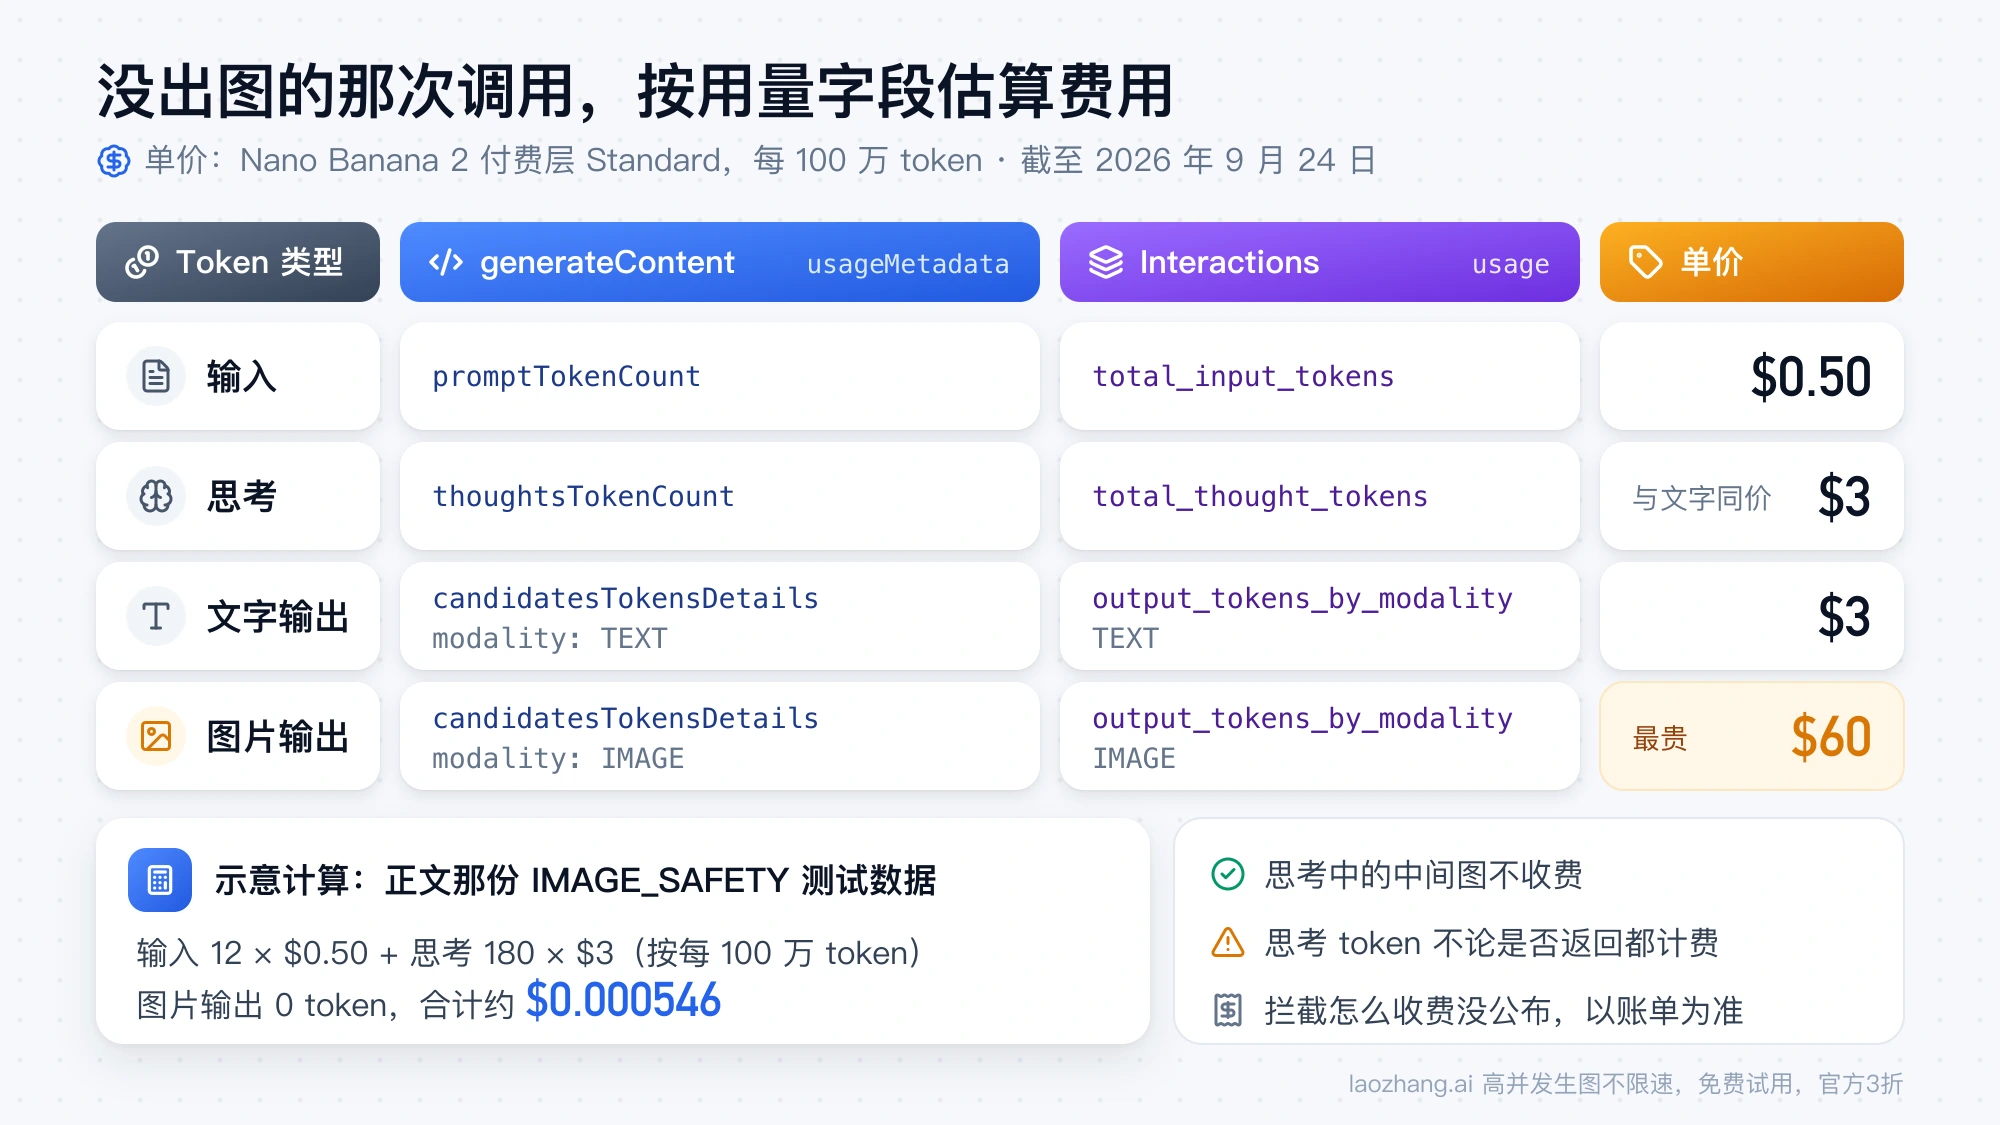
拿上面那份示意数据算:12 × $0.50 / 100 万 + 180 × $3 / 100 万 ≈ $0.000546。图片输出 token 为 0,这一次就不含一张图的 $0.067。这只是演示算法,数字来自手写的测试数据;你自己的失败调用要用它真实的 usageMetadata 或 usage 代入,最终金额以账单为准。如果失败响应里图片输出 token 不为 0,就按实际数字算,不要套用“拦截免费”或“拦截按整张收费”的说法。
客户端或工具里不显示图片
在第三方客户端里选了 Nano Banana 却只看到文字,按这个顺序排查:
- 模型 ID。 如果客户端预设里还是
gemini-2.5-flash-image-preview、gemini-3-pro-image-preview这类已下线的 ID,改成上面表格里的正式版。 - 是否请求了图片、能否显示图片。 客户端要在请求里带上图片输出设置,还要能把
inlineData或image内容块渲染出来;两者缺一,界面上都只剩文字。 - 用 curl 复现。 用同一个提示词、同一个模型 ID 按前面的命令发一次,再用脚本判断:curl 能出图,问题就在客户端;curl 也没图,按上面的对照表处理。
换一个中转平台或第三方接口,并不能解决拦截问题。只要对方最终调用的是 Google 的同一个模型,拦截规则就跟着模型走,IMAGE_SAFETY 不会因为换了入口而消失。
常见问题
Nano Banana 返回 200 却没有图片,是不是代码写错了?
不一定。拦截、只回文字、NO_IMAGE 都不是 HTTP 错误,而是正常返回的响应,原因写在 finishReason、promptFeedback.blockReason 或 interaction 的 status 里。先用脚本判断形态:报告“有最终图片”才是解析代码的问题。
把安全设置调成 BLOCK_NONE 能解决 IMAGE_SAFETY 吗?
不能。可调的四个安全类别对 Gemini 2.5 和 3 系列默认已是 OFF,IMAGE_SAFETY 不在其中,文档也没有关闭它的参数。只能改写内容;Interactions API 则不支持自定义安全设置。
被拦截的那次调用要付钱吗?
Google 没有公布专门规则。看这次调用的 usageMetadata(generateContent)或 usage(Interactions):输入 token 按输入单价,思考和文字输出 token 按文字单价,图片输出 token 按图片单价,估算结果仍以账单为准。
三月能跑的代码现在报错,怎么回事?
大概率是模型 ID:gemini-3.1-flash-image-preview 和 gemini-3-pro-image-preview 已在 2026 年 6 月 25 日停止服务,换成 gemini-3.1-flash-image 或 gemini-3-pro-image 即可;原版 gemini-2.5-flash-image 在 2026 年 10 月 2 日下线。
官方文档
接入参数、价格与扣费规则以老张API开发文档为准:图片生成计费与失败处理。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月24日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月24日。
- 1.Gemini API 弃用时间表ai.google.dev/gemini-api/docs/deprecations
- 2.图片生成文档ai.google.dev/gemini-api/docs/image-generation
- 3.generateContent API 参考ai.google.dev/api/generate-content
- 4.Interactions API 参考ai.google.dev/api/interactions
- 5.安全设置文档ai.google.dev/gemini-api/docs/safety-settings
- 6.Gemini API 价格表ai.google.dev/gemini-api/docs/pricing