Codex 提交消息时出错:原因在第二行,按报错原文逐类处理
Codex「提交消息时出错」的原因在第二行:Timeout、排队消息失效、AbsolutePathBuf、EPERM 各有处理办法。点重试前先确认消息是否已发出,以免重复执行。
文章目录
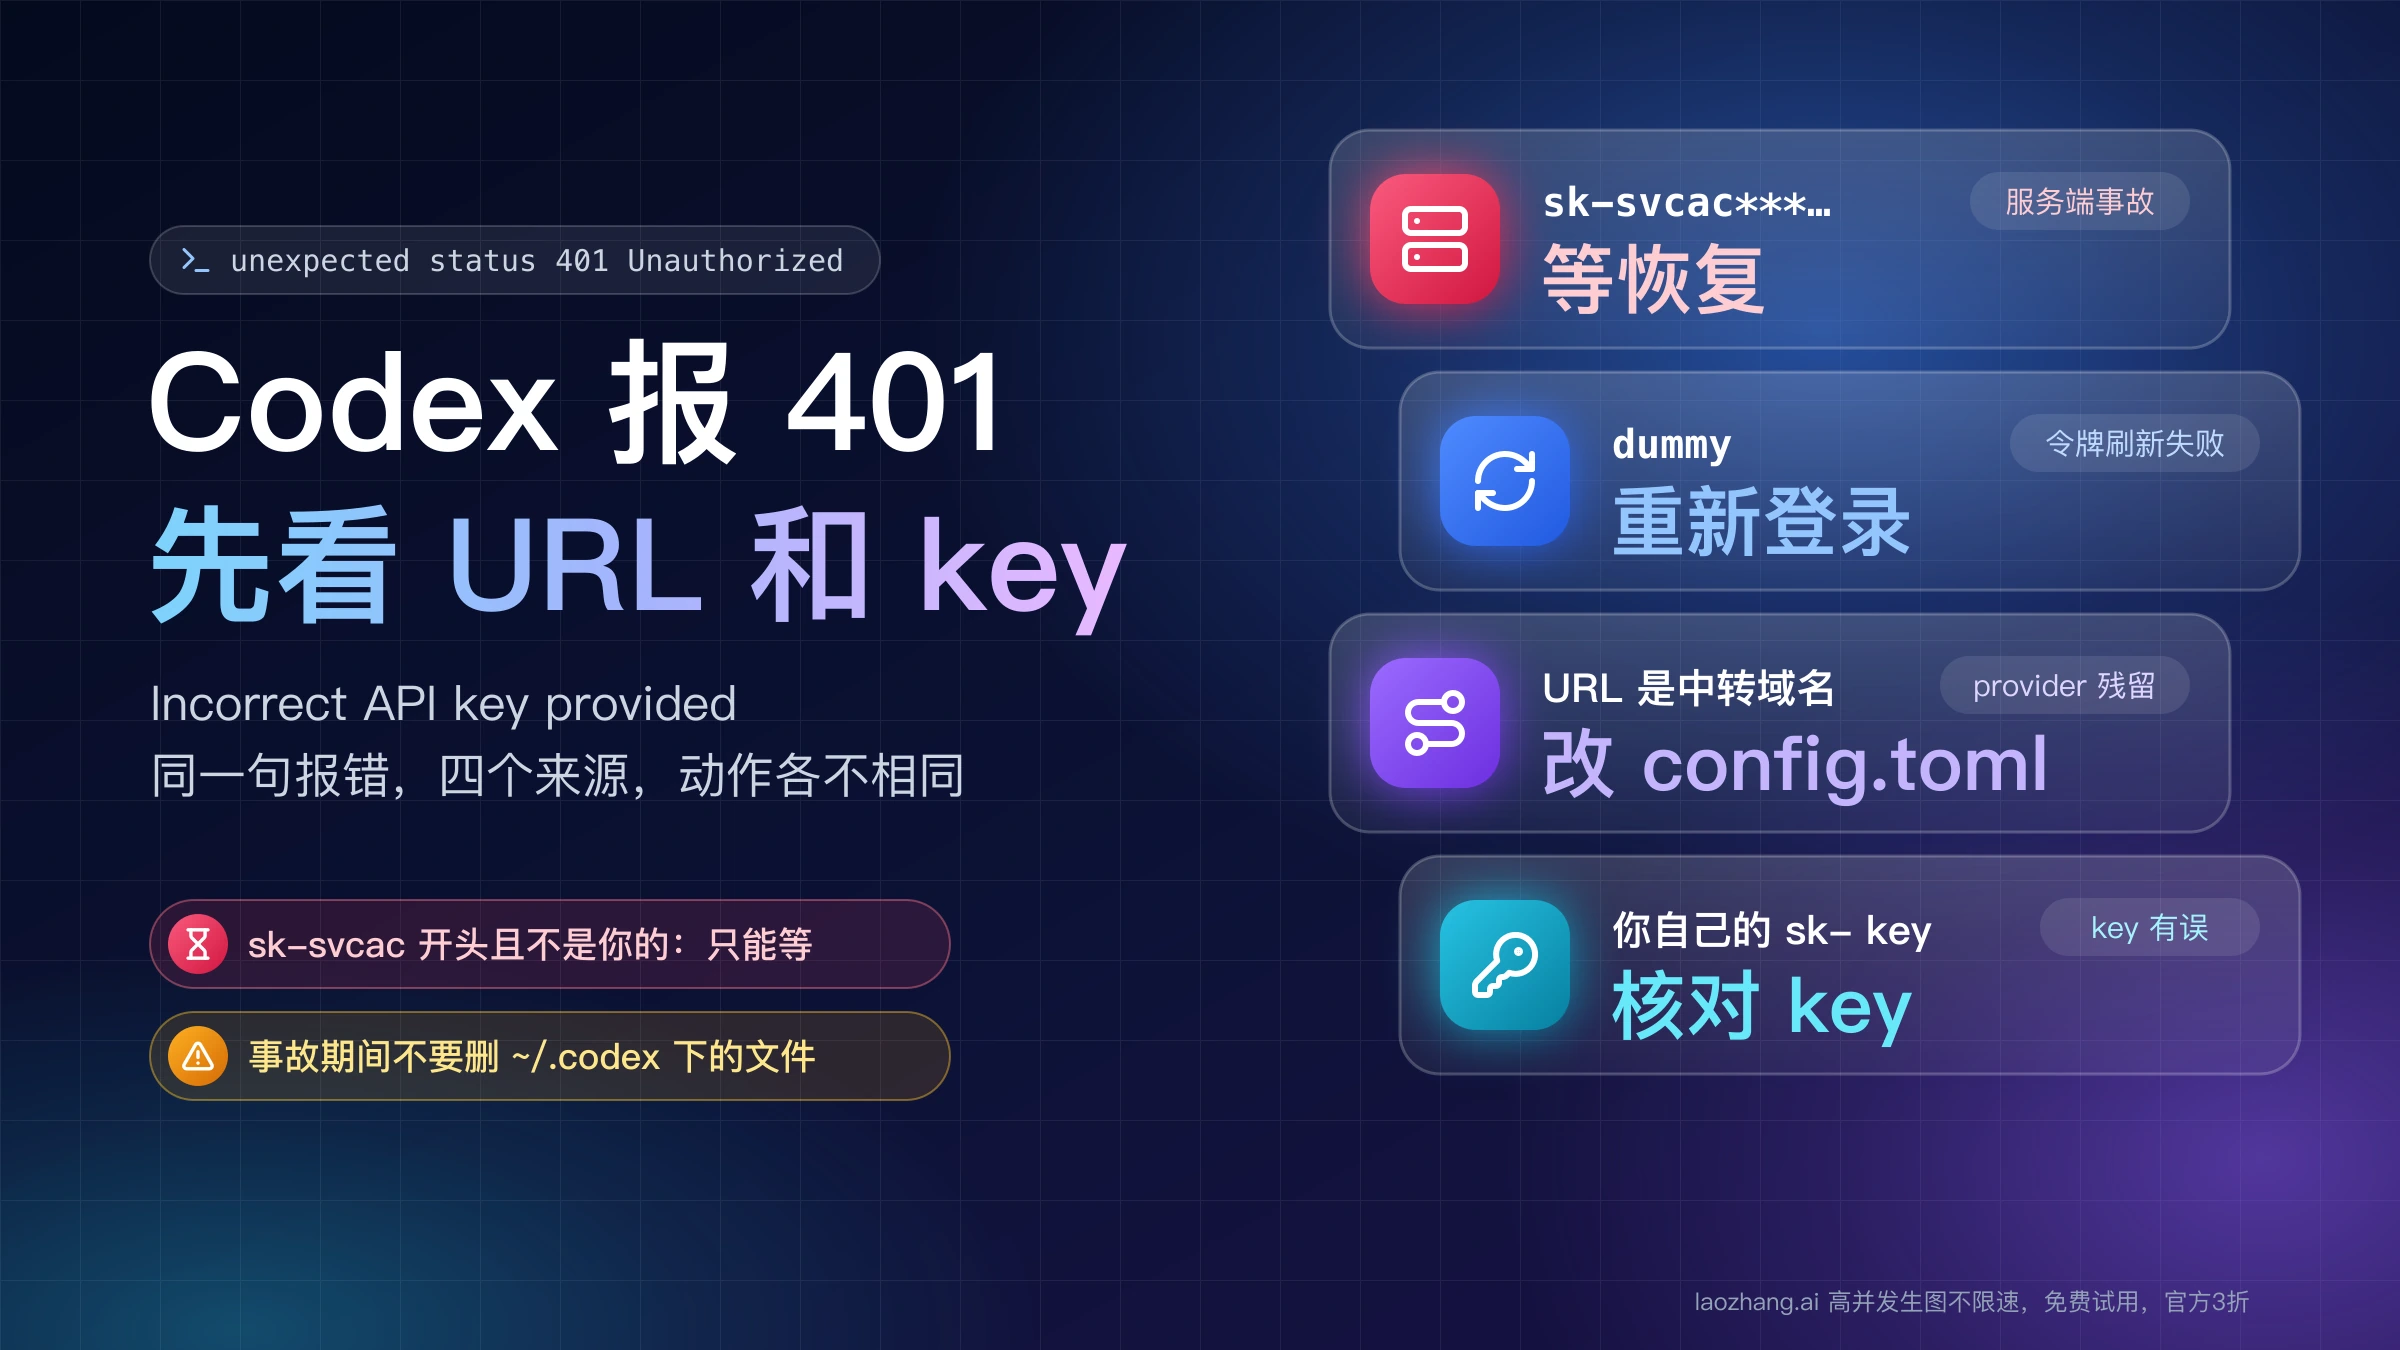
在 ChatGPT 桌面版(原来的 Codex 应用)、VS Code 或 Cursor 里的 Codex 插件、Codex 网页版里发消息,弹出「提交消息时出错」,英文界面是 "Error submitting message",繁体界面是「提交訊息時發生錯誤」。这一行只是统称,不是错误码。真正有用的是它下面那一行,比如 Timeout、App-server queued follow-up no longer exists、AbsolutePathBuf deserialized without a base path、EPERM: operation not permitted,不同的第二行对应完全不同的原因和处理办法。
先记住三件事:
- 先看第二行,再动手。同一个标题下有十几种原因,对一种有效的办法换到另一种上往往无效。只有标题、没有第二行,多半是请求超时或连接中断。
- 点「重试」前,先确认那条消息是不是已经发出去了。有报告显示界面标着失败、消息其实已经送达代理,重试后同一条消息和同一轮任务被执行了两次。
- 先判断坏的是一个会话还是整个应用。换到另一个会话发一句短话:别的会话正常,就只处理这一个会话;所有会话都发不出,才去重启应用。
截至 2026 年 10 月 16 日,OpenAI 的 Codex 故障排除页没有提到这个报错。在 GitHub、OpenAI 开发者论坛和 X 上能找到的 OpenAI 员工表态只有一条,针对的是 9 月那批「排队消息不存在」的报错,说修复已就位,没有给出版本号(见下文)。
下面的结论有四类依据:ChatGPT 桌面版 26.1013.31256 安装包里的界面代码;OpenAI 开源的 Codex app-server 源码(2026 年 10 月 16 日的 main 分支);LaoZhang AI 团队一台 Mac 上 10 月 2 日至 16 日的桌面版日志;GitHub openai/codex 仓库里 34 个相关 issue 和 OpenAI 开发者论坛的帖子。下文列出的各种报错没有逐一故意复现。文中写"报告有效"的办法,都是报告者说在自己机器上管用,不是 OpenAI 的方案,也不保证在你那里有效。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
提交消息时出错是什么意思:标题是统称,原因写在第二行
在桌面版里,这个提示的结构是两行:第一行固定写「提交消息时出错」,第二行把底层错误的原文原样贴出来。安装包里中文、英文、日文、韩文、俄文、西班牙文等各语言的提示都是同一个结构。第二行是底层错误的原文,通常是英文,所以中文界面的用户也可以直接拿第二行去 GitHub 搜。
第二行从哪里来,决定了它长什么样:
- 客户端没拿到任何错误文字:会话里那条失败消息下面只显示英文的 "Error submitting message",没有别的内容。最常见的情况是请求超时。旧版 VS Code 插件(26.513)的代码里,把消息交给本地 app-server 的
turn/start请求等待上限是 30,000 毫秒,也就是 30 秒;多位桌面版用户贴出的日志里也是timeoutMs=30000,随后是submit failed errorMessage=Timeout。 - 本地 app-server 拒绝了这条消息:第二行就是 app-server 返回的原文。开源代码里能看到的拒绝原因包括
thread not found(会话没有加载)、Input exceeds the maximum length of 1048576 characters.(文本输入超过 1,048,576 个字符)、remote image URLs are not supported、Server is draining; retry after reconnecting,以及各种配置读取错误。 - 桌面版自己的排队逻辑出错:比如 9 月的
App-server queued follow-up no longer exists,这句话不在开源 app-server 里,是桌面版界面代码抛出的。
「创建聊天时出错」(Error creating chat)和 "Error creating task" 下面带的第二行和本页是同一批,处理办法照用。
有几个长得像、但不归本页的报错:
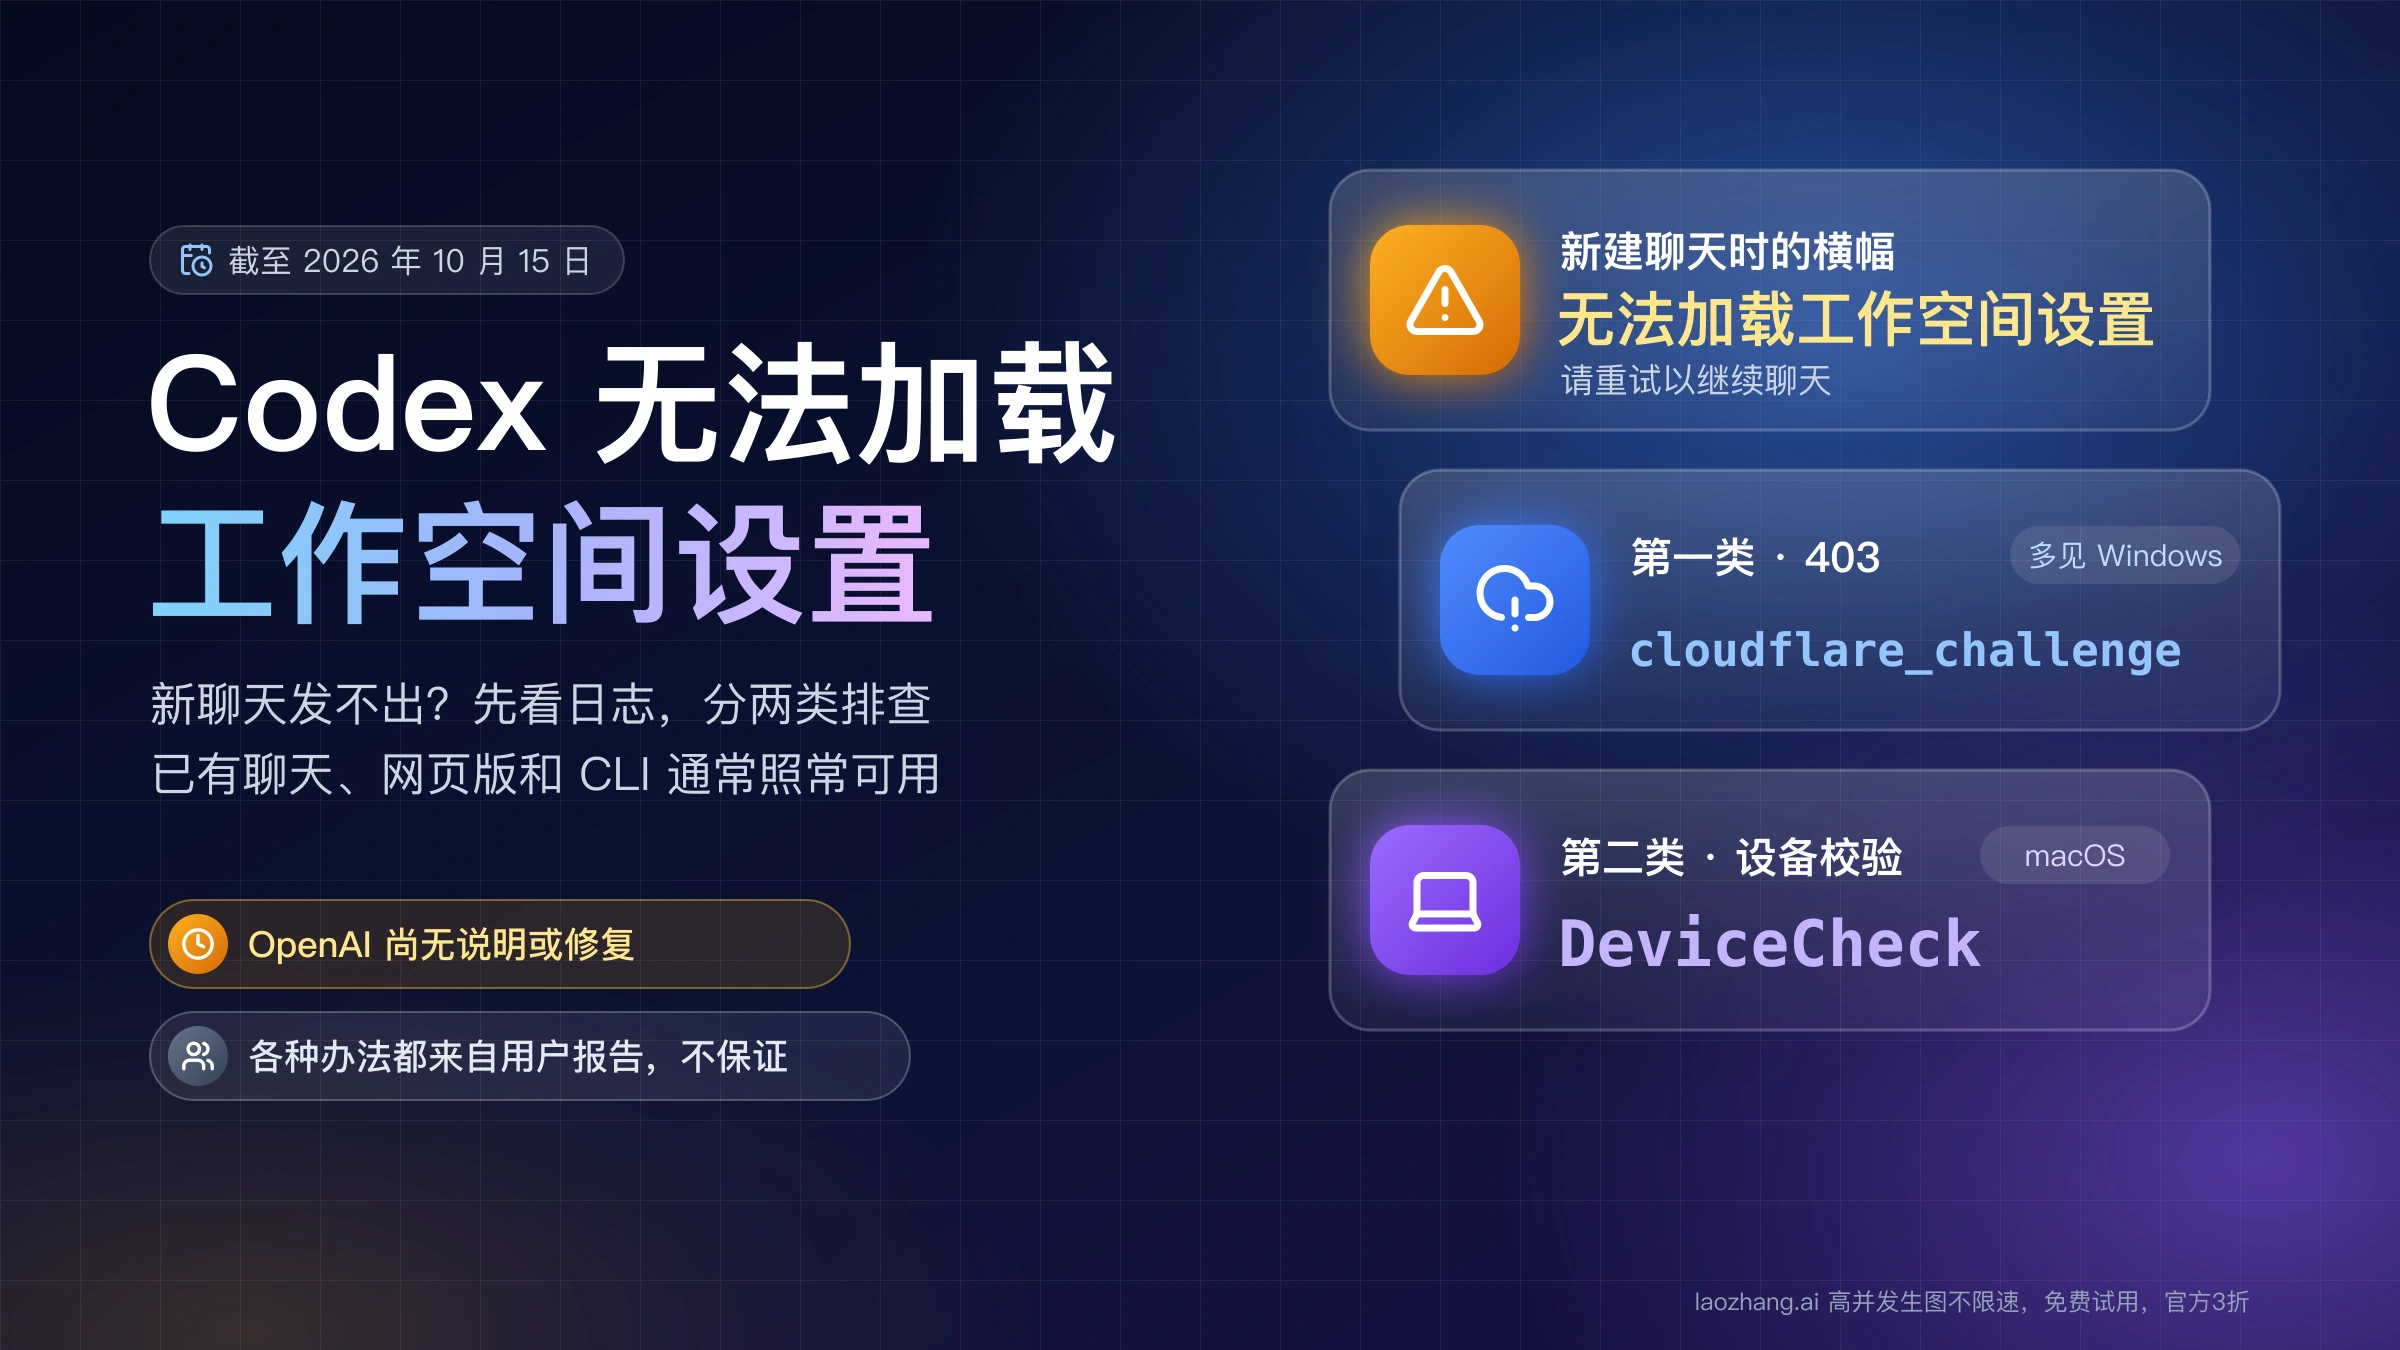
- 新建聊天时输入框上方出现「无法加载工作空间设置」,发送按钮是灰的,消息根本发不出去:见 Codex 无法加载工作空间设置:新聊天发不出,按日志分两类排查。本页的报错是按下发送之后才弹出的。
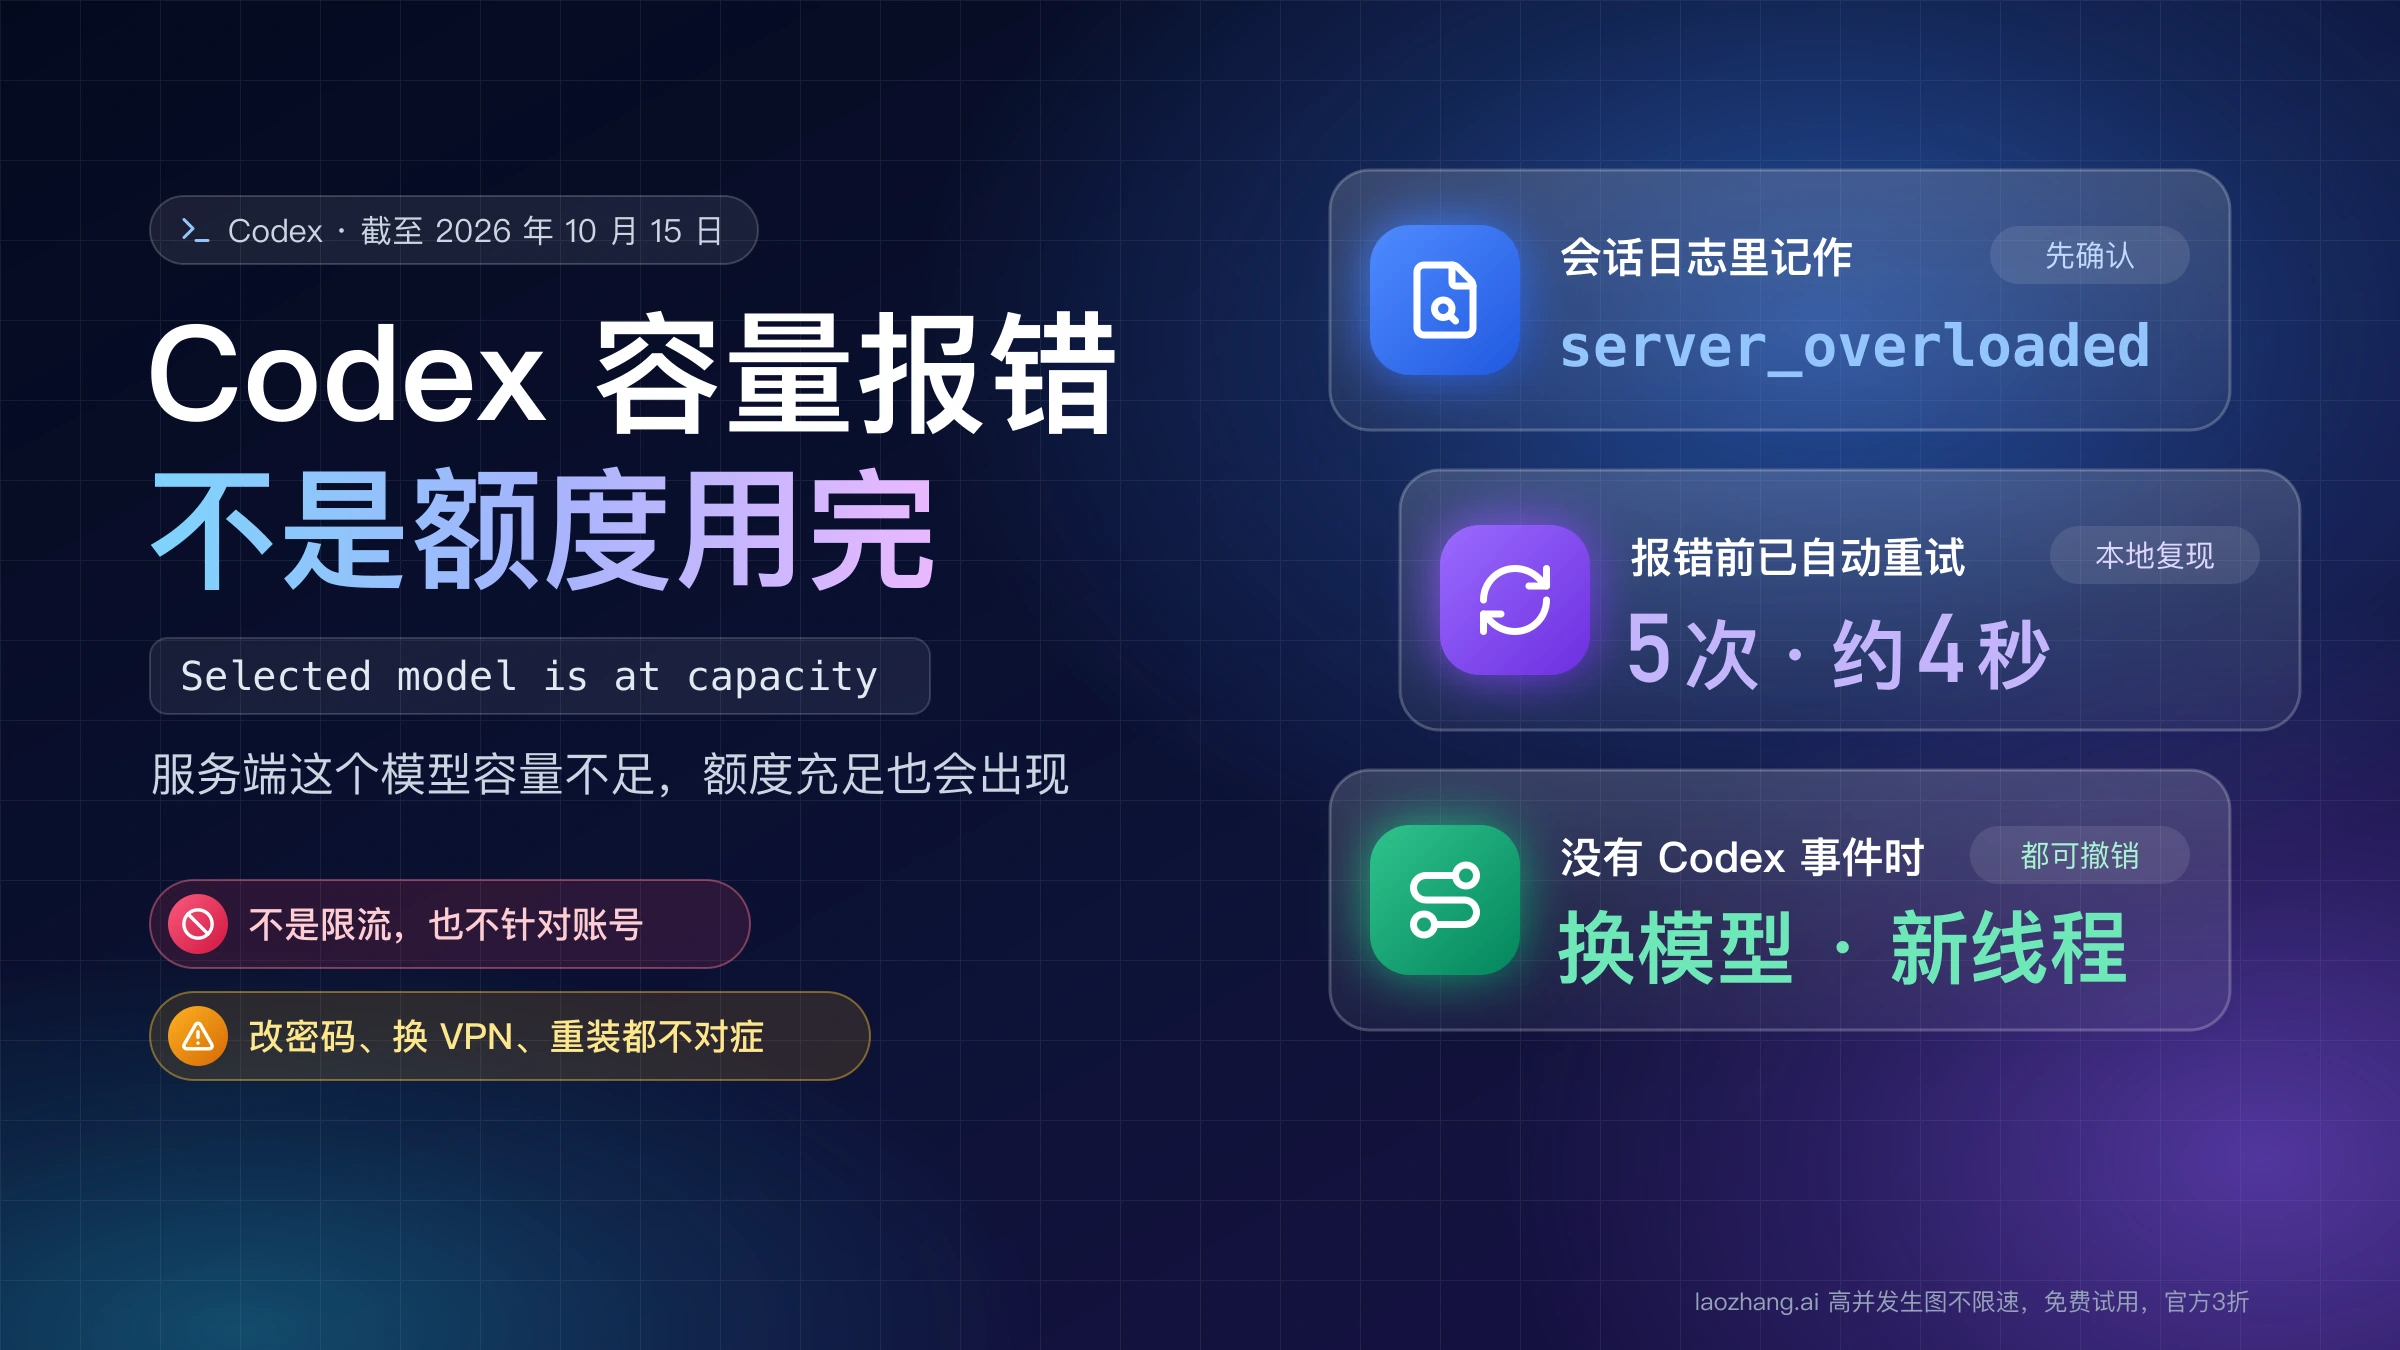
- 第二行是
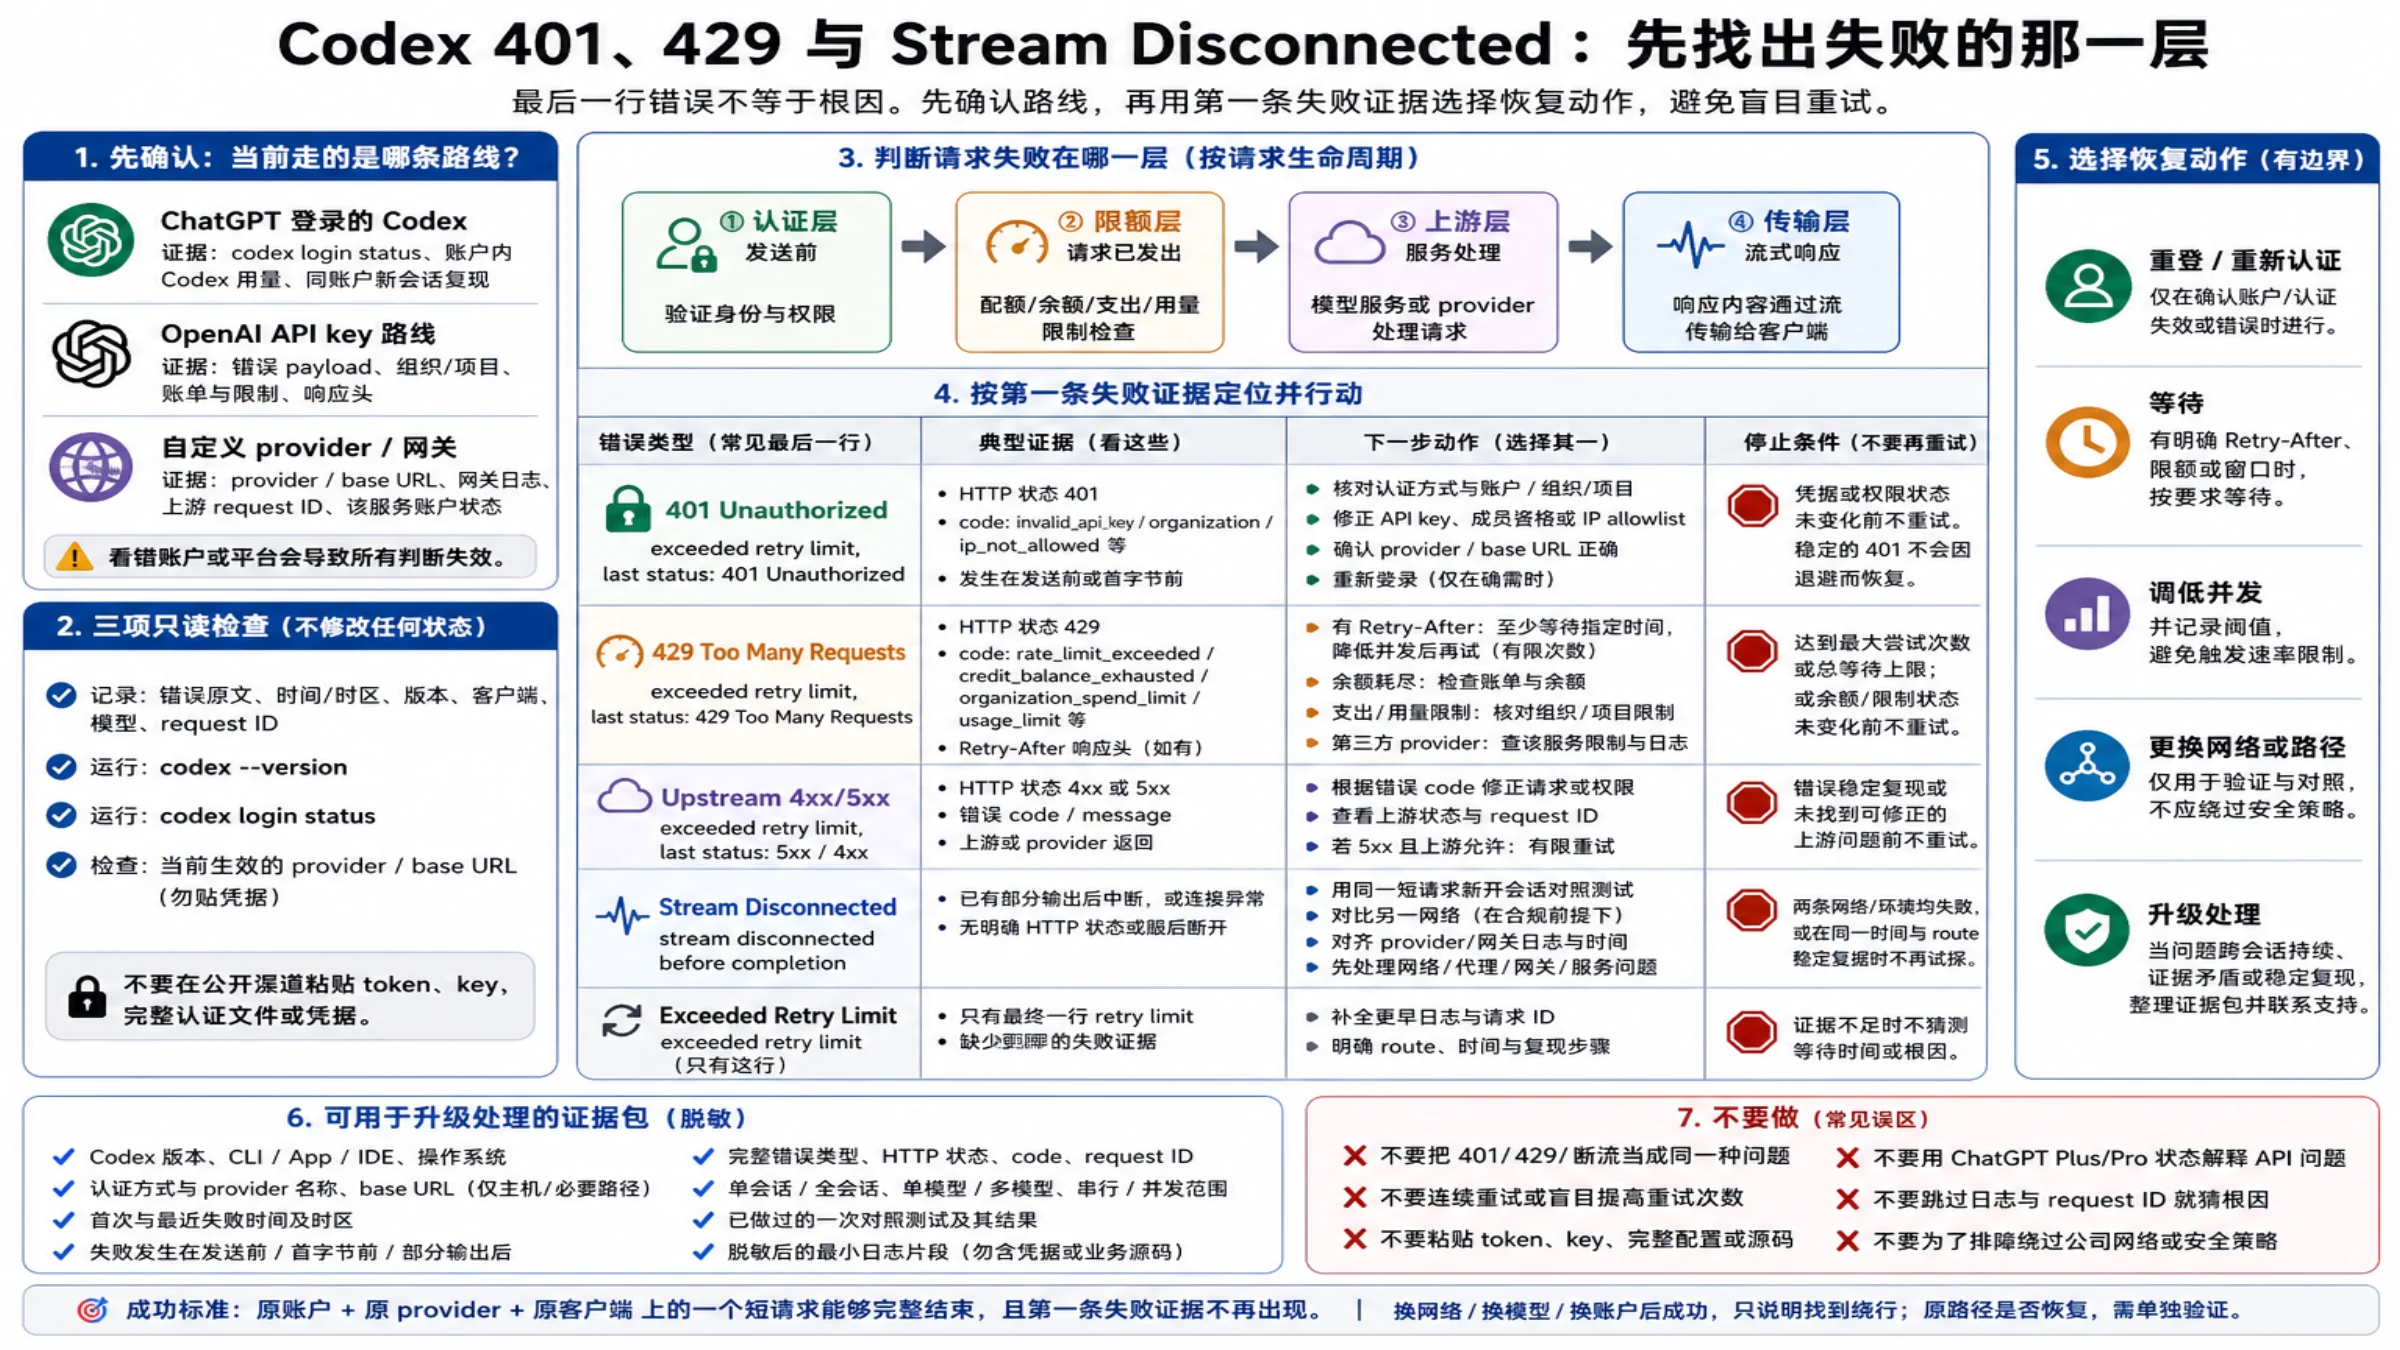
Selected model is at capacity:服务端容量不足,见 Codex Selected model is at capacity 怎么解决:不是额度用完。 - 回复到一半出现 429、401 或 stream disconnected:见 Codex exceeded retry limit 429、401 与 Stream Disconnected 排查。
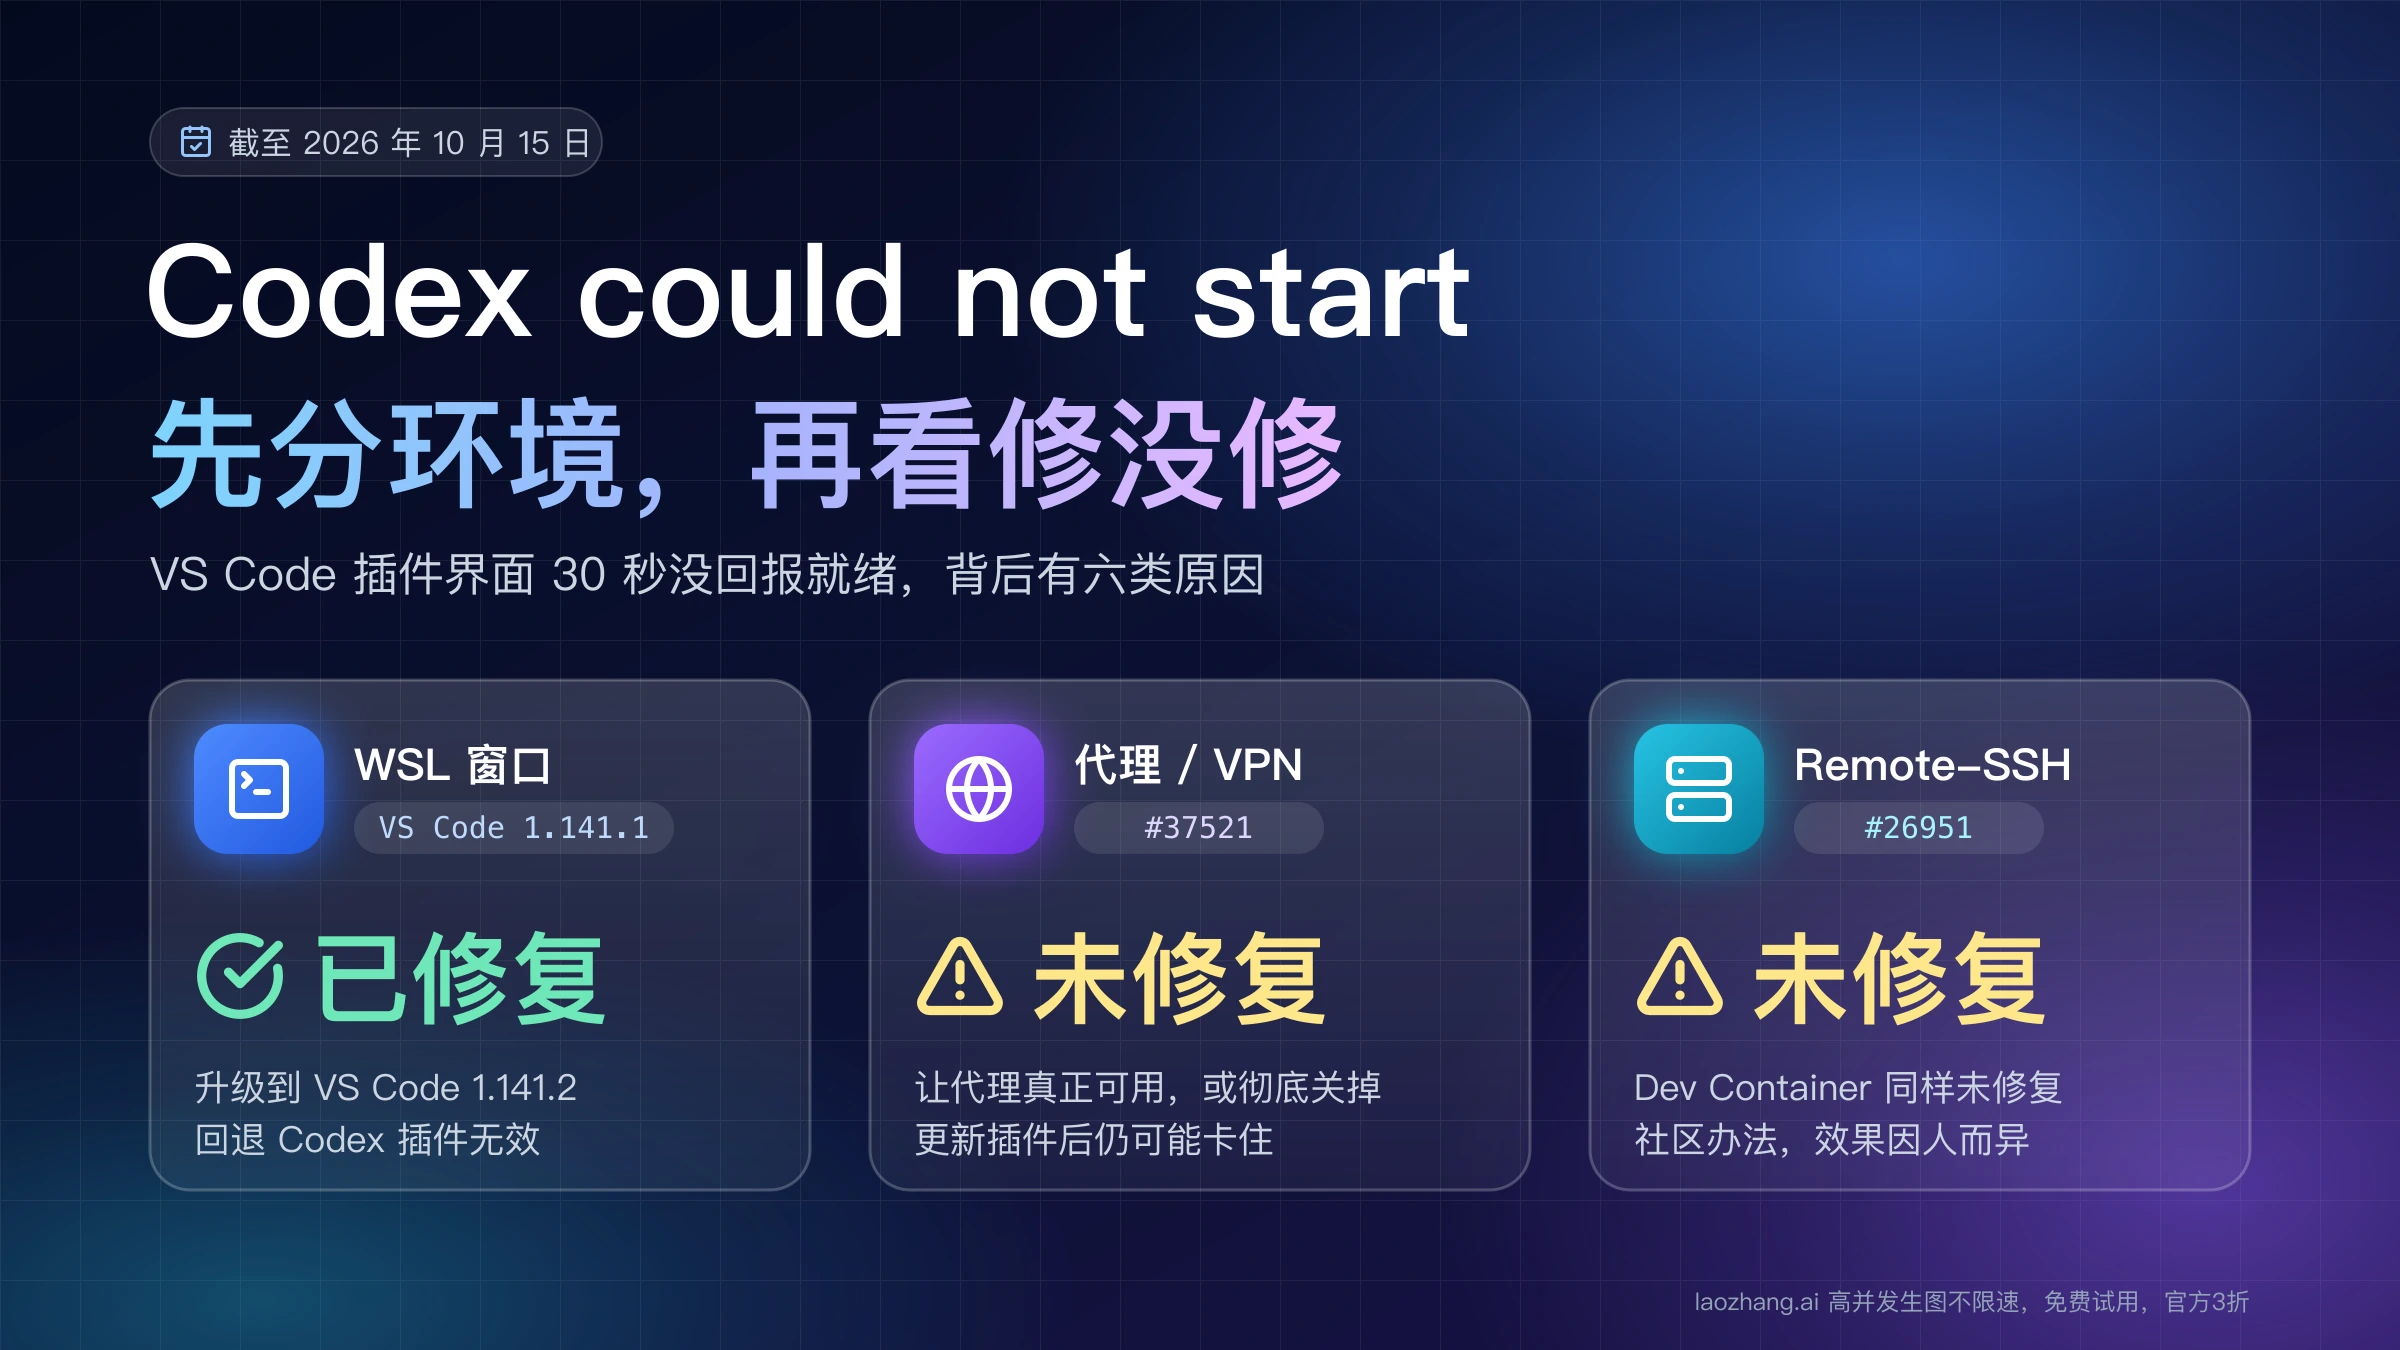
- VS Code 插件面板一直转圈后报 could not start:见 Codex could not start 报错:VS Code 插件按环境排查,哪些已修复。
- 提示 Model not found 或 GPT-5.5 模型不存在:见 ChatGPT Model not found?Codex 提示 GPT-5.5 模型不存在:已退役。
- 让 Codex 帮你写 git 提交信息(commit message)时生成失败,是另一个功能的问题,和发消息无关。
点重试之前:先确认这条消息是不是已经发出去了
「失败」不一定等于「没发出去」,这一步决定了重发安不安全。
报告里两种情况都有。一种是消息根本没到 app-server,也没有写进会话记录,重发很安全,这在超时和 agent loop died 的报告里都出现过。另一种是消息已经送达、这一轮已经开始,只是界面没收到确认:Windows 上的 EPERM 报错里,有用户点重试后,同一条消息和代理的回复都出现了两遍(GitHub openai/codex #52012);9 月排队消息那批报告里,也有人发现报错时消息已经保存过一次、这一轮已经开始(#44781)。
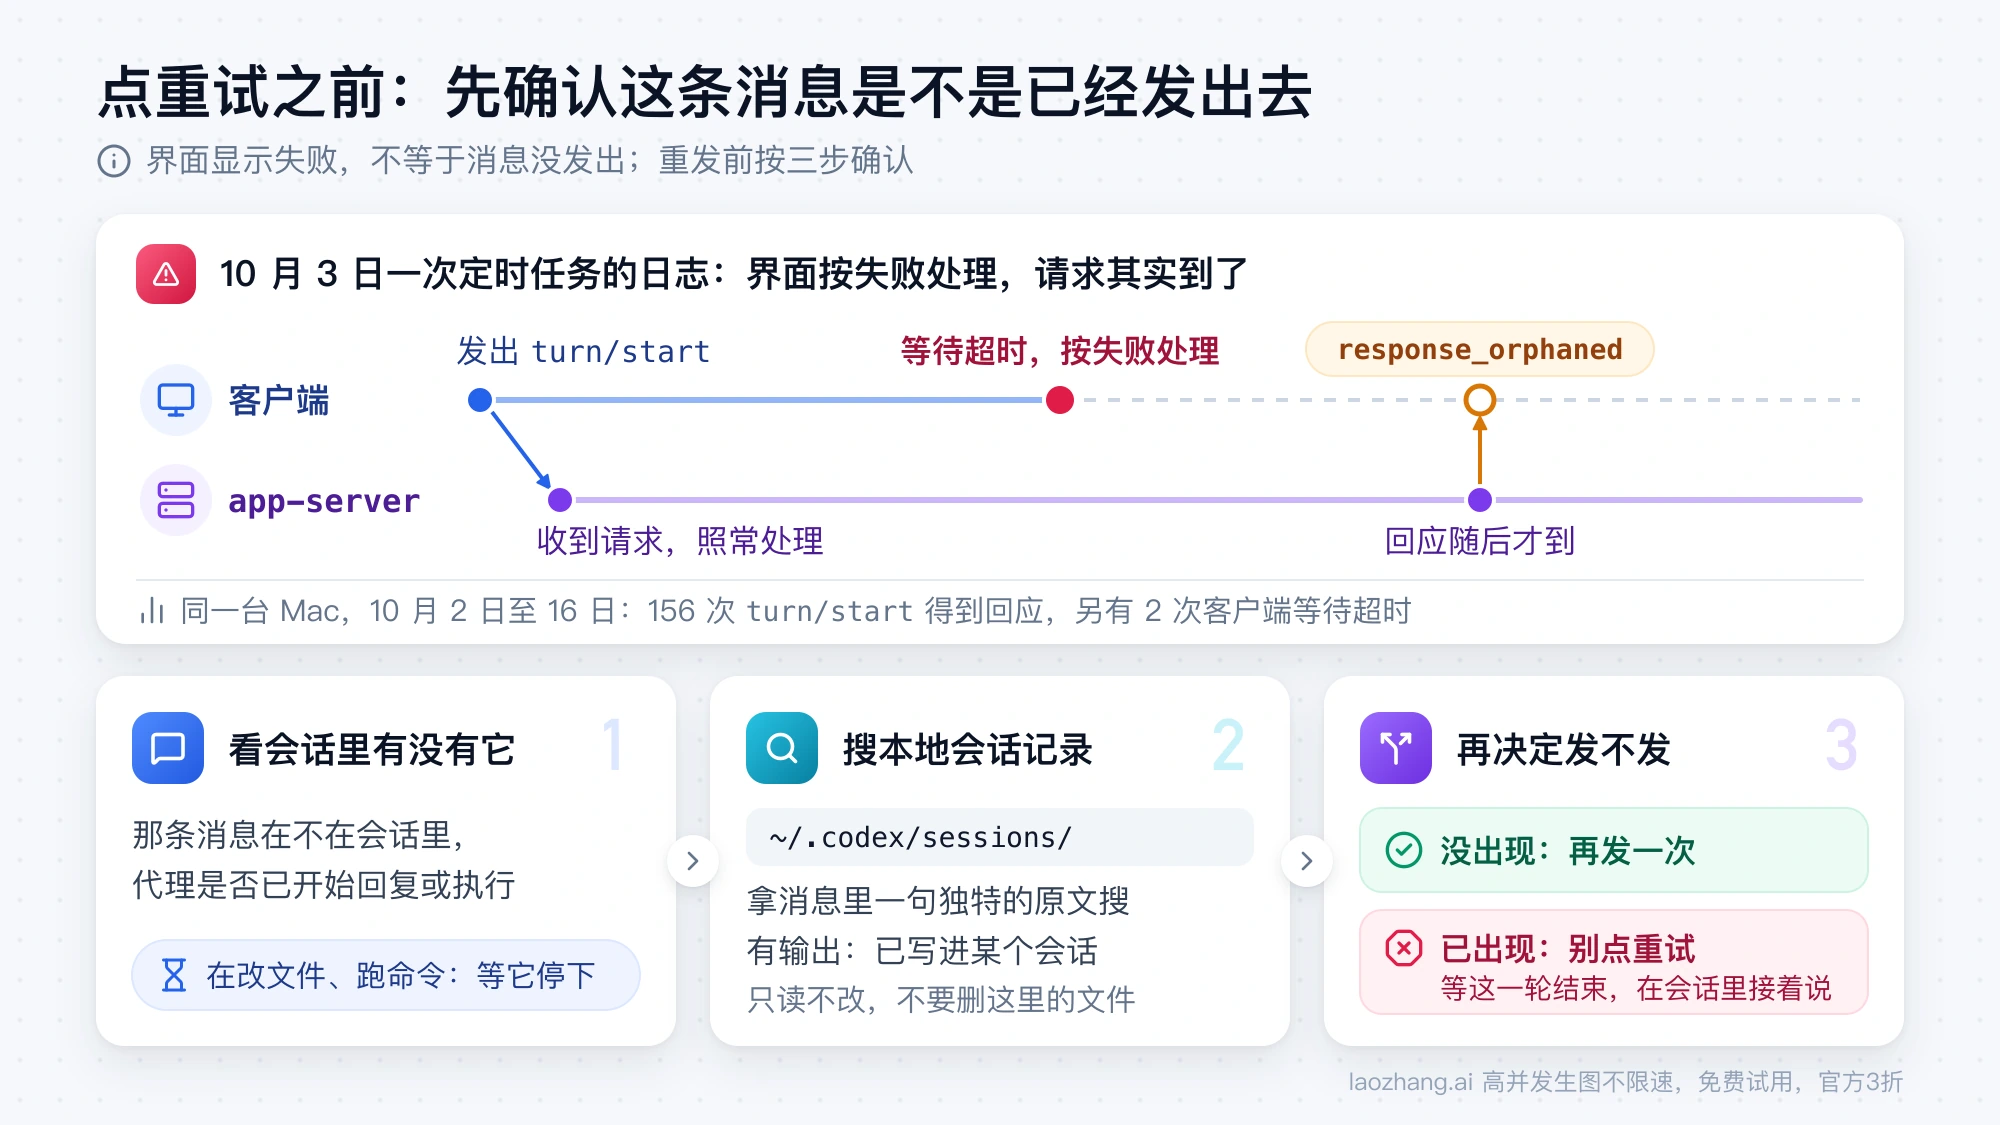
LaoZhang AI 团队那台 Mac 的日志里能看到后一种情况是怎么发生的。10 月 2 日至 16 日共有 156 次 turn/start 请求得到回应,耗时中位数 63 毫秒,95% 在 1,184 毫秒以内,最长 9,042 毫秒;另有 2 次客户端等待超时。其中一次发生在 10 月 3 日的一个定时自动化任务里:客户端已经报了超时,app-server 的回应随后才到,被记为 response_orphaned,也就是服务端处理了请求,客户端却已经按失败处理了。这只是一台机器、一个人的工作量,不代表普遍的失败率,但说明「界面显示失败、请求其实到了」确实会发生。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
重发前这样确认:
-
看会话里有没有你那条消息,代理是不是已经开始回复或执行命令。如果代理在改文件、跑命令,等它停下再说。
-
本地任务还可以查会话记录文件。记录按日期存在
~/.codex/sessions/年/月/日/下,每个会话一个rollout-….jsonl文件,中文按原文保存。在 macOS 或 Linux 上,拿消息里一句独特的原文搜当天的记录:grep -rl "消息里一句独特的原文" ~/.codex/sessions/2026/10/16有输出说明这句话已经写进了某个会话。Windows 上同样的文件在
%USERPROFILE%\.codex\sessions下。只读不改,不要手动删除这里的文件(原因见后文 rollout path 一节)。 -
消息没有出现,再重发一次;已经出现,就不要重试,等这一轮结束后在会话里接着说。
发不出去的文字要先保存。OpenAI 的故障排除页提到,取消运行后可以在输入框里按上方向键找回上一条提示词;但切换会话可能清掉排队中的其他消息(有一位用户报告过),所以长消息先复制到别处最稳妥。
只坏一个会话还是整个应用:换个会话发一句试试
在另一个会话或新会话里发一句很短的话,看结果分两种:
- 别的会话正常,只有这一个发不出。这是最常见的情况:排队消息失效、AbsolutePathBuf、thread not found、一个很大的旧会话超时,都只卡住单个会话或任务。不必重启整个应用,按下一节的对照表处理这个会话;实在救不回来,就在新会话里简要交代前情继续。
- 所有会话都发不出,或者新建聊天也失败。问题多半在应用或本机:app-server 卡住、旧的后台进程没退出、Windows 上状态文件写不进去。上面那台 Mac 的日志里,超时也是成批出现的,同一时段里
thread/start、thread/list、thread/resume、model/list等请求一起超时,说明 app-server 卡住时不只是发消息受影响。这时先彻底退出应用(不是关窗口)再打开。
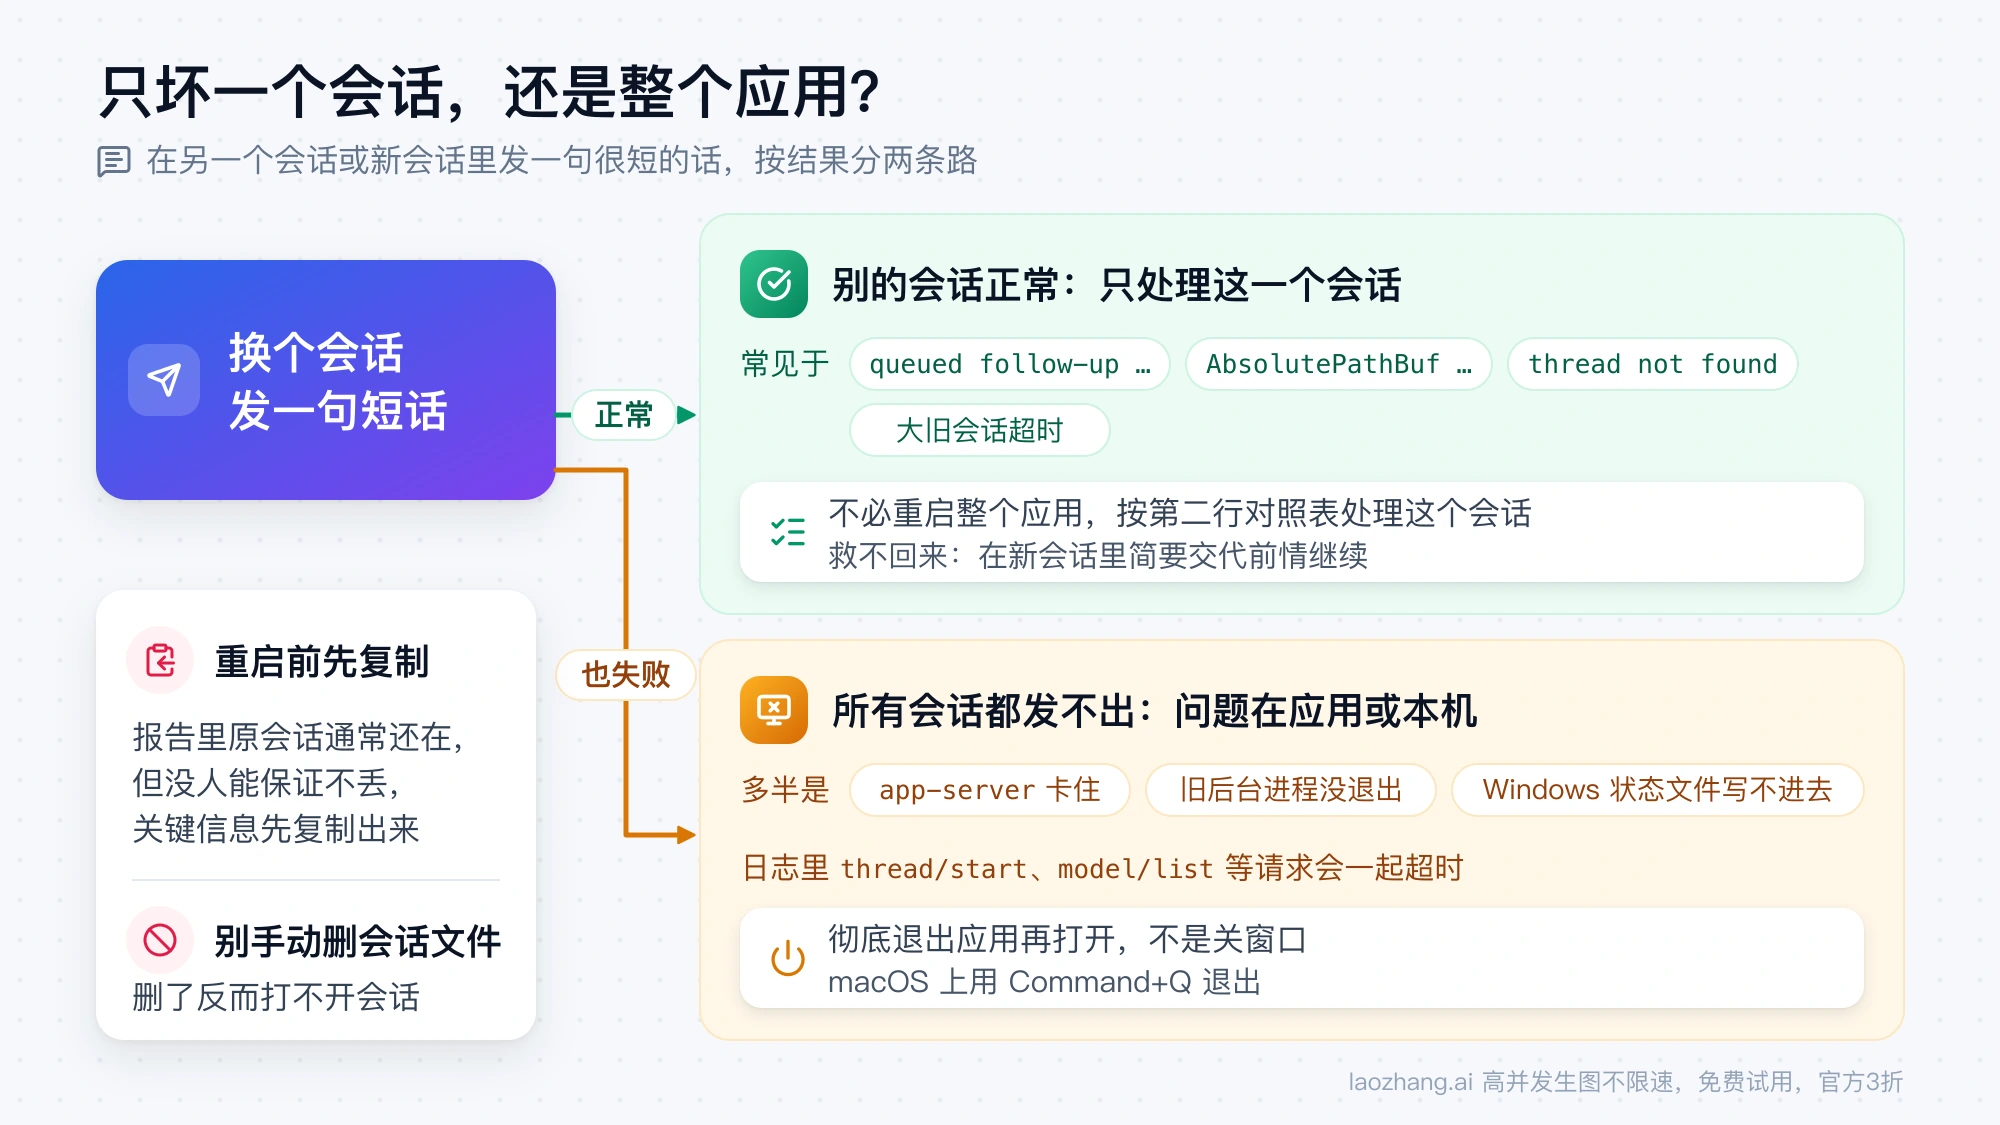
报告里重启后原来的会话通常还在,但没人能保证一定不丢,重启前把关键信息复制出来。
第二行报错对照表:17 种原文对应的场景和先做的事
左列只写第二行的开头,按你看到的原文对。"先做什么"一列是多位或至少一位报告者验证过的办法,标了"未验证"的是有人提议但没人确认。
| 第二行(原文开头) | 多见于 | 先做什么 |
|---|---|---|
没有第二行 / Timeout / App server request expired while queued | 应用开了好几天、会话很大、电脑很忙 | 等 1–5 分钟再发;不行就彻底退出重开,或开新会话 |
App-server queued follow-up no longer exists | 9 月的版本;编辑或撤回过排队中的追加消息 | 复制文字,切到别的会话再切回;或等这一轮结束、停止后重新发 |
Queued follow-up changed before dispatch | VS Code 插件里快速连发追加消息 | 稍等再重试;或改用 Interrupt 方式 |
invalid turn/start params: AbsolutePathBuf deserialized without a base path | Windows,直接回复 dot 创建的任务 | 输入框下方的权限从 Custom 改成 Approve for me |
failed to start turn / failed to submit turn input … agent loop died unexpectedly | 长会话;审批或交互提示没回应时 | 彻底退出重开(暂时有效);更新应用 |
Cannot steer conversation … | VS Code 插件,这一轮已结束、界面还在转 | 运行 Developer: Restart Extension Host |
thread not found | 刚打开一个旧会话就发消息 | 重启桌面版或新开一个窗口 |
failed to resolve rollout path … file does not exist | 手动删过 sessions 里的文件 | 不要再删;按下文恢复缺失的文件 |
EPERM: operation not permitted, rename … .codex-global-state.json | Windows 桌面版 | 先确认消息是否已发出,暂无已验证的修法 |
ENOENT: no such file or directory, mkdir '\\?' | Windows,不带项目的聊天 | 检查 config.toml 里的 projectlessWorkspaceRoot |
Unable to resolve projectless chat folder | Windows 远程控制 | 在主机上或用手机新建聊天 |
no client found | Remote SSH、同一会话开在多个窗口 | 关掉多余的窗口(未验证) |
Unable to determine project root for task | Codex 网页版、云任务 | 暂无已验证办法,别重置环境 |
a managed thread must retain its original environment | 网页版、桌面版、Android 上的托管任务 | 暂无已验证办法,别重置或删除环境 |
Input exceeds the maximum length of 1048576 characters. | 粘贴了超长文本 | 把文本拆小,或改成文件让 Codex 自己读 |
decoded message length too large … 4194304 bytes | 一次发很多浏览器批注 | 分批发送(未验证) |
Server is draining; retry after reconnecting | app-server 正在关闭 | 按原文所说,等重新连上后再发 |
另有一条 remote image URLs are not supported; use an inline data URL instead,意思是图片不能以网址的形式传入,报错原文已经给了做法:直接粘贴或上传图片。这一条和表中的 Input exceeds…、Server is draining… 来自开源 app-server 的代码,用户报告里还很少见到。
只有标题没有第二行,或第二行是 Timeout:多半是 30 秒超时
消息交给本地 app-server 后 30 秒内没有回应,客户端就放弃并报错。报告里常见的诱因有:应用连续开了三天多;会话本身极大(有人的会话记录有 154 MB);~/.codex/logs_2.sqlite 涨到 1.4–2.2 GB,同时被好几个 codex 进程共用;上次启动留下的 codex_chronicle 进程没退出;电脑 CPU 被别的程序占满。还有人实测,同一个项目里旧会话很慢,新会话很快。
报告有效的做法,从轻到重:
-
等 1–5 分钟再发一次。至少两位用户说这样就好了。重发前按上一节确认消息没有送达。
-
在新会话里继续。旧会话越来越慢、新会话正常时,这是最省事的办法。压缩上下文没有帮助(一位用户实测)。
-
彻底退出应用再打开。macOS 上用 Command+Q 退出,不是关窗口。多位用户说有效,但几天后会再犯。
-
清掉残留的
codex_chronicle进程(macOS)。先列出它的启动时间:ps -axo pid,lstart,etime,command | grep codex_chronicle如果有一个进程的启动时间早于你这次打开应用的时间,它就是上次留下的,结束它。报告者结束这个进程后,提交失败从 4 次降到 0 次(#27395)。Windows 上哪些 Codex 进程可以结束,见 Codex Windows 后台进程怎么处理:哪些该保留,哪些可以结束。
-
关掉占满 CPU 的其他程序,有一位用户这样解决。
logs_2.sqlite 文件很大时,没有任何报告者删除过它,也没人建议删除,不要把删它当成修法。Windows 上整个桌面版都变慢,可以对照 Codex Windows 应用变慢?先做 CLI 与桌面端路径检查。
App-server queued follow-up no longer exists:排队消息被编辑后失效
这是 2026 年 9 月最集中的一批,9 月 11 日到 10 月 1 日至少 7 个 issue,Windows、macOS、Linux 桌面版和 VS Code 插件 26.908.40401 都有。典型触发方式:一轮还在跑时你追加了一条消息,它进入排队;你点了编辑(或撤回),改完再发,就报这句。也有人没编辑、只是普通追加,或在自动压缩上下文之后遇到。一旦出现,这个会话里后面的消息也会接着失败,排队(Queue)和引导(Steer)两种方式都一样。
报告有效的做法:
- 先复制要发的文字,切到另一个会话,再切回来发。约 8 位报告者确认有效,有人在日志里看到切换后排队请求成功了。注意有一位用户说切换后其他排队中的消息被清空了。
- 等这一轮结束,或手动停止它,再把文字当作一条新消息发出。多位用户有效,也有人说只是"有时"有效。
删除那条消息、反复重启或更新,都被报告无效。
OpenAI 员工 etraut-openai 在 9 月 13 日回复:「The problem is understood. We have a fix in place, and it will be included in the next release.」(问题已明确,修复已就位,会包含在下一个版本里。)没有说是哪个版本。之后在 Windows 26.908.9136.0、macOS 26.908.70816 和 VS Code 26.908.40401 上,直到 9 月 21 日前后仍有报告。
截至 10 月 16 日,桌面版 26.1013.31256 的安装包里已经找不到这句报错,排队相关的错误改成了下一节的 Queued follow-up changed before dispatch。由此推断,更新到这个版本或更新的版本后,不应再看到这句旧报错;这是根据安装包内容做的推断,OpenAI 没有确认。如果你还在看到它,先把应用更新到最新版。
Queued follow-up changed before dispatch:VS Code 里连发追加消息
这句目前主要出现在 VS Code 插件里(26.930 到 26.1007 的版本,Windows 和 Linux 都有,#50914)。触发方式是在 chatgpt.followUpQueueMode 设为 queue 时,一轮还没跑完就快速连发 5–7 条追加消息。
报告者说多试几次最终能发出去;把追加方式改成 Interrupt 可以避开这个错误,代价是会打断当前的回复。重启、重新登录、清缓存、改用 Steer 都没用。社区里有人发布了修改已安装插件的补丁,那不是 OpenAI 的东西,不建议用。还有人模拟发现,插件恢复待发消息时,即使消息已被接收也可能再提交一次,所以这里重试前同样要先确认消息有没有发出。
最简单的预防是:一轮在跑时,把要补充的内容合成一条发,不要连发。
AbsolutePathBuf 报错:Windows 上回复 dot 创建的任务
完整原文是 invalid turn/start params: AbsolutePathBuf deserialized without a base path,日志里还会带 code=-32602 和 failureReason=invalid_config。这是 9 月底以来最活跃的一类,9 月 30 日到 10 月 15 日持续有新报告,覆盖 Windows 桌面版 26.909 到 26.1007 的多个版本,Windows 上的 ChatGPT 网页版也有人遇到。
触发条件很具体:任务是 dot 在一台已连接的 Windows 电脑上创建的(界面显示为 Cloud,"Runs on your computer when available"),你从桌面版输入框直接回复这个任务。任务记录能正常查看,dot 自己往任务里发的消息也照常能送达,只有你直接回复会失败。报告里失败请求的工作目录是混合格式,前半是 /tmp/codex-cloud-agent-…,后半接着 C:\Users\…。
报告有效的做法,都是按任务逐个处理:
- 把输入框下方的权限从 Custom 改成 Approve for me。4–5 位报告者确认有效。Approve for me 是让自动审核代你批准操作,生效的权限会随之改变;还有一位用户说,后来同一个任务又变回原来的权限,再次失败。
- 改成 Full Access。2 位报告者说有效,但他们都强调这会放宽权限,不是推荐做法。
- 把工作交接到一个新的本地任务,或 WSL 里的 Codex CLI 继续。有报告者用这种方式继续,并核对了工作目录里的文件没有丢。
重启、重装、更新、归档、Retry、换一个明确指定 Windows 文件夹的新任务,都被报告无效。截至 10 月 16 日,GitHub 和 X 上都没有 OpenAI 员工回应这一类。
agent loop died unexpectedly:长会话里的代理循环退出
原文是 failed to start turn: internal error; agent loop died unexpectedly 或 failed to submit turn input: internal error; agent loop died unexpectedly,常和「创建聊天时出错」一起出现,随后每次发送都报提交消息时出错。报告从 5 月持续到 10 月 10 日,macOS 和 Windows 都有。
报告里的诱因:Codex 弹出的交互提示一直没回应,过一阵再回来;让子代理关闭;工作区开了很久、压缩过很多次;审批操作时正好撞到 Plus 的 5 小时用量上限,额度恢复后这个会话仍然发不出,编辑消息还会提示 "Failed to edit message"。额度什么时候恢复,见 Codex 每周限额什么时候重置?恢复时间与即时重置说明。
约 6 位报告者说彻底退出再打开有效,但只是暂时的;有一位说更新应用后好了,原来那个"死掉"的会话也没丢。其他会话通常照常能用。有报告显示失败的消息没有写进会话记录,这种情况下重发不会重复,稳妥起见仍按前文先确认一次。
Cannot steer conversation:VS Code 插件以为这一轮还在跑
在 VS Code 插件里,有时会接连看到提交消息时出错、timeout,以及 Cannot steer conversation 后面跟着 "without an active turn id"。一位 Ubuntu 用户(插件 26.1007.21434)在 OpenAI 开发者论坛贴出了时间线:后端已经把这一轮记为完成,30 多秒后插件以"没有进行中的一轮"拒绝了他的追加消息,之后几分钟里每次发送都超时,其他会话的事件却照常到达。他找到的唯一办法是在命令面板运行 Developer: Restart Extension Host,这会连带重启其他扩展。原因还没确认,他自己的推测是插件里记录的这一轮状态过期了。
有人提议新开一个 Codex 面板,再从历史记录里重新打开这个会话,没人确认过。桌面版安装包里也有类似的报错 "Cannot steer conversation … because its active turn already ended",处理思路一样:这一轮已经结束,把追加内容作为一条新消息发出。
Windows 上的 EPERM、ENOENT 与 projectless chat folder 报错
这三类都只在 Windows 上报告过。
EPERM: operation not permitted, rename。完整原文是把 .codex-global-state.json.tmp-… 重命名为 .codex-global-state.json 时被拒绝,日志里还有 "Failed to persist queued submission outcome"。Linux.do 上 9 月 30 日有中文用户发帖问「codex提交消息总是出错是为什么」,帖中的报错以 EPERM: operation not permitted, rename 'C:\Users\…\.codex\ 开头,是同一类。GitHub 上的报告(#52012,Windows 10 和 11,26.1002 到 26.1007)说,有些消息界面显示失败、其实已经送达代理,点重试后用户消息和代理回复都重复了。重建状态文件、彻底重启、停止 Windows Search 都没用,目前没有已验证的修法。能做的是:每次报错都先按前文确认消息是否已发出,不要直接点重试。
ENOENT: no such file or directory, mkdir '\?'。出现在不带项目的聊天里。报告者发现原因是 ~/.codex/config.toml 里 [desktop] 下的 projectlessWorkspaceRoot 指向了一个已经不存在的文件夹,把它改成一个存在的文件夹、重启应用后恢复(#52386)。桌面版 26.1013.31256 里确实有这个设置项。
Unable to resolve projectless chat folder。出现在通过远程控制使用 Windows 电脑时,10 月 16 日仍有用户在 26.1007.9446.0 上报告。报告者的办法是在主机上从一个正常的会话新建指向现有项目的聊天,或者用手机在同一台主机上新建不带项目的聊天。
thread not found 与 rollout path 报错:会话没加载或文件被删
thread not found。常见于刚打开一个存档的旧会话就立刻发消息,或者界面以为会话已恢复、app-server 那边其实没加载。报告有效的是重启桌面版,或新开一个窗口再打开这个会话;分叉会话(fork)没用。最近一份报告是 10 月 15 日,只有截图。
failed to resolve rollout path … file does not exist,常和 "Codex app-server is not available" 一起出现,表现是每个新会话都失败、CLI 却正常。报告者事先手动删过 ~/.codex/sessions 里的会话文件。有一位用户这样恢复:复制一个新任务的记录文件,把文件名里的 ID 改成报错里缺失的那个,补回去之后,在应用里先归档、再删除那个会话(#30924)。重装应用、换一个全新的 .codex 目录都没解决。
所以:不要手动删除 ~/.codex/sessions 里的文件,要清理会话用应用里的归档和删除;如果想用全新配置排查,先把整个 .codex 目录备份。
Codex 网页版云任务:project root 与 original environment 暂无解法
网页版和云任务上有两句报错,截至 10 月 16 日都没有已验证的办法:
Unable to determine project root for task,9 月 30 日到 10 月 4 日的报告,Plus 用户在 Windows 和 macOS 的浏览器里都有,第一条消息和追加消息都可能失败。强制刷新、编辑后重新发布环境都没用;有人在 Mac 应用里重建环境后,Mac 应用里能聊了,浏览器里照旧失败;OpenAI 支持建议新建环境,有用户照做后卡在任务创建确认上 24 分钟。有人发现 dot 仍能把消息转进这个会话。a managed thread must retain its original environment,10 月 12 日到 16 日的报告,桌面版、网页版和 Android 都有,网页上可能同时显示 "Something went wrong. Request ID"。
报告者反复提醒的一点:在工作内容保存下来之前,不要重置或删除环境。
反馈给 OpenAI 时带上什么:会话 ID、版本号和第二行原文
OpenAI 截至 10 月 16 日的公开说明很少:故障排除页没有提到这个报错,更新记录里没有点名修复它的版本,OpenAIDevs 官方账号和几位常在 X 上回应 Codex 问题的员工,自 9 月 10 日以来也没有发过相关内容。唯一的员工回复就是前面那条针对排队消息的。所以反馈本身有用,尤其是 AbsolutePathBuf、EPERM 和云任务这几类还没人回应的。
按故障排除页的说法,反馈这样做:
- 在出问题的会话里,在输入框输入
/调出反馈,可以选择附上当前会话。提交后会拿到一个会话 ID,发 issue 时带上它。 - 写清版本号。ChatGPT 桌面版和 Codex CLI 可能带着不同版本的 Codex,在 macOS 上分别用
codex --version和/Applications/Codex.app/Contents/Resources/codex --version查看。 - 贴出第二行的完整原文,以及你在做什么时出现(是否在一轮进行中追加、是否是 dot 创建的任务、是否在 VS Code 里)。
- 需要日志时,macOS 的应用日志在
~/Library/Logs/com.openai.codex/年/月/日。日志和会话记录里可能有代码、路径和密钥,分享前先检查一遍。
先在 GitHub openai/codex 仓库里搜第二行原文,已有的 issue 补充你的版本和情况,比新开一个更容易被看到。上文的 issue 编号都可以在仓库里直接搜到。
常见疑问
Codex 提交消息时出错,重启会不会丢会话?
已有报告里,彻底退出重开或更新应用后,原来的会话通常还在,有一位用户特意说明那个发不出消息的会话没丢。但没人能保证,重启前把没发出去的文字和关键结论复制出来。真正导致会话打不开的报告,是手动删除了 ~/.codex/sessions 里的文件。
删掉 .codex 文件夹能修好提交消息时出错吗?
报告里没有这样修好的例子。有用户换了全新的 .codex 目录仍然失败,手动删会话文件还引出了 rollout path 报错。要用全新配置排查,先把整个目录备份,再按第二行对应的办法处理。
Codex 恢复对话失败,和提交消息时出错是一回事吗?
不完全是。打开旧会话后一发消息就报 thread not found,属于本页的情况,重启桌面版或新开窗口通常能恢复;如果打开会话本身就失败、或每个新会话都报 failed to resolve rollout path,多半是会话文件缺失,按上文 rollout path 一节处理。
提交消息时出错是不是 Codex 服务挂了?
大多数情况不是。多数原因出在本机的 app-server、单个会话的状态或某种任务类型上,换一个会话发一句短话就能分辨。只有所有会话、网页版和 CLI 都同时失败,才更像是服务端的问题;第二行是 Selected model is at capacity 时,确实是服务端容量不足。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月16日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月16日。