Gemini 3.8 Flash TTS:选型、调用、成本与迁移
量产用 Flash-Lite TTS,表演和双人对话用 Flash TTS;按每秒 25 token 换算,2026 年每小时音频 $0.54 或 $0.81,2027 年翻倍。
文章目录
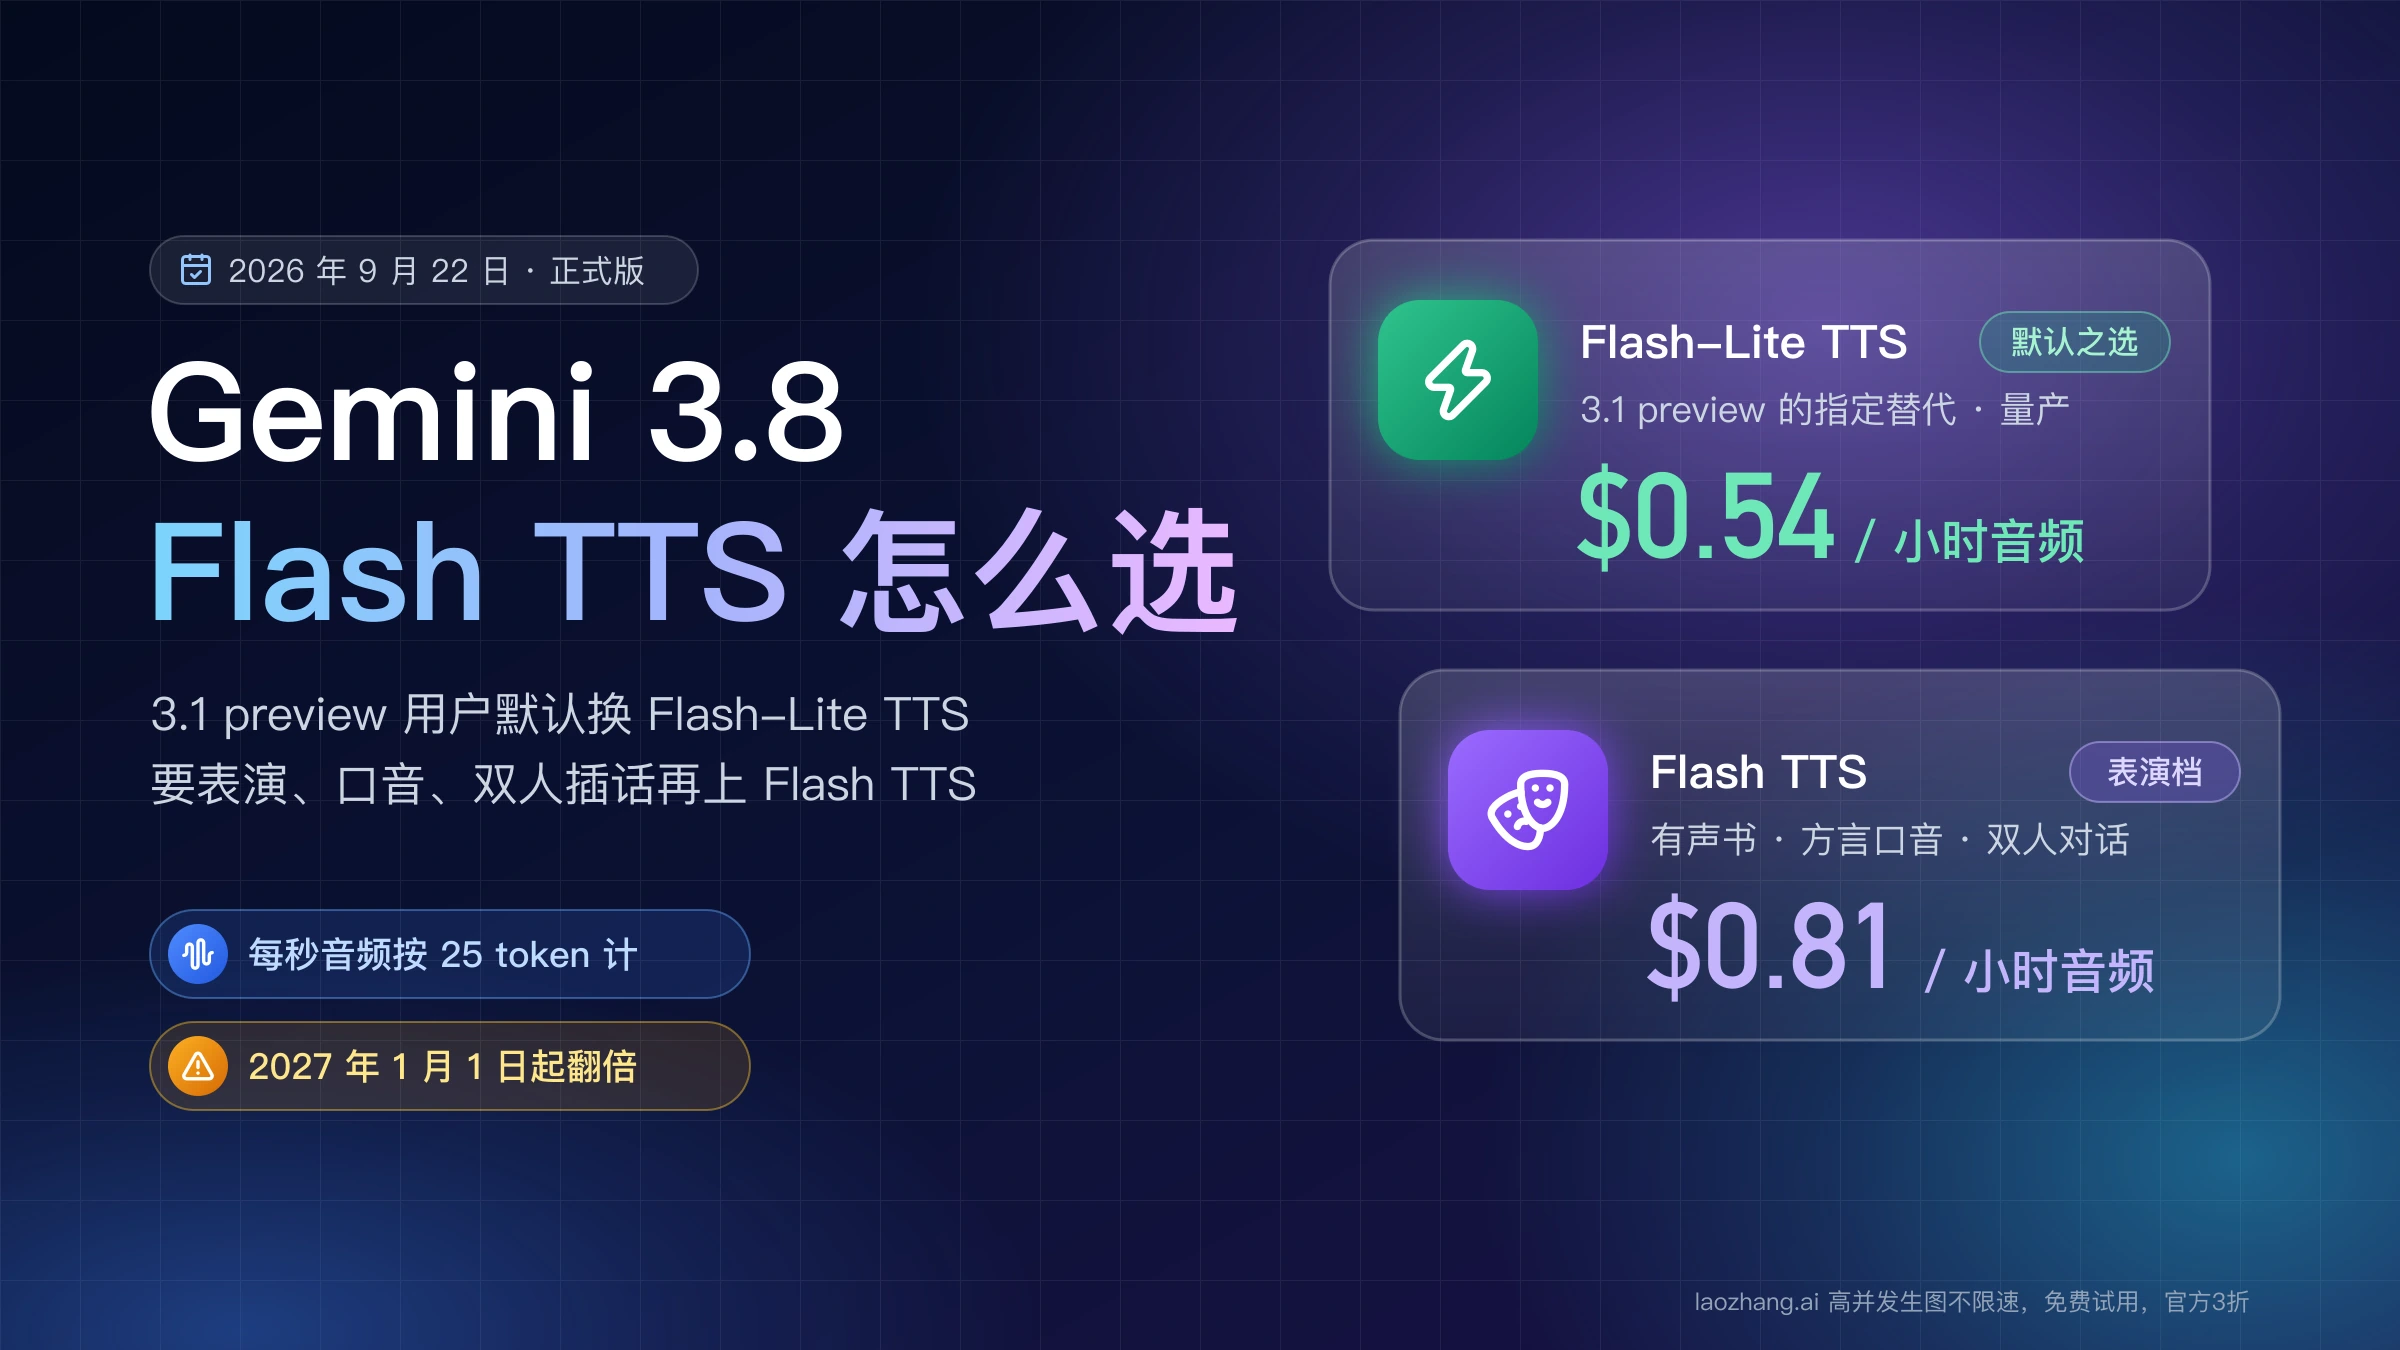
Google 在 2026 年 9 月 22 日的 Gemini API 更新日志里把两款文本转语音模型标为正式版:gemini-3.8-flash-tts 与 gemini-3.8-flash-lite-tts,同时上线了声音接口 /v1beta/voices;9 月 23 日官方博客正式发布。两款模型共用完全相同的请求结构,换模型只改一个字符串,所以选型可以先用一条规则回答:还在用 gemini-3.1-flash-tts-preview 的项目直接换成 Flash-Lite TTS,这是官方指定的替代品;需要细腻表演、地区口音、双人插话或长篇朗读不跑调时,再换到 Flash TTS。
价格方面,标准通道的音频输出 Flash TTS 为每百万 token $9.00,Flash-Lite TTS 为 $6.00。按官方脚注"每秒音频对应 25 个 token"换算,一小时音频分别约 $0.81 与 $0.54,这两个数从 2027 年 1 月 1 日起翻倍。免费层可以先试,但速率限制页没有公开 3.8 TTS 的具体限额。下面的代码改写自截至 2026 年 9 月 24 日更新的官方文档,运行前把文稿换成你的内容;延迟与音质请用自己的稿子验证。
先定模型:Flash、Flash-Lite,还是 Live API
两款模型的差别不在接口,而在音质档位和价格。官方模型页的对照如下:
| 对比项 | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
|---|---|---|
| 官方定位 | 旗舰创作档:最高音质、表演细腻度、方言覆盖 | 高吞吐、低延迟、低成本 |
| 适合的场景 | 有声书、工作室级旁白、复杂双人对话、大量口头声效、难读发音、地区方言 | 批量生产、实时语音助手的合成环节、朗读功能、声音复刻、日常单人合成 |
| 支持语言 | 130 多种 | 101 种 |
| 替代关系 | 新增的旗舰档 | gemini-3.1-flash-tts-preview 的指定替代 |
| 标准通道音频输出,2026 年 | $9.00 / 百万 token,约 $0.81 每小时 | $6.00 / 百万 token,约 $0.54 每小时 |
| 简体中文、繁体中文、粤语 | 支持 | 支持 |
判断时先问三个问题:
- 文稿是不是逐字念出来就行? 是,就用 TTS。语音助手的"语音输入、模型思考、语音回复"整条链路里,TTS 只负责最后一环:上一环的文字转写可以交给 Gemini 3.5 Transcribe,中间生成台本可以用 Gemini 3.8 Flash,每收到一轮回复文字就发一次 TTS 请求。如果你要的是用户说话、模型边听边答、可以随时打断的双向实时对话,那是 Live API 的范围,TTS 模型页明确写着"Live API:不支持",参考 Gemini 3.1 Flash Live API。
- 有没有表演需求? 单人播报、客服回复、朗读功能,Flash-Lite TTS 够用,而且是官方推荐的默认选择。要角色扮演、方言口音、双人对话里的插话和抢话、几分钟不跑调的长旁白,选 Flash TTS。Google 引用的 Hume AI 声音设计榜单里 Flash TTS 排第一,Hume AI 整体质量指数里 Flash TTS 第一、Flash-Lite TTS 第二,这些是 Google 自己公布的名次。
- 还在 2.5 TTS 上吗? 更新日志 9 月 18 日的说明是,2.5 系列模型只对"过去活跃使用过"的用户开放,新项目请用最新模型。这条说明针对整个 2.5 系列,
gemini-2.5-flash-preview-tts和gemini-2.5-pro-preview-tts都在其中,新项目不要再规划在它们上面。
Vertex AI 或 Google Cloud Text-to-Speech 的用户还要再等:截至 2026 年 9 月 30 日,Cloud TTS 的 Gemini-TTS 页面只列到 gemini-3.1-flash-tts-preview 和 2.5 系列,官方博客说企业版接口"即将通过 Gemini Enterprise 提供"。后面的代码、价格与限制都只针对 Gemini API(AI Studio 密钥)这一条路。
第一个请求:单说话人、双说话人与流式
准备工作只有两步:在 Google AI Studio 里创建密钥并放进环境变量 GEMINI_API_KEY(步骤见 Google AI Studio API Key 怎么创建),再安装 SDK。声音接口要求 google-genai 2.25.0 或 @google/genai 2.24.0 以上,装最新版即可。
单说话人:返回的是完整 WAV
import base64
from google import genai

client = genai.Client()  # 自动读取环境变量 GEMINI_API_KEY

interaction = client.interactions.create(
    model="gemini-3.8-flash-lite-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "各位好,欢迎收听本期节目。今天聊的是语音接口该怎么选。",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and relaxed",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": "Kore"},
        ]
    },
)

with open("intro.wav", "wb") as f:
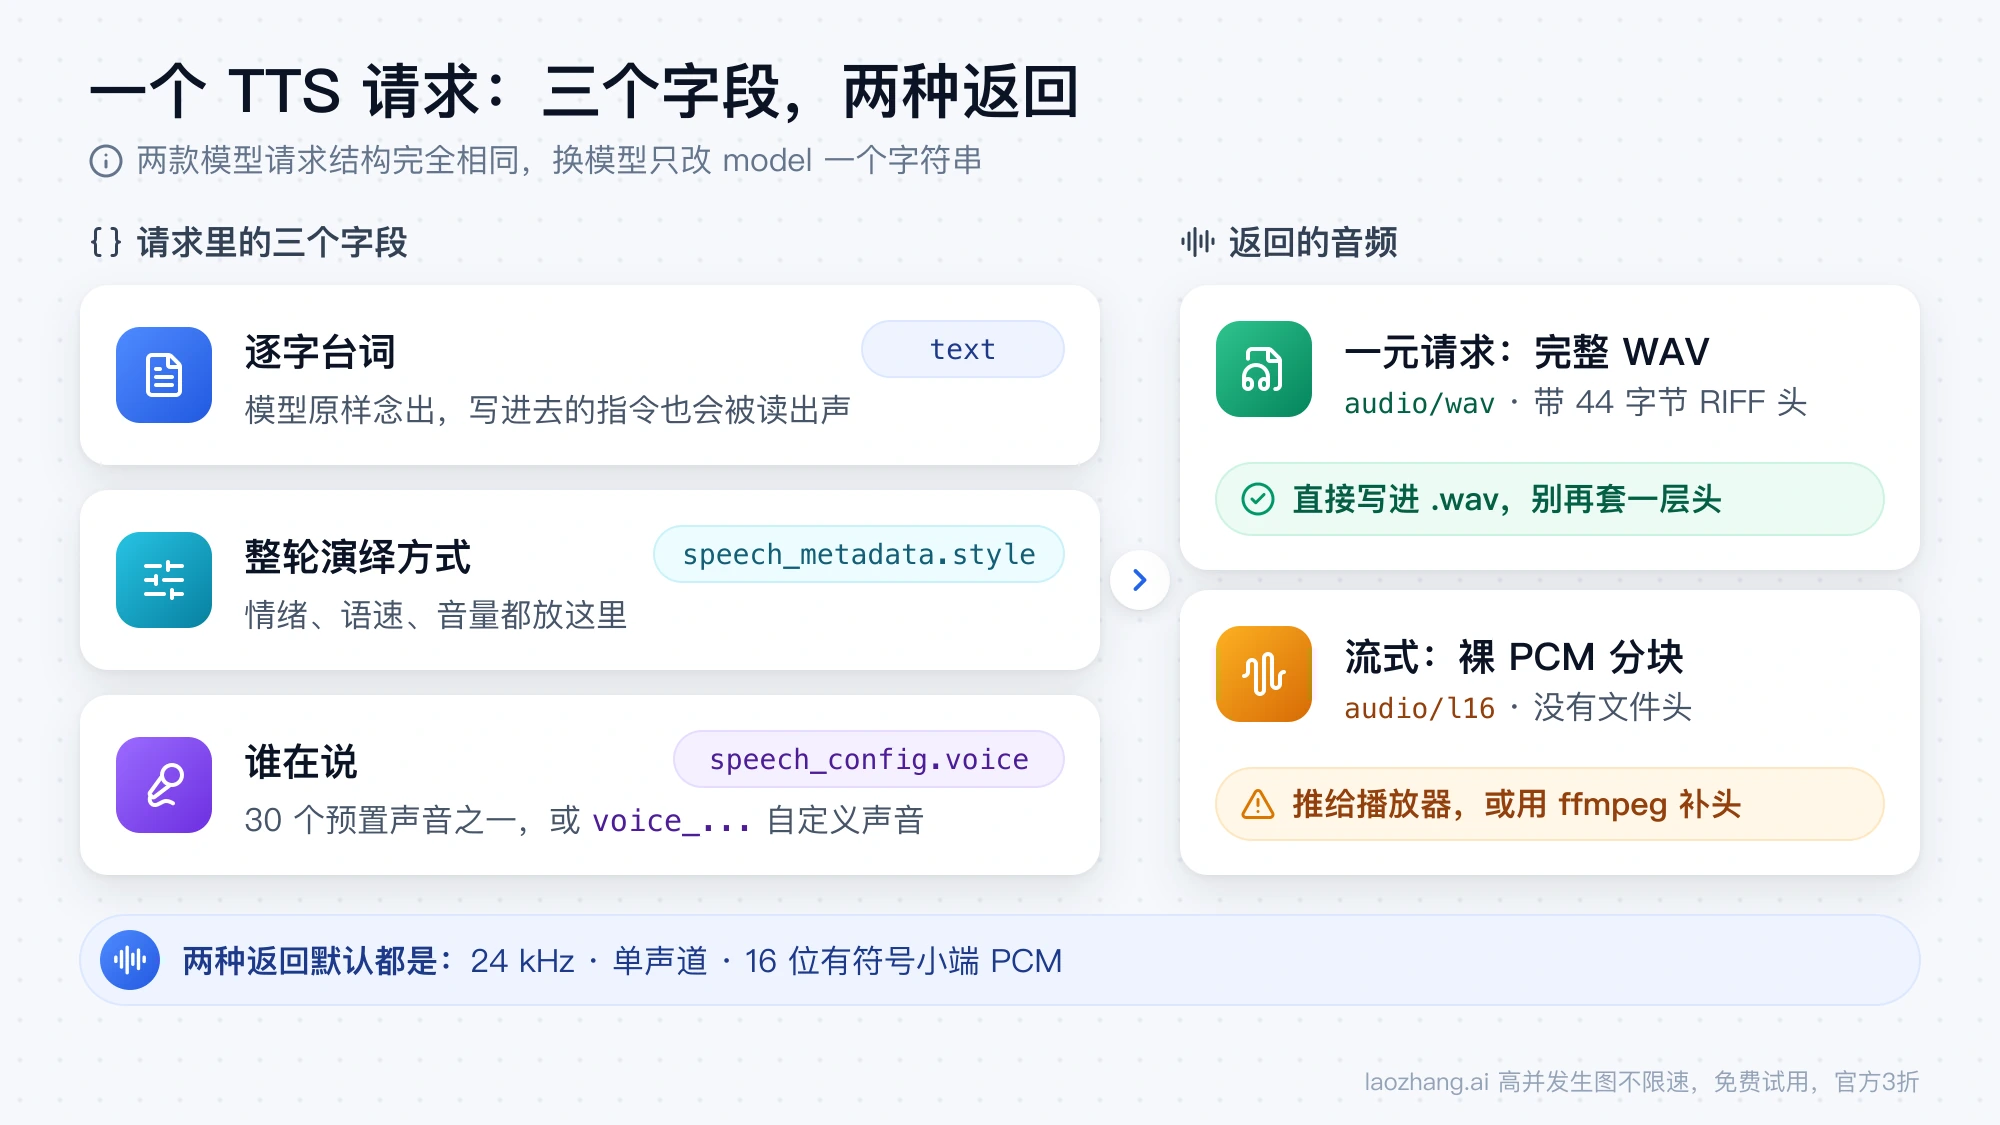
f.write(base64.b64decode(interaction.output_audio.data))三个字段各管一件事:text 是逐字台词,模型会原样念出来,任何"请用开心的语气"之类的指令写在这里都会被读出声;speech_metadata.style 是这一轮的整体演绎方式,情绪、语速、音量都放这里;speech_config 里的 voice 决定谁在说,可以是 30 个预置声音之一,也可以是后面讲到的 voice_... 自定义声音 ID。输入语言由模型自动识别,不需要声明。
返回值 interaction.output_audio.data 是 base64 字符串,解码后就是带 44 字节 RIFF 头的完整 WAV:24 kHz、单声道、16 位有符号小端 PCM。直接写进 .wav 文件即可,不要再用 wave 模块给它套一层头。
同一个请求用 REST 发送,音频在 steps[].content[].data 里,取最后一个 audio 块解码:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.8-flash-lite-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "各位好,欢迎收听本期节目。",
        "annotations": [{ "type": "speech_metadata", "style": "warm and relaxed" }]
      }]
    }],
    "response_format": { "type": "audio" },
    "generation_config": { "speech_config": [{ "voice": "Kore" }] }
  }' | jq -r '[.steps[] | select(.type=="model_output") | .content[] | select(.type=="audio")] | last | .data' | base64 --decode > intro.wav
双说话人:conversational 模式
播客、访谈、剧情对白用 speech_config.speakers 配两个说话人,mode 设为 conversational,每一轮台词各自带上 speaker:
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [
            {
                "type": "text",
                "text": "上周那个语音客服项目,最后是怎么把延迟压下来的?",
                "annotations": [{
                    "type": "speech_metadata",
                    "speaker": "Host",
                    "style": "curious, leaning in",
                }],
            },
            {
                "type": "text",
                "text": "<laugh> 说来话长。后来把每一轮回复拆成短句 |嗯嗯| 再逐句合成,用户听到第一句的时间就短多了。",
                "annotations": [{
                    "type": "speech_metadata",
                    "speaker": "Guest",
                    "style": "amused, storytelling",
                }],
            },
        ],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": {
            "mode": "conversational",
            "speakers": [
                {"speaker": "Host", "voice": "Puck"},
                {"speaker": "Guest", "voice": "Kore"},
            ],
        }
    },
)

with open("dialogue.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
这段代码里有三个约定:每一轮都必须写 speaker,且要与 speakers 里配置的名字一致;尖括号标签只描述某个时间点的人声动作,比如笑、叹气、咳嗽、短暂停顿,官方要求即使台词是中文,标签也保持英文;竖线包住的一到三个词是另一位说话人在背景里的插话,会与当前说话人同时发声,官方说明这个效果在 Flash TTS 上最好。单个请求最多两个说话人,而且只能用预置声音;想让自定义声音对话,要逐轮合成再拼接,后面的限制一节会讲怎么拼。
流式:默认返回裸 PCM
语音助手要在第一句合成完就开始播放,用 stream=True。流式返回的不是 WAV,而是没有文件头的 16 位 PCM 分块,同样是 24 kHz 单声道:
stream = client.interactions.create(
    model="gemini-3.8-flash-lite-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "好的,已经帮您查到了,订单预计明天下午送达。",
            "annotations": [{"type": "speech_metadata", "style": "calm and helpful"}],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={"speech_config": [{"voice": "Kore"}]},
    stream=True,
)

with open("reply.pcm", "wb") as f:
    for event in stream:
        if event.event_type == "step.delta" and event.delta.type == "audio":
            f.write(base64.b64decode(event.delta.data))
每个 step.delta 事件里的 delta.data 解码后可以直接推给播放器,播放器按 24000 Hz、1 声道、16 位有符号小端来配置。如果要把分块落成文件再听,需要自己补文件头,用 ffmpeg 一行就够:
ffmpeg -f s16le -ar 24000 -ac 1 -i reply.pcm reply.wav输出格式:什么时候改 mime_type
一元请求默认 audio/wav,流式默认 audio/l16,两者都可以在 response_format 里显式指定,并附带 sample_rate:
| mime_type | 内容 | 适用 |
|---|---|---|
audio/wav | 带 RIFF 头的 WAV,16 位 PCM,单声道,默认 24 kHz | 一元请求默认;直接存文件 |
audio/l16 | 无文件头的 16 位线性 PCM,24 kHz 单声道 | 流式默认;拼接多段、送入播放管线 |
audio/mulaw | 8 位 G.711 μ-law | 北美与日本的电话/IVR 系统 |
audio/alaw | 8 位 G.711 A-law | 欧洲及国际电话系统 |
采样率可以设 24000、16000 或 8000。电话客服接 8 kHz 的线路时,直接让接口输出 audio/mulaw 或 audio/alaw 并把 sample_rate 设为 8000,比拿到 WAV 再转码少一道工序。
成本:按每秒 25 token 换算
价格页对两款模型都写了同一条脚注:音频输出按每秒 25 个 token 计。由此得到换算基数:
- 1 分钟音频 = 1,500 个输出 token
- 1 小时音频 = 90,000 个输出 token
- 每小时成本 = 90,000 ÷ 1,000,000 × 每百万 token 的输出价
代入价格页的各通道数字,得到下面的每小时音频成本。这是按公式推导的数值,实际时长取决于模型的语速,重试与失败的生成不在其中:
| 通道 | 模型 | 2026 年输出价 / 百万 token | 2026 年每小时 | 2027 年起每小时 |
|---|---|---|---|---|
| 标准 | Flash TTS | $9.00 | 约 $0.81 | 约 $1.62 |
| 标准 | Flash-Lite TTS | $6.00 | 约 $0.54 | 约 $1.08 |
| Batch 或 Flex | Flash TTS | $4.50 | 约 $0.41 | 约 $0.81 |
| Batch 或 Flex | Flash-Lite TTS | $3.00 | 约 $0.27 | 约 $0.54 |
| Priority | Flash TTS | $16.20 | 约 $1.46 | 约 $2.92 |
| Priority | Flash-Lite TTS | $10.80 | 约 $0.97 | 约 $1.94 |
对照旧模型:gemini-3.1-flash-tts-preview 的音频输出是每百万 token $20.00,合每小时 $1.80;gemini-2.5-flash-preview-tts 是 $10.00,合每小时 $0.90。也就是说,从 3.1 preview 换到 Flash-Lite TTS,2026 年内每小时音频从 $1.80 降到 $0.54;即便 2027 年涨到 $1.08,仍低于 3.1 preview 的现价。
文本输入按标准通道每百万 token $0.50 计,几乎可以忽略:单个请求的输入上限是 8,192 个 token,全部用满也只有约 $0.004。所以估算时只算音频输出就够了。举一个具体例子:一期 30 分钟的双人播客,音频输出 30 × 1,500 = 45,000 个 token,用 Flash TTS 标准通道是 45,000 ÷ 1,000,000 × $9.00 ≈ $0.41,用 Flash-Lite TTS 约 $0.27。注意单个请求的输出上限是 16,384 个 token,按同一规则约合 655 秒、不到 11 分钟音频,30 分钟的节目至少要拆成三个请求。
免费层的情况是:标准与 Priority 通道对两款模型都"免费",Batch 与 Flex 在免费层不可用;免费层的数据会被 Google 用于改进产品,付费层不会。截至 2026 年 9 月 30 日,速率限制页没有列出 3.8 TTS 的每分钟请求数或每日请求数,实际限额只能在 AI Studio 的"活跃速率限制"里查看,怎么看以及为什么多个 Key 共享同一额度见 Gemini API 免费层速率限制 2026。付费后还有按 10 分钟计的消费上限:Tier 1 为 $10,Tier 2 为 $50,Tier 3 为 $200,批量生产有声书时要按这个上限安排并发。
从 3.1 preview 或 2.5 迁移:五处断点
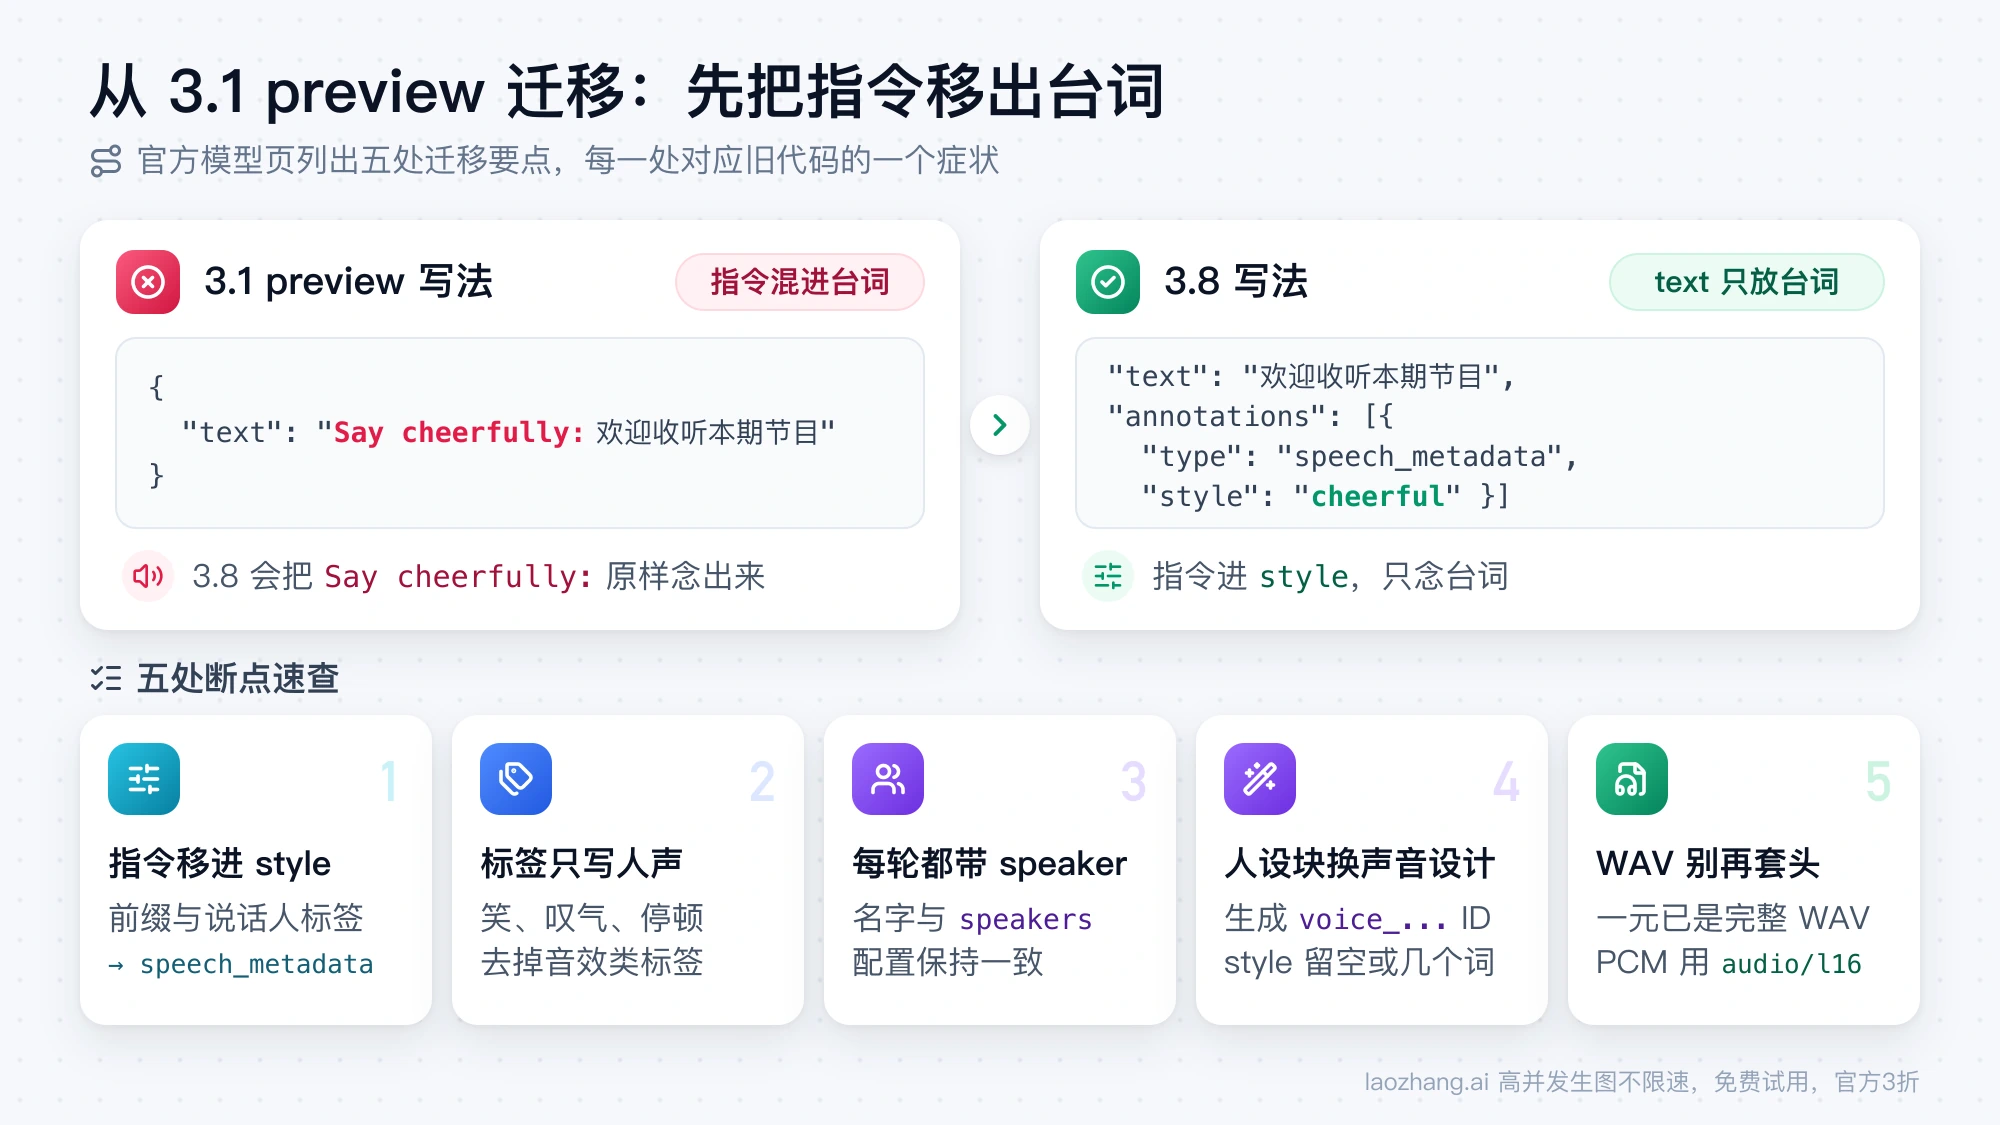
官方模型页列了五项迁移要点,每一项都对应旧代码的一个具体症状:
| 变化 | 旧代码的症状 | 改法 |
|---|---|---|
| 文本被严格当作逐字台词 | "Say cheerfully:" 或 "Speaker 1:" 这类前缀被念出来 | 指令移到 speech_metadata.style,说话人标签移到 speech_metadata.speaker |
| 尖括号只用于时间点上的人声事件 | 旧文稿里把掌声、撞击声写成标签,或把耳语这种持续状态写成标签 | 标签只写笑、叹气、咳嗽、呼吸、停顿这类人声,官方要求去掉音效类标签;耳语等持续风格写进 style |
多人请求每轮必须有 speaker | 旧写法靠文本里的 "Joe:" 前缀区分说话人,3.8 会把前缀念出来 | 每个 text 块都带 speaker,名字与 speakers 配置一致 |
| 长篇人设块被声音设计取代 | 多段"Audio Profile"或"Director's Notes"导致声音漂移,官方称这是漂移的最常见原因 | 用声音设计生成一个 voice_... ID,请求里 style 留空或只写几个词 |
| 一元请求默认返回 WAV | 旧代码给返回字节再套一层 RIFF 头,得到双头文件 | 删掉 wave 或 ffmpeg 的封装步骤;仍需要裸 PCM 就显式指定 audio/l16 |
第一项的前后对照,在请求体里长这样:
// 3.1 preview 的写法:指令和台词混在同一个字符串
{ "text": "Say cheerfully: 欢迎收听本期节目" }

// 3.8 的写法:text 只放台词,指令进 speech_metadata
{
  "text": "欢迎收听本期节目",
  "annotations": [{ "type": "speech_metadata", "style": "cheerful" }]
}
第四项值得多说一句。官方提示指南还专门提醒,不要在 style 里写"保持同一个声音""不要切换说话人"这类元指令,多余的提示文字反而会增加漂移;也不要在 style 里改年龄、性别、固定口音,这些属于声音本身,应该从声音库里挑或用声音设计生成。迁移后的正确顺序是:先用空 style 跑一遍文稿,多数请求不需要任何指令;确有需要再加一个简短的 style,并在多轮里复用同一个字符串。
两个附带提醒:官方文档页上的 Go 示例截至 9 月 24 日仍写着 gemini-3.1-flash-tts-preview、内联"Say cheerfully:"和手工 RIFF 封装,用 Go 的读者按 REST 的请求形状改写,别照抄;3.1 preview 用户默认换到 Flash-Lite TTS,价格和延迟档位对应,需要表演档再升 Flash TTS。
撞上限制之前
| 限制 | 数值 | 触碰时怎么办 |
|---|---|---|
| 输入 token | 每请求 8,192 | 长文稿按段落或章节拆分,每段一个请求 |
| 输出 token | 每请求 16,384,约合 655 秒音频 | 同上;一段控制在 10 分钟以内 |
| 单请求说话人 | 最多 2 个,且只能用预置声音 | 超过两人或要用自定义声音时,逐轮单独合成后拼接 |
| 拼接逐轮音频 | 一元返回带 44 字节 RIFF 头 | 请求时指定 audio/l16 拿裸 PCM,或去掉每段的 44 字节头再按 24 kHz PCM 拼接 |
| 有状态自定义声音 | 每项目 200 个,保留 1 年 | 声音设计与声音复刻共用这一额度,定期清理试验用的声音 |
无状态声音密钥 voicekey_... | 保留 7 天 | 只适合临时复刻,长期角色用 store=True |
| 输入形态 | 只接受文本,只输出音频 | 不支持函数调用、结构化输出、思考、Live API、代码执行、Google 搜索依据与 URL 上下文 |
| 模型版本 | 只有 gemini-3.8-flash-tts 与 gemini-3.8-flash-lite-tts 两个 ID | 没有带日期的快照版本可锁定 |
中文文稿还有一条容易踩的:尖括号标签必须保持英文。下面这种写法是对的,标签英文、台词中文:
这个方案前后试过三次 <sigh> ...最后还是换了流式。<short pause> 不过结果还不错 <laugh>。停顿有三个粒度:标点和省略号做自然迟疑,short pause、long pause 标签做精确位置的停顿,style 写 "speaking slowly" 控制整轮语速。官方给的强调手段是把英文单词全部大写并配合标点与标签,中文文稿没有对应写法,只能靠标点、停顿标签和拆分轮次;专有名词读错时,在词后用斜杠包一段国际音标,例如 /niːv/。
声音:预置、扩展库、声音设计与声音复刻
speech_config.voice 接受四类值:30 个预置声音的名字、扩展声音库里的声音 ID、声音设计生成的 voice_...、声音复刻生成的 voice_... 或无状态的 voicekey_...。
预置声音有 30 个,官方各给了一个词的性格标签,比如 Kore 是"沉稳",Puck 是"活泼",Charon 是"播报感",Algenib 是"沙哑"。扩展声音库通过 client.voices.list() 查询,可以按语言、地区、口音、性别、音高、人设、用途筛选,也可以按关键词搜索:
voices = client.voices.list(
    language_code=["zh-CN"],
    gender=["female"],
    contexts=["Audiobook"],
    type_=["prebuilt"],
    page_size=50,
)
for v in voices.voices or []:
print(v.id, v.display_name, v.accent, v.gender, v.pitch, v.description)声音设计是从一段文字描述生成一个可复用的声音。描述的重点是这个人是谁,也就是年龄、音色、音高、口音、说话节奏,不是一时的情绪。官方文档和开发者指南里的描述都用英文写,下面照这个写法:
created = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "prompted",
        "display_name": "深夜电台主播",
        "gender": "male",
        "language_code": "zh-CN",
        "prompted": {
            "input": (
                "A Mandarin-speaking radio host in his early 40s, low warm"
                " baritone, unhurried pace, relaxed late-night talk-show feel."
            ),
        },
    },
)
print(created.id)  # voice_... 之后直接填进 speech_config 的 voice
创建和读取时都会返回 sample_audio,是一段 base64 的 WAV 试听,可以先听再决定要不要留。两款模型都支持声音设计。
声音复刻用 type: "replicated",要提供两段音频:10 到 30 秒干净的参考语音 source_audio,以及同一位成年说话人清楚念出授权声明的 consent_audio。简体中文的声明原文是:
我是此声音的拥有者并授权谷歌使用此声音创建语音合成模型
两段音频建议用同一支麦克风、同一个房间录,重采样成 24 kHz 单声道 16 位 WAV。所有 Gemini 音频输出都带 SynthID 水印。官方博客脚注写明"通过 AI Studio 的声音复刻"在伊利诺伊州、得克萨斯州、欧洲经济区、英国、瑞士和印度不可用,这条只提到 AI Studio 界面,API 路径是否同样受限没有说明。
中国大陆读者的适用条件
Gemini API 与 Google AI Studio 的可用地区列表截至 2026 年 9 月 30 日包含台湾、日本、韩国、美国等地,但没有中国大陆,也没有香港;同一页还要求账号年满 18 岁并完成年龄验证。模型支持简体中文、繁体中文和粤语,与账号所在地能否开通是两件事:文稿是中文不代表大陆账号可以使用。大陆读者的地区、付费方式与凭据路线,请看 Gemini API Key 购买前先看:中国大陆的地区、付费与凭据路线;AI Studio 哪些功能免费、地区与年龄条件怎么影响使用,见 Google AI Studio 免费吗。
常见问题
Gemini 3.8 Flash TTS 免费吗? 免费层对两款模型的标准和 Priority 通道都不收费,Batch 与 Flex 在免费层不可用,免费层的数据会用于改进产品。免费层的每分钟、每日请求上限没有公开数字,以 AI Studio 里显示的活跃限额为准。
中文和粤语的效果哪款更好? 两款模型的语言表里简体中文、繁体中文、粤语都是支持状态,官方没有公布中文的对比数据。可以先用 Flash-Lite TTS 跑同一段文稿,只有在口音、情绪或双人插话不满意时换 Flash TTS,改一个模型字符串就能对比。
能在 Vertex AI 上用吗? 截至 2026 年 9 月 30 日不能。Cloud TTS 的 Gemini-TTS 页面没有列出 3.8 模型,官方博客说企业版接口"即将通过 Gemini Enterprise 提供",目前只有 Gemini API 这一条路。
流式拿到的音频为什么播不出来? 流式默认返回没有文件头的裸 PCM,很多播放器打不开。要么按 24 kHz、单声道、16 位配置播放器直接推流,要么用 ffmpeg 补上 WAV 头;反过来,一元请求返回的已经是完整 WAV,再套一层头就会变成双头文件。
自定义声音能用在双人对话里吗? 单请求的两人模式只接受预置声音。用声音设计或复刻的声音做对话,要逐轮合成,请求时指定 audio/l16,再按 24 kHz PCM 顺序拼接。