Claude Fable 5.2 和 5.1 区别:单价降 20%,high 以上每任务更贵
Fable 5.2 单价比 5.1 低 20%,每档分数都更高;low、medium 每任务便宜约三成,high 以上反而更贵。Claude Code 和应用保持默认直接换。
文章目录
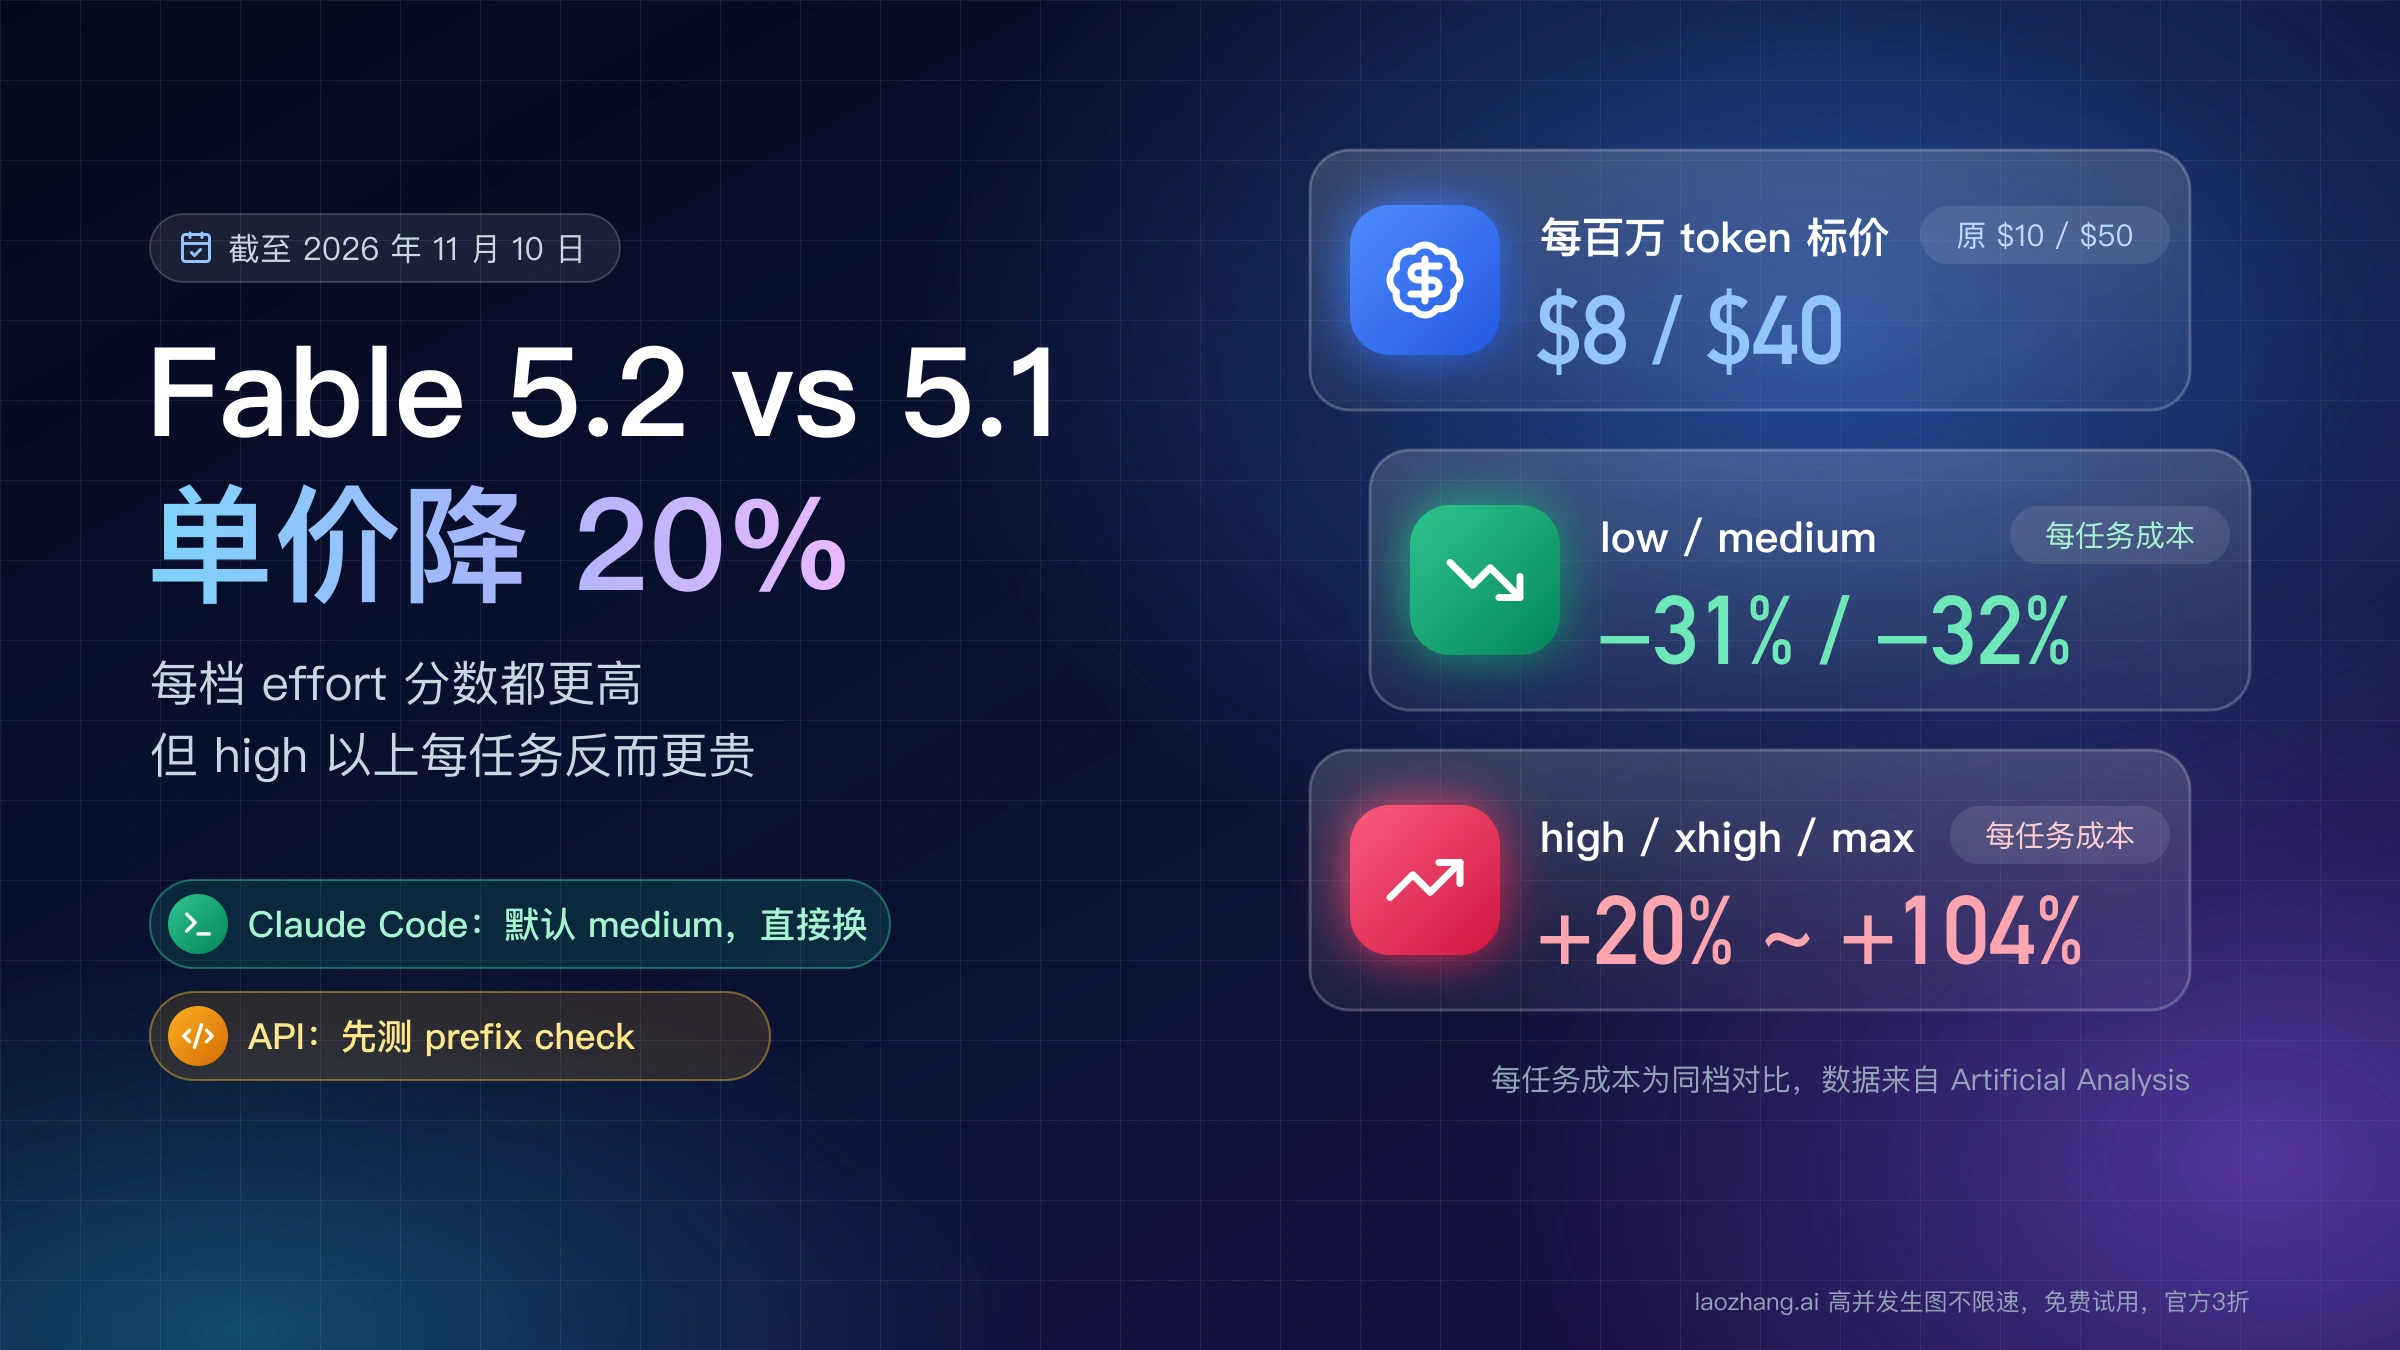
Claude Fable 5.2 在 2026 年 11 月 9 日发布,正在用 Fable 5.1 的人可以换。截至 2026 年 11 月 10 日,Artificial Analysis 智能指数 v5.0.1 里,5.2 每一档 effort 的分数都高于 5.1 的任何一档;每百万 token 的标价也全部低 20%,输入从 $10 降到 $8,输出从 $50 降到 $40。但单价降 20% 不等于每个任务便宜 20%:5.2 在 low、medium 下每任务成本比同档的 5.1 低约三成,到了 high、xhigh、max,它的输出 token 是 5.1 的 1.5–2.3 倍,同档每任务反而贵 20%–104%。
所以换模型时把 effort 一起定好。Claude Code 里 /model fable 现在就是 Fable 5.2,默认 effort 从 5.1 的 high 变成 medium,按 Artificial Analysis 的数据分数从 47 升到 56、每任务成本减半,保持默认即可;Claude 应用里选 Fable 5.2,保持 Medium。API 把 claude-fable-5-1 改成 claude-fable-5-2 后默认仍是 high,分数 47 → 62,每任务贵约 20%,在意成本就显式设成 medium;原来跑 xhigh 或 max 的,先试 5.2 的 high 或更低一档。
需要多做一步的是 API 接入:自己拼 messages 的代码在切流量前要先测 prefix check,否则可能收到 400;经网关或云平台调用的,先看它的模型列表里有没有 claude-fable-5-2。暂时不换也可以,Fable 5.1 现在标为 Legacy(旧版),但仍可调用,Anthropic 写明的退役日期不早于 2027 年 9 月 1 日。
Fable 5.2 和 5.1 区别:价格、Claude Code 默认档、限流和 API 变更
两个版本的规格主体没有变,变的是价格、Claude Code 里的默认 effort、限流的计算方式,以及四项可能让 API 代码报错的行为。下表按 Anthropic 截至 2026 年 11 月 10 日的 Fable 5.2 新功能说明、迁移指南和 Fable 5.1 模型页整理,价格单位是美元 / 每百万 token。
| 项目 | Fable 5.1 | Fable 5.2 |
|---|---|---|
| 模型 ID | claude-fable-5-1,现标为 Legacy | claude-fable-5-2,Amazon Bedrock 上是 anthropic.claude-fable-5-2 |
| 输入 / 输出 | $10 / $50 | $8 / $40 |
| 缓存读取 | $0.25 | $0.20 |
| 5 分钟 / 1 小时缓存写入 | $12.50 / $20 | $10 / $16 |
| Batch API 输入 / 输出 | $5 / $25(按标价五折推算) | $4 / $20 |
| Fast mode | 快速模式文档未列出 5.1 | speed: "fast",$16 / $80,输出速度最高 2.5 倍 |
| API 默认 effort | high | high |
| Claude Code 默认 effort | high | medium |
| 限流 | 与 Fable 5 共用一个额度 | 单独计算 |
| prefix check | 默认只对 2026 年 8 月 31 日及以后创建的账号生效 | 所有账号都生效 |
prefix check 之外,另有三项变化会让 5.1 上正常的 API 代码在 5.2 上出错或丢失上下文:5.1 读不了 5.2 的思考块,旧的电脑操作工具 computer_20251124 在 5.2 上被拒,advisor 工具的模型配对变严。它们怎么测、怎么改,放在后面的 API 检查清单里逐项说明。
没变的部分更多:100 万 token 上下文窗口、单次最多 128K 输出、文本和图片输入、始终开启的自适应思考(关闭思考或设置 budget_tokens 都返回 400)、low 到 max 五档 effort、可靠知识截止 2026 年 6 月、不支持 assistant 预填充、强制工具调用(tool_choice 设为 any 或 tool)返回 400、必须开启 30 天数据保留、不支持 Priority Tier。分词器也相同,同一段文字在两个版本上算出的 token 数一样,所以下文比较的 token 数量可以直接对照。缓存读取价两代都是普通输入价的 0.025 倍,缓存怎么计费、怎样才算命中,见 Claude Prompt Caching 提示缓存怎么用:各模型价格与命中实测。Anthropic 对这次迁移的概括是"大体可以直接替换"(Migration is mostly drop-in)。
同时发布的 Claude Mythos 5.2 是同一个模型、防护更少,只开放给通过 Anthropic 认证计划的机构,普通账号用不到。
Fable 5.2 每个任务更便宜吗:low、medium 便宜约三成,high 起更贵
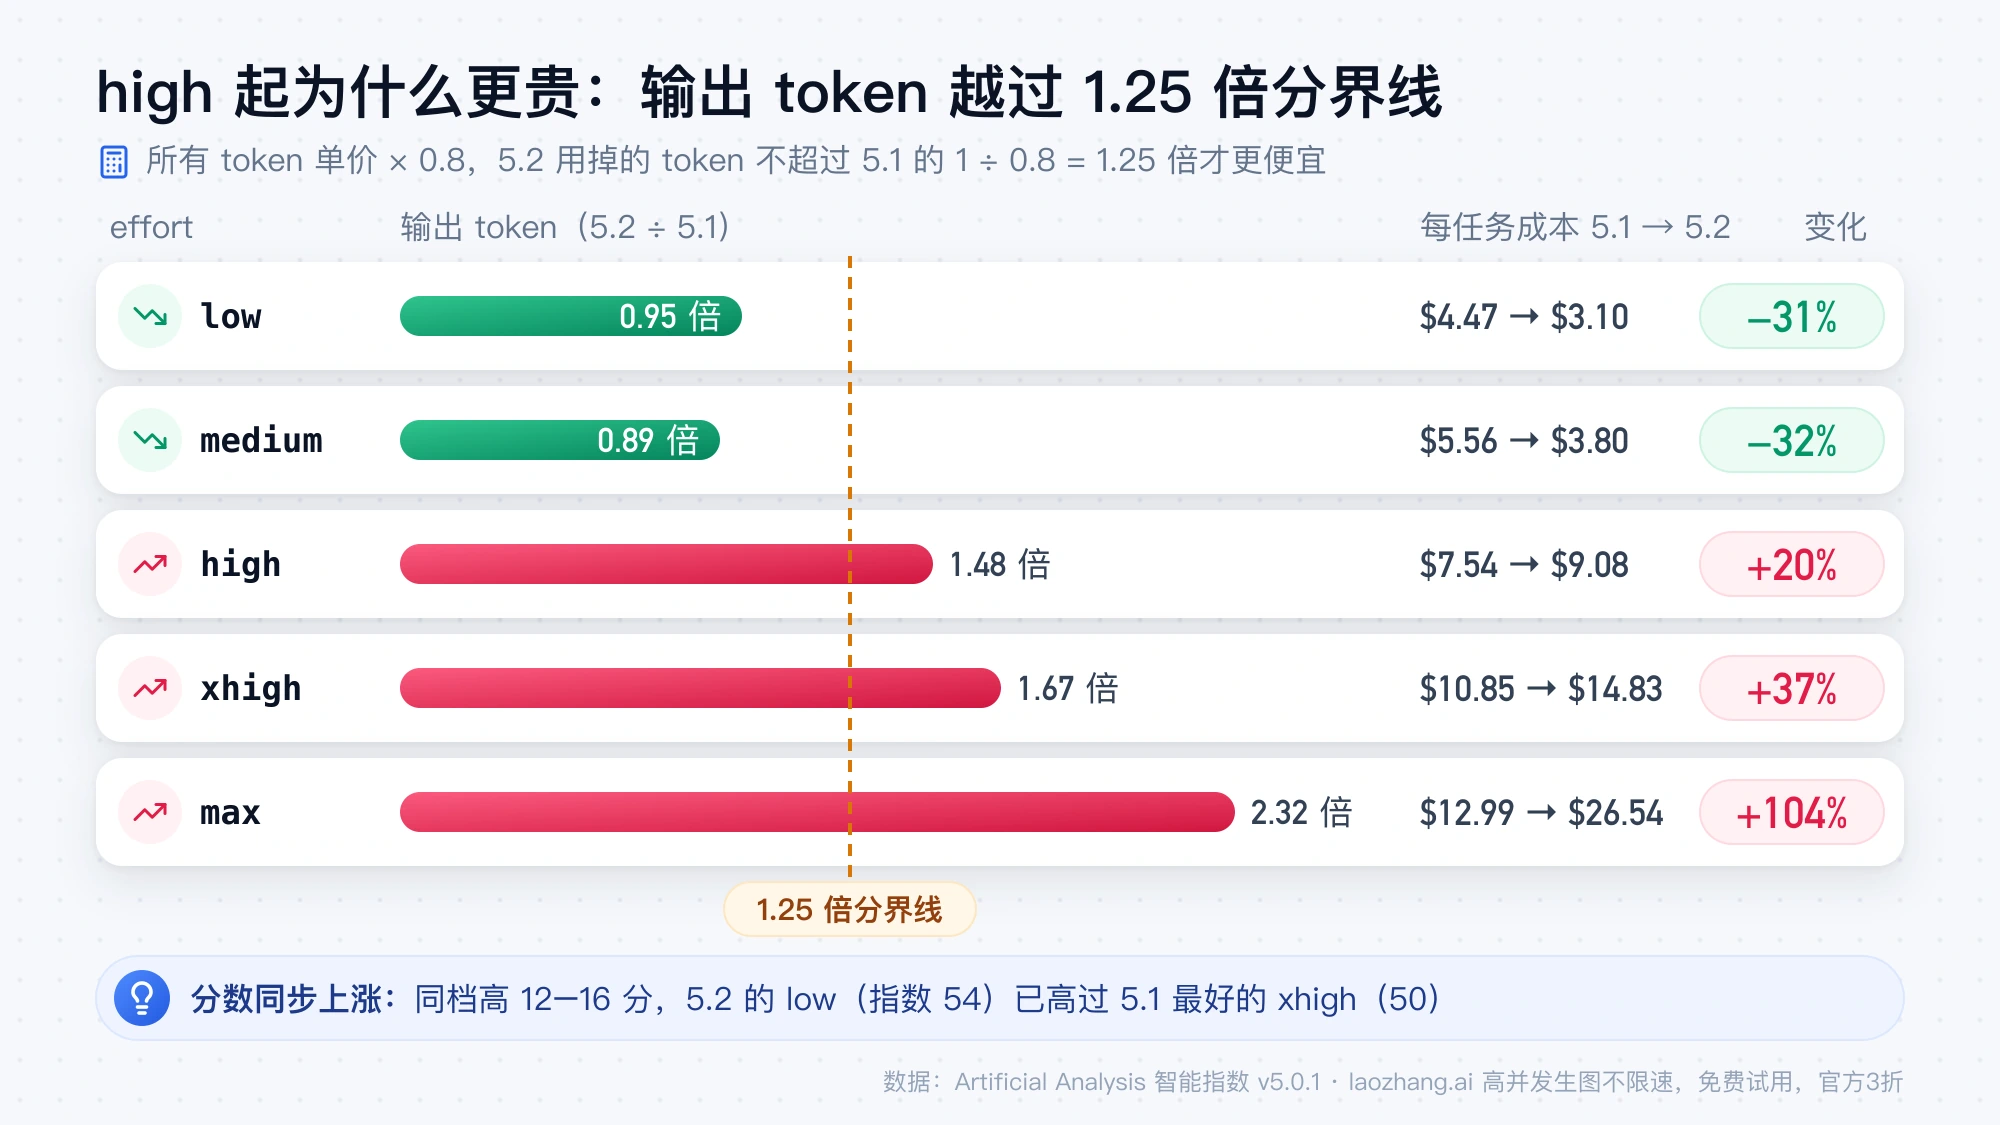
要看 effort 档位:同档比较时,5.2 在 low 和 medium 每任务比 5.1 便宜 31%–32%,在 high、xhigh、max 分别贵 20%、37%、104%。下表的原始数据来自截至 2026 年 11 月 10 日 Artificial Analysis 的 Fable 5.2 与 5.1 分档对比页(智能指数 v5.0.1,按上一节的官方标价计费),变化比例是 2026 年 11 月 10 日用这些数据复算的结果。每任务成本是 Artificial Analysis 自己那组评测任务的平均花费,不是你的账单。
| effort | 指数 5.1 → 5.2 | 每任务成本 5.1 → 5.2 | 成本变化 | 输出 token(5.2 ÷ 5.1) | 每任务用时 5.1 → 5.2 |
|---|---|---|---|---|---|
low | 39 → 54 | $4.47 → $3.10 | −31% | 0.95 倍 | 7.4 → 6.5 分钟 |
medium | 43 → 56 | $5.56 → $3.80 | −32% | 0.89 倍 | 9.7 → 8.3 分钟 |
high | 47 → 62 | $7.54 → $9.08 | +20% | 1.48 倍 | 13.2 → 17.7 分钟 |
xhigh | 50 → 62 | $10.85 → $14.83 | +37% | 1.67 倍 | 19.2 → 26.3 分钟 |
max | 49 → 65 | $12.99 → $26.54 | +104% | 2.32 倍 | 22.7 → 44.1 分钟 |
分界线可以自己算:所有 token 单价都乘了 0.8,所以 5.2 完成同一个任务用掉的 token 不超过 5.1 的 1 ÷ 0.8 = 1.25 倍时更便宜,超过就更贵。low 和 medium 下 5.2 的输出 token 只有 5.1 的 0.89–0.95 倍,降价和少用 token 叠在一起,所以便宜三成左右;high 以上它的输出 token 是 1.48–2.32 倍,越过了 1.25 倍这条线,降价被抵消还有余。表里的指数涨幅也要一起看:同档分数高 12–16 分,5.2 的 low(54)已经高过 5.1 最好的一档 xhigh(50)。
最贵的 max 不一定换来最高的分。Fable 5.1 的 max 指数是 49,反而低于它自己的 xhigh(50);在 Artificial Analysis 跑的 FrontierCode 2.0 编程评测里,5.2 从 low 到 max 依次是 38.4%、41.3%、49.1%、47.6%、48.8%,high 就是最高点,而 max 下它每任务的推理 token 达到 19.3 万,5.1 是 7.14 万。Anthropic 在 effort 文档里给 Fable 5.2 的建议与此一致:从 high 开始,因为"大部分能力提升在 high 已经拿到";xhigh 只用在实测确有提升的长时间编程和智能体任务上;max 留给测模型上限,或者时间和 token 都不在乎的少数任务。
高档位还有一笔表里看不到的开销。Anthropic 在迁移指南里写到,在智能体编程产品中开 xhigh 或 max 时,Fable 5.2 会启动子代理来复查自己的工作,5.1 在同样任务上不这么做,而"子代理可能占一次会话花费的很大一部分"。
发布当天在 Reddit 上流传的"便宜 30%"不是 Anthropic 的数字:官方降价是 20%,"最高 30%"说的是输出速度,见下一节。
换到 Fable 5.2 后跑哪一档:按入口和原来的档位定
原则是先按你实际在跑的档位换算,而不是按同名档位换:5.2 的 medium 已经比 5.1 的 high 分数高、花费少,所以从 5.1 的默认值换过来,降一档通常更划算。下表用的是同一组 Artificial Analysis 数据,"你现在的设置"一列对应各入口的默认值或常见的高档用法。
| 你现在的设置 | 换成 | 指数 | 每任务成本 | 每任务用时 |
|---|---|---|---|---|
Claude Code 默认:5.1 high | 5.2 medium(新默认) | 47 → 56 | $7.54 → $3.80(−50%) | 13.2 → 8.3 分钟 |
API 默认:5.1 high | 5.2 high(不改 effort) | 47 → 62 | $7.54 → $9.08(+20%) | 13.2 → 17.7 分钟 |
| Claude 应用默认:5.1 Medium | 5.2 Medium | 43 → 56 | $5.56 → $3.80(−32%) | 9.7 → 8.3 分钟 |
5.1 xhigh(5.1 分数最高的一档) | 5.2 high | 50 → 62 | $10.85 → $9.08(−16%) | 19.2 → 17.7 分钟 |
5.1 xhigh | 5.2 low | 50 → 54 | $10.85 → $3.10(−71%) | 19.2 → 6.5 分钟 |
5.1 max | 5.2 max | 49 → 65 | $12.99 → $26.54(+104%) | 22.7 → 44.1 分钟 |
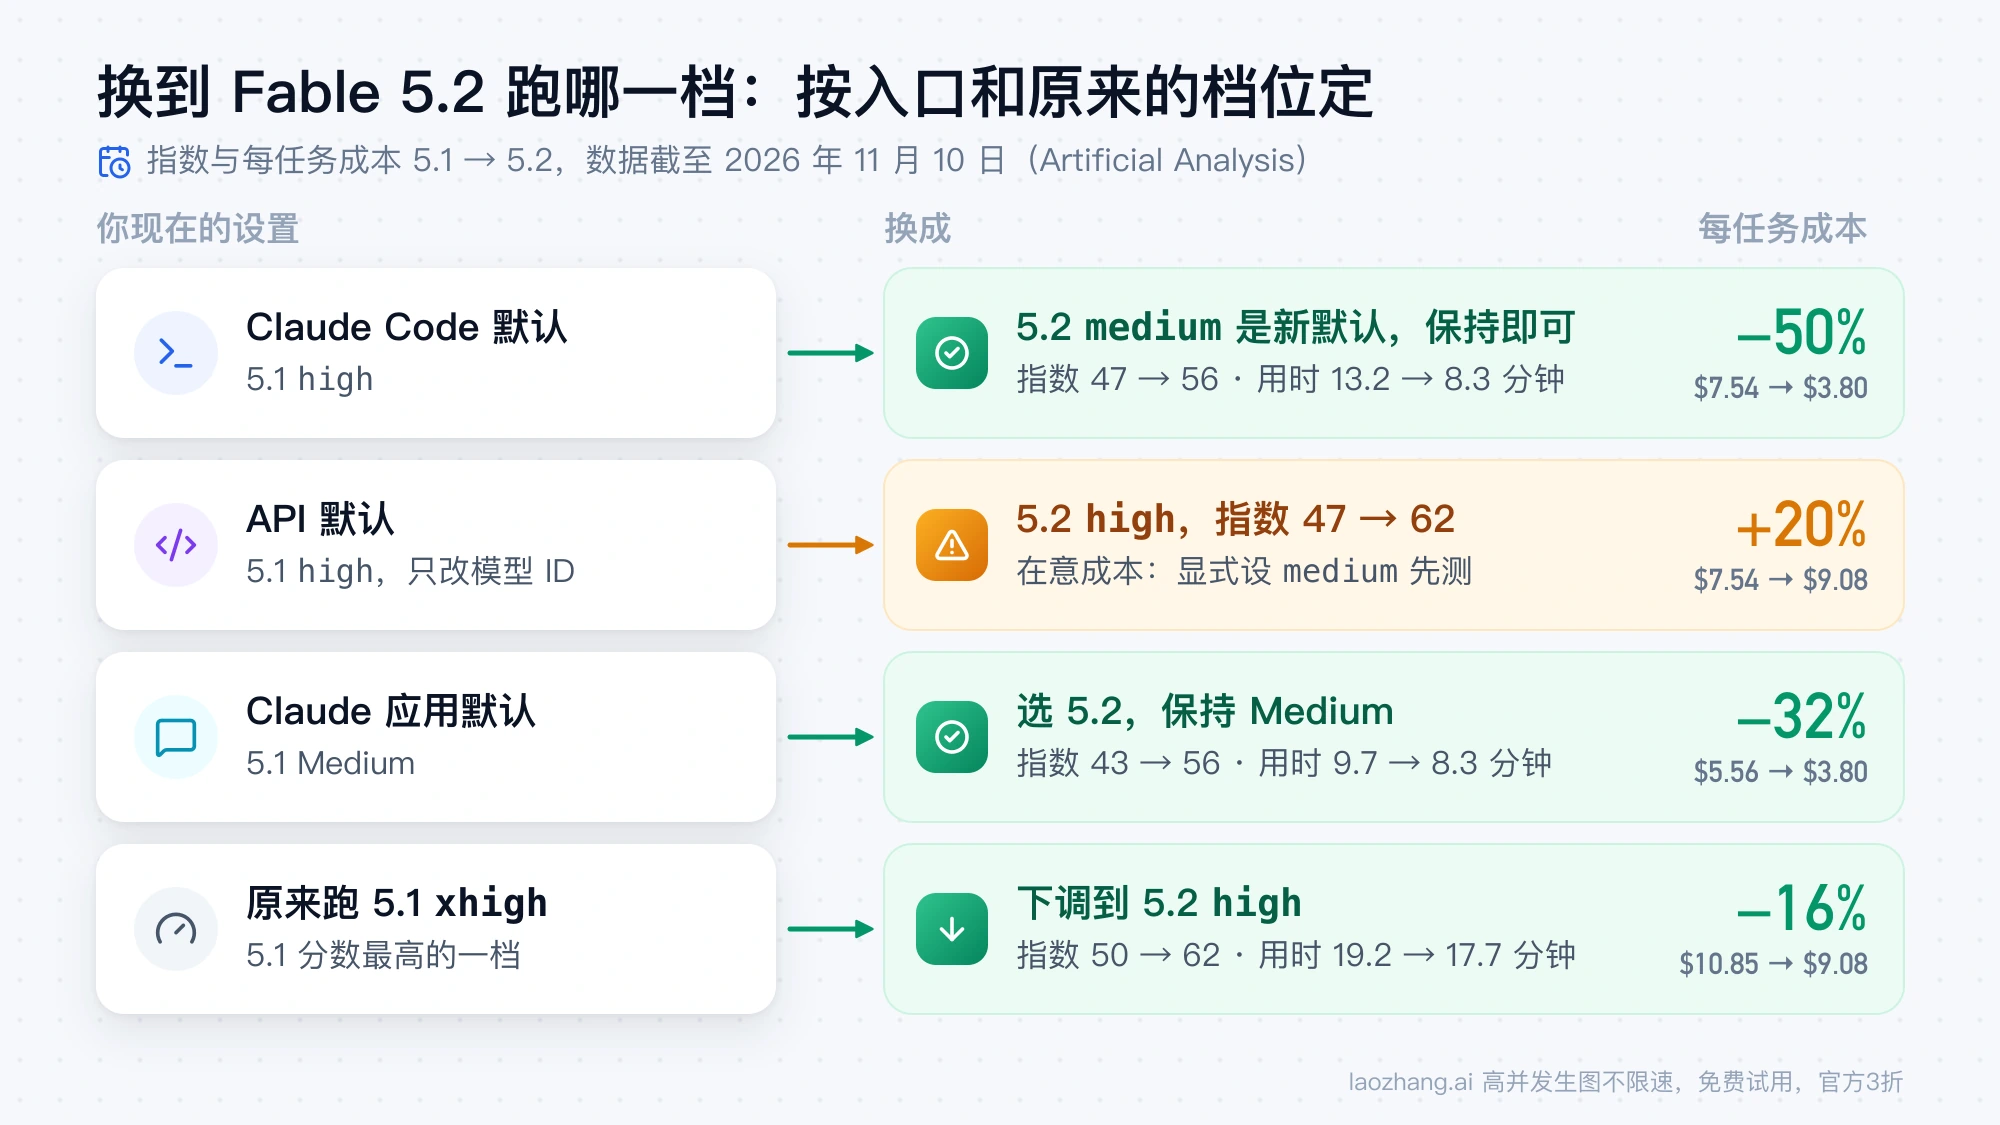
在 Claude Code 里,什么都不用改:Fable 5.2 默认 medium,比你原来 5.1 的 high 分数高、花费约一半。只有你单独给它设过 effort,或者长任务在 medium 下明显做不完,才往上调到 high。Claude Code 里 effort 在哪设、为什么有时设了不生效,见 Claude Code effort level 设置:各模型实测默认档与不生效排查。
在 API 里,默认值两代都是 high,只改模型 ID 的话每任务大约贵 20%、用时多三分之一,换来的是指数 62 而不是 56。先用自己的评测集跑一遍 medium 和 high,medium 能过就显式写上;原来为了质量开 xhigh 的,5.2 的 high 分数更高、成本还低 16%,可以直接下调一档。effort 写在 output_config 里:
response = client.messages.create(
    model="claude-fable-5-2",
    max_tokens=64000,
    output_config={"effort": "medium"},
    messages=[{"role": "user", "content": "..."}],
)
在 Claude 应用里,两个版本选中后显示的都是 Medium,选 Fable 5.2 就是同档升级,按上表分数更高、每任务 token 更少。应用里看不到 token 和费用,订阅额度怎么扣见后面的套餐一节。
这些换算都建立在 Artificial Analysis 的任务组合上。Anthropic 也在 effort 文档里建议不要把 5.1 的 effort 设置直接搬过来,而是在自己的任务上重新跑一遍各档,再重定成本和延迟的基线。
Fable 5.2 快了多少:官方说最高 30%,第三方测到输出快 4%–23%
单看生成速度,5.2 确实更快;看完成一个任务的总时间,要看档位。Anthropic 在发布公告里说 Fable 5.2 的输出"最高比 Fable 5.1 快 30%","最高"是上限而非平均。Artificial Analysis 截至 2026 年 11 月 10 日测到的输出速度,五档分别快 7%、4%、10%、23%、18%,都在 30% 以内。
但每任务用时还取决于输出多少 token。low 和 medium 下 5.2 输出更少、速度更快,每任务用时短 12%–14%;high 以上它输出的 token 多出 48%–132%,速度的提升抵不过,每任务用时反而长 34%–94%,max 档从 22.7 分钟拉到 44.1 分钟。Anthropic 的模型总览现在给 5.2 的相对延迟标签是 Moderate,2026 年 9 月 5.1 模型页上标的是 Slower。
真正要提速,5.2 多了 fast mode:请求里加 speed: "fast",输出速度最高 2.5 倍,价格是 $16 / $80,正好是标准价的两倍;快速模式文档里没有列出 Fable 5.1。短对话场景下的实际等待时间,见下一节的应用实测。
Claude 应用实测:6 道题两版全对,总用时 76.4 秒对 76.3 秒
在 Claude 应用里,短而明确的题目上两个版本都做对了,总用时几乎一样。2026 年 11 月 10 日上午(北京时间约 8:20–8:50),在一个 Ultra 套餐账号的 claude.ai 无痕对话里,把同样 6 道题分别发给 Fable 5.1 和 Fable 5.2,每题新开一个对话、各跑一次,effort 都保持应用默认的 Medium。在模型选择器里,Fable 5.2 在主列表,Fable 5.1 收在 "More models" 下面。用时从点击发送算到回答流式输出结束,包含思考时间;答案用事先写好的隐藏测试和规则评分。
| 题目 | Fable 5.1 用时 | Fable 5.2 用时 | 结果 |
|---|---|---|---|
| 价格应用题 | 6.0 秒 | 4.5 秒 | 两版都答对 $41.50 |
| 不写代码数数位和 | 11.4 秒 | 6.0 秒 | 两版都答对 55252 |
| 含两个虚构函数的标准库问题 | 2.6 秒 | 1.6 秒 | 两版都指出函数不存在 |
| CSV 行解析器 | 6.2 秒 | 3.8 秒 | 两版都通过 16/16 个测试 |
| 表达式求值器 | 10.0 秒 | 25.4 秒 | 两版都通过 25/25 个测试 |
| semver 范围匹配 | 40.2 秒 | 35.0 秒 | 两版都通过 36/36 个测试 |
| 合计 | 76.4 秒 | 76.3 秒 | 12 份答案全部通过 |
5.2 在 6 题里有 5 题更快,快 13%–47%;慢的那一题是表达式求值器,它写的程序比 5.1 长 31%(3,344 对 2,558 个字符),semver 那题它的代码也长 48%(3,991 对 2,701 个字符),多出来的是注释、文档字符串和辅助函数。
这组结果能说明的范围很窄:每题只跑了一次,一个账号、一个上午、一条网络,用时里含排队和网络延迟,单题的差距不能当成速度结论;应用里看不到 token 和费用;题目都是两代都能做对的短任务,对长时间的智能体工作说明不了什么,那部分以上面的 Artificial Analysis 数据和 Anthropic 的说明为准。其他档位、API、Claude Code 和 fast mode 都不在这次测试范围内。
API 换成 claude-fable-5-2 前的检查清单
只改模型 ID 大多数请求就能跑通,但 Anthropic 在 Fable 5.2 迁移指南里列了四项会让 5.1 上正常的代码在 5.2 上出错的变化,加上限流和行为差异,切生产流量前按下面逐项核对。以下错误信息和行为都出自 Anthropic 的文档。如果你的对话历史由 Claude Code、claude.ai、Claude Managed Agents 或 Claude Agent SDK 管理,prefix check 这一项不需要你处理。
- 先确认你的调用入口已经上线 5.2。第三方网关可能比 Anthropic 晚上线:laozhang.ai 网关在 2026 年 11 月 10 日(发布次日)才把
claude-fable-5-2加进/v1/models,当天早些时候列表里还只有 5.1 和 Fable 5,上架后的价格与 Anthropic 标价相同(每百万 token $8 / $40),按量计费;其他网关和云平台同样以它们的模型列表为准,Amazon Bedrock 上的 ID 是anthropic.claude-fable-5-2。 - 查一下 Fable 5.2 的限流。它单独计算,不和 Fable 5.1、Fable 5 共用,原来的额度不会自动带过去。
- 自己拼
messages的代码要测 prefix check。代码在两次请求之间改了system、tools或更早的消息,又把之后轮次的思考块(thinking block)原样发回,5.2 会对所有账号返回 400;5.1 只对 2026 年 8 月 31 日及以后创建的账号默认检查,所以老账号在 5.1 上正常、换到 5.2 就报错,重试同一个请求体也不会好。报错原文是Invalid `signature` in `thinking` block. The block is bound to a different conversation.。测试方法是带上 beta 头thinking-binding-controls-2026-08-01,设thinking.block_binding.prefix_mismatch_behavior: "drop_block"跑一轮会话,记录input_transformations,把每一条prefix_binding_mismatch都改掉。drop_block只适合修复期间临时用,丢掉思考块会让输出 token 增加。 - 查路由和回退会不会把对话从 5.2 切回 5.1。5.2 能读 5.1 的思考块,反过来不行:路由切换、客户端重试或拒答回退把对话从 5.2 移到 5.1 时,5.2 的思考块会被丢掉,请求照样成功、丢掉的部分不计费,但切换后的第一轮会因为没有之前的推理而更慢、更贵。
- 用了电脑操作工具的,把
computer_20251124换成computer_toolset_20260801工具集。除 Amazon Bedrock 外,旧工具在 5.2 上一律返回 400invalid_request_error。 - 用了 advisor 工具(beta)且执行模型换成 5.2 的,把 advisor 的
model也改成claude-fable-5-2或claude-mythos-5-2,保留 5.1 当 advisor 会返回 400。 max_tokens设得很小、又靠"直接回答,不要思考"这类提示词压住思考的请求,在 5.2 的medium及以上档位不再管用,思考 token 会把额度用完,以stop_reason: "max_tokens"结束却没有任何正文。删掉这类提示词,调大max_tokens或降低 effort。- 显式设置
effort,用自己的评测重跑各档,再按新结果重定成本和延迟基线(换算方法见上一节)。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
已经在用 Claude Code 的话,可以让它自动改代码:在项目里运行 /claude-api migrate this project to claude-fable-5-2。改完仍要按上面的清单测一遍。
Claude Code 里存着 claude-fable-5-1,会被自动改成 5.2 吗
会,但只对订阅登录、且模型写在用户设置里的情况。按 Claude Code 模型配置文档,Pro 和 Max 套餐用户第一次运行 v2.1.321 或更新版本时,用户设置里的 claude-fable-5-1 会自动改成 fable 别名,也就是 Fable 5.2,终端启动时的模型那一行可能出现一次 (auto-updated);Team 和 Enterprise 要等组织设置生效,可能晚一些,也可能不改,用 /model 查看当前模型。改过之后,会话从 Fable 5.2 的默认 effort medium 开始,除非你给它单独设过档位。用 Console 账号、第三方服务商,或者把模型写在项目、本地、托管设置里的,都保留 claude-fable-5-1 不变。
Fable 5.2 需要 Claude Code v2.1.321 或更新版本,旧版本先运行 claude update。想继续用 5.1,就按模型 ID 指定:会话里运行 /model claude-fable-5-1,或者用 claude --model claude-fable-5-1 启动。
Pro、Max、Ultra 套餐里 Fable 5.2 和 5.1 的额度规则相同
订阅里两个版本怎么扣额度没有区别,Anthropic 帮助中心的原话是 Fable 5.2 和 Fable 5.1 在这些套餐上"规则相同"。截至 2026 年 11 月 10 日,帮助中心的 Fable 套餐说明写的是:Free 不能用;Max、Ultra 以及 Team 高级席位和旧版 Enterprise 席位包含 Fable,每周用量上限最多一半可以花在 Fable 模型上;Pro 和 Team 标准席位从第一次请求起就走 usage credits。例外是发布周:从 2026 年 11 月 9 日到太平洋时间 11 月 16 日晚 11:59,所有 Fable 模型对 Pro 和 Team 标准席位也算在套餐内,最多用到每周上限的 50%,另送一次 Fable 额度重置,同时到期。Anthropic 没有公布这些上限对应多少 token 或多少条消息,也没有说 5.2 比 5.1 耗额度更快还是更慢。
Enterprise 套餐里,Fable 5.2 默认关闭,要管理员开启;发布七天后会自动加进已有 Fable 模型的角色,默认模型设成 Fable 的也会改成 5.2,除非管理员选择退出。
Fable 5.2 和 5.1 的其他问题
Fable 5.1 还能用多久?
截至 2026 年 11 月 10 日,Fable 5.1 在 Claude API 和各云平台上仍可调用,Anthropic 的模型弃用页写的退役时间不早于 2027 年 9 月 1 日,Fable 5.2 不早于 2027 年 11 月 9 日。5.1 现在标为 Legacy,模型页建议考虑迁移到 5.2,但没有停用或下线。在 Claude Code 里要按模型 ID 选它,在 Claude 应用里它在 "More models" 下面。
2026 年 9 月传的"Fable 5.2"就是这个版本吗?
不是。2026 年 9 月 18–20 日网上流传过一个"Fable 5.2",10 月初传闻名字又变成"Fable 5.5",两者都不是 Anthropic 的正式发布。2026 年 11 月 9 日发布的这一版是第一个官方的 Fable 5.2,模型 ID 是 claude-fable-5-2。
不换 5.2,直接用 Opus 5.5 是不是就够了?
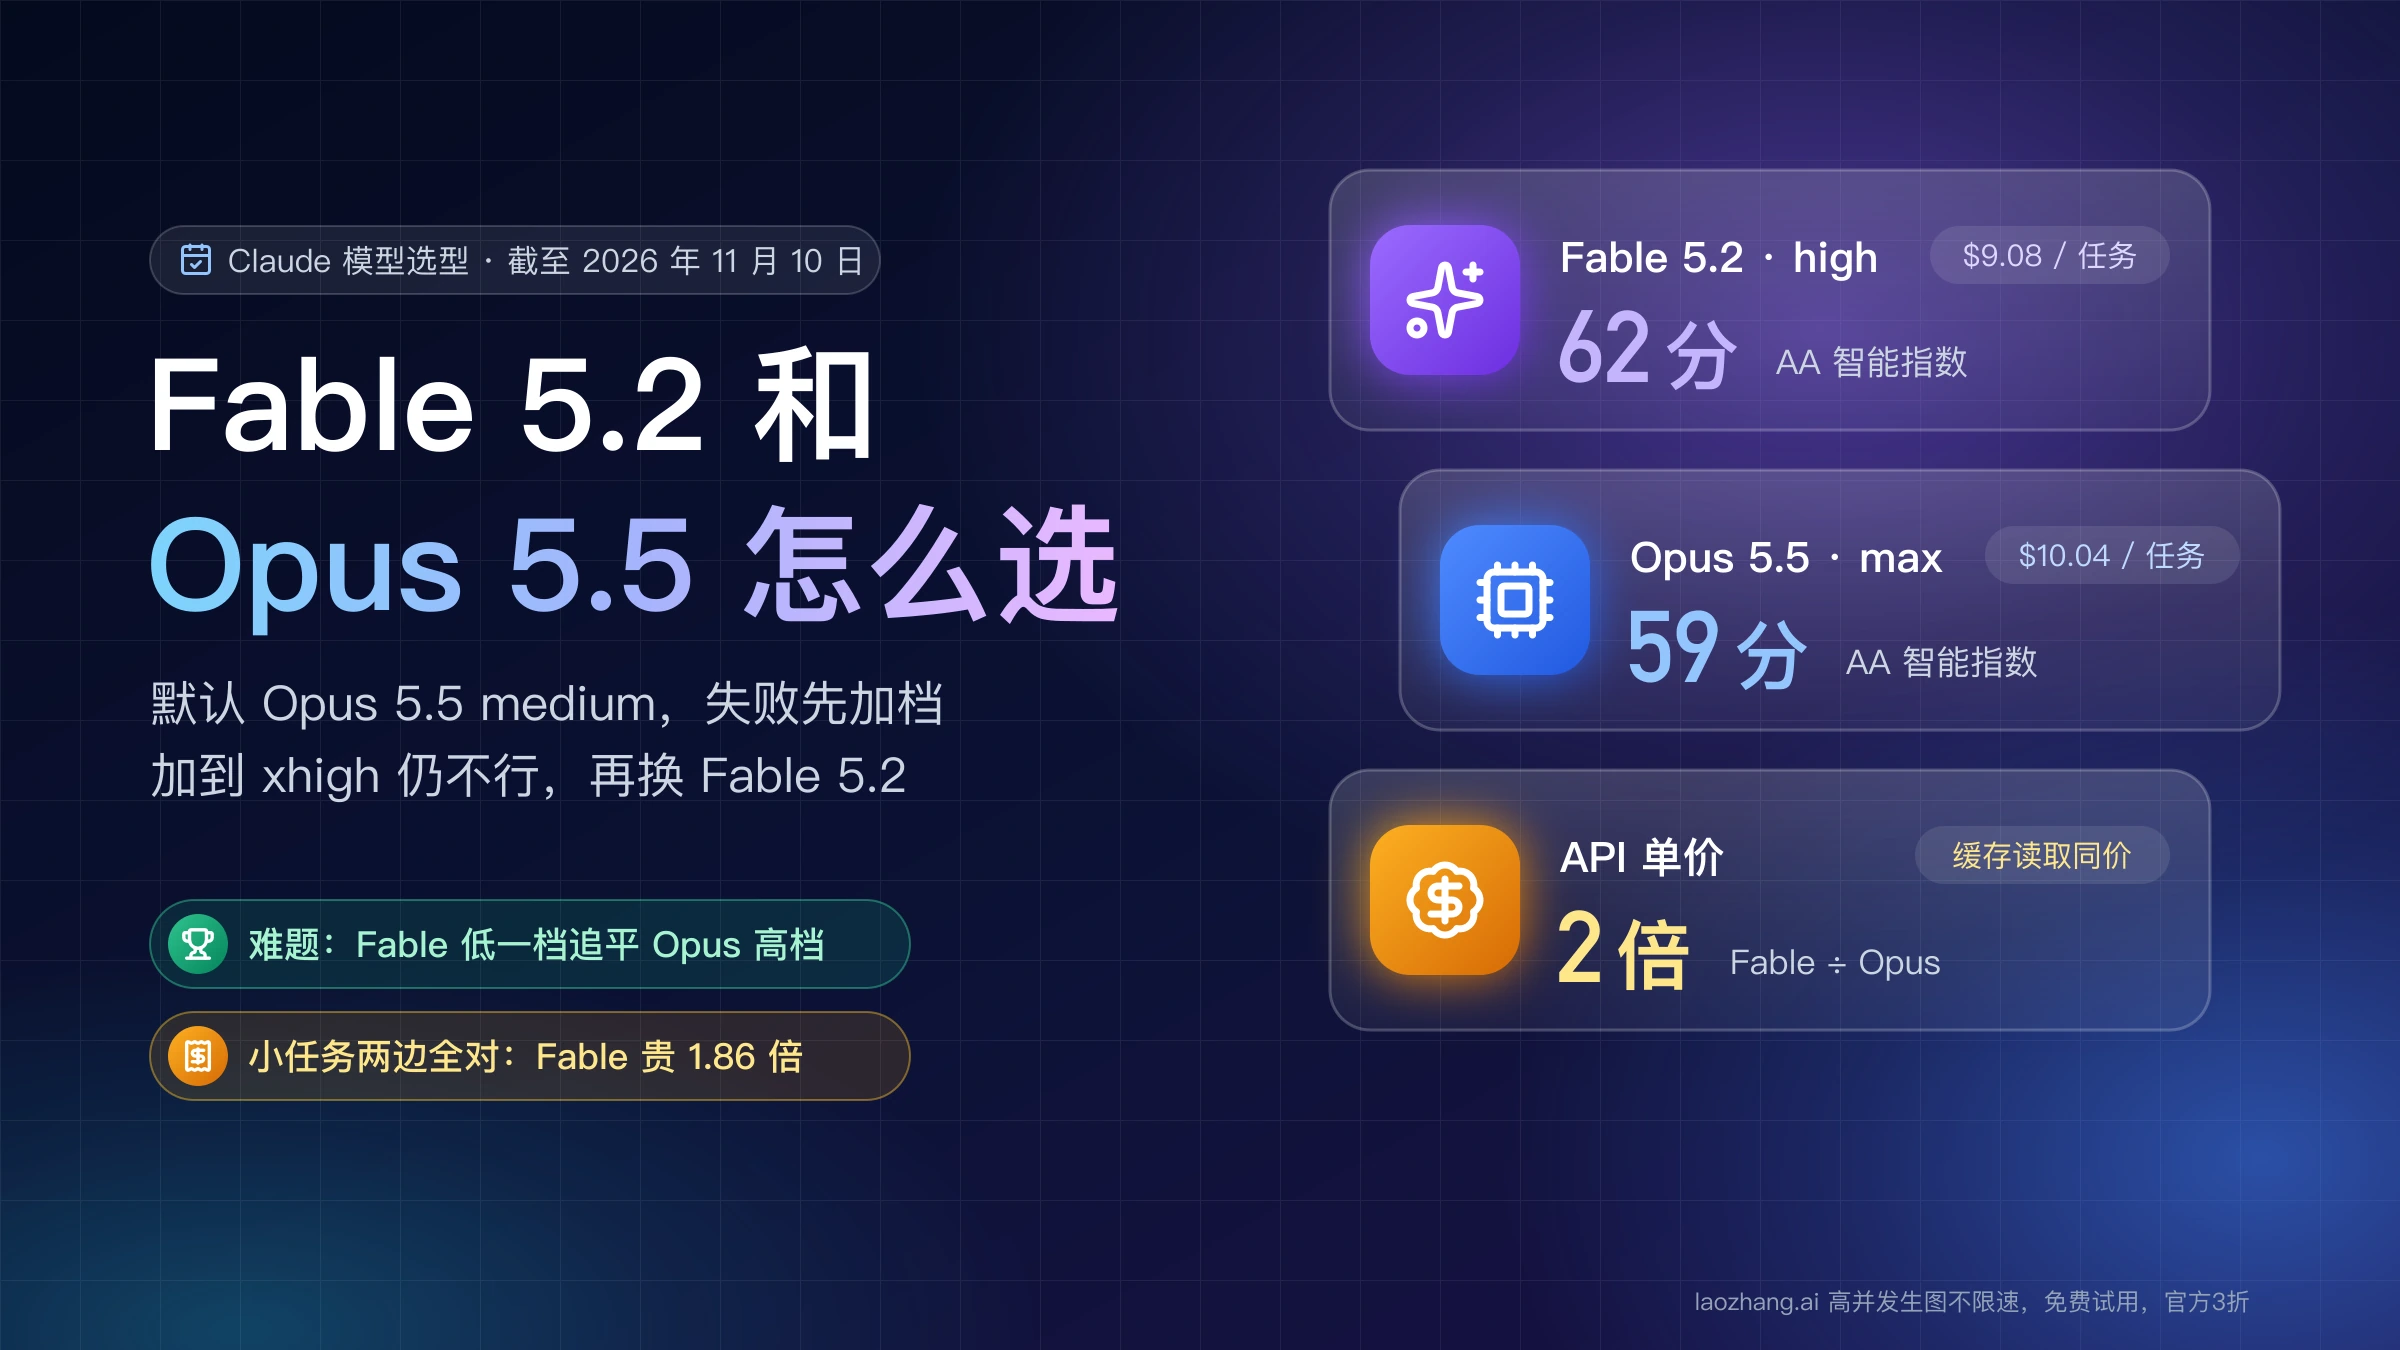
很多任务确实够:截至 2026 年 11 月 10 日,Anthropic 仍建议大部分编程和知识工作从 Opus 5.5 开始,在高 effort 下仍达不到要求再换 Fable。打算换到 5.2 的,拿它和 Opus 5.5 逐档对比见 Fable 5.2 和 Opus 5.5 怎么选:哪档对哪档,同题实测贵 1.86 倍;暂时留在 5.1 的,见 Claude Fable 5.1 和 Opus 5.5 怎么选?性能、价格与切换建议。
Anthropic 公布的跑分里,Fable 5.2 比 5.1 提升最大的是哪几项?
按 Anthropic 2026 年 11 月 9 日的发布公告(多数是各自最高可用 effort),差距最大的几项是 BenchCAD 2.1(max 档,按 0–100 计分,83.5 对 44.4)、RoboDojo Sim(64.9% 对 27.6%)、Remote Labor Index(41.3% 对 17.9%)、Chartography 无工具(73.4% 对 44.8%)和 AutomationBench(51.4% 对 31.4%);编程评测 FrontierCode 2.0 在 xhigh 下是 49.1% 对 32.4%。提升最小的是 OSWorld 2.1(89.3% 对 83.5%)和 AA-Briefcase v1.1(66.1% 对 61.5%)。这些是厂商自报的数字,没有第三方复现。
Fable 5.2 会比 5.1 少拒答吗?
按 Anthropic 发布公告里的早期测试,在 claude.ai、Claude Code 和 Cowork 上,Fable 5.2 被安全分类器拦下的请求比 5.1 少约 55%,网络安全类少约 60%,生物类少约 40%。被拦下的请求仍会转给其他模型回答:网络安全类由 Opus 4.8 回答,生物类由 Opus 5 回答。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月10日。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月10日。
- 1.Artificial Analysis 智能指数 v5.0.1artificialanalysis.ai/models/comparisons/claude-fable-5-2-vs-claude-fable-5-1
- 2.Fable 5.2 新功能说明platform.claude.com/docs/en/models/fable-5-2/whats-new-fable-5-2
- 3.迁移指南platform.claude.com/docs/en/models/fable-5-2/migration-guide
- 4.Fable 5.1 模型页platform.claude.com/docs/en/models/fable-5-1/overview
- 5.effort 文档platform.claude.com/docs/en/build-with-claude/effort
- 6.发布公告anthropic.com/claude-fable-and-mythos-5-2
- 7.快速模式文档platform.claude.com/docs/en/build-with-claude/fast-mode
- 8.Claude Code 模型配置文档code.claude.com/docs/en/model-config
- 9.帮助中心的 Fable 套餐说明support.claude.com/en/articles/15424964
- 10.Anthropic 的模型弃用页platform.claude.com/docs/en/about-claude/model-deprecations