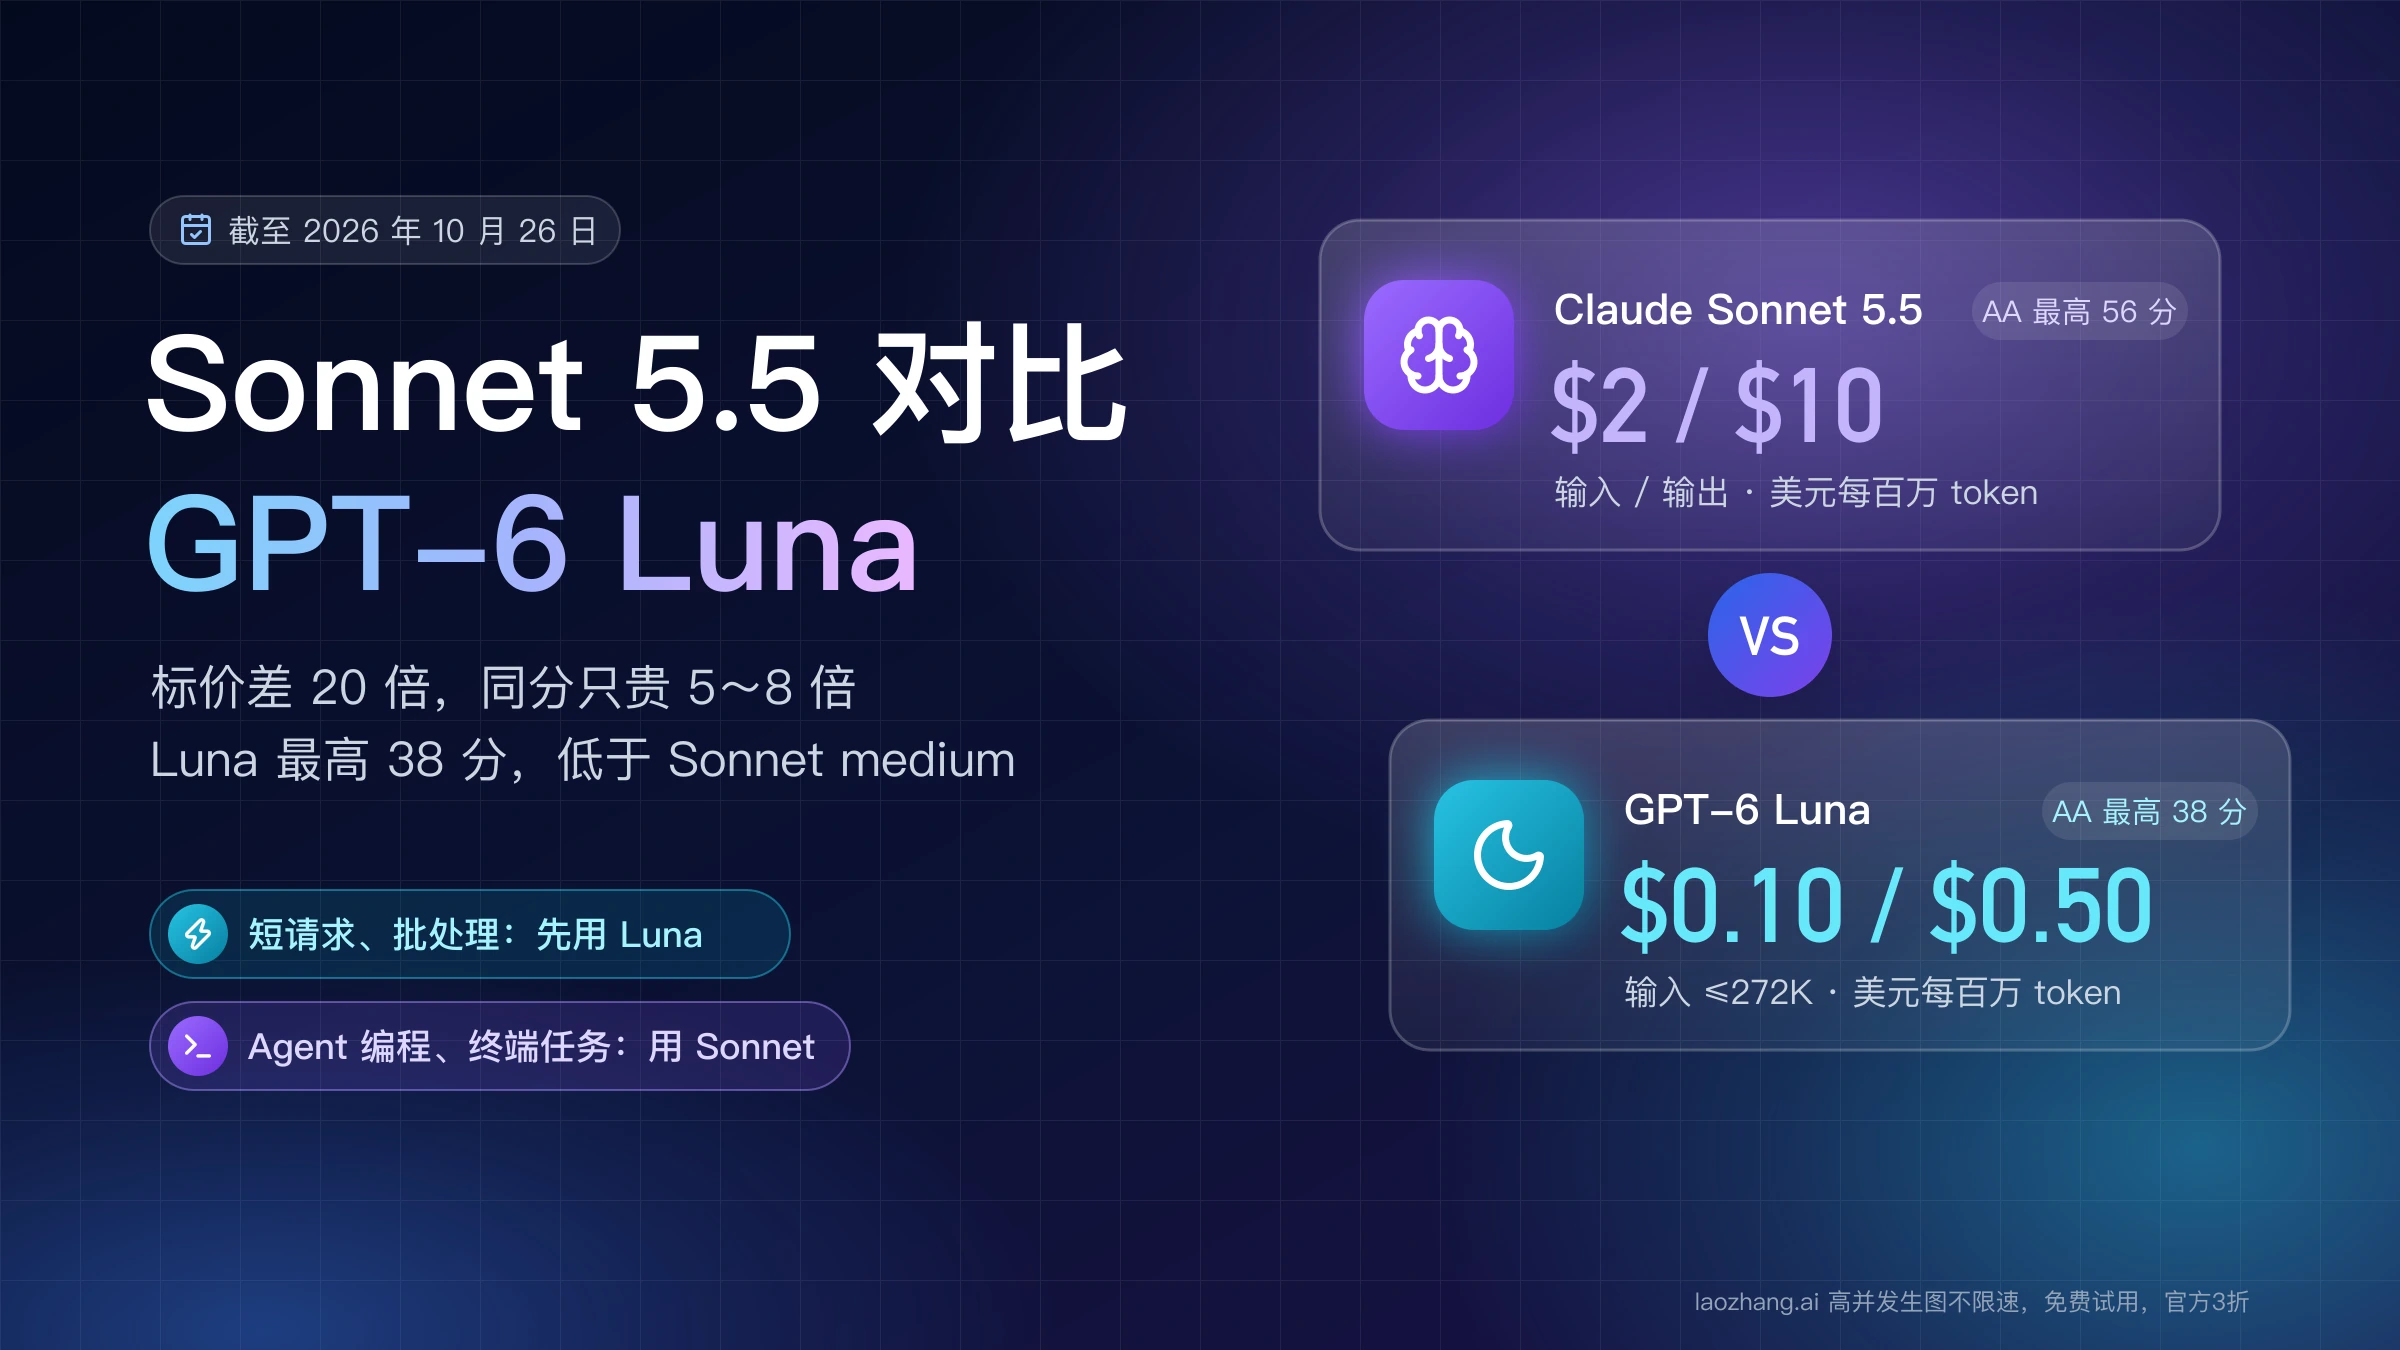
Claude Sonnet 5.5 和 GPT-6.1 Terra 对比:同分时成本差 4.3 倍
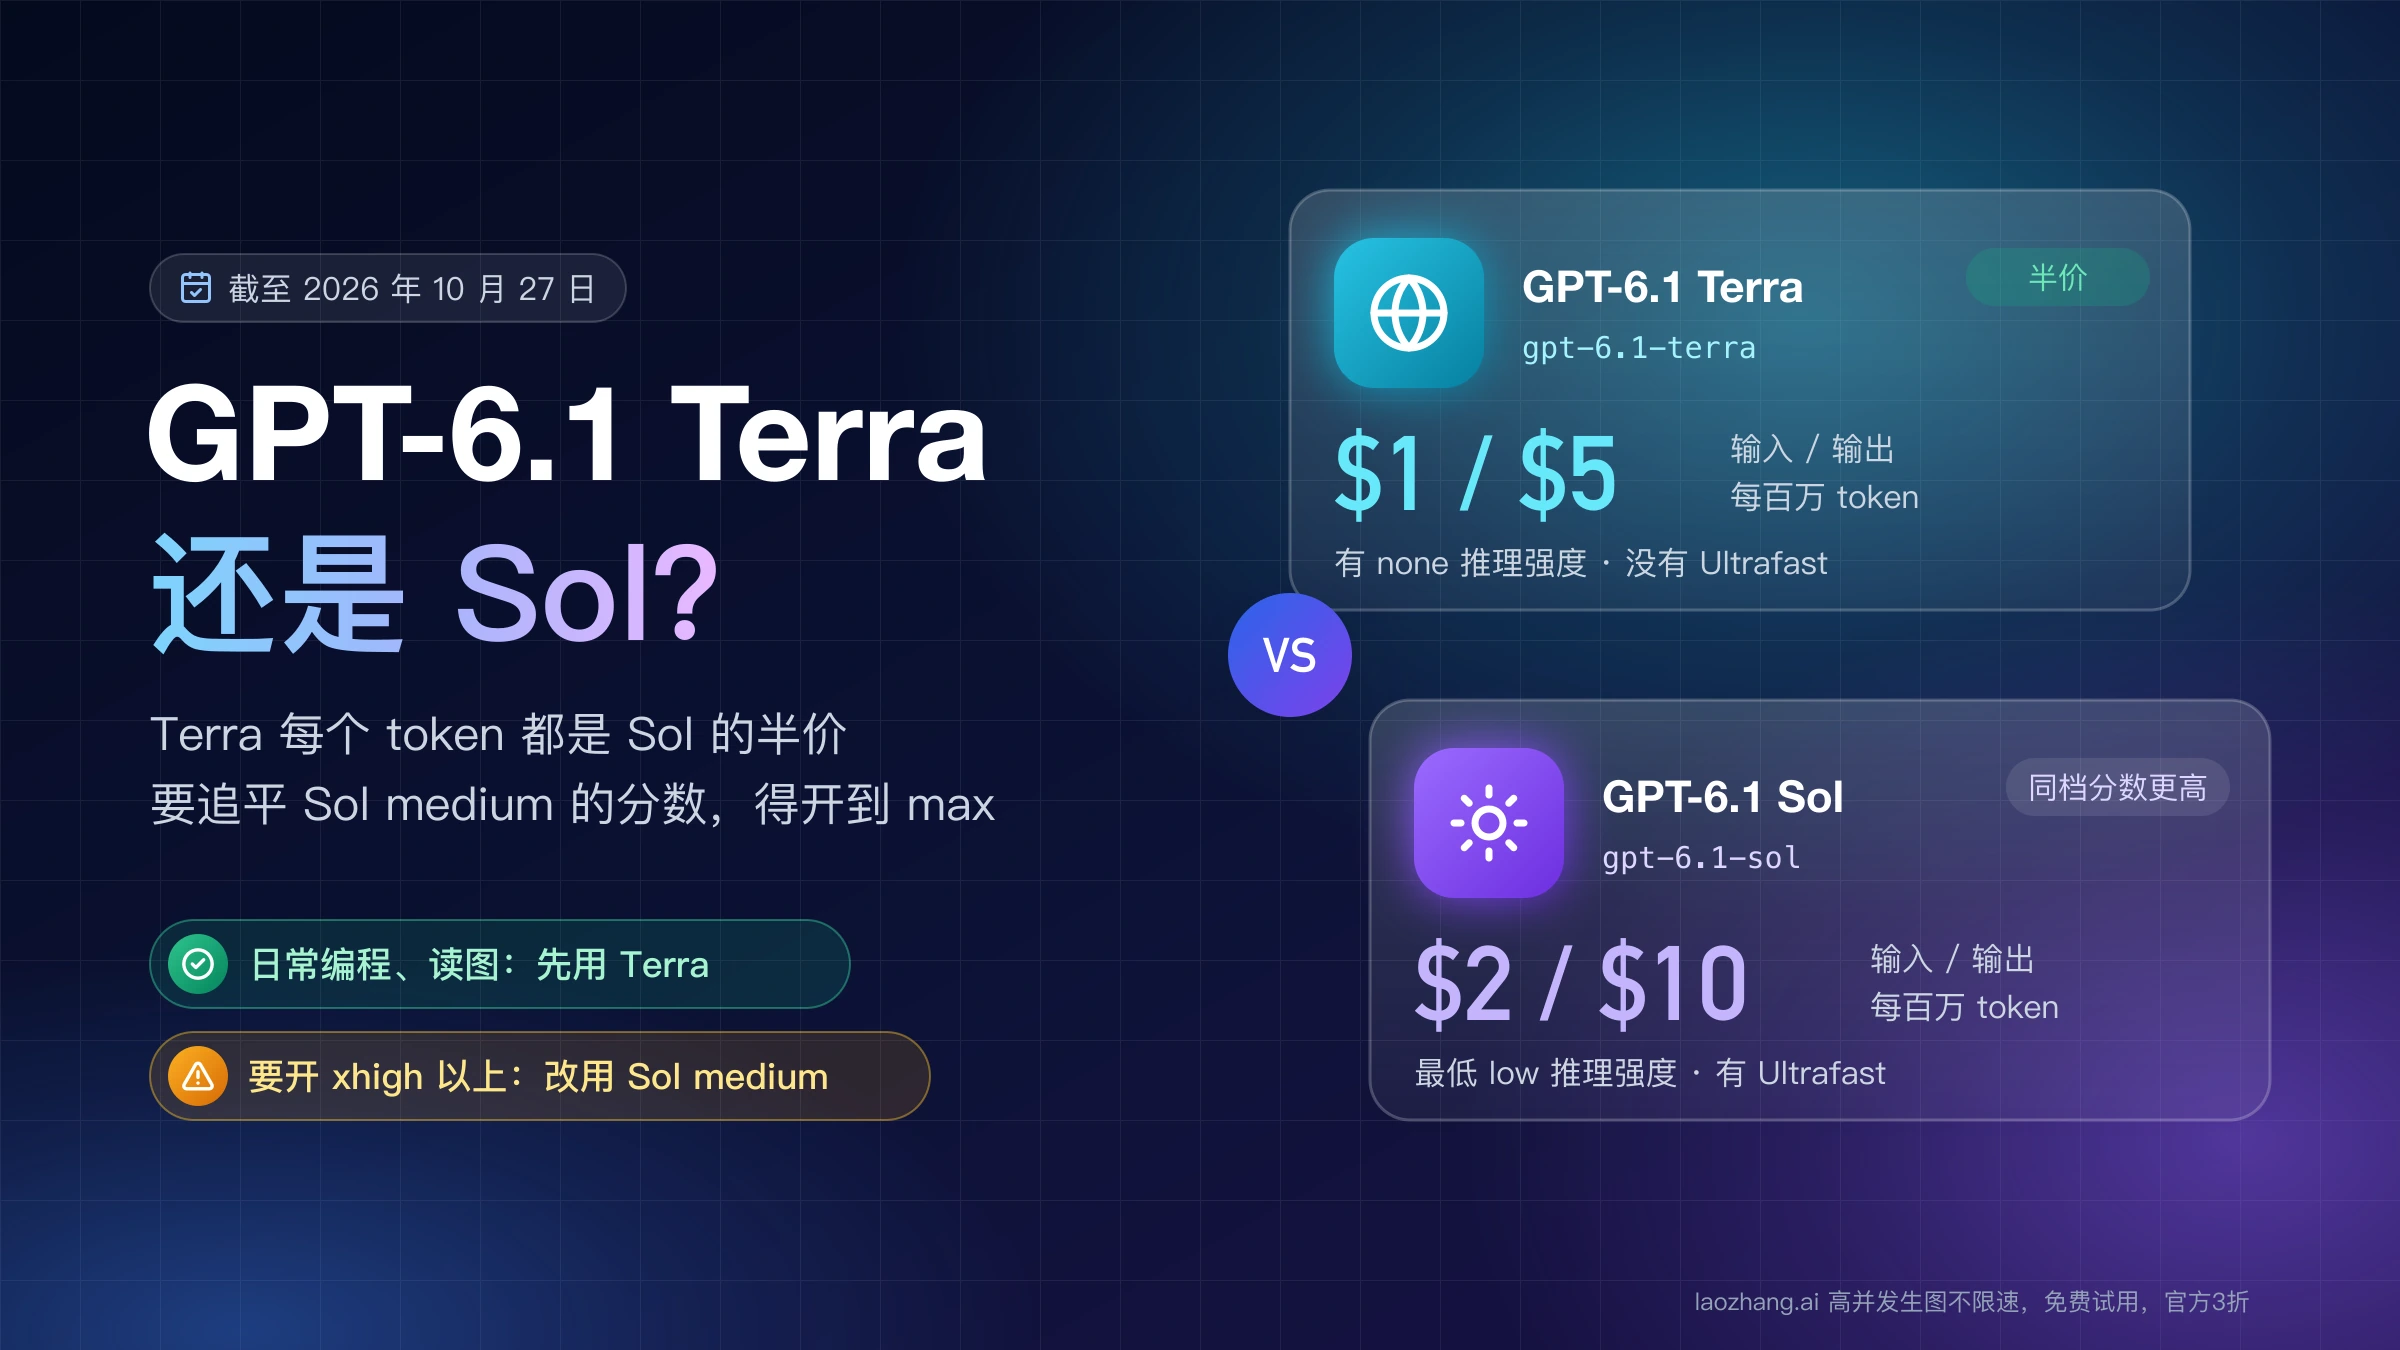
GPT-6.1 Terra 标价是 Sonnet 5.5 的一半,同一段中文 Sonnet 多计约四成 token;12 道题实测账单差 2.1~2.8 倍,同分时差 4.3 倍。
文章目录
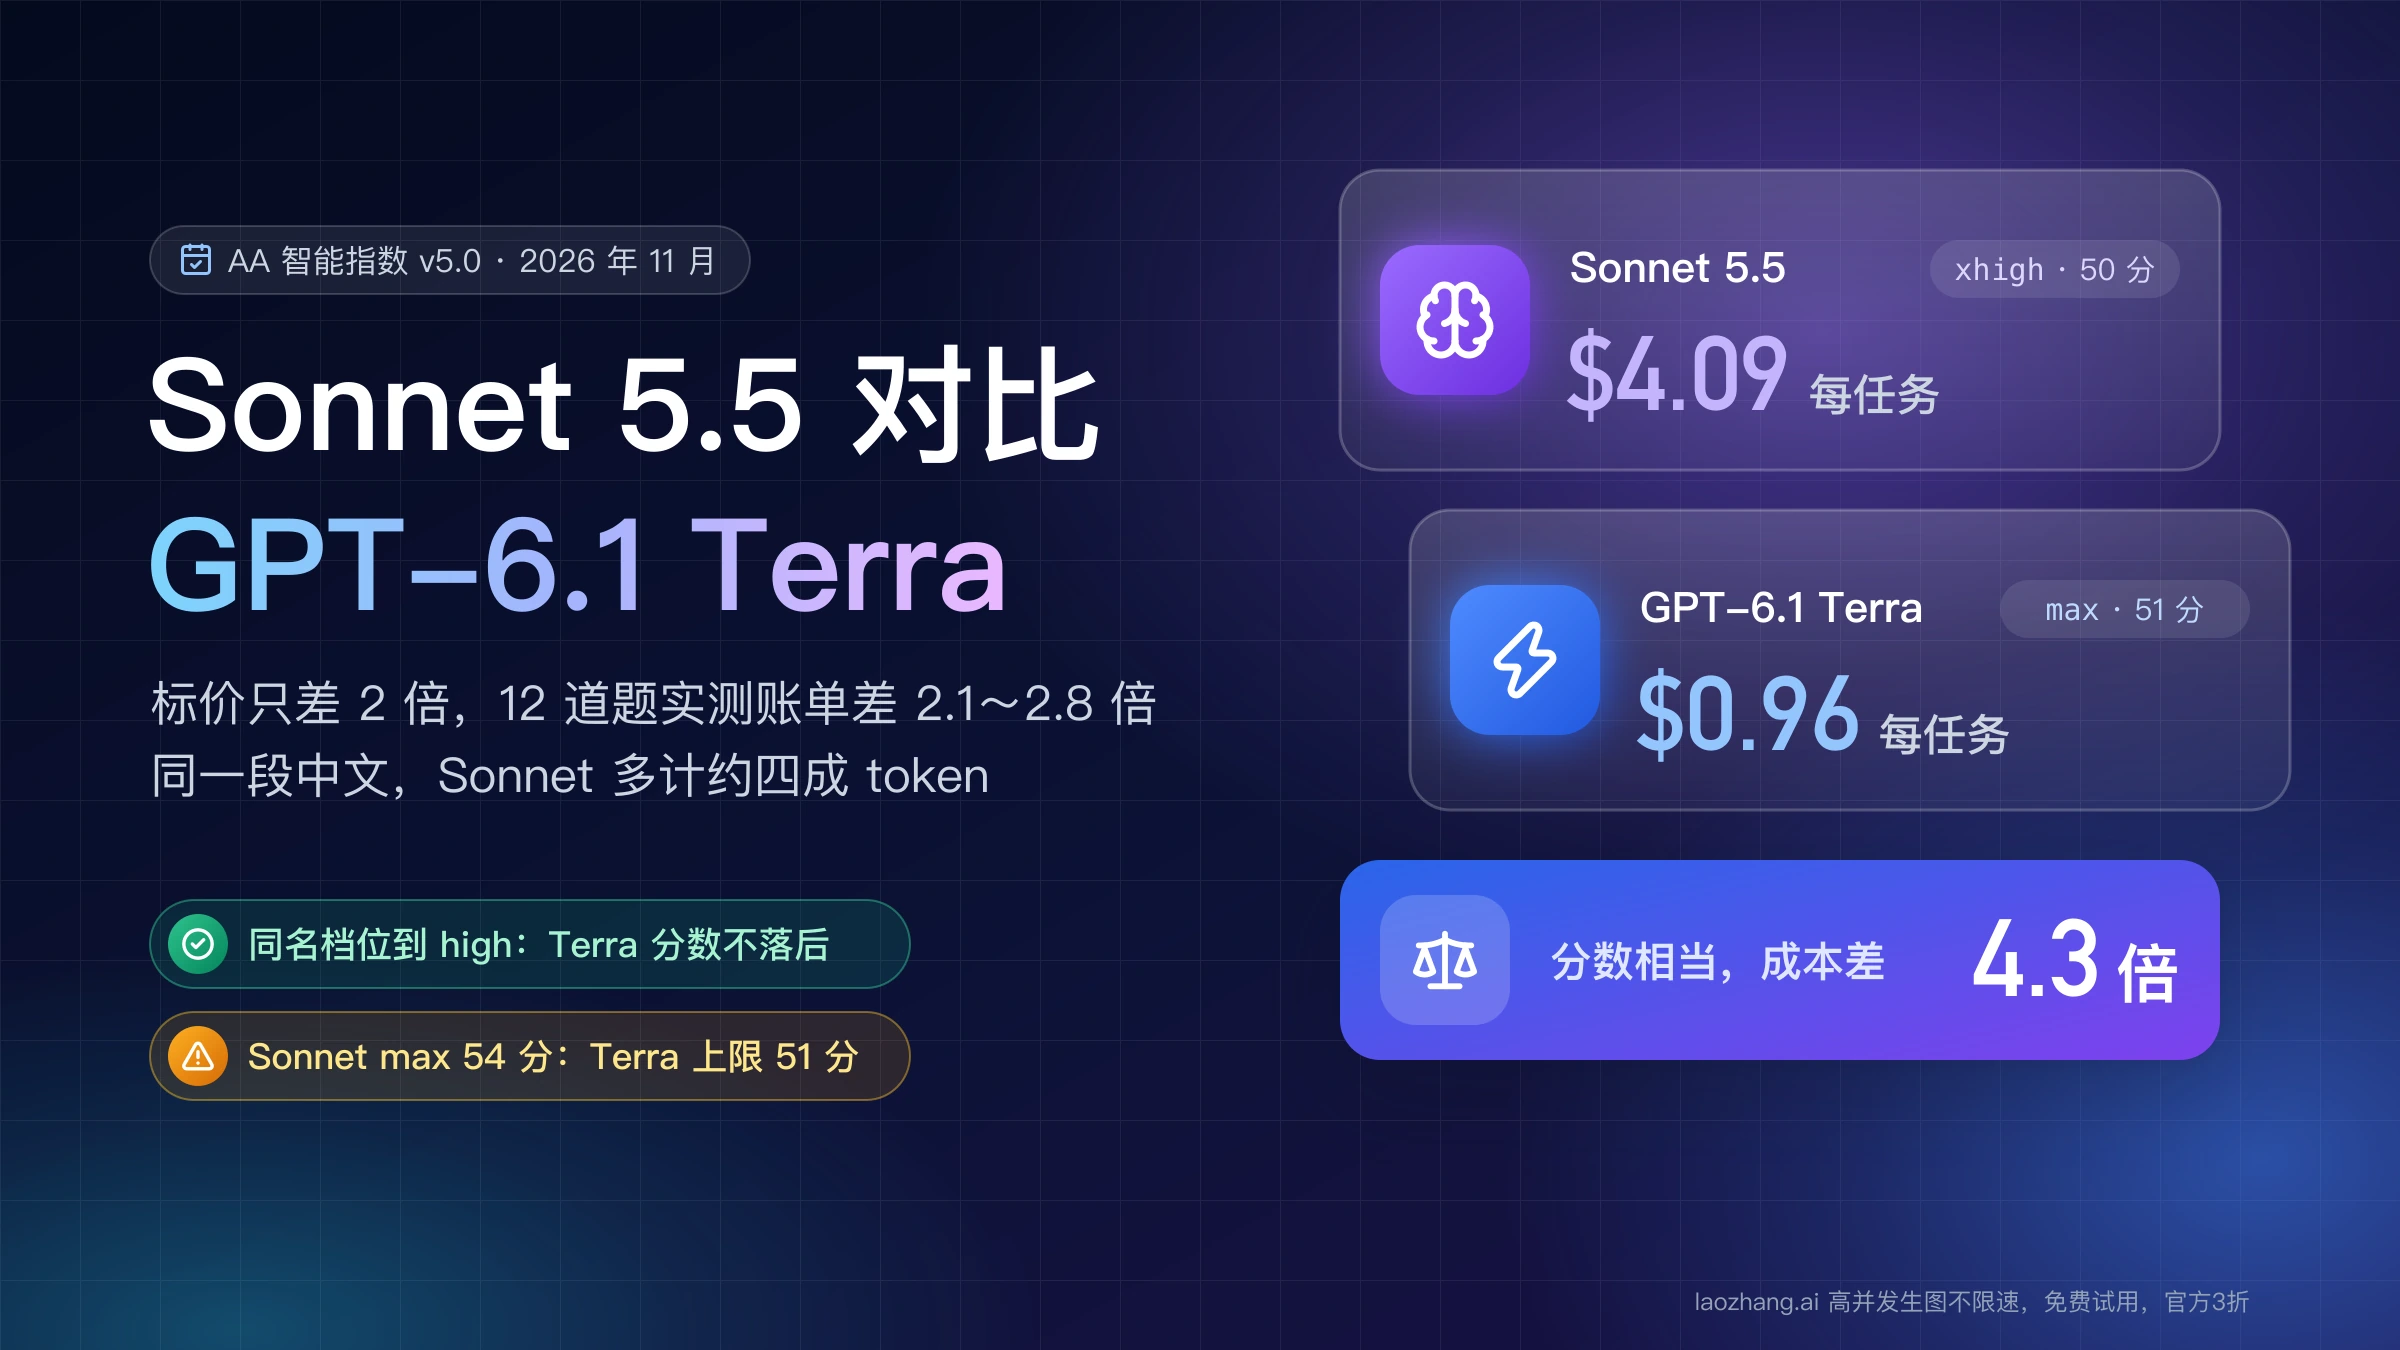
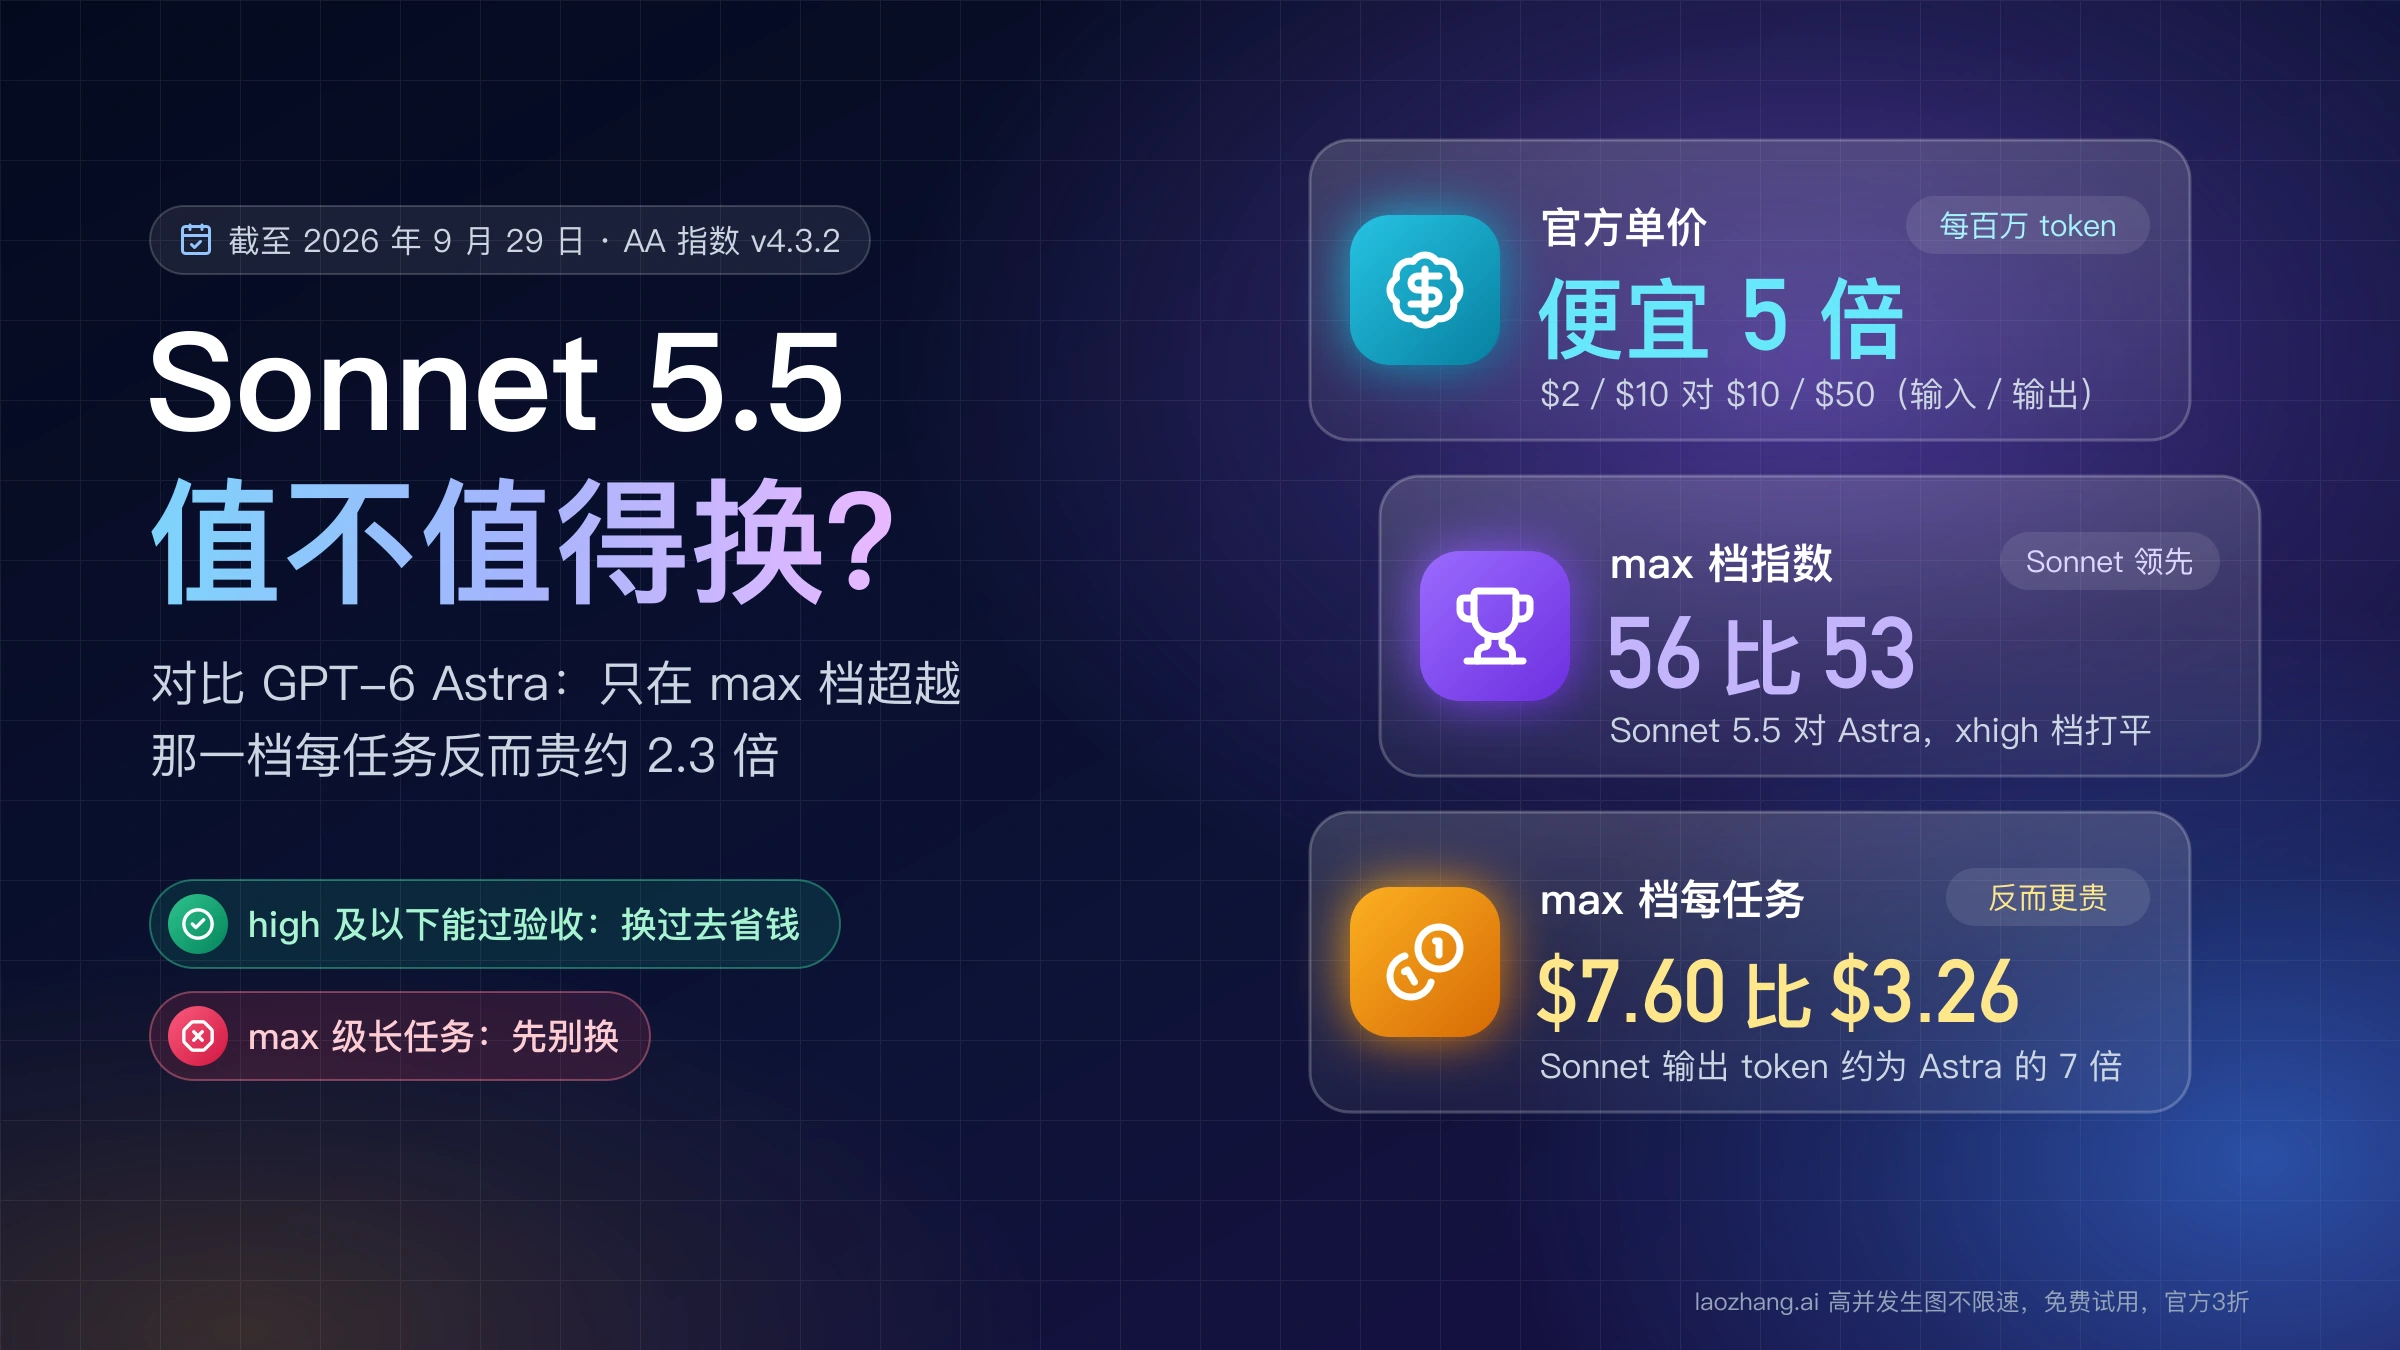
GPT-6.1 Terra(2026 年 10 月 26 日发布,API 模型 ID gpt-6.1-terra)的标价是 Claude Sonnet 5.5 的一半,但账单差距通常比一半更大。截至 2026 年 11 月 3 日,在 Artificial Analysis 的 Sonnet 5.5 与 Terra 发布对比页上,按智能指数(Intelligence Index)v5.0,Terra 的 high 档得 42 分,Sonnet 的 high 档得 41 分;要拿到和 Sonnet xhigh 相当的分数,Terra 得开到 max,每任务成本仍只有 Sonnet 的约四分之一(4.3 倍差距)。所以,API 里用 Sonnet 默认 high 跑的单轮、要求明确的工作,可以先拿同一批提示词换到 gpt-6.1-terra 的 medium 或 high 试跑。
Sonnet 仍有 Terra 够不到的地方。Sonnet 的 max 档得 54 分,高于 Terra 的上限 51 分;在多步终端操作、办公自动化这类分项评测里,分数相近时 Sonnet 也领先。这两类工作建议先留在 Sonnet,换之前用自己的任务复测。
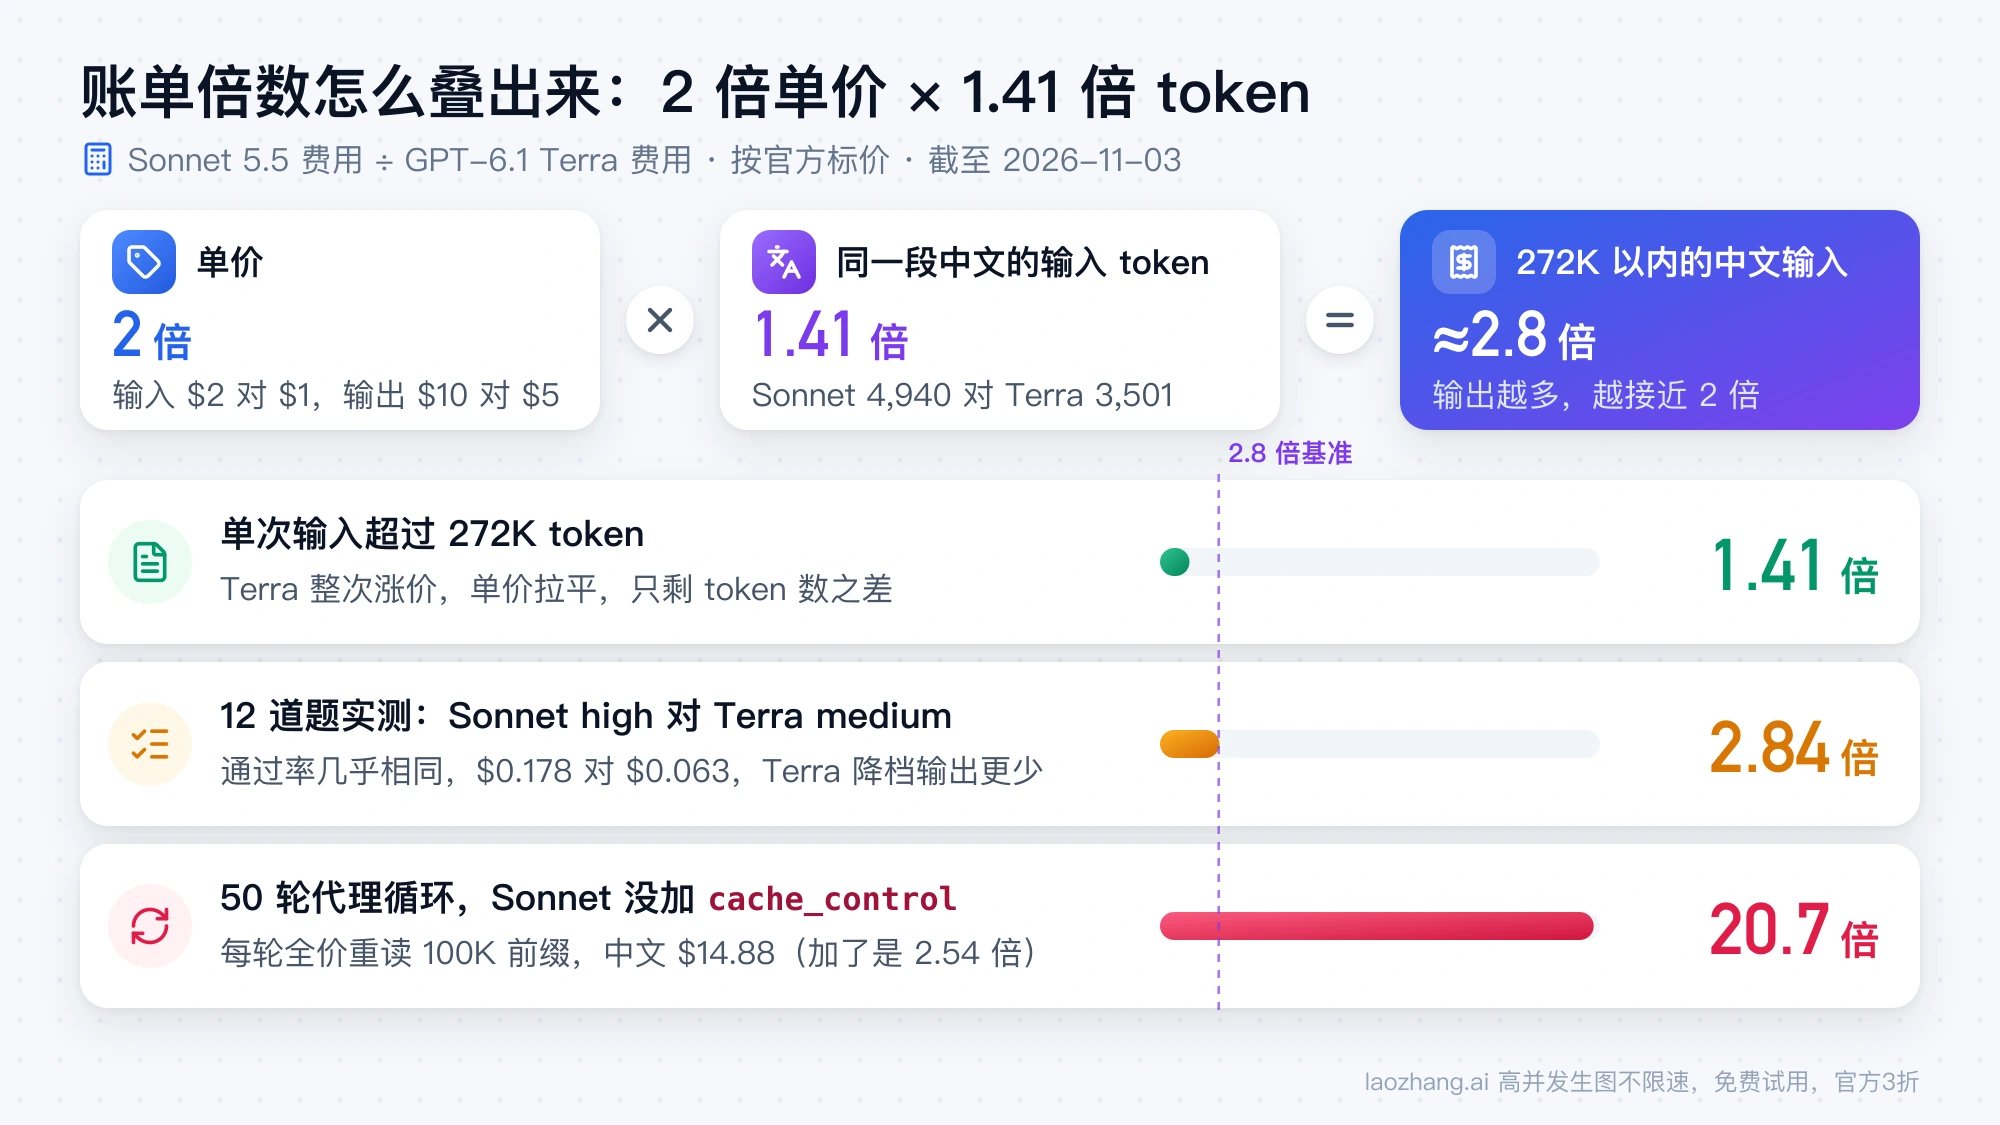
账单为什么不止差一半:同一段中文,Sonnet 计出的输入 token 是 Terra 的 1.41 倍,再乘上 2 倍单价,输入部分约按 2.8 倍计费。2026 年 11 月 3 日用同一批 12 道带隐藏测试的题目实测,Sonnet high 通过 11 题、按标价花 $0.178,Terra medium 通过 12 题、花 $0.063。例外有两个:提示超过 272K token 时 Terra 整次请求涨价,差距缩到只剩 token 数之差;Sonnet 不加 cache_control 跑长循环时,差距反而会拉大到十几、二十倍。
标价一半,账单不是一半:同一段中文按约 2.8 倍计费
按每百万 token 计,截至 2026 年 11 月 3 日,OpenAI API 定价页上 GPT-6.1 Terra 的 Standard 价格是输入 $1、输出 $5(单次输入不超过 272K),Claude 官方定价页上 Sonnet 5.5 是输入 $2、输出 $10。单价确实正好是 2 倍,但账单等于"单价 × token 数",而两家的分词方式不同,同样的文字计出的 token 数也不同。
2026 年 11 月 3 日,把同一段 6,000 字符的文字分别发给两家 API,扣掉只含指令时的基数后比较输入 token:中文 Sonnet 4,940、Terra 3,501,是 1.41 倍;英文 1.43 倍,Python 代码 1.46 倍,一份约一万 token 的长英文文档 1.50 倍。每种语言只测了一段文字,换一段内容比值会有小幅浮动,但方向一致。所以在 272K 以内,同一份中文提示放到 Sonnet 上,输入费用约是 Terra 的 2 × 1.41 ≈ 2.8 倍。
输出这一侧取决于推理强度(effort)。推理 token 按输出计费,档位越高写得越多:在下文的 12 道题里,两边都用 high 时输出量几乎一样(Sonnet 11,155、Terra 11,375 token),Terra 降到 medium 后输出只有 7,149 token。因此"换到 Terra 能省多少",要看你换过去用哪一档,而不是只看单价。
Sonnet 5.5 和 Terra 怎么选:按工作类型定 effort
先说结论:多数单轮、目标明确、能自动检查结果的工作,可以试着从 Sonnet 换到 Terra;Terra 的档位要按你原来在 Sonnet 上用的档位往上对,不要按同名对。两家的 effort 名字不是同一把尺子,同叫 high,耗的 token 和得到的分数都不一样。另外,"Sonnet 默认档"要分场景:Claude API 默认 high,Claude Code 和 Claude 应用默认 medium(见 Anthropic 的 Sonnet 5.5 发布公告);Terra 的默认是 medium。
| 你现在怎么用 Sonnet 5.5 | 建议 | 理由与前提 |
|---|---|---|
API 默认 high,写函数、改格式、抽字段、写摘要这类单轮任务 | 换 Terra,先试 medium,不够再开 high | AA 上 Terra high 的分数已不低于 Sonnet high,每任务成本低得多 |
需要 Sonnet xhigh 才做得好的难题 | 试 Terra max | 分数相当时 Terra 便宜约四分之三;max 要走 Responses API |
只有 Sonnet max 才够用 | 留在 Sonnet,或评估 Opus 5.5 | Terra 的最高分低于 Sonnet max |
| 多步终端操作、办公自动化、长时间运行的代理 | 两边复测后再决定 | 这类分项 Sonnet 领先;Terra 调用工具要走 Responses API |
| 提示经常超过 272K token | 主要按质量选 | 超过 272K 后两边单价拉平,只剩 token 数之差 |
Claude Code 里用默认 medium | 可以在 Codex 里对比 Terra medium | Sonnet medium 在 AA 上比 Terra medium 低 8 分,成本却更高 |
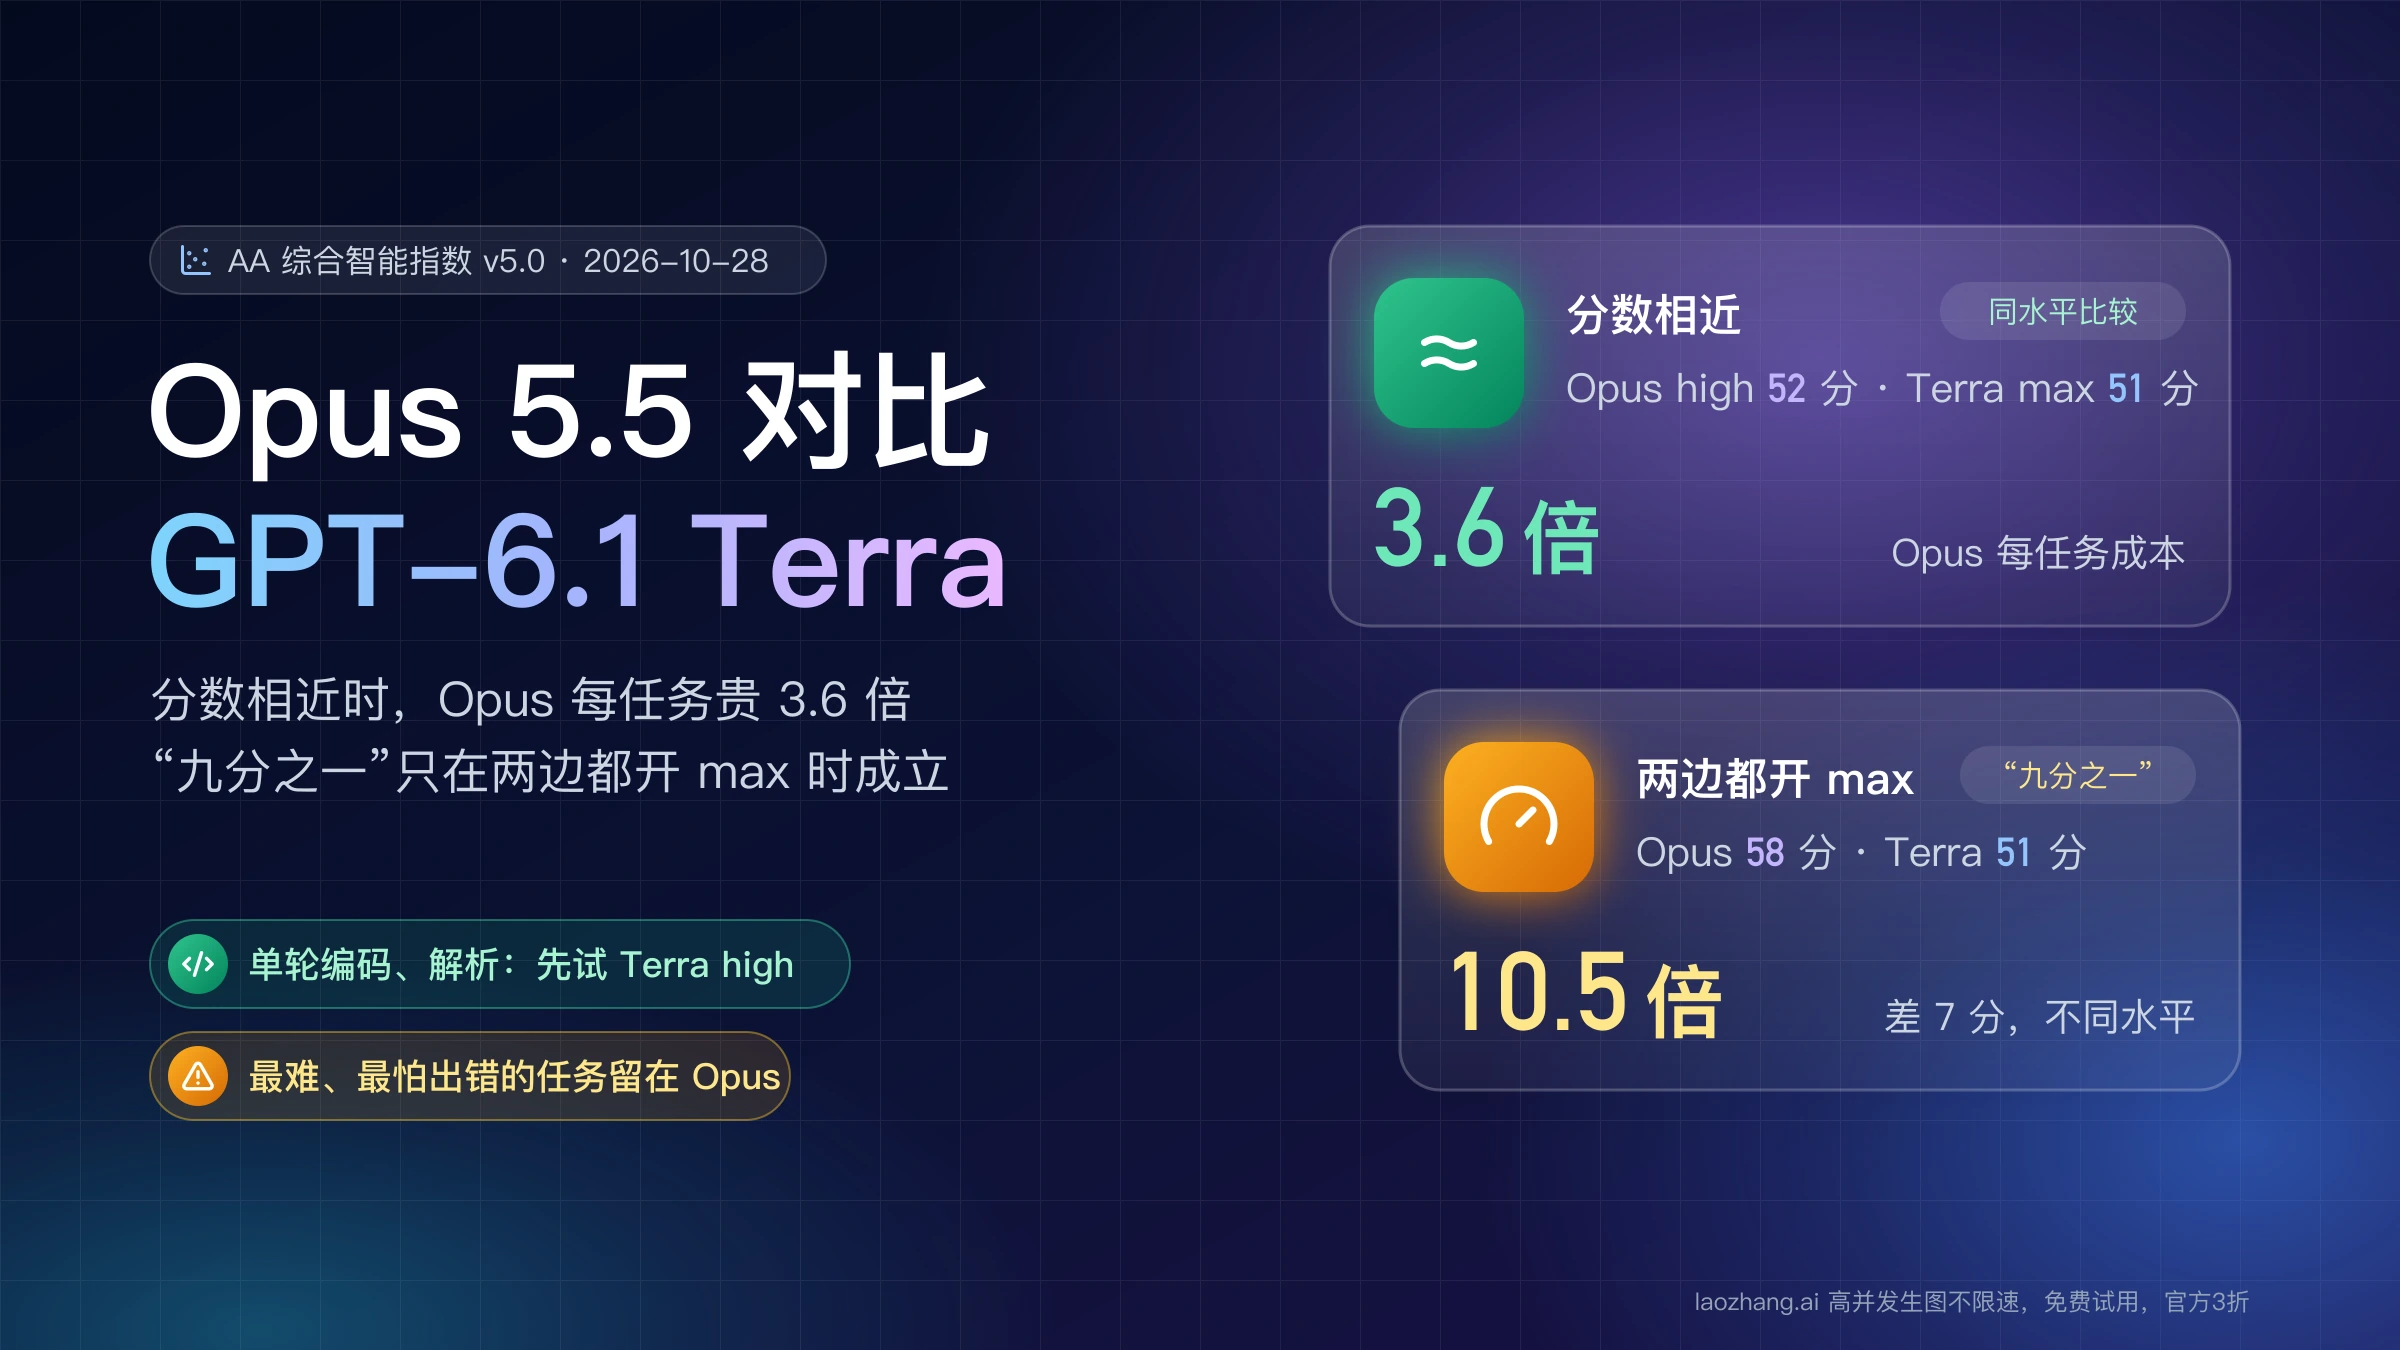
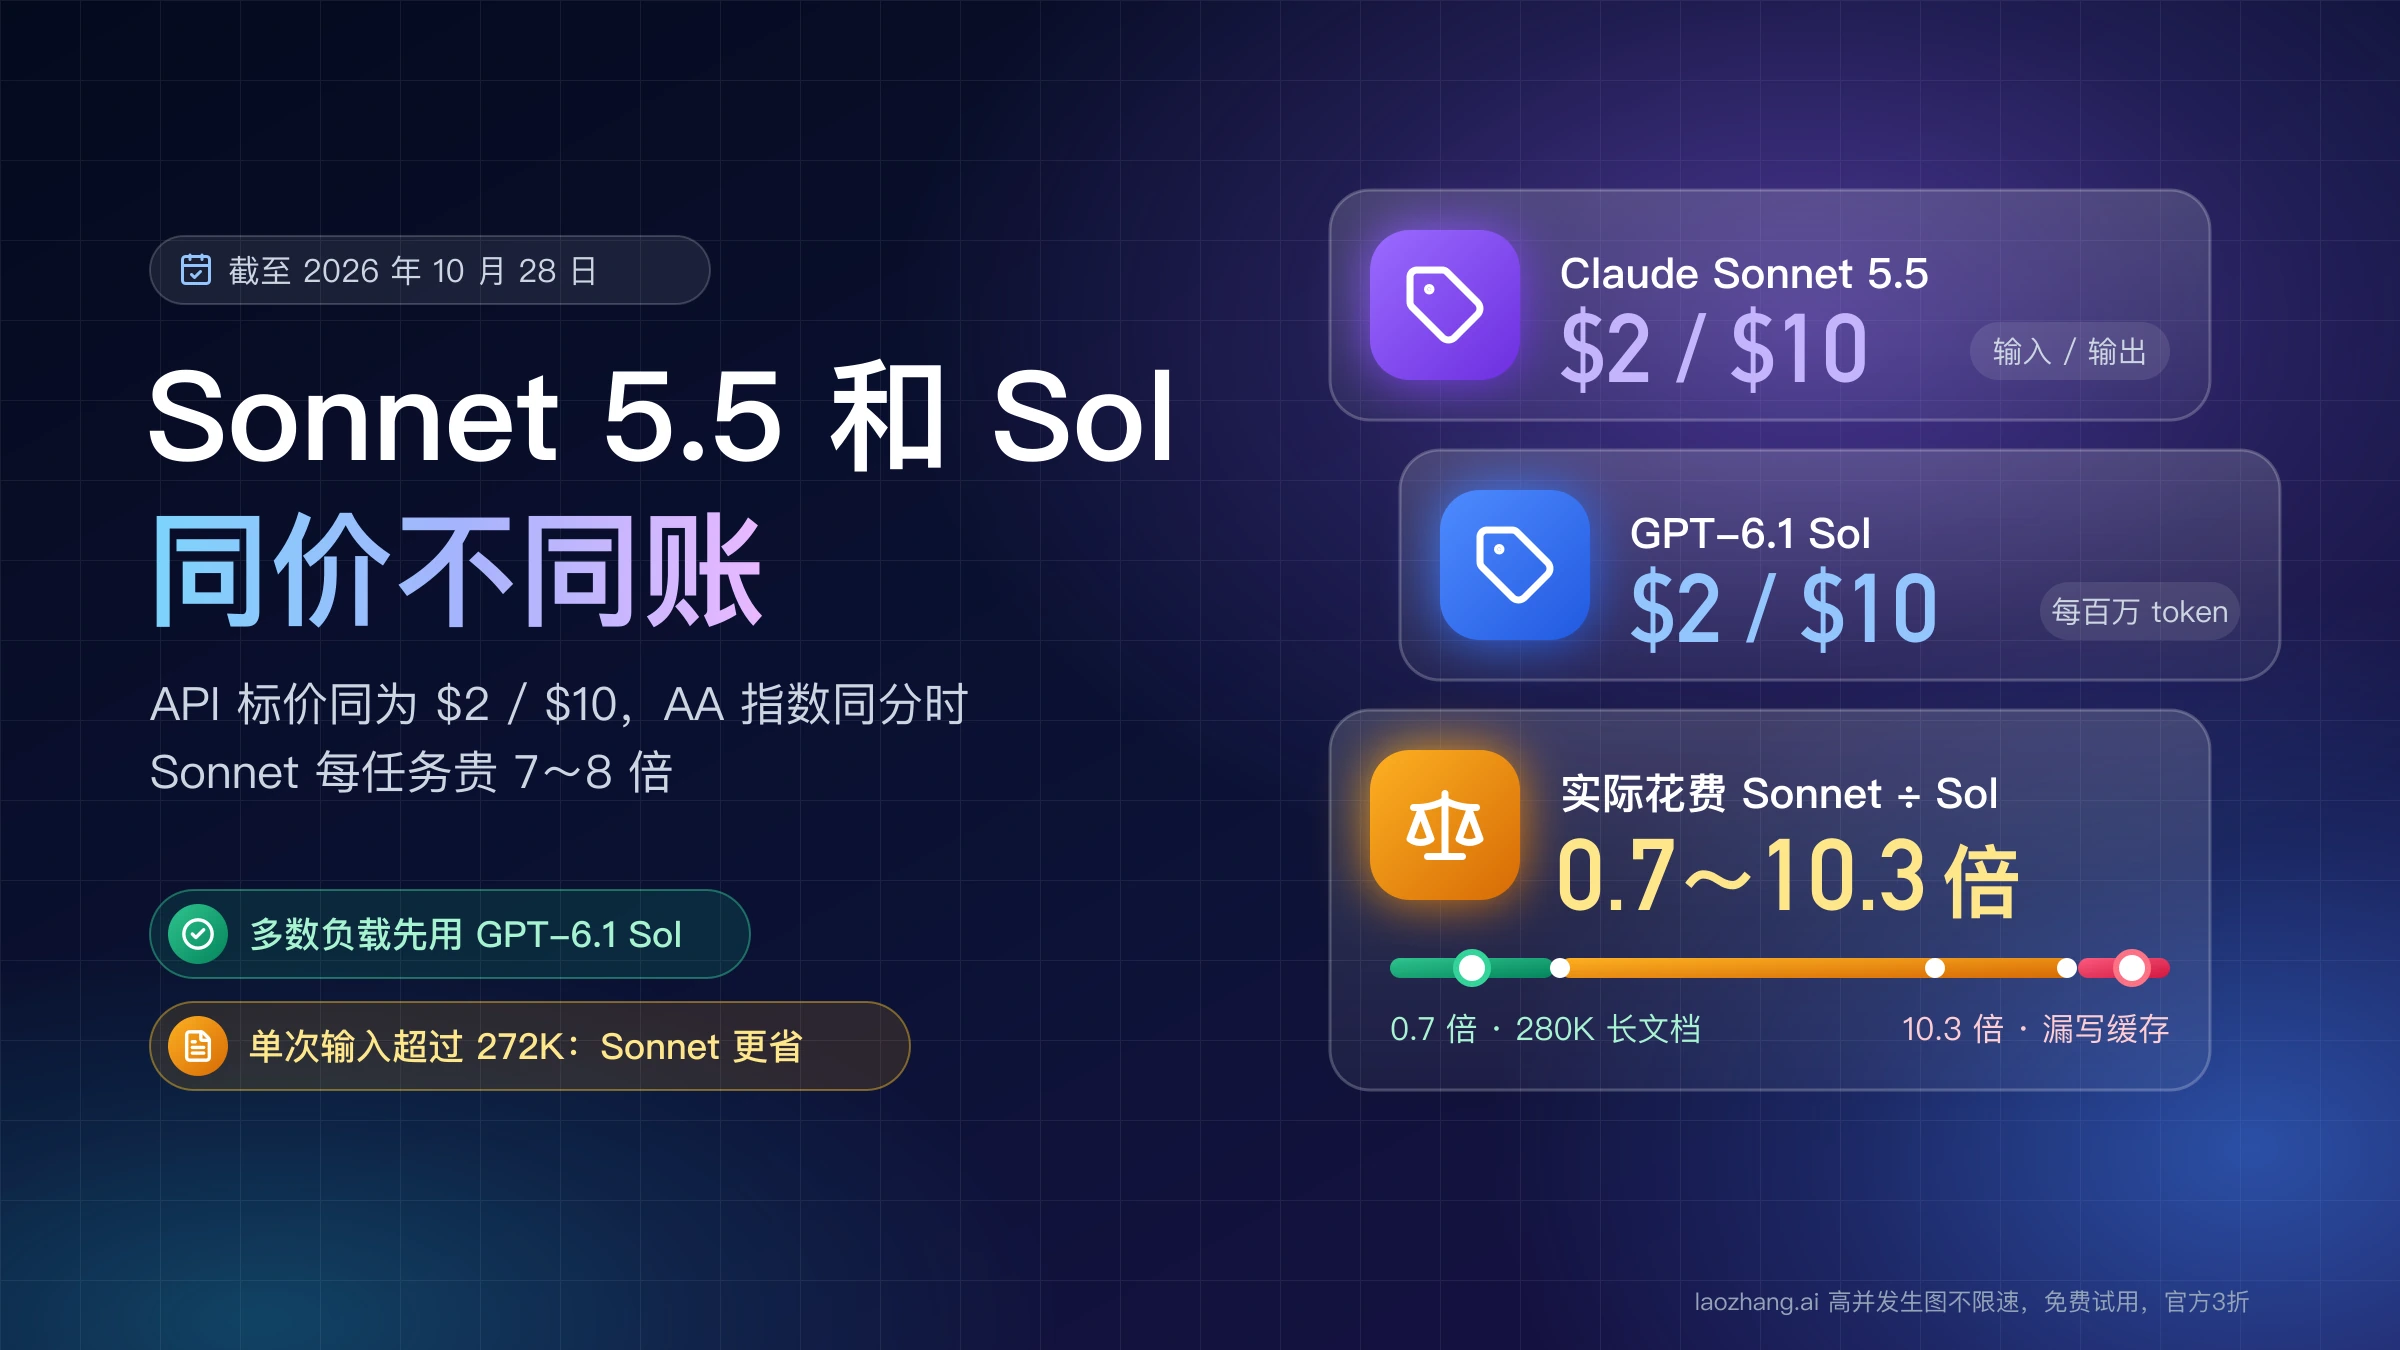
需要 Opus 级别的分数时,Terra 不是 Opus 的替代,Claude Opus 5.5 对比 GPT-6.1 Terra:同分时成本差 3.6 倍单独算了这一组。想要和 Sonnet 同价的 OpenAI 模型,看 Claude Sonnet 5.5 和 GPT-6.1 Sol 对比:同价,同分成本差 7~8 倍;在 OpenAI 内部 Terra 和 Sol 之间选,看 GPT-6.1 Terra 和 Sol 区别:Codex 实测用时减半,要高分时 Sol 更省。
AA v5.0 逐档对照:同名档位 Terra 到 high 都不落后
截至 2026 年 11 月 3 日,Artificial Analysis 智能指数 v5.0 对两款模型的每一档都给了分数、每任务成本和每任务用时。同名档位从 low 到 high,Terra 的分数都不低于 Sonnet,每任务成本只有 Sonnet 的约七分之一到五分之一;到 xhigh 和 max,Sonnet 的分数反超。这里的每任务成本是 AA 按它自己测到的 token 用量乘以官方标价算出的,不是你的账单,但能用来比较两家在同一套题上的相对开销。
| 推理强度 | Sonnet 5.5:分数 / 每任务成本 / 用时 | GPT-6.1 Terra:分数 / 每任务成本 / 用时 | 成本倍数(Sonnet ÷ Terra) |
|---|---|---|---|
none(不推理) | 无此档 | 30 / $0.23 / 104 秒 | — |
low | 25 / $0.51 / 127 秒 | 29 / $0.07 / 48 秒 | 7.3 倍 |
medium | 30 / $0.78 / 190 秒 | 38 / $0.17 / 118 秒 | 4.6 倍 |
high | 41 / $1.64 / 344 秒 | 42 / $0.26 / 172 秒 | 6.3 倍 |
xhigh | 50 / $4.09 / 719 秒 | 45 / $0.40 / 248 秒 | 10.2 倍 |
max | 54 / $10.02 / 1,263 秒 | 51 / $0.96 / 533 秒 | 10.4 倍 |
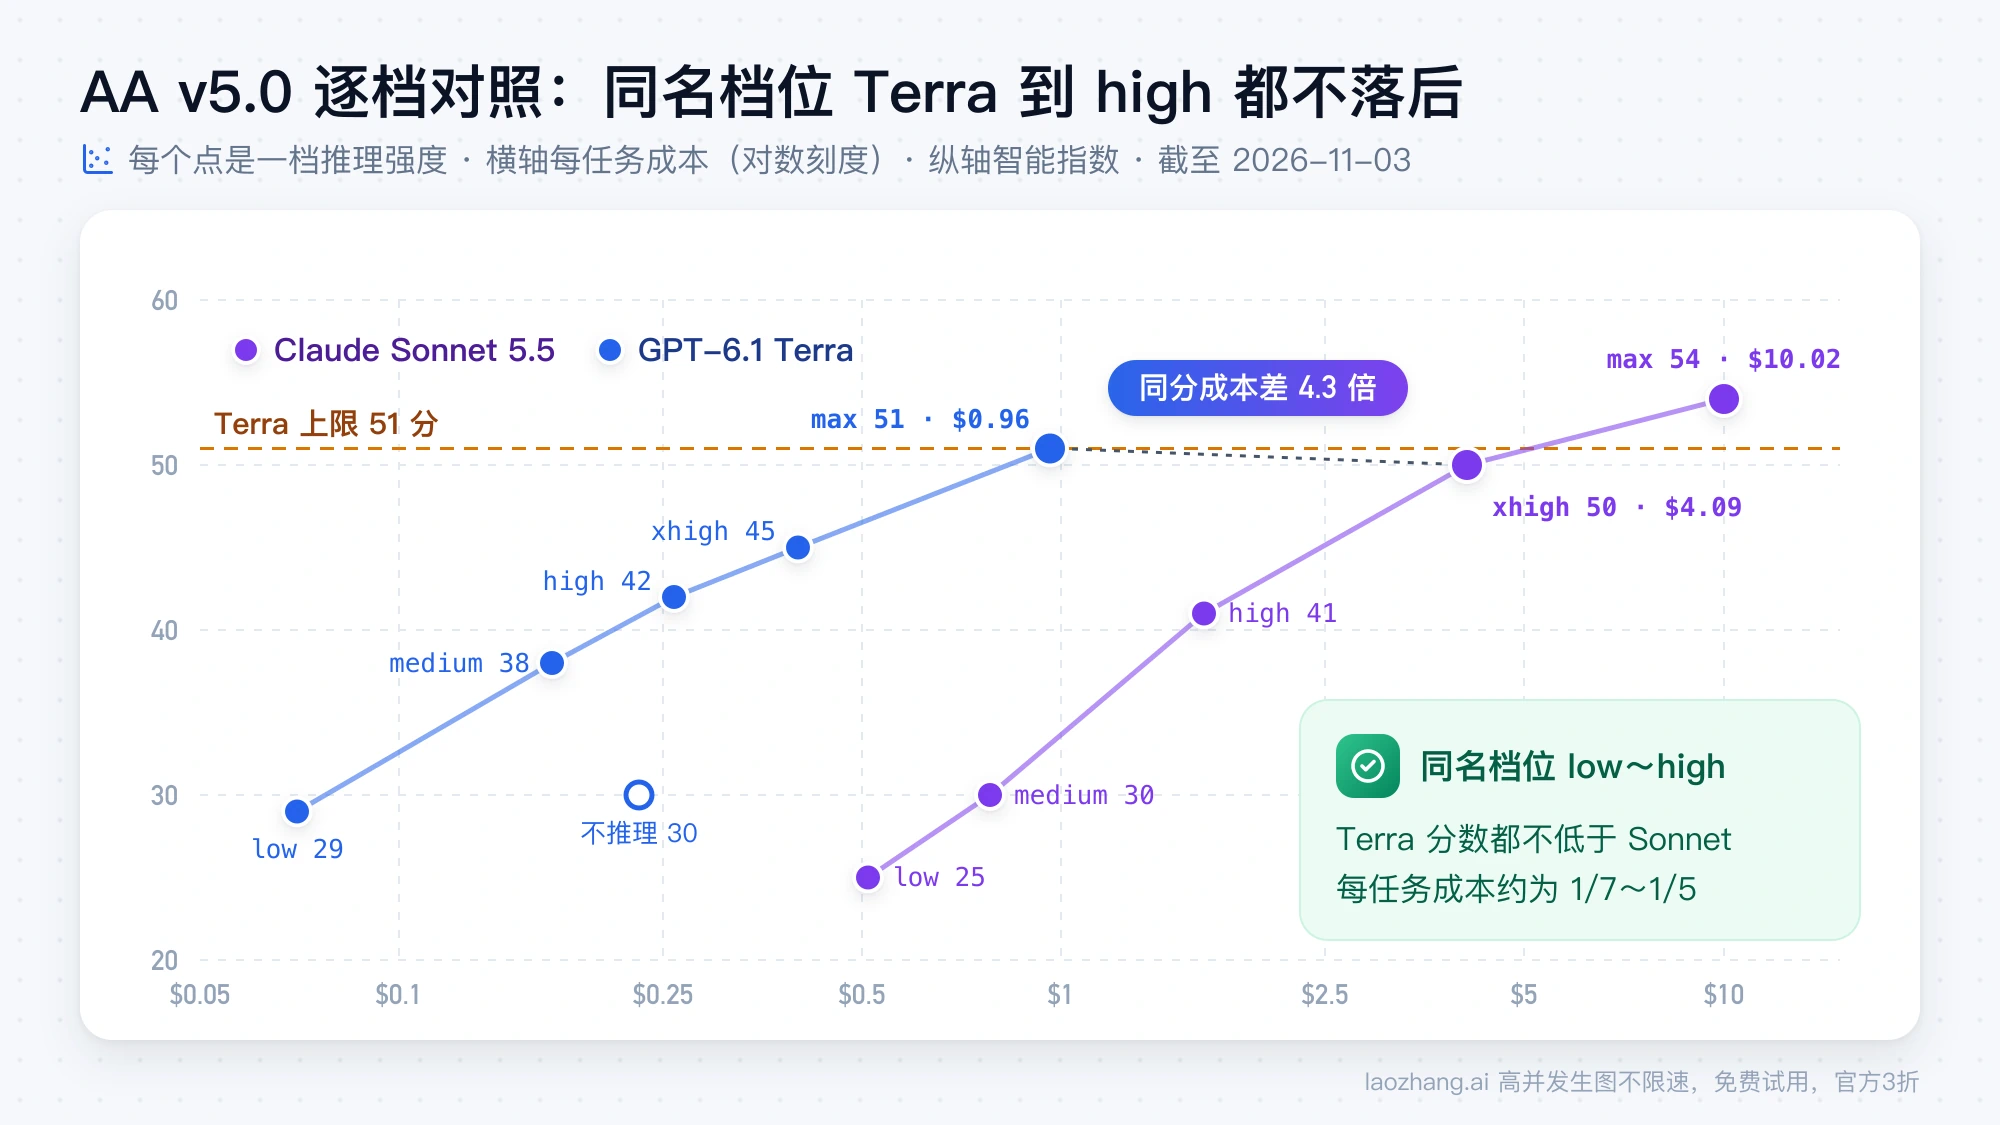
按默认档对默认档读:在 API 里,Sonnet 默认 high(41 分)对 Terra 默认 medium(38 分),Terra 低 3 分,Sonnet 的每任务成本是 9.6 倍、用时是 2.9 倍。在 Claude Code 和 Claude 应用里,Sonnet 默认 medium 只有 30 分,比 Terra medium 低 8 分,成本还是 4.6 倍。
按分数对分数读,结论更清楚。Sonnet xhigh(50 分)和 Terra max(51 分)几乎同分,Sonnet 每任务 $4.09、Terra $0.96,差 4.3 倍,用时差 1.35 倍。Sonnet medium 的 30 分,Terra 不推理就能拿到,成本差 3.4 倍。唯一 Terra 够不到的是 Sonnet max 的 54 分,代价是每任务 $10.02、约 21 分钟,是 Terra max 的 10.4 倍成本和 2.4 倍用时。
如果你看到"两者在 low 36 分、medium 41 分打平,xhigh 时 Sonnet 以 52 对 45 领先"这类说法,那是 AA 旧版指数 v4.3.2 的数字。AA 在 2026 年 10 月 27 日到 28 日之间换成了 v5.0,题目和分数都变了,新版里同名档位已经没有打平的情况。引用 AA 的数字时,带上版本号和日期。
能力区别:Sonnet 领先代理与办公评测,Terra 领先科研题
总分接近时,两者擅长的方向并不一样。拿几乎同分的 Sonnet xhigh(50 分)和 Terra max(51 分)逐项比,截至 2026 年 11 月 3 日的 AA v5.0 分项里,Sonnet 在偏代理和办公的三项上领先:命令行代理评测 Terminal-Bench 4.0 是 57.1% 对 55.6%,办公自动化 AutomationBench-AA 是 65.5% 对 60.2%,商务文档评测 AA-Briefcase v1.1 是 1744 对 1402。Terra 则在 FrontierCode 2.0 编程题(42.3% 对 35.6%)、科研推理题 CritPt v2 Hard(64.5% 对 54.0%)和 Terminal-Bench-Science 0.1(57.6% 对 52.4%)上领先。
这些都是 AA 对每种配置跑一次的结果,方向比具体数字更值得参考:如果你的工作主要是让模型在终端里连续执行命令、操作办公流程,Sonnet 的优势在这里;如果是独立的算法题或偏科研的推理,Terra 不吃亏。OpenAI 把 Terra 定位为擅长视觉推理、计算机操作和写作的快速模型,同时在 GPT-6.1 Terra 发布公告里说,最复杂的编程任务仍是 GPT-6.1 Sol 和 GPT-6 Astra 更合适。公告里"每任务成本约为九分之一"的说法,比较对象是 Claude Opus 5.5,不是 Sonnet,公告里没有和 Sonnet 的对比。
同一批 12 道题实测:通过率持平,Sonnet 贵 2.1~2.8 倍
2026 年 11 月 3 日,经 LaoZhang API 网关(laozhang.ai)用同一个 key 跑了同一批 12 道单轮题目。Sonnet 5.5 走 Anthropic Messages 接口,显式设置 thinking: adaptive 和 output_config.effort: "high";Terra 走 Chat Completions,reasoning_effort 分别用 medium 和 high,max_completion_tokens 设为 32,000。题目都有隐藏测试或唯一答案,包括表达式求值(25 个测试)、CSV 行解析(16 个)、语义化版本比较(30 个)、npm 风格版本范围(36 个)、在约 6,700 词长文里找三条备注并算出 $76.80,以及问几个编造出来的 CPython 函数是否存在。费用按两家官方标价乘以接口返回的用量计算。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 配置 | 通过 | 按标价费用 | 输出 token(其中推理) | 输入 token | 调用总用时 |
|---|---|---|---|---|---|
Sonnet 5.5 high | 11/12 | $0.1782 | 11,155(未单独返回) | 33,300 | 103 秒 |
GPT-6.1 Terra medium | 12/12 | $0.0628 | 7,149(3,740) | 21,977 | 130 秒 |
GPT-6.1 Terra high | 11/12 | $0.0839 | 11,375(7,816) | 21,977 | 176 秒 |
这组结果能说明的是成本:通过率几乎相同时,Sonnet high 的费用是 Terra medium 的 2.84 倍、Terra high 的 2.12 倍,单题从 1.1 倍到 5.8 倍不等。两边都用 high 时输出量相当,差距主要来自 2 倍单价和 Sonnet 多计的约五成输入 token(这批题以英文和代码为主,33,300 对 21,977)。它不能说明谁更聪明:12 道题没把两者拉开,两处失误是同一个格式小错,"5 条要点、每条不超过 25 词"那题各写出了一条 26 词的要点,每种配置只跑了一次。
另外两点和 AA 的结论方向不同,或者 AA 没有覆盖。在这条线路上,Sonnet 每次调用反而更快,12 题里有 11 题快于 Terra medium、12 题全部快于 Terra high,这与 AA 的每任务用时方向相反;两者的题目和计时方式不同,线路负载也会影响,不宜据此判断哪边更快。还有,两道约一万 token 的长提示在请求里没有任何缓存设置,Terra 返回的用量里仍出现了 10,103 和 10,195 个缓存写入 token,Sonnet 则没有缓存字段。工具调用、多轮代理、图片输入、Responses API,以及 Sonnet 的其他档位和 Terra 的 xhigh、max,这次都没有测,这些情况下的判断来自 AA 和两家文档。
估算自己的账单:公式和四个算例
把用量换成百万 token,Sonnet 5.5 的费用 = 2 × 新输入 + 2.5 × 缓存写入(5 分钟)+ 0.1 × 缓存读取 + 10 × 输出(含思考),这个单价一直适用到 1M 上下文。GPT-6.1 Terra 在单次输入不超过 272K 时 = 1 × 新输入 + 1.25 × 缓存写入(30 分钟)+ 0.05 × 缓存读取 + 5 × 输出(含推理)。同一份内容在 Sonnet 上的 token 数,约等于 Terra 的 token 数乘以语言系数(中文 1.41、英文 1.43、代码 1.46)。
下表按 2026 年 11 月 3 日的官方标价,假设两边输出 token 相同,只让 Sonnet 的输入按系数放大。实际跑起来输出量会因模型和档位不同而变,所以它是估算框架,不是报价。
| 场景(按 Terra token 计) | GPT-6.1 Terra | Sonnet 5.5,token 数相同 | Sonnet 5.5,中文(×1.41) | Sonnet 5.5,英文(×1.43) |
|---|---|---|---|---|
| 一轮对话:2K 输入 + 500 输出 | $0.0045 | $0.0090(2.0 倍) | $0.0106(2.36 倍) | $0.0107(2.38 倍) |
| 长文档:270K 输入 + 5K 输出 | $0.295 | $0.590(2.0 倍) | $0.811(2.75 倍) | $0.822(2.79 倍) |
50 轮代理循环:100K 前缀缓存,每轮 2K 新输入 + 1K 输出,Sonnet 加 cache_control | $0.72 | $1.44(2.0 倍) | $1.83(2.54 倍) | $1.84(2.56 倍) |
| Batch:10,000 次 ×(3K 输入 + 1K 输出),两边都用 Batch 价 | $40.0 | $80.0(2.0 倍) | $92.3(2.31 倍) | $92.9(2.32 倍) |
套用到自己的工作时,先用 Terra 的计费结果或 token 计数确定你的输入、输出量,再乘语言系数得到 Sonnet 的输入量。输出越多、输入越少,倍数越接近 2;中文或英文长输入占比越高,倍数越接近 2.8。再叠加 effort 的影响:如果 Terra 用 medium 就能完成原来 Sonnet high 的活,输出量还会再少三分之一左右,实测里 Sonnet high 对 Terra medium 的 2.84 倍就包含了这一部分。
超过 272K 或不开缓存:差距缩到 1.4 倍,或拉大到 20 倍
两个条件会让上面的倍数失效。第一个是长提示:截至 2026 年 11 月 3 日,单次请求输入超过 272K token 时,Terra 整次请求改按输入 $2、输出 $7.50、缓存读取 $0.10、30 分钟缓存写入 $2.50 计费,而 Sonnet 到 1M 都不涨价。两边每 token 单价在输入侧拉平,差距只剩分词系数:280K 输入 + 5K 输出时,Terra $0.598,Sonnet 按中文系数 $0.840,只差 1.41 倍;600K 输入时同样约 1.4 倍。注意 272K 是按 Terra 的 token 计的,换成中文内容在 Sonnet 上约是 384K token,所以别拿 Sonnet 的计数判断有没有越线。
第二个是缓存。OpenAI 对 GPT-5.6 及之后的模型默认开启缓存并对写入计费,实测里 Terra 在请求没写任何缓存设置时也产生了缓存写入;Anthropic 的缓存则要你主动开启,按 Claude 提示缓存文档,请求里不带顶层 cache_control 或显式的 cache_control 断点,就什么都不缓存。上面那个 50 轮代理循环,如果 Sonnet 一侧没加 cache_control,每轮都按全价重读 100K 前缀,token 数相同时是 Terra 的 14.9 倍($10.70),中文内容是 20.7 倍($14.88)。从 Sonnet 切到 Terra 做比较之前,先确认你现在的 Sonnet 请求有没有开缓存,否则会把缓存的差别算成模型的差别。
是哪个 Terra:GPT-6.1 Terra 不是 GPT-5.6 Terra
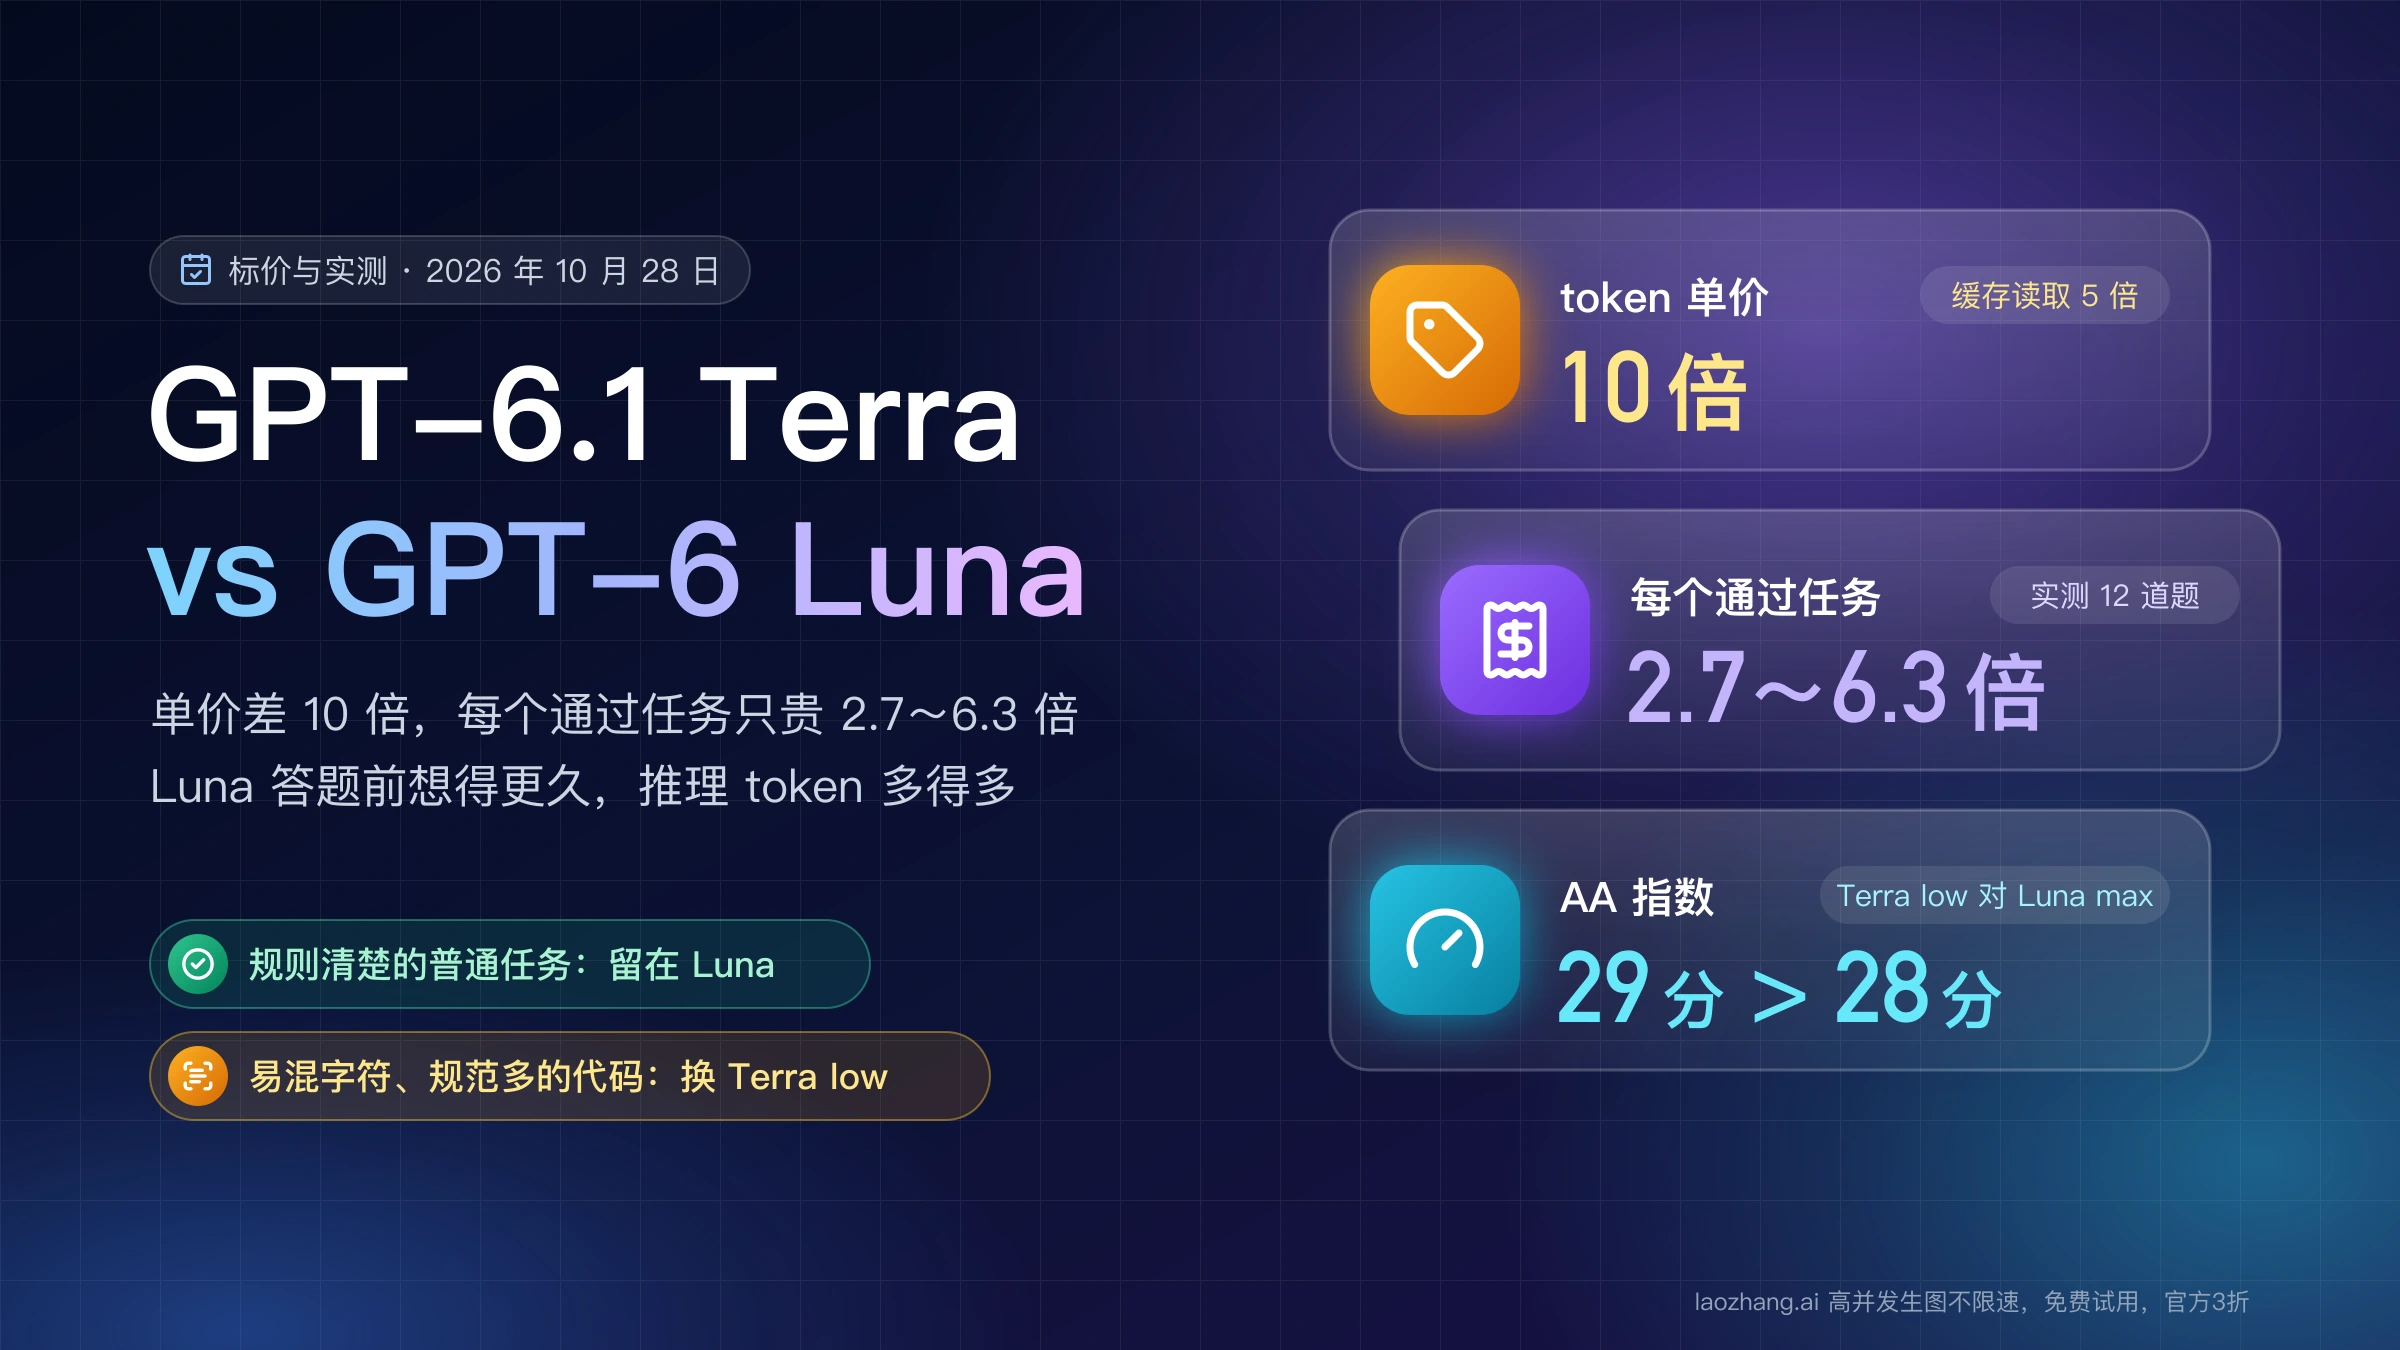
上面所有分数和倍数说的都是 gpt-6.1-terra。上一代 GPT-5.6 Terra(gpt-5.6-terra)截至 2026 年 11 月 3 日仍是可调用的模型,OpenAI 模型页上的价格是输入 $2、输出 $12,比 Sonnet 5.5 的输出还贵,弃用页也没有给它列停用日期。如果你在找的是 Sonnet 5.5 对 5.6 Terra,上面的倍数都不适用;GPT-6 全线与两个 Terra 怎么区分,见 GPT-6 Sol、Luna、Astra 与 Terra 怎么选?认清 6.1 Terra,再算成本。往下一档的 Luna,见 GPT-6.1 Terra 和 GPT-6 Luna 区别:实测每任务贵 2.7~6.3 倍。
ChatGPT、Codex 和 Claude 套餐里的入口与默认档
不走 API 的话,GPT-6.1 Terra 在 ChatGPT 里只出现在工作(Work)模式和 Codex,普通聊天里选不到;OpenAI 发布公告列出的是 Plus、Pro、Enterprise 和 Edu,Codex 文档另外列了 Business。Sonnet 5.5 在 Claude 应用和 Claude Code 里都能用,默认档是 medium,各模型在 Claude Code 里实际发送的默认档和改不动时的排查,见 Claude Code effort level 设置:各模型实测默认档与不生效排查。
套餐额度不能用 API 单价推算:截至 2026 年 10 月 27 日,Codex 文档给 Plus 和 Business 标准席位的 5 小时用量是 Terra 本地消息 35~285 条,并说明不是固定上限,Anthropic 则没有公布 Sonnet 5.5 的消息条数;Codex 里 Terra 与 Sol 的用量对比见上文链接的 Terra 与 Sol 区别一文。如果你经 CC Switch 在 Codex 里用 Terra 却看不到这个模型,见 CC Switch 下 Codex 看不到 GPT-6.1 Terra:回直连或升 0.165.0。
换之前用自己的提示词复测一小批
AA 的分数和上面的 12 道题都只能给出方向,真正决定换不换的是你自己的任务能不能通过、每个合格结果花多少钱。照下面的顺序做一小批就够判断;作为参照,上面 12 道题 × 3 种配置共 36 次调用,按标价一共约 $0.32。
- 从近期真实工作里挑 20~50 条提示词,每条都要能自动或快速判对错,例如有单元测试、有标准答案或有明确格式要求。只看"回答好不好"很难比出结论。
- 固定 Sonnet 一侧的设置:显式写出
thinking: {"type": "adaptive"}和output_config.effort,档位用你现在生产里用的那一档。2026 年 10 月 26 日的测试里,经同一网关调用 Sonnet 5.5 时不带thinking就不返回思考内容。如果你现在开了cache_control,复测也保持开启。 - Terra 一侧先跑默认
medium,再跑high。Chat Completions 要用max_completion_tokens:2026 年 10 月 28 日经同一网关测试,用max_tokens返回 400,reasoning_effort: "max"也返回 400(只接受到xhigh),而 Responses API 的reasoning: {"effort": "max"}正常返回。所以要测max或带工具调用,改走 Responses API。 - 每次调用记下返回的用量:输入、输出、推理 token,以及 Terra 的缓存写入 token。按上一节的公式乘官方单价算费用,不要按条数平摊。
- 按"总费用 ÷ 合格结果数"比较,而不是只比单次价格。Terra 某一档通过率掉下来、需要重试,省下的钱会被吃回去。
- 如果你的提示常在 200K 以上,单独挑几条超过 272K 的跑一次,确认长提示下的倍数;经 LaoZhang 调 Claude 时单次输出上限是 32,768 token,长输出任务要把这一点算进去。
Terra 的 medium 在你的任务上通过率和 Sonnet 持平,就先把这类工作换过去;只有 high 或 max 才持平时,按第 5 步算出的单个合格结果成本决定;Terra 开到 max 仍做不到的,留在 Sonnet。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月3日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月3日。
- 1.Artificial Analysis 的 Sonnet 5.5 与 Terra 发布对比页artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-1-terra
- 2.OpenAI API 定价页developers.openai.com/api/docs/pricing
- 3.Claude 官方定价页platform.claude.com/docs/en/about-claude/pricing
- 4.Anthropic 的 Sonnet 5.5 发布公告anthropic.com/news/claude-sonnet-5-5
- 5.GPT-6.1 Terra 发布公告openai.com/index/introducing-gpt-6-1-terra
- 6.Claude 提示缓存文档platform.claude.com/docs/en/build-with-claude/prompt-caching