GPT-6.1 Terra 和 GPT-6 Luna 区别:实测每任务贵 2.7~6.3 倍
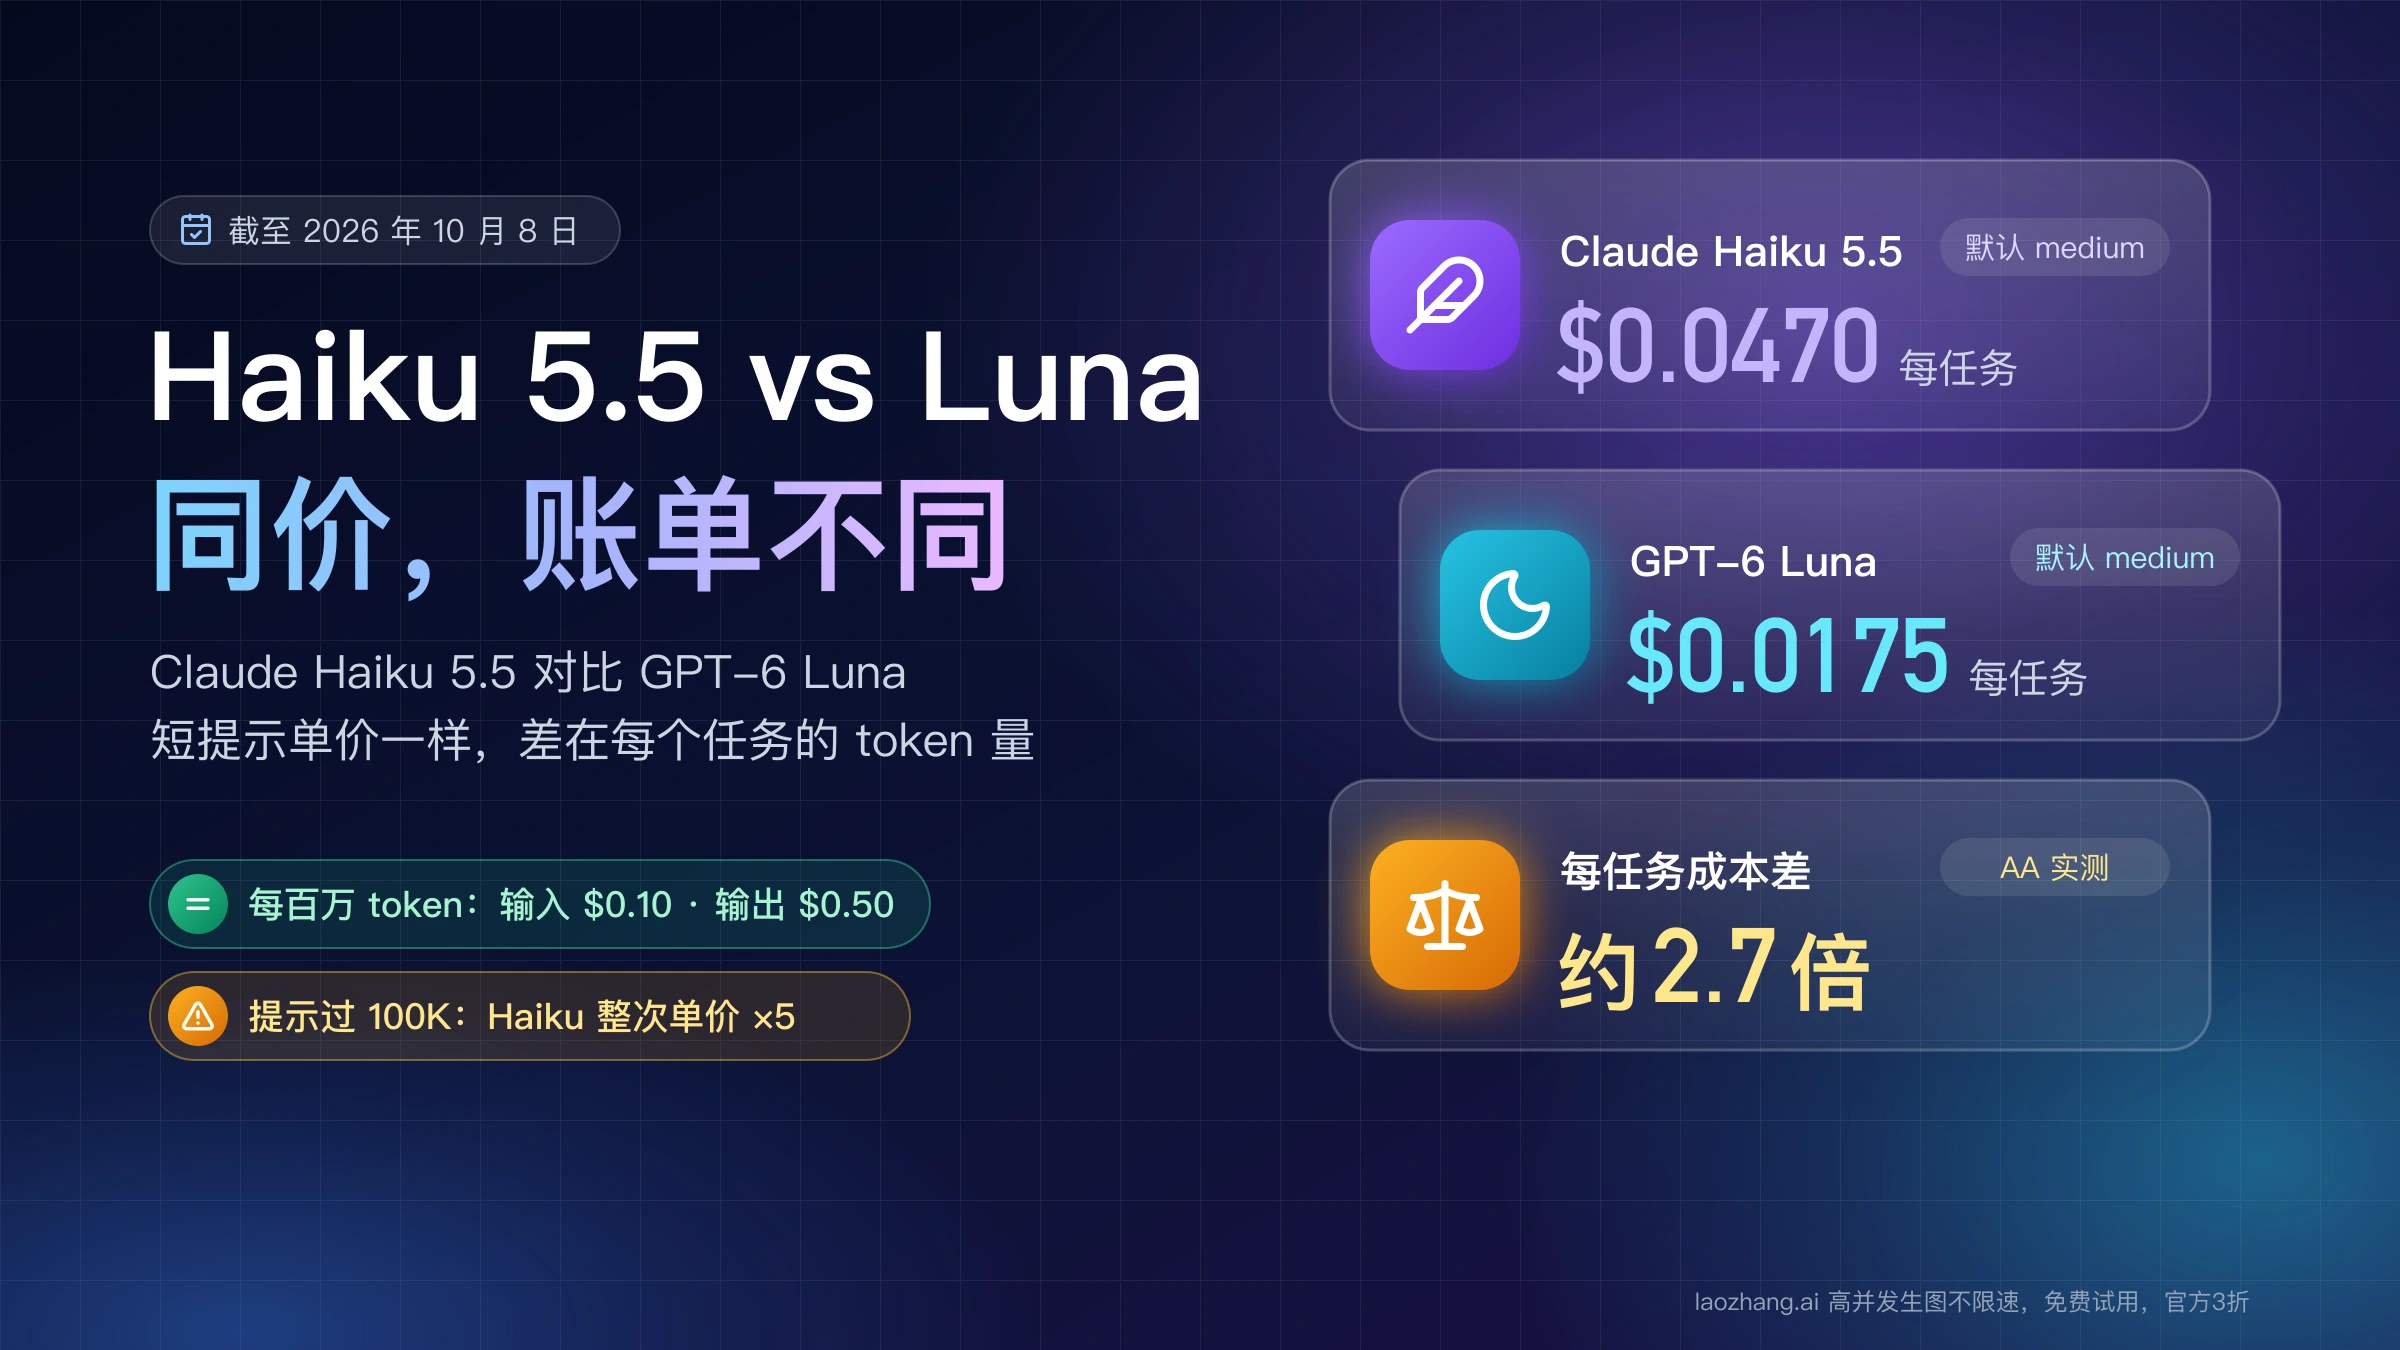
GPT-6.1 Terra 单价是 GPT-6 Luna 的 10 倍,实测每个通过任务贵 2.7~6.3 倍。普通任务留在 Luna,读图和规范多的代码换 Terra low。
文章目录
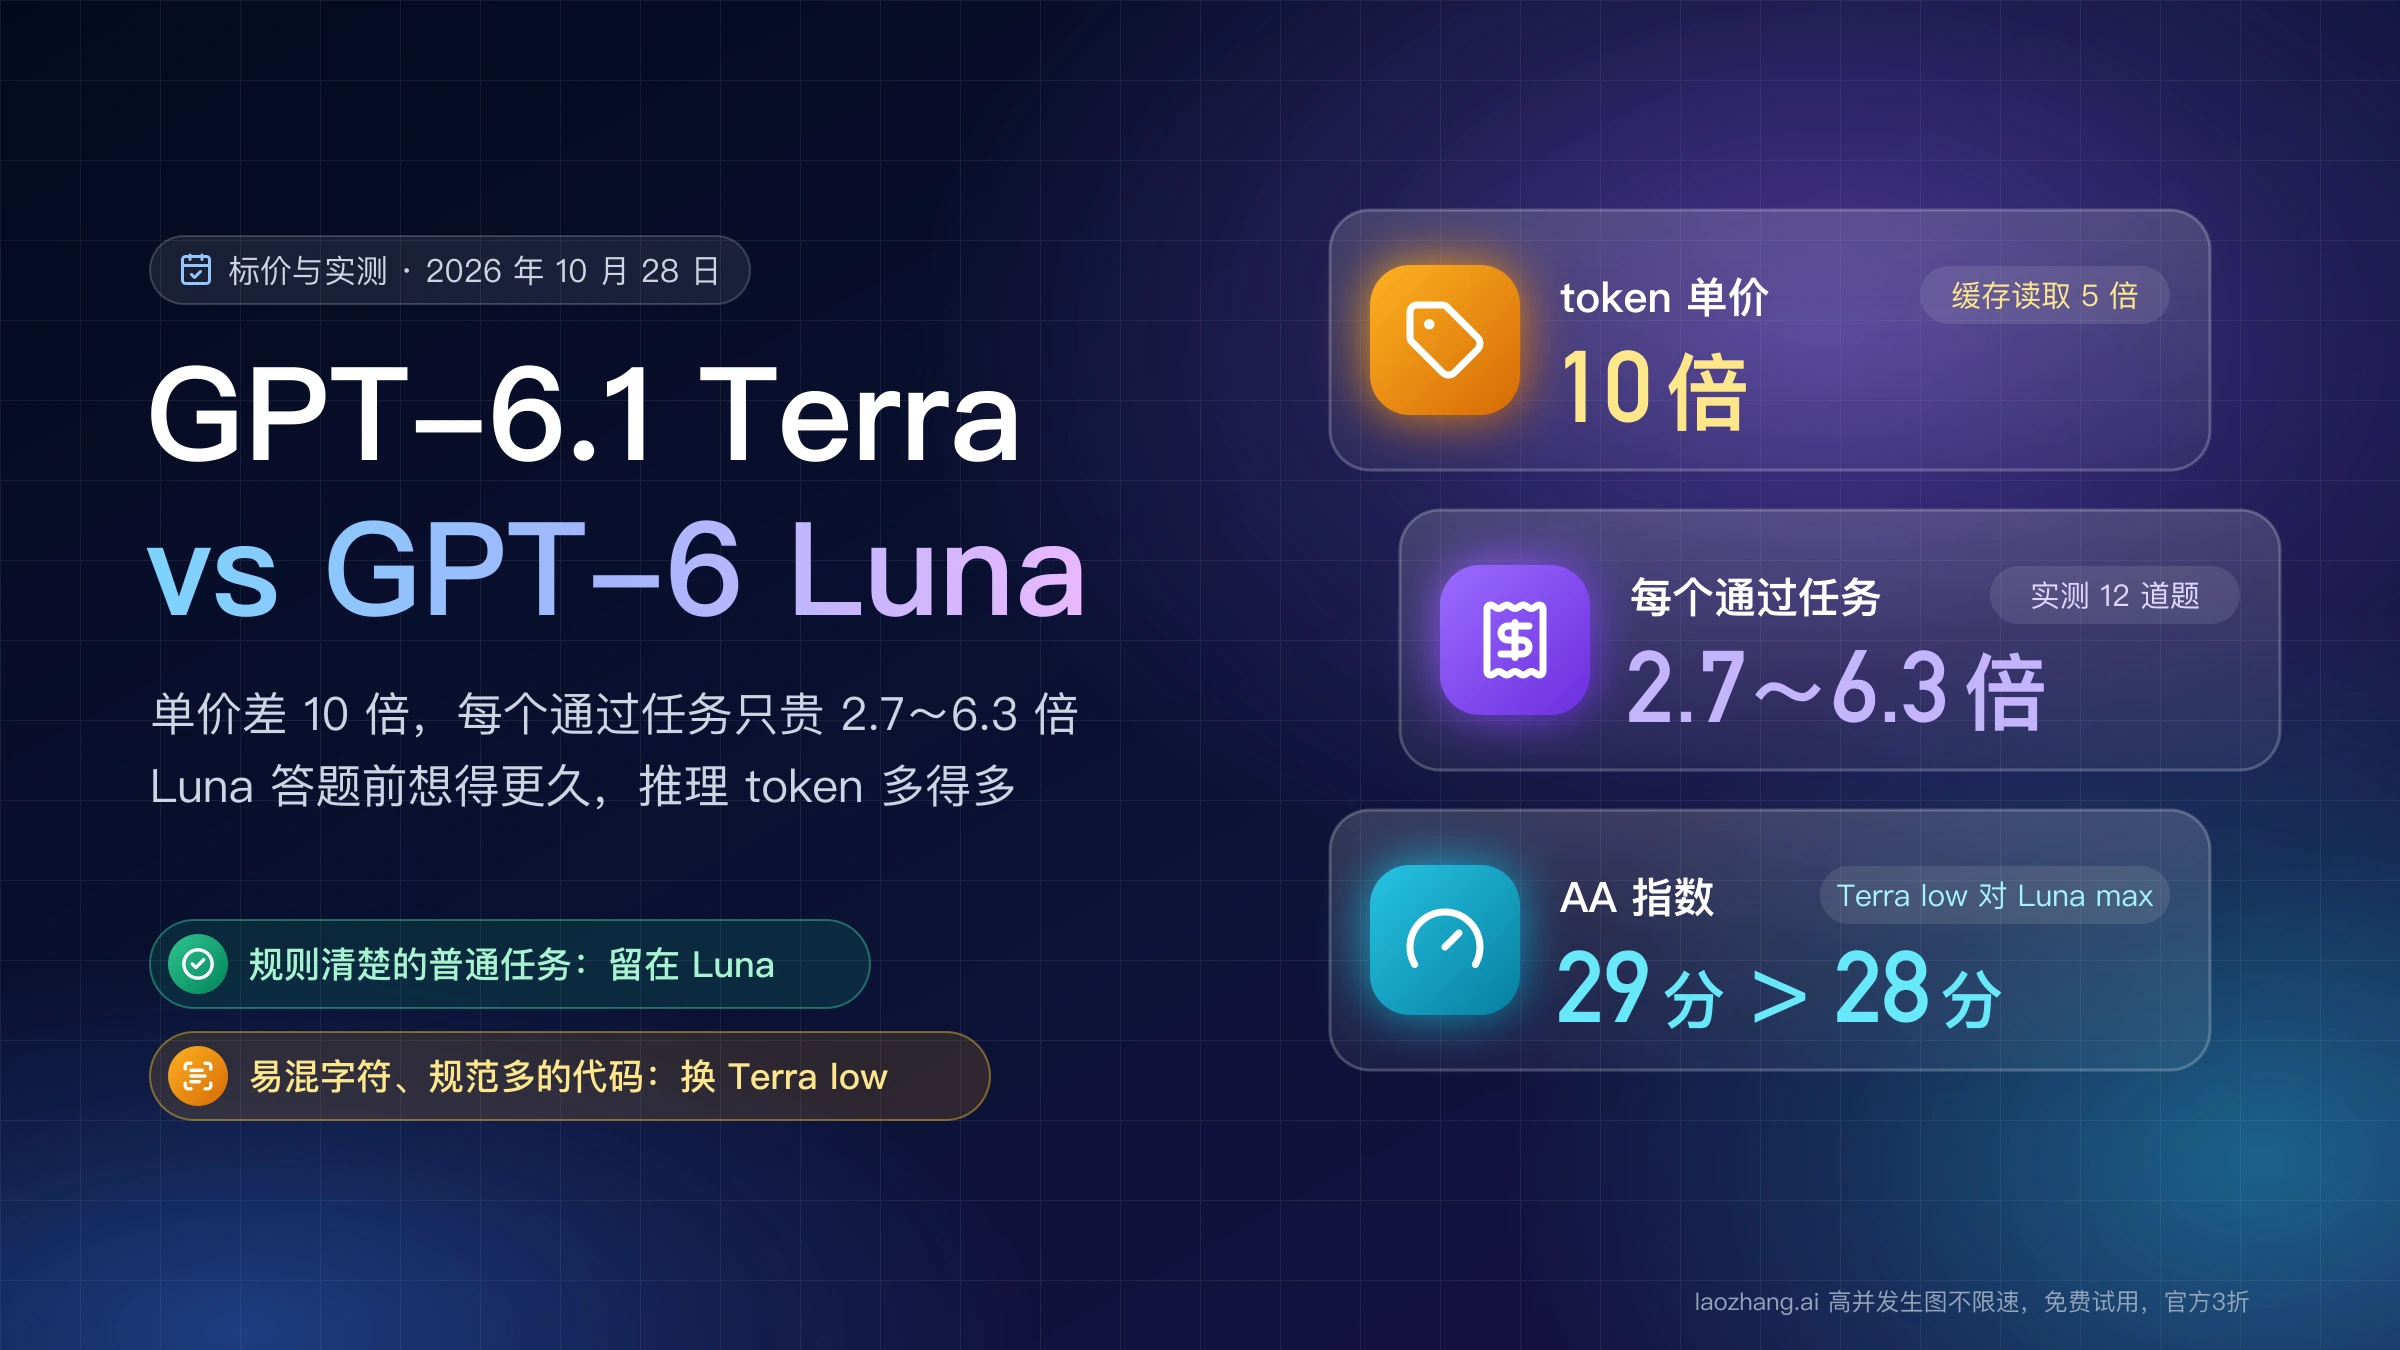
GPT-6.1 Terra 的 API 单价是 GPT-6 Luna 的 10 倍(缓存读取是 5 倍),但这是每百万 token 的价格,不是每个任务的价格。2026 年 10 月 28 日,经同一个 API 网关用 12 道题对比两者:Luna 每次答题前想得更久、产生的推理 token 更多,所以按每个通过的任务算,Terra 只贵 2.7~6.3 倍,每次调用还快 2~3 倍。值不值得换,取决于 Luna 在你的任务上会不会出错,而不是那个 10 倍。
所以,规则清楚、有测试兜底的批量任务(摘要、普通函数、解析器、长文档里找数算账),继续用 gpt-6-luna,reasoning_effort 用默认的 medium 就够了。Luna 反复出错的任务,比如要逐字读准图片里易混字符、或者规范细则很多的代码,直接换 gpt-6.1-terra 的 low 或 medium,不要把 Luna 往 xhigh、max 调:实测里 Luna 从 medium 调到 xhigh,输出 token 翻倍,通过数没有变化;在 Artificial Analysis 的 Intelligence Index v5.0 上,Terra low 得 29 分、每道题 $0.07,Luna max 得 28 分、每道题 $0.15。
有三种情况先别换。你的数据必须在美国和欧盟以外的地区驻留时,Terra 不支持,只能留在 Luna;你用的是 ChatGPT 普通聊天,那里没有 Terra,它只在 Work 和 Codex 里;你的 Luna 代码在 Chat Completions 上做工具调用,换成 Terra 必须先改到 Responses API。这几处的具体改法在后面的换模型清单里。
GPT-6.1 Terra 和 GPT-6 Luna 有什么区别:规格一样,定位不同
两者的硬规格几乎一样,差别在 OpenAI 给它们的定位和几处接口限制上。截至 2026 年 10 月 28 日,OpenAI 的 GPT-6.1 Terra 模型页和 GPT-6 Luna 模型页写的都是 1,050,000 token 上下文、单次最多输出 128,000 token、文本和图片输入、文本输出,推理强度都可选 none、low、medium(默认)、high、xhigh、max,推理 token 都按输出计费,都不支持音频和视频。所以上下文长度和输出上限不是选谁的理由。
定位上,OpenAI 把 Luna 叫作"最高效的模型,适合专注、大批量的任务";GPT-6.1 Terra 于 2026 年 10 月 26 日发布,定位是"快速、高效,擅长视觉推理、精确的计算机操作和清晰自然的写作",模型页举的例子是把商品照片对上目录条目、看懂技术图纸、在应用界面上执行操作、起草和修改文字。知识截止日期 Luna 是 2026 年 5 月 18 日,Terra 是 2026 年 6 月 1 日。真正会挡住切换的差别是工具调用和数据驻留:Terra 的工具调用只能走 Responses API,Luna 在 Chat Completions 上只有 reasoning_effort 为 none 时才能做函数调用;Terra 的数据驻留只支持美国和欧盟。
名字也容易混。GPT-6.1 Terra 是 GPT-6 家族里第一款 Terra,没有 gpt-6-terra 这个 ID;之前的 GPT-5.6 Terra 仍在价目表上,标价 $2 / $12(输入 / 输出),GPT-6.1 Terra 的输入是它的一半、输出是它的 5/12。Luna 这边没有对应的 6.1 版本,见文末的问答。
每百万 token 价格:除缓存读取是 5 倍外,都差 10 倍
按 OpenAI API 定价页截至 2026 年 10 月 28 日的 Standard 档,单次输入不超过 272K token 时,GPT-6.1 Terra 的输入是 $1、输出是 $5,GPT-6 Luna 是 $0.10 和 $0.50,正好 10 倍。唯一的例外是缓存读取:Terra 的缓存读取是自身输入价的 5%,Luna 是 10%,所以这一项只差 5 倍。
| 计费项(美元 / 每百万 token) | GPT-6.1 Terra | GPT-6 Luna | Terra 是 Luna 的 |
|---|---|---|---|
| 输入 | $1.00 | $0.10 | 10 倍 |
| 缓存读取 | $0.05 | $0.01 | 5 倍 |
| 缓存写入(30 分钟) | $1.25 | $0.125 | 10 倍 |
| 缓存写入(12 小时) | $2.50 | $0.25 | 10 倍 |
| 输出(含推理 token) | $5.00 | $0.50 | 10 倍 |
| 单次输入超过 272K:输入 / 缓存读取 / 输出 | $2.00 / $0.10 / $7.50 | $0.20 / $0.02 / $0.75 | 10 / 5 / 10 倍 |
超过 272K 的规则对整次请求生效:输入和缓存按 2 倍、输出按 1.5 倍计价,两款模型一样。Batch 和 Flex 是 Standard 的一半,Fast 是 2 倍,使用区域处理(数据驻留)另加 10%;Ultrafast 档目前两款都没有。缓存多的工作负载对 Terra 略有利,因为它的缓存读取只贵 5 倍,但只有在你的请求真的大量命中缓存时这一点才有意义。
AA Intelligence Index v5.0 各档对比:Terra low 已高过 Luna max
把两者放在同一套第三方题目上,最直观的结论是:Terra 最低的 low 档,已经比 Luna 开到 max 的分数高 1 分,每道题的花费只有一半,用时约为 1/12。下表来自 Artificial Analysis 的 GPT-6.1 Terra 与 GPT-6 Luna 对比页,截至 2026 年 10 月 28 日,指标是 Intelligence Index v5.0,"每道题成本"和"每道题用时"指它跑一道指数题的平均值。
| 推理强度 | Terra 分数 | Terra 每道题成本 | Terra 每道题用时 | Luna 分数 | Luna 每道题成本 | Luna 每道题用时 |
|---|---|---|---|---|---|---|
max | 51 | $0.96 | 657 秒 | 28 | $0.15 | 597 秒 |
xhigh | 45 | $0.40 | 287 秒 | 23 | $0.10 | 357 秒 |
high | 42 | $0.26 | 182 秒 | 21 | $0.07 | 269 秒 |
medium | 38 | $0.17 | 118 秒 | 18 | $0.04 | 未公布 |
low | 29 | $0.07 | 48 秒 | 10 | $0.01 | 28 秒 |
none | 30 | $0.23 | 104 秒 | 9 | $0.07 | 86 秒 |
该拿来对比的是分数相近的点,而不是同名档位。Terra low(29 分、$0.07、48 秒)对 Luna max(28 分、$0.15、597 秒),Terra 更便宜也快得多;Terra medium 的 38 分高过 Luna 任何一档。Luna 只有在分数更低的地方才更便宜:Luna medium 18 分、$0.04,Luna low 10 分、$0.01,Terra 没有这么低的档。还要注意加档的代价:Luna 从 low 调到 max,每道题成本涨 15 倍($0.01 到 $0.15),只多 18 分;Terra 从 low 调到 medium,成本涨 2.4 倍($0.07 到 $0.17),多 9 分。这正是"别把 Luna 调高,换 Terra low"这条规则的依据。
分项里差距最大的是带终端操作的编程任务。Terminal-Bench 4.0 上 Terra max 是 55.6%,Luna max 只有 12.6%,但 Terra low 也只有 15.2%,所以这类任务换 Terra 还得把推理强度开上去。FrontierCode 2.0 上两者 max 分别是 42.3% 和 25.2%。在 AA-Omniscience v1.1 这项知识问答指标上,Luna 每一档都是负分(−8 到 −26),Terra 开推理时是 23~30。
网上常见的"Terra 比 Luna 高 10 分",出自 Artificial Analysis 在 Terra 发布当天按旧版 Index v4.3.2 发的数字;换成 v5.0 后,两者 max 档是 51 比 28。引用分数时要带上版本和日期。
同一组 12 道题实测:Luna 三档都是 12/16,Terra 15/16 和 16/16
指数是很多题目的综合分,一个窄而明确的工作负载可能排出不同的顺序,所以 2026 年 10 月 28 日(约 05:40~06:30 UTC)又把两款模型放到同一组任务上跑了一轮。两者都经同一个 API 网关调用,用的是 laozhang.ai 的 OpenAI 兼容 Chat Completions 接口,返回的模型 ID 是 gpt-6.1-terra 和 gpt-6-luna-2026-09-22;每次调用只有一条用户消息,流式返回,max_completion_tokens 设为 32,000,不带工具。12 道题和判定规则在跑之前就写好了:一道应用题、三个带隐藏测试的函数、6,723 词文章的五条要点摘要、不用 eval 的表达式求值、CSV 行解析、数位和计数、npm 风格 semver 的 satisfies()(36 个隐藏测试)、埋了更正说明的长文档算账(答案 $76.80)、编造的标准库函数识别,以及发票加柱状图读成 JSON。其中 4 道各跑 2 次,所以每个配置共 16 次调用。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 配置 | 通过 | 16 次调用的标价成本 | 每个通过任务的成本 | 中位调用耗时 | 中位首个答案 token | 输出 token(其中推理) |
|---|---|---|---|---|---|---|
Luna medium | 12/16 | $0.0108 | $0.0009 | 11.4 秒 | 7.1 秒 | 15,553(9,688) |
Luna high | 12/16 | $0.0140 | $0.0012 | 14.2 秒 | 9.8 秒 | 22,063(16,127) |
Luna xhigh | 12/16 | $0.0188 | $0.0016 | 15.6 秒 | 11.2 秒 | 31,684(25,833) |
Terra low | 15/16 | $0.0625 | $0.0042 | 4.7 秒 | 4.0 秒 | 7,227(2,310) |
Terra medium | 16/16 | $0.0909 | $0.0057 | 5.9 秒 | 4.6 秒 | 12,916(8,095) |
成本是接口返回的 token 用量乘以上面的 OpenAI Standard 标价,不是网关的实际账单,缓存写入没有计入(Chat Completions 的用量里没有报这一项);整轮按标价共花 $0.197。Luna 没有 max 一行,是因为 Chat Completions 不接受 Luna 的 max,原因见后面的换模型清单。首轮有 12 次 Luna 调用在流式返回时中断(HTTP 200,但没有 finish_reason 和用量),重跑一次后全部正常完成,表里按重跑结果计。样本很小:12 道题、每档 1~2 次、单轮对话、不带工具,没有测 OpenAI 直连、工具调用和计算机操作、Codex 和 Work,以及 Batch、Flex。它能说明 Luna 在哪类题上会失手,不能当成通用的错误率。
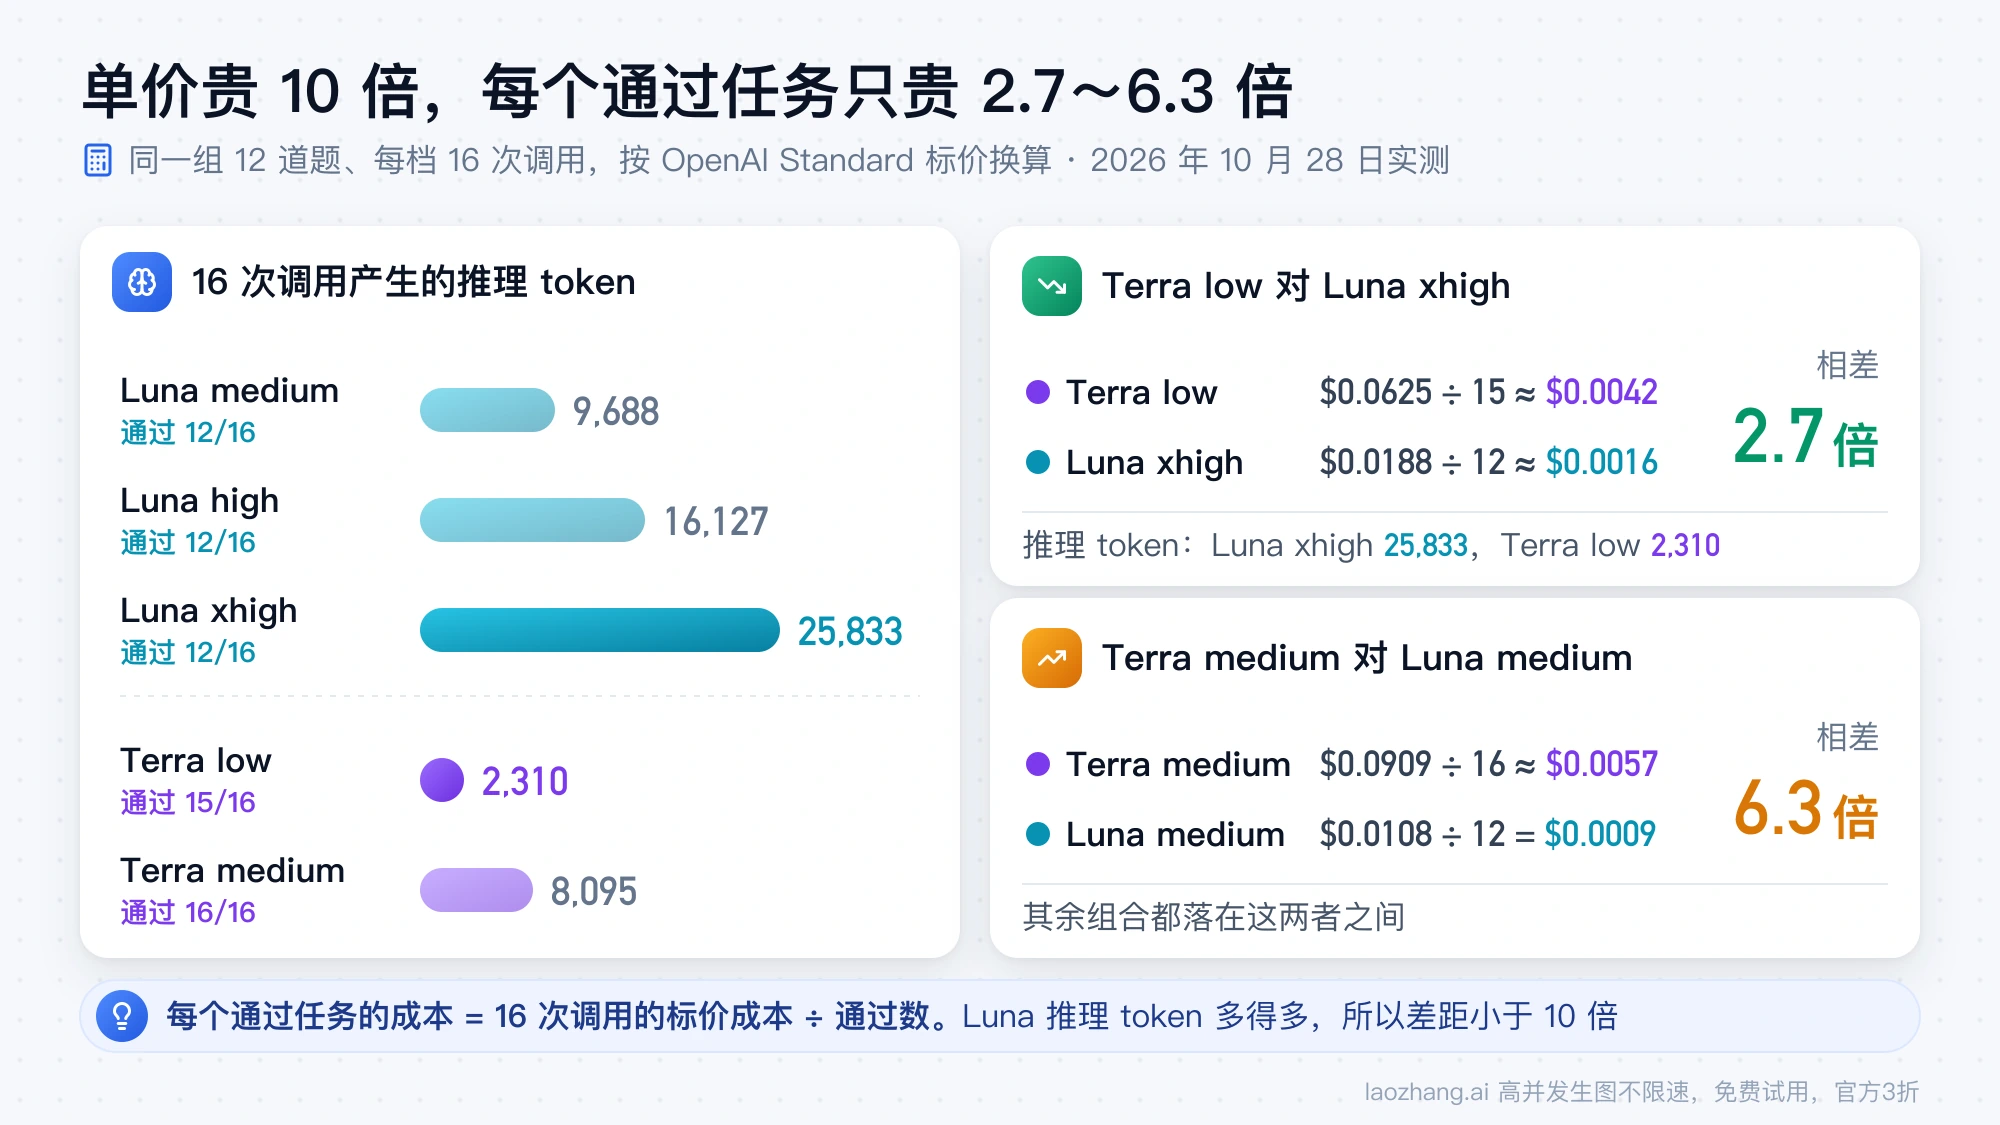
每个通过任务的成本 = 16 次调用的标价成本 ÷ 通过数。Terra low 是 $0.0625 ÷ 15 ≈ $0.0042,Luna xhigh 是 $0.0188 ÷ 12 ≈ $0.0016,相差 2.7 倍;Terra medium 是 $0.0909 ÷ 16 ≈ $0.0057,Luna medium 是 $0.0108 ÷ 12 = $0.0009,相差 6.3 倍,其余组合落在这两者之间。之所以低于 token 单价的 10 倍,是因为 Luna 用掉的推理 token 多得多:同样 16 次调用,Luna xhigh 产生了 25,833 个推理 token,Terra low 只有 2,310 个。耗时也是同一个原因。Artificial Analysis 测得 Luna 每秒输出 116~124 个 token,比 Terra 的 91 个快,但它答题前想得久,结果每次调用的中位耗时是 Terra 的 2~3 倍。
GPT-6 Luna 在哪出错:图里的字母 O 和 semver 规范细则
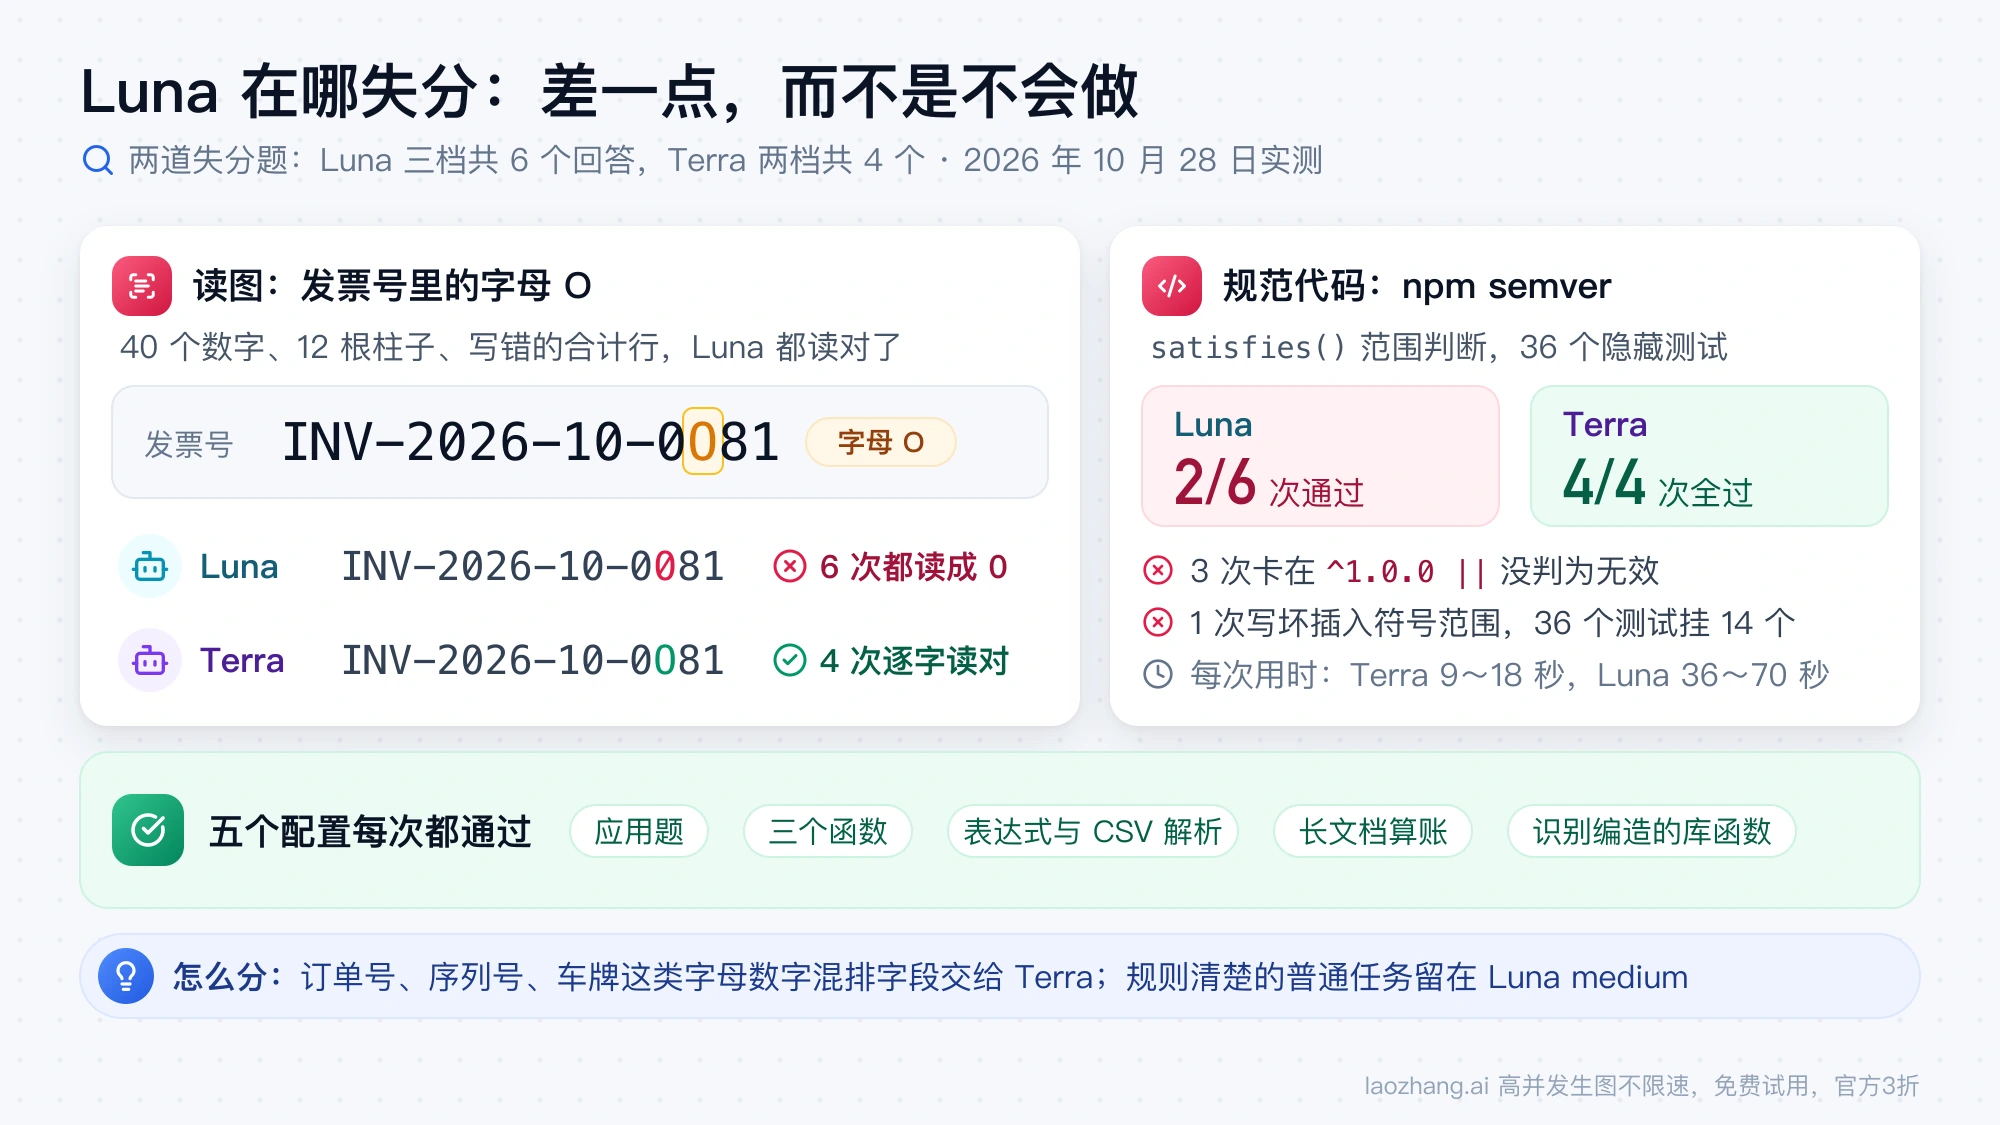
Luna 的失分集中在两道题上,而且都不是"不会做",而是差一点。第一道是发票加柱状图读成 JSON:Luna 的 6 个回答全部读对了 40 个数字,12 根柱子的高度都在 ±2 以内,也都找出了故意写错的那一行合计,但每一次都把发票号 INV-2026-10-0O81 里的字母 O 读成了数字 0;Terra 的 4 个回答全部逐字读对。这道题 Terra 每个回答用 8~17 秒、花 $0.0045~0.0139,Luna 用 24~54 秒、花 $0.0011~0.0025。如果你的抽取任务里有订单号、序列号、车牌这类字母数字混排的字段,一个字符读错就等于整条记录错,这正是 Terra 值得那几倍价钱的地方。
第二道是按 npm 规则实现 semver 范围判断。Luna 6 次只通过 2 次:3 次都卡在同一个隐藏测试上(^1.0.0 || 这种末尾多一个 || 的范围没有判为无效),1 次把插入符号范围整体写坏,36 个测试挂了 14 个;Terra 4 次全过,每次 9~18 秒,Luna 要 36~70 秒。规范越长、边界条件越多,Luna 越容易漏掉一条。
其余的错都只出现一次:Luna high 把"各位数字之和为 27 的六位以内整数个数"算成 67,252(正确答案 55,252);五条要点摘要那道题,Luna xhigh 和 Terra low 各写出一条 26 词的要点,超了 25 词的上限,这也是 Terra low 唯一的失分。应用题、三个函数、表达式和 CSV 解析器、带更正说明的长文档算账、编造的标准库函数识别,五个配置每次都通过。换句话说,在规则清楚的普通任务上,Luna 的 medium 已经和 Terra 一样可靠,而且便宜得多。
GPT-6.1 Terra 和 GPT-6 Luna 怎么选:先看 Luna 在你的任务上错不错
默认用 Luna medium,只把它答错的那部分任务交给 Terra,这是两者价格和实测结果共同指向的做法。判断一类任务该归谁,看三件事。第一,Luna 有没有在这类任务上稳定出错:读图里的易混字符、规则很多的规范代码、需要准确调用知识的问答(AA-Omniscience 上 Luna 是负分),出错就换 Terra;普通的摘要、改写、解析和有测试兜底的小函数,Luna 已经够用,每个通过任务便宜 2.7~6.3 倍。第二,错了之后先换模型,不先加档:Luna 从 medium 调到 xhigh 成本涨 74%,通过数不变,而 AA 上 Terra low 比 Luna max 高分又便宜。第三,速度要紧时偏向 Terra,同组题它每次调用快 2~3 倍,AA 上 low 档首个 token 1.29 秒,Luna low 是 2.43 秒。
拿自己的任务测一轮,比看任何分数都准。从最近的线上请求里挑 20~50 条有标准答案或能自动判对错的,分别用 Luna medium 和 Terra low 各跑一遍,记下每条是否通过和接口返回的 token 用量,再算"每个通过任务的成本 = 总成本 ÷ 通过数"。如果 Luna 的通过率和 Terra 一样,留在 Luna;如果 Luna 错的那些请求返工或人工复核的代价,超过 Terra 每条多出的成本(在这组题里是零点几美分),就把这类请求切到 Terra。
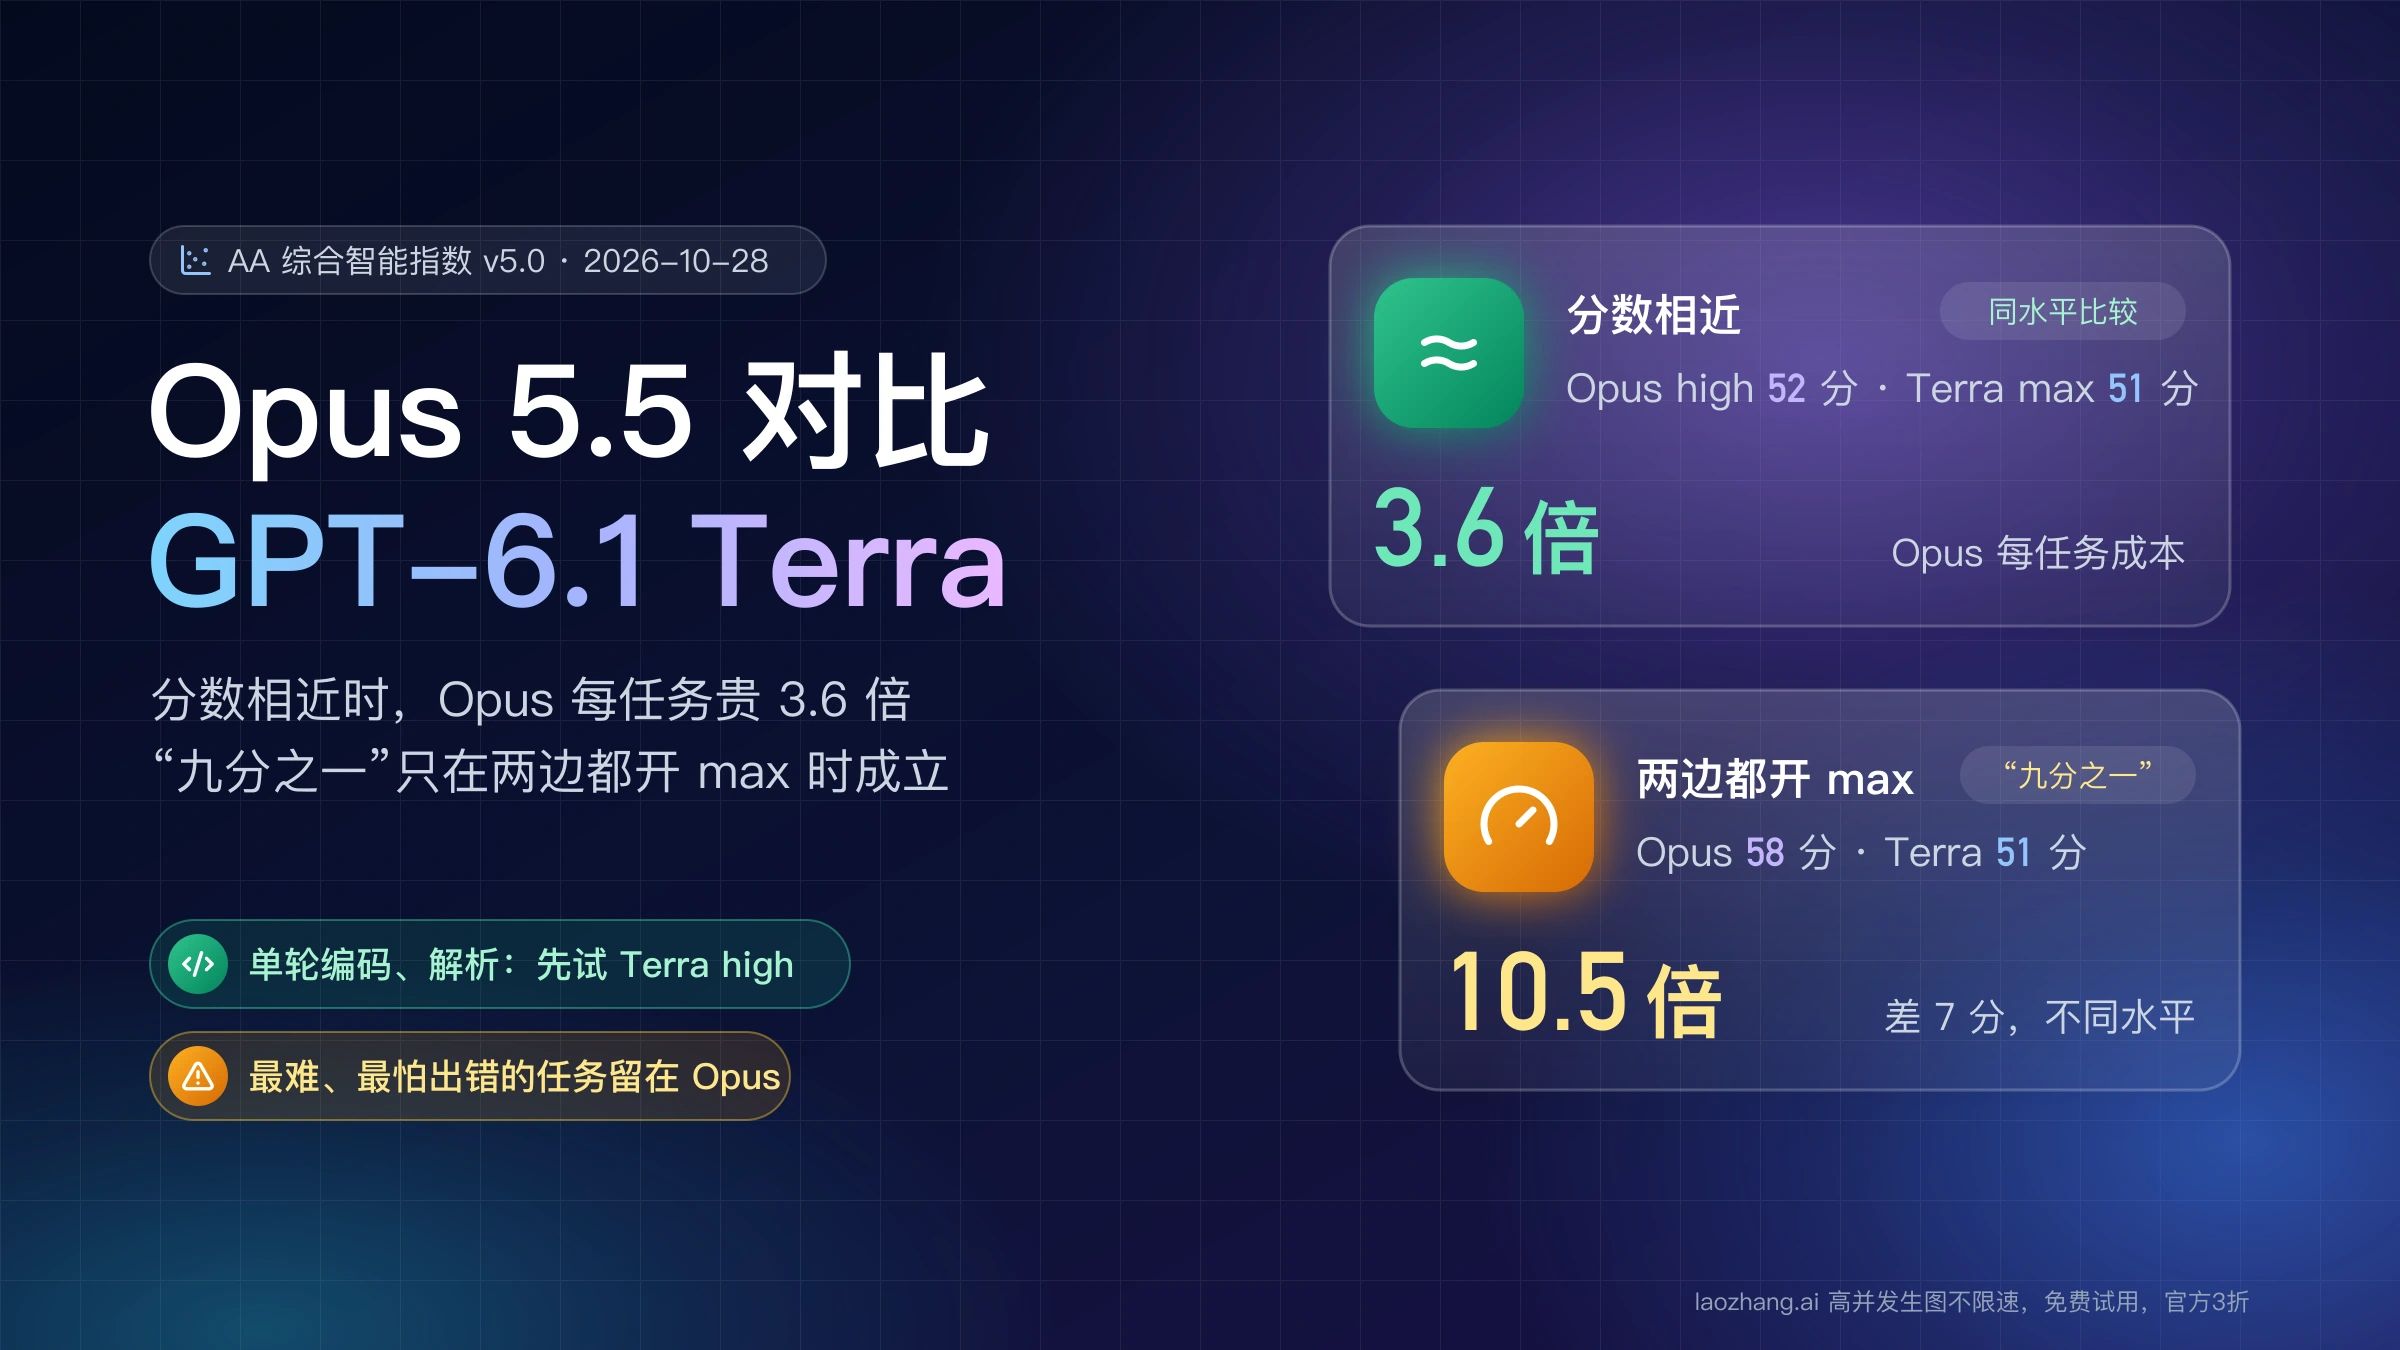
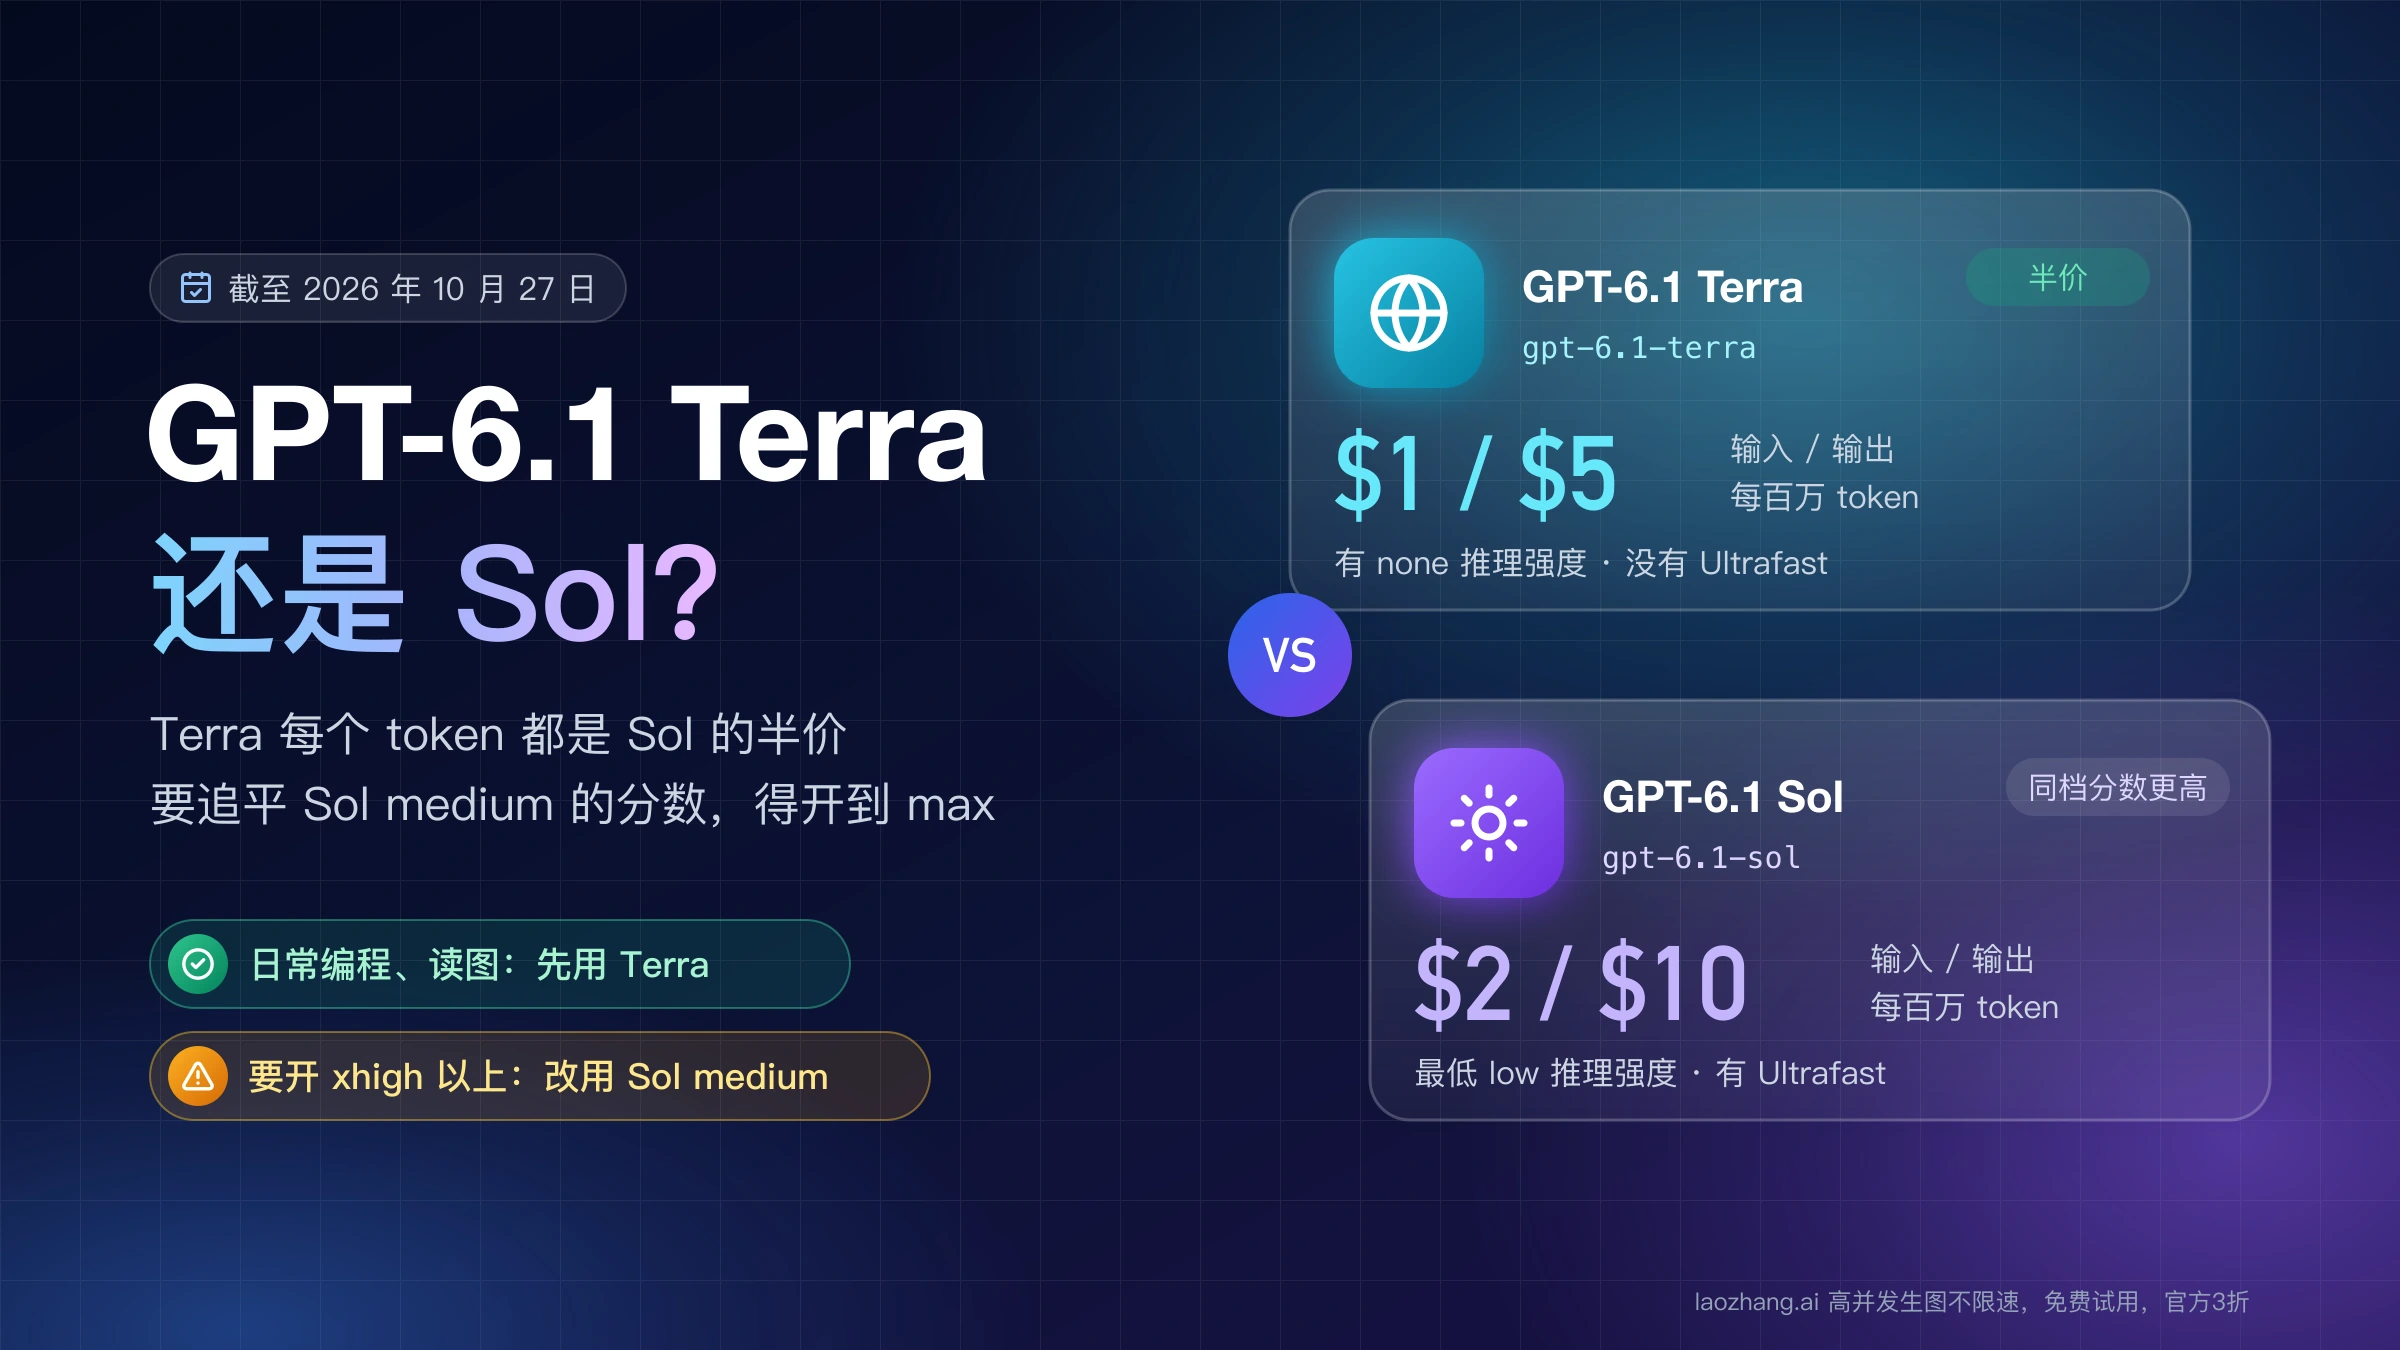
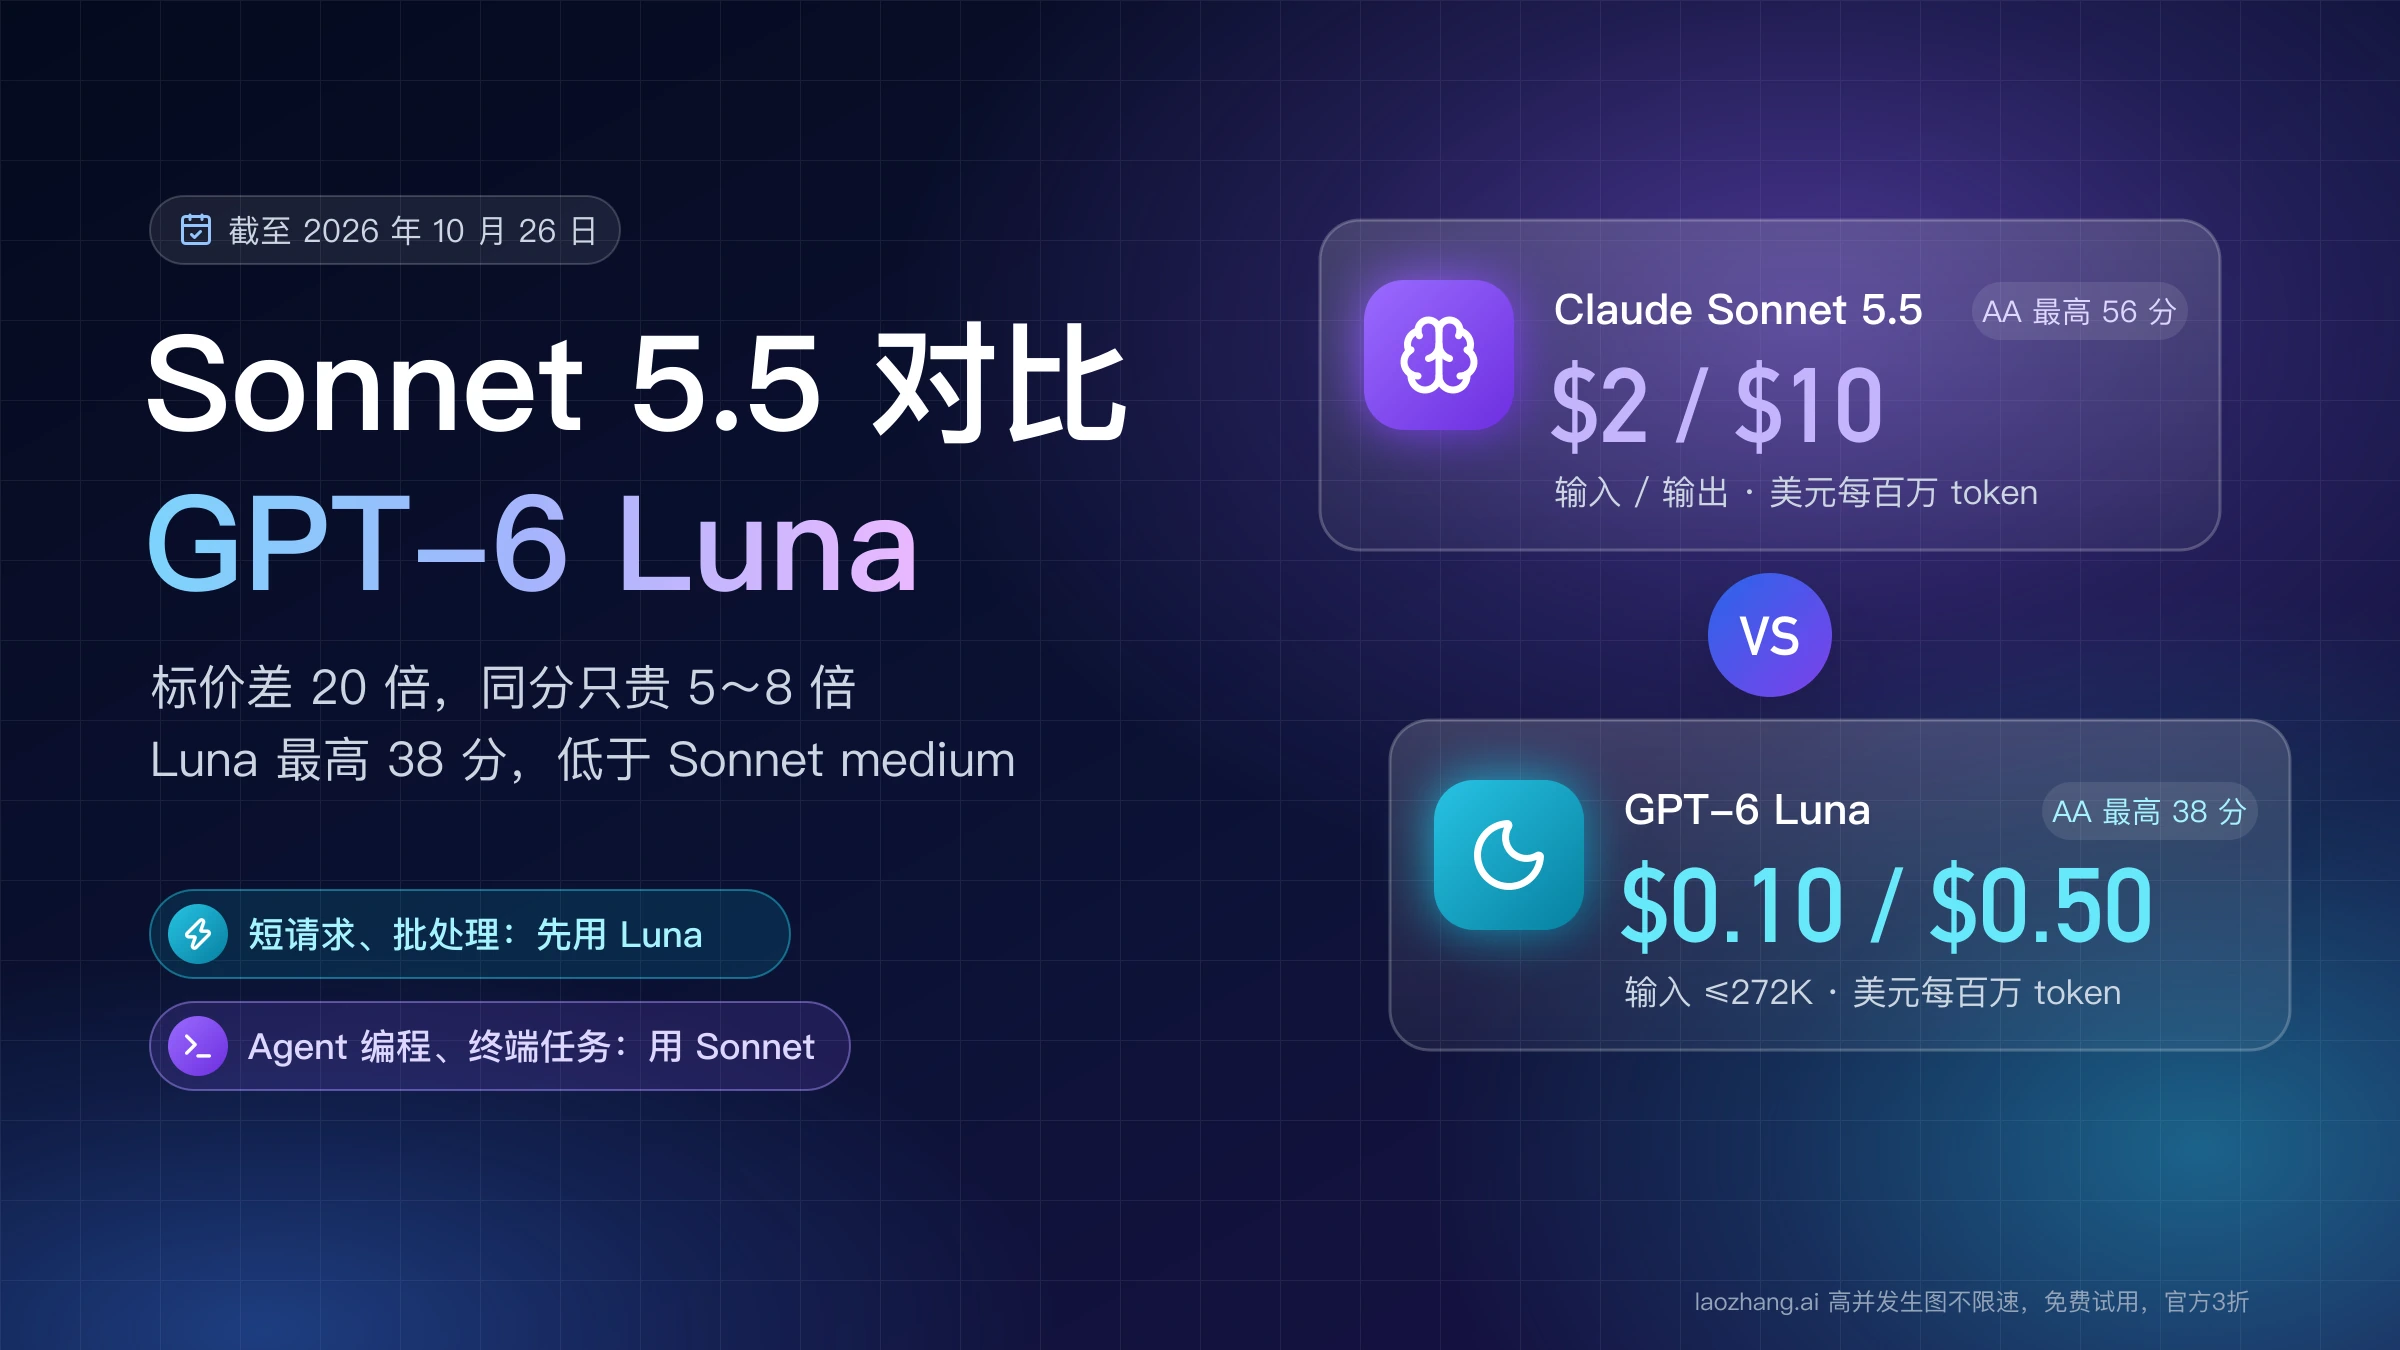
如果 Terra medium 也不够,下一步是 GPT-6.1 Sol,什么时候值得往上换,见 GPT-6.1 Terra 和 Sol 区别:Codex 实测用时减半,要高分时 Sol 更省;想把 Terra 和 Anthropic 的顶级模型比,看 Claude Opus 5.5 对比 GPT-6.1 Terra:同分时成本差 3.6 倍;Luna 对 Claude 中档模型,看 Claude Sonnet 5.5 对比 GPT-6 Luna:标价差 20 倍,同分差 5~8 倍。四款 GPT-6 型号放在一起怎么选、各自价格多少,看 GPT-6 Sol、Luna、Astra 与 Terra 怎么选?认清 6.1 Terra,再算成本。
从 gpt-6-luna 换到 gpt-6.1-terra:先改这几处请求参数
只把模型 ID 从 gpt-6-luna 改成 gpt-6.1-terra,大部分纯文本请求可以直接跑,但下面几处会报错或悄悄改变行为,换之前按顺序过一遍。其中 max 和 max_tokens 两条是 2026 年 10 月 28 日经同一个网关实际请求得到的结果,报错文本是 OpenAI 的格式;OpenAI 直连没有单独测。
- 在请求里显式写出推理强度。两款默认都是
medium,Terra 建议从low起步,不够再升medium,不要沿用你给 Luna 调高过的xhigh。 - 把
max_tokens换成max_completion_tokens。非流式请求带max_tokens时两款都返回 400,提示改用max_completion_tokens。 - 要用
max,就把请求改到 Responses API。在 Chat Completions 上,reasoning_effort: "max"对两款模型都返回 HTTP 400,提示只支持none、low、medium、high、xhigh;流式请求时 Terra 有一次返回了 200、Luna 仍是 400,结果不一致,不要依赖。改到 Responses API 并写成"reasoning": {"effort": "max"}后,两款都返回 200。 - 有工具调用的代码同样改到 Responses API。Terra 的工具调用只能在 Responses API 上用;如果你的 Luna 代码是在 Chat Completions 上把
reasoning_effort设成none来做函数调用,换成 Terra 后这条路不通。 - 核对数据驻留地区。按 OpenAI 的数据控制文档,GPT-6.1 Terra 只支持美国和欧盟的数据驻留,Luna 支持的地区更多。数据驻留地区设在美国、欧盟以外(如日本、韩国、印度、新加坡)的项目可以继续用 Luna,但换不了 Terra;这些地区只保证数据存放在当地,不保证推理在当地进行。某个具体地区 Luna 是否支持,以该页的模型表为准。
第 3 步改完的最小请求长这样:
{
  "model": "gpt-6.1-terra",
  "reasoning": { "effort": "max" },
  "input": "你的任务"
}
ChatGPT 和 Codex 里的 Terra 与 Luna:聊天里没有 Terra
在 ChatGPT 的普通聊天里选不到 GPT-6.1 Terra。按 ChatGPT 的模型说明,Terra 只出现在 Plus、Pro、Business、Enterprise 和 Edu 套餐的 Work 和 Codex 里,任何套餐的聊天里都没有;而截至 2026 年 10 月 8 日,免费版和 Go 的 GPT-6 聊天跑的是 Luna,付费套餐聊天用的是 GPT-6 Sol,详见 GPT-6 免费吗?ChatGPT 免费版给的是 Luna,Sol 与 Astra 仍要付费。Luna 在 Work 和 Codex 里也能选。截至 2026 年 10 月 27 日的模型说明里,Luna 支持 Codex IDE 扩展,Terra 的客户端列表里没有它;在 Codex CLI 里用 Terra 需要 0.159.0 或更高版本,命令是 codex -m gpt-6.1-terra。
额度上两者差得和 API 单价差不多。按 ChatGPT 的价格与额度说明,截至 2026 年 10 月 28 日,Plus 和标准 Business 每 5 小时的本地消息估计是 Luna 350~3,000 条、Terra 35~285 条,官方说明这只是估计,会随任务大小、上下文和推理强度变化,不是固定条数;Pro 没有 5 小时限制,但可能有每周限制。用 ChatGPT Credits 计费时,每百万 token 的输入 / 缓存输入 / 输出 Luna 是 2.5 / 0.25 / 12.5 credits,Terra 是 25 / 1.25 / 125 credits。所以在 Codex 里,同样的额度换成 Terra,能做的事大约少一个数量级,只把 Luna 做不好的任务交给它更划算。
GPT-6.1 Terra 和 GPT-6 Luna 的其他问题
有 GPT-6.1 Luna 吗?
截至 2026 年 10 月 28 日没有。OpenAI 定价页的旗舰模型表只列 GPT-6 Astra、GPT-6.1 Sol、GPT-6.1 Terra 和 GPT-6 Luna 四款,Luna 目前只有 gpt-6-luna 这一个版本(快照 gpt-6-luna-2026-09-22)。
GPT-6.1 Terra 把推理关掉,设成 none,会不会更省?
不会。按 Artificial Analysis 截至 2026 年 10 月 28 日的 Intelligence Index v5.0,Terra 的 none 档 30 分、每道题 $0.23、104 秒,low 档 29 分、$0.07、48 秒。关掉推理只多 1 分,每道题却贵 3 倍多、慢一倍,想省钱就用 low。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月28日。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月28日。
- 1.OpenAI 的 GPT-6.1 Terra 模型页developers.openai.com/api/docs/models/gpt-6.1-terra
- 2.GPT-6 Luna 模型页developers.openai.com/api/docs/models/gpt-6-luna
- 3.OpenAI API 定价页developers.openai.com/api/docs/pricing
- 4.Artificial Analysis 的 GPT-6.1 Terra 与 GPT-6 Luna 对比页artificialanalysis.ai/models/releases/comparisons/gpt-6-1-terra-vs-gpt-6-luna
- 5.OpenAI 的数据控制文档developers.openai.com/api/docs/guides/your-data
- 6.ChatGPT 的模型说明learn.chatgpt.com/docs/models
- 7.ChatGPT 的价格与额度说明learn.chatgpt.com/docs/pricing