Claude Fable 5.2 和 GPT-6.2 Sol 对比:同题实测成本差 6.5–12 倍
Sol 单价是 Fable 5.2 的四分之一,同题两边全对,Fable 贵 6.5–12 倍;Sol 开到 max 只追平 Fable medium,high 以上先别换。
文章目录
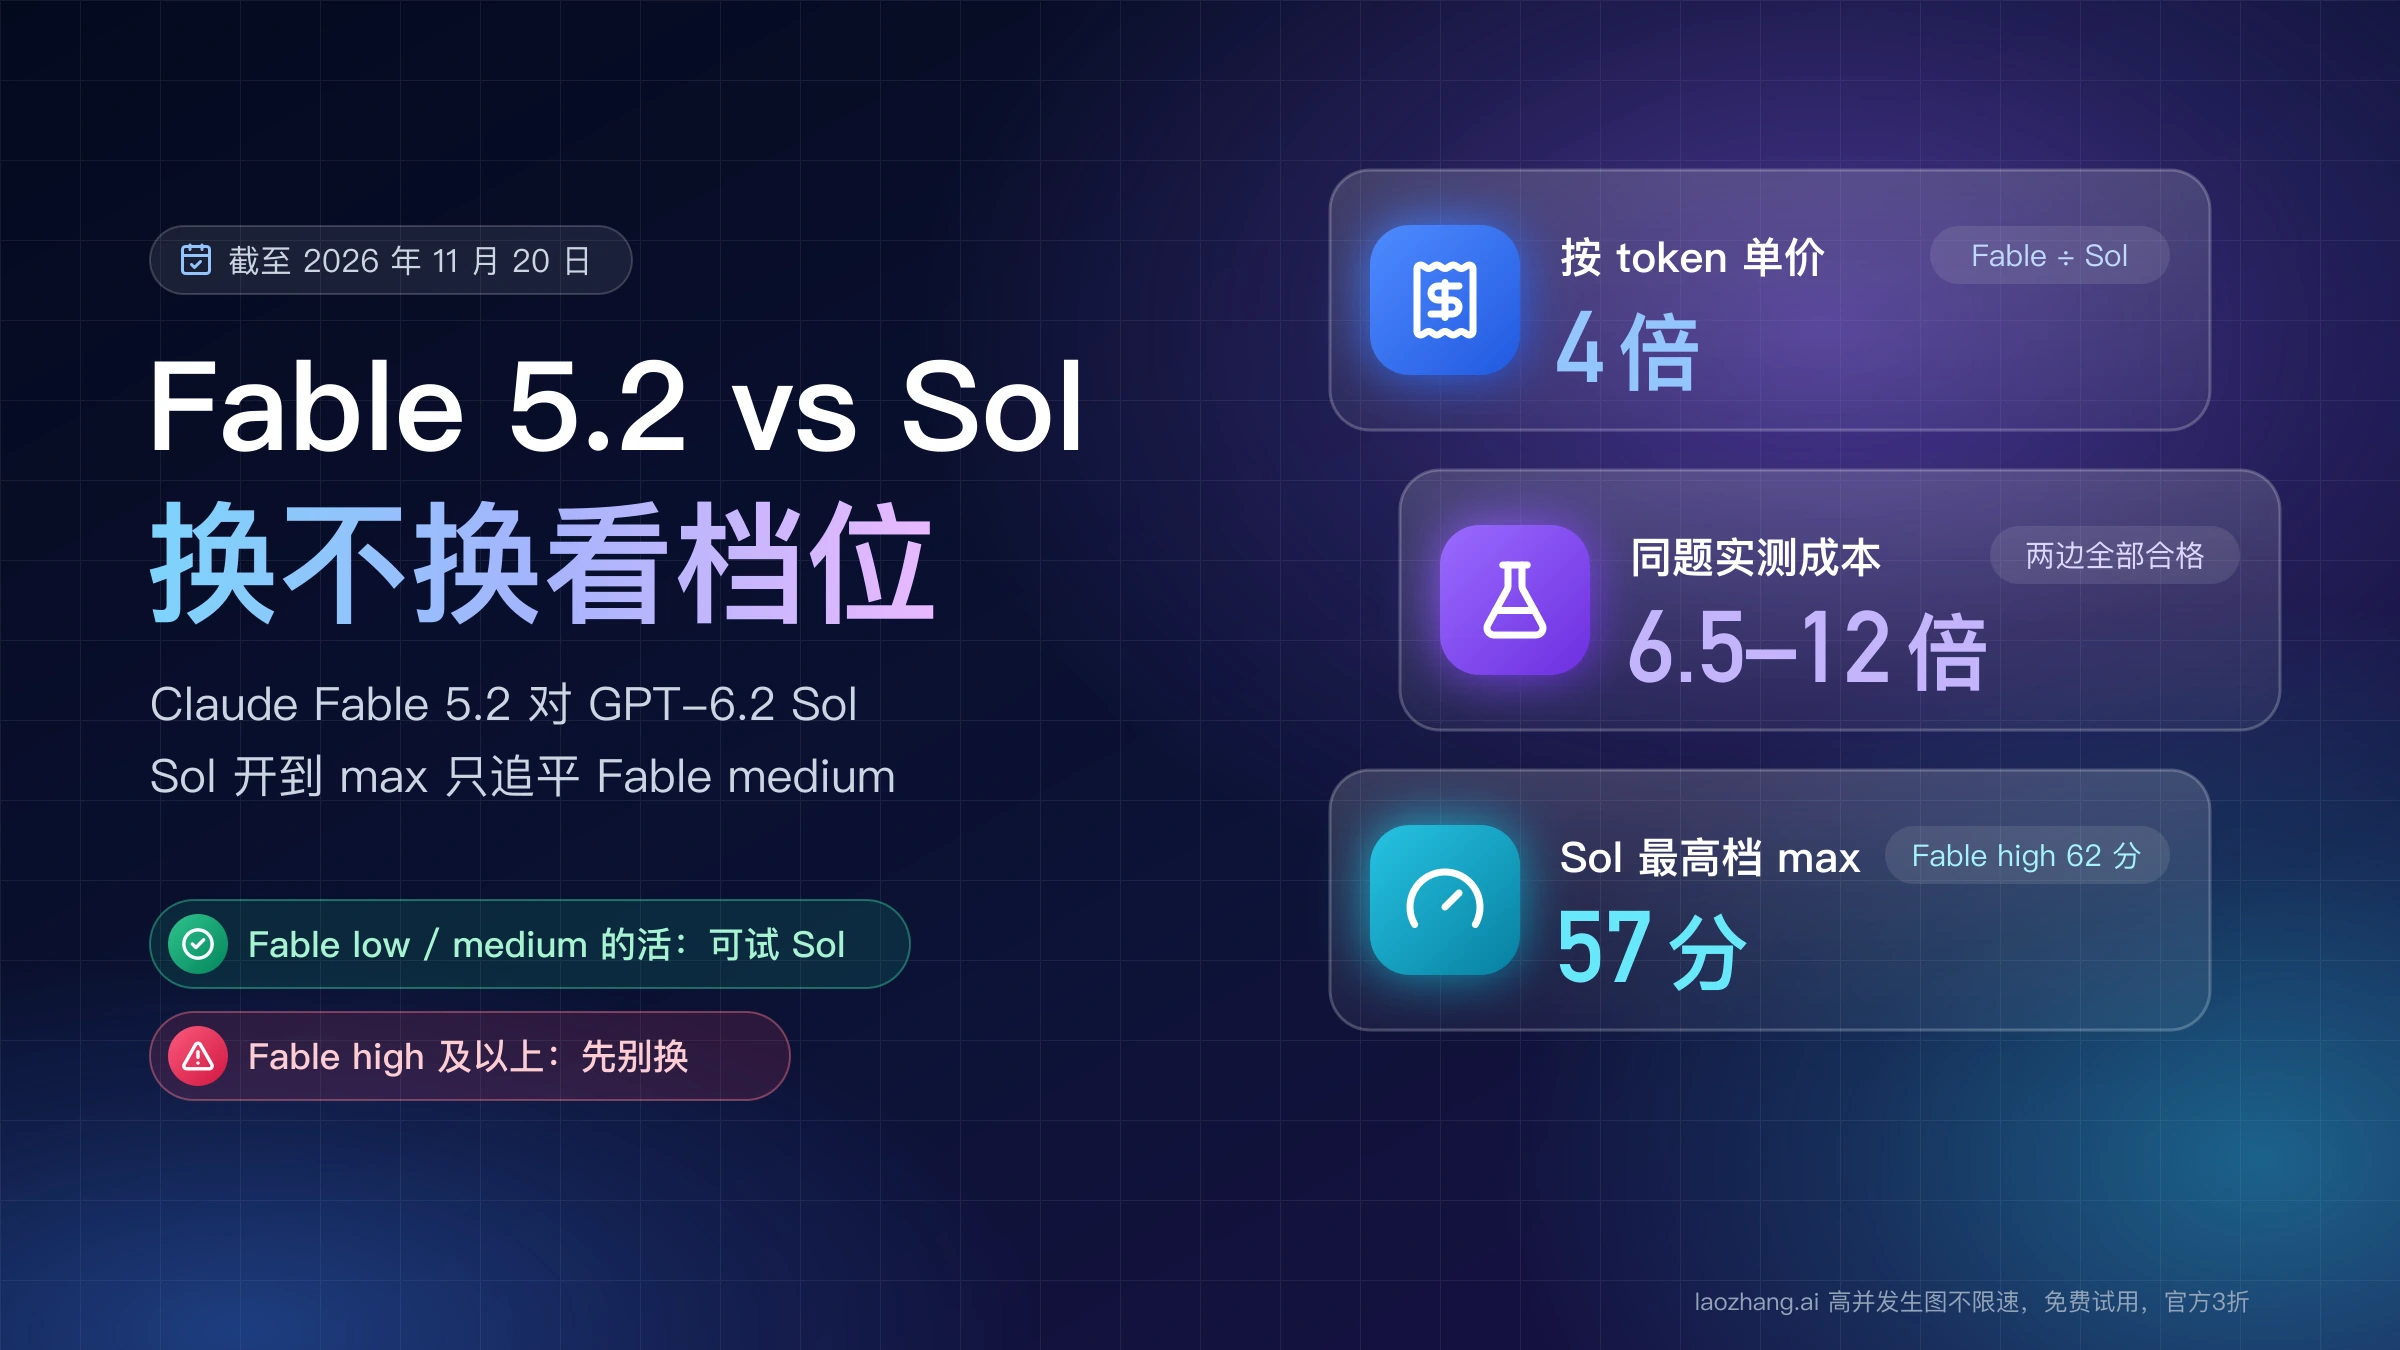
GPT-6.2 Sol 能接走 Claude Fable 5.2 的一大块工作,但接不走最难的那一档。按截至 2026 年 11 月 20 日的 Artificial Analysis 智能指数 Fable 5.2 与 GPT-6.2 Sol 对比页(v5.0.1,以下简称 AA),Sol 开到最高的 max 是 57 分,只比 Fable medium 的 56 分高 1 分,每道题成本 $1.01 对 $3.80;Fable high 是 62 分,Sol 没有任何一档够得到。成本差距比单价表看上去大:按 token 算 Fable 是 Sol 的 4 倍,而 2026 年 11 月 10 日至 20 日用同一批题跑的四组实测里,两款模型的答案全部合格,Fable 每组题的花费是 Sol 的 6.5–12 倍。实测量出来的只有钱、token 和时间的差别,质量差距目前只来自 AA 和 OpenAI 自己的评测图表。
所以换不换,要看你的 Fable 现在开在哪一档。用 Fable low 或 medium 的活(Claude Code 默认就是 medium),拿同一批题在 gpt-6.2-sol 的 xhigh 上跑一遍,AA 上两者同为 56 分,Sol 的成本只有 17%;用 Fable high 及以上、而且是因为低档做不好才开上去的活,先留在 Fable。最后拍板看你自己的通过率:两边跑同一批题,按每个合格结果算成本。
有几种情况在比质量之前就替你选好了。组织开了零数据保留,Fable 会直接返回 400;代码里要强制 tool_choice,Fable 也不接受;想在 ChatGPT 普通聊天里用 Sol 则用不到,它只在 ChatGPT Work 和 Codex 里。另外,单次输入超过 272K token 时 Sol 整次请求改按每百万 $4 输入、$15 输出计费,单价差会缩到 2–2.67 倍,这类请求要单独算账。
Sol 哪一档对应 Fable 哪一档:max 只追平 Fable medium
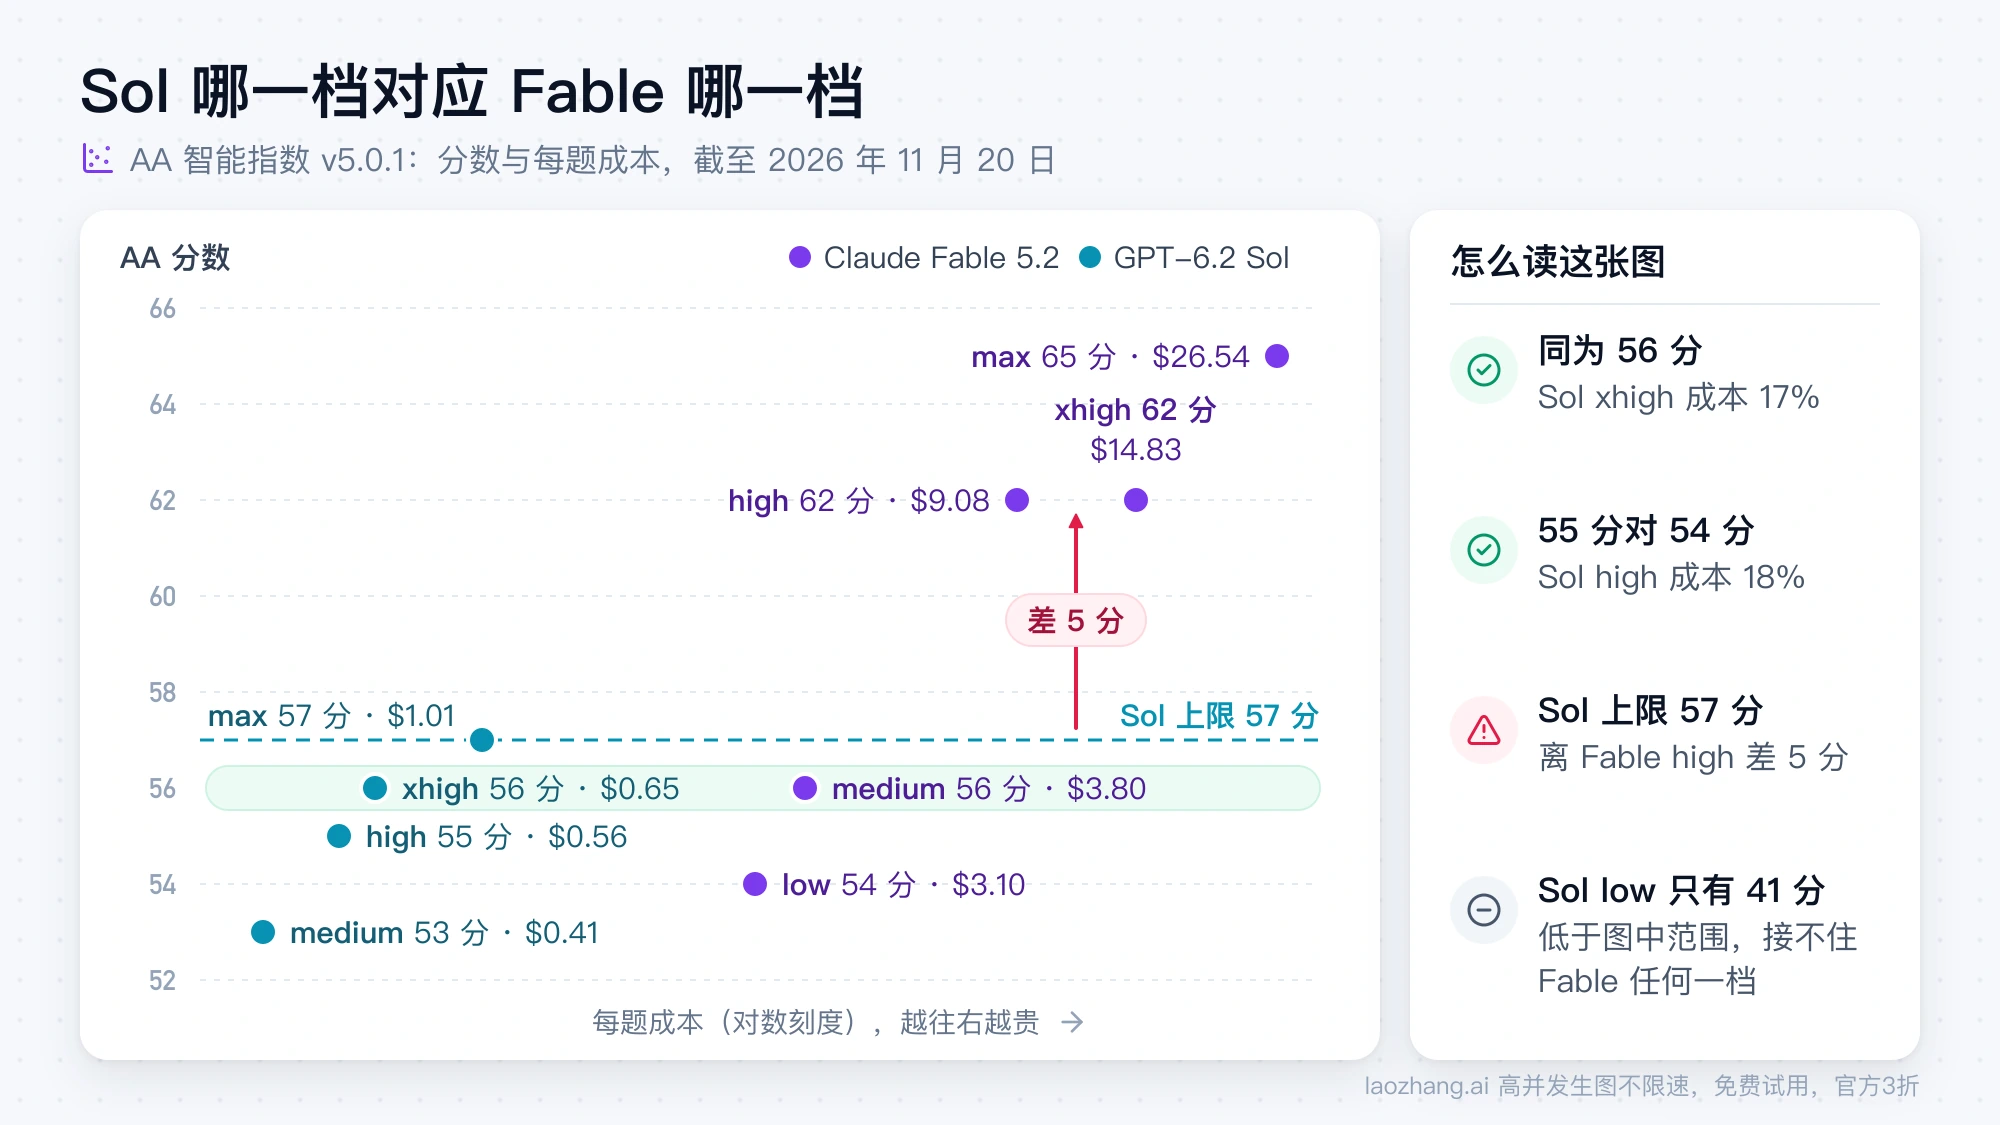
按 AA 智能指数同分对档,截至 2026 年 11 月 20 日,Sol xhigh(56 分,每题 $0.65)对应 Fable medium(56 分,$3.80),Sol high(55 分,$0.56)对应 Fable low(54 分,$3.10),成本都不到 Fable 的五分之一;Fable high、xhigh、max 的 62–65 分在 Sol 那边没有对应档,Sol 的上限 57 分离 Fable high 还差 5 分。下表的分数和每题成本取自 AA 对比页,成本占比是用表里两列相除得到的。
| 你现在用的 Fable 5.2 档位 | AA 分数 / 每题成本 | 换成 GPT-6.2 Sol 的哪一档 | Sol 分数 / 每题成本 | Sol 成本是 Fable 的 |
|---|---|---|---|---|
max | 65 / $26.54 | 没有同分档,最接近的 max 低 8 分 | 57 / $1.01 | 3.8% |
xhigh | 62 / $14.83 | 没有同分档,最接近的 max 低 5 分 | 57 / $1.01 | 6.8% |
high(Claude API 默认) | 62 / $9.08 | 没有同分档,最接近的 max 低 5 分 | 57 / $1.01 | 11% |
medium(Claude Code 默认) | 56 / $3.80 | xhigh;要多 1 分用 max | 56 / $0.65;57 / $1.01 | 17%;27% |
low | 54 / $3.10 | high;少 1 分可用 medium | 55 / $0.56;53 / $0.41 | 18%;13% |
先确认你说的"默认"是哪一个,三处含义不同。按 Claude 推理强度文档,Fable 5.2 在 Claude API 上不传 effort 时是 high,在 Claude 应用和 Claude Code 里默认是 medium;按 GPT-6.2 Sol 模型页,Sol 不传时是 medium,2026 年 11 月 18 日的接入实测返回的也是这一档。所以只改模型名、不动 effort,从 Claude Code 的 Fable 换到 Sol 的默认档,AA 分数会从 56 降到 53;要对上 Fable medium,得把 Sol 显式开到 xhigh。直接调 Claude API、从没设过 effort 的人,用的其实是表里第三行的 Fable high。
"同为 56 分"是取整后的结果。OpenAI 在 GPT-6.2 Astra 与 Sol 发布页里画了同一个指数的未取整值:Fable medium 56.4,Sol xhigh 55.7,Sol max 57.3,Fable high 61.8。要求严格不低于 Fable medium 时选 Sol max,成本仍只有 27%。
同分对档在专业领域题目上不成立。AA 的领域分项里,Fable medium 在财务会计、战略运营、法律三项分别是 60、62、58 分,Sol 开到 max 也只有 57、59、55 分,低 3 分;和它总分相同的 Sol xhigh 是 55、58、53 分,低 4–5 分。Sol high 对 Fable low 也一样,低 3–6 分。所以财务、法律、战略分析这类工作,即使 Fable 只开在 medium,换之前也要多拿几道题对照。Sol low 只有 41 分,比它自己的 medium 低 12 分,接不住 Fable 的任何一档。AA 指数是 9 项评测上的档位排名,能告诉你从哪一档开始试,不能替你预测自己工作上的通过率。
比质量之前先排除:这几种情况已经替你选好了
下面这些条件和分数无关,命中任何一条,选择就已经定了,不必再比通过率。Fable 5.2 的条件来自 Fable 5.2 迁移指南和 Claude 模型文档,Sol 的条件来自 GPT-6.2 Sol 模型页和 2026 年 11 月 18 日的接入实测。
- 你的组织在 Anthropic 开了零数据保留(ZDR)。Fable 5.2 要求 30 天数据保留,没有单独授权的零数据保留组织调用会收到 400,这部分工作用不了 Fable。
- 代码用
tool_choice强制模型调用工具(any或指定某个工具)。Fable 5.2 对这种请求返回 400,要么改成让模型自行决定是否调用,要么换模型。 - 任务属于高风险网络安全或研究型生物学。Fable 的安全分类器会把这类请求的大部分转给更早的模型处理,你调用的是 Fable,回答的却不是 Fable 5.2。
- OpenAI 侧的旧代码里写着
reasoning_effort: "none"。Sol 最低一档是low,2026 年 11 月 18 日通过 API 发none,返回 400:"Unsupported value: 'none' is not supported with the 'gpt-6.2-sol' model…"。 - 你的调用走 Chat Completions。同一天的实测里,Chat Completions 的
reasoning_effort从low到xhigh都能用,max必须走 Responses API;按 OpenAI 的说明,Sol 的工具调用也要求 Responses API。
GPT-6.2 Sol 便宜多少:按 token 4 倍,按任务 9–26 倍
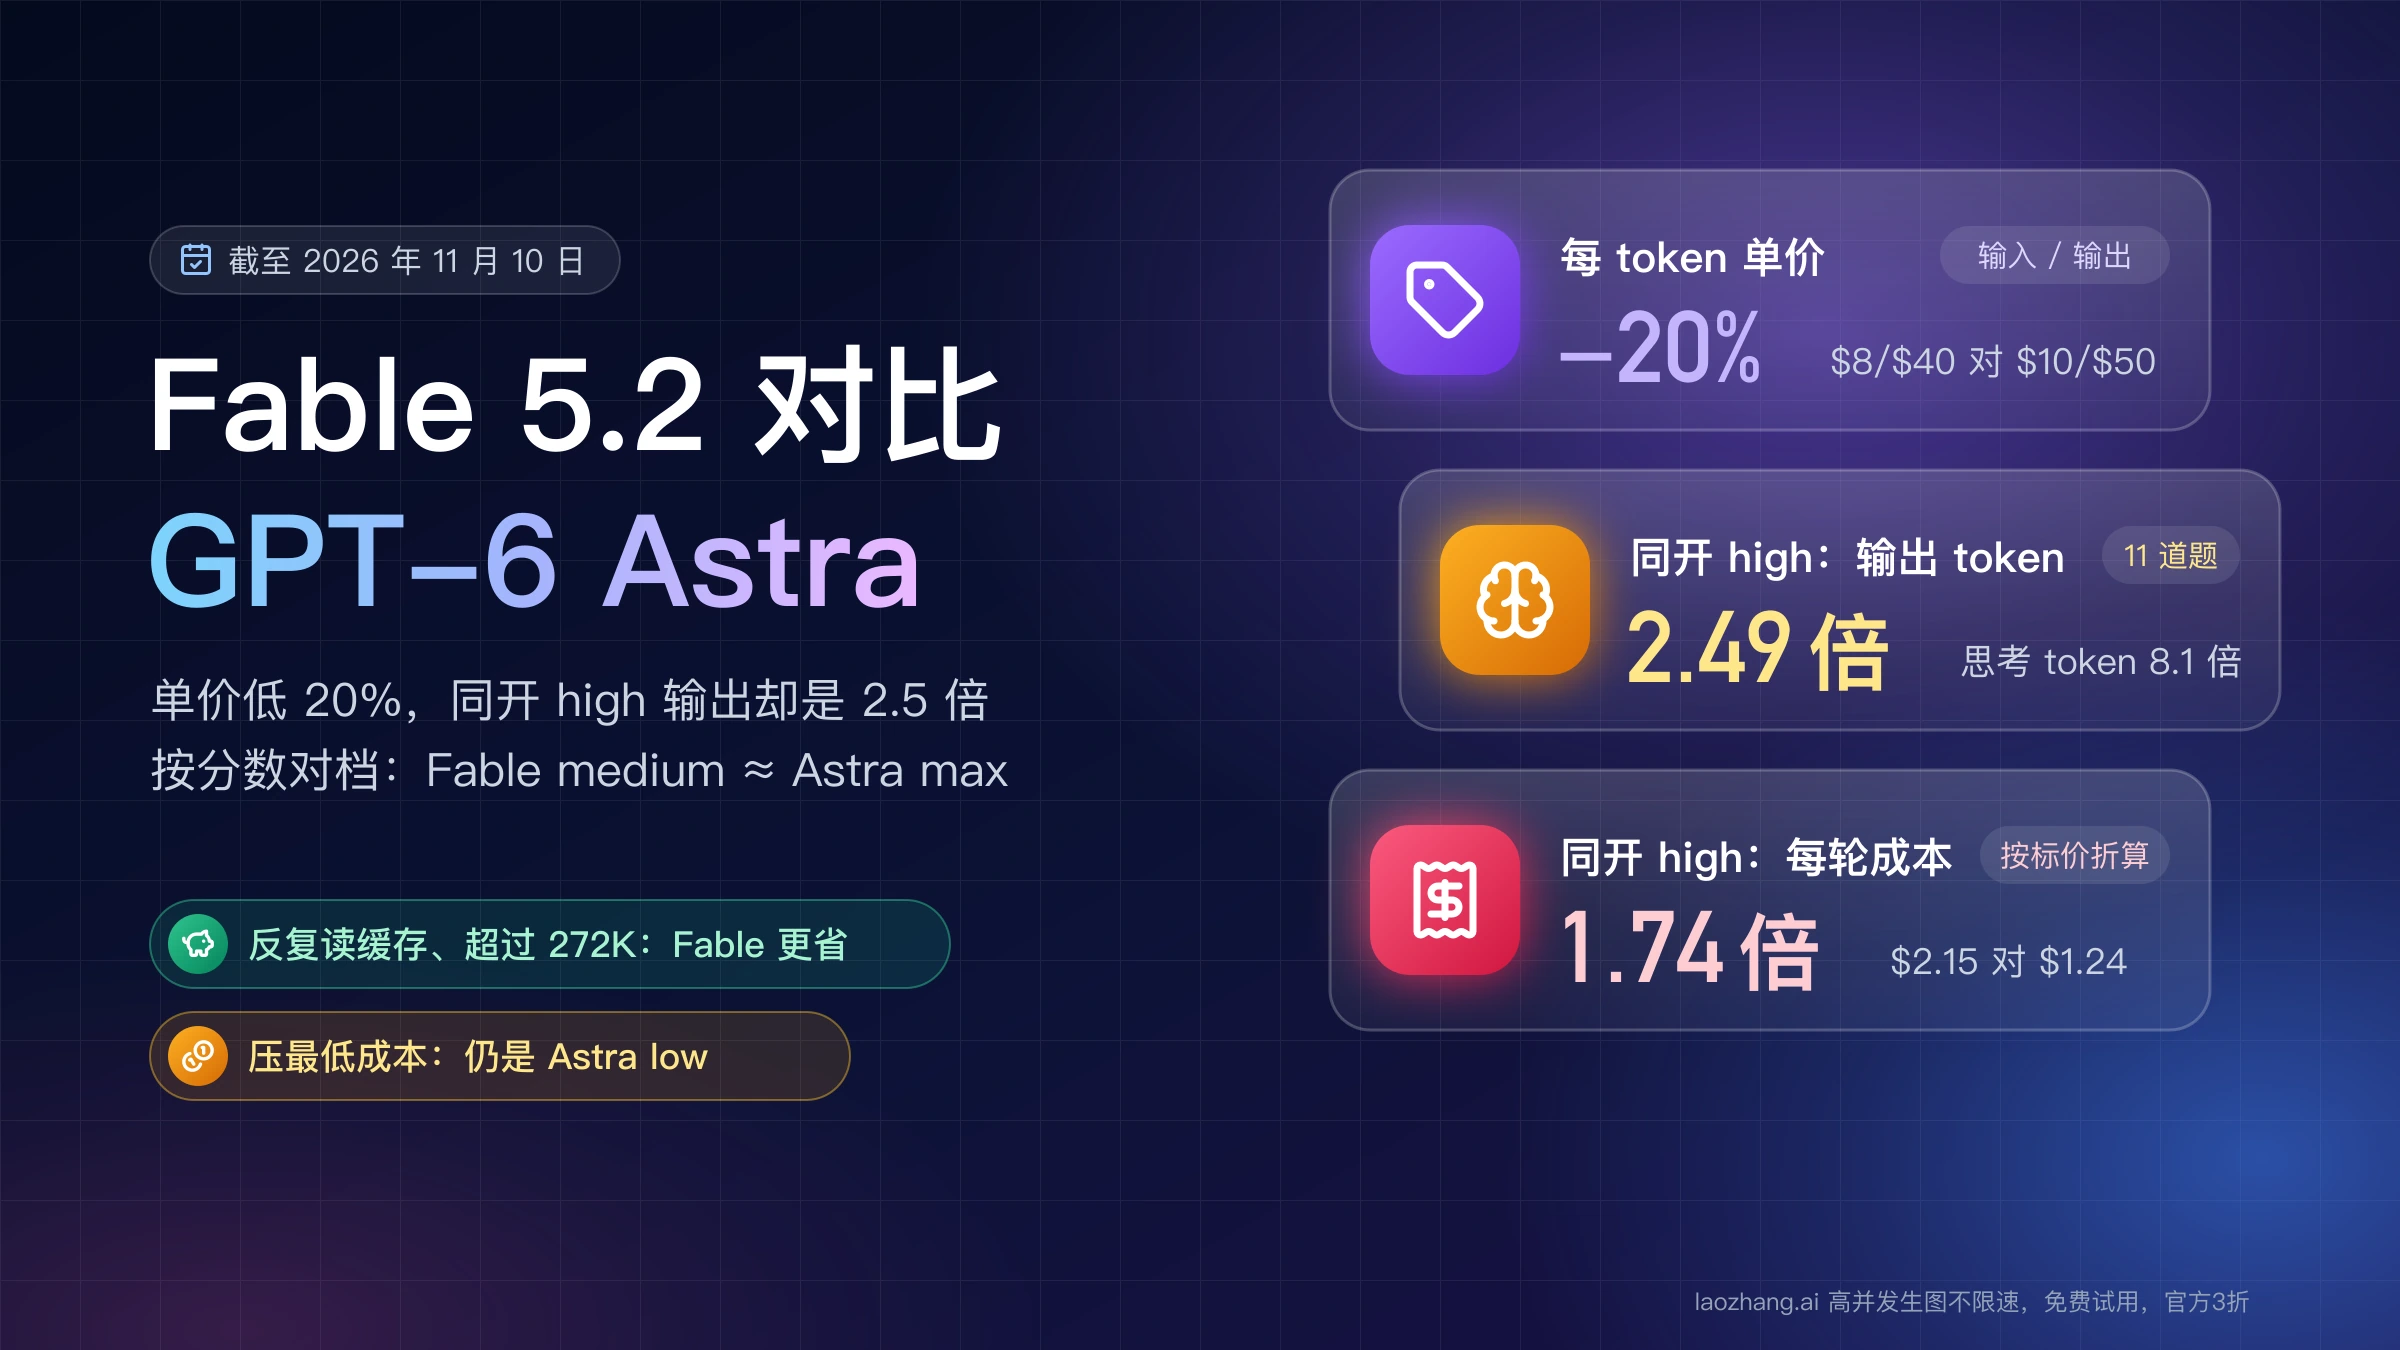
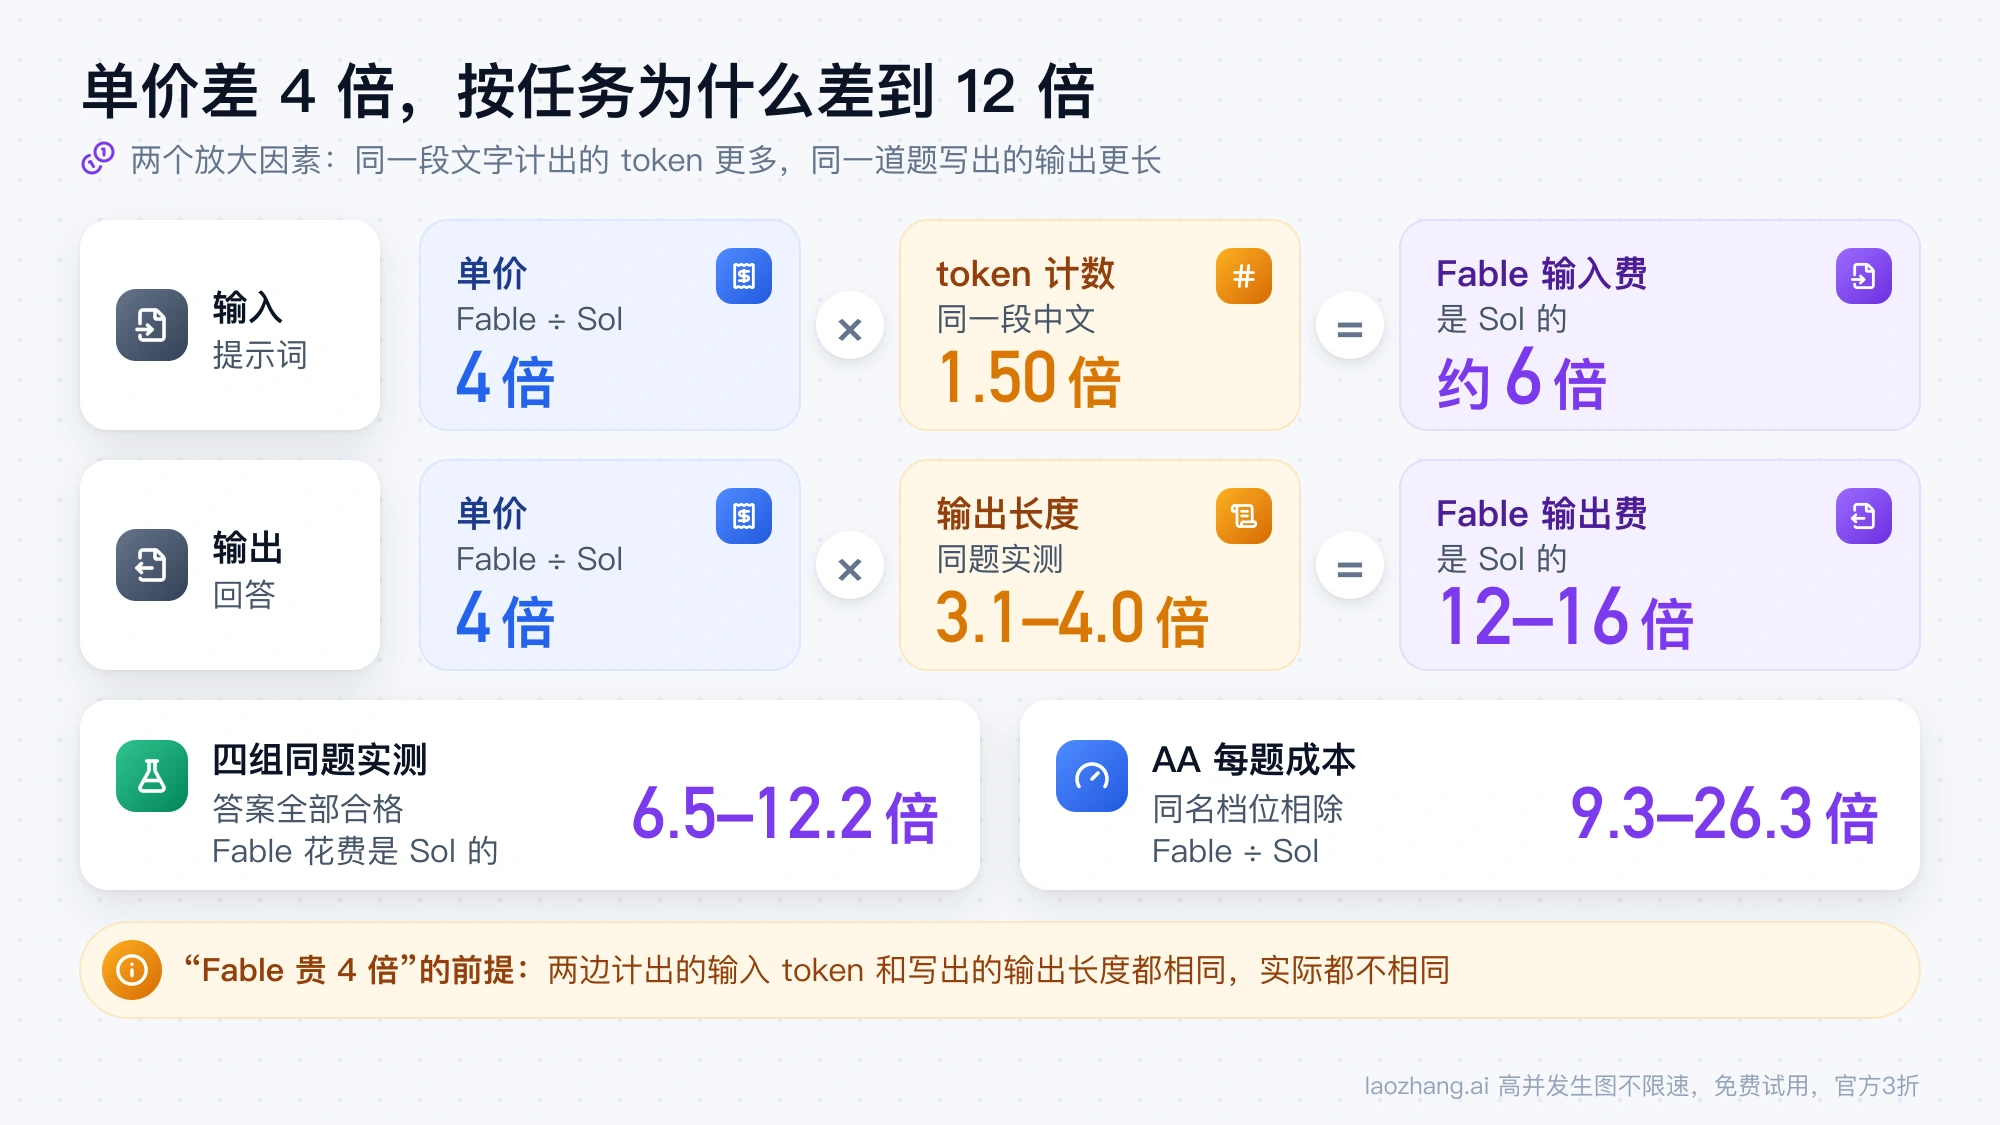
只看单价,Fable 5.2 的输入和输出都正好是 GPT-6.2 Sol 的 4 倍;按任务算,AA 同名档位之间差 9.3–26.3 倍。差距被放大有两个原因:同一段文字 Fable 计出的 token 更多,同一道题 Fable 写出的输出也多三到四倍。下表价格截至 2026 年 11 月 18 日,来自 OpenAI API 定价页和 Claude API 定价页,单位是美元 / 每百万 token,Standard 档。
| 计价项 | Claude Fable 5.2 | GPT-6.2 Sol | Fable 是 Sol 的 |
|---|---|---|---|
| 输入 | $8 | $2 | 4 倍 |
| 输出 | $40 | $10 | 4 倍 |
| 缓存命中 | $0.20 | $0.10 | 2 倍 |
| 缓存写入 | $10(5 分钟)/ $16(1 小时) | $2.50(30 分钟)/ $5(12 小时) | 时长不同,不直接比 |
| Batch 输入 / 输出 | $4 / $20 | $1 / $5 | 4 倍 |
| 加速档输入 / 输出 | fast 模式 $16 / $80 | Fast $4 / $20,Ultrafast $6 / $30 | 对 Fast 4 倍,对 Ultrafast 2.67 倍 |
| 单次输入超过 272K token | 不加价,仍是 $8 / $40 | 整次请求 $4 / $15,缓存命中 $0.20 | 输入 2 倍,输出 2.67 倍 |
Sol 的 Ultrafast 是 Standard 的 3 倍,这个价格执行到 2027 年 2 月 28 日,之后变成 6 倍,即 $12 / $60。Fable 的整个 100 万 token 上下文都按标准价计费,所以长上下文请求是两边差距最小的场景,但 Sol 的单价仍只有 Fable 的 37.5%–50%。
第一个放大因素是 token 计数。2026 年 11 月 18 日用同一段中文分别计数,Fable 5.2 计出的输入 token 是 GPT-6.2 Astra 的 1.50 倍(英文 1.45 倍);同一天 11 条相同提示词上,Sol 和 Astra 报告的输入总数完全一样(11,407),所以推断 Sol 与 Astra 计数相同,这个比例也适用于 Sol。实测里的直接对比也接近:同一份 146 KB 日志,Fable 计 78,537 个输入 token,Sol 计 55,843 个,是 1.41 倍。按 4 倍单价乘 1.50 倍 token,同一段中文提示词在 Fable 上的输入费约是 Sol 的 6 倍。
第二个因素是输出长度。下一节的实测里,Fable 写出的输出 token 是 Sol 的 3.1–4.0 倍,乘上 4 倍单价,输出费就是 12–16 倍,这和实测总成本的 12 倍基本对得上。AA 的每题成本反映的是同一件事:同名档位相除,max 26.3 倍($26.54 ÷ $1.01),xhigh 22.8 倍,high 16.2 倍,medium 9.3 倍,low 17.2 倍。按单价算出的"Fable 贵 4 倍",要求两边计出的输入 token 和写出的输出长度都相同,而实际这两样都不相同。
同一批题实测:两边全部做对,Fable 贵 6.5–12 倍
2026 年 11 月 10 日至 20 日,Fable 5.2 和 GPT-6.2 Sol 在四组相同的题目上各跑了一遍,所有答案全部合格。前三组比的是两边 API 的默认档(Fable high,Sol medium),第四组两边都开 high;Fable 的花费是 Sol 的 6.5–12.2 倍,用时是 1.1–5.4 倍。四组都没有分出质量高下,测出来的差别只有成本、token 和时间;文中关于"Fable 更强"的依据只来自 AA 和 OpenAI 的评测图表。
最有可能分出质量的是 11 月 20 日(UTC)新做的一组难题。8 道单轮题都带隐藏测试或唯一准确答案:会议空闲时段查找(37 项隐藏检查)、带优先级和短路运算的整数表达式解释器、处理夏令时跳变的排程器(包括豪勋爵岛 30 分钟夏令时和萨摩亚 2011 年跳过的一天)、支持花括号展开和 ** 的 glob 匹配、在 83 行带权 LRU/TTL 缓存里找出并修好两个 bug、满足 8 条互相牵制规则的 JSON 计划、数长度为 12 的合格字符串(答案 6503)、12 天库存模拟(答案 $130.10)。题目和隐藏测试在调用任何模型之前就已固定,每道题每种配置跑 2 次。结果 Fable 默认档、Fable medium、Sol 默认档、Sol high、Sol xhigh 全部 16/16。评分时发现 glob 题有一项隐藏测试检查了题面没写的规则,10 个答案都只错在这一项,这项测试被剔除;剔除前这道题的 10 个答案全部判为不合格,每种配置都一样,比较结论不变。
| 测试和日期 | Claude Fable 5.2 | GPT-6.2 Sol | 合格 | Fable ÷ Sol 成本 |
|---|---|---|---|---|
| 8 道难题、16 个答案,两边均为 11 月 20 日 | $3.6118,每次调用中位 25.8 秒 | $0.2971,7.3 秒 | 16/16 对 16/16 | 12.2 倍 |
| 8 道题、11 个答案,Fable 11 月 11 日,Sol 11 月 18 日 | $0.7436,合计 173.2 秒 | $0.0610,合计 56 秒 | 11/11 对 11/11 | 12.2 倍 |
| 146 KB 日志里的 7 个准确计数,日期同上 | $1.02,73.7 秒 | $0.1581,13.6 秒 | 全对 | 6.5 倍 |
11 题代理任务,Claude Code 对 Codex CLI,两边均开 high,Fable 11 月 10 日,Sol 11 月 20 日 | 每轮 $2.1545,221.8 秒 | 每轮 $0.184,中位 195 秒 | 22/22 对 33/33 | 11.7 倍 |
前三组通过 API 网关 laozhang.ai 调用,Fable 走 Messages 接口,Sol 走 Chat Completions,提示词、评分脚本完全相同;难题组只有一条用户消息,没有系统提示和工具。第四组是各家自己的编程 CLI:Sol 在 Codex CLI 0.166.0 里用 ChatGPT 订阅跑 3 轮,Fable 在 Claude Code 里跑 2 轮,金额是把 token 用量按 API 标价折算的,不是账单。Sol 每轮约 30 万输入 token,其中约 88% 命中缓存,按 Sol 的缓存价 $0.10 计;这组比的是"工具加模型",不只是模型。标着 11 月 10 日、11 日的 Fable 数据没有重跑,期间 Fable 的价格没有变化。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
换个档位比,差距会缩小但不会消失。难题组里把 Sol 开到 xhigh,推理 token 从 14,502 涨到 55,000,花费 $0.7008,结果没有任何变化,Fable 默认档仍是它的 5.15 倍;Fable 降到 medium 花 $1.7857,是 Sol xhigh 的 2.55 倍。按单题看,8 道难题 Sol 全部更便宜,Fable 默认档是 Sol 默认档的 9.2 倍(JSON 计划题)到 19.7 倍(表达式解释器)。8 道题那组里,Fable low 花 $0.4201,仍是 Sol 默认档的 6.9 倍。
这些测试的边界要说清楚。它们是单轮题和小型代理任务,每种配置只跑 1–3 次,没有覆盖跨多个文件、要跑几十分钟的长代理会话,也没有覆盖需求说不清、要模型自己判断何时停下来问人的场景。X 用户 kunchenguid 在 11 月 19 日的帖子里说,在真实项目上用了一整天,GPT-6.2 Astra 和 Sol 不能直接替代 Fable 5.2 和 Opus 5.5,问题出在什么时候该问用户、什么时候该直接动手的判断上;这是个人使用感受,没有测量,但它指向的正是上面四组题没覆盖的那类工作。你的活如果属于这一类,自测时一定要放进去。
OpenAI 的评测图表:medium 档 Sol 不输,最高档 Fable 领先
OpenAI 在 GPT-6.2 发布页的图表里也画了 Fable 5.2 的点。截至 2026 年 11 月 20 日,按图表数据标签读出的数值,medium 档上 Sol 在两项评测里高于 Fable、一项持平;开到 max,Fable 在三项里都领先 5.3–10.4 个百分点,Fable 的每题成本则是 Sol 的 17–32 倍。这些是厂商自报的结果,评测项目和测试框架都由 OpenAI 选择。
| 评测(OpenAI 公布) | medium:Fable / Sol | high:Fable / Sol | max:Fable / Sol | max 每题成本:Fable / Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 60.5% / 63.1% | 70.0% / 67.7% | 73.3% / 68.0% | $45.21 / $2.21 |
| BenchCAD 2.1 Core | 32.4% / 41.2% | 61.0% / 64.0% | 83.5% / 73.1% | $50.77 / $1.60 |
| AutomationBench 1.0.6 | 40.2% / 40.2% | 44.3% / 41.2% | 51.4% / 41.1% | $4.64 / $0.27 |
这个形状和 AA 的对档结论一致:Fable 的领先在 max 档最明显,medium 档两边差不多。low 档三项则都是 Fable 领先(53.8% 对 43.4%、26.9% 对 23.9%、39.7% 对 31.2%),和 Sol low 在 AA 上掉到 41 分对得上。Terminal-Bench-Science 上 Fable 的分数是 Artificial Analysis 用 mini-swe-agent 框架跑的,图表脚注写明 Anthropic 自己报告 Fable 5.2 在 Claude Code 里开 max 是 74.6%。
另外两张图只有一个 Fable 点。Agents' Last Exam v1.1 上 Fable max 72.8%,每题 $60.05,Sol max 73.0%,每题 $1.32,Sol high 72.0%;但发布页注明 Fable 的成绩剔除了 9 道改由备用模型完成的题,0.2 个百分点的差距只能算持平,不能当成 Sol 更强。Vals 科学指数 v1 上 Fable 63.7%(每题 $8.79),Sol 五个点里最高 58.5%($0.71),低 5.2 分。发布页上其余几项多是 Sol 和 GPT-6.2 Astra 或上一代 Sol 的比较;AA-3D 的 Elo 榜里 Fable 5.2 是 1,271,Sol 是 1,259。
谁更快:Sol 中低档快得多,开到 max 反而慢
GPT-6.2 Sol 在 medium 及以下比 Fable 5.2 的任何一档都快,但开到 max 去追分数时,它比 Fable medium 还慢。按 AA 截至 2026 年 11 月 20 日的数据,Sol medium 每题 3.5 分钟、3.6 秒出第一个回答 token,Fable 最快的 low 是 5.5 分钟、8.3 秒;Sol max 每题 9.6 分钟、83.9 秒出首字,而它对标的 Fable medium 是 6.5 分钟、11.2 秒。Sol xhigh 每题 5.9 分钟,总时长和 Fable medium 接近,只是首字要等 34.9 秒。
Fable 开到高档以后慢得明显:high 每题 15.2 分钟、首字 25.1 秒,max 是 42.0 分钟、262.5 秒。AA 对 Fable 的分钟数以前改过,这里的数字以 11 月 20 日为准。
实测的方向一样。难题组每次调用的中位用时,Fable 默认档 25.8 秒,Sol 默认档 7.3 秒;146 KB 日志 73.7 秒对 13.6 秒。差距最小的是编程 CLI 那组,Claude Code 里 Fable 221.8 秒,Codex 里 Sol 中位 195 秒,因为代理任务的时间大部分花在执行命令和读写文件上,不在模型生成上。两边都另有更贵的加速档,价格见前面的价格表;API 那三组的金额是按 Standard 标价算的。
ChatGPT 和 Claude 订阅里能不能用 Sol 和 Fable
在 ChatGPT 里,Sol 只在 Work 和 Codex 里能选。按 OpenAI 帮助中心关于 GPT-6 及 ChatGPT 中其他模型的说明,GPT-6.2 Astra 和 Sol 在 2026 年 11 月 17 日开始向 ChatGPT Work 和 Codex 推送,这次上线没有把两款模型加入普通聊天;发布页写明 Plus、Pro、Enterprise 和 Edu 用户可用,Sol 的 Ultrafast 只给 Pro $200 和 Pro $500。Work 和 Codex 里 6.2 Sol 的消息条数,OpenAI 没有公布。在 Codex 里用 codex -m gpt-6.2-sol 即可指定。
在 Claude 里,Fable 5.2 要看套餐。按 Claude 帮助中心的说明,Max、Ultra 以及 Team、Enterprise 的高级席位,Fable 系列计入周额度,最多占到一半;Pro 和 Team 标准席位用 Fable 要走按量付费的用量额度,11 月 9 日至 16 日发布周的包含额度已经结束。Claude Code 里的 Fable 默认开 medium。订阅里两边都按额度而不是按 token 计价,上面的 API 单价和每题成本不能直接搬来比较两个订阅哪个划算。
用自己的任务验证:同一批题两边跑,按合格结果算成本
AA 告诉你从哪一档开始试,最后能不能换要看你自己的通过率。下面的步骤按顺序做,重点是两边用同一批题、同一套判分,然后比"每个合格结果花多少钱",而不是比单价。
- 从最近的真实工作里挑一批题,每道都配上能自动判对错的检查,比如单元测试、准确数字或 JSON 校验。除了短而明确的题,一定放进几道长任务和需求不完整的任务,因为前一类两边大概率都能全对,分不出东西。Fable 还没接入的话,先看 Claude Fable 5.2 API Key 怎么获取:不用单独申请,调用与报错对照。
- 固定 Fable 现在用的档位,再按前面的对档表选 Sol 的起点:Fable
medium对 Solxhigh,Fablelow对 Solhigh;Fable 在high及以上的,也用 Solmax跑一遍,看差多少。两边都显式写上 effort,不要依赖默认值。 - 把调用改到 Sol 能完整工作的形态。要用工具或
max就走 Responses API;长的系统提示放进 input 的第一条 developer 消息,因为从 GPT-6.2 开始,顶层 instructions 会被追加在 input 之后,留在那里就吃不到提示缓存。 - 每种配置至少跑两遍,从返回的 usage 字段记下输入、输出和缓存命中 token,按各自单价算钱。同一段中文 Fable 会多计约 1.5 倍 token,所以用两边各自报告的数字,不要拿一边的 token 数套另一边的价格。
- 用"总花费 ÷ 合格结果数"比较。比如难题组里 Fable 默认档 $3.6118 ÷ 16 ≈ 每个合格结果 $0.226,Sol 默认档 $0.2971 ÷ 16 ≈ $0.019。Sol 有题不合格时,把重跑或人工返工的成本也算进去。
结果出来以后再分流。Sol 在起点档位就全部合格的活直接换过去;只在默认档失败的,先升到 xhigh 或 max 再下结论;升到 max 还过不了的留在 Fable。想留在 Claude 里降成本,下一步可以试 Opus 5.5,档位对照见 Fable 5.2 和 Opus 5.5 怎么选:哪档对哪档,同题实测贵 1.86 倍。
Fable 5.2 和 GPT-6.2 Sol 的其他问题
GPT-6.2 Sol Pro 是另一个模型吗?
不是。按截至 2026 年 11 月 20 日的 OpenAI 推理指南,GPT-5.6 和 GPT-6 系列模型在 Responses API 里支持 reasoning.mode 的 standard(默认)和 pro 两种模式,"Sol Pro"就是 gpt-6.2-sol 加上 "reasoning": {"mode": "pro"},模式和推理强度可以分别设置。OpenRouter 把它单独列成 openai/gpt-6.2-sol-pro,每 token 单价和 Sol 相同,并说明一次典型请求的花费是普通 Sol 的好几倍、耗时也长得多;OpenAI 的价格表里没有单独的 Sol Pro。AA 给 Sol 打的分都是 standard 模式。
Fable 5.2 应该和 GPT-6.2 Astra 比,还是和 Sol 比?
OpenAI 拿来对标 Fable 5.2 的是同一天发布的旗舰 GPT-6.2 Astra,想在同价位上比较,看 Fable 5.2 和 GPT-6 Astra 对比:GPT-6.2 Astra 同价,同题便宜七成;Sol 是 OpenAI 自己说的"日常工作首选",适合拿来接 Fable 中低档的活。
GPT-6.2 Sol 比 6.1 Sol 和 Opus 5.5 强多少?
两代 Sol 单价相同,6.2 在 AA 智能指数上分数更高、实测更快,具体数字和与 Opus 5.5 的对照见 GPT-6.2 Sol 和 6.1 Sol 区别:同价实测快 4 倍,Opus 5.5 还值不值。
和 Google 的便宜模型比,Sol 还划算吗?
在同一批题的实测里,Sol 比 Gemini 4 Hydrogen 更省,数字和条件见 Gemini 4 Hydrogen 和 GPT-6.2 Sol 对比:同题实测 Sol 便宜 72%。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月21日。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月21日。
- 1.Artificial Analysis 智能指数 Fable 5.2 与 GPT-6.2 Sol 对比页artificialanalysis.ai/models/comparisons/claude-fable-5-2-vs-gpt-6-2-sol
- 2.Claude 推理强度文档platform.claude.com/docs/en/build-with-claude/effort
- 3.GPT-6.2 Sol 模型页developers.openai.com/api/docs/models/gpt-6.2-sol
- 4.GPT-6.2 Astra 与 Sol 发布页openai.com/index/introducing-gpt-6-2-astra-sol
- 5.Fable 5.2 迁移指南platform.claude.com/docs/en/models/fable-5-2/migration-guide
- 6.OpenAI API 定价页developers.openai.com/api/docs/pricing
- 7.Claude API 定价页platform.claude.com/docs/en/about-claude/pricing
- 8.OpenAI 帮助中心关于 GPT-6 及 ChatGPT 中其他模型的说明help.openai.com/en/articles/20001354-gpt-6-and-other-models-in-chatgpt
- 9.Claude 帮助中心的说明support.claude.com/en/articles/15424964
- 10.OpenAI 推理指南developers.openai.com/api/docs/guides/reasoning