Ошибка Gemini «Requests ending with a model turn»: как исправить
С Gemini 3.6 Flash и в Gemini 4 Argon API возвращает 400, если последний ход в contents имеет role model. Закончите запрос ходом user, повтор не поможет.
Содержание
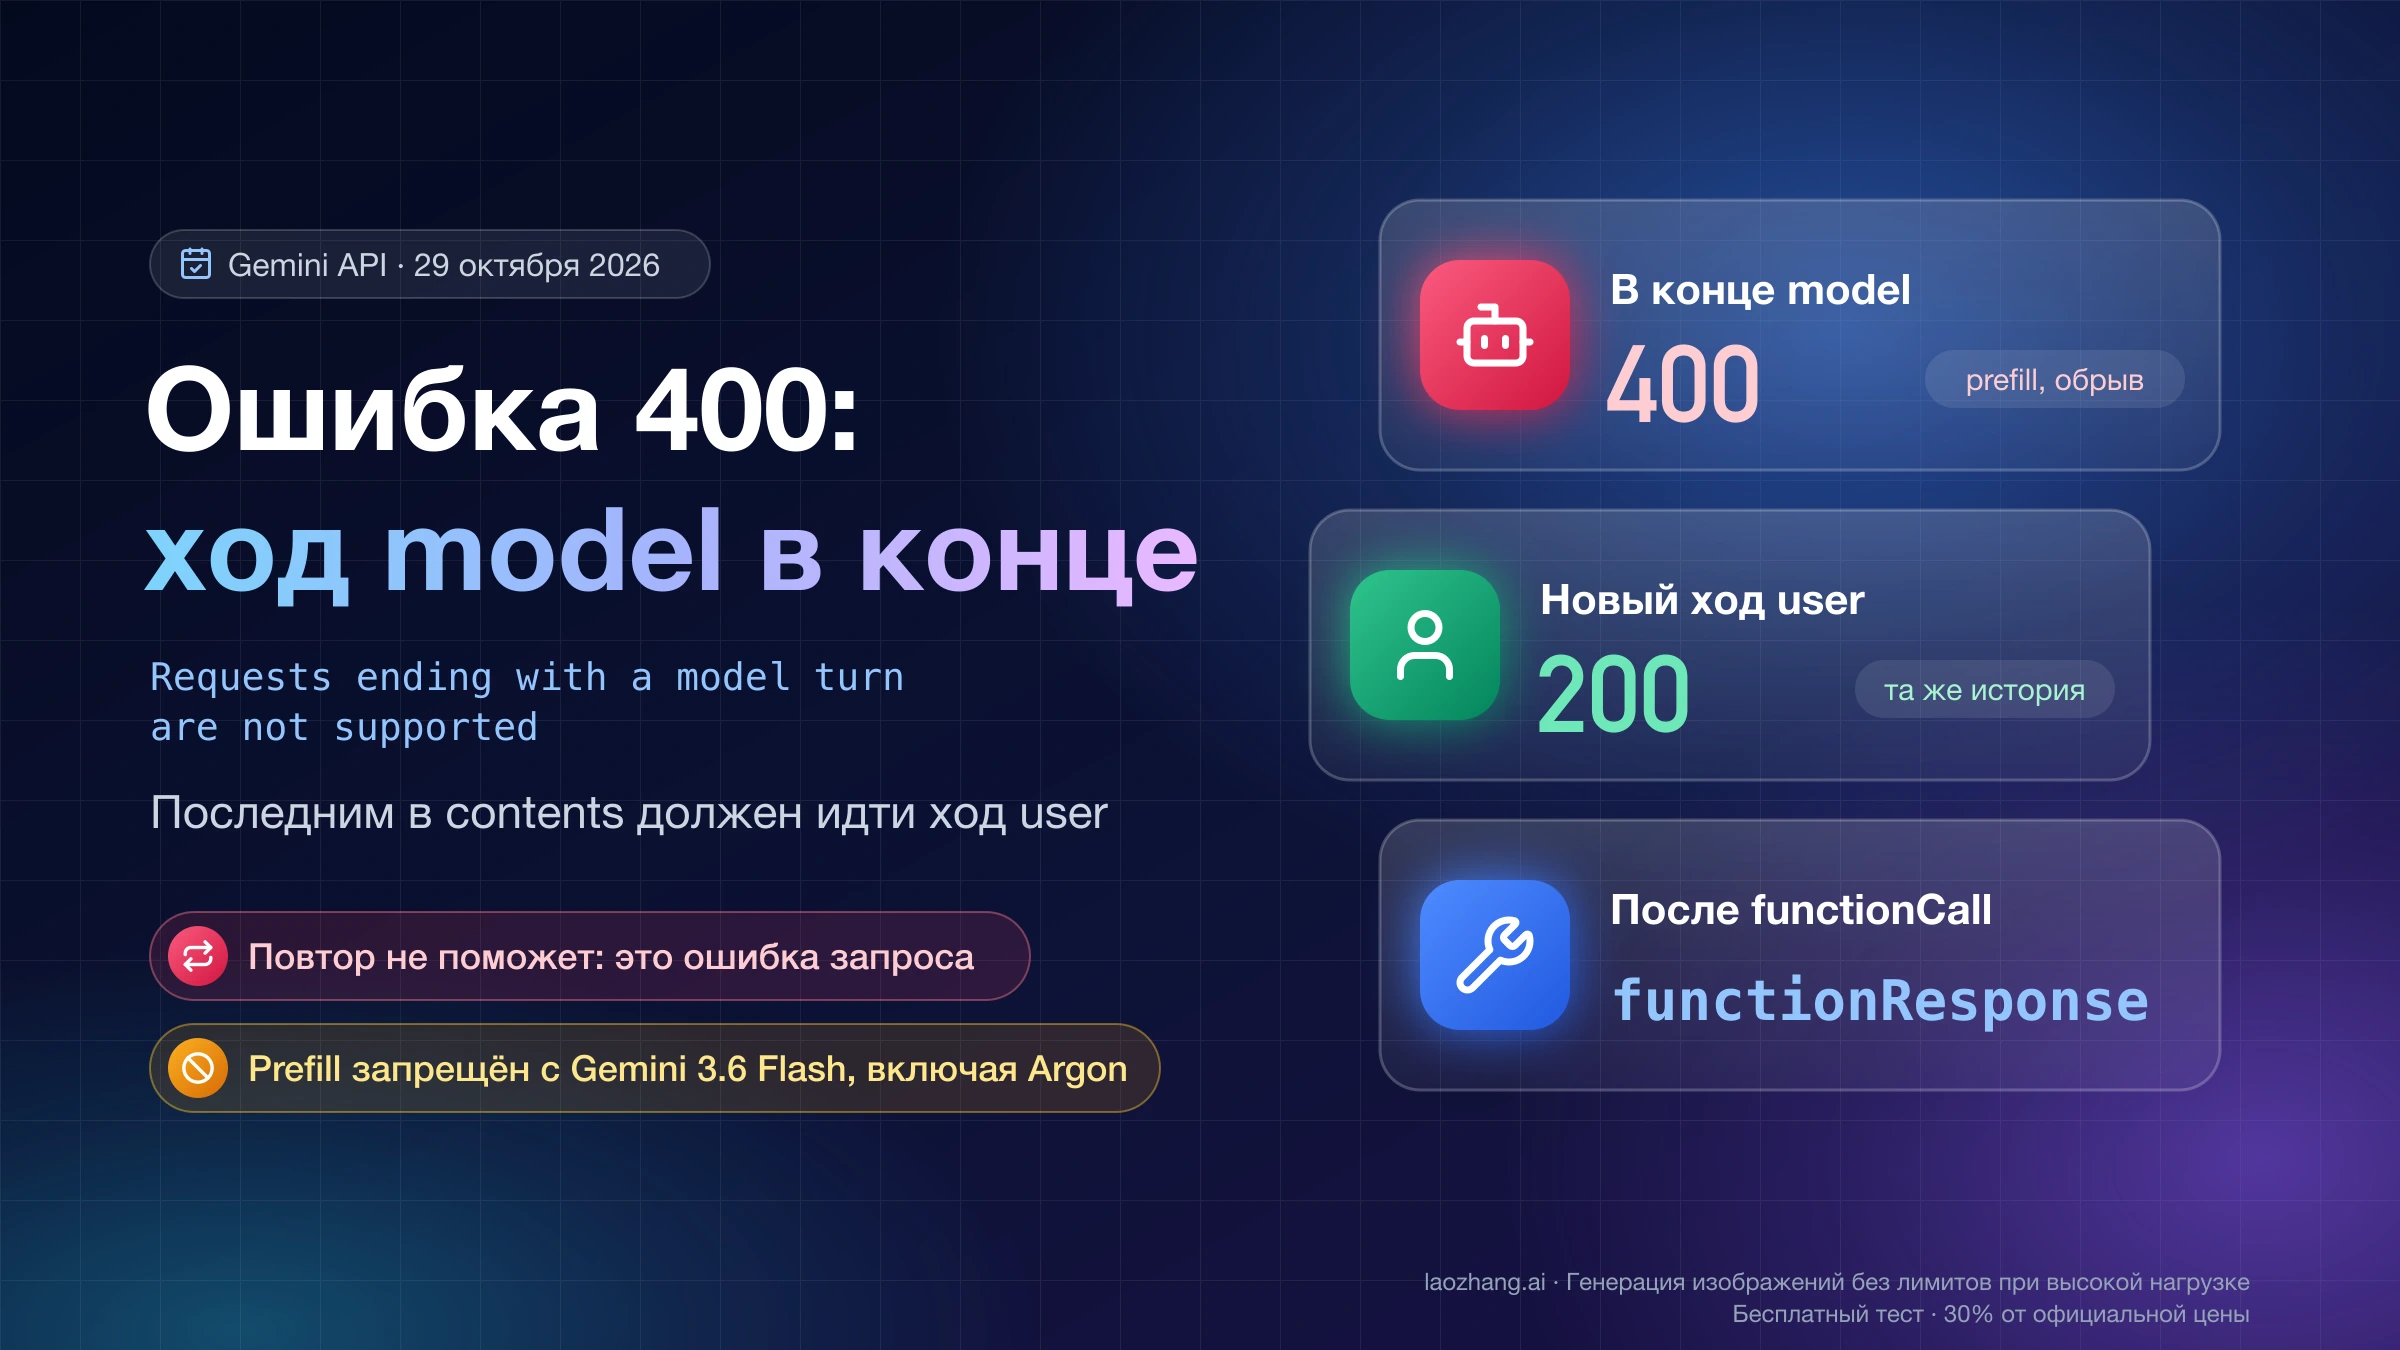
Ошибка 400 INVALID_ARGUMENT: Requests ending with a model turn are not supported. означает, что Google получил запрос, в котором последний непустой ход в массиве contents имеет role model, то есть принадлежит модели (в формате OpenAI это сообщение assistant). Правило Google объявил в описании изменений Gemini 3.6 Flash: оно действует для Gemini 3.6 Flash, Gemini 3.5 Flash-Lite и «всех следующих моделей», поэтому под него попадают и Gemini 3.7/3.8 Flash, и gemini-4-argon. Предзаполнение ответа (prefill) больше не поддерживается.
Исправляется это формой запроса: последним в contents должен идти ход user. Уберите prefill и сохранённый в конце истории ответ модели или добавьте после него новое сообщение пользователя. Если последним стоит functionCall, отправьте ход user с functionResponse. Указания вроде «без вступления» перенесите в systemInstruction, а принудительный JSON — в структурированный вывод с JSON schema. Если ошибку выдаёт готовый инструмент, обновите его: в Gemini CLI исправления вошли в v0.65.0. Повторять тот же запрос бесполезно, это ошибка запроса, а не перегрузка.
Есть одна ловушка. То, что в интерфейсе последним стоит ваше сообщение, не доказывает, что запрос к Google заканчивается на user: prefill, функции продолжения, преобразование истории, расширения, прокси и SDK могут дописать или переставить ходы. Смотреть нужно на тело запроса, которое реально уходит в API, а не на окно чата.
Что значит «Requests ending with a model turn are not supported»
Google проверяет только конец запроса: если последний непустой ход в contents принадлежит модели, API возвращает HTTP 400. Раньше так делали намеренно, чтобы модель «продолжила» заготовленное начало ответа, например Translation: или {. Начиная с Gemini 3.6 Flash это запрещено, а замену Google называет прямо: system_instruction или структурированный вывод (Structured outputs). На странице миграции Gemini 4 Argon это правило отдельно не повторяется, но формулировка «all future Gemini model releases» распространяется и на Argon.
Старые модели под правило не попадают: на LINUX DO 22 июля 2026 года писали, что на Gemini 3.5 Flash prefill ещё работает, а на 3.6 Flash уже нет. Возврат к старой модели может временно снять ошибку, но не исправляет запрос.
Текст ошибки встречается в трёх вариантах. Чаще всего это короткая форма из заголовка. В ответах AI Studio, у прокси и в трекере Google по Android Studio встречается длинная: Requests ending with a model turn are not supported unless the last part is a function response. Она подсказывает исключение: ход, который заканчивается результатом функции, допустим. Прокси оборачивают текст в PROXY ERROR 400, а OpenRouter показывает Provider returned error, и исходное сообщение Google лежит в поле error.metadata.raw.
Какой у вас случай: шесть причин, по которым запрос кончается ходом model
Причину проще всего определить по моменту, когда появляется ошибка: на первом же запросе, после отмены или перебивания, после вызова инструмента или только при подсчёте токенов. В таблице собраны случаи из отчётов разработчиков с июля по октябрь 2026 года.
| Причина | Как проявляется | Что исправить |
|---|---|---|
Prefill: в конец запроса добавлен заготовленный ход model | Падает каждый запрос, включая первый; на 3.5 Flash и старше то же работало | Убрать prefill; формат задать через systemInstruction или JSON schema |
| История кончается сохранённым ответом модели | Ошибка после /rewind, прерванного потока, Ctrl-C, перебивания голосом, после неупорядоченно сохранённого шага; новое сообщение пользователя «лечит» сессию | Перед отправкой добавить новый ход user или отрезать хвостовой ход model |
Последний ход — functionCall модели без ответа инструмента | Ошибка сразу после того, как модель вызвала функцию | Выполнить функцию и отправить ход user с functionResponse, сам ход модели вернуть без изменений |
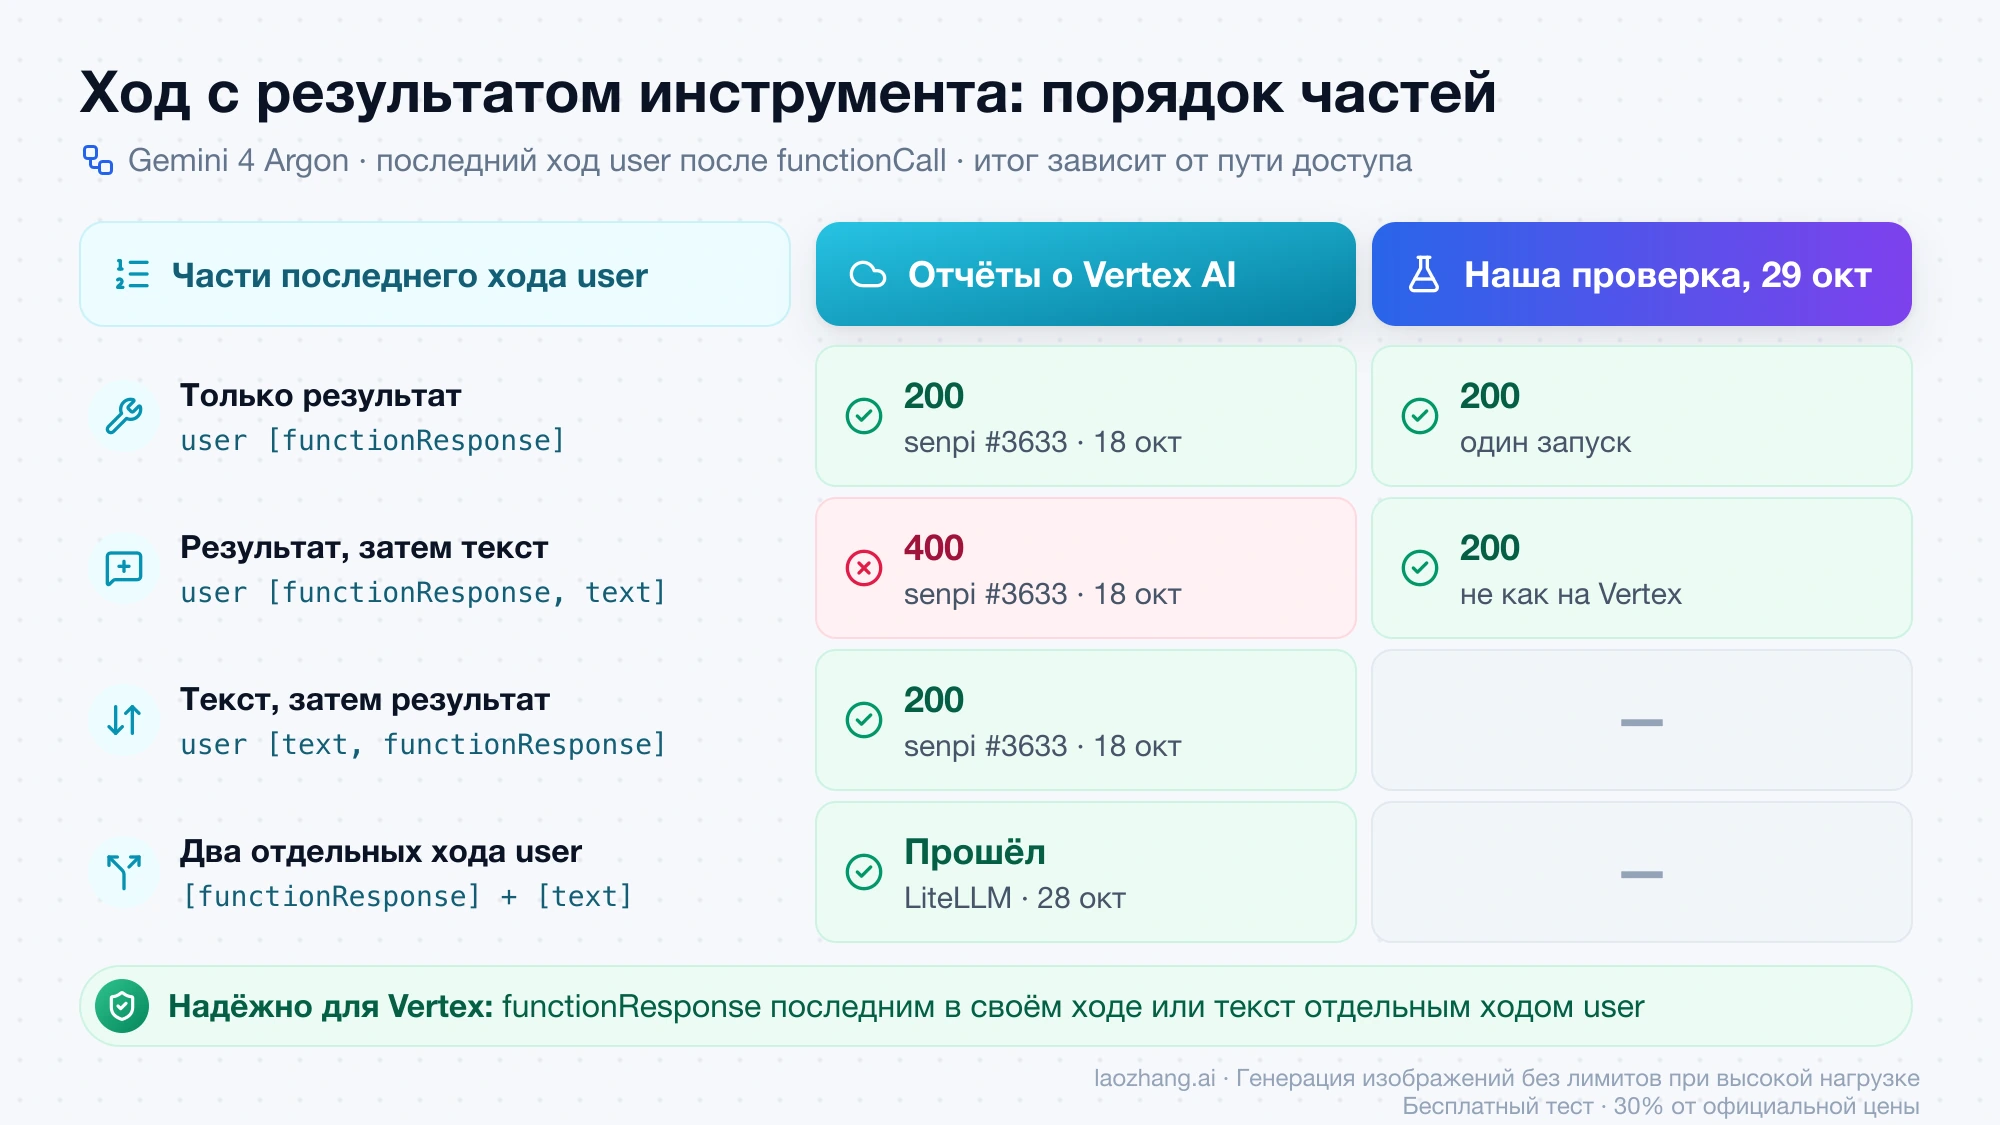
Результат инструмента и дополнительный текст в одном ходе user | На Vertex AI — 400, когда после результата инструмента приложение вставляет напоминание, заметку или реплику пользователя | Держать functionResponse последним в своём ходе или вынести текст в отдельный ход user |
| Изображение в результате инструмента | Ошибка на каждом шаге сразу после чтения .png или анализа картинки, текстовые шаги проходят | Вернуть результат инструмента текстом, изображение передать следующим сообщением пользователя |
countTokens по истории, которая кончается ответом модели | Подсчёт токенов падает или показывает 0, а генерация работает | Считать историю до последнего хода user или брать usageMetadata.promptTokenCount из ответа |
Случай с результатом инструмента и текстом показывает, что одна и та же история может пройти через одного посредника и не пройти через другого. В трекере агента senpi (issue #3633) 18 октября 2026 года для Gemini 4 Argon на Vertex замерили по одной переменной: последний ход user вида [functionResponse] даёт 200, [functionResponse, text] даёт 400, а [text, functionResponse] снова 200. 28 октября другой участник повторил это на gemini-4-argon через LiteLLM 1.101.0 и Google Cloud Express: когда результат инструмента и текст разнесли в два отдельных хода, запрос прошёл. Та же форма описана в langchain-google #1995, где интеграция vertexai сливает ToolMessage и следующий HumanMessage в один ход user.
Проверка 29 октября 2026 года: какие формы запроса к gemini-4-argon прошли
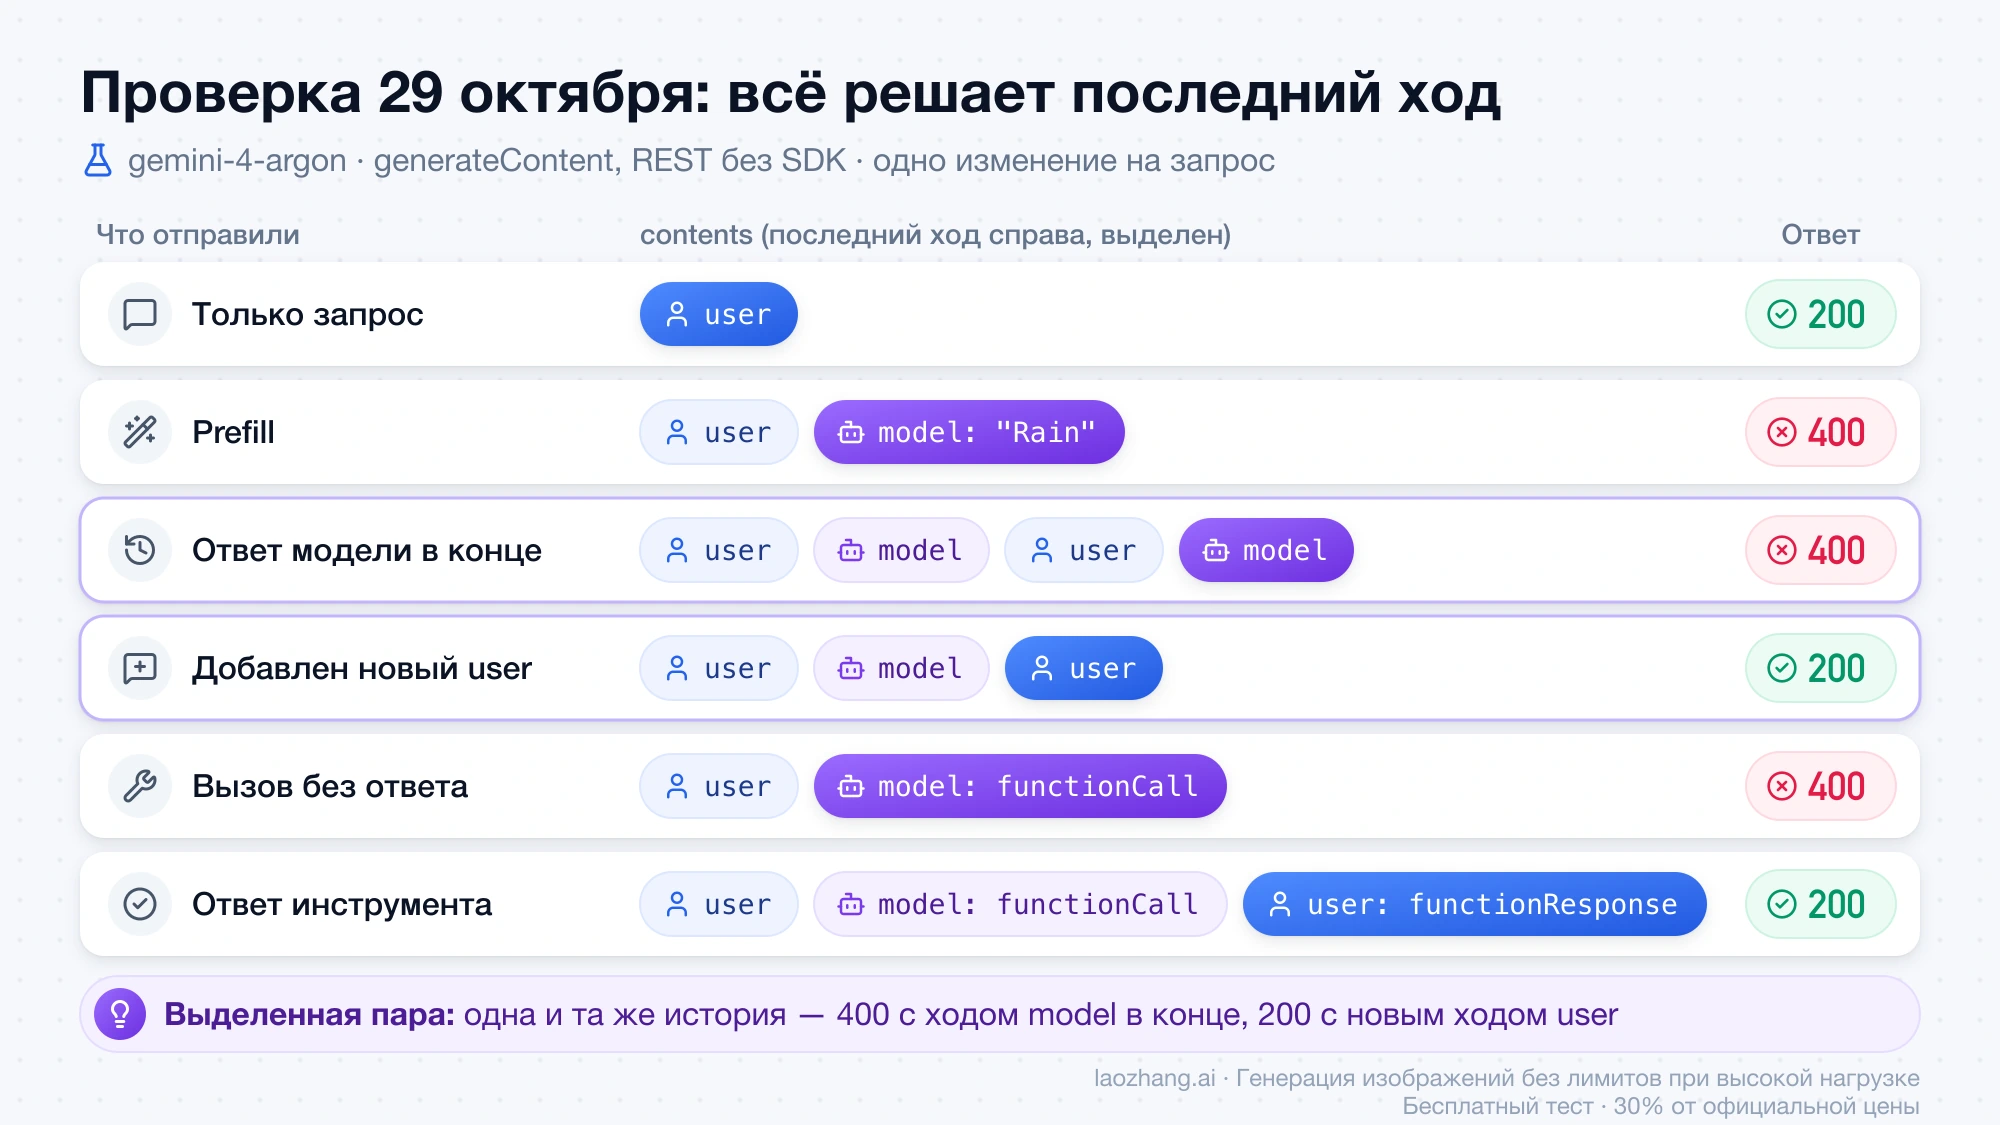
29 октября 2026 года, с 03:00 до 03:05 UTC, запросы к gemini-4-argon отправлялись через нативный эндпоинт Gemini generateContent на laozhang.ai: REST без SDK, thinkingLevel: low, и в каждом запросе менялась ровно одна деталь истории. Все ответы 200 пришли с modelVersion: gemini-4-argon, все ответы 400 содержали тот же текст ошибки, что и у Google.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Содержимое contents (последний элемент справа) | Результат |
|---|---|
[user] | 200 |
[user, model "Rain"], prefill | 400, при повторе в 03:13 UTC тоже 400 |
[user, model, user, model], история сохранена сразу после ответа | 400 |
Та же история без последнего хода model, то есть с новым user в конце | 200 |
[user] и объявленный инструмент | 200, модель вернула functionCall |
[user, model(functionCall)], ответа инструмента ещё нет | 400 |
[user, model(functionCall), user[functionResponse]] | 200 |
[user, model(functionCall), user[functionResponse, text]] | 200 |
Главное в таблице — пара из третьей и четвёртой строк: одна и та же история даёт 400 с ответом модели в конце и 200, когда последним стоит новый ход пользователя. Последняя строка расходится с отчётами о Vertex, где та же форма получала 400. Это зависит от того, как конкретный сервис собирает запрос к Google, поэтому ни один из двух результатов не стоит переносить на другие пути доступа.
Выборка небольшая: один эндпоинт, один день, по одному запуску на форму (prefill — два). Тело ошибки на этом пути имеет вид {"error":{"message":"…","type":"upstream_error","code":400}}, тогда как сам Google отвечает с полем "status": "INVALID_ARGUMENT". Формы [text, functionResponse], два раздельных хода user, а также замены prefill на systemInstruction и JSON schema в выборку не вошли. Для них ниже приведены рекомендация Google и отчёты о Vertex.
Как исправить запрос: закончить ходом user и убрать prefill
Начните с того, чтобы увидеть настоящий запрос. Включите журналирование тела запроса в SDK или в прокси и найдите последний элемент contents с непустыми parts. Если это model, нужное исправление зависит от того, что в нём лежит. Простая проверка перед отправкой ловит ошибку раньше, чем её вернёт API:
def last_turn_role(contents):
    for turn in reversed(contents):
        if turn.get("parts"):
            return turn["role"]
    return None

if last_turn_role(contents) == "model":
    raise ValueError("contents заканчивается ходом model: Gemini вернёт 400")
Если в конце стоит заготовленное начало ответа, уберите его и перенесите смысл в инструкции. Для указаний о стиле и формате Google рекомендует systemInstruction:
{
  "systemInstruction": {"parts": [{"text": "Выведи только перевод, без вступления."}]},
  "contents": [
    {"role": "user", "parts": [{"text": "Translate 'Hello world' to Spanish."}]}
  ]
}
Если prefill нужен был, чтобы ответ начинался с {, задайте структурированный вывод в generationConfig: "responseMimeType": "application/json" и схему в "responseJsonSchema", как описано в руководстве Google по структурированному выводу в generateContent. Тогда модель вернёт JSON без заготовки. Если же prefill служил для продолжения обрезанного длинного ответа, причину обрыва нужно искать в finishReason. Об этом подробно в статье Gemini 4 Argon API: доступ, finish_reason и обрыв ответа.
Если история кончается сохранённым ответом модели после отмены, перемотки или перебивания, не отправляйте её в таком виде. Добавьте новый ход user с тем, что вы хотите получить дальше, или отрежьте хвостовой ход model, если он был прерван и не нужен. После functionCall выполните функцию и отправьте ход user с functionResponse. Ход модели с вызовом функции возвращайте ровно в том виде, в каком он пришёл, вместе с thoughtSignature. Google требует передавать подписи размышлений в многоходовых запросах, поэтому удалять или подделывать их нельзя.
Если после результата инструмента нужно добавить текст, а запрос идёт через Vertex AI, держите functionResponse последним в своём ходе или вынесите текст в отдельный ход:
[
  {"role": "model", "parts": [{"functionCall": {"name": "get_weather", "args": {"city": "Paris"}}, "thoughtSignature": "…как пришло…"}]},
  {"role": "user", "parts": [{"functionResponse": {"name": "get_weather", "response": {"temp_c": 14}}}]},
  {"role": "user", "parts": [{"text": "Ответь одним предложением."}]}
]
Изображение из результата инструмента передайте так же отдельно: результат инструмента текстом, а картинку следующим сообщением пользователя. В hermes-agent #139313 именно такой вариант через OpenRouter и google/gemini-4-argon дал 200, а результат инструмента с картинкой в конце запроса давал 400.
Автоматический повтор здесь не нужен. В руководстве Google по устранению неполадок Gemini API повторять советуют только временные ошибки 429, 408 и 5xx, а 400 — это ошибка в самом запросе, и тот же запрос снова получит 400. Мейнтейнер senpi 20 октября 2026 года тоже попросил считать этот 400 ошибкой запроса, а не поводом для паузы или переключения на запасную модель. Если в вашем коде 400 запускает цикл повторов, как в livekit agents-js #2108, агент просто замолкает.
Почему countTokens на Gemini 4 Argon даёт 400
Об этом сообщил мейнтейнер плагина Obsidian Gemini Scribe allenhutchison в obsidian-gemini #1708 27 октября 2026 года. С моделью gemini-4-argon вызов models.countTokens на первом ходе новой сессии вернул 400 INVALID_ARGUMENT с обрезанным в журнале текстом Requests ending wi…are not supported., а тот же сценарий с gemini-flash-latest проходил. По версии автора, сразу после сохранения ответа история сессии кончается ходом модели, и Argon отклоняет countTokens с таким contents. Сам автор помечает это как гипотезу, а результаты generateContent из таблицы выше с ней согласуются, хотя и не доказывают её. Ошибка в плагине не роняла сессию, но счётчик токенов и порог сжатия контекста получали 0.
Исправление, которое предлагает автор, — считать токены до последнего хода user или добавлять в конец ход user. Вторая задокументированная возможность — вообще не вызывать подсчёт для уже отправленной истории: usageMetadata.promptTokenCount приходит в каждом ответе generateContent и ничего не стоит.
def contents_for_count(contents):
    last_user = max(i for i, t in enumerate(contents) if t["role"] == "user")
    return contents[: last_user + 1]

client.models.count_tokens(model="gemini-4-argon", contents=contents_for_count(history))
Сам countTokens для Argon поддерживается: в документации Firebase AI Logic о подсчёте токенов gemini-4-argon стоит первым в списке моделей, вызов бесплатный, квота 3000 запросов в минуту, а в подсчёт входят системные инструкции и инструменты. Если вы работаете через шлюз, сначала убедитесь, что он вообще пропускает :countTokens. На том же шлюзе, что и в проверке выше, запрос к /v1beta/models/gemini-4-argon:countTokens 29 октября 2026 года вернул 400 unsupported action: countTokens независимо от того, чем кончалась история. Это другой 400 от другого слоя, и к правилу о ходе модели он отношения не имеет.
Ошибка в Gemini CLI, opencode, SillyTavern или LangChain: что делать
Если запрос собирает инструмент или библиотека, а не ваш код, исправление нужно искать в нём: обновиться, если фикс уже вышел, или обойти конкретный сценарий, который ставит ход модели в конец. Статусы ниже указаны по состоянию на 29 октября 2026 года.
| Инструмент | Откуда ход model в конце | Статус | Что сделать |
|---|---|---|---|
| Gemini CLI | /rewind, прерванный поток, быстрый Ctrl-C, чтение .png через ReadFile (#29530, #29574) | Исправления влиты 7 и 13 октября, оба есть в стабильной v0.65.0 от 20 октября | Обновиться до v0.65.0 или новее |
| opencode | Служебное сообщение о лимите шагов добавляется как ответ ассистента (#45359); чтение .png через OpenRouter (#55694) | #45359 закрыт, но 15 сентября ошибка повторялась на 1.18.31, слияние PR #55382 не подтверждено; #55694 открыт | Отправить новое сообщение, после него сессия продолжается |
| Zoo Code, Kilo Code | Zoo Code на Vertex дописывает prefill для вызова инструментов (#1052); в Kilo Code шаги сохранялись не по порядку | Открыто | Автор отчёта по Zoo Code временно вернулся на gemini-3.5-flash |
| SillyTavern и другие ролевые фронтенды | Prefill ассистента, «продолжить», настройки начала ответа, преобразование истории, расширения | Зависит от пресета | Новый чат, последним — настоящее сообщение пользователя; отключить prefill и продолжение, затем включать по одному |
| LangChain (langchain-google, vertexai) | Результат инструмента и следующий HumanMessage слиты в один ход user (#1995) | Открыто | Не ставить сообщение пользователя сразу за результатом инструмента или разделять их вручную |
| LiteLLM | История на Vertex кончается текстовым ответом ассистента (#38537) | Открыто | Перед вызовом убирать хвостовой ответ ассистента или добавлять сообщение пользователя |
| OpenRouter | Результат инструмента с изображением стоит последним; текст Google виден только в metadata.raw | Открыто в hermes-agent #139313 | Результат текстом, изображение отдельным сообщением пользователя |
| instructor | Повторный запрос структурированного вывода (reask) заканчивается ходом модели (#2631) | Открыто | Автор отчёта предлагает max_retries=0 для вызовов Gemini, чтобы reask не запускался |
Для Gemini CLI вывод «v0.65.0 и новее» сделан по сравнению тегов на GitHub: оба исправления входят в v0.65.0 и не входят в v0.64.0. Обновить CLI можно командой npm install -g @google/gemini-cli@latest, а подробности установки и входа есть в статье Как установить Gemini CLI: npm, Windows и вход после 18 июня 2026.
В SillyTavern названия пунктов зависят от версии и пресета, поэтому проще проверить сам эффект: начать новый чат, где последним идёт ваше сообщение, и по очереди возвращать prefill ассистента, продолжение ответа и обработку истории, пока ошибка не вернётся. Так советует руководство EvoLink по настройке Gemini в SillyTavern от 16 октября 2026 года.
Ошибка model turn в Gemini: другие вопросы
Это то же самое, что ошибка «role system is not supported»?
Нет. Там API не принимает саму роль сообщения, а здесь роль допустима, но стоит не на своём месте. Про неподдерживаемые роли написано в статье Как исправить API 400 с неподдерживаемой ролью и не сломать системные инструкции.
У Claude тоже запретили prefill?
У Claude похожий запрет на prefill, но у него свой текст ошибки (This model does not support assistant message prefill) и свой список моделей. Подробности в статье Ошибка 400 prefill в Claude: на каких моделях и чем заменить.
Что значит «Function call is missing a thought_signature»?
Это другой 400 у Gemini 3 и новее: в последнем ходе модели вызов функции передан без подписи размышлений. Он появляется, когда приложение пересобирает ход модели вместо того, чтобы вернуть его без изменений; в отчёте senpi от 18 октября 2026 года он встретился на той же истории, что и ошибка о ходе модели.
Какие ещё 400 бывают у Gemini 4 Argon?
По странице миграции Google на 27 октября 2026 года Argon возвращает ошибку на явное кэширование (cachedContents), а temperature, top_p и top_k игнорирует. Это отдельные ограничения Argon, с последним ходом в contents они не связаны.
Источники18
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 29 окт. 2026 г..
Источники18
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 29 окт. 2026 г..
- 1.в описании изменений Gemini 3.6 Flashai.google.dev/gemini-api/docs/whats-new-gemini-3.6
- 2.Gemini 4 Argonai.google.dev/gemini-api/docs/generate-content/latest-model
- 3.трекере агента senpi (issue #3633)github.com/code-yeongyu/senpi/issues/3633
- 4.langchain-google #1995github.com/langchain-ai/langchain-google/issues/1995
- 5.руководстве Google по структурированному выводу в generateContentai.google.dev/gemini-api/docs/generate-content/structured-output
- 6.hermes-agent #139313github.com/NousResearch/hermes-agent/issues/139313
- 7.руководстве Google по устранению неполадок Gemini APIai.google.dev/gemini-api/docs/troubleshooting
- 8.livekit agents-js #2108github.com/livekit/agents-js/issues/2108
- 9.obsidian-gemini #1708github.com/allenhutchison/obsidian-gemini/issues/1708
- 10.документации Firebase AI Logic о подсчёте токеновfirebase.google.com/docs/ai-logic/count-tokens
- 11.#29530github.com/google-gemini/gemini-cli/issues/29530
- 12.#29574github.com/google-gemini/gemini-cli/issues/29574
- 13.#45359github.com/anomalyco/opencode/issues/45359
- 14.#55694github.com/anomalyco/opencode/issues/55694
- 15.#1052github.com/Zoo-Code-Org/Zoo-Code/issues/1052
- 16.#38537github.com/BerriAI/litellm/issues/38537
- 17.#2631github.com/567-labs/instructor/issues/2631
- 18.руководство EvoLink по настройке Gemini в SillyTavernevolink.ai/blog/sillytavern-gemini-setup-troubleshooting