Gemini 4 Hydrogen: цена API $1,50/$7,50 и стоимость вызова
Gemini 4 Hydrogen вышла 12 ноября 2026 года: $1,50 за 1 млн входных токенов, $7,50 за выходные вместе с рассуждением. Вызов в тесте стоил от $0,0016 до $0,0495.
Содержание
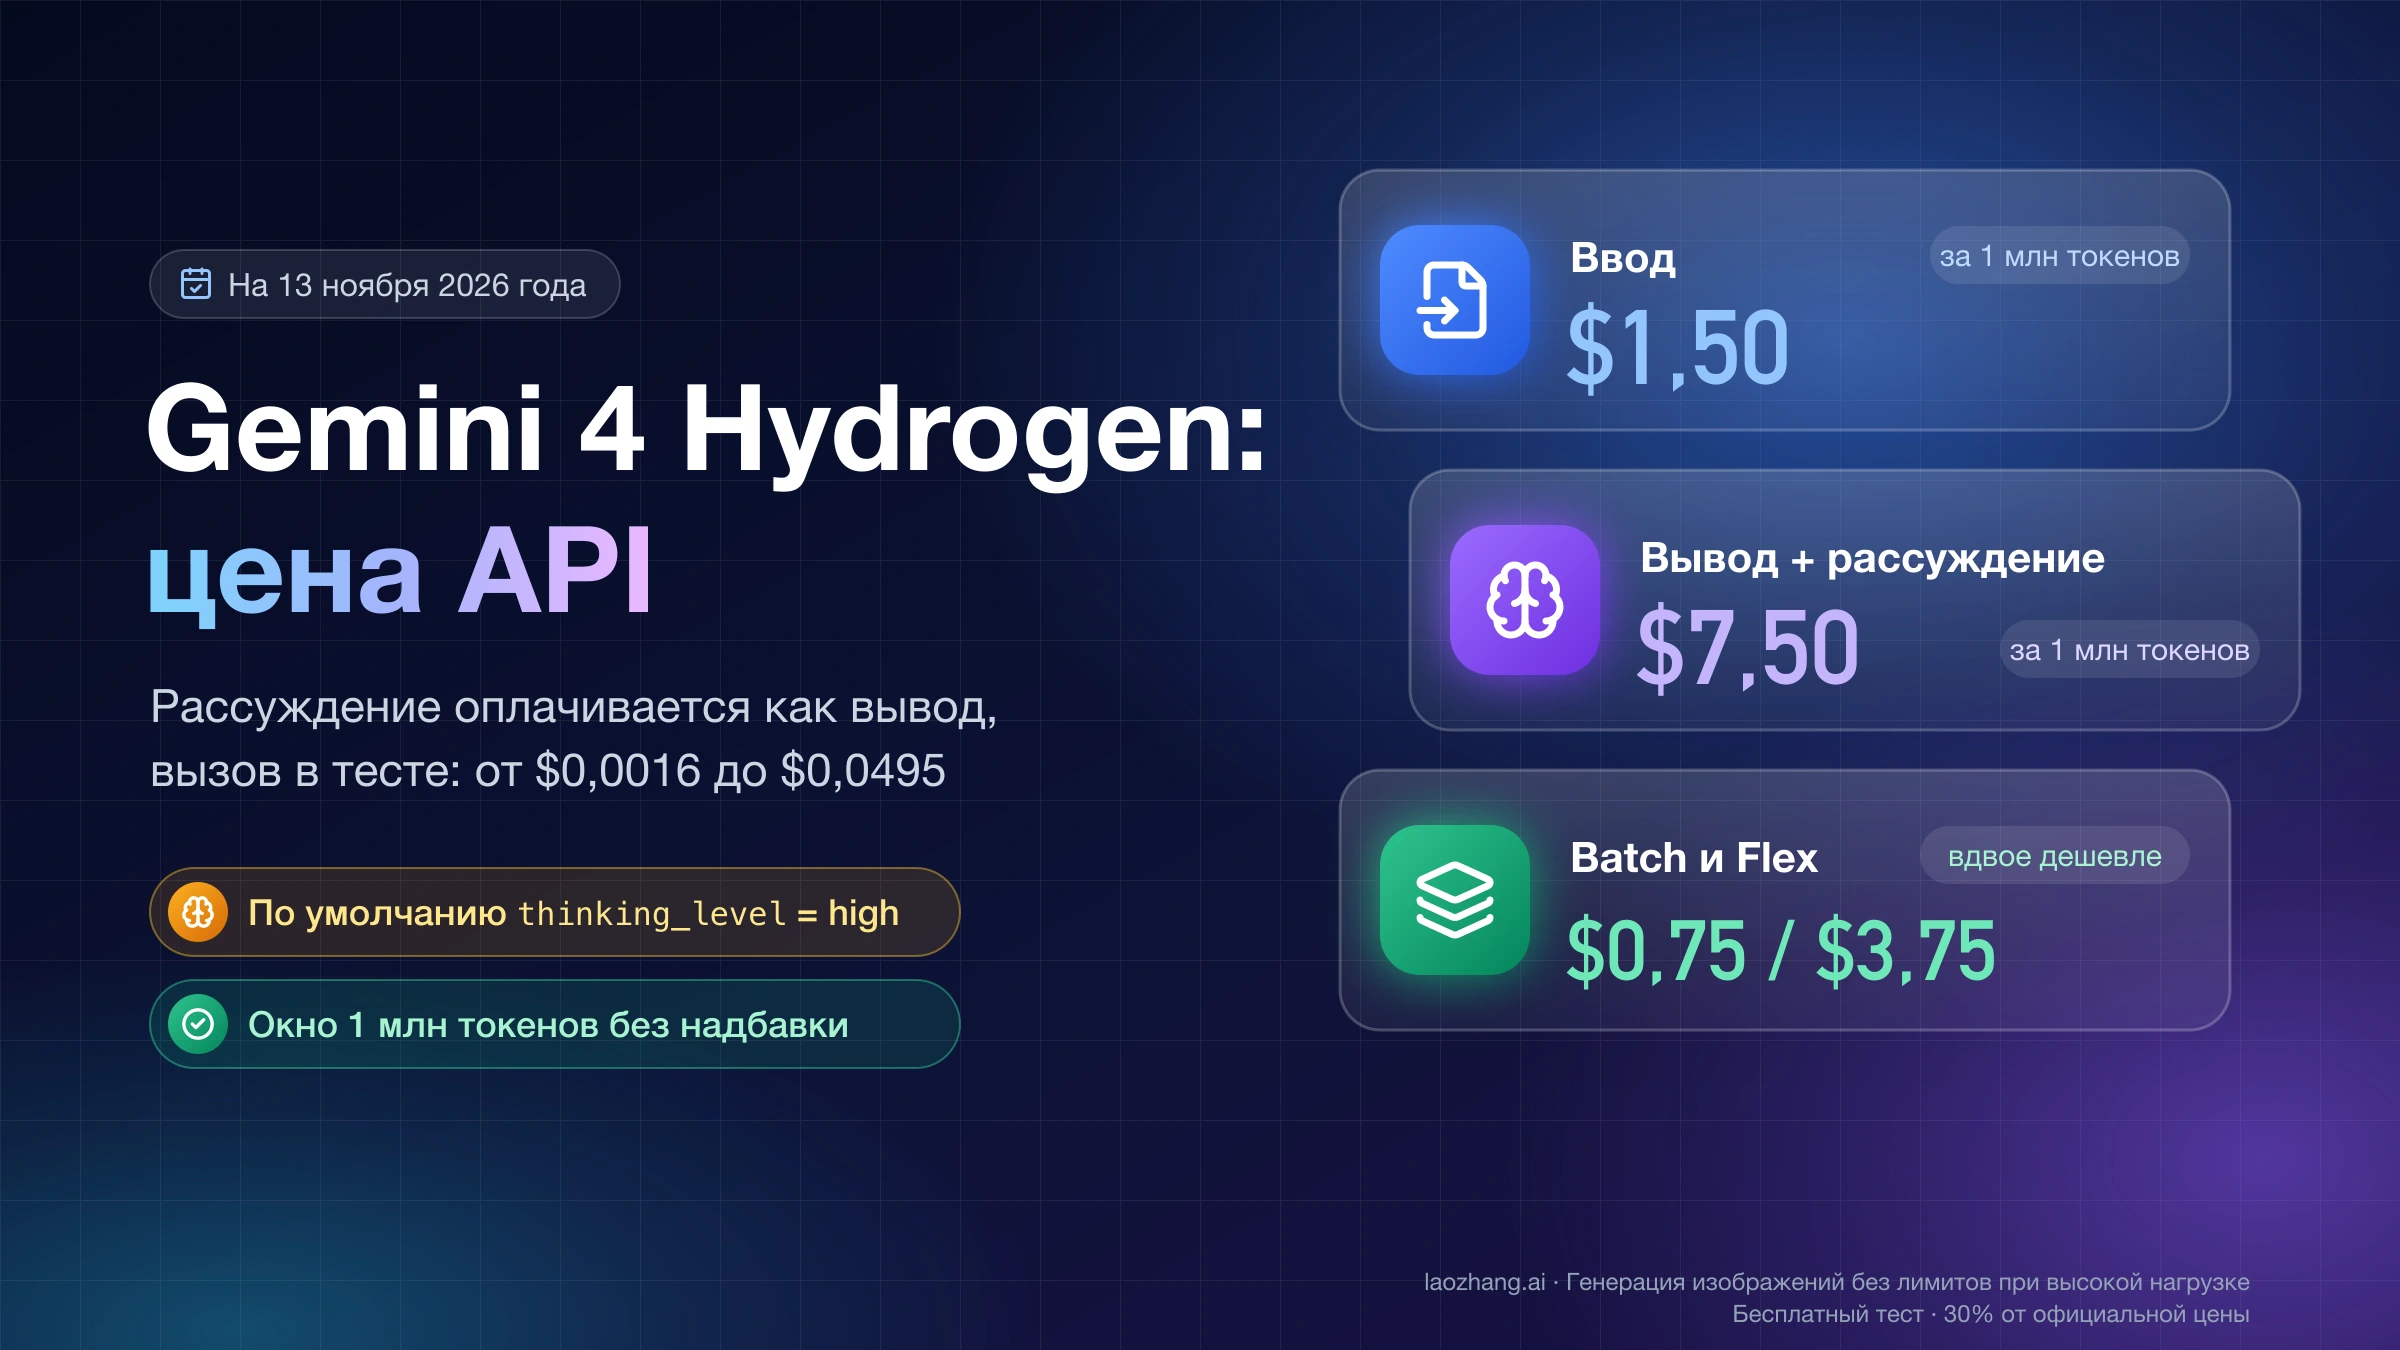
Gemini 4 Hydrogen (gemini-4-hydrogen) вышла в общий доступ 12 ноября 2026 года и по состоянию на 13 ноября 2026 года стоит в Gemini API $1,50 за 1 млн входных токенов и $7,50 за 1 млн выходных. Цена одна на всё окно в 1 млн токенов, без надбавки за длинный контекст, а режимы Batch и Flex обходятся вдвое дешевле. Главное условие спрятано в строке вывода: в неё входят токены рассуждения, а уровень рассуждения по умолчанию у Hydrogen — high, поэтому счёт определяет не длина ответа, а то, сколько модель думала перед ним.
Чтобы заложить бюджет, задайте thinking_level явно и считайте стоимость по полному числу выходных токенов. 13 ноября 2026 года в Google AI Studio два коротких задания стоили на уровне low $0,0056 и $0,0016 за вызов, а на xhigh — $0,0495 и $0,0156, примерно в 9–10 раз дороже. Фоновые задачи, где ответ не нужен сразу, выгоднее отправлять через Batch или Flex: те же токены там стоят вдвое меньше.
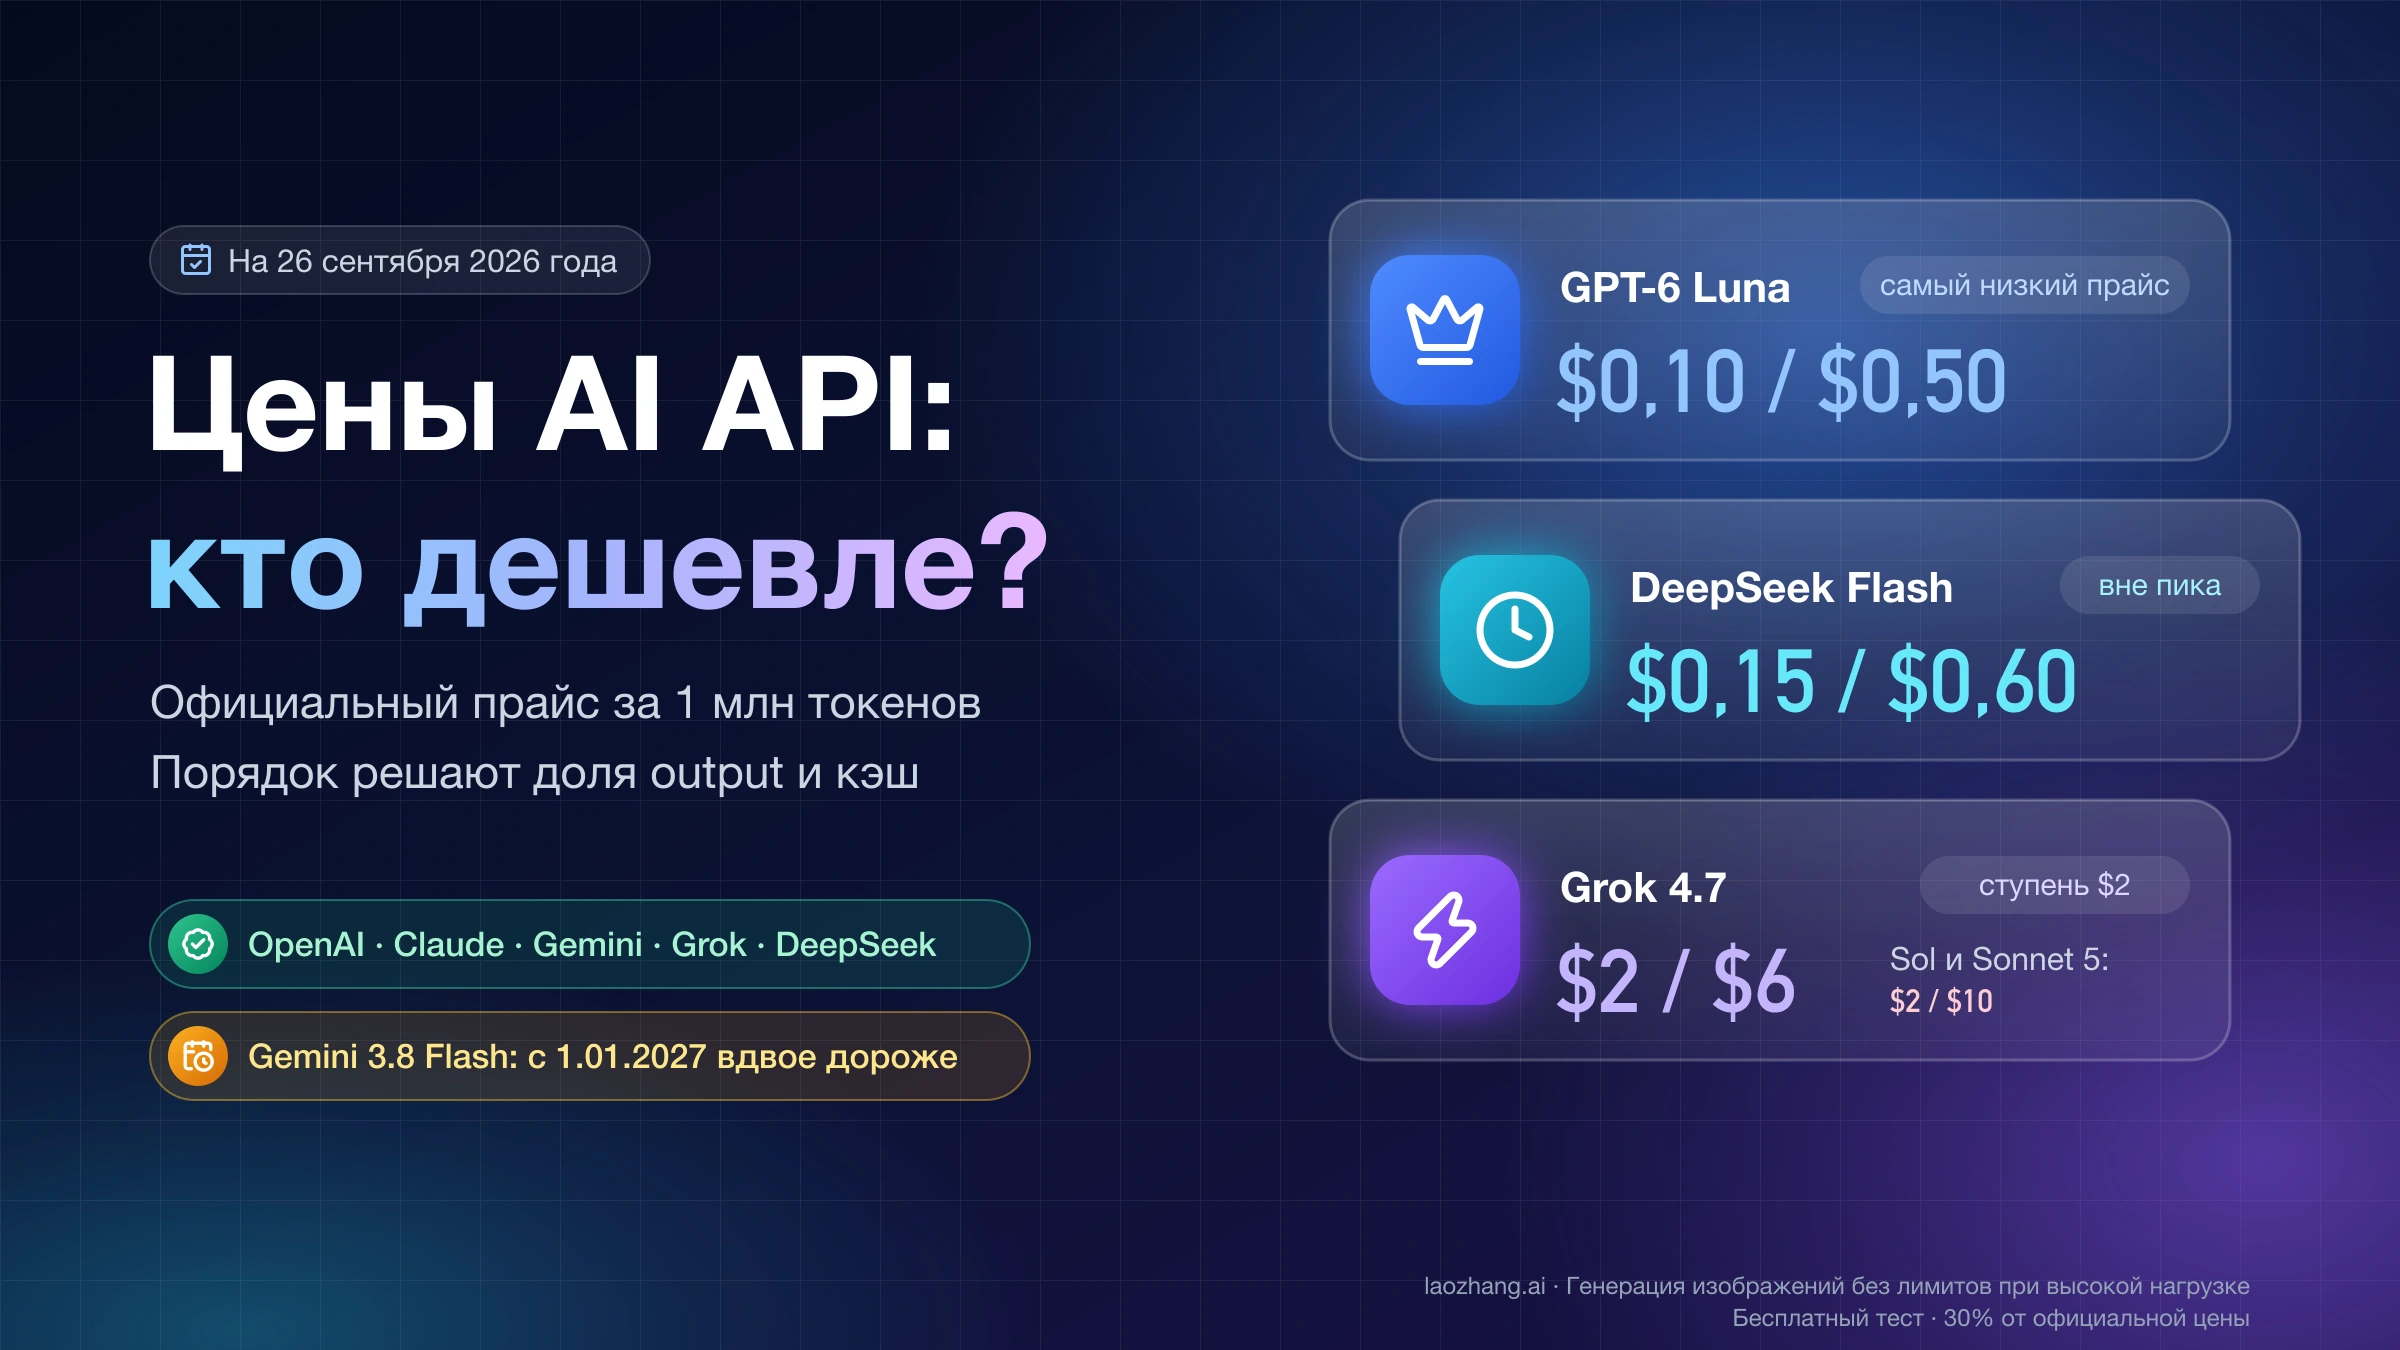
Сравнение с соседними моделями меняется в две даты. Сейчас за токен Hydrogen вдвое дороже Gemini 3.8 Flash и на четверть дешевле Gemini 4 Argon и Carbon; с 1 декабря 2026 года Argon и Carbon дорожают вдвое, а с 1 января 2027 года Flash выходит на ту же цену, что и Hydrogen. Gemini API и AI Studio, согласно списку доступных регионов Google, из России не обслуживаются, а рублёвые цены посредников — их собственные тарифы, а не прайс Google.
Цены Gemini 4 Hydrogen по тарифам: от бесплатного уровня до Priority
По состоянию на 13 ноября 2026 года Hydrogen можно оплачивать по четырём ставкам в Gemini Developer API и по двум региональным ставкам в Vertex AI, а для прототипов есть бесплатный уровень. Во всех платных вариантах действует одно правило из страницы цен Gemini Developer API: учитывается и оплачивается каждый токен, который обработала модель, включая токены рассуждения, а при работе с поиском Google — ещё и внутренние системные инструкции и описания функций.
| Тариф | Ввод, за 1 млн токенов | Вывод с рассуждением, за 1 млн | Чтение из кэша, за 1 млн | Условия |
|---|---|---|---|---|
| Бесплатный уровень (Gemini API и AI Studio) | $0 | $0 | $0 | Запросы используются для улучшения продуктов Google; Batch, Flex и поиск Google недоступны |
| Standard | $1,50 | $7,50 | $0,075 | Одна цена на всё окно в 1 млн токенов |
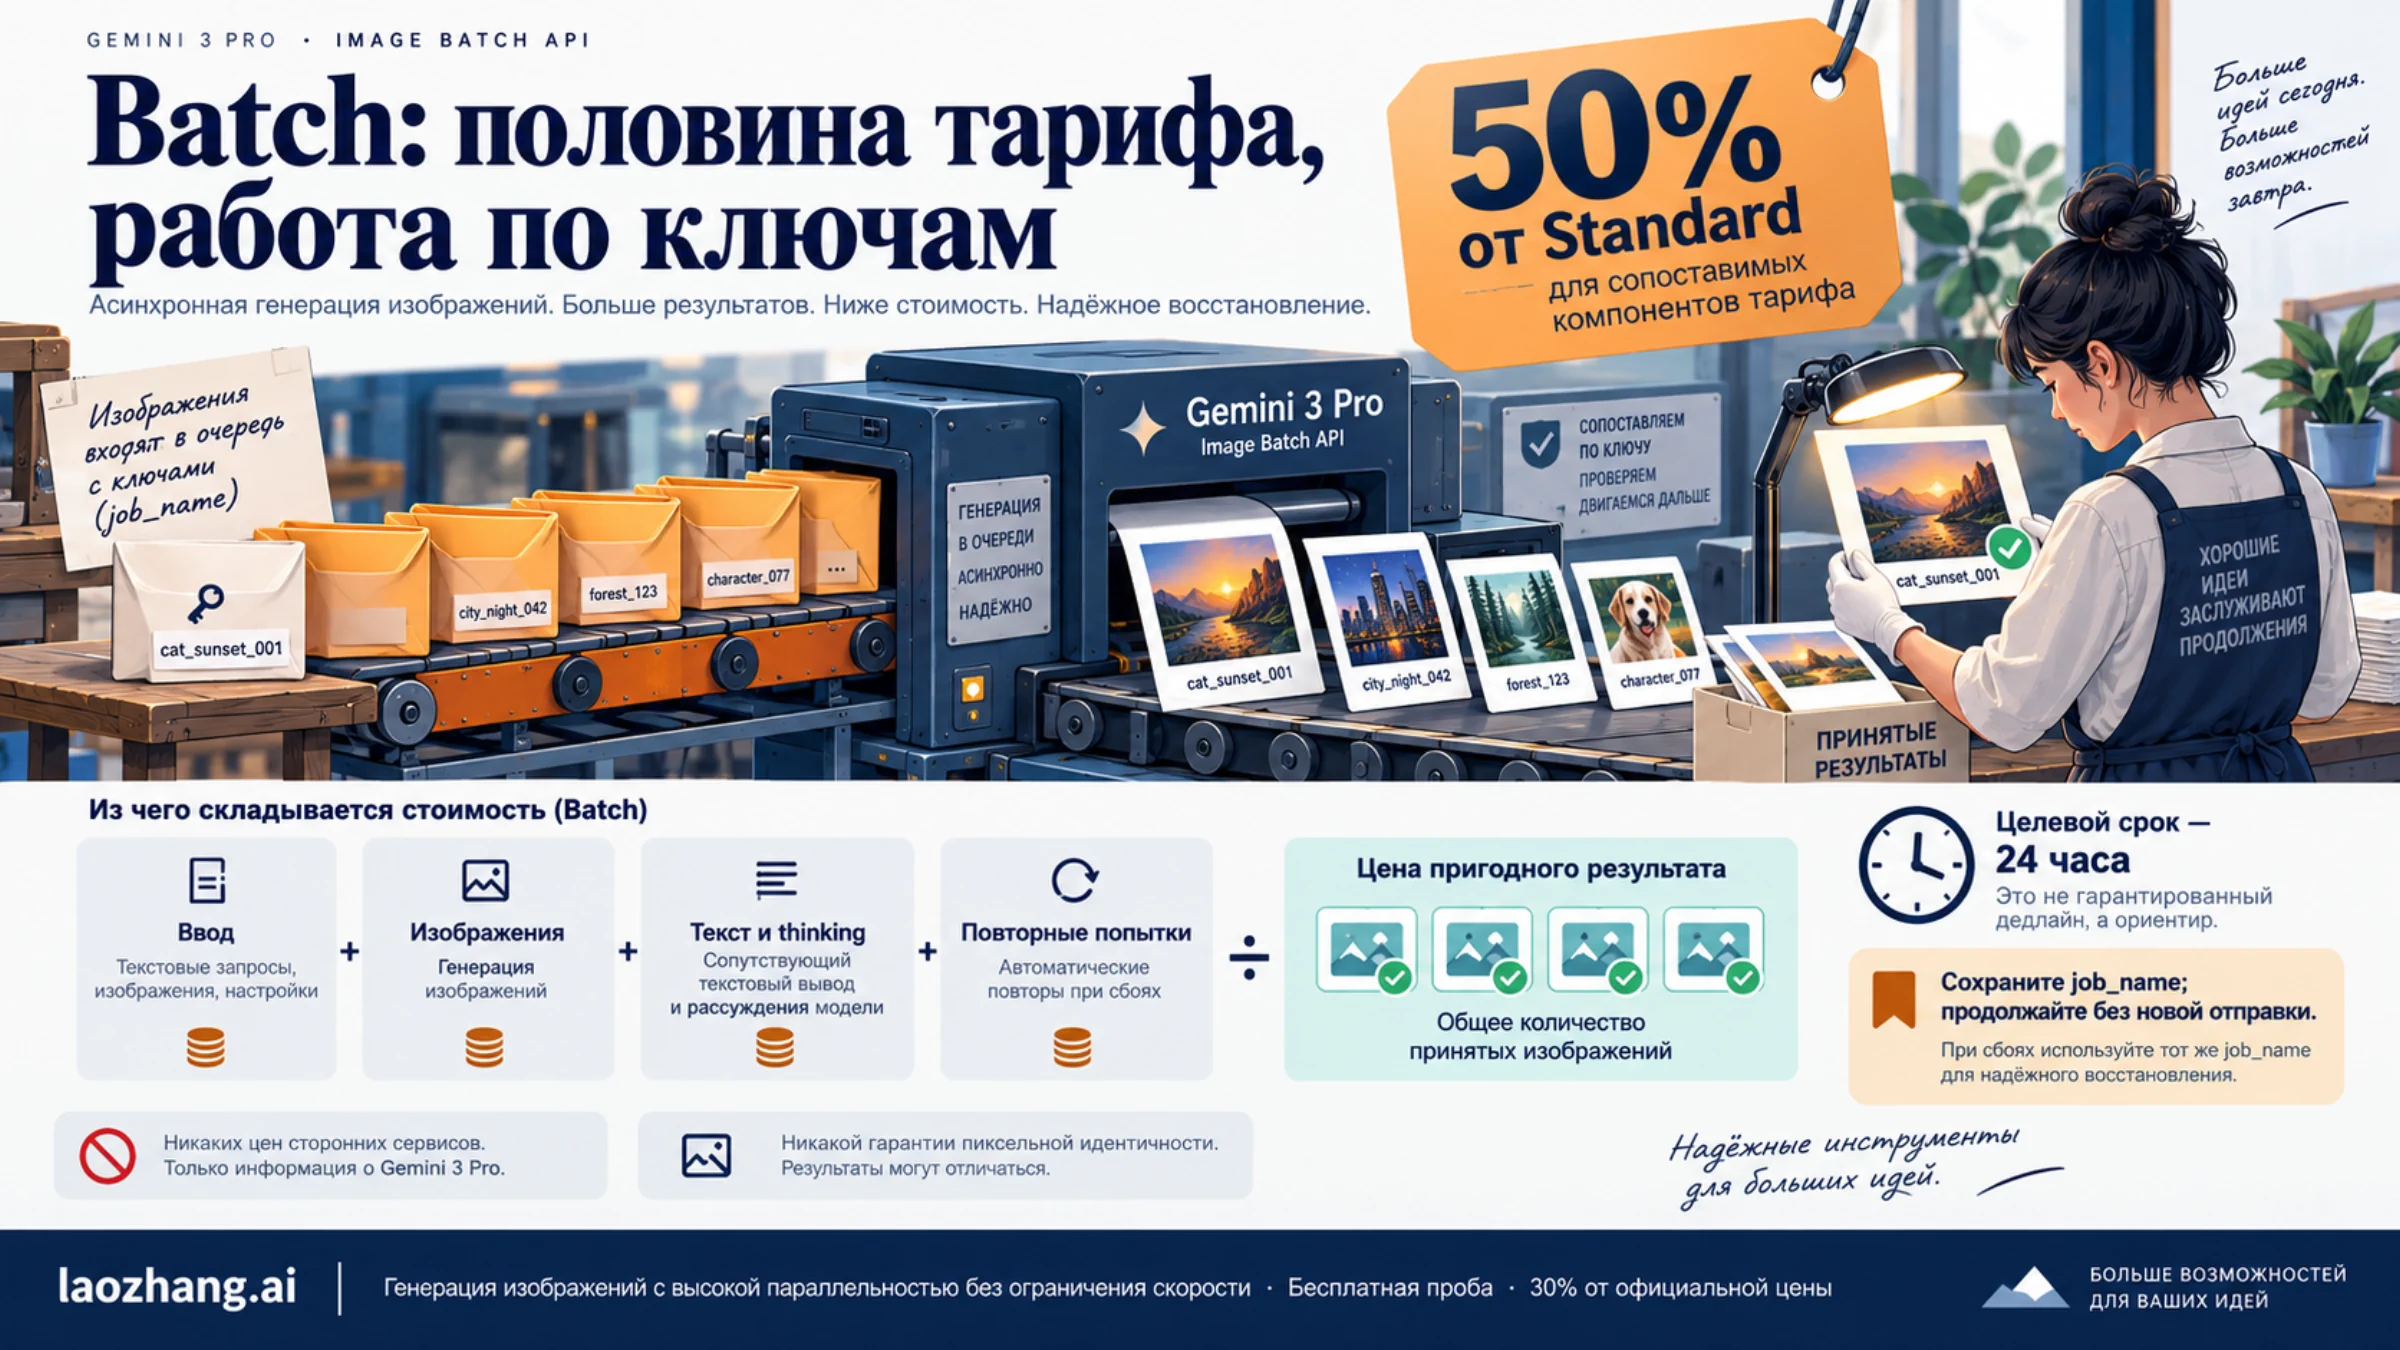
| Batch и Flex | $0,75 | $3,75 | $0,0375 | Только на платном уровне |
| Priority | $2,70 | $13,50 | $0,135 | В 1,8 раза дороже Standard |
| Vertex AI, Global | $1,50 | $7,50 | $0,075 | Запись в кэш $1,875 с 12 января 2027 года |
| Vertex AI, Non-global | $1,65 | $8,25 | $0,0825 | На 10 % дороже Global; запись в кэш $2,0625 с 12 января 2027 года |
В прайсе Vertex AI для генеративных моделей Global и Non-global означают тип эндпоинта: глобальный или привязанный к конкретному региону. Наценка в 10 % за региональный эндпоинт распространяется на все режимы, поэтому Batch и Flex в Non-global стоят $0,825 / $4,125, а Priority — $2,97 / $14,85. Кэш у Hydrogen только неявный (implicit): явный кэш, который можно создать заранее, модель не поддерживает.
Цифры $0,75 / $3,75, которые 12 ноября, ещё до релиза, разошлись в X как «цена Hydrogen», совпадают с официальной ценой Batch и Flex, а не со стандартной. Те же $0,75 / $3,75 указаны и для программы Contributor, но она закрытая, работает по приглашениям, и данные из неё Google использует для улучшения продуктов. Общие правила оплаты Gemini API и цены остальных моделей разобраны в статье «Как купить доступ к Gemini API в России: ключ $0, цены 2026–2027».
Сколько стоит один вызов: замер в AI Studio 13 ноября 2026 года
Один короткий вызов Hydrogen стоил от $0,0016 на уровне low до $0,0495 на уровне xhigh, и от 89 до 99,7 % этой суммы пришлось на выходные токены. Замер сделан 13 ноября 2026 года в Google AI Studio в Chrome, на бесплатном уровне одного аккаунта Google, с моделью gemini-4-hydrogen. Два задания прогнали на всех четырёх уровнях рассуждения, каждый раз в новом чате, и записали число токенов из подсказки Token Usage; стоимость пересчитана по ставкам Standard.
Задание A — написать на Python функцию parse_duration с указанием вернуть только код. Задание B — посчитать месячный счёт SaaS-сервиса (12 000 пользователей по 40 запросов в месяц, 1 800 входных и 450 выходных токенов на запрос, цены $1,50 / $7,50) и уложиться в пять строк.
| Задание | Уровень | Вход, токенов | Вывод с рассуждением, токенов | За вызов | За 1 000 вызовов |
|---|---|---|---|---|---|
| A, код на Python | low | 85 | 732 | $0,0056 | $5,62 |
| A, код на Python | medium | 85 | 1 169 | $0,0089 | $8,89 |
| A, код на Python | high | 85 | 1 588 | $0,0120 | $12,04 |
| A, код на Python | xhigh | 85 | 6 586 | $0,0495 | $49,52 |
| B, расчёт счёта | low | 118 | 187 | $0,0016 | $1,58 |
| B, расчёт счёта | medium | 118 | 906 | $0,0070 | $6,97 |
| B, расчёт счёта | high | 118 | 651 | $0,0051 | $5,06 |
| B, расчёт счёта | xhigh | 118 | 2 053 | $0,0156 | $15,57 |
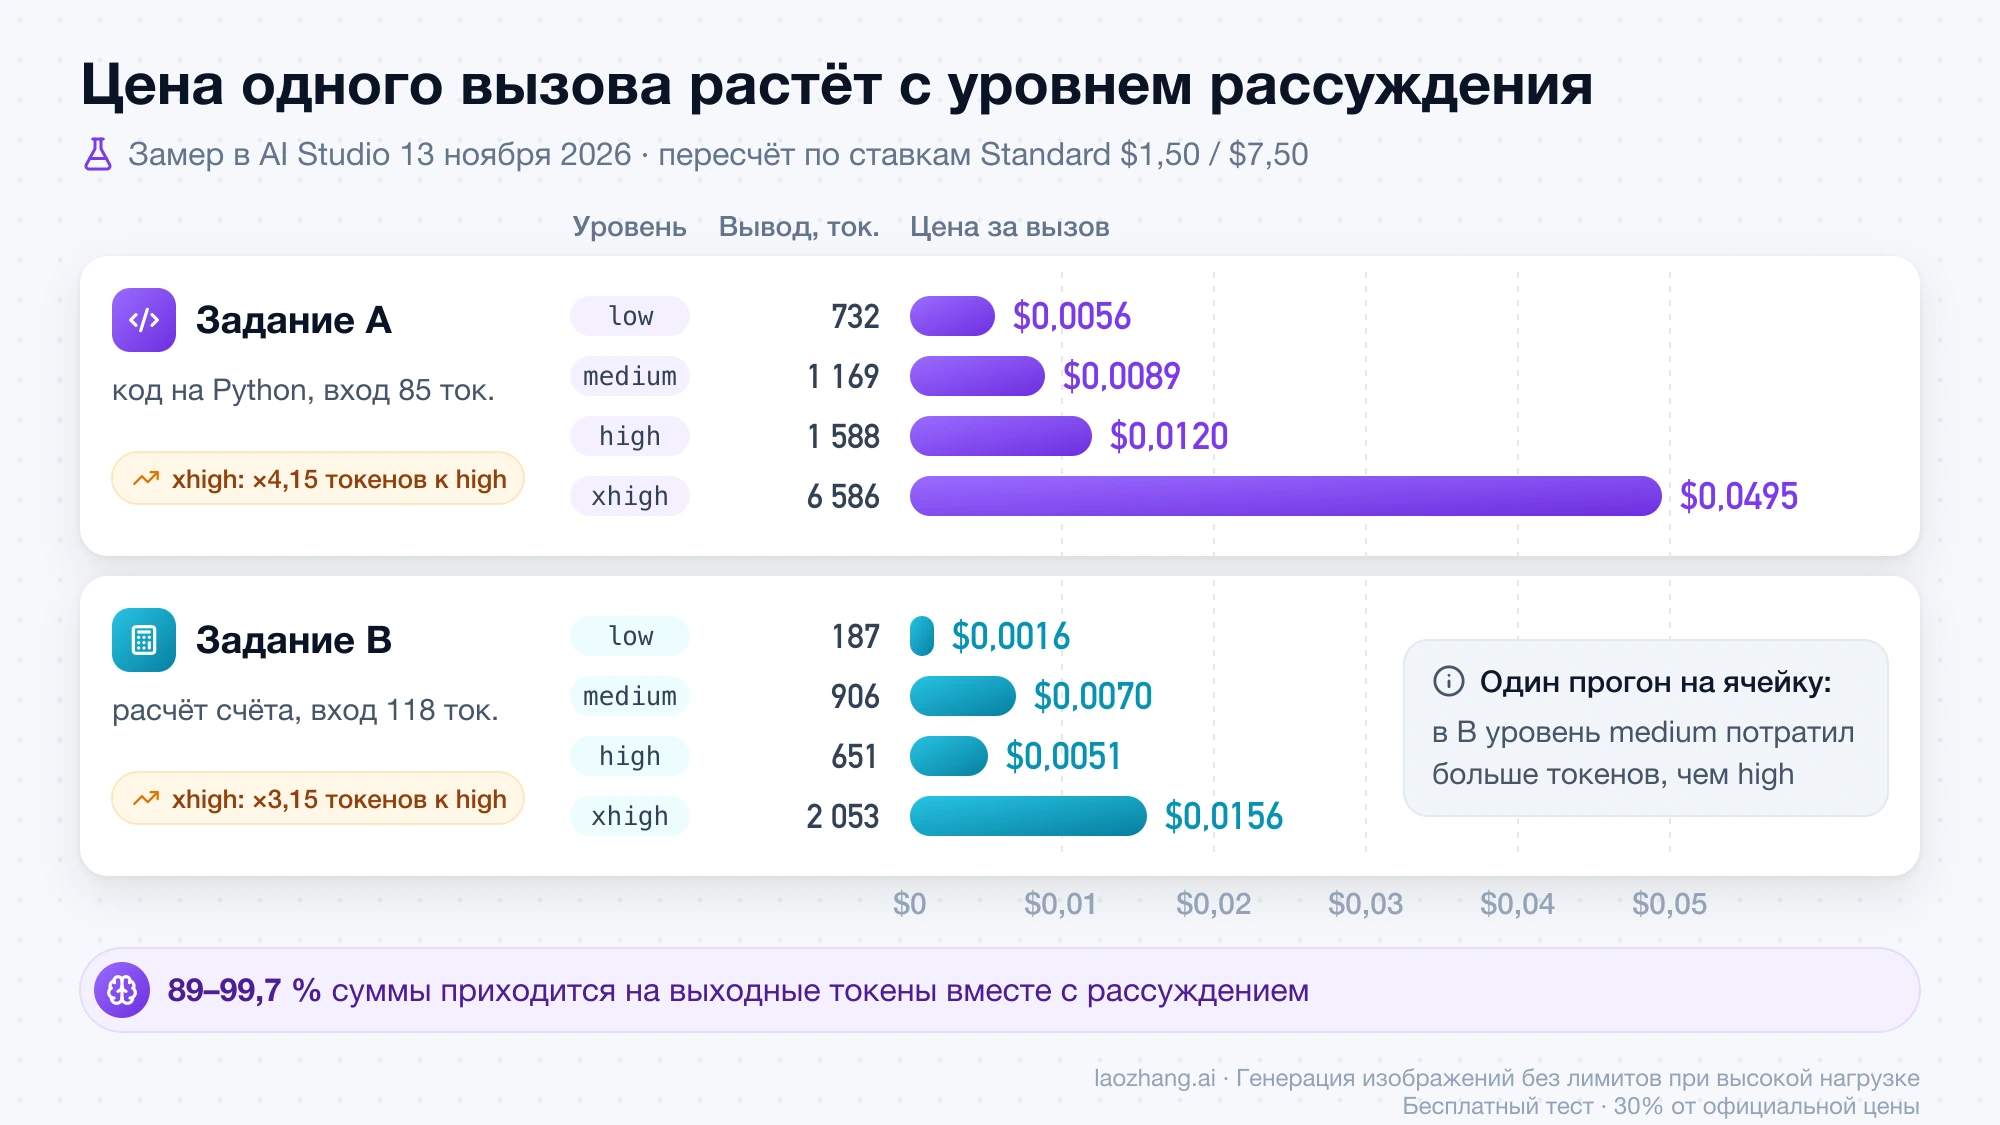
Качество ответа от уровня почти не зависело, а цена зависела сильно. В задании B модель на всех четырёх уровнях дала верный ответ, $2 916 в месяц, причём на low блока рассуждений (Thoughts) не было вовсе. В задании A на каждом уровне получился парсер на регулярных выражениях; код прочитан в интерфейсе, но не запускался, и отличался заметно только вариант xhigh, где шаблон скомпилирован заранее. При этом xhigh выдал в 4,15 раза больше выходных токенов, чем high, в задании A и в 3,15 раза больше в задании B.
У замера есть границы. На каждую ячейку приходится один прогон, поэтому одиночный вызов может нарушить порядок: в задании B уровень medium потратил 906 токенов, а high — 651. Числа взяты из интерфейса AI Studio, а не из счёта API; Google тарифицирует на платном уровне те же токены, включая рассуждение, так что пересчёт по прайсу корректен, но это вывод, а не выставленный счёт. Неявный кэш в этом замере не проверялся, потому что короткие запросы не дотягивают до его порога; данные о нём ниже взяты из документации Google.
Месячный бюджет на Hydrogen: формула и пример на 480 000 запросов
Месячный счёт за Hydrogen на тарифе Standard считается так: число запросов × (входные токены × $1,50 + выходные токены × $7,50) / 1 000 000. Ошибиться легко во второй скобке: выходные токены — это видимый ответ плюс рассуждение, и рассуждение в тексте ответа не видно, его нужно брать из метаданных использования в ответе API или из подсказки Token Usage в AI Studio.
На примере из задания B: 12 000 пользователей по 40 запросов дают 480 000 запросов в месяц. Ввод — 864 млн токенов × $1,50 = $1 296, видимый вывод — 216 млн токенов × $7,50 = $1 620, итого $2 916 в месяц. Каждые 500 токенов рассуждения на запрос добавляют 240 млн выходных токенов, то есть ещё $1 800 в месяц: при 500 токенах счёт становится $4 716, при 2 000 — $10 116, в 3,5 раза больше бюджета, посчитанного по видимому ответу.
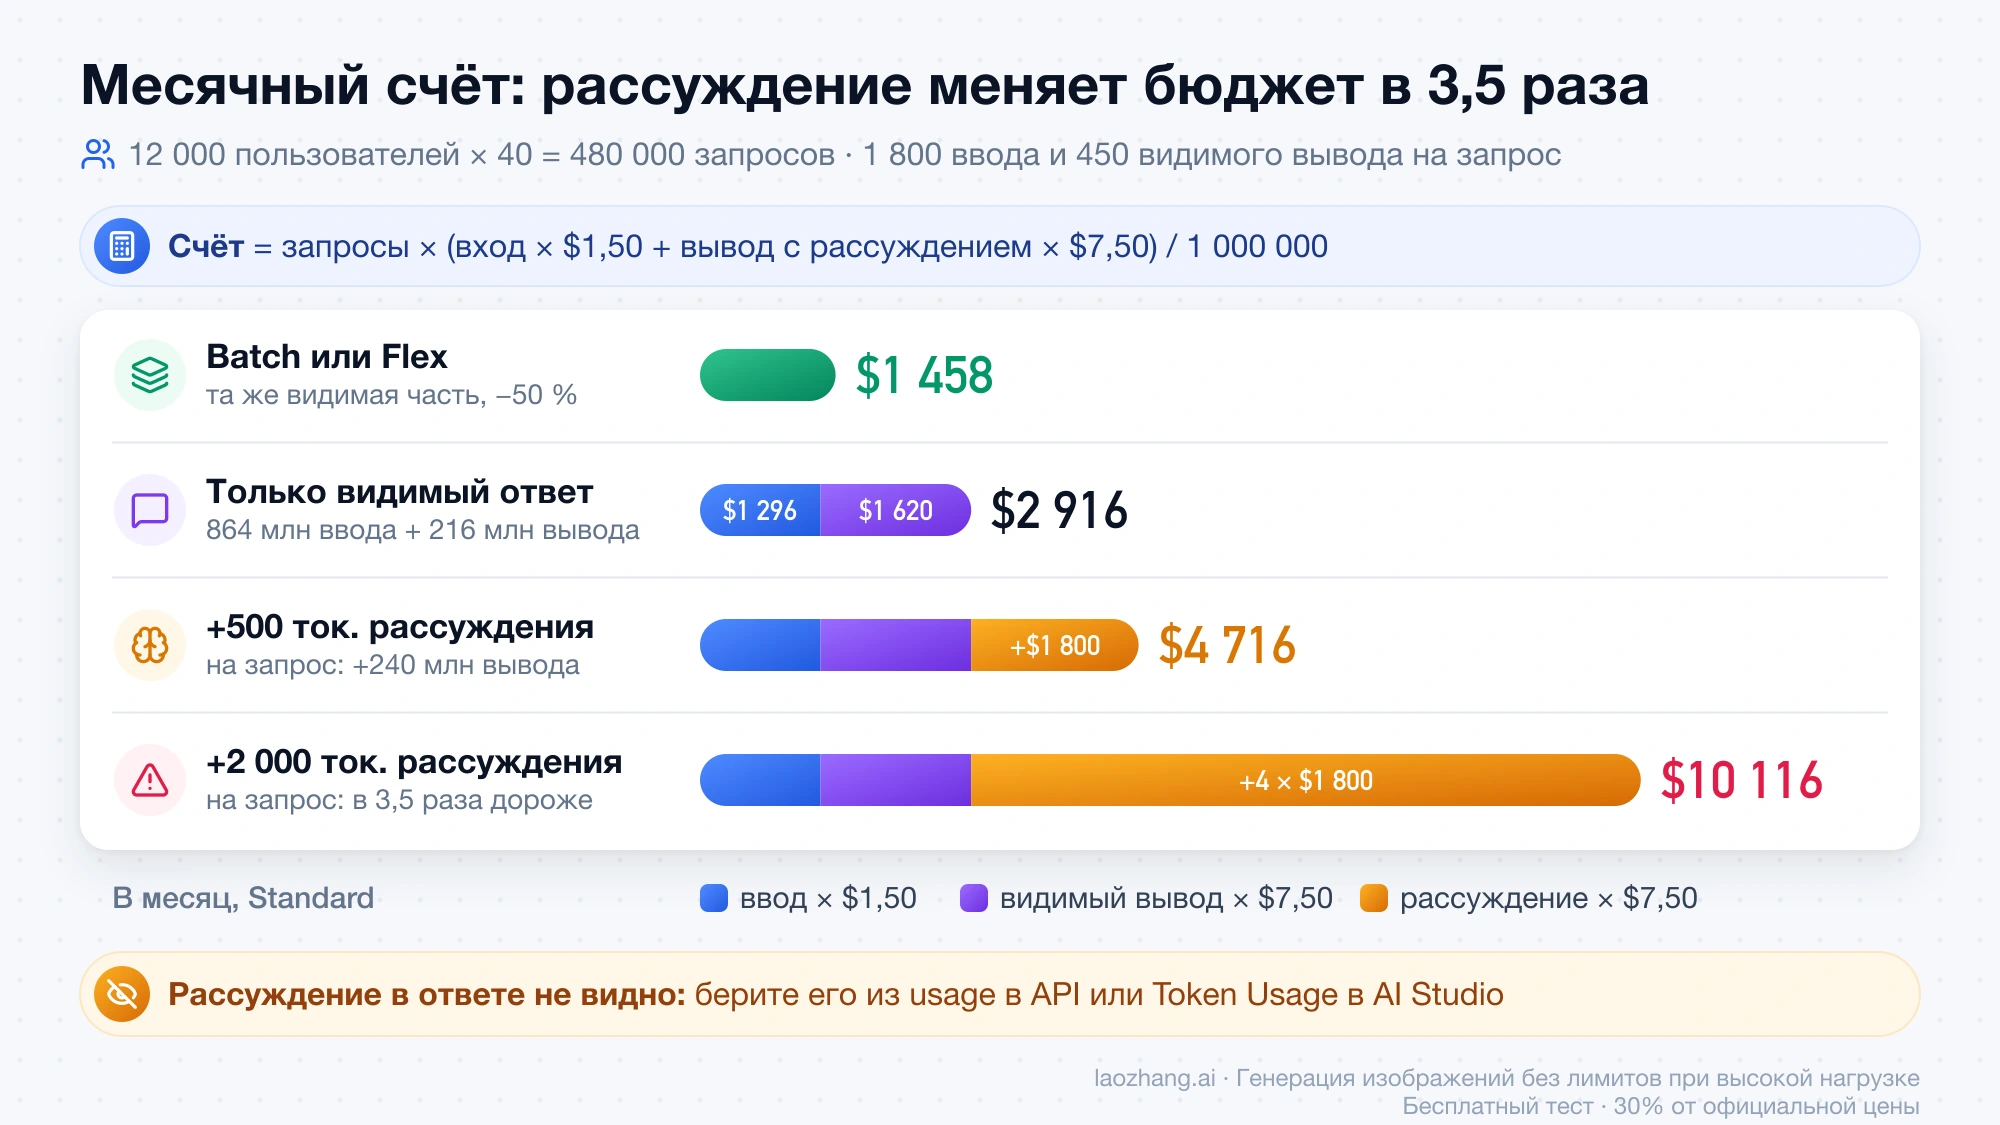
Поэтому бюджет надёжнее строить по выборке собственных реальных запросов на выбранном уровне: средний вывод с рассуждением, умноженный на трафик, ближе к будущему счёту, чем любая оценка по длине ответа. Параметр max_output_tokens ограничивает рассуждение и ответ вместе (по умолчанию 65 536 за синхронный запрос) и годится как страховочный потолок, но не как способ экономии: Google советует не ставить низкие лимиты вроде 8 192, а снижать уровень рассуждения, иначе ответ обрежется посередине. Если задача допускает ожидание, тот же объём через Batch стоит вдвое меньше: $1 458 вместо $2 916 по видимой части.
Какой уровень рассуждения дешевле: low, medium, high или xhigh
Самый дешёвый уровень — low, но выгоднее всего самый низкий уровень, который ещё проходит ваши проверки качества. Именно так советует действовать Google в описании нововведений Gemini 4 Hydrogen: прогнать свои тесты на всех четырёх уровнях с большим max_output_tokens и выбрать минимальный, который устраивает. По умолчанию модель работает на high, и если thinking_level не задан, вы платите за этот уровень.
Сторонние замеры Artificial Analysis (индекс v5.0.1, по состоянию на 13 ноября 2026 года) показывают, как растут оценка и стоимость одного задания из их индекса: low — 27 баллов за $0,29 и 1,3 минуты, medium — 41 балл за $0,80 и 3,7 минуты, high — 51 балл за $1,87 и 8,3 минуты, xhigh — 54 балла за $3,16 и 13,5 минуты. Переход с medium на high добавляет 10 баллов за 2,3 раза большую цену, а с high на xhigh — всего 3 балла за 69 % сверху; на xhigh модель, по оценке AA, особенно многословна.
Правило выбора выходит такое. Для быстрого чата и массовой обработки, где цена и задержка важнее глубины, начинайте с low: в задании B он дал верный ответ за 187 токенов. Для интерактивного программирования и вызовов инструментов, где важна скорость ответа, Google рекомендует medium. Сложный код, агентные сценарии и мультимодальные задачи — область high. На xhigh переходите только для конкретных многошаговых задач, которые high не решил на ваших тестах: Google прямо предупреждает, что на простых запросах этот уровень склонен «передумывать», и в замере выше он стоил в 3–4 раза дороже high без заметного выигрыша в ответе.
Hydrogen, 3.8 Flash, Argon и Carbon: цены сейчас, с 1 декабря и с 1 января
За токен Hydrogen сейчас вдвое дороже Gemini 3.8 Flash и на 25 % дешевле Gemini 4 Argon и Carbon. С 1 декабря 2026 года Argon и Carbon переходят с $2 / $10 на $4 / $20, и Hydrogen стоит уже 37,5 % от их цены, а с 1 января 2027 года заканчивается вводная цена 3.8 Flash, и её ставки сравниваются с Hydrogen.
| Модель, ввод / вывод за 1 млн | До 30 ноября 2026 | 1–31 декабря 2026 | С 1 января 2027 |
|---|---|---|---|
| Gemini 4 Hydrogen | $1,50 / $7,50 | $1,50 / $7,50 | $1,50 / $7,50 |
| Gemini 3.8 Flash | $0,75 / $3,75 | $0,75 / $3,75 | $1,50 / $7,50 |
| Gemini 4 Argon и Carbon | $2 / $10 | $4 / $20 | $4 / $20 |
Если пересчитать токены вызова A на уровне high (85 на входе, 1 588 на выходе) по другим ставкам, Hydrogen всегда стоит $0,0120, 3.8 Flash — $0,0060 до конца года и $0,0120 с января, Argon и Carbon — $0,016 до 30 ноября и $0,0321 с 1 декабря. Это сравнение только ставок: другие модели на том же задании потратили бы другое число токенов.
Реальное число токенов меняет картину сильнее, чем прайс. По замерам Artificial Analysis одно задание индекса на уровне high обходится Hydrogen в $1,87, а 3.8 Flash — в $7,77 даже по нынешней половинной цене Flash, при оценке 31 балл против 51 у Hydrogen; с января, когда ставки Flash удвоятся, эта разница вырастет вдвое. Для типичных нагрузок Hydrogen поэтому может оказаться дешевле Flash уже сейчас, хотя за токен дороже. С Argon и Carbon Hydrogen выигрывает и по ставке за токен, и, по данным анонса Google, по индексу AA: на уровне high у Hydrogen 51 балл, у Argon 50. Где старшие модели всё же сильнее на ваших задачах, покажут только собственные тесты. Замеры Argon и Flash по уровням собраны в статье «Gemini 4 Argon vs 3.8 Flash: сравнение, тест цены и что выбрать», сравнение двух старших моделей — в «Gemini 4 Carbon vs Argon: где Carbon сильнее и цена задачи».
Что изменится в счёте при переходе с Gemini 3.8 Flash
Код, перенесённый с 3.8 Flash без правок, на Hydrogen почти наверняка будет думать дольше, потому что уровень по умолчанию у Flash — medium, а у Hydrogen — high. Если нужен прежний баланс, задайте thinking_level: "medium" явно; значение minimal, если оно осталось в коде от более старых моделей (3.6 Flash, 3.5 Flash-Lite; у 3.8 Flash его и так нет), Hydrogen отклоняет с ошибкой, так что его придётся заменить на low. Параметры temperature, top_p и top_k сервер теперь игнорирует.
Второе изменение касается кэша. Явное кэширование (cachedContents, caches.create) Hydrogen не поддерживает, поля cached_content нужно убрать из запросов. Вместо него работает неявный кэш: он включается сам на запросах от 4 096 токенов и при попадании даёт скидку 95 % на кэшированные входные токены, то есть $0,075 вместо $1,50 за 1 млн. Строки за хранение кэша, как у явного кэша Flash ($0,50 за 1 млн токенов в час, с 2027 года $1,00), в прайсе Hydrogen нет, но и управлять попаданиями напрямую уже нельзя. Наконец, ввод, рассуждение и вывод теперь делят одно окно в 1 048 576 токенов, а жёстко заданные низкие лимиты max_output_tokens Google советует убрать или поднять до 65 536.
Где счёт растёт незаметно: поиск Google, кэш в Vertex и ответы длиннее 32K
Помимо токенов, на счёт Hydrogen влияют три правила, которые легко пропустить при расчёте бюджета:
- Поиск Google как источник ответа (Grounding with Google Search) на платном уровне бесплатен до 5 000 поисковых запросов в месяц, причём этот лимит общий для всех моделей Gemini 3 и новее; дальше каждые 1 000 запросов стоят $14, а в сутки допускается не больше 1 500. Один вызов модели может породить несколько поисковых запросов, и оплачивается каждый из них. На бесплатном уровне поиск недоступен.
- В Vertex AI с 12 января 2027 года начнёт оплачиваться запись в кэш: $1,875 за 1 млн токенов на глобальном эндпоинте и $2,0625 на региональном. На странице цен Gemini Developer API такой строки нет.
- В Vertex AI с 13 ноября 2026 года ответ длиннее 32K токенов оплачивается по фактически полученным токенам, даже если запрос завершился ошибкой из-за таймаута клиента или сервера; в остальных случаях Vertex берёт деньги только за успешные ответы с кодом 200. Для длинной генерации это значит, что слишком короткий таймаут на клиенте стоит денег без результата.
Бесплатный доступ к Gemini 4 Hydrogen и где смотреть лимиты
Hydrogen доступна бесплатно: она есть в бесплатном уровне Gemini API и в бесплатном плане Google AI Studio, где ввод, вывод и кэш не тарифицируются. Плата за это — данные: на бесплатном уровне Google использует запросы для улучшения своих продуктов, а на платном нет. Кроме того, бесплатно недоступны Batch, Flex и поиск Google, поэтому для рабочего сервиса с пользовательскими данными бесплатный уровень не подходит. Что ещё входит в бесплатный доступ и для каких моделей, описано в статье «Gemini API Free Tier 2026: ключ бесплатно, какие модели и лимиты».
Таблицы RPM и RPD для бесплатного уровня Hydrogen Google не публикует: лимиты привязаны к проекту, а не к ключу, суточный счётчик сбрасывается в полночь по тихоокеанскому времени, а действующие значения для своего проекта видны на странице лимитов в AI Studio (aistudio.google.com/rate-limit), если проект Google Cloud подключён к AI Studio. Цифры, которые встречаются для Flash, к Hydrogen не относятся. На платном уровне есть ещё ограничение расходов за 10 минут — $10 на Tier 1 и $200 на Tier 2 и Tier 3, после чего API возвращает 429 RESOURCE_EXHAUSTED; подробнее об уровнях — в статье «Лимиты Gemini API: где смотреть, уровни Tier 1–3 и ошибки 429». В приложении Gemini, по словам Google, Hydrogen доступна всем в выборе модели, но подписки приложения к оплате API отношения не имеют.
Источники3
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 13 нояб. 2026 г..
Источники3
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 13 нояб. 2026 г..