Gemini 3.8 Flash TTS API: модель, цена за минуту и первый запрос
Flash-Lite TTS заменяет 3.1 preview примерно за $0,54 в час аудио, Flash TTS — $0,81; с 2027 года цены удваиваются. Ниже рабочий запрос, стриминг и миграция.
Содержание
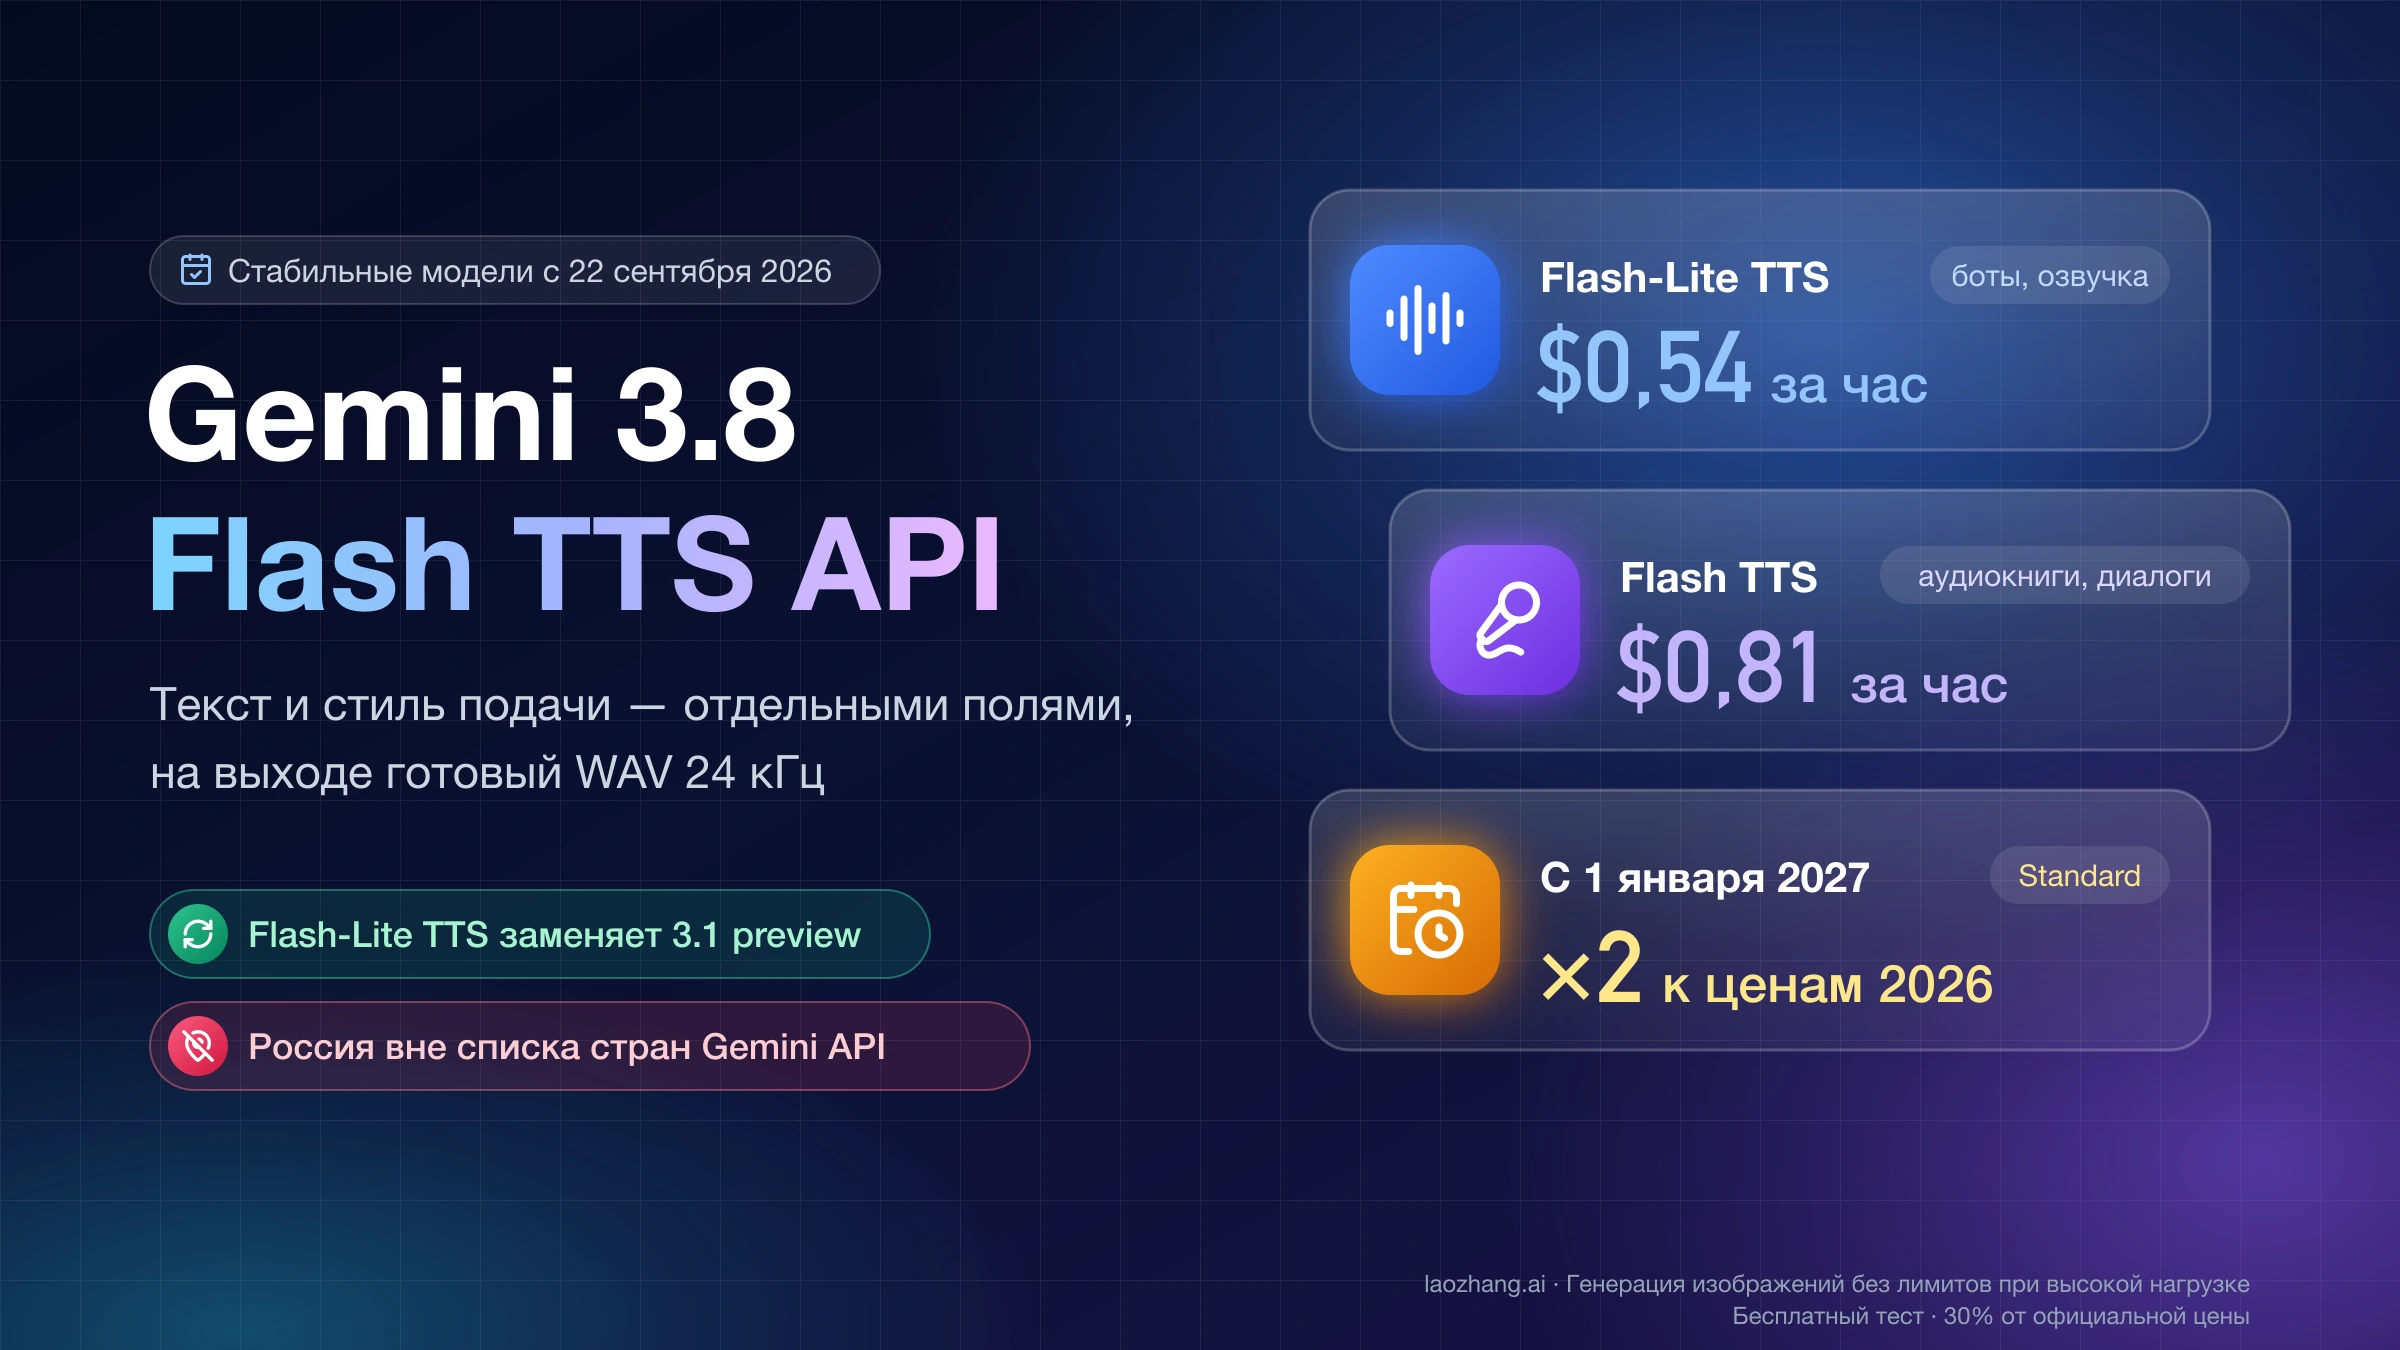
Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) и Gemini 3.8 Flash-Lite TTS (gemini-3.8-flash-lite-tts) стали стабильными моделями Gemini API 22 сентября 2026 года по журналу изменений; публичный анонс в блоге Google вышел 23 сентября. Это модели «текст на входе, аудио на выходе»: они читают ровно тот текст, который вы передали, а стиль подачи задаётся отдельным полем. Для большинства задач ответ на вопрос «какую брать» короткий: Flash-Lite TTS — замена gemini-3.1-flash-tts-preview для озвучки, голосовых ботов и функции «прочитать вслух»; Flash TTS — для аудиокниг, сцен с двумя актёрами и сложной актёрской подачи. Обе вызываются одним и тем же запросом, поэтому переключиться можно заменой одной строки.
Стоимость считается от токенов аудио по официальному правилу «25 токенов на секунду»: час озвучки в стандартном режиме стоит около $0,54 на Flash-Lite и $0,81 на Flash по тарифу до конца 2026 года, а с 1 января 2027 года эти суммы удваиваются. Формула и таблица по режимам — ниже. Код повторяет форму официальных примеров Google и рассчитан на проверку в вашем проекте; замеров задержки и субъективного качества звучания в нём нет.
Для читателя из России есть отдельное условие: Россия не входит в список стран, где доступны Gemini API и Google AI Studio, и это не зависит от языка текста, который вы озвучиваете. Как это влияет на оплату и получение ключа — в разделе про доступ.
Какую модель брать: правило выбора
Обе модели поддерживают одиночного спикера, диалог на два голоса, Voice design и Voice replication, принимают до 8 192 входных токенов и автоматически определяют язык текста; русский есть в списках обеих. Разница — в задачах, под которые они настроены, и в цене:
| Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS | |
|---|---|---|
| ID модели | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| Позиционирование Google | флагман для творческих задач: максимальная точность тембра, актёрская нюансировка, региональные акценты | быстрая и дешёвая рабочая лошадка: массовая генерация, низкая задержка |
| Для чего рекомендована | аудиокниги, студийная озвучка, сложные диалоги на два голоса, обилие смеха/вздохов, трудное произношение, диалекты | голосовые агенты и боты поддержки, «прочитать вслух», массовый дубляж, репликация голоса, бытовая озвучка одним голосом |
| Языков | более 130 | 101 |
| Кого заменяет | новый творческий уровень | официальная замена gemini-3.1-flash-tts-preview |
| Стандартный тариф 2026, выход | $9,00 за 1 млн токенов аудио ($0,81 в час) | $6,00 за 1 млн токенов ($0,54 в час) |
Практическое правило из руководства разработчика Google: по умолчанию берите Flash-Lite TTS как замену 3.1 preview и переходите на Flash TTS, когда нужна студийная актёрская подача, диалог с перебиваниями и поддакиваниями, работа с диалектом или длинное повествование без «дрейфа» голоса. Приём с наложенными реакциями (|реакция| в тексте одного спикера) работает лучше именно на Flash TTS.
Google приводит и собственные цифры качества: Flash TTS занимает первое место в Voice Design Benchmark от Hume AI (71,4 балла), Flash TTS и Flash-Lite — первые два места в их же Overall Quality Index. В слепых сравнениях на Voice Arena модели вошли в топ по японскому, бразильскому португальскому, вьетнамскому, арабскому (MSA), мексиканскому испанскому и хинди. Русский в этом перечне не назван — это не оценка качества, а просто отсутствие выделенного результата. Все цифры — из анонса Google, независимой проверки они не проходили.
Когда TTS не подходит вовсе: если вам нужен разговор в реальном времени, где пользователь говорит голосом, а модель отвечает голосом и её можно перебить, это задача Live API, а не TTS. У TTS-моделей Live API не поддерживается, равно как function calling, структурированный вывод, поиск и «мышление». Подробности двунаправленного режима — в статье Gemini 3.1 Flash Live API: model ID, цена и быстрый старт. Обратная задача, распознавание речи, закрыта отдельной моделью: Gemini 3.5 Transcribe API.
Первый запрос: один голос, WAV на диск
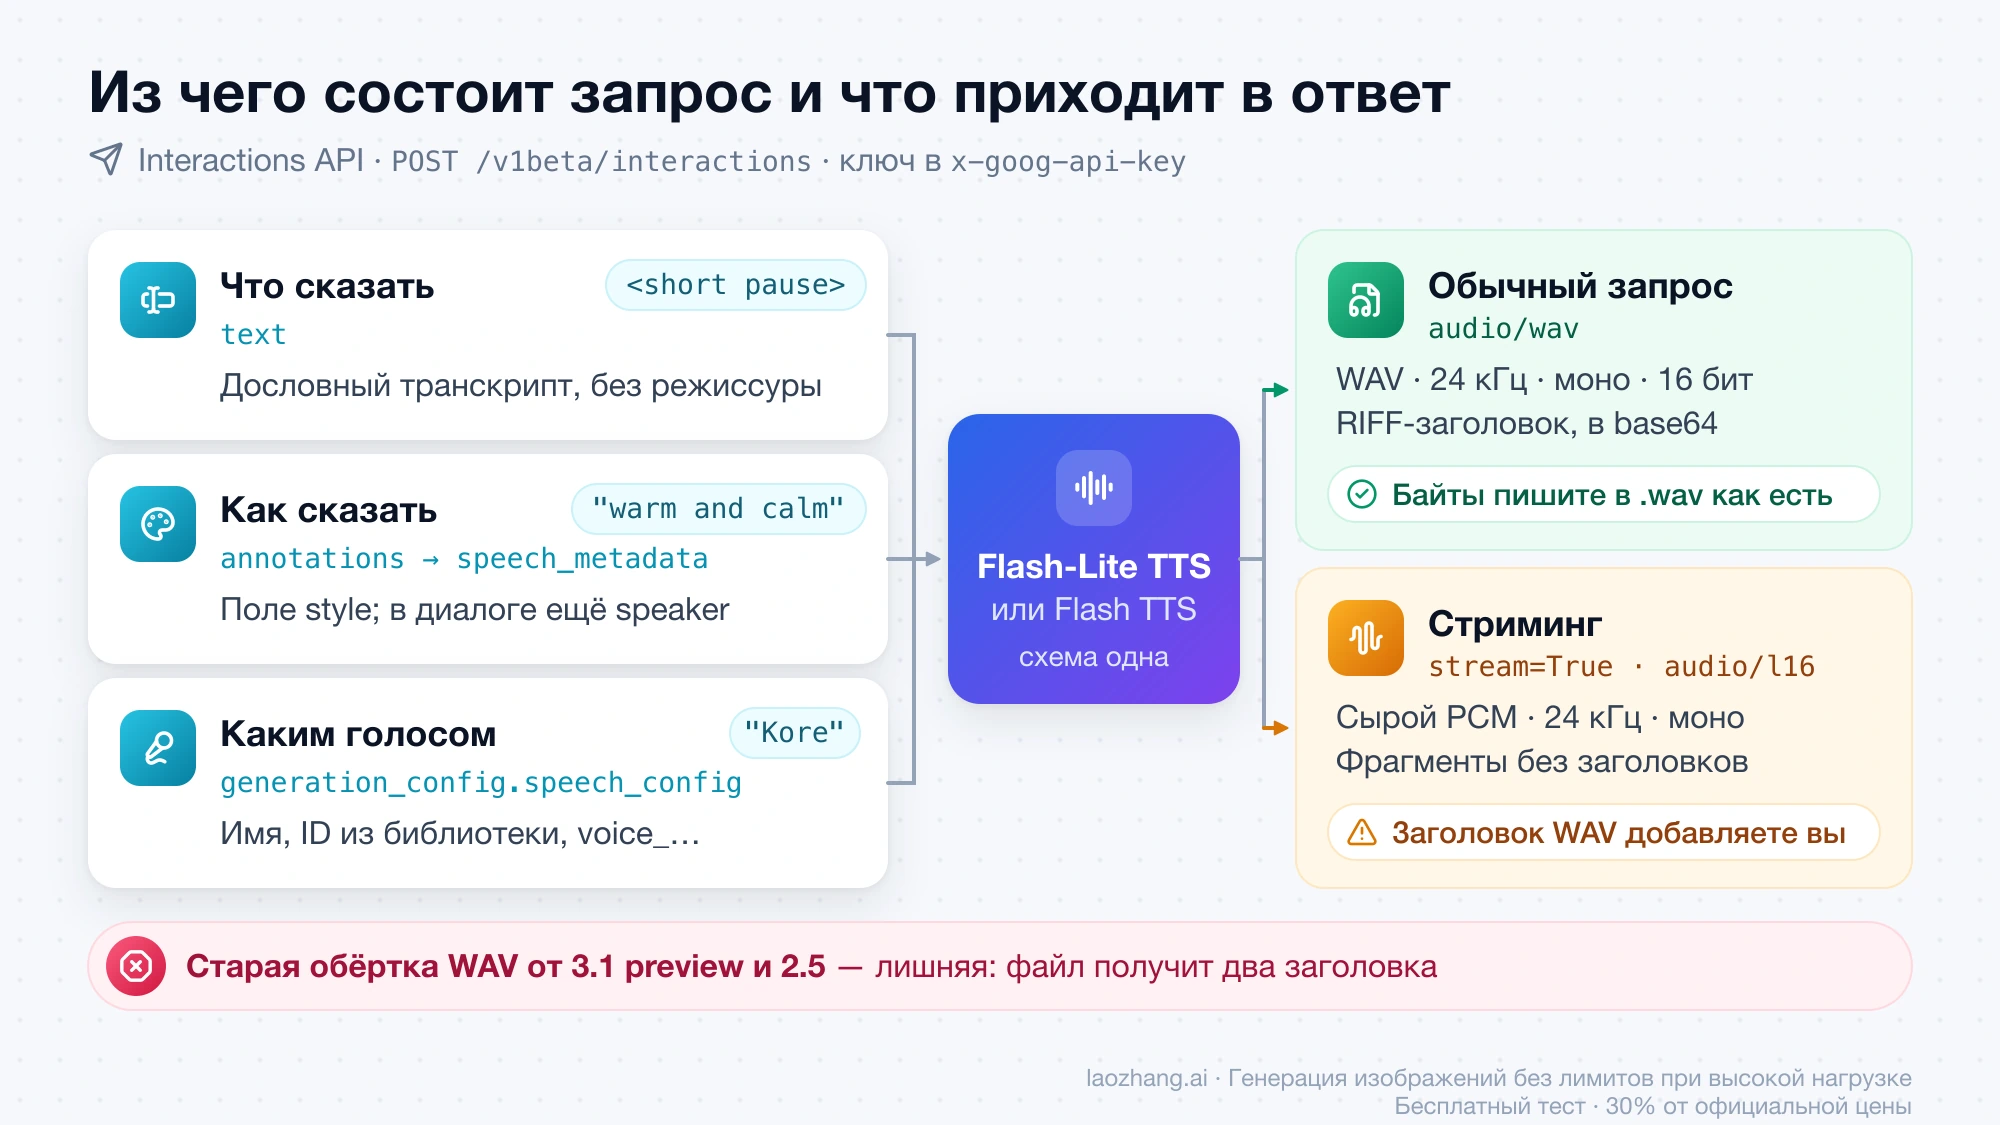
Запросы идут через Interactions API (POST https://generativelanguage.googleapis.com/v1beta/interactions, ключ в заголовке x-goog-api-key). Три части запроса, которые нужно понимать:
text— дословный транскрипт. Модель произнесёт всё, что там написано, кроме тегов в угловых скобках и реакций между вертикальными чертами. Режиссёрских указаний в текст не пишите.annotationsсtype: "speech_metadata"— стиль подачи (style) и, для диалогов, имя спикера (speaker).generation_config.speech_config— какой голос: предустановленное имя вродеKore, ID из расширенной библиотеки,voice_...из Voice design или репликации либоvoicekey_....
Python (SDK google-genai; ключ берётся из переменной окружения GEMINI_API_KEY):
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-lite-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Добрый день! <short pause> Сегодня разберём, как работает синтез речи.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and calm",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": "Kore"},
        ]
    },
)

with open("out.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
То же через REST:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.8-flash-lite-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Добрый день! <short pause> Сегодня разберём, как работает синтез речи.",
        "annotations": [{ "type": "speech_metadata", "style": "warm and calm" }]
      }]
    }],
    "response_format": { "type": "audio" },
    "generation_config": { "speech_config": [ { "voice": "Kore" } ] }
  }' | jq -r '[.steps[] | select(.type=="model_output") | .content[] | select(.type=="audio")] | last | .data' \
  | base64 --decode > out.wav
Что приходит в ответ. Для обычного (не потокового) запроса — готовый WAV: 24 кГц, моно, 16-битный PCM с RIFF-заголовком, закодированный в base64. В Python и JavaScript SDK его отдаёт свойство interaction.output_audio (последний аудиоблок ответа); в сыром JSON он лежит в steps[].content[].data. Байты после декодирования пишутся в .wav как есть — никакой заголовок добавлять не нужно. Это главное отличие от 3.1 preview и 2.5, которые по умолчанию возвращали «голый» PCM; если оставить старую обёртку, файл получит два заголовка.
Теги в угловых скобках (пауза, вздох, смех) остаются английскими и для русского текста — это прямое указание документации. Для поля style примеров на других языках Google не даёт; надёжнее писать и его по-английски, как в примерах выше. Официальный JavaScript-пример на @google/genai повторяет ту же структуру один в один (client.interactions.create, затем Buffer.from(interaction.output_audio.data, 'base64')), так что переносится с Python без изменений структуры. А вот Go-примеры на странице документации по состоянию на 30 сентября 2026 года всё ещё написаны под gemini-3.1-flash-tts-preview с инструкцией «Say cheerfully:» прямо в тексте и ручной сборкой WAV-заголовка — для 3.8 их копировать нельзя, адаптируйте от REST-формы.
Диалог на два голоса в одном запросе
Для подкаста или сцены с двумя персонажами в speech_config передаётся объект с mode: "conversational" и списком speakers, а каждая реплика идёт отдельным элементом content с обязательным speaker в speech_metadata:
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [
            {
                "type": "text",
                "text": "Ну что, ты дослушал вчерашний выпуск? |ага| Там же в конце самое интересное.",
                "annotations": [{
                    "type": "speech_metadata",
                    "speaker": "Anna",
                    "style": "cheerful and friendly",
                }],
            },
            {
                "type": "text",
                "text": "<chuckle> Дослушал. Честно говоря, не ожидал такого финала.",
                "annotations": [{
                    "type": "speech_metadata",
                    "speaker": "Ivan",
                    "style": "calm and relaxed",
                }],
            },
        ],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": {
            "mode": "conversational",
            "speakers": [
                {"speaker": "Anna", "voice": "Aoede"},
                {"speaker": "Ivan", "voice": "Puck"},
            ],
        }
    },
)

with open("dialog.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
Три ограничения, которые здесь важны:
- В одном запросе не больше двух спикеров, и только с предустановленными голосами. Голоса из Voice design или репликации в
speakersне передаются. speakerобязателен в каждой реплике и должен совпадать с одним из настроенных имён. Реплика без спикера — ошибка схемы, а старый приём «Speaker 1: текст» внутри строки теперь будет прочитан вслух.- Реакции слушателя пишутся между вертикальными чертами внутри реплики говорящего — 1–3 слова (
|ага|,|правда?|,|подожди|); второй голос произносит их фоном, не прерывая первого. Несколько таких вставок в одной строке дают наложение речи, например хоровой отсчёт. Документация отмечает, что это работает лучше на Flash TTS.
Если вам нужен диалог собственных голосов, каждая реплика синтезируется отдельным запросом, а потом склеивается. Поскольку обычный ответ — WAV с 44-байтовым заголовком, запросите сырой PCM ("response_format": {"type": "audio", "mime_type": "audio/l16"}) или отрежьте первые 44 байта каждого фрагмента перед конкатенацией кадров 24 кГц. В Python это выглядит так:
import wave

chunks = [b1, b2, b3]  # сырые PCM-байты каждой реплики (audio/l16, 24 кГц, моно)

with wave.open("dialog.wav", "wb") as w:
    w.setnchannels(1)
    w.setsampwidth(2)
    w.setframerate(24000)
    w.writeframes(b"".join(chunks))
Стриминг: что приходит и как отдать в плеер
Для голосового агента, где первые слова должны звучать до конца генерации, добавьте stream=True. Здесь формат по умолчанию другой: вместо WAV приходят фрагменты «голого» 16-битного PCM (audio/l16, 24 кГц, моно) без заголовков, чтобы их можно было играть и склеивать непрерывно:
import base64
from google import genai

client = genai.Client()

stream = client.interactions.create(
    model="gemini-3.8-flash-lite-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Заказ принят. Курьер будет у вас примерно через сорок минут.",
            "annotations": [{"type": "speech_metadata", "style": "polite and clear"}],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={"speech_config": [{"voice": "Charon"}]},
    stream=True,
)

with open("out.pcm", "wb") as f:
    for event in stream:
        if event.event_type == "step.delta" and event.delta.type == "audio":
            f.write(base64.b64decode(event.delta.data))
Каждый фрагмент — событие step.delta с delta.type == "audio" и base64 в delta.data. Что с ним делать дальше:
- Проиграть на месте. Сырому PCM нужно сообщить параметры: например,
ffplay -f s16le -ar 24000 -ac 1 out.pcm. Веб-плеер через Web Audio API получает те же 24 000 Гц, один канал, знаковые 16-битные сэмплы. - Сохранить в файл. Соберите фрагменты в WAV через
wave, как в примере выше, — это единственный случай в 3.8, когда заголовок добавляете вы. - Отдать в телефонию. Через
response_format.mime_typeдоступныaudio/mulaw(8-битный G.711 μ-law, североамериканская и японская телефония/IVR) иaudio/alaw(европейская телефония); частоту дискретизации задаётsample_rate— 24000, 16000 или 8000.
| Формат | mime_type | Когда по умолчанию | Что внутри |
|---|---|---|---|
| WAV | audio/wav | обычный запрос | 16-бит PCM, моно, 24 кГц, RIFF-заголовок |
| Сырой PCM | audio/l16 | стриминг | те же сэмплы без заголовка |
| μ-law | audio/mulaw | только по запросу | 8-бит G.711 |
| A-law | audio/alaw | только по запросу | 8-бит G.711 |
Для агентов Google советует делать один TTS-запрос на каждую реплику по мере прихода текста от языковой модели, оставлять style пустым или одной короткой постоянной строкой на весь разговор и не пересылать описание персонажа в каждом запросе — личность голоса должен нести сам выбранный голос.
Как управлять подачей: style, теги и паузы
Правило разделения простое: то, что длится всю реплику, идёт в speech_metadata.style; то, что случается в конкретной точке, — тегом внутри текста.
| Что нужно | Куда писать | Примеры |
|---|---|---|
| Эмоция, темп, громкость, манера на всю реплику | style | "whispered urgently", "speaking slowly", "sarcastic", "out of breath" |
| Смех, вздох, кашель, пауза в конкретном месте | тег в тексте | смех, вздох, короткая и длинная пауза |
| Логическое ударение | ЗАГЛАВНЫЕ буквы слова | «Это ОЧЕНЬ важный момент!» |
| Сложное имя или термин | транскрипция МФА между косыми чертами | /niːv/ |
Пример русской реплики с тегами — теги остаются английскими:
Так... <short pause> давайте посмотрим ещё раз. <sigh> Кажется, я знаю, где ошибка.Рекомендуемый список тегов в документации: дыхание (breath, heavy breath, exhales, pant, sigh), смех (laugh, chuckle, giggle, snicker, cackle), реакции (gasp, cough, sneeze, throat-clearing, snort, tsk, argh), звуки (sob, cry, whimper, groan, growl, yawn, scream, shout), паузы (short pause, long pause). Звуковые эффекты вроде аплодисментов или ударов тегами не описываются — только человеческие звуки. Паузы также задаются пунктуацией: многоточия и тире дают естественные заминки.
Что не работает или вредит по документации Google:
- Длинные описания персонажа в
style(«Audio Profile», «Director's Notes» из эпохи 3.1) — названы самой частой причиной дрейфа голоса. Персонаж создаётся один раз через Voice design, аstyleостаётся коротким или пустым. - Мета-инструкции вроде «не меняй тембр», «держи голос ровно» — увеличивают дрейф, а не уменьшают.
- Возраст, пол, имя, постоянный акцент в
style— это свойства голоса, а не реплики; их задают выбором голоса из библиотеки или в Voice design. - Смена эмоции посередине реплики — делится на несколько частей
contentс разнымиstyleдля одного и того же спикера.
Порядок работы, который советует руководство: сначала синтезируйте текст с пустым style (большинству реплик режиссура не нужна — модель читает пунктуацию и контекст), затем добавляйте короткие подсказки только тем репликам, где нужно изменить подачу, и переиспользуйте одну и ту же строку для одинаковой манеры. Самый естественный результат даёт текст, написанный как реальная устная речь, с заминками и «э-э… ну, в общем».
Голоса: предустановленные, библиотека, Voice design и репликация
Четыре способа выбрать голос, и все четыре принимают обе модели:
- 30 предустановленных студийных голосов —
Zephyr,Puck,Charon,Kore,Fenrir,Leda,Orus,Aoede,Callirrhoe,Autonoe,Enceladus,Iapetus,Umbriel,Algieba,Despina,Erinome,Algenib,Rasalgethi,Laomedeia,Achernar,Alnilam,Schedar,Gacrux,Pulcherrima,Achird,Zubenelgenubi,Vindemiatrix,Sadachbia,Sadaltager,Sulafat. У каждого в документации одно слово характера: Kore — «твёрдый», Puck — «бодрый», Charon — «информативный», Sulafat — «тёплый». - Расширенная библиотека голосов (Extended Voice Library) — запрашивается через
client.voices.list()илиGET /v1beta/voicesс фильтрамиlanguage_code,region_code,accent,gender,pitch,persona,contexts,typeи текстовымsearch; по умолчанию 50 записей на страницу, максимум 1 000. В анонсе библиотека названа «2 000+ голосов», в журнале изменений — «150+ предустановленных и пользовательских»; точное число лучше не закладывать в продукт, а проверить фильтром по нужному языку. Нужны SDKgoogle-genai2.25.0+ или@google/genai2.24.0+. - Voice design — голос по текстовому описанию:
client.voices.create(store=True, voice={"model": "gemini-3.8-flash-tts", "type": "prompted", "display_name": ..., "gender": ..., "language_code": ..., "prompted": {"input": "описание"}}). В ответ приходят постоянныйvoice_...и пробныйsample_audio(WAV в base64), чтобы сразу прослушать. Описывайте, кто говорит — возраст, тембр, высоту, акцент, ритм, — а не сиюминутную эмоцию. - Voice replication (в разговорном языке «клонирование голоса») —
type: "replicated"с двумя записями одного взрослого человека:source_audio— 10–30 секунд чистой речи,consent_audio— тот же голос произносит дословную фразу согласия на одном из 30 поддерживаемых языков. Для русского фраза есть, локальru-RU:
Я являюсь владельцем этого голоса и даю согласие Google на использование этого голоса для создания модели синтетического голоса.
Обе записи желательно делать на одном микрофоне в одной комнате и привести к WAV 24 кГц моно 16 бит — иначе проверка совпадения голоса может не пройти. Всё аудио, сгенерированное моделями Gemini, несёт водяной знак SynthID.
Квоты на пользовательские голоса: 200 сохранённых голосов на проект (store=True, общий счётчик для Voice design и репликации) со сроком хранения 1 год; репликация с store=False возвращает самодостаточный ключ voicekey_..., который хранится у вас и живёт 7 дней. В speech_config любой из этих идентификаторов передаётся так же, как имя предустановленного голоса.
Одна оговорка из анонса: репликация голоса через интерфейс AI Studio недоступна в Иллинойсе, Техасе, ЕЭЗ, Великобритании, Швейцарии и Индии. Про путь через API в этой сноске ничего не сказано.
Сколько это стоит: от токенов к минутам и часам
Google тарифицирует TTS за токены, а не за символы или минуты, и даёт правило пересчёта в сноске к прайс-листу: 25 токенов аудио на секунду. Отсюда:
- 1 минута аудио = 1 500 токенов выхода;
- 1 час = 90 000 токенов;
- стоимость часа = 90 000 × цена за 1 млн токенов / 1 000 000, то есть цена за миллион, делённая примерно на 11,1.
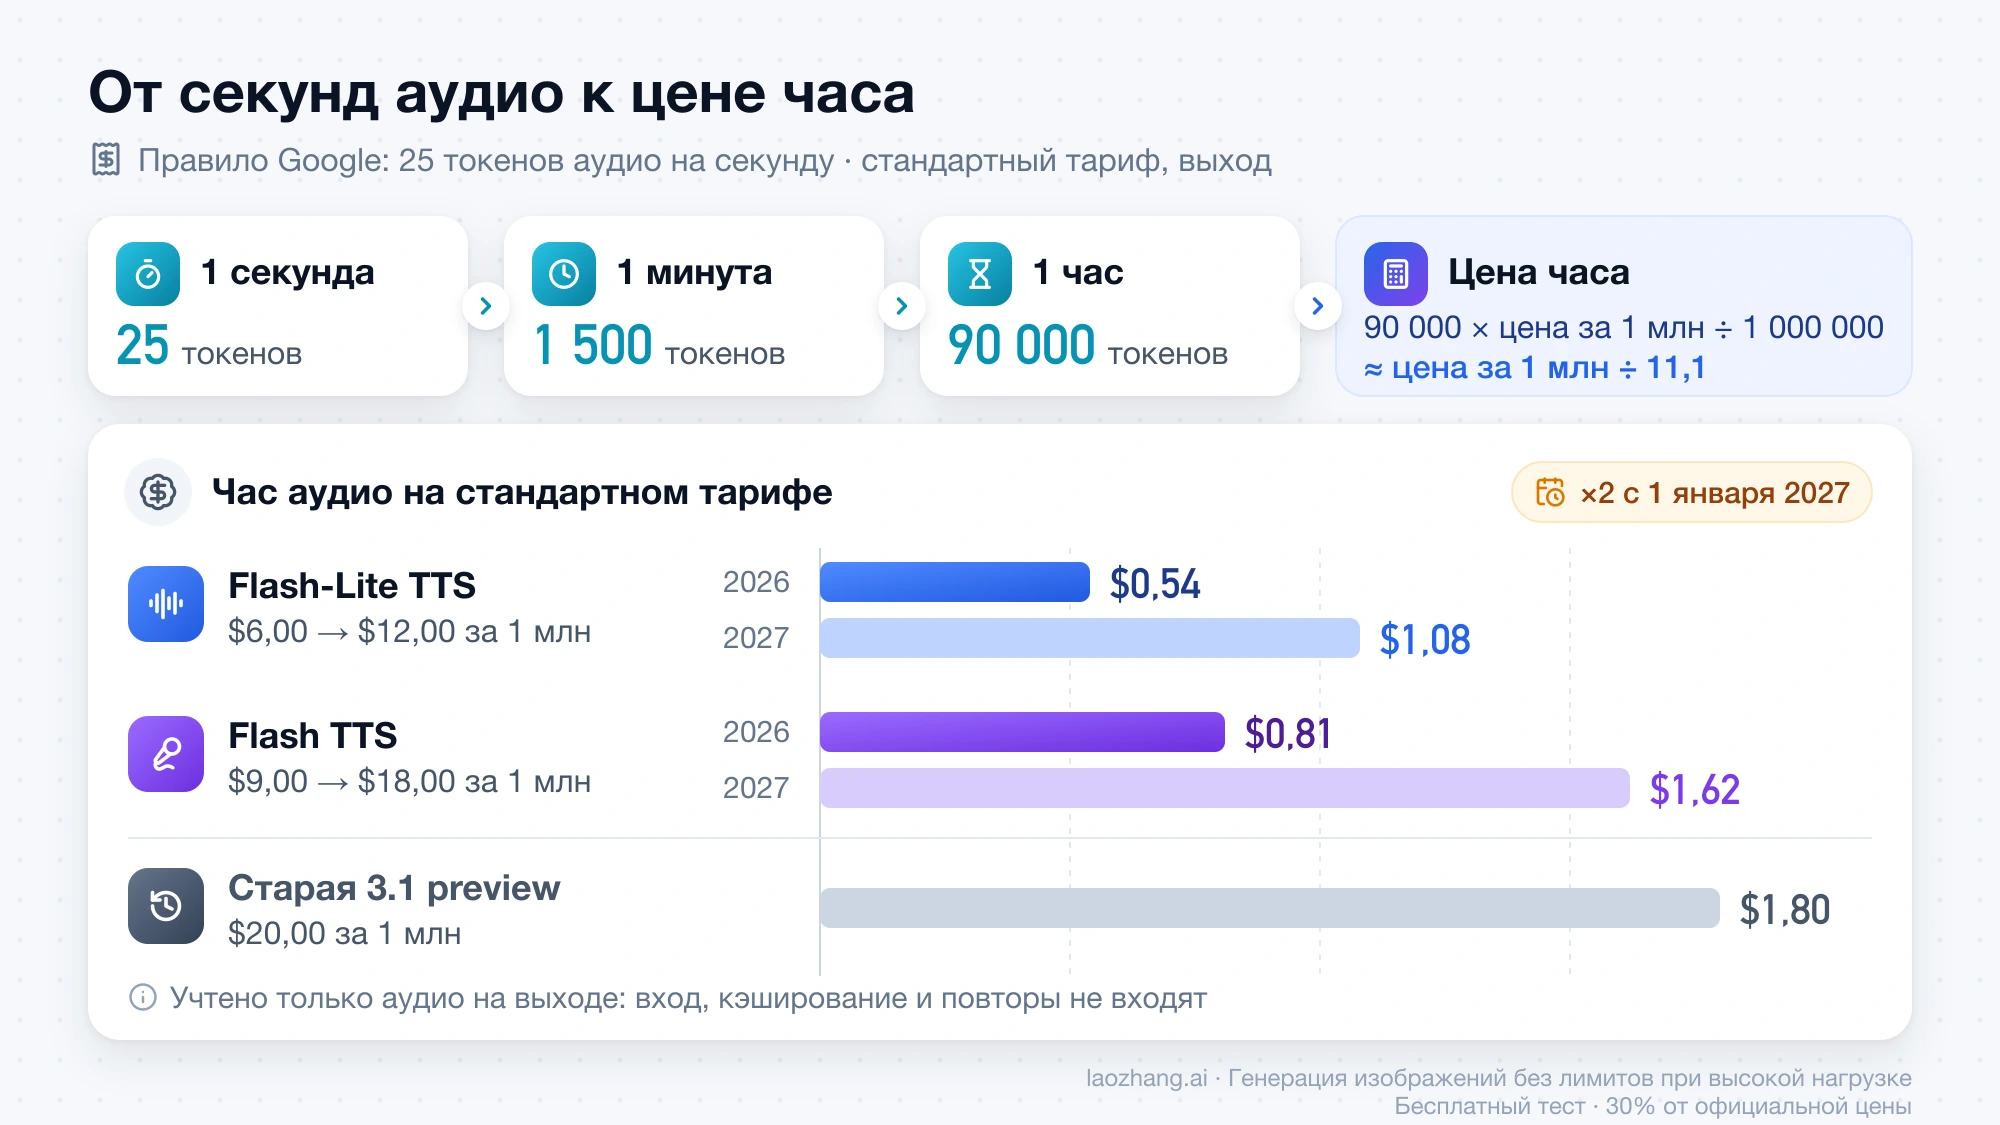
Текст на входе тарифицируется отдельно, но при $0,50 за миллион токенов это копейки: минута речи — это порядка 150–200 токенов текста, около $0,0001, часовая аудиокнига добавит меньше цента. В расчётах ниже учтено только аудио; кэширование, повторные запросы и неудачные генерации не включены, а реальная длительность зависит от темпа, который выберет модель.
| Режим | Модель | 2026: за минуту / за час | С 1 января 2027: за минуту / за час |
|---|---|---|---|
| Standard | Flash TTS ($9,00 → $18,00 за 1 млн) | $0,0135 / $0,81 | $0,027 / $1,62 |
| Standard | Flash-Lite TTS ($6,00 → $12,00) | $0,009 / $0,54 | $0,018 / $1,08 |
| Batch или Flex | Flash TTS ($4,50 → $9,00) | $0,00675 / $0,405 | $0,0135 / $0,81 |
| Batch или Flex | Flash-Lite TTS ($3,00 → $6,00) | $0,0045 / $0,27 | $0,009 / $0,54 |
| Priority | Flash TTS ($16,20 → $32,40) | $0,0243 / $1,458 | $0,0486 / $2,916 |
| Priority | Flash-Lite TTS ($10,80 → $21,60) | $0,0162 / $0,972 | $0,0324 / $1,944 |
Цены — в долларах с официальной страницы тарифов, без налогов и комиссий за конвертацию. Batch и Flex вдвое дешевле Standard, Priority — в 1,8 раза дороже. Вход во всех режимах стоит $0,50 (Standard), $0,25 (Batch, Flex) и $0,90 (Priority) за миллион токенов текста в 2026 году и удваивается в 2027-м; кэширование контекста — $0,125 за миллион в 2026 году плюс $0,50 за миллион токенов в час хранения.
Пример для ориентира: аудиокнига на 10 часов в стандартном режиме обойдётся примерно в $5,40 на Flash-Lite или $8,10 на Flash в 2026 году, через Batch — $2,70 и $4,05, а в 2027 году каждая сумма удвоится. Для сравнения, старая gemini-3.1-flash-tts-preview стоит $20,00 за миллион токенов аудио, то есть $1,80 в час — новая Flash-Lite дешевле в три с лишним раза, а Flash — в 2,2 раза при более высоком классе; gemini-2.5-flash-preview-tts ($10,00 за миллион, $0,90 в час) тоже дороже обеих.
Бесплатный уровень. В режимах Standard и Priority обе модели на бесплатном уровне помечены как «Free of charge», но с условием: данные бесплатного уровня Google использует для улучшения продуктов, на платном — нет. Batch и Flex бесплатно недоступны. Сколько именно запросов и токенов в минуту разрешено 3.8 TTS, страница лимитов не публикует — там есть только строки для 2.5 TTS; актуальные значения для своего проекта смотрите в AI Studio. Как устроены лимиты и почему все ключи проекта делят одну квоту — в статье Gemini API Free Tier Rate Limits 2026: что ещё бесплатно и где смотреть live quotas.
Ещё одно ограничение платного уровня — лимит расходов за скользящие 10 минут: $10 на Tier 1 (привязан платёжный аккаунт), $50 на Tier 2 (оплачено $100 и прошло 3 дня), $200 на Tier 3 ($1 000 и 30 дней). При превышении приходит 429 RESOURCE_EXHAUSTED. На Tier 1 в стандартном режиме это около 12 часов аудио Flash TTS за 10 минут — для массового пакетного производства уже может стать узким местом.
Миграция с 3.1 preview и 2.5 TTS: пять ломающих изменений
Flash-Lite TTS — официальная замена gemini-3.1-flash-tts-preview, а сама 3.1 в списке моделей помечена как устаревшая preview-модель с рекомендацией перейти на 3.8. Для gemini-2.5-flash-preview-tts и gemini-2.5-pro-preview-tts причина переезда другая: с 18 сентября 2026 года доступ к моделям 2.5 ограничен пользователями, которые активно применяли их раньше; модели не сняты с обслуживания, но новые проекты их не получат. Пять изменений, которые ломают старый код:
1. Текст стал дословным транскриптом. Указания вида «Say cheerfully: Привет!» или «Speaker 1: Привет!» внутри строки модель может прочитать вслух.
# было (3.1 preview / 2.5)
input: "Say cheerfully: Have a wonderful day!"

# стало (3.8)
"text": "Have a wonderful day!",
"annotations": [{ "type": "speech_metadata", "style": "cheerful and friendly" }]
2. Теги в угловых скобках — только для точечных событий. Смех, вздох, кашель, дыхание, короткая пауза остаются в тексте; шёпот, темп, «сарказм» и любые звуковые эффекты (аплодисменты, удары) из тегов уходят: манера — в style, эффекты — не поддерживаются.
3. В диалоге спикер указывается в каждой реплике. Старый формат одной строки с именами уходит в структуру:
# было
input: "TTS the following conversation between Joe and Jane:\nJoe: How's it going today Jane?\nJane: Not too bad, how about you?"

# стало
content: [
  { "text": "How's it going today Jane?", "annotations": [{ "type": "speech_metadata", "speaker": "Joe" }] },
  { "text": "Not too bad, how about you?", "annotations": [{ "type": "speech_metadata", "speaker": "Jane" }] }
]
speech_config: { "mode": "conversational", "speakers": [ { "speaker": "Joe", "voice": "Puck" }, { "speaker": "Jane", "voice": "Kore" } ] }
4. Длинные «Audio Profile» и «Director's Notes» заменяются голосом из Voice design. Абзацы с описанием персонажа перед транскриптом были нормой для 3.1; в 3.8 они названы главной причиной дрейфа. Опишите персонажа один раз в voices.create, получите voice_... и передавайте его в speech_config с пустым или минимальным style.
5. Обычный ответ теперь WAV, а не сырой PCM. Если код оборачивал байты в заголовок через модуль wave или ffmpeg, уберите обёртку и пишите байты напрямую в .wav. Если конвейер ожидает именно «голый» PCM, μ-law или A-law, явно задайте response_format с mime_type audio/l16, audio/mulaw или audio/alaw. Стриминга это не касается — там PCM остался по умолчанию.
Порядок миграции: замените ID модели на gemini-3.8-flash-lite-tts, перенесите режиссуру в speech_metadata, уберите обёртку WAV, прогоните регрессионный набор с пустым style — и только потом добавляйте стилистику обратно там, где она действительно изменилась. Если в результате не хватает выразительности, переключитесь на gemini-3.8-flash-tts: схема запроса одна.
Лимиты и границы отказа
Сводка жёстких ограничений со страниц моделей и руководства, чтобы не выяснять их по ошибкам API:
| Ограничение | Значение | Что это значит на практике |
|---|---|---|
| Входных токенов | 8 192 | длинный текст режется на части заранее; для аудиокниги — по главам или сценам |
| Выходных токенов | 16 384 (лимит обслуживания Gemini API) | по правилу 25 токенов/с это около 655 секунд, то есть примерно 10,9 минуты аудио на запрос — расчёт, документация минуты не называет |
| Спикеров в одном запросе | до 2, только предустановленные голоса | пользовательские голоса в диалоге — по одной реплике на запрос со склейкой |
| Сохранённых голосов | 200 на проект, 1 год | общий счётчик для Voice design и репликации |
Ключ voicekey_... | 7 дней | хранится у вас, для сценариев без серверного хранения биометрии |
| Вход / выход | только текст / только аудио | никаких изображений, файлов, инструментов, структурированного вывода, Live API |
| Версии | только gemini-3.8-flash-tts и gemini-3.8-flash-lite-tts | датированных снимков нет; последнее обновление — сентябрь 2026 года |
| Режимы потребления | Standard, Batch, Flex, Priority; кэширование | Batch и Flex — без бесплатного уровня |
Отдельно про Google Cloud: на странице Gemini-TTS в документации Cloud Text-to-Speech по состоянию на 30 сентября 2026 года перечислены только gemini-3.1-flash-tts-preview, gemini-2.5-flash-tts, gemini-2.5-flash-lite-preview-tts и gemini-2.5-pro-tts — записи о 3.8 там нет. В анонсе доступ для предприятий через Gemini Enterprise обозначен как «скоро». Если ваш стек живёт на Vertex AI, на 30 сентября 2026 года путь к 3.8 TTS — только Gemini API с ключом AI Studio.
Доступ из России: что даёт язык и что даёт регион
Обе модели поддерживают русский текст и определяют язык сами, а фраза согласия для репликации голоса есть на ru-RU. Но это свойство модели, а не условия доступа. Список стран и территорий, где доступны Gemini API и Google AI Studio, по состоянию на 30 сентября 2026 года Россию не содержит; для остальных регионов та же страница предлагает Gemini API в Gemini Enterprise Agent Platform, то есть облачный путь — а Google Cloud не принимает новые регистрации из России с 10 марта 2022 года. Дополнительные условия той же страницы: возраст от 18 лет и проверка возраста аккаунта; для Colab регион определяется по расположению виртуальной машины, а не пользователя.
Отсюда практический вывод: язык интерфейса, язык текста и русскоязычная документация на ai.google.dev не означают, что ключ из России выдадут и оплату примут. Вопрос «как оплатить и получить ключ, находясь в России» разобран отдельно, с ценами и оценкой рисков каждого маршрута: Как купить доступ к Gemini API в России: цены, ключ и безопасные маршруты. Если регион у вас подходящий, порядок действий такой: Ключ Google AI Studio: проверка региона, создание и первый запрос, затем первый запрос из раздела выше.
Реселлеры в русскоязычном интернете уже предлагают «Gemini 3.8 Flash TTS купить в России» с рублёвыми ценами — это их тарифы, а не тарифы Google; долларовые цифры из таблицы выше на них не переносятся, и условия про водяной знак, бесплатный уровень и использование данных у посредника могут отличаться.
Частые вопросы
Gemini 3.8 Flash TTS можно скачать как программу? Нет. Это модель, доступная через Gemini API и в интерфейсе Google AI Studio; никакого приложения или офлайн-версии нет. Ближайшая «программа» — плейграунд речи в AI Studio, где можно набрать текст, выбрать голос и прослушать результат, но он работает по тем же региональным правилам, что и API.
Что лучше для русской озвучки — Flash или Flash-Lite? Русский поддерживают обе, разница не в языке, а в задаче. Для бота, читалки и массовой генерации — Flash-Lite; для аудиокниги, актёрских сцен и диалога с наложенными реакциями — Flash. В анонсе Google результатов именно по русской речи нет, поэтому разумный путь — прогнать один и тот же фрагмент на обеих моделях: запрос отличается только ID.
Можно ли протестировать бесплатно? На бесплатном уровне режимы Standard и Priority для обеих моделей помечены как бесплатные, при этом Google использует данные таких запросов для улучшения продуктов. Batch и Flex бесплатно недоступны, а лимиты запросов для 3.8 TTS на странице лимитов не опубликованы — смотрите их в своём проекте AI Studio. Что именно в AI Studio бесплатно и когда включается оплата — в статье Google AI Studio бесплатно: что доступно и когда нужно платить.
Чем gemini-3.8-flash-tts отличается от gemini-3.8-flash? Это разные модели одной линейки. gemini-3.8-flash — текстовая модель, которая принимает текст и изображения и отвечает текстом; TTS-модели принимают только текст и возвращают только аудио. Для генерации самого текста подкаста, который потом озвучится, нужна текстовая модель — о ней в статье Gemini 3.8 Flash: цена, ID модели и переход с 3.7 без риска.
Почему gemini-2.5-flash-preview-tts перестала отвечать? С 18 сентября 2026 года Google ограничил доступ к моделям 2.5 теми, кто активно использовал их раньше; для новых проектов рекомендованы актуальные модели. Если доступ пропал, переносите код на gemini-3.8-flash-lite-tts по чек-листу из раздела о миграции — главное, убрать инструкции из текста и обёртку WAV.