Gemini 3.5 Transcribe API: как расшифровать запись и запустить live-транскрипцию
Запись расшифровывается через Files и Interactions API, субтитры поступают из отдельной Live-модели. Пользовательский словарь и разметка по словам требуют разных конфигураций; предварительный текст потока нужно заменять, окончательный — сохранять.
Содержание
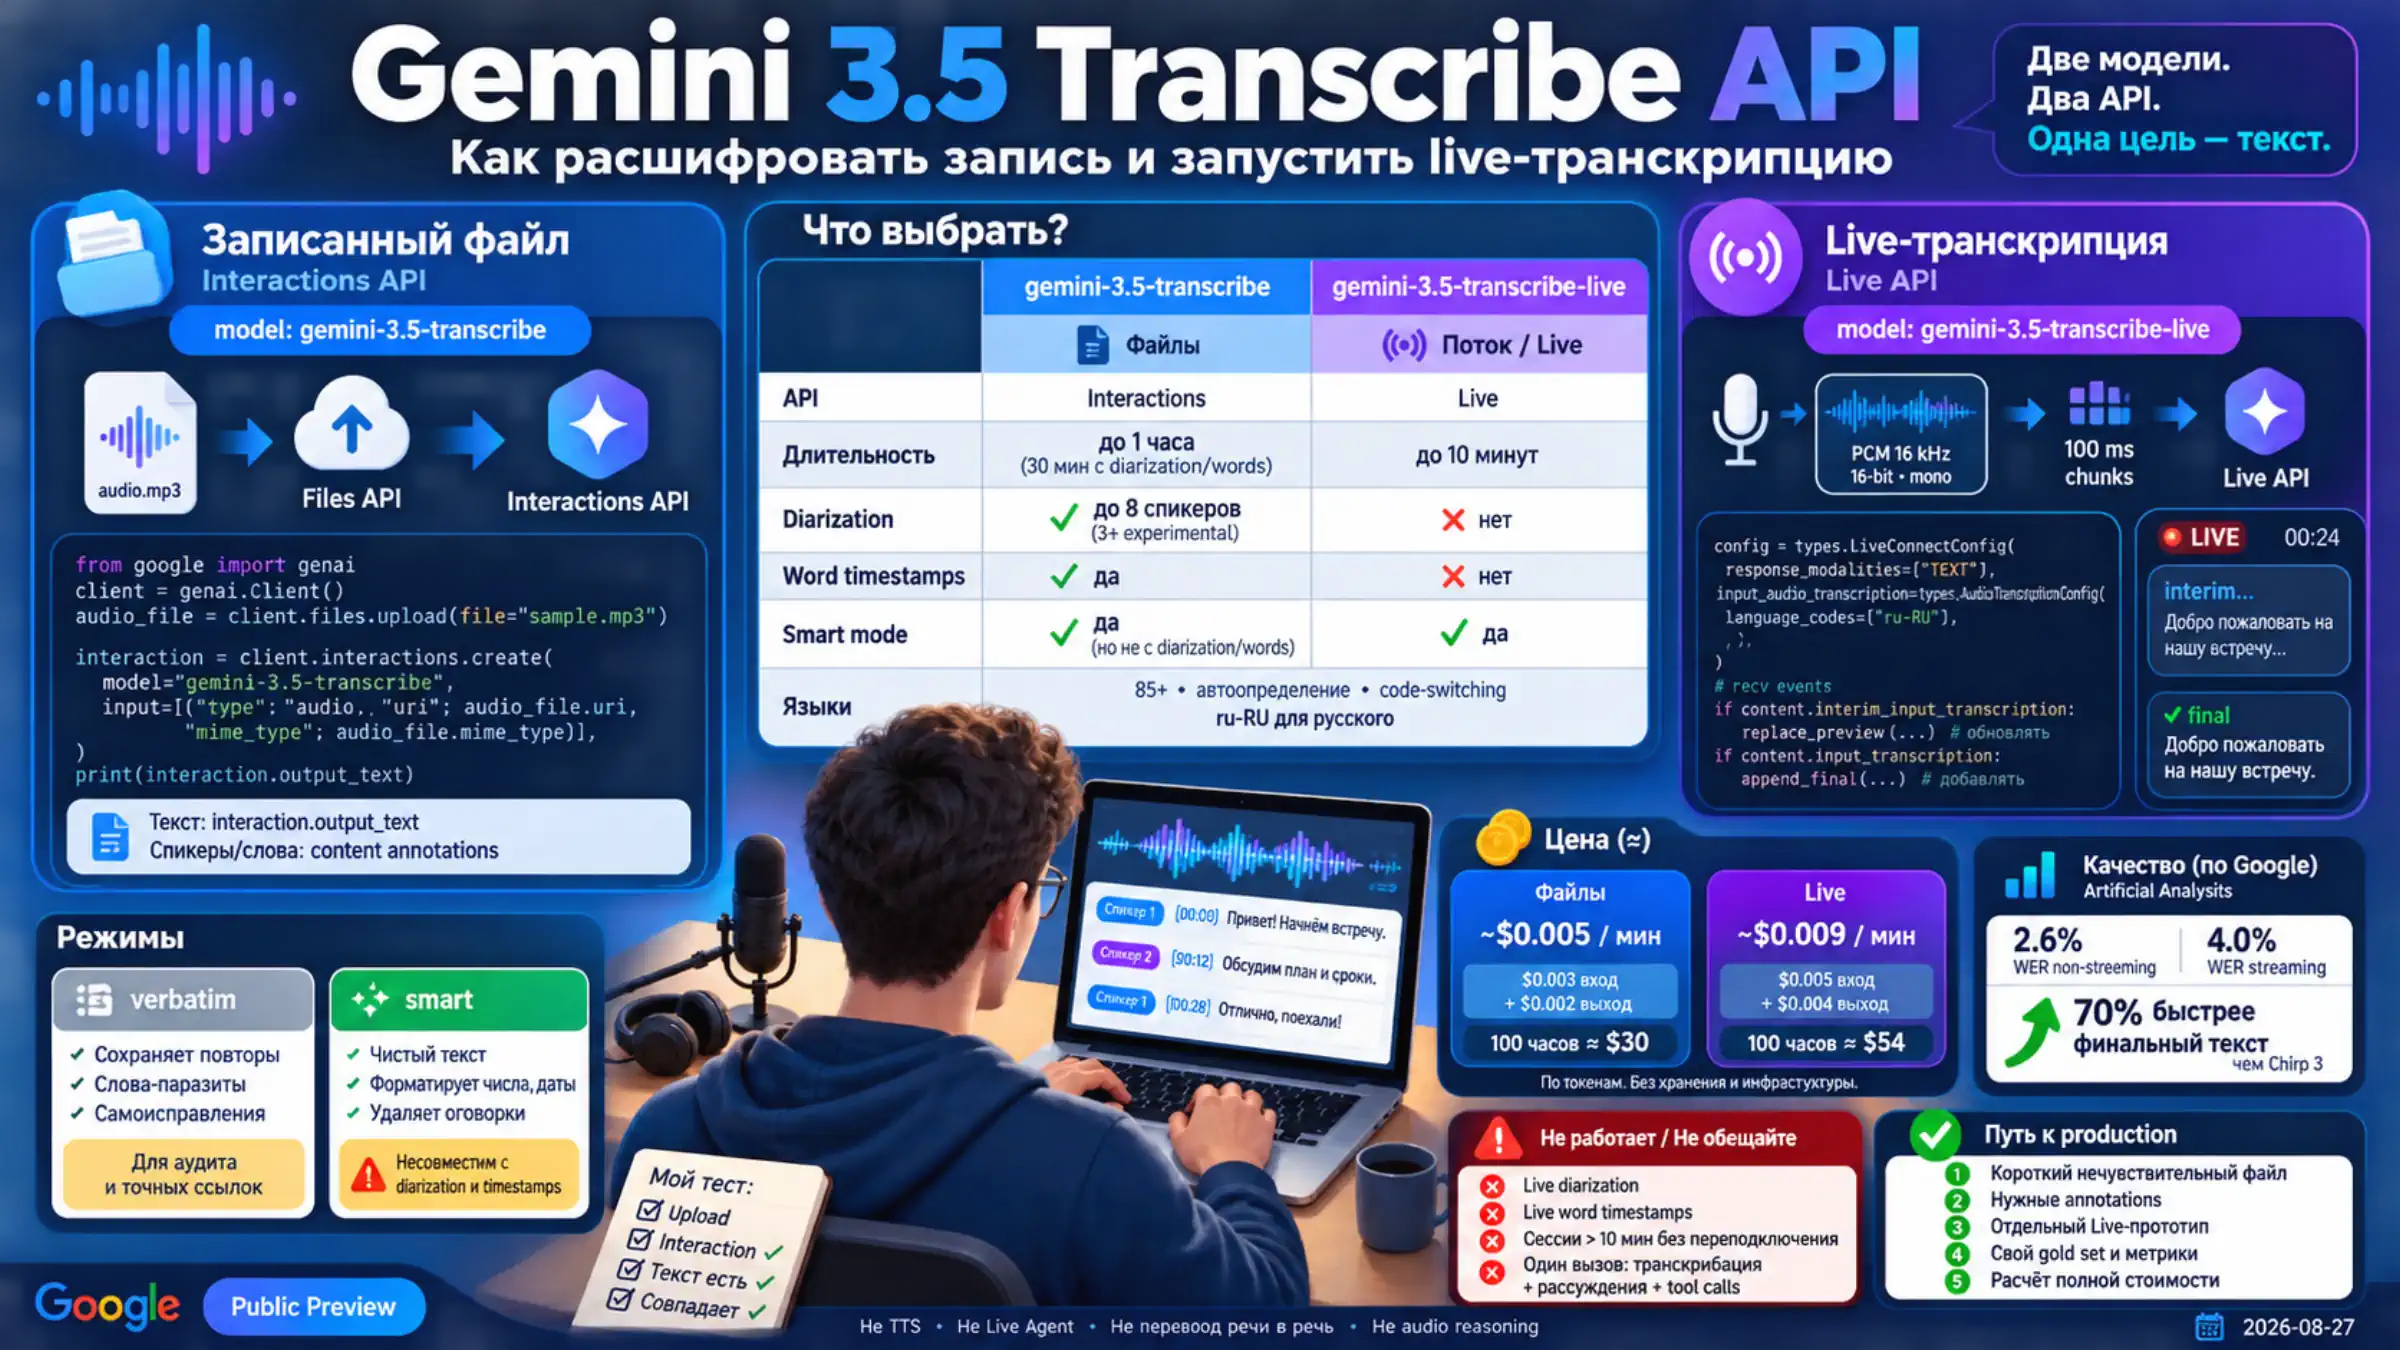
Чтобы расшифровать запись, загрузите её через Files API и передайте полученный URI в Interactions API с моделью gemini-3.5-transcribe. Для субтитров во время речи используйте gemini-3.5-transcribe-live: ей нужен поток несжатого PCM и отдельная обработка предварительного и окончательного текста.
Главный выбор для записанного созвона — словарь терминов или разметка по словам и спикерам. Их нельзя включить в одном запросе: текущий API отклоняет сочетание custom_vocabulary с разделением говорящих или временными метками. Ниже есть оба допустимых варианта, разбор ответа и пример Live-клиента с ограниченным ожиданием после конца аудио. Схема запросов основана на руководстве по транскрипции; локально проверены только собственные обработчики на искусственных данных, без обращений к модели.
Как выбрать модель для записи или субтитров
| Что нужно получить | Записанный файл | Аудиопоток |
|---|---|---|
| Model ID | gemini-3.5-transcribe | gemini-3.5-transcribe-live |
| Подключение | Files → Interactions | Live API, двустороннее соединение |
| Вход | Например, MP3 или WAV с соответствующим MIME | PCM: signed 16-bit, 16 кГц, mono, little-endian |
| Предельная длительность | 1 час; с разделением говорящих или временными метками — 30 минут | Сессия до 10 минут |
| Разделение по спикерам | Да, в режиме verbatim | Нет |
| Временные метки слов | Да, в режиме verbatim | Нет |
| Результат для приложения | Текст и, при запросе, аннотации слов | Предварительные и окончательные фрагменты |
Ограничения относятся к конкретным моделям Gemini 3.5 Transcribe, а формат потока — к Live transcription. Русский поддерживается с кодом ru-RU; без языковой подсказки работает автоопределение, в том числе при переключении языков.
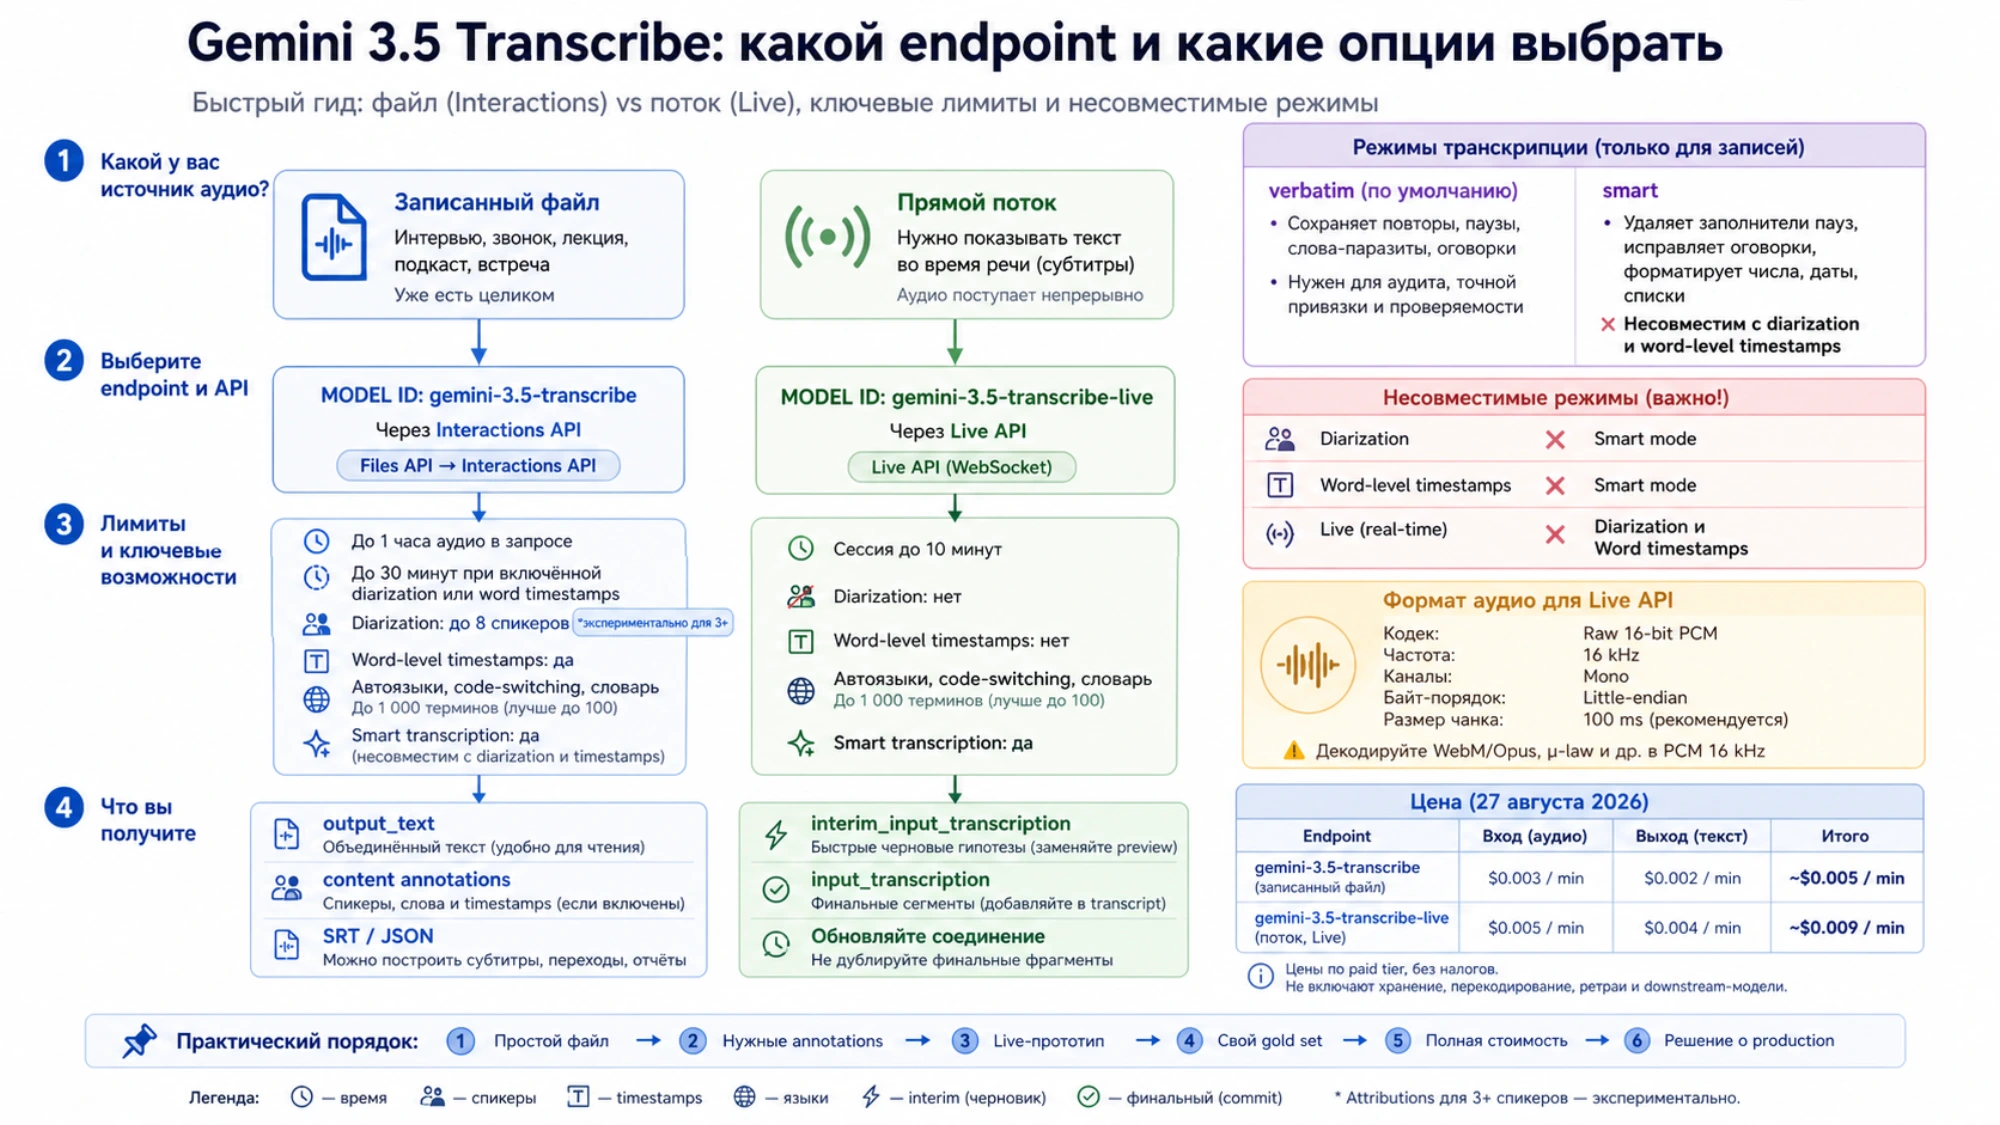
Для часовой встречи с разметкой придётся разделить запись на допустимые части. Сохраните время начала каждой части: смещение слова в ответе относится к отправленному аудио, и к нему нужно прибавить смещение части в исходной записи. Метки говорящих между отдельными запросами не следует автоматически считать идентификаторами одного и того же человека.
Это специализированное распознавание речи. Вызов инструментов, рассуждение по аудио и озвучивание ответа не входят в возможности этих моделей. Резюме встречи можно строить следующим этапом, после сохранения расшифровки; отдельный этап имеет собственную стоимость и правила обработки данных.
Расшифровать файл: два допустимых профиля Python
Для примера нужен Google Gen AI SDK с поддержкой текущего Interactions API, доступ к модели в вашем проекте и разрешённый к отправке файл. Ключ должен быть настроен на сервере; код использует стандартное чтение учётных данных SDK. Здесь нет проверки доступности конкретного аккаунта, установленной версии SDK или успешного сетевого вызова.
Сохраните пример как recorded.py. Профиль terms задаёт словарь, а marked запрашивает слова, временные метки и метки говорящих. Каждый запуск делает одну транскрипцию; запуск обоих профилей оплачивается как два независимых запроса.
import argparse
import json
from pathlib import Path
from google import genai

PROFILES = {
    "terms": {
        "language_codes": ["ru-RU"],
        "custom_vocabulary": ["Кубернетес", "BigQuery", "ЛаоЧжан"],
    },
    "marked": {
        "language_codes": ["ru-RU"],
        "mode": {
            "type": "verbatim",
            "diarization_mode": "speaker",
            "timestamp_granularities": ["word"],
        },
    },
}


def validate_profile(config):
    mode = config.get("mode", {"type": "verbatim"})
    if isinstance(mode, dict):
        if mode.get("type") != "verbatim":
            raise ValueError("Object mode must be verbatim")
        marked = bool(mode.get("diarization_mode")
                      or mode.get("timestamp_granularities"))
    else:
        if mode != "smart":
            raise ValueError("String mode must be smart")
        marked = False
    if config.get("custom_vocabulary") and marked:
        raise ValueError("Vocabulary and annotations are incompatible")
    if len(config.get("custom_vocabulary", [])) > 1000:
        raise ValueError("Vocabulary exceeds 1000 terms")


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("audio", type=Path)
    parser.add_argument("--profile", choices=PROFILES, default="marked")
    args = parser.parse_args()
    config = PROFILES[args.profile]
    validate_profile(config)
    client = genai.Client()
    audio = client.files.upload(file=str(args.audio))
    result = client.interactions.create(
        model="gemini-3.5-transcribe",
        input=[{"type": "audio", "uri": audio.uri,
                "mime_type": audio.mime_type}],
        generation_config={"transcription_config": config},
    )
    Path("interaction.json").write_text(
        json.dumps(result.model_dump(mode="json"),
                   ensure_ascii=False, indent=2), encoding="utf-8")
    print(result.output_text)


if __name__ == "__main__":
    main()
Примеры команд для вашего окружения: python recorded.py sample.mp3 --profile terms или python recorded.py sample.mp3 --profile marked. Сохранённый interaction.json содержит ответ целиком; фиксированное имя в этом минимальном примере перезаписывается при следующем запуске. В приложении используйте отдельное имя для каждой записи. Полный ответ полезнее одного напечатанного текста: он сохраняет статус, структуру и аннотации, если они вернулись.
Локальный validate_profile отсеивает рассматриваемые несовместимые сочетания, но не заменяет серверную проверку всех параметров. По официальному описанию словаря и режимов, максимум — 1 000 терминов, а обычно лучшие результаты достигаются со списком до 100. Это разные условия: допустимый размер и рекомендация по использованию. Выбирайте фамилии, названия и сокращения, ошибки в которых действительно мешают работе.
У профиля terms режим verbatim используется по умолчанию. Для текста без слов-паразитов и самоисправлений можно заменить конфигурацию на {"language_codes": ["ru-RU"], "mode": "smart"}. В записанном API smart — строка, а объект mode предназначен для {"type": "verbatim", ...}. Не используйте {"type": "smart"} и не добавляйте разметку к smart: это не текущая документированная форма.
Для проверяемой цитаты сохраняйте verbatim и исходную запись. Читабельная версия smart может убрать оговорку или повтор, поэтому она не заменяет дословную расшифровку и ручную сверку важных мест.
Как сохранить слова, время и говорящих из ответа
output_text — объединённая расшифровка. Аннотации находятся глубже: steps[].content[].annotations[], где type равен word_info. В них используются text, speaker, start_offset и end_offset; смещения в JSON представлены строками длительности, например "0.100s". Это структура ответа Interactions, а не поля Live-субтитров.
Следующий обработчик работает с interaction.json, сохранённым предыдущим примером. Он не обращается к API. Для отсутствующего времени или говорящего остаётся null, а неверное время не превращается в выдуманное значение.
import json
import re
from decimal import Decimal, ROUND_HALF_UP
from pathlib import Path


def milliseconds(value):
    if value is None:
        return None
    if not isinstance(value, str) or not re.fullmatch(r"\d+(?:\.\d+)?s", value):
        raise ValueError(f"Invalid duration: {value!r}")
    return int((Decimal(value[:-1]) * 1000).quantize(
        Decimal("1"), rounding=ROUND_HALF_UP))


def word_rows(document):
    rows = []
    for step in document.get("steps") or []:
        for content in step.get("content") or []:
            for item in content.get("annotations") or []:
                if item.get("type") != "word_info":
                    continue
                start = milliseconds(item.get("start_offset"))
                end = milliseconds(item.get("end_offset"))
                if start is not None and end is not None and end < start:
                    raise ValueError("Word ends before it starts")
                rows.append({
                    "text": item.get("text"),
                    "speaker": item.get("speaker"),
                    "start_offset": item.get("start_offset"),
                    "end_offset": item.get("end_offset"),
                    "start_ms": start, "end_ms": end,
                })
    return rows


if __name__ == "__main__":
    document = json.loads(Path("interaction.json").read_text(encoding="utf-8"))
    result = {"status": document.get("status"), "words": word_rows(document)}
    Path("words.json").write_text(json.dumps(result, ensure_ascii=False, indent=2),
                                  encoding="utf-8")
    print(f"Words: {len(result['words'])}")
Начало "0s" корректно сохраняется как 0 мс: его нельзя отбрасывать проверкой if start. Если words пуст, это не доказательство тишины или плохого распознавания. Сначала проверьте профиль запроса, статус ответа и наличие аннотаций. Текст может быть непустым и без разметки.
Из таких строк можно строить переход к месту записи или группировать слова для SRT. Группировка, длительность показа субтитра и обработка пересекающейся речи — уже решения приложения. Парсер выше не обещает готовый монтажный файл и не проверяет попадание слов во время на слух.
В карточке модели заявлено до восьми говорящих, но определение говорящего для трёх и более экспериментально. Временные метки могут снижать точность распознавания. Метка вроде spk_1 обозначает голос в данной расшифровке, а не установленную личность участника встречи.
Live-субтитры: правильный PCM и конечное ожидание
Для Live сначала подготовьте правильные байты. Контейнер WAV содержит заголовок; его нельзя целиком отправить как audio/pcm. MP3, WebM/Opus и телефонный μ-law тоже не становятся PCM после замены MIME. По руководству Live API, нужен несжатый 16-битный PCM, 16 кГц, один канал, little-endian. Порция в 100 мс при этих параметрах — 1 600 отсчётов, то есть 3 200 байт.
Пример ниже читает уже подготовленный PCM WAV, проверяет формат и отправляет только аудиокадры в темпе записи. Это серверный прототип для файла длиной до 30 секунд, а не реализация захвата микрофона. Сохраните его как live_file.py; SDK и серверные учётные данные нужны те же, что и выше.
import argparse
import asyncio
import json
import wave
from contextlib import suppress
from dataclasses import dataclass, field
from google import genai
from google.genai import types


@dataclass
class Captions:
    final: list[str] = field(default_factory=list)
    preview: str = ""

    def apply(self, content):
        if content is None:
            return
        interim = getattr(content, "interim_input_transcription", None)
        if interim is not None and interim.text is not None:
            self.preview = interim.text
        finished = getattr(content, "input_transcription", None)
        if finished is not None and finished.text is not None:
            if finished.text:
                self.final.append(finished.text)
            self.preview = ""


def read_pcm(path):
    with wave.open(path, "rb") as audio:
        if (audio.getnchannels(), audio.getsampwidth(), audio.getframerate(),
            audio.getcomptype()) != (1, 2, 16000, "NONE"):
            raise ValueError("Expected uncompressed mono 16-bit 16-kHz WAV")
        if not 0 < audio.getnframes() <= 30 * 16000:
            raise ValueError("Use a nonempty sample no longer than 30 seconds")
        chunks = []
        while data := audio.readframes(1600):
            if len(data) % 2:
                raise ValueError("Incomplete 16-bit sample")
            chunks.append(data)
        return chunks


async def receive(session, captions):
    while True:
        seen = False
        async for response in session.receive():
            seen = True
            captions.apply(getattr(response, "server_content", None))
        if not seen:
            return "receiver_ended"
        # An iterator may end after a turn; keep listening for the next one.
        await asyncio.sleep(0.01)


async def run(path):
    chunks = read_pcm(path)
    captions = Captions()
    report = {"finish": "not_started", "error": None}
    receiver = None
    try:
        client = genai.Client()
        config = types.LiveConnectConfig(
            response_modalities=["TEXT"],
            input_audio_transcription=types.AudioTranscriptionConfig(
                language_codes=["ru-RU"], mode="VERBATIM"),
        )
        async with client.aio.live.connect(
            model="gemini-3.5-transcribe-live", config=config
        ) as session:
            receiver = asyncio.create_task(receive(session, captions))
            try:
                for chunk in chunks:
                    if receiver.done():
                        report["finish"] = receiver.result()
                        break
                    await session.send_realtime_input(audio=types.Blob(
                        data=chunk, mime_type="audio/pcm;rate=16000"))
                    await asyncio.sleep(len(chunk) / 32000)
                else:
                    await session.send_realtime_input(audio_stream_end=True)
                    done, _ = await asyncio.wait({receiver}, timeout=3.0)
                    report["finish"] = (receiver.result() if done else "drain_timeout")
            finally:
                if not receiver.done():
                    receiver.cancel()
                with suppress(asyncio.CancelledError, Exception):
                    await receiver
    except Exception as error:
        report["finish"] = "error"
        report["error"] = f"{type(error).__name__}: {error}"
    finally:
        report.update(final=captions.final, unfinished_preview=captions.preview)
        print(json.dumps(report, ensure_ascii=False))


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("wav")
    asyncio.run(run(parser.parse_args().wav))
Запуск для вашего окружения: python live_file.py sample-16k-mono.wav. В отличие от варианта с неопределённым your_pcm_source(), здесь показаны источник кадров, хранение текста и остановка задачи чтения. Пример ограничивает ожидание ответов после отправки конца аудио тремя секундами. Это выбранный срок приложения, а не обещание Google успеть вернуть последний фрагмент. Установление соединения и отправка относятся к сетевой работе SDK и этим сроком не ограничены.
interim_input_transcription заменяет текущую строку предпросмотра. input_transcription добавляется в список окончательных фрагментов и очищает предпросмотр. Обработчик принимает обе части одного события и спокойно пропускает события без server_content. Он не удаляет одинаковые окончательные строки: человек действительно может дважды сказать «да». Порядковые номера, если они нужны для хранения, назначайте в своём приложении; это не идентификаторы сегментов от сервера.
В отчёте drain_timeout означает, что истёк срок ожидания, а receiver_ended — что итератор завершился без новых событий. Ни один статус сам по себе не доказывает, что обработано последнее слово. unfinished_preview остаётся отдельно и не выдаётся за окончательный текст. При ошибке уже полученные фрагменты тоже сохраняются в отчёте. Для рабочего сервиса этот отчёт нужно записывать в надёжное хранилище вместе с идентификатором записи; печать в консоль здесь служит простым выходом прототипа.
В данном варианте остаётся автоматическое определение начала и конца речи. Сигнал audio_stream_end=True отправляется на конце файла, чтобы завершить аудиопоток и дать серверу сформировать окончательный текст. Для кнопки push-to-talk используется другой режим: автоматическое определение активности отключают и отправляют activity_start/activity_end. Не смешивайте эти две схемы без отдельной логики.
Для читабельных Live-субтитров в AudioTranscriptionConfig можно выбрать mode="SMART"; дословный вариант — "VERBATIM". Здесь значения прописные, в отличие от строки "smart" у записанного API. Live не возвращает разметку слов и говорящих, поэтому приведённое состояние субтитров не пытается создать такие данные из времени получения событий.
Длинный эфир потребует смены сессий до десятиминутного предела, сохранения уже подтверждённых фрагментов и явной обработки пропуска или повторной отправки аудио. Этот короткий прототип не реализует переподключение и не гарантирует отсутствие потерь между сессиями.
Сколько стоит транскрипция
На 6 октября 2026 года цены Gemini Developer API для выделенных моделей такие:
| Модель | Входное аудио, USD за 1 млн токенов | Выходной текст, USD за 1 млн токенов | Опубликованный ориентир за минуту, вход + выход |
|---|---|---|---|
gemini-3.5-transcribe | 2,00 | 12,00 | ≈ 0,003 + 0,002 = 0,005 USD |
gemini-3.5-transcribe-live | 3,50 | 21,00 | ≈ 0,005 + 0,004 = 0,009 USD |
Оплата идёт по токенам, а не по фиксированному минутному тарифу. Для оценки Google использует 25 аудиотокенов в секунду и около 175 выходных текстовых токенов в минуту. Из этих предположений получаются 0,0051 USD за минуту записи и 0,008925 USD за минуту Live до округления.
Поэтому для 100 часов, то есть 6 000 минут, расчёт даёт 30,60 USD и 53,55 USD соответственно. Округлённые минутные ориентиры дают около 30 и 54 USD — это другое округление той же оценки, а не два разных тарифа. Ни одна сумма здесь не является полученным счётом.
Для фактических объёмов формула проста: audio_tokens × input_rate / 1_000_000 + text_tokens × output_rate / 1_000_000. Добавьте отдельно перекодирование, хранение, повторы запросов, последующее резюме и проверку человеком. Если расшифровываете одну запись двумя профилями, учитывайте оба вызова. Для этих специализированных моделей не стоит закладывать скидку Batch: карточка модели не указывает поддержку Batch API.
Что проверить перед отправкой рабочих записей
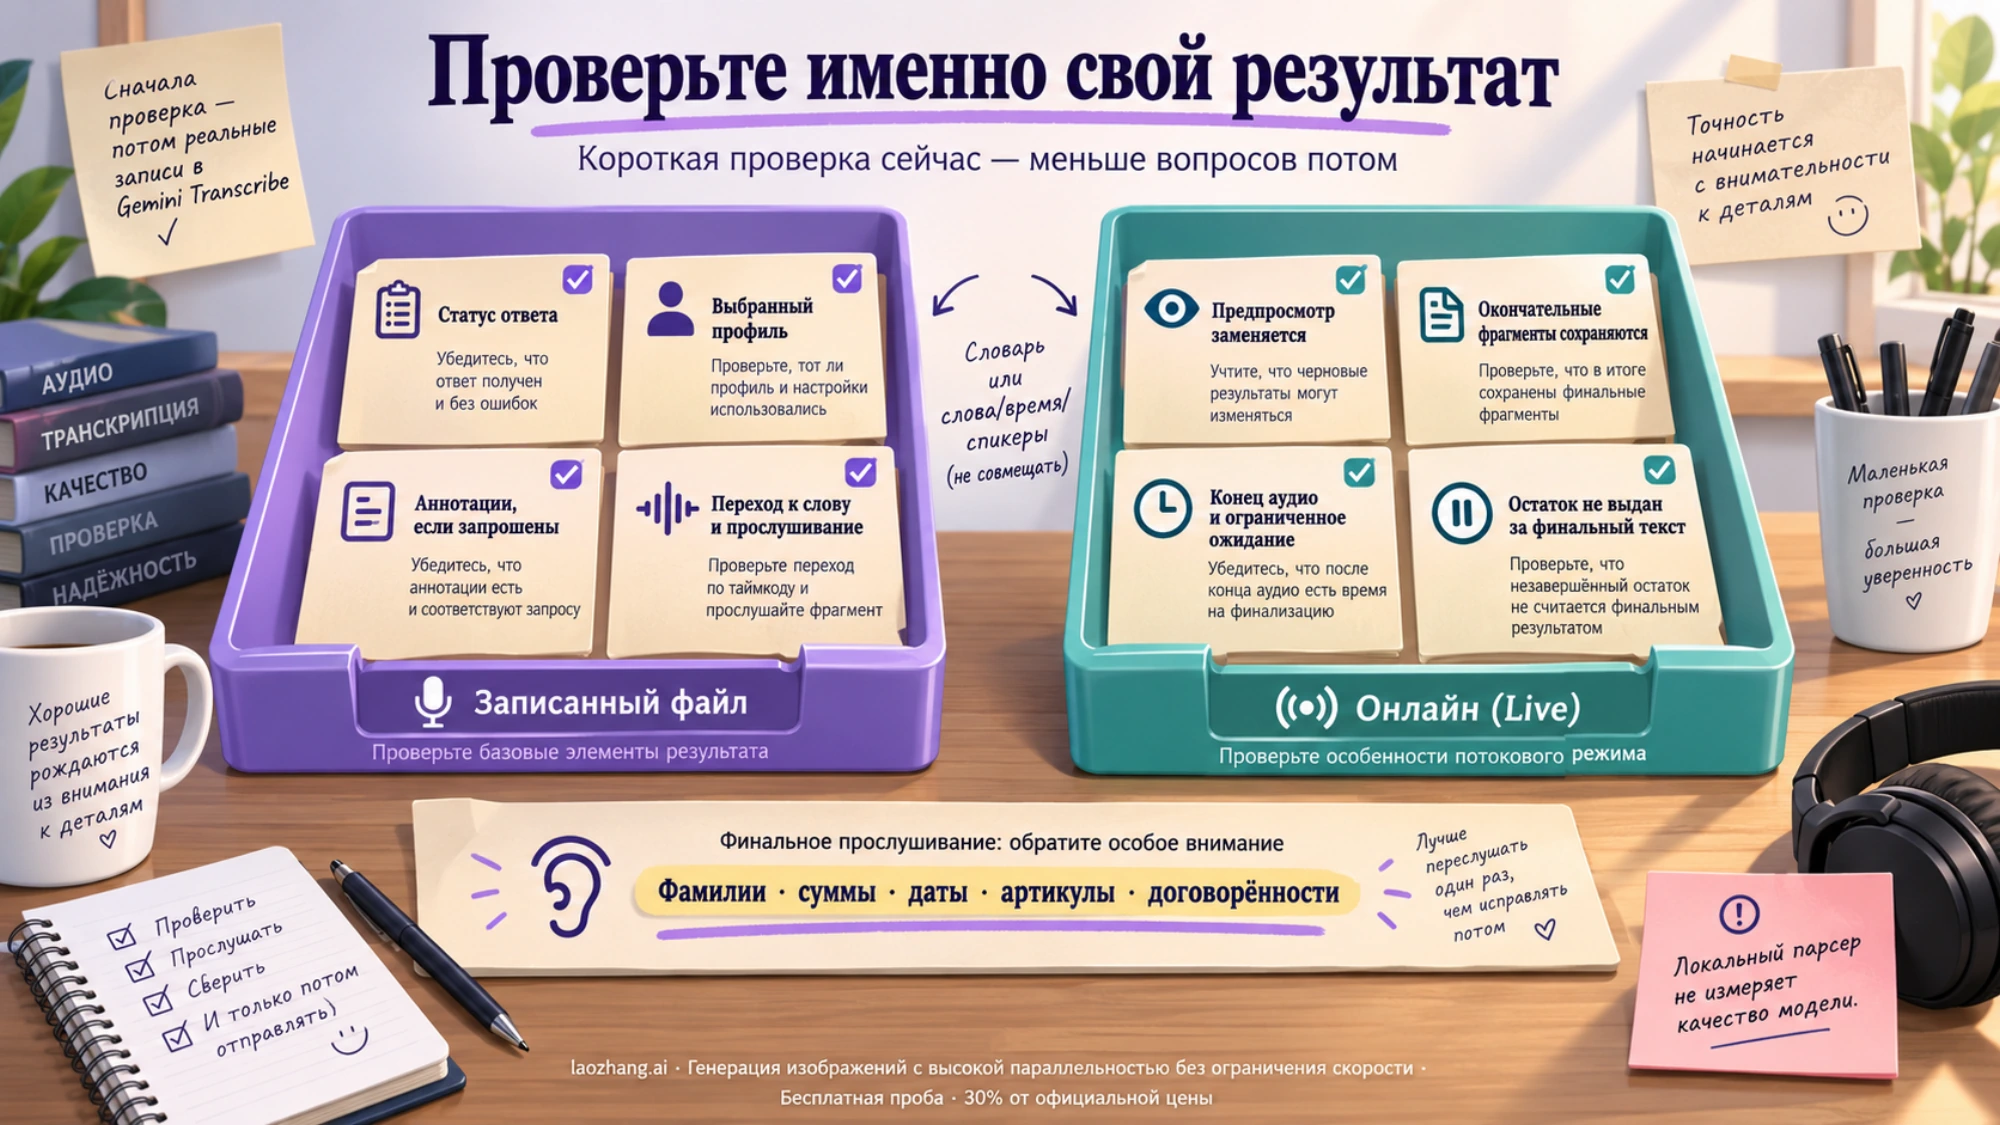
Вместо проверки только «вернулся ли текст» разделите испытания по задаче. Для записи проверьте статус ответа, наличие требуемых аннотаций и переход по времени к нужному слову. Для Live проверьте смену предварительной строки, сохранение окончательной, остаток после конца аудио и поведение при разрыве. Затем прослушайте разрешённые к использованию записи и отдельно сверяйте фамилии, суммы, даты, артикулы и договорённости: средняя ошибка по словам может скрыть дорогую ошибку в числе.
В рамках подготовки этого руководства мы выполнили офлайн-проверки собственного кода: допустимые профили и отказ от их смешивания, разбор синтетических word_info с нулевым и отсутствующим временем, замену предпросмотра, сохранение повторяющихся окончательных фраз и чтение созданного локально PCM WAV. Синтетический асинхронный источник также проверяет завершение и отмену ожидания; арифметика стоимости проверена через Decimal. SDK-клиенты и сетевые примеры не запускались. Эти результаты подтверждают логику обработчиков, но не точность модели, задержку Live или принятие запросов сервером.
У файлов есть отдельный жизненный цикл: по документации Files API, загруженные объекты удаляются автоматически через 48 часов; пределы — 2 ГБ на файл и 20 ГБ на проект. Само хранение через Files API, где оно доступно, не оплачивается отдельно, но это не делает вызов транскрипции бесплатным. Сохраните исходное аудио у себя: URI файла не является долговременным архивом. Период 48 часов нельзя переносить на ответы Interactions и все журналы провайдера.
Для конфиденциальных звонков важны условия использования Gemini API, а не только колонка Free/Paid в таблице цен. В общем случае данные бесплатного сервиса могут использоваться для улучшения продуктов и просматриваться людьми; такие запросы не предназначены для чувствительной информации. Для платного API требуется проект с активным Cloud Billing: запросы и ответы не используются для улучшения продуктов, но возможна ограниченная обработка и журналирование для безопасности и юридических требований. Это не обещание нулевого хранения.
Для ЕЭЗ, Швейцарии и Великобритании условия использования данных платного сервиса распространяются также на бесплатную квоту; приложения, предоставляющие API-клиенты пользователям этих регионов, должны использовать Paid Services. Язык записи не определяет регион пользователя или право отправлять данные. Согласие участников и правила вашей организации проверяются отдельно.
При прямом подключении браузера постоянный ключ на клиенте недопустим. Краткоживущие токены выпускает доверенный сервер после аутентификации клиента; сейчас они предназначены для Live API v1beta и могут ограничивать модель и конфигурацию. По умолчанию на начало сессии даётся 1 минута, на обмен сообщениями — 30 минут, число использований — 1. Тридцать минут жизни токена не продлевают десятиминутный предел Transcribe Live. Выдача токенов и браузерная аутентификация в приведённые серверные примеры не входят.
Частые вопросы
Можно ли запустить Gemini 3.5 Transcribe локально или скачать open-source модель?
Приведённые официальные способы подключения — облачные API. Python-скрипт может работать на вашем компьютере, но аудио отправляется Google, а распознавание не выполняется офлайн. Рассмотренные документы модели не дают способа скачать её веса и развернуть локально. Офлайн-проверка парсера — проверка приложения, не локальный запуск Gemini.
Можно ли одновременно добавить словарь и получить спикеров с временными метками?
Нет, текущий API запрещает словарь вместе с любой из этих двух функций. Выберите профиль под задачу. Если нужны два разных результата, сделайте отдельные допустимые запросы и сохраните их раздельно; не считайте автоматическое сопоставление двух расшифровок точным без проверки.
Есть ли бесплатная транскрипция и работает ли она для любого аккаунта?
В таблице цен указан бесплатный уровень, однако это не обещание одинаковых квот и доступа во всех проектах и странах. Доступность модели, условия данных и разрешение отправить конкретную запись проверяются для вашего аккаунта. Короткий тест AI Studio, описанный другим автором, не доказывает, что ваш SDK-запрос доступен бесплатно.
Модели уже GA или всё ещё public preview?
В проверенных 6 октября официальных материалах есть расхождение: журнал изменений называет релиз 26 августа GA, а публикация о запуске продолжает использовать public preview. Поэтому статус запуска нельзя превращать в гарантию доступа конкретного проекта. Для интеграции используйте точные model ID и текущую спецификацию нужного API.
Можно ли использовать Live для готовых субтитров с точным временем каждого слова?
Live даёт предварительные и окончательные фрагменты, но не поддерживает временные метки слов и разделение говорящих. Для разметки готовой записи используйте gemini-3.5-transcribe с профилем marked. Время прихода события в приложение не является временем произнесения слова в аудио.
Источники9
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 7 окт. 2026 г..
Источники9
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 7 окт. 2026 г..
- 1.руководстве по транскрипцииai.google.dev/gemini-api/docs/transcribe
- 2.конкретным моделям Gemini 3.5 Transcribeai.google.dev/gemini-api/docs/models/gemini-3.5-transcribe
- 3.Live transcriptionai.google.dev/gemini-api/docs/live-api/live-transcribe
- 4.цены Gemini Developer APIai.google.dev/gemini-api/docs/pricing
- 5.документации Files APIai.google.dev/gemini-api/docs/files
- 6.условия использования Gemini APIai.google.dev/gemini-api/terms
- 7.Краткоживущие токеныai.google.dev/gemini-api/docs/live-api/ephemeral-tokens
- 8.журнал измененийai.google.dev/gemini-api/docs/changelog
- 9.публикация о запускеblog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5-transcribe