GPT-6 Astra API 가격: 272K 기준과 캐시·서비스 티어 계산법
2026년 10월 26일 기준 GPT-6 Astra는 입력 $10·출력 $50, 캐시 쓰기 30분 $12.50·12시간 $25다. 기본 캐시 때문에 한 번 쓰는 긴 프롬프트는 25% 더 낸다.
목차
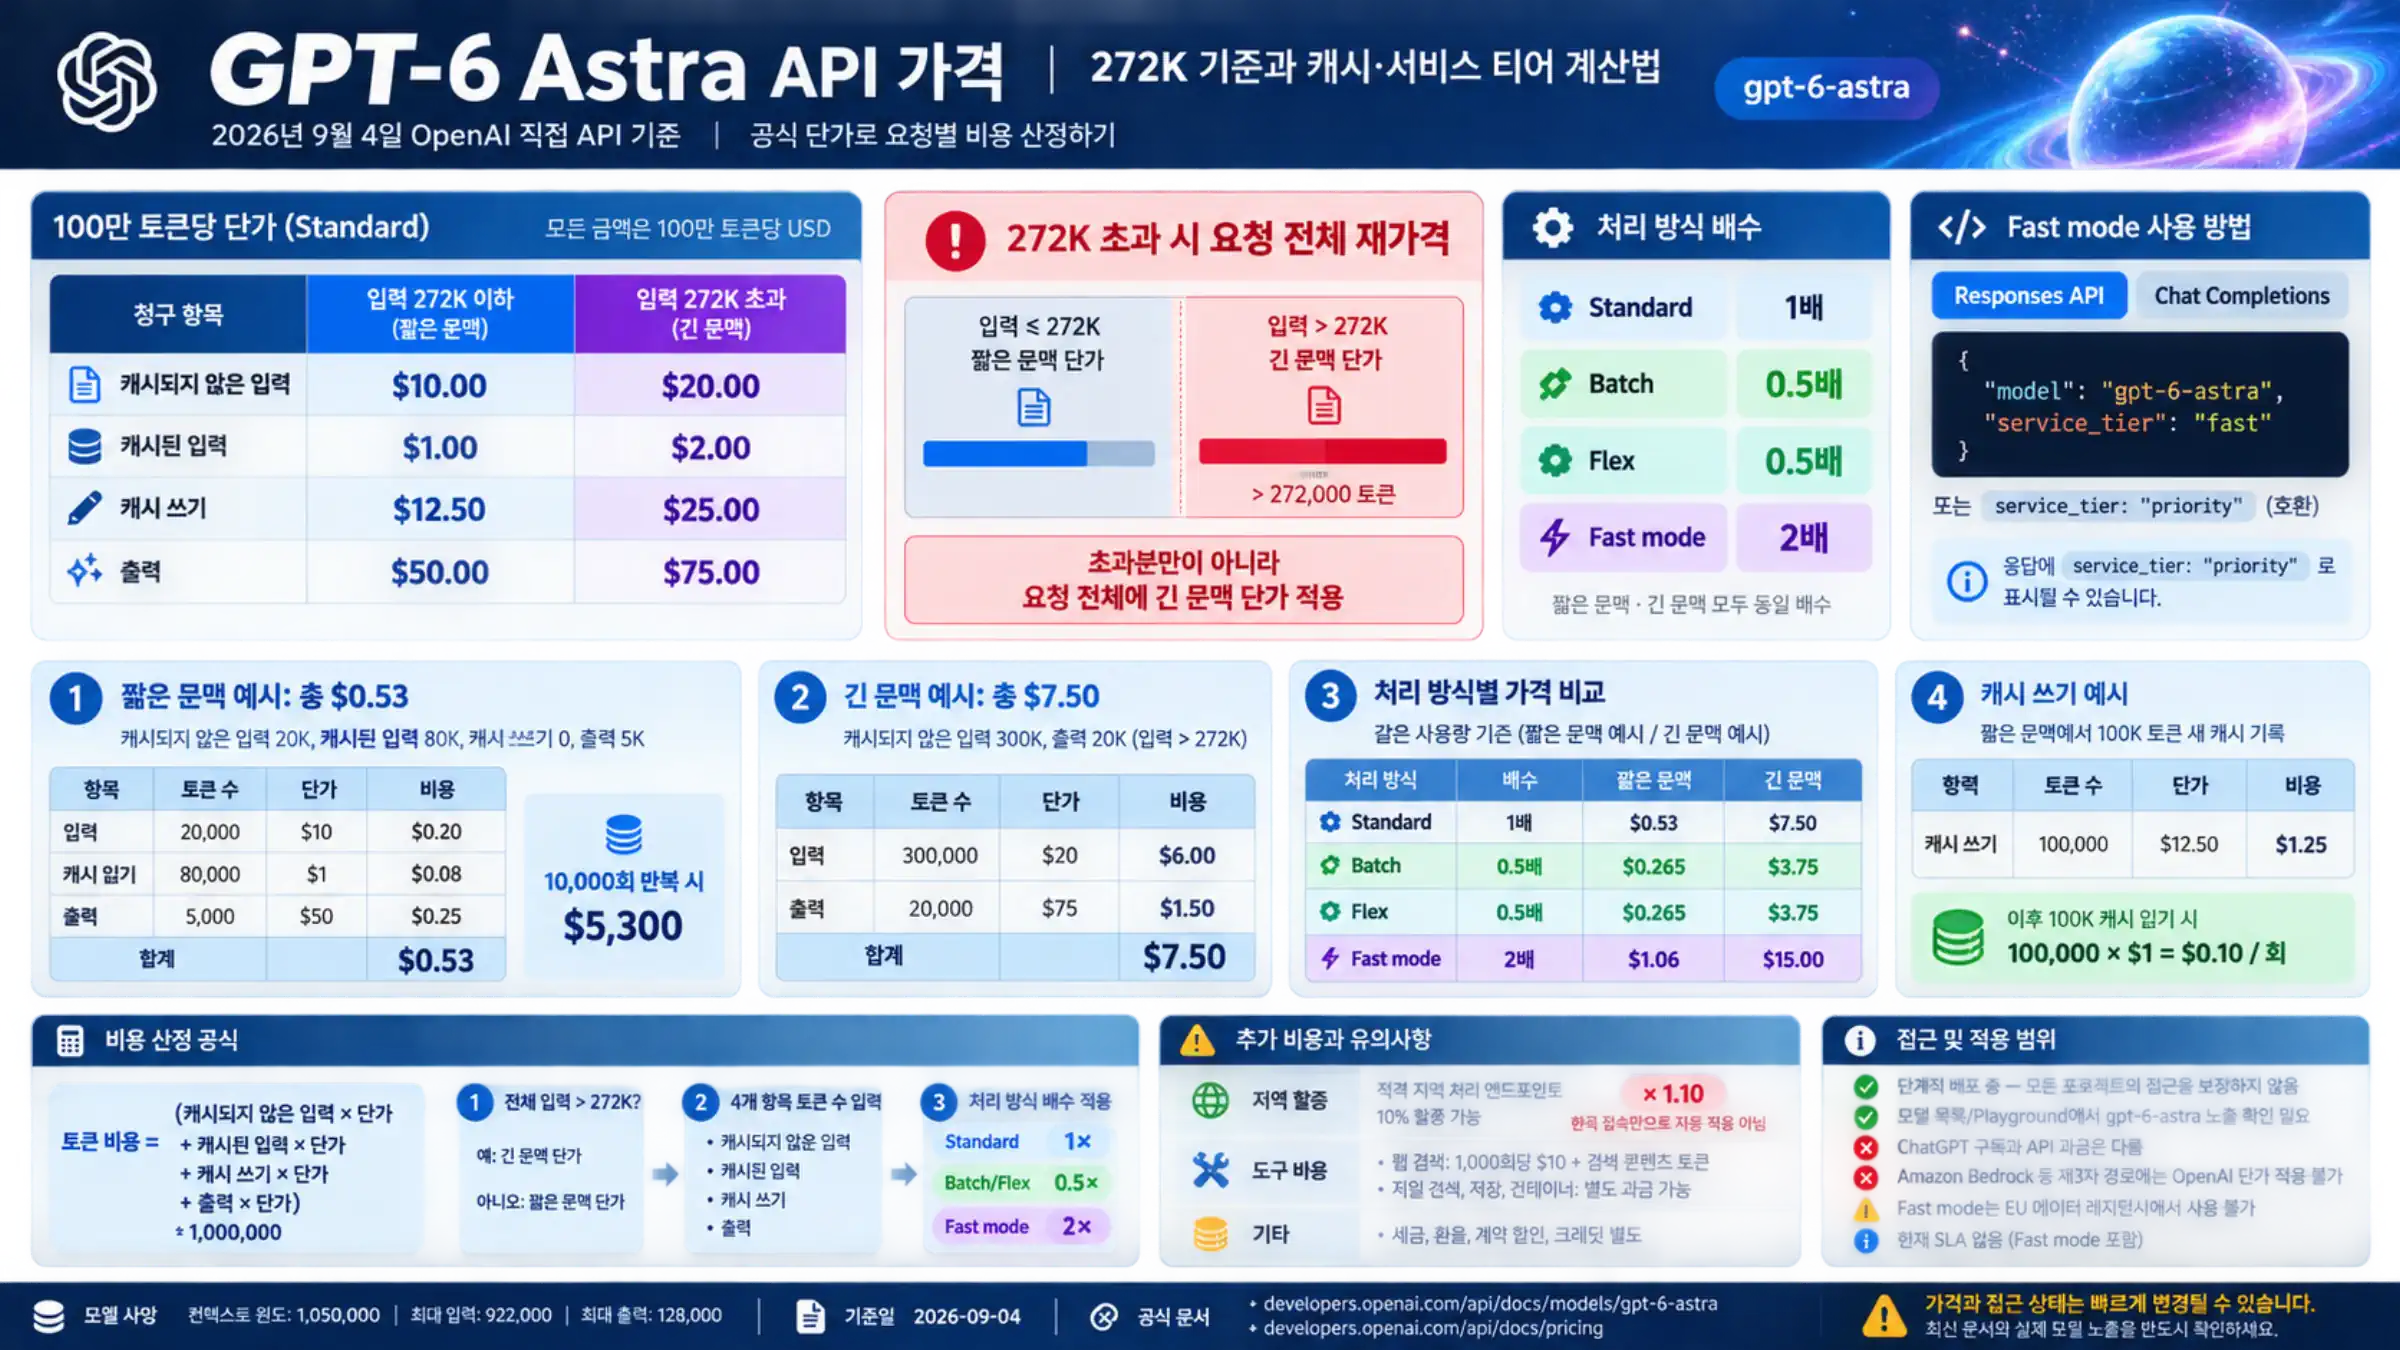
2026년 10월 26일 기준, OpenAI가 직접 청구하는 GPT-6 Astra(gpt-6-astra) API의 Standard 단가는 입력 272K 이하에서 100만 토큰당 입력 $10, 캐시된 입력 $1, 출력 $50이다. 캐시 쓰기 단가는 10월 20일부터 둘로 나뉘어 기본 30분 보관이 $12.50, 12시간 보관이 $25다. 입력이 272,000토큰을 넘으면 초과분만 비싸지는 것이 아니라 요청 전체가 입력 $20, 캐시된 입력 $2, 출력 $75의 긴 문맥 단가로 계산된다. 현재 USD 단가표는 OpenAI API 가격 페이지에서 확인할 수 있다.
예산에서 먼저 확인할 것은 캐시 설정이다. OpenAI는 GPT-5.6 이후 모델에서 프롬프트 캐시를 기본으로 켜 두고, 1,024토큰 이상인 앞부분을 일반 입력의 1.25배 단가로 캐시에 기록한다. 2026년 10월 26일 캐시 설정 없이 보낸 10,106토큰짜리 Astra 요청 한 건도 10,103토큰이 쓰기로 잡혔다. 같은 앞부분을 다시 쓰지 않는 요청이라면 Responses API에서 prompt_cache_options.mode를 "explicit"로 두고 브레이크포인트를 넣지 않아 쓰기 요금을 없애고, 30분보다 긴 간격으로 세 번 이상 쓰는 고정 앞부분, 즉 처음 기록한 뒤 두 번 이상 다시 읽는 앞부분이라면 ttl: "12h"로 기록하는 편이 가장 싸다.
아래 단가와 계산은 OpenAI Platform에서 직접 청구되는 gpt-6-astra 사용량에만 해당한다. ChatGPT Plus·Pro 같은 구독료, Amazon Bedrock, 다른 API 중개 서비스의 가격에는 그대로 대입할 수 없다. OpenAI는 달러로 청구하고 원화 금액은 결제 시 카드사가 적용하는 환율로 정해지므로, 예시는 모두 달러로 두고 세금·계약 할인·크레딧은 제외한다.
먼저 가격과 실제 접근 가능 여부를 나눠 확인한다
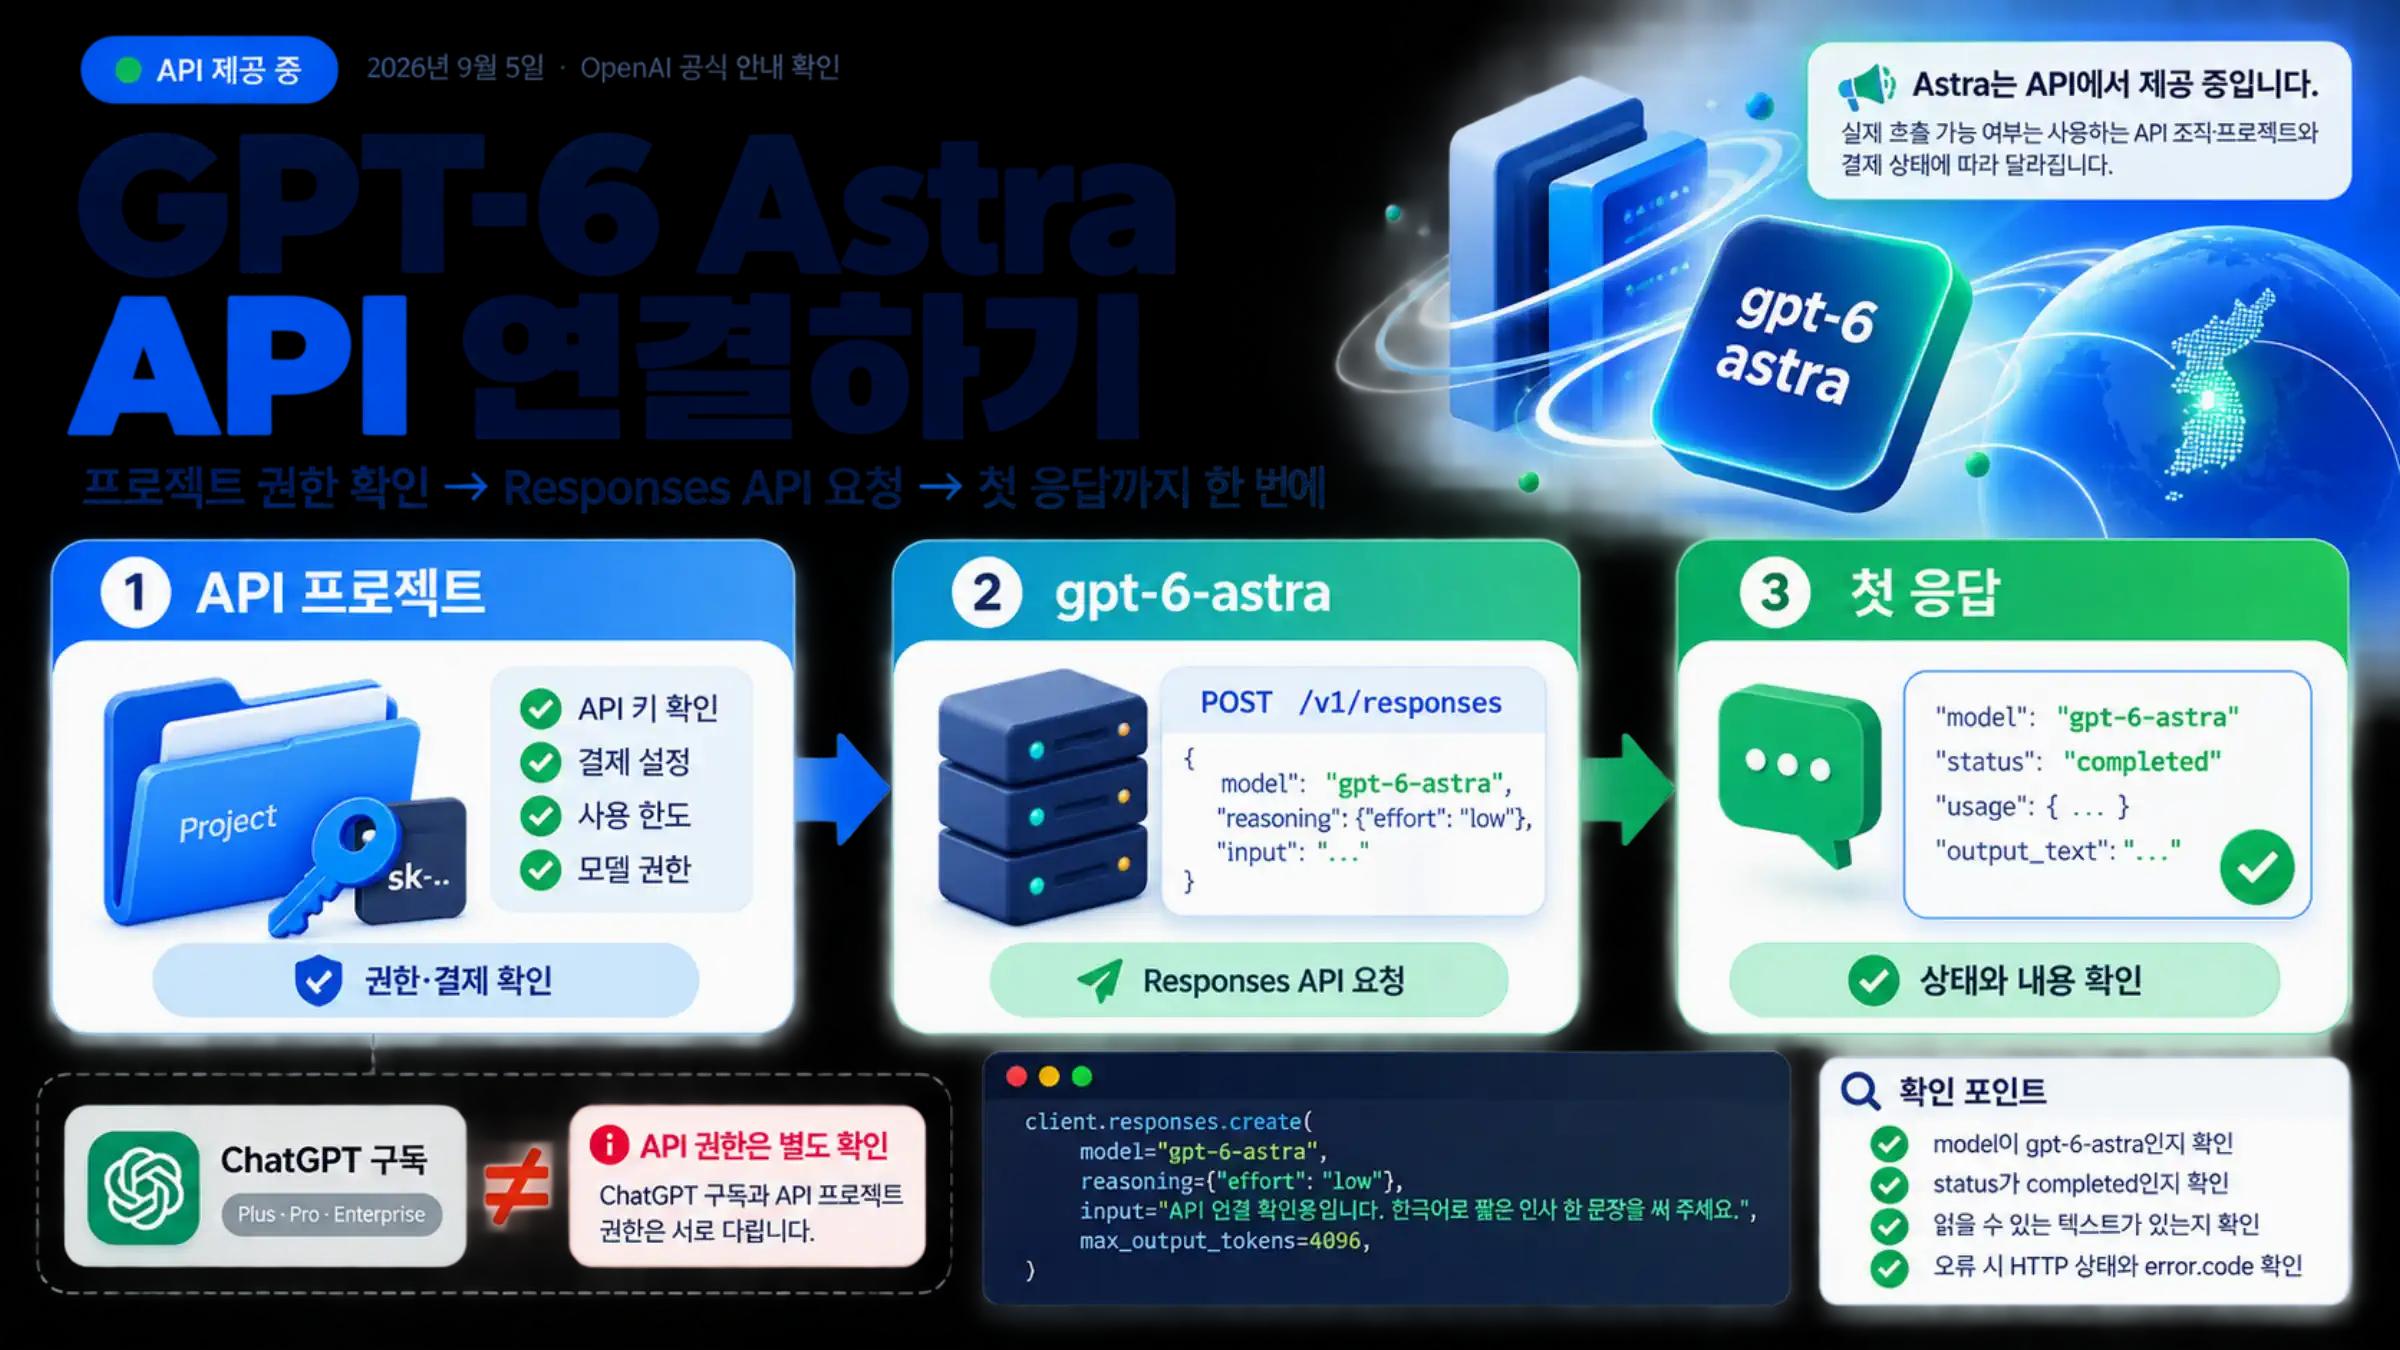
공식 가격표에 단가가 올라 있다는 사실은 내 프로젝트에서 지금 gpt-6-astra를 호출할 수 있다는 뜻이 아니다. Astra는 2026년 9월 3일 API에 공개됐지만 사용 한도는 조직의 API 사용 티어에 따라 다르고, 10월 21일부터는 조직이나 프로젝트 설정에서 쓸 수 있는 처리 방식(service tier)을 제한할 수 있게 됐다. 허용되지 않은 처리 방식을 요청하면 service tier 오류가 돌아오므로, 비용을 계산하기 전에 사용할 프로젝트에서 모델이 보이는지와 작은 요청이 성공하는지부터 확인한다. 프로젝트 권한과 첫 호출 절차는 GPT-6 Astra API 사용 방법: 프로젝트 권한 확인부터 첫 응답까지에 정리돼 있다.
호출 방식도 고를 수 있는 단가를 바꾼다. OpenAI 최신 모델 가이드에 따르면 Astra는 Responses, Chat Completions, Batch를 지원하지만 함수 호출은 Responses에서만 된다. 12시간 캐시 쓰기와 Ultrafast도 Responses API 전용이라, Chat Completions로 연결한 앱에는 이 두 가지가 선택지에 없다.
모델의 컨텍스트 윈도는 1,050,000토큰이지만 최대 입력은 922,000토큰, 최대 출력은 128,000토큰이다. 즉, “약 100만 토큰 문맥”을 “입력만 105만 토큰”으로 해석해서는 안 된다. 이 규격과 과금 기준은 서로 다른 제한이므로, 요청이 기술적으로 들어가는지와 얼마가 청구되는지를 각각 계산해야 한다.
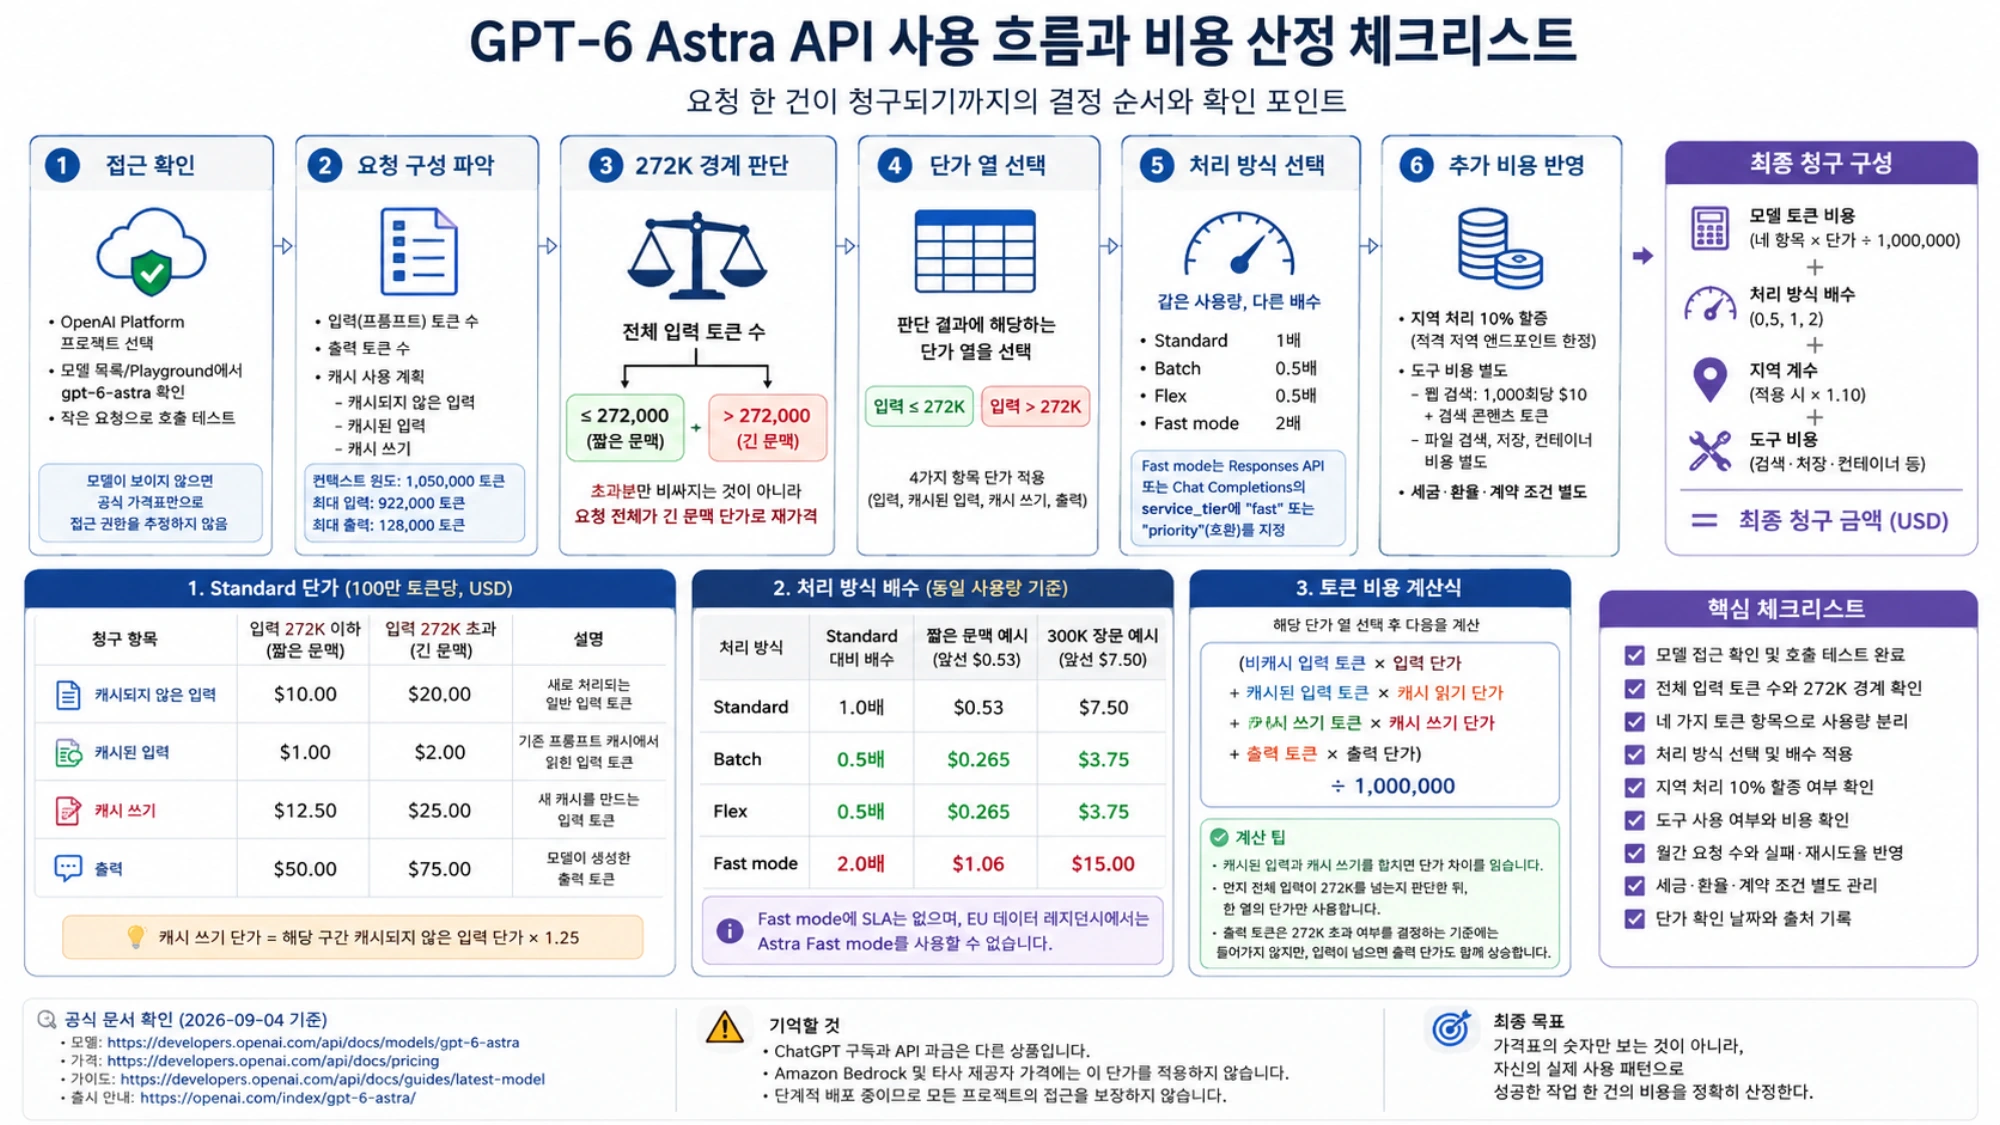
위 그림은 2026년 9월 4일 기준이다. 그림의 캐시 쓰기 $12.50·$25.00은 지금의 30분 쓰기 단가이며, 12시간 쓰기와 Ultrafast는 그림에 없다.
100만 토큰당 단가는 다섯 종류로 나뉜다
Standard 처리에서 Astra에 붙는 단가는 2026년 10월 26일 기준 다섯 가지다. 10월 20일 전에는 캐시 쓰기가 한 가지였지만, 지금은 캐시를 얼마나 오래 보관하느냐에 따라 30분과 12시간 두 단가로 나뉜다. 긴 문맥 여부는 입력 토큰 수로 판정한다.
| 청구 항목 | 입력 272K 이하 | 입력 272K 초과 | 계산할 때의 의미 |
|---|---|---|---|
| 캐시되지 않은 입력 | $10.00 | $20.00 | 새로 처리되는 일반 입력 토큰 |
| 캐시된 입력(읽기) | $1.00 | $2.00 | 기존 프롬프트 캐시에서 읽힌 입력 토큰 |
| 캐시 쓰기 30분 | $12.50 | $25.00 | 기본값, 일반 입력의 1.25배 |
| 캐시 쓰기 12시간 | $25.00 | $50.00 | Responses API에서 ttl: "12h" 지정 시, 일반 입력의 2.5배 |
| 출력 | $50.00 | $75.00 | 모델이 생성한 출력 토큰 |
모든 금액은 100만 토큰당 미화 달러다. 두 쓰기 단가는 일반 입력 위에 얹는 추가 요금이 아니라 그 토큰에 매기는 전체 단가이고, 캐시 읽기는 어느 기간으로 기록했든 같은 $1이다. GPT-6 Astra 모델 페이지에는 아직 “Cache writes $12.5” 한 줄만 있는데, 이는 30분 단가다. 12시간 단가는 가격 페이지와 OpenAI 프롬프트 캐싱 가이드에 함께 나온다.
요청별 토큰 비용은 다음처럼 산정할 수 있다.
토큰 비용 =
  (일반 입력 토큰 × 해당 입력 단가
 + 캐시 읽기 토큰 × 해당 캐시된 입력 단가
 + 30분 쓰기 토큰 × 해당 30분 쓰기 단가
 + 12시간 쓰기 토큰 × 해당 12시간 쓰기 단가
 + 출력 토큰 × 해당 출력 단가)
  ÷ 1,000,000

일반 입력 토큰 = input_tokens − cached_tokens − cache_write_tokens
Responses API 응답의 usage.input_tokens_details에는 캐시 읽기 cached_tokens와 쓰기 합계 cache_write_tokens가 오고, prompt_cache_options를 지원하는 모델이면 cache_write_tokens_details 아래에 ttl_30m_tokens와 ttl_12h_tokens가 함께 온다. 두 ttl 값은 겹치지 않고 합하면 cache_write_tokens가 되므로, 각각 단가를 곱한 뒤 cache_write_tokens를 다시 더하면 쓰기를 두 번 세게 된다. cached_tokens에는 쓰기로 청구된 토큰이 들어가지 않는다. 2026년 10월 26일의 Chat Completions 호출(아래 캐시 절)에서는 쓰기 토큰이 prompt_tokens_details.cache_write_tokens로 돌아왔다.
먼저 요청의 전체 입력이 272,000토큰을 넘는지 판정하고 표의 한 열만 선택한 다음, 실제 사용량에서 다섯 항목을 분리해 넣는다. 캐시된 입력과 캐시 쓰기를 하나의 “캐시 토큰”으로 합치면 단가 차이를 잃게 된다.
짧은 문맥에서 $0.53이 나오는 예시
한 Standard 요청이 캐시되지 않은 입력 20,000토큰, 캐시된 입력 80,000토큰, 캐시 쓰기 0토큰, 출력 5,000토큰을 사용했다고 가정하자. 전체 입력은 100,000토큰이므로 짧은 문맥 단가를 쓴다.
입력       20,000 × $10    ÷ 1,000,000 = $0.20
캐시 읽기  80,000 × $1     ÷ 1,000,000 = $0.08
출력        5,000 × $50    ÷ 1,000,000 = $0.25
합계                                      = $0.53
같은 토큰 구성이 10,000회 반복되면 토큰 비용은 $5,300이다. 이 계산은 모든 요청이 같은 사용량을 기록하고 캐시 쓰기, 도구 비용, 지역 할증, 세금, 실패 후 재시도가 없다는 가정에만 맞는다.
캐시가 기본으로 켜진 상태라면 새로 들어온 20,000토큰도 캐시에 기록될 수 있다. 그 경우 이 20,000토큰은 일반 입력 $0.20이 아니라 30분 쓰기 20,000 × $12.50 ÷ 1,000,000 = $0.25로 청구되고, 합계는 $0.58이 된다.
캐시는 기본으로 켜져 있다: 다시 읽지 않는 긴 프롬프트는 25% 더 낸다
OpenAI 프롬프트 캐싱 가이드는 지원 모델에서 캐시가 기본으로 켜져 있다고 밝히며, GPT-5.6 이후 모델(Astra 포함)의 30분 쓰기는 일반 입력의 1.25배로 청구된다. 기본으로 켜져 있다는 말은 자동 할인이 아니라, OpenAI가 최신 메시지 끝에 브레이크포인트를 두고 1,024토큰 이상인 앞부분을 쓰기 단가로 기록한다는 뜻이다. 같은 앞부분이 다시 읽히면 그 토큰은 $1로 줄지만, 다시 읽히지 않으면 $10 대신 $12.50을 낸 셈이 된다.
2026년 10월 26일 LaoZhang API 게이트웨이(laozhang.ai)를 거쳐 gpt-6-astra에 Chat Completions 요청을 한 번 보냈다. 캐시 옵션과 추론 강도는 지정하지 않았고, 프롬프트는 긴 영어 기사와 5줄 요약 지시로 된 10,106토큰이었다. 응답 usage에는 cache_write_tokens: 10103, cached_tokens: 0, 출력 328토큰이 기록됐다. 공시 단가로 계산하면 (3 × $10 + 10,103 × $12.50 + 328 × $50) ÷ 1,000,000 ≈ $0.1427이고, 같은 프롬프트를 일반 입력으로만 계산하면 약 $0.1175다. 한 번만 쓰는 요청이 읽히지 않을 캐시 때문에 약 $0.025, 입력 부분 기준 25%를 더 낸 것이다. 같은 날 약 1K 토큰 미만 프롬프트에서는 쓰기가 생기지 않았다. 경로 하나에서 한 번 호출한 관찰이며, OpenAI 직결 계정과 Responses API 경로는 이 호출에 포함되지 않았다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
재사용 계획이 없는 요청에서 쓰기 요금을 없애려면 Responses API에서 prompt_cache_options.mode를 "explicit"로 지정하고 브레이크포인트를 하나도 두지 않는다. 가이드는 이때 요청이 캐시를 사용하지도 기록하지도 않는다고 설명한다. 고정 지시문 뒤에만 prompt_cache_breakpoint를 두면 그 앞부분만 기록되고, 마지막 브레이크포인트 뒤의 질문은 쓰기 요금 없이 일반 입력으로 청구된다. 요청 하나에서 만들 수 있는 쓰기는 최대 4개다.
{
  "model": "gpt-6-astra",
  "prompt_cache_options": { "mode": "explicit" },
  "input": [
    {
      "role": "user",
      "content": [
        { "type": "input_text", "text": "한 번만 처리할 긴 문서와 질문..." }
      ]
    }
  ]
}
가이드의 설정 예시는 모두 Responses API 기준이며, Chat Completions에서 prompt_cache_options를 받는지는 가이드에 나와 있지 않다. 같은 대화에서 기본 모드로 캐시한 앞부분을 다음 요청에서 explicit 모드로 바꾸면 이전 캐시를 찾지 못할 수 있으므로, 대화 도중이 아니라 요청 유형별로 모드를 정해 두는 편이 안전하다.
30분·12시간·캐시 없음 중 무엇이 싼가: 재사용 간격과 횟수로 정한다
같은 앞부분을 12시간 안에 몇 번, 얼마 간격으로 다시 쓰느냐가 기준이다. 요청 간격이 30분을 넘으면 30분 캐시는 매번 만료돼 다시 기록될 수 있으므로, 세 번째 사용부터는 12시간 쓰기가 가장 싸고 한두 번만 쓰면 캐시 없음이 가장 싸다. 요청이 30분 안에 이어지면 읽을 때마다 보관 기간이 30분씩 연장되므로 기본 30분이 12시간보다 싸다. 아래 표는 100,000토큰 앞부분을 Standard 짧은 문맥 단가로 쓸 때의 입력 쪽 비용이다.
| 사용 패턴 (100K 토큰 앞부분) | 캐시 없음 | 기본 30분 | 12시간 |
|---|---|---|---|
| 30분 넘는 간격으로 1회 | $1.00 | $1.25 | $2.50 |
| 30분 넘는 간격으로 2회 | $2.00 | $2.50 | $2.60 |
| 30분 넘는 간격으로 3회 | $3.00 | $3.75 | $2.70 |
| 1시간 간격으로 10회 | $10.00 | $12.50 | $3.40 |
| 5분 간격으로 10회 | $10.00 | $2.15 | $3.40 |
계산식은 캐시 없음이 사용 횟수 n × $1.00, 12시간이 첫 쓰기 $2.50 + 읽기 $0.10 × (n − 1)이다. 기본 30분은 간격이 30분을 넘을 때 매번 만료된다고 본 최대치 n × $1.25이며, OpenAI가 최소 기간보다 오래 보관하면 일부가 읽기로 잡혀 더 싸질 수 있다. 5분 간격이면 30분은 $1.25 + $0.10 × 9 = $2.15다. 요청 전체가 272K를 넘는 긴 문맥에서는 모든 단가가 같은 비율로 오르므로 판단은 같다. 300,000토큰 앞부분이면 캐시 없음 $6.00, 30분 쓰기 $7.50, 12시간 쓰기 $15.00, 읽기 1회 $0.60이다.
12시간은 Responses API에서 prompt_cache_options.ttl을 "12h"로 주거나 브레이크포인트마다 prompt_cache_breakpoint.ttl로 지정하며, 지원하지 않는 값은 400 invalid_request_error가 된다. 이미 30분으로 기록된 앞부분을 12시간으로 올리면 새 12시간 쓰기로 다시 청구되고 앞선 30분 쓰기는 차감되지 않으므로, 하루 종일 쓸 고정 지시문이나 참고 자료는 첫 요청부터 12시간으로 기록한다. 한 요청 안에서 지시문은 12시간, 자주 바뀌는 세션 문맥은 30분으로 섞을 수도 있다. 12시간은 캐시 읽기 단가를 받을 수 있는 최소 기간이지, 그동안 지연 시간이 줄어든다는 보장은 아니다.
272K를 넘으면 초과분이 아니라 요청 전체에 높은 단가가 적용된다
GPT-6 Astra에서 가장 자주 놓치기 쉬운 부분은 272K가 누진 구간이 아니라는 점이다. 공식 모델 가격 주석에 따르면 입력 프롬프트가 272K를 초과하면 입력과 캐시 단가는 2배, 출력 단가는 1.5배가 요청 전체에 적용된다. 두 캐시 쓰기 단가도 이 규칙을 따라 $25와 $50이 된다.
캐시되지 않은 입력 300,000토큰과 출력 20,000토큰을 사용한 Standard 요청을 계산하면 다음과 같다.
입력  300,000 × $20 ÷ 1,000,000 = $6.00
출력   20,000 × $75 ÷ 1,000,000 = $1.50
합계                                = $7.50
처음 272,000토큰에 $10을 적용하고 나머지 28,000토큰에만 $20을 적용하는 방식은 틀리다. 출력 토큰은 272K 초과 여부를 정하는 기준에는 들어가지 않지만, 입력이 기준을 넘으면 해당 요청의 출력에도 $75 단가가 적용된다. 그래서 경계 근처에서는 작은 차이가 크게 벌어진다. 출력 20,000토큰은 같고 입력만 271,000토큰이면 $2.71 + $1.00 = $3.71이지만, 273,000토큰이면 $5.46 + $1.50 = $6.96이다.
긴 문서를 여러 번 다룬다면 컨텍스트를 무조건 채우기 전에 요청 분할, 검색으로 필요한 부분만 선별하기, 안정적인 공통 프리픽스의 캐시 재사용을 함께 비교할 가치가 있다. 다만 요청 분할이 결과 품질이나 재시도 횟수를 악화시키면 작업당 비용은 오히려 늘 수 있으므로 대표 데이터로 확인해야 한다.
Batch·Flex·Fast mode에 따라 적용 단가가 달라진다
GPT-6 Astra의 공식 가격 관계는 단순하다. Batch와 Flex는 Standard의 50%, Fast mode는 2배, 9월 29일 추가된 Ultrafast는 6배다. 두 캐시 쓰기에도 같은 배수가 적용되고, 짧은 문맥과 긴 문맥 모두 이 관계를 유지한다. Standard 단가는 앞의 표와 같고, 나머지 처리 방식의 짧은 문맥 단가는 OpenAI API 가격 페이지 기준 다음과 같다.
| 처리 방식 | 입력 | 캐시된 입력 | 30분 쓰기 | 12시간 쓰기 | 출력 |
|---|---|---|---|---|---|
| Batch·Flex | $5.00 | $0.50 | $6.25 | $12.50 | $25.00 |
| Fast mode | $20.00 | $2.00 | $25.00 | $50.00 | $100.00 |
| Ultrafast | $60.00 | $6.00 | $75.00 | $150.00 | $300.00 |
입력이 272K를 넘으면 어느 처리 방식이든 입력·캐시 단가는 2배, 출력은 1.5배가 된다. 예를 들어 Ultrafast의 긴 문맥 단가는 입력 $120, 캐시된 입력 $12, 30분 쓰기 $150, 12시간 쓰기 $300, 출력 $450이다. 같은 토큰 구성을 처리 방식만 바꿔 계산하면 다음과 같다.
| 처리 방식 | Standard 대비 | 앞의 $0.53 예시 | 300K 장문 예시 |
|---|---|---|---|
| Standard | 1배 | $0.53 | $7.50 |
| Batch | 0.5배 | $0.265 | $3.75 |
| Flex | 0.5배 | $0.265 | $3.75 |
| Fast mode | 2배 | $1.06 | $15.00 |
| Ultrafast | 6배 | $3.18 | $45.00 |
이 표는 토큰 구성이 완전히 같다는 가정의 가격 비교다. 실제로 어떤 처리 방식을 사용할 수 있는지, 지연 시간이 업무 요구에 맞는지, 같은 품질과 재시도율을 유지하는지는 별도로 검증해야 한다. 가격 배수가 성능이나 완료 시간을 보장하지는 않는다.
Fast mode를 요청 수준에서 선택할 때는 Responses API 또는 Chat Completions의 service_tier에 "fast"를 지정하고, 호환용 "priority"도 같은 동작을 한다. 응답과 사용량 대시보드에 priority로 표시되는 것은 GPT-5.6 이하 모델이다. GPT-6 Astra의 Fast mode에는 지연 시간 SLA가 없고 EU 데이터 레지던시와 함께 사용할 수 없다. 또 OpenAI Fast mode 가이드에 따르면 트래픽을 너무 빨리 늘리면 일부 Fast 요청이 Standard 속도로 처리되고 Standard 요금이 청구되며 응답에 service_tier: "default"가 표시되므로, 청구액을 다시 계산할 때는 요청이 아니라 응답에 표시된 처리 방식으로 단가를 고른다.
Ultrafast는 Responses API에서 service_tier: "ultrafast"로 지정하며 모든 API 사용자가 쓸 수 있지만, Standard·Fast와 별도의 TPM 한도가 걸린다. OpenAI Ultrafast 가이드에 나온 Astra 기본 한도는 Build 500,000, Launch 1,000,000, Grow 5,000,000 TPM이다. 글로벌 처리와 미국 데이터 레지던시에서만 되고 EU 등 다른 지역 레지던시는 지원하지 않으며, OpenAI는 도구 호출이 잦은 에이전트에 WebSocket 연결을 권한다. Astra에서 Ultrafast가 Standard보다 몇 배 빠른지는 공식 문서에 수치가 없으므로, 6배 단가를 낼 가치는 직접 잰 응답 시간으로 판단해야 한다.
Batch나 Flex가 단가상 저렴하다고 해서 실시간 사용자 요청에 자동으로 적합한 것은 아니다. 반대로 Fast mode와 Ultrafast도 대기 시간을 줄이는 이익이 추가 요금보다 클 때 선택해야 한다. 월간 예산을 만들 때는 처리 방식별 요청 비중을 나눠 계산하는 편이 정확하다.
지역 할증과 도구 비용도 추가해야 한다
토큰 표만 맞춰도 최종 청구액이 달라질 수 있는 항목이 있다.
- 데이터 레지던시가 가능한 2026년 3월 5일 이후 출시 모델의 적격 지역 처리 엔드포인트에는 10% 할증이 붙는다. 한국에서 접속한다는 사실만으로 이 할증을 적용해서는 안 되며, 선택한 엔드포인트와 프로젝트 자격을 확인해야 한다. 적용 대상이라면 앞서 계산한 모델 토큰 비용에 1.10을 곱한다.
- 웹 검색은 호출 1,000회당 $10에 검색 콘텐츠 토큰이 선택한 모델 단가로 추가 청구된다. 파일 검색은 호출과 저장 공간, 호스팅 컨테이너는 세션·용량 기준 비용이 별도로 생길 수 있다. 현재 항목별 금액은 OpenAI 가격 페이지의 Tools 표에서 확인하는 것이 안전하다.
- 일반 API 엔드포인트 호출 자체에 별도 정액 호출료가 붙는 것은 아니지만, 모델 토큰과 실제로 사용한 유료 도구는 청구된다.
- 부가세, 계약 단가와 프로모션 크레딧은 계정 청구 설정에 따라 달라진다. 원화로 비용을 보고해야 한다면 OpenAI 청구서의 USD 금액과 카드 명세서의 원화 금액을 따로 기록하고 환율 기준일을 남기는 편이 좋다.
따라서 실무 추정식은 모델 토큰 비용 × 해당 시 지역 계수 + 도구 호출·저장·컨테이너 비용으로 잡고, 세금과 계약 조건은 별도 항목으로 두면 누락을 찾기 쉽다.
ChatGPT 구독과 제3자 가격에는 이 단가를 대입하지 않는다
ChatGPT에서 GPT-6 Astra를 사용할 수 있는 플랜이 있다는 안내와 OpenAI API 토큰 청구는 같은 상품이 아니다. ChatGPT 구독을 보유해도 API 크레딧이나 특정 API 프로젝트의 접근 권한이 자동으로 생기지 않고, 반대로 API 가격표는 ChatGPT 월 구독료를 계산하는 표가 아니다. 무료 플랜에서 어떤 모델이 제공되는지는 GPT-6 무료 사용: 무료 플랜은 GPT-6 Luna, Sol·Astra는 유료 요금제에, 구독과 API 중 어느 쪽이 내 사용량에 맞는지는 ChatGPT Plus와 API 차이: 내 사용량으로 비용 계산하기에 나와 있다.
Amazon Bedrock이나 Microsoft Azure를 통해 OpenAI 모델을 쓴다면 청구는 그 서비스가 한다. OpenAI API 가격 페이지도 Bedrock과 Azure의 OpenAI 모델은 해당 서비스를 통해 청구된다고 적고 각 서비스의 가격 페이지로 안내하므로, 그 경로에서 Astra를 쓸 수 있더라도 가격은 OpenAI 직결 단가가 아니라 AWS나 Azure의 가격표로 확인한다. 다른 게이트웨이 역시 해당 사업자의 모델 식별자, 마진, 환율, 실패 과금, 캐시 지원과 서비스 조건을 따르므로, gpt-6-astra라는 이름이 같다는 이유만으로 OpenAI 직결 단가를 적용하면 안 된다. 예를 들어 LaoZhang API(laozhang.ai)의 가격표는 2026년 10월 26일 기준 gpt-6-astra를 OpenAI Standard 공시 단가와 같은 숫자로 게시하지만, 캐시 쓰기는 30분 단가 하나뿐이고 12시간 쓰기 단가는 게시되어 있지 않다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
비교 기준은 간단하다. OpenAI Platform 프로젝트에서 직접 호출하면 공식 단가와 실제 사용량을 사용한다. ChatGPT 안에서 사용하면 해당 구독 조건을 본다. Bedrock이나 다른 제공자를 통하면 그 제공자의 현재 가격표와 청구 기록을 기준으로 삼는다.
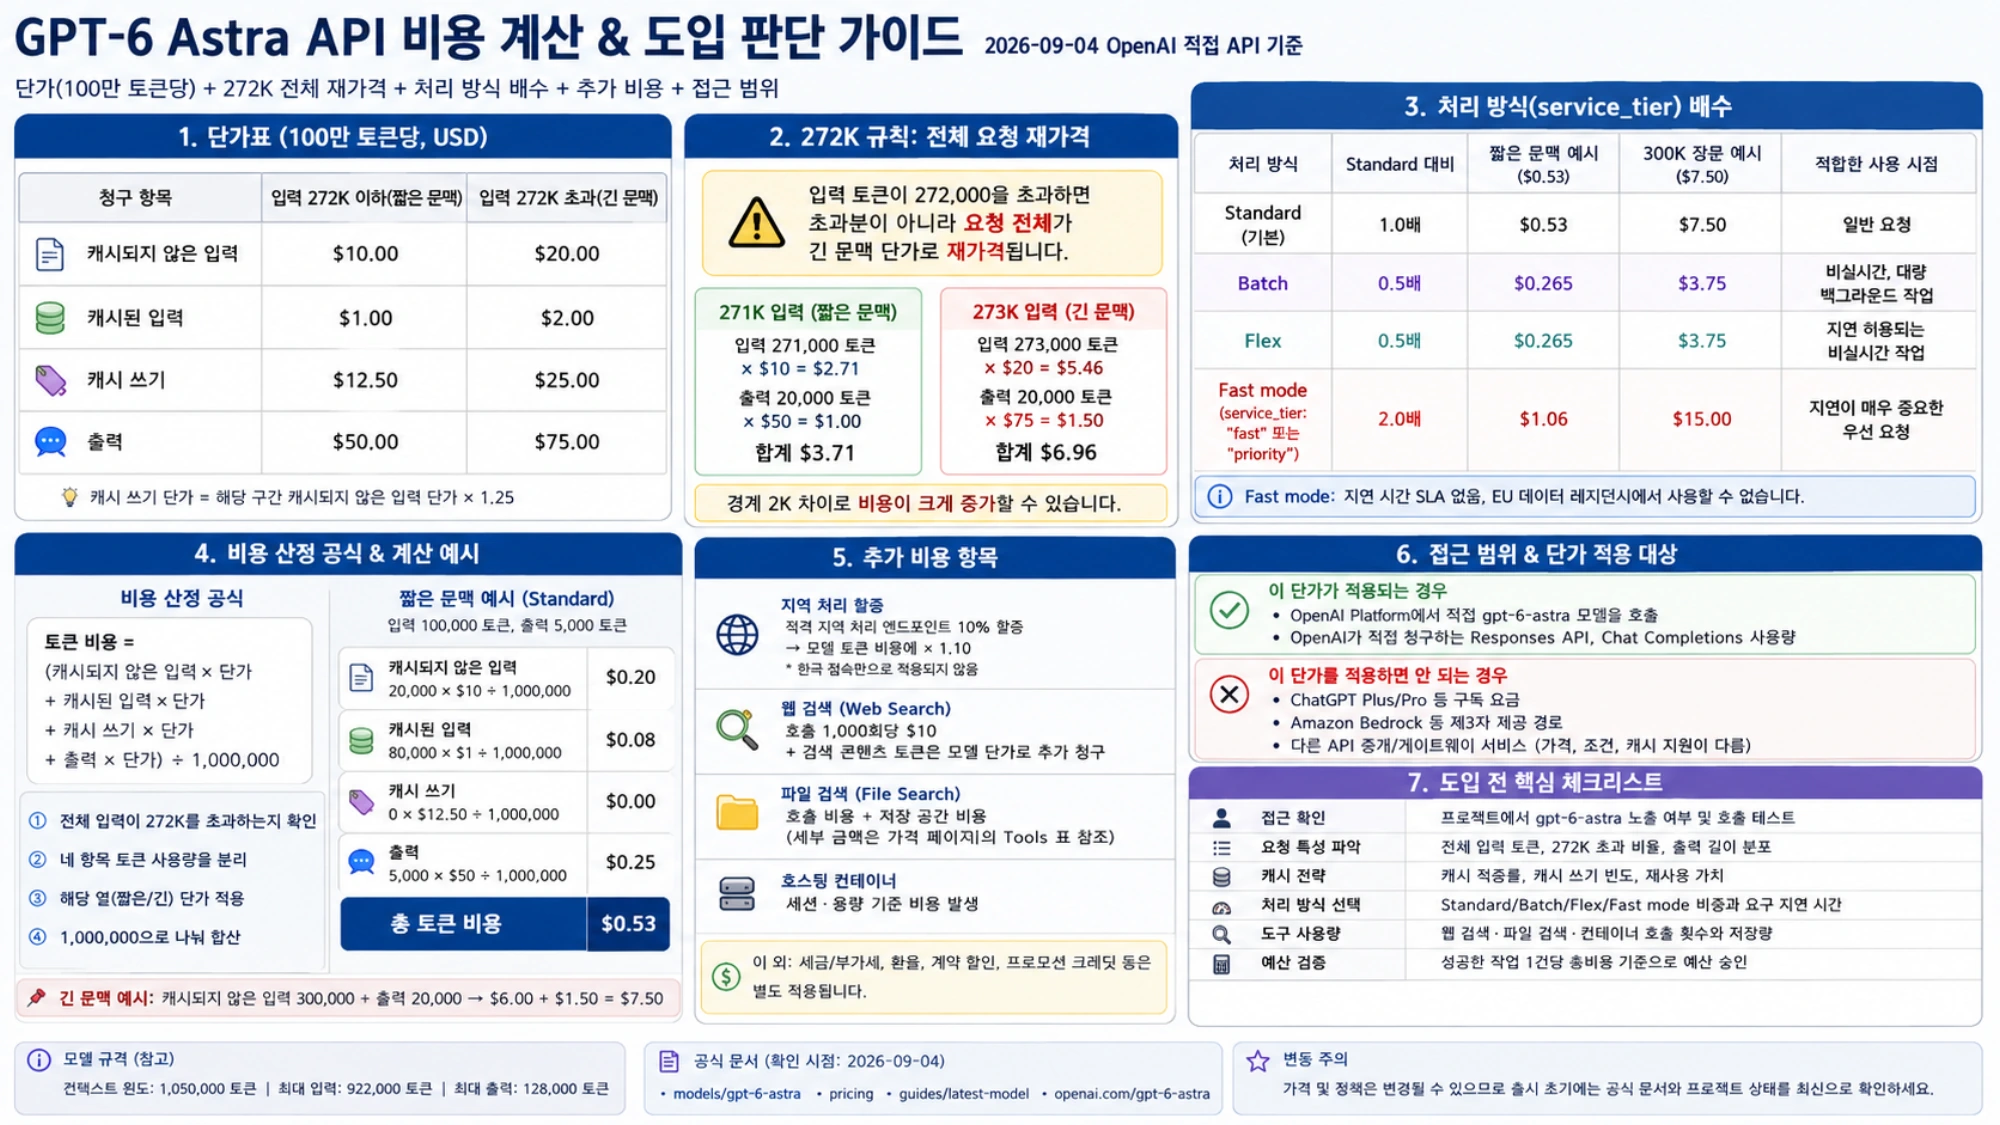
위 그림도 2026년 9월 4일 기준이다. 그림의 캐시 쓰기 단가는 30분 쓰기이며, 처리 방식 표에는 Ultrafast(6배)가 빠져 있다.
예산 승인은 요청 단가보다 성공한 작업 단가로 한다
견적을 낼 때 평균 프롬프트 하나만 계산하면 캐시 적중률, 장문 경계, 출력 편차와 재시도를 놓치기 쉽다. 실제 도입 전에는 대표 요청 묶음에서 다음 값을 기록하는 편이 유용하다.
- 요청별 전체 입력 토큰과 272K 초과 여부
- 일반 입력, 캐시 읽기, 30분 쓰기(
ttl_30m_tokens), 12시간 쓰기(ttl_12h_tokens), 출력의 실제 분포 - 응답의
cache_write_tokens가 의도한 앞부분에서만 생기는지, 다시 읽히지 않는 쓰기가 얼마나 되는지 - Standard, Batch, Flex, Fast mode, Ultrafast별 요청 비중
- 웹 검색·파일 검색·컨테이너 사용 횟수와 저장량
- 실패, 사용자 수정, 재시도로 추가된 호출 수
그다음 월간 요청 수 × 요청당 토큰 비용에 처리 방식·지역·도구 비용을 반영한다. 최종 의사결정에는 성공한 결과 한 건을 얻기까지 든 총비용을 사용한다. GPT-6 Astra의 높은 토큰 단가가 더 적은 출력이나 재시도로 상쇄되는지는 가격표가 아니라 자신의 작업 데이터로만 판단할 수 있다. 일부 제3자 사이트에 보이는 “Astra Pro”도 별도 단가가 있는 모델이 아니다. OpenAI API의 pro 모드(reasoning.mode: "pro")는 Astra 표준 단가로 청구되고, 모델 작업량이 늘어난 만큼 토큰 사용량과 비용이 커진다.
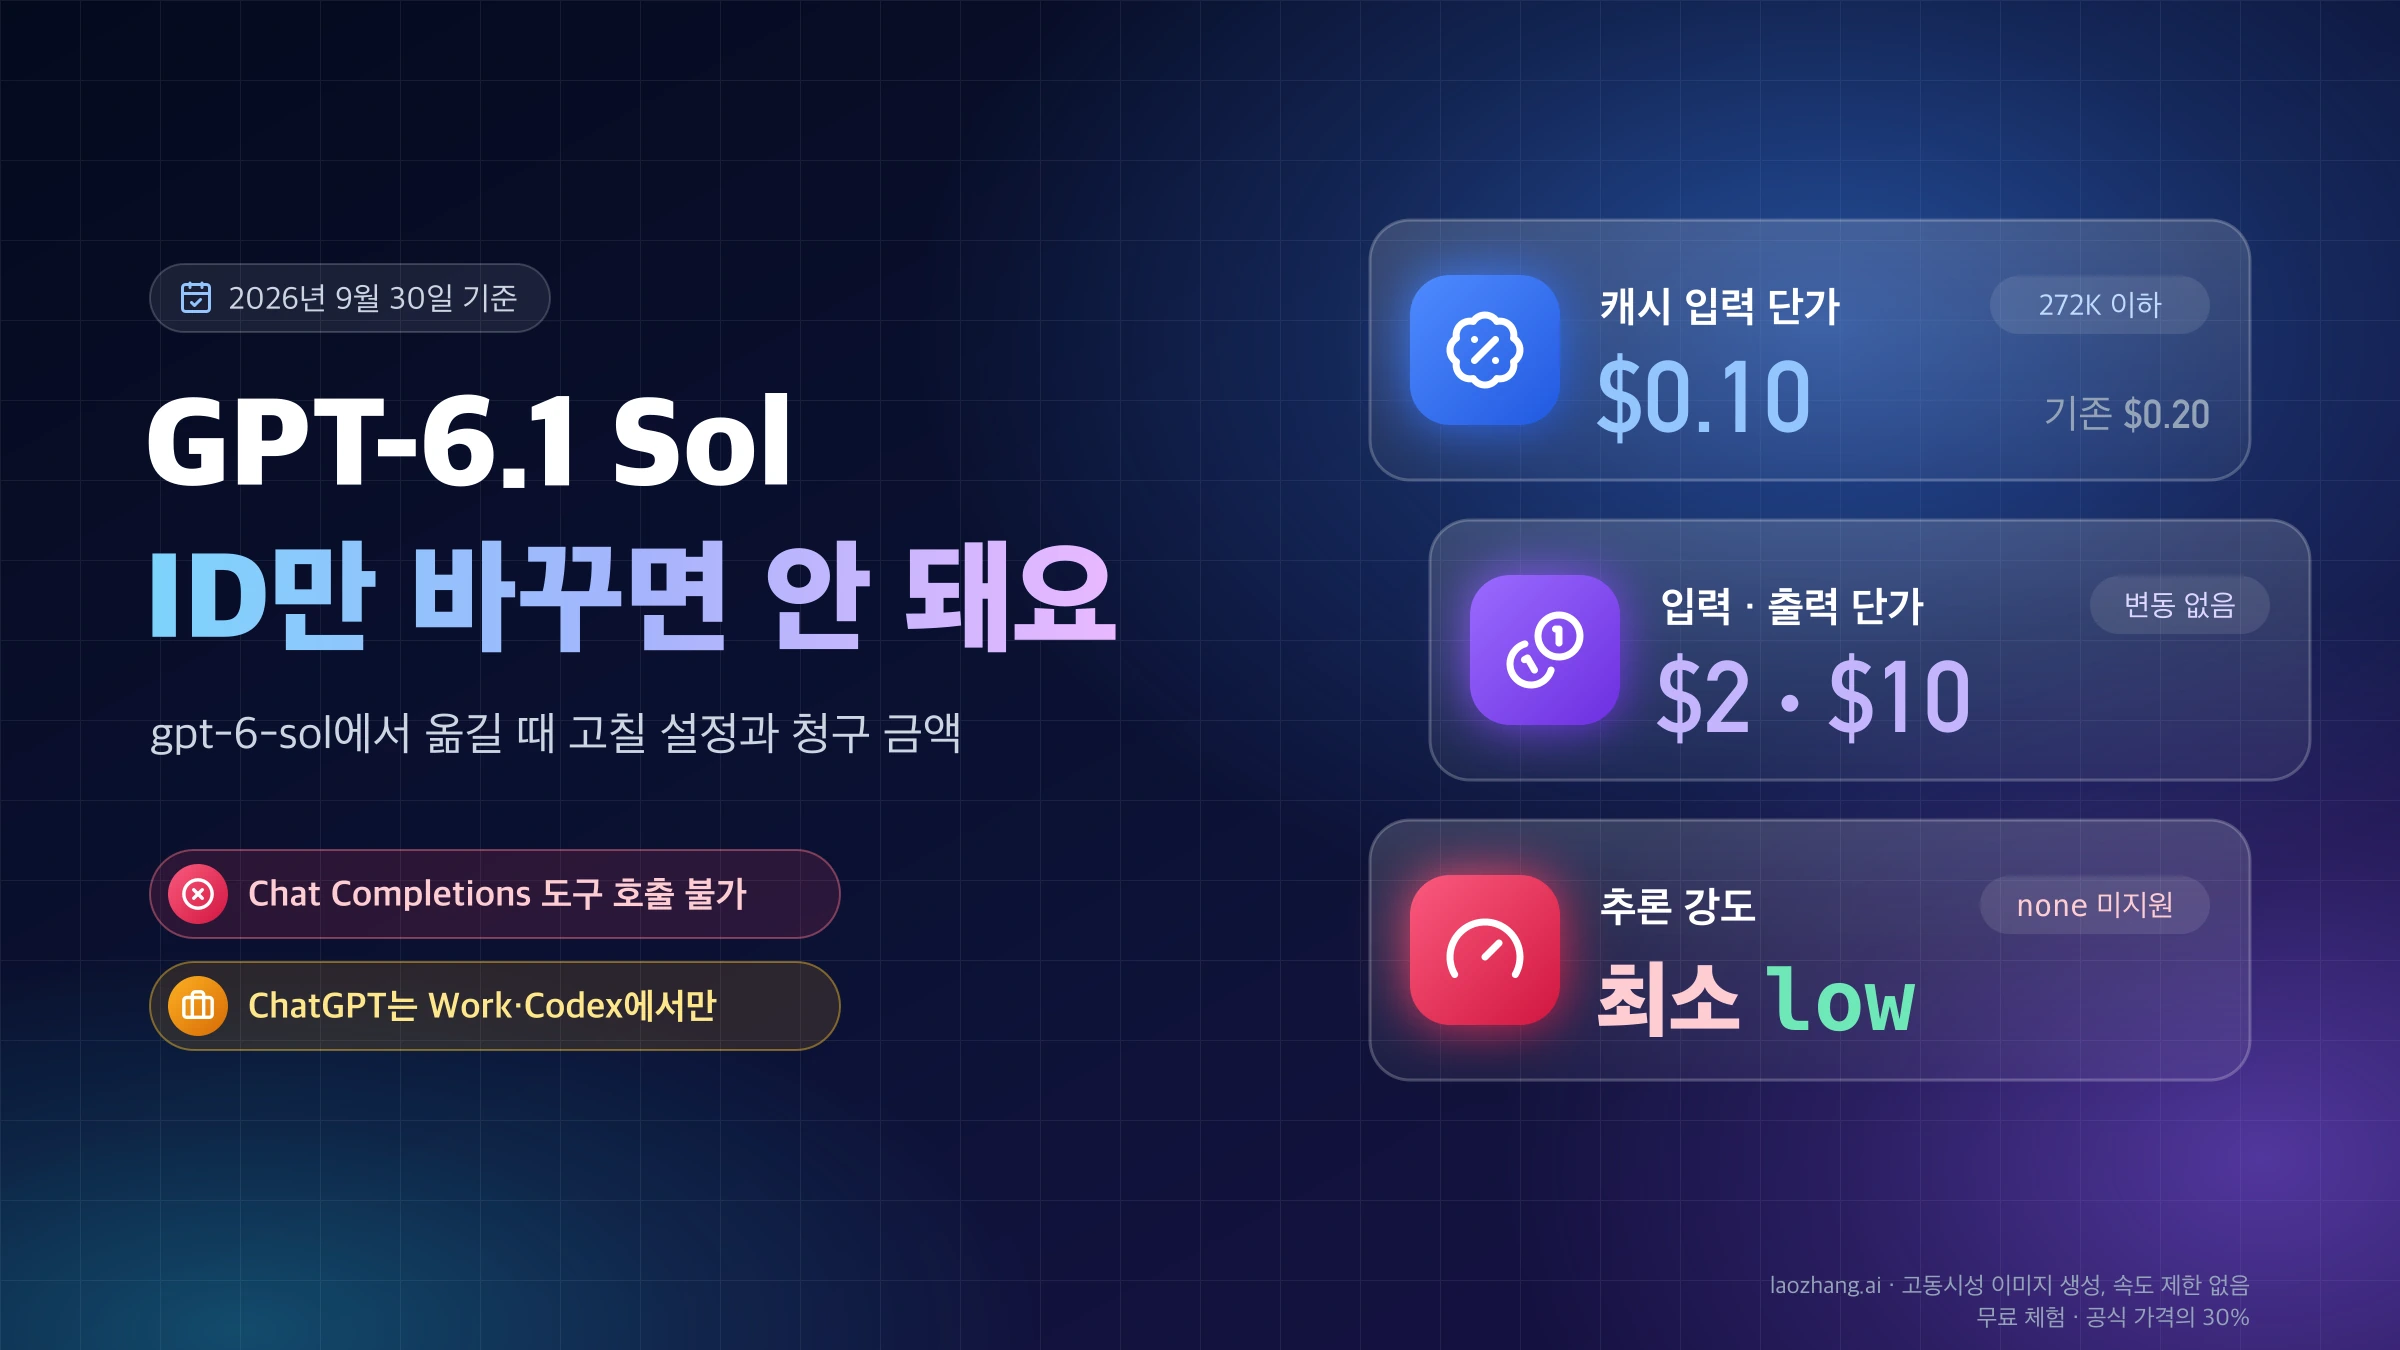
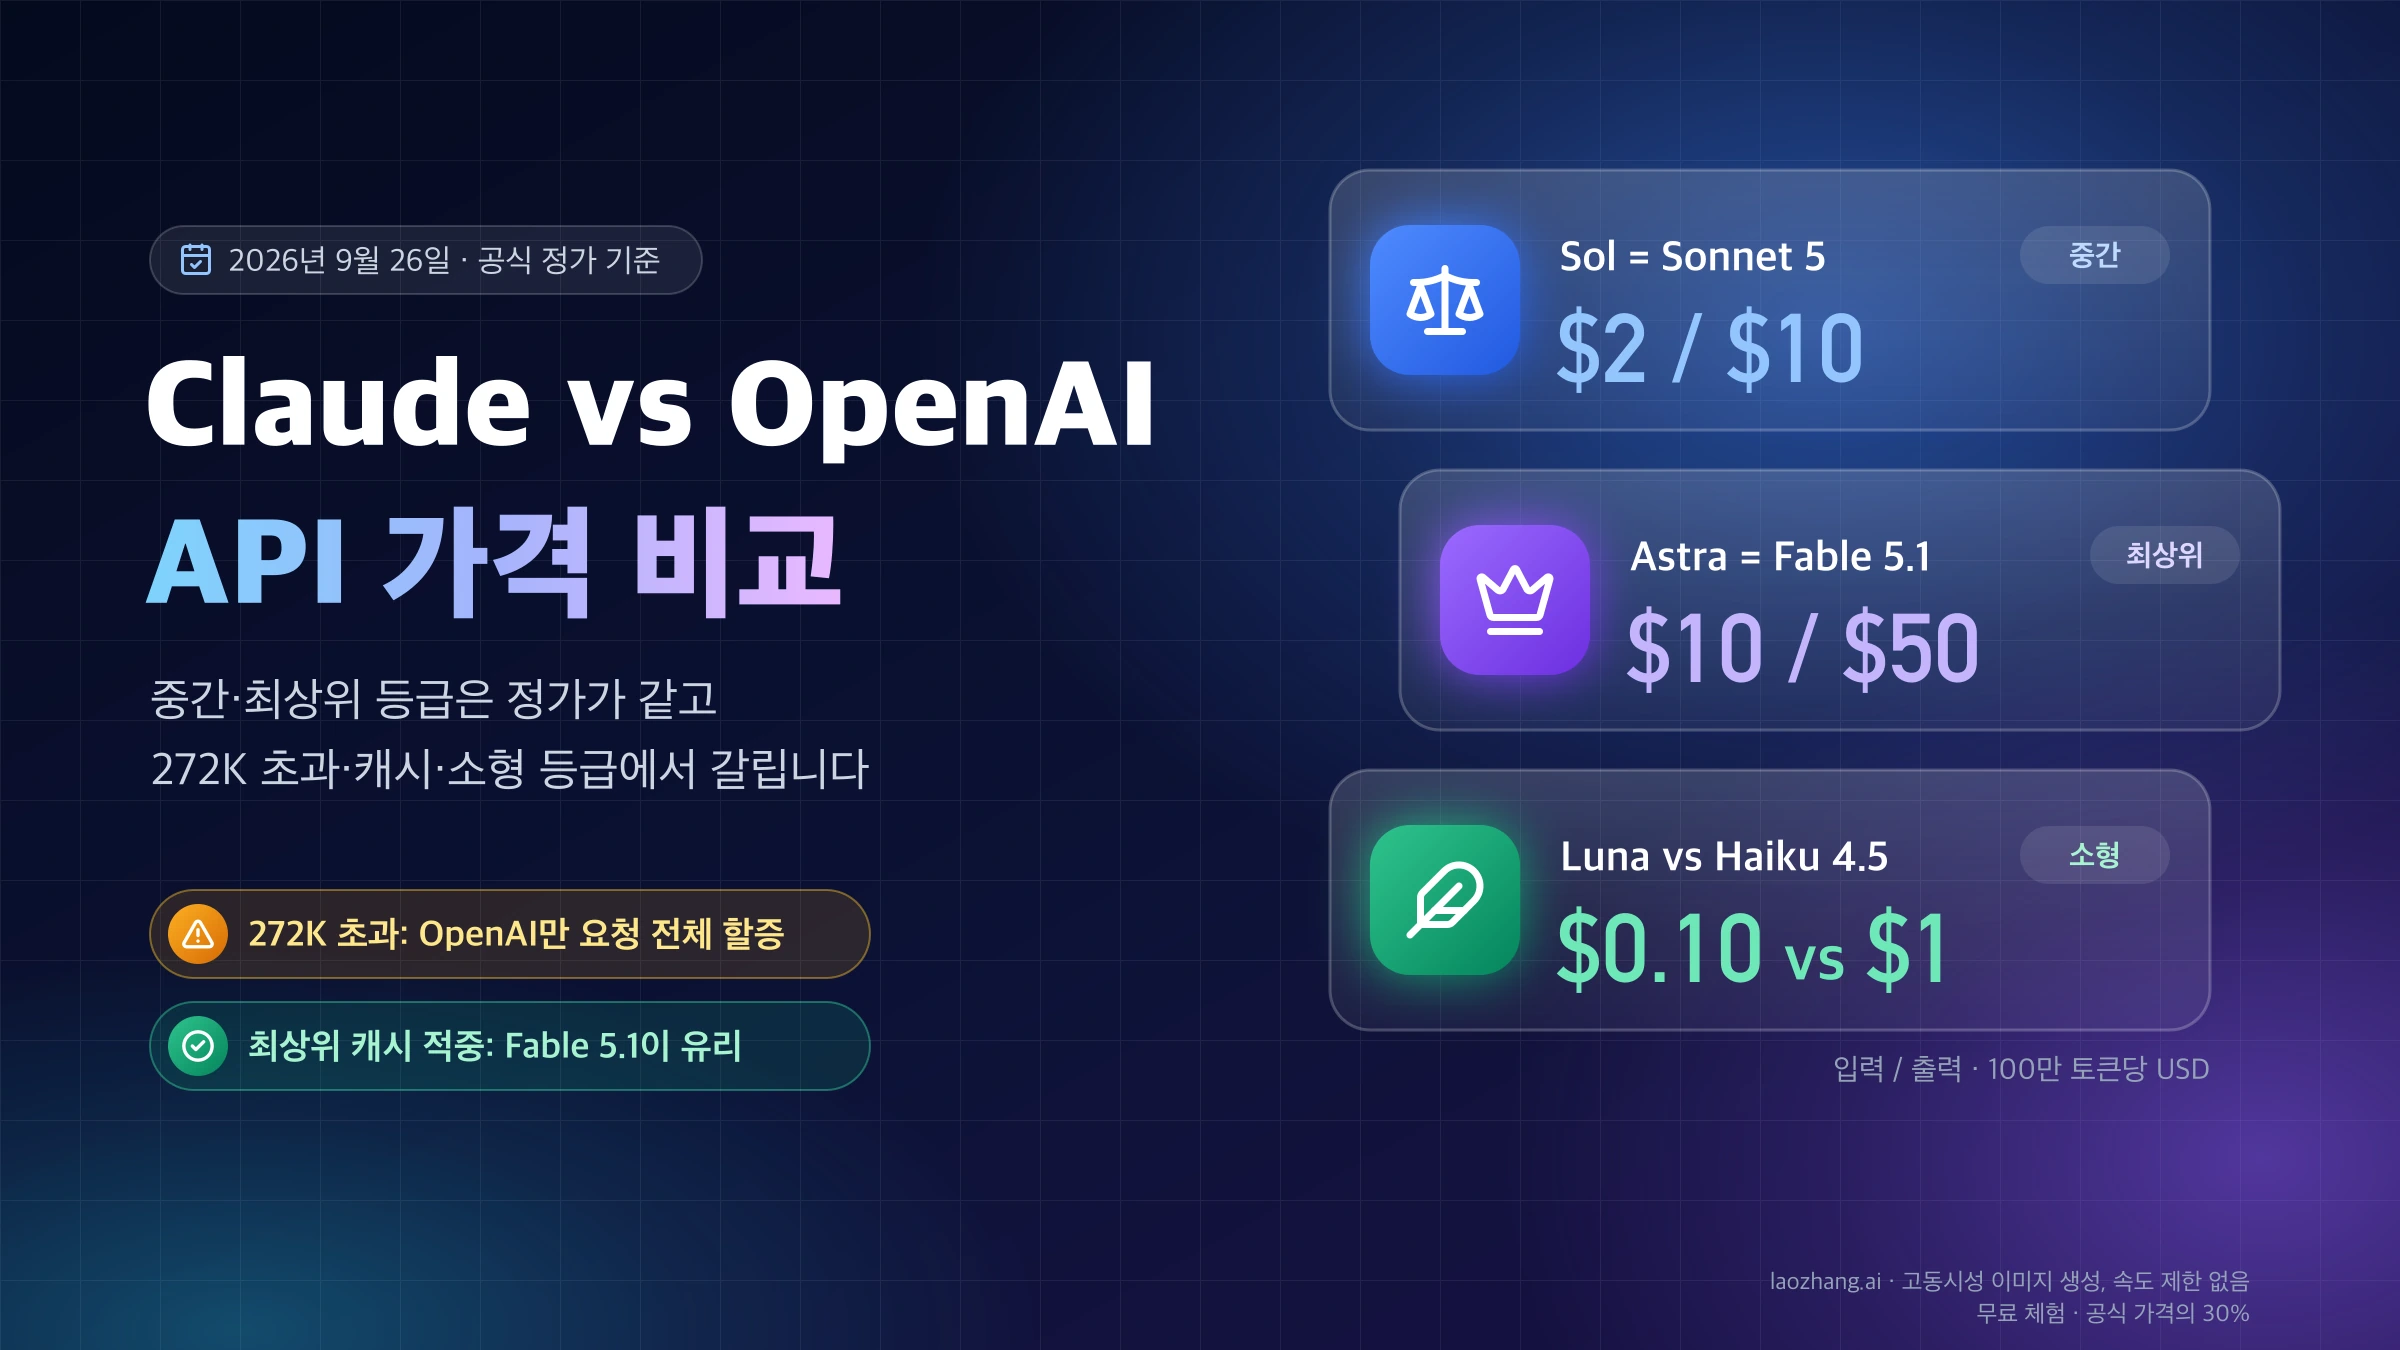
같은 작업을 더 싸게 처리할 후보로는 OpenAI가 Astra에 가까운 성능을 낮은 비용으로 제공한다고 소개하는 GPT-6.1 Sol이 있다. 입력·출력 단가가 Astra의 5분의 1이고, 2026년 10월 25~26일 같은 8개 작업을 두 모델로 처리했을 때도 비용은 약 1/5~1/6이었으며 답은 양쪽 모두 통과했다. 전환 기준은 GPT-6.1 Sol·Astra·GPT-6 Sol 비교와 전환 기준에, 단가가 같은 Claude Fable 5.1과 한국어 토큰 수·캐시 동작을 비교한 결과는 GPT-6 Astra와 Claude Fable 5.1 비교: 같은 단가, 한국어 토큰은 1.9배에 있다. 2026년 11월 9일부터 현재 Fable은 입력 $8, 출력 $40의 Fable 5.2이며, Astra와의 비교는 Fable 5.2 vs GPT-6 Astra 비교: 추론 강도 대응표와 실측 토큰 2.5배에서 볼 수 있다.
가격과 정책은 짧은 기간에도 바뀐다. 캐시 쓰기 단가가 두 가지로 나뉜 것도 출시 약 7주 뒤인 10월 20일이었다. 계산표에는 단가를 확인한 날짜와 출처 URL을 함께 저장하고, 예산 승인 전에 공식 가격 페이지와 프로젝트의 실제 모델 노출을 다시 확인해야 한다. 그러면 $10/$50이라는 두 숫자만으로 예산을 잡는 대신, 기본 캐시 쓰기와 긴 문맥 요금으로의 전환까지 포함한 재현 가능한 비용 산정이 가능하다.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 10일.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 10일.
- 1.OpenAI API 가격 페이지developers.openai.com/api/docs/pricing
- 2.OpenAI 최신 모델 가이드developers.openai.com/api/docs/guides/latest-model
- 3.GPT-6 Astra 모델 페이지developers.openai.com/api/docs/models/gpt-6-astra
- 4.OpenAI 프롬프트 캐싱 가이드developers.openai.com/api/docs/guides/prompt-caching
- 5.OpenAI Fast mode 가이드developers.openai.com/api/docs/guides/fast-mode
- 6.OpenAI Ultrafast 가이드developers.openai.com/api/docs/guides/ultrafast-mode