AI 영상 여러 캐릭터 대화: 투샷 한 번에 vs 샷 분할, 장면 조건으로 고르기
두 사람이 짧게 주고받는 대화는 투샷으로 한 번에, 세 명 이상·긴 대사·잦은 대사 수정은 샷 분할이 안전합니다. 모델별 공식 제한과 실패 증상별 조치를 함께 봅니다.
목차
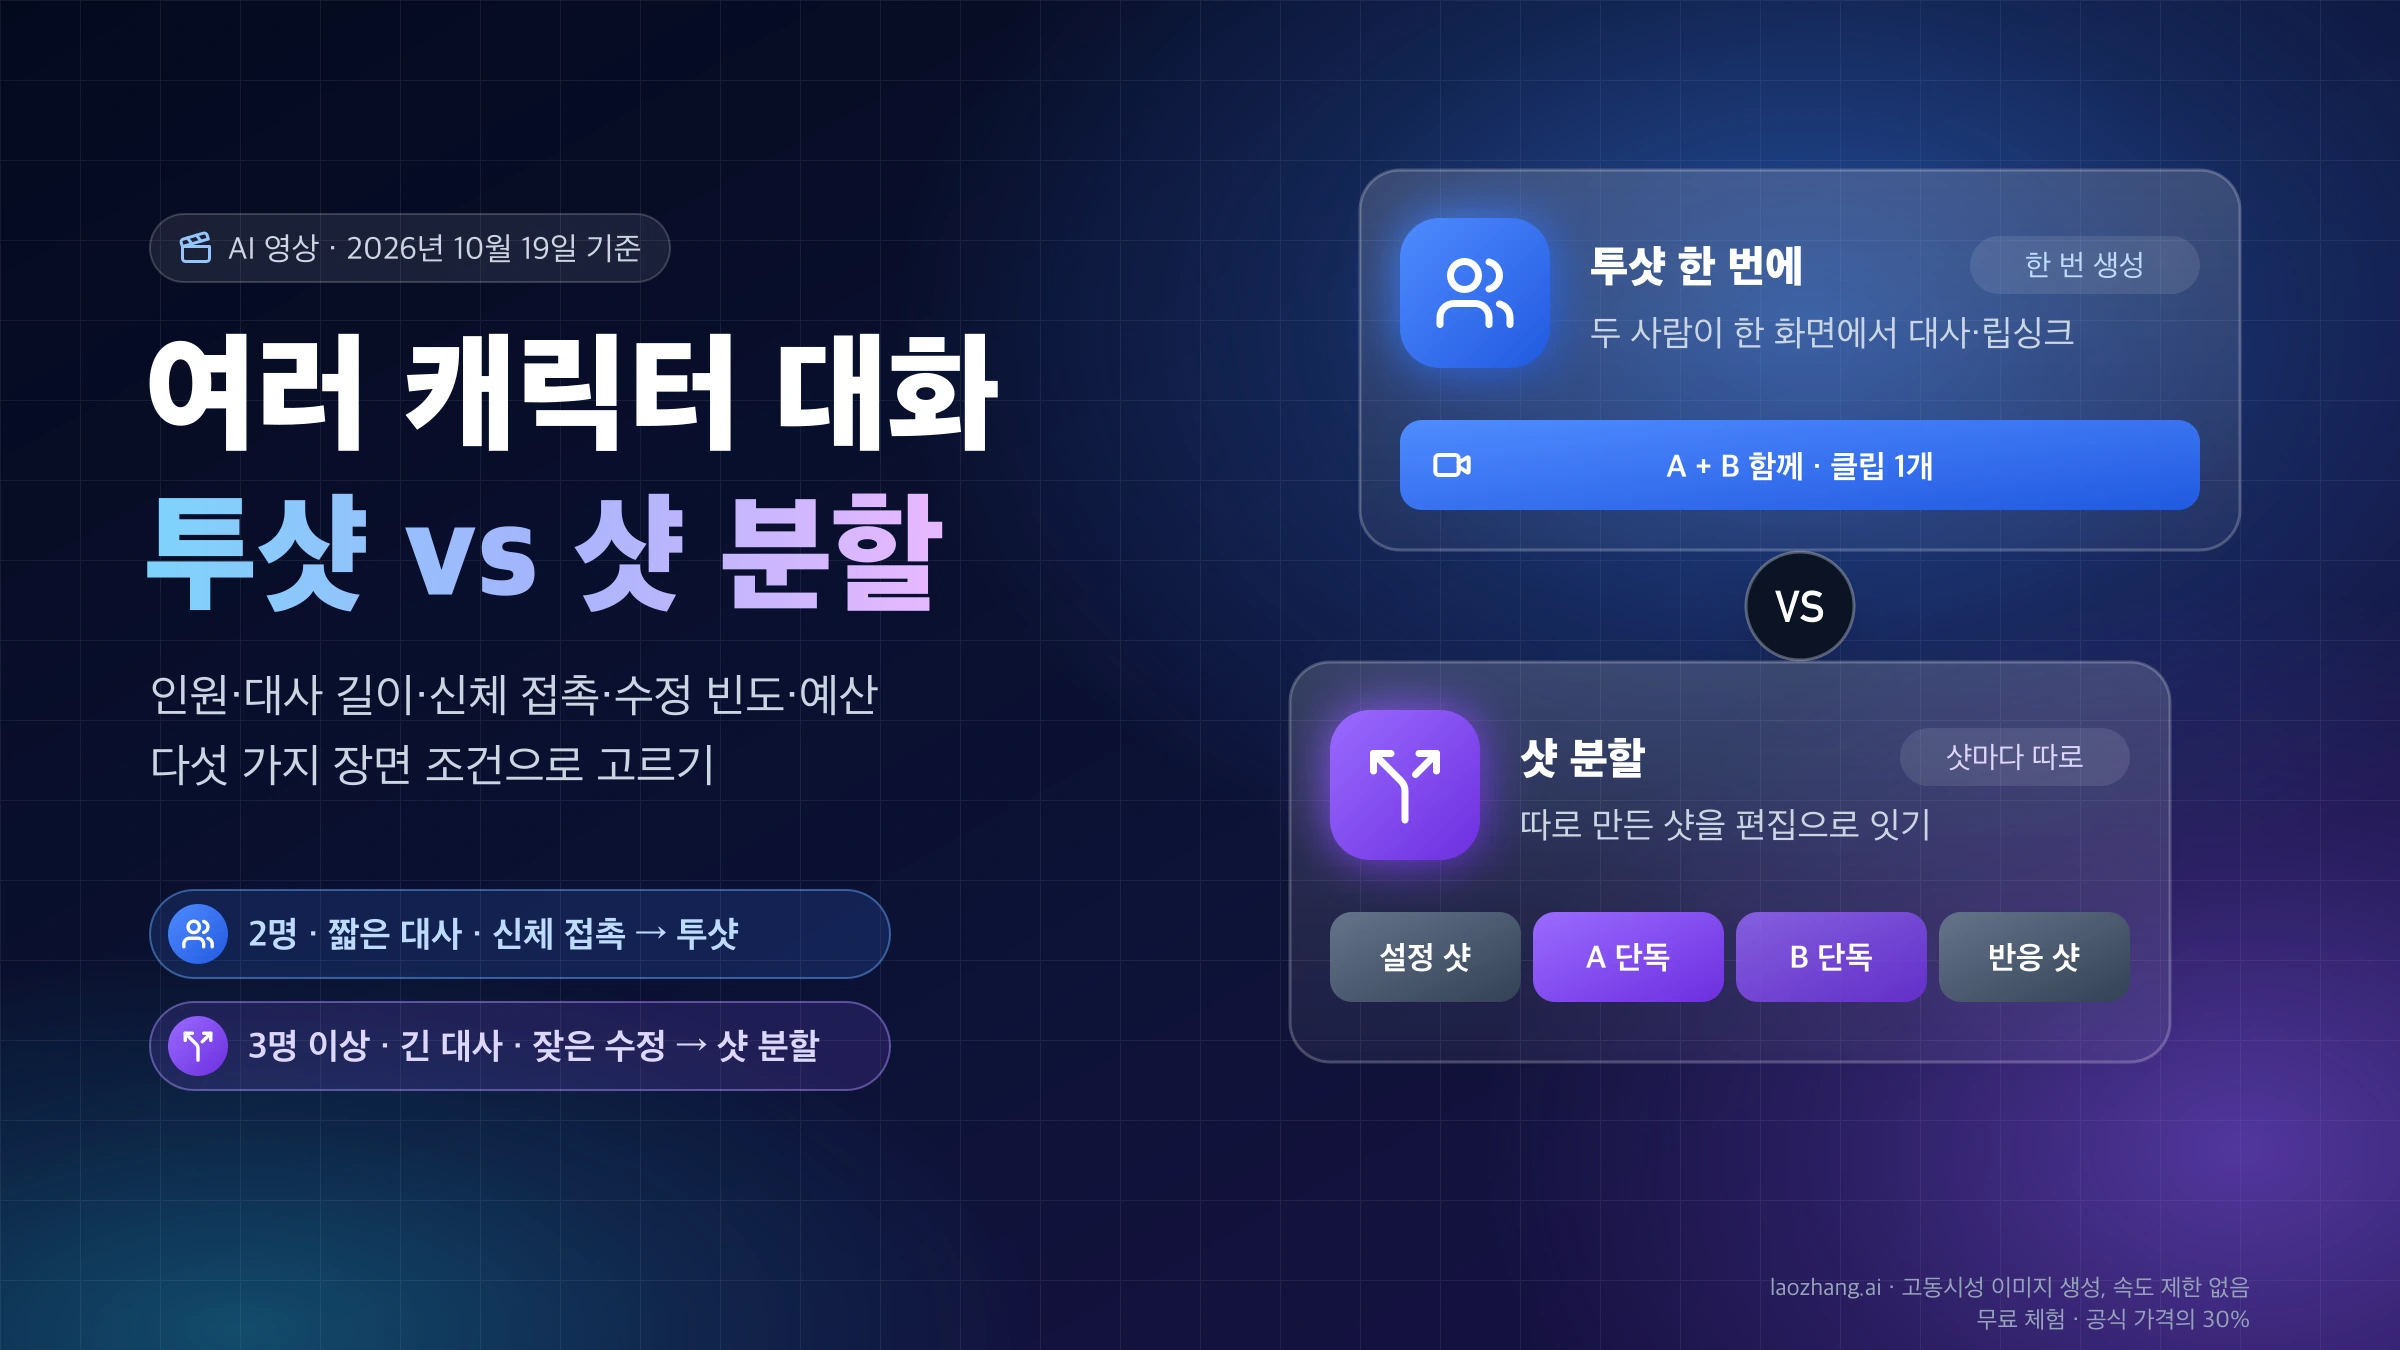
AI 영상에서 여러 캐릭터가 대화하는 장면은 두 가지 방식으로 만듭니다. 두 사람이 한 화면에 함께 보이는 투샷을 대사·립싱크까지 한 번에 생성하거나, 단독 샷·리버스 샷·오버 더 숄더 샷을 따로 생성한 뒤 편집으로 잇는 방식입니다.
고르는 기준은 장면 조건입니다. 두 사람이 한 클립 길이 안에서 한두 번 주고받고, 서로 몸이 닿거나 물건을 건네는 장면이라면 투샷으로 한 번에 만드는 편이 자연스럽습니다. 반대로 세 명 이상이 나오거나, 대사가 한 클립보다 길거나, 대사를 자주 고쳐야 하는 장면이라면 샷을 나누는 편이 안전합니다. 샷 하나가 틀렸을 때 그 샷만 다시 만들면 되고, 화면 안에서 말하는 사람이 한 명뿐이라 입과 목소리가 엇갈릴 여지가 줄어들기 때문입니다.
그 사이에 절충안이 두 가지 있습니다. Kling 3.0, MiniMax H3, Gemini Omni Flash처럼 한 번의 생성 안에서 컷을 나눠 주는 내장 멀티샷과, Runway 도움말이 안내하는 캐릭터별 연기 후 합성 방식입니다. 아래의 제한과 실패 양상은 2026년 10월 19일 기준 공급사 문서와 출처를 밝힌 제3자 글에서 가져왔으며, 성공률 같은 측정값은 포함하지 않습니다.
투샷 vs 샷 분할: 다섯 가지 장면 조건으로 고르기
판단에 가장 큰 영향을 주는 조건은 인원, 대사 길이, 신체 상호작용, 대사 수정 빈도, 채택 컷당 예산입니다. 조건이 엇갈리면 위쪽 행을 우선합니다. 인원과 대사 길이는 모델의 한계와 바로 연결되고, 아래쪽 조건은 작업 방식으로 어느 정도 보완할 수 있기 때문입니다.
| 장면 조건 | 투샷 한 번에 | 샷 분할 편집 |
|---|---|---|
| 화면 속 인원 | 2명 | 3명 이상, 또는 2명이라도 외형이 비슷할 때 |
| 대사 길이 | 한 클립 안에 끝남 (Veo 3.1은 최대 8초, Seedance 2.5는 최대 30초) | 한 클립보다 김 |
| 신체 접촉·동작 상호작용 | 악수, 포옹, 물건 건네기처럼 두 사람의 타이밍이 맞아야 함 | 시선과 반응 위주라 컷으로 이어도 어색하지 않음 |
| 대사 수정 빈도 | 대본이 확정됨 | 대사를 바꾸거나 언어를 바꿀 가능성이 큼 |
| 채택 컷당 예산 | 생성 횟수를 줄이고 싶음 | 실패한 부분만 다시 만들어 재시도 비용을 줄이고 싶음 |
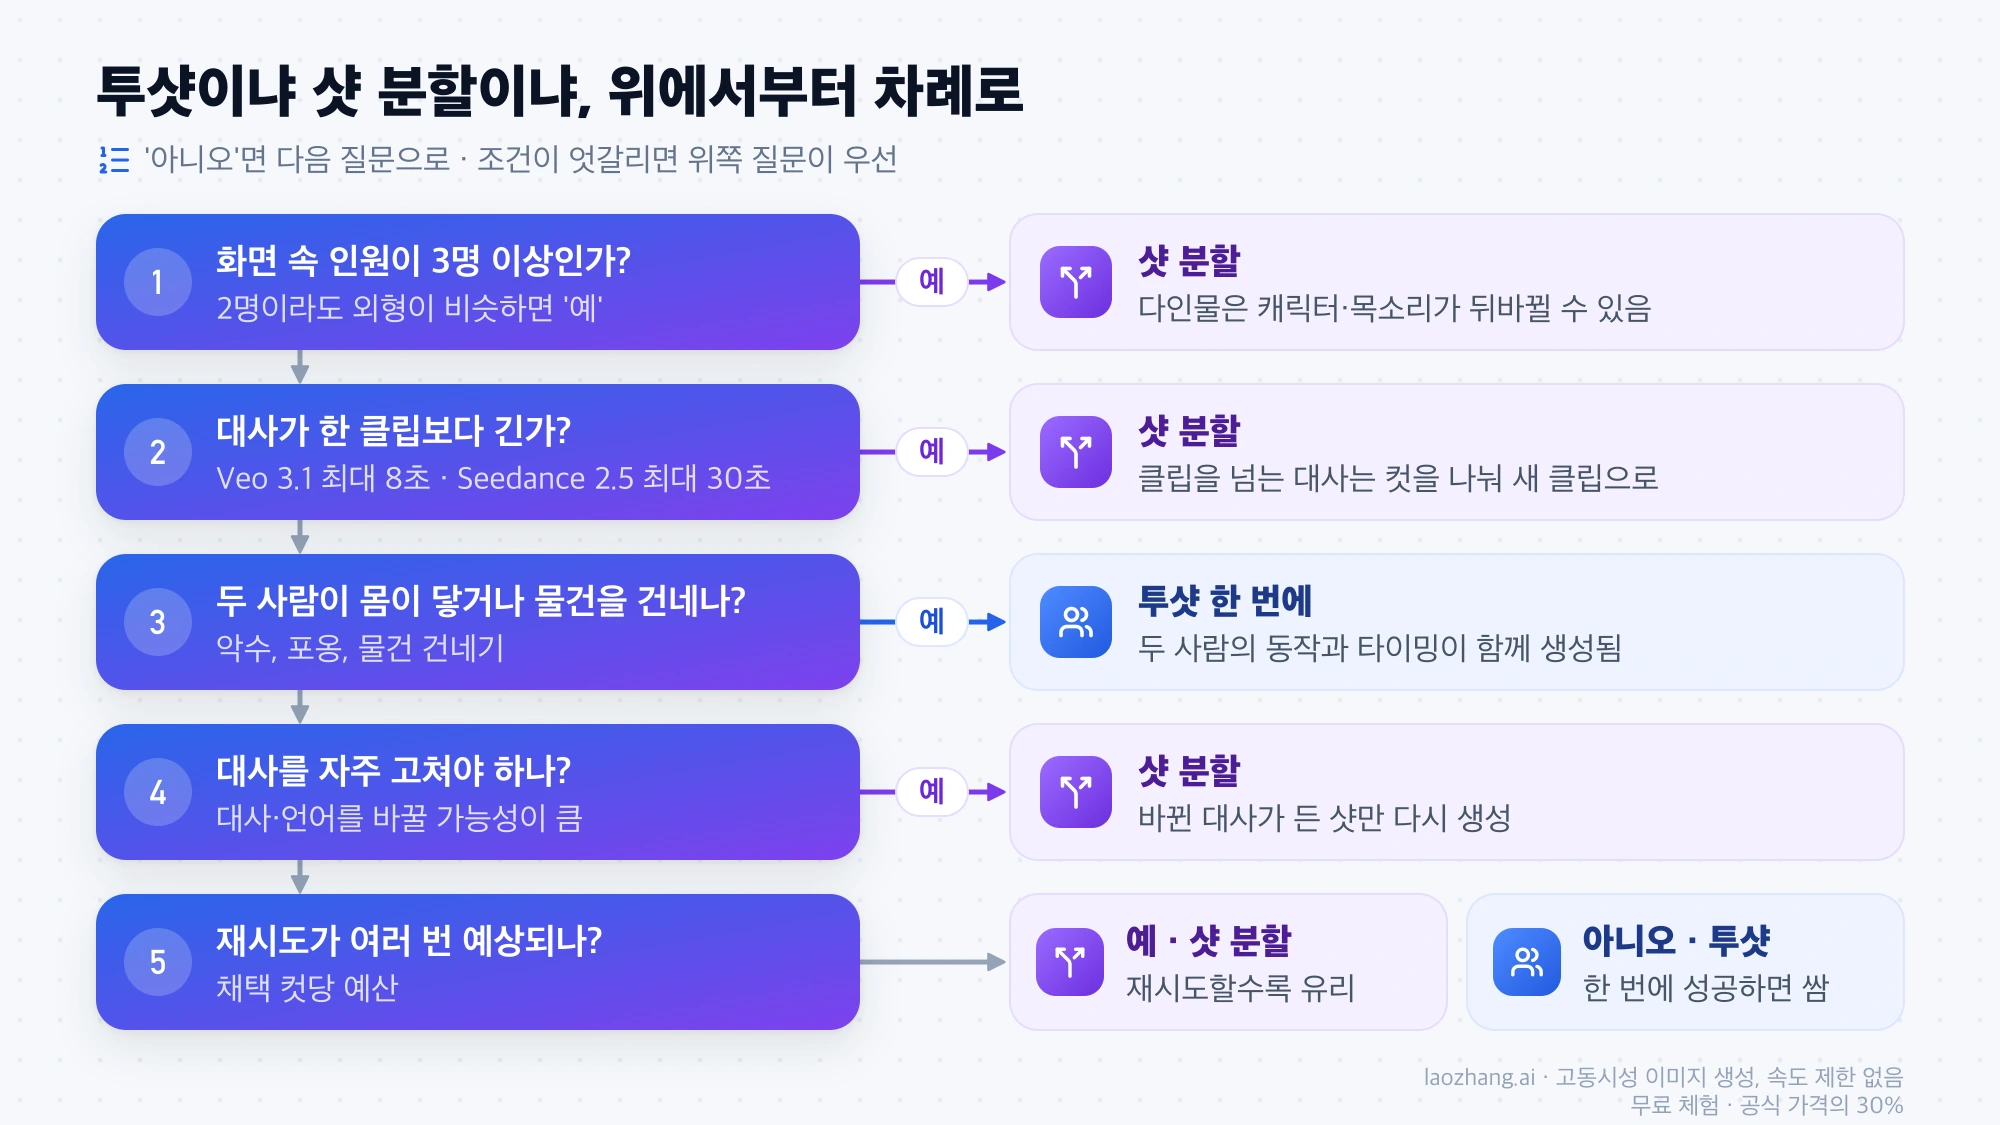
세 명 이상은 투샷보다 샷 분할 쪽으로 판단이 기웁니다. Seedance 2.5 공식 프롬프트 가이드는 여러 피사체가 나오는 영상에서 캐릭터가 참조 이미지·목소리·등장 순서와 어긋날 수 있다고 적고 있고, 같은 가이드가 참조와 편집 요구를 한 작업에 많이 몰면 결과가 불안정할 수 있으니 단순한 작업 여러 개로 나누라고 권합니다. 제3자인 Seedance TV 블로그(2026년 8월 28일)도 두 캐릭터가 가장 통제하기 쉽고, 그보다 많으면 두 사람씩 묶은 샷이나 반응 샷으로 나눠 편집하라고 제안합니다.
투샷으로 한 번에 만들 때: 맞는 장면과 무너지는 지점
투샷의 장점은 두 사람의 동작과 시선이 같은 시간 안에서 함께 생성된다는 점입니다. 한 사람이 컵을 내밀고 다른 사람이 받는 장면은 샷을 나누면 손 위치와 타이밍을 맞추기 어렵습니다. 대사가 짧고 확정되어 있다면 한 번에 만드는 편이 편집 부담도 적습니다.
무너지는 지점은 세 군데에서 나타납니다.
- 클립 길이: Veo 3.1의 한 클립은 4초, 6초, 8초 중 하나이고 참조 이미지를 쓰면 8초로 고정됩니다. 그보다 긴 대화는 연장하거나 컷을 나눠야 합니다. 연장은 한 번에 7초씩 늘어나지만, Google 문서는 영상의 마지막 1초에 목소리가 없으면 목소리가 제대로 이어지지 않는다고 적고 있습니다. 대사 중간에서 끊긴 지점부터 연장해야 한다는 뜻입니다.
- 화자 연결: Seedance 2.5의 공식 FAQ는 다인물 영상에서 캐릭터가 참조 이미지나 목소리 톤, 등장 순서와 뒤바뀔 수 있다고 명시합니다. 예로 든 것은 처음 등장한 캐릭터가 다른 참조 캐릭터로 바뀌는 경우입니다. 이 문제를 공식 문서에 직접 적은 곳은 Seedance뿐이고, 다른 모델 문서에는 언급이 없습니다. 언급이 없다고 문제가 없다는 뜻은 아닙니다.
- 기본 컷 분할: Gemini Omni Flash는 기본적으로 여러 샷으로 나눈 영상을 만들려고 합니다. 한 화면에서 이어지는 투샷이 필요하면 "No scene cuts"나 "In a single continuous shot" 같은 문구를 프롬프트에 넣어야 합니다.
한국어 대사라면 언어 조건도 봅니다. Omni Flash 문서는 영어만 완전히 지원하고 다른 언어는 평가하지 않았다고 적고 있습니다. Seedance 2.5는 중국어가 아닌 대사를 쓸 때 대사 앞에 언어를 지정하라고 안내합니다.
샷 분할 편집: 리버스 샷·오버 더 숄더로 나눌 때 챙길 것
샷 분할은 실제 촬영의 대화 편집과 같은 구조입니다. 두 사람이 함께 나오는 설정 샷 하나, 말하는 사람을 비추는 단독 샷이나 오버 더 숄더 샷, 듣는 사람의 반응 샷을 따로 만들고 편집에서 잇습니다. Google의 Vertex AI Veo 프롬프트 가이드도 오버 더 숄더 샷을 "대화에서 흔히 쓰는 샷"으로 소개합니다.
샷마다 화면에서 말하는 사람이 한 명이라 입과 목소리가 엇갈릴 가능성이 줄어듭니다. 대신 샷 사이에서 같은 사람으로 보이게 하는 일이 새 과제가 됩니다. 다음 네 가지를 먼저 고정하세요.
- 캐릭터별 참조 자료: 캐릭터마다 같은 참조 이미지를 모든 샷에 씁니다. Seedance 2.5는 업로드 순서대로 번호를 매기고 "이미지 1~2는 캐릭터 1이며 오디오 1에 대응한다"처럼 텍스트로 연결하라고 안내합니다. 이미지 안에 이름만 써 두면 캐릭터가 섞이거나 중복되기 쉽다고 합니다.
- 목소리: 목소리 참조를 받는 모델이면 캐릭터마다 같은 음성 파일을 씁니다. Seedance 2.5는 오디오 참조를 최대 10개까지 받고, 각 오디오는 2~30초, 합계 30초 이내입니다. Kling 4.0은 참조 오디오를 "목소리 참조"로만 받습니다.
- 시선 방향과 위치: A가 화면 왼쪽, B가 오른쪽이면 모든 샷에서 그 방향을 유지합니다. 반응 샷에서 시선이 뒤집히면 편집에서 어색해집니다.
- 조명과 배경: 같은 장소라는 정보(조명 방향, 시간대, 배경 소품)를 모든 샷 프롬프트에 반복해서 적습니다.
실존 인물 얼굴에는 제한이 있습니다. Seedance 2.5는 실제 얼굴 사진을 바로 올릴 수 없고, 같은 계정의 신뢰된 생성 결과, 미리 준비된 디지털 캐릭터, 본인 인증을 거친 실존 인물 에셋만 쓸 수 있습니다. Omni Flash도 일부 알아볼 수 있는 인물은 지원하지 않습니다.
Seedance를 API로 쓰면서 샷마다 같은 가상 캐릭터를 유지하려면 laozhang.ai의 Seedance 에셋 워크플로가 하나의 방법입니다. 공개 HTTPS 이미지 한 장으로 가상 인물 에셋을 만들고, 이를 asset:// 형식의 reference_image로 모든 샷 요청에 넣는 방식입니다. 프롬프트 쪽 매핑 방법은 Seedance 2 프롬프트 가이드: 참조 이미지, 샷 설계와 2.5 수정 예제에서 더 자세히 다룹니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
절충안: 모델 내장 멀티샷과 Runway 캐릭터별 연기 합성
두 방식 사이에 공급사가 직접 안내하는 절충안이 있습니다.
내장 멀티샷은 한 번의 생성 안에서 컷을 나눠 줍니다. Kling 3.0은 출시 노트에서 클래식한 샷-리버스 샷 대화를 자동 카메라 각도로 만든다고 소개하고, API는 한 번에 1~6개 샷을 지원합니다(각 샷 1초 이상, 샷 길이 합이 전체 길이). MiniMax H3는 "네이티브 멀티샷"을 내세우고, Wan 2.7은 "Shot 1 [0–3 seconds]"처럼 프롬프트에 샷을 나눠 적습니다. Seedance 2.5도 ShotN과 정수 초 타임스탬프로 구간을 나눌 수 있습니다. 편집 없이 컷 구조를 얻는다는 장점이 있지만, 한 샷만 틀려도 전체를 다시 생성해야 하고 화자 연결 문제는 그대로 남습니다.
Runway의 캐릭터별 연기 합성은 화면은 투샷인데 연기는 한 사람씩 따로 입히는 방식입니다. Runway 도움말(2025년 12월 17일 업데이트)은 Act-Two가 한 캐릭터 입력만 지원한다고 밝히고, 다음 절차로 두 명 이상의 대화를 만들라고 안내합니다.
- 캐릭터별 연기와 대사를 따로 녹화합니다(Act-Two 최대 30초).
- 두 캐릭터가 함께 있는 정지 이미지를 만듭니다.
- 그 이미지로 10초짜리 배경 영상을 만들고, 대사가 길면 마지막 프레임에서 연장합니다.
- 캐릭터 한 명만 보이게 잘라 Act-Two를 한 사람씩 돌립니다.
- 영상 편집기에서 합성합니다.
직접 연기한 영상이 있고 편집기를 다룰 수 있다면 이 방식이 화자 연결을 가장 확실하게 통제합니다. Act-Two는 초당 5크레딧입니다. 참고로 Runway의 단독 Lip Sync 도구는 2026년 5월 27일에 종료되었고, Act-Two가 대체 도구입니다.
모델별 여러 캐릭터 대화 기능 비교 (공식 문서 기준)
아래 표는 2026년 10월 19일 기준 각 공급사 문서에 적힌 내용만 모은 것입니다. "기재 없음"은 지원하지 않는다는 뜻이 아니라 문서에 적혀 있지 않다는 뜻입니다.
| 모델·도구 | 한 클립 길이 | 대사 표기 | 목소리-캐릭터 연결 | 멀티샷 | 주의할 점 |
|---|---|---|---|---|---|
| Veo 3.1 (제미나이 API) | 4/6/8초, 연장 시 최대 148초 | 따옴표. 공식 예시에 두 화자를 한 클립에 넣음 | 기재 없음 | 기재 없음 | 참조 이미지는 최대 3장, 문구는 "한 사람·캐릭터·제품의 에셋 이미지" |
| Gemini Omni Flash | 연장 10초씩, 합계 최대 40초 | 기재 없음 | 없음 (오디오 참조 미지원, 음성 편집 미지원) | 기본값이 여러 샷 | 말하는 영상을 연장해 대사 추가 불가, 영어 외 언어 미평가 |
| Seedance 2.5 | 4~30초 | 중괄호 또는 "Dialogue (역할): …" | 이미지·오디오 번호를 텍스트로 연결 | ShotN + 정수 초 타임스탬프 | 다인물 뒤바뀜을 FAQ에 명시, 실존 얼굴 직접 업로드 불가 |
| Kling 3.0 | 3~15초 | 캐릭터를 지정해 "says:" | 말하는 캐릭터 지정 가능하다고 주장 | API 1~6샷 | 화자 지정 정확도는 공급사 주장 |
| Kling 4.0 | 3~30초 | 기재 없음 | 목소리 참조만 | 기재 없음 | 립싱크 개선을 내세우나 다인물 화자 언급 없음, API 문서는 3.0 |
| MiniMax H3 | 4~15초 | 11개 언어 대사 | 기재 없음 | 네이티브 멀티샷 | 오디오 참조 최대 3개, 오디오만 입력 불가 |
| Wan 2.7 | 2~15초 | 기재 없음 | 기재 없음 | 프롬프트로 샷 구분 | 오디오 입력 2~30초 |
| Runway Act-Two | 최대 30초 연기 | 직접 녹화한 연기 | 캐릭터별로 따로 실행 | 별도 앱(최대 5샷, 기본 무음) | 한 캐릭터 입력만, 합성은 편집기에서 |
| MultiTalk / InfiniteTalk (오픈소스) | 최대 15초 / 기본 최대 40초 | 오디오 파일 | person1·person2에 오디오 각각 연결 | 없음 | 직접 GPU 필요, 논문이 오디오-인물 연결 오류를 언급 |
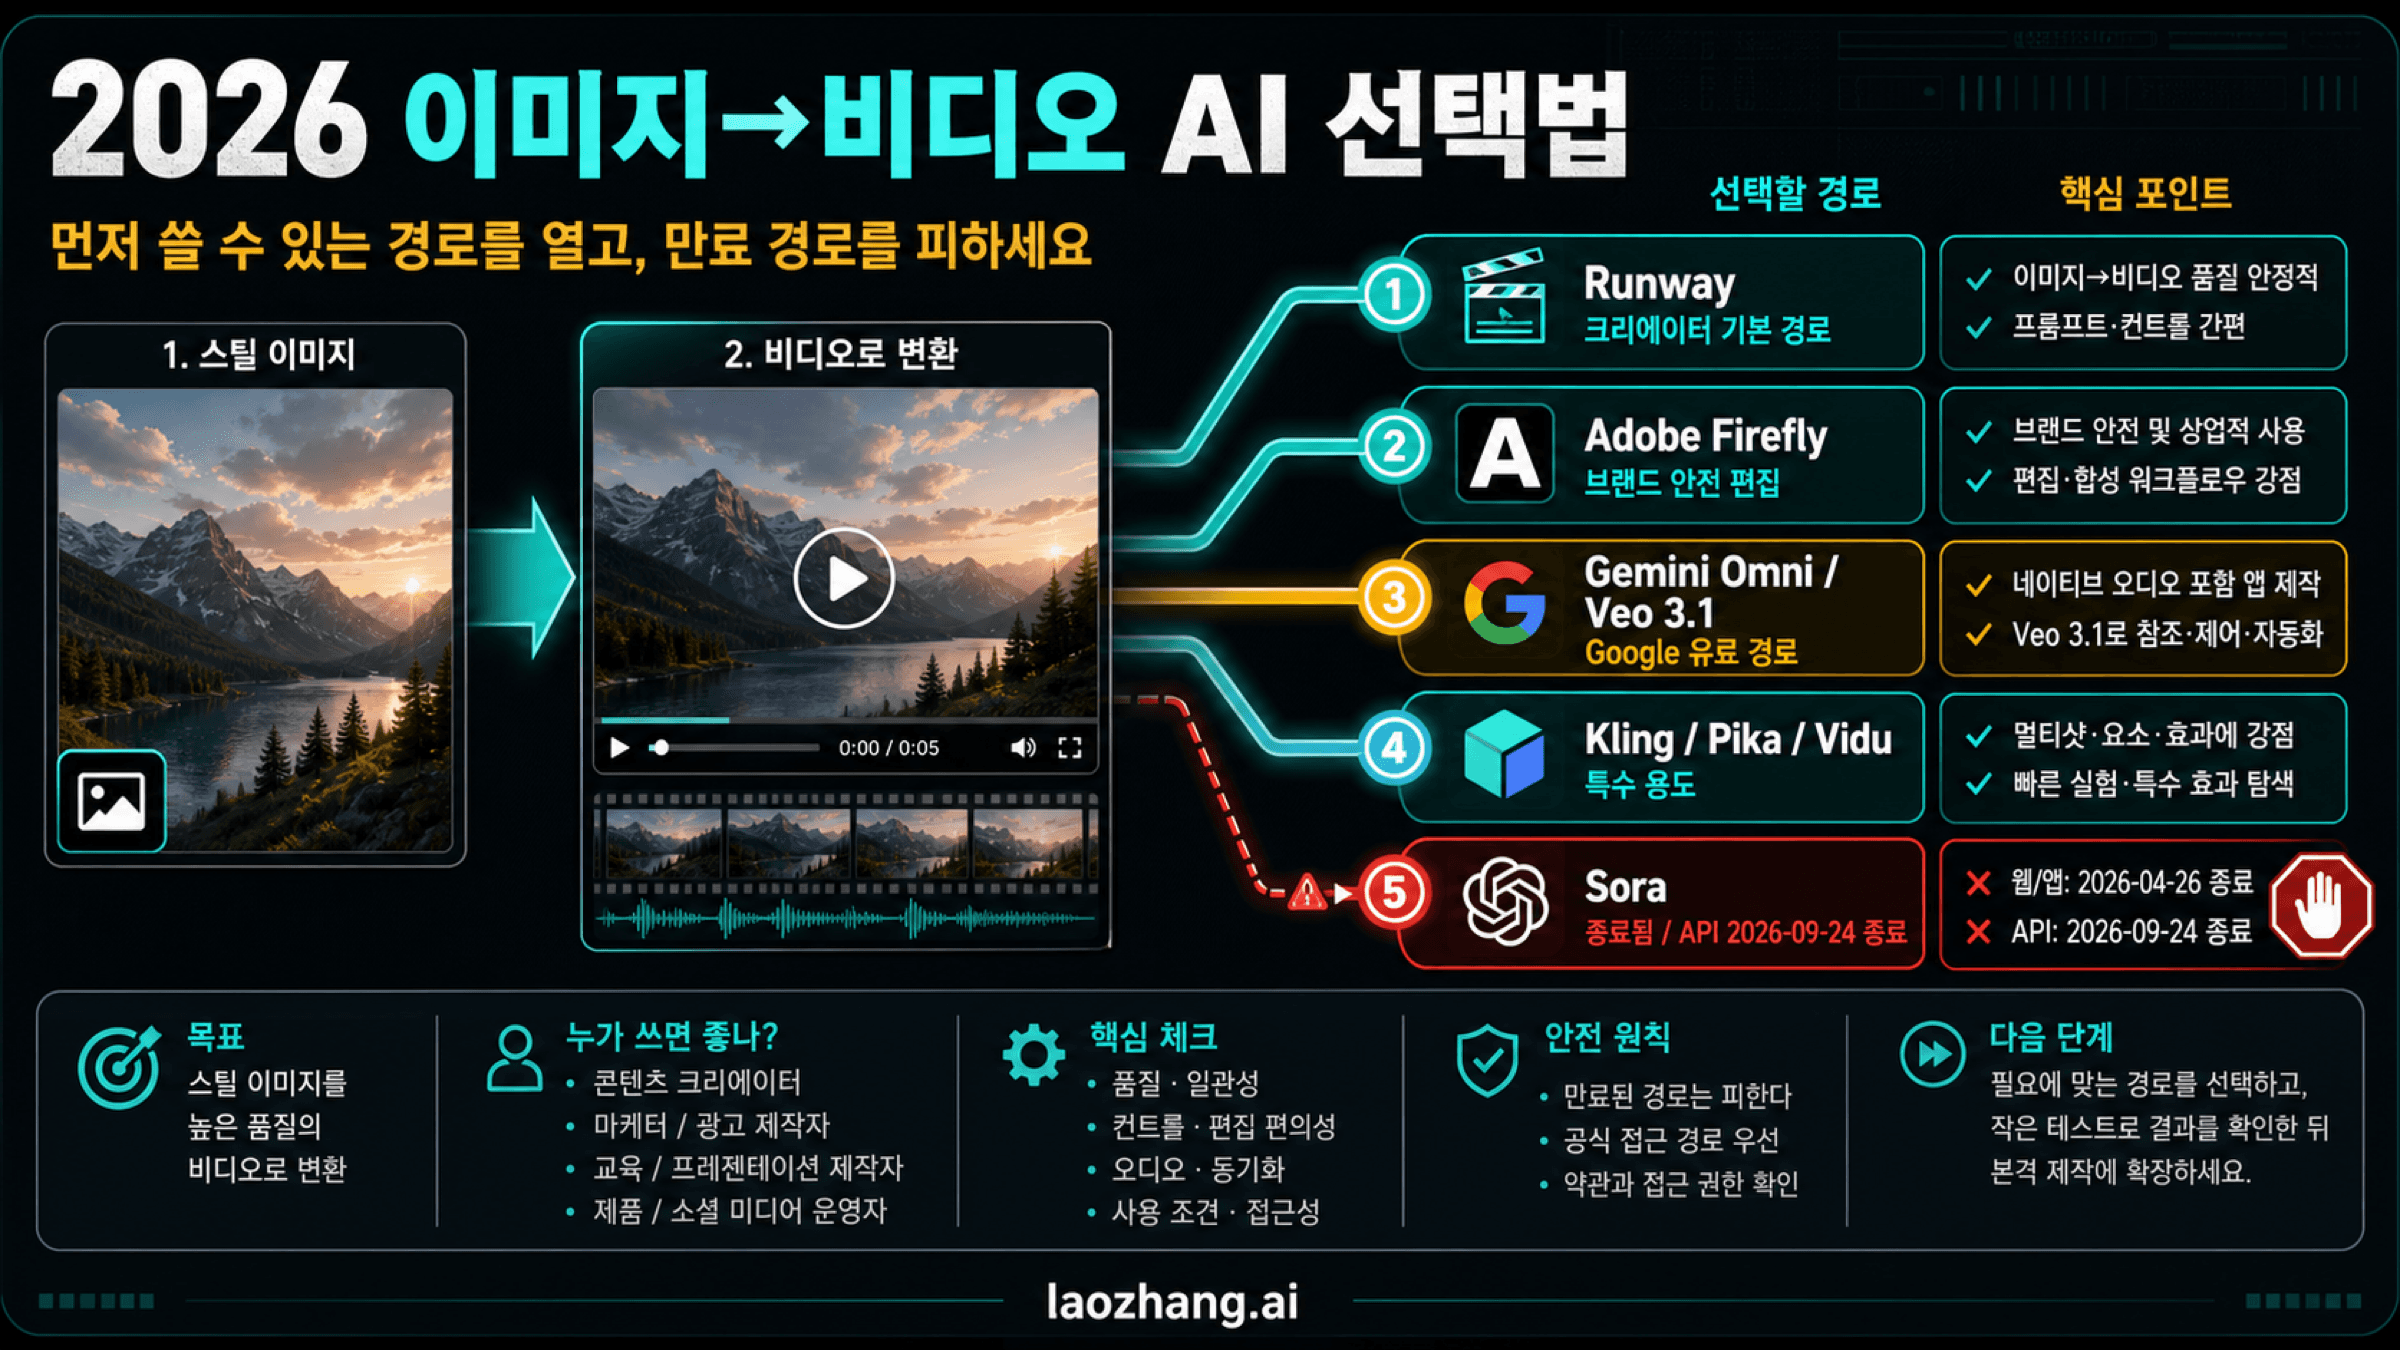
Veo 3.1의 참조 이미지 문구는 두 인물 장면에서 해석이 갈립니다. 원문은 "up to three asset images of a single person, character, or product"이고, 두 캐릭터의 참조를 한 요청에 섞어도 되는지 문서만으로는 분명하지 않습니다. Kling 3.0의 "말하는 캐릭터를 정확히 지정해 모호함을 없앤다"는 출시 노트의 홍보 문구이며, 4.0 노트에는 같은 언급이 다시 나오지 않습니다. Sora는 앱이 2026년 4월 26일, 모델과 Videos API가 9월 24일에 종료되어 선택지가 아닙니다.
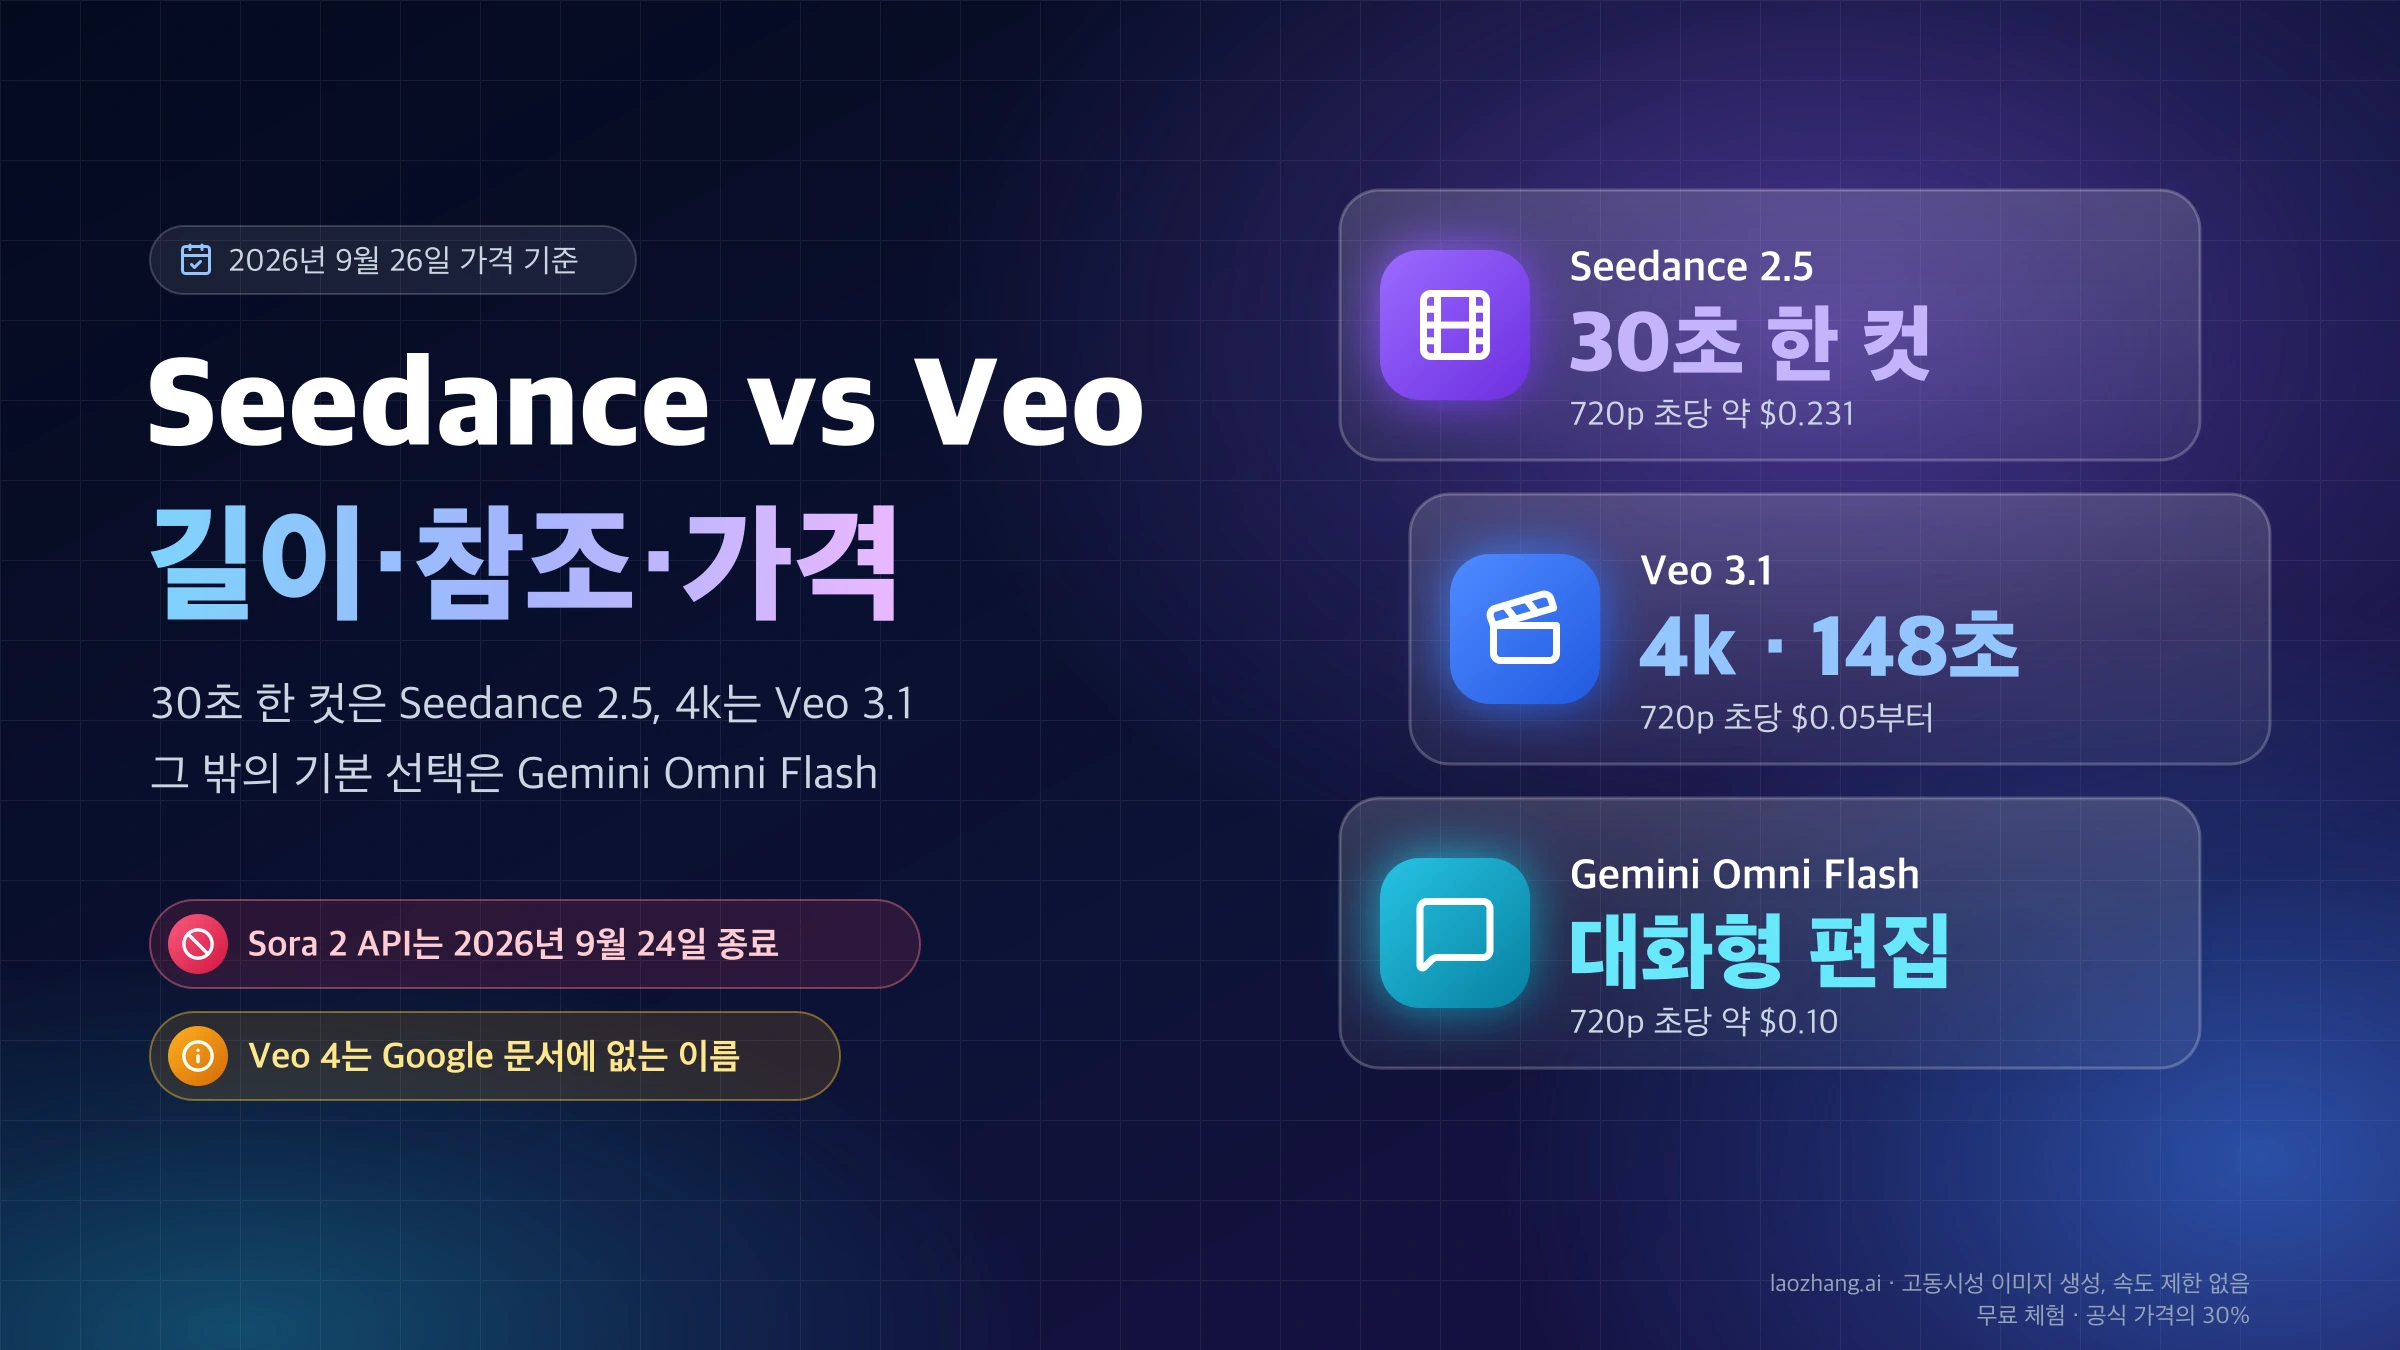
어느 모델을 먼저 시험할지는 길이·참조·가격 차이로 정리한 Seedance vs Veo 비교: 길이·참조·초당 가격 차이와 Wan 3.0·MiniMax H3·Seedance 2.5 비교: 납품 기준으로 먼저 테스트할 모델을 참고하세요. Omni의 모델명과 이용 경로는 Gemini Omni 1.1 Flash 사용 가이드: API 모델명부터 4K·40초 제한까지에 있습니다.
대사를 프롬프트에 쓰는 법: 투샷 템플릿과 샷 분할 템플릿
아래 두 템플릿은 공식 문서에 나온 문법으로 구성한 초안이며, 생성 결과로 검증한 것은 아닙니다. 공통 원칙은 대사마다 말하는 사람과 듣는 사람을 함께 적는 것입니다. 제3자 Seedance TV 블로그는 "그러자 그가 대답한다"처럼 쓰면 엉뚱한 사람이 말하기 쉽다며, "A가 말하고 B는 화면 오른쪽에서 듣는다"처럼 양쪽을 다 적으라고 권합니다.
투샷 한 번에(Veo 3.1 문법, 대사는 따옴표):
Medium two-shot in a small cafe at night, warm window light.
A woman in a green coat sits on the left, a man in a gray hoodie sits on the right.
The woman, looking at the man, says: "We missed the last train."
The man listens, then looks up and replies: "Then we walk."
No subtitles. In a single continuous shot.
샷 분할(Seedance 2.5식 참조 매핑, 샷마다 별도 요청):
Image 1 is Character A and corresponds to Audio 1.
Image 2 is Character B and corresponds to Audio 2.
Shot 1: Over-the-shoulder shot from behind Character B. Character A faces camera on the left side of frame.
Character A speaks in Korean: "막차를 놓쳤어." Character B listens, back to camera, on the right.
Same cafe, same warm window light, night. No subtitles.
샷 분할에서는 이 블록을 샷마다 복사하고, 시점과 말하는 사람만 바꿉니다. 참조 매핑 줄과 장소·조명 줄은 그대로 두어야 샷 사이에서 같은 사람, 같은 장소로 이어집니다. Seedance 가이드는 같은 대사 단어를 반복하면 자막이 생길 수 있다고 하니, 대사는 한 번만 적습니다.
입이 엉뚱한 사람에게서 움직일 때: 실패 증상별 다음 조치
증상마다 프롬프트나 참조만 고치면 되는지, 방식을 바꿔야 하는지가 다릅니다. 같은 수정으로 두세 번 시도해도 그대로라면 오른쪽 열의 방식 변경으로 넘어가세요.
| 증상 | 가능한 원인 | 먼저 할 일 (프롬프트·참조 수정) | 그래도 안 되면 (방식 변경) |
|---|---|---|---|
| 대사가 다른 사람 입에서 나옴 | 대사에 화자만 있고 듣는 사람과 위치가 없음 | 대사마다 화자·청자와 화면 위치를 적음 | 말하는 사람별 단독 샷으로 분할 |
| 목소리가 캐릭터끼리 바뀜 | 오디오와 캐릭터의 연결이 텍스트에 없음 | 등장 순서대로 업로드하고 이미지·오디오 번호를 다시 매김 (Seedance FAQ) | 샷 분할 후 샷마다 한 사람의 목소리만 사용 |
| 처음 나온 캐릭터가 다른 참조 인물로 바뀜 | 참조 업로드 순서와 등장 순서가 다름 | 업로드 순서를 등장 순서에 맞춤 (Seedance FAQ) | 인원을 줄이거나 두 사람씩 묶은 샷으로 분할 |
| 컷이 바뀌며 얼굴·옷이 섞임 | 캐릭터별 참조가 약하거나 묘사가 비슷함 | 캐릭터별 참조 이미지를 모든 샷에 고정, 옷 색을 뚜렷하게 구분 | 가상 인물 에셋 등 고정 참조 사용 |
| 한 화면을 원했는데 컷이 나뉨 | Omni Flash 기본값이 여러 샷 | "No scene cuts"를 프롬프트에 추가 | 컷 분할이 기본값이 아닌 모델로 변경 |
| 연장한 뒤 목소리가 끊기거나 달라짐 | Veo 연장 직전 마지막 1초에 목소리가 없음 | 대사가 이어지는 지점에서 연장 | 연장 대신 컷을 나눠 새 클립으로 생성 |
| 두 사람의 동작 타이밍이 어긋남 | 상호작용을 샷 사이에서 맞추려 함 | 상호작용 구간만 투샷으로 생성 | 해당 구간은 투샷, 대사 구간은 샷 분할로 혼합 |
| 대사 한 줄을 바꾸려는데 전체를 다시 만들어야 함 | 투샷·내장 멀티샷은 한 덩어리 | Seedance 2.5의 부분 편집(대사만 수정) 시도 | 처음부터 대사 단위로 샷 분할 |
비용 비교: 샷 분할은 생성 횟수가 늘지만 재시도는 작아진다
샷 분할은 첫 생성 비용이 더 들고, 재시도 비용은 줄어듭니다. 아래는 Seedance 2.5 BytePlus 720p 정가 약 $0.231/초(2026년 10월 15일 기준 공개 가격, 자주 바뀜)로 12초 대화를 만드는 예입니다.
- 투샷 한 번에: 12초 × $0.231 = 약 $2.77. 화자가 뒤바뀌면 12초 전체를 다시 생성하므로 재시도 1회마다 약 $2.77이 더 듭니다.
- 샷 분할: 4초 샷 4개(설정 샷, A 단독, B 단독, 반응 샷) = 16초 × $0.231 = 약 $3.70. 샷 하나가 틀리면 그 4초만 다시 만들어 재시도 1회에 약 $0.92입니다.
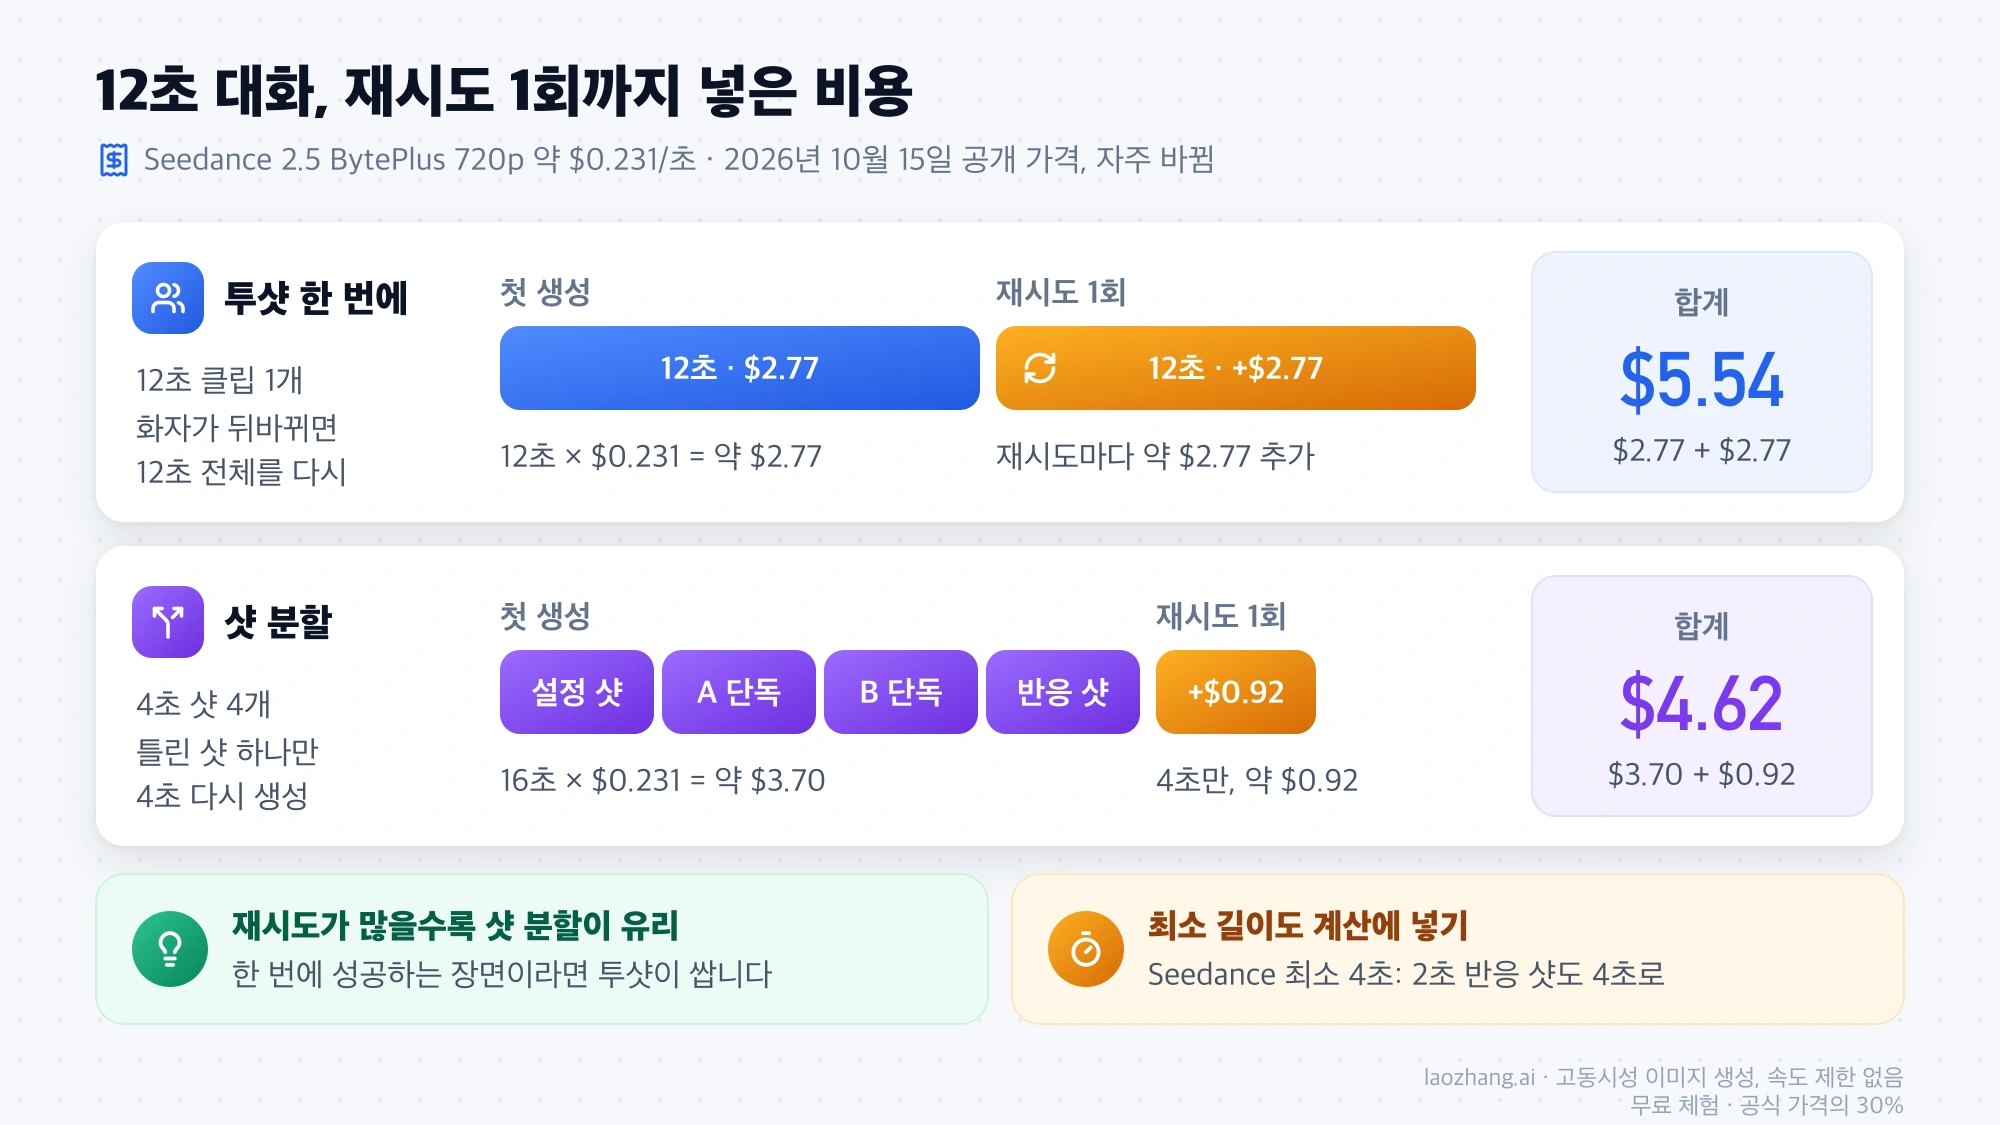
이 가정에서는 재시도가 한 번만 있어도 합계가 비슷해집니다(투샷 $2.77 + $2.77 = $5.54, 샷 분할 $3.70 + $0.92 = $4.62). 재시도가 많을수록 샷 분할이 유리해지고, 한 번에 성공하는 장면이라면 투샷이 쌉니다. Seedance 최소 길이가 4초라서 2초짜리 반응 샷도 4초로 생성된다는 점, Veo 3.1은 참조 이미지를 쓰면 샷마다 8초로 고정된다는 점도 계산에 넣어야 합니다. 같은 방식으로 다른 모델도 비교할 수 있습니다. 예를 들어 Veo 3.1 Fast 720p는 초당 $0.10, MiniMax H3 768P는 초당 $0.08입니다(2026년 10월 기준 정가).
자주 묻는 질문
AI 영상에서 세 명 이상을 한 화면에서 대화시킬 수 있나요?
시도는 할 수 있지만 권장하기 어렵습니다. Seedance 2.5 공식 FAQ가 다인물 영상의 캐릭터·목소리 뒤바뀜을 적고 있고, 제3자 Seedance TV 블로그도 두 명이 가장 통제하기 쉽다고 봅니다. 세 명 이상은 설정 샷 하나만 함께 보여 주고, 대사는 단독 샷이나 두 사람씩 묶은 샷으로 나누는 편이 안전합니다.
여러 캐릭터 대화 영상을 무료로 만들 수 있는 도구가 있나요?
라이선스 비용 없이 쓸 수 있는 선택지는 오픈소스 MultiTalk와 InfiniteTalk입니다. 오디오를 인물별로 연결하는 구조이지만, 직접 GPU 환경을 갖춰야 하고 필요한 하드웨어 사양은 저장소마다 확인해야 합니다. 웹 서비스의 무료 크레딧은 조건이 자주 바뀌므로 각 서비스의 현재 요금 페이지를 보고 판단하세요.
한국어 대사도 립싱크가 맞나요?
모델마다 다릅니다. Seedance 2.5는 중국어가 아닌 대사 앞에 언어를 지정하라고 안내하고, MiniMax H3는 11개 언어 대사를 내세웁니다. Gemini Omni Flash 문서는 영어만 완전히 지원하고 다른 언어는 평가하지 않았다고 적고 있습니다. 한국어 대사가 중요하다면 짧은 샷 하나로 먼저 확인한 뒤 전체 장면에 들어가는 편이 비용을 아낍니다.
Sora로 멀티 캐릭터 대화를 만들 수 있나요?
만들 수 없습니다. Sora 앱은 2026년 4월 26일에, Sora 2 모델과 Videos API는 2026년 9월 24일에 종료되었습니다. 대안은 위 비교표의 Veo 3.1, Seedance 2.5, Kling 등입니다.