Qwen-Image-2.1 は 2026年9月20日に公開された生成・編集兼用の画像モデルで、公式の ComfyUI 重みと Diffusers パイプラインが初日から用意されています。自分の環境で動かすなら、判断すべきことは三つだけです。手持ちの VRAM(Mac ならユニファイドメモリ)でどの重みの組み合わせが収まるか、そのためにどのルート(ComfyUI 純正・GGUF・Diffusers・mflux)を使うか、生成した画像を何に使うか。最後の点は、重みのライセンスが非商用限定なので、ダウンロード前に確認しておく価値があります。
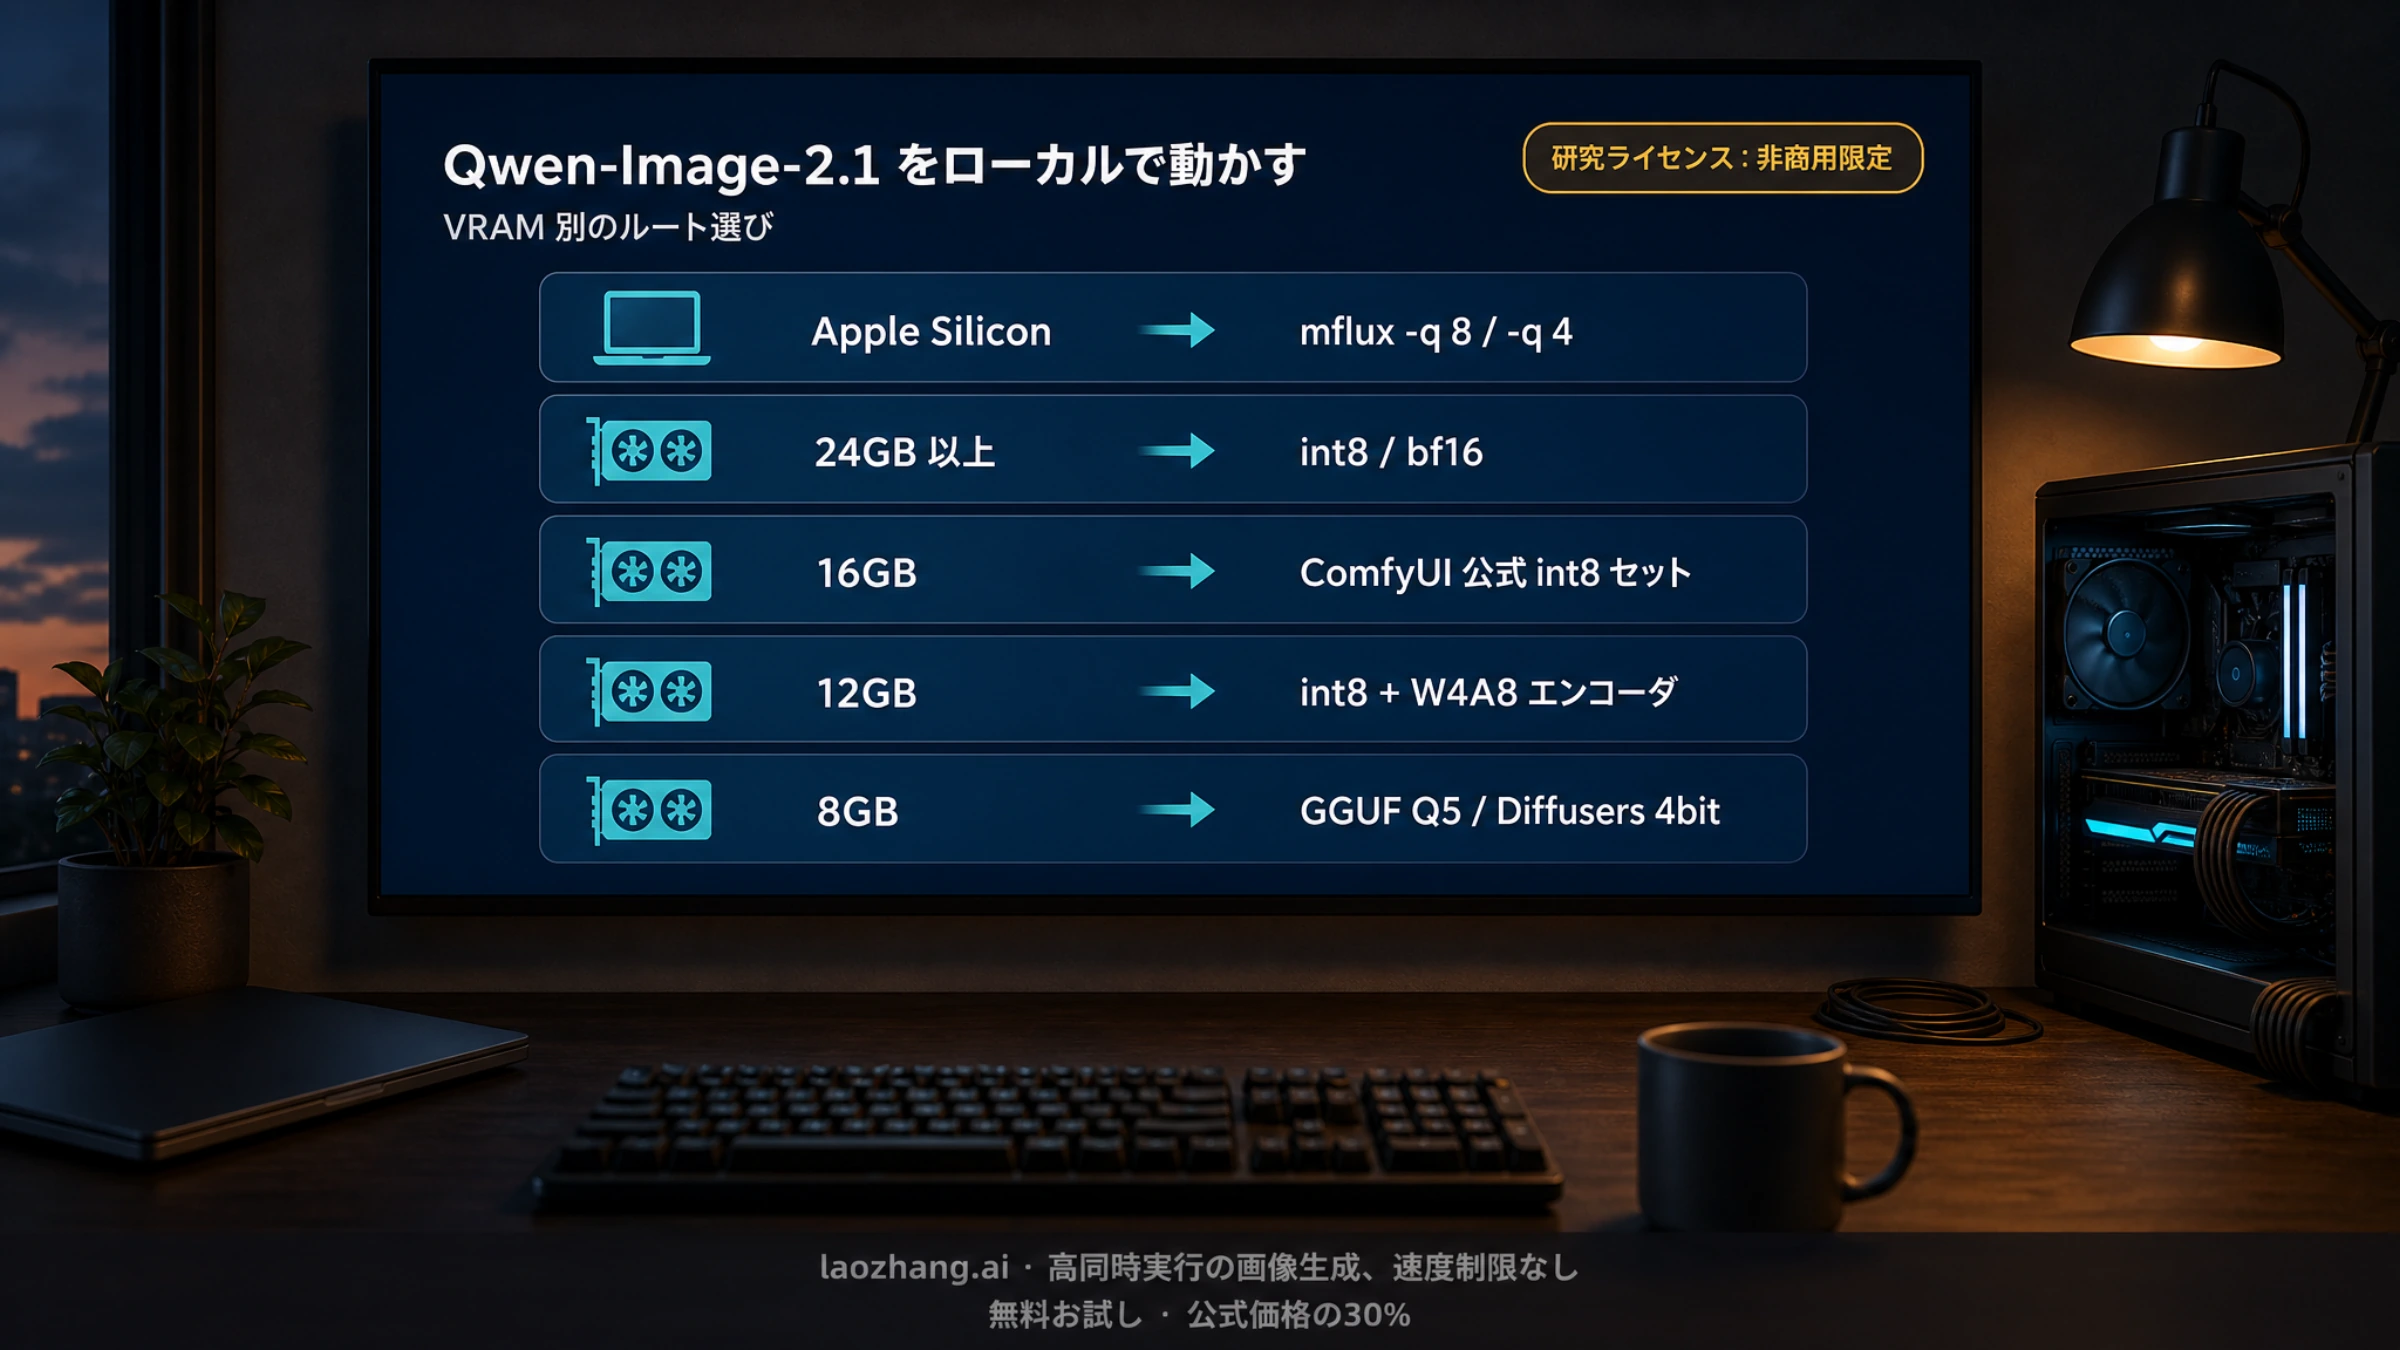
先に結論をまとめると次の通りです。VRAM の数字はすべて第三者か公式ドキュメントの実測・記載で、公式の「最低 VRAM」は公表されていません(ComfyUI 公式チュートリアルにも VRAM 表記はありません)。
| 手持ち環境 | 現実的な入口 | 落とすファイルの合計(目安) | 根拠になる実測・記載 |
|---|---|---|---|
| NVIDIA 24〜32GB | ComfyUI 公式 int8 セット。bf16 拡散モデルも試せる | int8 セット約 17.3GB、bf16 に替えると約 24GB | ai.rs の計算では int8 セット約 16.1GiB が RTX 4090 に常駐、SGLang は RTX 4090 でも offload フラグを推奨 |
| NVIDIA 16GB | ComfyUI 公式 int8 セット(既定のまま) | 約 17.3GB | 1024² 20 ステップでピーク約 13.9GB の報告(RTX 5070 Ti、量子化不明) |
| NVIDIA 12GB | ComfyUI 公式 int8 拡散モデル+W4A8 エンコーダ、または GGUF Q8_0/Q6_K | 約 14.3GB(公式最小)/約 13〜15GB(GGUF+w4a8 エンコーダ) | ai.rs 計算で W4A8+NVFP4 が約 10.4GiB、GGUF 配布者は Q8_0 を 12GB 以上向けと案内 |
| NVIDIA 8GB | GGUF Q5_K_M/Q4_K_M+W4A8 エンコーダ、または Diffusers の bitsandbytes 4bit | 約 11.6GB | Diffusers 4bit でピーク約 7GB(Colab A100 での実測)。ただし 8GB で Q4_K_M が画像入力時に落ちたという日本語の報告あり |
| Apple Silicon | mflux(-q 8 か -q 4) | MLX q4 パックで約 10.7GB | M5 Max で bf16 ピーク約 46GB、-q 8 で約 30.7GB(1024²、40 ステップ、PR 作者の計測) |
以下では、この表の根拠と、それぞれのルートで最初の 1 枚を出すまでの手順、透過画像の出し方、ライセンスの境界を順に説明します。
モデルの構成を知ると VRAM の見当がつく
Qwen-Image-2.1 は一つのモデルで文字からの生成、参照画像を使った編集、透過(RGBA)画像の生成と編集をこなします。公式リポジトリによると、画像を描く拡散モデル(DiT)は 7B パラメータ、テキストと参照画像を理解するテキストエンコーダは Qwen3-VL 8B、VAE は 64 チャンネルの RGBA 対応オートエンコーダです。参照画像は最大 10 枚、編集は「丸で囲む」「塗りつぶす」「元画像+マスクの 2 入力」の三つの指定方法に対応します。前世代の Qwen-Image-2512 が 20B だったので、描画部分は大幅に軽くなっています。
VRAM を考えるうえで重要なのは、メモリを食うのは 7B の描画モデルより 8B のテキストエンコーダという点です。BF16 のファイルサイズは拡散モデル 14.2GB に対しエンコーダ 17.5GB。vLLM-Omni の公式レシピ(データセンター GPU での計測)でも、エンコーダを FP8 にすると約 6GB 減るのに対し、DiT を FP8 にしても約 2GB しか減らないと記録されています。ComfyUI の公式配布に w4a8 という 6.31GB のエンコーダが用意されているのは、この理由からです。低 VRAM 環境でまず削るべきはエンコーダ側だと覚えておくと、以降の組み合わせ選びが楽になります。
ダウンロードするファイルとサイズ
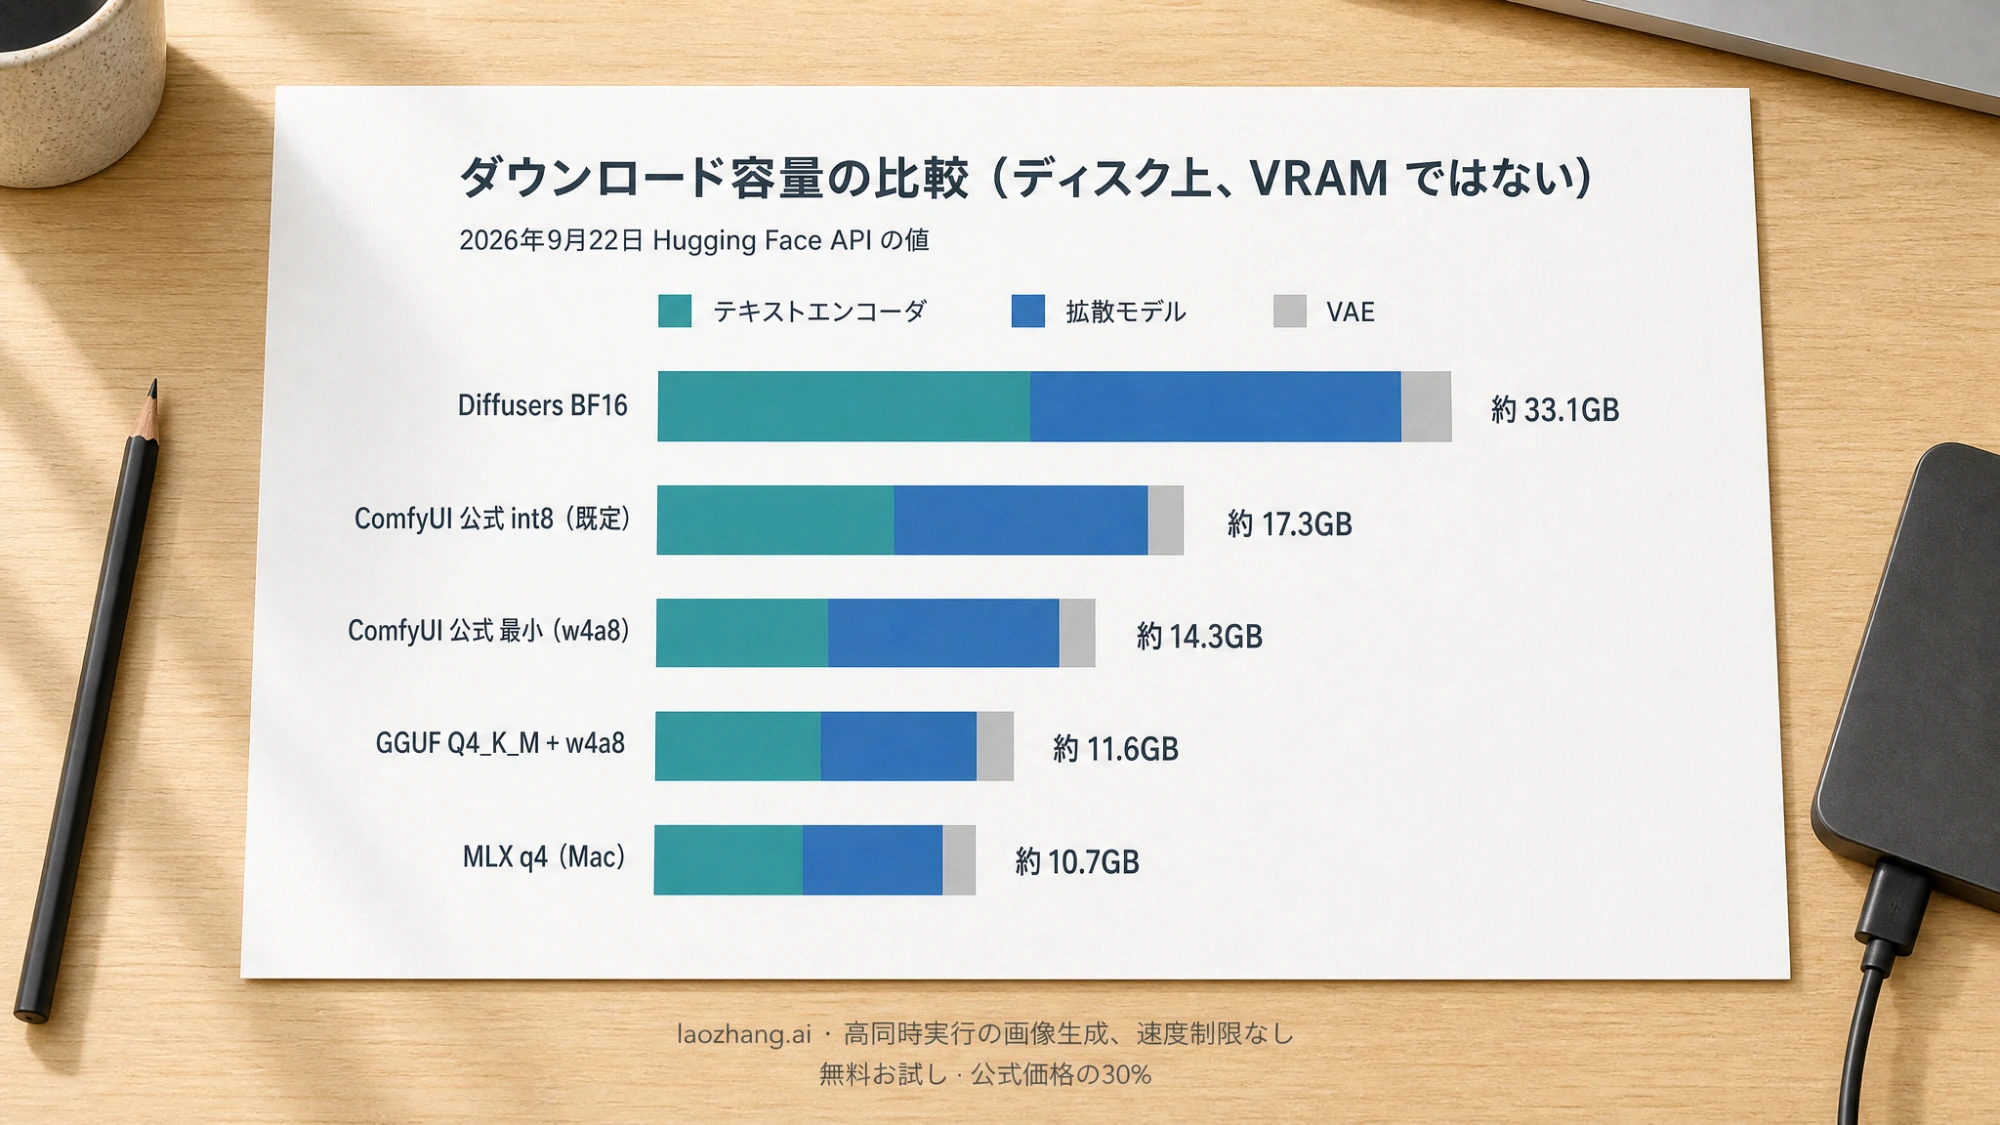
サイズはすべて 2026年9月22日に Hugging Face の API から取得したディスク上の値(10 進 GB)で、VRAM 使用量ではありません。
ComfyUI 公式配布(Comfy-Org/Qwen-Image-2.1)
Comfy-Org のリポジトリ全体は 74GB ありますが、必要なのは拡散モデル 1 つ、テキストエンコーダ 1 つ、VAE 1 つだけです。
| 役割 | ファイル | サイズ | 置き場所 |
|---|---|---|---|
| 拡散モデル(既定) | qwen_image_2.1_int8_convrot.safetensors | 7.26GB | ComfyUI/models/diffusion_models |
| 拡散モデル(高 VRAM 向け) | qwen_image_2.1_bf16.safetensors | 14.23GB | 同上 |
| テキストエンコーダ(既定) | qwen3vl_8b_int8_convrot.safetensors | 9.35GB | ComfyUI/models/text_encoders |
| テキストエンコーダ(最小) | qwen3vl_8b_w4a8.safetensors | 6.31GB | 同上 |
| テキストエンコーダ(bf16) | qwen3vl_8b_bf16.safetensors | 17.53GB | 同上 |
| VAE | qwen_image_2.1_vae_bf16.safetensors | 0.68GB | ComfyUI/models/vae |
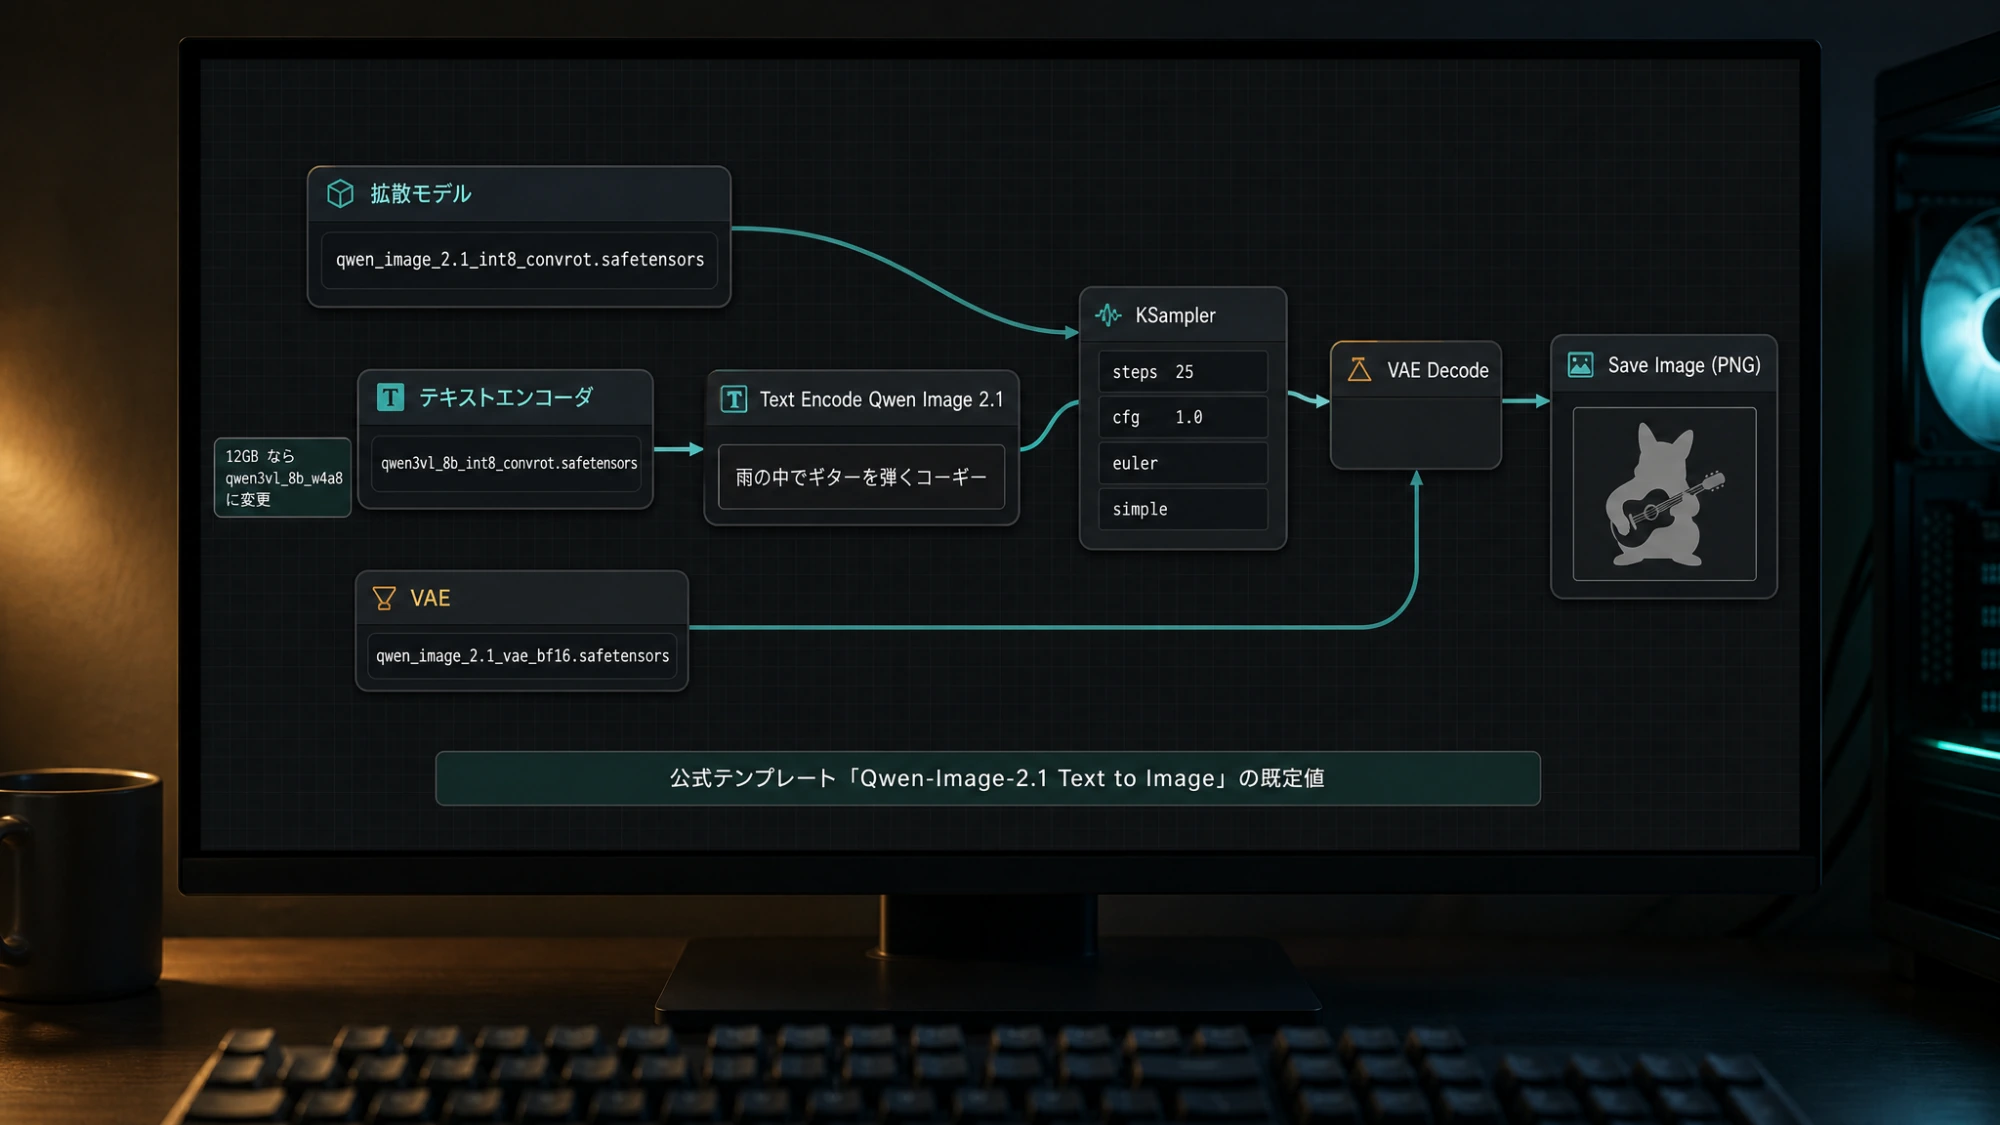
公式チュートリアルの既定は int8 拡散モデル+int8 エンコーダ+bf16 VAE で、合計約 17.3GB。エンコーダを w4a8 に替えると約 14.3GB が公式ファイルだけで組める最小構成です。bf16 版については「より多くの VRAM が必要」とだけ書かれ、数値はありません。
同じリポジトリには qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors と ..._pe_i2i...(各 9.47GB)もあります。ファイル名から、プロンプトを書き直して詳細化する PE(Prompt Enhance)モデルの ComfyUI 版と読めますが、チュートリアル本文には説明がなく、最初の 1 枚を出すためには不要です。
Diffusers 用フル BF16(Qwen/Qwen-Image-2.1)
QwenImage21Pipeline が読む本家リポジトリはテキストエンコーダ 4 分割約 17.5GB、拡散モデル 2 分割約 14.2GB、VAE 1.35GB の合計約 33.1GB です。任意のプロンプト書き換えモデル Qwen/Qwen-Image-2.1-PE-T2I / PE-I2I は別リポジトリで、PE-I2I だけで約 18.8GB あります。
コミュニティ GGUF(拡散モデルのみ)
GGUF 化されているのは拡散モデルだけで、テキストエンコーダと VAE は上の Comfy-Org 版 safetensors をそのまま使います。2026年9月22日時点の主な配布は次の二つです。
| 配布 | 量子化とサイズ |
|---|---|
| AlperKTS/Qwen-Image-2.1-GGUF(9月20日) | Q5_K_M 4.89GB、Q6_K 5.84GB、Q8_0 7.62GB |
| JohnsonHsu/Qwen-Image-2.1-GGUF(9月22日) | Q4_0 4.05GB、Q4_K_M 4.60GB、Q5_K_M 5.22GB、Q6_K 5.88GB、Q8_0 7.59GB |
Q4_K_M+w4a8 エンコーダ+VAE なら合計約 11.6GB。AlperKTS のモデルカードは Q8_0 を 12GB 以上、Q6_K を 8〜12GB、Q5_K_M を 8GB 向けと案内していますが、これは配布者の目安で計測値ではありません。Q4 系は画質の劣化があると配布者自身が書いています。「uncensored」を名乗る再配布も出回っていますが、本記事では扱いません。
Mac 向け MLX パック
toxicdog/Qwen-Image-2.1-MLXの q4 パックは DiT 4.00GB+テキストエンコーダ 6.02GB+VAE 0.68GB の約 10.7GB です。mflux 側の対応は後述します。
第三者の実測値をどう読むか
公式が VRAM を公表していないため、判断材料は第三者の記録です。条件がそれぞれ違うので、数字だけを並べると矛盾して見えます。条件ごとに整理します。
Diffusers、bf16、2048×2048、40 ステップ(Zenn の kun432 氏、Google Colab、9月21日)。 この検証スクラップが日本語で最も条件の揃った記録です。A100 80GB で最適化なしのピークは約 31GB、enable_model_cpu_offload() を有効にすると約 17GB、bitsandbytes の 4bit(nf4)を拡散モデルとエンコーダの両方に適用すると約 7GB に収まっています。最適化なしの A100 で 2048²・40 ステップの 1 枚が「1 分ちょっと」。L4(24GB)は CPU オフロードをしても 2048² の VAE デコードで OOM になり、pipe.vae.enable_tiling() で回避できたものの画像に縦線が入り、タイリングを切ると縦線は消えました。つまり 2048² の既定解像度は VAE デコードのピークが別に来るので、拡散ステップが通っても最後で落ちることがあります。
ComfyUI 系、1024×1024、20 ステップ(AIReiter がまとめた X 上の報告、本人計測ではない)。 RTX 5070 Ti 16GB で約 25 秒、ピーク約 13.9GB。量子化の種類は書かれていません。同じまとめで RTX 4090 の BF16 はシステム全体で約 30.2GB 常駐、1024² で約 21 秒、1536² で約 56 秒(ステップ数不明)。16GB で公式 int8 セットが動く、という表の判断はこの報告に依っています。
構成計算(ai.rs)。 公式 int8 セットは約 16.1GiB で 24GB の RTX 4090 に常駐できる、W4A8 エンコーダ+NVFP4 拡散モデルなら約 10.4GiB という試算です。計測ではなく足し算なので、実行時のアクティベーション分は含まれません。
日本語の構成ガイド(negi-lab、著者検証ベース)。 この記事は 24GB を「最低限の『人権』」、16GB を実用最低ラインと位置づけ、Q4_K_M は 8GB で理論上動くが画像入力の作業で落ちたと書いています。Mac については 32GB モデルだと OS 分を引いて実際に使えるのは 20GB 程度で、64GB を勧めています。
サーバー系フレームワーク。 SGLang-Diffusion のクックブックは RTX 4090 向けに --performance-mode manual --dit-layerwise-offload true --text-encoder-cpu-offload true、RTX 5090 向けに --component-residency text_encoder=layerwise-offload を指定しています。24GB でも bf16 のままなら offload 前提、という公式側の姿勢が読み取れます。RTX 5090 で 1024px・40 ステップ・エンコーダを層ごとに流す設定で 14.12 秒という計測が載っています。
これらを突き合わせると、矛盾に見える 8GB の話は次のように整理できます。Diffusers 4bit の「約 7GB」は 2048² の生成で、A100 という余裕のあるカードで測ったピークです。negi-lab の「落ちた」は GGUF Q4_K_M で参照画像を入力した編集作業です。参照画像はエンコーダ側でトークンとして処理されるので、枚数と解像度が増えるほどエンコーダのメモリが膨らみます。8GB のカードでは、文字からの生成を 1024² 程度に抑えれば通る可能性が高く、複数枚の参照画像を使った編集は 12GB 以上で考える、というのが記録から言える範囲です。
ComfyUI で最初の 1 枚を出す
16GB 以上の NVIDIA GPU なら、追加ノードなしで公式テンプレートから始めるのが最短です。
- ComfyUI を最新版に更新します。公式チュートリアルは「最新の ComfyUI」を要件にしており、ローカル環境では nightly が必要と書かれています。テンプレートが使うコアノード(
Text Encode Qwen Image 2.1など)が古い版には存在しません。 - 上の表の既定 3 ファイル(int8 拡散モデル 7.26GB、int8 エンコーダ 9.35GB、VAE 0.68GB)をそれぞれのフォルダに置きます。12GB 前後ならエンコーダを
qwen3vl_8b_w4a8.safetensorsに替えます。 - テンプレートライブラリから「Qwen-Image-2.1 Text to Image」を開きます。編集は「Qwen Image 2.1 Image Edit」、透過画像は「Remove Background: Qwen Image 2.1」です。
- ローダーで 3 ファイルを選び、プロンプトを書いて実行します。
三つのテンプレートはいずれも 25 ステップ、cfg 1、サンプラー euler、スケジューラ simple が既定で、2048×2048(約 4.0MP)を目標解像度にしています。Diffusers の既定が 40 ステップなのはパイプラインが違うためで、どちらかが間違いということではありません。最初はテンプレートの値のまま出し、VRAM が苦しければ解像度を 1024² や 1536² に下げるのが先で、ステップ数を削るのは後です。
透過画像のテンプレートは、VAE が 4 チャンネルを直接出力するので、従来のマッティング(背景除去)ノードを挟まずにアルファ付きの画像が得られます。保存は PNG にしてください。JPEG や WebP の既定設定ではアルファが落ちます。
生成の速度感は、上で挙げた RTX 5070 Ti 16GB の 1024²・20 ステップ約 25 秒、RTX 4090 の 1024² 約 21 秒という報告が目安になります。2048² はピクセル数が 4 倍なので、時間もメモリも別物として見てください。
GGUF ルート(8〜12GB)
GGUF の拡散モデルを読むには ComfyUI-GGUF カスタムノードが必要です。custom_nodes に git clone し、pip install --upgrade gguf を実行してから、テンプレートの拡散モデルローダーを Unet Loader (GGUF)(UnetLoaderGGUF)に差し替え、テキストエンコーダと VAE は公式の safetensors のままにします。
つまずきやすいのはノードの版です。公開直後の記録では、古い ComfyUI-GGUF が Qwen-Image-2.1 の GGUF を読むと Unknown model architecture! で止まり、ノードの更新で解決したという報告があります。city96 版の README には 2026年9月22日時点で Qwen-Image-2.1 の対応が明記されていないため、エラーが出たらまず ComfyUI 本体とノードの両方を更新し、それでも駄目なら対応を取り込んだフォークを探すのが順序です。
量子化の選び方は、12GB なら Q8_0(約 7.6GB)、8GB なら Q5_K_M か Q6_K から始めて、落ちる場合にだけ Q4 に下げるのが妥当です。Q4 系は配布者が画質低下を認めており、文字の描画や商品写真の忠実さが売りのモデルで最初から Q4 を選ぶ理由は薄いからです。8GB で参照画像を使った編集をしたい場合は、前節の通り落ちる報告があるので、参照画像を 1 枚・小さめの解像度から試してください。
Diffusers ルート(Python から制御したい場合)
公式 README の手順はこの通りです。
bashpip install "torch>=2.4.0" "transformers>=5.17" accelerate pillow
pip install git+https://github.com/huggingface/diffusers
pythonimport torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
)
pipe.enable_model_cpu_offload()  # 24GB 以下なら最初から有効に

image = pipe(
    prompt="雨の中でギターを弾くコーギー、写実的な写真",
    width=1024, height=1024,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("first.png")
既定値は 40 ステップ・2048×2048 で、公式が挙げる解像度プリセットは 1:1 が 2048×2048、4:3 が 2400×1792、3:2 が 2528×1696、16:9 が 2752×1536(縦向きはそれぞれ逆)です。編集は同じパイプラインに image= で PIL 画像 1 枚か最大 10 枚のリストを渡すだけです。メモリの目安は前節の Zenn の記録の通り、offload で約 17GB、bitsandbytes 4bit で約 7GB。README 自体は .to("cuda") の CUDA 前提で書かれ、MPS(Mac)は触れられていません。
2048² で VAE デコード時に OOM が出る場合、pipe.vae.enable_tiling() は回避策になりますが縦線のアーティファクトが報告されているので、可能なら解像度を下げるか offload を強める方を先に試してください。
透過画像は専用のプロンプト書式を使います。
This is an RGBA image with transparency. <説明>. The image has alpha channel and the background is transparent.
出力は必ず PNG で保存します。Zenn の検証では、この書式で生成した画像を画像編集ソフトで開くと背景が透過になっていることが確認されています。
プロンプト書き換え(PE)モデルは必須ではありません。ただし同じ検証で、日本語の短いプロンプトを PE-T2I に通してから生成すると結果が目に見えて良くなったと記録されています。日本語で指示したい人ほど恩恵が大きい一方、PE-I2I だけで約 18.8GB の追加ダウンロードと別の推論コストが要るので、まずは PE なしで 1 枚出してから検討する順番で十分です。
Mac(Apple Silicon)は mflux から
Diffusers の README が CUDA 前提なので、Mac では MLX 実装の mflux が現実的な入口です。2026年9月21日にマージされた PR #736 で mflux-generate-qwen-2.1 コマンド(txt2img と img2img)が追加され、-q 8 / -q 4 で拡散モデルを量子化できます。テキストエンコーダは bf16 のままです。
PR 作者の M5 Max での計測は、1024²・40 ステップ・bf16 で 1 ステップ約 1.5 秒、1 枚約 78 秒、ピークメモリ約 46GB。-q 8 にするとピーク約 30.7GB でした。レビュアーの M3 Ultra では 1 ステップ約 2.95 秒、1 枚約 2 分です。ここから言えることは次の通りです。
- 32GB の Mac は
-q 8でもピークとほぼ同じ容量なので、negi-lab が指摘する「実際に使えるのは 20GB 程度」を踏まえると、-q 4か解像度の引き下げが前提になります。 - 48GB なら
-q 8、64GB 以上なら bf16 も視野に入ります。64GB 推奨という日本語の記事の判断は、この計測と整合します。 - 速度は 1024² で 1 枚 1〜2 分と、上で見た NVIDIA の 20 秒台とは桁が違います。枚数を出す用途なら、Mac は検証用と割り切るのが無難です。
PR #736 時点では、参照画像による編集、LoRA、条件画像の KV キャッシュは未対応として保留されています。後続の PR #741 のタイトルは参照画像編集・RGBA・プレフィックスキャッシュの追加を掲げていますが、本文は未確認なので、編集用途で Mac を使うつもりならリポジトリの最新状態を確認してから始めてください。Draw Things の 2.1 対応も現時点では確認できていません。
商用利用の前に:Qwen Research License の境界
ここが日本語の検索で最も多く出る疑問です。note には「非商用のライセンスのようです。出力した画像を商用利用できるのかどうかも、僕にははっきり判断できませんでした」という感想が並びますが、ライセンス本文を読むと線引きははっきりしています。以下は法的助言ではなく、条文の要約です。
- 重み(Materials)の使用・複製・配布・改変は 「FOR NON-COMMERCIAL PURPOSES ONLY」、つまり研究または評価目的に限られます。
- 商用目的で使うには別途の商用ライセンスが必要で、連絡先として model-business@notice.qwencloud.com が示されています。
- 再配布や派生物には契約書の同梱、改変ファイルの明示、「Built with Qwen」または「Improved using Qwen」の表示が求められ、派生物の主名称に「Qwen」を使うことはできません。GGUF や MLX の再配布もこの条件下にあり、Hugging Face 上では
license: otherとして扱われています。 - 生成された画像そのものについて、ライセンス本文には明示的な条項がありません。
最後の点について、Qwen の開発チームが 2026年9月21日に X で「出力はライセンス対象の Materials に含まれず、生成した画像の権利は利用者にある」という趣旨の投稿をしたと伝えられています。ただし本記事の執筆時点で投稿本文は直接確認できておらず(検索結果の抜粋のみ)、Hugging Face の議論スレッドでは「SNS の投稿がライセンスファイルを上書きすることはない」という反論も出ています。趣味の利用が「研究または評価」に当たるかについても、同じスレッドで意見が割れています。
実務上の判断はこう整理できます。個人の検証や社内評価はライセンスの範囲内。クライアント納品や自社サービスの画像生成にこのモデルを組み込む、あるいは重みを載せた有料サービスを運用するなら、商用ライセンスの取得か、別モデルへの切り替えが必要です。生成画像だけを商用に使う中間的なケースは、X の投稿を根拠にするか条文を厳格に読むかで結論が変わるため、案件の重さに応じて上記の連絡先に確認するのが確実です。前世代の Qwen-Image-2512 が Apache-2.0 だったことを覚えている人ほど、この変更は見落としやすいので注意してください。
動かない、または商用で使えない場合の選択肢
機材が足りない、あるいはライセンスの都合で組み込めない場合、まず試すべきは公式の Hugging Face Space です。品質の確認だけならダウンロードなしで済みます。ModelScope 側には DiffSynth-Studio があり、ダウンロード・オンライン生成に加えて LoRA 学習が案内されているので、学習まで視野に入れるならこちらを見てください。
商用の画像生成をすぐに API で回したい場合は、別モデルのホスト型 API に切り替える判断になります。laozhang.ai のモデルカタログには 2026年9月22日時点で Qwen の画像モデルは載っていませんが、gpt-image-2.5-flare(入力 100 万トークン $5・出力 100 万トークン $30)、gemini-3.1-flash-image(1 回 $0.055)、flux-2-pro(1 回 $0.03)などが Images エンドポイントで使えます。価格は変動するので、実際の数字はカタログで確認してください。ComfyUI のワークフローを保ったまま切り替えたいなら、GPT Image 2.5 の ComfyUI ノードを使う方法もあります。編集用途で開源・ホスト型を横断して比較したい場合は画像から画像を生成する AI の選び方が参考になります。
GPU の買い替えを検討する段階なら、16GB クラスの選び方はローカル LLM コーディング向け 16GB GPU の選び方にまとめてあります。画像生成でも判断軸(VRAM 容量とメモリ帯域)は共通です。
よくある質問
Qwen-Image-2.1 の公式な最低 VRAM は何 GB ですか。 公式には公表されていません。README、Hugging Face のモデルカード、ComfyUI 公式チュートリアルのいずれにも VRAM の数値はなく、bf16 版は「より多くの VRAM が必要」とだけ書かれています。本記事の表の数字はすべて第三者の実測か構成計算です。
無料で使えますか。 重みは無料でダウンロードでき、研究・評価目的なら費用はかかりません。ただしライセンスは非商用限定で、商用利用には別途契約が必要です。ダウンロードだけで 14〜33GB、PE モデルを加えるとさらに 9.5〜18.8GB のストレージが要ります。
透過 PNG はどうやって出しますか。
ComfyUI では「Remove Background: Qwen Image 2.1」テンプレート、Diffusers では This is an RGBA image with transparency. ... The image has alpha channel and the background is transparent. の書式を使い、いずれも PNG で保存します。VAE が 4 チャンネルを直接出力するため、背景除去ノードは不要です。
参照画像は何枚まで使えますか。
公式仕様で最大 10 枚です。Diffusers では image= にリストで渡します。ただし枚数が増えるほどテキストエンコーダのメモリが増えるので、8〜12GB の環境では 1〜2 枚から始めてください。
LoRA は学習できますか。 2026年9月22日時点で公式に案内されているのは ModelScope の DiffSynth-Studio による学習です。mflux の Mac 実装では PR #736 の段階で LoRA は未対応です。他の学習ツールの対応は確認できていません。
Diffusers の 40 ステップと ComfyUI の 25 ステップ、どちらが正しいのですか。 どちらもそれぞれの公式既定値です。パイプラインが異なるため単純比較はできません。使うルートの既定値から始め、品質に不満があれば増やす、時間を縮めたければ減らす、という順で調整してください。