MiniMax M3.1 Flashのサイズは252.4GB:必要メモリと量子化版
MiniMax M3.1 Flashは総パラメータ約428B、重みは252.4GBです。256GB級なら3-bit版、GPUサーバーなら公式版、それ未満はAPIが現実的です。
目次
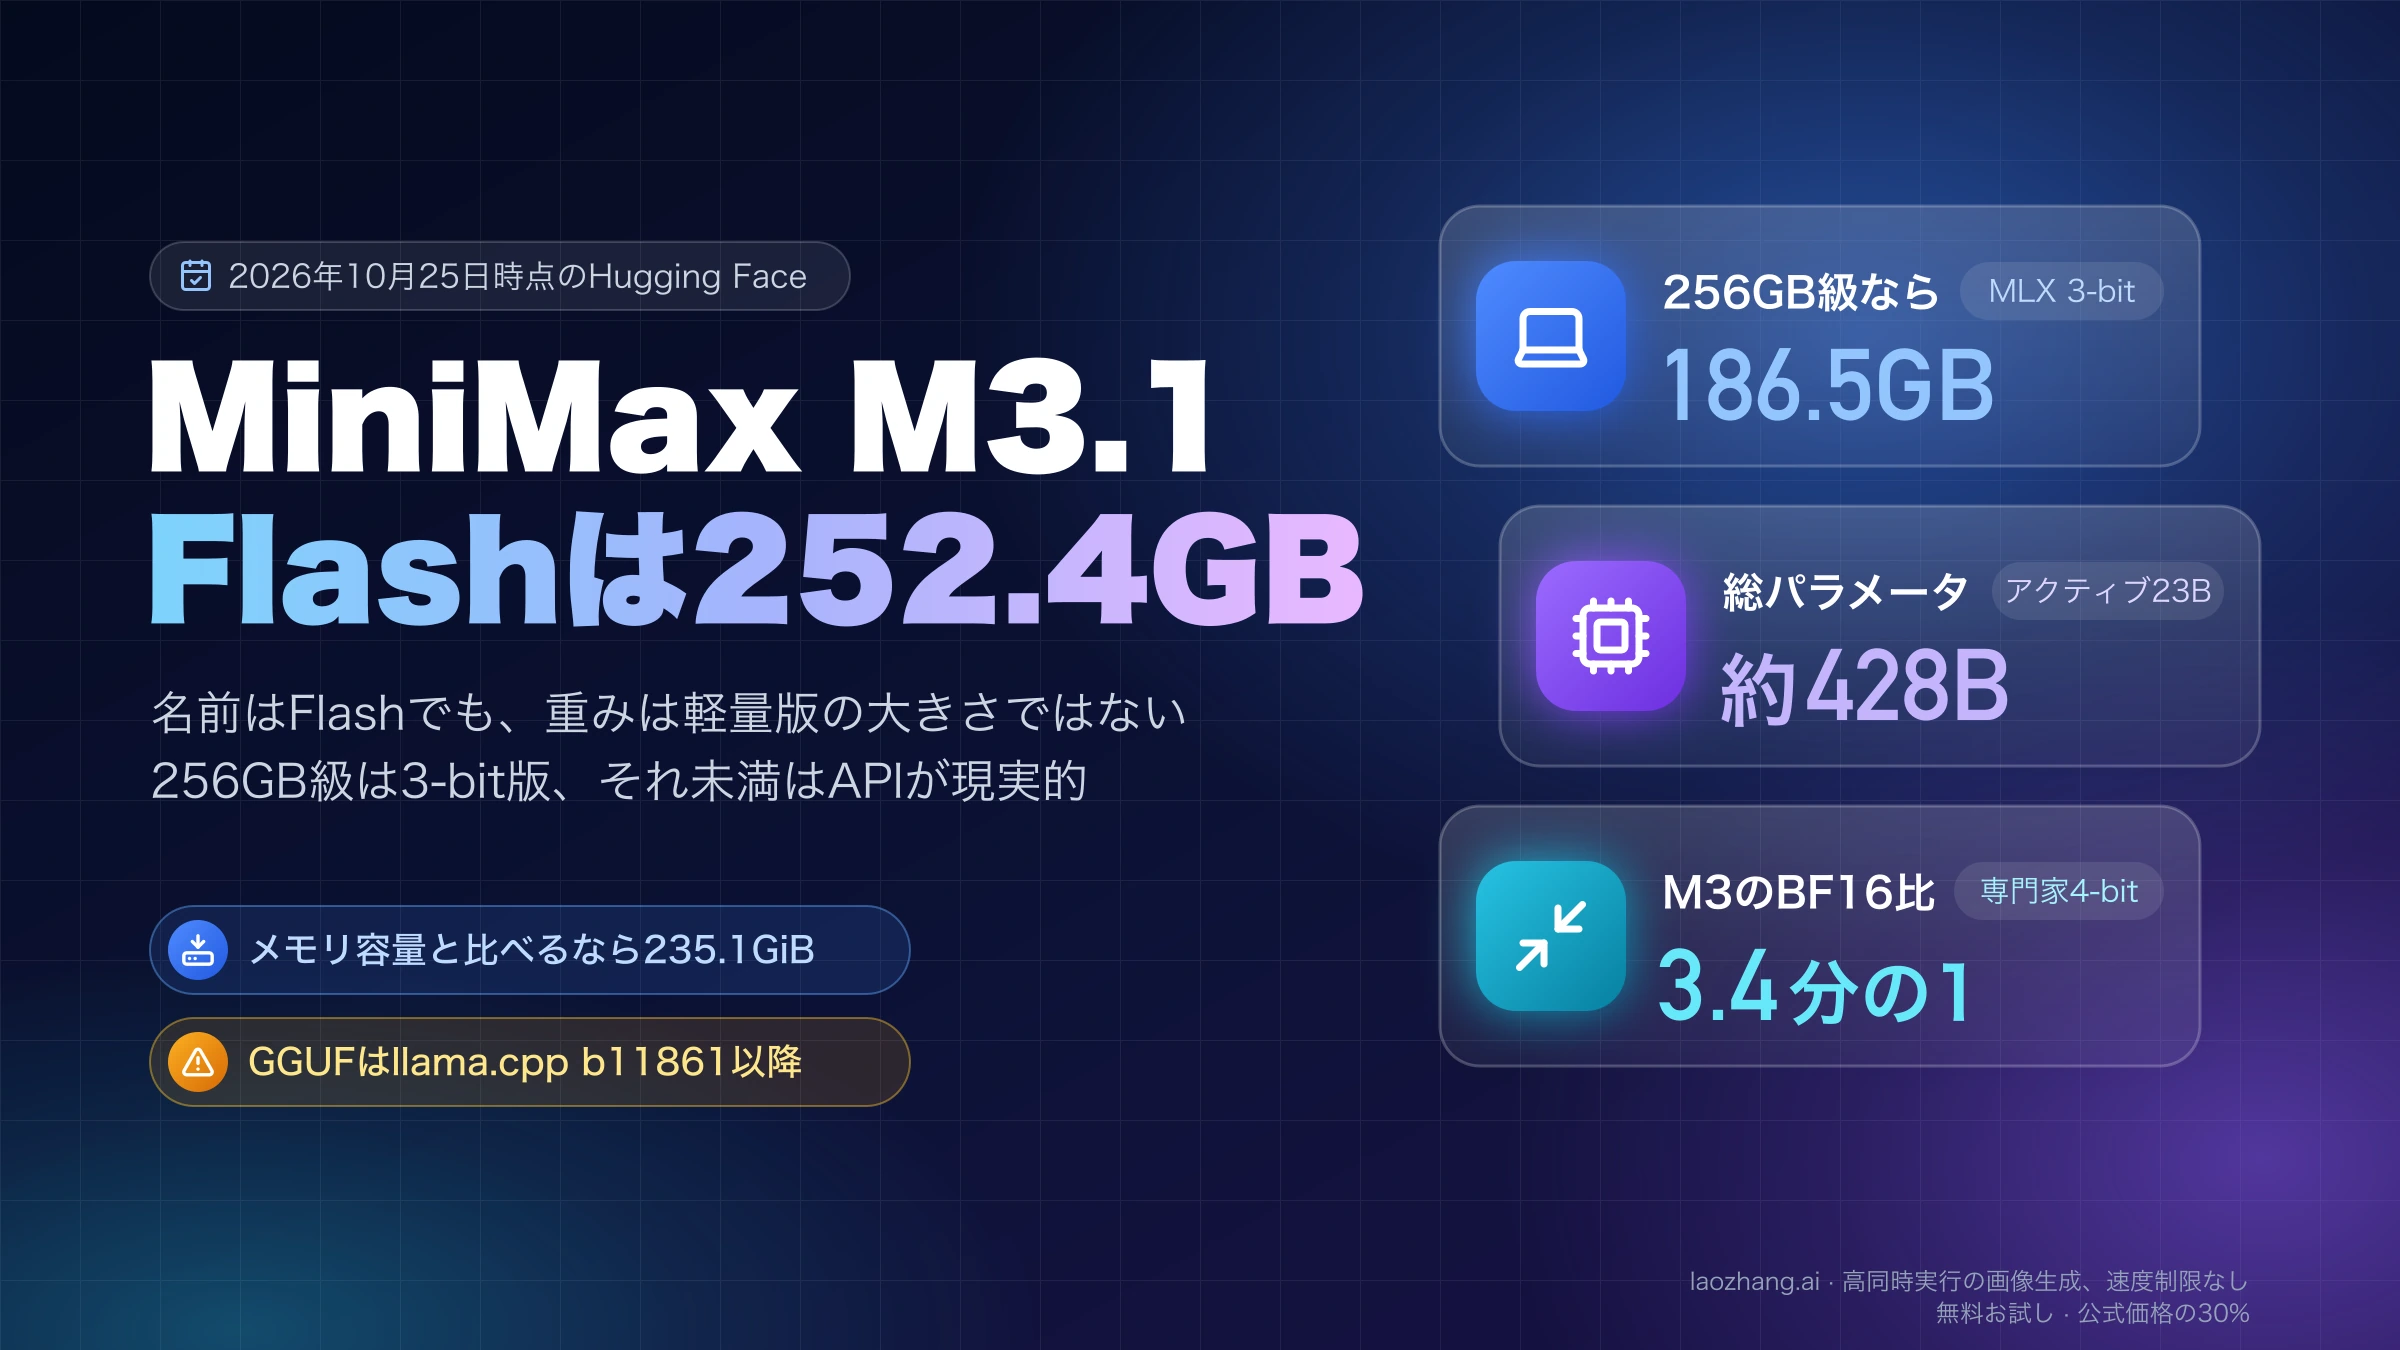
MiniMax M3.1 Flashは、総パラメータ約428B、1トークンあたりのアクティブパラメータ約23BのMoEモデルで、2026年10月23日にHugging Faceで重みが公開されました。公式リポジトリMiniMaxAI/MiniMax-M3.1-Flashのファイルは合計252.4GB(235.1GiB)あり、名前に「Flash」と付いていても小さいモデルではありません。パラメータ数は前モデルのMiniMax M3と同じで、専門家(エキスパート)の重みを学習の段階から4-bitにしたぶん、ダウンロードが小さくなっています。
どの版を落とすかは、手元のメモリ総量で決まります。ユニファイドメモリ256GBのMacのような256GB級なら、mlx-community/MiniMax-M3.1-Flash-Text-3bit(186.5GB)か、unsloth/MiniMax-M3.1-Flash-GGUFのUD-IQ3_XXS〜UD-Q3_K_XLを、GGUFならllama.cpp b11861以降で動かします。H100/H200を8枚積んだノードや、B200・B300などBlackwell世代のGPU 4枚のサーバーなら、公式版をvLLM 0.33.0以降で起動します。メモリが128GB以下だと、重みだけなら最小の1-bit版か2-bit版が入るものの余裕がないため、MiniMaxのAPIを使うほうが現実的です。
ここに載せたファイルサイズは、2026年10月25日にHugging FaceのAPIから各リポジトリのファイル一覧を取得して合計したもので、パラメータ数も公式のconfig.jsonから計算し直しています。モデル本体のダウンロードやローカルでの推論は行っておらず、後半で触れる速度の数字はコミュニティの報告1件だけです。起動条件はvLLM、SGLang、llama.cppがそれぞれ公開している情報に基づきます。
公式の重み252.4GBの内訳と、M3と同じパラメータ数
2026年10月25日時点で、公式リポジトリには72個のファイルがあり、合計は252,446,157,295バイトです。48個に分かれたモデル本体の重み(model-*.safetensors)が250.1GB、投機的デコード用の小さなドラフトモデルを収めたdspark/フォルダが2.3GBで、残りはトークナイザーと設定ファイルです。DSparkは対応するサーバーで生成を速くするための部品で、基本の推論には使いません。
サイズを読むときは単位に注意が要ります。Hugging Faceの表示は10進のGB(1GB = 10億バイト)ですが、GPUやMacのメモリ容量として書かれる「192GB」「512GB」は実質的に2進の値なので、載るかどうかはGiB(1GiB = 1,073,741,824バイト)にそろえて比べます。252.4GBをGiBに直すと235.1GiBで、数字が約7%小さくなります。以下の表では両方を併記します。
「Flash」は、パラメータを減らした軽量版という意味ではありません。2026年10月25日時点のHugging Face APIでは、MiniMax M3の公式リポジトリはBF16(16-bit)の重みで854.2GBあり、パラメータ数は427.0Bでした。M3.1 Flashを数え直すと427.1Bでほぼ同じです。ダウンロードが約3.4分の1になったのは、ルーティングされる専門家の重みを量子化認識学習(QAT)で4-bit(NVFP4)にしたからで、公式のconfig.jsonによると、アテンションと密な層は8-bit(MXFP8)、埋め込み・出力層・画像エンコーダーはBF16のまま残っています。M3.1 FlashにはMiniMax公式のBF16版はなく、配布されているのはこの4-bitと8-bitが混ざったチェックポイントだけです。
「アクティブ23B」は1トークンの計算に使う部分の大きさで、必要なメモリの量ではありません。各MoE層はトークンごとに128個の専門家から4個を選ぶので、どの専門家が呼ばれてもよいように、全体の重みをメモリに置いておく必要があります。
Hugging Faceの「220B params」は4-bitを2つずつ詰めた数え方
Hugging Faceのモデルページには「220B params」と表示されますが、これは4-bitの重みを詰めて保存しているために生じる見かけの数字です。2026年10月25日時点のsafetensorsメタデータでは、U8が206,561,083,392、F8_E4M3が10,560,208,896、BF16が3,323,222,528、F32が46,339,200で、合計が220,490,854,016になります。U8として数えられているのはNVFP4で保存された専門家の重みで、1バイトに4-bitの値が2つ入っているため、U8の数は実際のパラメータ数の半分になります。
206.56B(U8)× 2 + 10.56B(F8)+ 3.32B(BF16)+ 0.05B(F32)≒ 427.1B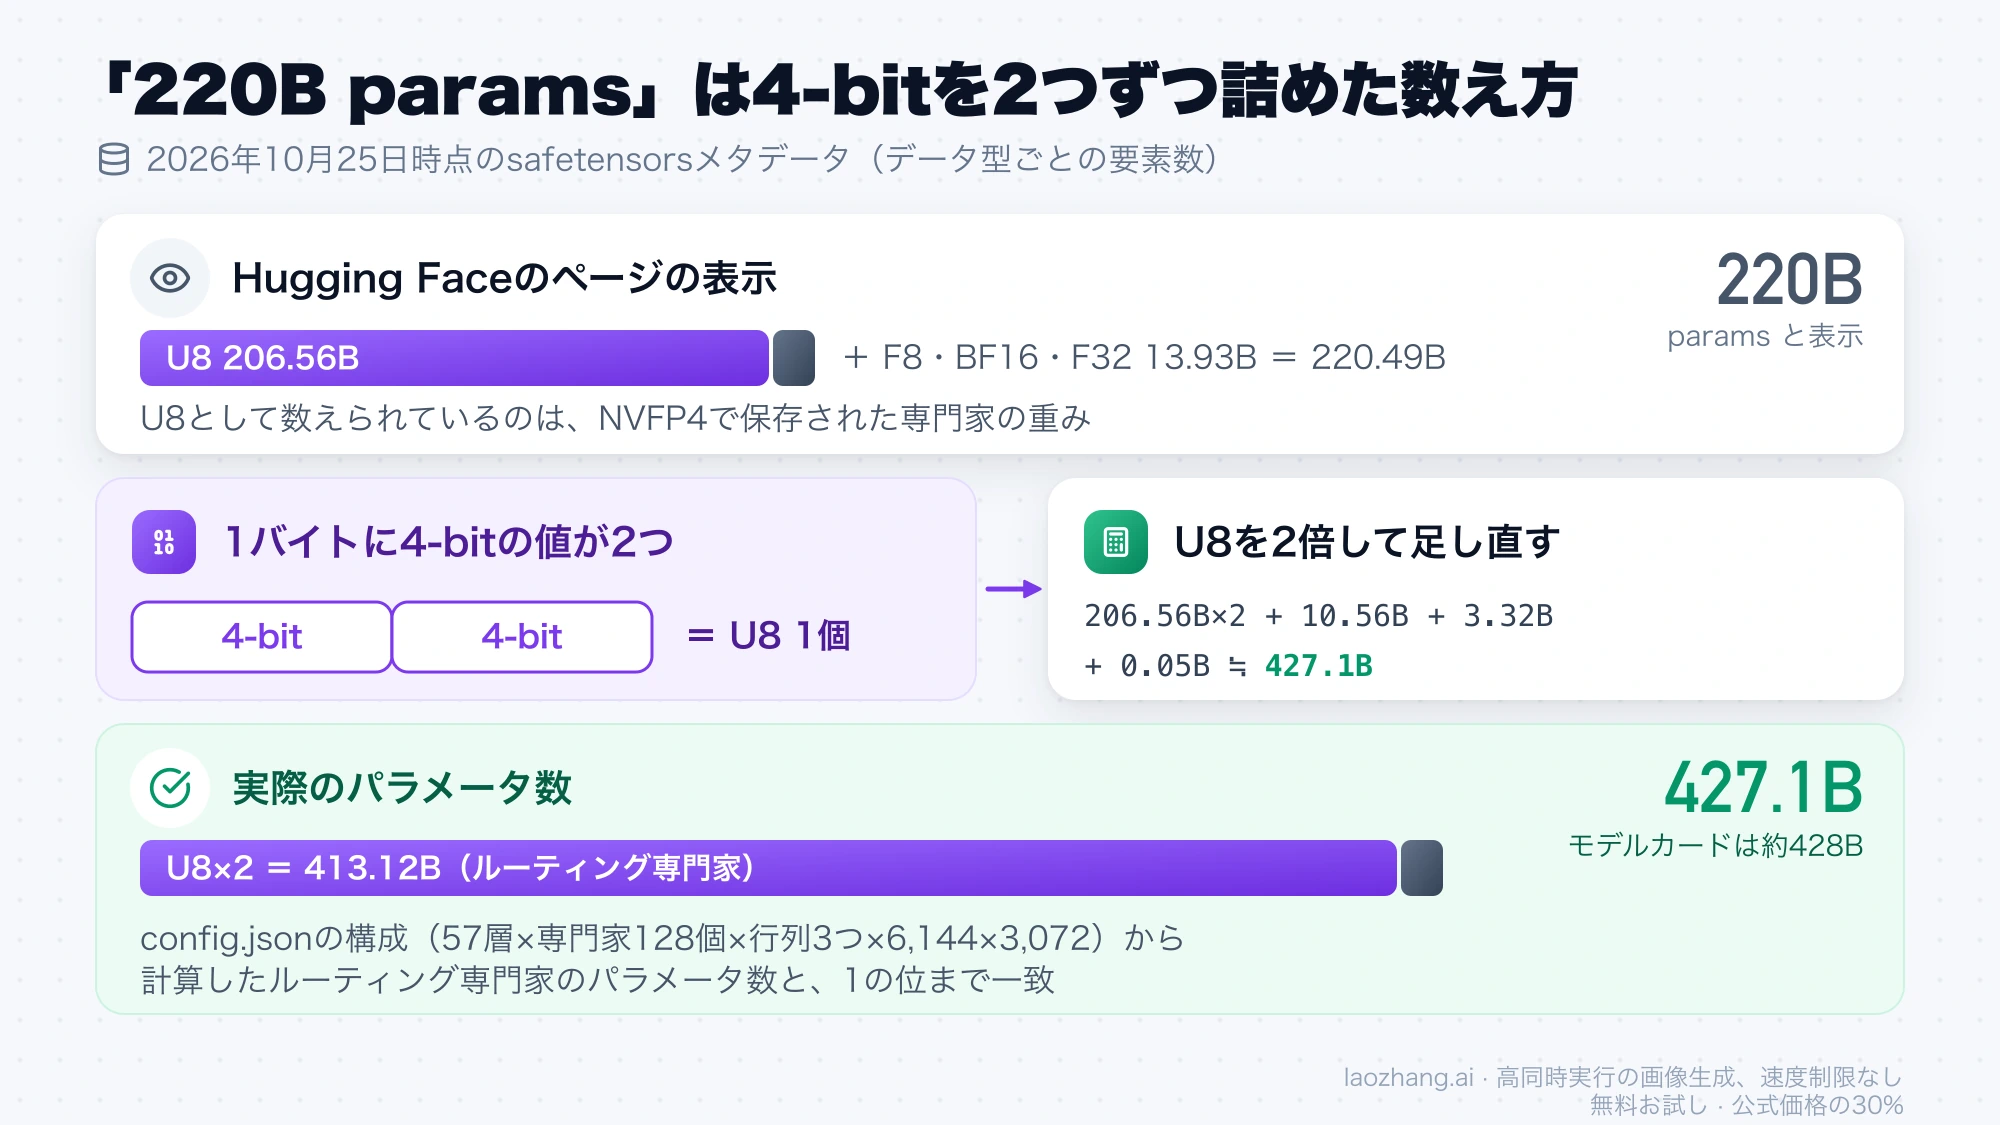
U8を2倍した413,122,166,784は、config.jsonの構成(MoE層57層 × 専門家128個 × 行列3つ × 6,144 × 3,072)から計算したルーティング専門家のパラメータ数と1の位まで一致します。補正後の427.1Bは、モデルカードにある「約428B」とほぼ同じです。同じファイルを置いたミラーのunsloth/MiniMax-M3.1-Flashにも同じ220Bが表示されるので、ページによって規模が違うように見えても、中身は同じモデルです。
Hugging Faceでどれを落とすか:配布版ごとの実測サイズ
2026年10月25日時点で、Hugging Face上の「MiniMax-M3.1-Flash」の名前を含むリポジトリは49個あります。そのうち配布元がはっきりしていて、動かすエンジンが分かっている主な版について、APIのファイル一覧からサイズを合計したのが次の表です。
| リポジトリ | 量子化 | サイズ(GB / GiB) | 形式 | 動かす環境とエンジン |
|---|---|---|---|---|
MiniMaxAI/MiniMax-M3.1-Flash(公式) | 専門家NVFP4+MXFP8 | 252.4 / 235.1(DSpark込み) | safetensors | NVIDIA Blackwell・Hopper、AMD MI355X。vLLM 0.33.0以降かSGLang |
amd/MiniMax-M3.1-Flash-Quark-MXFP4 | MXFP4 | 239.5 / 223.0(DSpark込み) | safetensors | AMD MI350X・MI355X。SGLang(ROCm 7.2以降) |
FlagRelease/MiniMax-M3.1-Flash-W8A8-nvidia-FlagOS-Express | W8A8(8-bit) | 433.2 / 403.4(DSpark込み) | safetensors | FlagOSのvLLM-plugin-FL。Huawei Ascendなど他社チップ向けは別リポジトリ |
mlx-community/MiniMax-M3.1-Flash-Text-4bit | 4-bit | 248.4 / 231.3 | MLX(テキストのみ) | Apple SiliconのMac。MLX |
mlx-community/MiniMax-M3.1-Flash-Text-3bit | 3-bit | 186.5 / 173.7 | MLX(テキストのみ) | Apple SiliconのMac。MLX |
unsloth/MiniMax-M3.1-Flash-GGUF UD-Q8_K_XL | 8-bit系 | 259.1 / 241.3 | GGUF | llama.cpp b11861以降 |
| 同 UD-Q4_K_XL | 4-bit系 | 249.4 / 232.3 | GGUF | llama.cpp b11861以降 |
| 同 UD-Q3_K_XL | 3-bit系 | 194.0 / 180.6 | GGUF | llama.cpp b11861以降 |
| 同 UD-IQ3_S | 3-bit系 | 175.5 / 163.4 | GGUF | llama.cpp b11861以降 |
| 同 UD-IQ3_XXS | 3-bit系 | 160.0 / 149.1 | GGUF | llama.cpp b11861以降 |
| 同 UD-Q2_K_XL | 2-bit系 | 143.9 / 134.0 | GGUF | llama.cpp b11861以降 |
| 同 UD-IQ2_XXS | 2-bit系 | 134.9 / 125.7 | GGUF | llama.cpp b11861以降 |
| 同 UD-IQ1_M | 1-bit系 | 129.4 / 120.5 | GGUF | llama.cpp b11861以降 |
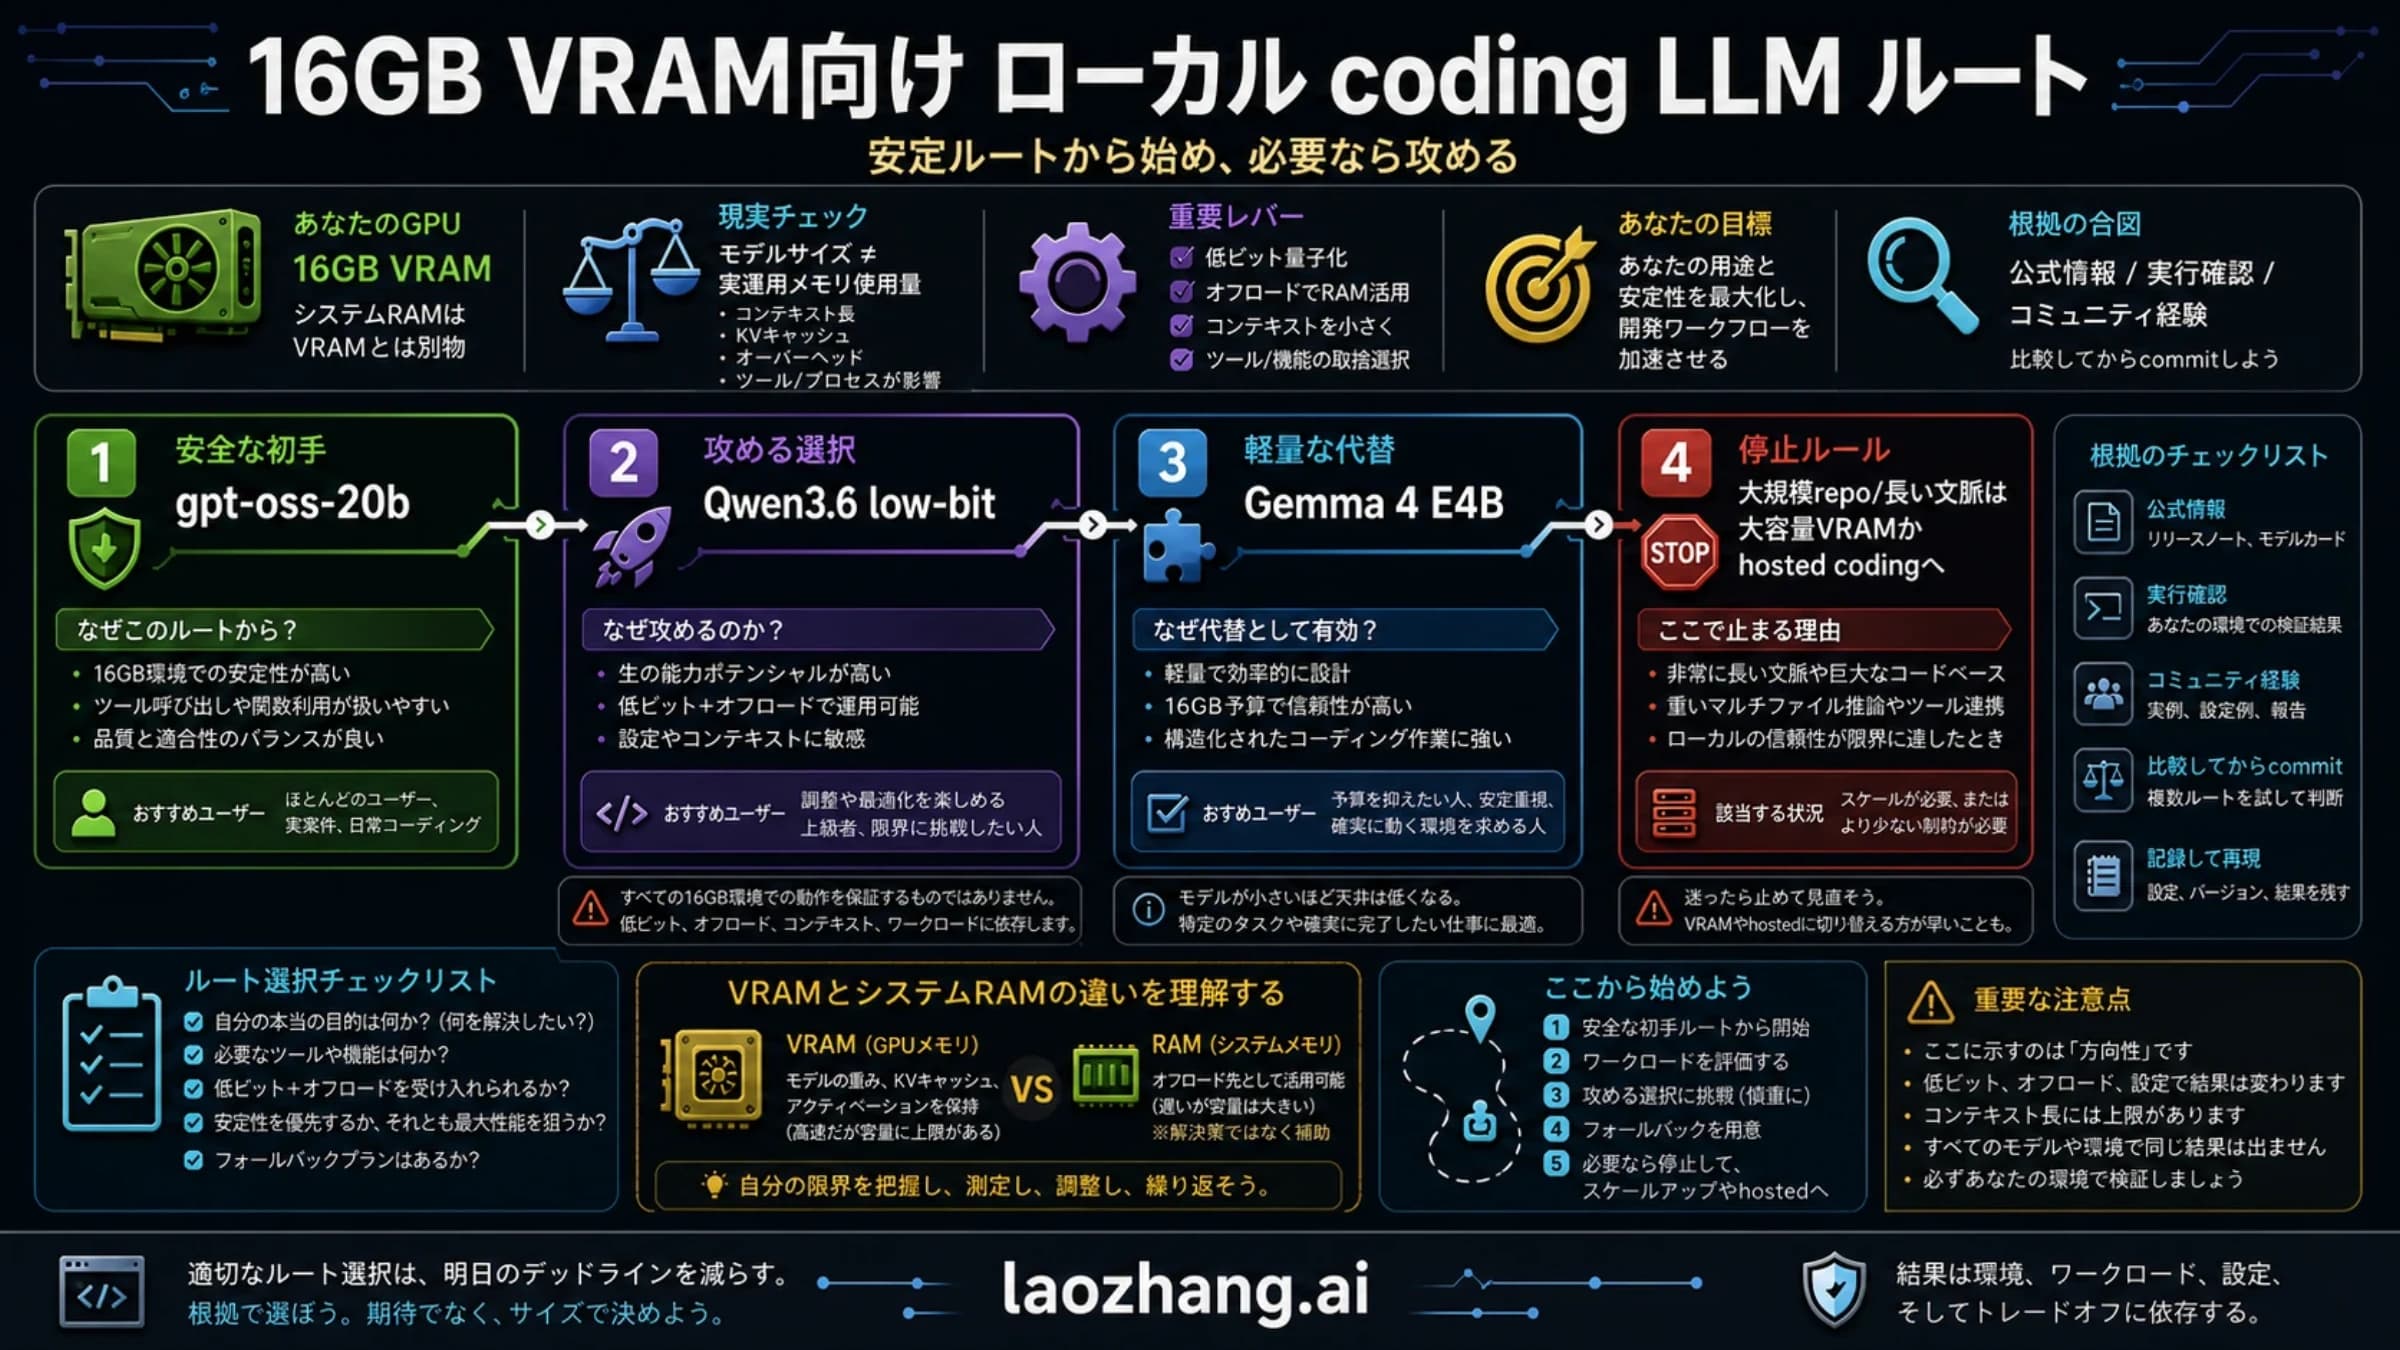
よく誤解されるのが4-bitのGGUFの大きさです。UD-Q4_K_XLは249.4GBで、公式版とほとんど変わりません。公式の専門家がすでに4-bitで配布されているため、4-bitに量子化し直してもファイルは小さくならず、メモリを減らしたいなら3-bit以下を選ぶことになります。ビット数を下げるほど容量は減りますが、MiniMaxはモデルカードで「評価結果は公式の重みのもので、第三者の量子化版では異なる可能性がある」と書いています。1-bitや2-bitの版でコーディングエージェントを動かすと何が崩れやすいかは、ローカル coding agent が失敗する?量子化・コンテキスト・Harness を切り分けるで切り分け方をまとめています。
UnslothのGGUFリポジトリは、2026年10月25日時点でREADMEの冒頭が「Work in progress」のままで、同じ日にもファイルが更新されています。量子化の種類やサイズは今後変わる可能性があり、BF16のフォルダは1.7GBしかなく、まだそろっていません。画像入力用のプロジェクターmmproj-F32.gguf(3.5GB)は別ファイルで、テキストだけなら要りません。ダウンロード数は公式リポジトリが最も多く、個人が公開しているGGUFにはUnslothのGGUFより多くダウンロードされているものもありますが、その変換の手順は公開情報からは分かりません。名前にuncensoredやabliteratedと付くリポジトリは安全のための調整を外した改変版で、公式の重みとは別物として扱うべきです。
自分のマシンに載る?メモリ別に選ぶ版とエンジン
余裕を残して載るのは、メモリ総量が256GB級なら3-bit以下の版で、512GB級なら公開されているGGUFとMLX版がすべて入ります。公式版はNVIDIAかAMDのGPUサーバー向けです。128GBでは、UD-IQ1_M(120.5GiB、残り7.5GiB)とUD-IQ2_XXS(125.7GiB、残り2.3GiB)が重みだけ入るのが限度で、32GBのGPU 1枚には、CPU側のメモリへ逃がさない限りどの版も載りません。
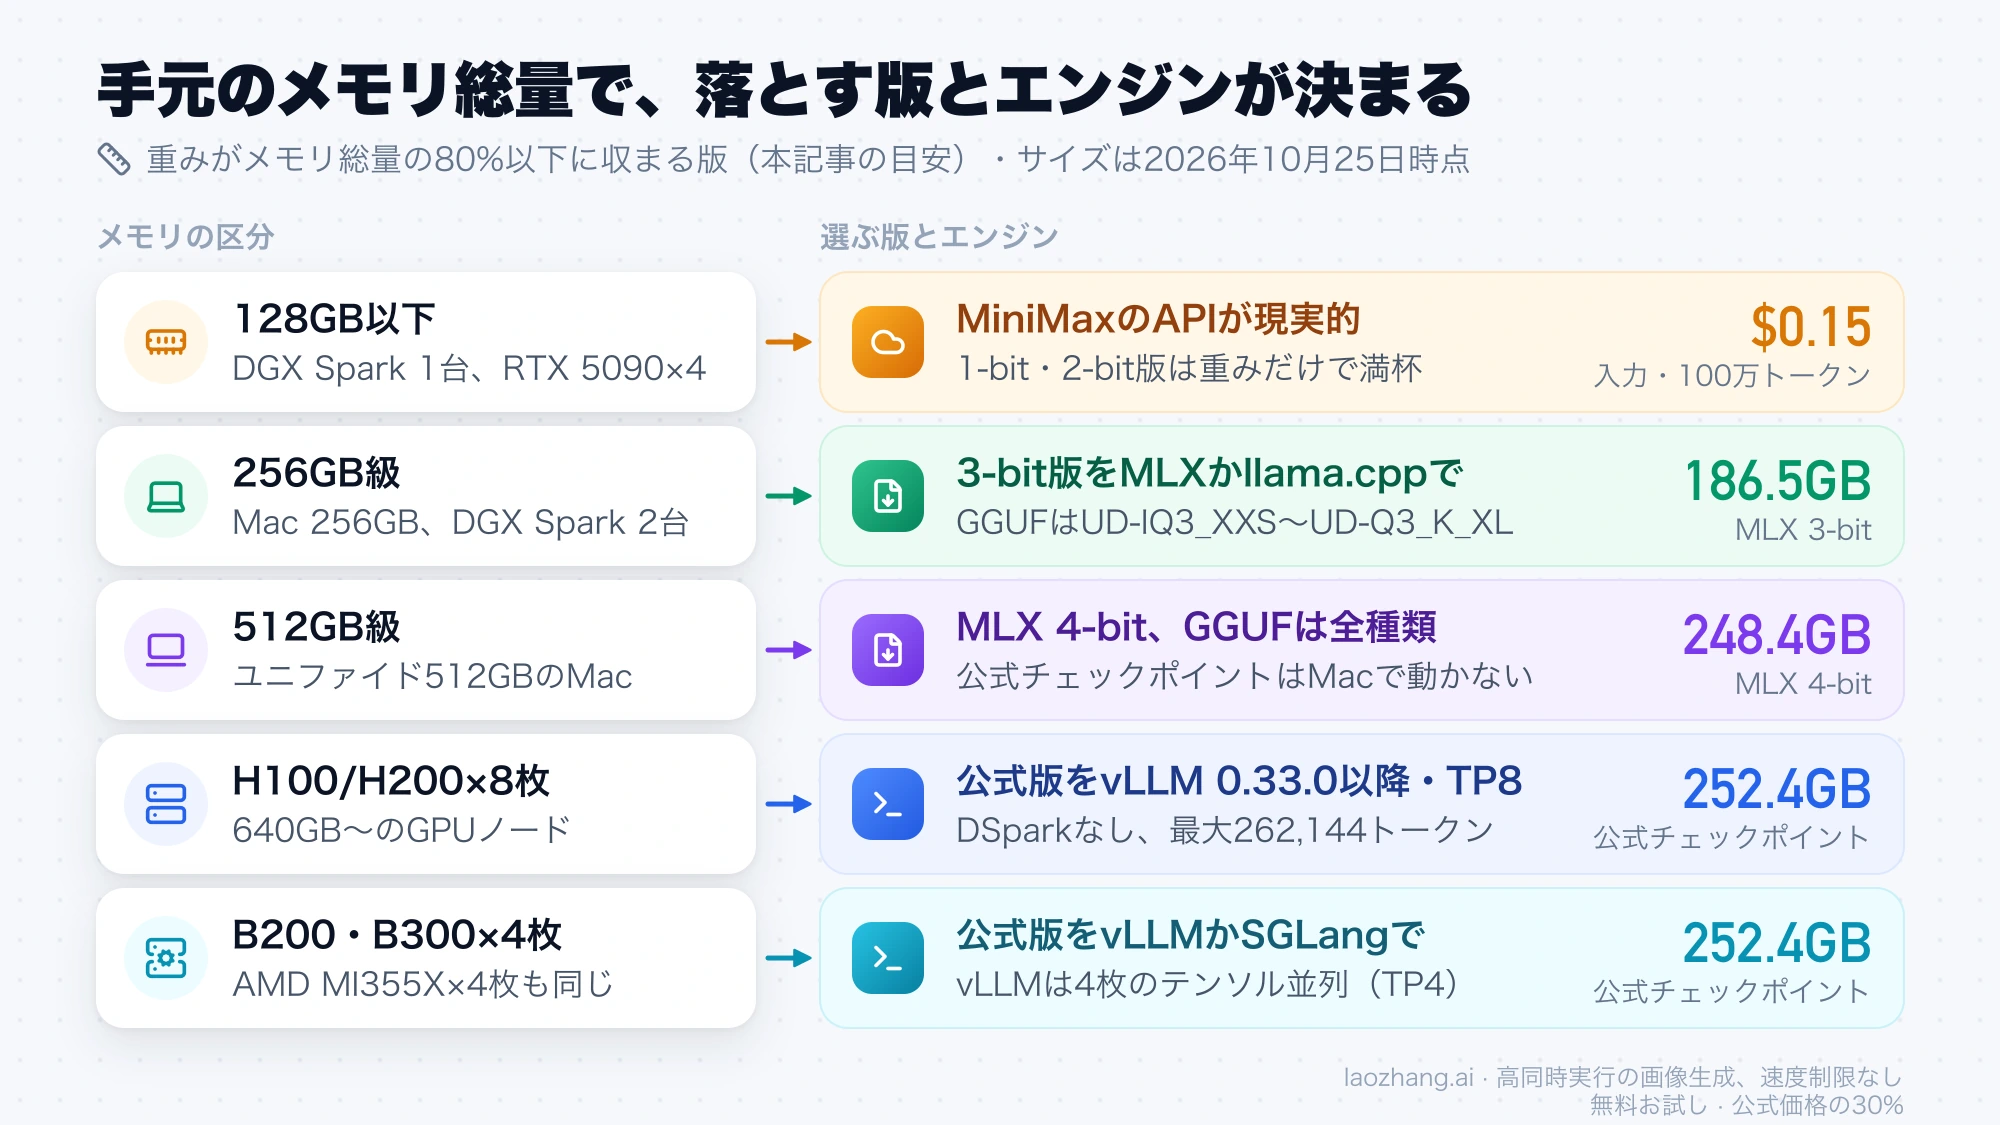
| メモリの区分 | 例 | 余裕をもって載る版 | エンジン | 注意点 |
|---|---|---|---|---|
| 32GB | RTX 5090 1枚+システムRAM | なし | llama.cpp b11861以降でRAMへオフロード | 2-bitで出力毎秒約5トークンという報告が1件 |
| 128GB | DGX Spark 1台、RTX 5090 4枚 | なし(UD-IQ1_MとUD-IQ2_XXSが重みだけ入る) | llama.cpp b11861以降 | KVキャッシュの余地がほぼない |
| 256GB | ユニファイドメモリ256GBのMac、DGX Spark 2台 | MLX 3-bit、GGUF UD-IQ3_XXS〜UD-Q3_K_XL | MacはMLXかllama.cpp | 4-bit版と公式版は重みだけ入り余裕がない |
| 512GB | ユニファイドメモリ512GBのMac | MLX 4-bit、GGUFはUD-Q8_K_XLまで全種類 | MLXかllama.cpp | 公式チェックポイントはMacでは動かない |
| 640GB〜 | H100 80GB×8、H200 141GB×8 | 公式版 | vLLM 0.33.0以降、TP8 | DSparkなし、レシピ例はコンテキスト262,144トークン・動画オフ |
| 768GB〜 | B200×4、B300×4、GB200・GB300 | 公式版 | vLLM(TP4)、SGLang | NVFP4の専門家をネイティブに実行 |
| AMDのGPUサーバー | MI355X×4 | 公式版、AMD Quark MXFP4 | vLLM(TP4、ROCm 7.2以降)、SGLang | vLLMは読み込み時に専門家をMXFP8へ変換 |
| 504GiB以上 | Ascendなど国産系アクセラレータ8枚 | FlagOS W8A8(403.4GiB) | vLLM-plugin-FL | 8-bitなので公式版より大きい |
表の「余裕をもって載る」は、重みのファイルがメモリ総量の80%以下に収まることを指します。残りの約20%をKVキャッシュ、計算途中の値、OSやランタイムに回すための目安で、MiniMaxや各エンジンが示した数字ではありません。KVキャッシュはコンテキストを長くするほど増え、重みとは別にかかるので、100万トークンのような長い文脈を使う予定なら、さらに大きなメモリが必要になります。H200 4枚(564GB)も容量の上では公式版が入りますが、vLLMのレシピがHopperに指定しているのは1ノード8枚のTP8です。
容量が足りても、エンジンがその形式に対応していなければ動きません。ユニファイドメモリ512GBのMacは公式版の235.1GiBを容量では収められますが、Macで使えるのはMLX版かGGUF版です。DGX Sparkについては、4台をつないでvLLMのTP4で動かしたというコミュニティの報告をkie.aiが紹介していますが、2台構成での動作報告は公開情報にありません。32GBのGPU 1枚で無理なく動くモデルを探しているなら、Qwen3.8-27Bの必要VRAM:RTX 5090・GPU 2枚・量子化と262Kの設定のほうが現実的な選択肢です。
vLLMでの起動:H100/H200は8枚、Blackwellは4枚
公式チェックポイントを動かすにはvLLM 0.33.0以降が必要です。2026年10月23日に更新されたvLLMのMiniMax-M3.1-Flashレシピは、Blackwell(GB200、GB300、B200、B300)とAMD MI355Xで4枚のテンソル並列(TP4)、H100/H200で1ノード8枚のTP8を指定しています。HopperにはFP4のテンソルコアがないため、専門家の重みはMarlinカーネルで処理され、KVキャッシュはFP8になり、DSparkによる投機的デコードは有効になりません。Hopper向けの例では最大コンテキストを262,144トークンに抑え、動画入力をオフにしています(画像は使えます)。
H100/H200の8枚ノードで試す手順は次のとおりです。まずvLLMを0.33.0以降に更新します。
pip install -U "vllm>=0.33.0"次に公式の重み(252.4GB)をHugging Faceのキャッシュに落とします。起動時に取得させるより、先に落としておくほうが失敗したときに切り分けやすくなります。
hf download MiniMaxAI/MiniMax-M3.1-Flash最後に、レシピのHopper向けの例をそのまま使って起動します。
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
  --tensor-parallel-size 8 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype fp8 \
  --attention-config '{"indexer_kv_dtype": "fp8"}' \
  --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
  --max-model-len 262144 \
  --max-num-seqs 80 \
  --limit-mm-per-prompt '{"video": 0}' \
  --gpu-memory-utilization 0.9 \
  --no-enable-log-requests \
  --disable-hybrid-kv-cache-manager \
  --moe-backend marlin \
  --enable-auto-tool-choice \
  --tool-call-parser minimax_m3
--block-size 128はMiniMax Sparse Attention(MSA)のブロックサイズに合わせるための必須設定で、外すとNo common block size for 16というエラーで止まります。Blackwellでは-tp 4に加えて、KVキャッシュをNVFP4にする--kv-cache-dtype nvfp4と、dspark/のドラフトモデルを自動で読み込む--speculative-config("method":"dspark")を付けた別のコマンドになり、AMD MI355X用のコマンドもレシピに載っています。データ並列で組む構成では初回起動が10分を超えることがあり、レシピはVLLM_ENGINE_READY_TIMEOUT_S=3600で待ち時間を延ばしています。
SGLangを使う場合、SGLangのMiniMax-M3.1クックブックによると、2026年10月25日時点ではM3.1への対応がまだSGLangのリリース版に含まれておらず、番号がまだ決まっていない対応PRからインストールするか、開発版のDockerイメージlmsysorg/sglang:dev-minimax-m31-flashを使います。用意されているのはB300 4枚とB200 8枚、AMD MI350X/MI355X 4枚の構成で、Hopper向けの例はありません。BlackwellではMSA用カーネルの一部が実行時にコンパイルされ、CUDA Toolkitが13.4より古いとエラーにならずに遅い経路で動くため、起動ログで確認しておく必要があります。
Macとllama.cppで動かす条件:GGUFはb11861以降
Macでは公式チェックポイントは動きません。NVFP4の専門家を処理できるのはCUDAやROCm向けのvLLMとSGLangで、Macで使えるのはMLX版かGGUF版です。MLX版のmlx-community/MiniMax-M3.1-Flash-Text-4bitと-Text-3bitは名前のとおりテキスト専用で、画像や動画は入力できません。GGUFを使う場合は、使う量子化のファイルだけを指定して落とすと、ほかの版を巻き込まずに済みます。
hf download unsloth/MiniMax-M3.1-Flash-GGUF --include "*UD-IQ3_XXS*"GGUFで最も大事なのはllama.cppのバージョンです。2026年10月23日に報告されたllama.cppのissue #31063では、M3.1 FlashのGGUFがエラーなく読み込まれるのに、どのプロンプトでも意味のない文字列しか出力されませんでした。原因はMiniMax M3用のコードが専門家ごとのNVFP4スケールを計算に渡していなかったことで、修正のPR #31097は2026年10月24日にマージされ、それを含む最初のリリースがb11861です。それより古いllama.cppや、古いllama.cppを組み込んだツールでは、どのGGUFを使っても出力が壊れます。
M3.1 Flash向けのUnslothの説明ページは2026年10月25日時点でまだなく、参考になるのは前モデルM3のGGUFの案内です。そこではGGUF版は実験的な扱いで、テキストのみ、MSAには未対応で通常のアテンションに切り替わるため、コンテキストは控えめに設定するよう書かれています。M3.1 FlashのGGUFでMSAや画像入力が使えるかは、公開情報に記載がありません。
GPU 1枚とシステムRAMを組み合わせて、入りきらない部分をRAMに逃がす方法もあります。issue #31063の報告者は、RTX 5090(32GB)と128GBのRAMで、自分で変換した146GiBのQ2_K(2-bit)のGGUFを動かしました。修正を当てたあとは60層すべてを使ったモデルが筋の通った回答を返し、速度はプロンプト処理が毎秒3.59トークン、生成が毎秒5.12トークンだったと書いています。これは1人の報告で、Unslothの配布ファイルとは別の自作の量子化版です。毎秒5.12トークンだと、1,000トークンの回答を出すのに約3分15秒(1,000 ÷ 5.12 ≒ 195秒)かかる計算になります。なお、Ollamaのminimax-m3.1-flash:cloudはクラウドで実行されるモデルで、手元のメモリには載りません。
無料で使える?商用はMiniMax Community Licenseの表示と通知
重みは無料でダウンロードでき、非商用なら追加の手続きなしで使えます。ただしライセンスはMiniMax独自のMiniMax Community Licenseで、OSIが定義するオープンソースではないため、正確には条件付きの「オープンウェイト(重み公開)」のモデルです。商用で使う場合は、製品のWebサイトやUI、ブログ、ドキュメントなどに「Built with MiniMax M3.1-Flash」と目立つように表示します。そのうえで、年間売上が2,000万ドル以下ならapi@minimax.ioへ件名「M3.1-Flash licensing — notice」で一度だけ通知を送り、2,000万ドルを超える場合は件名「M3.1-Flash licensing - authorization request」で事前に書面の許可を得る必要があります。
ライセンスの「商用利用」は、主に商業的な利益や対価を目的とする利用と定義され、有料の製品やサービスへの組み込み、APIの商用利用、追加学習やファインチューニングをした派生モデルの商用提供が含まれます。量子化版や派生モデルを使っても、元の重みのライセンスはそのまま及びます。軍事目的での利用や未成年者を害する利用など、禁止事項の一覧も付いています。
APIに切り替える目安:入力$0.15、出力$0.60
手元のメモリが256GBに届かない場合や、100万トークンのコンテキストや画像・動画の入力を公式の重みのまま使いたい場合、あるいは業務に合うかをまず試したい段階なら、MiniMaxのAPIから始めるほうが、機材を用意せずに済みます。2026年10月25日時点のMiniMax APIの料金ページでは、MiniMax-M3.1-Flashは100万トークンあたり入力$0.15、出力$0.60、キャッシュ読み取り$0.015で、コンテキスト長による段階料金はありません。たとえば入力200万トークン、出力50万トークンの作業なら、2 × 0.15 + 0.5 × 0.60 = 0.60ドルです。
ローカル実行が向くのは、256GB以上のメモリをすでに持っていて、データを外に出せない、あるいは大量の処理を定額の設備で回したいときです。新たにGPUサーバーを用意してまで動かすかどうかは、APIの請求額とハードウェアの費用を比べて決めることになり、その考え方はローカル LLM coding agent: Claude/Codex より向く場面で整理しています。同じく重みが公開されたFlashモデルで、チェックポイントが載るかを同じ観点で見たものにGLM-5.3-Flash導入ガイド:Ox Alphaの正体、API料金、ローカル実行があります。
MiniMax M3.1 Flashのダウンロードに関するよくある質問
MiniMax M3.1 FlashはTransformersで動かせますか?
2026年10月25日時点では、公式のモデルカードでTransformers、KTransformers、Unsloth、ATOMとの統合は「進行中」とされています。推奨されている推論エンジンはSGLang、vLLM、TokenSpeedの3つで、Transformersでそのまま読み込む手順はまだ示されていません。
unsloth/MiniMax-M3.1-Flashと公式リポジトリは何が違いますか?
2026年10月25日時点で、unsloth/MiniMax-M3.1-Flashのsafetensorsは公式と同じ250.1GB、dspark/も同じ2.3GBで、同じチェックポイントの複製とみられます。量子化したGGUF版は別のリポジトリunsloth/MiniMax-M3.1-Flash-GGUFにあります。
272Bに削った版なら、小さいマシンで動きますか?
コミュニティ製のprimitive-ai/MiniMax-M3.1-Flash-pruned-272B-NVFP4は、2026年10月25日時点で162.9GB(151.7GiB)あり、容量だけなら256GB級に余裕をもって入ります。ただし専門家の一部を取り除いた別のモデルなので、MiniMaxの評価結果は当てはまりません。形式も公式と同じNVFP4のsafetensorsで、Macでそのまま動くものではありません。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月25日。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月25日。
- 1.vLLMのMiniMax-M3.1-Flashレシピrecipes.vllm.ai/MiniMaxAI/MiniMax-M3.1-Flash
- 2.SGLangのMiniMax-M3.1クックブックdocs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3.1
- 3.llama.cppのissue #31063github.com/ggml-org/llama.cpp/issues/31063
- 4.PR #31097github.com/ggml-org/llama.cpp/pull/31097
- 5.MiniMax Community Licensehuggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/blob/main/LICENSE
- 6.MiniMax APIの料金ページplatform.minimax.io/docs/guides/pricing