GLM-5.3-Flash導入ガイド:Ox Alphaの正体、API料金、ローカル実行
GLM-5.3-Flashを使うなら、まず公式APIで実際の仕事を試します。ローカル実行には、約305.8 GiBのFP8版の重みに加え、キャッシュや作業領域が必要です。動作時の有効パラメータ数18Bだけで、必要VRAMは判断できません。
目次
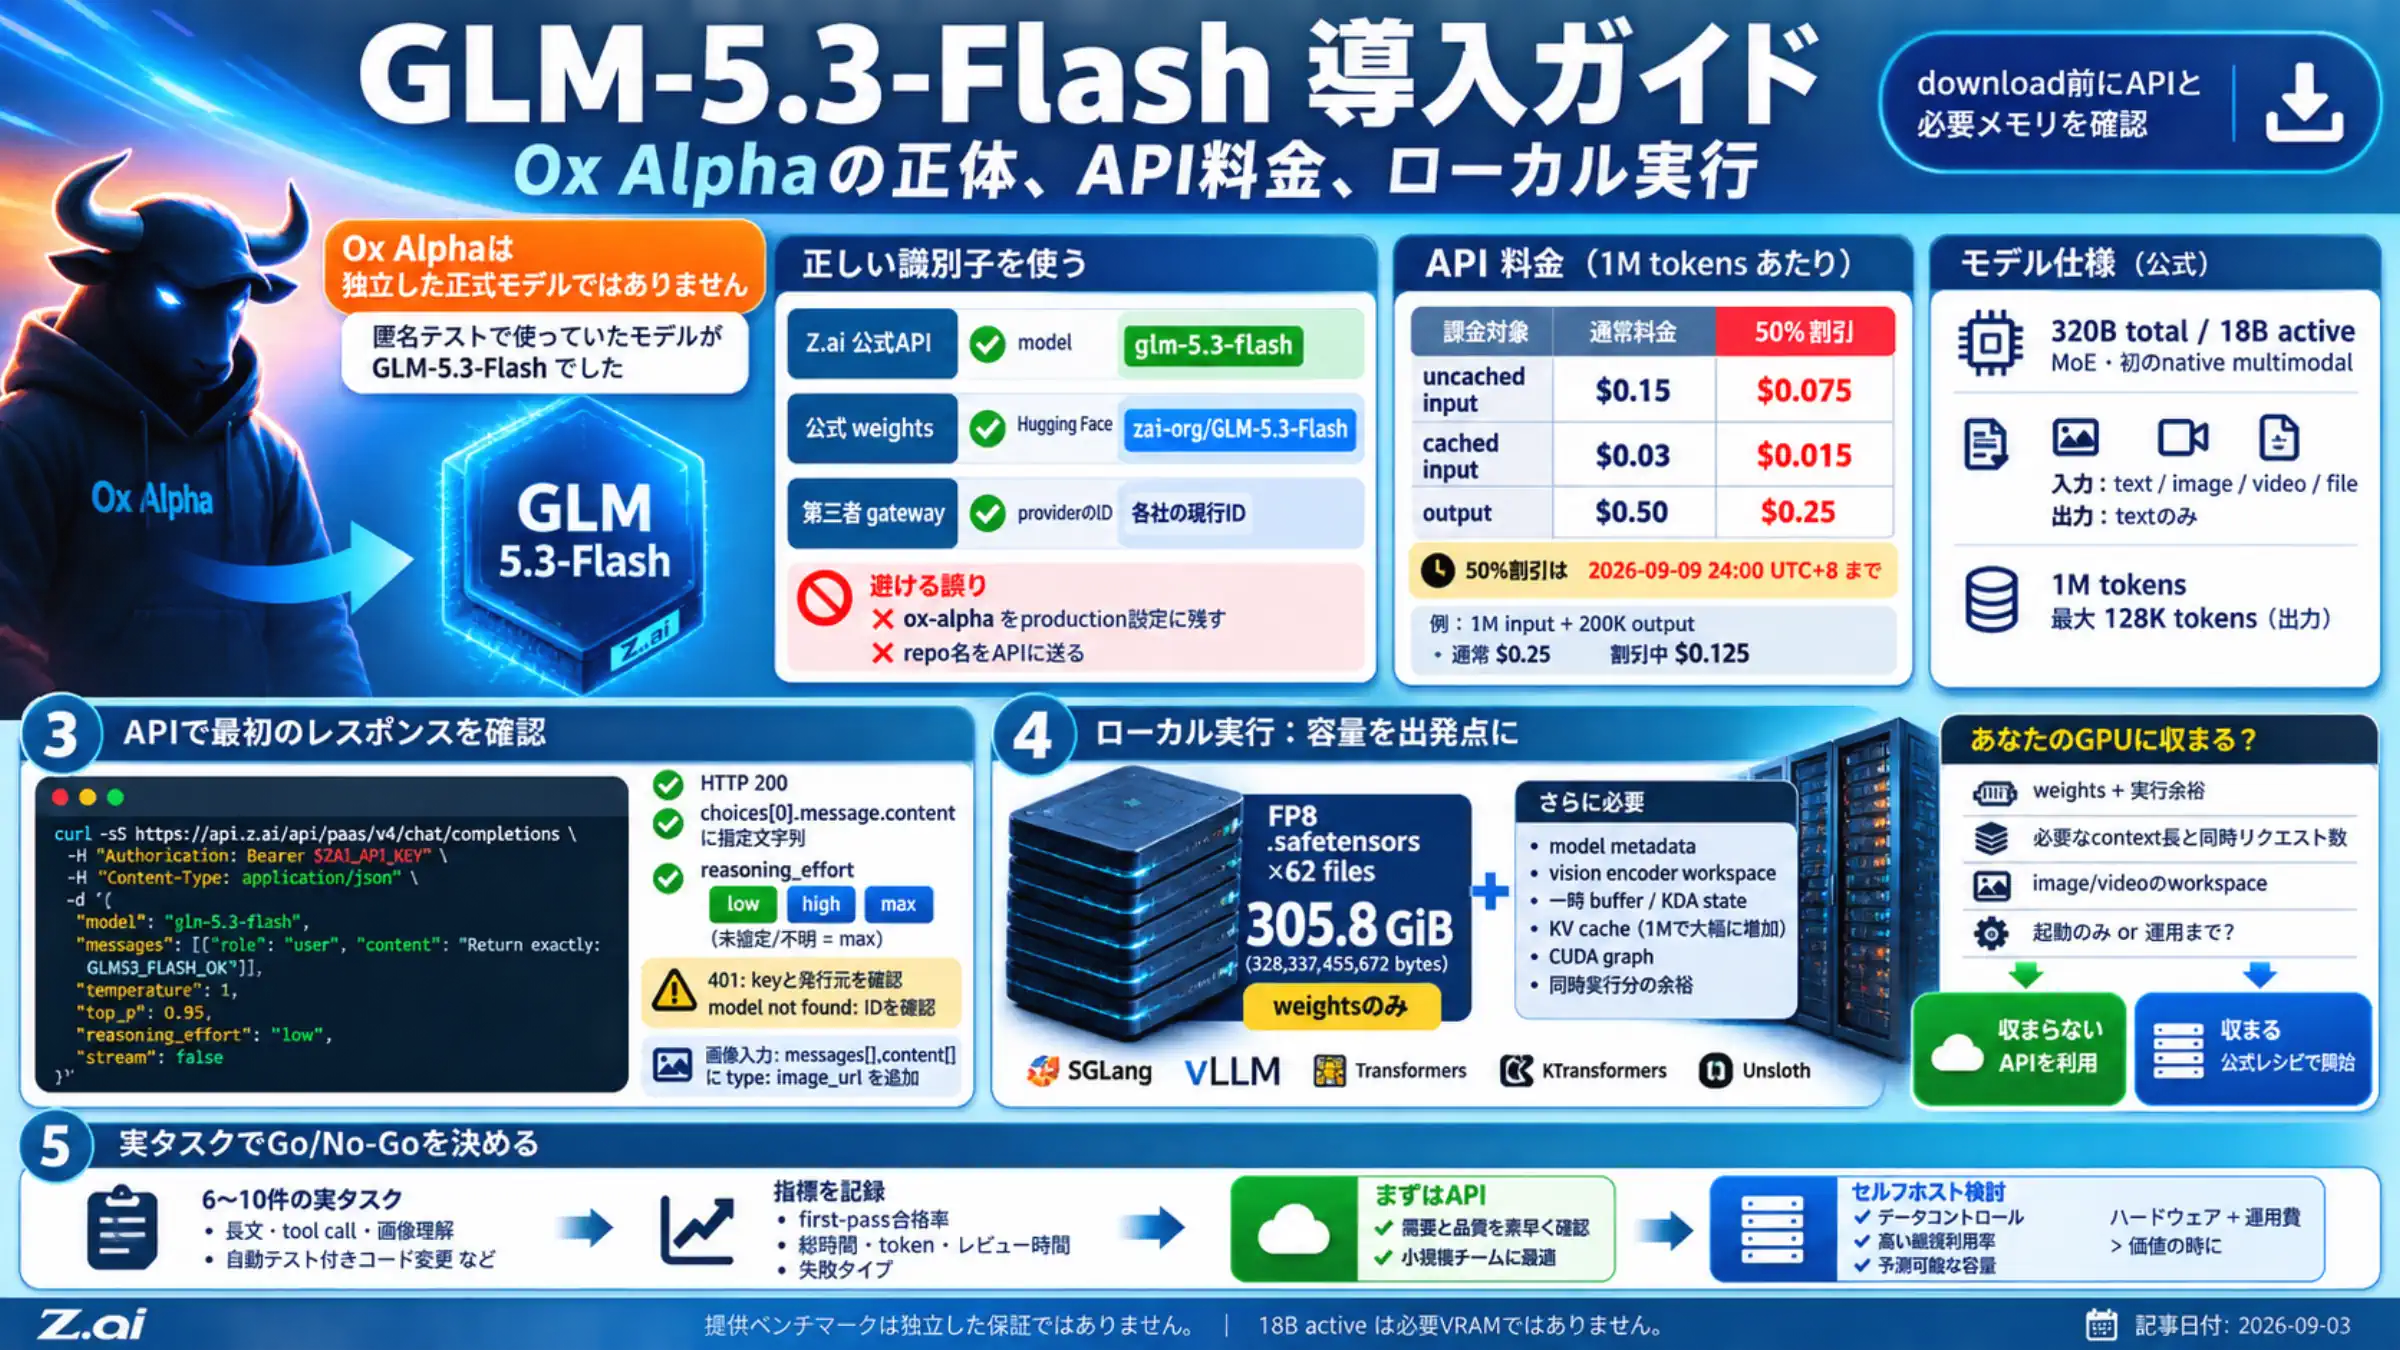
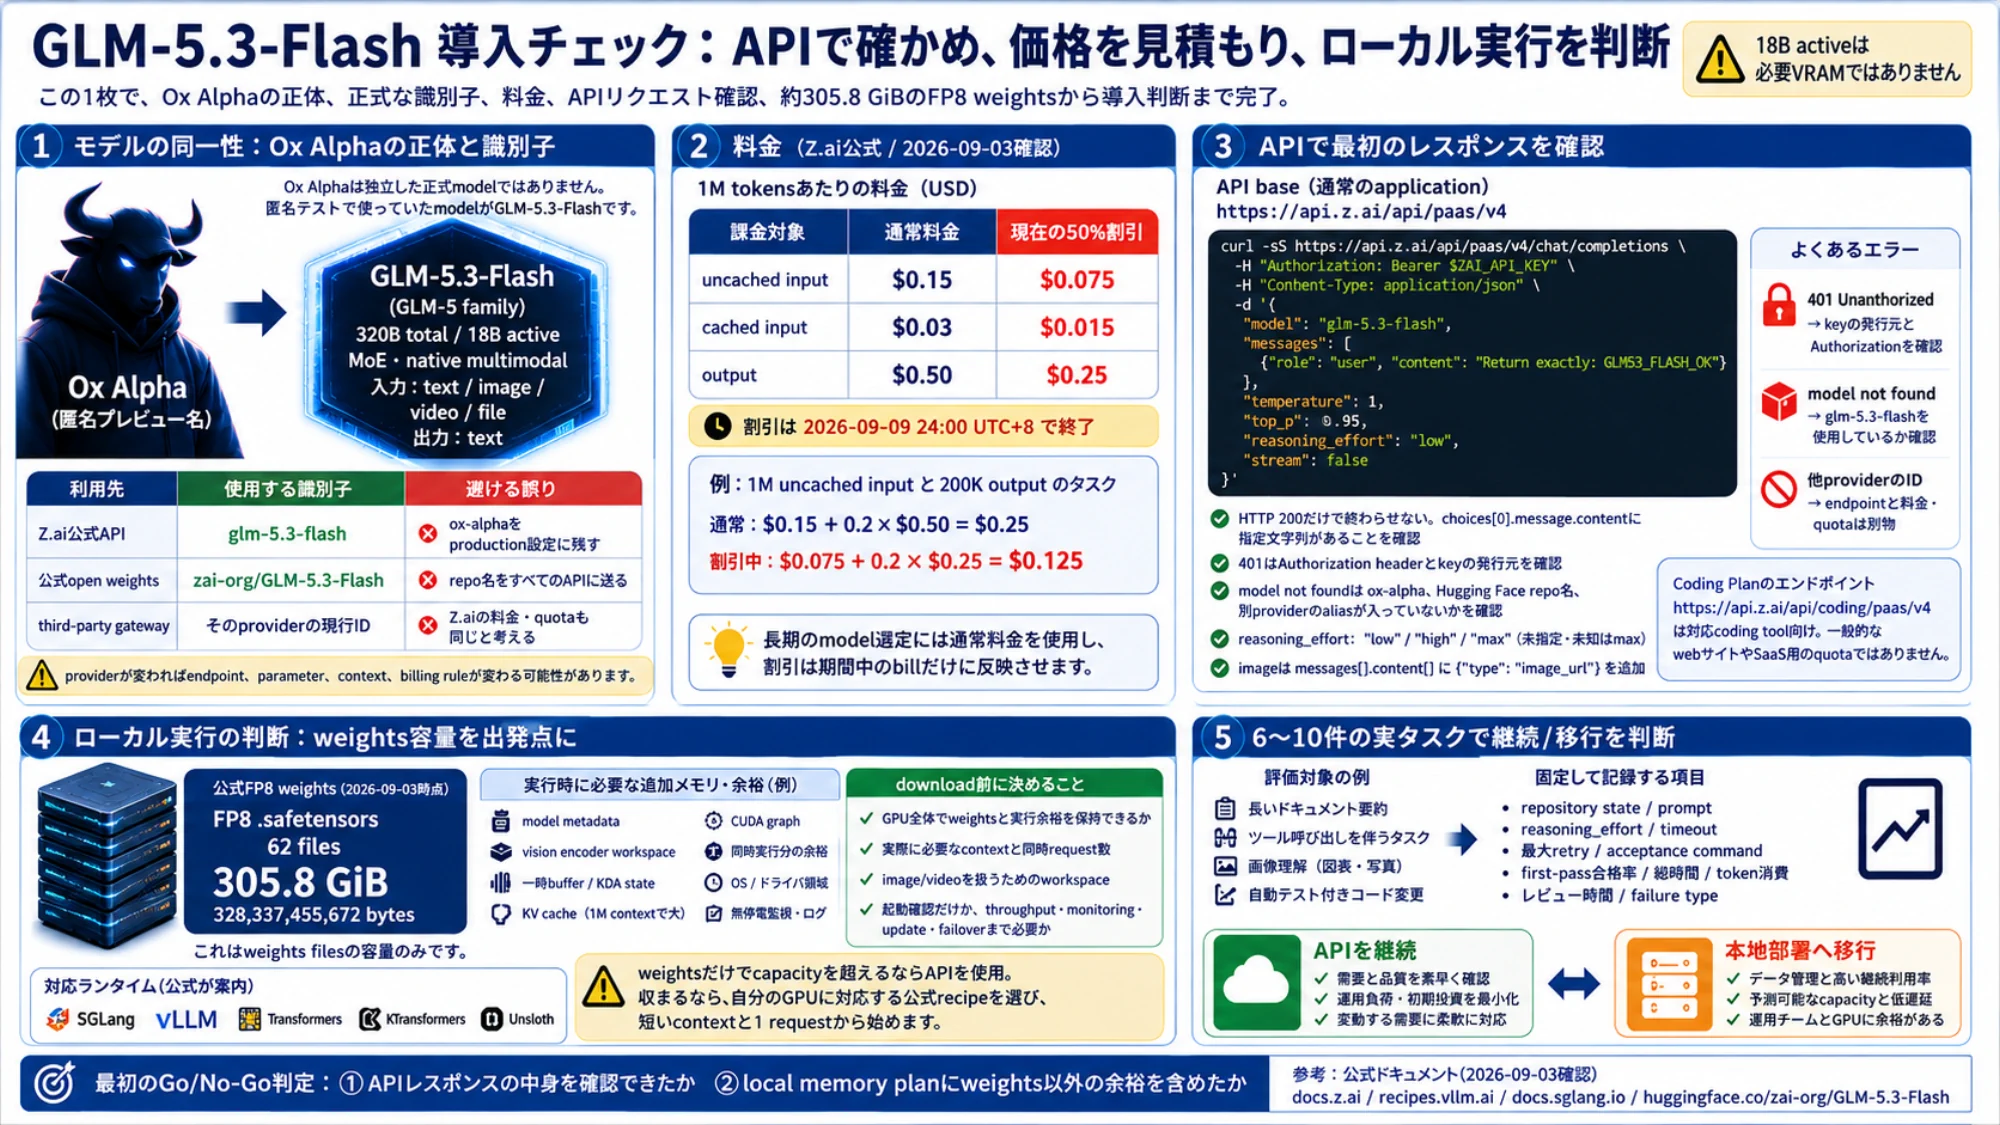
Ox Alphaは、GLM-5.3-Flashの匿名テスト時に使われた名前です。Z.aiは、OpenCodeとOpenRouterでOx Alphaとして試されていたモデルがGLM-5.3-Flashだったと説明しています。正式公開後は、Z.ai APIでglm-5.3-flash、公式配布の重みでzai-org/GLM-5.3-Flashを指定します。
個人や小規模チームなら、最初は提供元が運用するAPIで用途に合うかを確かめる方が現実的です。公式FP8版は、重みのファイルだけで約305.8 GiBあります。「有効パラメータ数18B」は、1トークンの処理で使う部分の規模を示します。モデル全体が18Bのものと同じメモリで動くという意味ではありません。
Ox Alphaとの関係と正式なモデル仕様
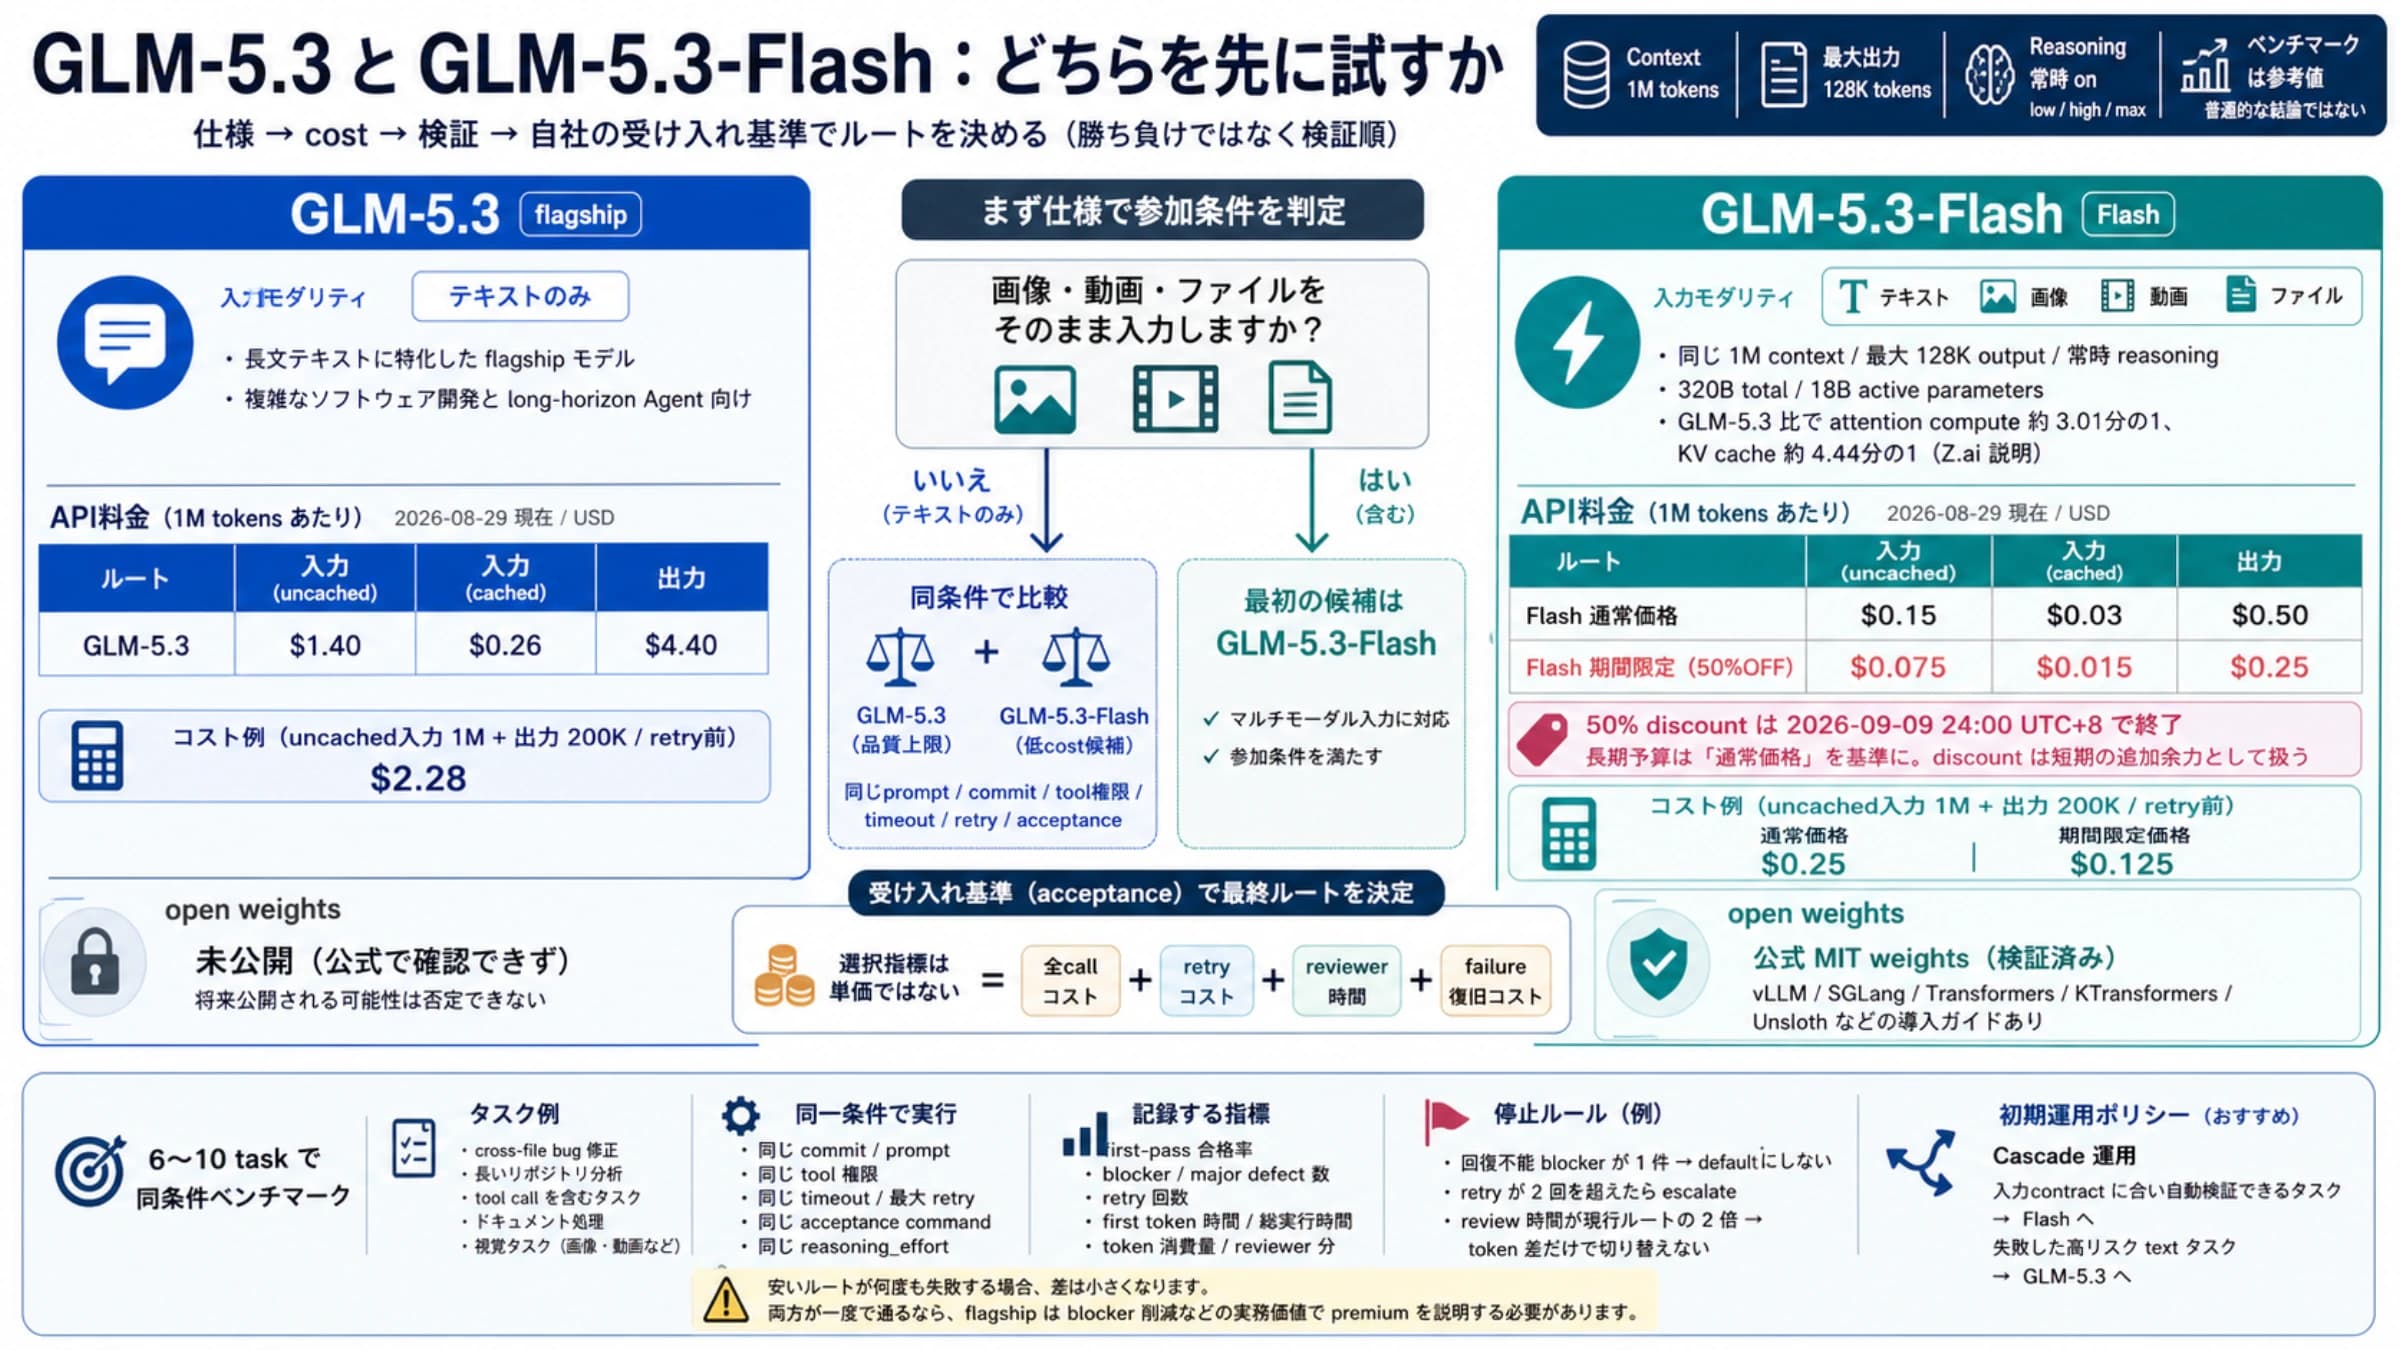
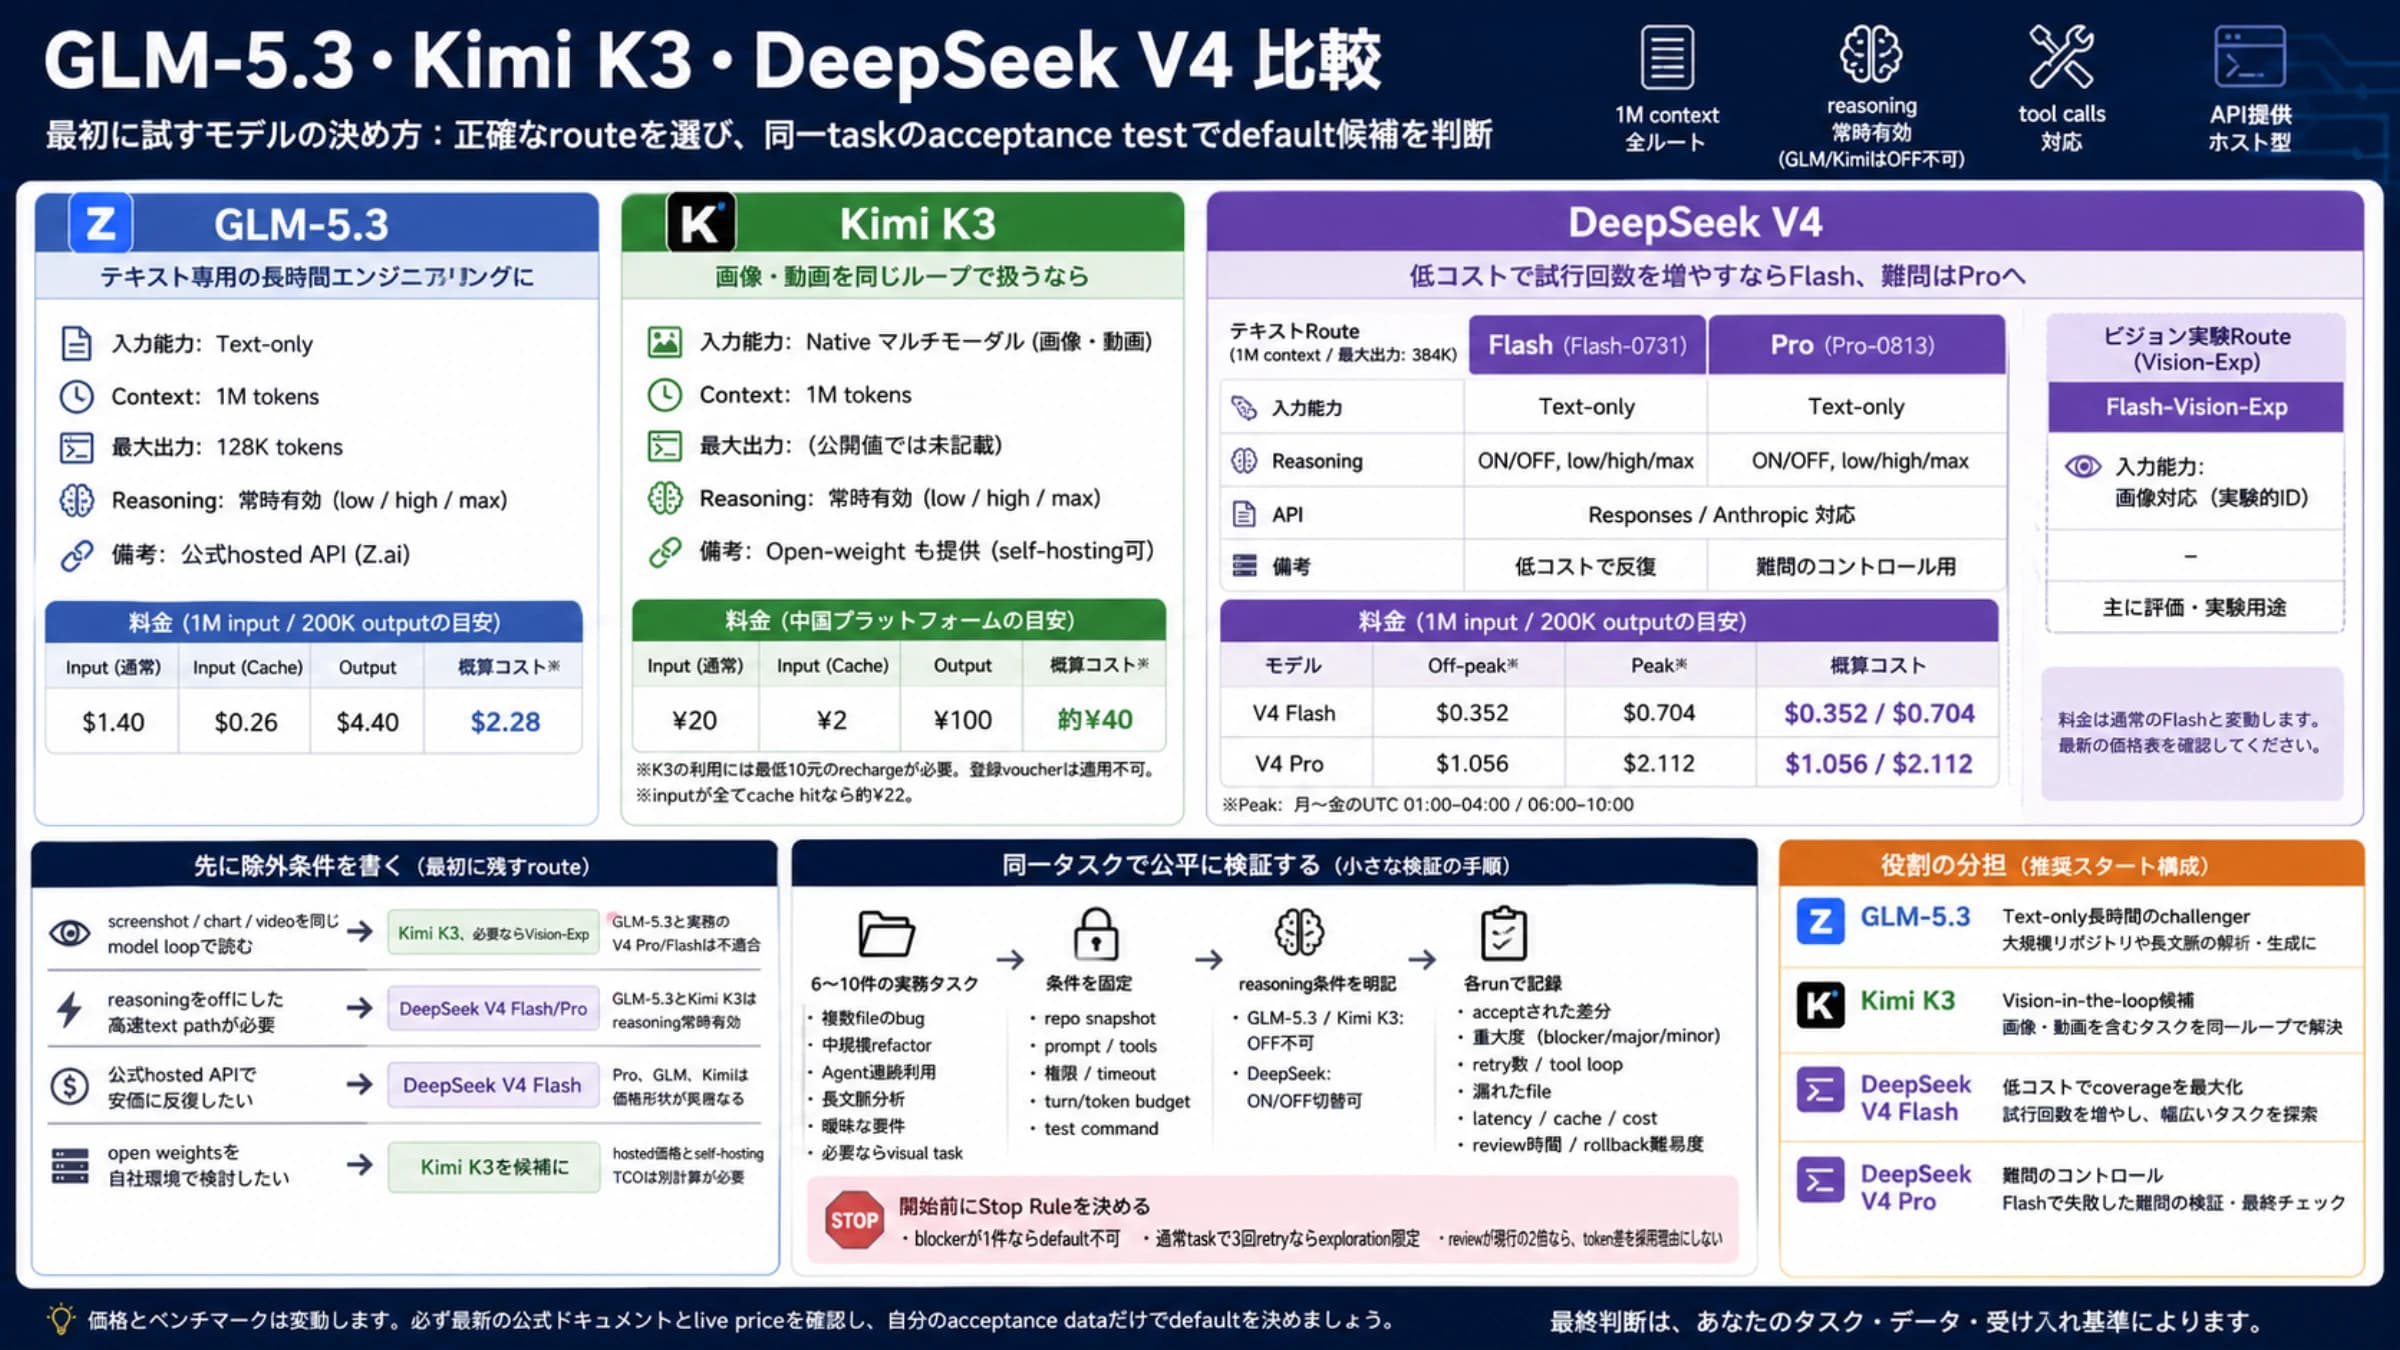
GLM-5.3-Flash公式ガイドによると、GLM-5.3-Flashは総パラメータ数320B、有効パラメータ数18BのMoEモデルで、GLM-5系列で初めて複数の入力形式を標準で扱います。テキスト、画像、動画、ファイルを入力でき、出力はテキストです。コンテキスト長は100万トークン、最大出力は128Kトークンと記載されています。
Z.aiはスパースアテンションと線形アテンションを組み合わせ、GLM-5.3よりアテンションの計算量とKVキャッシュを削減したと報告しています。計算量の削減は運用費用を抑える背景になりますが、自社のコードでの正確さや応答時間を保証するものではありません。
識別子は利用先ごとに分けます。
| 利用先 | 使用する識別子 | 避ける誤り |
|---|---|---|
| Z.ai公式API | glm-5.3-flash | ox-alphaを本番設定に残す |
| 公式の公開ウェイト | zai-org/GLM-5.3-Flash | リポジトリ名をすべてのAPIに送る |
| 第三者のAPIゲートウェイ | その提供元の現行ID | Z.aiの料金・利用枠も同じと考える |
同じ基盤モデルでも、提供元が変わればエンドポイント、パラメーター、コンテキスト、課金条件が変わる可能性があります。
長期予算では通常料金を使う
2026年9月3日に確認したZ.ai公式料金表は、100万トークンあたり次の金額です。
| 課金対象 | 通常料金 | 公表された50%割引 |
|---|---|---|
| 通常入力 | $0.15 | $0.075 |
| キャッシュ済み入力 | $0.03 | $0.015 |
| 出力 | $0.50 | $0.25 |
割引は2026年9月9日24:00(UTC+8)までと案内されていました。以下の割引額は当時の条件を示すもので、延長の有無は未確認です。長期予算では通常料金を使ってください。
キャッシュされない入力100万トークンと出力20万トークンを使う場合、再試行やツール料金を含まない通常料金は$0.25です。
$0.15 + 0.2 × $0.50 = $0.25
当時の割引料金では$0.125でした。本番で比較するときは、再試行を含むAPI費用に、確認・修正・復旧に使った時間を金額換算して加え、完了したタスク数で割ります。呼び出し単価が安くても、やり直しが増えれば利点は小さくなります。
公式APIで最初の応答を確認する
通常のアプリケーションはAPI入門ガイドにあるhttps://api.z.ai/api/paas/v4を使います。Coding Planのhttps://api.z.ai/api/coding/paas/v4は対応開発ツール向けで、一般的なWebサイト、Bot、SaaS用の利用枠ではありません。
キー、エンドポイント、モデルIDをまとめて確認する最小リクエストです。
curl -sS https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {"role": "user", "content": "Return exactly: GLM53_FLASH_OK"}
    ],
    "temperature": 1,
    "top_p": 0.95,
    "reasoning_effort": "low",
    "stream": false
  }'
HTTP 200だけで終わらせず、choices[0].message.contentに指定文字列があることを確認します。401ならAuthorizationヘッダーとキーの発行元、model not foundならox-alpha、Hugging Faceのリポジトリ名、別提供元の別名が入っていないかを見ます。
reasoning_effortはlow、high、maxを受け付けます。公式ドキュメントでは省略または未知の値はmaxになります。費用と待ち時間を比較する時は同じ値に固定します。
画像はmessages[].content[]へtype: image_urlを追加し、image_url.urlにURLまたはBase64 Data URLを入れます。複数形式の入力に対応していても、画像や動画を生成するモデルではありません。
ローカル実行は重みの容量を出発点にする
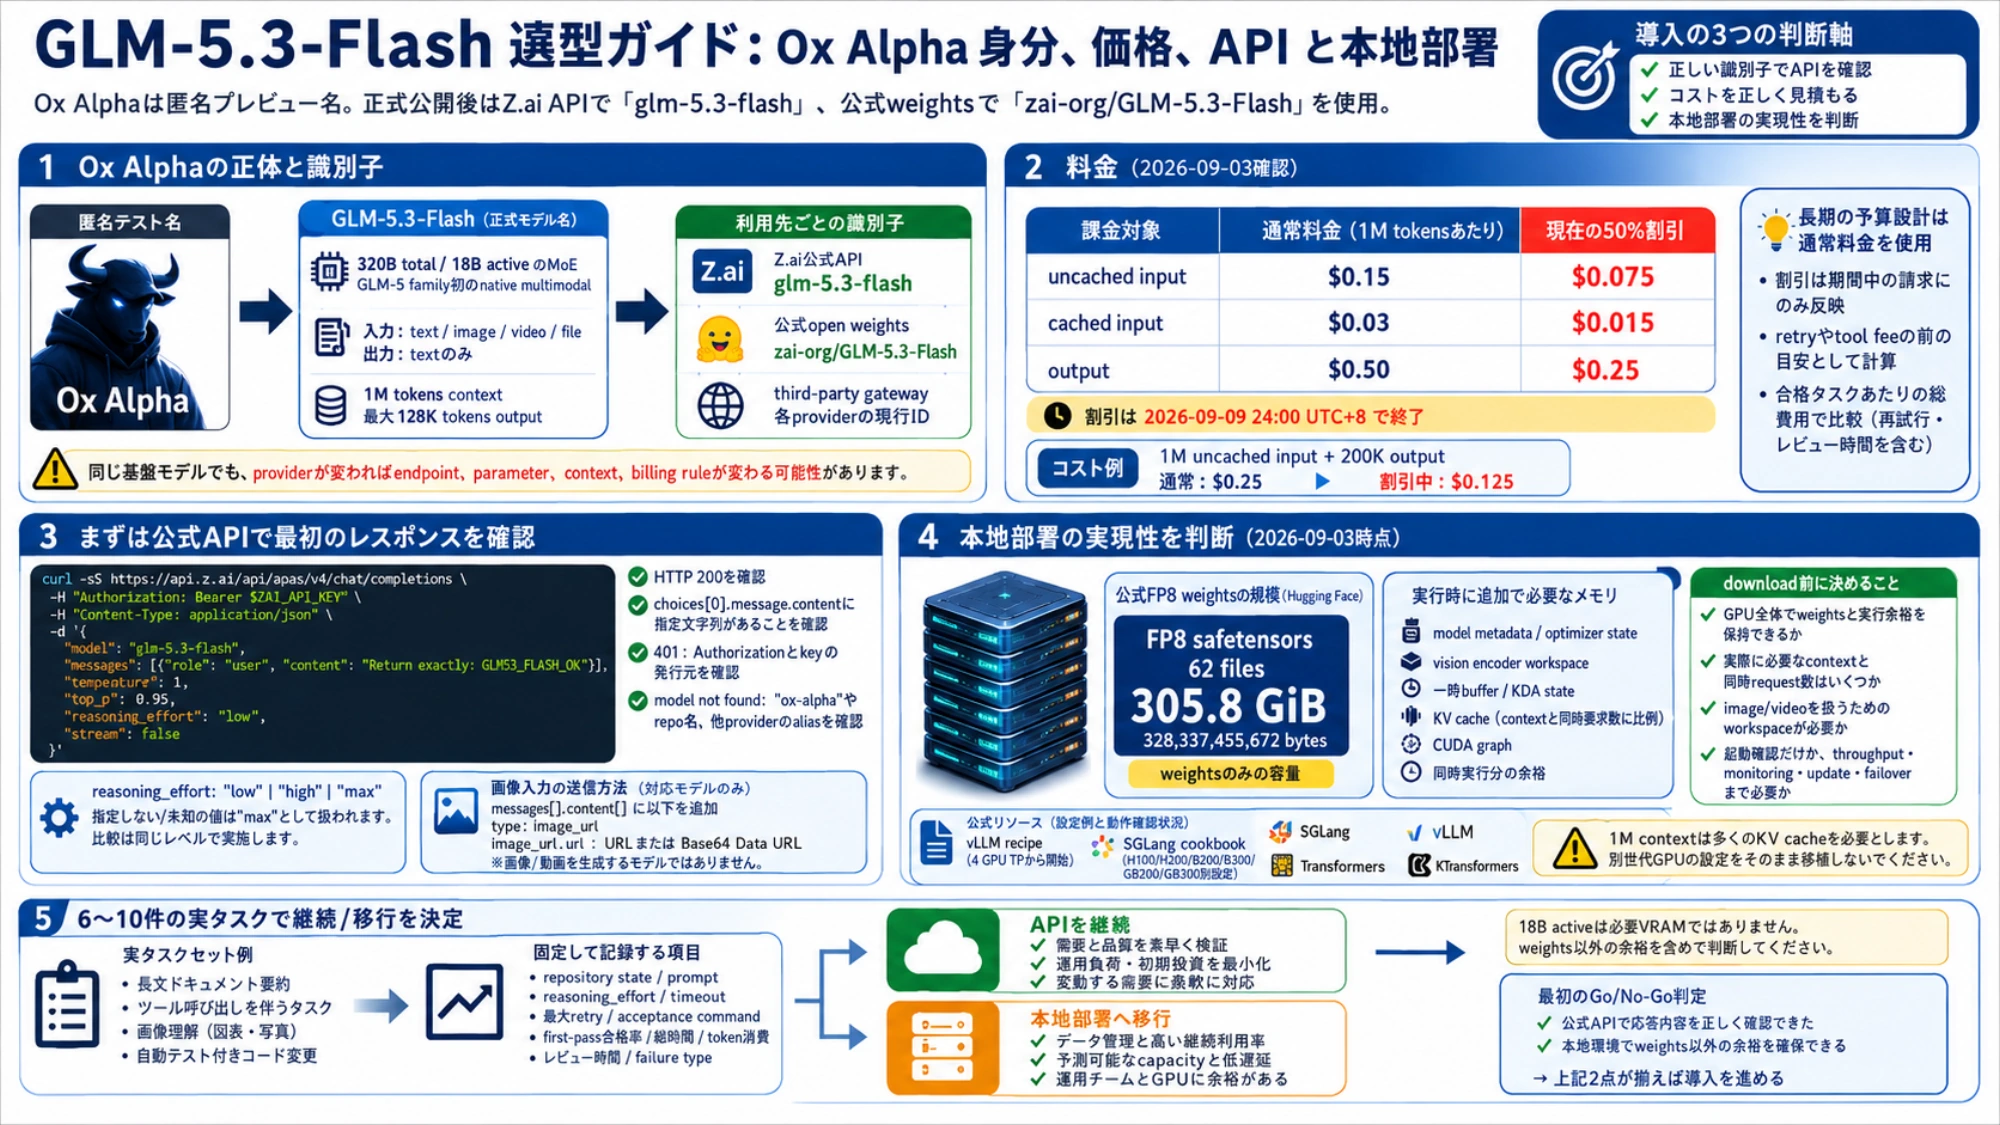
公式Hugging FaceモデルカードはMITライセンスを示し、SGLang、vLLM、Transformers、KTransformers、Unslothを案内しています。2026年9月3日の公式リポジトリのAPIでは、FP8の.safetensorsが62 ファイル、合計328,337,455,672 バイト、約305.8 GiBでした。
これは重みファイルの容量だけです。実行時にはモデルのメタデータ、画像エンコーダーの作業領域、一時バッファー、KDAの状態、KVキャッシュ、CUDAグラフ、同時実行数分の余裕も必要です。100万トークンのコンテキストでは、短い入力のテストよりも多くのキャッシュ領域が必要です。CPU/RAMやディスクへオフロードしてプロセスが起動しても、最初のトークンが返るまでの時間や処理速度が用途に合うとは限りません。
現在のvLLMの実行ガイドも、実行時の作業領域やKVキャッシュを除いても、FP8版の重みに約306 GiBが必要と説明しています。最初の例はGPU 4枚を使ったテンソル並列です。SGLangの実行ガイドはH100、H200、B200、B300、GB200、GB300別の設定と検証状態を示します。
ダウンロード前に次を決めます。
- GPU全体で重みと実行用の作業領域を確保できるか
- 必要なコンテキスト長と同時リクエスト数をどこまでにするか
- 画像や動画を扱うための作業領域が必要か
- 試験用の起動だけでよいか、本番用の処理速度、監視、更新、障害時の切り替えまで必要か
重みだけで容量を超えるならAPIを使います。収まるなら、自分のGPUに対応する公式実行ガイドを選び、短いコンテキスト長と同時実行1件から始めます。別世代GPU向けのFP8 KVキャッシュや投機的デコード設定をそのまま移植しないでください。
実際の仕事を使って継続利用を判断する
長文処理、ツール呼び出し、画像理解、自動テスト付きのコード修正など、実務に必要な課題を少数用意します。コードの開始状態、指示、reasoning_effort、タイムアウト、再試行上限、確認用コマンドをそろえ、初回で完了したか、総時間、消費トークン数、人の確認時間、失敗内容を記録します。
APIは、必要な品質を得られるかを手早く確かめる方法です。自前で運用するのは、データを管理できる利点や継続的な利用量が、機材費と運用負担に見合う場合に検討します。使っていない時間のGPU費用も含めて比較してください。
失敗の影響が大きいテキスト中心の開発業務でGLM-5.3も比較したい場合は、別のGLM-5.3とGLM-5.3-Flashの検証ガイドを使えます。Flashだけを導入する場合も、まずAPIの応答内容を確認します。ローカルで動かすなら、重み以外の作業領域までメモリに収まることが、導入判断の前提です。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年9月3日。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年9月3日。
- 1.GLM-5.3-Flash公式ガイドdocs.z.ai/guides/vlm/glm-5.3-flash
- 2.Z.ai公式料金表docs.z.ai/guides/overview/pricing
- 3.API入門ガイドdocs.z.ai/api-reference/introduction
- 4.公式Hugging Faceモデルカードhuggingface.co/zai-org/GLM-5.3-Flash
- 5.vLLMの実行ガイドrecipes.vllm.ai/zai-org/GLM-5.3-Flash
- 6.SGLangの実行ガイドdocs.sglang.io/cookbook/autoregressive/GLM/GLM-5.3-Flash