16GB VRAMで使うローカルCoding LLMの選び方:Qwen3.8は3bitなら載る
16GB VRAMのローカルCoding LLMはgpt-oss-20bが基準。Gemma 4 12Bは余裕で収まり、Qwen3.8-27BはQ4_K_M不可で3bitが中心です。
目次
2026年10月22日時点で、16GB VRAMのGPU(RTX 4060 Ti 16GB、RTX 5060 Ti 16GB、RTX 5070 Ti、RTX 4080/5080など)でローカルCoding LLMを使うなら、基準はgpt-oss-20bのままです。モデルカードに「16GBのメモリ内で動く」と明記されている唯一の候補で、MXFP4のGGUFファイルは12.11GBです。
7月から変わったのは残りの2ルートです。上級ルートで最初に試すQwenは、Qwen3.6 35B A3Bから2026年8月5日公開のQwen3.8-27Bに替わりました。ただし標準的なQ4_K_M(UnslothのUD-Q4_K_Mで16.46GB、Ollamaのqwen3.8:27bは18GB表示)は16GBに載りません。計算上の目安は、UD-Q3_K_XL(13.15GB)などの3bit GGUFなら64Kまで、UD-IQ4_XS(14.25GB)なら32Kまでです。軽量ルートはGemma 4 E4BからGemma 4 12B(Google公式のQAT Q4_0で6.98GB)に替わり、E4Bは8GBカードやノートPC向けに下がりました。
もう一つの落とし穴はOllamaの既定値です。VRAMが24GiB未満だとコンテキスト長は4kで始まり、Ollama自身がコーディングツールに勧める64000トークンに届きません。どのモデルでも、先にコンテキスト長を設定し、そのうえで自分のリポジトリでsmoke testを行います。
結論:モデル名より先にルートを決める
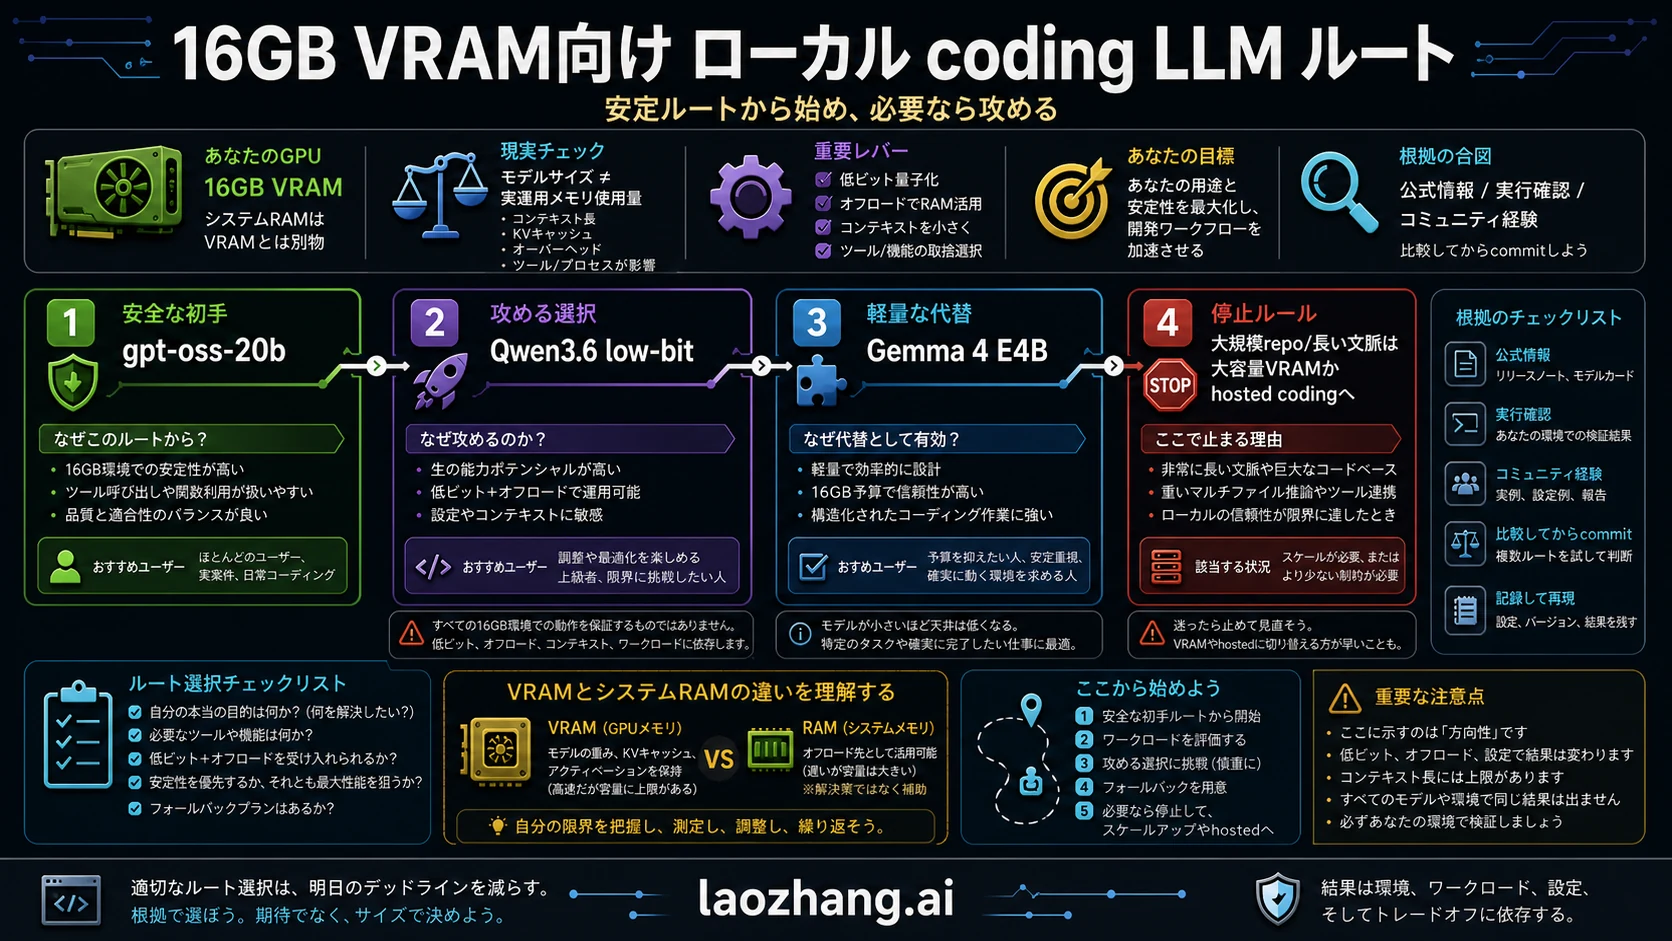
図は2026年7月時点のルート表記です。現在の候補は下の表と本文を参照してください。
16GBで決めるべきなのは「一番強いモデル名」ではなく、モデル・量子化ファイル・コンテキスト長の組み合わせです。同じQwen3.8-27Bでも、Q4_K_Mなら重みだけでVRAMがほぼ埋まり、UD-Q3_K_XLなら64Kのコンテキストまで計算上は収まります。
| ルート | 2026年10月の第一候補 | 重みファイル(量子化) | 計算上の合計(コンテキスト長) | 7月時点からの変化 |
|---|---|---|---|---|
| 基準 | gpt-oss-20b | MXFP4 GGUF 12.11GB | 約12.8GiB(64K) | 変更なし |
| 上級 | Qwen3.8-27B | UD-Q3_K_XL 13.15GB | 約13.3GiB(32K)、約14.4GiB(64K)、KVはq8_0 | Qwen3.6 35B A3Bから交代 |
| 長いコンテキスト・軽量 | Gemma 4 12B | QAT Q4_0 6.98GB | 約7.8GiB(64K)、約8.8GiB(128K) | Gemma 4 E4Bから交代 |
| コード特化 | Devstral Small 2 24B | IQ4_XS 12.78GB | 約14.4GiB(16K) | Qwen2.5-Coder、DeepSeek Coder、Qwen3-Coder-30B-A3Bから交代 |
| 停止 | 24GB以上のGPU、ホスト型のコーディングエージェント | — | — | 変更なし |
合計は「重みファイル+KVキャッシュ」の計算値で、ランタイムの作業領域や画面表示に使うVRAMは含みません。GBは10の9乗バイト、GiBは2の30乗バイトです。16GBカードの容量は16GiBなので、ここに挙げた値との差がランタイムと表示用の余白になります。
選び方は目的で分かれます。まず確実に動かしたいならgpt-oss-20b、ファイル全体や長いログを読ませたいならコンテキストを128Kまで伸ばせるGemma 4 12B、ベンダー公表のコーディング指標が最も高いモデルを3bitで試したいならQwen3.8-27Bです。Devstral Small 2はエージェント型のコーディング向けに作られていますが、KVキャッシュが重いため16GBでは16〜32Kの短いコンテキストに限られます。
根拠の分け方:公式、実行環境、コミュニティ
16GBに関する主張は、出どころによって強さが違います。モデルの位置づけはベンダーのモデルカード、メモリ量はファイルサイズと構成ファイルからの計算、使い心地はコミュニティの実機報告、と分けて読みます。
ベンダー自身が16GBを明記しているのはOpenAIのgpt-oss-20bモデルカードだけです。GoogleはGemma 4 12Bのモデルカードで12B・26B A4B・31Bを一般向けGPUやワークステーション向け、E2B・E4Bをモバイルやエッジ向けと位置づけています。MistralはDevstral Small 2のモデルカードで「RTX 4090 1枚か32GBのMac」で動くと書いており、16GBとは書いていません。
ベンダーのベンチマークは、ローカルで使う設定とは条件が違います。Qwen3.8-27Bのモデルカードのコーディング指標は、フル精度のモデルを256Kのコンテキストで測った値です。16GBカードで使う3bitファイルと32〜64Kのコンテキストに、そのまま当てはめることはできません。
量子化ファイルにも二種類あります。gpt-oss-20bのMXFP4とGemma 4のQAT Q4_0は開発元が用意した形式で、Qwen3.8-27BやDevstral Small 2の3bit・4bit GGUFはUnslothによるコミュニティ量子化です。後者は配布元と品質の検証主体がベンダーとは別です。
ブログやSNSの実機報告は候補探しには役立ちますが、GPU、ドライバー、ランタイムのバージョン、ファイル名、量子化、コンテキスト長が書かれていなければ、自分の環境で同じ結果になる保証にはなりません。
メモリの数値はすべて、2026年10月22日時点のHugging Faceのファイルサイズとconfig.jsonから計算した値です。手元の16GiBのM4 Macで確認したのは、llama.cppのオプション(後述のコマンドで使うもの)が存在することと、llama.cppが認識するMetalの予算が12,124MiBであることの2点だけです。モデルのダウンロードや推論は行っていないため、速度や品質の実測値は含みません。
16GB VRAMで本当に使える余白
必要なVRAMはおおむね「重みファイル+KVキャッシュ+ランタイムの作業領域」です。重みはファイルサイズでほぼ決まり、KVキャッシュは「1トークンあたりの量×コンテキスト長」で増えます。コード支援では関数、テスト、エラーログ、過去の提案をまとめて渡すため、普通のチャットよりコンテキストが長くなり、KVキャッシュの差が効いてきます。
各モデルのconfig.jsonから、全体注意の層だけを数えたKVキャッシュ(F16)は次のとおりです。
| モデル | 1トークンあたり(F16) | 32K | 64K | 128K |
|---|---|---|---|---|
| gpt-oss-20b(全体注意12層) | 24KiB | 0.75GiB | 1.5GiB | 3GiB |
| Gemma 4 12B(全体注意8層) | 16KiB+スライディング最大約320MiB | 0.5GiB | 1GiB | 2GiB |
| Qwen3.6 35B A3B(全体注意10層) | 20KiB | 0.63GiB | 1.25GiB | 2.5GiB |
| Qwen3.8-27B(全体注意16層) | 64KiB | 2GiB | 4GiB | 8GiB |
| Devstral Small 2(全40層) | 160KiB | 5GiB | 10GiB | 20GiB |
計算式は「層数×KVヘッド数×ヘッド次元×2(KとV)×2バイト」です。たとえばQwen3.8-27Bは16×4×256×2×2バイト=64KiBになります。KVをq8_0に量子化するとおよそ0.53倍になり、Qwen3.8-27Bの64Kは約2.13GiBまで下がります。Qwen3.8-27Bの線形注意層が持つ固定の状態や、画像入力用のプロジェクター(mmproj)はこの表に含みません。
この表から分かるのは、Devstral Small 2が重みの割に長いコンテキストに弱く、Gemma 4 12Bが逆に強いことです。gpt-oss-20bは24層の半分がスライディングウィンドウ注意、Qwen3.6 35B A3Bは全体注意が40層中10層だけなので、KVキャッシュが軽く済みます。
VRAMから溢れた分はメインメモリへオフロードされ、OOMは避けられても待ち時間が増えます。開発中の待ち時間は品質の問題です。パッチのたびに長く待つくらいなら、収まるモデルで速く回したほうが作業は進みます。
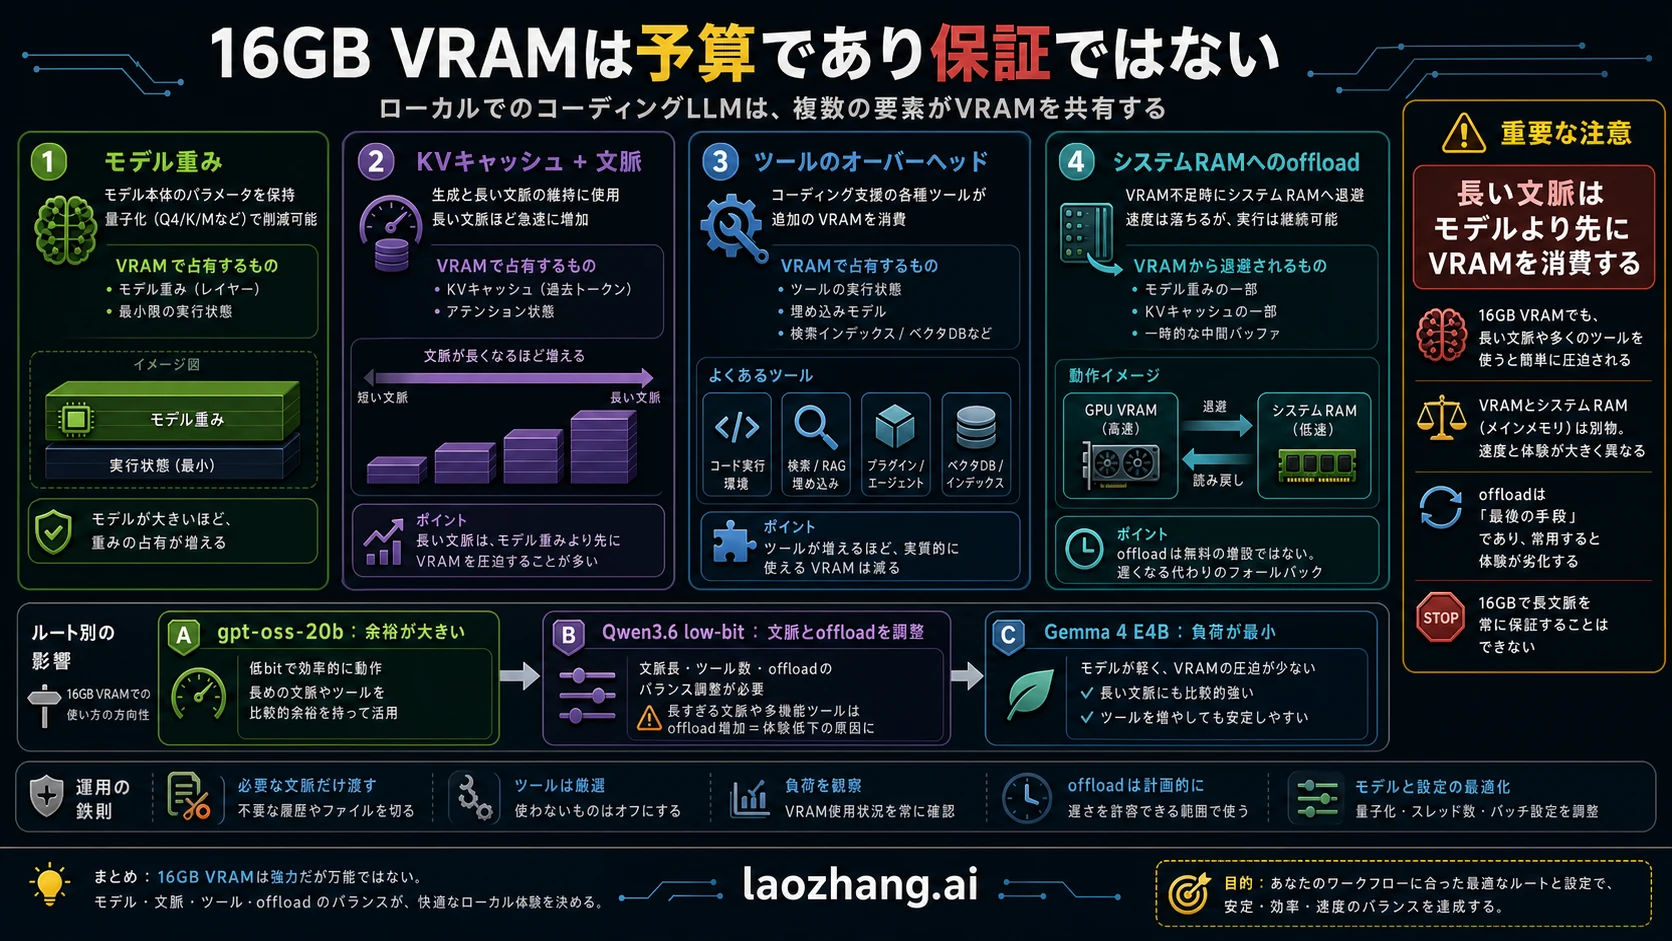
図は2026年7月時点のルート表記です。現在の候補とメモリの数値は本文の表を参照してください。
ルート1:gpt-oss-20bを基準にする
gpt-oss-20bは、パラメータ21B、アクティブ3.6BのMoEで、MoE部分の重みはMXFP4で事後学習されています。ライセンスはApache-2.0です。2025年8月以降、OpenAIから20B級の後継モデルは出ていません(gpt-oss-safeguard-20bは安全性分類用で、コーディング向けではありません)。
メモリの計算は単純です。ggml-orgのMXFP4 GGUFは12.11GB(11.28GiB)で、KVキャッシュは64Kで1.5GiBなので、合計は約12.8GiBです。128Kまで伸ばすと約14.3GiBになり、ランタイムの作業領域を考えると余白はわずかです。日常の基準としては64Kが無理のない設定です。
Ollamaで使う場合は、サーバー起動時にコンテキスト長を指定してからモデルを動かします。
OLLAMA_CONTEXT_LENGTH=64000 ollama serve別のターミナルで次を実行します。
ollama run gpt-oss:20b
ollama ps
ollama psのPROCESSOR欄で、モデルがGPUとCPUにどう割り当てられているかを確認します。CPU側の割合が出ていれば、VRAMから溢れてオフロードが起きています。Ollamaのgpt-oss:20bパッケージは14GB表示で、コンテキストの上限は128Kです。
最初から全リポジトリを入れず、一つのファイル、近いテスト一つ、明確な修正要求一つに絞ります。ここで遅い、OOMになる、コンテキストを忘れるといった問題が出たら、大きいモデルへ進む前にコンテキスト長、ランタイム設定、エディタ連携の順に境界を確かめます。基準が通ったら、テスト、隣接モジュール、エラーログの順に負荷を増やします。
ルート2:Qwen3.6 35B A3Bは上級者向けの実験
このルートで最初に試すQwenは、2026年8月からQwen3.8-27Bです。Qwen3.6 35B A3Bは、メインメモリに余裕がありオフロードによる速度低下を許容できる場合のMoEルートとして残ります。どちらも既定の設定では16GBに載らず、量子化ファイルとコンテキスト長を自分で選ぶことが前提です。
先に試すのはQwen3.8-27B:Q4_K_Mは不可、UD-Q3_K_XLなら64Kまで
Qwen3.8-27Bは64層のdenseモデルで、全体注意16層と線形注意48層の構成です。ネイティブのコンテキストは262Kで、ライセンスはApache-2.0です。Qwenのモデルカードでは、コーディングの全指標でQwen3.6-27Bを上回っています(Terminal Bench 2.1で73.0対63.4、SWE-bench Proで61.7対53.5、LiveCodeBench v6で90.3対83.9)。前述のとおり、これはフル精度・256Kでの値です。
16GBに収まるかどうかは、どのファイルを選ぶかで決まります。サイズはUnslothのQwen3.8-27B GGUFのものです。
| ファイル | サイズ | +32K(KVはq8_0) | +64K(KVはq8_0) | 16GBでの判断 |
|---|---|---|---|---|
| UD-Q4_K_M | 16.46GB(15.33GiB) | — | — | 重みだけでほぼ一杯、不可 |
| UD-IQ4_XS | 14.25GB(13.27GiB) | 約14.3GiB | 約15.4GiB | 32Kまで |
| UD-Q3_K_XL | 13.15GB(12.24GiB) | 約13.3GiB | 約14.4GiB | 64Kまで |
| UD-IQ3_XXS | 10.93GB(10.18GiB) | 約11.2GiB | 約12.3GiB | 余裕はあるがビット数が最も低い |
Ollamaの既定タグqwen3.8:27bはQ4_K_Mで18GB表示なので、16GBカードではそのまま使えません。Ollamaで3bit版を使うには、Hugging FaceのGGUFリポジトリを直接指定します。
ollama run hf.co/unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XLKVキャッシュをF16のまま使う場合、UD-Q3_K_XLの合計は32Kで約14.2GiB、64Kでは約16.2GiBになり、64Kは収まりません。Ollamaで使うならコンテキスト長は32K程度に抑えます。Ollamaが勧める64000トークンを確保したい場合は、llama.cppでKVキャッシュをq8_0に量子化します。
llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XL --no-mmproj -c 65536 -ngl 99 -fa on -ctk q8_0 -ctv q8_0--no-mmprojは画像入力用のプロジェクター(mmproj-F16で0.93GB)を読み込まない指定で、コード用途ならその分をコンテキストに回せます。上の計算には線形注意層の固定状態が含まれていないため、実際に起動したらnvidia-smiなどで使用量を確かめ、溢れるなら-cを下げます。llama.cppの各オプションはHomebrew版(build 11429)で存在を確認していますが、このモデルを読み込んだ結果ではありません。
32GBカードや2枚構成でQ4_K_M以上を使う場合の予算は、Qwen3.8-27Bの必要VRAM:RTX 5090・GPU 2枚・量子化と262Kの設定を参照してください。
Qwen3.6 35B A3Bが今も合う場面:エキスパートをメインメモリに置く
Qwen3.6 35B A3B(2026年4月15日公開)は、総パラメータ35B、アクティブ3Bで、256個のエキスパートから8個を使うMoEです。全体注意は40層中10層だけで、KVキャッシュは1トークン20KiBと軽めです。一方、Qwenのモデルカードは思考モードを保つために128K以上のコンテキストを勧めています。
全部をGPUに載せるなら、Unslothの3bit級UD-IQ3_XXS(13.21GB、12.30GiB)が目安です。KVを加えた合計は64Kで約13.6GiB、128Kで約14.8GiBになり、推奨の128Kは16GBぎりぎりです。Ollamaのqwen3.6:35bは23〜24GB表示で、そのままでは収まりません。
このモデルが今も意味を持つのは、メインメモリが多い環境です。llama.cppの--n-cpu-moeは、指定した数の層のMoEエキスパート重みをCPU側(メインメモリ)に置き、注意層などはGPUに残します。UD-Q4_K_M(22.13GB)のように16GBを超えるファイルでも、エキスパートをメインメモリに逃がせば16GBカードと組み合わせて使えます。メインメモリにはファイルの大半を置ける容量が必要です。
llama-server -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_M --no-mmproj -c 131072 -ngl 99 -fa on --n-cpu-moe 40--n-cpu-moe 40は全40層のエキスパートをメインメモリに置く設定です。ここから数字を下げ、VRAMが埋まる手前で止めると、GPUに残せるエキスパートが増えます。CPU側に置いた分だけ、全部をGPUに置くより遅くなる点は前提として受け入れてください。
同世代のQwen3.6-27B(dense)もありますが、Qwen自身の表でQwen3.8-27Bが全項目で上回っており、16GBで選ぶ理由は薄くなりました。Ollamaのqwen3.6:27b-codingは19GB表示で、16GBには載りません。
ルート3:Gemma 4 E4Bと小型コードモデルを残す
7月時点の軽量ルートだったGemma 4 E4Bは、16GBカードではGemma 4 12Bに替わりました。小型コードモデルの枠も、Qwen2.5-CoderやDeepSeek Coderといった世代から、Devstral Small 2中心に入れ替わっています。軽いモデルを残す理由そのもの、つまり速い応答と安定したコンテキスト保持は変わりません。
16GBカードではGemma 4 12Bが先頭
Gemma 4 12Bは2026年5月23日にHugging Faceで公開された、パラメータ11.95B、コンテキスト256Kのモデルです。3月の初回リリース時の4サイズにはなかったサイズで、ライセンスはApache-2.0です。Googleのベンチマーク表では、LiveCodeBench v6が72.0%(E4Bは52.0%)、Codeforces ELOが1659(E4Bは940)で、コーディングの指標はE4Bから大きく上がっています。ただしこの表にSWE-bench系の指標はなく、リポジトリをまたぐエージェント作業の強さはこれだけでは判断できません。
メモリには大きな余裕があります。Google公式のQAT Q4_0 GGUFは6.98GB(6.50GiB)で、KVキャッシュとスライディング部分を足した合計は64Kで約7.8GiB、128Kで約8.8GiB、256Kで約10.8GiBです。QAT(量子化を前提にした学習)による、開発元自身の量子化ファイルです。この計算はK・Vを別々に持つ前提の上限寄りの値ですが、ランタイムによってはスライディング部分を多めに確保することがあります。
ollama run gemma4:12bOllamaのgemma4:12bは7.7〜8.0GB表示です。16GBカードでは、長いファイルやログを丸ごと渡したい作業、gpt-oss-20bでコンテキストが足りない作業の受け皿になります。
上位のGemma 4 26B A4Bは、公式QAT Q4_0が14.44GB、画像用のmmprojが1.19GBで、16GBではコンテキストの余地がほとんど残りません。Gemma 4 31BはQ4_0で17.65GBあり、重みだけで16GiBを超えます。
Gemma 4 E4Bは8GBカードとノートPC向け
E4BはGoogleがモバイル・エッジ向けと位置づけるサイズで、コンテキストは128Kです。公式QAT Q4_0は5.15GBにmmprojが0.99GB、Ollamaのgemma4:e4bは6.6〜9.5GB表示です。8GBのGPU、16GBメモリのノートPC、GPUを他の用途と共有する環境では、今も第一候補になります。
コード特化の枠:Devstral Small 2は短いコンテキストで使う
Devstral Small 2(24B、Apache-2.0、コンテキスト256K)は、エージェント型のコーディング向けに作られたモデルです。MistralはSWE-bench Verifiedで68.0%と公表しています。問題は前述のKVキャッシュで、1トークン160KiBと重く、16GBでは次の組み合わせに限られます。
| ファイル(Unsloth) | サイズ | コンテキスト | 合計(計算) | 判断 |
|---|---|---|---|---|
| Q4_K_M | 14.33GB(13.35GiB) | 32K(F16) | 約18.4GiB | 不可 |
| IQ4_XS | 12.78GB(11.90GiB) | 16K(F16) | 約14.4GiB | 可 |
| Q3_K_M | 11.47GB(10.69GiB) | 32K(q8_0) | 約13.4GiB | 可 |
Ollamaのdevstral-small-2:24bはQ4_K_Mで15GB表示です。16GBでは、Ollamaが勧める64000トークンには届きません。複数ファイルを長く読ませるエージェント作業よりも、範囲を絞った修正向けです。
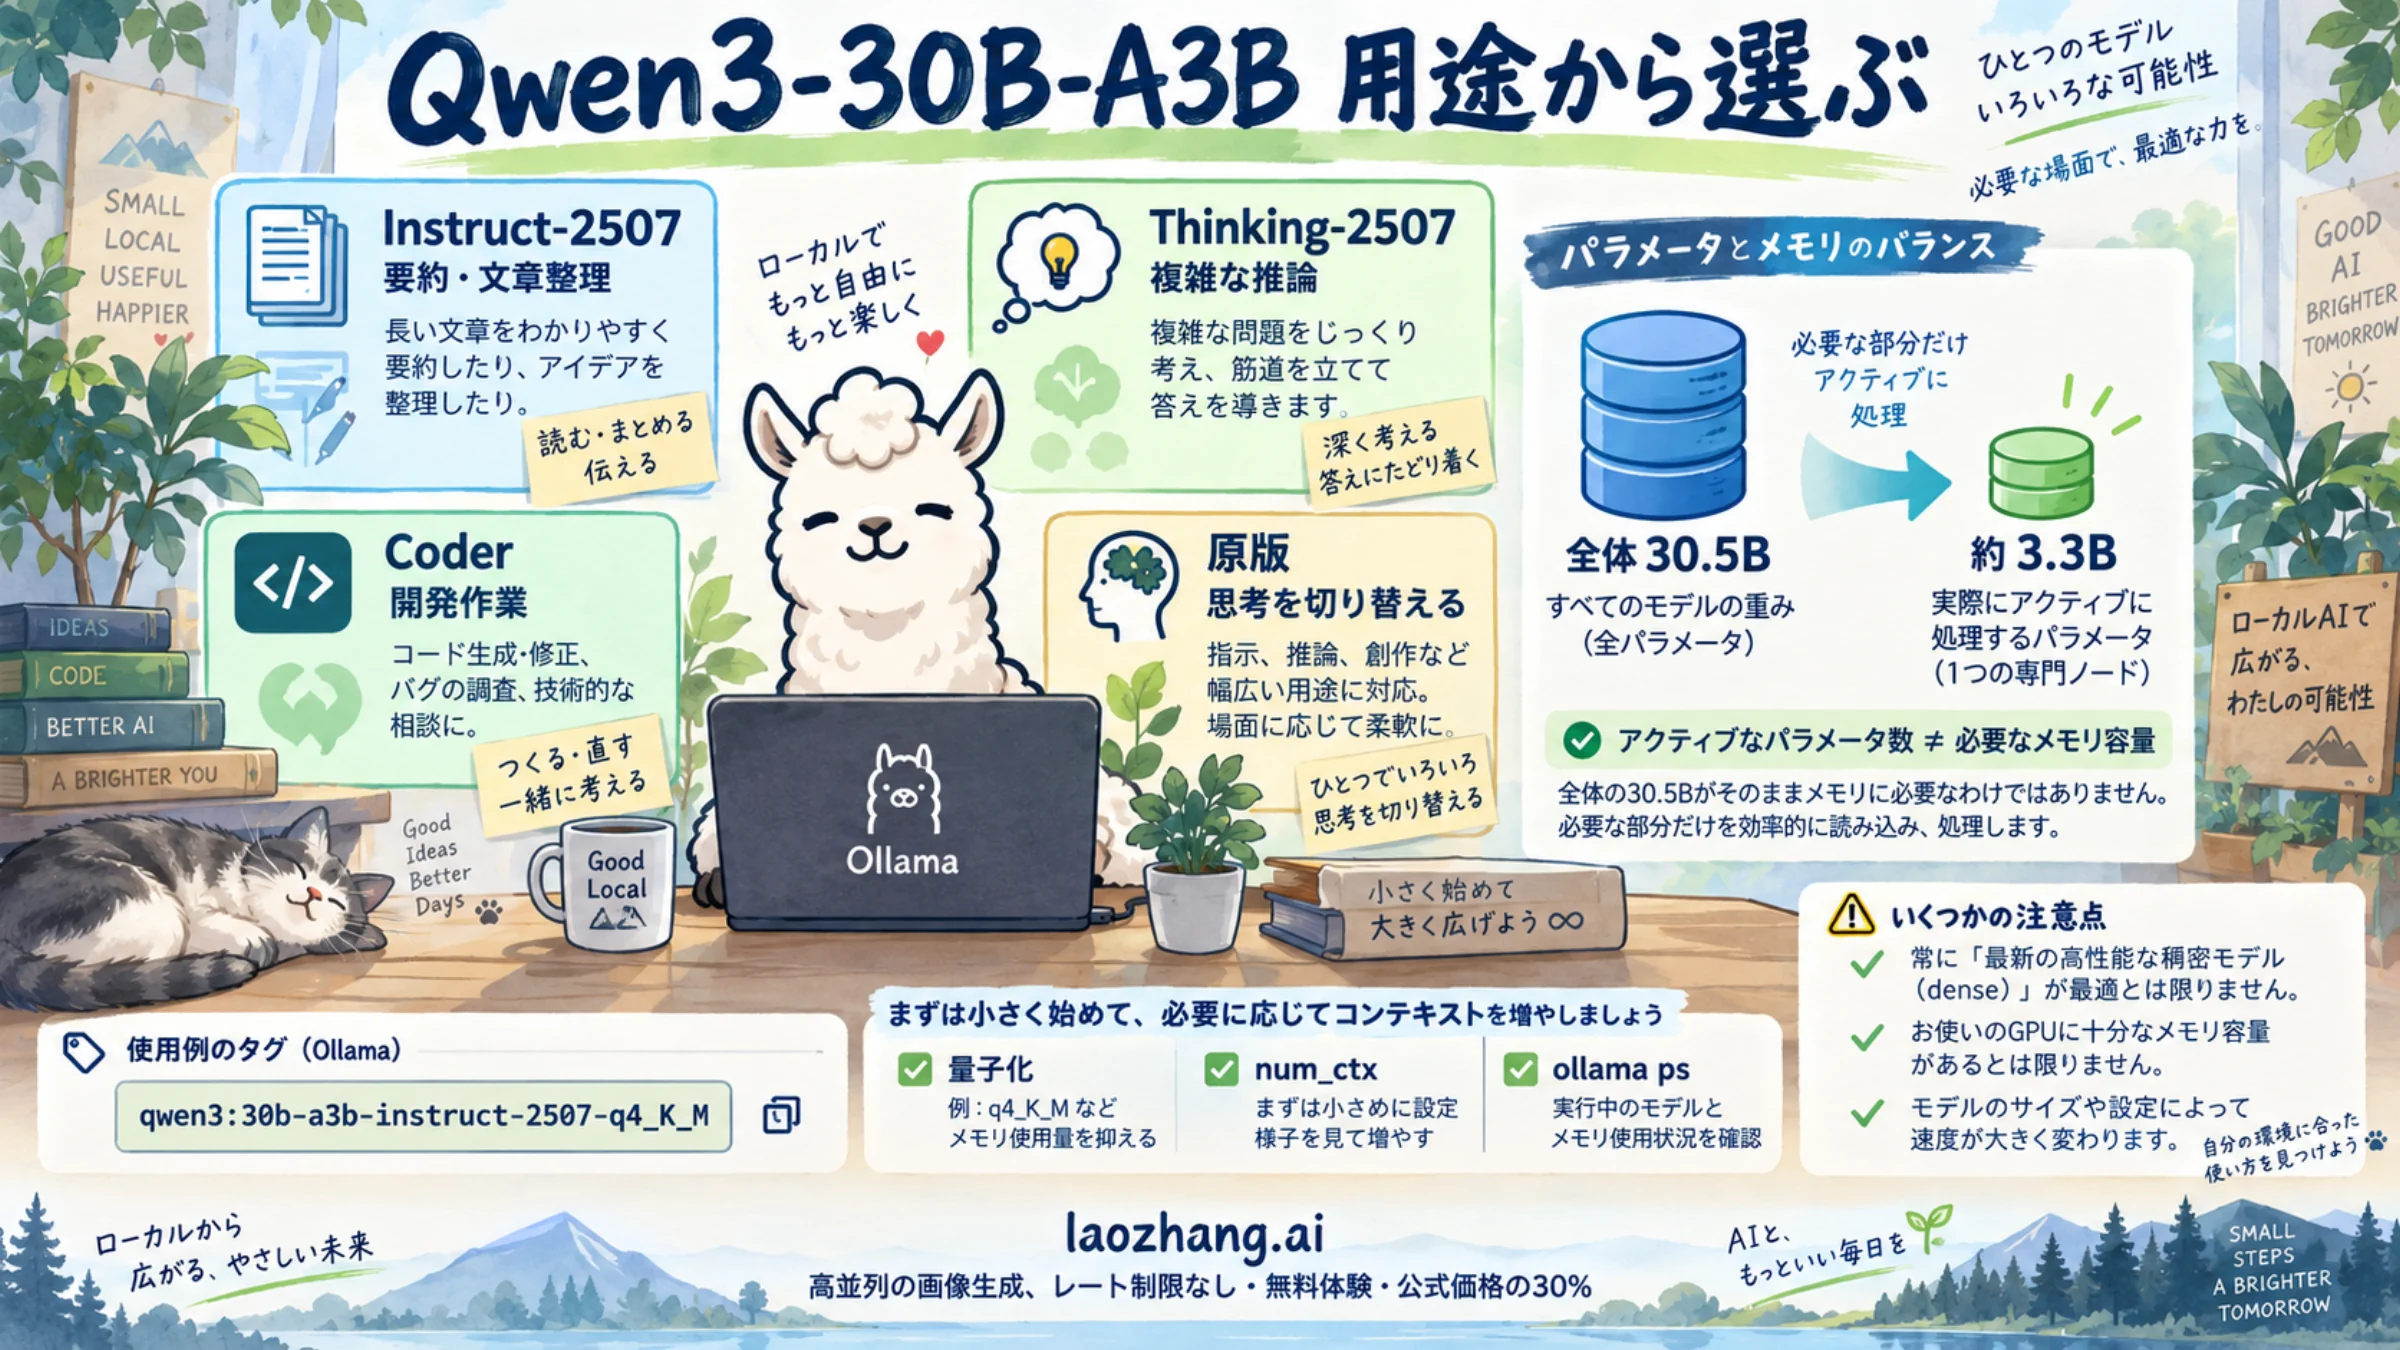
7月時点の候補だったQwen2.5-Coder、DeepSeek Coder、Qwen3-Coder-30B-A3Bは、今から16GBで新しく選ぶ候補ではなくなりました。「Qwen Coder」で探している場合、OllamaのQwen3-Coder 30BはQ4_K_Mで約19GBあり、16GBには収まりません(詳しくはQwen3-30B-A3Bの選び方:Ollamaでの動かし方と必要メモリ)。後継のQwen3-Coder-Nextはさらに大きく、Q4_K_Mで合計48.4GBです。16GBで使うQwenのコード向けモデルとしては、Qwen3.8-27Bの3bit版を試すのが現実的です。
ほかに、IBMのGranite 4.2(2026年8月25日公開、3B・8B・30B、Apache-2.0)があります。8BのQ4_K_M GGUFは5.35GBで軽く、30BはQ3_K_Mで14.13GBです。モデルカードの表の並びから読むと、SWE-bench Verifiedは8Bで47.67で、上の候補を置き換えるほどではありません。
16GB級ではないモデル:GLM-5.3-Flash、Qwen3.8-Flash-Next
新しく話題になったモデルの中には、名前に「Flash」や「Next」が付いていても16GBとは桁が違うものがあります。
| モデル | 公開ファイルの大きさ | 16GBでの扱い |
|---|---|---|
| GLM-5.3-Flash | 公式FP8で約305.8GiB | ローカルでは不可。まずAPI |
| Qwen3.8-Flash-Next | 125BのMoE(アクティブ6B)、公式BF16で約360GB | 不可 |
| Qwen3-Coder-Next | GGUF Q4_K_Mで4分割、合計48.4GB | 不可 |
| GLM-4.7-Flash(2026年1月) | UD-Q3_K_XL 13.78GB、Q3_K_M 14.61GB、Q4_K_M 18.31GB | 3bitならファイルは収まる |
「アクティブ6B」は1トークンあたりの計算量で、必要なメモリ量ではありません。全パラメータを置く場所が必要です。
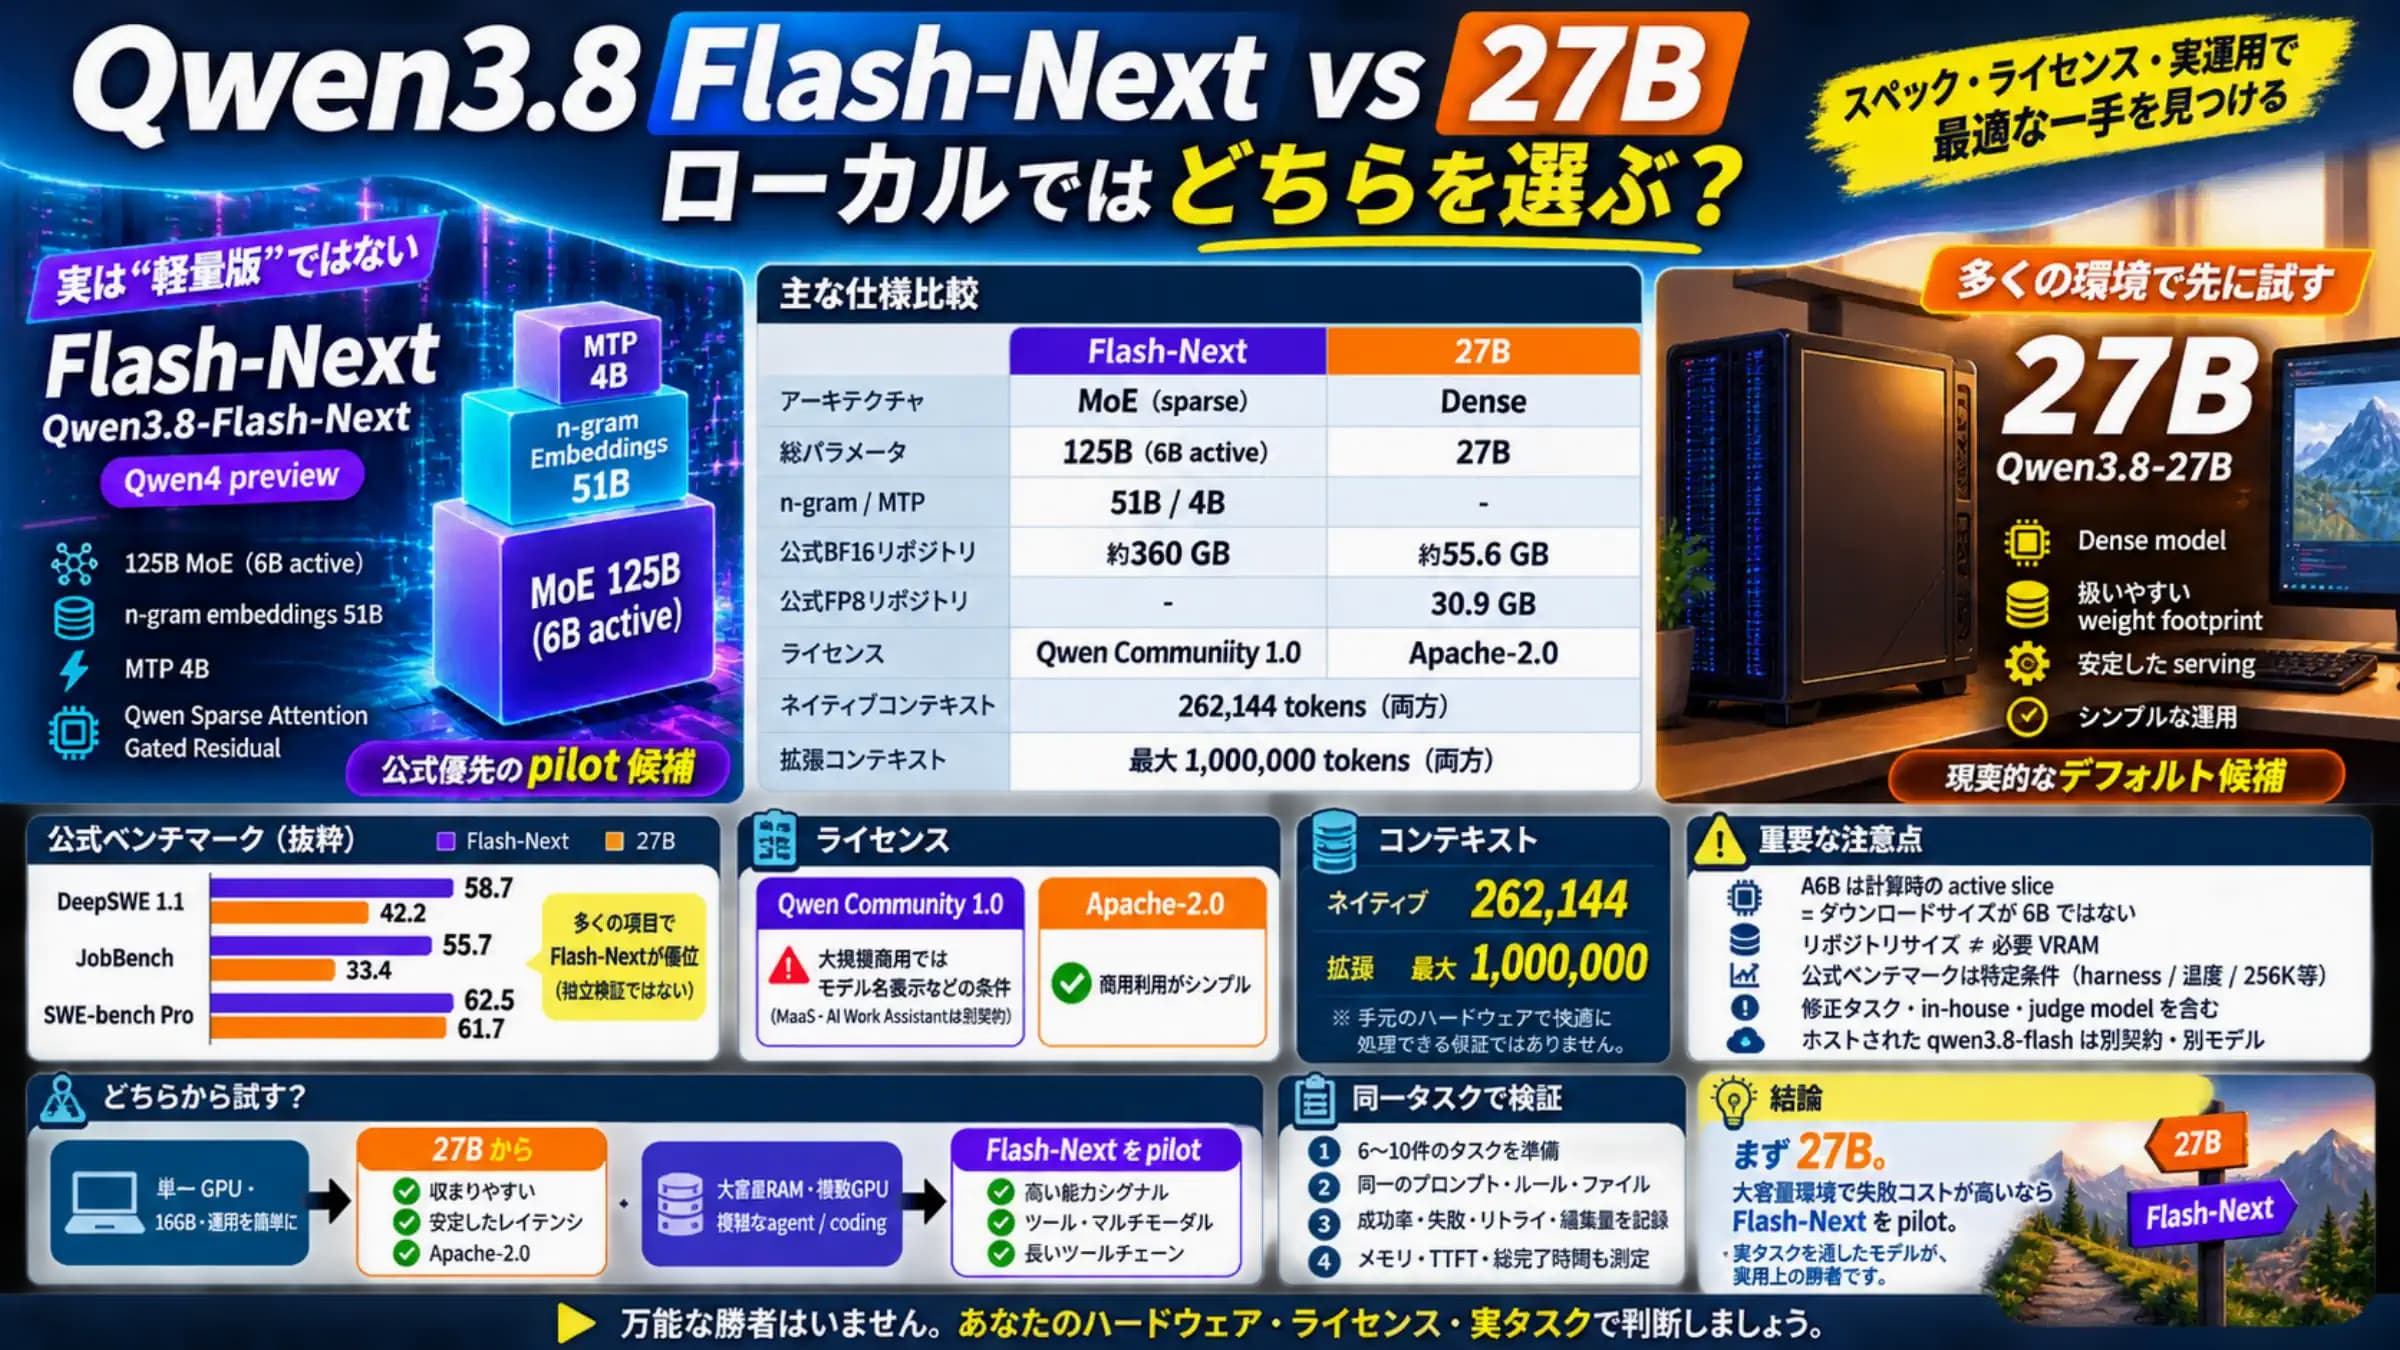
特に取り違えやすいのがGLM-4.7-FlashとGLM-5.3-Flashです。16GBカードに入る3bit版があるのは前者で、UD-Q3_K_XLの13.78GB(約12.83GiB)なら、16GiBのカードにコンテキストと作業領域用の約3GiBが残ります。後者は別物で、APIでの使い方とローカル実行に必要な規模はGLM-5.3-Flash導入ガイド:Ox Alphaの正体、API料金、ローカル実行を参照してください。Qwen3.8-Flash-Nextと27Bの違いはQwen3.8 Flash-Nextと27Bを比較:ローカルではどちらを選ぶ?を参照してください。
16GBメモリのMacやGPUなしPC:Metalの予算は12,124MiB
「16GB」がVRAMではなくメインメモリやユニファイドメモリの場合、使える量はさらに少なくなります。16GiBのユニファイドメモリを持つM4 Macでllama-cli --list-devicesを実行すると、llama.cppが認識するMetalの予算は12,124MiB(約11.8GiB)でした。
この予算に当てはめると、計算上は次のようになります。
- Gemma 4 12B(QAT Q4_0、6.50GiB):64Kの約7.8GiBでも十分に収まります。
- gpt-oss-20b(MXFP4、11.28GiB):重みだけで予算をほぼ使い切り、KVキャッシュに残るのは約0.56GiBです。
- Qwen3.8-27B(UD-Q3_K_XL、12.24GiB):重みだけで予算を超えます。
16GBのMacでは、Gemma 4 12BかGemma 4 E4Bが現実的です。macOS側でGPUに割り当てる上限を引き上げる方法もありますが、引き上げた場合の効果は未検証です。予算の値は測定したものですが、上のモデルの搭載可否は計算であり、実際に読み込んで試したものではありません。
大きなGPUのない16GBメモリのPCでは、推論はCPUで行うことになり、Gemma 4 E4B(QAT Q4_0で5.15GB)やGranite 4.2 8B(Q4_K_Mで5.35GB)のような小型モデル向けです。
実行環境:Ollama、LM Studio、llama.cpp、エディタ連携
同じモデル名でも、実行環境によって実際のファイルと既定のコンテキスト長が違います。推奨を残すときは、モデル名だけでなく実行経路も一緒に書きます。
Ollamaのコンテキスト長のドキュメントによると、既定値はVRAMが24GiB未満で4k、24〜48GiBで32k、48GiB以上で256kです。16GBカードは4kから始まるため、そのままではコーディングツールが渡すファイルの大半が切り捨てられ、モデルが直前の内容を「忘れた」ように見えます。Ollamaはエージェントやコーディングツールには64000トークン以上を勧めており、アプリのスライダーかOLLAMA_CONTEXT_LENGTH=64000 ollama serveで設定します。コンテキストを伸ばせばVRAMも増えるので、設定後はollama psで割り当てを確認します。
Ollamaの公式ライブラリにない量子化ファイルは、Hugging FaceのOllama連携ドキュメントにあるollama run hf.co/{user}/{repo}:{quant}の形式で取得できます。量子化の名前はリポジトリのファイル名(UD-Q3_K_XLなど)と一致させます。
| ルート | Ollama | llama.cpp |
|---|---|---|
| gpt-oss-20b | gpt-oss:20b(14GB表示) | ggml-orgのMXFP4 GGUF |
| Qwen3.8-27B | hf.co/unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XL | -hfで同じファイル+-ctk/-ctv q8_0 |
| Gemma 4 12B | gemma4:12b(7.7〜8.0GB表示) | Google公式のQAT Q4_0 GGUF |
| Devstral Small 2 | devstral-small-2:24b(Q4_K_M、15GB表示)は余白が少ないためhf.co/unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF:IQ4_XS | IQ4_XS(16K)かQ3_K_M(32K、KVはq8_0) |
LM StudioはGUIで同じGGUFファイルを選び、コンテキスト長を設定してローカルサーバーとして公開する経路です。どの経路でも、ファイル名、量子化、コンテキスト長が上の表と同じなら、メモリの計算は変わりません。
llama.cppで使う主なオプションは、-c(コンテキスト長)、-ngl(GPUに載せる層数)、-fa(Flash Attention)、-ctkと-ctv(KVキャッシュの型)、--n-cpu-moe(MoEエキスパートをCPU側に置く層数)、-hf user/repo:quant(Hugging Faceから取得)、--no-mmproj(画像用プロジェクターを読まない)です。
エディタ連携(VS Codeの拡張機能やCLIのエージェントなど)は、どのファイルをどれだけサーバーに送るかを決めます。エディタ側で設定したコンテキスト長がサーバー側より長いと、送った内容が黙って切り捨てられます。挙動が分からないときは、いったんCLIに戻して、問題がモデル、コンテキスト、エディタ連携のどれにあるかを切り分けます。
Smoke test:自分のコードで証明する
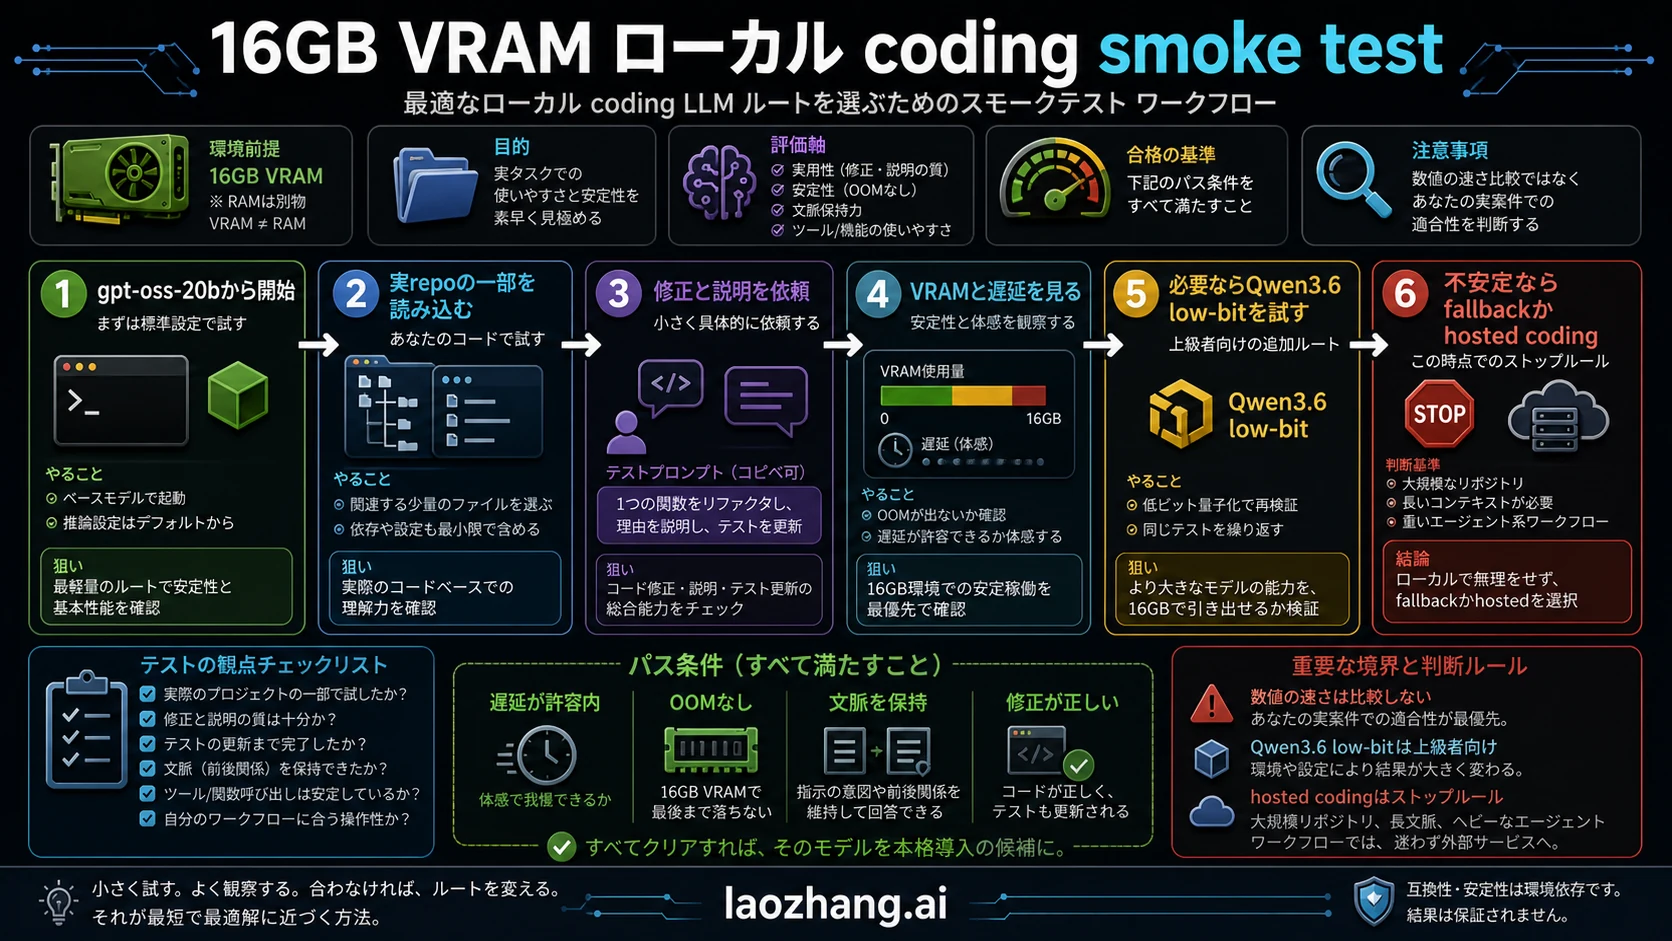
図は2026年7月時点のルート表記です。試す順番は本文を参照してください。
smoke testは自分のコードで行います。一般的なパズルやベンチマークでは、実際の関数、テスト、パッチの制約を保持できるかは見えません。
最小構成は、一つのファイル、一つのテスト、一つの修正要求です。モデルには現状の説明、パッチ、更新すべきテスト名、足りないコンテキストを具体的に答えさせます。
以下のファイルを読み、動作を変えずに関数を一つリファクタリングしてください。
トレードオフを説明し、パッチを示し、更新すべきテスト名を挙げてください。
コンテキストが足りない場合は、次に必要なファイル名またはシンボル名を具体的に書いてください。
合格条件は四つです。待ち時間が許容範囲であること、OOMや想定外のオフロードがないこと、関数とテストの制約を最後まで忘れないこと、パッチが小さくレビューできることです。
試す順番はgpt-oss-20b、Gemma 4 12B、Qwen3.8-27Bの3bit版です。基準が合格してから、コンテキストを段階的に増やし、最後に上級ルートを試します。この順なら、モデルの品質の差と、設定を詰める作業の差を混同しにくくなります。
停止ライン:16GBに固執しない場面
停止ラインは先に決めておきます。16GB環境で一番時間を失うのは、起動だけはするモデルを日常用途まで無理に持ち上げようとすることです。
| 症状 | 原因の候補 | 次の手 |
|---|---|---|
| 起動後に極端に遅い | オフロード、または重い量子化 | 小さいモデルか、より大きいVRAM |
| 短い質問は良いがリポジトリでは崩れる | コンテキスト不足、Ollamaの既定4k | コンテキスト長を設定し、タスクを狭める |
| コンテキストを増やすとOOM | KVキャッシュが予算を超えている | KVをq8_0にするか、コンテキストを下げる |
| パッチのループで状態を失う | エージェント作業が16GBには重い | ホスト型のコーディングエージェントか上位GPU |
| 3bitで出力の質が明らかに落ちる | 量子化が低すぎる | Gemma 4 12Bに戻るか、24GB以上でQ4_K_M |
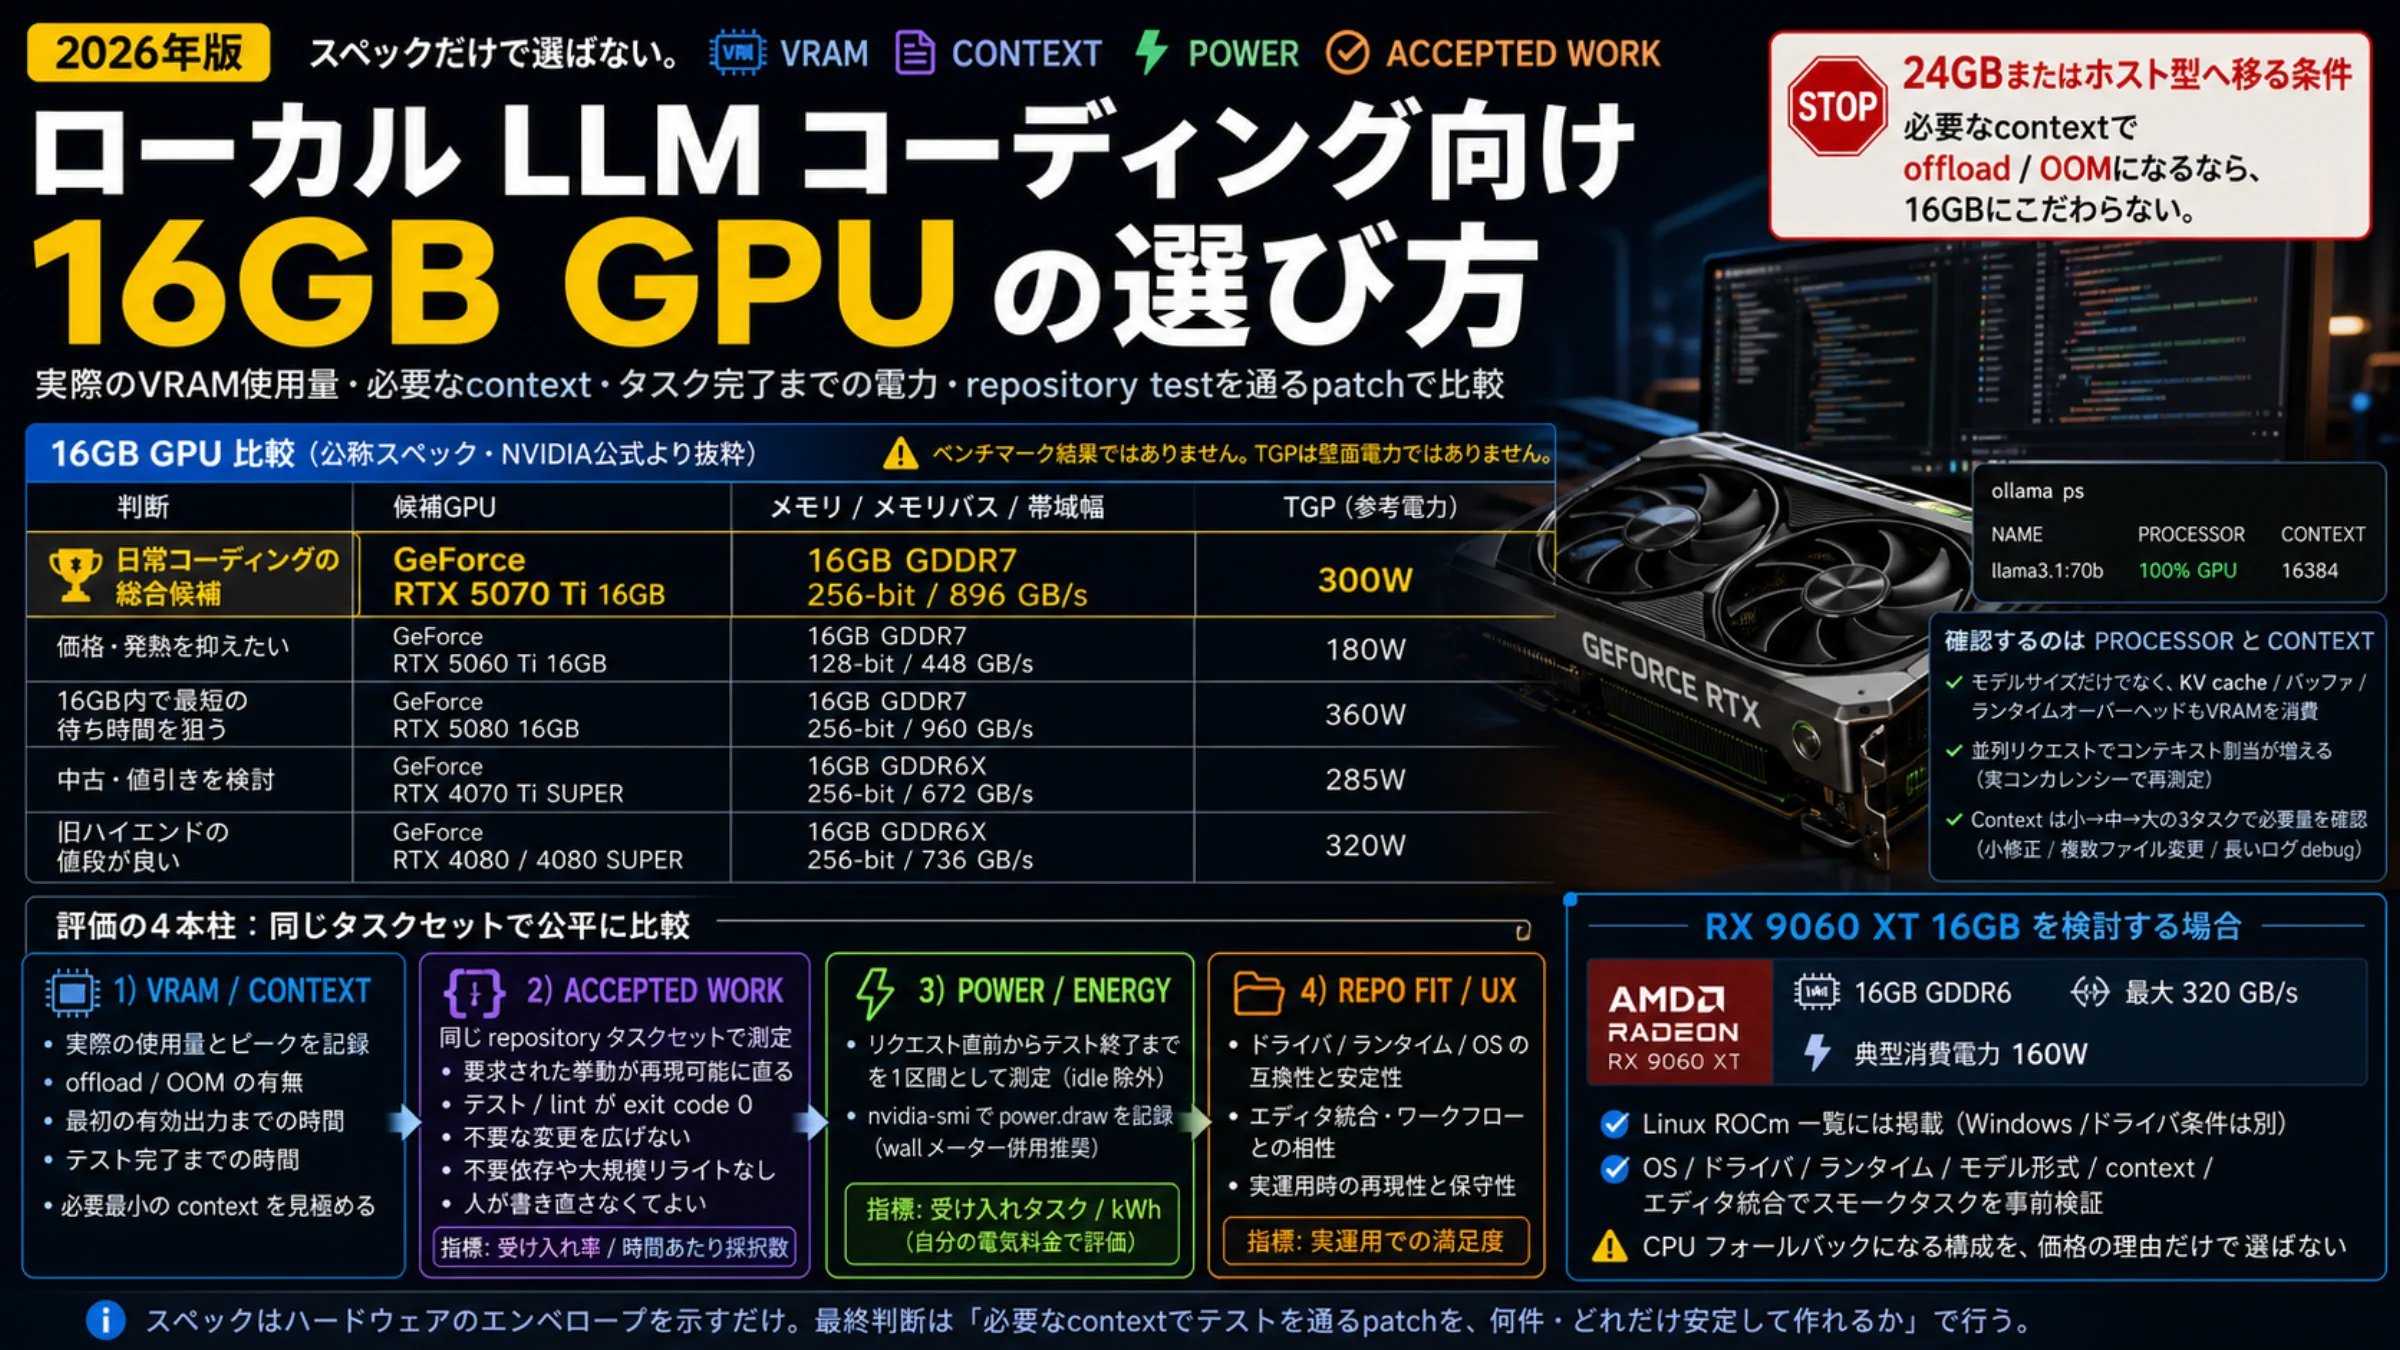
解決策は一つではありません。小さいモデルへ戻す、タスクを狭める、コンテキストを下げる、24GB以上のカードへ移る、長い複数ファイルの作業だけホスト型に出す、のいずれかです。どのカードを選ぶかはローカル LLM コーディング向け16GB GPUの選び方、ホスト型に切り替える基準はローカル LLM coding agent: Claude/Codex より向く場面、載ったのに失敗する場合の原因の分け方はローカル coding agent が失敗する?量子化・コンテキスト・Harness を切り分けるが参考になります。
目的は16GBですべてを証明することではなく、コード作業を速く、安定して、レビューできる状態にすることです。
ローカル検証ログに残す項目
検証ログには、再現に必要な条件と結果を同じ形式で残します。
GPU / VRAM:          RTX 4060 Ti 16GB など
メインメモリ:        32GB など
OS / ドライバー:
ランタイム / 版:      Ollama 0.x / llama.cpp build xxxx
リポジトリ / ファイル: unsloth/Qwen3.8-27B-GGUF / Qwen3.8-27B-UD-Q3_K_XL.gguf
KVキャッシュの型:     f16 / q8_0
コンテキスト長:      32768
GPU/CPUの割り当て:   ollama ps の PROCESSOR 欄
タスク:              関数1つ+テスト1つ / +エラーログ / +隣接モジュール
待ち時間 / ピーク:
結果 / 失敗理由:
gpt-oss-20bでは、どの程度のリポジトリの切り出しを安定して扱えるかを見ます。Qwen3.8-27Bの3bit版では、gpt-oss-20bより実際にパッチの質が上がるかと、待ち時間が許容範囲かを見ます。Gemma 4 12Bでは、長いコンテキストを渡したときに指示を保てるかを見ます。
残すべき結論は「起動した」ではなく「正しく直せた」です。同じタスクを三段階で増やすと判断しやすくなります。最初は一つの関数と一つのテスト、次にエラーログ、最後に隣接モジュールを足し、どの段階で遅くなり、どの段階でテスト名を忘れるかを見ます。
モデル、量子化、ランタイム、エディタ連携を同時に替えると、改善の理由が分かりません。タスクと指示文を固定し、変数を一つずつ変えます。チームに共有するときも「このモデルが最強」ではなく、「このGPU、このファイル、このコンテキスト長、この作業では合格」と書きます。モデル名だけの推薦は数か月で古くなりますが、再現条件はそのまま次の比較に使えます。
よくある質問
16GB VRAMで最初に試すローカルCoding LLMは?
gpt-oss-20bです。ベンダーが16GBのメモリで動くと明記している唯一の候補で、MXFP4 GGUF(12.11GB)に64KのKVキャッシュを足しても計算上約12.8GiBに収まります。Ollamaで使う場合は、既定の4kのままにせず、OLLAMA_CONTEXT_LENGTH=64000を設定してから試します。
Qwen3.6 35B A3Bは16GBで動きますか?
UD-IQ3_XXS(13.21GB)なら、64Kで約13.6GiB、モデルカードが勧める128Kで約14.8GiBと計算上は収まりますが、余白はほとんどありません。UD-Q4_K_M(22.13GB)はllama.cppの--n-cpu-moeでエキスパートをメインメモリに置けば使えますが、遅くなります。2026年8月以降、16GBで最初に試すQwenはQwen3.8-27Bの3bit版です。
gpt-oss-20bはコード用途に十分ですか?
局所的な修正、コードの説明、短いテスト案の作成には基準として十分使えます。複数ファイルにまたがる長いエージェント作業は、自分のリポジトリでsmoke testをしてから判断します。品質が足りない場合の次の候補はQwen3.8-27Bの3bit版、コンテキストが足りない場合はGemma 4 12Bです。
Gemma 4 E4Bはなぜ候補ですか?
8GBのGPUやノートPCでは今も第一候補ですが、16GBカードではGemma 4 12Bに置き換わりました。12Bは公式QAT Q4_0で6.98GB、128Kでも計算上約8.8GiBに収まり、GoogleのLiveCodeBench v6の値は72.0%とE4Bの52.0%を大きく上回ります。
OllamaとLM Studioはどちらがよいですか?
CLIで手早く始めるならOllama、GUIで量子化ファイルを選んでローカルサーバーを立てるならLM Studioです。Ollamaを使う場合は、VRAMが24GiB未満だと既定のコンテキスト長が4kになる点に注意してください。どちらでも、ファイル名、量子化、コンテキスト長が同じならメモリの計算は変わりません。
RTX 4060 Ti 16GBで足りますか?
ここで挙げた4ルートの計算は、16GiBのカードを前提にしています。gpt-oss-20b、Gemma 4 12B、Qwen3.8-27Bの3bit版、Devstral Small 2の短いコンテキストは、いずれも容量の面では収まる計算です。速度はカードのメモリ帯域にも左右され、上の計算には含まれません。カードの比較はローカル LLM コーディング向け16GB GPUの選び方を参照してください。
8GB VRAMならどうしますか?
Gemma 4 E4B(公式QAT Q4_0で5.15GB)を中心に、短いコンテキストと狭いタスクに絞ります。Gemma 4 12Bは重みだけで6.50GiBあり、8GBではコンテキストの余地がわずかです。16GB向けのQwen3.8-27Bの設定は、そのまま移せません。
24GB VRAMにすれば十分ですか?
余裕は大きく増えます。たとえばQwen3.8-27BのUD-Q4_K_M(15.33GiB)に64KのKVキャッシュ(q8_0で約2.13GiB)を足しても約17.5GiBで、3bitに下げる必要がなくなります。それでもコンテキストとKVキャッシュの管理は残り、smoke testは必要です。32GB以上の構成はQwen3.8-27Bの必要VRAM:RTX 5090・GPU 2枚・量子化と262Kの設定を参照してください。
いつローカル調整を止めるべきですか?
OOM、オフロードによる遅延、コンテキストの喪失、パッチのループの失敗が、コードを書く作業より長くなった時点です。小さいモデルへ戻すか、24GB以上のカードへ移るか、長い作業だけホスト型のコーディングエージェントに出します。
コミュニティのベンチマークだけで決められますか?
候補探しには使えますが、保証にはなりません。ベンダーのベンチマークも同じで、Qwen3.8-27Bのコーディング指標はフル精度・256Kで測った値であり、16GBで使う3bit・32〜64Kの設定とは条件が違います。モデルファイル、量子化、ランタイム、自分のコードで確認します。
Qwen3.8-27Bは16GB VRAMで動きますか?
3bitのGGUFなら計算上は動きます。UnslothのUD-Q3_K_XL(13.15GB)にq8_0のKVキャッシュを足すと、32Kで約13.3GiB、64Kで約14.4GiBです。Q4_K_M(16.46GB、Ollamaのqwen3.8:27bは18GB表示)は重みだけで16GBがほぼ埋まるため使えません。Ollamaではhf.co/unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XLを指定します。
Qwen Coderは16GB VRAMで使えますか?
Qwenのコード特化モデルは、どれも16GBには大きすぎます。OllamaのQwen3-Coder 30BはQ4_K_Mで約19GB、Qwen3.6-27Bのコーディング向けタグqwen3.6:27b-codingは19GB、Qwen3-Coder-NextはQ4_K_Mで合計48.4GBです。16GBで使うQwenのコーディング向けモデルとしては、Qwen3.8-27Bの3bit版(UD-Q3_K_XL、13.15GB)が現実的です。
GLM-5.3-Flashは16GBで動きますか?
動きません。公式のFP8重みだけで約305.8GiBあります。3bit版が16GBカードに入るのは別モデルのGLM-4.7-Flashで、UD-Q3_K_XLは13.78GBです。
16GBメモリのMacでも使えますか?
小型から中型のモデルなら使えます。16GiBのM4 Macでllama.cppが認識するMetalの予算は12,124MiBで、Gemma 4 12B(6.50GiB)は余裕を持って収まる計算です。gpt-oss-20b(11.28GiB)は重みだけで予算をほぼ使い切り、Qwen3.8-27Bの3bit版は予算を超えます。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月22日。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月22日。
- 1.OpenAIのgpt-oss-20bモデルカードhuggingface.co/openai/gpt-oss-20b
- 2.Gemma 4 12Bのモデルカードhuggingface.co/google/gemma-4-12B-it
- 3.Devstral Small 2のモデルカードhuggingface.co/mistralai/Devstral-Small-2-24B-Instruct-2512
- 4.Qwen3.8-27Bのモデルカードhuggingface.co/Qwen/Qwen3.8-27B
- 5.ggml-orgのMXFP4 GGUFhuggingface.co/ggml-org/gpt-oss-20b-GGUF
- 6.UnslothのQwen3.8-27B GGUFhuggingface.co/unsloth/Qwen3.8-27B-GGUF
- 7.Google公式のQAT Q4_0 GGUFhuggingface.co/google/gemma-4-12B-it-qat-q4_0-gguf
- 8.Ollamaのコンテキスト長のドキュメントdocs.ollama.com/context-length
- 9.Hugging FaceのOllama連携ドキュメントhuggingface.co/docs/hub/ollama