Qwen3-30B-A3Bの選び方:Ollamaでの動かし方と必要メモリ
Qwen3-30B-A3Bは用途と思考モードで選びます。短い要約ならInstruct-2507、推論を深めるならThinking-2507、開発ならCoderが候補です。原版は思考の切り替えが必要な場合に使えます。Ollamaのモデル名と実際の設定を確認してから、メモリに合わせて使い始めましょう。
目次
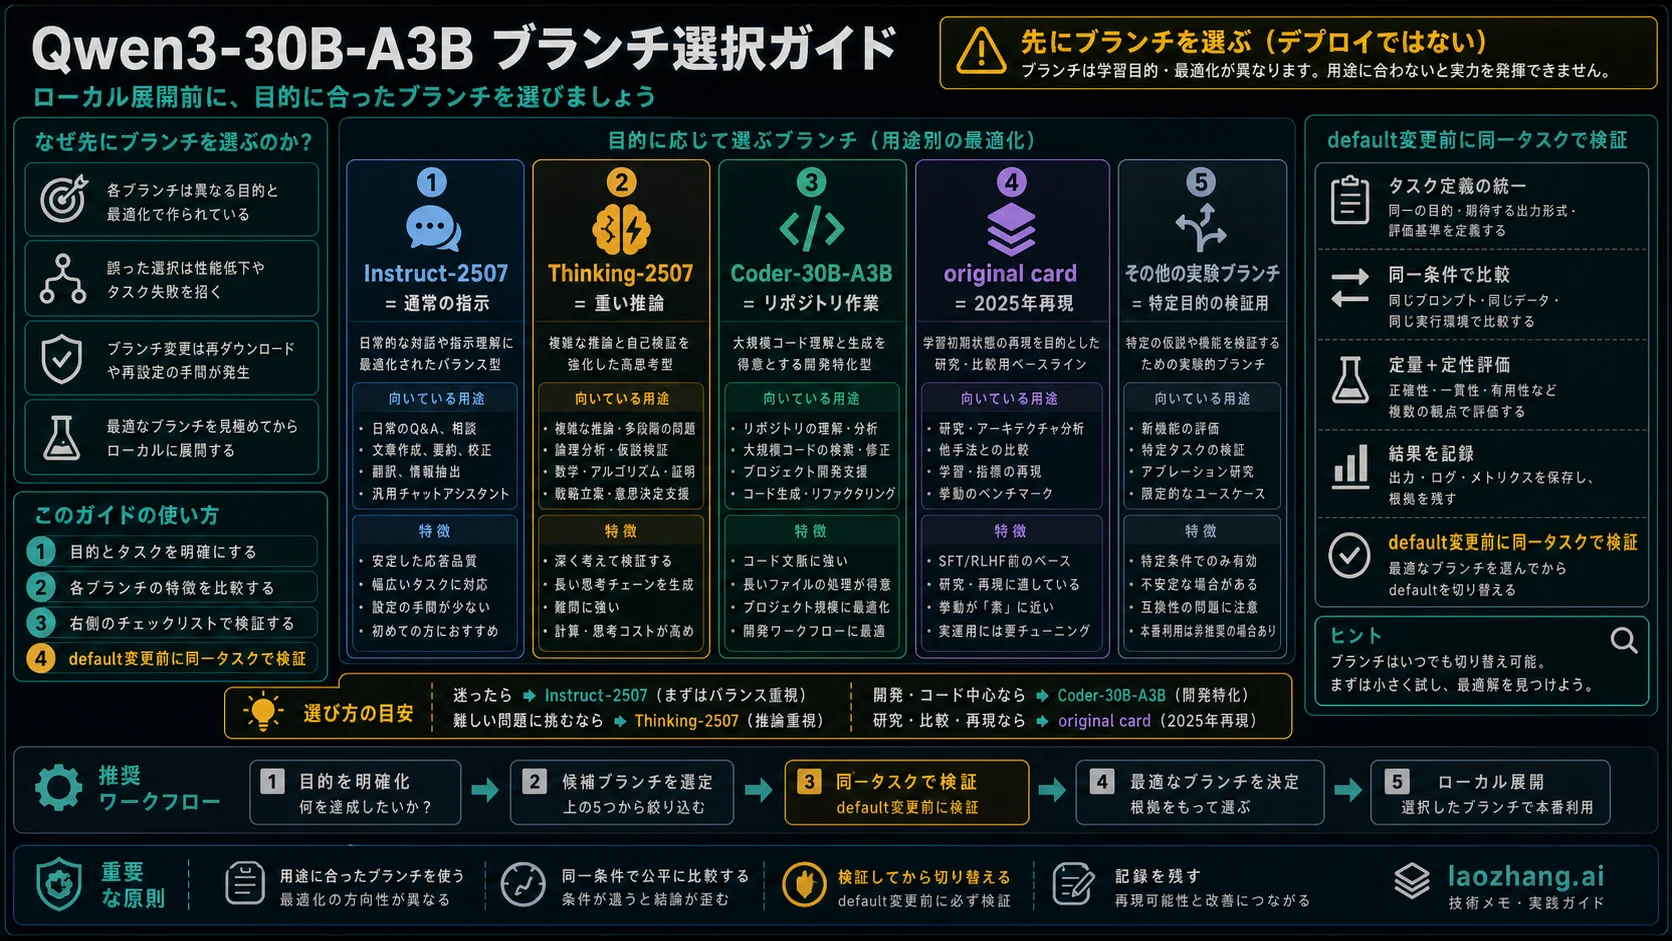
Qwen3-30B-A3Bを日常の要約や文章整理に使うなら、まず Instruct-2507 を選びます。条件の多い問題をじっくり解かせるなら Thinking-2507、コードの修正や開発作業なら Coder-30B-A3B-Instruct が候補です。一つのモデルで思考あり・なしを切り替えたい場合は、原版のQwen3-30B-A3B に意味があります。
名前の「A3B」は、約3Bの重みだけをメモリに置けば動くという意味ではありません。モデル全体は30.5Bパラメータあり、トークンごとに約3.3Bが働くMoE方式です。ローカルで使えるかどうかは、全重みの量子化、会話の長さ、KVキャッシュ、GPUとCPUへの配置で決まります。原版のモデルカードに、全体と有効化されるパラメータ数の区別が記載されています。
以下では、用途からモデルを選び、Ollamaで短い日本語の依頼を送り、実際に読み込まれた設定を確認するところまで説明します。コマンドは文書に基づく実行例です。ここでモデルを動かして得た回答、速度、メモリ実測値は掲載していません。参照したモデルカードとOllamaの資料は2026年10月7〜8日に確認しています。
どのモデルを選べばよいか
最初に決めるのは、長い思考過程が必要か、それとも最終回答を直接得たいかです。2507は2025年7月の更新を示す名前で、InstructとThinkingは別々のモデルです。
| やりたいこと | 選ぶモデルの正確なID | 思考モードとコンテキスト |
|---|---|---|
| 会話ごとに思考あり・なしを切り替える | Qwen/Qwen3-30B-A3B | 切り替え式。標準32,768トークン、YaRNによる拡張で131,072 |
| 要約、分類、文章の推敲、通常の質問 | Qwen/Qwen3-30B-A3B-Instruct-2507 | 非思考専用。標準262,144トークン |
| 数学、複数条件の計画、複雑な原因分析 | Qwen/Qwen3-30B-A3B-Thinking-2507 | 思考専用。標準262,144トークン |
| コードの読解、修正、開発ツールとの連携 | Qwen/Qwen3-Coder-30B-A3B-Instruct | 非思考専用。標準262,144トークン、YaRNによる1Mへの拡張を案内 |
出典:原版、Instruct-2507、Thinking-2507、Coder。標準の対応長と、実行環境で割り当てる長さは別です。入力、会話履歴、生成する出力は同じコンテキスト枠を使います。
Instruct-2507の「非思考」は、論理問題を解けないという意味ではありません。長い思考ブロックを生成せず、回答を直接出すモデルです。短い社内文書の整理やメールの推敲なら、まずこの動作が必要な出力形式に合うかを見ます。
Thinking-2507は、条件の組み合わせや反例の検討に時間をかける用途に向きます。ただし、長く考えればいつでも正しくなるわけではありません。自分の問題で正答が増えるか、待ち時間や回答の確認に見合うかを判断してください。
原版は古い結果の再現だけに限りません。たとえば同じローカルアシスタントで、通常の短い質問には思考を使わず、難しい問いでは使う運用に適しています。Hugging Faceの原版テンプレートでは enable_thinking=False が明示的な無効化、思考が有効なときの /think と /no_think が入力による切り替えです。これは原版の仕組みで、固定モードの2507を相互に変換するものではありません。原版の切り替え方法を参照してください。
Coderはコーディングとツール利用を重視した別モデルです。開発ツールと連携する際は、その環境が関数呼び出し形式を解釈できるかも確認します。モデルがコマンドを文章に書くだけでは、ファイルの編集やテストの実行は行われません。
Ollamaでは省略しないモデル名で始める
Ollamaを導入済みで、ローカルのOllamaが起動している場合、Instruct-2507の入り口は次の明示的なタグです。初回はモデルが未取得ならダウンロードが発生します。掲載時点のQ4_K_M版は約19GBなので、保存先の空き容量も必要です。
ollama run qwen3:30b-a3b-instruct-2507-q4_K_Mこのタグの公開ページでは、Instruct-2507と量子化形式を名前で識別できます。ollama run qwen3 と省略すると、確認時点では既定の8Bモデルが選ばれます。30Bを使う手順としては省略しないでください。
短い動作確認では、対話画面でコンテキストを8,192トークンに指定してから依頼を入力できます。
/set parameter num_ctx 8192
次の連絡文を、事実を追加せず丁寧な日本語に直してください。
「来週火曜の打合せを15時に変えたいです。難しければ木曜の午前を希望します。」
出力は件名と本文だけにし、本文は3文以内にしてください。
この依頼なら、曜日と時間を変えていないか、第二希望を残しているか、指定した形式に収まるかを読み比べられます。日本語が出たことだけで成功とせず、元の条件が保たれているかを確認しましょう。8,192はこの短い確認用に選んだ設定で、モデルの最大対応長ではありません。
モデル情報と実際の割り当てを確認する
別のターミナルで次を実行します。
ollama show qwen3:30b-a3b-instruct-2507-q4_K_M
ollama show qwen3:30b-a3b-instruct-2507-q4_K_M --modelfile
ollama ps
show でパラメータ数、量子化、モデル側のコンテキスト情報を、--modelfile でテンプレートと設定値を確認します。モデルが読み込まれている間の ps では、PROCESSOR のCPU/GPU配置と CONTEXT の実際の割り当てを見ます。OllamaのModelfile資料とコンテキスト長の資料が各項目の根拠です。
タグは更新される可能性があります。確認時点では qwen3:30b-a3b と qwen3:30b は同じ短縮ダイジェスト ad815644918f、明示的なInstructタグは 19e422b02313 でした。短い名前が2025年4月の原版を指すと決めつけず、取得したモデルの情報、テンプレート、配布元を照合してください。比較を再現したい場合は、モデルIDとリビジョン、量子化、タグの識別情報、Ollamaのバージョン、コンテキスト設定を記録します。短いタグのページにある262,144という値を、原版の標準32,768に上書きして解釈することもできません。
リクエスト単位で長さを指定する例
対話画面を使わず送るなら、起動済みのローカルOllamaに次のようなリクエストを送れます。シェルにそのまま渡せる形の例です。
curl http://127.0.0.1:11434/api/chat \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen3:30b-a3b-instruct-2507-q4_K_M",
    "messages": [{
      "role": "user",
      "content": "議事メモを決定事項と未決事項に分けてください。資料の締切は金曜に決定。担当者は未定。次回会議は月曜10時に決定。メモにない項目は追加しないでください。"
    }],
    "stream": false,
    "options": {"num_ctx": 8192}
  }'
stream: false では、まとまった一つの応答を受け取ります。通常の回答本文は message.content で確認します。モデル情報には対応可能な最大長が出ても、今回の依頼は options.num_ctx で指定した長さを使います。OllamaのチャットAPIとコンテキストの指定方法を参照してください。
思考を止める操作はモデルごとに違う
Instruct-2507とCoderは非思考専用なので、思考を無効にするための追加指定は不要です。Thinking-2507は思考専用で、/no_think を付けてInstructと同じ動作にはできません。Thinking-2507の既定テンプレートは開始側の <think> を先に挿入するため、生成部分に閉じ側の </think> だけが含まれることがあります。開始タグが回答中にないだけで故障と判断しないでください。Thinking-2507の説明に明記されています。
切り替えに対応するOllamaモデルでは、APIの think が制御項目です。まず /api/show の情報を確認できます。
curl http://127.0.0.1:11434/api/show \
  -H 'Content-Type: application/json' \
-d '{"model":"qwen3:30b-a3b-instruct-2507-q4_K_M"}'現在のOllamaの思考機能の資料では、thinking.values と thinking.default に対応する値と既定値が示されます。false を許すモデルなら、チャットのリクエストに "think": false を加えて無効化できます。思考がある応答では message.thinking と message.content を区別します。情報が省略されていることだけで、内部の思考がないと断定はできません。
Hugging Faceの enable_thinking とOllamaの think は、それぞれの環境の指定方法です。また、思考の表示を隠すことと、生成を無効にすることも別です。原版の切り替えを使いたい場合は、原版に対応する配布物であることと、実行環境の制御が対応していることを確認してから設定してください。ここでは未確認のThinking-2507用Ollamaタグを挙げていません。
必要メモリは全重みとKVキャッシュを足して考える
30.5Bパラメータをすべて理想的な4bitで保存するだけなら、計算は 30.5 × 10^9 × 4 ÷ 8 で15.25GB、約14.20GiBです。ただし、量子化の補助情報や低ビット化しない部分を含まない理想値です。先ほどのOllama配布物が約19GBなのは、この理想値と実際のファイルが同じではないためです。ファイル容量も、実行時のメモリ利用のピークとは一致しません。
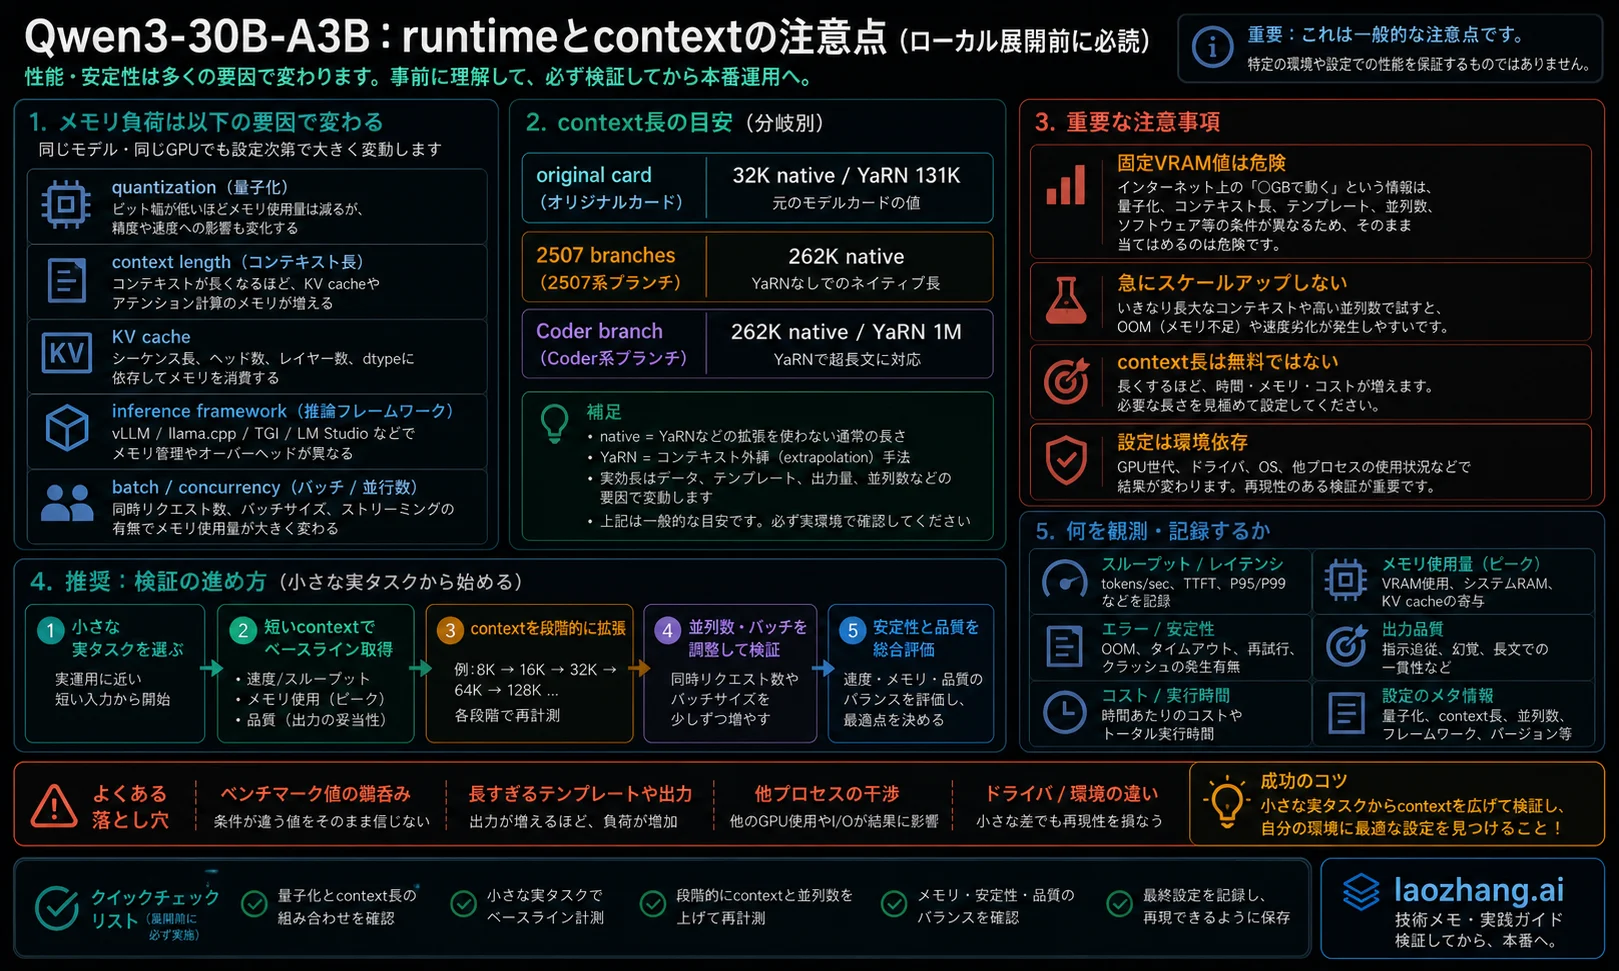
会話が長くなると、過去のトークンを参照するためのKVキャッシュが増えます。たとえばCoderの設定ファイルにある48層、4つのKVヘッド、ヘッド次元128を使い、KVをF16で保持すると仮定します。1トークン当たりは次の計算になります。
KとVの2組 × 48層 × 4ヘッド × 128要素 × 2バイト
= 98,304バイト = 96KiB/トークン| 保持するトークン数 | F16 KVキャッシュの理論上の容量(1系列) |
|---|---|
| 8,192 | 0.75GiB |
| 32,768 | 3GiB |
| 65,536 | 6GiB |
| 262,144 | 24GiB |
これは指定した構造とF16という条件からの計算で、実測ではありません。重み、計算途中のデータ、実行環境の管理領域、余白は別に必要です。重みをQ4にしてもKVが自動で4bitになるわけではなく、KVの形式や確保方法によって実際の量は変わります。同時に複数の会話を処理する場合も、系列の数に応じた余裕が必要です。
したがって「19GBのモデルだから、メモリが19GBあれば262Kで動く」とは判断できません。MacのユニファイドメモリではOSやほかのアプリも同じ容量を使います。GPUのVRAMが足りなくてもCPUへの配置で動く場合はありますが、その条件では速度も変わります。まず短い長さで読み込みと応答を確認し、必要な文章量に合わせて長さを増やしてください。途中でメモリ不足になったら、先にコンテキストを縮め、同時処理を減らすことで切り分けられます。
既定値が4Kとは限らない
確認したOllamaのコンテキスト長の資料では、VRAMが24GiB未満なら4K、24〜48GiBなら32K、48GiB以上なら256Kという既定値が示されています。一方、FAQには既定4,096という説明が残っています。両方の記述があるため、どのインストール環境でも一律4Kと考えるのは適切ではありません。コンテキスト長の資料とFAQを区別し、自分の環境では明示した num_ctx と、読み込み後の ollama ps を確認してください。
256Kと1Mの説明を混ぜない
2507の標準262,144トークンと、モデルカードに載る1M向けの手順は別です。Instruct/Thinkingの1M手順はDCAとMInference、専用設定を組み合わせる方法で、約240GBの総GPUメモリを必要とする条件が記されています。普通のOllamaのQ4モデルで、長さの数値だけ変えれば同じものになるわけではありません。Instructの長文処理手順にある適用条件を確認してください。
CoderのYaRNによる1M拡張も、実行環境と設定を伴う別の説明です。最初の日本語の動作確認では最大長を目指す必要はなく、入力と出力に必要な枠を確保することが先です。
Coderを試すなら、修正条件を短く具体的にする
開発用途では、OllamaのCoder 30Bタグを使えます。確認時点ではQ4_K_Mで約19GBです。
ollama run qwen3-coder:30b対話画面では、次のような小さな課題から始めると、回答を自分で確認できます。
/set parameter num_ctx 8192
Pythonの関数 split_labels(text) を作ってください。
半角カンマで区切り、各項目の前後の空白を除き、空の項目を捨てます。
同じ項目が複数ある場合は最初のものだけを残し、順番は変えません。
大文字と小文字は別の項目として扱います。外部ライブラリは使わないでください。
関数と、空文字・重複・大文字小文字を確認するassertを書いてください。
たとえば入力が "赤, 青,赤,,青, RED,red" なら、仕様上は ['赤', '青', 'RED', 'red'] が期待値です。これは課題の判定基準で、実際のモデルが返した結果ではありません。コードを受け取ったら、そのまま採用せず、指定した条件とテストを確認します。
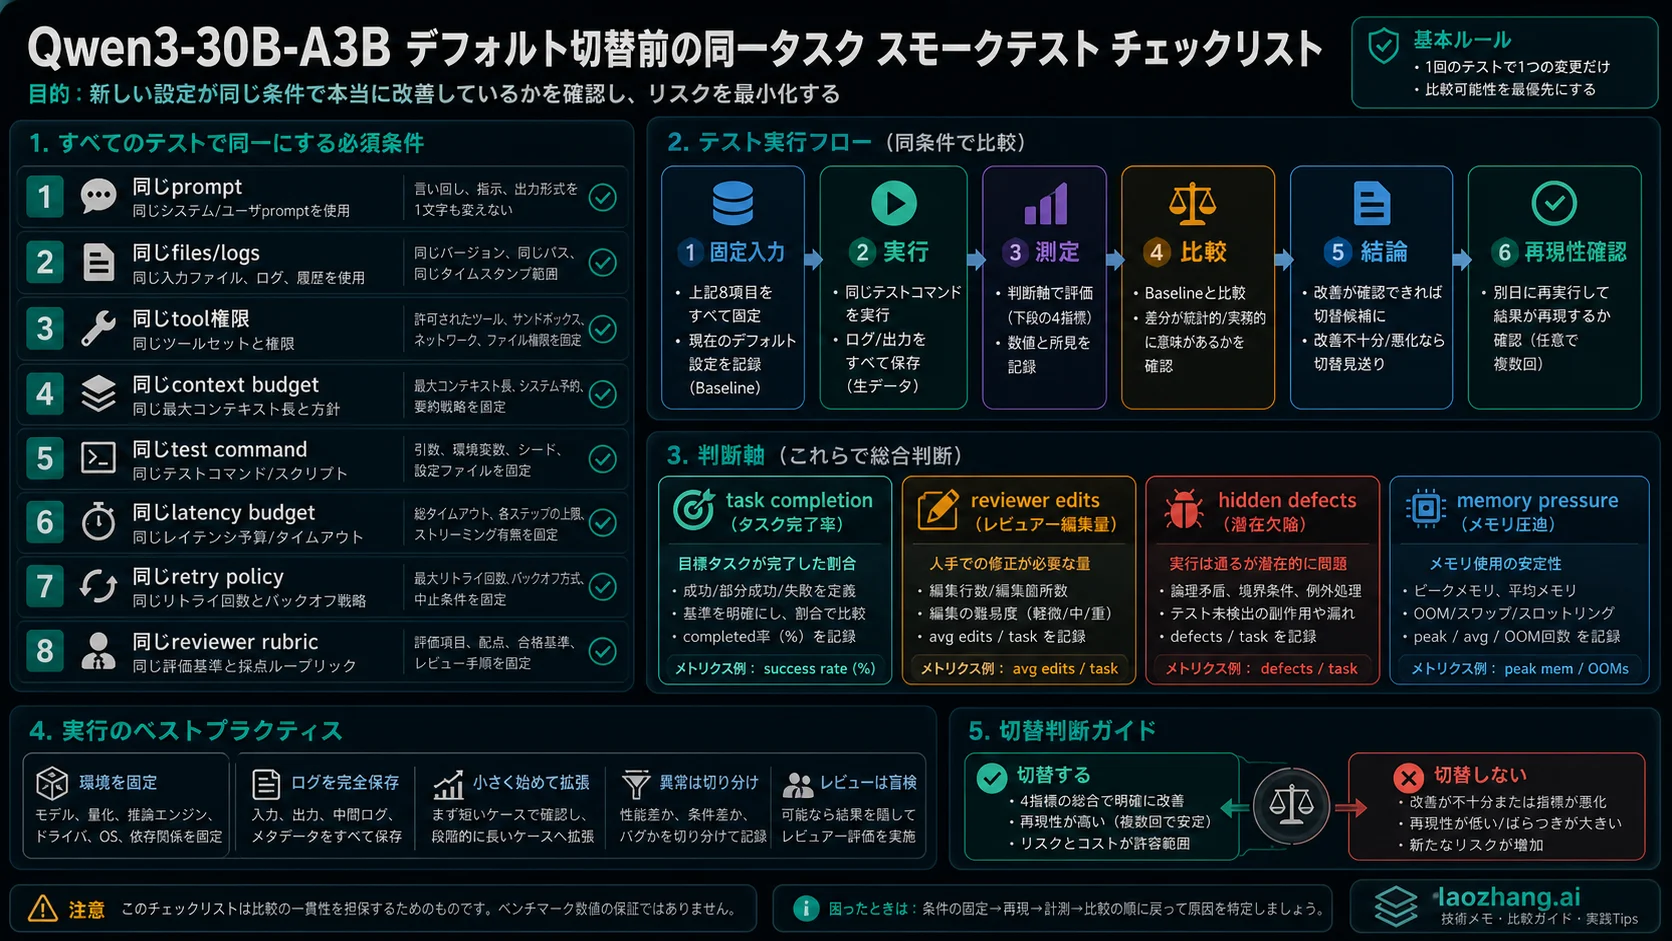
実際のプロジェクトに進む際も、同じ入力、量子化、コンテキスト長で比較すれば、モデルを変えた影響を判断しやすくなります。確認するのは、必要な修正で済むか、既存の動作を保てるか、テストで失敗が見つかるかです。短い関数が書けたことだけでは、複数ファイルにまたがる改修を任せられるとまでは言えません。
よくある質問
Qwen3-30B-A3Bは16GBのGPUでも使えますか?
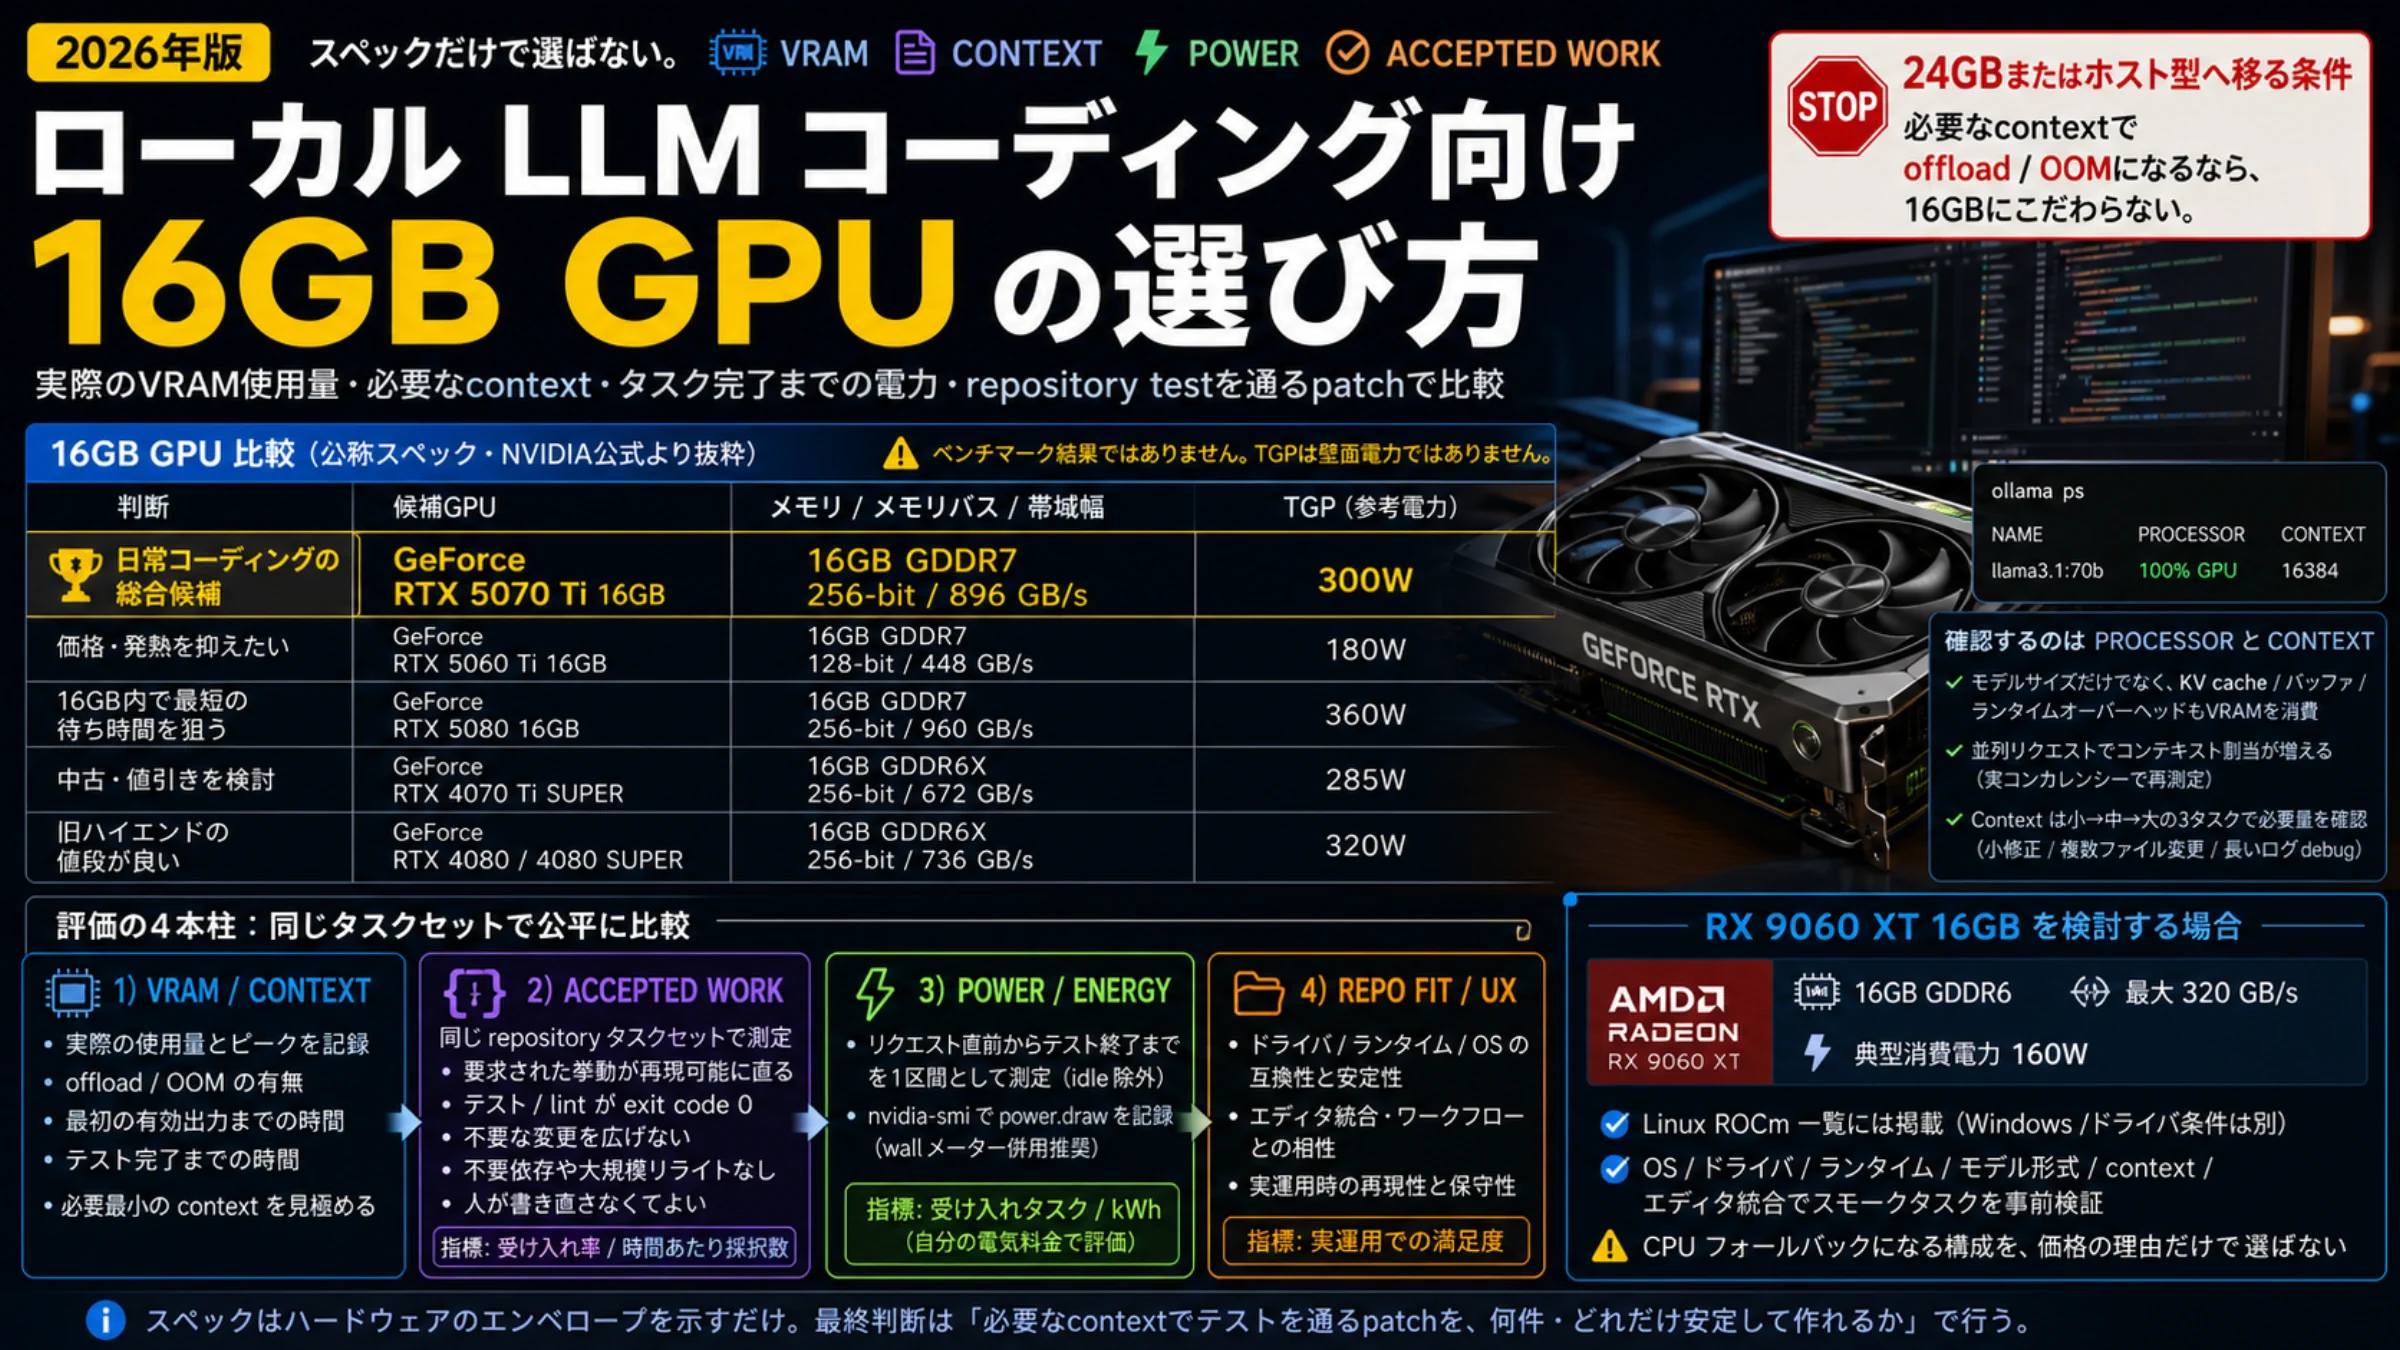
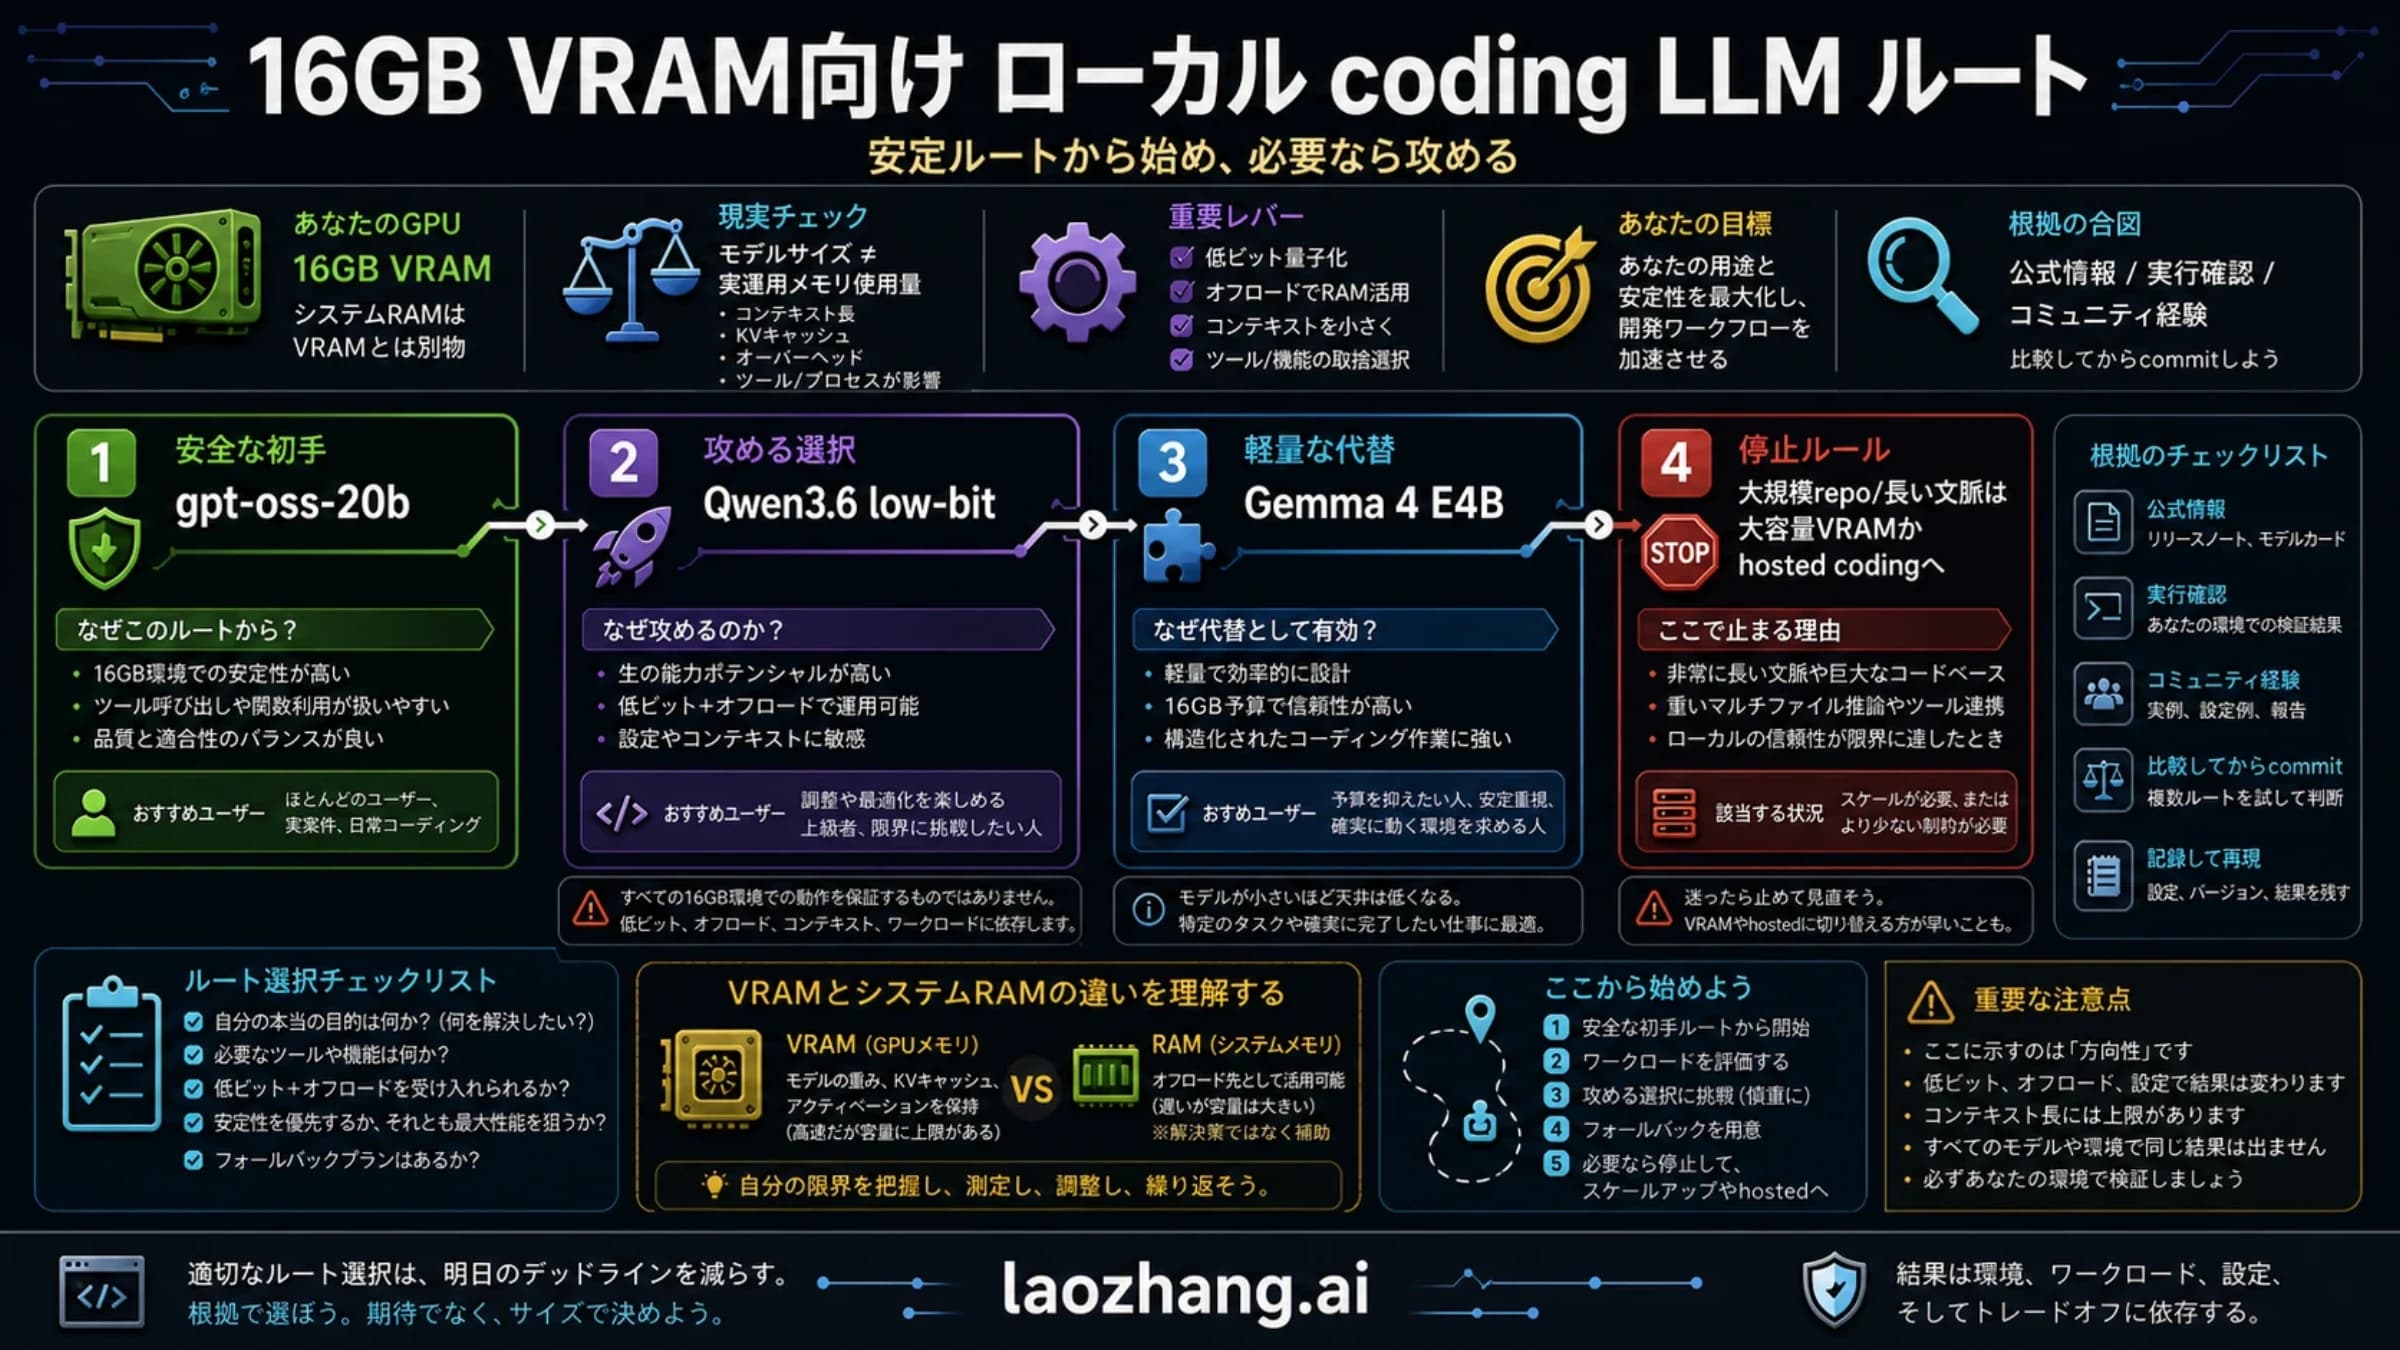
全重みをGPUに載せる前提なら、ここで紹介した約19GBのQ4_K_M配布物は16GB VRAMに収まりません。CPUへの一部配置や別の量子化で動く可能性はありますが、さらにKVキャッシュと実行時の領域が必要です。16GBという数字だけで可否や速度は決まりません。Ollamaの配布物のサイズと、自分の設定長を合わせて見てください。
原版とInstruct-2507のどちらを選ぶべきですか?
思考あり・なしを同じモデルで切り替えたいなら原版、回答を直接出す用途ならInstruct-2507を選びます。原版は標準32,768トークン、Instruct-2507は標準262,144トークンという違いもあります。原版とInstruct-2507のモデルカードを使い分けてください。
Thinking-2507で思考をオフにできますか?
Thinking-2507は思考専用です。通常の非思考回答が必要ならInstruct-2507に切り替えるか、切り替え式の原版を使います。Thinking-2507のモデルカードでは、思考専用であることが明示されています。
262K対応なら長い資料をそのまま入れられますか?
実行環境でその長さを割り当て、必要なメモリを確保していることが前提です。入力だけで262Kを使い切ると出力の余地がありません。num_ctx と ollama ps の CONTEXT を確認し、履歴と出力を含めた枠として考えてください。Ollamaのコンテキスト長の資料に確認方法があります。
Qwen3.8-27BはQwen3-30B-A3Bの新しい名前ですか?
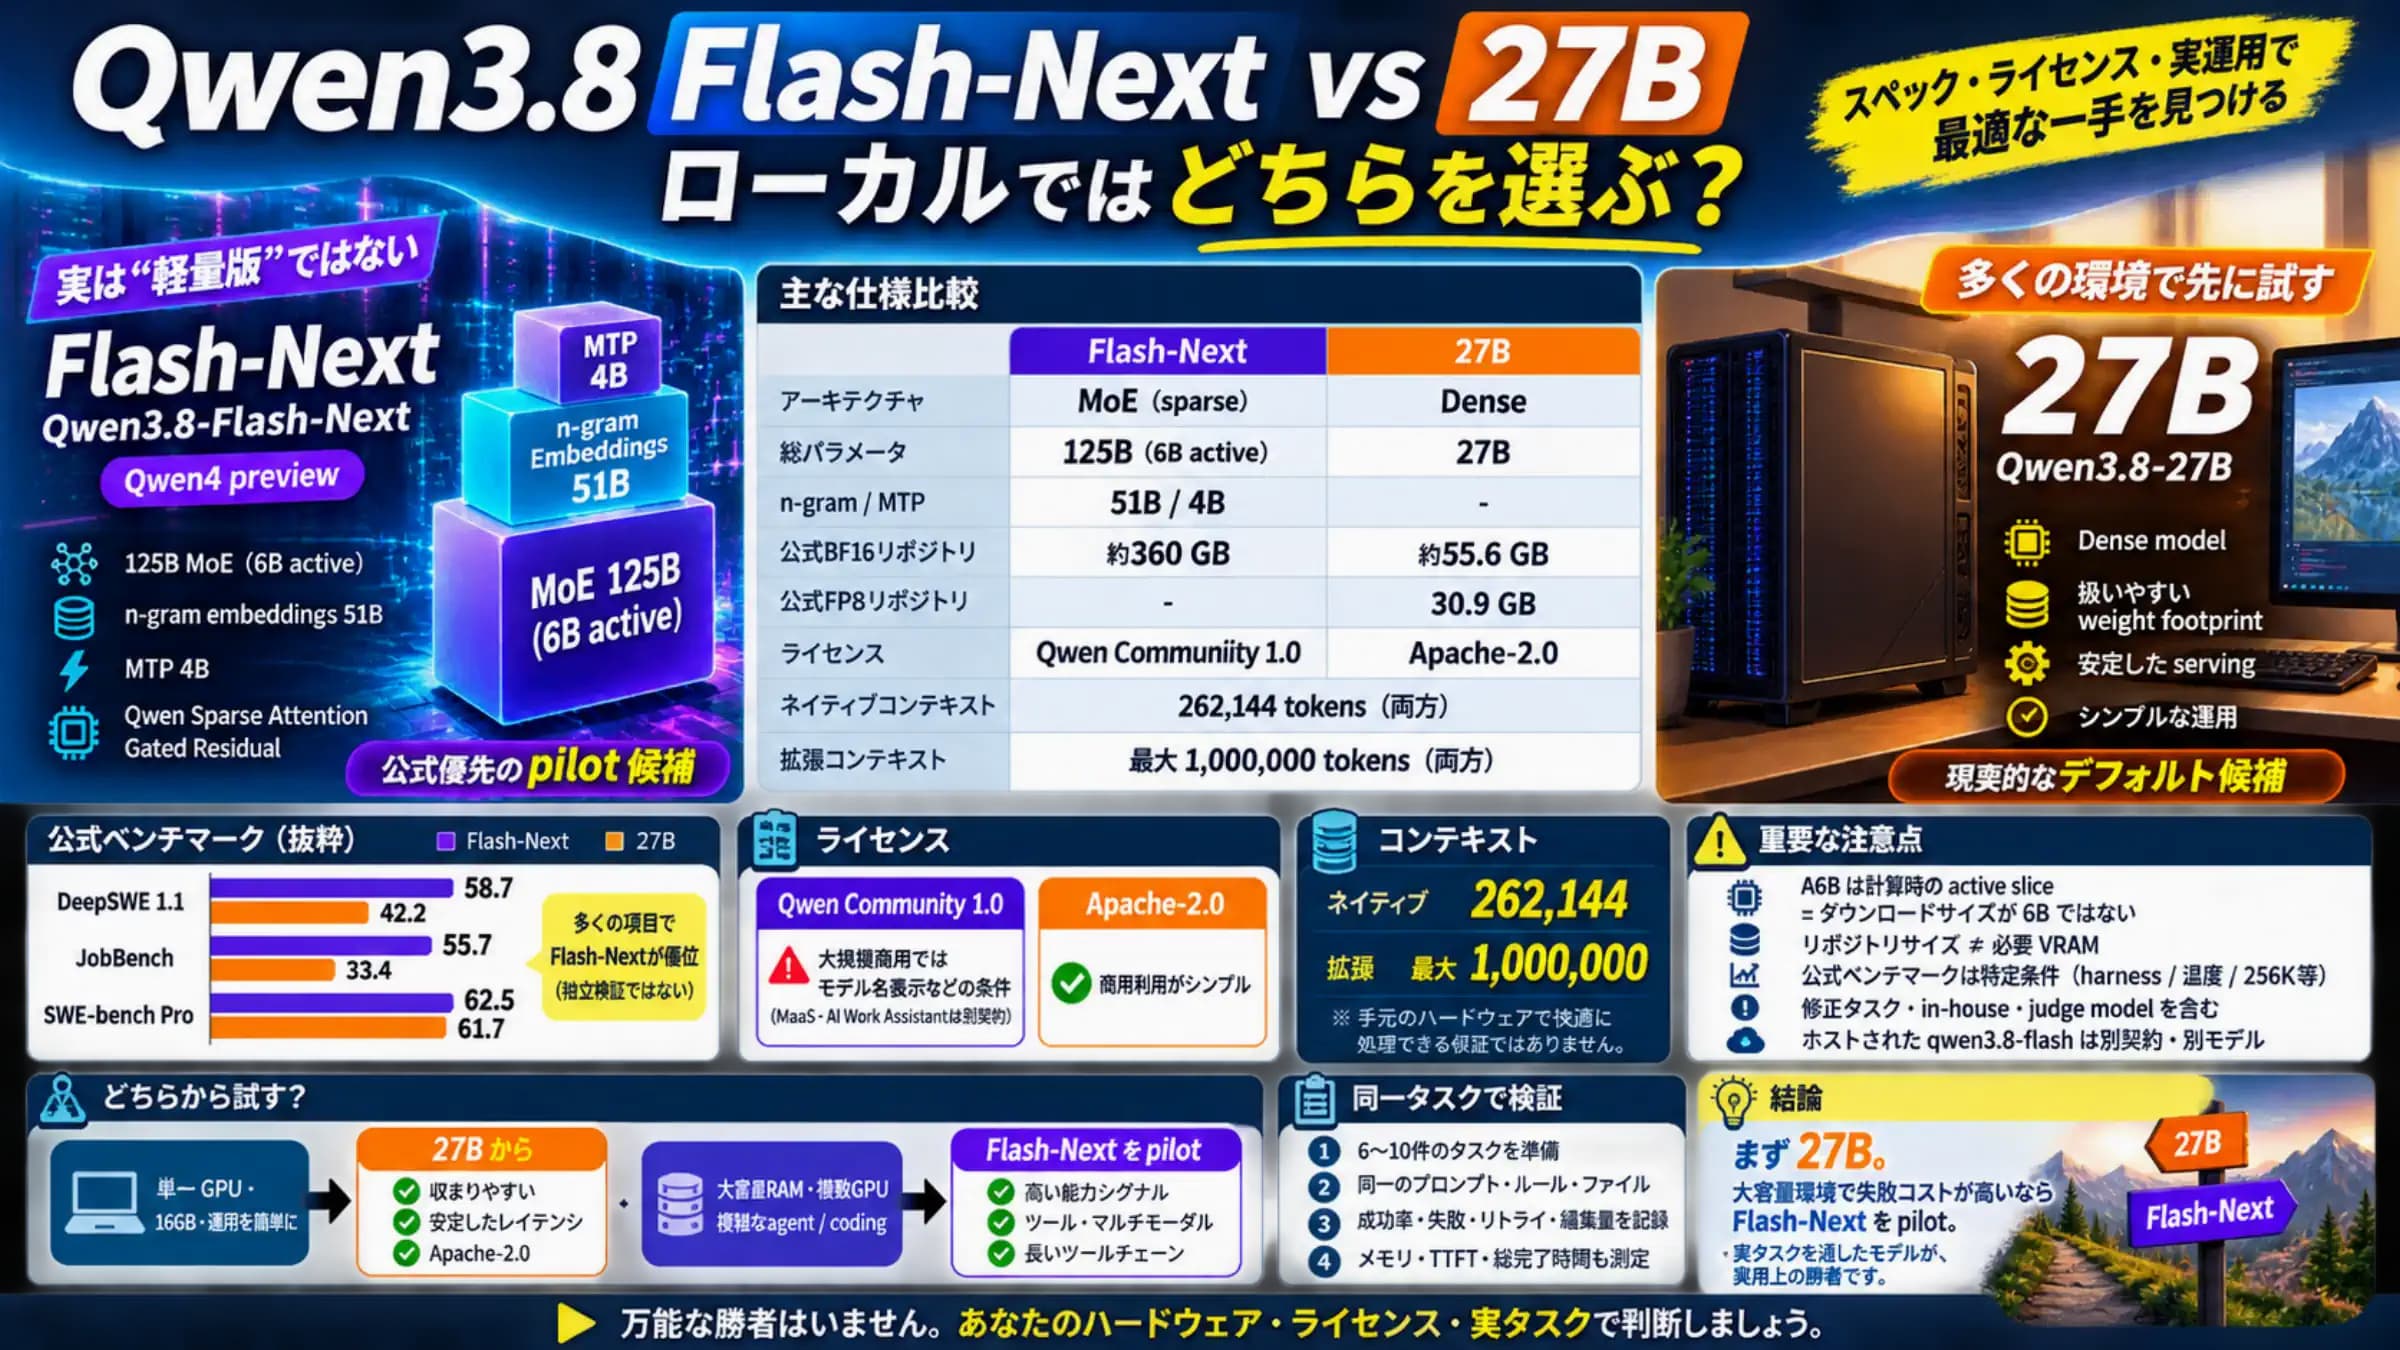
別のモデルです。Qwen3.8-27Bは画像も扱う27Bの密なモデルで、30B-A3BのMoEや2507の別名ではありません。Qwen3.6-35B-A3Bも別モデルです。数字が新しいことだけで、今の用途で速い、メモリが少なくて済む、回答が良いと決めることはできません。Qwen3.8-27Bのモデルカードで対象を区別できます。27BのGPU容量や長文設定を検討する場合は、Qwen3.8-27Bの必要VRAMと262K設定で、そのモデル固有の条件を確認してください。
参考資料14
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月8日。
参考資料14
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月8日。
- 1.原版のモデルカードhuggingface.co/Qwen/Qwen3-30B-A3B
- 2.Instruct-2507huggingface.co/Qwen/Qwen3-30B-A3B-Instruct-2507
- 3.Thinking-2507huggingface.co/Qwen/Qwen3-30B-A3B-Thinking-2507
- 4.Coderhuggingface.co/Qwen/Qwen3-Coder-30B-A3B-Instruct
- 5.このタグの公開ページollama.com/library/qwen3:30b-a3b-instruct-2507-q4_K_M
- 6.OllamaのModelfile資料github.com/ollama/ollama/blob/main/docs/modelfile.mdx
- 7.コンテキスト長の資料github.com/ollama/ollama/blob/main/docs/context-length.mdx
- 8.短いタグのページollama.com/library/qwen3:30b-a3b
- 9.OllamaのチャットAPIdocs.ollama.com/api/chat
- 10.コンテキストの指定方法docs.ollama.com/faq
- 11.Ollamaの思考機能の資料docs.ollama.com/capabilities/thinking
- 12.Coderの設定ファイルhuggingface.co/Qwen/Qwen3-Coder-30B-A3B-Instruct/blob/main/config.json
- 13.OllamaのCoder 30Bタグollama.com/library/qwen3-coder:30b
- 14.Qwen3.8-27Bのモデルカードhuggingface.co/Qwen/Qwen3.8-27B