Cómo usar GPT-6 Astra en Claude Code: proxy, plugin y coste real
Astra entra en Claude Code como modelo principal tras un proxy LiteLLM o por encargo con el plugin de Codex; ambas vías se probaron el 12 de noviembre de 2026.
En esta página
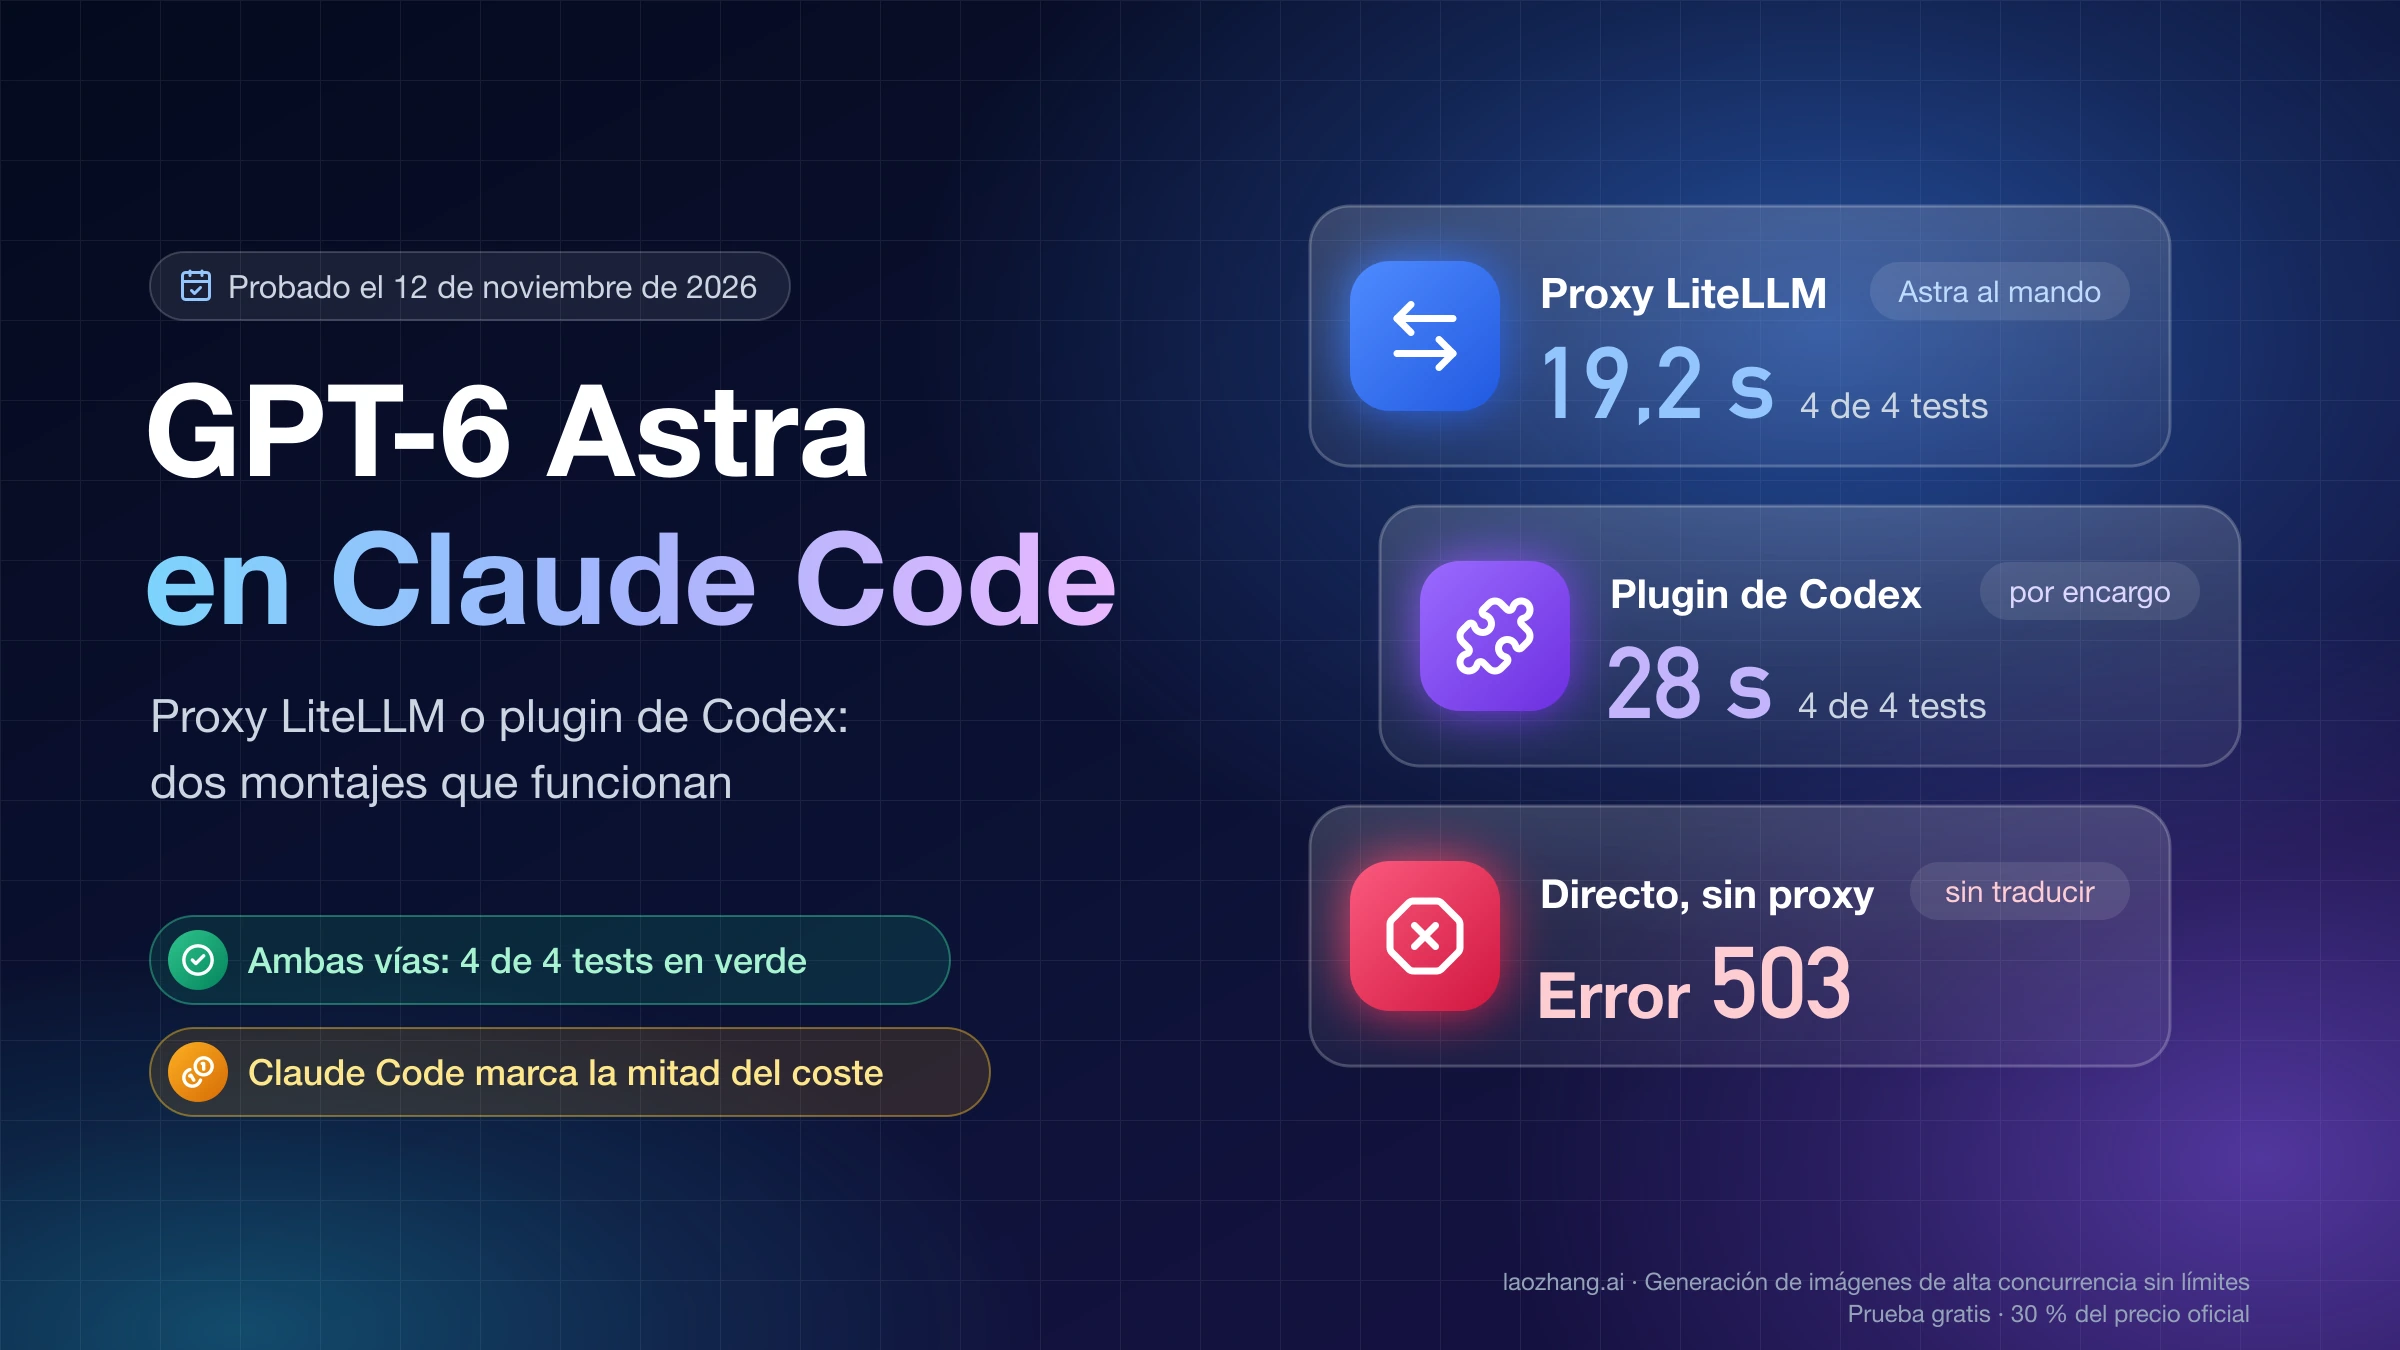
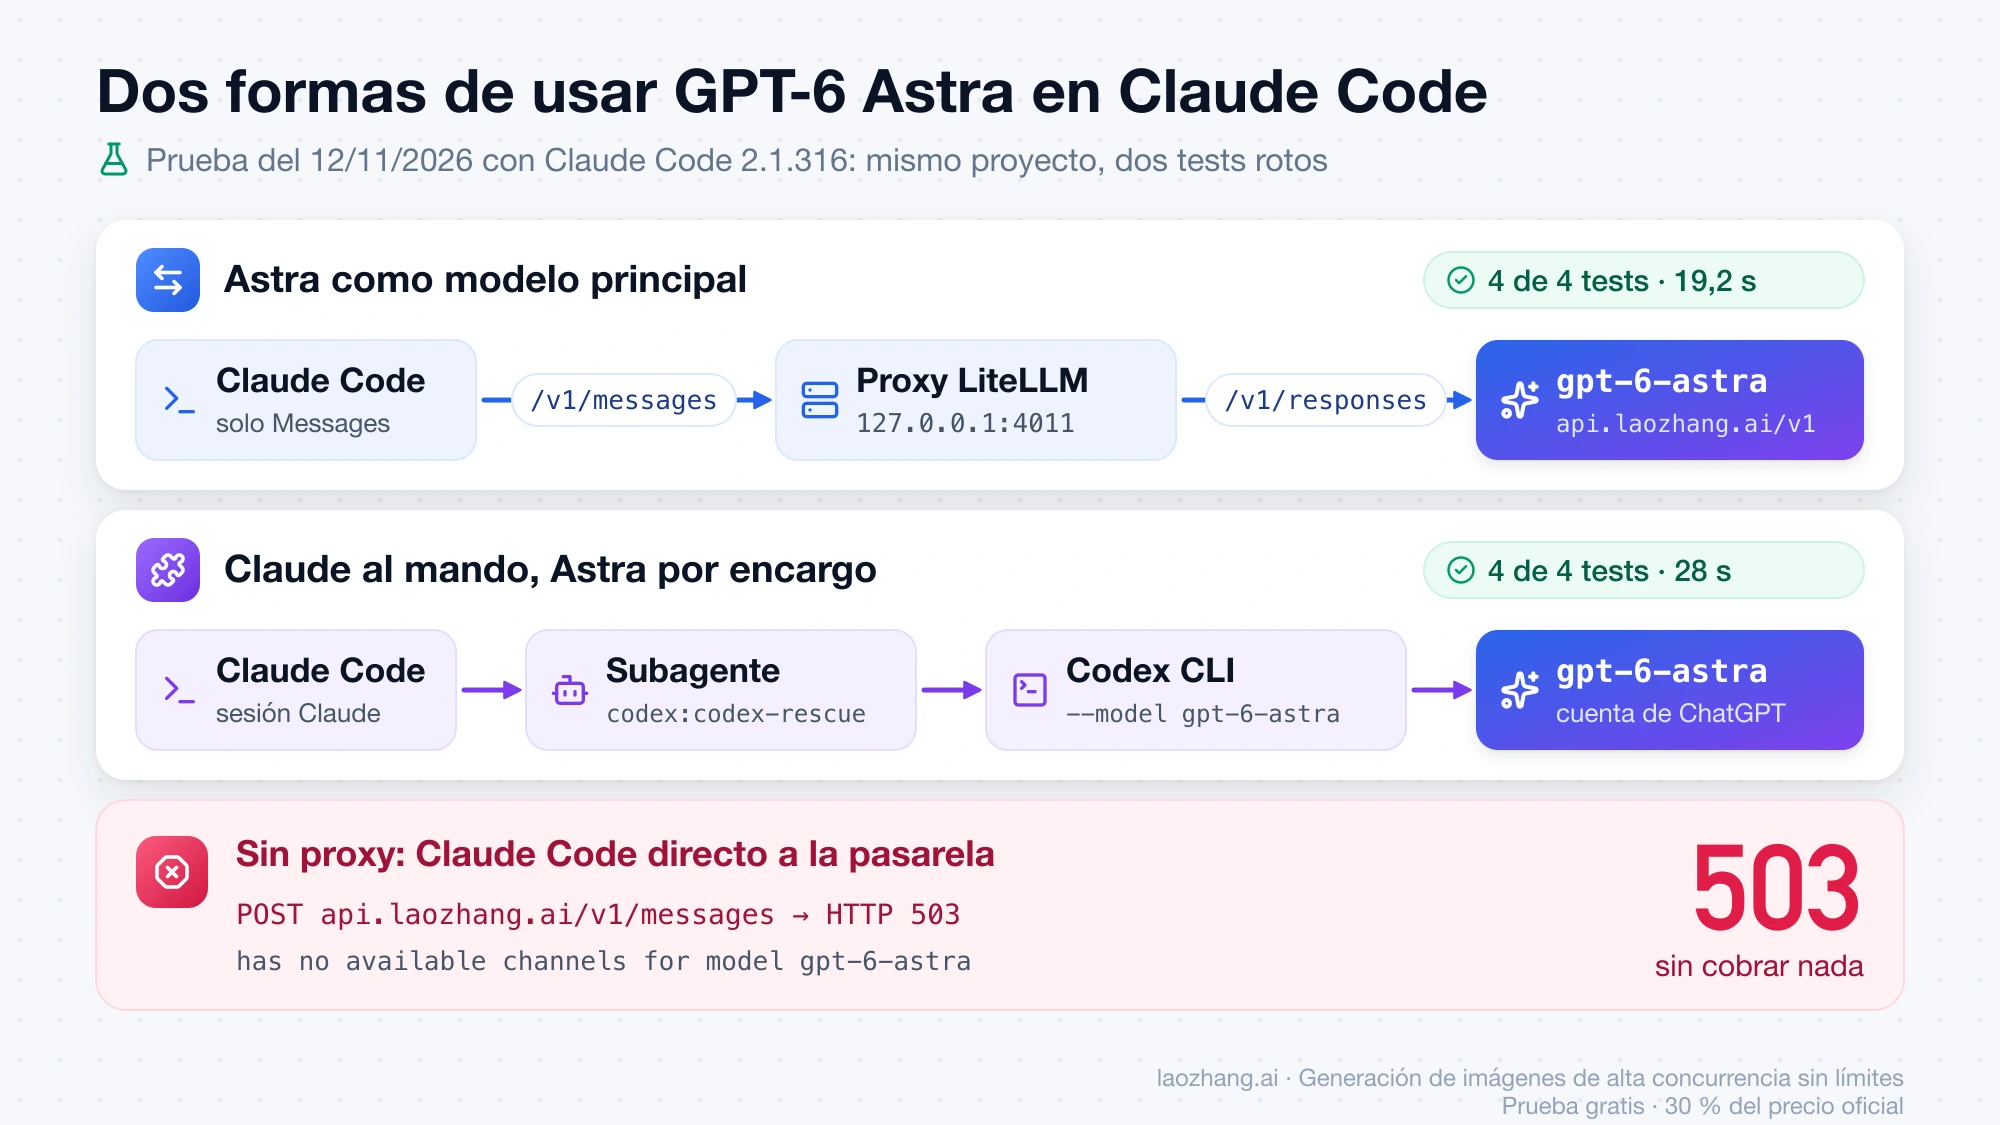
Puedes usar GPT-6 Astra en Claude Code, pero no hay ningún interruptor oficial: Claude Code solo habla el formato Messages de Anthropic, y Anthropic dice en su página sobre gateways LLM para Claude Code que no da soporte a enrutar Claude Code hacia modelos que no sean Claude. Funcionan dos montajes distintos. Si quieres que Astra sea el modelo principal, pones delante un proxy local que traduzca los formatos (LiteLLM), lo conectas a un endpoint compatible con OpenAI que sirva gpt-6-astra y apuntas Claude Code a ese proxy con ANTHROPIC_BASE_URL y gpt-6-astra en ANTHROPIC_MODEL, ANTHROPIC_DEFAULT_OPUS_MODEL y ANTHROPIC_DEFAULT_SONNET_MODEL. Si prefieres que Claude siga al mando y solo encargue trabajo a Astra, instalas el plugin oficial de Codex de OpenAI y delegas con /codex:rescue --model gpt-6-astra.
Las dos vías se probaron el 12 de noviembre de 2026 con Claude Code 2.1.316 sobre un proyecto Python pequeño con dos tests rotos. Con LiteLLM 1.109.1 y laozhang.ai como proveedor, Astra dejó los 4 tests en verde en 19,2 segundos; con el plugin de Codex 1.0.6 y una cuenta de ChatGPT, en 28 segundos. Lo que no funcionó fue el atajo: escribir gpt-6-astra en Claude Code y apuntarlo directamente a la pasarela, sin proxy que traduzca, devolvió un error 503.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Antes de elegir, ten presente una cosa del coste: con Astra como modelo principal, la cifra que imprime Claude Code sale más o menos a la mitad de lo que cuesta a precio de lista de OpenAI, porque Claude Code no tiene tarifa para ese modelo. Para saber lo que gastas, mira el panel de uso de tu proveedor.
¿Astra como modelo principal o Claude delegando en Astra?
La diferencia está en quién dirige la sesión y quién la paga. Con el proxy, Astra decide cada lectura, cada comando y cada edición, y pagas sus tokens con una clave de API. Con el plugin de Codex, Claude sigue siendo el modelo de la sesión, y Astra solo trabaja cuando le pasas una tarea; ese trabajo se descuenta de tus límites de Codex en ChatGPT (o de una clave de OpenAI), mientras que la conversación con Claude sigue saliendo de tu plan de Claude.
| Astra como modelo principal (proxy LiteLLM) | Claude al mando, Astra por encargo (plugin de Codex) | |
|---|---|---|
| Quién lleva el bucle | Astra elige herramientas y edita | Claude; un subagente pasa la tarea a Codex, que la ejecuta con Astra |
| Qué pagas | Tokens de Astra con una clave de API (OpenAI o un proveedor compatible) | Tu plan de Claude para la sesión, más los límites de Codex de ChatGPT o una clave de OpenAI |
| Qué necesitas | LiteLLM, una clave de API y seis variables de entorno | Node.js 18.18 o superior, Codex CLI con sesión iniciada y el plugin |
| Respaldo del fabricante | Ninguno: Anthropic no da soporte a modelos que no sean Claude | El plugin lo publica OpenAI |
| Qué se resiente | La cifra de coste, el aviso de modelo no reconocido y funciones no probadas | Si no indicas --model, Codex usa su modelo por defecto, no necesariamente Astra |
| Prueba del 12/11/2026 | 4 de 4 tests en 19,2 s, unos 0,23 USD a precio de lista | 4 de 4 tests en 28 s con la suscripción de ChatGPT |
Si lo que buscas es que Astra haga todo el trabajo y ya pagas la API de OpenAI o de un proveedor compatible, el proxy es la vía. Si te gusta cómo planifica Claude y quieres usar Astra como segunda mano o como revisor, sin abrir otra cuenta de API, el plugin es más sencillo y lo mantiene el propio OpenAI. Hay una tercera herramienta para el primer montaje, Claude Code Router (v3.1.3, una app de escritorio que levanta una pasarela local en http://127.0.0.1:3456 y admite proveedores con formato OpenAI Chat o Responses según su repositorio de Claude Code Router en GitHub); hace lo mismo que LiteLLM, pero no se usó en las pruebas.
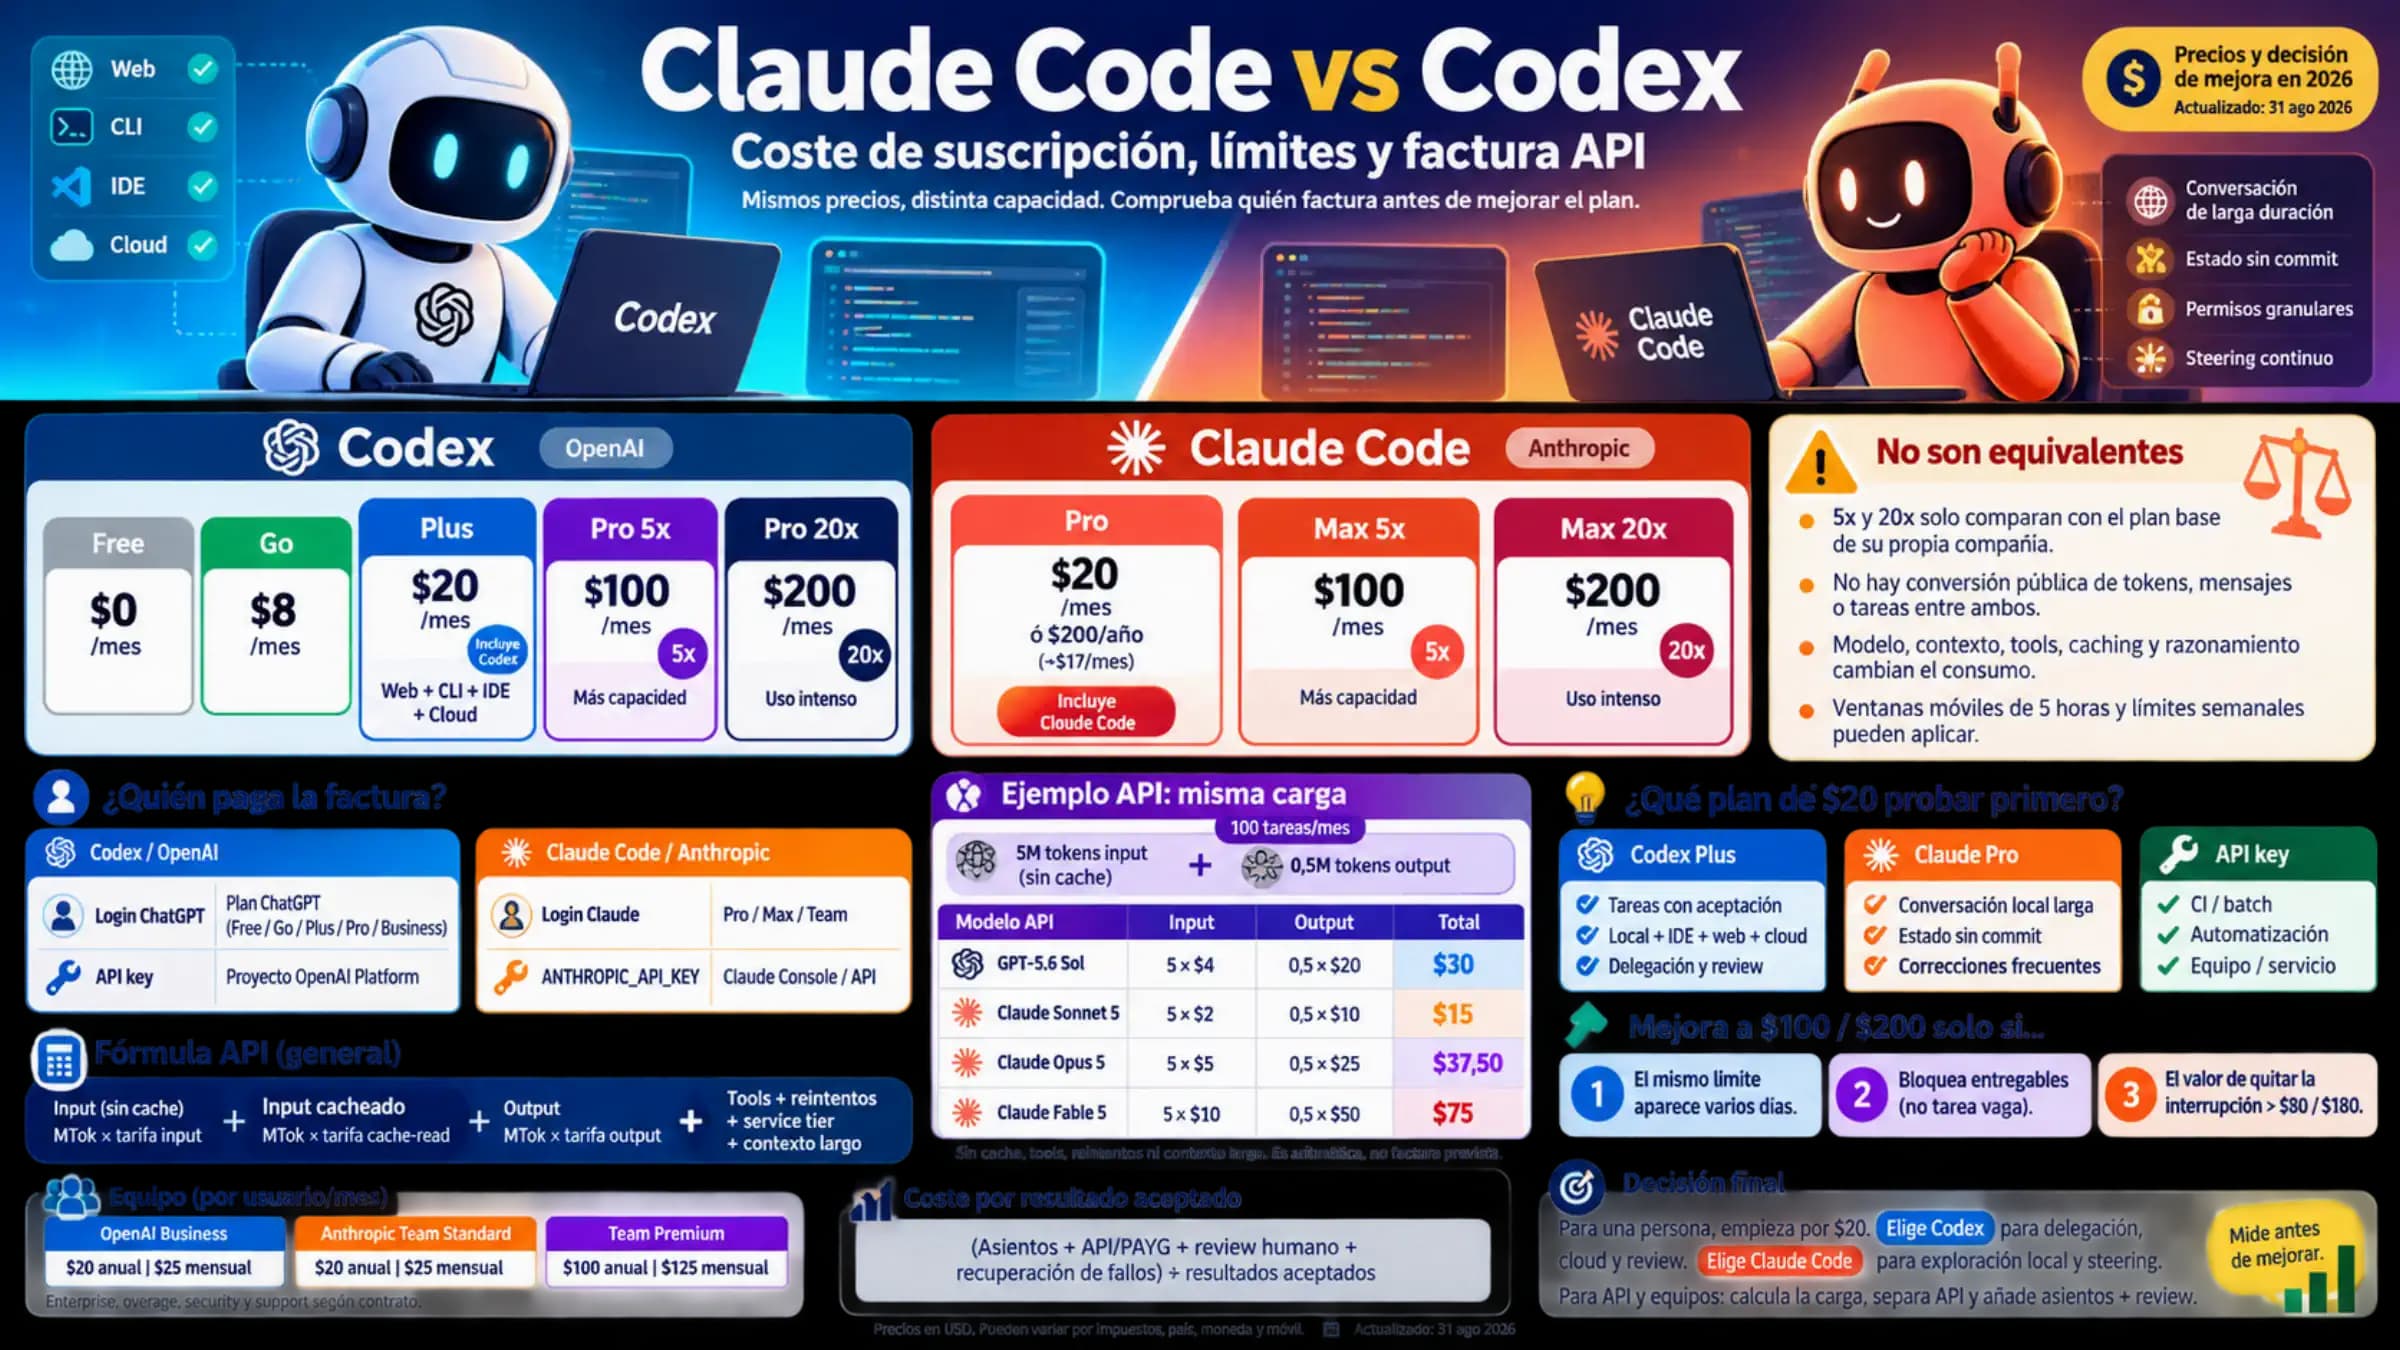
Si la duda es de modelo y no de montaje, la comparación de calidad y coste está en Fable 5.2 vs GPT-6 Astra: niveles equivalentes y coste por tarea. Si es de herramienta, lo que cuesta cada suscripción está en Claude Code vs Codex: coste de suscripción, límites y factura API.
Configurar Claude Code con OpenAI a través de LiteLLM, paso a paso
Para que Astra sea el modelo principal, Claude Code tiene que hablar con algo que entienda su formato Messages y lo traduzca al de OpenAI. LiteLLM hace exactamente eso: publica un endpoint /v1/messages en tu máquina y reenvía cada petición a OpenAI o a cualquier proveedor compatible. Es la vía que documenta el propio LiteLLM en su tutorial Use Claude Code with Non-Anthropic Models, y la que funcionó el 12 de noviembre de 2026 con LiteLLM 1.109.1 y Claude Code 2.1.316.
-
Instala LiteLLM con el proxy. El tutorial de LiteLLM usa
uv; fija la versión si quieres reproducir la prueba tal cual:uv tool install 'litellm[proxy]==1.109.1' -
Crea
litellm-config.yaml. Esta es la configuración usada en la prueba, con laozhang.ai como proveedor compatible con OpenAI:model_list: - model_name: gpt-6-astra litellm_params: model: openai/gpt-6-astra api_base: https://api.laozhang.ai/v1 api_key: os.environ/LAOZHANG_API_KEY - model_name: gpt-6-luna litellm_params: model: openai/gpt-6-luna api_base: https://api.laozhang.ai/v1 api_key: os.environ/LAOZHANG_API_KEY litellm_settings: drop_params: truemodel_namees el nombre que pedirá Claude Code;openai/le dice a LiteLLM que el destino habla el formato de OpenAI, ydrop_params: truedescarta los parámetros que el destino no acepta. Con una clave de OpenAI directa, el patrón que documenta LiteLLM es el mismo sin la líneaapi_basey conapi_key: os.environ/OPENAI_API_KEY; esa variante no formó parte de la prueba. -
Arranca el proxy.
LITELLM_MASTER_KEYes la clave del propio proxy (invéntala larga); es la que usará Claude Code, no la del proveedor:export LAOZHANG_API_KEY="tu-clave-del-proveedor" export LITELLM_MASTER_KEY="sk-una-clave-local-larga" litellm --config litellm-config.yaml --host 127.0.0.1 --port 4011 -
Antes de tocar Claude Code, comprueba el proxy desde otra terminal con una petición en formato Anthropic. Exporta allí también
LITELLM_MASTER_KEY:curl -s http://127.0.0.1:4011/v1/messages \ -H "Authorization: Bearer $LITELLM_MASTER_KEY" \ -H "Content-Type: application/json" \ -d '{"model": "gpt-6-astra", "max_tokens": 256, "messages": [{"role": "user", "content": "Reply with exactly one word: connected"}]}'La respuesta debe llevar
"model":"gpt-6-astra". En la prueba, la misma llamada con una herramienta definida devolvió"stop_reason":"tool_use", que es lo que necesita Claude Code para leer y editar archivos. -
En esa segunda terminal, apunta Claude Code al proxy y arráncalo:
export ANTHROPIC_BASE_URL="http://127.0.0.1:4011"
export ANTHROPIC_AUTH_TOKEN="$LITELLM_MASTER_KEY"
export ANTHROPIC_MODEL="gpt-6-astra"
export ANTHROPIC_DEFAULT_OPUS_MODEL="gpt-6-astra"
export ANTHROPIC_DEFAULT_SONNET_MODEL="gpt-6-astra"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="gpt-6-luna"
export CLAUDE_CODE_MAX_CONTEXT_TOKENS=272000
claude
Las cuatro variables de modelo están porque Claude Code no pide un solo modelo. Sin --model, la sesión principal usa el que diga ANTHROPIC_DEFAULT_OPUS_MODEL; los subagentes heredan el modelo de la sesión, y ANTHROPIC_DEFAULT_HAIKU_MODEL recibe peticiones menores, como la que pone título a la sesión. Si dejas alguna sin definir, Claude Code pide un ID de Claude que el proxy no tiene en su lista. En la variable de Haiku puedes poner cualquier modelo de tu configuración; en la prueba fue gpt-6-luna. Cómo funcionan estas variables con otro modelo, paso a paso, está en GLM-5.3-Flash en Claude Code: configuración, effort y créditos.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
CLAUDE_CODE_MAX_CONTEXT_TOKENS=272000 es opcional y es una elección, no una recomendación oficial. Claude Code no conoce gpt-6-astra, así que supone una ventana de 200.000 tokens y compacta la conversación al llegar ahí; con 272.000 le das más margen y la conversación se compacta antes de cruzar los 272.000 tokens de entrada, a partir de los cuales OpenAI cobra la petición entera a la tarifa alta. La ventana real de Astra es de 1.050.000 tokens, así que aquí el límite lo pone el precio, no el modelo.
Las mismas claves se pueden poner en el bloque env de ~/.claude/settings.json en vez de exportarlas en la terminal; qué fuente gana si tienes varias está en Configuración de Claude Code API: claves, settings.json, modelos y gateways. En la prueba, Claude Code se arrancó además con un directorio de configuración vacío (CLAUDE_CONFIG_DIR), sin ajustes, plugins ni memoria; usar uno aparte para Astra evita mezclarlo con tu configuración habitual de Claude.
Cómo comprobar que responde gpt-6-astra y no Claude
La confirmación no está en lo que diga el modelo, sino en tres sitios que puedes mirar tú: la cabecera de Claude Code, /status y el registro del proxy. En la sesión interactiva del 12 de noviembre de 2026, la cabecera mostraba gpt-6-astra · API Usage Billing y, debajo, el aviso ⚠ Model "gpt-6-astra" isn't recognized · context assumed to be 200k tokens, que aparece cuando no defines CLAUDE_CODE_MAX_CONTEXT_TOKENS. /status listaba Auth token: ANTHROPIC_AUTH_TOKEN, Anthropic base URL: http://127.0.0.1:4011 y Model: gpt-6-astra; si en lugar de eso ves tu cuenta de Claude o api.anthropic.com, alguna variable no ha llegado a la sesión.
El registro de LiteLLM es la prueba más fuerte: si arrancas el proxy con --detailed_debug, muestra el modelo y la URL de destino de cada llamada. En la sesión interactiva de la prueba, un solo mensaje del usuario generó tres peticiones, dos a gpt-6-astra y una a gpt-6-luna para el título de la sesión, y en todas las ejecuciones las llamadas salieron hacia https://api.laozhang.ai/v1/responses, la API Responses, pese al prefijo openai/ de la configuración. Eso importa, porque en la API de OpenAI Astra solo admite llamadas a herramientas por Responses, no por Chat Completions. El mismo registro muestra un HEAD /api/hello con 404 al arrancar; es inofensivo.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
En la ejecución sin interfaz, Astra arregló el archivo con seis llamadas al proveedor y siete turnos: ejecutó los tests, buscó con Glob, leyó dos archivos, editó uno y volvió a ejecutar los tests. Al final contestó «I am GPT-6 Astra (gpt-6-astra)», pero esa frase sola no prueba nada; lo que la confirma es que el registro del proxy y /status dicen lo mismo. Claude Code envió ocho valores de anthropic-beta y el campo output_config, y ninguna de las ejecuciones devolvió un 400.
¿Cuánto cuesta Astra en Claude Code? El doble de lo que marca
La tarea de prueba costó 0,228 USD a precio de lista de OpenAI con el effort por defecto, y Claude Code imprimió 0,114 USD. La diferencia es sistemática: en las tres ejecuciones, la cifra de Claude Code es la mitad, porque no tiene tarifa para gpt-6-astra y su salida JSON lo marca como costBasis: "unknown". Para presupuestar, usa el panel de uso de tu proveedor, no la línea de coste de Claude Code.
CLAUDE_CODE_EFFORT_LEVEL | Llegó a Astra como | Tiempo y turnos | Tokens de salida (de razonamiento) | Precio de lista | Lo que marcó Claude Code |
|---|---|---|---|---|---|
| Sin definir | high | 19,2 s, 7 turnos | 521 (37) | 0,228 USD | 0,114 USD |
low | low | 17,5 s, 5 turnos | 364 (0) | 0,203 USD | 0,101 USD |
max | max | 34,4 s, 9 turnos | 1.531 (963) | 0,289 USD | 0,144 USD |
Las tres ejecuciones dejaron los 4 tests en verde el 12 de noviembre de 2026. El precio de lista sale de multiplicar el uso que devolvió el proveedor por las tarifas de Astra en OpenAI (a 10 de noviembre de 2026, por millón de tokens: 10 USD de entrada, 12,50 USD por escritura en caché, 1 USD por lectura de caché y 50 USD de salida). Para la ejecución por defecto: 12 × 10 + 11.728 × 12,50 + 55.265 × 1 + 521 × 50 = 228.035, dividido entre un millón, 0,228 USD. Es una estimación, no una factura: un proveedor como laozhang.ai cobra según su propia tarifa.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Casi dos tercios de ese coste (0,147 USD, el 64 %) es la primera escritura en caché de unos 11.700 tokens: el prompt de sistema y las definiciones de herramientas que Claude Code envía siempre. Por eso hasta la tarea más corta, con effort low, ronda los 0,20 USD; en cambio, mientras la caché siga activa, las peticiones siguientes de una sesión vuelven a leer ese bloque a 1 USD por millón. Una sesión real es mucho más grande que esta prueba, y si una sola petición supera los 272.000 tokens de entrada, OpenAI cobra la petición entera a 20 USD de entrada y 75 USD de salida por millón. La tabla completa está en Precio de la API de GPT-6 Astra: coste con caché y contexto largo.
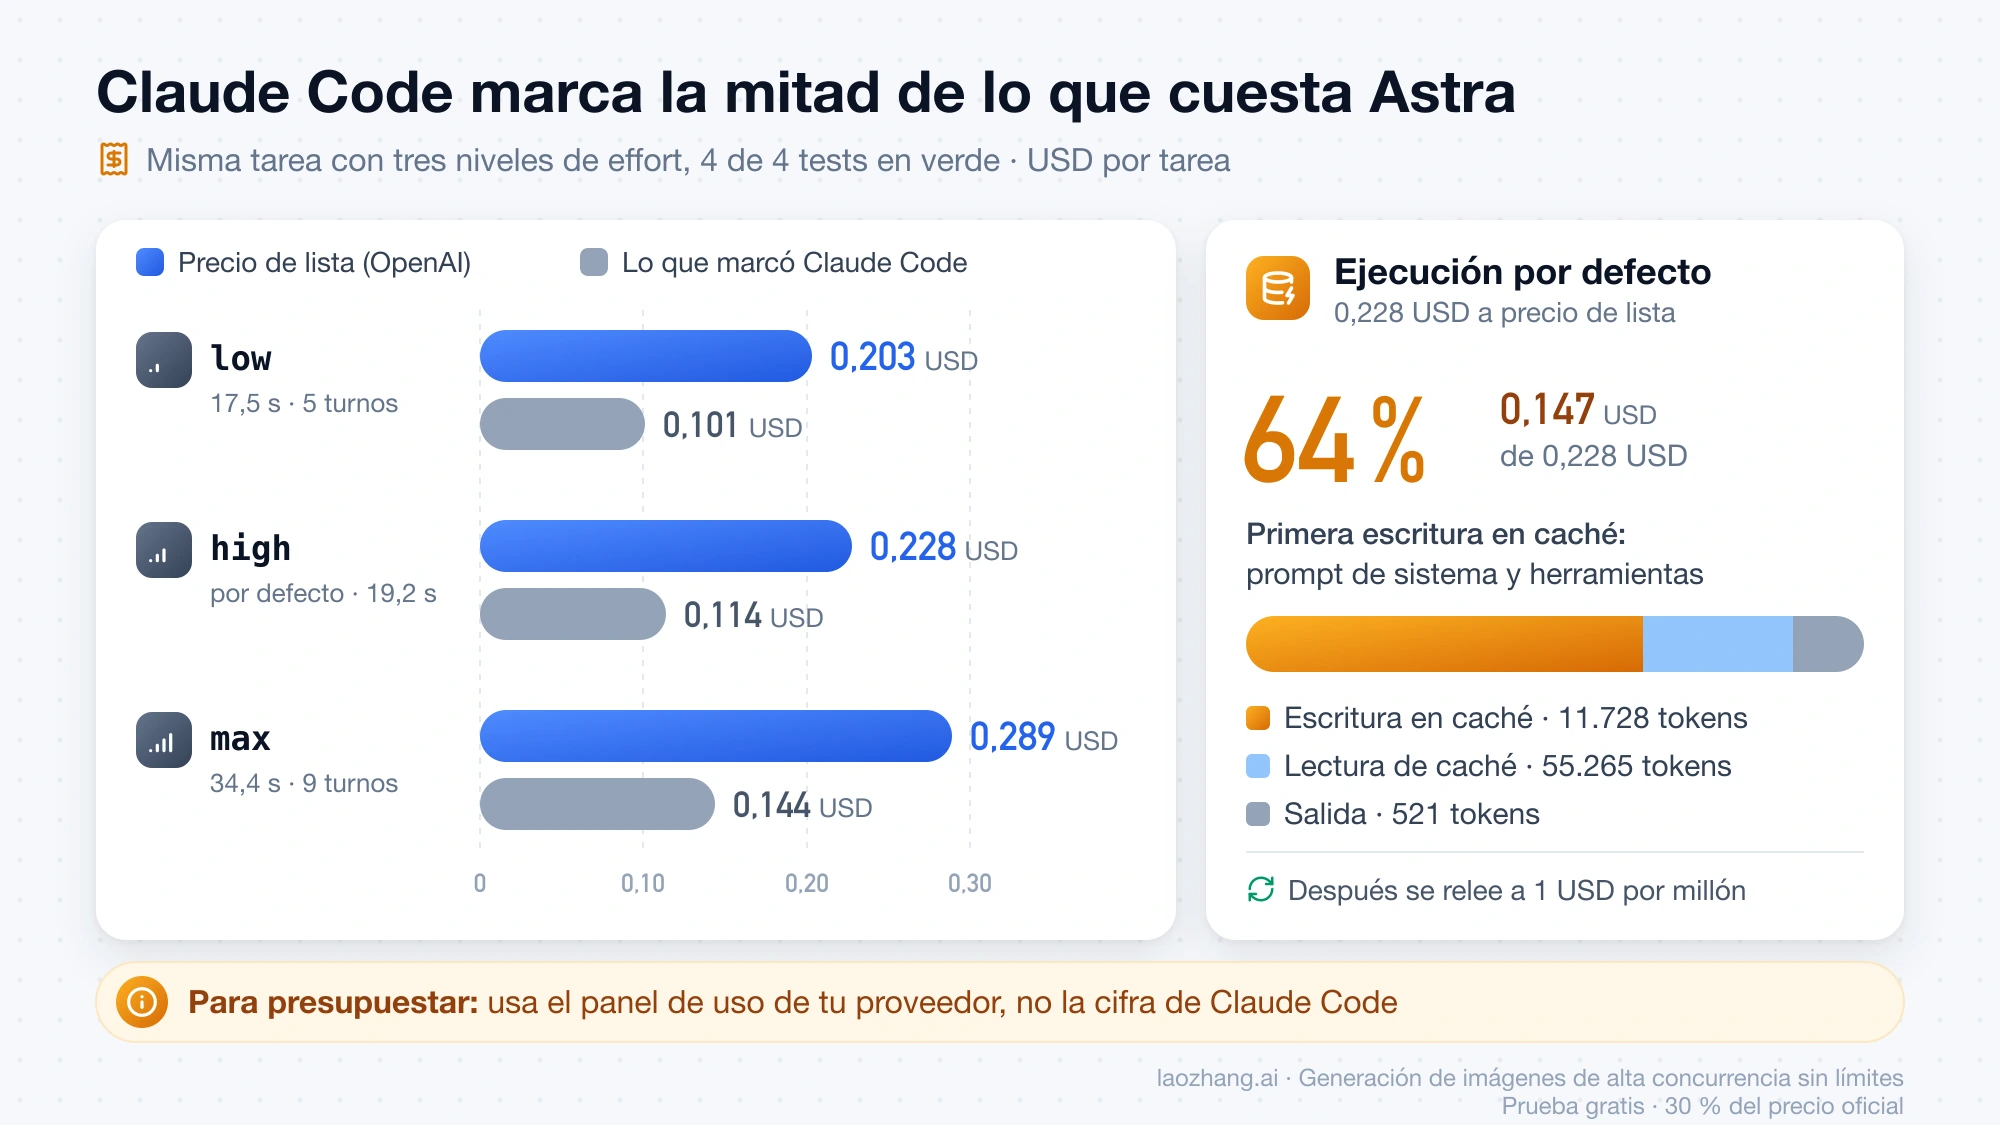
La tabla también responde a si se respeta el effort: lo que pones en Claude Code llega a Astra como reasoning.effort, y sin definirlo viaja high. Astra acepta de low a max, no none ni minimal. Con una sola muestra por nivel y una tarea fácil, esto demuestra que la correspondencia funciona, no qué nivel conviene; para eso, y para saber por qué el effort cambia solo, mira Claude Code effort level: qué es y por qué vuelve a medium.
Delegar tareas en Astra con el plugin de Codex y /codex:rescue
Si Claude debe seguir siendo tu modelo principal, el plugin openai/codex-plugin-cc añade a Claude Code comandos que pasan trabajo a Codex, el agente de OpenAI, y con --model gpt-6-astra ese trabajo lo hace Astra. Necesitas Node.js 18.18 o superior y Codex CLI con sesión iniciada, con una cuenta de ChatGPT o una clave de API de OpenAI; el plugin usa la instalación, la sesión y la configuración de Codex que ya tengas en la máquina.
-
Dentro de Claude Code, añade el repositorio del plugin, instálalo y recarga:
/plugin marketplace add openai/codex-plugin-cc /plugin install codex@openai-codex /reload-plugins -
Ejecuta
/codex:setup. Comprueba si Codex está instalado y con sesión iniciada, y si falta puede ofrecerte instalarlo con npm (npm install -g @openai/codex). Si no has iniciado sesión, escribe!codex loginen la misma sesión de Claude Code. -
Delega la tarea nombrando el modelo y el effort:
/codex:rescue --model gpt-6-astra --effort medium arregla los tests que fallan en textkit/slug.py -
Si quieres que Astra sea siempre el modelo por defecto del plugin en un proyecto, crea
.codex/config.tomlen la raíz conmodel = "gpt-6-astra"ymodel_reasoning_effort = "medium". Según el README del plugin, esa configuración de proyecto solo se carga si el proyecto es de confianza para Codex; la de usuario va en~/.codex/config.toml.
El paso 3 importa más de lo que parece. El subagente codex:codex-rescue no pasa --model si no lo escribes, y entonces Codex usa su modelo por defecto, que puede no ser Astra. También añade --write por defecto, así que Codex edita tus archivos, y el propio subagente funciona con model: sonnet, de modo que la coordinación sigue consumiendo de tu plan de Claude. Para revisiones, /codex:review es de solo lectura; la puerta de revisión opcional (/codex:setup --enable-review-gate) puede agotar los límites rápido, según avisa el propio README.
El 12 de noviembre de 2026, con el plugin 1.0.6 y Codex CLI 0.166.0 con sesión de ChatGPT, el script que ejecuta ese subagente (codex-companion.mjs task --write --model gpt-6-astra --effort medium) resolvió la misma tarea en 28 segundos con los 4 tests en verde, y el archivo de sesión de Codex registró "model":"gpt-6-astra" y "reasoning_effort":"medium". Se ejecutó el script directamente, no el comando /codex:rescue escrito en una sesión interactiva de Claude. Gastó 130.507 tokens de entrada (112.128 de caché) y 369 de salida, pero esos totales no se comparan con los del proxy: el effort y el agente que ejecuta la tarea son distintos.
¿Sirve tu suscripción de ChatGPT en vez de una clave de API? Sí, por esta vía, y el uso cuenta contra tus límites de Codex. A 26 de octubre de 2026, los planes Free y Go recibían GPT-6 Luna en Codex, no Astra; Plus y Business estándar tenían entre 5 y 45 mensajes locales de Astra cada 5 horas, y Pro no tenía límite de 5 horas. Existen proxies de la comunidad que reutilizan el inicio de sesión de ChatGPT para poner Astra como modelo principal de Claude Code, pero funcionan al margen de lo que documentan OpenAI y Anthropic; la vía publicada por un fabricante para usar la suscripción es este plugin.
Errores al usar Astra en Claude Code: 503, modelo no reconocido y 400
Los tres mensajes que vas a ver primero tienen causas muy distintas: el 503 sale de la pasarela, el aviso de modelo no reconocido es de Claude Code y no bloquea nada, y el 400 aparece cuando el proxy no adapta la petición.
503 «has no available channels for model gpt-6-astra»
Este error aparece si apuntas ANTHROPIC_BASE_URL directamente a una pasarela cuyo endpoint en formato Claude no tiene Astra. El 12 de noviembre de 2026, una llamada POST https://api.laozhang.ai/v1/messages con gpt-6-astra devolvió HTTP 503 con Current group default has no available channels for model gpt-6-astra under billing mode [pay-as-you-go, pay-per-request], sin cobrar nada. Claude Code 2.1.316 mostró lo mismo así:
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
API Error: 503 Current group default has no available channels for model gpt-6-astra under billing mode [pay-as-you-go, pay-per-request] (request id: …). This is a server-side issue, usually temporary — try again in a moment. If it persists, check your inference gateway (api.laozhang.ai).El «usually temporary» es el texto genérico de Claude Code para cualquier 5xx: aquí no se arregla esperando mientras la pasarela no añada ese canal, porque solo sirve Astra por sus endpoints compatibles con OpenAI (/v1/chat/completions y /v1/responses), y su página de Claude Code no incluye ningún modelo GPT. La solución es poner LiteLLM delante y apuntarlo al endpoint /v1 de la misma pasarela, como en la configuración de arriba. Si tu pasarela dice que traduce el formato en su servidor, pruébalo con un curl a su /v1/messages antes de cambiar Claude Code.
Aviso «Model "gpt-6-astra" isn't recognized · context assumed to be 200k tokens»
No es un error: Claude Code avisa de que no conoce el ID y supone una ventana de 200.000 tokens, que es donde compactará la conversación. Según la guía de configuración de modelos de Claude Code, CLAUDE_CODE_MAX_CONTEXT_TOKENS declara otra ventana y, para un ID que no empieza por claude- y no lleva [1m], se aplica por sí sola. En la prueba, con CLAUDE_CODE_MAX_CONTEXT_TOKENS=272000 la salida JSON de Claude Code registró contextWindow: 272000 y el aviso desapareció. No añadas [1m] a gpt-6-astra para quitar el aviso: con ese sufijo Claude Code supone una ventana de un millón de tokens, ignora la variable y deja crecer las peticiones por encima de los 272.000 tokens que cambian la tarifa.
400 «Extra inputs are not permitted»
Este 400 no apareció en ninguna de las ejecuciones con LiteLLM, pero es el fallo típico de un proxy que reenvía el cuerpo de Anthropic tal cual a un destino con otro esquema. La documentación del protocolo de gateways de Claude Code explica que Claude Code manda a cualquier pasarela los mismos campos que a la API de Anthropic, como output_config.effort, context_management o marcas cache_control, y que reintenta una vez sin effort ni context_management si los rechazan. Si te ocurre, comprueba que drop_params: true está en la configuración de LiteLLM; si el 400 nombra un campo de herramientas o context_management, CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS=1 reduce lo que envía Claude Code.
Lo que no cubren las pruebas: búsqueda web, subagentes, MCP
Las pruebas del 12 de noviembre de 2026 demuestran que el montaje funciona en una máquina, con una tarea pequeña y una muestra por caso; no que todo Claude Code funcione igual con Astra. Quedaron sin ejercitar WebSearch y WebFetch (en la API de Anthropic son herramientas del servidor, y LiteLLM tiene una página aparte, «Claude Code - WebSearch Across All Providers», para ellas), las imágenes, los subagentes, los servidores MCP, las sesiones largas y la compactación automática. Si dependes de alguna de esas funciones, pruébala en una sesión corta antes de pasar tu trabajo diario a Astra, y ten a mano tu configuración de Claude para volver con solo quitar las variables.
Para otros modelos que no son de Anthropic en Claude Code, la misma lógica de pasarela y variables, con DeepSeek, está en Claude Code con OpenRouter y DeepSeek: rutas, configuración y primeros errores, y el acceso a Astra por API fuera de Claude Code, en Cómo acceder a GPT-6 Astra por API y comprobar la primera respuesta.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 12 nov 2026.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 12 nov 2026.
- 1.página sobre gateways LLM para Claude Codecode.claude.com/docs/en/llm-gateway
- 2.repositorio de Claude Code Router en GitHubgithub.com/musistudio/claude-code-router
- 3.Use Claude Code with Non-Anthropic Modelsdocs.litellm.ai/docs/tutorials/claude_non_anthropic_models
- 4.openai/codex-plugin-ccgithub.com/openai/codex-plugin-cc
- 5.guía de configuración de modelos de Claude Codecode.claude.com/docs/en/model-config
- 6.documentación del protocolo de gateways de Claude Codecode.claude.com/docs/en/llm-gateway-protocol