GLM-5.3-Flash en Claude Code: configuración, effort y créditos
Con el GLM Coding Plan, apunta Claude Code a api.z.ai/api/anthropic y pon glm-5.3-flash[1m] en las tres ranuras de modelo; la sesión principal usa la de Opus.
En esta página
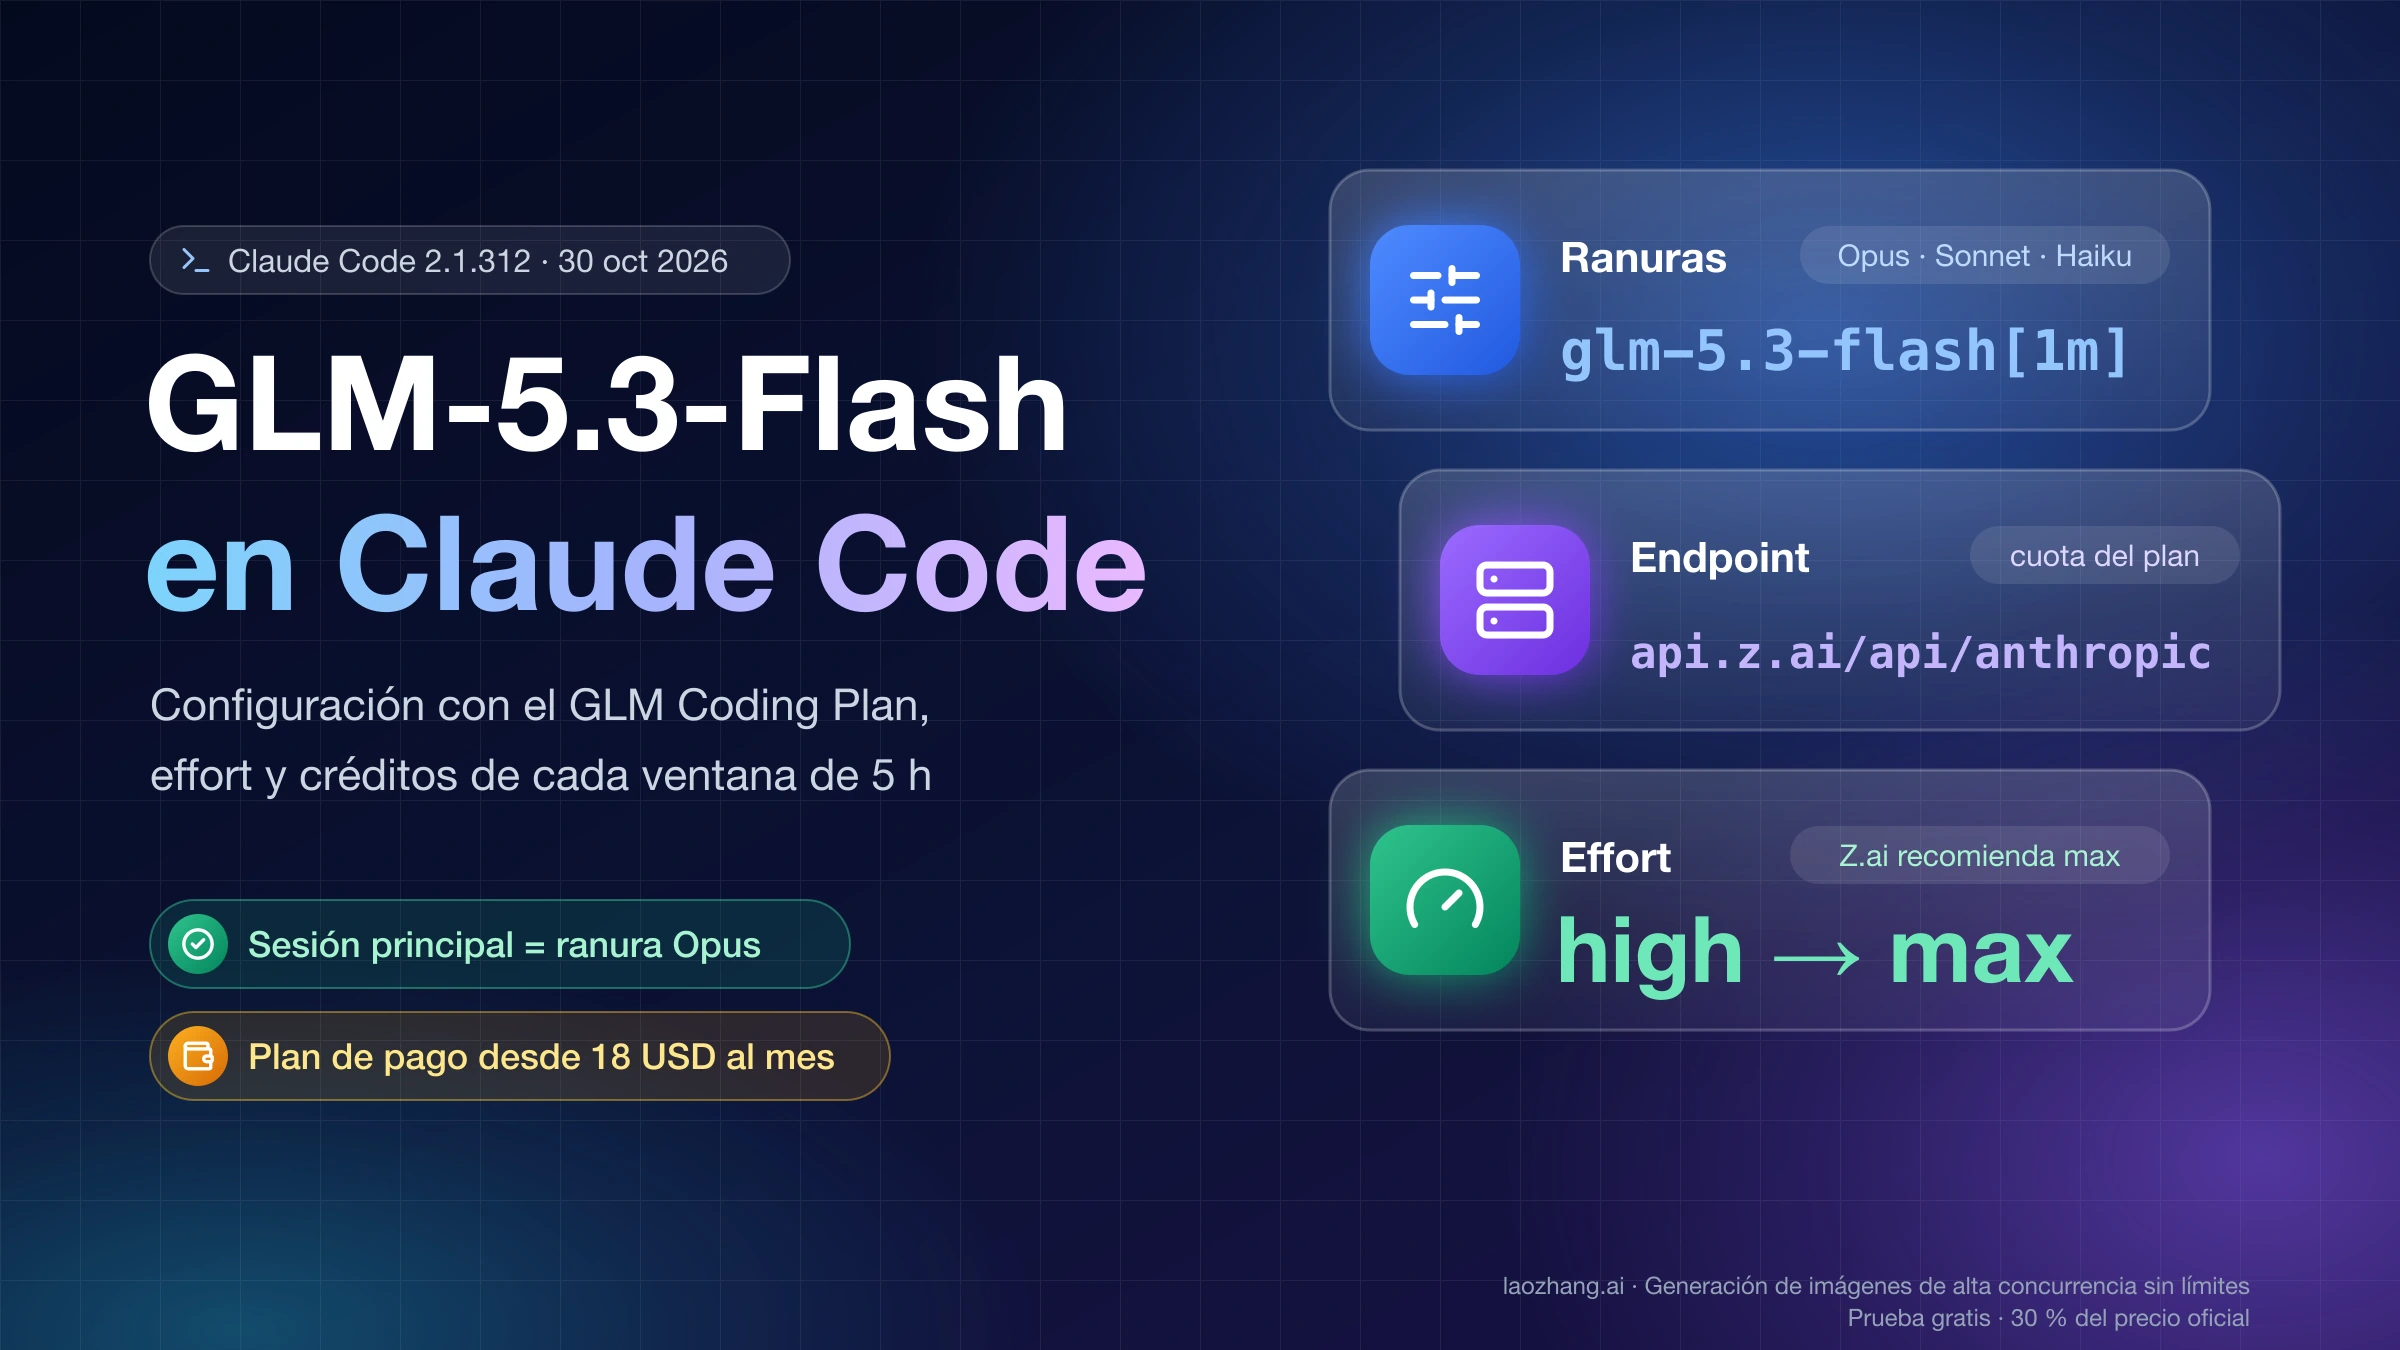
Para que Claude Code trabaje con GLM-5.3-Flash necesitas una suscripción al GLM Coding Plan de Z.ai (desde 18 USD al mes) y unas pocas claves en el bloque env de ~/.claude/settings.json: ANTHROPIC_BASE_URL con el endpoint https://api.z.ai/api/anthropic, tu clave de Z.ai en ANTHROPIC_AUTH_TOKEN y glm-5.3-flash[1m] en ANTHROPIC_DEFAULT_OPUS_MODEL, ANTHROPIC_DEFAULT_SONNET_MODEL y ANTHROPIC_DEFAULT_HAIKU_MODEL. Claude Code es solo el cliente: escoge una de esas tres ranuras, manda la petición a ese endpoint y es el endpoint del plan el que decide de qué cuota se descuenta.
Dos detalles cambian el resultado. La sesión principal sale por la ranura Opus, así que la configuración «manual» que publica Z.ai en su página de Claude Code (Flash solo en Haiku, GLM-5.3 en Sonnet y Opus) te deja programando con GLM-5.3 y reserva Flash para tareas de fondo. Y Claude Code envía effort high por defecto, cuando Z.ai recomienda max para programar: si lo quieres, añade "CLAUDE_CODE_EFFORT_LEVEL": "max" en el mismo bloque y confirma con /status qué modelo está activo.
Todo esto vale a 30 de octubre de 2026 con Claude Code 2.1.312. Si no quieres pagar el plan, la vía documentada para llevar GLM-5.3-Flash a Claude Code es OpenRouter, con otra configuración; al final tienes el enlace a esa guía.
Antes de configurar: GLM Coding Plan, clave de Z.ai y Claude Code al día
El GLM Coding Plan es de pago y es lo que hace funcionar este método: la clave se crea en el panel del plan, solo sirve dentro de las herramientas que Z.ai admite (Claude Code es una de ellas) y solo a través de los endpoints del plan. No existe una versión gratuita del plan; lo que sí es gratis son los pesos abiertos de GLM-5.3-Flash, que puedes ejecutar en tu propio hardware si te alcanza, como se explica en la Guía de GLM-5.3-Flash: Ox Alpha, precio de la API y ejecución local. Los precios de cada plan y lo que rinden están más abajo, en la sección de créditos.
Dentro del plan solo se pueden llamar dos modelos, GLM-5.3 y GLM-5.3-Flash, según las preguntas frecuentes del GLM Coding Plan. Z.ai redirige las peticiones antiguas: glm-5.2 y glm-5.1 acaban en GLM-5.3, y glm-4.7 acaba en GLM-5.3-Flash, de modo que una configuración copiada de un vídeo con glm-4.7 ya está usando Flash sin decirlo. GLM-5.3-FlashX, la variante rápida, no está disponible en el plan a 30 de octubre de 2026, así que no lo pongas en ninguna ranura. Si tu cuenta es de bigmodel.cn (la plataforma para China), todo lo que sigue vale igual con el endpoint https://open.bigmodel.cn/api/anthropic.
La versión de Claude Code también cuenta. Z.ai dice haber verificado la compatibilidad con la 2.0.14, pero recomienda la última, y su guía para cambiar de modelo en el GLM Coding Plan avisa de que el sufijo [1m] puede dar «el modelo no existe» en versiones antiguas. Ejecuta claude update antes de empezar. La 2.1.312, la última publicada en npm el 30 de octubre de 2026, es la versión con la que se hizo la captura de peticiones descrita más abajo.
Configurar settings.json para GLM-5.3-Flash, paso a paso
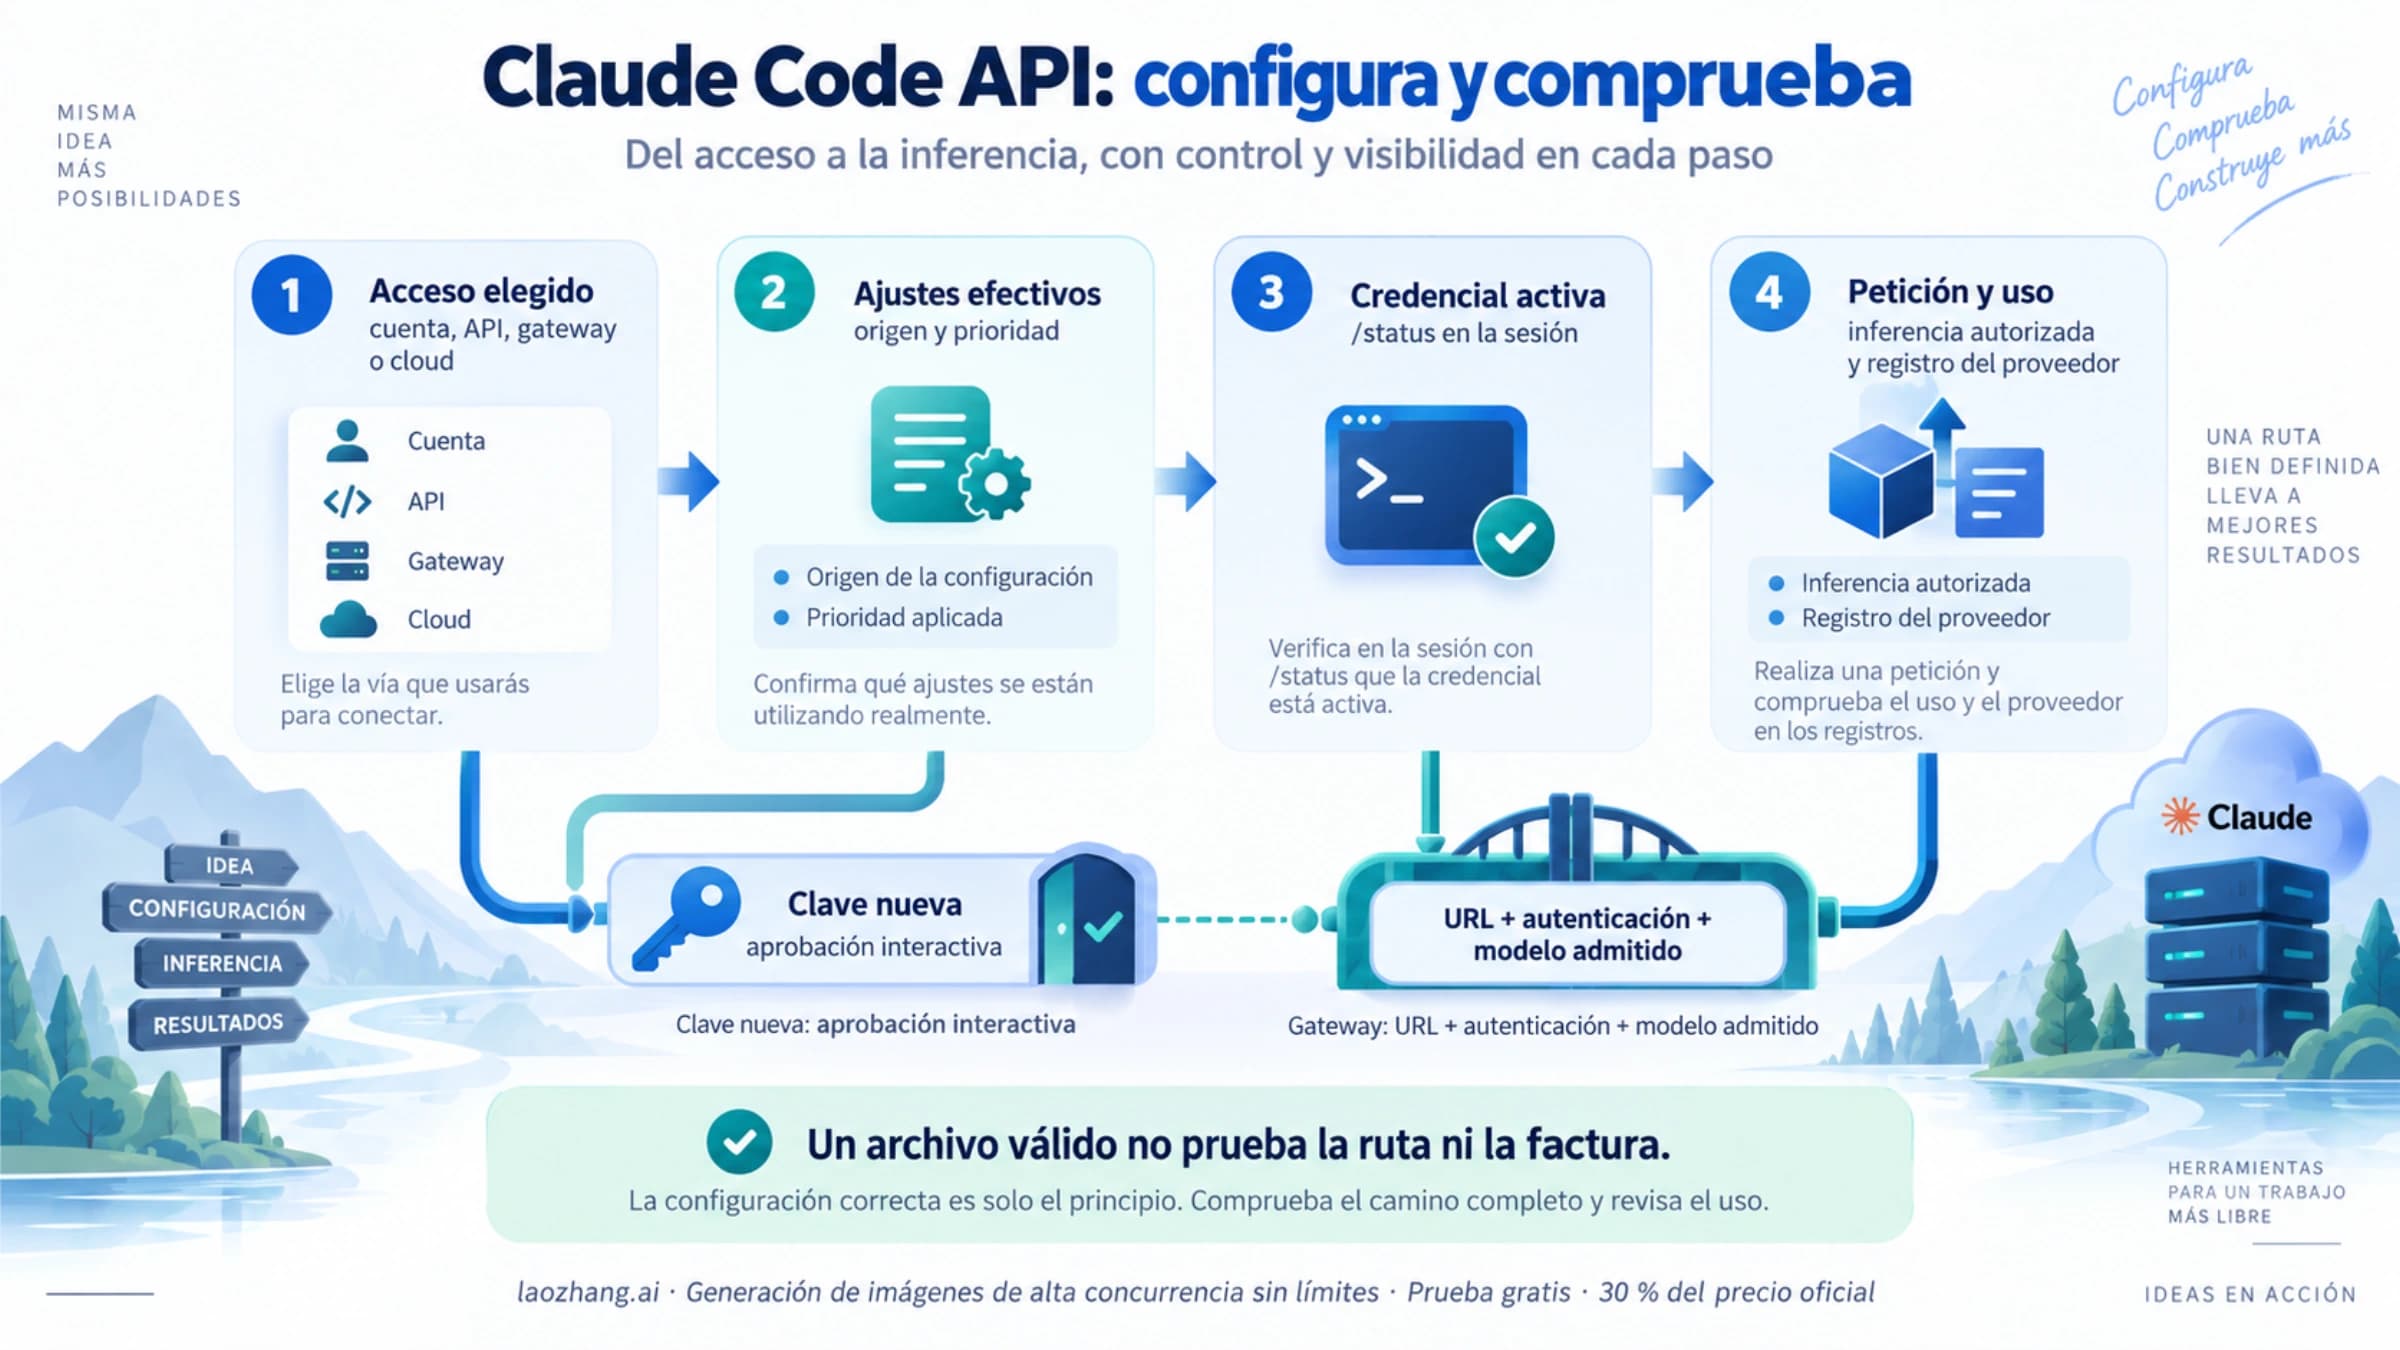
Toda la configuración vive en el bloque env de un único archivo: ~/.claude/settings.json en macOS y Linux, %USERPROFILE%\.claude\settings.json en Windows. Si el archivo ya tiene otros campos, no lo sustituyas entero: añade o cambia solo las claves de abajo, como pide la propia Z.ai. Si además tienes variables de entorno de otro proveedor en tu shell o ajustes de proyecto, el orden de prioridad entre ellos está en Configuración de Claude Code API: claves, settings.json, modelos y gateways.
-
En Z.ai, entra en Personal Coding Plan > Plan Overview y crea una clave de API (en un plan de equipo, en Team Coding Plan > My Plan).
-
Abre el archivo de ajustes con tu editor:
# macOS / Linux / WSL mkdir -p ~/.claude && ${EDITOR:-nano} ~/.claude/settings.json# Windows (PowerShell) New-Item -ItemType Directory -Force "$env:USERPROFILE\.claude" notepad "$env:USERPROFILE\.claude\settings.json" -
Dentro de
env, añade estas claves y sustituyetu_clave_de_zaipor la clave del paso 1:{ "env": { "ANTHROPIC_BASE_URL": "https://api.z.ai/api/anthropic", "ANTHROPIC_AUTH_TOKEN": "tu_clave_de_zai", "API_TIMEOUT_MS": "3000000", "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000", "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.3-flash[1m]", "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.3-flash[1m]", "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-5.3-flash[1m]" } } -
Cierra todas las ventanas de Claude Code, abre una terminal nueva en tu proyecto y ejecuta
claude. Si pregunta «Do you want to use this API key», responde que sí.
Cada clave tiene un papel concreto, y saberlo evita la mayoría de los errores de la última sección. A las tres claves de modelo se les llama aquí ranuras: son las variables ANTHROPIC_DEFAULT_*_MODEL, que asignan un modelo real a los alias opus, sonnet y haiku de Claude Code.
| Clave | Qué hace | Valor para Flash |
|---|---|---|
ANTHROPIC_BASE_URL | Adónde envía Claude Code todas las peticiones; es lo que hace que cuenten como plan | https://api.z.ai/api/anthropic |
ANTHROPIC_AUTH_TOKEN | La clave de Z.ai que viaja en cada petición | Tu clave del plan |
API_TIMEOUT_MS | Tiempo máximo de espera por petición, en milisegundos | 3000000 (50 minutos, el valor de Z.ai) |
CLAUDE_CODE_AUTO_COMPACT_WINDOW | Tamaño de contexto a partir del cual Claude Code compacta la conversación | 1000000, junto con [1m] en el modelo |
ANTHROPIC_DEFAULT_OPUS_MODEL | Ranura que usa la sesión principal cuando no eliges otra | glm-5.3-flash[1m] |
ANTHROPIC_DEFAULT_SONNET_MODEL | Ranura que se usa al elegir sonnet con /model o --model | glm-5.3-flash[1m] |
ANTHROPIC_DEFAULT_HAIKU_MODEL | Ranura de haiku y de las tareas de fondo, como el título de la sesión | glm-5.3-flash[1m] |
Z.ai ofrece dos atajos que escriben el archivo por ti: el asistente npx @z_ai/coding-helper y, en macOS y Linux, el script claude_code_zai_env.sh. El script solo escribe la clave, la base URL y API_TIMEOUT_MS, sin ranuras. En la captura de peticiones del 30 de octubre de 2026 que se describe en la sección siguiente, Claude Code con solo esas tres claves pidió el modelo claude-opus-5-5, y la documentación de Z.ai no dice qué modelo atiende su servidor ante ese nombre. Añade las ranuras tú mismo después de usar cualquiera de los dos atajos y así sabrás qué modelo trabaja.
La configuración manual de Z.ai incluye además "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": 1. En esa misma captura no cambió nada de la petición principal, así que puedes ponerla o no. Otra clave opcional es "CLAUDE_CODE_MAX_OUTPUT_TOKENS": "128000", que subió el max_tokens enviado de 32.000 a 128.000, la salida máxima que Z.ai documenta para GLM-5.3-Flash. La documentación del plan no dice si su endpoint acepta ese valor desde Claude Code, así que déjala para cuando las respuestas largas se corten.
Las dos configuraciones de Z.ai: con cuál responde de verdad Flash
Z.ai publica dos asignaciones distintas, y solo una te da GLM-5.3-Flash en la conversación principal. La página «How to Switch Models» pone glm-5.3-flash[1m] en las tres ranuras; la página de Claude Code dice en una lista que las tres van a GLM-5.3-Flash, pero su bloque «Manual configuration» pone Flash solo en Haiku y glm-5.3[1m] en Sonnet y Opus. Como Claude Code usa la ranura Opus para la sesión principal, con esa segunda configuración programas con GLM-5.3, que gasta unas tres veces más créditos por turno.
Para ver qué ranura usa cada tipo de petición, el 30 de octubre de 2026 se ejecutó Claude Code 2.1.312 (macOS, instalado con npm) con las dos configuraciones de Z.ai copiadas tal cual, pero con ANTHROPIC_BASE_URL apuntando a un endpoint simulado (mock) local: un pequeño servidor que imita la API de Anthropic, anota cada petición y devuelve una respuesta fija. No intervino ninguna cuenta de Z.ai ni ningún modelo real, así que la captura muestra qué envía Claude Code, no qué responde Z.ai ni qué modelo sirve de verdad su servidor.
Con las tres ranuras en Flash, la petición por defecto salió con model: "glm-5.3-flash": Claude Code quita el sufijo [1m] del nombre y lo convierte en la cabecera beta context-1m-2025-08-07. Llevaba además thinking de tipo adaptive, effort: "high" y max_tokens de 32.000. Con la configuración manual mixta, la misma petición salió como model: "glm-5.3". Después se repitió la prueba con un nombre distinto en cada ranura. Sin --model, la sesión usó la ranura Opus, y --model sonnet, --model haiku y --model opus usaron cada uno la suya. En una sesión interactiva, antes de cada mensaje salió además una petición en segundo plano a la ranura Haiku, sin herramientas, que genera el título de la sesión; en modo -p no apareció. Los subagentes integrados Explore y general-purpose, en cambio, usaron el modelo de la sesión, es decir, la ranura Opus y no la de Haiku; los subagentes personalizados con su propio campo model quedaron fuera de la prueba.
| Configuración | Sesión principal | Título de sesión (segundo plano) | Subagentes Explore y general-purpose |
|---|---|---|---|
«How to Switch Models»: las tres ranuras en glm-5.3-flash[1m] | GLM-5.3-Flash | GLM-5.3-Flash | GLM-5.3-Flash |
«Manual configuration»: Haiku en Flash, Sonnet y Opus en glm-5.3[1m] | GLM-5.3 | GLM-5.3-Flash | GLM-5.3 |
Variante: Opus y Haiku en Flash, Sonnet en glm-5.3[1m] (deducida de las dos filas anteriores) | GLM-5.3-Flash; GLM-5.3 con /model sonnet | GLM-5.3-Flash | El modelo que tenga la sesión |
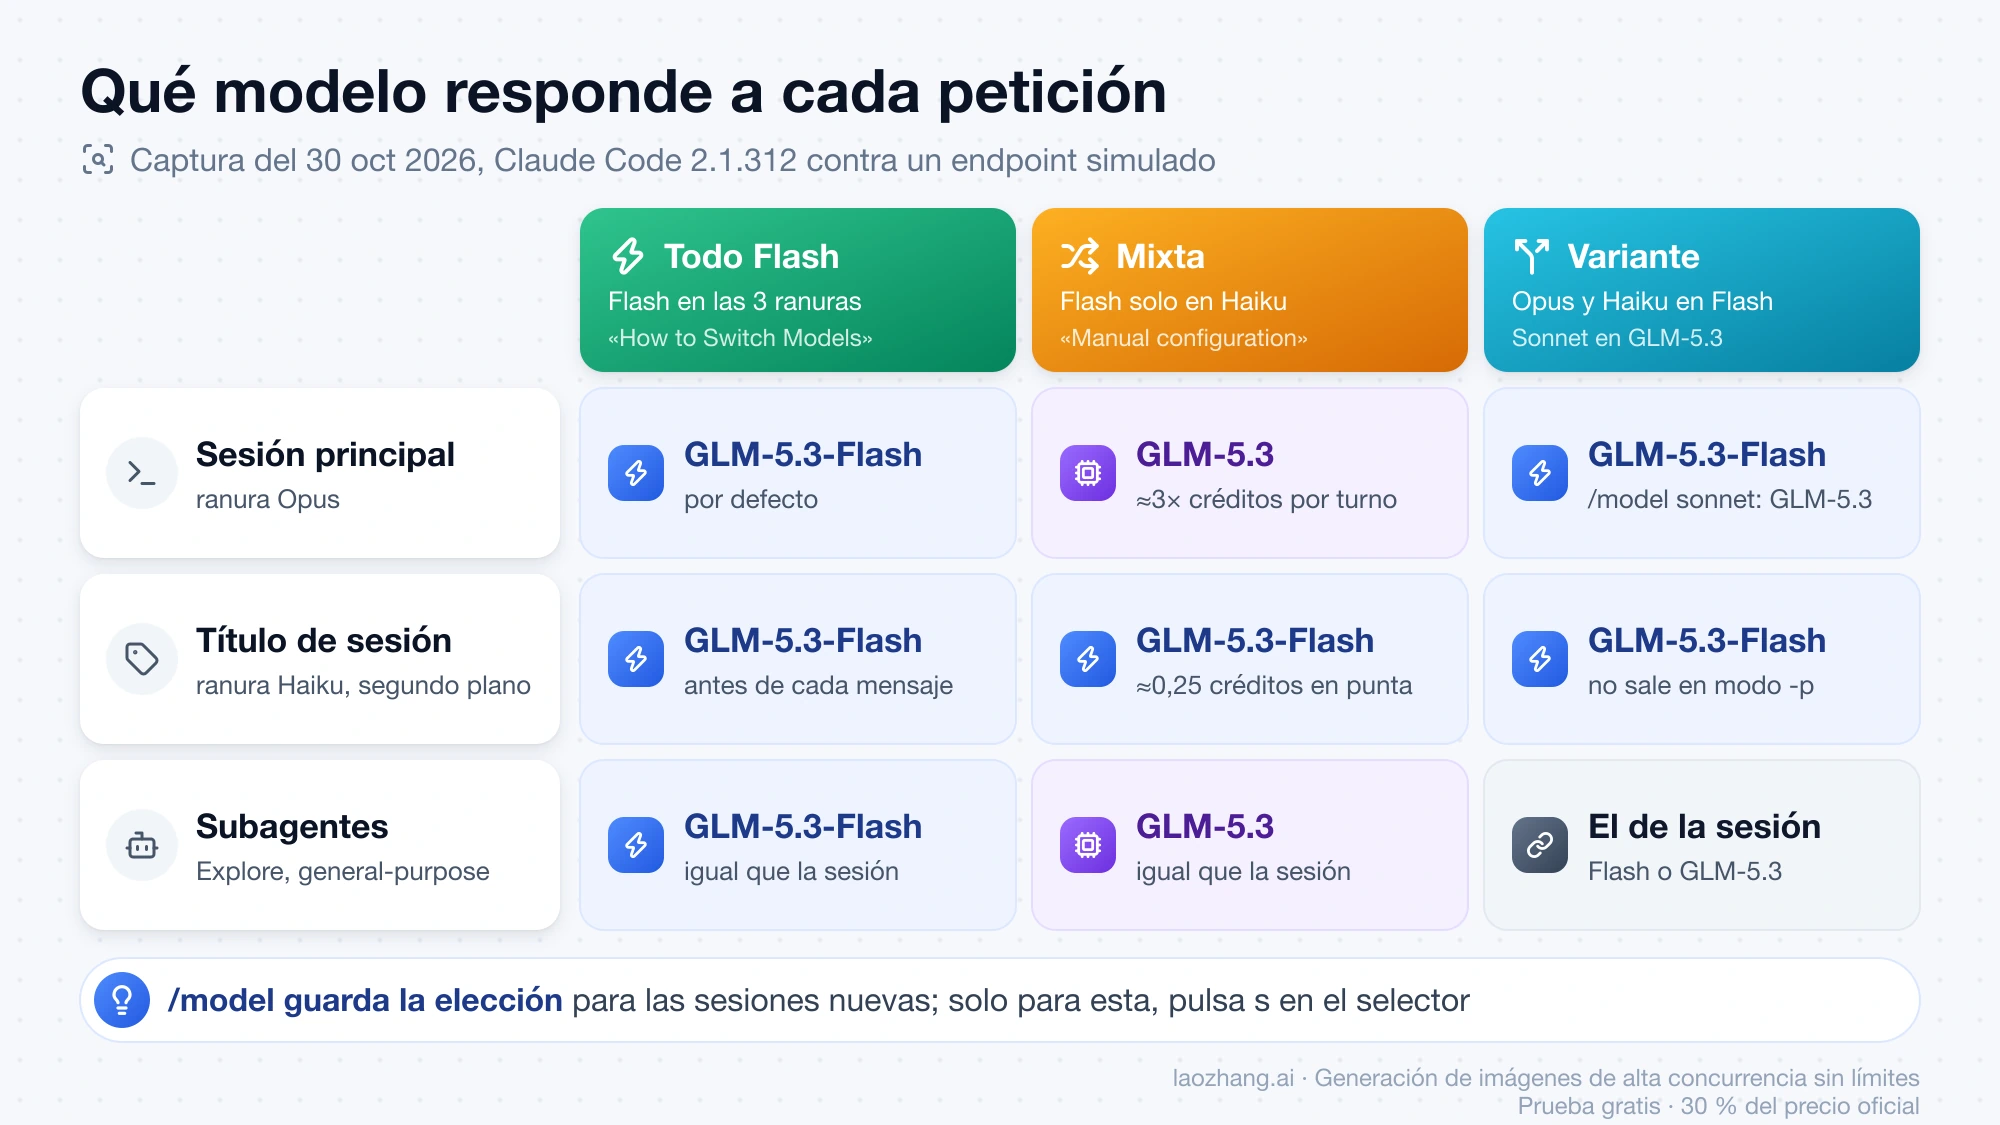
Si quieres que todo vaya por Flash, usa la primera fila, que es el bloque del paso a paso. Si prefieres Flash por defecto y GLM-5.3 a mano para los problemas difíciles, usa la variante y cambia con /model sonnet cuando lo necesites. Ten en cuenta que /model guarda la elección: en la captura, /model haiku escribió "model": "haiku" en settings.json como modelo por defecto de las sesiones nuevas. Para cambiar solo la sesión actual, abre el selector con /model y pulsa s sobre la fila del modelo, como indica la documentación de Claude Code. Qué tareas merecen GLM-5.3 está en GLM-5.3 o GLM-5.3-Flash: qué modelo probar primero.
Comprobar con /status que responde glm-5.3-flash
/status es la comprobación fiable de qué modelo usa la sesión, qué archivo de ajustes se ha cargado y adónde van las peticiones. Preguntarle al modelo quién es no sirve: en Reddit circula un hilo titulado «GLM 5.3 Flash decided it's Claude», y lo que el modelo diga de sí mismo no cambia lo que Claude Code envía.
- Abre una terminal nueva en tu proyecto y ejecuta
claude. - Escribe
/status. - Comprueba cuatro líneas:
Modeldebe mostrarDefault (glm-5.3-flash[1m])oglm-5.3-flash;Auth token,ANTHROPIC_AUTH_TOKEN;Anthropic base URL,https://api.z.ai/api/anthropic; ySetting sources,User settings.
Así se vio en la sesión interactiva de la captura del 30 de octubre de 2026, contra el endpoint simulado, y en esa sesión el banner de inicio mostraba glm-5.3-flash[1m] · API Usage Billing. Esa etiqueta la puso Claude Code y no viene de Z.ai: qué cuota se descuenta lo decide el endpoint, y según las preguntas frecuentes de Z.ai, las llamadas desde herramientas admitidas con la clave del plan solo usan la cuota del plan. Si Model muestra un nombre de Claude o falta User settings, la configuración no se ha aplicado: la tabla de errores de más abajo tiene las causas.
Effort de GLM-5.3-Flash en Claude Code: de high a max a propósito
Claude Code 2.1.312 manda effort: "high" en cada petición, y en el endpoint del plan un effort explícito manda sobre todo lo demás, así que GLM-5.3-Flash trabaja en high y no en el max que Z.ai usa por defecto y recomienda para programar. Si quieres max, tienes que pedirlo, y conviene hacerlo de forma que sobreviva a la sesión.
La regla de Z.ai, publicada en su guía para cambiar de modelo, es «effort explícito > interruptor de thinking > max por defecto», con esta conversión: low se queda en low, medium y high pasan a high, y xhigh y max pasan a max. Por eso apagar el razonamiento desde Claude Code tampoco baja a low: con CLAUDE_CODE_DISABLE_THINKING=1, la captura del 30 de octubre mostró que desaparecía el campo thinking, pero seguía saliendo effort: "high", que según esa misma regla es lo que decide.
En la captura, --effort envió exactamente el nivel indicado, y /effort max cambió la siguiente petición a max con el aviso «Set effort level to max (this session only)»: en la sesión siguiente vuelve a high. Para que se mantenga, pon la variable en el mismo bloque env; con ella, cada sesión nueva envió max:
"CLAUDE_CODE_EFFORT_LEVEL": "max"La otra vía persistente es la clave de primer nivel "effortLevel": "xhigh" fuera de env (Claude Code no acepta max en esa clave), que también se mantuvo y que Z.ai convierte en max. Elegir no es solo cuestión de calidad. En el Code Bench v1.0 de Z.ai, ejecutado en Claude Code 2.1.207, GLM-5.3-Flash supera a GLM-5.2 en todos los niveles de effort y en max casi iguala a Claude Opus 4.8 (29,0 frente a 29,5), según la propia página de GLM-5.3-Flash en la documentación de Z.ai. Pero más razonamiento son más tokens de salida, que en el plan son los que más créditos cuestan. Una regla práctica: max para errores difíciles y cambios en muchos archivos, high cuando quieras estirar el plan Lite.
Cuánto dura el GLM Coding Plan con Flash: créditos por turno y hora punta
Con Flash, un turno típico de agente gasta unas tres veces menos créditos que con GLM-5.3: con los supuestos de abajo, la ventana de 5 horas del plan Lite da para unos 299 turnos en hora punta y 598 fuera de ella, frente a 99 y 198 con GLM-5.3. Es la misma proporción que anuncia Z.ai cuando dice que Flash ofrece el triple de cuota que GLM-5.3.
Los precios mensuales de Lite, Pro y Max, a 30 de octubre de 2026 en z.ai/subscribe, están en la tabla de abajo. El pago trimestral descuenta un 20 % (14,40, 64 y 134,40 USD al mes, respectivamente) y el anual un 30 % (12,60, 56 y 117,60 USD al mes). Cada plan tiene dos límites a la vez, uno cada 5 horas y otro semanal, y los dos se miden en créditos. La ventana de 5 horas se recarga 5 horas después de consumir y la semanal cada 7 días desde la suscripción, según la página de resumen del GLM Coding Plan.
La misma página da la fórmula: créditos = (entrada × multiplicador de entrada + entrada en caché × multiplicador de caché + salida × multiplicador de salida) / 10.000. Los multiplicadores son 2,3 / 0,56 / 8 para GLM-5.3-Flash y 6,9 / 1,7 / 24 para GLM-5.3, y fuera de la hora punta todo cuesta la mitad. Para la tabla se supone un turno de agente con 60.000 tokens de contexto en caché, 4.000 tokens nuevos de entrada y 3.000 de salida contando el razonamiento: con Flash son (4.000 × 2,3 + 60.000 × 0,56 + 3.000 × 8) / 10.000 = 6,68 créditos en punta y 3,34 fuera de ella; con GLM-5.3, 20,16 y 10,08. Son supuestos, no consumo medido en Z.ai.
| Plan (precio mensual) | Créditos cada 5 h / por semana | Turnos con Flash en 5 h (punta / valle) | Turnos con GLM-5.3 en 5 h (punta / valle) | Turnos con Flash por semana (punta / valle) |
|---|---|---|---|---|
| Lite (18 USD) | 2.000 / 10.000 | 299 / 598 | 99 / 198 | 1.497 / 2.994 |
| Pro (80 USD) | 12.000 / 60.000 | 1.796 / 3.592 | 595 / 1.190 | 8.982 / 17.964 |
| Max (168 USD) | 28.000 / 140.000 | 4.191 / 8.383 | 1.388 / 2.777 | 20.958 / 41.916 |
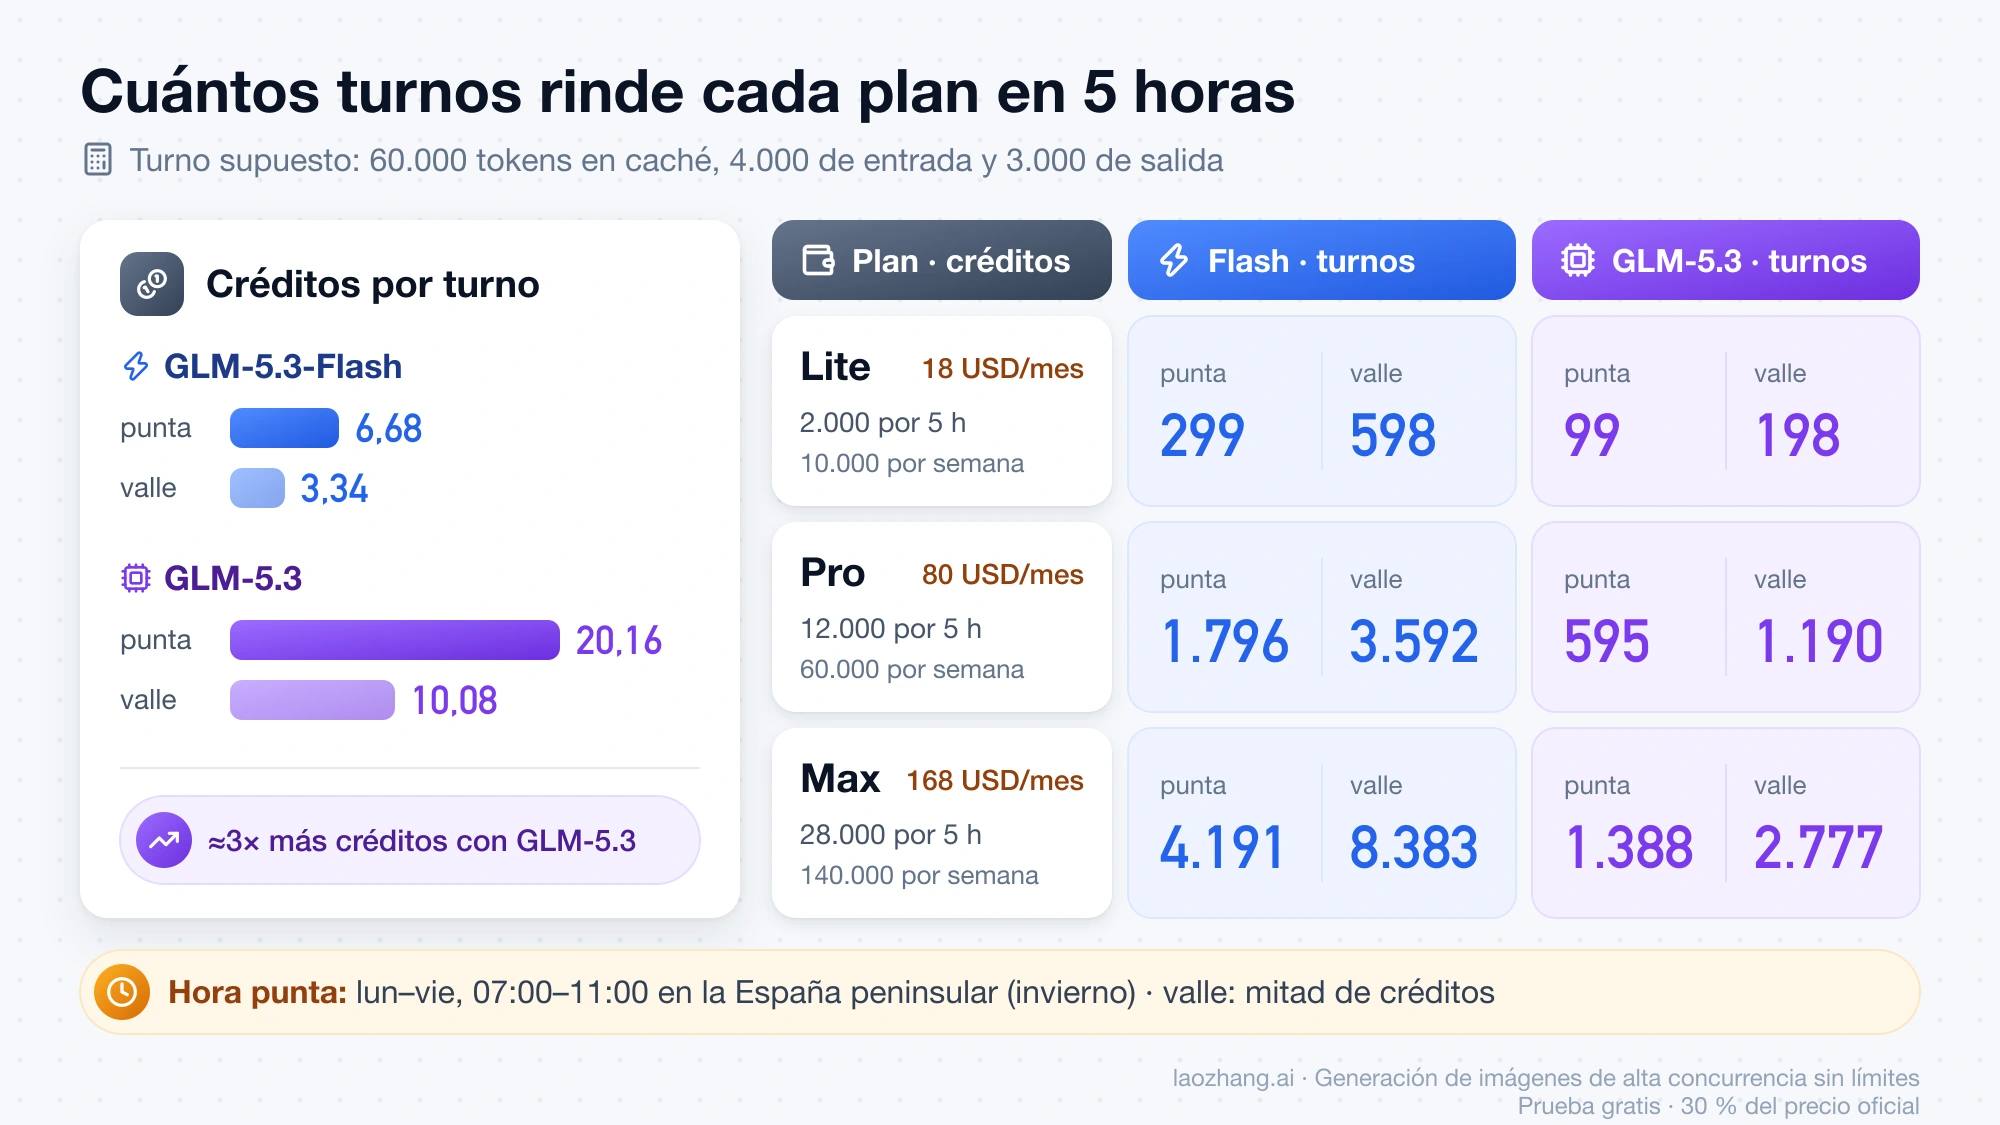
Los turnos pesados cambian mucho la cuenta. Con 150.000 tokens en caché, 10.000 nuevos y 8.000 de salida, un turno con Flash cuesta 17,10 créditos en punta y 8,55 en valle, y la ventana de 5 horas de Lite baja a unos 116 y 233 turnos. Subir el effort a max alarga la salida y empuja en esa dirección. La petición de título que Claude Code lanza antes de cada mensaje, en cambio, apenas pesa: con unos 1.000 tokens de entrada y 30 de salida sale a unos 0,25 créditos con Flash en punta. Fíjate también en el límite semanal: en Lite equivale a cinco ventanas de 5 horas llenas, así que si agotas la ventana dos veces al día, la semana se acaba antes de que termine el tercer día.
La hora punta del plan es de lunes a viernes de 14:00 a 18:00 hora de Singapur (UTC+8), es decir, de 06:00 a 10:00 UTC. En la España peninsular, desde el cambio al horario de invierno del 25 de octubre, eso es de 07:00 a 11:00 (de 08:00 a 12:00 en verano; en Canarias, una hora menos). Fuera de esa franja y durante todo el fin de semana, los créditos cuestan la mitad.
Cuando se acaba la cuota, Claude Code no pasa a cobrar del saldo de tu cuenta: las llamadas desde herramientas admitidas solo usan la cuota del plan y hay que esperar a la siguiente recarga, según las preguntas frecuentes del plan. El progreso se ve en la página de suscripción de Z.ai. Antes de pagar conviene saber tres reglas más: no hay reembolsos, compartir la cuenta está prohibido y puede acabar en bloqueo, y para cancelar la renovación la FAQ pide 24 horas de antelación mientras que la política de uso pide 3 días, así que hazlo con al menos 3 días.
Errores al usar GLM-5.3-Flash en Claude Code: 1113, [1m] y aviso de 200k
Casi todos los primeros fallos vienen de que la petición no llega al endpoint del plan o de que Claude Code no lee el nombre de modelo que esperas. Busca tu síntoma en la tabla; las causas salen de la documentación de Z.ai y de Claude Code y de la captura del 30 de octubre de 2026.
| Síntoma | Causa | Qué hacer |
|---|---|---|
1113 Insufficient Balance aunque has pagado el plan, o se descuenta saldo de la cuenta | La petición sale de una herramienta no admitida, va a otra base URL o pide un modelo fuera del plan, como glm-5.3-flashx | Pon https://api.z.ai/api/anthropic en ANTHROPIC_BASE_URL y solo glm-5.3-flash o glm-5.3 (con [1m]) en las ranuras |
/status muestra un modelo de Claude o no aparece User settings | Siguen abiertas ventanas antiguas, el JSON tiene una coma de más o de menos, o editaste un archivo que esa instalación no lee (por ejemplo, WSL frente a Windows) | Cierra todas las ventanas, valida el JSON y edita el archivo de la instalación que arrancas; Z.ai propone, como último recurso, borrar settings.json y volver a crearlo |
Claude Code dice que el modelo con [1m] no existe | Versión de Claude Code antigua | claude update y vuelve a abrir la sesión |
| «Claude Code doesn't recognize the model …, so it assumes a context window of 200k tokens» | El modelo activo no lleva [1m], así que Claude Code no envía la cabecera de 1M y compacta a 200K | Añade [1m] al valor de la ranura o al --model (claude --model 'glm-5.3-flash[1m]') y mantén CLAUDE_CODE_AUTO_COMPACT_WINDOW en 1000000 |
| El plan deja de responder a mitad de sesión | Se ha agotado la cuota de 5 horas o la semanal | Espera a la recarga o mueve el trabajo pesado fuera de la hora punta; no se cobra del saldo |
| Varias sesiones en paralelo fallan o van lentas | La concurrencia depende del plan y baja en hora punta | Z.ai recomienda un proyecto a la vez en Lite, uno o dos en Pro y dos o más en Max |
El aviso de 200k tiene una trampa: en la captura, --model glm-5.3-flash sin sufijo y con CLAUDE_CODE_AUTO_COMPACT_WINDOW en 1000000 no mostró el aviso, pero tampoco envió la cabecera de 1M. Que no aparezca el aviso no prueba que tengas el contexto de un millón; lo que lo asegura es el [1m] en el nombre del modelo.
GLM-5.3-Flash en Claude Code sin el plan: OpenRouter, pago por uso o local
Sin suscripción, el endpoint del plan no te sirve, y la vía documentada para llevar GLM-5.3-Flash a Claude Code es OpenRouter, que lo ofrece como z-ai/glm-5.3-flash. A 25 de octubre de 2026, el endpoint de la propia Z.ai dentro de OpenRouter cobraba 0,15 USD por millón de tokens de entrada, 0,03 USD en caché y 0,50 USD de salida. La conexión de Claude Code con OpenRouter, con su clave y su ID de modelo, está en Claude Code con OpenRouter y DeepSeek: rutas, configuración y primeros errores. Usar una clave de Z.ai sin plan contra https://api.z.ai/api/anthropic no figura como ruta de pago por uso: las preguntas frecuentes de Z.ai solo dicen que las llamadas que no cumplen las condiciones del plan descuentan saldo de la cuenta o fallan con 1113 Insufficient Balance.
Los IDs de la API, el precio por uso y lo que hace falta para ejecutar los pesos en local están en la Guía de GLM-5.3-Flash: Ox Alpha, precio de la API y ejecución local. Si dudas entre Flash y DeepSeek por coste, la cuenta por tarea en hora punta y en valle está en DeepSeek V4.1 Flash vs GLM-5.3-Flash: precio en valle y punta.
Fuentes4
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.
Fuentes4
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.