Qwen3.8 Flash-Next vs 27B: cuál ejecutar en local
Empieza con 27B si necesitas que el modelo quepa y sea fácil de operar. Prueba Flash-Next cuando dispongas de mucha más memoria y las tareas de agentes justifiquen su consumo de memoria.
En esta página
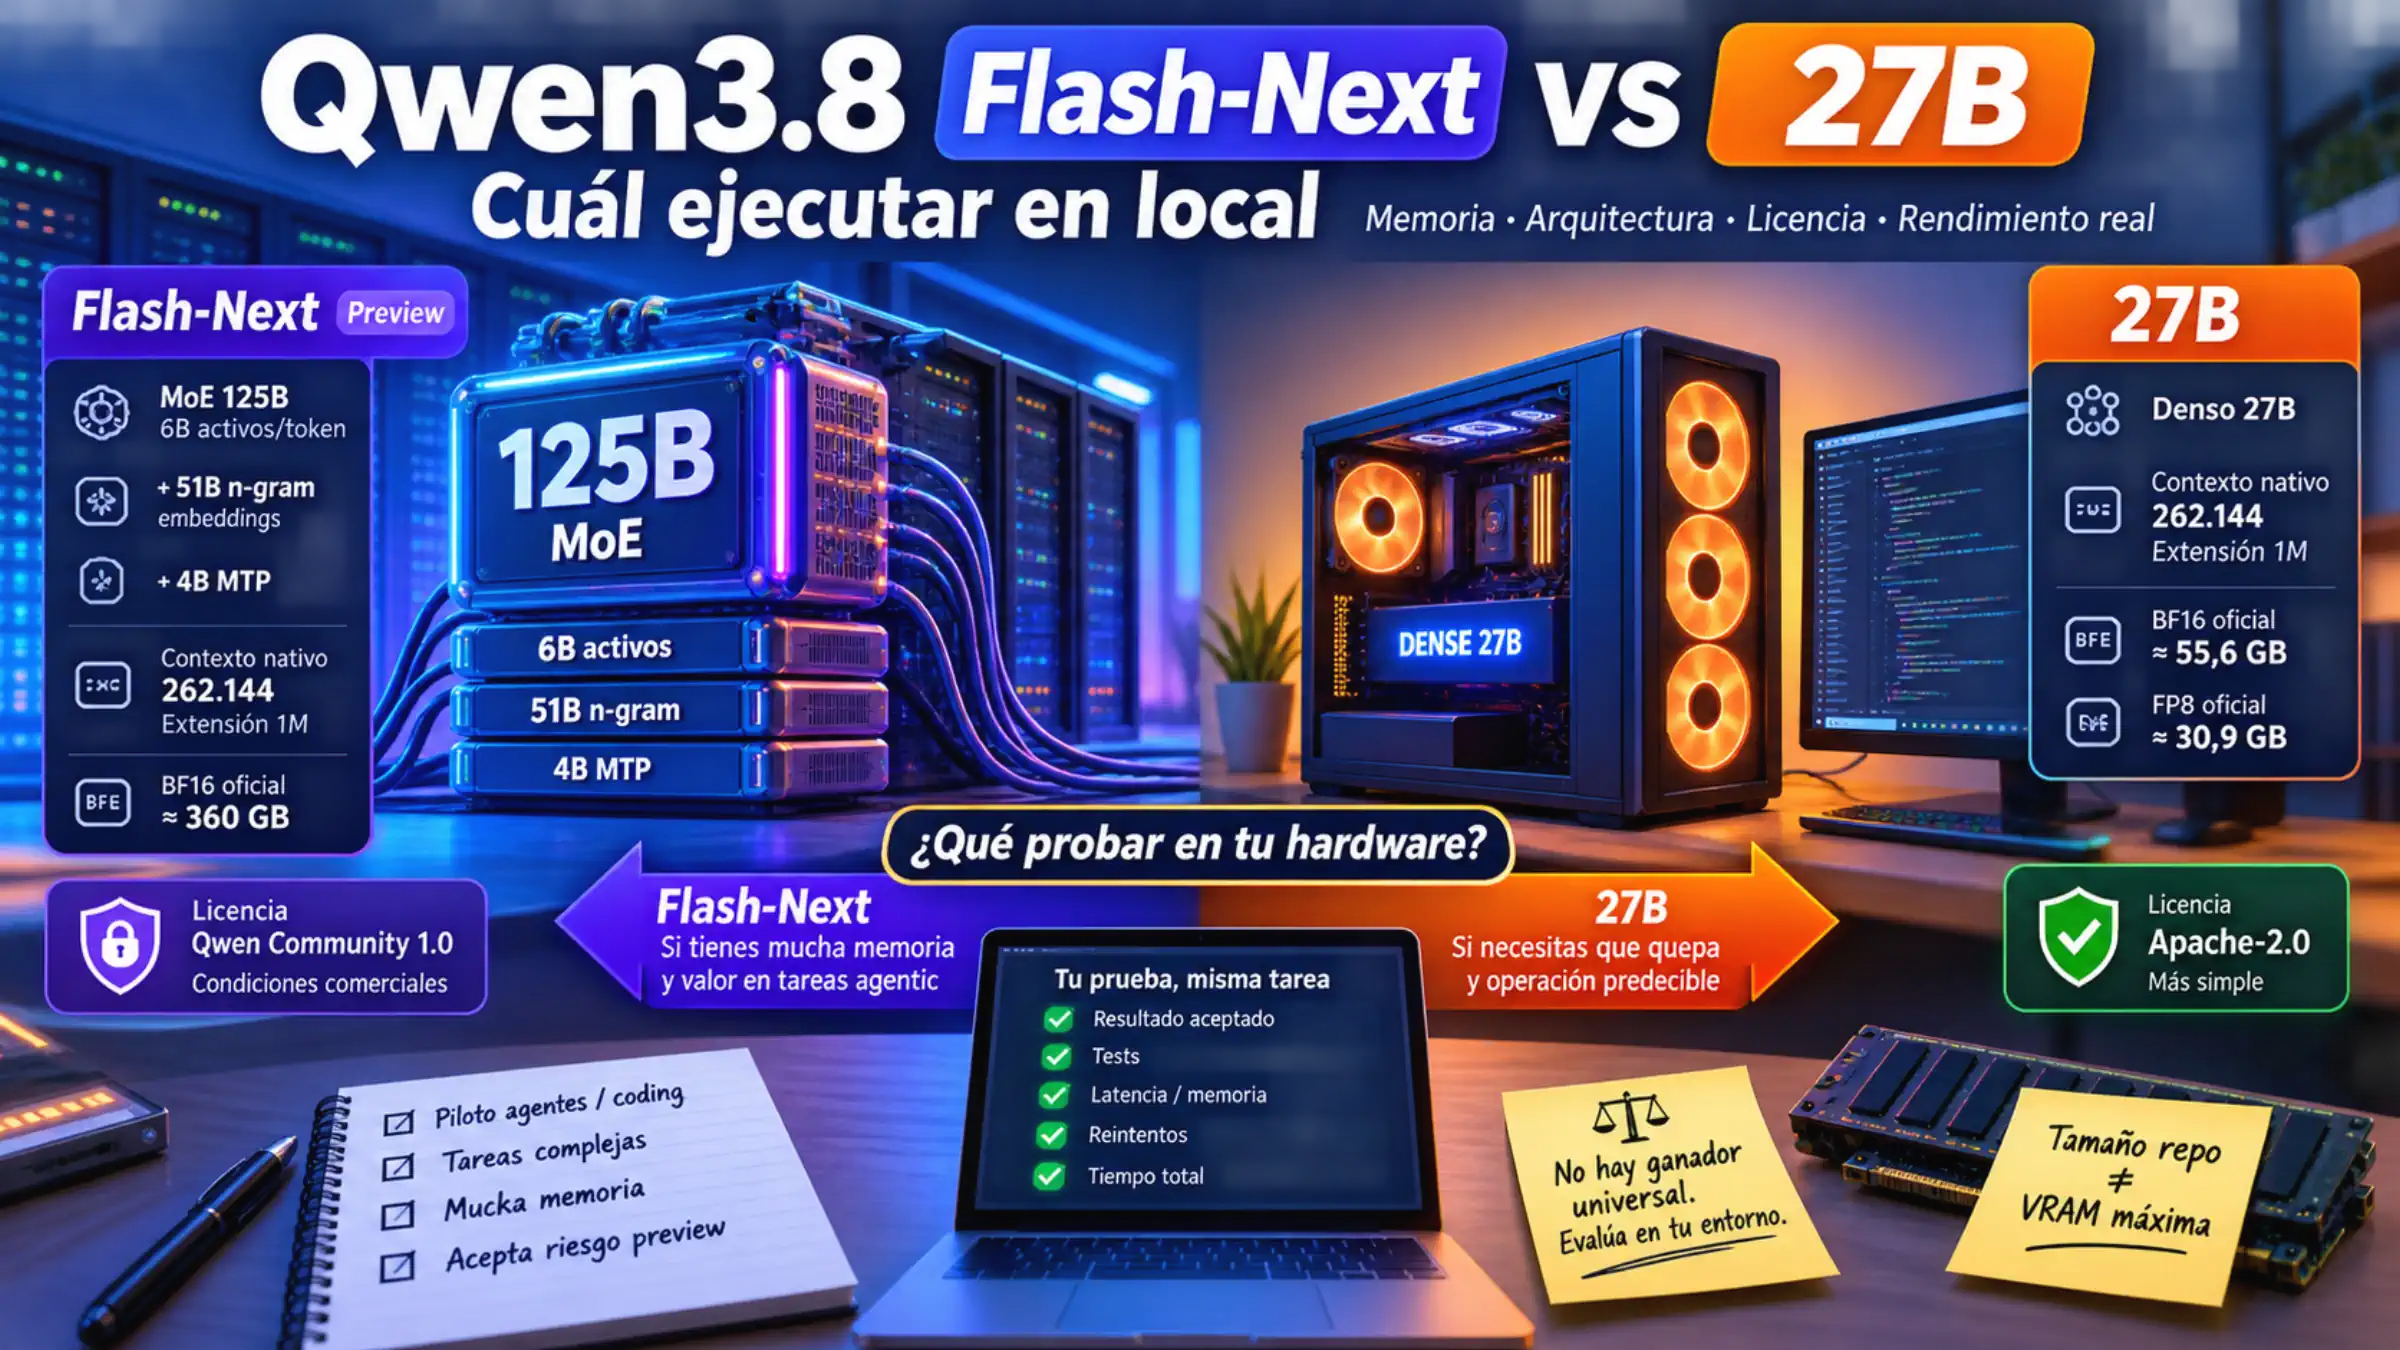
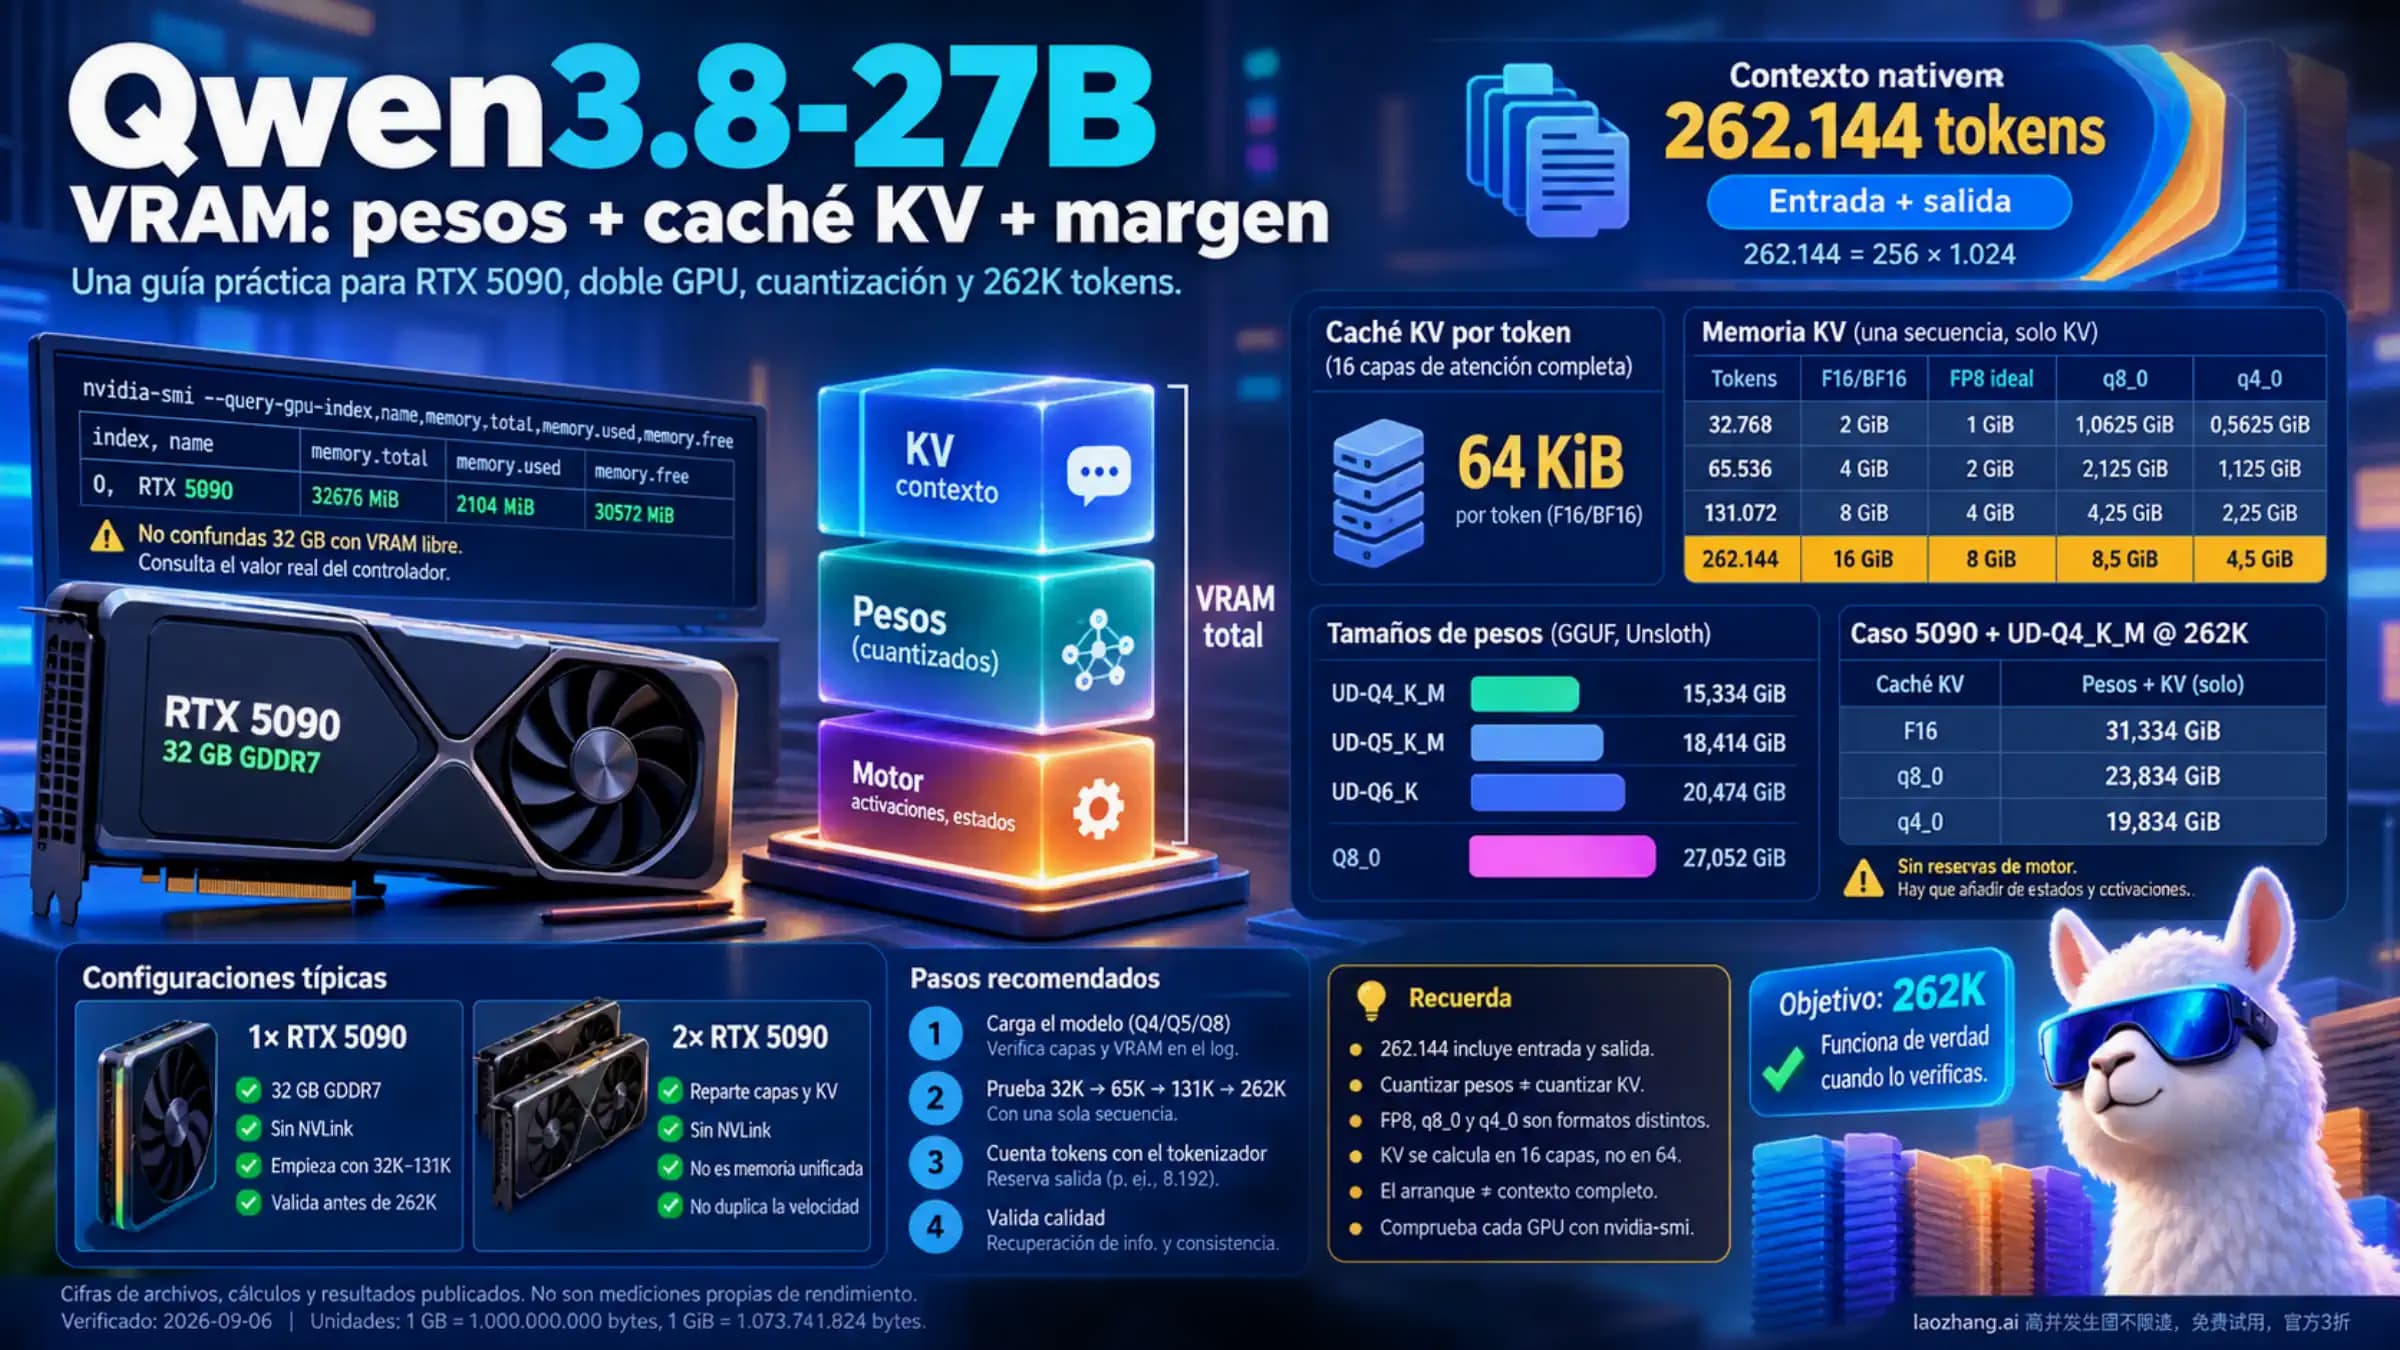
Para una estación de trabajo convencional, Qwen3.8-27B es el punto de partida más práctico. Es un modelo denso de 27B; su repositorio oficial BF16 ocupa unos 55,6 GB y el repositorio oficial FP8, 30,9 GB. El repositorio base está marcado como Apache-2.0. Es más fácil comprobar si cabe, planificar la latencia y recuperar el servicio si algo falla.
Qwen3.8-Flash-Next merece una prueba para tareas más exigentes, pero no es una opción de poca memoria, aunque la palabra Flash pueda sugerirlo. La ficha oficial describe un MoE de 125B con 6B activos por token, más 51B de n-gram embeddings y 4B de MTP. La revisión BF16 oficial comprobada ocupaba cerca de 360 GB. A6B describe una parte del cálculo; no describe la descarga ni todos los pesos que el sistema debe poder consultar.
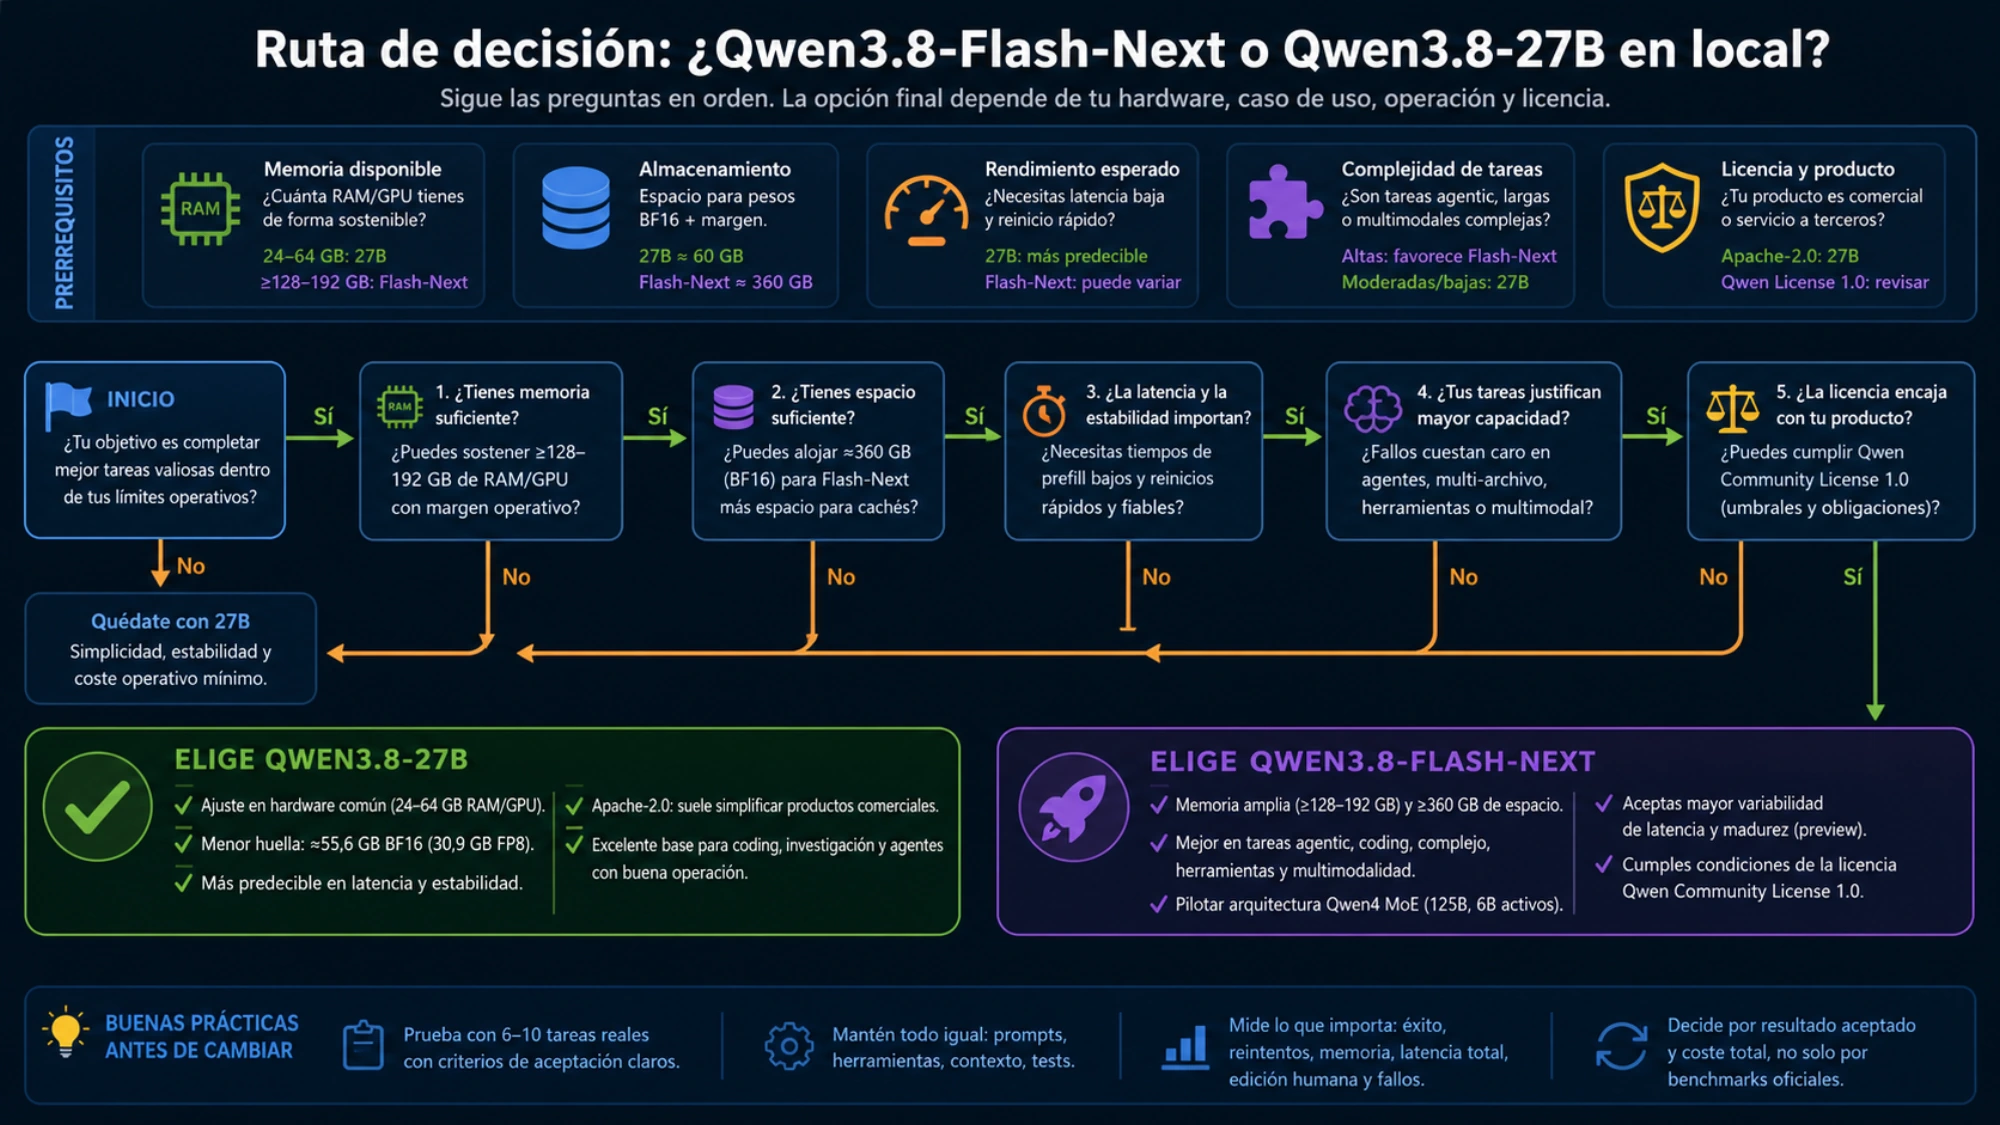
La regla útil es esta: elige 27B si cabe en tu equipo y buscas un modelo denso más sencillo de desplegar; prueba Flash-Next cuando las tareas complejas sean suficientemente valiosas y la infraestructura pueda absorber su huella. No cambies el modelo por defecto solo por una tabla oficial.
Las diferencias que cambian la decisión
| Factor | Qwen3.8-Flash-Next | Qwen3.8-27B |
|---|---|---|
| Arquitectura | MoE disperso de 125B, 6B activos | Denso de 27B |
| Bloques adicionales | 51B n-gram embedding y 4B MTP | MTP; sin el bloque n-gram de 51B listado |
| Contexto nativo | 262.144 tokens | 262.144 tokens |
| Artefactos BF16 oficiales | cerca de 360 GB en la revisión comprobada | unos 55,6 GB |
| FP8 oficial | confirmar la versión concreta disponible | 30,9 GB |
| Licencia | Qwen Community License 1.0 | Apache-2.0 |
| Madurez | versión preliminar experimental de una arquitectura Qwen4 | versión Qwen3.8 densa y compacta |
Las fuentes son las fichas oficiales de Qwen3.8-Flash-Next y Qwen3.8-27B. Ambas indican 262.144 tokens de contexto nativo y una vía de extensión a 1M. Ese máximo no garantiza que el hardware pueda servirlo con una latencia útil.
El tamaño del repositorio tampoco equivale a VRAM máxima. A los pesos se suman la caché KV, el contexto, las imágenes, el lote, la concurrencia y el entorno de inferencia. La cuantización reduce la huella, pero puede cambiar calidad y compatibilidad. Un Flash-Next muy comprimido y con descarga a RAM no es directamente comparable con un 27B que funciona cómodamente a mayor precisión.
Qué demuestra la tabla de Qwen
En la comparación del fabricante, Flash-Next supera a 27B en la mayoría de filas publicadas. DeepSWE 1.1 aparece como 58,7 frente a 42,2 y JobBench como 55,7 frente a 33,4. Sin embargo, SWE-bench Pro queda mucho más cerca: 62,5 frente a 61,7. Flash-Next también aventaja a 27B en varias evaluaciones de software multilingüe, uso de herramientas, trabajo profesional y multimodalidad.
Es una razón válida para poner Flash-Next en una prueba de programación o agentes. No demuestra que ganará en tu entorno. Las notas de la evaluación describen marcos distintos, temperatura, contexto de 256K, tareas corregidas, evaluaciones internas y modelos de valoración. Algunas filas usan el mejor resultado de más de un marco.
La tabla del proveedor formula una hipótesis. El resultado aceptado de tu tarea, con tu cuantización, entorno de inferencia, plantilla de instrucciones y herramientas, toma la decisión.
Cuándo es mejor 27B
Empieza por 27B si necesitas una sola máquina sin descarga agresiva a RAM, si quieres una planificación más sencilla para un modelo denso, si Apache-2.0 facilita la revisión del producto, si la latencia interactiva y el reinicio rápido son importantes, o si ya has validado una cuantización y una plantilla de 27B.
27B no es una alternativa débil. Qwen lo presenta como modelo nativo de visión y lenguaje para programación, investigación, trabajo profesional y agentes de larga duración. La pequeña diferencia en SWE-bench Pro recuerda que el modelo más grande no convierte cada tarea ordinaria en un resultado mejor.
En una tarea acotada, la estabilidad puede valer más que el techo de capacidad. Si Flash-Next pagina memoria, tarda mucho en procesar la entrada o necesita una cuantización más agresiva, el tiempo total hasta una respuesta aceptada puede favorecer a 27B.
Cuándo merece la pena Flash-Next
Pruébalo cuando un fallo genera una repetición cara: cambios de código entre varios archivos, cadenas largas de herramientas, recreación de aplicaciones, procesos de trabajo profesionales, software multilingüe o agentes multimodales. Qwen atribuye la nueva dirección a Qwen Sparse Attention, Gated Residual, n-gram Embedding y una receta de entrenamiento nueva. Es una arquitectura experimental real, no un cambio de nombre de 27B.
El estado preliminar añade incertidumbre operativa. vLLM, SGLang, TokenSpeed, llama.cpp y otros entornos pueden incorporar la arquitectura, MTP, vídeo y controles de razonamiento en momentos diferentes. Confirma la versión exacta y comienza con contexto corto antes de aumentar carga.
La licencia puede resolver la comparación antes que el rendimiento
Flash-Next utiliza Qwen Community License 1.0. Permite usar, modificar, distribuir, desplegar, alojar y ajustar los pesos, pero incluye condiciones materiales. Los productos comerciales que superan los umbrales de usuarios o ingresos indicados deben mostrar el nombre del modelo. Los negocios comerciales de Model as a Service y AI Work Assistant, tal como los define el texto, deben obtener una licencia separada de Qwen. Hay una excepción descrita para uso interno sin ofrecer a terceros el modelo, sus salidas o sus capacidades.
El repositorio oficial de 27B está marcado como Apache-2.0. Si vas a crear una API de modelo, un asistente de código o un asistente de oficina, revisa esta diferencia antes de invertir en integración. No es asesoramiento jurídico: hay que leer la licencia completa actual y aplicarla a los hechos del producto.
El servicio Flash alojado tiene sus propias condiciones
Qwen/Qwen3.8-Flash-Next es el identificador del repositorio de pesos para alojar el modelo en tu infraestructura. qwen3.8-flash de Qwen Cloud es un servicio alojado basado en Flash-Next con precios, límites de solicitudes, herramientas y disponibilidad del proveedor. No hereda el coste ni el SLA de una instalación local.
Si la infraestructura de Flash-Next es demasiado pesada, el servicio alojado puede ser otra prueba. Si necesitas privacidad, control del checkpoint y cuantización propia, valora alojarlo en tu propia infraestructura. No mezcles resultados de cuantizaciones publicadas por la comunidad con el endpoint oficial.
Una prueba de cambio con tareas idénticas
Selecciona entre seis y diez tareas con criterio de aceptación visible. Mantén iguales las instrucciones, reglas del sistema, archivos, imágenes, permisos de herramientas, límite de contexto, comando de prueba y rúbrica humana.
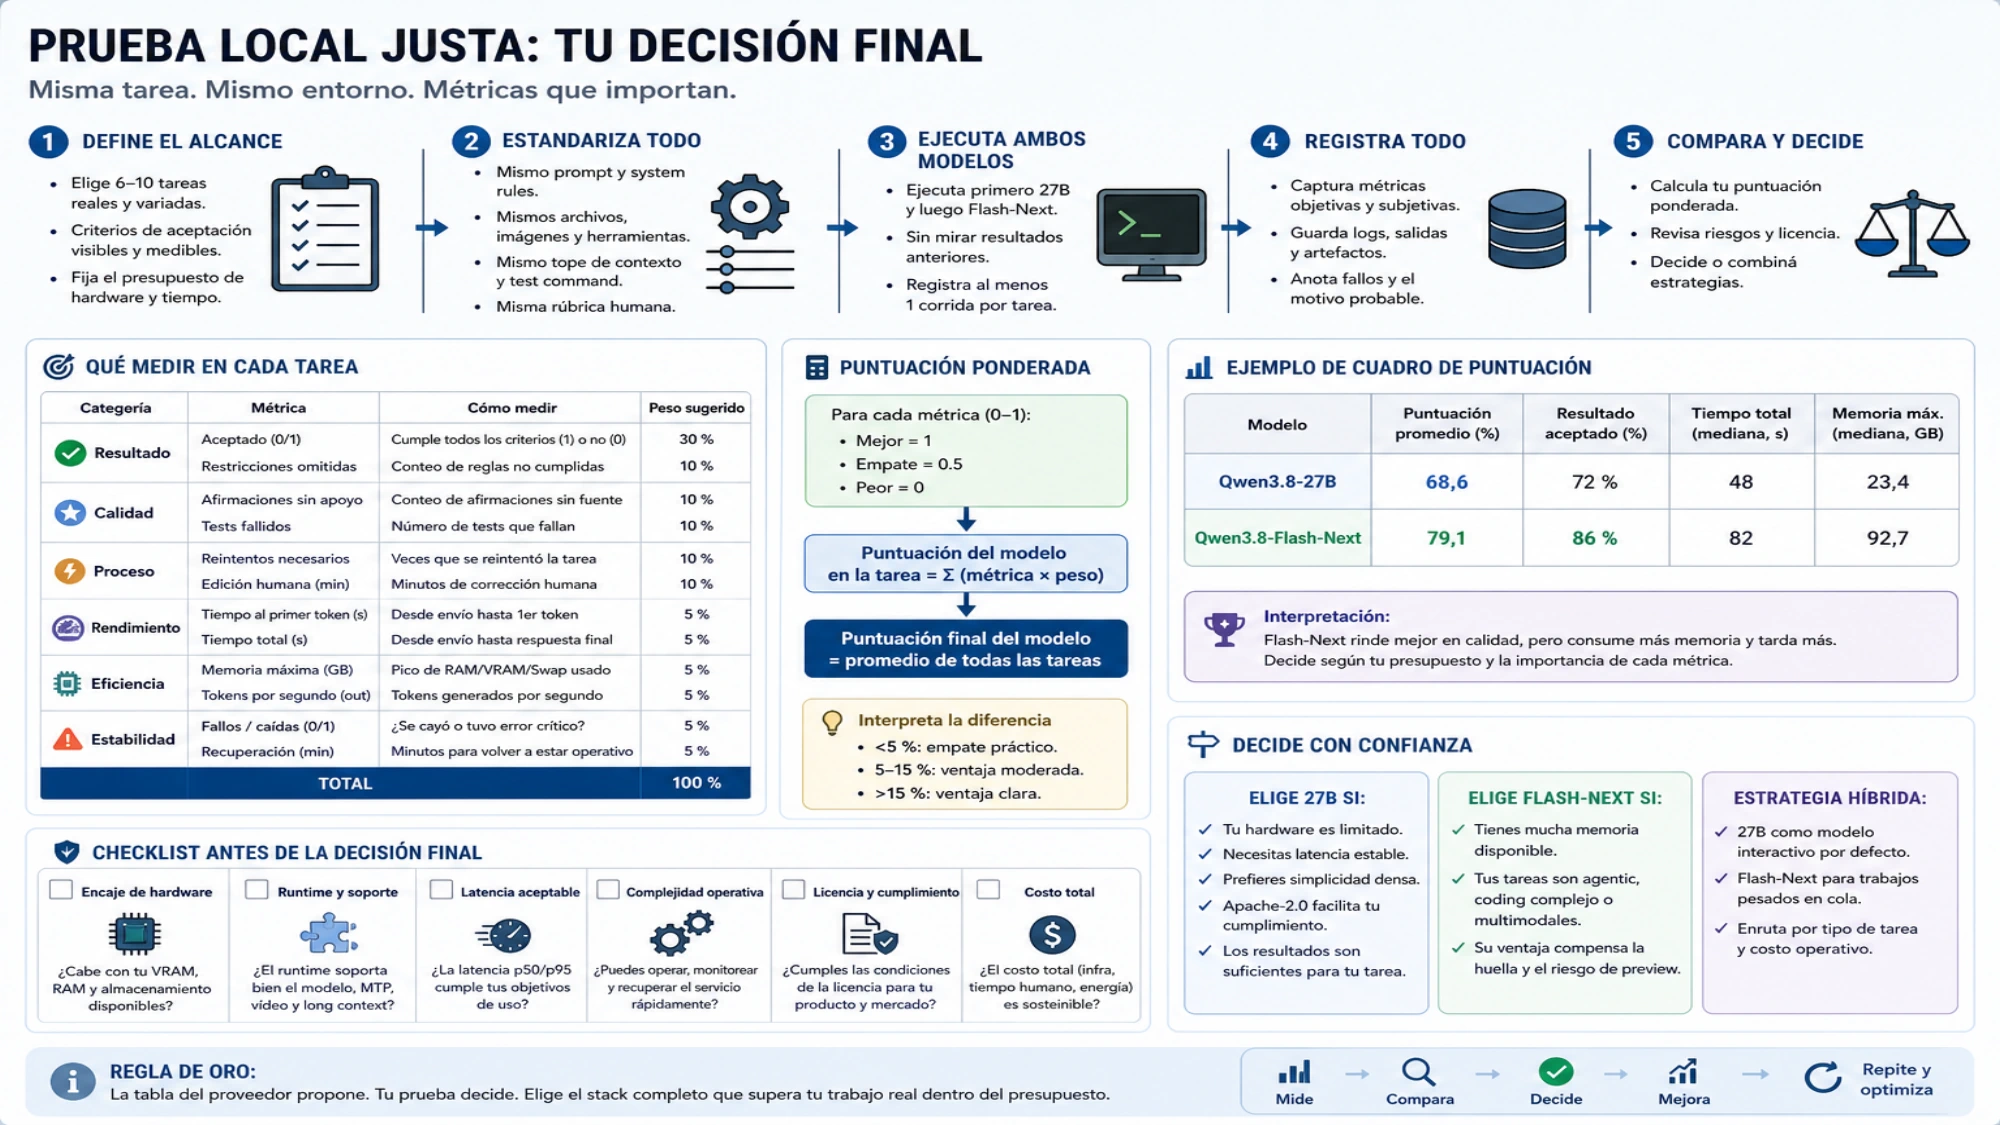
Registra resultado aceptado, restricciones omitidas, afirmaciones sin apoyo, pruebas fallidas, reintentos, edición humana, memoria máxima, tiempo al primer token, tiempo total y recuperación de fallos. Tokens por segundo no incluye el coste del revisor ni de una segunda ejecución.
Mantén 27B si los éxitos extra de Flash-Next no compensan memoria, descarga a RAM, revisión de licencia y tiempo humano. Avanza con Flash-Next si reduce de forma consistente reintentos en tareas caras y cabe en el presupuesto operativo. También puedes dividir el trabajo: 27B como modelo interactivo por defecto y Flash-Next para tareas pesadas en cola.
Con solo 16 GB de VRAM, empieza por la guía de LLM local para programación con 16 GB. Para ramas Qwen anteriores, consulta la guía Qwen3-30B-A3B.
Veredicto
Qwen3.8-27B gana como primera opción cuando necesitas que el modelo quepa en tu equipo, una operación sencilla y una licencia Apache-2.0. Flash-Next gana un lugar en la prueba cuando hay mucha memoria y el valor de completar mejor programación, agentes o multimodalidad compensa su huella y riesgo de versión preliminar.
Calcula la memoria a partir de todos los pesos y del contexto, verifica los resultados con tus propias tareas y revisa las condiciones de la licencia. El ganador útil es el sistema completo que supera tu trabajo real dentro del presupuesto.
Fuentes3
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 2 sept 2026.
Fuentes3
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 2 sept 2026.