Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro: capacidades y coste de la API
Compara las entradas admitidas, el contexto y la facturación de estas tres API, con costes calculados por petición y criterios para evaluar código, documentos y herramientas.
En esta página
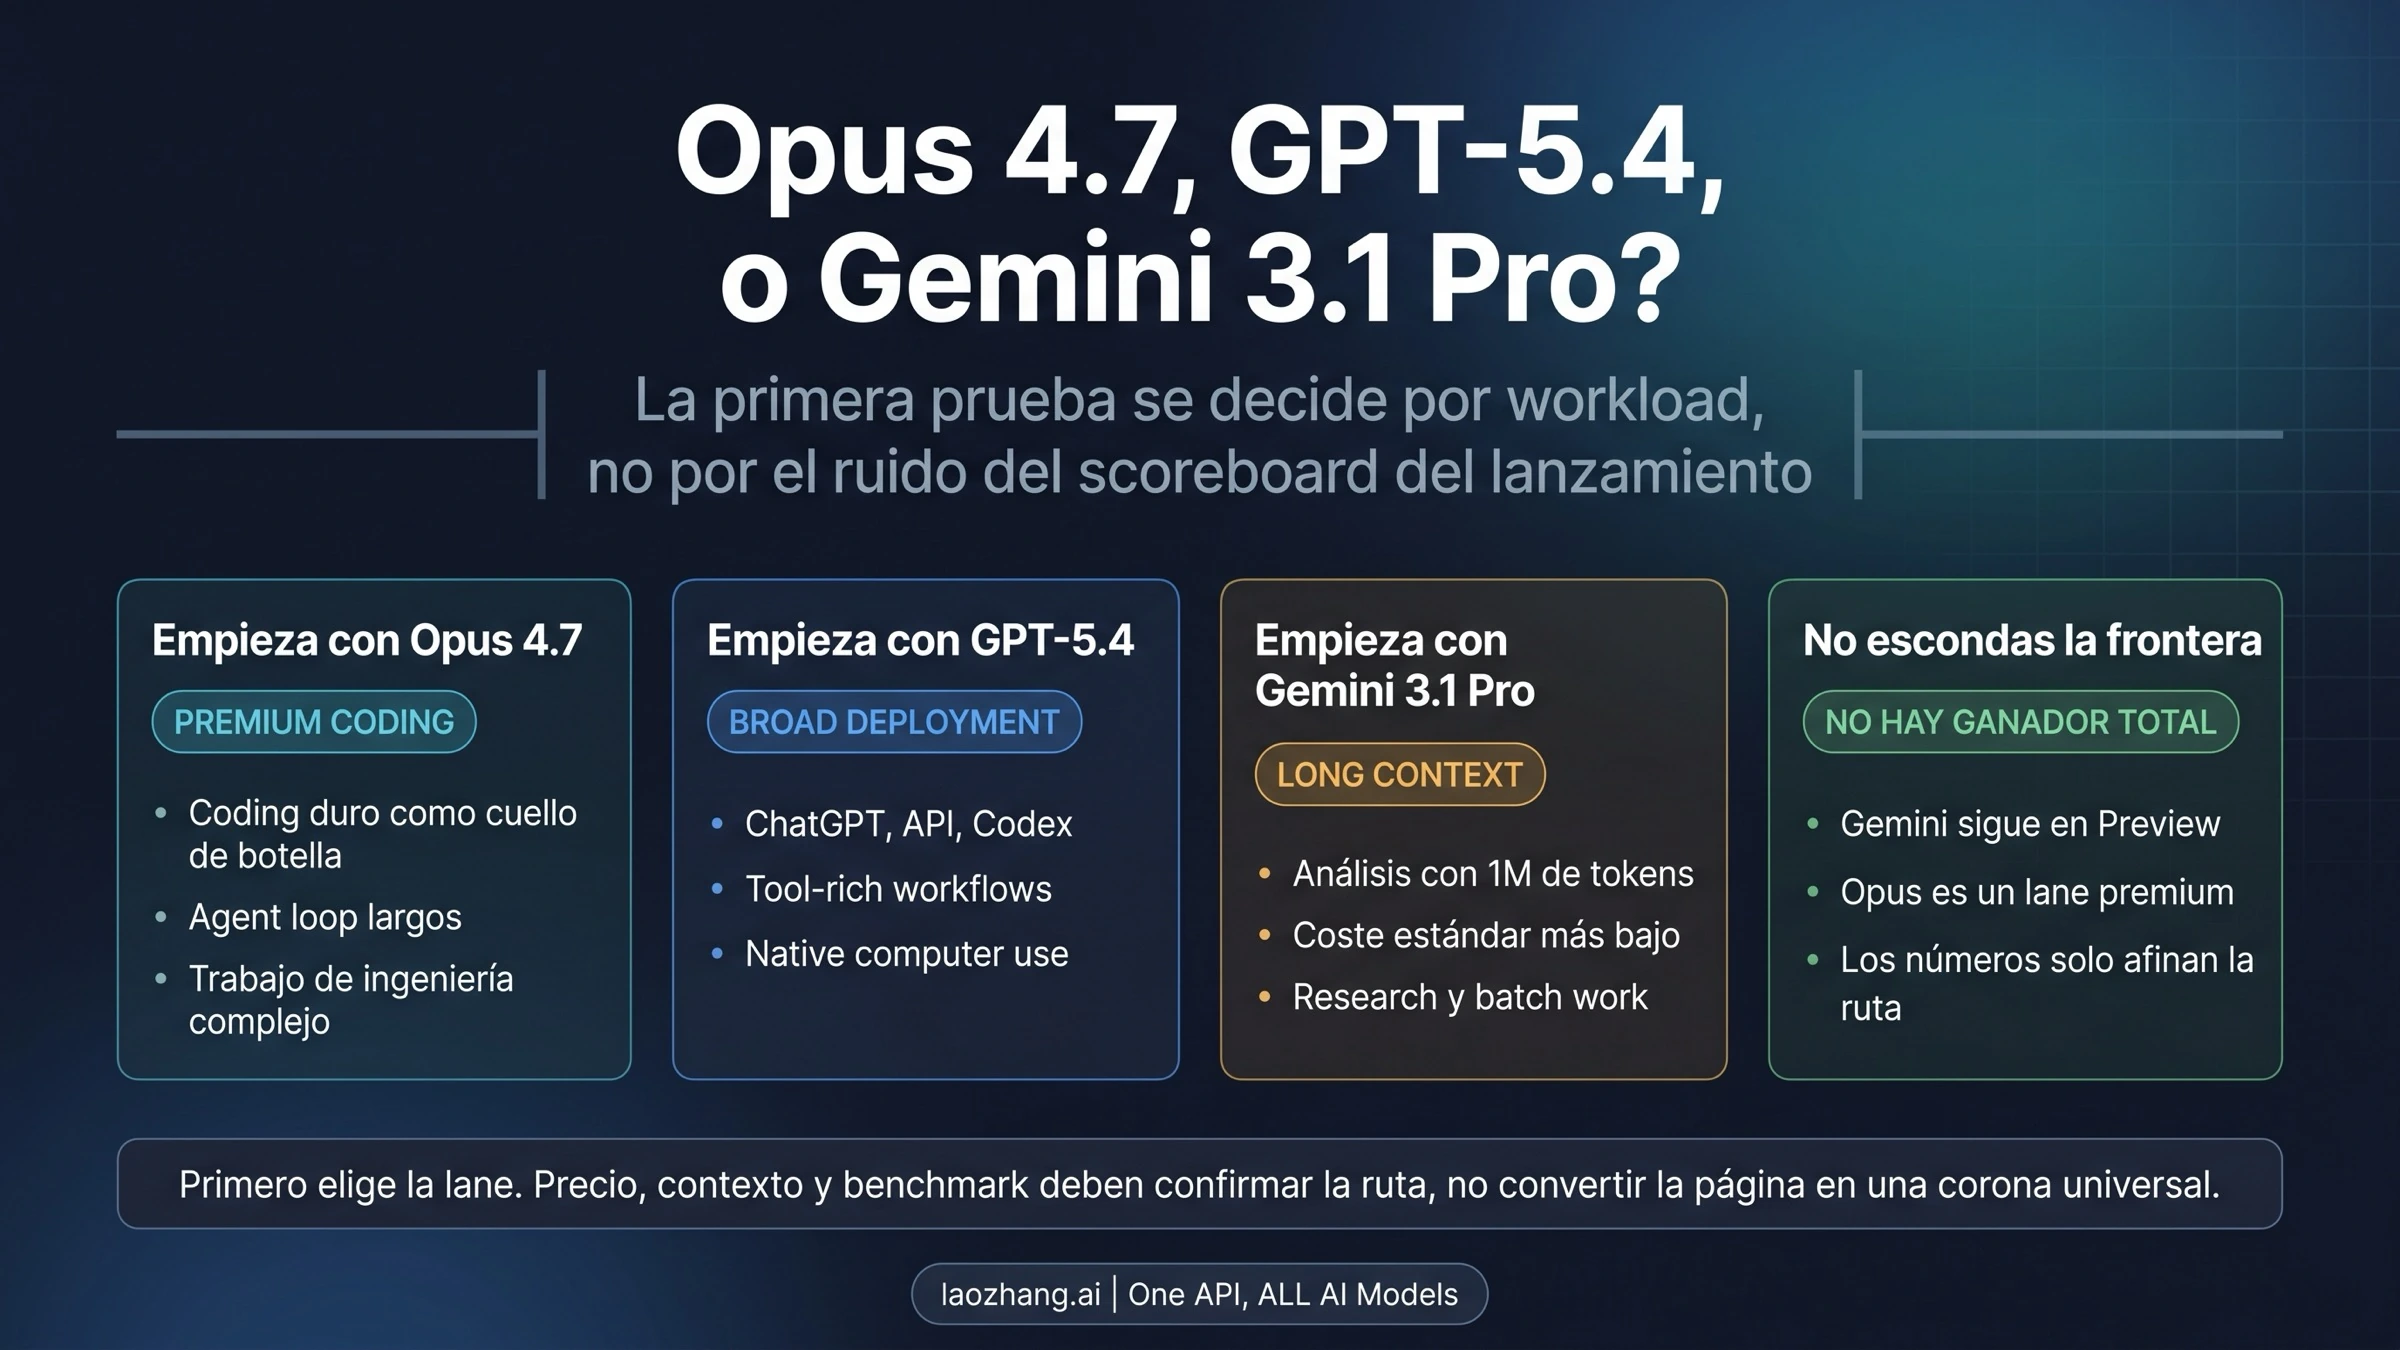
Para elegir entre Claude Opus 4.7, GPT-5.4 y Gemini 3.1 Pro, primero comprueba que la API admite tus archivos y herramientas; después compara el coste de obtener un resultado válido. El precio por millón de tokens ayuda, pero cambia con la longitud de la entrada y no demuestra qué modelo resolverá mejor tu tarea.
Hay una diferencia práctica que suele quedar oculta en las comparativas: con 250.000 tokens de entrada y 10.000 de salida facturable, el cálculo sin caché da 0,775 USD para GPT-5.4, 1,18 USD para Gemini 3.1 Pro y 1,50 USD para Opus 4.7. Gemini ya ha superado su umbral de precio; GPT todavía no. Con 100.000 tokens, el orden por coste es distinto. Más abajo puedes reproducir las cuentas.
Esta guía compara esos modelos concretos por API, con documentación comprobada el 7 de septiembre de 2026. No es una comparación de suscripciones de ChatGPT, Claude o Google, ni incluye pruebas propias de rendimiento.
Qué puedes enviar y recibir con cada API
Los tres admiten texto e imágenes y generan texto. La diferencia más visible está en las modalidades de entrada de Gemini, los límites de salida y las herramientas disponibles en cada interfaz.
| Característica | Claude Opus 4.7 | GPT-5.4 | Gemini 3.1 Pro |
|---|---|---|---|
| Identificador del modelo | claude-opus-4-7 | gpt-5.4 | gemini-3.1-pro-preview |
| Contexto o límite de entrada publicado | Contexto de 1 millón de tokens | Contexto de 1.050.000 tokens | Entrada de hasta 1.048.576 tokens |
| Máximo de salida publicado | 128.000 tokens | 128.000 tokens | 65.536 tokens |
| Modalidades admitidas por el modelo | Texto e imágenes de entrada; texto de salida | Texto e imágenes de entrada; texto de salida | Texto, imágenes, audio, vídeo y PDF de entrada; texto de salida |
| Aspecto que revisar antes de integrar | Razonamiento adaptativo y consumo de tokens | Compatibilidad de herramientas con el endpoint elegido | Estado Preview y funciones concretas admitidas |
Fuentes de los límites y modalidades: ficha oficial de Opus 4.7, ficha oficial de GPT-5.4 y ficha oficial de Gemini 3.1 Pro Preview. Una ventana de contexto y un límite de entrada no son términos intercambiables: deja espacio para instrucciones, historial, herramientas y respuesta según las reglas de la API.
Si necesitas analizar audio o vídeo directamente con uno de estos modelos, Gemini es el candidato de esta tabla cuya ficha enumera esas modalidades. No implica que produzca audio o imágenes: su salida es texto y la ficha no admite generación de audio, generación de imágenes ni Live API. Si conviertes primero una grabación en una transcripción, estarás comparando otro procedimiento; incluye el tiempo y el coste de esa conversión.
Para un documento de texto largo, los tres ofrecen una capacidad del orden de un millón de tokens. Que el archivo quepa no demuestra que el modelo encuentre y relacione correctamente la información. Una respuesta que omite una excepción al final del documento puede costar poco y seguir siendo inservible.
Comprueba las herramientas donde vas a ejecutar la petición
GPT-5.4 está disponible mediante Responses y Chat Completions, entre otras opciones; su ficha recoge llamadas a funciones y enumera herramientas para Responses API, como búsqueda web o búsqueda en archivos. Antes de trasladar un prototipo, verifica las combinaciones admitidas por el endpoint elegido. La existencia de una función en otra aplicación de OpenAI no confirma que tu petición API la ofrezca de la misma forma.
Gemini 3.1 Pro Preview admite llamadas a funciones, ejecución de código, respuestas estructuradas y búsqueda de Google como fuente de apoyo. Su ficha señala la búsqueda en archivos como disponible solo en AI Studio. Tampoco debes dar por hecho que la variante customtools mejora todas las tareas: es una variante independiente orientada a priorizar herramientas personalizadas. Estos detalles figuran en la documentación del modelo.
En Opus 4.7, el razonamiento adaptativo afecta a cómo planificas el trabajo y el presupuesto. Para cualquier integración con herramientas, registra también sus argumentos, resultados y llamadas adicionales: forman parte del trabajo que estás comparando, no solo del texto final.
Cuánto cuesta una petición: los umbrales cambian el orden
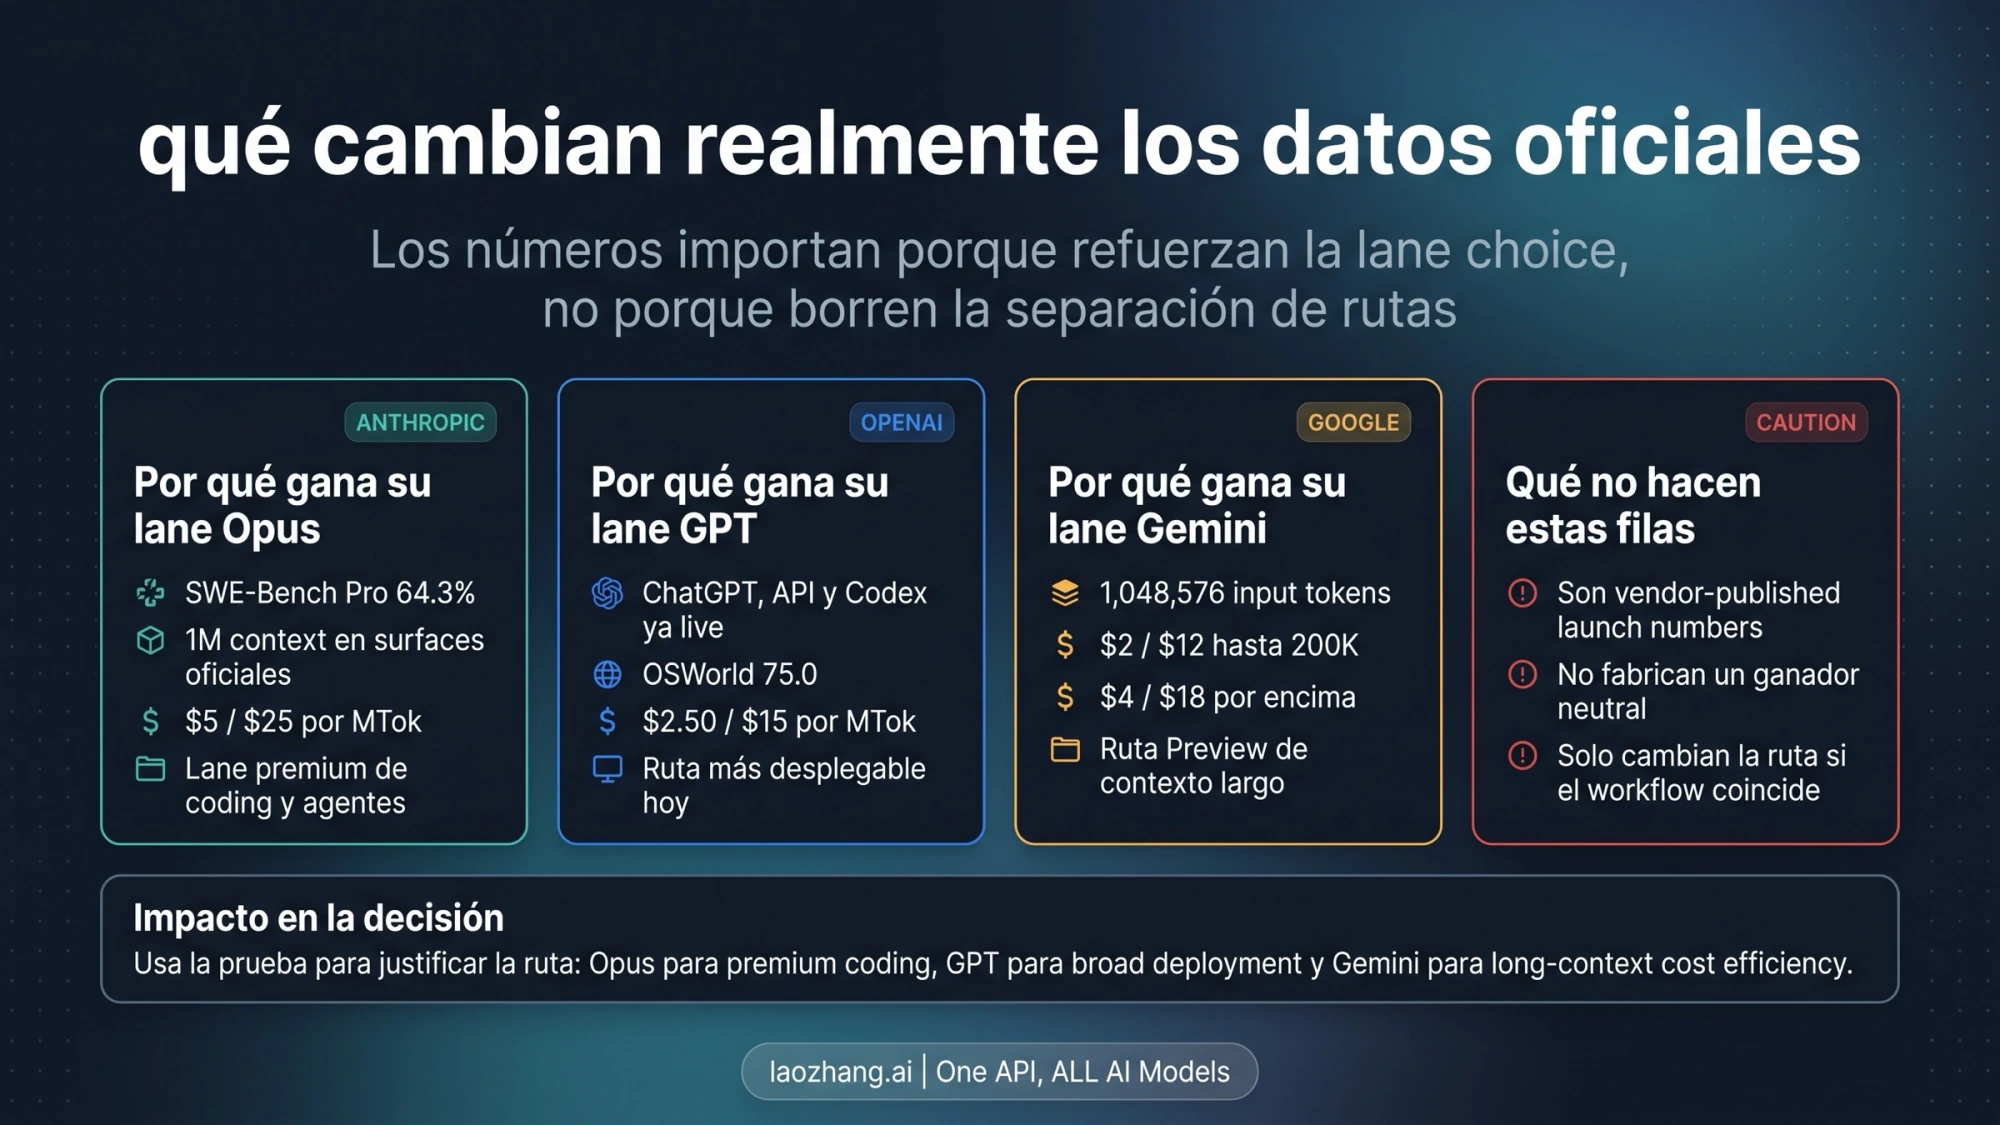
Las tarifas siguientes están expresadas en USD por millón de tokens, para peticiones estándar sin caché. No incluyen herramientas, impuestos ni descuentos de procesamiento por lotes.
| Modelo y tamaño de entrada | Entrada | Salida |
|---|---|---|
| Opus 4.7, dentro de su contexto admitido | 5 USD | 25 USD |
| GPT-5.4, hasta 272.000 tokens de entrada | 2,50 USD | 15 USD |
| GPT-5.4, más de 272.000 tokens de entrada | 5 USD | 22,50 USD |
| Gemini 3.1 Pro, hasta 200.000 tokens de entrada | 2 USD | 12 USD |
| Gemini 3.1 Pro, más de 200.000 tokens de entrada | 4 USD | 18 USD |
Para GPT-5.4, la ficha del modelo publica la tarifa base de 2,50/15 USD y especifica que, al superar 272.000 tokens de entrada, la sesión completa pasa a entrada al doble y salida a 1,5 veces la tarifa. No se aplica el recargo únicamente a los tokens que exceden el umbral.
Anthropic mantiene la tarifa estándar para el contexto completo de Opus 4.7, sin un tramo de contexto largo adicional; véase su documentación de precios. Google publica los dos tramos de Gemini en la tabla de precios de Gemini API, donde la salida incluye los tokens de razonamiento facturables.
Para reproducir un cálculo sin caché ni herramientas:
coste = (tokens de entrada / 1.000.000 × tarifa de entrada)
      + (tokens de salida facturables / 1.000.000 × tarifa de salida)
Supongamos que cada API contabiliza la entrada indicada y 10.000 tokens de salida facturables:
| Entrada contabilizada por cada API | Opus 4.7 | GPT-5.4 | Gemini 3.1 Pro |
|---|---|---|---|
| 100.000 tokens | 0,750 USD | 0,400 USD | 0,320 USD |
| 250.000 tokens | 1,500 USD | 0,775 USD | 1,180 USD |
| 300.000 tokens | 1,750 USD | 1,725 USD | 1,380 USD |
Por ejemplo, para 250.000 tokens en Gemini: 0,25 × 4 + 0,01 × 18 = 1,18 USD. En GPT-5.4: 0,25 × 2,50 + 0,01 × 15 = 0,775 USD. Estas son cuentas ilustrativas, no facturas observadas ni resultados de una prueba de calidad.
El mismo archivo no tiene necesariamente el mismo número de tokens en las tres API. Anthropic indica que el tokenizador de Opus 4.7 puede producir aproximadamente entre 1,0 y 1,35 veces los tokens de la misma entrada respecto al anterior, dependiendo del contenido; no es un aumento fijo del 30 % ni una conversión frente a GPT o Gemini. La explicación está en el anuncio de Opus 4.7. Cuenta la entrada con cada proveedor y contrasta la estimación con el uso finalmente facturado.
Caché, razonamiento y herramientas: lo que falta en la cuenta sencilla
Si repites un documento o instrucciones extensas, calcula por separado la primera petición y las siguientes. Opus 4.7 publica 0,50 USD por millón de tokens leídos de caché, pero escribirlos cuesta 6,25 USD para cinco minutos o 10 USD para una hora. GPT-5.4 publica una base de 0,25 USD para entrada en caché, sujeta a las reglas aplicables a la petición. Gemini publica lecturas a 0,20/0,40 USD según el tramo y almacenamiento a 4,50 USD por millón de tokens y hora. Fuentes: Anthropic, OpenAI y Google.
Una tarifa reducida de lectura solo compensa si reutilizas suficiente contenido durante su vigencia. En Google, además, mantener la caché tiene un coste de almacenamiento. Evita presentar el precio de lectura como el coste completo de la primera consulta.
En un agente, añade los tokens de definiciones y resultados de herramientas, las llamadas sucesivas y cualquier herramienta cobrada por uso. Para la salida, utiliza el total facturable que comunique el proveedor, no solo la longitud del texto que ve la persona. Y conserva los reintentos fallidos en la cuenta: consumir presupuesto sin resolver la tarea también forma parte del coste.
Cómo elegir con una evaluación que puedas repetir
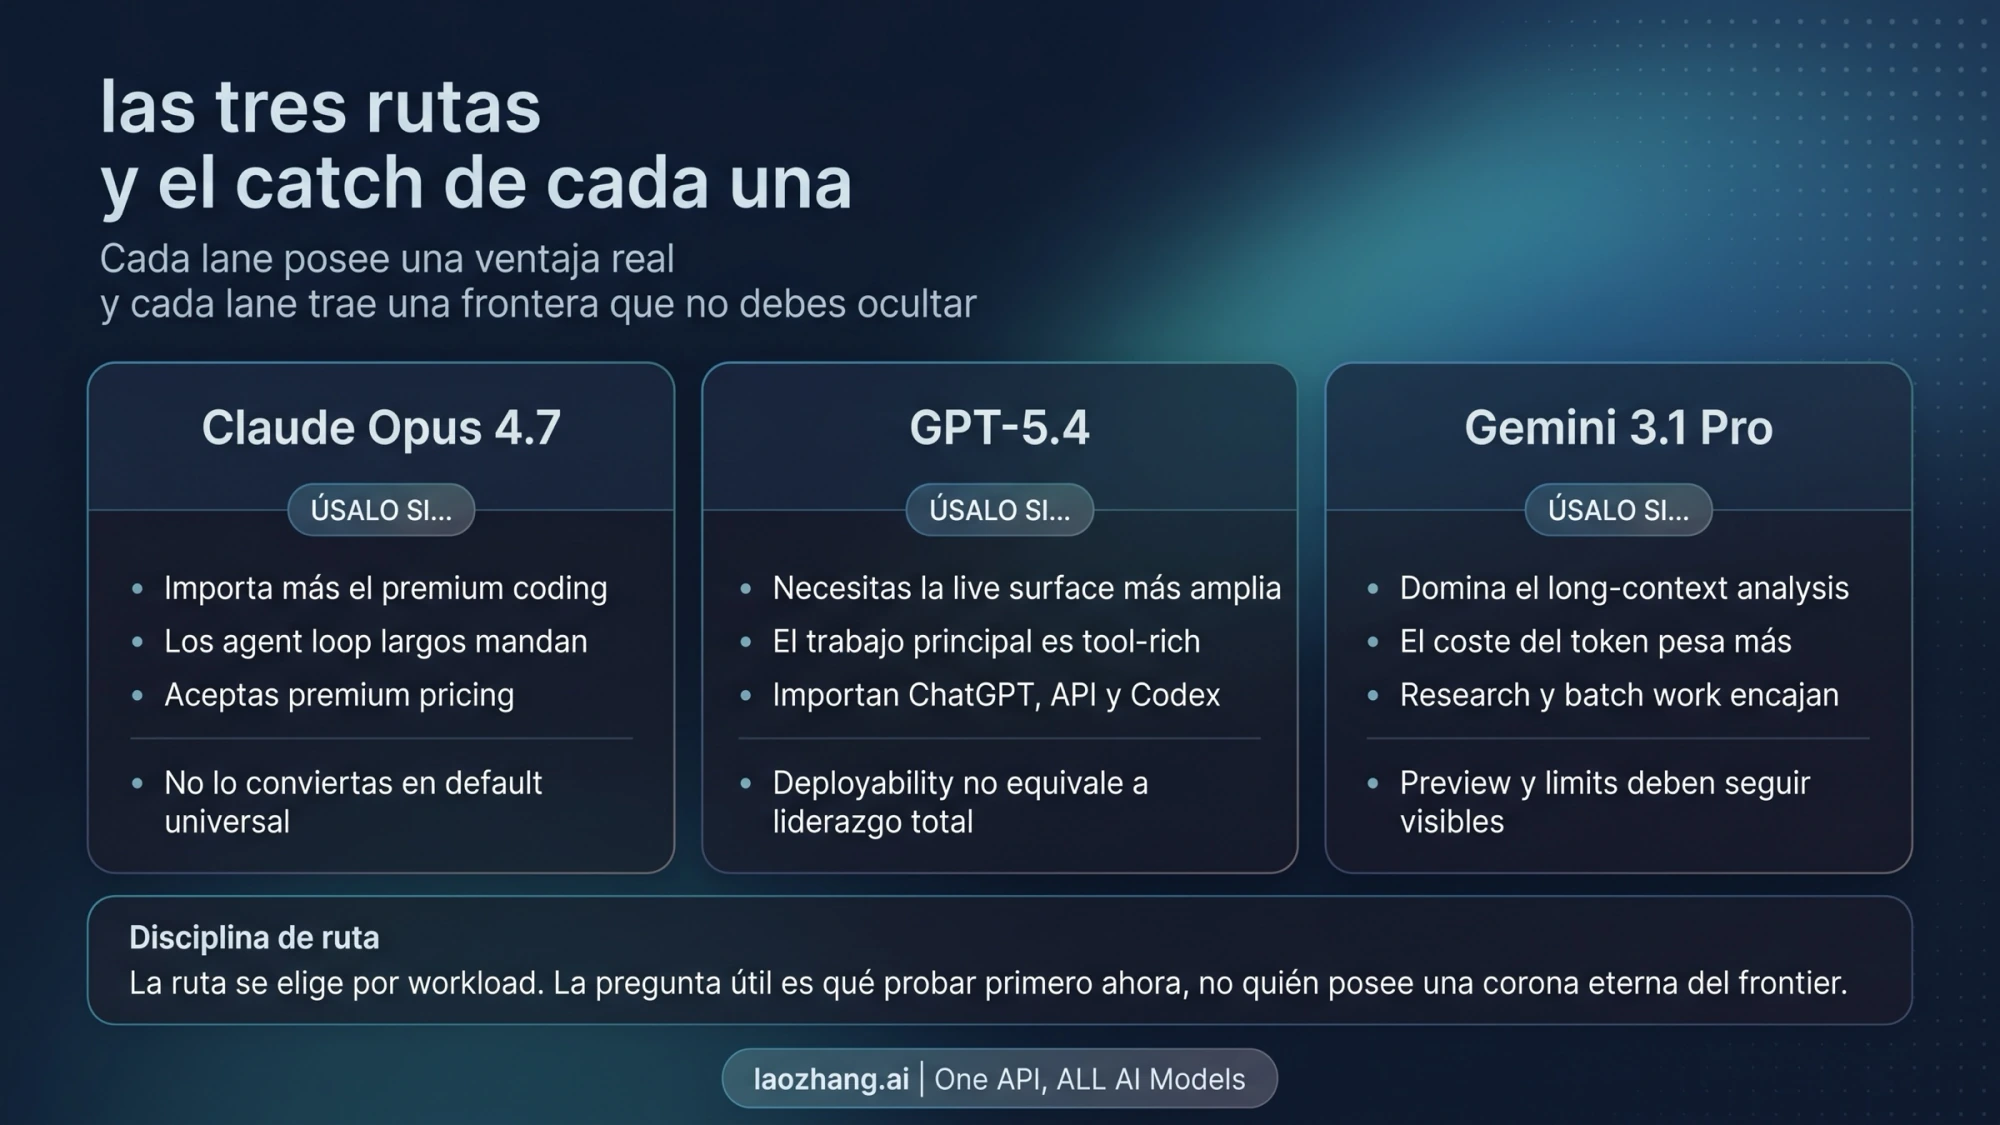
Las pruebas publicadas por los fabricantes sirven para identificar tareas que merece la pena explorar. Sin igualar instrucciones, herramientas, presupuesto de razonamiento y criterios de corrección, sus cifras no demuestran un ganador en tu aplicación. En lugar de asignar a cada marca una especialidad definitiva, prepara una muestra de trabajos que ya puedas corregir.
| Trabajo real | Material para la prueba | Condición para aceptar el resultado | Motivo de rechazo |
|---|---|---|---|
| Corregir un error de programación | Repositorio fijado a una revisión, fallo reproducible y pruebas existentes | Corrige el fallo, pasa las pruebas y conserva el comportamiento requerido | Cambia las pruebas para ocultar el fallo, rompe otra función o deja un parche que no se ejecuta |
| Revisar documentos largos | Documentos con respuestas y excepciones previamente localizadas | Responde correctamente y señala el fragmento que respalda cada afirmación relevante | Inventa una cláusula, omite una excepción decisiva o cita una ubicación inexistente |
| Extraer datos estructurados | Casos completos, campos ausentes y ejemplos ambiguos | Devuelve el formato esperado y coincide con los valores comprobados | Rellena datos desconocidos, altera unidades o incumple el esquema |
| Usar herramientas | Entorno de prueba con respuestas conocidas y permisos delimitados | Elige la herramienta adecuada, envía argumentos correctos y termina al alcanzar el objetivo | Ejecuta una acción ajena al encargo, repite llamadas sin progreso o declara éxito sin obtenerlo |
Fija las condiciones antes de empezar. Usa el mismo objetivo, los mismos datos y los mismos límites de herramientas; documenta cualquier adaptación de formato necesaria para cada API. Establece un presupuesto máximo de tiempo y gasto por tarea, y configura el razonamiento para respetarlo. Una etiqueta de esfuerzo con el mismo nombre en dos servicios no garantiza el mismo consumo.
Registra el identificador exacto del modelo, la fecha, los parámetros y la versión de tu aplicación. GPT-5.4 ofrece, por ejemplo, el identificador fechado gpt-5.4-2026-03-05 en su ficha oficial. En las tareas variables, repite los casos y conserva los fallos; no elijas únicamente la respuesta más convincente.
Después compara tres resultados: proporción de tareas aceptadas, tiempo hasta un resultado aceptado y coste total dividido entre tareas aceptadas. Si una muestra cuesta 3 USD y resuelve 8 tareas, el coste por tarea resuelta es 0,375 USD. Si otra cuesta 2 USD y resuelve 4, es 0,50 USD. Son ejemplos aritméticos: muestran por qué el modelo más barato por petición puede salir más caro en el trabajo completo.
La decisión puede ser usar un modelo para las tareas que resuelve de forma económica y recurrir a otro cuando falla un criterio verificable. Para justificarlo, incluye también el coste y el tiempo de ese segundo intento en la evaluación. No presupongas que repartir peticiones entre proveedores siempre mejora el resultado.
Estado del modelo y acceso: dos comprobaciones finales
La ficha consultada de Opus 4.7 lo clasifica como Active (legacy); por tanto, no corresponde presentarlo como el modelo más reciente de Anthropic. Gemini conserva el identificador Preview. Esa etiqueta debe entrar en la decisión si tu aplicación exige un modelo estable: revisa disponibilidad, límites y política de cambios en la cuenta donde vayas a integrarlo, sin deducir una calidad inferior solo del nombre.
La tabla de precios de Google no ofrece un nivel gratuito de API para Gemini 3.1 Pro Preview. Poder probarlo en AI Studio no equivale a disponer de una API gratuita para producción. Tampoco una suscripción a una aplicación de chat permite asumir crédito de API incluido.
Si ya utilizas Opus 4.6, la siguiente decisión incluye el cambio de tokenizador y la regresión sobre tu código: consulta la comparación entre Opus 4.7 y Opus 4.6. Si el obstáculo es cómo probar Gemini y qué se factura, continúa con el acceso a Gemini 3.1 Pro Preview y su API.
Para escoger entre estas tres API, elimina primero las que no cumplan los requisitos de entrada, salida o herramientas. Calcula después tus peticiones a ambos lados de los umbrales relevantes y prueba los candidatos restantes con criterios de aceptación ya escritos. Eso permite decidir cuánto estás dispuesto a pagar por una tarea resuelta sin convertir el posicionamiento de un proveedor en una conclusión de rendimiento.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 7 sept 2026.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 7 sept 2026.
- 1.ficha oficial de Opus 4.7platform.claude.com/docs/id/models/opus-4-7/overview
- 2.ficha oficial de GPT-5.4developers.openai.com/api/docs/models/gpt-5.4
- 3.ficha oficial de Gemini 3.1 Pro Previewai.google.dev/gemini-api/docs/models/gemini-3.1-pro-preview
- 4.documentación de preciosplatform.claude.com/docs/en/about-claude/pricing
- 5.tabla de precios de Gemini APIai.google.dev/gemini-api/docs/pricing
- 6.anuncio de Opus 4.7anthropic.com/news/claude-opus-4-7