Cambiar la base_url de OpenAI: qué ajuste gana y qué ruta poner
El argumento base_url gana a OPENAI_BASE_URL. La URL debe llevar el prefijo del proveedor (/v1, /openai/v1, /v1beta/openai), nunca la ruta /chat/completions.
En esta página
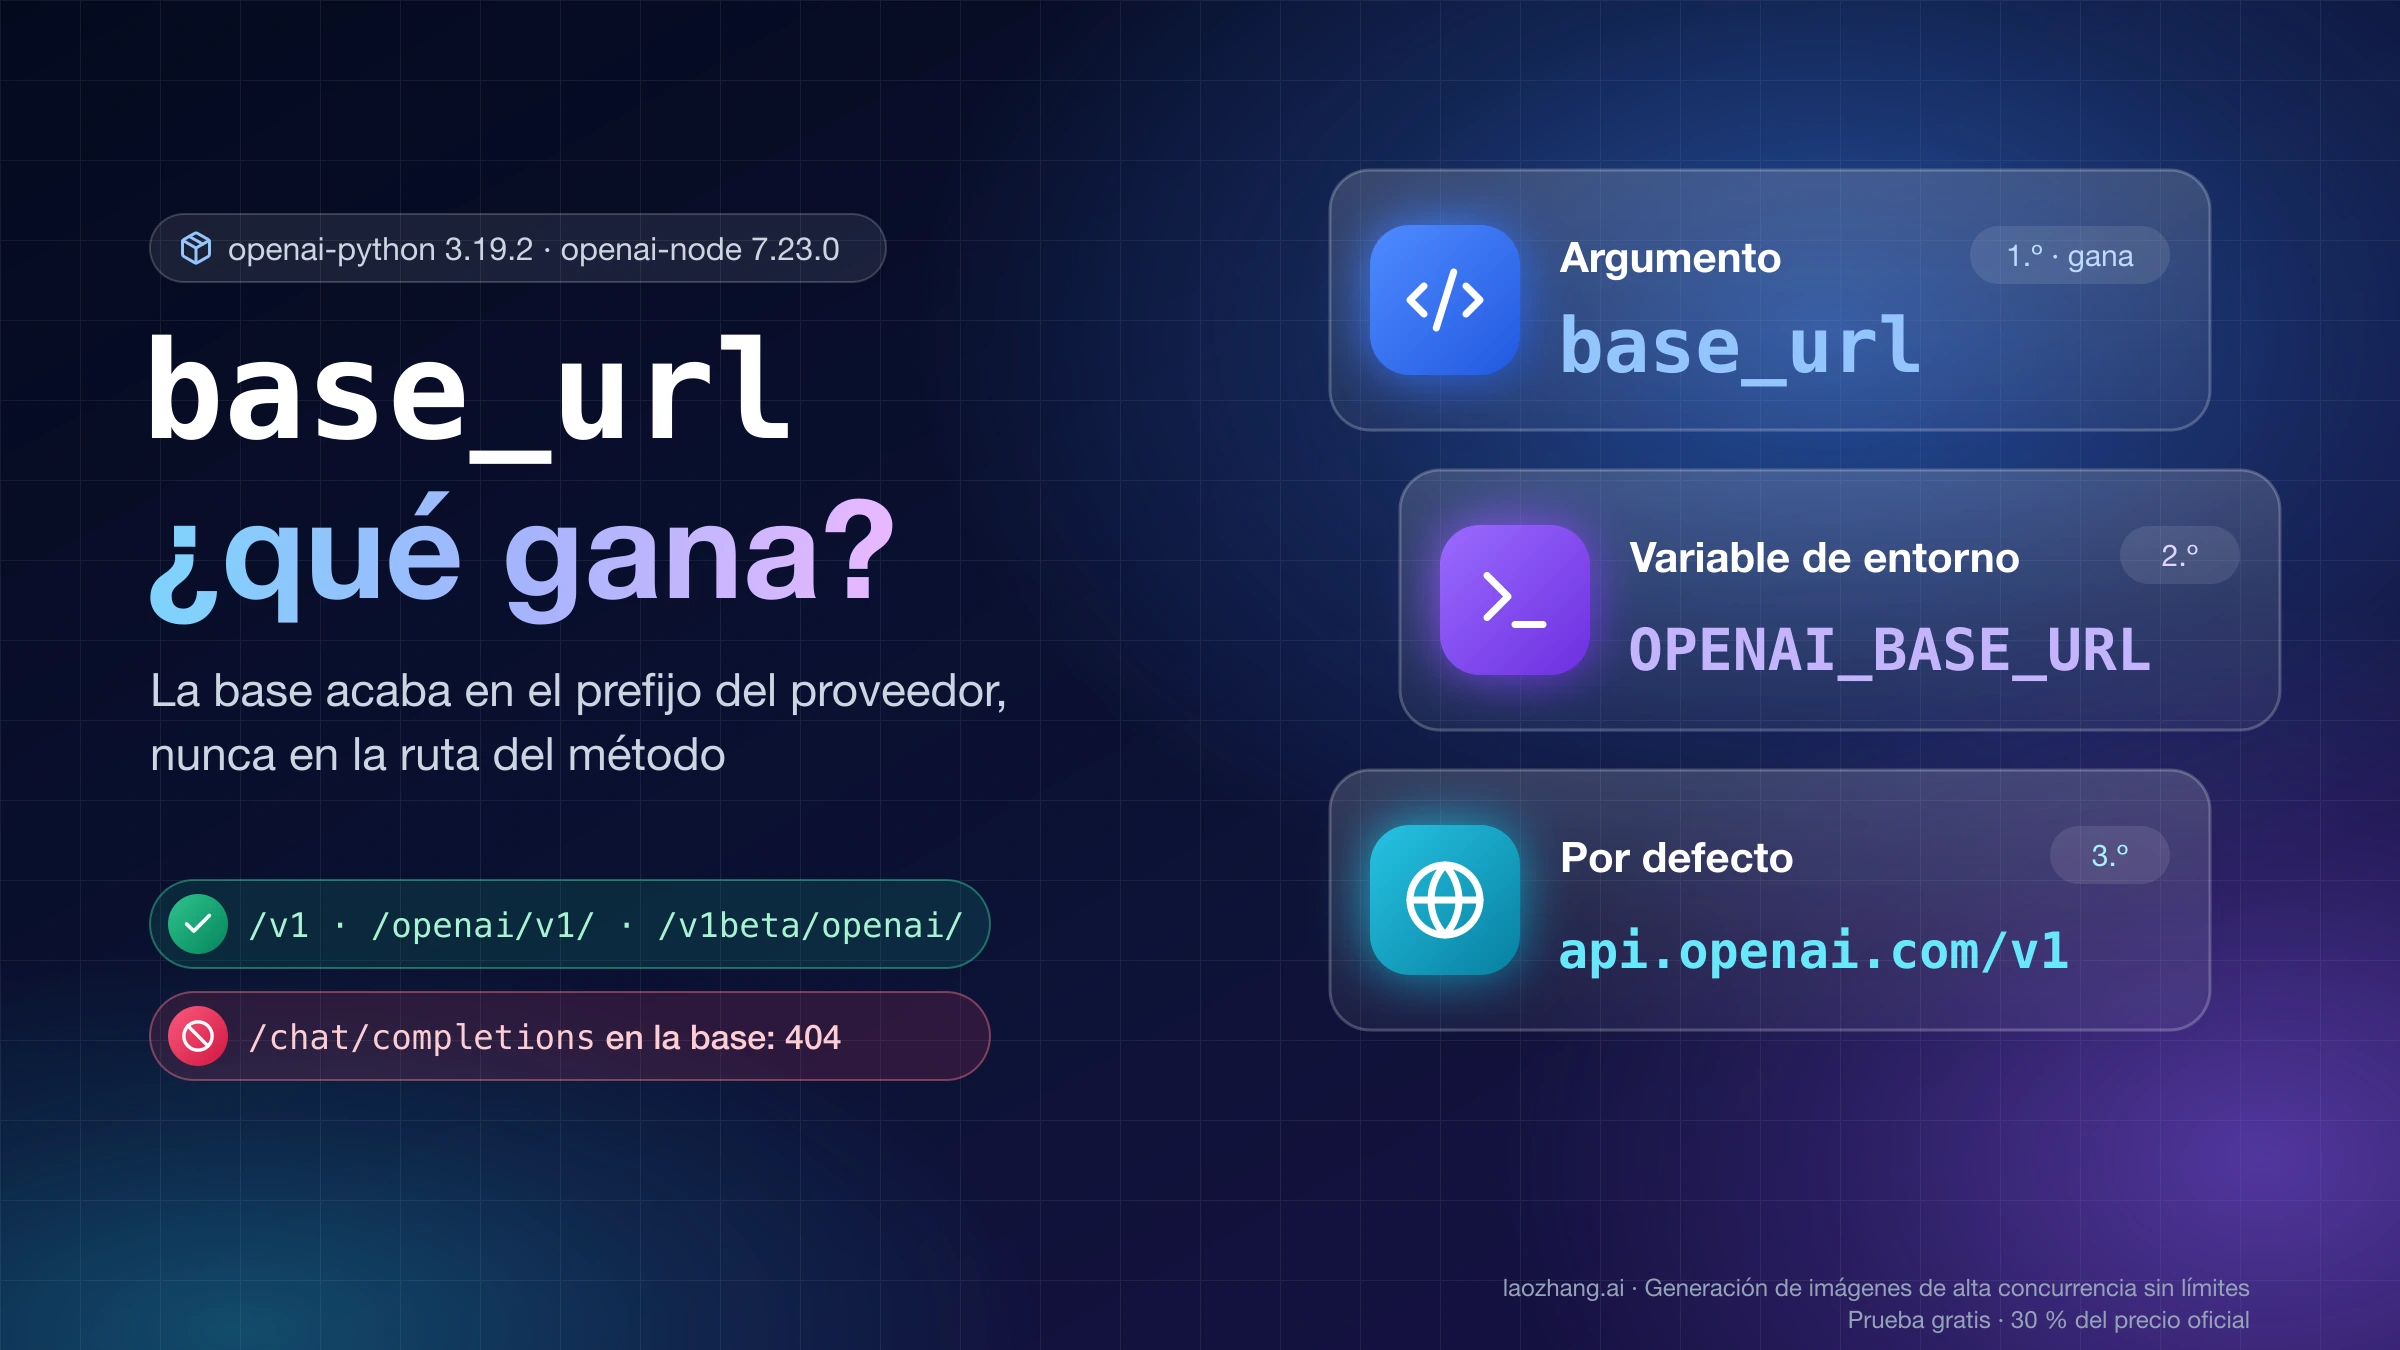
En los SDK oficiales de OpenAI, la URL base se decide en este orden: el argumento del constructor (base_url en Python, baseURL en Node), después la variable de entorno OPENAI_BASE_URL y, si no hay ninguna, https://api.openai.com/v1. El SDK añade a esa base la ruta de cada método (/chat/completions, /responses), así que la base tiene que terminar justo donde termina el prefijo del proveedor: /v1 en una pasarela típica, /openai/v1/ en Azure OpenAI y /v1beta/openai/ en Gemini.
El comportamiento descrito aquí corresponde a openai-python 3.19.2 y openai-node 7.23.0, las versiones publicadas a 26 de septiembre de 2026, comprobado contra un servidor de eco local que registra la ruta de cada petición. Si usas Cursor, su campo "Override OpenAI Base URL" funciona con otras reglas; están más abajo.
Qué valor gana cuando hay varios
Es fácil tener la base configurada en un sitio mientras el cliente la lee de otro. Esta tabla recoge lo que hace cada SDK cuando conviven varios ajustes:
| Situación | Python (openai 3.19.2) | Node (openai 7.23.0) |
|---|---|---|
Argumento del constructor y OPENAI_BASE_URL a la vez | Gana el argumento | Gana el argumento |
Solo OPENAI_BASE_URL | Se usa la variable | Se usa la variable |
| Ninguno de los dos | https://api.openai.com/v1 | https://api.openai.com/v1 |
OPENAI_BASE_URL definida pero vacía | La base queda vacía y la llamada falla con APIConnectionError: Connection error. | Vuelve sin avisar a https://api.openai.com/v1 |
Solo la variable antigua OPENAI_API_BASE | Se ignora: el cliente sigue en api.openai.com | Se ignora igual |
data_residency="eu" / dataResidency: 'eu' con OPENAI_BASE_URL definida | Gana la residencia: https://eu.api.openai.com/v1 | Igual |
baseURL: null con la variable definida | — | No lee la variable y usa el valor por defecto |
with_options(base_url=...) / withOptions({ baseURL }) | Cambia solo esa llamada; el cliente conserva su base | Igual |
Tres filas merecen atención. La variable vacía se comporta distinto en cada lenguaje: en Node la petición acaba en OpenAI con una clave que quizá sea de otro proveedor, y OpenAI la rechazará como clave incorrecta. La variable OPENAI_API_BASE viene de la librería anterior a la versión 1 (se usaba junto a openai.api_base) y sigue apareciendo en tutoriales de 2023 y 2024; los SDK actuales no la leen, aunque algún framework puede leerla por su cuenta, así que consulta su documentación antes de dar por hecho cuál usa. Y la residencia de datos no es una URL que escribas a mano: el SDK conoce los hosts us.api.openai.com, eu.api.openai.com y ae.api.openai.com y los elige con data_residency. En Python, combinar data_residency o provider con base_url lanza un error al crear el cliente; en Node, provider no se puede combinar con baseURL ni con dataResidency.
La variable se lee al construir el cliente. Si la defines con os.environ después de crear OpenAI(), ese cliente no la verá.
Cómo une el SDK la base y la ruta
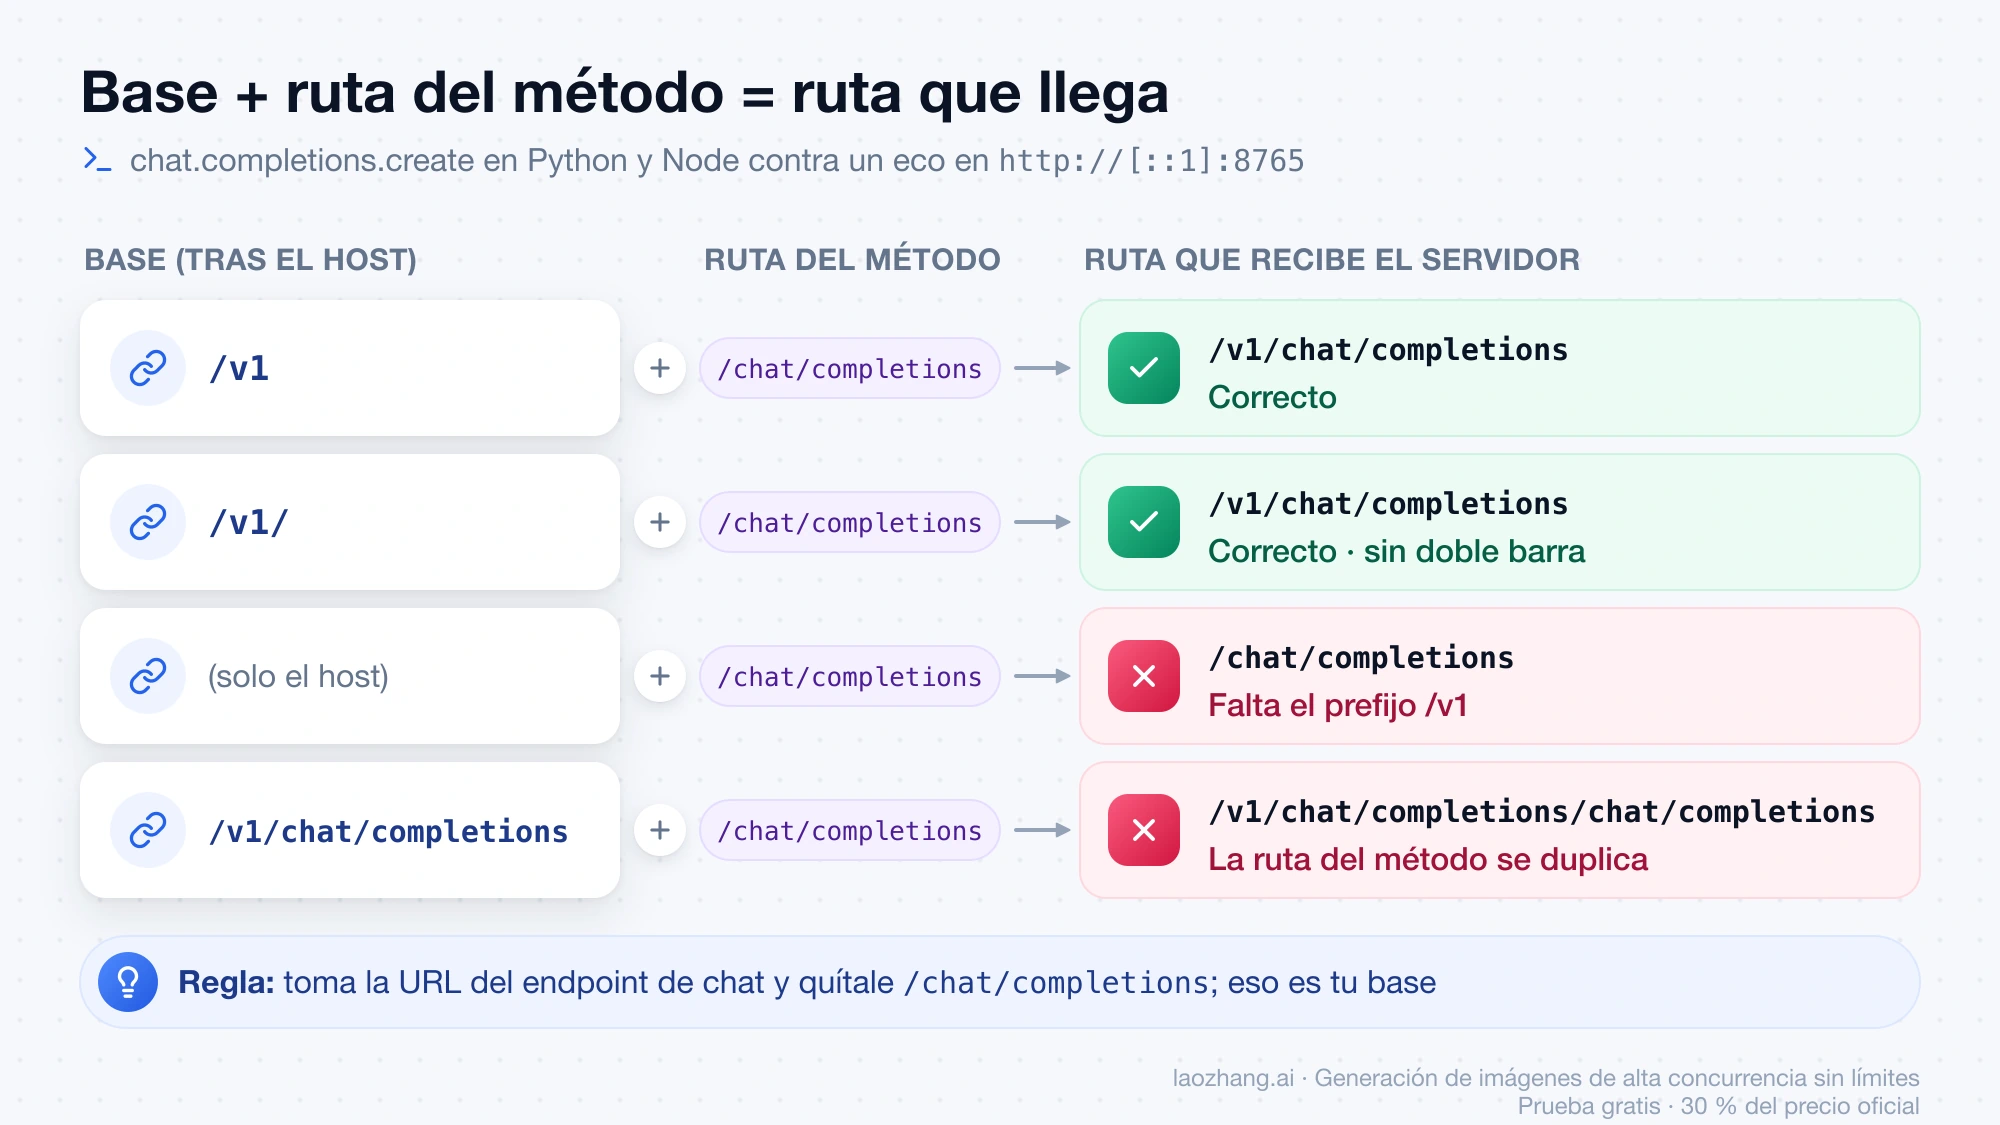
Python normaliza la base añadiéndole una barra final y luego le pega la ruta relativa del método; Node produce el mismo resultado. Estas son las rutas que llegaron al servidor de eco con chat.completions.create en ambos SDK:
| Base que pasas | Ruta que recibe el servidor |
|---|---|
http://[::1]:8765/v1 | /v1/chat/completions |
http://[::1]:8765/v1/ | /v1/chat/completions (sin doble barra) |
http://[::1]:8765 | /chat/completions |
http://[::1]:8765/v1/chat/completions | /v1/chat/completions/chat/completions |
Con responses.create y la base .../v1, la petición llega a POST /v1/responses.
De ahí sale la regla práctica: toma la URL completa del endpoint de chat que documenta el proveedor y quítale /chat/completions. Lo que queda es tu base. La barra final da igual; lo que rompe la llamada es que falte un segmento del prefijo o que sobre la ruta del método.
Qué URL base escribir para cada destino
| Destino | URL base | model | Qué API documenta |
|---|---|---|---|
| OpenAI (global) | Nada, o https://api.openai.com/v1 | ID de modelo de OpenAI | Todas las del SDK |
| OpenAI con residencia de datos | No uses base_url: data_residency="us", "eu" o "ae" | ID de modelo de OpenAI | Las del SDK, si tu organización tiene acceso a esa región |
| Azure OpenAI (API v1) | https://TU-RECURSO.openai.azure.com/openai/v1/ | Nombre de la implementación (deployment) | Chat Completions y Responses, con un subconjunto de funciones en la versión GA |
| Gemini (compatibilidad con OpenAI) | https://generativelanguage.googleapis.com/v1beta/openai/ | ID de modelo de Gemini | Chat Completions, embeddings, salida estructurada, imagen, vídeo, audio, batch; Responses no figura |
| Pasarela compatible, por ejemplo laozhang.ai | https://api.laozhang.ai/v1 | ID que publique la pasarela | Chat Completions; según su documentación, Responses solo para los modelos GPT-6 |
| Servidor local o propio | Lo que preceda a /chat/completions en su documentación, p. ej. http://host:puerto/v1 | El nombre que sirva el servidor | La que implemente el servidor |
En Azure, Microsoft Learn describe la API v1 como un cambio de dos cosas: usar el cliente OpenAI() normal en lugar de AzureOpenAI() y añadir /openai/v1/ al punto de conexión del recurso. Ya no hace falta api-version. También vale el dominio *.services.ai.azure.com/openai/v1/, y las variables OPENAI_BASE_URL y OPENAI_API_KEY funcionan con OpenAI() sin parámetros:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    base_url="https://TU-RECURSO.openai.azure.com/openai/v1/",
)

respuesta = client.responses.create(
    model="mi-implementacion",  # nombre de la implementación, no del modelo
    input="Prueba",
)
El cliente antiguo AzureOpenAI(azure_endpoint=..., api_version=...) sigue existiendo en el SDK; no mezcles sus parámetros con los de la API v1. Si en Azure la base ya es correcta y lo que ves son errores 429, el problema es de cuota y se diagnostica aparte: Límite TPM de Azure OpenAI: cómo diagnosticar y resolver los errores 429.
Con Gemini, la página de compatibilidad de Google (actualizada el 2 de septiembre de 2026) indica que el soporte de las librerías de OpenAI sigue en beta y no documenta un endpoint /responses. Eso no demuestra que nunca vaya a funcionar, pero tampoco es algo en lo que apoyarte: en noviembre de 2025 un usuario del foro de la comunidad de OpenAI obtuvo un 404 al llamar a client.responses.create con esa base. Si tu código usa Responses y el destino es Gemini, cambia esas llamadas a chat.completions.create.
Cambiar solo la URL base basta cuando se cumplen dos condiciones: que la ruta encaje con la tabla anterior y que el destino implemente la API concreta que llama tu código.
Proxy y URL base son ajustes distintos
"Proxy" se usa para dos cosas. Si hablas de un servicio intermediario que expone una API compatible (una pasarela), eso se configura con la URL base. Si hablas de un proxy HTTP por el que tiene que salir el tráfico de tu red, eso es un salto de red y se configura en el cliente HTTP, sin tocar la base:
from openai import OpenAI, DefaultHttpx2Client

client = OpenAI(
    base_url="https://api.ejemplo.com/v1",  # origen de la API
    http_client=DefaultHttpx2Client(proxy="http://proxy.miempresa.local:3128"),  # salto de red
)
Los nombres DefaultHttpx2Client y httpx2 son los del README actual; versiones anteriores del SDK usaban DefaultHttpxClient, así que revisa cuál trae la tuya. En Node, el proxy va en fetchOptions, por ejemplo con ProxyAgent de undici como dispatcher y el fetch de undici, y la base sigue en baseURL.
Si la petición no llega a ninguna parte (tiempo de espera agotado, DNS, TLS), el problema suele estar en ese salto y no en la base; el diagnóstico por capas está en Error de conexión de OpenAI API: corrige APIConnectionError probando la ruta.
Comprueba adónde van realmente las peticiones
Antes de culpar al proveedor, confirma el host y la ruta que usa tu proceso. De más barato a más completo:
- Imprime la base efectiva.
print(client.base_url)en Python oconsole.log(client.baseURL)en Node, justo después de crear el cliente y en el mismo proceso que falla (no en una consola aparte con otras variables). - Activa los logs del SDK.
OPENAI_LOG=infooOPENAI_LOG=debugen Python; en Node, la misma variable o la opciónlogLevel: 'debug'del cliente. El formato de estos mensajes puede cambiar entre versiones. - Apunta a un servidor de eco local. No necesitas clave real ni gastar tokens: el servidor imprime el método, la ruta y el inicio de la cabecera
Authorization, y devuelve una respuesta mínima de chat. - Mira los logs del proveedor. Si tu código dice que llama a un proveedor y en su panel no aparece ni la petición ni un 401, la petición no llegó.
El servidor de eco solo usa la biblioteca estándar de Python:
# eco.py
import json
import socket
from http.server import BaseHTTPRequestHandler, HTTPServer

class Eco(BaseHTTPRequestHandler):
    def do_POST(self):
        self.rfile.read(int(self.headers.get("Content-Length", 0)))
        auth = self.headers.get("Authorization", "")[:12]
        print(f"{self.command} {self.path}  host={self.headers.get('Host')}  auth={auth}...")
        body = json.dumps({
            "id": "eco", "object": "chat.completion", "created": 0, "model": "eco",
            "choices": [{"index": 0, "finish_reason": "stop",
                         "message": {"role": "assistant", "content": "ok"}}],
        }).encode()
        self.send_response(200)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

    def log_message(self, *args):
        pass

class ServidorIPv6(HTTPServer):
    address_family = socket.AF_INET6

ServidorIPv6(("::1", 8765), Eco).serve_forever()
Arráncalo con python eco.py y, en otra terminal, lanza tu código con la misma configuración que en producción cambiando solo la base:
# prueba.py
from openai import OpenAI

client = OpenAI(api_key="sk-prueba", max_retries=0)
print("base efectiva:", client.base_url)
client.chat.completions.create(
    model="eco", messages=[{"role": "user", "content": "hola"}]
)OPENAI_BASE_URL=http://[::1]:8765/v1 python prueba.pyEl servidor debería imprimir POST /v1/chat/completions. Si imprime /v1/chat/completions/chat/completions, estás pasando la ruta del método dentro de la base; si el servidor no imprime nada y el script falla con un 401, la petición salió hacia otro host: tu proceso no está leyendo la variable. La respuesta de eco sirve para chat.completions; con responses.create verás la ruta en el servidor, pero el SDK no podrá interpretar la respuesta, y eso es lo esperado.
Del síntoma a la capa que hay que corregir
| Lo que ves | Qué suele significar | Qué cambiar |
|---|---|---|
404 y el log muestra /chat/completions/chat/completions | La base incluye la ruta del método | Quita /chat/completions de la base |
404 y la ruta es /chat/completions sin prefijo | Falta /v1, /openai/v1 o /v1beta/openai | Añade el prefijo que documenta el proveedor |
404 solo en responses.create | El destino no implementa Responses (caso de Gemini) | Usa chat.completions.create o un destino que documente /responses |
| 401 de OpenAI ("Incorrect API key provided") con una clave de otro proveedor | La petición fue a api.openai.com: base no aplicada, OPENAI_API_BASE en lugar de OPENAI_BASE_URL, variable vacía en Node o data_residency activa | Imprime la base efectiva y corrige de dónde se lee |
| 401 del proveedor correcto | La clave no es de ese destino o no tiene permiso | Usa la clave que emite ese proveedor |
| Modelo no encontrado | El ID pertenece a otro proveedor, o en Azure pasas el nombre del modelo en lugar del de la implementación | Usa el ID del destino (en Azure, la implementación) |
APIConnectionError: Connection error. en Python | Base vacía (OPENAI_BASE_URL="") o host inalcanzable | Borra la variable vacía; si la base es correcta, revisa red y proxy |
La clave pertenece a quien la emite: una clave de Gemini no sirve en Azure y una de Azure no sirve en OpenAI. Si dudas de qué credenciales necesita cada llamada, OpenAI API Key y Organization ID: lo que de verdad necesitas en 2026 lo separa. Si el cliente que cambias es Codex y no un SDK, su configuración tiene nombres propios (openai_base_url, proveedores personalizados): Custom Provider en Codex: API Key, Base URL y config.toml.
Override OpenAI Base URL en Cursor
En Cursor, el campo se llama "Override OpenAI Base URL" y está en Cursor Settings > Models, junto a la clave de OpenAI. La página de ayuda de Cursor no lo documenta; lo que sigue viene de respuestas del personal de Cursor en su foro entre agosto y septiembre de 2026, y algunas describen limitaciones conocidas sin fecha de solución.
A qué modelos afecta. La clave de OpenAI y la URL de override se aplican a todos los modelos que no son de Claude ni de Gemini, incluidos Composer, Grok y los modelos de OpenAI del selector integrado (respuestas del 21 de agosto y del 23 de septiembre de 2026). Composer y Grok corren en la infraestructura de Cursor y rechazan claves propias con "This model does not support custom API keys". No se puede tener a la vez los modelos propios en tu endpoint y los de Cursor en Cursor: hay que desactivar el override para usar los de Cursor y volver a activarlo para los tuyos.
Nombres reservados. Si el ID de tu modelo personalizado coincide con uno que Cursor sirve por su cuenta (en agosto y septiembre de 2026 pasaba con kimi-k3, kimi-k2.6 o kimi-latest, entre otros), Cursor lo enruta a su propio backend y la petición nunca llega a tu URL. Usa un ID real del proveedor que no choque con esos nombres.
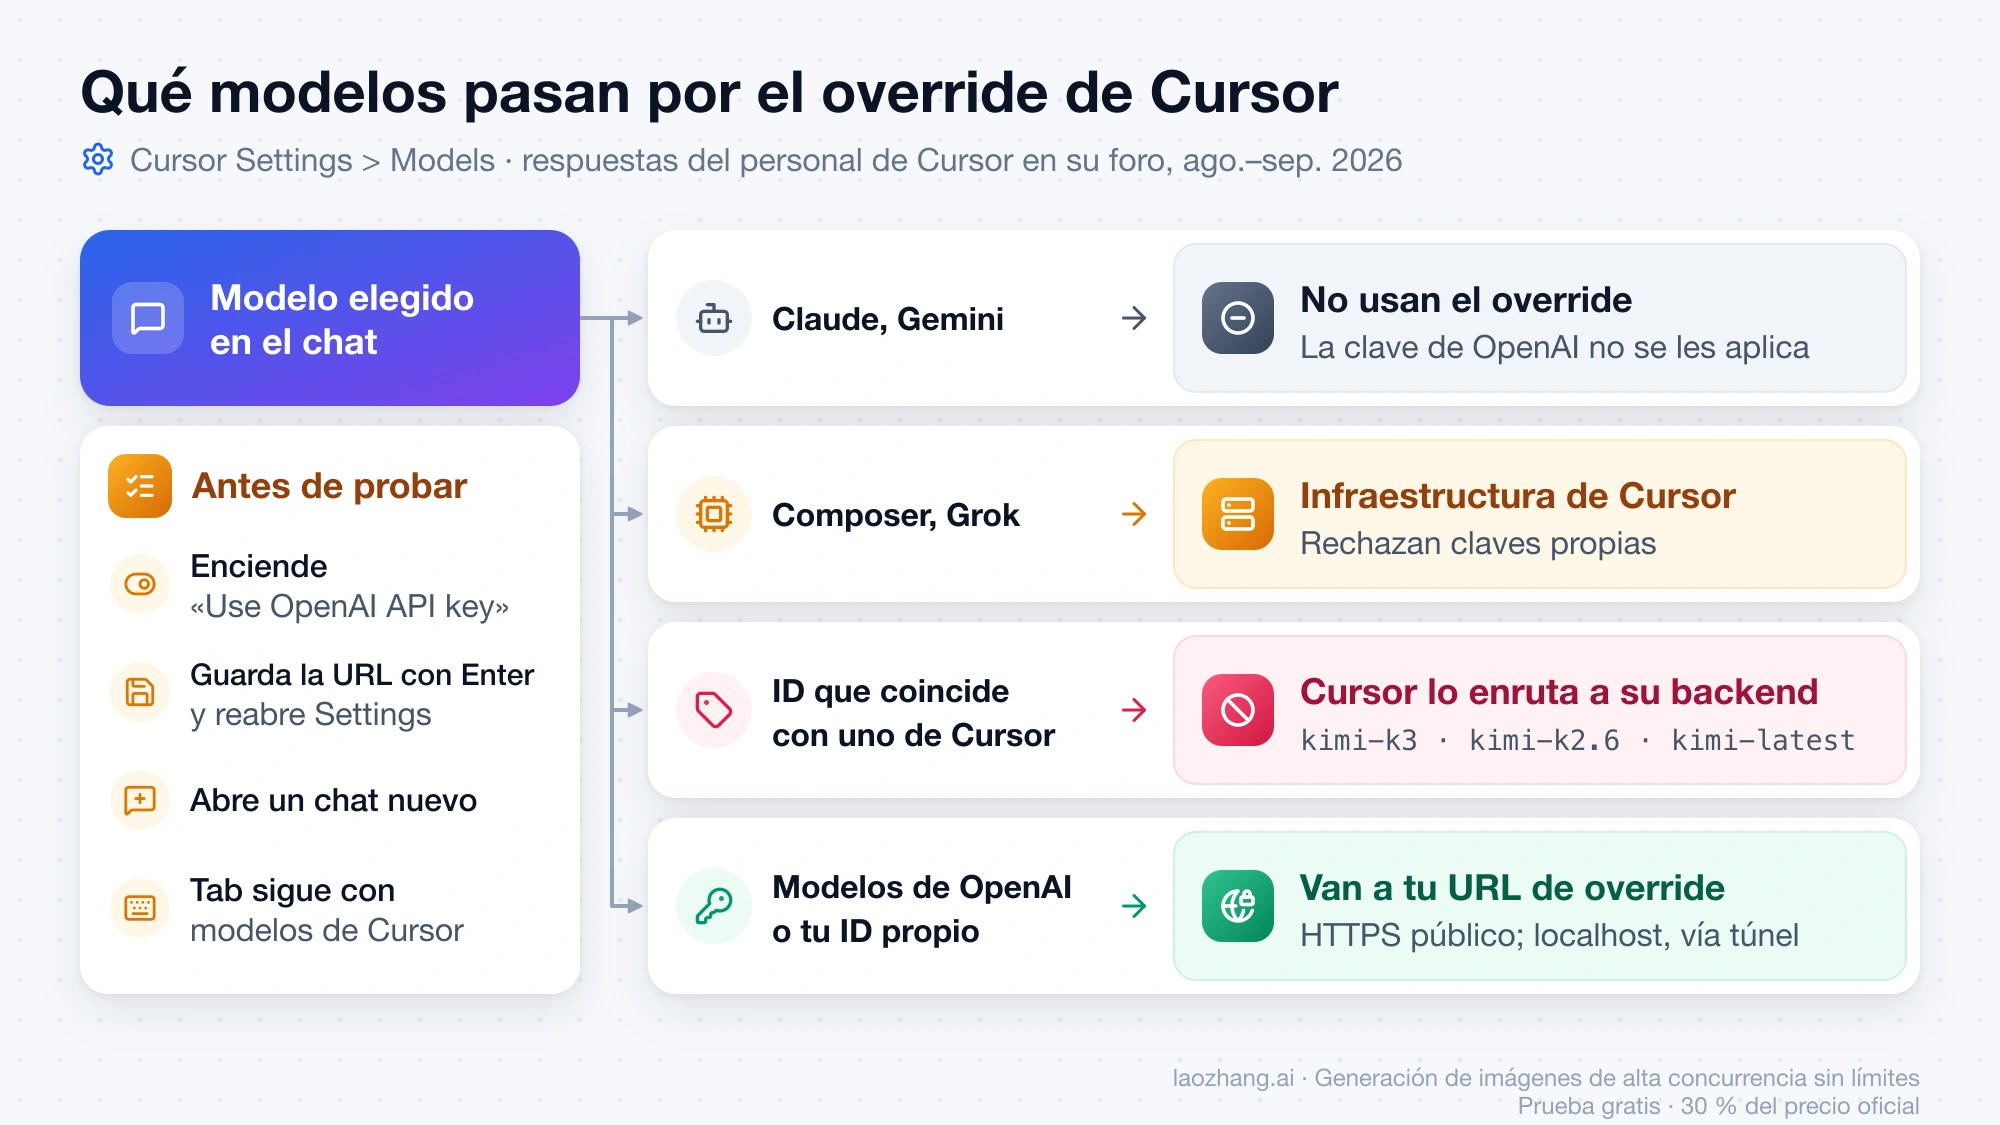
Pasos que se suelen saltar.
- Pegar la clave y activar "Use OpenAI API key" son dos pasos distintos; el override solo actúa con ese interruptor encendido.
- Al activar el override, el campo se rellena con
https://api.openai.com/v1. Si lo desactivas y lo vuelves a activar, vuelve a ese valor. Escribe la URL de tu proveedor, pulsa Enter o haz clic fuera para guardarla, cierra y abre Settings para confirmar que sigue ahí. - Abre un chat nuevo después de cambiar la configuración.
Si te olvidas del paso 2, tu clave de otro proveedor viaja a api.openai.com y OpenAI responde "Incorrect API key provided"; en el panel de tu proveedor no verás ningún 401 porque la petición nunca llegó. En las versiones 3.15.x hubo un fallo por el que los campos no aceptaban el clic; el apaño era activar el interruptor y entrar en el campo con Tab.
Nada de direcciones locales. Todas las peticiones con clave propia pasan por los servidores de Cursor, que construyen el prompt, así que el override no llega a direcciones locales ni de la red interna: necesita un endpoint HTTPS público. Para un modelo local, el personal de Cursor propone un túnel (ngrok, Cloudflare Tunnel). Un túnel expone tu servidor a internet: ponle autenticación antes de publicarlo.
Qué no cambia. Las claves propias solo se usan en los modelos de chat; el autocompletado con Tab sigue usando los modelos de Cursor. La política de retención cero de datos de Cursor no se aplica cuando usas tu propia clave, y, según su página de ayuda a 26 de septiembre de 2026, en los planes Team y Enterprise cada petición con clave propia se sigue cobrando a la tarifa de tokens de Cursor, 0,25 $ por millón de tokens.
Preguntas frecuentes
¿Sigue funcionando OPENAI_API_BASE?
No con los SDK oficiales actuales: openai-python y openai-node solo leen OPENAI_BASE_URL, y con OPENAI_API_BASE sola el cliente sigue apuntando a api.openai.com. Algunos frameworks pueden seguir leyendo el nombre antiguo por su cuenta; comprueba en su documentación qué variable usan.
¿Puedo cambiar la base solo para una llamada?
Sí. client.with_options(base_url="...") en Python y client.withOptions({ baseURL: "..." }) en Node desvían únicamente la llamada encadenada; el cliente original conserva su base.
¿Cualquier servicio compatible con OpenAI acepta Responses API?
No hay garantía. Azure OpenAI documenta responses.create en su API v1; la compatibilidad de Gemini no incluye /responses; cada pasarela publica su propia lista, y a veces solo para algunos modelos. Si estás pasando código de Assistants a Responses y quieres que siga funcionando fuera de OpenAI, confirma el soporte del destino antes de migrar: Cómo migrar de Assistants API a Responses API sin cortar producción.