Gemini 4 Argon «Retrying (1/9)» en Antigravity: el corte de 60 s
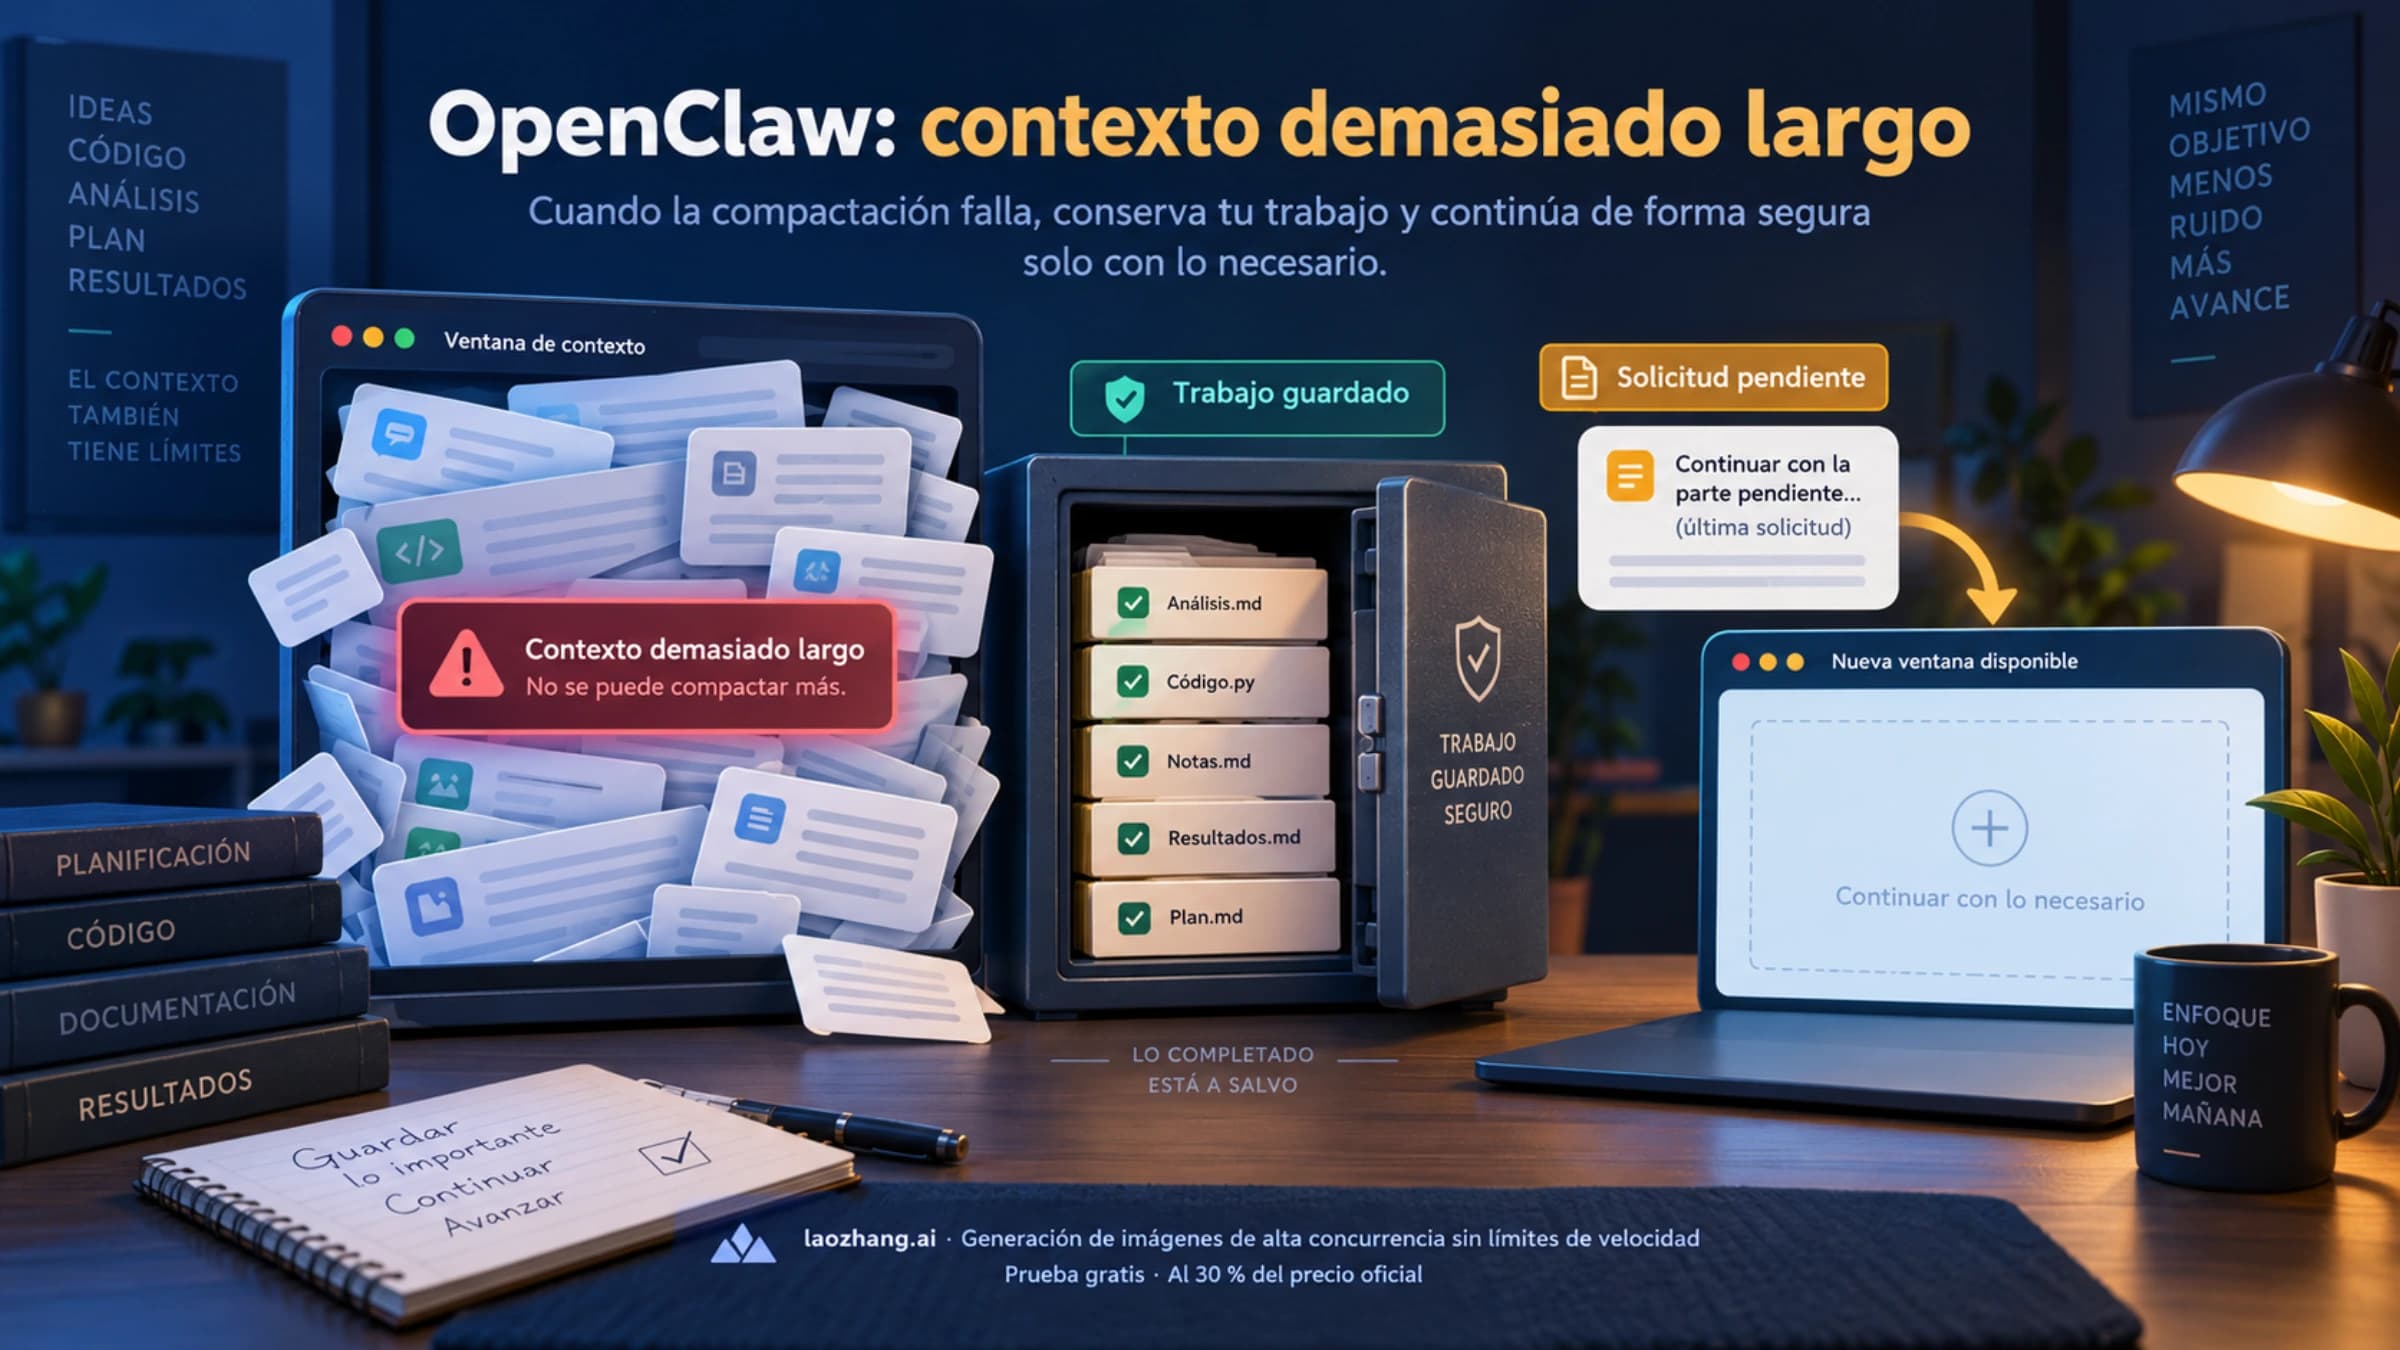
Con Gemini 4 Argon, el contador 1/9 suele ser una edición grande que pasa 60 s sin enviar datos. Para en el primer aviso y pide la edición por rangos de líneas.
En esta página
Si Antigravity muestra Model unavailable, retrying in 4s (attempt 1/9) con Gemini 4 Argon, o solo Retrying (1/9)... en el cliente de Windows, no significa que el modelo esté apagado ni, en la mayoría de los casos documentados, que Google esté caído. Es un aviso genérico de reintento que tapa varios fallos distintos, y con Argon el más repetido en el foro de desarrolladores de Google es este: el agente prepara una edición grande de un archivo, durante ese rato no llega ningún dato y la conexión se corta a los 60 segundos. Como cada reintento vuelve a enviar exactamente la misma petición, falla igual hasta el noveno y la ejecución termina con «Agent execution terminated due to error».
Por eso lo útil es no esperar los nueve intentos. Si el aviso salta mientras el agente escribe o modifica un archivo grande y te queda cuota, detén el paso en el primer aviso, sigue en la misma conversación y pídele que haga la edición por rangos de líneas, con 100 líneas como mucho por llamada. Si en cambio falla hasta un mensaje corto, o fallan todos los modelos Gemini mientras Claude responde, el problema es la capacidad del servidor: pasa un rato a Gemini 3.8 Flash o a Claude Sonnet 5.5 u Opus 5.5. Y si el uso de tu plan aparece al 0 % en Settings, es la cuota.
El 27 de octubre de 2026 se hicieron dos comprobaciones, ninguna dentro de Antigravity, así que el aviso no se reprodujo: se volvió a ejecutar el script del autor de la investigación pública sobre el corte con su propio log, y se midió cómo envía Argon una edición de archivo a través de una pasarela de terceros. Lo demás procede del registro de cambios y la documentación de Antigravity y de los hilos del foro de Google, citados en cada sección.
Qué significa «Model unavailable» y el contador 1/9 en Antigravity
El aviso completo es Model unavailable, retrying in Ns (attempt k/9) y aparece encima de un paso del agente: Antigravity va a reintentar la petición al modelo hasta nueve veces. La cuenta atrás con número de intento existe desde la versión 2.16.0 de la App (22 de septiembre de 2026), según el registro de cambios de Antigravity. Si los nueve intentos fallan, la conversación se detiene con «Agent execution terminated due to error», que en el log figura como stream reading error: unexpected EOF; si pulsas Cancel en Windows, el cliente muestra «task cancelled by user». Google no documenta el texto exacto del aviso, que cambia según el cliente y la versión.
«Model unavailable» no quiere decir aquí que Argon esté fuera de servicio, sino que la petición se quedó sin respuesta. En el log que publicó el autor del hilo «"Model unavailable" retry loop is a 60-second cutoff on silent model responses» del foro Google AI Developers (App 2.23.0 en Linux, 14 y 15 de octubre de 2026) no había ni un solo 503, UNAVAILABLE, RESOURCE_EXHAUSTED o «No capacity»: las peticiones simplemente no recibían datos.
La explicación tiene que ver con las llamadas a herramientas, que son los pasos en que el agente escribe o reemplaza un archivo (write_to_file, replace_file_content). Mientras Argon razona o escribe texto, envía datos cada pocos segundos; cuando prepara una de estas llamadas, el contenido del archivo solo llega al cliente cuando está completo, y hasta entonces la conexión está en silencio. Según ese análisis y su repositorio antigravity-stream-cutoff-rca en GitHub, las peticiones a daily-cloudcode-pa.googleapis.com que no reciben nada se cierran unos 60 segundos después: pedir un archivo nuevo de unas 1.200 líneas en un solo paso hizo saltar el aviso 3 de 3 veces, entre 60,25 y 60,36 s. Qué componente corta la conexión no está claro; el autor apunta al front-end de Google sin haberlo comprobado con una captura de red, y Google no lo ha confirmado.
Cuál es tu caso: cinco causas detrás del mismo contador
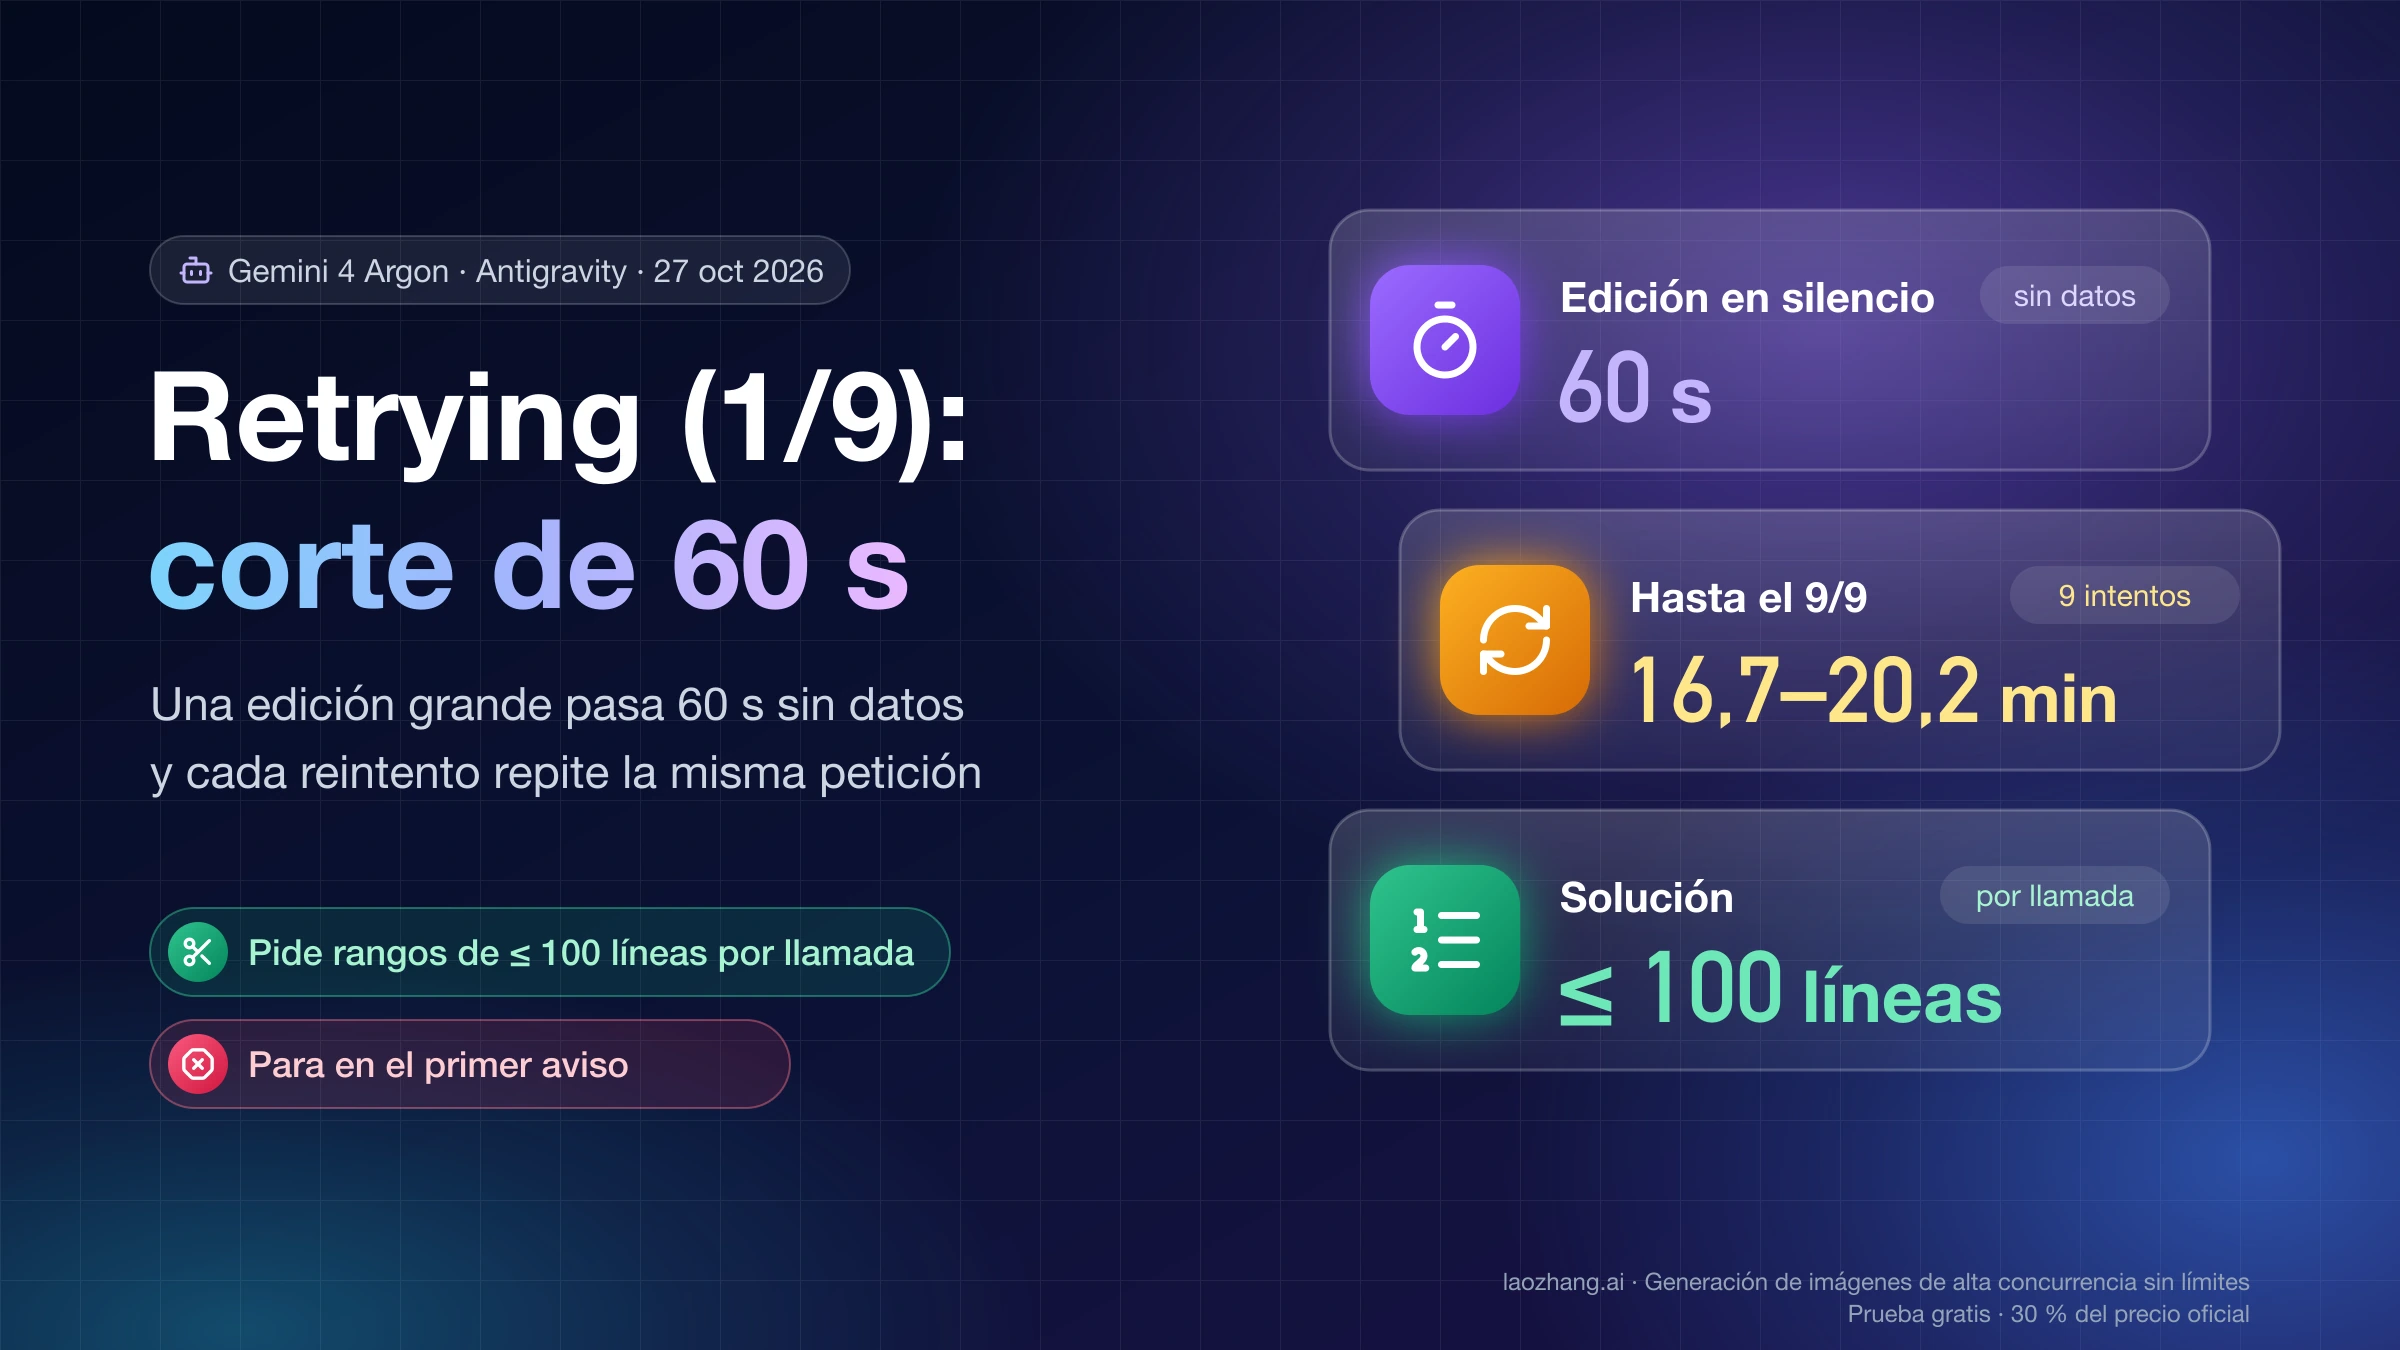
Lo que estaba haciendo el agente cuando saltó el aviso suele bastar para saber qué tienes. Si estaba escribiendo o editando un archivo grande, casi seguro es el corte de 60 s; si falla hasta un saludo, es capacidad; y si el contador de uso está vacío, es cuota.
| Lo que ves | Causa probable | Qué hacer |
|---|---|---|
| Salta mientras el agente escribe o edita un archivo grande, hacia los 60 s; te queda cuota y otras peticiones funcionan | Llamada a herramienta en silencio cortada a los 60 s | Detener el paso en el primer aviso y pedir la edición por rangos de líneas en la misma conversación |
| Falla cualquier mensaje, incluso uno corto, o fallan todos los modelos Gemini mientras Claude responde | Falta de capacidad del modelo en el servidor | Pasar un rato a Gemini 3.8 Flash (Medium o Low) o a Claude Sonnet 5.5 / Opus 5.5, o esperar; aquí sí sirve un chat nuevo |
| El uso del plan aparece al 0 % en Settings | Cuota de cinco horas o semanal agotada | Esperar a la recarga o activar AI Credit Overages |
| Falla de forma irregular con VPN, proxy o cortafuegos de empresa, o desde una cuenta usada con herramientas de terceros | La red corta conexiones que parecen inactivas, o la cuenta tiene restricciones | Probar sin VPN ni proxy; dejar de usar esas herramientas |
| Un razonamiento muy largo, sin ediciones, se corta en una pausa de unos 60 s o hacia los 120 s | Pausa sin datos durante el razonamiento | Bajar el nivel de razonamiento, partir la tarea y probar sin VPN |
Si dudas entre las dos primeras filas, hay una prueba de un solo intento: pide al mismo agente una edición pequeña, de 100 líneas o menos. Si entra a la primera, el tamaño de la petición era lo que fallaba; si también se queda reintentando, descarta el corte de 60 s y mira capacidad, cuota y red. Es una deducción a partir de los casos publicados en el foro, no un procedimiento de Google, y no se ha validado dentro de Antigravity.
La falta de capacidad tiene otro aspecto. El 1 de octubre de 2026, un usuario Pro con Gemini 3.7 Flash High vio Model unavailable, retrying in 3s (attempt 2/9) con cualquier petición, y cambiar de modelo lo resolvió al momento; un usuario que responde a menudo en el foro de desarrolladores de Google contestó que el fallo era del servicio y no de la cuenta, y que por eso cambiar de modelo funciona. No es una respuesta oficial de Google. En el hilo del foro de Google del 26 de octubre de 2026 sobre todos los modelos Gemini con «high traffic», todos los Gemini devolvían «Our servers are experiencing high traffic right now» con el 98 % de la cuota semanal y el 100 % de la de cinco horas sin usar, mientras Claude respondía; la primera respuesta del hilo, del mismo usuario, recomendó un chat nuevo con Gemini 3.8 Flash en Medium o Low, o pasar temporalmente a Claude Sonnet 5.5 u Opus 5.5. Si vas a quedarte un tiempo en Flash, Gemini 4 Argon vs 3.8 Flash: coste real por tarea y cuál usar compara lo que cambia.
En la red, la pista es el razonamiento largo. En el hilo del foro de Google sobre razonamientos de Gemini interrumpidos hacia los 120 segundos (App 2.18.1, Gemini 3.1 Pro High, 2 de octubre de 2026), ese mismo usuario del foro respondió que algunas redes cortan las conexiones que parecen inactivas durante unos dos minutos y aconsejó probar sin VPN, proxy ni cortafuegos de empresa, bajar el nivel de razonamiento y partir las tareas grandes. Las herramientas de terceros para entrar en Antigravity o rotar cuentas automáticamente no son una solución: la FAQ de Antigravity dice que usarlas incumple los términos de servicio y puede acabar en la suspensión o el cierre de la cuenta.
Si Antigravity no muestra ningún contador y solo va lento, lo tienes en Gemini 3.8 Flash va lento en Antigravity: qué está esperando; si el error es de licencia, en Antigravity error 3501 de licencia: qué se arregla y cuándo parar.
Cómo hacer pasar una edición grande con Argon: 100 líneas por llamada
La solución que más usuarios confirman es que ninguna llamada a herramienta lleve mucho contenido, de modo que cada una termine antes de los 60 segundos. Hazlo así:
- Detén el paso en cuanto veas el primer aviso durante una edición grande, porque los intentos siguientes repiten la misma petición.
- No cierres la conversación. Escribe en el mismo chat algo como: «Divide esa edición en varias llamadas
replace_file_contentpor rangos de líneas, con 100 líneas como máximo cada una, y empieza por las líneas 1–100». - Si es un archivo nuevo, pide que lo escriba en varias llamadas de 100 líneas como mucho, en lugar de crearlo entero de una vez.
- Para las tareas siguientes, pon la regla al principio. La frase que propone un usuario de Windows en el hilo del foro es «Apply changes in chunks of at most 60-80 lines per tool call», y otro usuario la confirmó en la App 2.24.0 con Argon High en macOS.
Seguir en la misma conversación tiene una razón concreta. Cada corte deja en el historial la línea «Error: The stream was interrupted. Please continue the task you were working on.», y en la sesión que relata el autor del hilo «Gemini 4 Argon "Retrying (1/9)": 60s Tool-Call Cutoffs» del foro de Google, Argon vio esas interrupciones y dividió él mismo la edición en el sexto intento; veinte minutos después seguía partiendo sus ediciones sin reintentos. Si cancelas y abres un chat nuevo con la misma instrucción, pierdes ese contexto y el agente vuelve a intentar la misma edición grande.
Pide rangos de líneas explícitos, no «un archivo de unas N líneas». En la prueba del 27 de octubre de 2026 que se describe más abajo, pedir «unas 400 líneas» dio entre 551 y 773 líneas reales, así que un tamaño aproximado en la instrucción no sirve de límite. Y no esperes que partir la edición lo resuelva siempre: en los experimentos controlados de la investigación, un archivo de 1.200 líneas escrito en 12 llamadas de 100 líneas pasó en 1 de 3 ejecuciones; las otras dos fallaron en el bloque 9 de 12, tras 60,2 s de silencio, y en el bloque 5 de 12, con otro error (proto: unexpected EOF) tras unos 46 s sin datos y sin reintento. Reduce los fallos, pero no los elimina; el usuario de macOS que lo confirmó también escribió que el error necesita un arreglo definitivo de Google.
¿Esperar al 9/9, cancelar o abrir un chat nuevo?
Con una edición grande en silencio, esperar no sirve y sale caro. En el log de la investigación, la espera tras el primer fallo es de 4 s y se duplica más o menos después de cada intento, con algo de variación; las más largas, de unos 2,4–4 minutos, llegan después de que fallen el séptimo y el octavo intento, es decir, mientras ves 7/9 y 8/9. Las 12 ejecuciones que agotaron los nueve intentos tardaron entre 16,7 y 20,2 minutos desde el primer fallo hasta detenerse; el registro de cambios de la App 2.14.0 (15 de septiembre de 2026) habla de reintentos con espera creciente «durante unos doce minutos», y la diferencia cuadra con los 60 s de silencio que dura cada uno de los nueve intentos antes de fallar, que esa cifra probablemente no cuenta. En este caso, para en el primer aviso y sigue los pasos de la sección anterior sin abrir otro chat.
Con falta de capacidad, la cuenta cambia. El fallo no depende de tu petición, así que esperar unos minutos puede bastar, y abrir un chat nuevo o cambiar de modelo es lo que recomendaron las respuestas en esos hilos del foro. Si el aviso salta en una conversación muy larga que ya repite cosas, empezar de cero también es razonable. Lo que no tiene sentido es repetir en un chat nuevo la misma edición grande que estaba fallando, porque volverá a cortarse a los 60 s.
Por qué fallan las ediciones y no el chat: Argon medido el 27 de octubre de 2026
Argon envía el texto normal en trozos desde los primeros segundos, pero una llamada a herramienta le llega al cliente entera, de golpe, cuando ha terminado de generarla. El 27 de octubre de 2026 se lanzaron cinco peticiones a Gemini 4 Argon por el endpoint nativo de Gemini de laozhang.ai (streamGenerateContent?alt=sse), con thinkingLevel en low y una única función write_to_file(path, content), pidiendo un módulo de Python. No es el endpoint de Antigravity, y esa pasarela no cortó ninguna conexión a los 60 s, así que la prueba muestra cómo entrega Gemini la llamada, no dónde está el temporizador de Antigravity.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Petición | Líneas escritas | Tokens de salida | Primer dato | Eventos recibidos |
|---|---|---|---|---|
| Herramienta, «unas 100 líneas» | 135 | 2.029 | 20,8 s | 2 |
| Herramienta, «unas 400 líneas» | 616 | 5.965 | 54,9 s | 2 |
Herramienta, «unas 400 líneas», con streamFunctionCallArguments | 665 | 6.635 | 59,8 s | 2 |
| Herramienta, «unas 400 líneas», repetición | 773 | 7.250 | 62,0 s | 2 |
| Texto normal, «unas 400 líneas» | 551 | 6.276 | 6,2 s | 241 |
En las cuatro llamadas a herramienta no llegó ni un byte hasta el final: el contenido completo (de 6,9 a 30,3 KB) vino en un solo evento y el segundo era un cierre vacío. El mismo archivo como texto empezó a llegar a los 6,2 s, en 241 trozos, sin ninguna pausa más larga que esos primeros 6,2 s. La repetición de 773 líneas pasó de los 60 s: dentro de Antigravity, esa petición habría caído en el corte que mide la investigación.
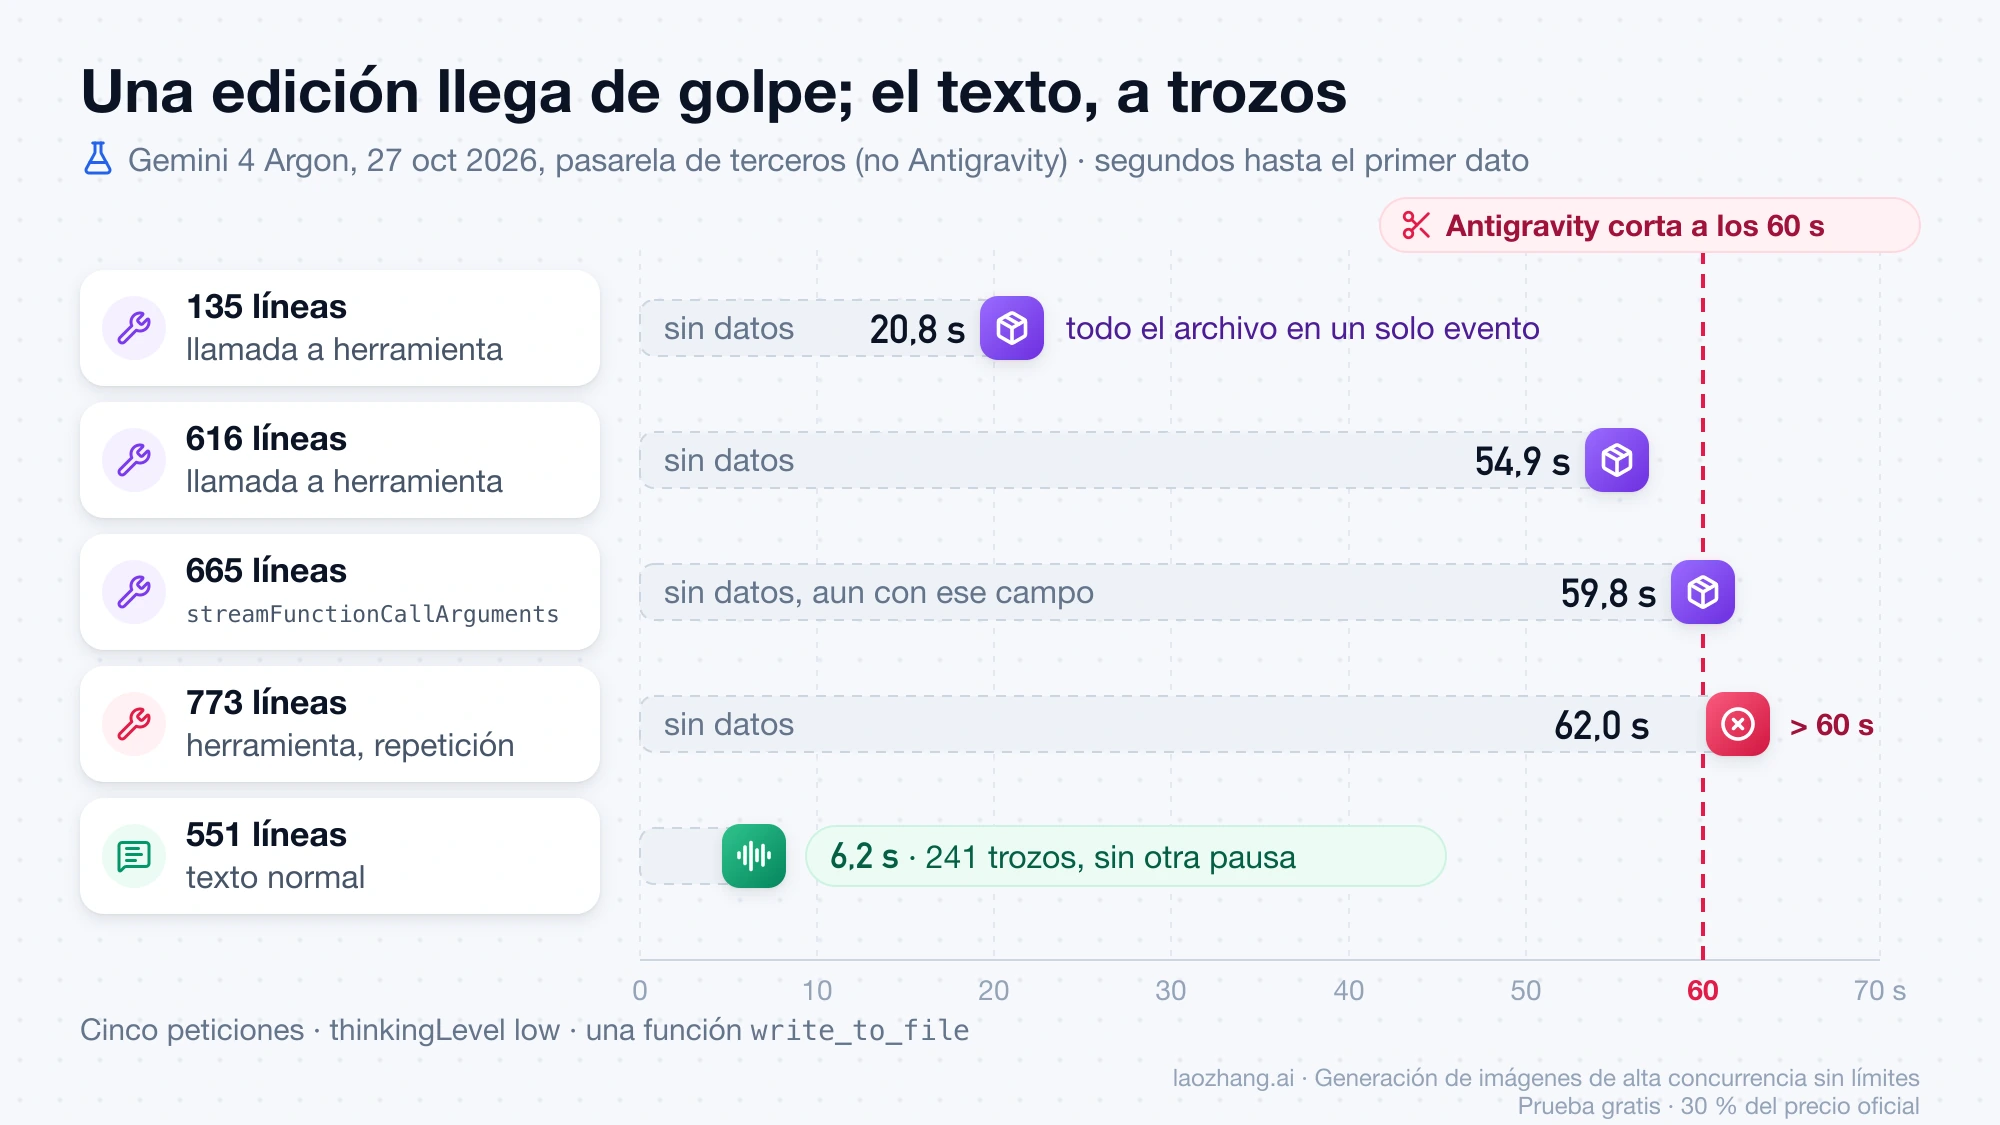
De ahí sale una regla de tamaño, calculada a partir de esos cinco resultados. Argon generó unos 95–116 tokens de salida por segundo, así que 60 s de silencio dan para unos 5.700–7.000 tokens (95 × 60 y 116 × 60), que en ese archivo de Python eran unas 600–700 líneas. Las 135 líneas tardaron 20,8 s, cerca de un tercio de esos 60 s; al mismo ritmo, 100 líneas serían unos 15 s (20,8 × 100 / 135), una cuarta parte. La densidad de líneas cambia con el lenguaje y el archivo, y son solo cinco muestras. En esta prueba el razonamiento iba en low y no llegó ningún fragmento de razonamiento, así que el silencio cubrió todo lo anterior a la llamada; en Antigravity, Argon trabaja en High y envía su razonamiento por partes, y el corte llega 60 s después del último dato recibido, de modo que ese razonamiento no gasta el margen. Por qué los bloques de 100 líneas de la investigación aún fallaron dos de tres veces no está explicado; el autor menciona como posibilidad respuestas lentas del servidor.
Eso explica también por qué Claude parece aguantar. En el hilo de la investigación, un usuario de Windows escribió que con los modelos Claude no le pasaba y con los Gemini sí, y la explicación que le dieron es que el problema está en cómo viajan los argumentos de las llamadas a herramientas de Gemini, guardados enteros antes de enviarse. La prueba anterior confirma la parte de Gemini; el comportamiento de Claude no se midió. Por la misma razón, pedirle a Argon que escriba una línea de estado antes de la edición no evita el corte: según el autor del hilo «Gemini 4 Argon "Retrying (1/9)"» del foro de Google, esa línea llegó en el segundo 3 y la ejecución falló en el 63, y en sus logs cada corte llegó justo 60,0 s después de la última palabra de razonamiento o de estado recibida.
Si construyes tu propio agente con la API de Gemini, la documentación de llamadas a funciones de Vertex AI describe la opción que pide la investigación: poner streamFunctionCallArguments a true dentro de toolConfig.functionCallingConfig con streamGenerateContent, para recibir los argumentos por partes (partialArgs, willContinue) a medida que se generan. Está en Preview, vale para Gemini 3 y posteriores salvo Gemini 3.1 Flash-Lite, y Antigravity no la activa ni deja activarla. En la prueba por la pasarela, la petición con ese campo devolvió 200 sin error, pero todo siguió llegando de golpe a los 59,8 s; no se sabe si la pasarela reenvía el campo. Para agentes de terceros, Antigravity recomienda una clave de API de Gemini Enterprise o de Google AI Studio, no tu inicio de sesión. Si estás decidiendo en tu código cuándo reintentar, ¿Reintentar la API LLM o cambiar de modelo? Cinco comprobaciones trata esa decisión.
¿Se me acabó la cuota de Antigravity? Cómo comprobarlo
Solo si el uso aparece al 0 %. En Reddit, la respuesta destacada a un hilo sobre este aviso dice que solo le pasa con la cuota de cinco horas agotada, pero el log de la investigación y el hilo del 26 de octubre muestran el mismo contador con cuota de sobra. Así que mira primero la página Settings de Antigravity, que según la página de planes de Antigravity muestra el uso de la cuota base de cada modelo.
Con Google AI Pro, la cuota es alta y se recarga cada cinco horas hasta llegar al límite semanal; Ultra tiene la más alta, también cada cinco horas, y los demás planes se recargan cada semana. Google no publica cifras, y el ritmo depende de cuánto trabaje el agente. Cuando se acaba la cuota base, el ajuste AI Credit Overages decide qué pasa: con Never esperas a la recarga, con Always se gastan los créditos de IA que hayas comprado. Que la App reintente al quedarse sin cuota no está documentado; la CLI, en cambio, desde la 1.3.3 (10 de octubre de 2026) avisa de inmediato de que has alcanzado tu cuota individual en vez de reintentar.
¿Lo ha arreglado Google? Estado de la App a 27 de octubre de 2026
No hay ningún arreglo anunciado. La primera respuesta en el hilo de la investigación, de un usuario que responde a menudo en el foro y no habla por Google, fue actualizar a la 2.23.1, pero el autor repitió la prueba el 15 de octubre en esa versión y el 22 de octubre en la 2.25.0, y los archivos de 1.200 líneas en una sola llamada se siguieron cortando entre 60,18 y 60,38 s; en la 2.25.0, además, un razonamiento de 4 min 22 s sin herramientas se cortó al llegar una pausa a los 60 s, mientras que un texto de unas 1.500 palabras terminó sin problema.
Ninguna versión de la App posterior a la 2.23.0 con la que se hizo la investigación, de la 2.23.1 (13 de octubre) a la 2.26.0 (22 de octubre, la última a 27 de octubre de 2026), menciona en el registro de cambios los argumentos de herramientas por partes, un mecanismo para mantener viva la conexión o el corte de 60 s. La 2.26.0 corrige otra cosa: que una desconexión al despertar el equipo o cambiar de red wifi detuviera al agente en vez de reintentar. Nadie ha vuelto a medir el corte en la 2.26.0, así que la falta de una entrada no prueba que siga igual. Actualizar no hace daño, pero las versiones se despliegan de forma gradual y pueden tardar unos días en llegarte; si tras actualizar sigues viendo el aviso en ediciones grandes, pedir la edición por rangos de líneas sigue siendo lo que reduce los fallos.
Revisa tu log de Antigravity y prepara el informe para Google
El script reconstruct_attempts.py del repositorio de la investigación lee el language_server.log de Antigravity y lista cada petición fallida; si los fallos marcados como no response headers se agrupan justo por encima de 60 s, tienes el mismo corte. El 27 de octubre de 2026 se ejecutó en macOS 26.1 con Python 3.12.1 sobre el log publicado por el autor y dio 136 intentos fallidos en 21 ejecuciones: 104 sin cabeceras de respuesta (79 con tiempo medido: mínimo 60,270 s, mediana 60,352 s, máximo 61,075 s) y 32 cortados a mitad de respuesta (mediana 73,216 s). El resultado coincidió byte a byte con el CSV publicado.
Para tu propio log, desde la carpeta del repositorio y con Python 3.10 o posterior:
python3 scripts/reconstruct_attempts.py ~/.config/Antigravity/logs/language_server.log --utc-offset=+01:00 --year 2026 > fallos.csvEsa ruta del log es la de Linux; en macOS y Windows no se ha verificado dónde guarda Antigravity el archivo. El desfase es el de la hora local de tu equipo, porque el log se escribe en hora local: en la España peninsular es +01:00 desde el 25 de octubre de 2026, y en Canarias +00:00. Escríbelo siempre con =: con desfases negativos, la forma con espacio del README (--utc-offset -04:00) falla con «expected one argument».
Para enviar el informe al foro Google AI Developers, en la categoría Google Antigravity, el autor de la investigación adjuntó estos datos, que permiten buscar los fallos en el servidor. No es una plantilla oficial de Google:
- Hora UTC de cada fallo.
- ResponseID y Trace ID, si existen; los fallos sin cabeceras no tienen ResponseID porque la respuesta nunca empezó.
- Versión de la App o de la CLI y sistema operativo.
- Modelo y nivel de razonamiento, por ejemplo Gemini 4 Argon, High.
- Qué hacía el paso, por ejemplo «archivo de 1.200 líneas en una sola llamada
write_to_file».
A esa lista vale la pena añadir, aunque el autor no lo incluyera, cuánta cuota te quedaba según Settings, si la edición pequeña de la prueba de un intento pasó y si otros modelos funcionaban a la misma hora, porque son los datos que separan el corte de 60 s de la capacidad y la cuota.
Gemini 4 Argon en Antigravity: otras preguntas
¿Por qué no aparece Gemini 4 Argon en Antigravity IDE?
Porque no está disponible ahí. A 27 de octubre de 2026, la página de modelos de Antigravity indica que Argon está en la Antigravity App, la Antigravity CLI y las extensiones para IDE, pero no en Antigravity IDE. Si el contador te sale en el IDE, es con otro modelo.
¿Tengo Gemini 4 Argon con una prueba de Google AI Pro?
Solo en algunos casos. La misma página de modelos dice que Argon está en los planes de pago de Google AI Pro o en las pruebas asociadas a dispositivos premium elegibles; en Free y en Google AI Plus no está. Claude Sonnet 5.5 y Opus 5.5 solo aparecen en Pro con suscripción de pago, no en prueba. Google ha cambiado ese texto varias veces en octubre de 2026, así que compruébalo el día que lo necesites.
¿Pasa lo mismo en la Antigravity CLI?
La CLI también ofrece Argon, pero su registro de cambios va por separado y en el foro no hay mediciones del corte de 60 s en la CLI. Lo que sí cambió a mediados de octubre de 2026 es cómo reintenta: desde la 1.3.4 (13 de octubre) espera como mucho 30 segundos entre reintentos automáticos en lugar de hasta 4 minutos, y desde la 1.3.6 (15 de octubre) cancela y vuelve a enviar una petición si pasan 5 minutos sin recibir datos. Esas reglas acortan la espera, pero no evitan que una edición grande vuelva a quedarse en silencio, así que conviene aplicar ahí el mismo límite de 100 líneas por llamada; la última versión a 27 de octubre de 2026 es la 1.4.0.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 27 oct 2026.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 27 oct 2026.
- 1.registro de cambios de Antigravityantigravity.google/docs/changelog
- 2.«"Model unavailable" retry loop is a 60-second cutoff on silent model responses» del foro Google AI Developersdiscuss.ai.google.dev/t/189559
- 3.antigravity-stream-cutoff-rca en GitHubgithub.com/Xiphiros/antigravity-stream-cutoff-rca
- 4.hilo del foro de Google del 26 de octubre de 2026 sobre todos los modelos Gemini con «high traffic»discuss.ai.google.dev/t/195034
- 5.hilo del foro de Google sobre razonamientos de Gemini interrumpidos hacia los 120 segundosdiscuss.ai.google.dev/t/186367
- 6.FAQ de Antigravityantigravity.google/docs/faq
- 7.hilo «Gemini 4 Argon "Retrying (1/9)": 60s Tool-Call Cutoffs» del foro de Googlediscuss.ai.google.dev/t/189747
- 8.documentación de llamadas a funciones de Vertex AIdocs.cloud.google.com/vertex-ai/generative-ai/docs/multimodal/function-calling
- 9.página de planes de Antigravityantigravity.google/docs/plans
- 10.foro Google AI Developers, en la categoría Google Antigravitydiscuss.ai.google.dev
- 11.página de modelos de Antigravityantigravity.google/docs/models