Gemini 3.5 Transcribe API: archivos, subtítulos en directo y validación
Para grabaciones, Gemini 3.5 Transcribe usa Files e Interactions; para subtítulos en directo, usa Live con PCM. El vocabulario personalizado y las anotaciones de hablante o palabra requieren configuraciones separadas.
En esta página
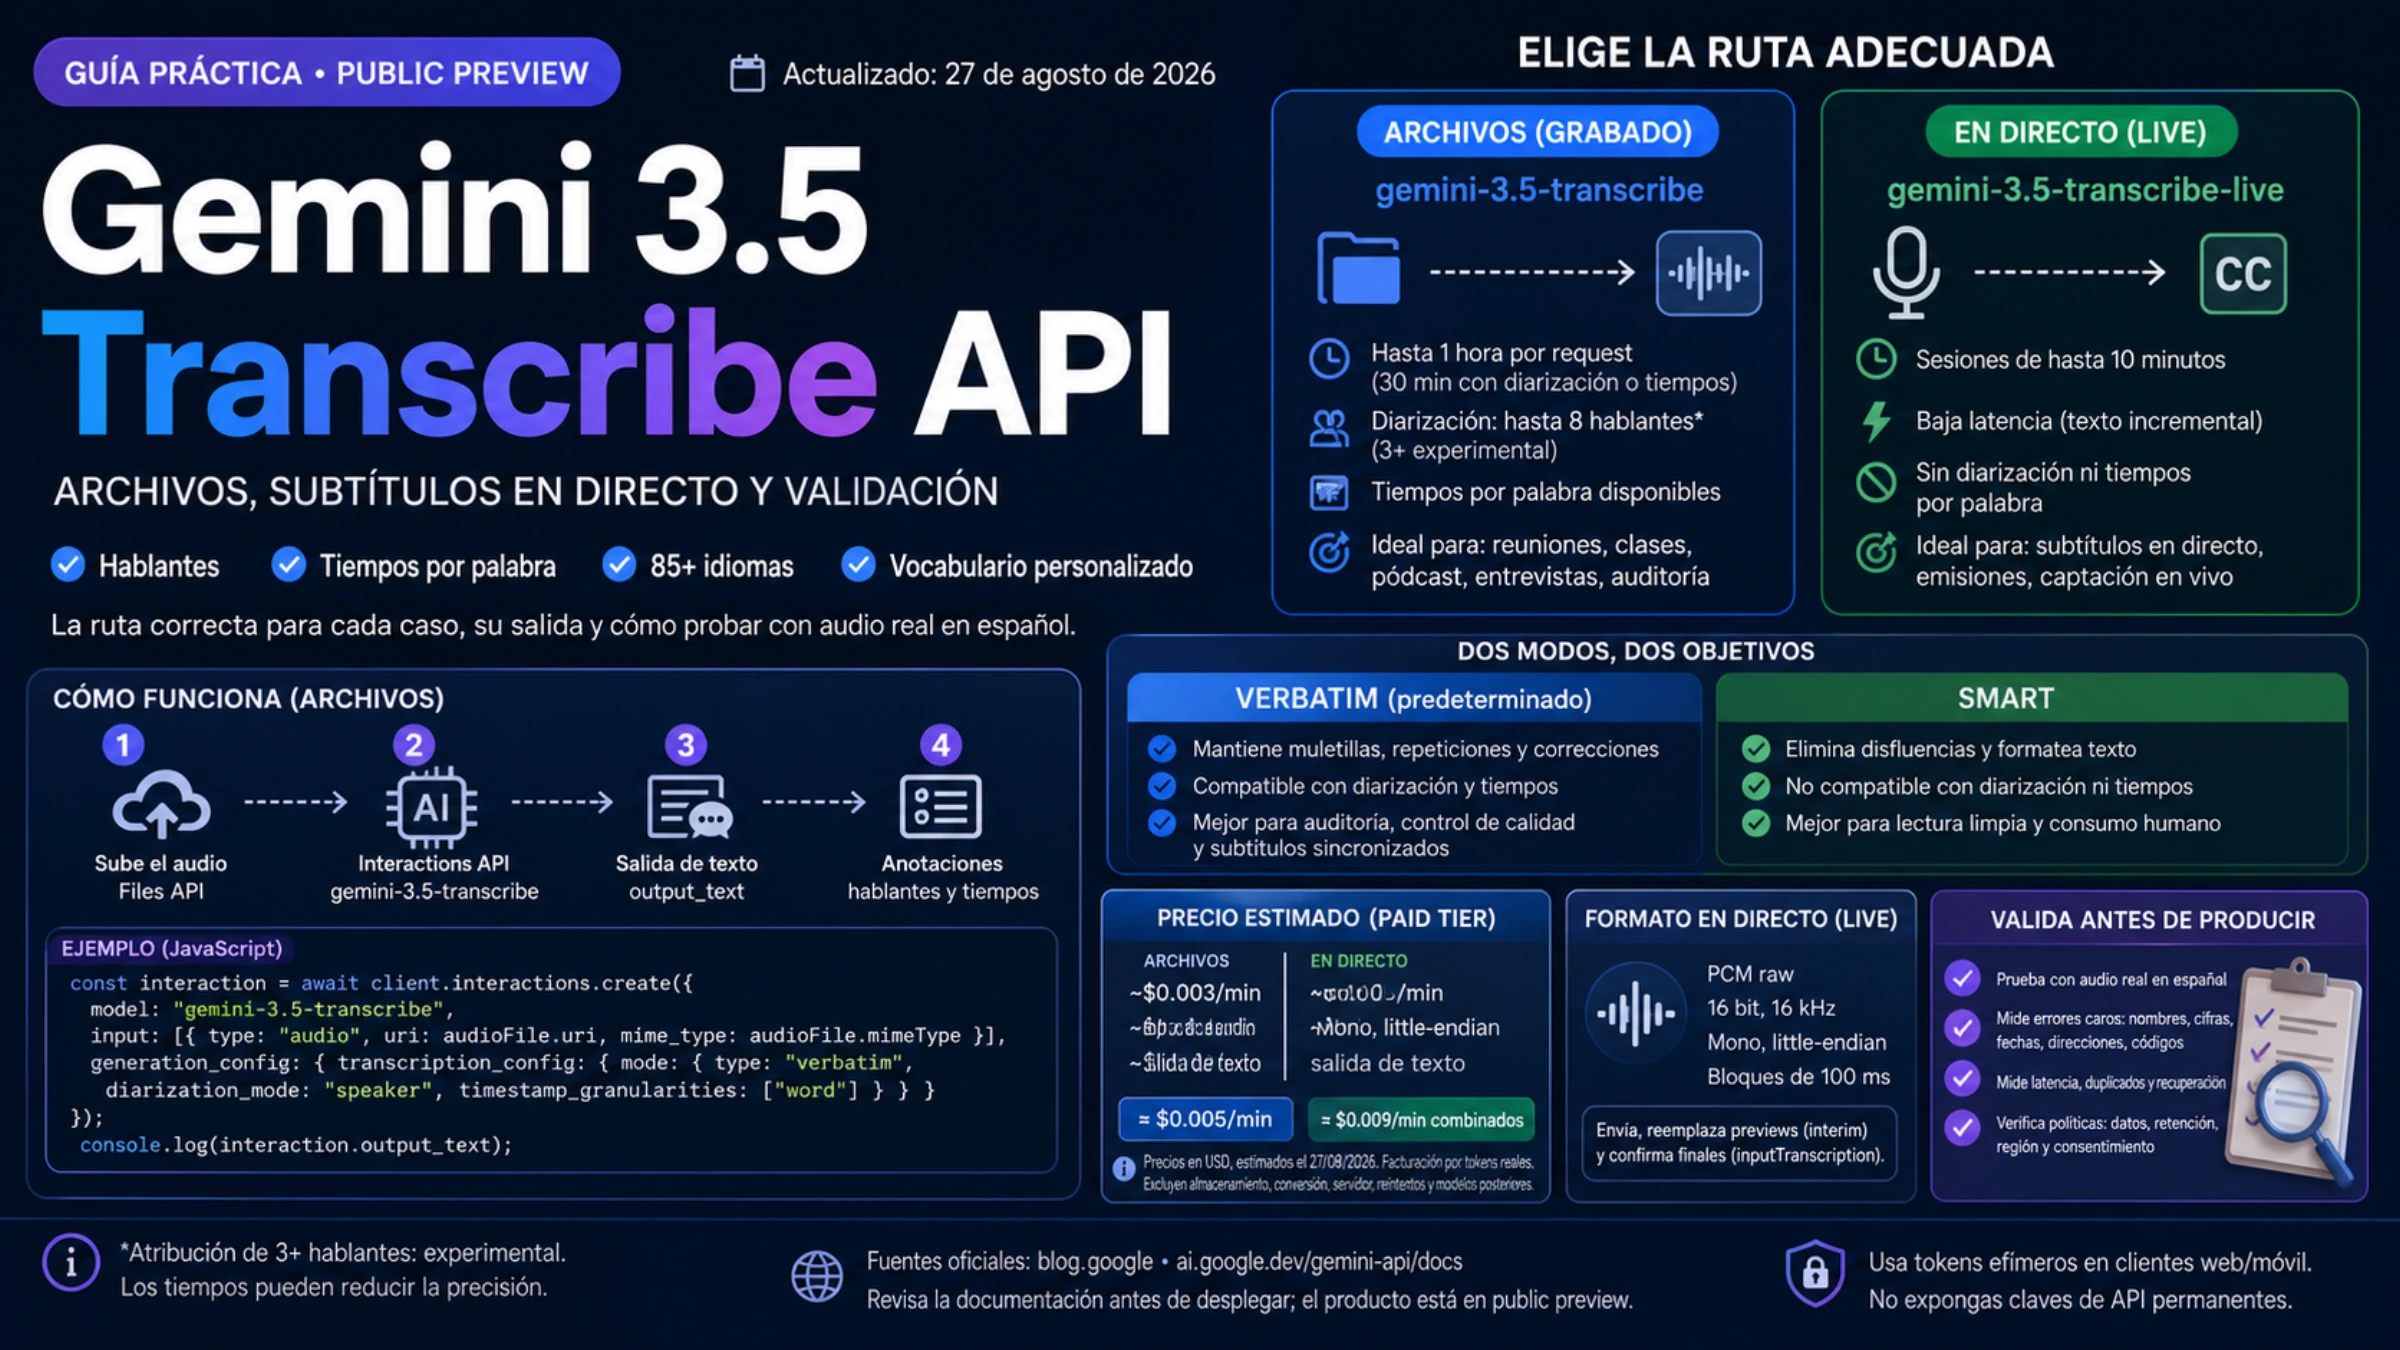
Para transcribir un archivo, usa gemini-3.5-transcribe con Files API e Interactions API. Para mostrar subtítulos mientras llega el audio, usa gemini-3.5-transcribe-live con Live API. La decisión depende de lo que necesitas conservar: la ruta de grabaciones ofrece hablantes y marcas de tiempo por palabra; Live devuelve texto provisional y final, sin esas anotaciones.
Hay una incompatibilidad que conviene resolver antes de escribir el primer cliente: en una grabación no puedes combinar custom_vocabulary con diarización ni con marcas de tiempo. Elige un perfil para términos específicos o uno para anotaciones. La ficha del modelo y la guía de transcripción documentan esta separación.
Los ejemplos siguientes sirven para construir el cliente y comprobar su lógica. Hemos comprobado sin conexión los perfiles, el lector de anotaciones, el estado de los subtítulos y los cálculos con datos sintéticos. Los ejemplos de SDK no se han ejecutado contra Google: no son una prueba de acceso de una cuenta, precisión del reconocimiento o facturación.
Elige la ruta según el resultado que necesitas
| Necesidad | Grabaciones | Live |
|---|---|---|
| Modelo exacto | gemini-3.5-transcribe | gemini-3.5-transcribe-live |
| API | Files para subir; Interactions para transcribir | Live API, conexión bidireccional |
| Entrada | Archivo y su MIME real | PCM sin contenedor: 16 bits, 16 kHz, mono, little-endian |
| Duración máxima | Una hora; 30 minutos con hablantes o tiempos por palabra | Diez minutos por sesión |
| Hablantes y tiempos por palabra | Disponibles con configuración compatible | No disponibles |
| Resultado visible | Texto y, si se solicitan, anotaciones | Texto provisional que cambia y segmentos finalizados |
Estos son los límites publicados en la documentación del modelo, consultada el 6 de octubre de 2026. Una entrevista que debe revisarse palabra a palabra encaja en la primera columna. Una clase que necesita subtítulos inmediatos encaja en la segunda. Si necesitas ambas cosas, conserva el audio de origen, muestra Live durante la sesión y procesa después la grabación con anotaciones.
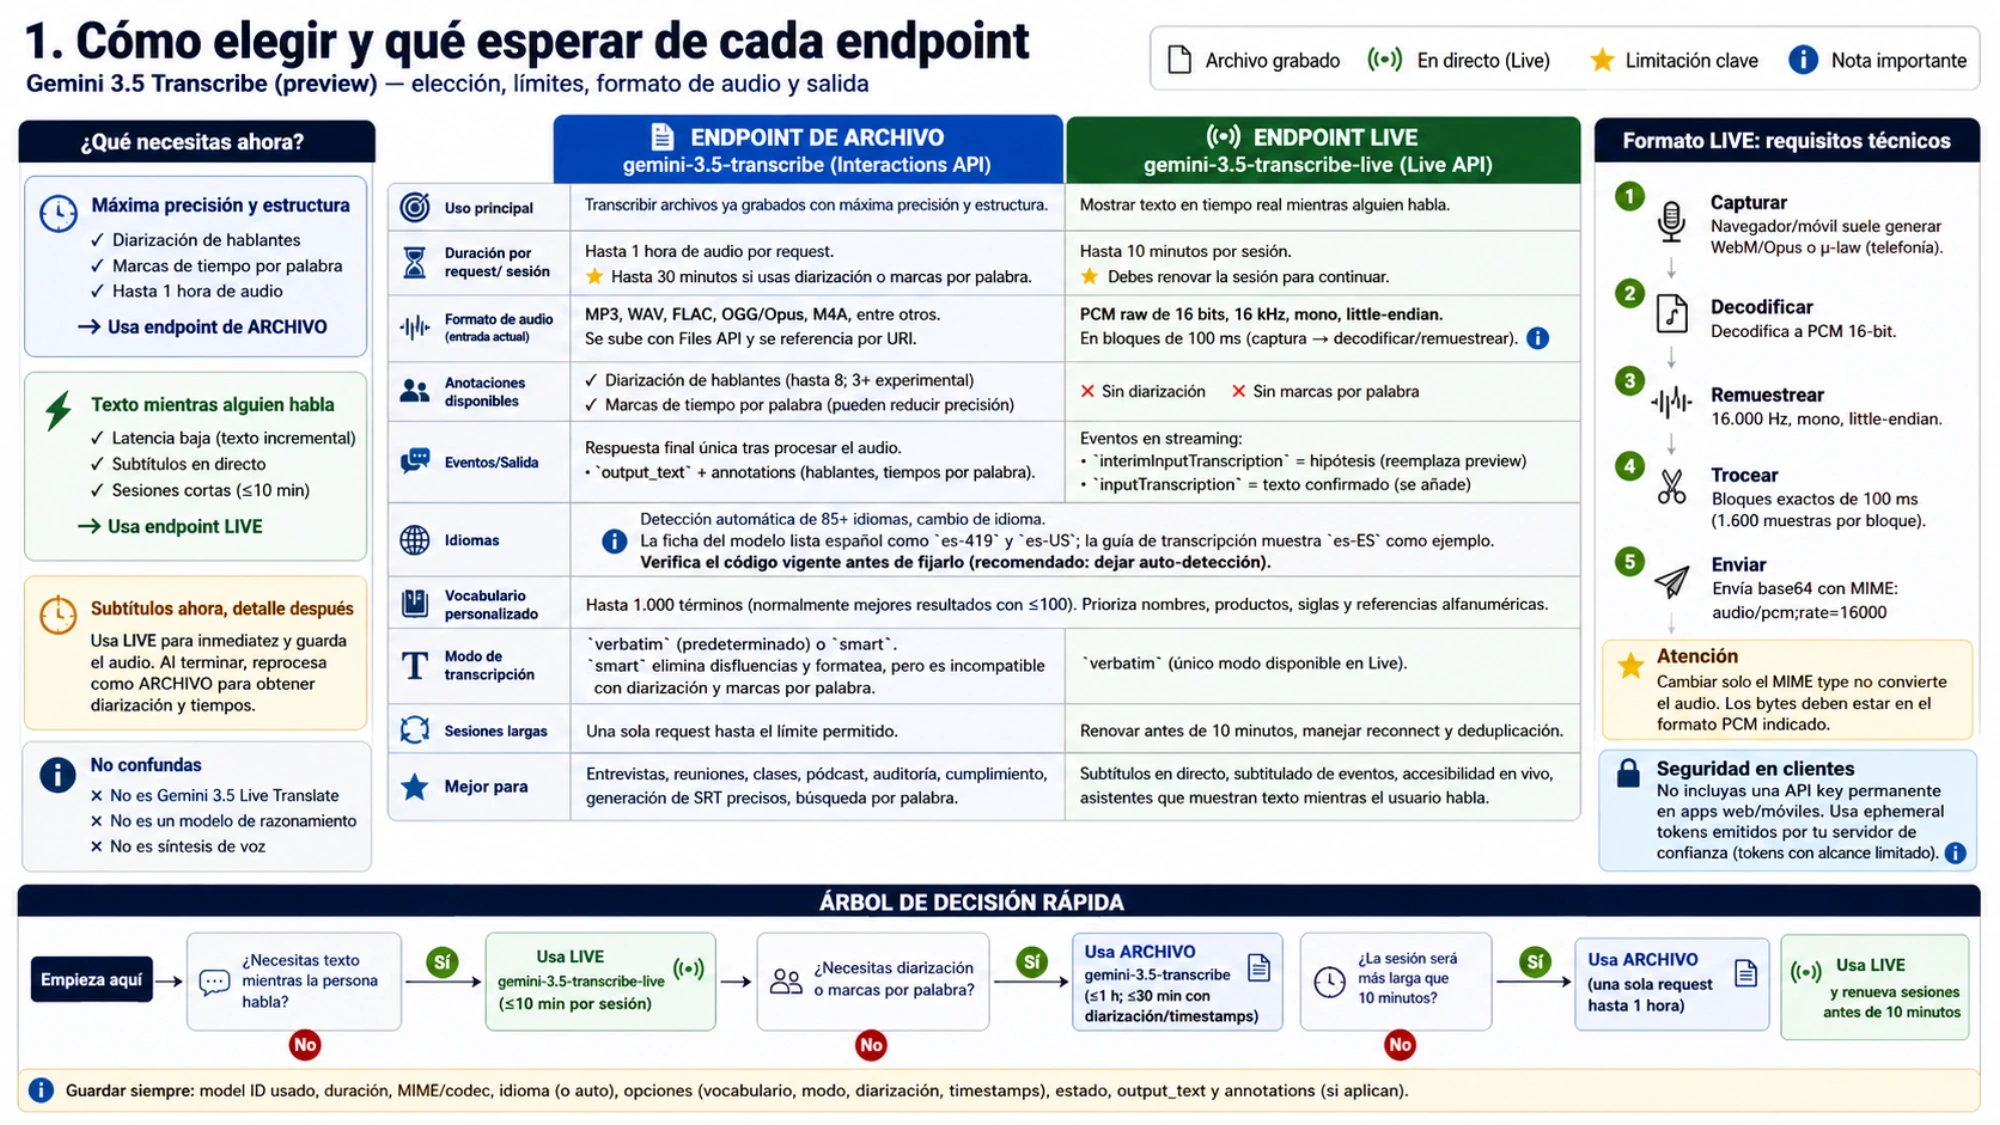
Transcribe convierte voz en texto. No es Live Translate, un asistente que responde con audio ni Gemini Flash utilizado para preguntas generales sobre un archivo. La ficha actual tampoco admite llamadas a funciones en estos modelos de transcripción. Si quieres resumir, traducir o ejecutar una herramienta, hazlo en una etapa posterior con el texto obtenido.
Transcribe una grabación sin mezclar opciones incompatibles
El recorrido es: subir un archivo, conservar su URI y MIME, enviar una interacción y comprobar el estado y la respuesta. La guía oficial utiliza una entrada de audio plana; en REST corresponde a POST https://generativelanguage.googleapis.com/v1beta/interactions, con autenticación x-goog-api-key. No sustituyas esta ruta por generateContent ni por un endpoint de audio de otro proveedor.
Este ejemplo de Python requiere google-genai en tu entorno y una credencial válida configurada para el SDK. entrevista.wav es un archivo local que tú has decidido enviar; usa primero una grabación corta sin información sensible. El código muestra el recorrido documentado, sin afirmar que se haya probado aquí con una versión instalada del SDK.
from google import genai

client = genai.Client()
archivo = client.files.upload(
    file="entrevista.wav",
    config={"mime_type": "audio/wav"},
)

resultado = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "type": "audio",
        "uri": archivo.uri,
        "mime_type": archivo.mime_type,
    }],
)
print(resultado.status)
print(resultado.output_text)
Comprueba que la subida devuelve una URI, que el MIME coincide con el archivo y que la interacción termina correctamente. Después, escucha un fragmento y contrástalo con el texto: recibir una cadena no prueba que corresponda bien al audio. No etiquetes un MP3 como WAV para resolver un error; cambia el MIME al formato real o convierte el archivo.
Un perfil para términos y otro para hablantes y palabras
Para una grabación con nombres de productos, puedes añadir vocabulario al modo literal. Para localizar quién dijo una palabra y en qué momento, solicita diarización y tiempos, sin vocabulario personalizado. Este pequeño selector devuelve la configuración de cada alternativa y evita mezclar ambas en la aplicación:
def perfil_grabacion(nombre, terminos=None):
    terminos = [] if terminos is None else list(terminos)
    if nombre == "terminos":
        if not all(isinstance(t, str) and t.strip() for t in terminos):
            raise ValueError("Los términos deben ser cadenas no vacías")
        if len(terminos) > 1000:
            raise ValueError("El máximo es 1000 términos")
        return {"custom_vocabulary": terminos}
    if terminos:
        raise ValueError("Este perfil no admite vocabulario personalizado")
    if nombre == "anotaciones":
        return {"mode": {
            "type": "verbatim",
            "diarization_mode": "speaker",
            "timestamp_granularities": ["word"],
        }}
    if nombre == "legible":
        return {"mode": "smart"}
    raise ValueError("Perfil desconocido")
Incorpora una de esas configuraciones al mismo recorrido de subida:
configuracion = perfil_grabacion("anotaciones")
# Alternativa: perfil_grabacion("terminos", ["BigQuery", "LaoZhang"])
# Alternativa: perfil_grabacion("legible")

resultado = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "type": "audio",
        "uri": archivo.uri,
        "mime_type": archivo.mime_type,
    }],
    generation_config={"transcription_config": configuracion},
)
verbatim es el modo predeterminado: conserva repeticiones, muletillas y autocorrecciones. smart busca un texto más legible y no admite diarización ni tiempos por palabra. En grabaciones se expresa como "mode": "smart", no como {"type": "smart"}. Si necesitas conservar el habla original y ofrecer una versión limpia, guarda la salida literal y transforma una copia. La salida literal sigue siendo una transcripción del modelo, no una declaración certificada. Modos y configuración oficiales.
Google admite hasta 1.000 términos y recomienda normalmente 100 o menos. El máximo no es una invitación a cargar un diccionario entero: elige nombres, siglas o referencias cuya confusión tenga consecuencias. La diarización llega hasta ocho hablantes, pero la atribución con tres o más es experimental. Solicitar tiempos por palabra también puede reducir la precisión. Estos límites pertenecen al modelo actual; no garantizan una reunión de ocho personas correctamente separada.
Qué hacer con el español y sus variantes
La detección automática se activa omitiendo language_codes o enviando una lista vacía. Es un punto de partida razonable para audio en español y conversaciones que cambian de idioma. Hay una discrepancia concreta: la lista del modelo incluye es-419 y es-US, mientras que la guía de grabaciones muestra un ejemplo con es-ES. Hasta confirmar el código aceptado para tu caso, no conviertas ese ejemplo en una condición obligatoria de la solicitud.
Conserva las anotaciones, no solo output_text
output_text es el texto unido. Para construir un reproductor que salte a una palabra o una vista por hablante, conserva también la respuesta estructurada: las palabras aparecen en steps[].content[].annotations[], con type: "word_info", text, speaker, start_offset y end_offset. Los desplazamientos usan cadenas de duración, por ejemplo "0.100s". Estructura y ejemplos de respuesta.
La siguiente función recibe un diccionario de respuesta JSON, como el de REST. No requiere el SDK. Devuelve las anotaciones de palabra manteniendo los campos originales y añadiendo los tiempos en segundos:
import re
from decimal import Decimal

def segundos(valor):
    if valor is None:
        return None
    if not isinstance(valor, str) or not re.fullmatch(r"\d+(?:\.\d+)?s", valor):
        raise ValueError("Duración no válida")
    return Decimal(valor[:-1])

def leer_palabras(respuesta):
    palabras = []
    for paso in respuesta.get("steps", []):
        for contenido in paso.get("content", []):
            for nota in contenido.get("annotations", []):
                if nota.get("type") != "word_info":
                    continue
                inicio = segundos(nota.get("start_offset"))
                fin = segundos(nota.get("end_offset"))
                if inicio is not None and fin is not None and fin < inicio:
                    raise ValueError("La palabra termina antes de empezar")
                palabras.append({
                    **nota,
                    "inicio_segundos": inicio,
                    "fin_segundos": fin,
                })
    return palabras
"0s" es un inicio válido: no lo descartes por ser cero. Si falta speaker, no asignes por defecto «hablante 1»; si faltan tiempos, no los calcules repartiendo la duración entre palabras. Una lista vacía indica que no se han encontrado esas anotaciones en la respuesta, no que el audio sea silencioso ni que el reconocimiento haya sido perfecto.
Antes de exportar SRT, agrupa las palabras en subtítulos legibles y revisa solapamientos, puntuación y cortes. El parser anterior no realiza esa edición. Si dividiste una grabación en archivos de menos de 30 minutos, guarda el comienzo de cada fragmento y aplica ese desplazamiento cuando necesites tiempos de la grabación completa; los tiempos de un fragmento por sí solos no reconstruyen toda la sesión.
Construye Live con PCM y dos estados de texto
Live espera audio PCM sin cabecera de contenedor: muestras enteras con signo de 16 bits, 16.000 muestras por segundo, un canal y orden little-endian. Un bloque de 100 ms contiene 1.600 muestras, es decir, 3.200 bytes. Un WAV tiene cabecera y un WebM/Opus contiene audio comprimido: ninguno se convierte en PCM poniendo audio/pcm en el mensaje. Decodifica y remuestrea antes de enviar. Entrada y eventos de Live Transcribe.
En Python, server_content.interim_input_transcription sustituye la previsualización; server_content.input_transcription añade un segmento finalizado. En JavaScript, los nombres son serverContent.interimInputTranscription y serverContent.inputTranscription. Un mensaje puede contener ambos o no contener server_content.
Esta clase aplica la regla a un mensaje JSON de JavaScript. Los números de segmento son identificadores de tu aplicación, no identificadores enviados por Google:
class Subtitulos:
    def __init__(self):
        self.provisional = ""
        self.segmentos = []

    def recibir(self, mensaje):
        contenido = mensaje.get("serverContent") or {}
        parcial = contenido.get("interimInputTranscription")
        final = contenido.get("inputTranscription")
        if parcial is not None:
            self.provisional = parcial.get("text", "")
        if final is not None:
            texto = final.get("text", "")
            if texto:
                self.segmentos.append({
                    "numero": len(self.segmentos) + 1,
                    "texto": texto,
                })
            self.provisional = ""
Aquí, si llegan ambos estados juntos, se añade el final y se vacía la previsualización. No añadas cada hipótesis al historial ni elimines globalmente finales iguales: alguien puede decir «sí» dos veces. Tras una reconexión, la igualdad del texto tampoco demuestra si un segmento es una repetición técnica o una nueva intervención. Conserva los límites de cada conexión y trata la reconciliación como una decisión de la aplicación.
Envía el audio y pon un plazo al cierre
El ejemplo siguiente transcribe un archivo local ya convertido a PCM y usa VAD automático. Requiere el SDK y una credencial del servidor. No captura el micrófono ni convierte audio; reutiliza Subtitulos del bloque anterior. La validación de bytes detecta un contenedor WAV evidente y una longitud impar, pero no demuestra por sí sola la frecuencia ni los canales del archivo.
import asyncio
from contextlib import suppress
from pathlib import Path
from google import genai
from google.genai import types

async def transcribir_pcm(ruta, espera_final=4.0):
    pcm = Path(ruta).read_bytes()
    if not pcm or len(pcm) % 2 or pcm.startswith(b"RIFF"):
        raise ValueError("Se necesita PCM de 16 bits sin contenedor")
    if len(pcm) >= 16000 * 2 * 600:
        raise ValueError("Divide el audio y deja margen antes de diez minutos")
    if espera_final <= 0:
        raise ValueError("El plazo de espera debe ser positivo")

    subtitulos = Subtitulos()
    estado = "en_curso"
    error = None
    client = genai.Client(http_options={"api_version": "v1beta"})
    async with client.aio.live.connect(
        model="gemini-3.5-transcribe-live",
        config={
            "response_modalities": ["TEXT"],
            "input_audio_transcription": {},
        },
    ) as sesion:
        async def escuchar():
            while True:
                recibido = False
                async for mensaje in sesion.receive():
                    recibido = True
                    contenido = mensaje.server_content
                    if contenido is None:
                        continue
                    evento = {"serverContent": {}}
                    for origen, destino in (
                        ("interim_input_transcription", "interimInputTranscription"),
                        ("input_transcription", "inputTranscription"),
                    ):
                        parte = getattr(contenido, origen, None)
                        if parte is not None:
                            evento["serverContent"][destino] = {"text": parte.text or ""}
                    subtitulos.recibir(evento)
                if not recibido:
                    return

        receptor = asyncio.create_task(escuchar())
        try:
            for inicio in range(0, len(pcm), 3200):
                bloque = pcm[inicio:inicio + 3200]
                await sesion.send_realtime_input(audio=types.Blob(
                    data=bloque, mime_type="audio/pcm;rate=16000",
                ))
                await asyncio.sleep(len(bloque) / 32000)
            await sesion.send_realtime_input(audio_stream_end=True)
            await asyncio.wait_for(asyncio.shield(receptor), espera_final)
            estado = "recepcion_cerrada"
        except asyncio.TimeoutError:
            estado = "cierre_por_plazo"
        except Exception as exc:
            estado = "error"
            error = str(exc)
        finally:
            if not receptor.done():
                receptor.cancel()
            with suppress(asyncio.CancelledError, Exception):
                await receptor
    return {
        "estado": estado,
        "error": error,
        "segmentos": subtitulos.segmentos,
        "provisional": subtitulos.provisional,
    }

# En tu servidor: resultado = asyncio.run(transcribir_pcm("muestra.pcm"))
audio_stream_end=True indica que has terminado de enviar audio y permite finalizar la transcripción pendiente. No cierra por sí solo el WebSocket. El plazo de cuatro segundos es una elección del ejemplo, no una garantía de latencia de Google. Si se agota, guarda los segmentos recibidos y señala que podría faltar el último; no conviertas el provisional en final. Un error al abrir o cerrar la conexión debe manejarse además en el código que llama a esta función. La cancelación de la tarea no cancela cargos ya generados.
El ejemplo usa la detección automática de actividad. Si eliges control manual, la guía establece desactivar automatic_activity_detection y enviar activity_start y activity_end; no mezcles esa modalidad con señales manuales añadidas sin criterio al flujo automático. Live utiliza los valores de modo "SMART" y "VERBATIM", en mayúsculas, distintos del modo "smart" de Interactions. Configuración de Live.
Conecta un navegador sin publicar una clave permanente
Si el cliente se conecta directamente, un servidor de confianza debe autenticarlo y emitir un token efímero con restricciones para este modelo y su configuración TEXT. Los tokens efímeros actuales se admiten en Live con v1beta. Por defecto permiten iniciar una sesión durante un minuto, enviar mensajes durante 30 minutos y un uso. Son tres condiciones distintas.
Ese plazo de 30 minutos no amplía el límite de diez minutos de Transcribe Live. Para sesiones largas, programa nuevas conexiones con margen y decide cómo conservar el audio pendiente. No prometas continuidad sin pérdida ni entrega exactamente una vez entre conexiones basándote solo en un token o en comparar el texto. Tampoco incluyas la clave permanente en el código del navegador.
Calcula el coste con la tarifa de Transcribe
La tarifa específica de Gemini Developer API, consultada el 6 de octubre de 2026, distingue tokens de audio de entrada y tokens de texto de salida:
| Ruta | Entrada, por un millón de tokens de audio | Salida, por un millón de tokens de texto | Referencia aproximada por minuto, ambas partes |
|---|---|---|---|
| Grabaciones | 2 USD | 12 USD | 0,005 USD |
| Live | 3,50 USD | 21 USD | 0,009 USD |
Las referencias de duración usan 25 tokens de audio por segundo y unos 175 tokens de texto por minuto. No uses aquí los 32 tokens por segundo de una estimación de audio genérico. Con las hipótesis específicas, un minuto grabado cuesta 1.500 × 2 / 1.000.000 + 175 × 12 / 1.000.000 = 0,0051 USD; en Live, 0,008925 USD.
Por tanto, 100 horas, o 6.000 minutos, dan 30,60 USD para grabaciones y 53,55 USD para Live, sin redondear antes de multiplicar. Los aproximados 30 y 54 USD salen de multiplicar las referencias redondeadas. Son presupuestos bajo esas hipótesis, no facturas observadas ni una cuota garantizada.
Para un consumo real, calcula tokens_audio_entrada × tarifa_entrada / 1.000.000 + tokens_texto_salida × tarifa_salida / 1.000.000. Añade almacenamiento, conversión, retransmisiones, llamadas posteriores y revisión humana según tu arquitectura. La ficha del modelo no ofrece Batch para esta ruta, por lo que no debes aplicar automáticamente un descuento Batch de otros modelos.
Revisa el tratamiento de datos antes de enviar audio
La página de precios muestra nivel gratuito y de pago, pero sus casillas sobre mejora de productos no resumen todos los casos. Las condiciones de Gemini API indican, con carácter general, que el servicio gratuito puede usar entradas y respuestas para mejorar productos e incluir revisión humana; piden no enviar información personal, confidencial o sensible.
En la API de pago, asociada a un proyecto con facturación activa, las entradas y respuestas no se usan para mejorar esos productos bajo dichas condiciones. Eso no equivale a retención cero: siguen existiendo tratamientos limitados por seguridad, abuso u obligaciones legales. Hay además una excepción para el Espacio Económico Europeo, Suiza y Reino Unido: se aplican las condiciones de uso de datos del servicio de pago incluso a la cuota gratuita, y los clientes de API ofrecidos a usuarios de esas regiones deben utilizar servicios de pago. El idioma español de una grabación no determina dónde está su usuario ni qué condición le corresponde.
Los archivos de Files API se eliminan automáticamente a las 48 horas; el límite es de 2 GB por archivo y 20 GB por proyecto. No puedes descargar después el archivo subido desde esa API: conserva tu original si lo necesitas. Las 48 horas describen el ciclo de vida del archivo, no el de todas las interacciones, salidas o registros. Límites y gestión de Files.
Antes de utilizar llamadas de clientes o reuniones internas, confirma el consentimiento y la política aplicable, el proyecto y su facturación, quién accede a originales y transcripciones y cuánto tiempo los conserva tu aplicación. Elegir el nivel de pago no certifica por sí solo el cumplimiento de un sector regulado.
Valida el reconocimiento y el comportamiento de tu cliente por separado
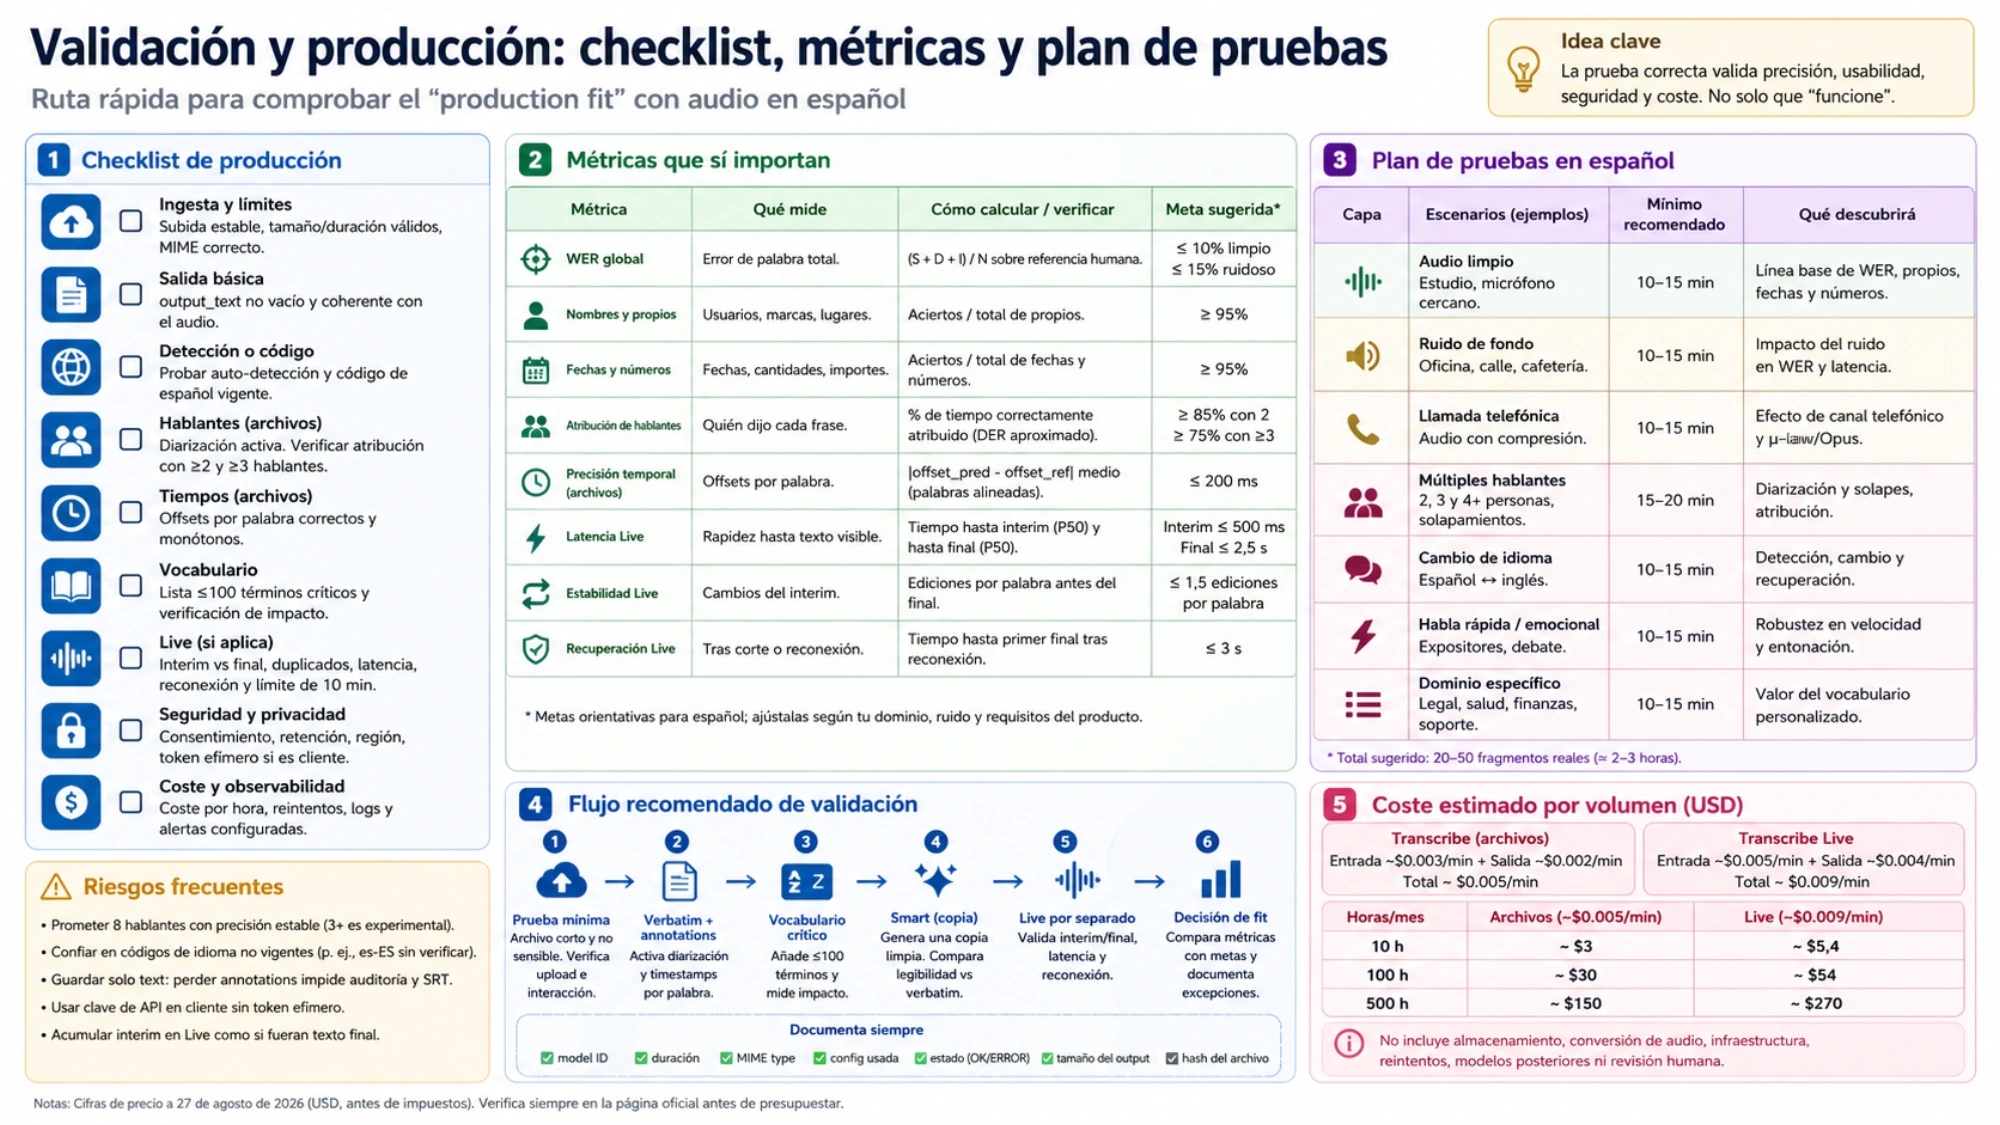
Las pruebas sintéticas de este artículo verifican que las configuraciones se separan, que 0s se conserva, que una palabra sin hablante no recibe uno inventado y que el texto provisional se sustituye mientras los finales repetidos se guardan. También comprueban los cálculos y la aritmética de los bloques PCM. Se ha revisado la sintaxis de los ejemplos de Python sin importar ni instanciar el SDK. Esto valida lógica de aplicación; no demuestra que el servicio acepte la solicitud ni que reconozca bien una voz.
Para evaluar el modelo, prepara grabaciones autorizadas representativas de tu uso y una transcripción humana de referencia. Incluye acentos, ruido, distancias al micrófono y nombres propios que de verdad importen. Compara especialmente cantidades, fechas, negaciones y compromisos: una baja tasa media de error puede ocultar un error caro. En grabaciones, comprueba los hablantes y vuelve al audio desde los tiempos. En Live, mide cuándo aparece la hipótesis, cuántas correcciones recibe y cuándo llega el final; prueba además el cierre y una interrupción de conexión.
Google publicó resultados atribuidos a Artificial Analysis de un WER del 4,0 % en streaming y del 2,6 % en grabaciones, y una reducción del tiempo hasta el texto final frente a Chirp 3. Son cifras del anuncio del 26 de agosto, no resultados de nuestras pruebas ni una precisión garantizada para castellano, una llamada telefónica o un micrófono concreto.
Preguntas frecuentes
¿Puedo usar Gemini 3.5 Transcribe gratis?
La tabla de precios incluye un nivel gratuito. Eso no demuestra el acceso o la cuota de una cuenta concreta. Revisa también las condiciones de datos, incluida la excepción del EEE, Suiza y Reino Unido y la obligación de servicio de pago para clientes dirigidos a usuarios de esas regiones, antes de enviar audio.
¿Es una API en preview o ya está disponible de forma general?
El registro de cambios dice disponibilidad general desde el 26 de agosto; el anuncio de lanzamiento sigue describiendo una preview pública. Las etiquetas oficiales no coinciden en las páginas consultadas el 6 de octubre. Usa los identificadores y contratos de la documentación actual y comprueba el acceso del proyecto; ninguna de esas etiquetas acredita disponibilidad para todas las cuentas.
¿Puedo tener diarización y tiempos por palabra en los subtítulos en directo?
No con el contrato actual de gemini-3.5-transcribe-live. Para obtenerlos, conserva la grabación y utiliza gemini-3.5-transcribe después, con el perfil literal y sin vocabulario personalizado. Ese perfil reduce el máximo del archivo a 30 minutos. Capacidades y límites oficiales.
¿El texto final ya puede publicarse sin revisión?
«Final» significa que el modelo ha finalizado ese segmento, no que una persona lo haya contrastado con el audio. Publica automáticamente solo si tu evaluación y el impacto de los errores lo permiten. Para nombres, cifras, acuerdos o citas sensibles, conserva el original y una revisión adecuada a su uso.
Fuentes9
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 7 oct 2026.
Fuentes9
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 7 oct 2026.
- 1.ficha del modeloai.google.dev/gemini-api/docs/models/gemini-3.5-transcribe
- 2.guía de transcripciónai.google.dev/gemini-api/docs/transcribe
- 3.Entrada y eventos de Live Transcribeai.google.dev/gemini-api/docs/live-api/live-transcribe
- 4.tokens efímeros actualesai.google.dev/gemini-api/docs/live-api/ephemeral-tokens
- 5.tarifa específica de Gemini Developer APIai.google.dev/gemini-api/docs/pricing
- 6.condiciones de Gemini APIai.google.dev/gemini-api/terms
- 7.Límites y gestión de Filesai.google.dev/gemini-api/docs/files
- 8.anuncio del 26 de agostoblog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5-transcribe
- 9.registro de cambiosai.google.dev/gemini-api/docs/changelog