Migrar function calling de Chat Completions a Responses API
Recorre los function_call de Responses, ejecuta solo funciones permitidas y devuelve sus resultados con el call_id original. Después continúa el bucle hasta una respuesta final, conservando el estado y evitando repetir efectos al recuperar una petición.
En esta página
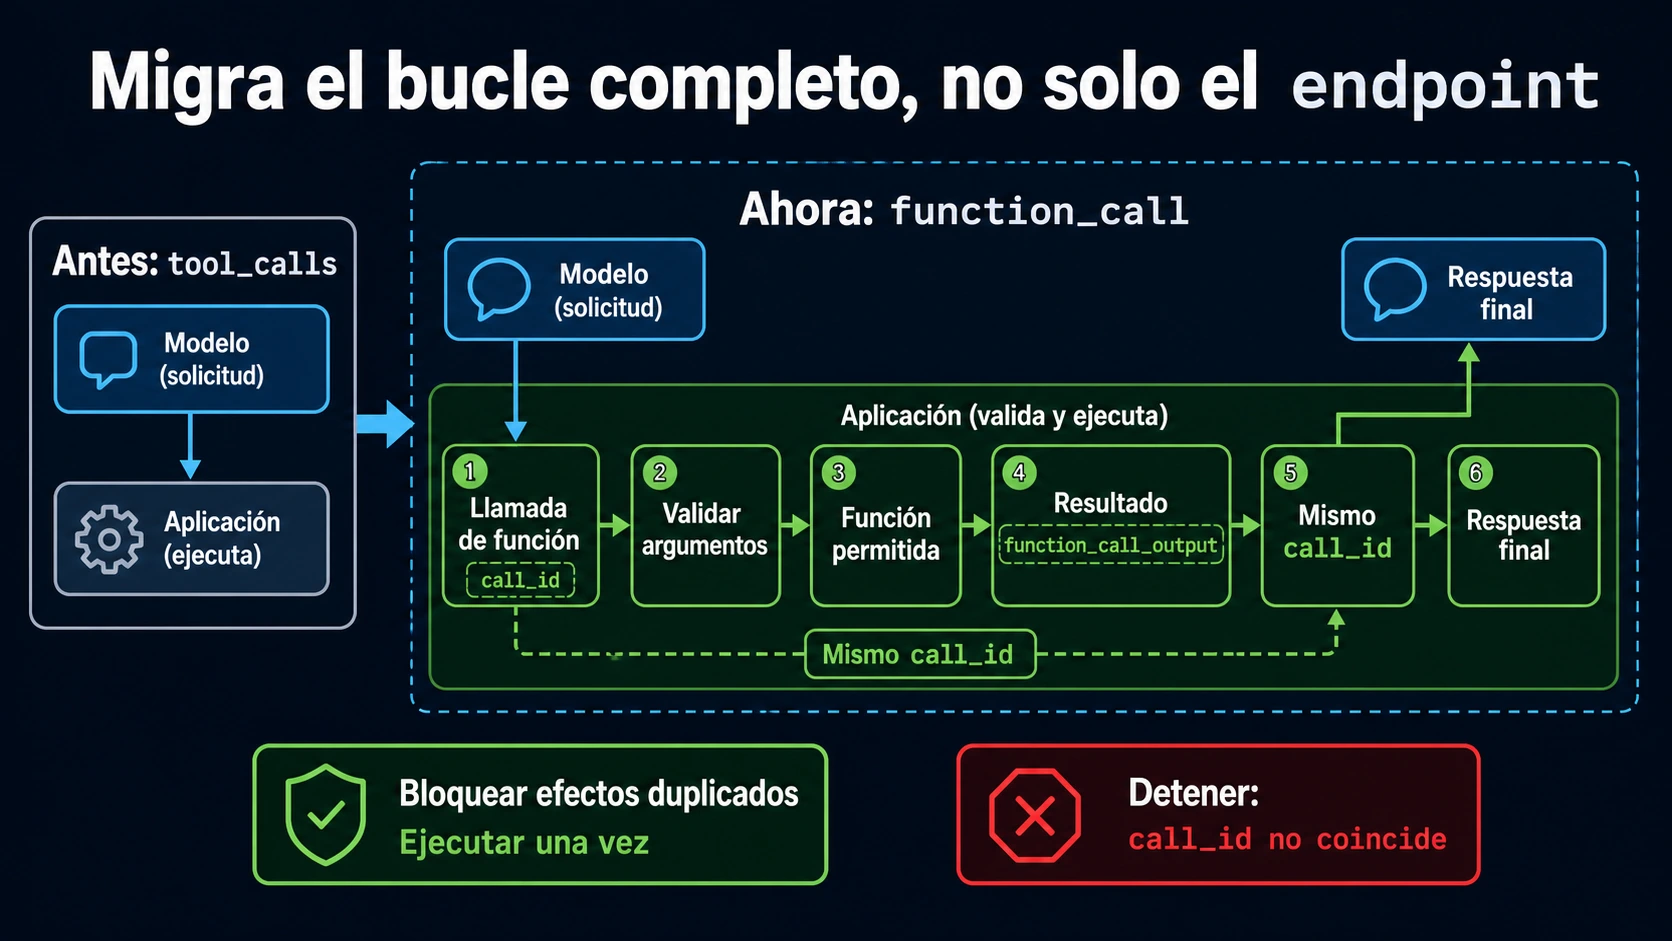
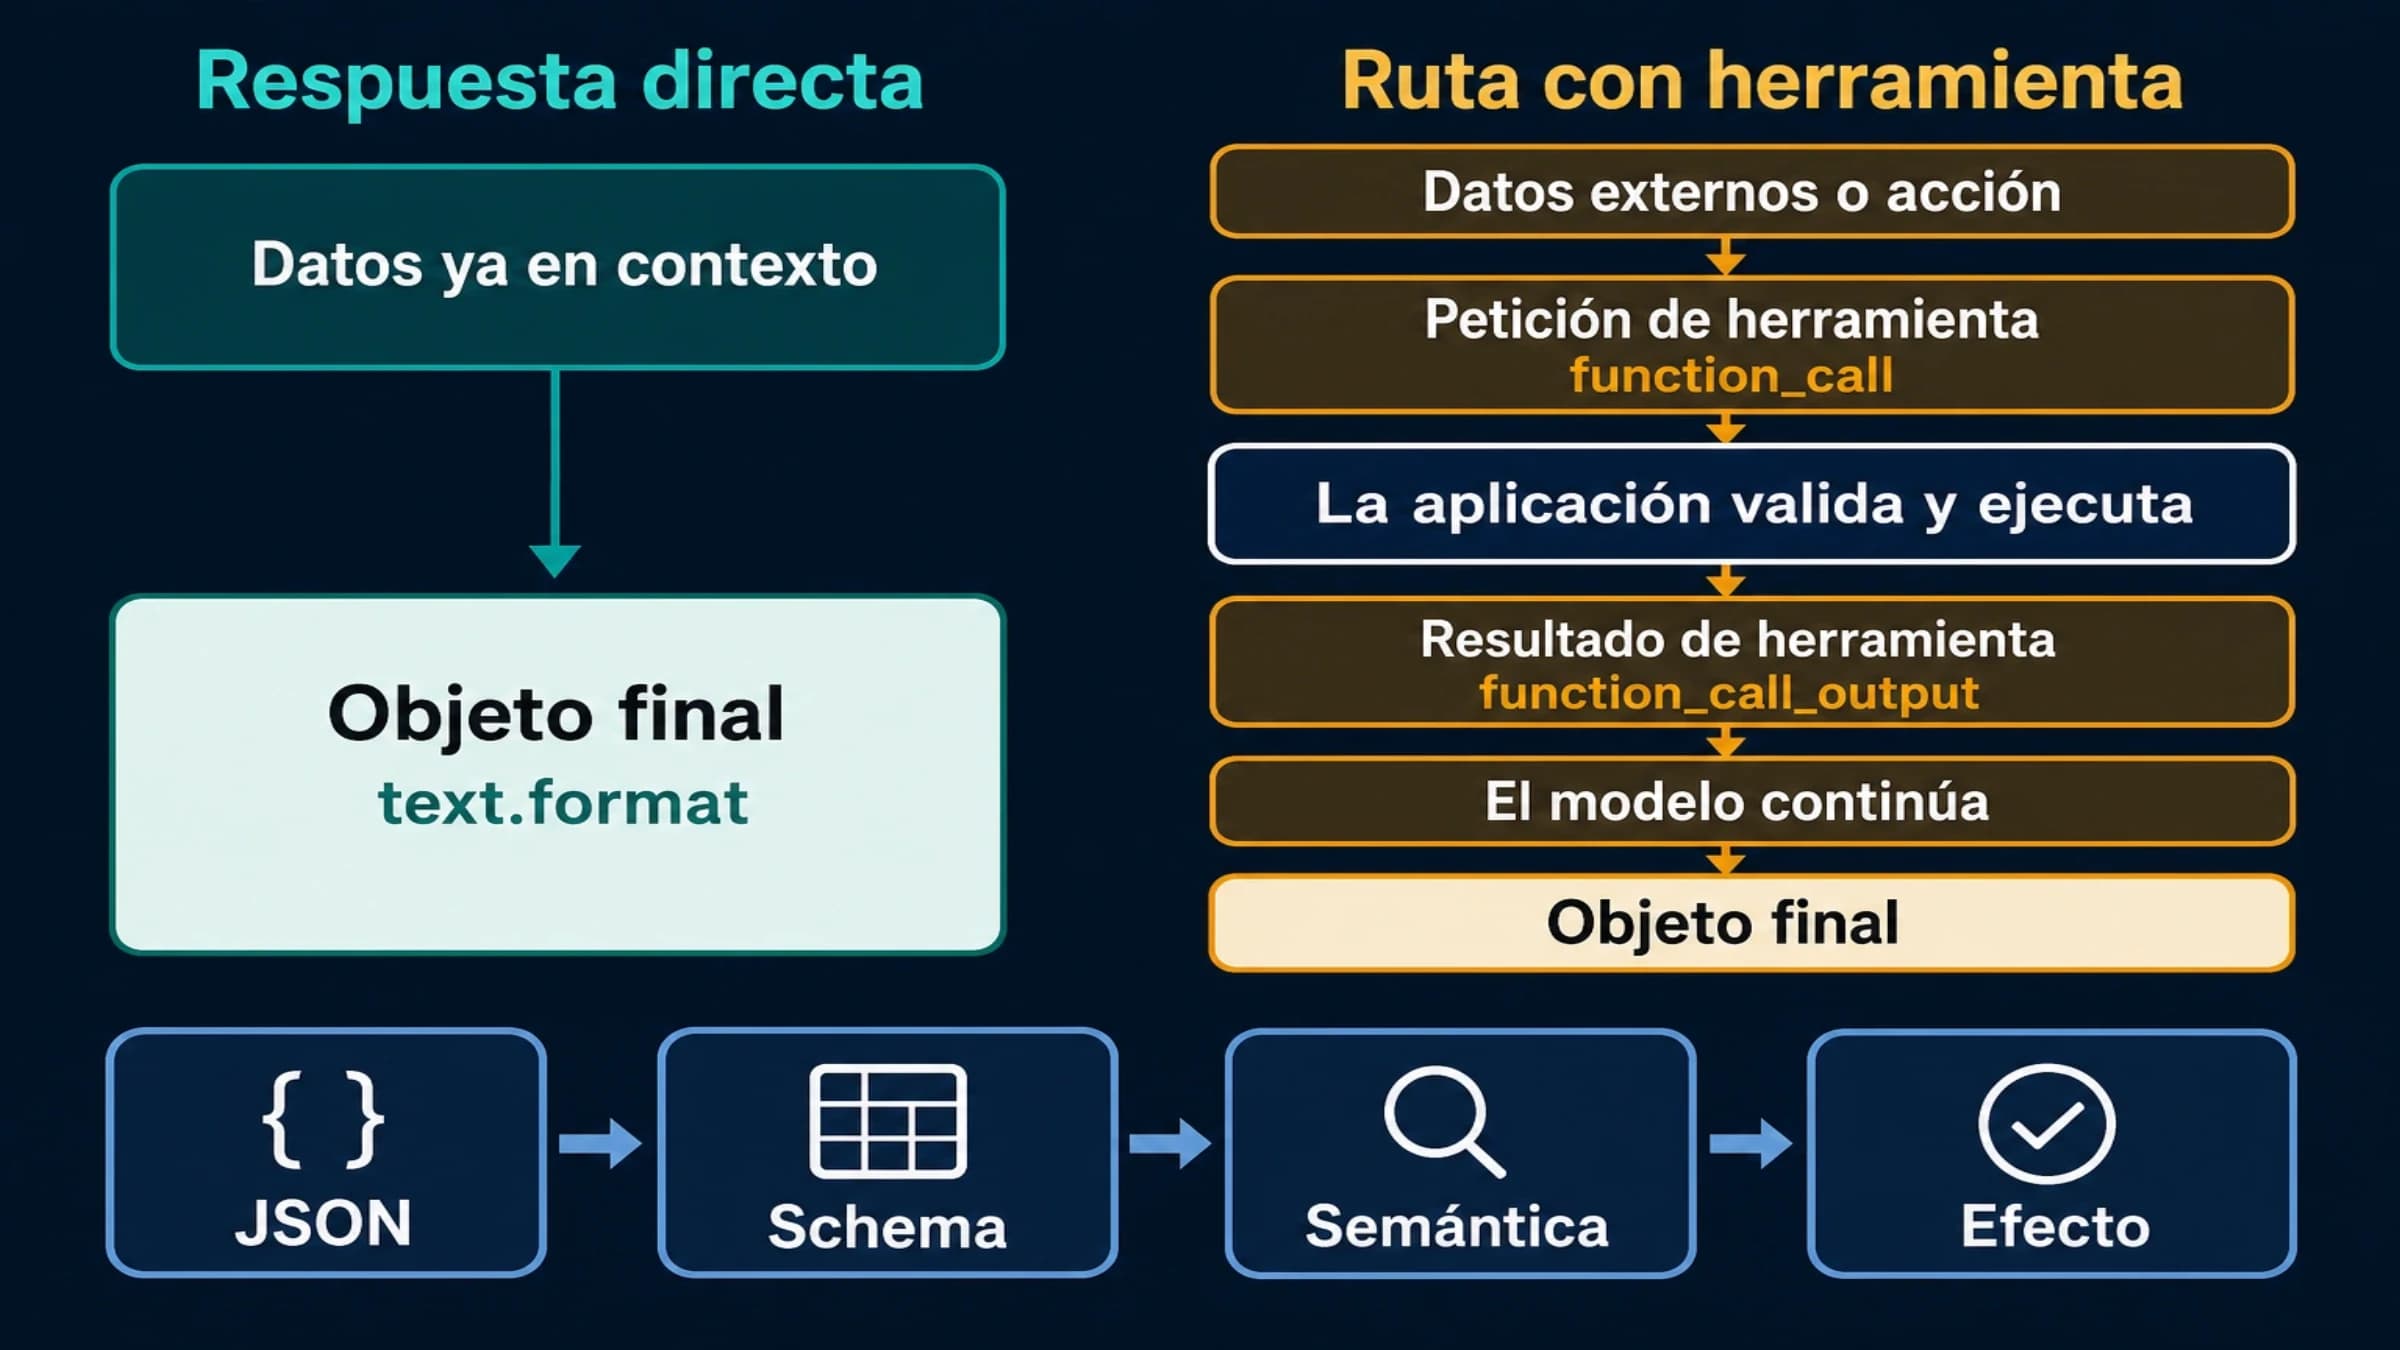
Para migrar function calling de Chat Completions a Responses API, migra el bucle completo: el modelo solicita una función, tu aplicación valida sus argumentos y permisos, ejecuta el código y devuelve un function_call_output con el call_id original. La siguiente petición al modelo puede generar la respuesta final o pedir otra función. Cambiar chat.completions.create() por responses.create() deja sin resolver esa continuación.
El ejemplo de esta guía consulta un pedido ficticio en JavaScript, sin modificar datos. Incluye la función que se ejecuta, el validador, la devolución del resultado, la conservación del historial y una condición de salida. Puedes comprobar su lógica sin credenciales; la integración con el SDK y el servicio necesita una prueba posterior en un entorno autorizado.
Chat Completions sigue admitido por OpenAI, que recomienda Responses para proyectos nuevos. Esta migración parte de funciones propias que ya funcionan en Chat. La retirada de Assistants y las herramientas alojadas por OpenAI son otros trabajos.
Qué cambia entre las dos APIs
| Parte del bucle | Chat Completions | Responses API |
|---|---|---|
| Entrada | messages | input, con mensajes y otros Items |
| Salida que hay que recorrer | choices[0].message.tool_calls | Los elementos function_call de response.output |
| Definición de la función | tools[].function.name, parameters, strict | tools[].name, parameters, strict, sin el envoltorio function |
| Resultado de tu aplicación | Mensaje role: "tool" con tool_call_id | Item type: "function_call_output" con call_id |
| Continuación | Añadir mensajes y solicitar otra completion | Añadir Items y resultados, o elegir un mecanismo de estado alojado |
| Streaming | Deltas de choices | Eventos tipados de Responses |
Son cambios documentados en la guía de migración. El nombre de tu función y su lógica de negocio pueden mantenerse; cambia cómo la declares y cómo enlazas su solicitud con el resultado.
response.output puede mezclar mensajes, razonamiento y varias llamadas. Recorre el array por type; no des por hecho que output[0] contiene texto o una función. Además, item.id y call_id identifican cosas diferentes: el primero identifica el Item; el segundo une la llamada de función con su resultado. OpenAI describe ese intercambio en la guía de function calling.
Conserva el comportamiento de la ruta actual
Antes de mover tráfico, elige una consulta inocua que tu aplicación ya resuelva y conserva su entrada, instrucciones, modelo, configuración efectiva, argumentos validados, resultado de la función y respuesta final. Esa será la comparación con Responses. No uses datos personales para construir los fixtures.
Mantén el modelo cuando sea compatible y revisa sus parámetros aparte del cambio de API. A fecha de 7 de octubre de 2026, GPT-6 Astra y GPT-6.1 Sol requieren Responses para llamar a herramientas, aunque admiten Chat para peticiones sin ellas. GPT-6 Sol y Luna admiten funciones en Chat con reasoning_effort: "none". En Responses el campo es reasoning.effort; Astra y 6.1 Sol no admiten none. Con razonamiento distinto de none, tampoco debes arrastrar sin más parámetros de muestreo incompatibles. La compatibilidad oficial por modelo determina qué configuración puedes conservar.
No estrenes a la vez un modelo, un proveedor y una estrategia de estado: complicaría atribuir un cambio en el resultado. El criterio de aceptación será que el pedido autorizado produzca el resultado esperado y una respuesta final equivalente, sin ejecuciones adicionales. Un 200 OK o un texto que diga «he consultado el pedido» no demuestra esa ejecución.
Bucle completo de Responses API en JavaScript
Guarda este primer archivo como bucle-responses.mjs. Contiene el programa de aplicación y recibe el transporte y el conversor de Items como dependencias. Así puedes probarlo sin importar ni inicializar el SDK. El segundo archivo lo conecta con OpenAI.
La herramienta tiene strict: true, todos sus campos en required y additionalProperties: false. Actualmente, si omites strict, Responses intenta normalizar el esquema para usar el modo estricto y, si no puede, recurre a llamadas de mejor esfuerzo; Chat es no estricto por defecto. Un esquema incompatible enviado con strict: true se rechaza. Estos detalles del modo estricto no sustituyen la validación ni los permisos de la aplicación.
export const tools = [{
  type: "function",
  name: "consultar_pedido",
  description: "Consulta un pedido de la cuenta autenticada, sin modificarlo.",
  strict: true,
  parameters: {
    type: "object",
    properties: { pedido: { type: "string" } },
    required: ["pedido"],
    additionalProperties: false
  }
}];

const instructions = "Consulta el pedido con consultar_pedido. " +
  "Explica el resultado recibido. No inventes estados ni acciones.";

function validateCall(call) {
  if (typeof call.call_id !== "string" || !call.call_id ||
      typeof call.name !== "string" || typeof call.arguments !== "string") {
    throw new Error("Llamada sin identidad o argumentos completos");
  }
  if ((call.status && call.status !== "completed") || call.async === true ||
      call.namespace || (call.caller && call.caller.type !== "direct")) {
    throw new Error("Variante de llamada fuera de este bucle síncrono");
  }
}

export function makeExecutor(account, orders) {
  // account procede de la sesión del servidor; nunca de los argumentos.
  const ledger = new Map();
  const trace = [];
  const handlers = Object.freeze({
    consultar_pedido: async ({ pedido }) => {
      const row = orders.get(pedido);
      if (!row || row.cuenta !== account) {
        return { estado: "no_disponible" };
      }
      return { pedido, estado: row.estado, entrega: row.entrega };
    }
  });

  function execute(call) {
    validateCall(call);
    const signature = JSON.stringify([call.name, call.arguments]);
    const existing = ledger.get(call.call_id);
    if (existing) {
      if (existing.signature !== signature) {
        throw new Error("El mismo call_id llegó con otro contenido");
      }
      return existing.pending;
    }

    // La promesa queda registrada antes de empezar el trabajo asíncrono.
    const pending = Promise.resolve().then(async () => {
      let result;
      let executed = false;
      try {
        if (!Object.hasOwn(handlers, call.name)) throw new Error("name");
        const args = JSON.parse(call.arguments);
        if (!args || typeof args !== "object" || Array.isArray(args) ||
            Object.keys(args).length !== 1 ||
            !Object.hasOwn(args, "pedido") ||
            typeof args.pedido !== "string" || !/^ORD-\d{4}$/.test(args.pedido)) {
          throw new Error("arguments");
        }
        result = await handlers[call.name](args);
        executed = true;
      } catch {
        result = { error: "consulta_rechazada" };
      }
      trace.push({ call_id: call.call_id, name: call.name, executed });
      return {
        type: "function_call_output",
        call_id: call.call_id,
        output: JSON.stringify(result)
      };
    });
    ledger.set(call.call_id, { signature, pending });
    return pending;
  }
  return { execute, trace };
}

export async function migrateOrder({ create, toInput, model, executor, question }) {
  if (typeof model !== "string" || !model.trim()) throw new Error("Falta model");
  if (typeof toInput !== "function") throw new Error("Falta conversor de Items");
  const history = [{ role: "user", content: question }];
  const expires = Date.now() + 15_000;
  let totalCalls = 0;
  function remaining() {
    const ms = expires - Date.now();
    if (ms <= 0) throw new Error("Plazo del bucle agotado");
    return ms;
  }

  for (let round = 0; round < 6; round += 1) {
    const response = await create({
      model,
      instructions,
      input: structuredClone(history),
      tools,
      store: false,
      parallel_tool_calls: false,
      max_output_tokens: 1_200
    }, { signal: AbortSignal.timeout(remaining()) });
    remaining();
    if (response.status !== "completed" || response.error) {
      throw new Error(`Response no completada: ${response.status}`);
    }
    if (!Array.isArray(response.output)) throw new Error("Falta output");
    const calls = [];
    const ids = new Set();
    const text = [];
    for (const item of response.output) {
      if (item.type === "function_call") {
        validateCall(item);
        if (ids.has(item.call_id)) throw new Error("call_id duplicado en el lote");
        ids.add(item.call_id);
        calls.push(item);
      } else if (item.type === "message") {
        if (item.role !== "assistant" || item.status !== "completed" ||
            !Array.isArray(item.content)) throw new Error("Mensaje incompleto");
        for (const part of item.content) {
          if (part.type === "refusal") throw new Error("El modelo rechazó la solicitud");
          if (part.type !== "output_text" || typeof part.text !== "string") {
            throw new Error("Contenido de mensaje no contemplado");
          }
          if (item.phase !== "commentary") text.push(part.text);
        }
      } else if (item.type !== "reasoning") {
        throw new Error(`Item no contemplado: ${item.type}`);
      }
    }

    // Convierte toda la salida, con reasoning y phase, no solo las llamadas.
    history.push(...toInput(response.output));
    if (calls.length === 0) {
      const finalText = text.join("\n").trim();
      if (!finalText || !executor.trace.some((entry) => entry.executed)) {
        throw new Error("Falta una consulta ejecutada o una respuesta final");
      }
      return { text: finalText, response_id: response.id, trace: [...executor.trace] };
    }
    totalCalls += calls.length;
    if (totalCalls > 8) throw new Error("Demasiadas llamadas de aplicación");
    // Concurrencia de aplicación = 1; procesa también lotes sintéticos múltiples.
    for (const call of calls) {
      remaining();
      history.push(await executor.execute(call));
    }
  }
  throw new Error("Se agotaron las seis rondas sin respuesta final");
}
consultar_pedido busca el pedido y comprueba la cuenta autenticada. Si el pedido no existe o pertenece a otra cuenta, devuelve no_disponible sin revelar sus datos. Los argumentos solo pueden contener pedido; la identidad de la cuenta la aporta la sesión del servidor. En una aplicación real, sustituye el Map por tu consulta autorizada, no por un identificador de cuenta generado por el modelo.
El registro guarda la promesa antes de esperar al handler. Dos solicitudes concurrentes con el mismo call_id y contenido reutilizan esa promesa; el mismo ID con argumentos distintos detiene el proceso. La comprobación de IDs duplicados dentro de una Response ocurre antes de ejecutar cualquier llamada de ese lote. Son controles de este programa, no una garantía de ejecución única ofrecida por OpenAI.
Conecta el programa con el SDK
Guarda este archivo como ejecutar.mjs junto al anterior. Requiere el paquete openai, una credencial preparada en el servidor y OPENAI_MODEL con un modelo compatible. La guía de clave API y primera llamada resuelve ese requisito si aún no tienes la conexión básica.
El conversor toResponseInputItems y su ruta de importación son los que utiliza la documentación actual de estado de conversación. Fija y comprueba la versión del SDK que uses: el chequeo local mostrado más abajo no carga ese paquete ni demuestra que tu versión exporte el helper.
import OpenAI from "openai";
import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";
import { makeExecutor, migrateOrder } from "./bucle-responses.mjs";

const model = process.env.OPENAI_MODEL;
if (!model) throw new Error("Define OPENAI_MODEL con tu modelo compatible");
const client = new OpenAI({ maxRetries: 0 });
const orders = new Map([
  ["ORD-2084", { cuenta: "cuenta-demo", estado: "preparado", entrega: "2026-10-09" }]
]);
const result = await migrateOrder({
  model,
  question: "¿Cuál es el estado del pedido ORD-2084?",
  executor: makeExecutor("cuenta-demo", orders),
  toInput: toResponseInputItems,
  create: (body, options) => client.responses.create(body, options)
});
console.log(result.text);
Para ejecutarlo en un entorno de pruebas autorizado:
npm install openai
node ejecutar.mjs
Prepara antes OPENAI_API_KEY y OPENAI_MODEL mediante la configuración segura de ese entorno. El ejemplo no imprime secretos y consulta únicamente los datos ficticios del Map. La conexión utiliza los parámetros por defecto del modelo; si tu ruta antigua especificaba un esfuerzo de razonamiento u otros parámetros, configura sus equivalentes admitidos antes de comparar resultados. No des por reproducida esa configuración solo por conservar el nombre del modelo.
En cada petición se reenvían instructions y el historial manual. Al terminar una ronda, el programa convierte toda la salida: conserva el razonamiento y los valores de phase, además de las llamadas. No reconstruye el contexto a partir de output_text. Este último es una comodidad del SDK para agregar texto; no representa el estado completo ni es un campo superior que puedas dar por hecho en cualquier respuesta REST. Aquí el texto final se obtiene de los mensajes terminados y se excluye phase: "commentary".
La aplicación fija seis rondas, ocho llamadas y un plazo de 15 segundos como límites de demostración. No son recomendaciones universales. max_output_tokens limita la salida visible y el razonamiento; max_tool_calls limita las herramientas integradas de OpenAI, no las rondas de tus funciones ni el gasto total. Consulta esos campos en la referencia de creación de Responses.
Comprueba la lógica sin llamar a OpenAI
Guarda este tercer archivo como prueba-local.mjs. Se importa el programa de aplicación, no ejecutar.mjs, y se devuelven Responses inventadas. La prueba verifica que hay una segunda petición, que el resultado conserva el ID y que un duplicado concurrente no vuelve a consultar el Map.
import assert from "node:assert/strict";
import { makeExecutor, migrateOrder } from "./bucle-responses.mjs";

const orders = new Map([
  ["ORD-2084", { cuenta: "demo", estado: "preparado", entrega: "2026-10-09" }]
]);
const call = {
  type: "function_call", id: "fc_demo", call_id: "call_demo",
  name: "consultar_pedido", arguments: '{"pedido":"ORD-2084"}', status: "completed"
};
const executor = makeExecutor("demo", orders);
const replies = [
  { id: "resp_1", status: "completed", output: [call] },
  { id: "resp_2", status: "completed", output: [{
    type: "message", role: "assistant", status: "completed", phase: "final_answer",
    content: [{ type: "output_text", text: "El pedido está preparado." }]
  }] }
];
let requests = 0;
const result = await migrateOrder({
  model: "fixture", executor, question: "Consulta ORD-2084",
  toInput: (items) => structuredClone(items), // doble, no helper del SDK
  create: async (body) => {
    if (requests === 1) {
      assert.equal(body.input.at(-1).call_id, "call_demo");
      assert.equal(JSON.parse(body.input.at(-1).output).estado, "preparado");
    }
    return replies[requests++];
  }
});
assert.equal(result.text, "El pedido está preparado.");
assert.equal(requests, 2);
const concurrent = makeExecutor("demo", orders);
await Promise.all([concurrent.execute(call), concurrent.execute(call)]);
assert.equal(concurrent.trace.length, 1);
const invalid = makeExecutor("demo", orders);
const rejected = await invalid.execute({ ...call, arguments: "null" });
assert.equal(JSON.parse(rejected.output).error, "consulta_rechazada");
assert.equal(invalid.trace[0].executed, false);
console.log("OK: bucle, correlación, deduplicación y rechazo local");node --check bucle-responses.mjs
node prueba-local.mjsLa salida OK acredita esas comprobaciones locales. Al preparar esta guía también se comprobaron, con transporte falso y eventos sintéticos, lotes múltiples, nombres no permitidos, argumentos incorrectos, aislamiento entre cuentas, estados no terminados, rechazos, límites y cierres de streaming. No se inicializó un cliente real ni se realizaron peticiones a OpenAI. Por tanto, esos resultados no acreditan aceptación del SDK, del servidor o del modelo, ni una prueba de producción.
Paralelismo: procesa todas las llamadas o desactívalo
parallel_tool_calls: false permite cero o una llamada por turno; no obliga al modelo a usar una función. tool_choice: "auto" también permite responder sin ella, mientras required exige una o más llamadas. Si necesitas forzar una función concreta, la forma de Responses es tool_choice: { type: "function", name: "consultar_pedido" }. Es comportamiento de selección, no prueba de que el handler haya tenido éxito. Fuente: configuración de function calling.
El bucle procesa todos los Items de función que reciba y ejecuta el lote en serie, aunque el fixture inyecte varias llamadas. Al permitir paralelismo en una integración real, decide aparte cuántas consultas admite tu servicio interno. Dos lecturas independientes pueden ejecutarse a la vez; dos escrituras sobre el mismo pedido quizá deban serializarse. Devuelve un resultado por llamada con su propio call_id y termina el lote antes de solicitar la siguiente Response.
Un nombre no admitido o argumentos inválidos producen un resultado de error; no ejecutan un handler. Un call_id ausente o contradictorio rompe la correlación y detiene el bucle. No fabriques un ID para intentar continuar.
Elige una estrategia de estado
Usa una estrategia coherente en cada flujo. La guía de conversación distingue historial manual, encadenamiento y Conversations:
| Estrategia | Qué envías al continuar | Qué debes conservar o comprobar |
|---|---|---|
| Historial manual, como en el programa | Entrada previa, salida convertida y resultados de funciones | Orden, metadatos relevantes, razonamiento y phase; recuperación en tu aplicación |
previous_response_id | ID anterior y entrada nueva, incluidos los resultados de funciones | Disponibilidad del estado anterior; reenvío de las instrucciones superiores |
| Conversation | ID de la conversación y nueva entrada | Permisos, retención y ciclo de vida; sus entradas y salidas se añaden automáticamente tras completarse |
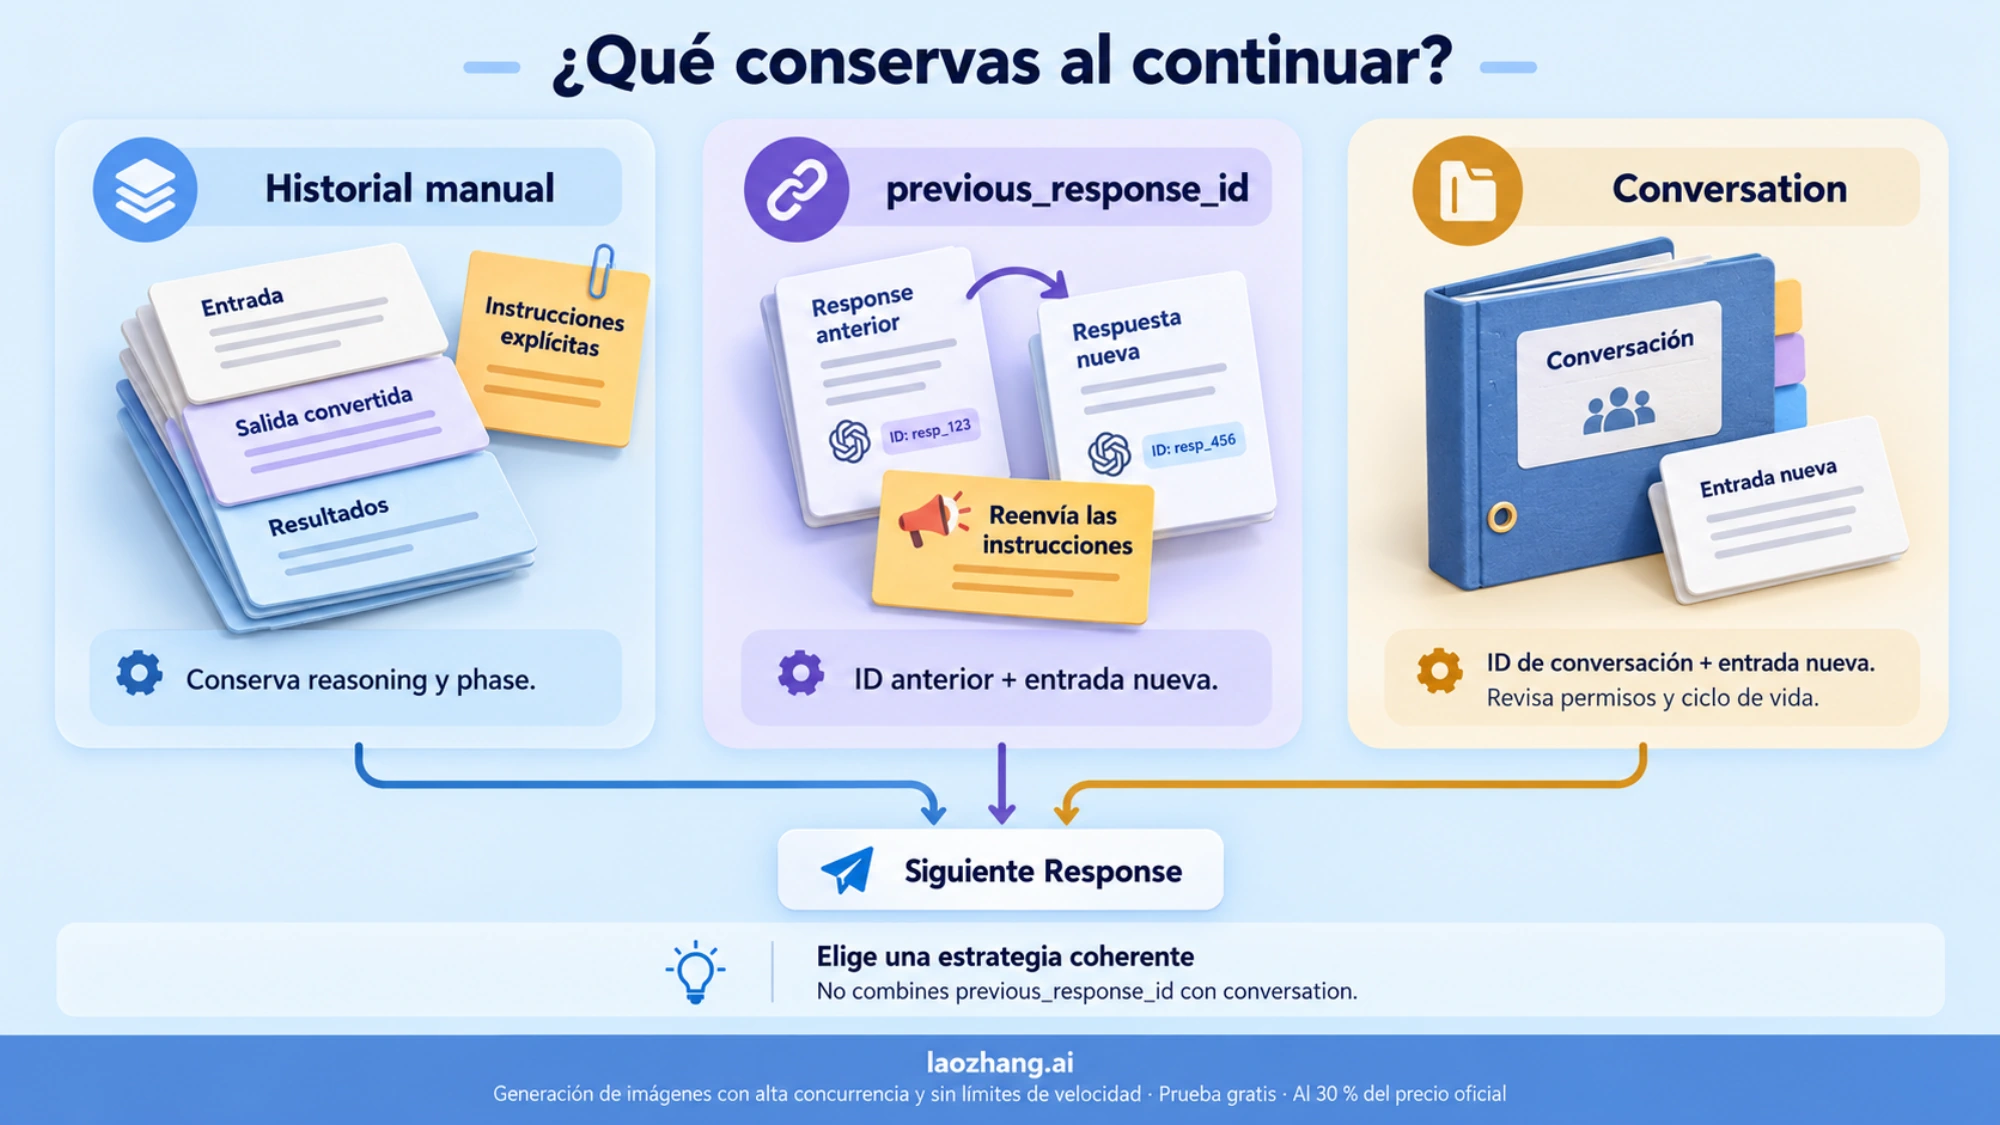
previous_response_id funciona también en HTTP; no requiere por sí mismo WebSocket. No lo combines con conversation en la misma petición ni reenvíes además el historial que ya estás referenciando. Las instrucciones superiores no se heredan de la Response anterior. Las restricciones aparecen en la referencia de la petición.
Enviar menos JSON al encadenar no convierte el contexto en gratuito: los tokens de entrada anteriores de la cadena siguen facturándose como entrada. Con el historial manual, conserva los Items cifrados de razonamiento que devuelva Responses, en vez de intentar convertirlos en texto. La guía actual indica que se devuelven por defecto; include: ["reasoning.encrypted_content"] sigue siendo una opción explícita de la referencia.
store: false desactiva el almacenamiento ordinario de la Response, pero no activa Zero Data Retention ni borra los logs de tu aplicación o de terceros. Las Responses almacenadas tienen por defecto una retención de 30 días, con las condiciones y excepciones del servicio; los Items de Conversation no tienen ese mismo plazo de caducidad. Revisa la política de datos de OpenAI al decidir dónde guardar el estado.
Streaming: sustituye el reducer de eventos
El parser de choices[].delta de Chat no sirve para los eventos tipados de Responses. En particular, response.function_call_arguments.done contiene arguments, item_id, output_index y sequence_number; no trae el call_id que debes devolver. Ese ID se conserva desde el Item de llamada recibido en response.output_item.added y se contrasta con el Item completo de response.output_item.done. Usa los campos del evento de argumentos terminados y del Item terminado.
Este consumidor adopta una política conservadora: acumula los deltas y espera a response.completed antes de entregar la Response al bucle. Así, un Item terminado no desencadena una consulta si después la generación falla o queda incompleta. Guarda el archivo como stream-responses.mjs.
export async function collectResponse(events) {
  const slots = new Map();
  const seen = new Map();
  for await (const event of events) {
    if (Number.isInteger(event.sequence_number)) {
      const encoded = JSON.stringify(event);
      if (seen.has(event.sequence_number)) {
        if (seen.get(event.sequence_number) !== encoded) {
          throw new Error("Secuencia repetida con otro evento");
        }
        continue;
      }
      seen.set(event.sequence_number, encoded);
    }
    if (event.type === "response.output_item.added" &&
        event.item.type === "function_call") {
      if (slots.has(event.output_index)) throw new Error("Índice reutilizado");
      slots.set(event.output_index, {
        item: event.item, buffer: event.item.arguments ?? "", argsDone: false
      });
    } else if (event.type === "response.function_call_arguments.delta" ||
               event.type === "response.function_call_arguments.done") {
      const slot = slots.get(event.output_index);
      if (!slot || slot.item.id !== event.item_id) throw new Error("Item no registrado");
      if (event.type.endsWith(".delta")) {
        if (slot.argsDone || typeof event.delta !== "string") {
          throw new Error("Delta fuera de orden");
        }
        slot.buffer += event.delta;
      } else {
        if (slot.buffer !== event.arguments) throw new Error("Argumentos distintos");
        JSON.parse(event.arguments);
        slot.argsDone = true;
      }
    } else if (event.type === "response.output_item.done" &&
               event.item.type === "function_call") {
      const slot = slots.get(event.output_index);
      if (!slot || !slot.argsDone || slot.item.id !== event.item.id ||
          slot.item.call_id !== event.item.call_id ||
          slot.item.name !== event.item.name || slot.buffer !== event.item.arguments) {
        throw new Error("La llamada final no coincide con sus eventos");
      }
      slot.finished = event.item;
    } else if (event.type === "response.completed") {
      const response = event.response;
      if (response.status !== "completed" || !Array.isArray(response.output)) {
        throw new Error("Finalización incoherente");
      }
      for (const [index, slot] of slots) {
        const item = response.output[index];
        if (!slot.finished || !item || item.type !== "function_call" ||
            item.id !== slot.finished.id || item.call_id !== slot.finished.call_id ||
            item.name !== slot.finished.name || item.arguments !== slot.buffer) {
          throw new Error("La Response final no contiene la llamada terminada");
        }
      }
      for (const [index, item] of response.output.entries()) {
        if (item.type === "function_call" && !slots.get(index)?.finished) {
          throw new Error("Llamada sin cierre de eventos");
        }
      }
      return response;
    } else if (["error", "response.failed", "response.incomplete"].includes(event.type)) {
      throw new Error(`Stream interrumpido: ${event.type}`);
    }
  }
  throw new Error("Fin del transporte sin response.completed");
}
Para conectar esa variante, añade import { collectResponse } from "./stream-responses.mjs" a ejecutar.mjs y sustituye únicamente su función create por:
create: async (body, options) => {
  const events = await client.responses.create({ ...body, stream: true }, options);
  return collectResponse(events);
}
El reducer no ejecuta funciones. Devuelve la Response completa y el programa principal aplica después las mismas reglas de validación, autorización y resultado. Los deltas de texto pueden mostrarse como contenido provisional en una interfaz, pero no acreditan la finalización de la consulta.
Si llega response.failed, response.incomplete, un evento de error o un fin de transporte sin response.completed, el consumidor falla. Una cancelación o error de lectura del iterable también se propaga. Los eventos oficiales de streaming distinguen esos estados; un EOF del transporte no equivale a una generación completada. En las pruebas sintéticas se comprobó, entre otros casos, que el .done de argumentos carece de call_id, que un ID ajeno se rechaza y que repetir exactamente un evento no duplica su delta.
Idempotencia y recuperación después de un timeout
El Map del programa evita duplicados de protocolo dentro de ese ejecutor. No es un registro duradero ni evita una mutación duplicada después de reiniciar el proceso. Además, dos call_id diferentes pueden pedir la misma operación de negocio. El identificador del protocolo tampoco concede permisos sobre una cuenta.
Para una lectura, registra el resultado y decide si repetir la consulta es admisible. Para un reembolso, un correo o un cambio de pedido, utiliza una clave de operación duradera que identifique la intención autorizada, por ejemplo pedido, acción y solicitud de negocio. Guarda de forma atómica la reserva y el resultado confirmado, o utiliza las garantías de idempotencia del sistema que ejecuta el efecto. Es una decisión de ingeniería de tu aplicación, no un campo que Responses resuelva por ti.
| Punto de interrupción | Qué sabes | Cómo recuperar |
|---|---|---|
| Antes de ejecutar una función | No se ha confirmado un efecto | Conserva la llamada, verifica argumentos y permisos y decide si continuar |
| Tras enviar una escritura, antes de recibir respuesta | El efecto puede haberse producido | Consulta el registro o el sistema destino; no repitas la escritura a ciegas |
| Efecto confirmado, antes de devolver el resultado al modelo | Hay un resultado de negocio conocido | Recupera ese resultado y devuélvelo con el call_id de la llamada correspondiente |
| Resultado devuelto, pero falta el texto final | La función puede estar terminada aunque el flujo no lo esté | Continúa desde un estado recuperable sin volver a ejecutar el efecto confirmado |
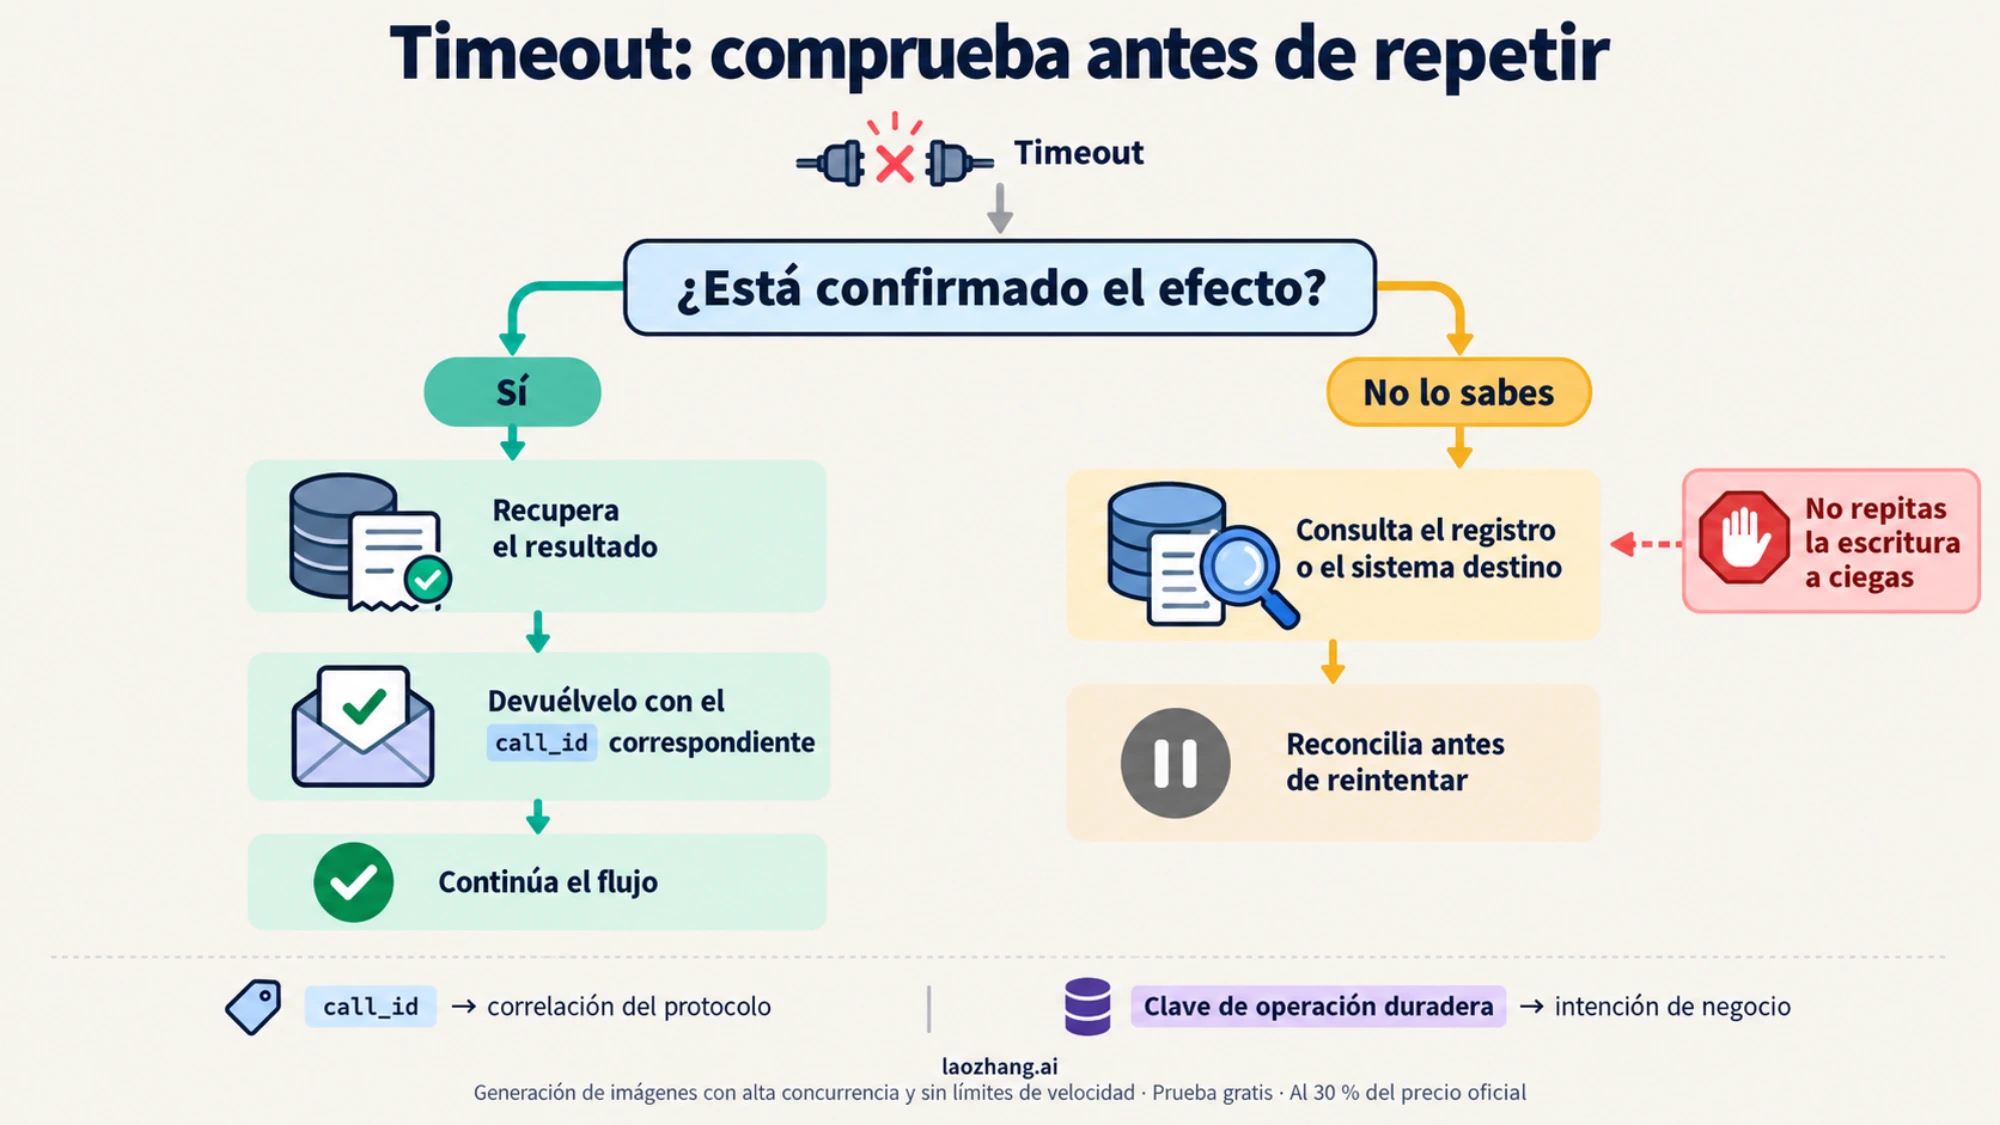
Separa el retry de la petición al modelo del retry de una operación de negocio. El adaptador desactiva los reintentos automáticos del SDK para que la decisión sea explícita; comprueba esa configuración en la versión que hayas fijado. El bucle no implementa por sí solo recuperación duradera y tampoco convierte un timeout de un servicio externo en una garantía de cancelación.
Fallos observables y corrección
| Síntoma | Qué comprobar primero | Acción |
|---|---|---|
| Se rechaza el esquema | Envoltorio function, required y objetos anidados | Aplana la definición y elige strict deliberadamente |
| La función se ejecutó, pero no hay respuesta final | Petición posterior y resultado añadido a input | Continúa con los resultados; no vuelvas a ejecutar por faltar prosa |
| La API no encuentra la llamada del resultado | call_id original frente a item.id y al resultado enviado | Conserva la correlación exacta |
| Falta una función de un lote | Todo response.output, no solo el primer Item | Procesa cada llamada contemplada y conserva cada ID |
| Se pierde la política o el contexto | Estrategia elegida, instrucciones, reasoning y phase | Recupera el historial relevante y reenvía instrucciones |
| El stream acaba, pero el flujo no | Evento terminal, estado y argumentos finalizados | Trata EOF, error o incompleto como fallo; no ejecutes JSON parcial |
| Se repite un efecto después de un timeout | Registro de operación de negocio y estado en el destino | Reconcilia primero y reutiliza el resultado confirmado |
No interpretes una Response failed, incomplete, cancelled, queued o in_progress como la salida completa de este bucle síncrono. Los rechazos, la falta de texto final y los tipos no implementados también deben tener una salida propia. Si una variante necesita herramientas asíncronas, namespaces u otras modalidades, extiende el programa con sus reglas concretas; no la envíes automáticamente al dispatcher de este ejemplo.
Checklist de aceptación en staging
La prueba local permite encontrar fallos de lógica antes de usar el servicio. Después, con permisos y datos de prueba, verifica el recorrido real desde la petición hasta el resultado que recibe el usuario:
- Chat y Responses reciben la misma entrada normalizada, instrucciones, datos seguros y configuración compatible del modelo.
- Se observa la ejecución del handler autorizado y su resultado, además de los IDs del modelo.
- JSON inválido, nombres ajenos, argumentos extra y pedidos de otra cuenta no revelan datos ni ejecutan acciones no permitidas.
- Cada llamada aceptada recibe su resultado con el
call_idoriginal; un lote no pierde ninguna. - El historial conserva los Items necesarios, funciona en un segundo turno y se recupera según la estrategia elegida.
- El consumidor de streaming soporta corte de JSON, errores, cancelación y EOF sin liberar llamadas parciales.
- Se distingue resultado confirmado, resultado desconocido y rechazo; reiniciar el proceso no duplica una escritura confirmada.
- La respuesta final existe y comunica el resultado real de la función, sin convertir el mensaje del modelo en prueba del efecto.
- Los logs conservan IDs, versión del esquema, duración y clase de resultado, sin guardar credenciales o payloads sensibles innecesarios.
- La ruta de vuelta está validada con modelo, endpoint, configuración, estado y resultados de negocio compatibles.
Usa un cambio de configuración reversible para ampliar tráfico de forma gradual. Volver a Chat con un modelo que solo admite funciones en Responses no es una recuperación válida. Al cambiar de ruta, conserva también los resultados de operaciones ya confirmadas: un flag no deshace ni deduplica efectos externos.
Preguntas frecuentes
¿Puedo seguir usando Chat Completions?
Sí, OpenAI lo sigue admitiendo. Comprueba además el modelo: algunos admiten Chat para texto y requieren Responses para herramientas. La guía de migración y la compatibilidad actual por modelo son las referencias para esa decisión.
¿Por qué una función ejecutada no produce automáticamente una respuesta final?
Porque la función la ejecuta tu aplicación. Debes devolver su resultado como function_call_output y solicitar otra Response; esta puede responder o pedir más funciones. Detenerte después del handler deja el bucle incompleto. Fuente: flujo de function calling.
¿Desactivar el paralelismo evita reembolsos duplicados?
No. parallel_tool_calls: false limita la selección a cero o una llamada por turno. Un retry, un reinicio o dos llamadas distintas aún pueden repetir la misma intención. Las escrituras requieren idempotencia y recuperación en tu aplicación; el call_id sirve para correlacionar el resultado del protocolo. Fuente para el límite de paralelismo.
¿Hace falta Structured Outputs para migrar este bucle?
No para obtener una respuesta final de texto. Function calling resuelve el acceso a tus funciones; text.format controla la forma de una salida final estructurada. Si tu interfaz necesita un objeto con esquema después de consultar datos, pueden combinarse. La comparación entre Structured Outputs y function calling explica cuándo conviene hacerlo.
¿Sirve el mismo programa para Azure o una pasarela compatible?
La lógica de tu aplicación puede reutilizarse, pero debes comprobar la integración concreta. La guía española de Microsoft utiliza rutas y nombres de despliegue propios de Azure. La autenticación, la retención, los IDs de estado y los eventos pueden variar en otro proveedor. Una petición HTTP aceptada no demuestra que soporte todo el bucle.
Empieza por la prueba local del pedido ficticio. Después compara las trazas de las dos rutas en staging y exige una consulta autorizada, un resultado correlacionado y una respuesta final equivalente antes de mover tráfico.
Fuentes9
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 8 oct 2026.
Fuentes9
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 8 oct 2026.
- 1.sigue admitido por OpenAI, que recomienda Responses para proyectos nuevosdevelopers.openai.com/api/docs/guides/migrate-to-responses
- 2.OpenAI describe ese intercambio en la guía de function callingdevelopers.openai.com/api/docs/guides/function-calling
- 3.compatibilidad oficial por modelodevelopers.openai.com/api/docs/guides/latest-model
- 4.documentación actual de estado de conversacióndevelopers.openai.com/api/docs/guides/conversation-state
- 5.referencia de creación de Responsesdevelopers.openai.com/api/reference/resources/responses/methods/create
- 6.política de datos de OpenAIdevelopers.openai.com/api/docs/guides/your-data
- 7.campos del evento de argumentos terminadosdevelopers.openai.com/api/reference/resources/responses/streaming-events
- 8.eventos oficiales de streamingdevelopers.openai.com/api/docs/guides/streaming-responses
- 9.guía española de Microsoftlearn.microsoft.com/es-es/azure/developer/ai/how-to/azure-openai-to-responses