Nano Banana Pro 安全过滤器:能调的默认已关,被拦截怎么查
Nano Banana Pro 可调的四类安全过滤默认已关,设 BLOCK_NONE 解不开 IMAGE_SAFETY 等拦截;先看返回原因,再决定改写、换素材还是放弃。
文章目录
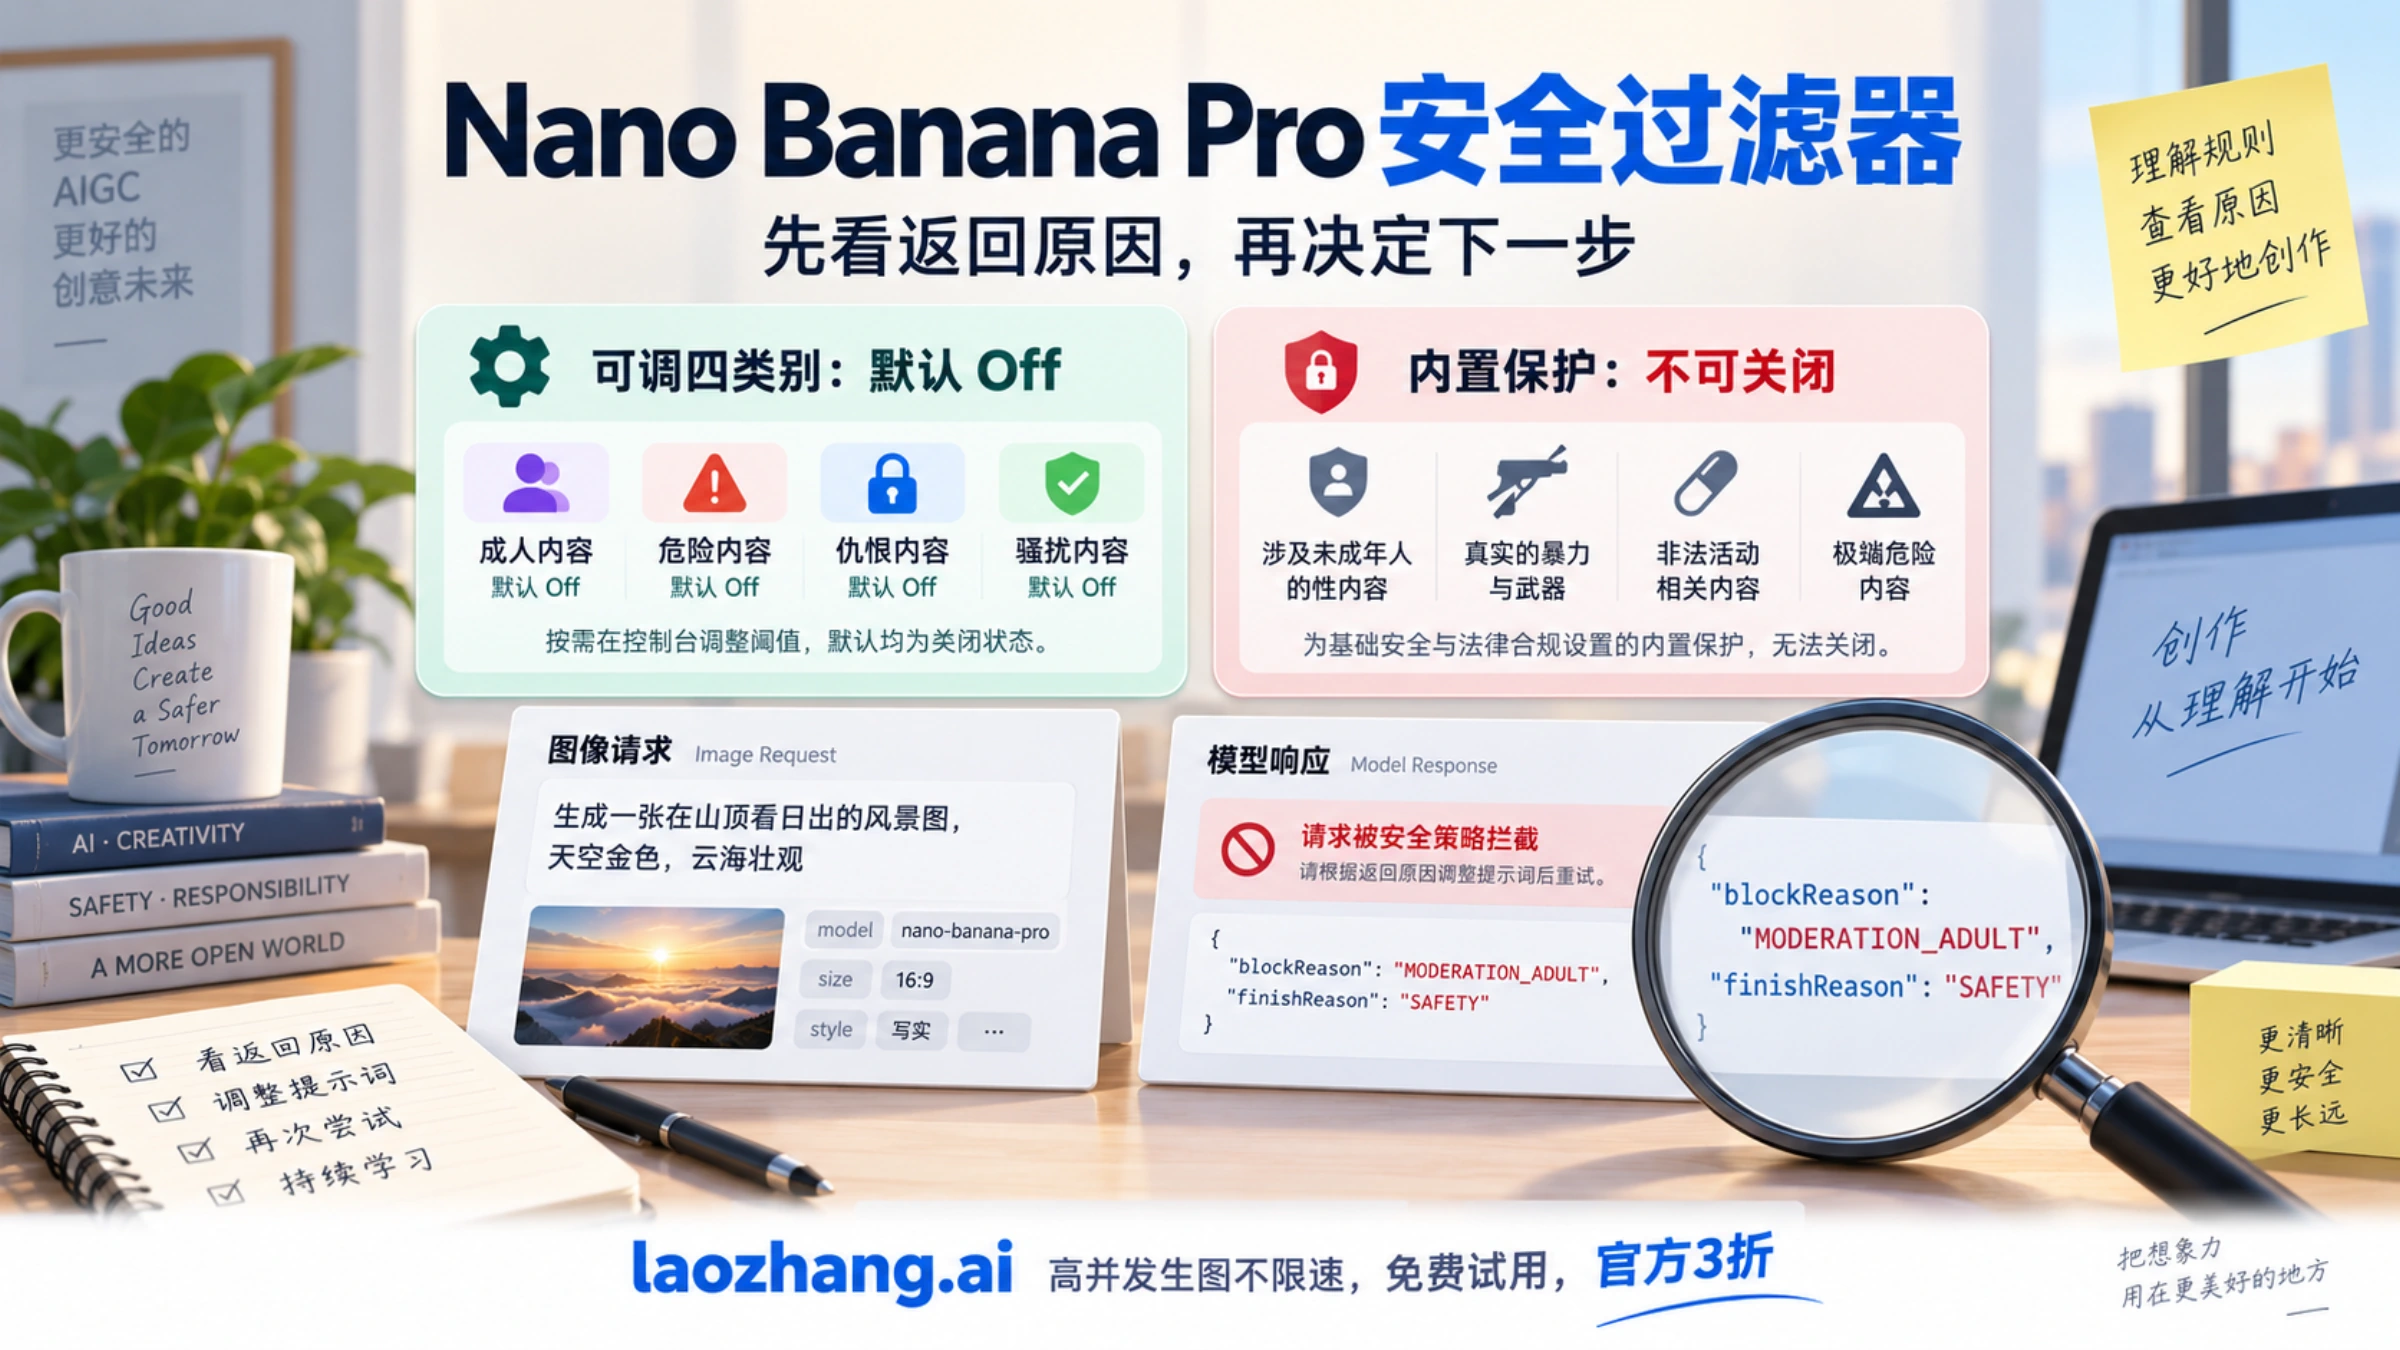
截至 2026 年 10 月 5 日,Nano Banana Pro(API 模型 ID gemini-3-pro-image)的安全过滤要分成两部分看。能调的是四个类别:骚扰、仇恨言论、露骨色情、危险内容,在 generateContent 请求的 safetySettings 里设阈值;Google 的「安全设置」文档写明,Gemini 2.5 和 3 系列模型不设阈值时,这几项默认就是 Off。调不了的是另一部分:儿童安全这类核心危害的内置保护始终拦截,返回 IMAGE_SAFETY、PROHIBITED_CONTENT、OTHER 的结果也没有对应的开关。
所以图片被拦时,先别急着把阈值改成 BLOCK_NONE。没设过阈值的请求,可调过滤本来就是关着的。该做的是读响应里的 promptFeedback.blockReason 和 candidates[].finishReason,按原因决定改写、换素材、重试一次还是放弃。正常请求被误拦确实有开发者报告过,这时把用途和画面写清楚、拿掉没有权利使用的真人和品牌,是合规范围内能做的事。想办法骗过过滤器则是另一回事:Google 的《生成式 AI 使用限制政策》(Generative AI Prohibited Use Policy)明文禁止规避安全过滤器,可能招来限流甚至停用访问权限。
Nano Banana Pro 能调的安全设置:四个类别,默认 Off
Google「安全设置」文档(页面更新于 2026 年 9 月 17 日)列出的可调类别只有四个:
| 类别 | API 常量 | Google 的说明 |
|---|---|---|
| 骚扰 | HARM_CATEGORY_HARASSMENT | 针对身份或受保护属性的负面、有害评论 |
| 仇恨言论 | HARM_CATEGORY_HATE_SPEECH | 粗鲁、不尊重或亵渎的内容 |
| 露骨色情 | HARM_CATEGORY_SEXUALLY_EXPLICIT | 涉及性行为或其他淫秽内容 |
| 危险内容 | HARM_CATEGORY_DANGEROUS_CONTENT | 宣扬、协助或鼓励有害行为 |
每个类别可以单独设阈值。Google AI Studio 界面和 API 用的名字不同:
| AI Studio 里的选项 | API 阈值 | 效果 |
|---|---|---|
| Off | OFF | 关闭这个类别的安全过滤 |
| Block none | BLOCK_NONE | 不论不安全的概率多高都照常返回 |
| Block few | BLOCK_ONLY_HIGH | 不安全概率为高时拦截 |
| Block some | BLOCK_MEDIUM_AND_ABOVE | 概率为中或高时拦截 |
| Block most | BLOCK_LOW_AND_ABOVE | 概率为低、中、高时都拦截 |
这两张表背后有几条容易被忽略的规定:
- 判断依据是概率,不是严重程度。 Google 举的例子是,「机器人打了我一拳」被判为不安全的概率可能高于「机器人把我砍伤了」,尽管后者更暴力。
- 不设阈值时默认是 Off。 文档原话是 Gemini 2.5 和 3 模型的默认阈值为 Off。对 Nano Banana Pro 来说,
safetySettings的实际用途更多是加严:比如你做的是面向公众的出图应用,想在 Google 自带的保护之外再多拦一些。 - 放宽设置可能招来复查。 文档提醒,使用较宽松安全设置的应用可能会被复查,是否符合服务条款由你负责。
- API 参考里还有两个类别。
safetySettings支持的类别列表多出HARM_CATEGORY_CIVIC_INTEGRITY(已标记弃用)和HARM_CATEGORY_JAILBREAK,后者对应「试图绕过或颠覆模型安全准则的提示」。
能在哪里改,取决于你从哪个入口出图:
- Gemini API 的
generateContent:每次请求单独传safetySettings(Python SDK 里是safety_settings)。 - Google AI Studio:Run settings 面板的 Advanced settings 里点 Safety settings,用滑块按类别调。
- Gemini API 的 Interactions API:不支持自定义安全设置。
- Gemini 应用:没有安全设置可调。
改不了的部分:核心危害保护和政策禁止的内容
Google 在同一份文档里写明,除了四个可调类别,Gemini API 还有针对核心危害的内置保护,例如危及儿童安全的内容,这类内容始终拦截,不能调整。
更大的一块边界来自《生成式 AI 使用限制政策》(最后修改于 2024 年 12 月 17 日)。和出图直接相关的禁止项包括:
- 涉及儿童性虐待或剥削的内容;
- 助长暴力极端主义、未经同意的私密图像、自残或违法活动的内容;
- 侵犯他人权利的内容,包括隐私和知识产权,例如未经法定同意使用个人数据或生物特征;
- 以色情或性满足为目的的露骨内容;
- 为了欺骗而冒充在世或已故的人,或者为了欺骗谎称生成内容完全出自人手。
政策也写了例外:Google 可能基于教育、纪实、科学或艺术方面的考虑破例。这是 Google 一方的判断,不是你能在请求里打开的开关。
PROHIBITED_CONTENT、IMAGE_SAFETY、IMAGE_PROHIBITED_CONTENT、SPII 这些返回原因都不属于四个可调类别,API 里没有任何参数能关掉它们。Google 也没有公开过滤系统的内部结构,比如分几道检查、按什么顺序运行;你能看到的只有响应里的原因字段。
被拦截后看哪个字段:blockReason 与 finishReason 对照表
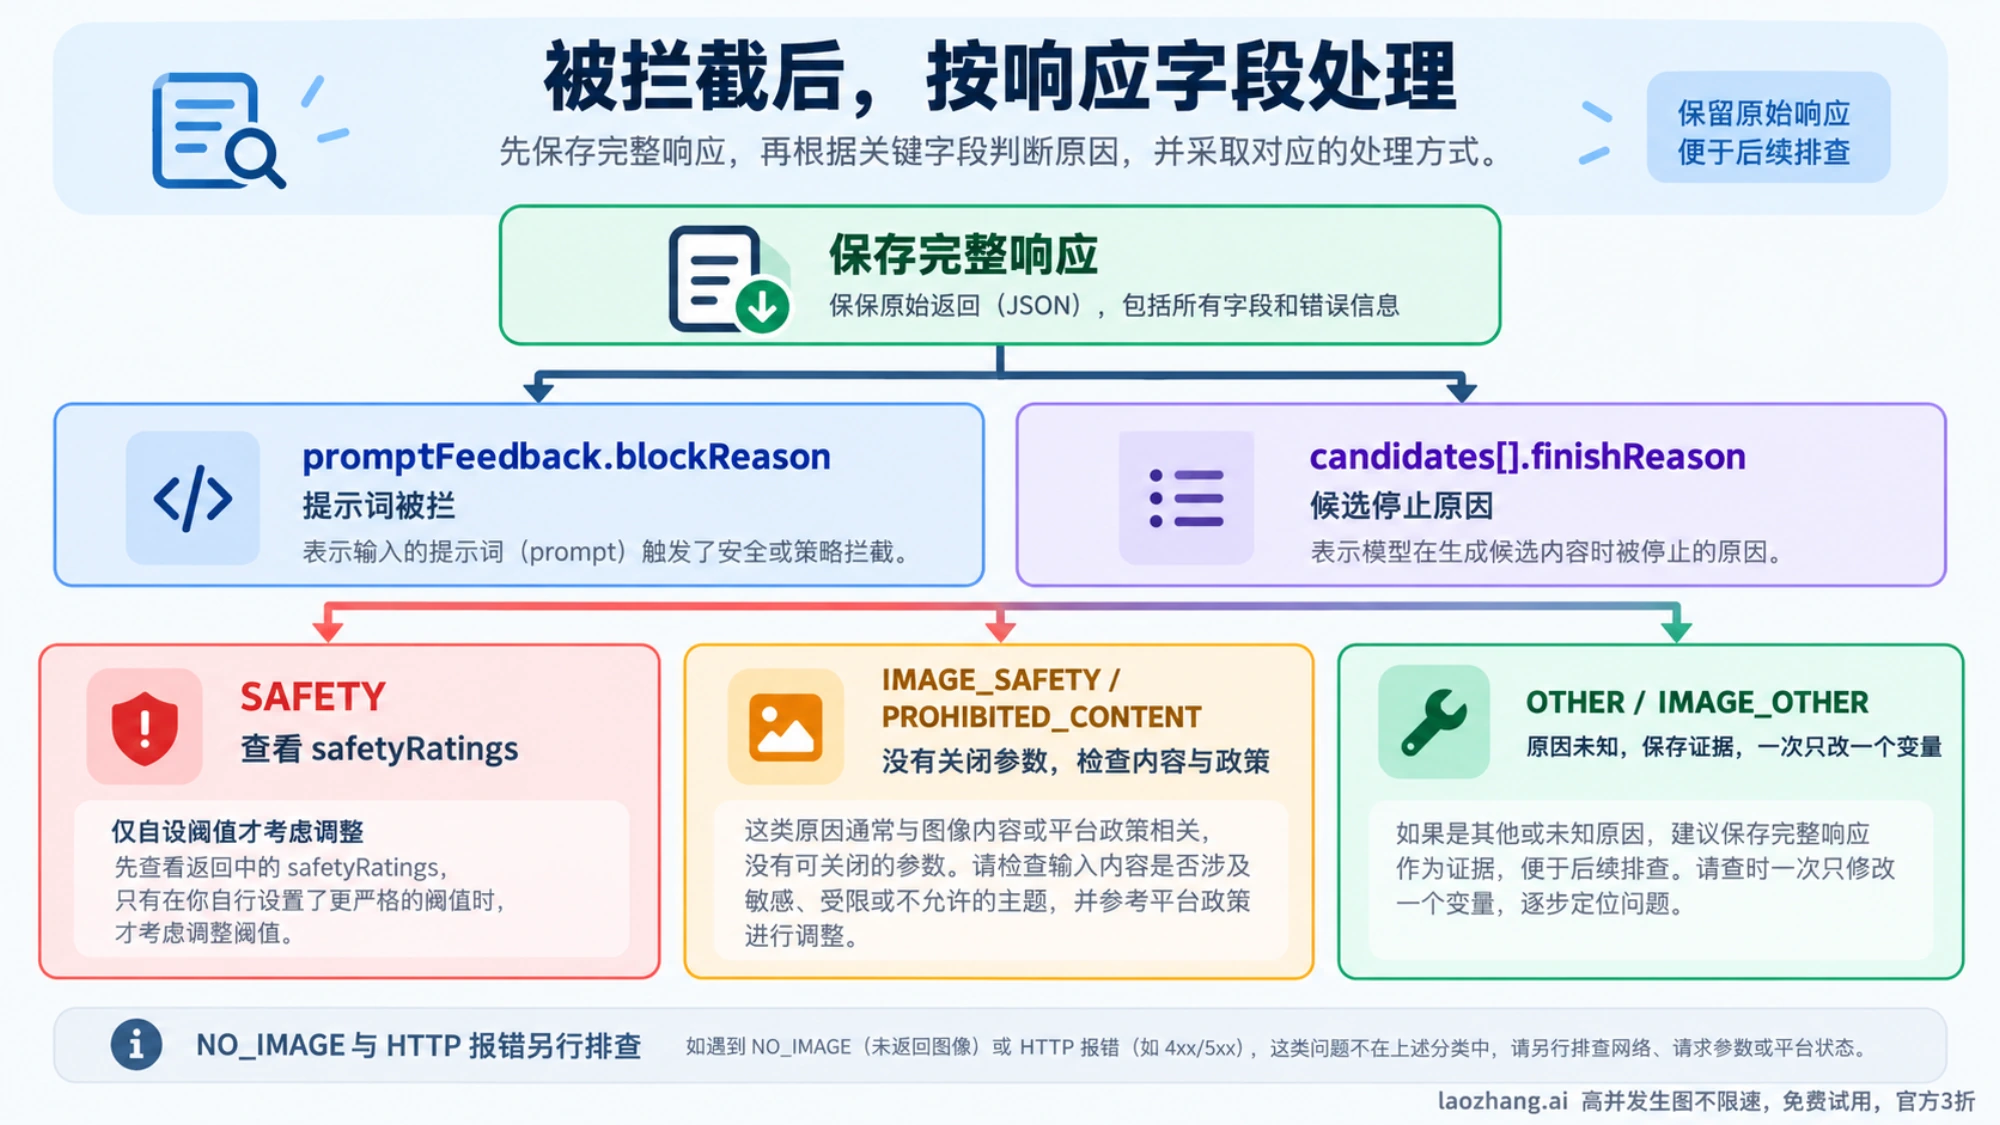
安全拦截不是 400 或 500 报错,而是正常响应里的两个字段:
promptFeedback.blockReason有值:提示词在生成前就被拦了,响应里没有候选结果。candidates[].finishReason不是STOP:生成过程中或生成后被拦。同一候选里的finishMessage有时会补一句说明,safetyRatings列出各类别的概率,以及是否因此被拦(blocked)。
下表的「Google 的定义」取自 API 参考(截至 2026 年 10 月 5 日),「能做什么」是据此给出的处理建议:
| 返回位置与值 | Google 的定义 | 能做什么 |
|---|---|---|
blockReason: SAFETY | 提示词因安全原因被拦,需查看 safetyRatings | 看是哪个类别;如果阈值是你自己设的,按用途决定是否放宽,否则改写内容 |
blockReason: BLOCKLIST | 提示词含术语屏蔽列表里的词 | 去掉相关词语后再发 |
blockReason: PROHIBITED_CONTENT | 提示词含禁止内容 | 不可调;对照使用限制政策,换题材,不要反复改写同一请求 |
blockReason: IMAGE_SAFETY | 因生成的图片内容不安全,候选被拦 | 同下方 IMAGE_SAFETY |
blockReason: OTHER | 提示词因未知原因被拦 | 保存响应,改一个变量再测;仍被拦就上报 |
finishReason: SAFETY | 候选内容因安全原因被标记 | 看 safetyRatings 里 blocked 为 true 的类别 |
finishReason: IMAGE_SAFETY | 生成的图片违反安全规定 | 不可调;检查是否涉及真人、未成年人、暴露、暴力,写清用途和画面 |
finishReason: PROHIBITED_CONTENT 或 IMAGE_PROHIBITED_CONTENT | 可能含禁止内容;生成的图片含其他禁止内容 | 不可调;换题材 |
finishReason: SPII | 可能含敏感个人身份信息 | 去掉证件号、住址等个人信息 |
finishReason: IMAGE_RECITATION | 生成内容与已有素材过于相似而停止 | 不要要求复刻具体作品或角色,改成原创描述 |
finishReason: IMAGE_OTHER 或 OTHER | 其他杂项问题;原因未知 | 开发者报告过的误拦多是这两个值;重试一次,再逐项排除参考图、人物、措辞 |
finishReason: NO_IMAGE | 应该出图但没有生成 | 不是安全拦截;明确要求生成图片并检查输出模态 |
finishReason: PUP_LIMITED_DISABLED | 账号因违反使用限制政策被限制或停用 | 已是账号层面的问题,见后文「Google 使用限制政策的执法」一节 |
OTHER 是最让人头疼的一类,Google 的定义只有「原因未知」,排查顺序单独整理在 Nano Banana 2 blockReason OTHER:官方只写「原因未知」,该查什么,同样适用于 Pro。响应正常结束却没有图片、只有文字,属于另一类问题,按 Nano Banana API 不出图:按返回字段逐项排查 处理。返回 429、503 这类 HTTP 错误则与内容无关,见 Nano Banana API 报错:先分清 429、503、无图像和请求被拒。
设成 BLOCK_NONE 还被拦:原因不在四个可调类别里
BLOCK_NONE 和 OFF 只作用于四个可调类别。根据上面两条官方规定可以推出:没设过阈值时这些类别本来就是 Off,再显式写一遍 BLOCK_NONE 不会带来变化;IMAGE_SAFETY、PROHIBITED_CONTENT、OTHER 不属于可调类别,也不会因此消失。
开发者的报告与这个推断一致。Stack Overflow 上 2026 年 2 月 6 日的一个问题里,一个团队用 Nano Banana Pro 的预览版模型生成涉及知名公众人物的图片,响应返回 blockReason: OTHER;他们把所有类别都设成 BLOCK_NONE,结果不变。
BLOCK_NONE 真正起作用的情形只有一种:返回的是 SAFETY,而且 safetyRatings 里被拦的类别正是你自己(或你用的框架、封装库)设过的较严阈值。这时把阈值调回默认,前提是你的用途确实需要、并且符合服务条款。
用 Python 设置 safetySettings 并读出拦截原因
下面的代码按 Google API 参考的字段和 google-genai SDK 的写法整理,没有实际运行过。它示范两件事:safety_settings 放在哪,以及被拦后从哪些字段读原因。示例里的阈值是加严用的,适合面向公众的应用。模型 ID 用正式版 gemini-3-pro-image;gemini-3-pro-image-preview 已于 2026 年 6 月 25 日下线。
from google import genai
from google.genai import types

client = genai.Client()  # 从环境变量 GEMINI_API_KEY 读取 key

config = types.GenerateContentConfig(
    response_modalities=["TEXT", "IMAGE"],
    image_config=types.ImageConfig(aspect_ratio="1:1", image_size="2K"),
    safety_settings=[
        # 不设时这些类别默认是 OFF;这里为面向公众的应用加严两项
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_SEXUALLY_EXPLICIT,
            threshold=types.HarmBlockThreshold.BLOCK_MEDIUM_AND_ABOVE,
        ),
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HARASSMENT,
            threshold=types.HarmBlockThreshold.BLOCK_ONLY_HIGH,
        ),
    ],
)

response = client.models.generate_content(
    model="gemini-3-pro-image",
    contents="电商详情页主图:纯白背景上的一双灰色跑鞋,柔和的棚拍光,45 度俯拍",
    config=config,
)

feedback = response.prompt_feedback
if feedback and feedback.block_reason:
    print("提示词被拦:", feedback.block_reason)

for candidate in response.candidates or []:
    print("finishReason:", candidate.finish_reason, candidate.finish_message)
    for rating in candidate.safety_ratings or []:
        print("  ", rating.category, rating.probability, "blocked =", rating.blocked)
    parts = candidate.content.parts if candidate.content else []
    for i, part in enumerate(parts or []):
        if part.inline_data and not part.thought:
            with open(f"output_{i}.png", "wb") as f:
                f.write(part.inline_data.data)

print("responseId:", response.response_id, "modelVersion:", response.model_version)
print("usage:", response.usage_metadata)
几处说明:
safety_settings里没写的类别按默认处理,也就是 Off。每个类别只能出现一次。- 被拦时把
responseId、modelVersion、完整提示词、是否带参考图一起存下来,后面重试对比和上报都要用。 - Nano Banana Pro 默认开启思考,思考过程里可能出现中间图片,带
thought标记的部分不是最终结果,所以示例跳过了它们。 - 返回的图片格式以
inline_data.mime_type为准,示例统一存成.png只是为了简短。
正常提示词也被拦:开发者报告过的误拦
误拦确实存在,但 Google 没有公布误拦率,下面这些只是个别开发者的报告,不代表普遍比例:
- 2025 年 12 月 29 日,Google AI Developers Forum 的「blockReason OTHER」帖子里,有开发者说,他接入 Nano Banana Pro 的网站每发 5 次请求就会遇到一次没有结果返回、日志显示 OTHER。Google 员工 Logan Kilpatrick 回复说,现在的「Other」错误「这样设置没什么帮助」,团队打算重构,希望在 1 月上半月上线。帖子里之后没有更新,截至 2026 年 10 月 5 日 API 参考对
OTHER的定义仍是「原因未知」。 - 2026 年 3 月 14 日,同一论坛上标题为「Nano Banana is unusable because of the new safety filters」的帖子报告,一个明显无害的提示词在 AI Studio 里失败,API 返回
finishReason: IMAGE_OTHER。 - 2026 年 5 月 7 日,有开发者报告在 AI Studio 里用 Nano Banana Pro 预览版,只要附上参考图就被以 Other 原因拦截;Google 员工私信索要细节,没有公开结论。
这些报告说明两件事:一是 OTHER、IMAGE_OTHER 不告诉你具体原因,只能靠控制变量去找;二是参考图和真人都在这些报告里出现过。原样连续重发不会让结果更好,先保存证据,一次只改一个条件。
正当请求怎样写清楚:用途、具体画面、权利和对照测试
下面这些做法的目标,是让模型准确理解一个本来就合规的请求,而不是让违规请求蒙混过关:
- 写明用途和场景。 「电商详情页主图」「医学教材里的解剖示意图」「服装设计参考稿」这类说明,让请求的上下文一目了然。政策允许基于教育、纪实、科学或艺术考虑的例外,但写了用途不等于保证通过。
- 用具体的视觉描述代替含糊词。 「性感」「血腥」「惊悚」这类形容词说不清画面具体是什么样,改写成光线、构图、服装款式、镜头距离等具体元素。Google 的图片生成指南也建议正面描述想要的画面,比如用「空无一人的街道」代替「不要车」,并用广角、微距、低机位这类摄影术语控制构图。
- 不用没有权利的真人、品牌和作品。 政策禁止侵犯隐私和知识产权,Google 在图片编辑说明里也提醒上传的图片要有相应权利。真实人物换成虚构模特,品牌商品换成你自己的产品或无标识的通用款。
- 用中性对照提示定位触发点。 其他条件不变,每次只去掉一个元素重发:参考图、人物、某个词、某种风格。中性版本能出图、加回某个元素就被拦,问题就出在这个元素上。
如果定位出来的元素本身就是政策禁止的内容,正确的结论是放弃它。换说法、拆成几步、套上虚构情节去让它通过,正是政策里写的「规避安全过滤器」。
Google 使用限制政策的执法:从限流、暂停到关闭访问
《生成式 AI 使用限制政策》把「规避滥用防护或安全过滤器,例如操纵模型违反我们的政策」列为禁止行为,与生成禁止内容本身并列。API 参考里还专门列有 HARM_CATEGORY_JAILBREAK 类别,对应试图绕过或颠覆模型安全准则的提示。
Gemini API 和 AI Studio 的使用政策(页面更新于 2026 年 6 月 9 日)写明了执法方式:
- 检测:自动系统扫描 API 使用中违反使用限制政策的内容;某个项目持续出现可疑活动时,可能交给授权员工人工复查。
- 数据保留:提示词、附带的上下文和输出保留 55 天,用于发现和防止违规。
- 处理措施:可能先发邮件了解情况;可能临时限制使用,例如调整速率限制或改由其他模型响应;可能暂停访问;严重违规时作为最后手段,永久关闭 Gemini API 及其他 Google 服务的访问权限。暂停或关闭的通知里会附申诉链接。
如果响应里出现 PUP_LIMITED_DISABLED,或者收到 Google 的邮件,问题已经从单次请求变成账号层面。限流、停用和申诉怎么处理,见 Nano Banana Pro 风控:拦截、限流、封号各由什么触发,怎么处理。
Gemini 应用、AI Studio、API 和第三方网关:哪里能调安全设置
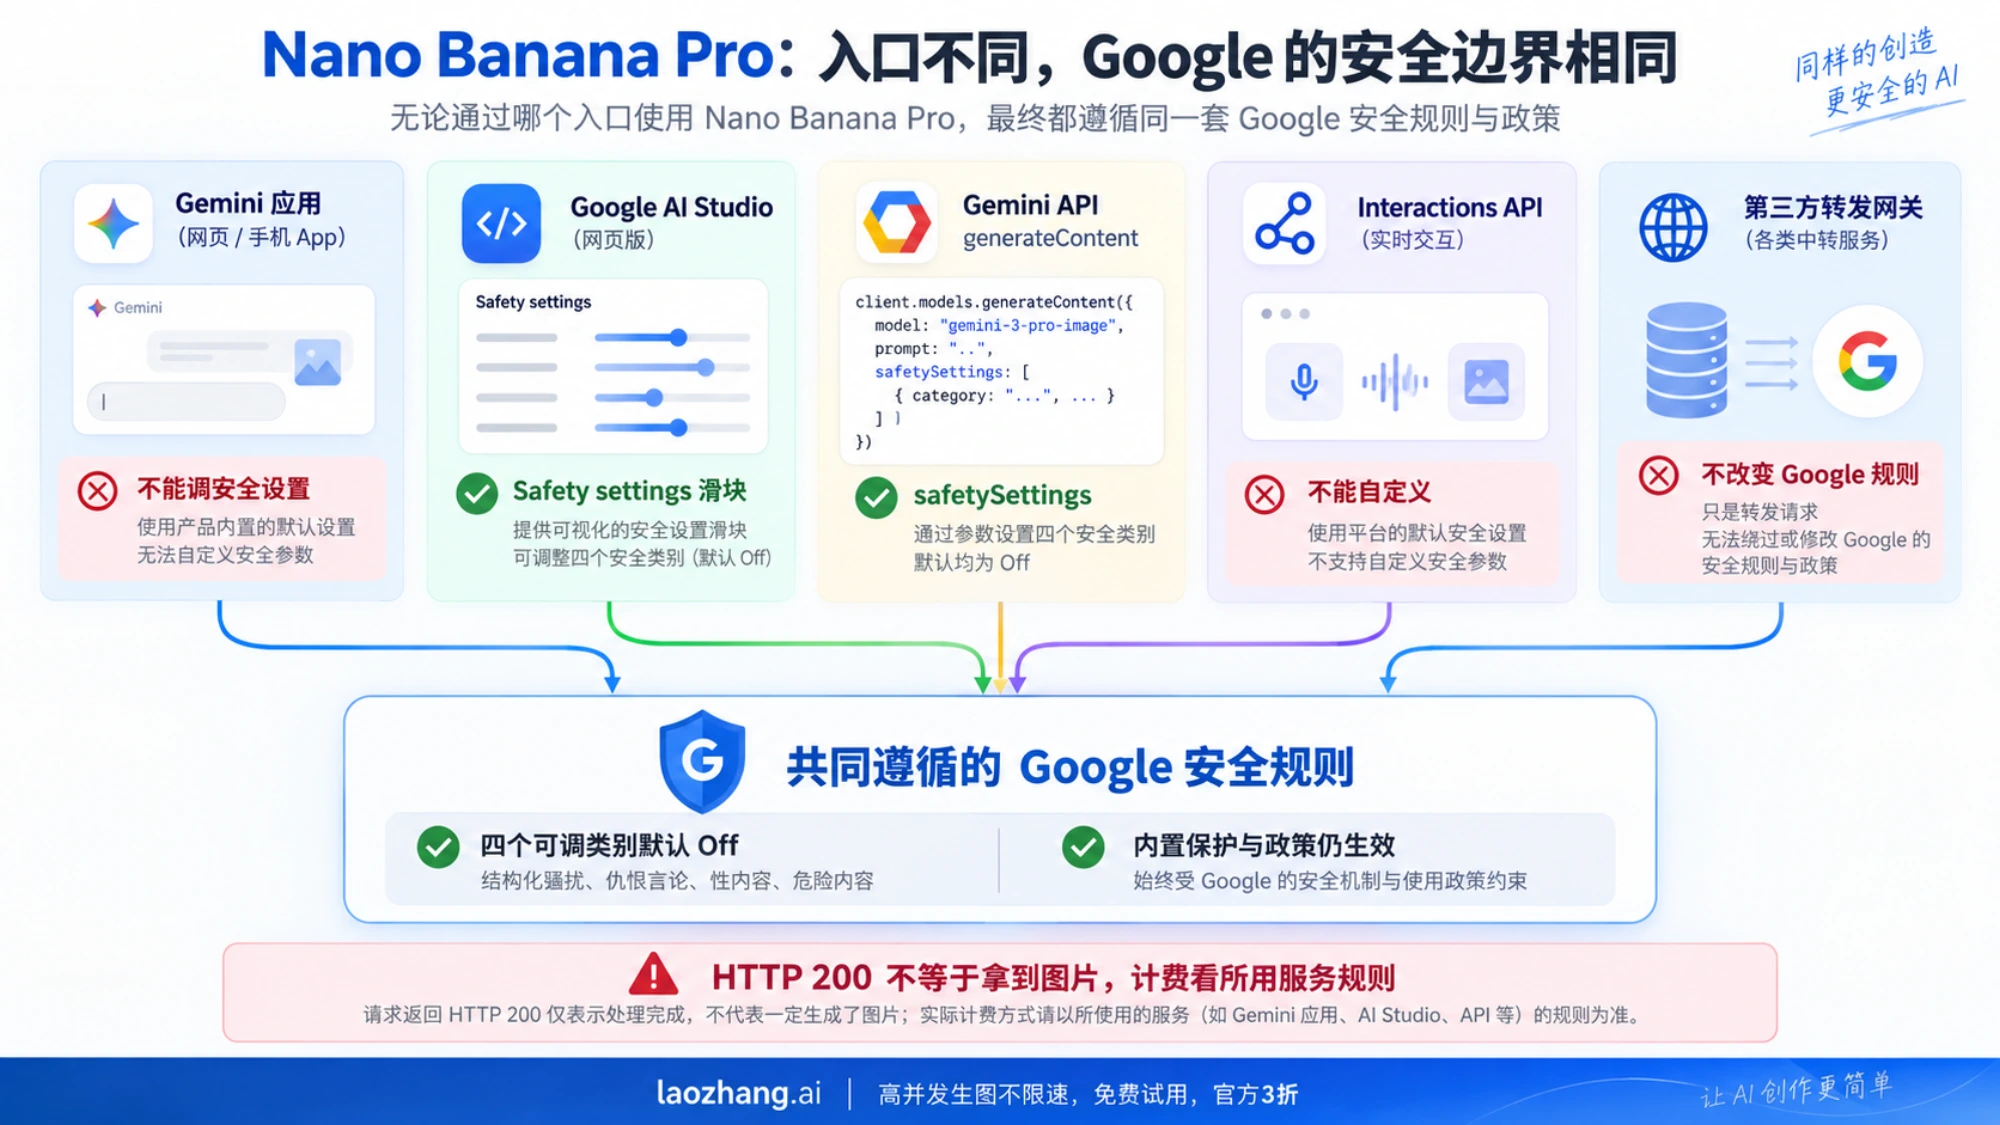
| 入口 | 能否调安全设置 | 水印 |
|---|---|---|
| Gemini 应用 | 不能 | SynthID;按发布公告,免费用户和 Google AI Pro 用户的图片另有可见的 Gemini 星标,Ultra 用户没有 |
| Google AI Studio | 能,Safety settings 滑块 | SynthID;按发布公告不加可见水印 |
Gemini API generateContent | 能,safetySettings | SynthID |
| Gemini API Interactions API | 不能 | SynthID |
| 转发到 Google 的第三方 API 网关 | 不改变 Google 的规则 | SynthID |
几个入口用的是同一个模型,内置保护和政策边界对它们一视同仁。区别只在于你有没有办法调那四个类别,而它们默认已经是 Off。在 Gemini 应用里出图失败,多数时候先要排除的是入口和额度问题,见 Gemini 里 Nano Banana Pro 用不了?先按应用路线排查。
第三方网关也不例外。以 laozhang.ai 为例,它把 gemini-3-pro-image 请求转发给 Google 的模型,Google 的安全规则照样生效,不会因此更宽松。它的文档还写明,HTTP 200 但没有图片的调用按一次计费,所以被拦下、以 200 返回的请求在那里同样要付费。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
常见问题
Nano Banana Pro 被安全过滤拦截的请求扣费吗?
Google 的计费文档写明,失败的 400 和 500 请求不收费,但计入配额。安全拦截不是这类报错,而是正常响应里的拦截原因,Google 没有单独公布这类响应怎么计费。可以看响应里的 usageMetadata:candidatesTokenCount、thoughtsTokenCount 有没有值,再对照账单。Nano Banana Pro 默认开启思考,思考部分按文字输出计费。通过第三方网关调用时以对方的计费规则为准。
Nano Banana Pro 生成的图片都有 SynthID 水印吗?
都有。Google 的图片生成文档写明所有生成的图片都含 SynthID 水印,这个水印肉眼看不见,没有设置可以关闭;你可以把图片上传到 Gemini 应用,问它是不是 Google AI 生成的(发布时先支持英文提问)。可见的 Gemini 星标是另一回事,按发布公告只加在 Gemini 应用免费用户和 Google AI Pro 用户的图片上。为了欺骗而谎称生成内容出自人手,也在使用限制政策的禁止之列。
以前能生成的图片现在被拦了,是 Google 改了过滤规则吗?
安全设置文档只描述当前规则,没有列出过滤行为何时改过。能确定的是模型本身变过:Nano Banana Pro 的预览版 gemini-3-pro-image-preview 已于 2026 年 6 月 25 日下线,现在用的是正式版 gemini-3-pro-image,同一提示词在两个版本上的结果可能不同。2026 年 3 月的论坛帖标题就叫「新的安全过滤器」,说明开发者察觉到了变化,但 Google 没有公布改动内容。排查时把响应里的 modelVersion 一起记下。
能不能申请 Google 放宽 Nano Banana Pro 的安全过滤?
公开文档里没有为单个账号放宽内置保护的申请入口。政策中基于教育、纪实、科学或艺术考虑的例外由 Google 判断,不是申请制的开关;申诉链接只随暂停或关闭访问的通知提供。遇到你认为是误拦的情况,可以带着 responseId、modelVersion、提示词和参考图情况,在 Google AI Developers Forum 发帖说明。