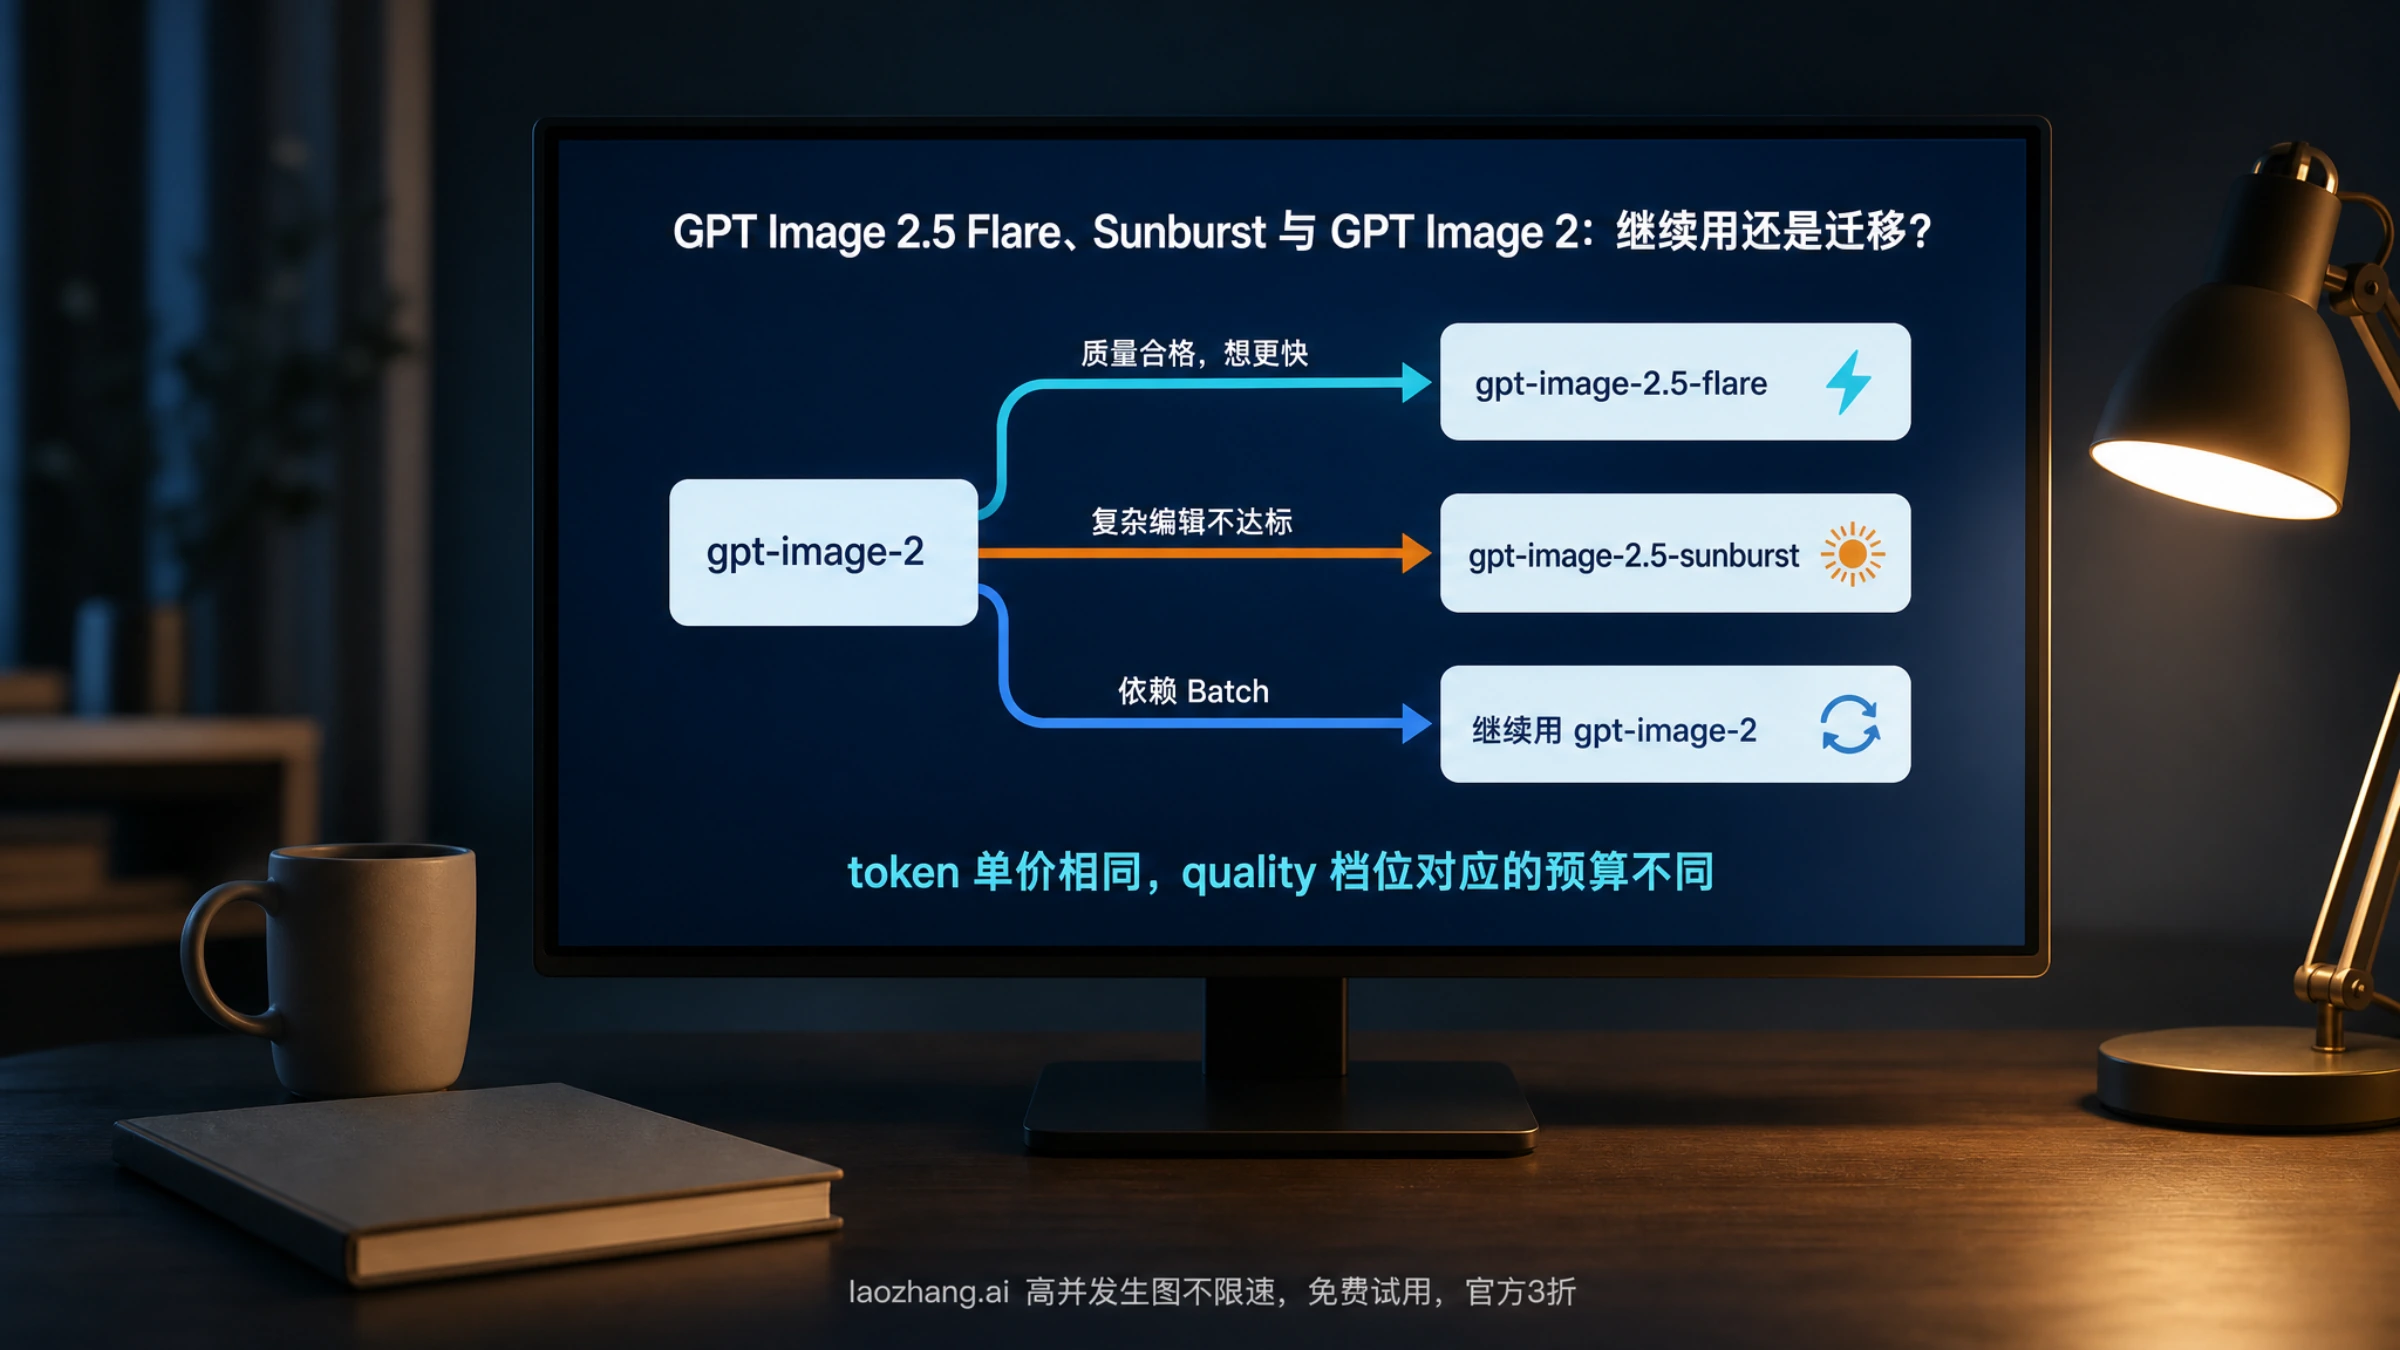
已经在用 gpt-image-2 且输出合格的流程,先用同样的提示词和参考图测 gpt-image-2.5-flare,目标是保住质量、缩短等待;GPT Image 2 在复杂编辑上达不到要求的,先测 gpt-image-2.5-sunburst 确认质量,再用同一批输入测 Flare;依赖 Batch 半价的流程暂时留在 GPT Image 2。 这是 OpenAI 提示词指南给出的迁移路径,不是本站的测试结论。GPT Image 2.5 提示词指南:选择模型
迁移本身有一个容易被忽略的陷阱:三款模型的 token 单价一模一样,但 quality: "medium" 在 GPT Image 2 和 2.5 上对应的输出预算相差约 4 倍。只改 model 字符串、其他参数原样保留,账单和画面复杂度会一起变化,而错误日志里什么都不会提示。下文先讲清三款模型的官方定位,再讲预算对应关系、现有的速度与画质证据,最后给出可以直接照做的迁移步骤。
先看结论:三种情况分别怎么办
| 你的现状 | 先测哪款 | 判断标准 |
|---|---|---|
| GPT Image 2 流程已验证、质量合格,想缩短等待 | gpt-image-2.5-flare | 同一批提示词、参考图和尺寸下,质量不掉、响应时间缩短才切换 |
| GPT Image 2 在复杂编辑、细节保留上不达标 | gpt-image-2.5-sunburst | 先确认 Sunburst 达标;达标后再用同样输入测 Flare,Flare 也达标且更快就用 Flare |
依赖 v1/batch 的离线批量任务 | 继续用 gpt-image-2 | 两款 2.5 型号页目前把 v1/batch 标为不支持,Batch 价格表也只列了 gpt-image-2 |
| 新接入,没有历史基线 | 速度优先选 Flare,质量要求苛刻选 Sunburst | 输出达标后再往低质量档试,看能否进一步降延迟 |
GPT Image 2 没有被弃用。官方弃用页上,2026 年 10 月 23 日下线的 gpt-image-1 和 2026 年 12 月 1 日下线的 gpt-image-1.5、gpt-image-1-mini、chatgpt-image-latest,推荐替代都是 gpt-image-2;gpt-image-2 与两款 2.5 型号都没有弃用条目。OpenAI 弃用页。所以"留在 GPT Image 2"是一个正常选项,不是拖延。
三款模型的官方定位,以及 OpenAI 自己的两种说法
截至 2026 年 9 月 22 日,OpenAI 图片模型只有三个当前型号 ID,都接受文字与图片输入、输出图片,都支持生成、编辑和局部重绘。不带后缀的 gpt-image-2.5 不是模型 ID。
| 型号 ID | 当前快照 | 型号页标签 | 官方定位 | quality 档位 |
|---|---|---|---|---|
gpt-image-2 | gpt-image-2-2026-04-21 | 性能 Higher,速度 Medium | 上一代主力模型,旧模型的官方推荐替代 | low、medium、high、auto |
gpt-image-2.5-flare | gpt-image-2.5-flare-2026-09-08 | 速度 Very fast | "面向高质量日常生图的最快模型",小模型,速度优先 | low、medium、high、xhigh、max、auto |
gpt-image-2.5-sunburst | gpt-image-2.5-sunburst-2026-09-08 | 性能 Highest,速度 Medium | "生成与编辑能力最强的模型",基础模型,质量优先 | 同 Flare |
来源:gpt-image-2 型号页、gpt-image-2.5-flare 型号页、gpt-image-2.5-sunburst 型号页。标签是 OpenAI 的分类描述,不是测量值。
关于 Flare 相对 GPT Image 2 的画质,OpenAI 自己有两种表述,最好都记住:
- 提示词指南:Flare "是小模型,为速度优化,画质与 GPT Image 2 相当";Sunburst "是基础模型,为质量优化,画质高于 GPT Image 2";两者"在精确编辑和主体保留上都有改进"。
- 2026 年 9 月 8 日的发布文:Flare "是多数应用的默认选择,与 GPT‑Image‑2 相比,它能以低 50% 的延迟生成质量更高的图像";Sunburst "为精细创作提供额外一层精度,生成时间更长"。OpenAI 发布说明
"相当"和"更高"之间的差别,OpenAI 没有解释,本站也没有做付费实测来裁决。中文页面里流传的"Flare 速度是 GPT Image 2 的 2 到 4 倍"没有出现在发布文正文里,本文不采用。能拿到的第三方数据在后文单独列出,并注明条件。
单价相同,为什么只换 model 账单就变了
三款模型的 Standard 单价完全一致
| 计费项 | gpt-image-2 | gpt-image-2.5-flare | gpt-image-2.5-sunburst |
|---|---|---|---|
| 文字输入 | $5.00 / 百万 token | $5.00 | $5.00 |
| 文字输入(缓存命中) | $1.25 | $1.25 | $1.25 |
| 图片输入 | $8.00 | $8.00 | $8.00 |
| 图片输入(缓存命中) | $2.00 | $2.00 | $2.00 |
| 图片输出 | $30.00 | $30.00 | $30.00 |
| 文字输出 | 不计费 | 不计费 | 不计费 |
来源:OpenAI 价格页 Standard 标签,2026 年 9 月 22 日读取;两款 2.5 型号页也写明 "Token rates match GPT Image 2"。
如果你在别处看到"GPT Image 2 图片输出 $15/百万、2.5 贵一倍"或者"GPT Image 2 半价",那是把 GPT Image 2 的 Batch 价格(图片输入 $4.00、缓存 $1.00、输出 $15.00、文字输入 $2.50、缓存 $0.625,正好是 Standard 的一半)当成了 Standard 价格。价格页的 Batch 标签只列了 gpt-image-2,两款 2.5 型号页把 v1/batch 标为不支持。今天的状态是"2.5 尚未列出 Batch",不是"永远没有"。
同一个 quality 标签,输出预算不同
真正改变单张费用的是输出 token 数。官方图片生成指南明确写道,模型"可以为同一个 quality 设置消耗不同的 token 数,但共享同一个图片输出 token 单价",并且"相同的 quality 标签不意味着跨模型的图片质量或响应时间相同"。图片生成指南:成本与延迟
下面是官方计算器在 2026 年 9 月 22 日的实时读数(只算输出 token,按 $30/百万折算,不含文字与图片输入,也不含流式 partial images;计算器把 Sunburst 与 Flare 合并为一个选项):
| quality | GPT Image 2,1024×1024 | GPT Image 2.5,1024×1024 | GPT Image 2,2048×1152 | GPT Image 2.5,2048×1152 |
|---|---|---|---|---|
low | 196 token($0.00588) | 196($0.00588) | 157($0.00471) | 157($0.00471) |
medium | 1,756($0.05268) | 439($0.01317) | 1,413($0.04239) | 367($0.01101) |
high | 7,024($0.21072) | 1,756($0.05268) | 5,650($0.16950) | 1,413($0.04239) |
xhigh | 不提供 | 3,122($0.09366) | 不提供 | 2,511($0.07533) |
max | 不提供 | 7,024($0.21072) | 不提供 | 5,650($0.16950) |
对应关系一眼可见:2.5 的 high 等于 GPT Image 2 的 medium 预算,2.5 的 max 等于 GPT Image 2 的 high 预算,low 两代相同,2.5 的 medium 和 xhigh 插在中间。可以把 2.5 的质量阶梯理解为在 GPT Image 2 的三档之间多插了两档,而不是整体上移。
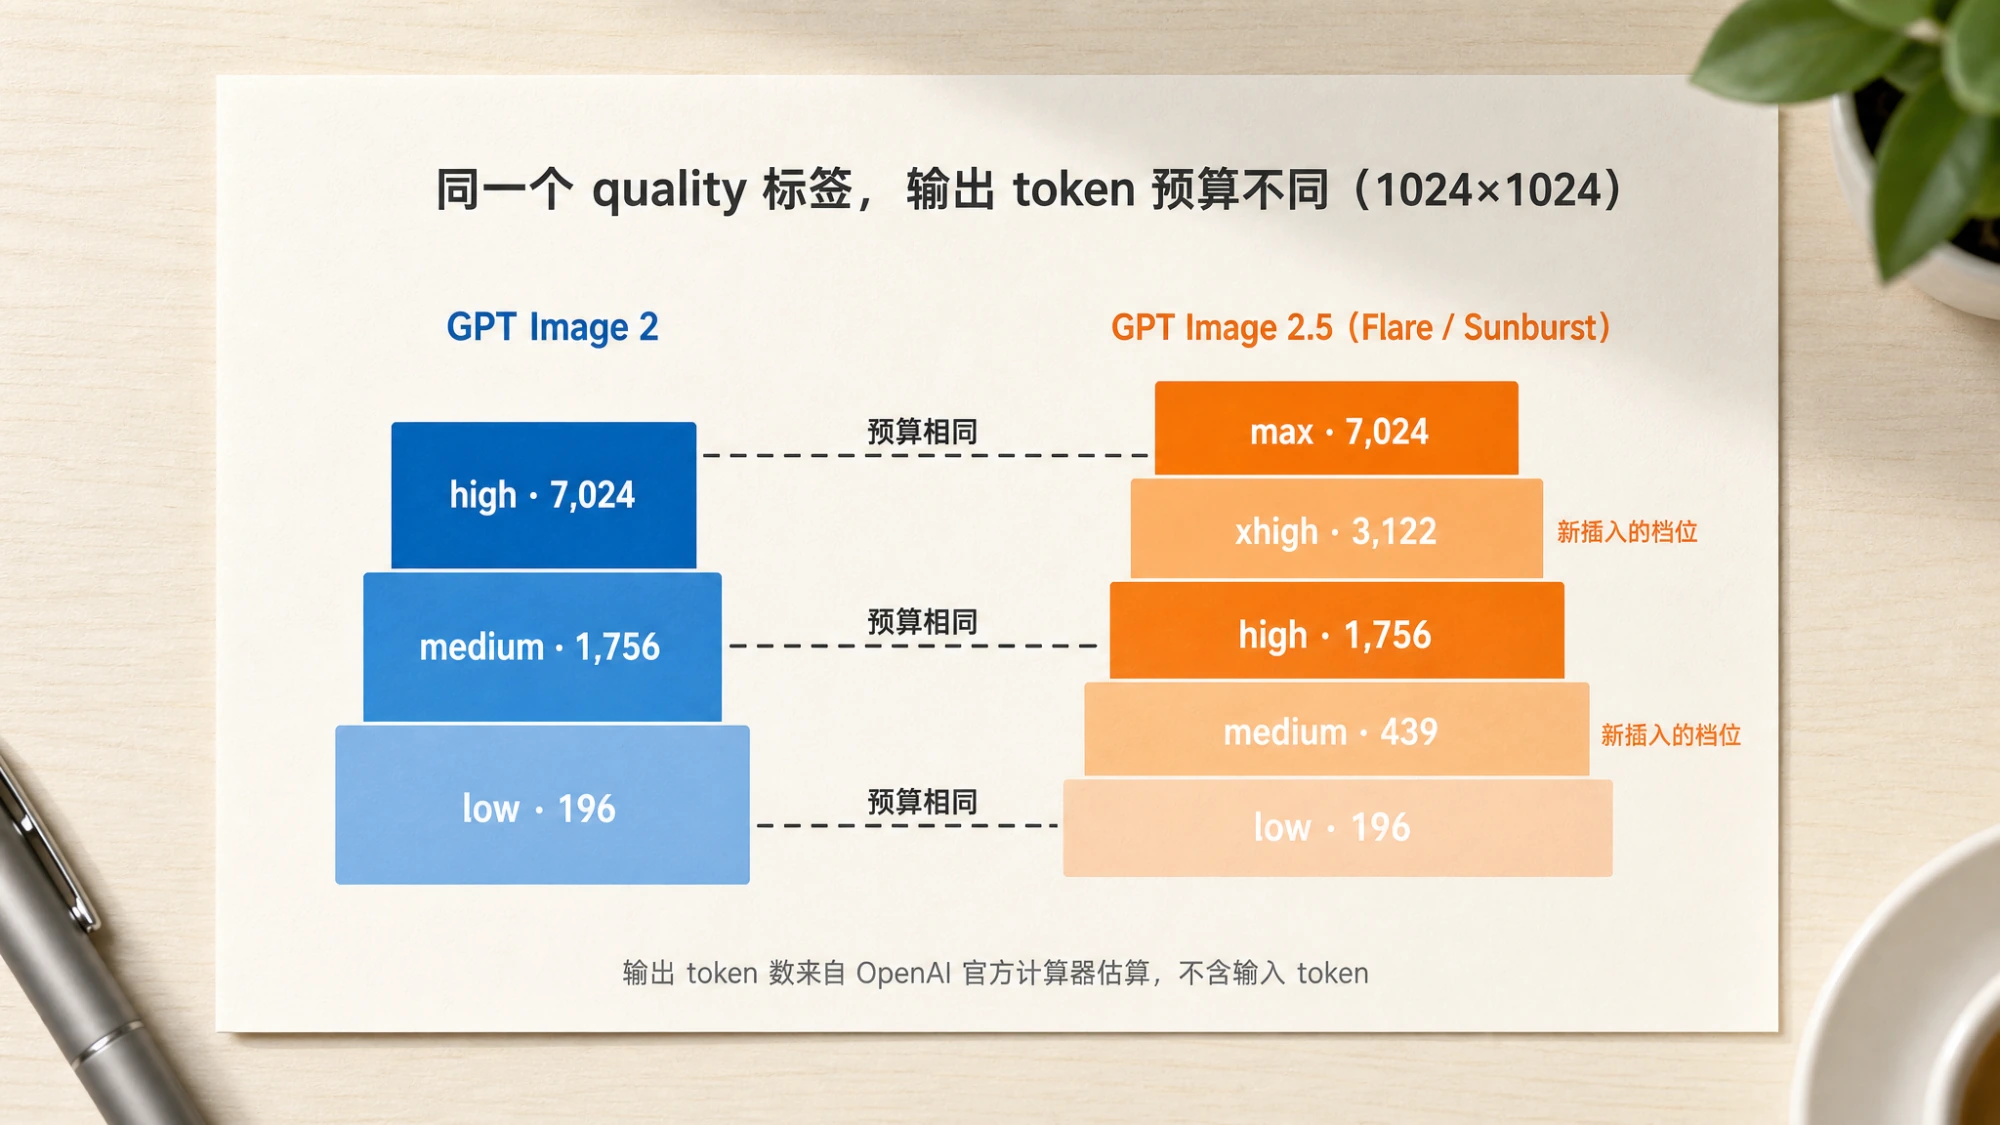
这带来两个实际后果:
- 原样保留
quality: "medium"只换 model,1024×1024 的输出预算从 1,756 token 降到 439 token,单张输出费用从约 $0.053 降到约 $0.013。账单会明显变少,但你其实是在用一个更小的预算生成图片,复杂构图和细节可能一起变简单。这不是模型退步,是设置被悄悄调低了。 - 想在等预算下比较,GPT Image 2
medium应该对 2.5high,GPT Image 2high应该对 2.5max。Artificial Analysis 榜单把 2.5max与 GPT Image 2high放在一起比,正是同样的 7,024 token 预算。
计算器给的是估算,auto 无法估算;流式输出每张 partial image 额外计 100 输出 token;编辑请求带参考图时,gpt-image-2 强制按高保真处理图片输入,输入 token 也会更高。实际成本以响应里的 usage 字段为准。需要更细的预算表可以看 GPT Image 2.5 API 价格与按次计费怎么选 与 GPT Image 2 API 价格说明。
速度、画质与多轮漂移:现有证据能说明什么
盲测榜单:2.5 领先,但票数还少
Arena(原 lmarena)的两张榜单,页面标注更新于 2026 年 9 月 7 日:
| 榜单 | gpt-image-2.5-sunburst | gpt-image-2.5-flare | gpt-image-2(medium) |
|---|---|---|---|
| 文生图 | 1421 ±13(3,149 票,Preliminary) | 1399 ±13(2,856 票,Preliminary) | 1381 ±4(78,731 票) |
| 图片编辑 | 1520 ±9(6,704 票,Preliminary) | 1491 ±9(5,676 票,Preliminary) | 1461 ±3(235,928 票) |
来源:Arena 文生图榜、Arena 图片编辑榜。两款 2.5 都标着 Preliminary,票数不到 GPT Image 2 的十分之一;GPT Image 2 的条目是 medium 档,与 2.5 的默认档位不是等预算比较。
Artificial Analysis 的文生图 Elo(盲投):Sunburst max 1197 ±9(13,401 次比较),Flare max 1190 ±9(12,778 次),GPT Image 2 high 1171 ±9(15,176 次)。Artificial Analysis 文生图榜。这组数据是等预算的(都是 7,024 token),Flare 与 Sunburst 的差距在误差范围内;它衡量的是偏好,不是速度或成本。
唯一读到的等预算延迟测试:Tosea 的幻灯片编辑
Tosea.ai 在 2026 年 9 月 9 日发布了自己的测试:用官方 API 的 images/edits 端点,提示词是大纲加 1 到 3 张品牌模板参考图,主矩阵 2048×1152,每个设置 5 页取平均,单次调用、无重试,共 41 次调用全部成功。它从响应的 usage 读到的输出 token 与上表 2048×1152 的官方读数完全一致。Tosea:GPT Image 2.5 完全指南(日文)
在这个条件下,同为 1,413 token 的渲染(GPT Image 2 medium 对 2.5 high):GPT Image 2 平均 37.3 秒,Sunburst 27.7 秒,Flare 19.7 秒,即 Flare 快 47%、Sunburst 快 26%,每页输出费用都约 $0.059。同为 5,650 token 时分别是 82.9、59.8、33.7 秒。三款模型在全部 15 张矩阵幻灯片上的文字和数字都正确,没有出现 2.5 成功而 GPT Image 2 失败的情况。
多轮编辑漂移(连续 1、2、3 次编辑后相对原图的像素变化比例):GPT Image 2 为 5.6%、8.1%、11.4%,Sunburst 为 4.1%、6.8%、9.9%,Flare 为 3.8%、6.7%、9.2%;三款各 9 次编辑全部成功。作者还观察到 2.5 的 auto 在 5 次运行里有 4 次落在 1,413 token 档,有一次是 628。
这些数字的边界很清楚:一个视觉领域(带品牌参考的密集商务幻灯片)、两个分辨率、每格 5 张、无 p95。人像、个人照片的主体保留、透明背景、蒙版局部重绘都没有测。OpenAI 自己也说"一个工作负载上的速度提升不能推出另一个工作负载上的固定提升"。把它当作"2.5 在等预算下确实更快、漂移略小"的一个支持性样本,而不是通用比例。
按官方路径迁移:六步检查清单
以下步骤来自提示词指南"迁移现有工作流"一节,结合前面的预算对应关系补充了具体参数。提示词指南:迁移现有工作流
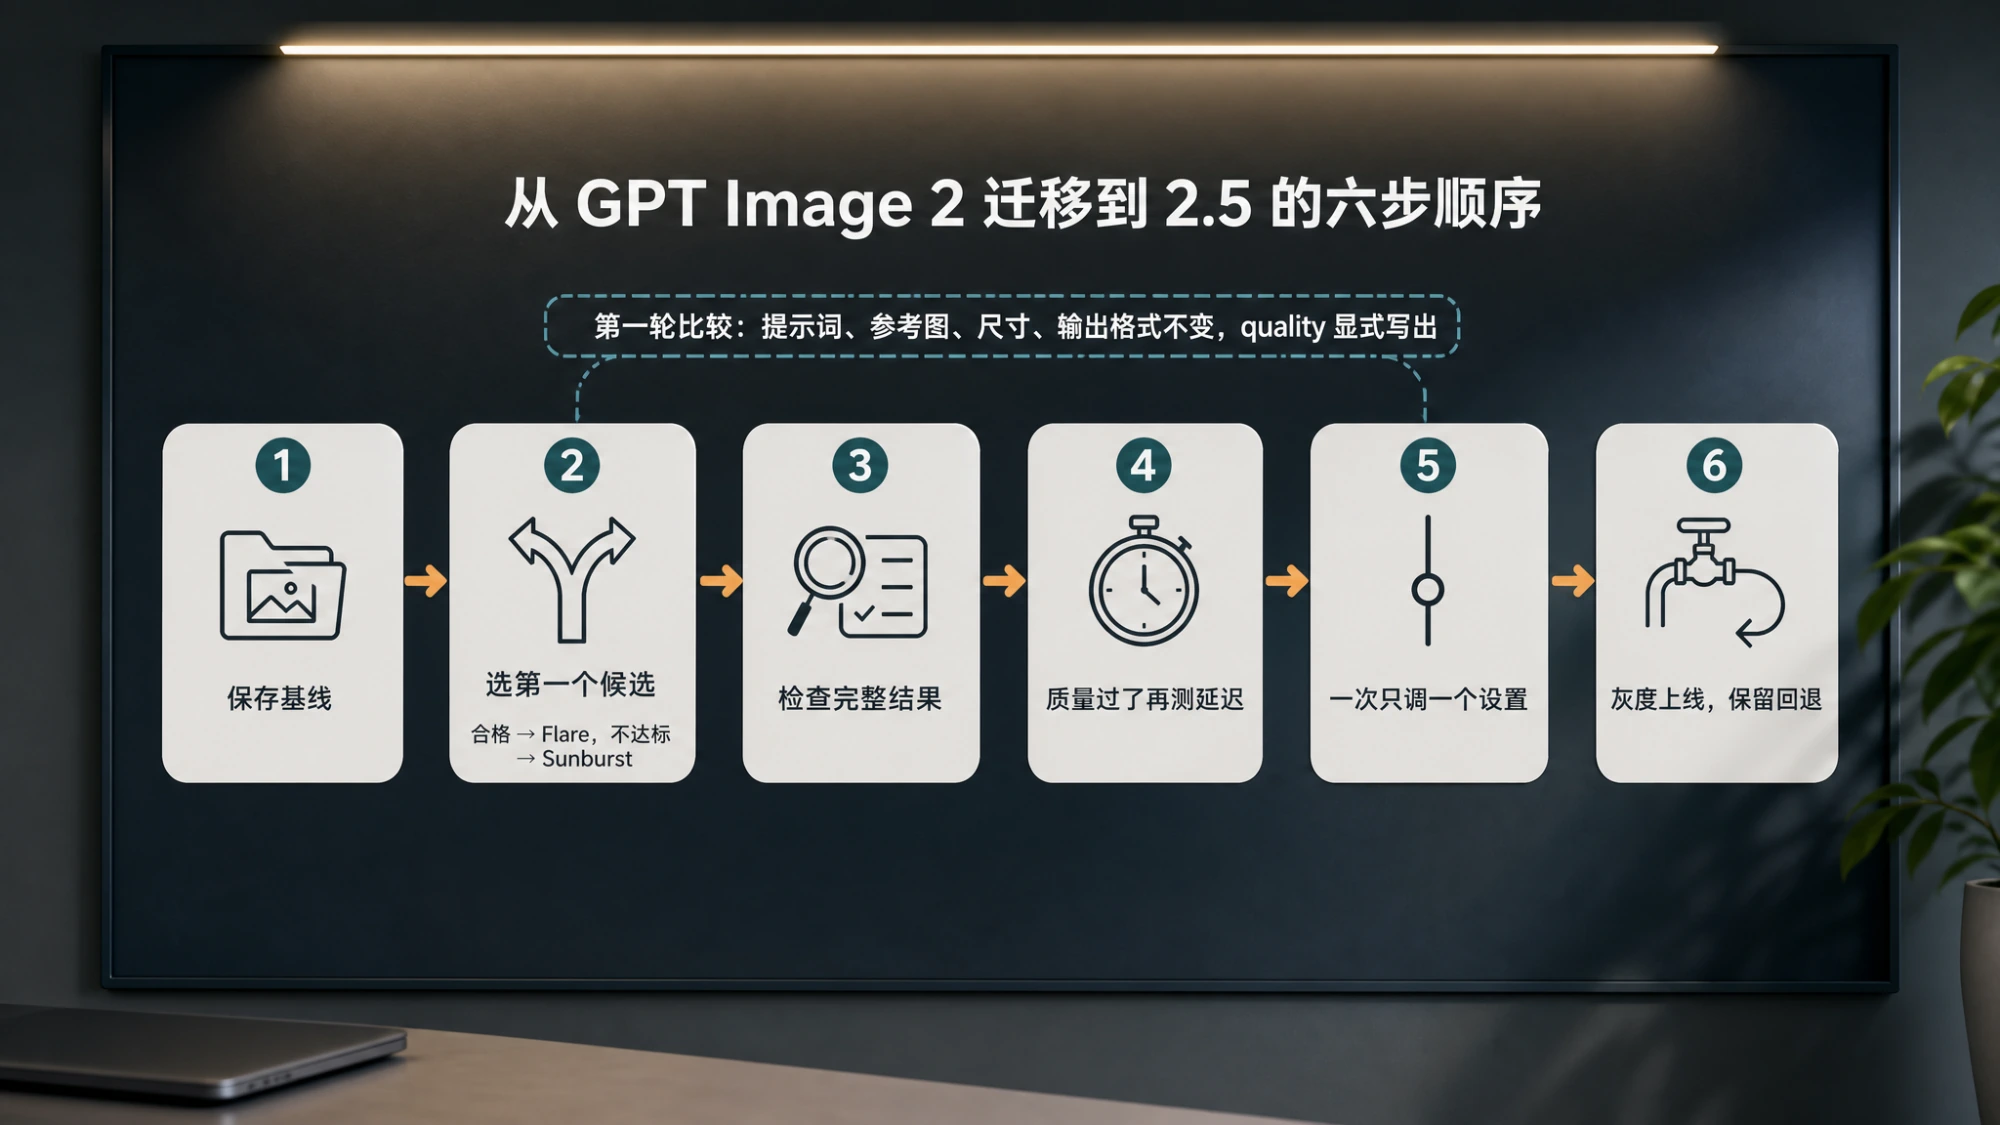
- 保存基线。 收集有代表性的生产提示词与参考图,特别是困难编辑、必须精确的文字、人脸、商品几何形状、透明素材;记录当前的模型、请求参数和结果。
- 选第一个候选。 GPT Image 2 已达标就先测 Flare;在复杂任务上不达标就先测 Sunburst。第一轮比较保持提示词、参考图、尺寸、输出格式不变,并且把
quality显式写出来,按预算对应(GPT Image 2medium对 2.5high),不要沿用auto或同名标签。 - 检查完整结果。 对比指令遵循、身份与商品保留、文字准确性、不该变的地方有没有变、透明通道是否干净;重复请求看一致性;编辑流程要测完整的连续步骤,不只测单步。
- 质量过了再测延迟。 从 Sunburst 起步且达标的,用同一批要求评估 Flare,只有质量仍可接受且延迟改善才切换,否则留 Sunburst。
- 一次只调一个设置。 先比较质量档位再改提示词;记录典型响应时间与慢响应、失败、重试和每张合格图片的成本。官方原话是"确认当前价格,而不是假设更快的模型更便宜"。
- 按工作流灰度上线。 通过验收后先切一小部分流量,监控同样的指标再扩大;旧模型在受支持期间保留为回退,最好固定到快照
gpt-image-2-2026-04-21。
请求层面的改动很小。以编辑请求为例,等预算迁移只需要改两处:
pythonfrom openai import OpenAI

client = OpenAI()

# 基线:GPT Image 2,medium 档,1024×1024 约 1,756 输出 token
baseline = client.images.edit(
    model="gpt-image-2",
    image=open("product.png", "rb"),
    prompt="把背景换成浅灰色摄影棚,商品和标签保持不变",
    quality="medium",
    size="1024x1024",
)

# 候选:GPT Image 2.5 Flare,high 档,同样约 1,756 输出 token
candidate = client.images.edit(
    model="gpt-image-2.5-flare",
    image=open("product.png", "rb"),
    prompt="把背景换成浅灰色摄影棚,商品和标签保持不变",
    quality="high",
    size="1024x1024",
)

print(baseline.usage, candidate.usage)  # 用实际 usage 核对预算是否对齐
几处参数差异需要留意:gpt-image-2 不接受 xhigh 与 max,也不允许传 input_fidelity(它对所有图片输入固定高保真);三款模型的尺寸限制相同(边长为 16 的倍数、长短边比不超过 3:1、总像素 655,360 到 8,294,400,超过 2560×1440 为实验性);透明背景在三款上都要显式传 background: "transparent" 并用 PNG 或 WebP 输出,图片生成指南的 GPT Image 2 参考页把透明背景标为预览功能。走 Responses API 的话,把 2.5 型号写在 image_generation 工具的 model 字段即可,主线模型的 token 会另行计费。图片生成指南
每张合格图片的成本按"计费的全部尝试(输入 + 输出 + partial images + 重试)÷ 被采纳的图片数"计算。举一个假设的例子:如果 Flare high 在你的任务上 10 次采纳 9 次,GPT Image 2 medium 10 次采纳 7 次,即使单次输出费用相同(都约 $0.053),Flare 的每张合格图片成本会低约 22%;反过来采纳率更低的话,账单省下的钱会被重试吃掉。采纳率只能在自己的基线上测出来。
什么时候继续留在 GPT Image 2
- Batch 是成本主体。
v1/batch目前只有gpt-image-2列出支持,Batch 价格是 Standard 的一半。离线批量任务如果对延迟不敏感,2.5 在 Standard 下的输出预算优势(例如 2.5high对 GPT Image 2medium,同预算)并不能抵消 Batch 的半价,除非你原本就在用low。 - 已验证的流程没有延迟痛点。 官方路径的前提是"想在保住质量的同时降低延迟"。如果用户不在等图,切换只会带来重新验收的成本。
- 需要回退目标。 即便决定迁移,灰度期间也要保留
gpt-image-2的调用路径;它目前没有弃用条目,且是 GPT Image 1 系列的官方推荐替代,短期内不会成为"必须离开"的模型。
尚未接入 GPT Image 2 的读者,可以先看 GPT Image 2 API 接入说明,再决定是否直接从 2.5 起步。
Flare 还是 Sunburst:只需要记住一条顺序
两款 2.5 的差别不是"一个只能生图、一个只能修图",而是速度与质量的取舍:Flare 是速度优先的小模型,Sunburst 是质量优先的基础模型,两者同样支持生成、编辑与透明背景,token 单价相同,计算器里的输出预算也相同。官方给的顺序是:Sunburst 达标后一定要再用同样输入测 Flare,Flare 也达标就用 Flare;Flare 达不到才留 Sunburst。两者在编辑精度、细节保留上的具体比较见 GPT Image 2.5 Flare 与 Sunburst 对比。如果切到 2.5 后画面出现噪点或颗粒感,通常先排查质量档位与输出格式,参见 GPT Image 2.5 噪点与颗粒问题排查。
常见问题
GPT Image 2 会下线吗?
截至 2026 年 9 月 22 日不会。OpenAI 弃用页上没有 gpt-image-2 的条目,它反而是 gpt-image-1(2026 年 10 月 23 日下线)与 gpt-image-1.5、gpt-image-1-mini、chatgpt-image-latest(2026 年 12 月 1 日下线)的推荐替代。官方同时建议在旧模型受支持期间把它保留为回退,这意味着"今天没有弃用"不是永久承诺。
GPT Image 2.5 比 GPT Image 2 贵一倍吗?
不是。三款模型的 Standard 单价完全相同,图片输出都是 $30/百万 token。"贵一倍"的说法把 GPT Image 2 的 Batch 价格($15/百万输出)当成了 Standard 价格。真正影响单张费用的是输出 token 数,而 2.5 在同名 quality 下消耗的 token 通常更少:1024×1024 的 medium 是 439 token,GPT Image 2 是 1,756。
只把 model 改成 gpt-image-2.5-flare,其他参数不动,行不行?
请求会成功,但如果 quality 是 medium,输出预算会从 1,756 token 降到 439(1024×1024),画面复杂度和费用同时下降;如果是 auto,预算由模型自行决定,Tosea 的测试里 2.5 auto 多数落在相当于 GPT Image 2 medium 的档位。要做公平比较,把 quality 显式改为对应预算的档位(medium 改 high,high 改 max),再看质量和延迟。
能直接用 gpt-image-2.5 作为模型名吗?
官方型号页只列出 gpt-image-2.5-flare 和 gpt-image-2.5-sunburst 两个 ID(各自带 2026-09-08 快照)。Tosea 报告不带后缀的 gpt-image-2.5 会返回"does not exist"错误,这一点来自第三方复现,官方页面没有单独说明。
Arena 的分数可以直接当选型依据吗?
只能当参考。两款 2.5 的条目都标着 Preliminary,票数在 3 千到 7 千之间,GPT Image 2 的条目有 7.9 万到 23.6 万票且是 medium 档;榜单不衡量延迟、成本或你的采纳率。选型仍然要在自己的基线上按等预算比较。
用 Batch 的团队现在该怎么办?
继续用 gpt-image-2 跑 Batch,同时用 Standard 小流量测 2.5 的采纳率和延迟。等 OpenAI 的价格页或型号页列出 2.5 的 Batch 支持后,再用同样的基线重新算每张合格图片的成本。