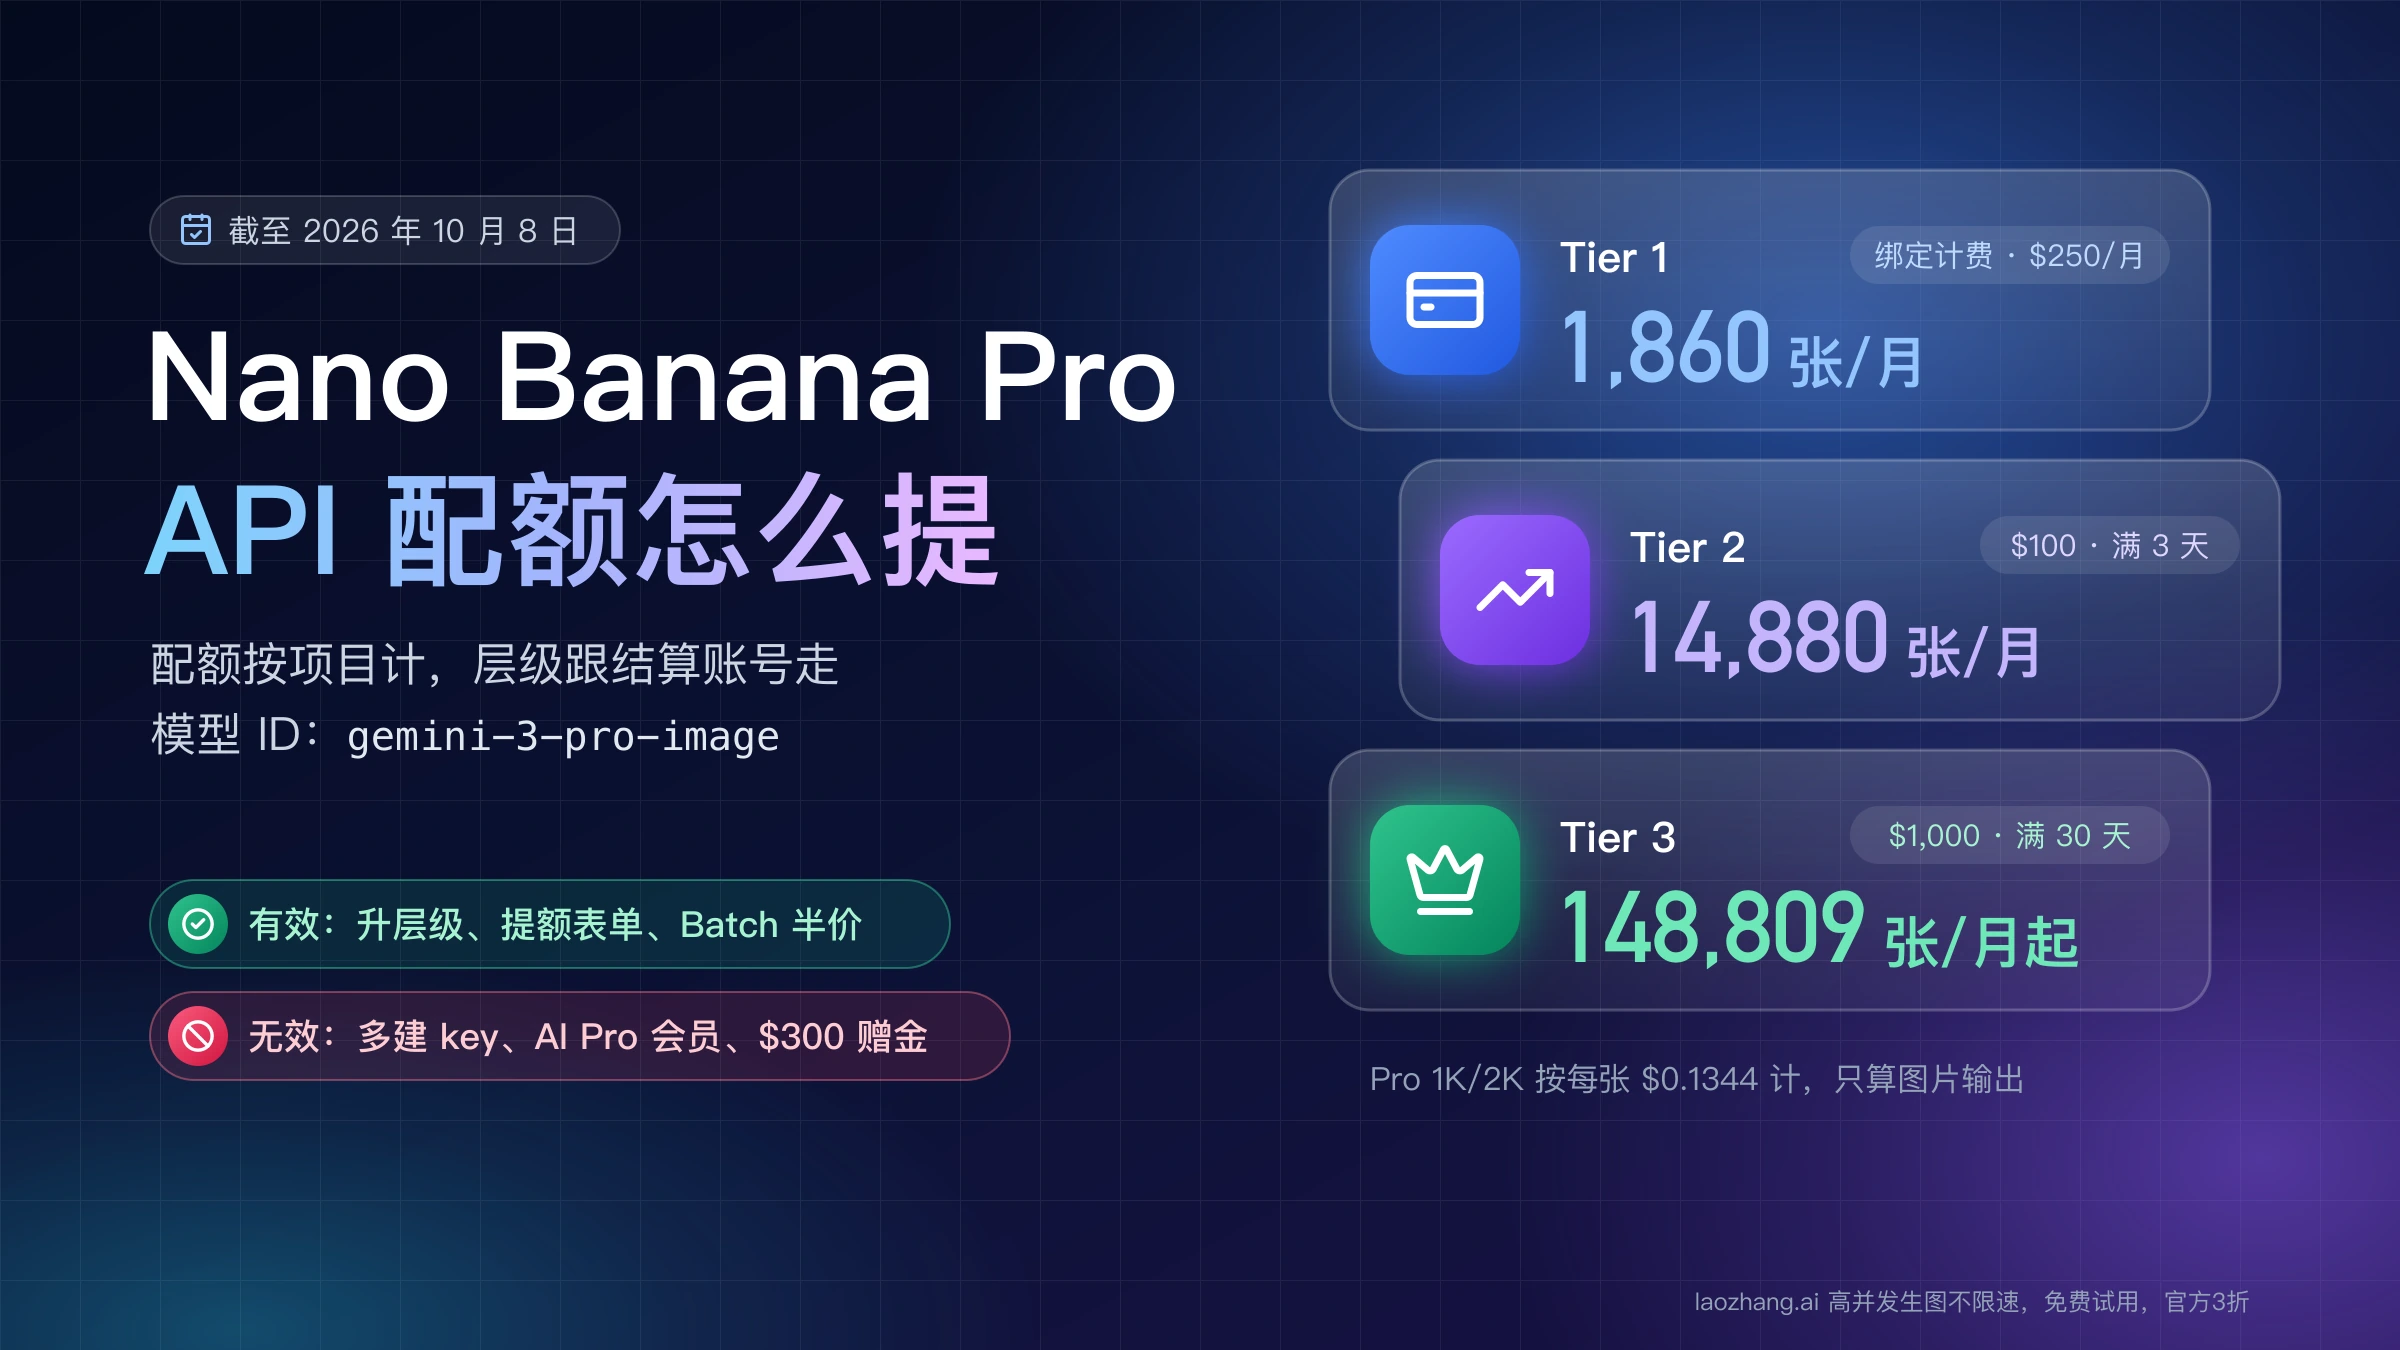
Nano Banana Pro API 怎么调用:JSON 请求、YAML 配置与 PDF 转图
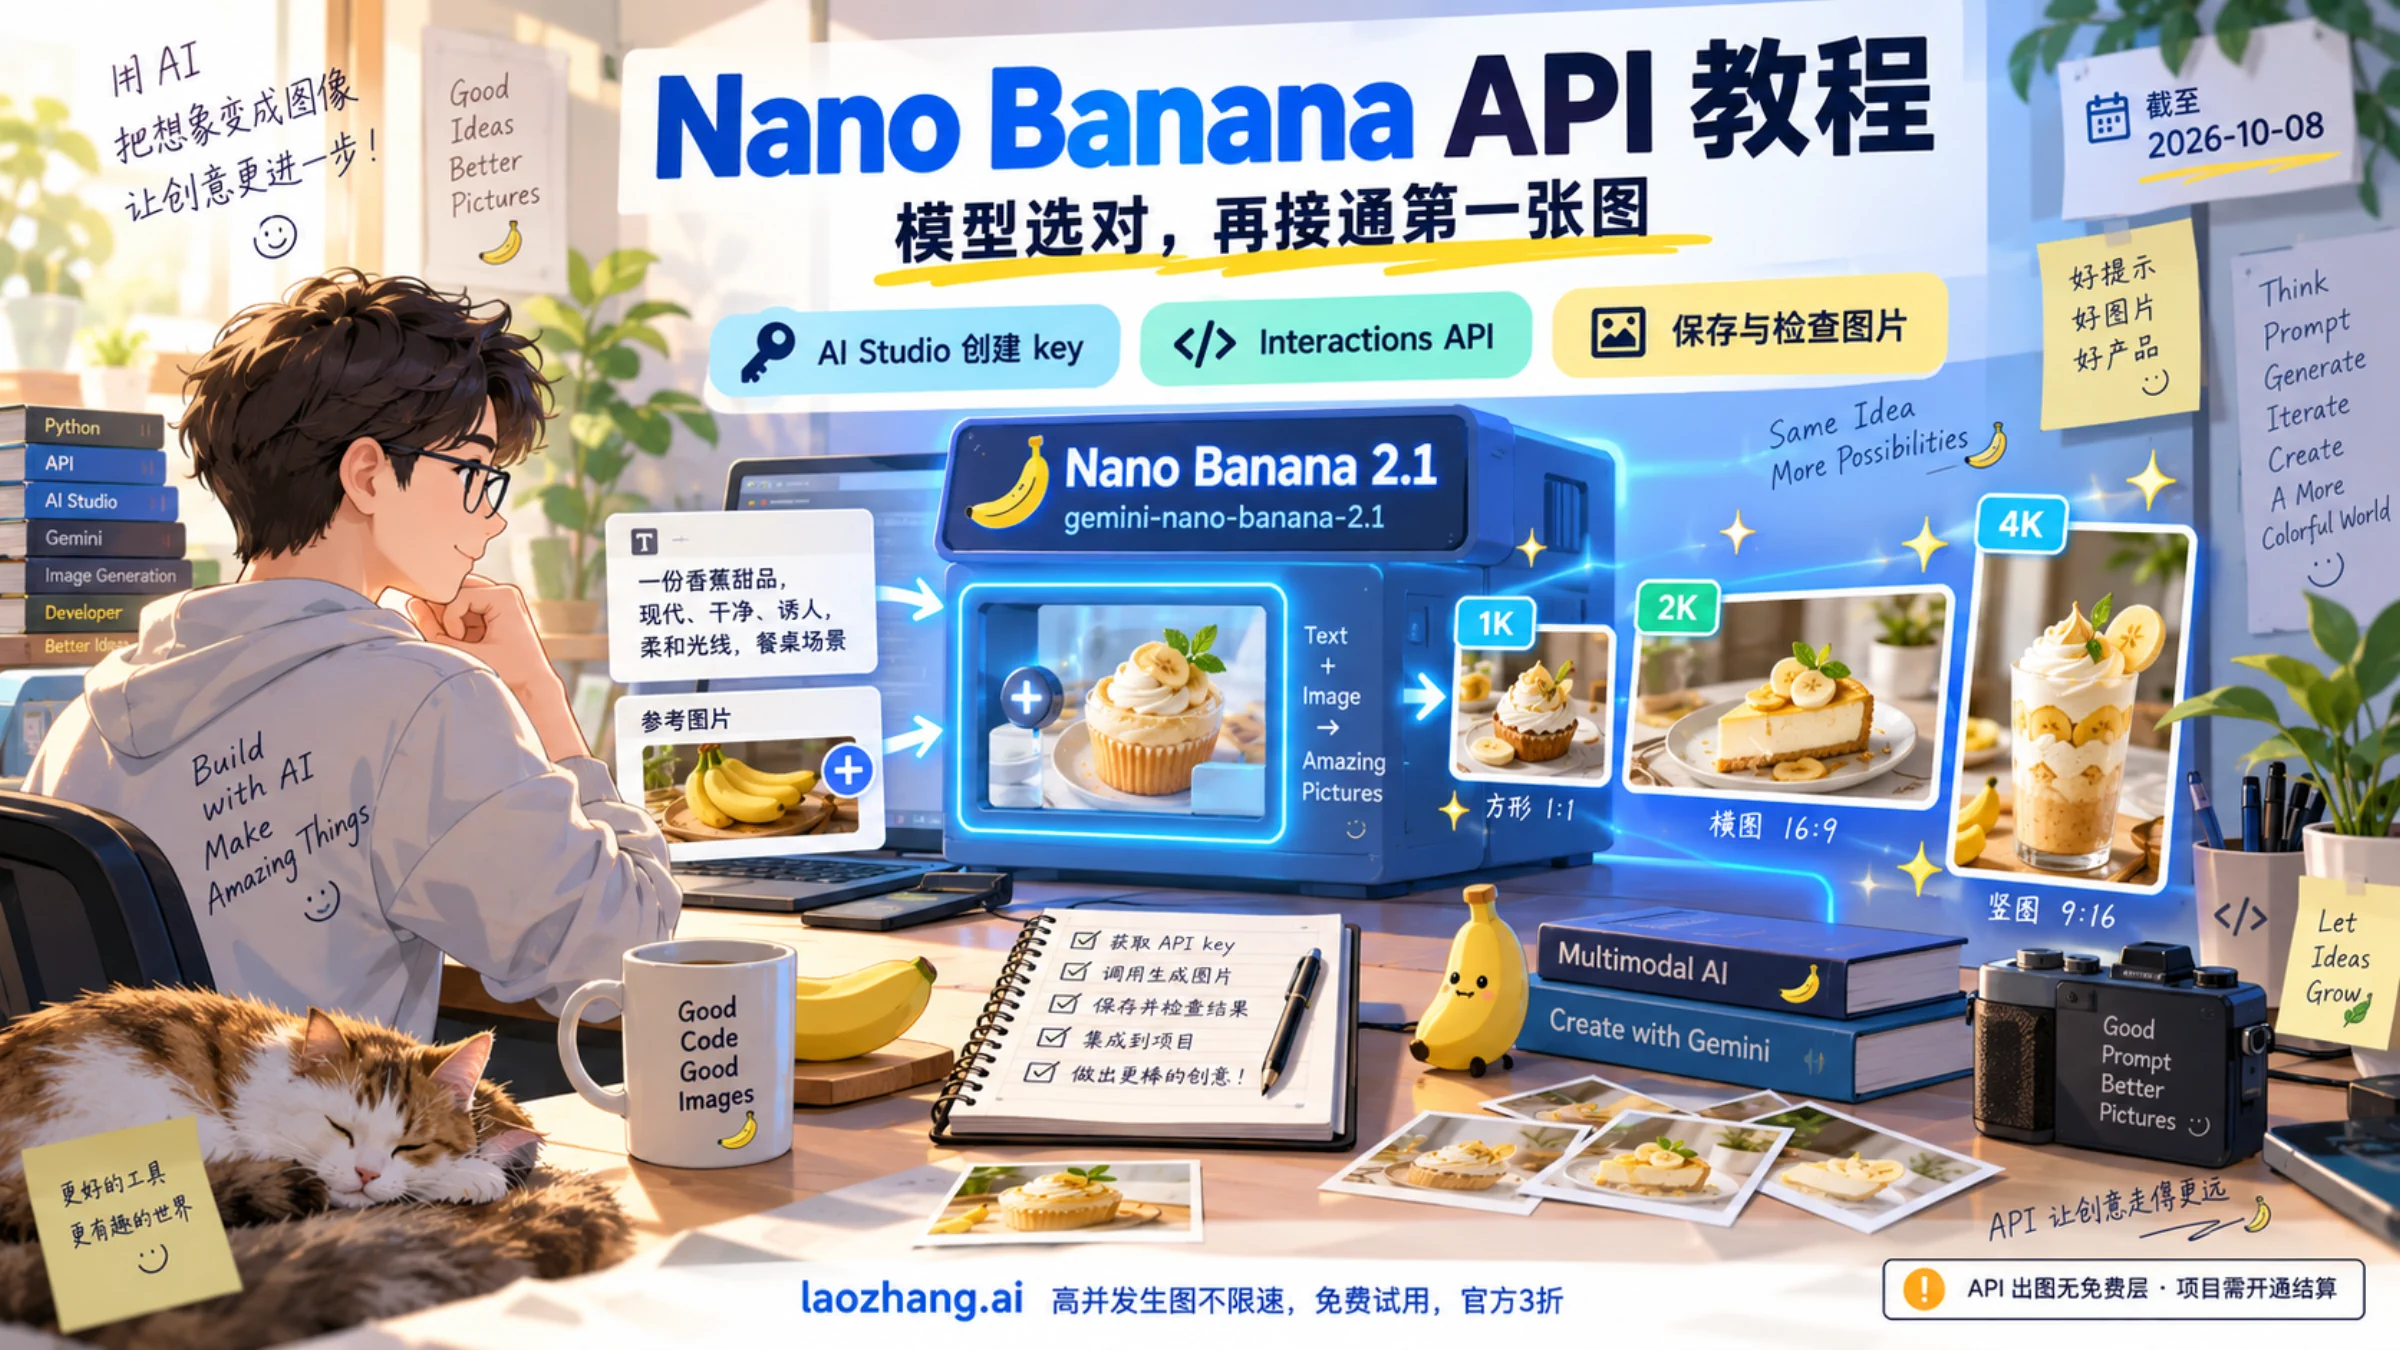
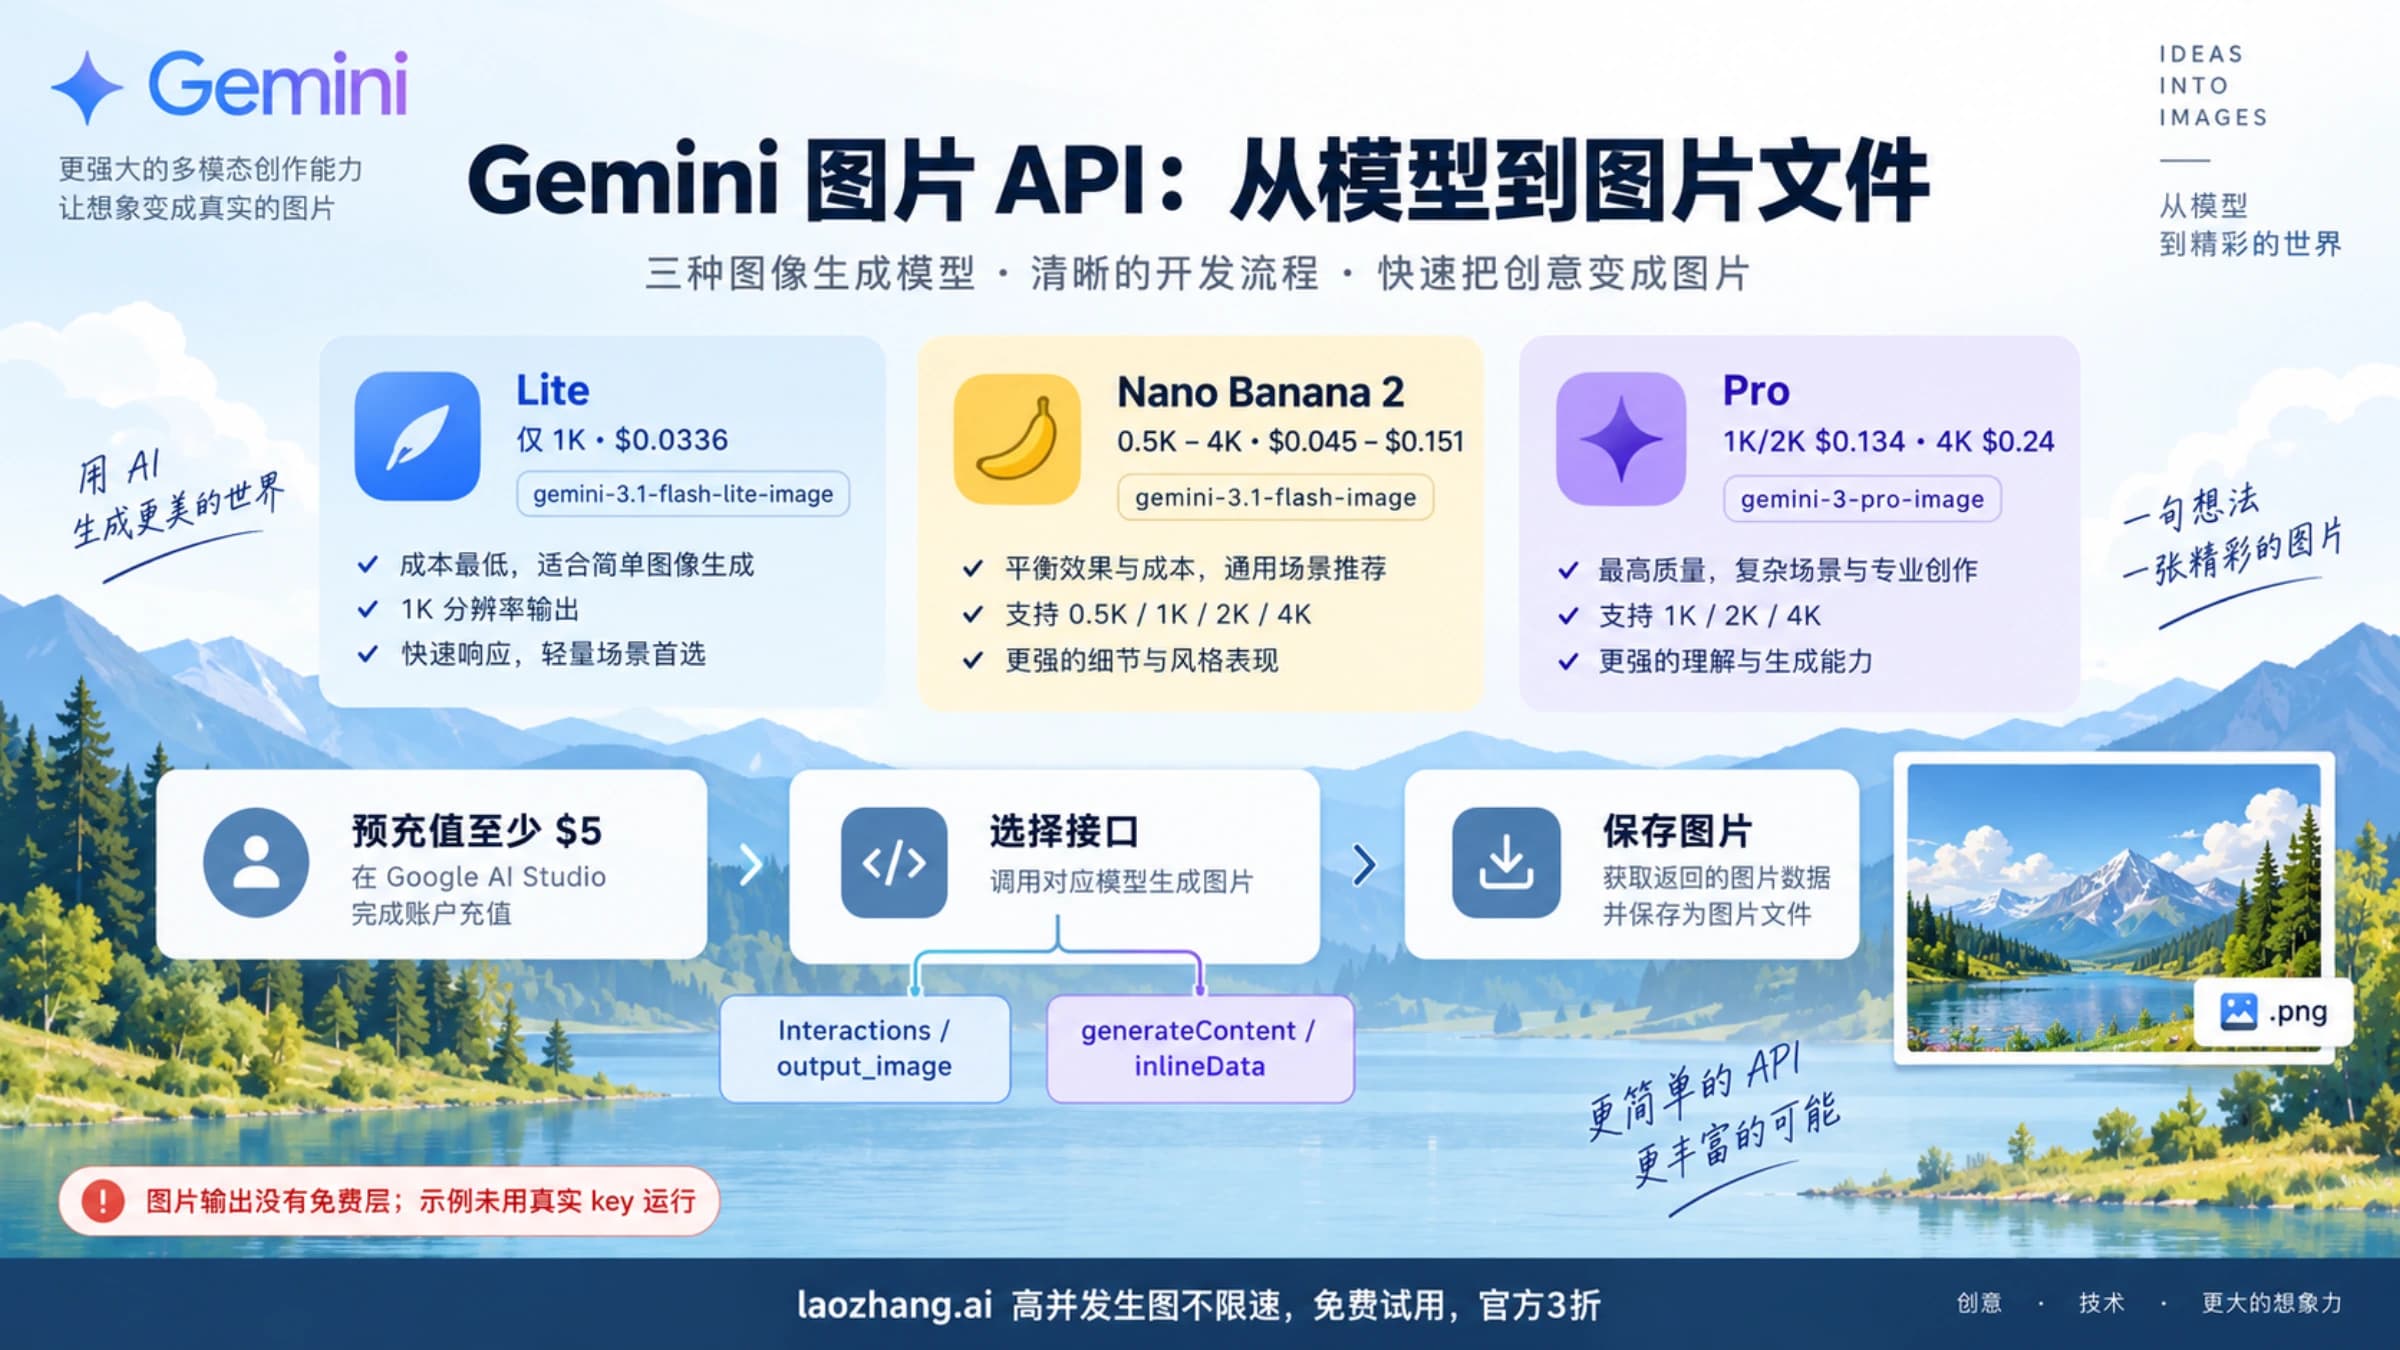
官方 Pro 模型是 gemini-3-pro-image。新接入可用 Interactions API;应用 JSON/YAML 要先校验和转换,响应要遍历图片内容,PDF 则先提取事实再交给 Pro 生图。
文章目录

Nano Banana Pro 的官方模型 ID 是 gemini-3-pro-image。 新项目可以从 Google Interactions API 接入:请求用 model、input 和 response_format,返回图片从 steps 中提取。已有 generateContent 项目仍受支持,但请求体和响应解析必须成套保留。Google 图片生成文档、Interactions 说明
如果你要把运营填写的创意 JSON、YAML 或 PDF 接进生图流程,关键是先处理输入:创意 JSON/YAML 是应用配置,PDF 是文档输入,它们都不能原样当作 Pro 图片请求。 下面先跑通文生图与图片保存,再给出配置转换和 PDF 衔接的完整代码。
本文按 2026 年 10 月 7 日核对的文档编写。请求字段有官方依据,配置转换、响应解析和合成数据流程经过离线检查;没有执行真实模型调用,也没有验证账号资格、画质、延迟或实际账单。配图用于说明流程。
官方最小请求:先生成一张 2K 海报
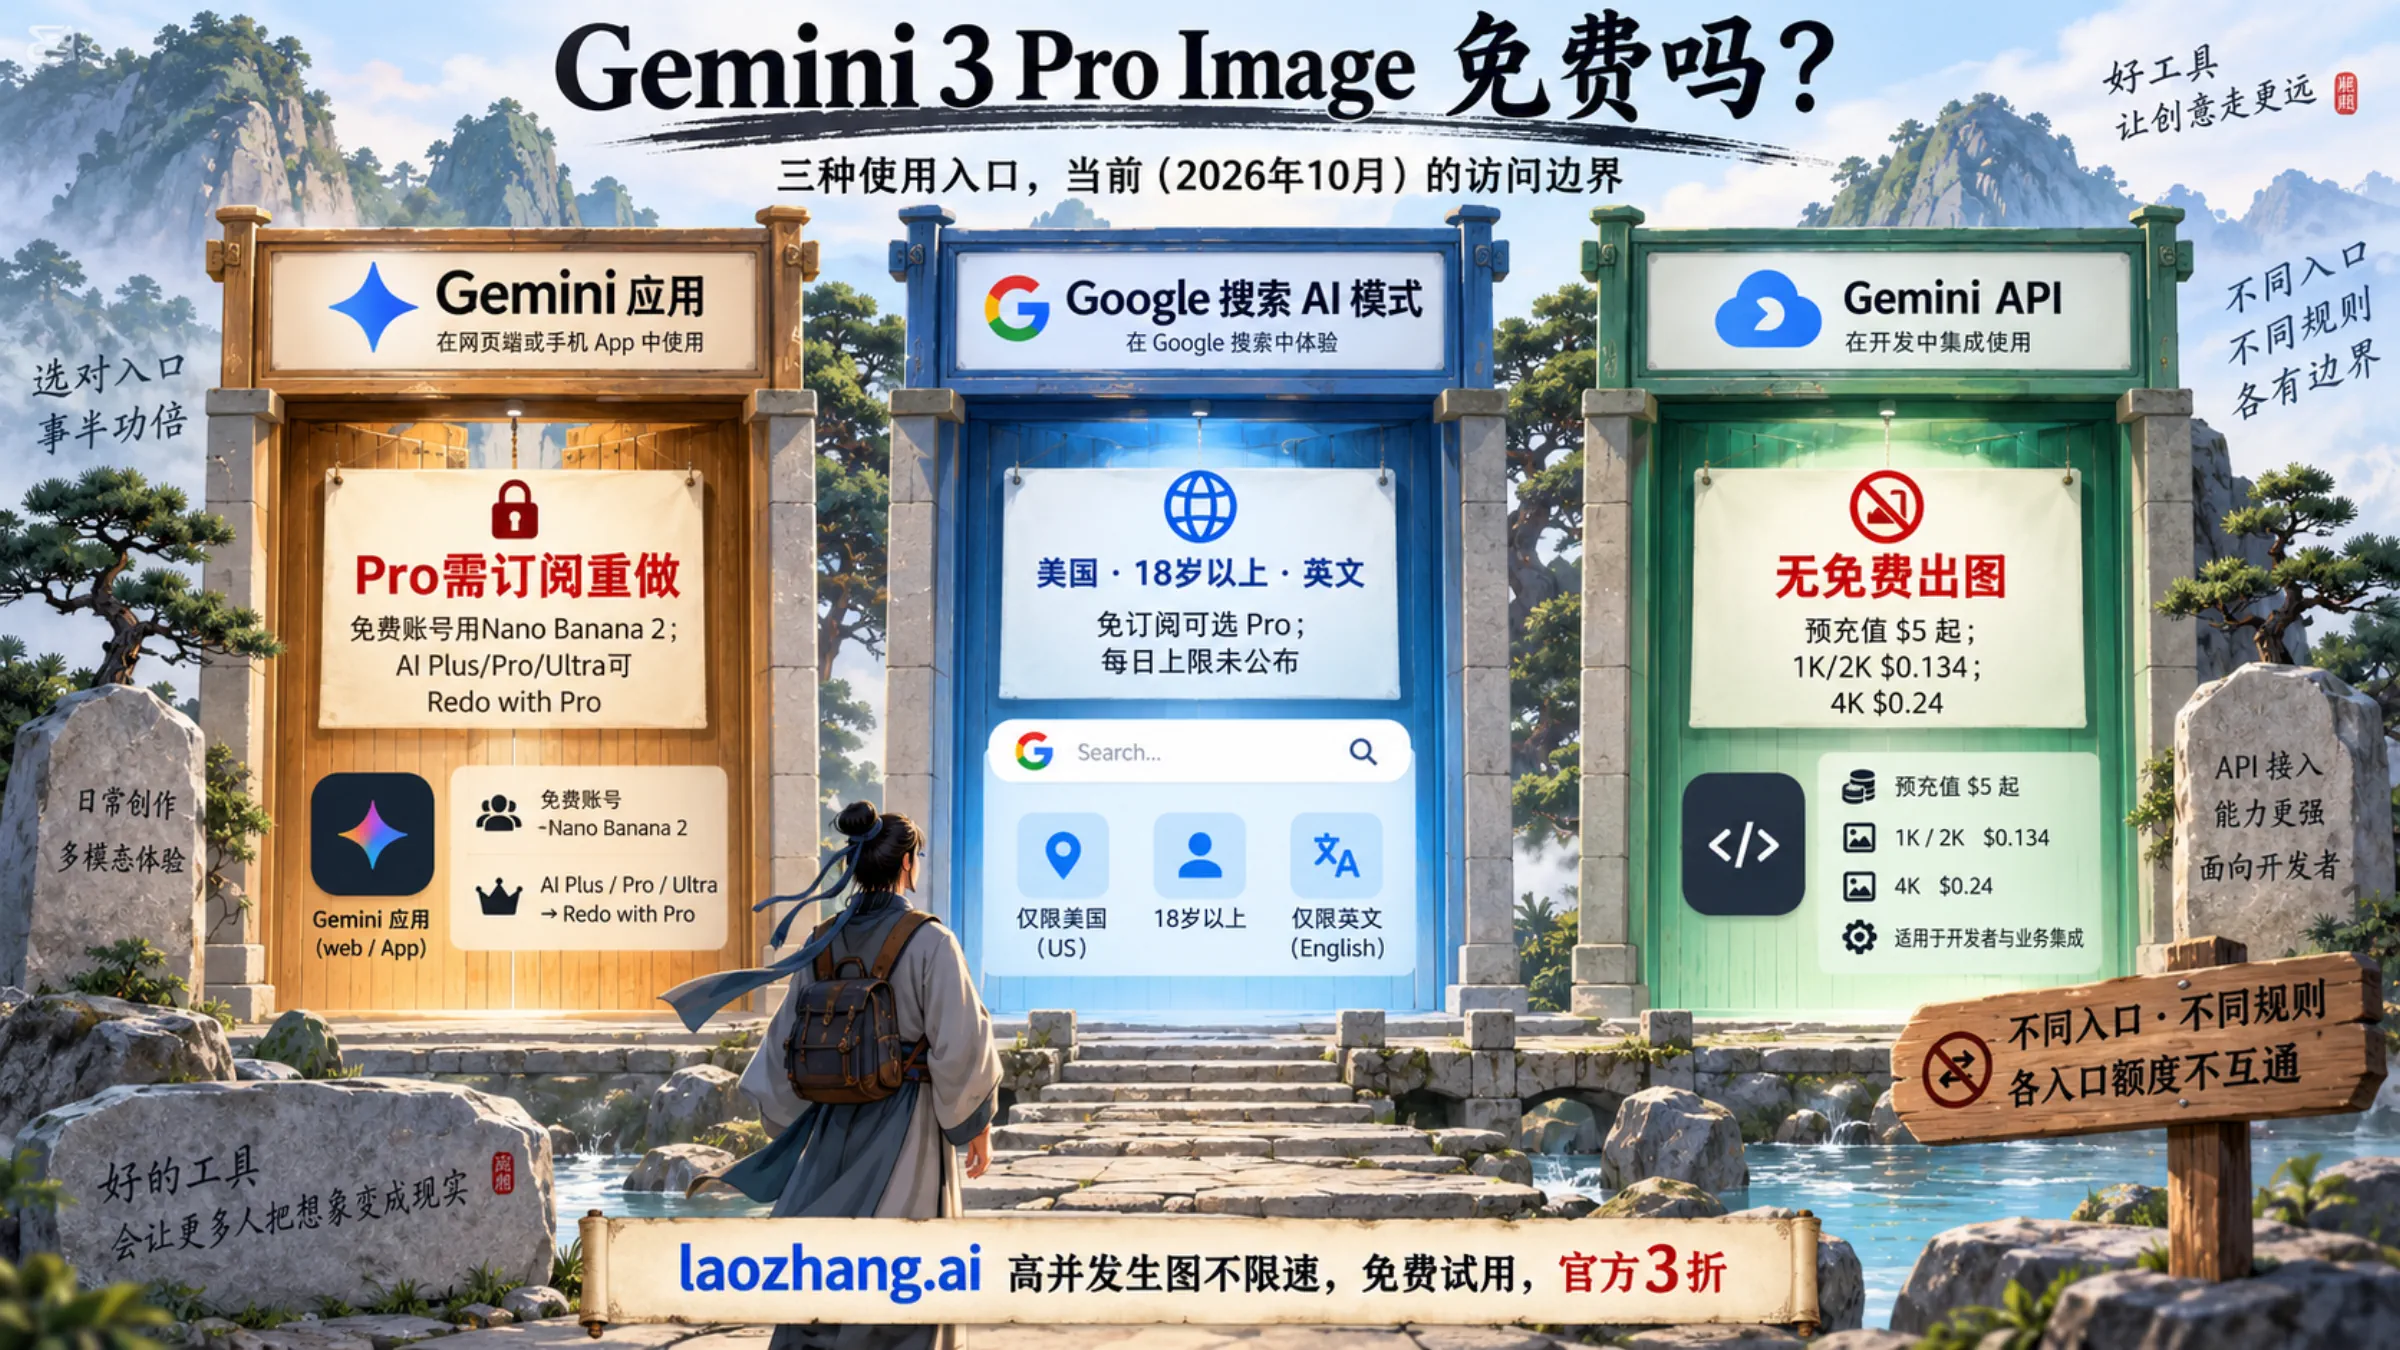
准备一个允许调用该模型、已配置计费的 Google 项目,以及该项目的 Gemini API 密钥。Pro 图片 API 的价格表没有免费档;能创建密钥或使用 AI Studio 界面,不代表这条 API 免费。API 密钥说明、官方价格
将以下内容保存为 request.json。这是 Google Interactions 请求体,可以直接用于下一条命令:
{
  "model": "gemini-3-pro-image",
  "input": [
    {
      "type": "text",
      "text": "为一家茶饮店制作夏季新品海报。主体是一杯透明杯青柠气泡茶,浅绿色背景,产品居中。画面只出现“青柠气泡茶”和“夏日限定”两组中文。不要价格、人物、英文副标题或额外 Logo。"
    }
  ],
  "response_format": {
    "type": "image",
    "mime_type": "image/png",
    "aspect_ratio": "16:9",
    "image_size": "2K"
  },
  "store": false
}
在你自己的运行环境中设置 GEMINI_API_KEY,再发送请求。以下命令会产生实际 API 调用和相应费用;正文中的示例并未执行。密钥不要写进 JSON、前端代码或版本库。
curl --fail-with-body -sS -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" -H "x-goog-api-key: $GEMINI_API_KEY" -H "Content-Type: application/json" --data-binary @request.json -o response.jsonresponse.json 保留整个响应,下一节的解析器再把图片写入文件。不要把 HTTP 200 当作“图片已经生成”:还要检查响应中的错误、最终输出以及是否存在图片内容。
这里的 store: false 适合不依赖服务端历史的单次请求。Interactions 默认保存对象;关闭保存后,不能用这次 ID 继续服务端会话,也不能启用后台模式。连续编辑可选择保存交互并使用 previous_interaction_id,或由应用显式携带完整历史;这个 ID 只继承历史,工具和配置仍需按文档重新发送。store: false 本身不等于零数据保留。Interactions 生命周期与存储
2K、4K 和比例该怎么填?
Pro 的尺寸档位是大写 1K、2K、4K;支持的十种比例为 1:1、2:3、3:2、3:4、4:3、4:5、5:4、9:16、16:9、21:9。例如,官方表中 16:9 的 2K 是 2752 × 1536,4K 是 5504 × 3072;4K 并不意味着所有比例都是 4096 × 4096。 不要把 Flash 的额外比例和尺寸选项直接套到 Pro。Pro 图片规格表
提示词可以指定文字和构图,但清晰文字能力不保证每次拼写正确,要求“生成三张”也不保证返回三张。Pro 的 thinking 默认启用且不能关闭;不要从其他模型的教程复制“关闭思考”的参数。
保存完整响应,再按 MIME 保存全部图片
Interactions 不是 candidates[0].content.parts[0] 格式。应遍历 steps,只读取 type: model_output 的 content,再处理其中的图片。这样既不会把获取历史时出现的用户输入当成输出,也不会漏掉文字与图片交错返回的情况。SDK 的 .output_image 快捷属性只取最后一张图片,多图保存不能只依赖它。图片输出说明
下面保存为 save_images.py,使用 Python 标准库,无需 AI SDK。本页三个脚本统一使用 Python 3.9 或更新版本。它保留原始响应,另写文字与文件清单;图片扩展名按实际返回的 MIME 决定。第二个模式用于后文服务商的 generateContent 响应。
import base64
import json
import sys
from pathlib import Path

EXTENSIONS = {
    "image/png": ".png",
    "image/jpeg": ".jpg",
    "image/webp": ".webp",
}

def outputs(response, mode):
    if mode == "interactions":
        for step_index, step in enumerate(response.get("steps", [])):
            if step.get("type") != "model_output":
                continue
            for part_index, part in enumerate(step.get("content", [])):
                yield f"{step_index}-{part_index}", part
    elif mode == "generateContent":
        for candidate_index, candidate in enumerate(
            response.get("candidates", [])
        ):
            for part_index, part in enumerate(
                candidate.get("content", {}).get("parts", [])
            ):
                if part.get("thought") is True:
                    continue
                if "inlineData" in part:
                    item = part["inlineData"]
                    yield f"{candidate_index}-{part_index}", {
                        "type": "image",
                        "mime_type": item.get("mimeType"),
                        "data": item.get("data"),
                    }
                elif "text" in part:
                    yield f"{candidate_index}-{part_index}", {
                        "type": "text", "text": part["text"]
                    }
    else:
        raise ValueError("模式只能是 interactions 或 generateContent")

def save(response_file, output_dir, mode):
    raw = Path(response_file).read_bytes()
    response = json.loads(raw)
    folder = Path(output_dir)
    folder.mkdir(parents=True, exist_ok=False)
    (folder / "response.json").write_bytes(raw)
    if response.get("error"):
        raise RuntimeError(json.dumps(response["error"], ensure_ascii=False))
    images, texts = [], []
    for index, part in outputs(response, mode):
        if part.get("type") == "text":
            texts.append(part.get("text", ""))
        elif part.get("type") == "image":
            mime = part.get("mime_type")
            if mime not in EXTENSIONS:
                raise ValueError(f"未处理的图片 MIME:{mime}")
            data = part.get("data")
            if not isinstance(data, str) or not data:
                raise ValueError("图片缺少内联 base64,需按实际响应另行处理")
            image_bytes = base64.b64decode(data, validate=True)
            if not image_bytes:
                raise ValueError("图片字节为空")
            filename = f"image-{index}{EXTENSIONS[mime]}"
            (folder / filename).write_bytes(image_bytes)
            images.append({"file": filename, "mime_type": mime})
    (folder / "text.txt").write_text(
        chr(10).join(texts), encoding="utf-8"
    )
    (folder / "manifest.json").write_text(
        json.dumps({"images": images}, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )
    if not images:
        raise RuntimeError("没有最终图片;原始响应和文字已保存,请检查原因")
    return images

if __name__ == "__main__":
    if len(sys.argv) != 4:
        raise SystemExit(
            "用法:python3 save_images.py 响应.json 新输出目录 模式"
        )
    print(json.dumps(save(*sys.argv[1:]), ensure_ascii=False))
执行:
python3 save_images.py response.json result-001 interactions每次使用一个新目录,避免覆盖上次产物。成功时,目录中会有原始 response.json、text.txt、manifest.json 和按 MIME 命名的图片。清单有图片只能证明返回了图片字节;尺寸、文字、构图和业务可用性还要对实际图像检查。
若返回文本而没有图片,先读已保存的响应,区分模型未生成图片、内容拦截与解析格式错误。不要直接补一个 .png 后缀,也不要将思考内容当成最终图片。
把应用 JSON/YAML 转成官方请求,而不是直接提交
JSON 在这里有两种用途:request.json 是接口请求;设计需求也可以保存为 JSON 对象。后者由你的程序解释,不是 Google 官方提示词格式,更不等于模型的 Structured Output 能力。当前 Pro 模型卡明确列出 Structured Output 不受支持。Pro 模型卡
例如,将同一海报需求保存为 creative.json:
{
  "route": "google-interactions",
  "model": "gemini-3-pro-image",
  "creative": {
    "subject": "透明杯青柠气泡茶",
    "required_text": ["青柠气泡茶", "夏日限定"],
    "visual_rules": ["浅绿色背景", "产品居中", "杯身完整可见"],
    "forbidden": ["价格", "人物", "英文副标题", "额外 Logo"]
  },
  "output": {
    "aspect_ratio": "16:9",
    "image_size": "2K"
  },
  "reference_images": []
}
YAML 可以表达相同内容。保存为 creative.yaml,特别是比例要加引号,数组也应保持数组类型:
route: google-interactions
model: gemini-3-pro-image
creative:
  subject: 透明杯青柠气泡茶
  required_text:
    - 青柠气泡茶
    - 夏日限定
  visual_rules:
    - 浅绿色背景
    - 产品居中
    - 杯身完整可见
  forbidden:
    - 价格
    - 人物
    - 英文副标题
    - 额外 Logo
output:
  aspect_ratio: "16:9"
  image_size: "2K"
reference_images: []
以下 compile_request.py 先检查对象、字符串、数组、比例和尺寸,再把创意字段转换成自然语言,把规格放入 response_format。未知字段会报错,避免将拼错的参数悄悄丢掉。JSON 路径仅用标准库;读取普通 YAML 时需要运行环境已有 PyYAML,使用 safe_load,不执行 YAML 中的对象标签。
import base64
import json
import sys
from pathlib import Path
from typing import TypedDict

class Creative(TypedDict):
    subject: str
    required_text: list[str]
    visual_rules: list[str]
    forbidden: list[str]

class Output(TypedDict):
    aspect_ratio: str
    image_size: str

class AppConfig(TypedDict):
    route: str
    model: str
    creative: Creative
    output: Output
    reference_images: list[str]

RATIOS = {
    "1:1", "2:3", "3:2", "3:4", "4:3",
    "4:5", "5:4", "9:16", "16:9", "21:9",
}

def exact_keys(value, names, label):
    if not isinstance(value, dict) or set(value) != set(names):
        raise ValueError(f"{label} 必须且只能包含:{names}")

def string(value, label):
    if not isinstance(value, str) or not value.strip():
        raise ValueError(f"{label} 必须是非空字符串")
    return value

def strings(value, label):
    if not isinstance(value, list):
        raise ValueError(f"{label} 必须是字符串数组")
    return [string(item, label) for item in value]

def image_part(filename):
    raw = Path(filename).read_bytes()
    if raw.startswith(bytes([137, 80, 78, 71, 13, 10, 26, 10])):
        mime = "image/png"
    elif raw.startswith(bytes([255, 216, 255])):
        mime = "image/jpeg"
    elif raw[:4] == b"RIFF" and raw[8:12] == b"WEBP":
        mime = "image/webp"
    else:
        raise ValueError(f"参考图不是可识别的 PNG/JPEG/WebP:{filename}")
    return {
        "type": "image", "mime_type": mime,
        "data": base64.b64encode(raw).decode("ascii"),
    }

def compile_config(config: AppConfig):
    exact_keys(config, [
        "route", "model", "creative", "output", "reference_images"
    ], "应用配置")
    if config["route"] != "google-interactions":
        raise ValueError("此转换器仅支持 Google Interactions")
    if config["model"] != "gemini-3-pro-image":
        raise ValueError("此转换器仅针对 Pro 模型")
    creative = config["creative"]
    exact_keys(creative, [
        "subject", "required_text", "visual_rules", "forbidden"
    ], "creative")
    subject = string(creative["subject"], "subject")
    required = strings(creative["required_text"], "required_text")
    rules = strings(creative["visual_rules"], "visual_rules")
    forbidden = strings(creative["forbidden"], "forbidden")
    output = config["output"]
    exact_keys(output, ["aspect_ratio", "image_size"], "output")
    ratio = string(output["aspect_ratio"], "aspect_ratio")
    size = string(output["image_size"], "image_size")
    if ratio not in RATIOS or size not in {"1K", "2K", "4K"}:
        raise ValueError("比例或尺寸不在此 Pro 配置支持范围")
    references = strings(config["reference_images"], "reference_images")
    if len(references) > 14:
        raise ValueError("参考图总数超过 14")
    lines = [f"制作海报,主体:{subject}。"]
    if required:
        lines.append("必须出现且准确拼写的文字:" + "、".join(required))
    if rules:
        lines.append("构图要求:" + ";".join(rules))
    if forbidden:
        lines.append("不要出现:" + "、".join(forbidden))
    parts = [{"type": "text", "text": chr(10).join(lines)}]
    parts.extend(image_part(path) for path in references)
    return {
        "model": config["model"],
        "input": parts,
        "response_format": {
            "type": "image", "mime_type": "image/png",
            "aspect_ratio": ratio, "image_size": size,
        },
        "store": False,
    }

def load_config(filename):
    path = Path(filename)
    text = path.read_text(encoding="utf-8")
    if path.suffix.lower() == ".json":
        return json.loads(text)
    if path.suffix.lower() in {".yaml", ".yml"}:
        try:
            import yaml
        except ImportError as error:
            raise RuntimeError("YAML 读取需要 PyYAML;也可以使用 JSON") from error
        return yaml.safe_load(text)
    raise ValueError("输入文件应为 .json、.yaml 或 .yml")

if __name__ == "__main__":
    if len(sys.argv) != 3:
        raise SystemExit("用法:python3 compile_request.py 配置文件 请求.json")
    result = compile_config(load_config(sys.argv[1]))
    Path(sys.argv[2]).write_text(
        json.dumps(result, ensure_ascii=False, indent=2), encoding="utf-8"
    )
任选一种配置生成请求:
python3 compile_request.py creative.json request.json
python3 compile_request.py creative.yaml request.json
检查生成的 request.json,再用第一节的 curl 命令发送。配置转换本身不发网络请求,也不读取密钥。它检查的是我们定义的应用类型与已核对的字段,不是 Google 服务器的完整验证器。
图生图:将参考图片变成内联媒体字节
在配置中把 reference_images 改为已获准使用的本地图片路径数组,例如 ["product.png"]。转换器会读取实际文件,识别 MIME,编码成原始 base64,放在独立的 type: image 输入项中;data 不带 data:image/png;base64, 前缀。
14 张只是总数检查。官方还区分物体、人物和风格参考,并列出高保真任务的更小限制,不能把“最多 14 张”解释为任意 14 张都能保持细节。参考图越多,也越要检查是否存在相互冲突的要求。参考图与限制说明
这条示例选用内联图片,不代表所有原生接口都不支持 HTTPS。若现有 generateContent 工作流出现 Unsupported file URI type,可按图片引用与文件 URI 排错指南检查实际发送的值、地址有效期和接口条件;不要把另一套接口的 fileData 塞进本例。
PDF 转图:先提取并核对事实,再让 Pro 排版
Pro 模型卡声明文本和图片输入,不能从“Gemini 支持 PDF”推出 Pro 能直接读取 PDF。可用的衔接方式是:文档模型读 PDF → 提取带页码的事实 → 核对原文 → Pro 用已确认的文字和必要页面图片生成素材。 需要逐字保留合同、脚注或法律条款时,应使用文档排版与校对流程,普通生图无法承担这一保证。Pro 输入类型、PDF 文档处理
第一步:为文档模型构造 PDF 请求
下面的 pdf_workflow.py 包含三个本地动作:生成文档请求、提取文档响应中的文字,以及将已核对的事实交给前一节转换器。把它与 compile_request.py 放在同一目录。
PDF 请求使用文档指南示例的 gemini-3.8-flash,不使用 Pro。代码只生成文件;上传或调用由你在已批准的环境中执行。文档指南的 50 MB 或 1,000 页限制适用于文档处理路线,同时仍受总上下文限制;代码只检查字节数,不能代替 PDF 页数与内容检查。
import base64
import json
import sys
from pathlib import Path
from compile_request import compile_config, exact_keys, string

def write_json(filename, value):
    Path(filename).write_text(
        json.dumps(value, ensure_ascii=False, indent=2), encoding="utf-8"
    )

def pdf_request(source, destination):
    raw = Path(source).read_bytes()
    if not raw.startswith(b"%PDF-") or len(raw) > 50_000_000:
        raise ValueError("需要 PDF 文件,且此示例限定为不超过 50 MB")
    instruction = (
        "从报告中提取用于中文数据海报的事实。请返回一个 JSON 对象,"
        "包含 facts 数组,每项有 label、value、unit、page_refs、quote。"
        "page_refs 使用从 1 开始的 PDF 页码整数数组;"
        "quote 保留支持数值的原文。没有依据的字段不要补造。"
        "只返回 JSON,不要 Markdown 围栏。"
    )
    write_json(destination, {
        "model": "gemini-3.8-flash",
        "input": [
            {"type": "text", "text": instruction},
            {
                "type": "document", "mime_type": "application/pdf",
                "data": base64.b64encode(raw).decode("ascii"),
            },
        ],
        "store": False,
    })

def extracted_text(response_file, destination):
    response = json.loads(Path(response_file).read_text(encoding="utf-8"))
    if response.get("error"):
        raise ValueError("文档请求失败,请先检查原始响应")
    texts = [
        part["text"]
        for step in response.get("steps", [])
        if step.get("type") == "model_output"
        for part in step.get("content", [])
        if part.get("type") == "text" and isinstance(part.get("text"), str)
    ]
    if not texts:
        raise ValueError("文档响应没有最终文字")
    Path(destination).write_text(chr(10).join(texts), encoding="utf-8")

def handoff(source, destination):
    value = json.loads(Path(source).read_text(encoding="utf-8"))
    exact_keys(value, ["verified", "subject", "facts", "page_images"], "核对文件")
    if value["verified"] is not True:
        raise ValueError("先核对 PDF 原文,再明确标记 verified 为 true")
    if not isinstance(value["facts"], list) or not value["facts"]:
        raise ValueError("至少需要一项已核对事实")
    required, provenance = [], []
    for fact in value["facts"]:
        exact_keys(fact, ["label", "value", "unit", "page_refs", "quote"], "事实")
        label = string(fact["label"], "label")
        number = string(fact["value"], "value")
        unit = string(fact["unit"], "unit")
        quote = string(fact["quote"], "quote")
        pages = fact["page_refs"]
        if not isinstance(pages, list) or not pages or any(
            type(page) is not int or page < 1 for page in pages
        ):
            raise ValueError("page_refs 必须是非空正整数数组")
        required.append(f"{label}:{number}{unit}")
        provenance.append({
            "label": label, "page_refs": pages, "quote": quote
        })
    config = {
        "route": "google-interactions", "model": "gemini-3-pro-image",
        "creative": {
            "subject": string(value["subject"], "subject"),
            "required_text": required,
            "visual_rules": ["信息层级清楚", "数字和单位成组显示"],
            "forbidden": ["未提供的数字", "虚构来源", "额外统计结论"],
        },
        "output": {"aspect_ratio": "16:9", "image_size": "2K"},
        "reference_images": value["page_images"],
    }
    request = compile_config(config)
    write_json(destination, request)
    write_json(str(destination) + ".facts.json", provenance)

if __name__ == "__main__":
    actions = {
        "pdf-request": pdf_request,
        "extract-text": extracted_text,
        "handoff": handoff,
    }
    if len(sys.argv) != 4 or sys.argv[1] not in actions:
        raise SystemExit(
            "用法:python3 pdf_workflow.py "
            "pdf-request|extract-text|handoff 输入文件 输出文件"
        )
    actions[sys.argv[1]](*sys.argv[2:])
先将实际 PDF 保存为 report.pdf,在本地生成请求:
python3 pdf_workflow.py pdf-request report.pdf document-request.json确认文件允许发往选定服务后,再调用文档模型。这个请求也会产生文档模型费用:
curl --fail-with-body -sS -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" -H "x-goog-api-key: $GEMINI_API_KEY" -H "Content-Type: application/json" --data-binary @document-request.json -o document-response.json
python3 pdf_workflow.py extract-text document-response.json extracted.txt
提取指令要求模型返回 JSON,但本例没有配置强制输出约束。因此 extracted.txt 可能需要整理,不能把“能解析成 JSON”当作“数值正确”。打开原 PDF,对照标签、数值、单位、页码和原文,再编写第二步的核对文件。
第二步:只把已核对内容交给 Pro
将以下格式保存为 verified.json。其中的 18.6% 是合成演示数据,不能当成真实报告结论;实际使用时必须替换为自己核对过的内容,最后才设 verified: true。
{
  "verified": true,
  "subject": "某茶饮门店季度经营数据海报",
  "facts": [
    {
      "label": "季度营收同比增长",
      "value": "18.6",
      "unit": "%",
      "page_refs": [3],
      "quote": "合成示例:本季度营收同比增长 18.6%。"
    }
  ],
  "page_images": []
}
需要参考版式或图表时,把核对过的相关页面渲染为 PNG/JPEG/WebP,再把真实文件路径填入 page_images。只需要几项事实时可以保留空数组,无需把整本报告转换成参考图。
python3 pdf_workflow.py handoff verified.json request.json这会生成可交给 Pro 的 request.json,另存 request.json.facts.json 留下页码与原文。之后沿用第一节请求和第二节图片保存流程。代码只能检查类型和人工确认标记,不会自动证明你已核对原文,也不会保证图片中的数字正确;生成后还要逐项检查关键文字。
涉及客户或未公开资料时,先确认文档模型、生图模型、上传文件及本方日志各自允许的保存条件。Files API 的文件保存窗口和 Interactions 对象保存是两类控制;不能用删除一个对象推断整条链路已清空。具体核验可参考API 数据保留与零数据保留指南。
Google 与服务商接口:不能只换域名
先确定你付费和发密钥的对象,再选择请求格式。Google Interactions、Google 现有 generateContent 和服务商的兼容接口,名称接近,字段归属却不同:
| 路线 | 请求与响应 | 鉴权、费用归谁 |
|---|---|---|
| Google Interactions | input、response_format;解析 steps | Google 项目和密钥 |
Google generateContent | contents[].parts[]、对应生成配置;解析 candidates[].content.parts[] | Google 项目和密钥 |
| 服务商 Gemini 兼容接口 | 按该服务商规定的 contents 与配置 | 服务商密钥、计费和数据条款 |
| 服务商 OpenAI 兼容接口 | messages 及该服务商图片返回格式 | 服务商密钥、计费和数据条款 |
Google 说明旧 generateContent 仍受支持。迁移时一起替换 endpoint、请求构造和响应解析,而不是把 contents 改名后继续用旧解析器。Interactions 与旧接口的关系
以本站 LaoZhang API 的公开 Pro 文档为例,需要自定义比例或 2K/4K 时,文档给出的 Gemini 兼容请求可保存为 provider-request.json:
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
{
  "contents": [
    {
      "role": "user",
      "parts": [
        {"text": "生成青柠气泡茶海报,只出现“青柠气泡茶”和“夏日限定”,浅绿色背景,产品居中。"}
      ]
    }
  ],
  "generationConfig": {
    "responseModalities": ["TEXT", "IMAGE"],
    "imageConfig": {
      "aspectRatio": "16:9",
      "imageSize": "2K"
    }
  }
}
下面使用的是 LaoZhang API 密钥,不是 Google 密钥。调用和图片保存均按服务商响应处理:
curl --fail-with-body -sS -X POST "https://api.laozhang.ai/v1beta/models/gemini-3-pro-image:generateContent" -H "Authorization: Bearer $LAOZHANG_API_KEY" -H "Content-Type: application/json" --data-binary @provider-request.json -o provider-response.json
python3 save_images.py provider-response.json provider-result-001 generateContent
该文档另提供 /v1/chat/completions 文生图方式,固定 1:1/1K。需要本例的 16:9/2K,就应选它说明支持这些规格的路径,不能把 Interactions 的 response_format 移植过去强制改尺寸。
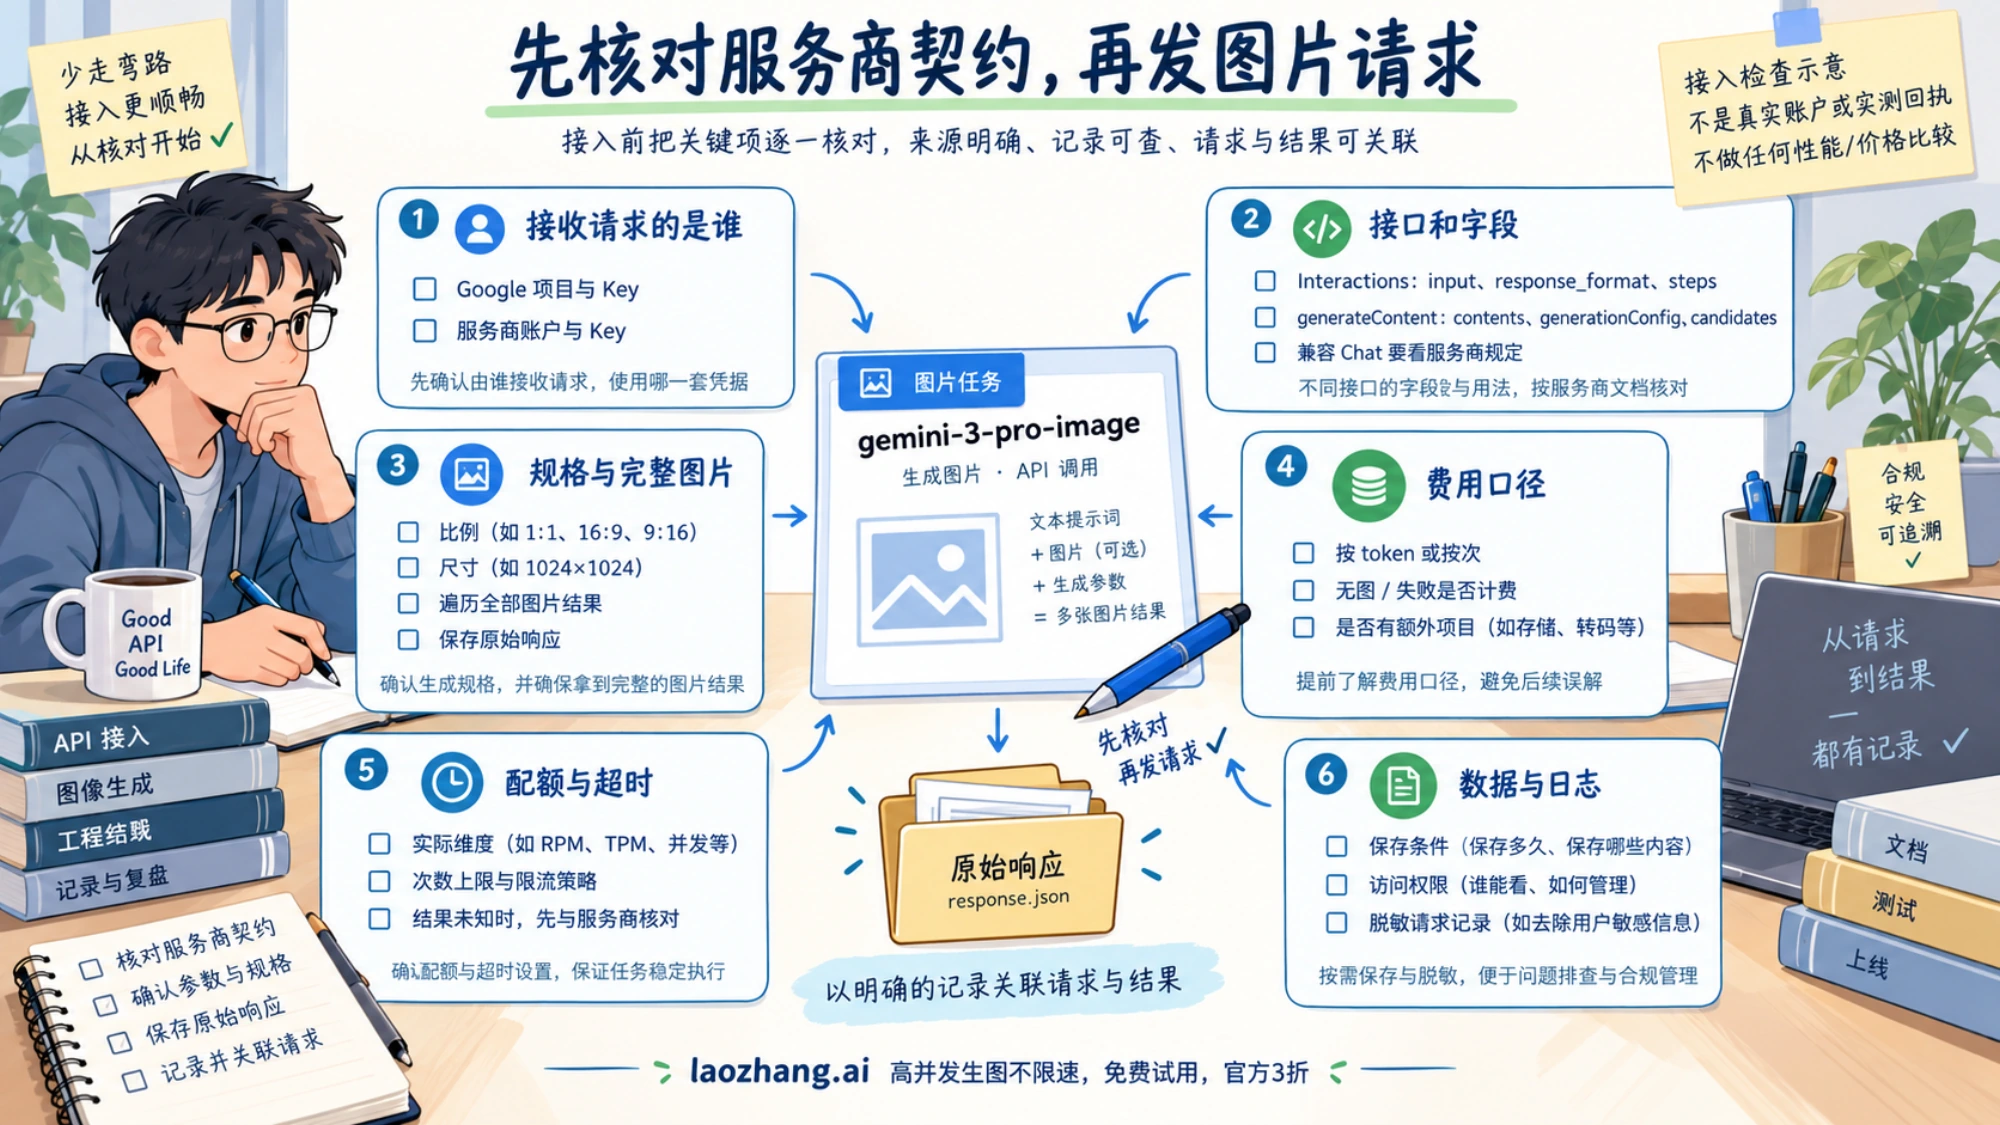
这张图用于说明核对项目,不是服务商与 Google 的质量评分或实测结果。LaoZhang API 的 2026 年 9 月 24 日公开文档列出 Pro 为每次 0.09 美元,并说明 HTTP 200 即扣一次,即使没有图片;这与 Google 的 token 计费不同。本文没有读取实时控制台价格或核对实际账单,也没有验证不同路线的质量和延迟,不能据此承诺总体更便宜。
密钥、价格和配额分别检查
密钥负责认证,费用与配额归项目。Google 当前政策并非“9 月以后所有 standard key 都不能用”:新 AI Studio 密钥自 2026 年 5 月 28 日默认采用 auth key;未限制的 standard key 请求被拒绝,已限制的 standard key 仍可工作。遇到认证错误,按实际密钥类型和 API 限制检查,不靠密钥前缀猜有效性。密钥政策
若使用 Gemini SDK,同时设置 GOOGLE_API_KEY 与 GEMINI_API_KEY 时,前者优先。本文 curl 显式引用后者,避免自动选择变量的歧义;采用 SDK 时仍需确认实际使用的密钥。Interactions 文档要求 Python google-genai 或 JavaScript @google/genai 从 2.3.0 起支持相关用法,本文未做 SDK 安装与运行测试。
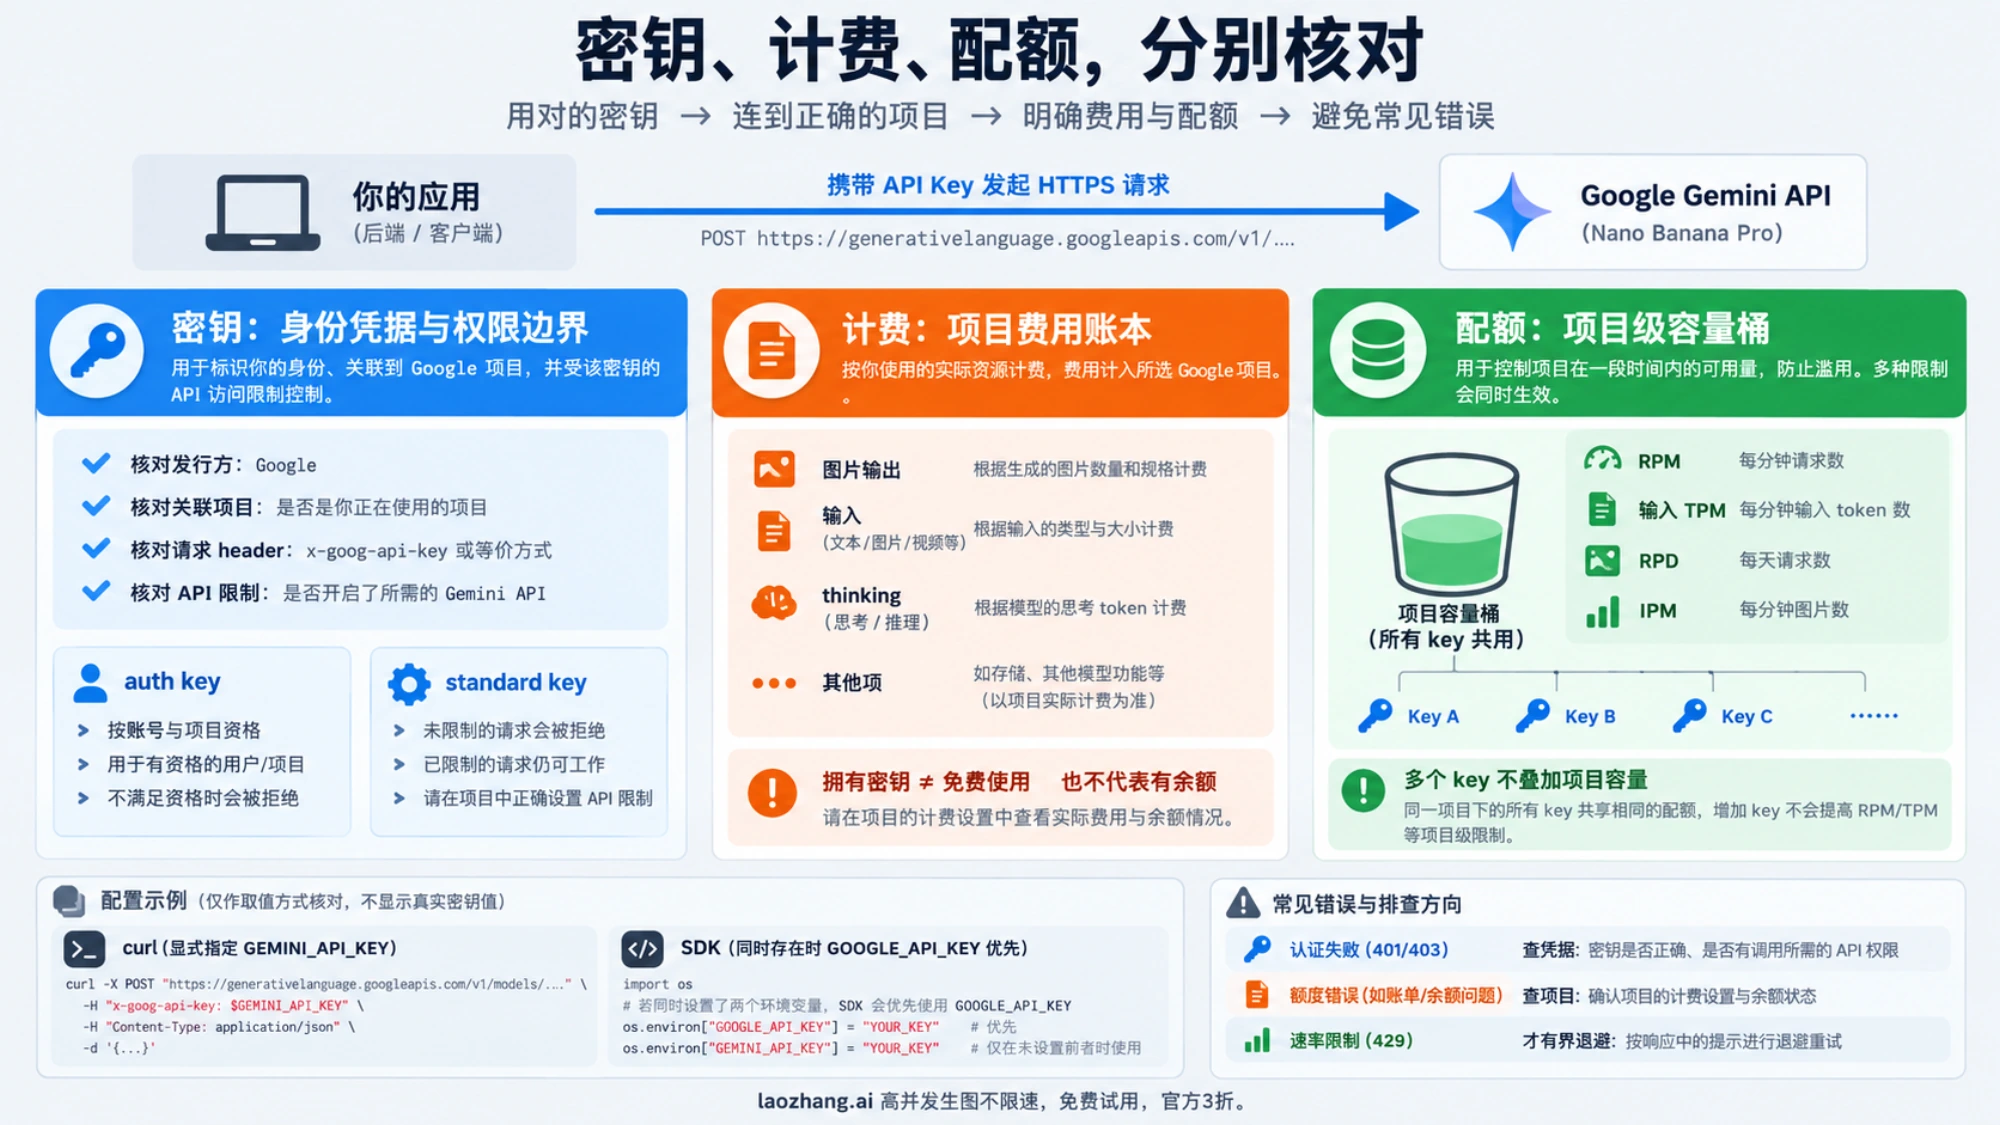
图用于区分三者职责;迁移日期、等级金额和当前资格以相邻官方资料为准。
一张图多少钱?先区分图片输出与整次请求
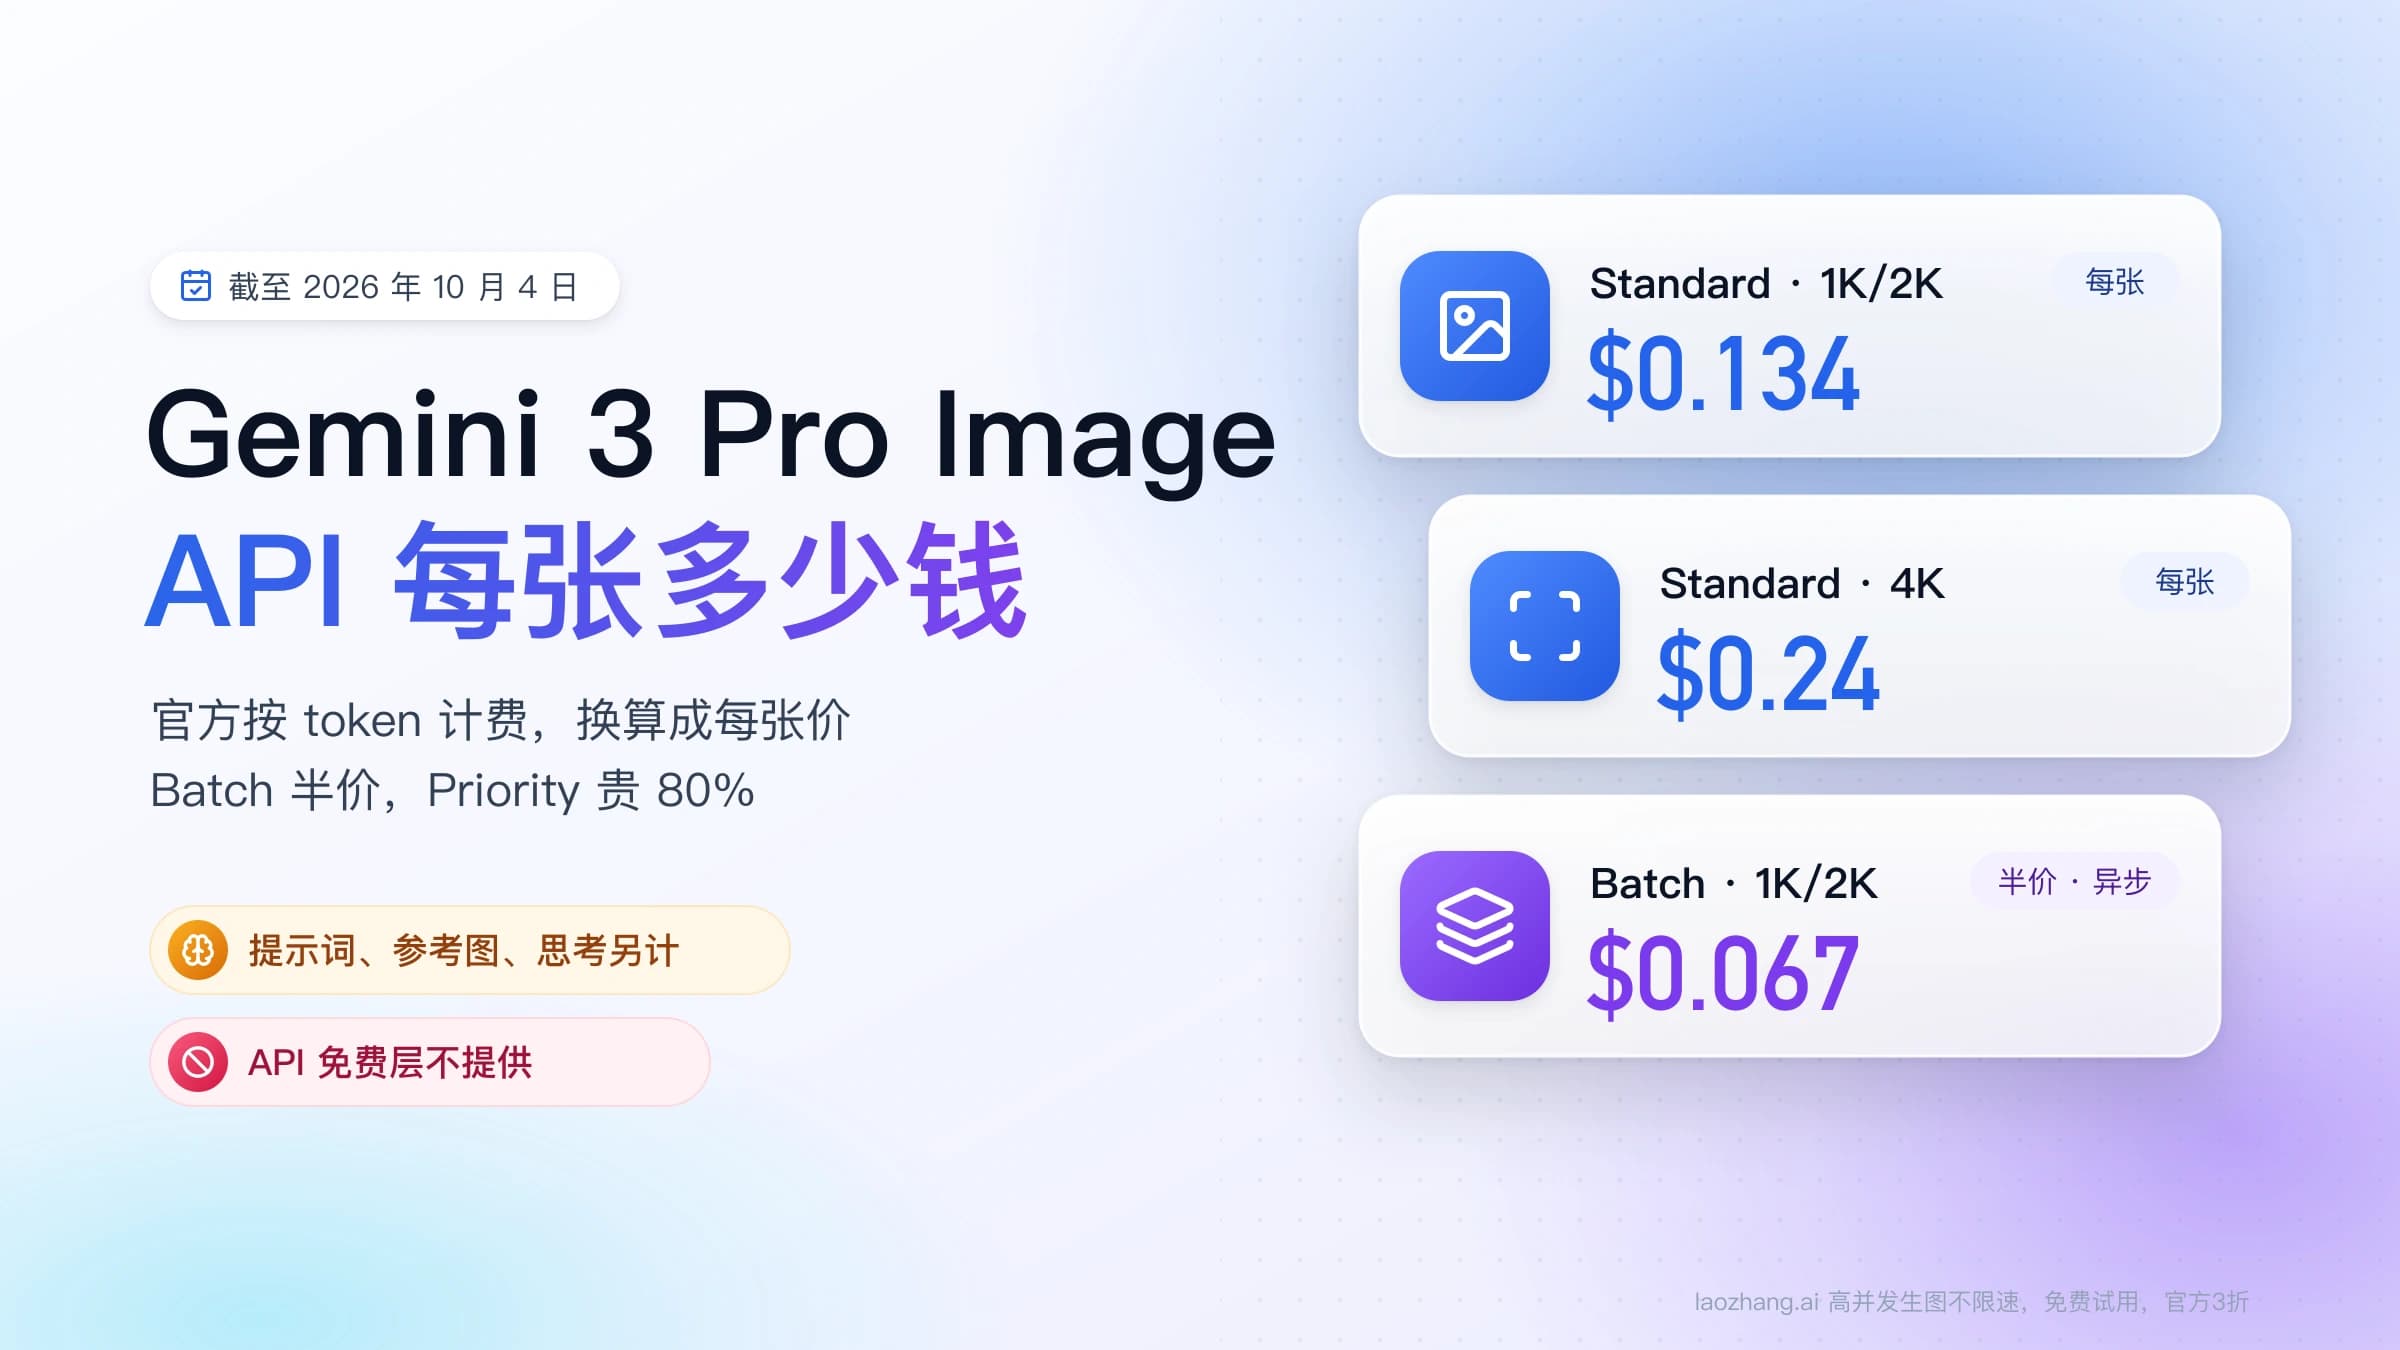
截至本次核对,Google Pro Standard 图片输出按每百万输出 token 120 美元计费,1K/2K 对应 1,120 token,4K 对应 2,000 token。价格表将前者显示为约 0.134 美元,精确乘法是 0.1344 美元;4K 为 0.24 美元。官方 Pro 价格表
| 输出规格 | Standard 图片输出部分 | 100 张的图片输出算术示例 |
|---|---|---|
| 1K 或 2K | 1,120 × 120 ÷ 1,000,000 = 0.1344 美元 | 13.44 美元 |
| 4K | 2,000 × 120 ÷ 1,000,000 = 0.24 美元 | 24 美元 |
这不是整次调用报价,也不是 100 张可用成品的保证。Standard 文本与图片输入按每百万 token 2 美元、文本及 thinking 输出按 12 美元计费;搜索、重试、税费和不可用产物也会影响总成本。用了 grounding 时,Gemini 3.x 共享每月 5,000 次搜索查询,超出后按每 1,000 次查询 14 美元计费;一次请求可能触发多次搜索,不能按 API 请求数直接折算。
Batch 价格表的图片输出为约 0.067 美元和 0.12 美元,但 Interactions 目前没有 Batch 支持,不能编造 /interactions/batch。Flex/Priority 的价格行与 Pro 模型卡的资格说明也存在冲突,所以本教程使用 Standard,不把价格表有某一行当成账号已经能用该服务等级。Interactions 功能边界、Pro 模型卡
429 怎么处理?看项目额度,不靠换 key
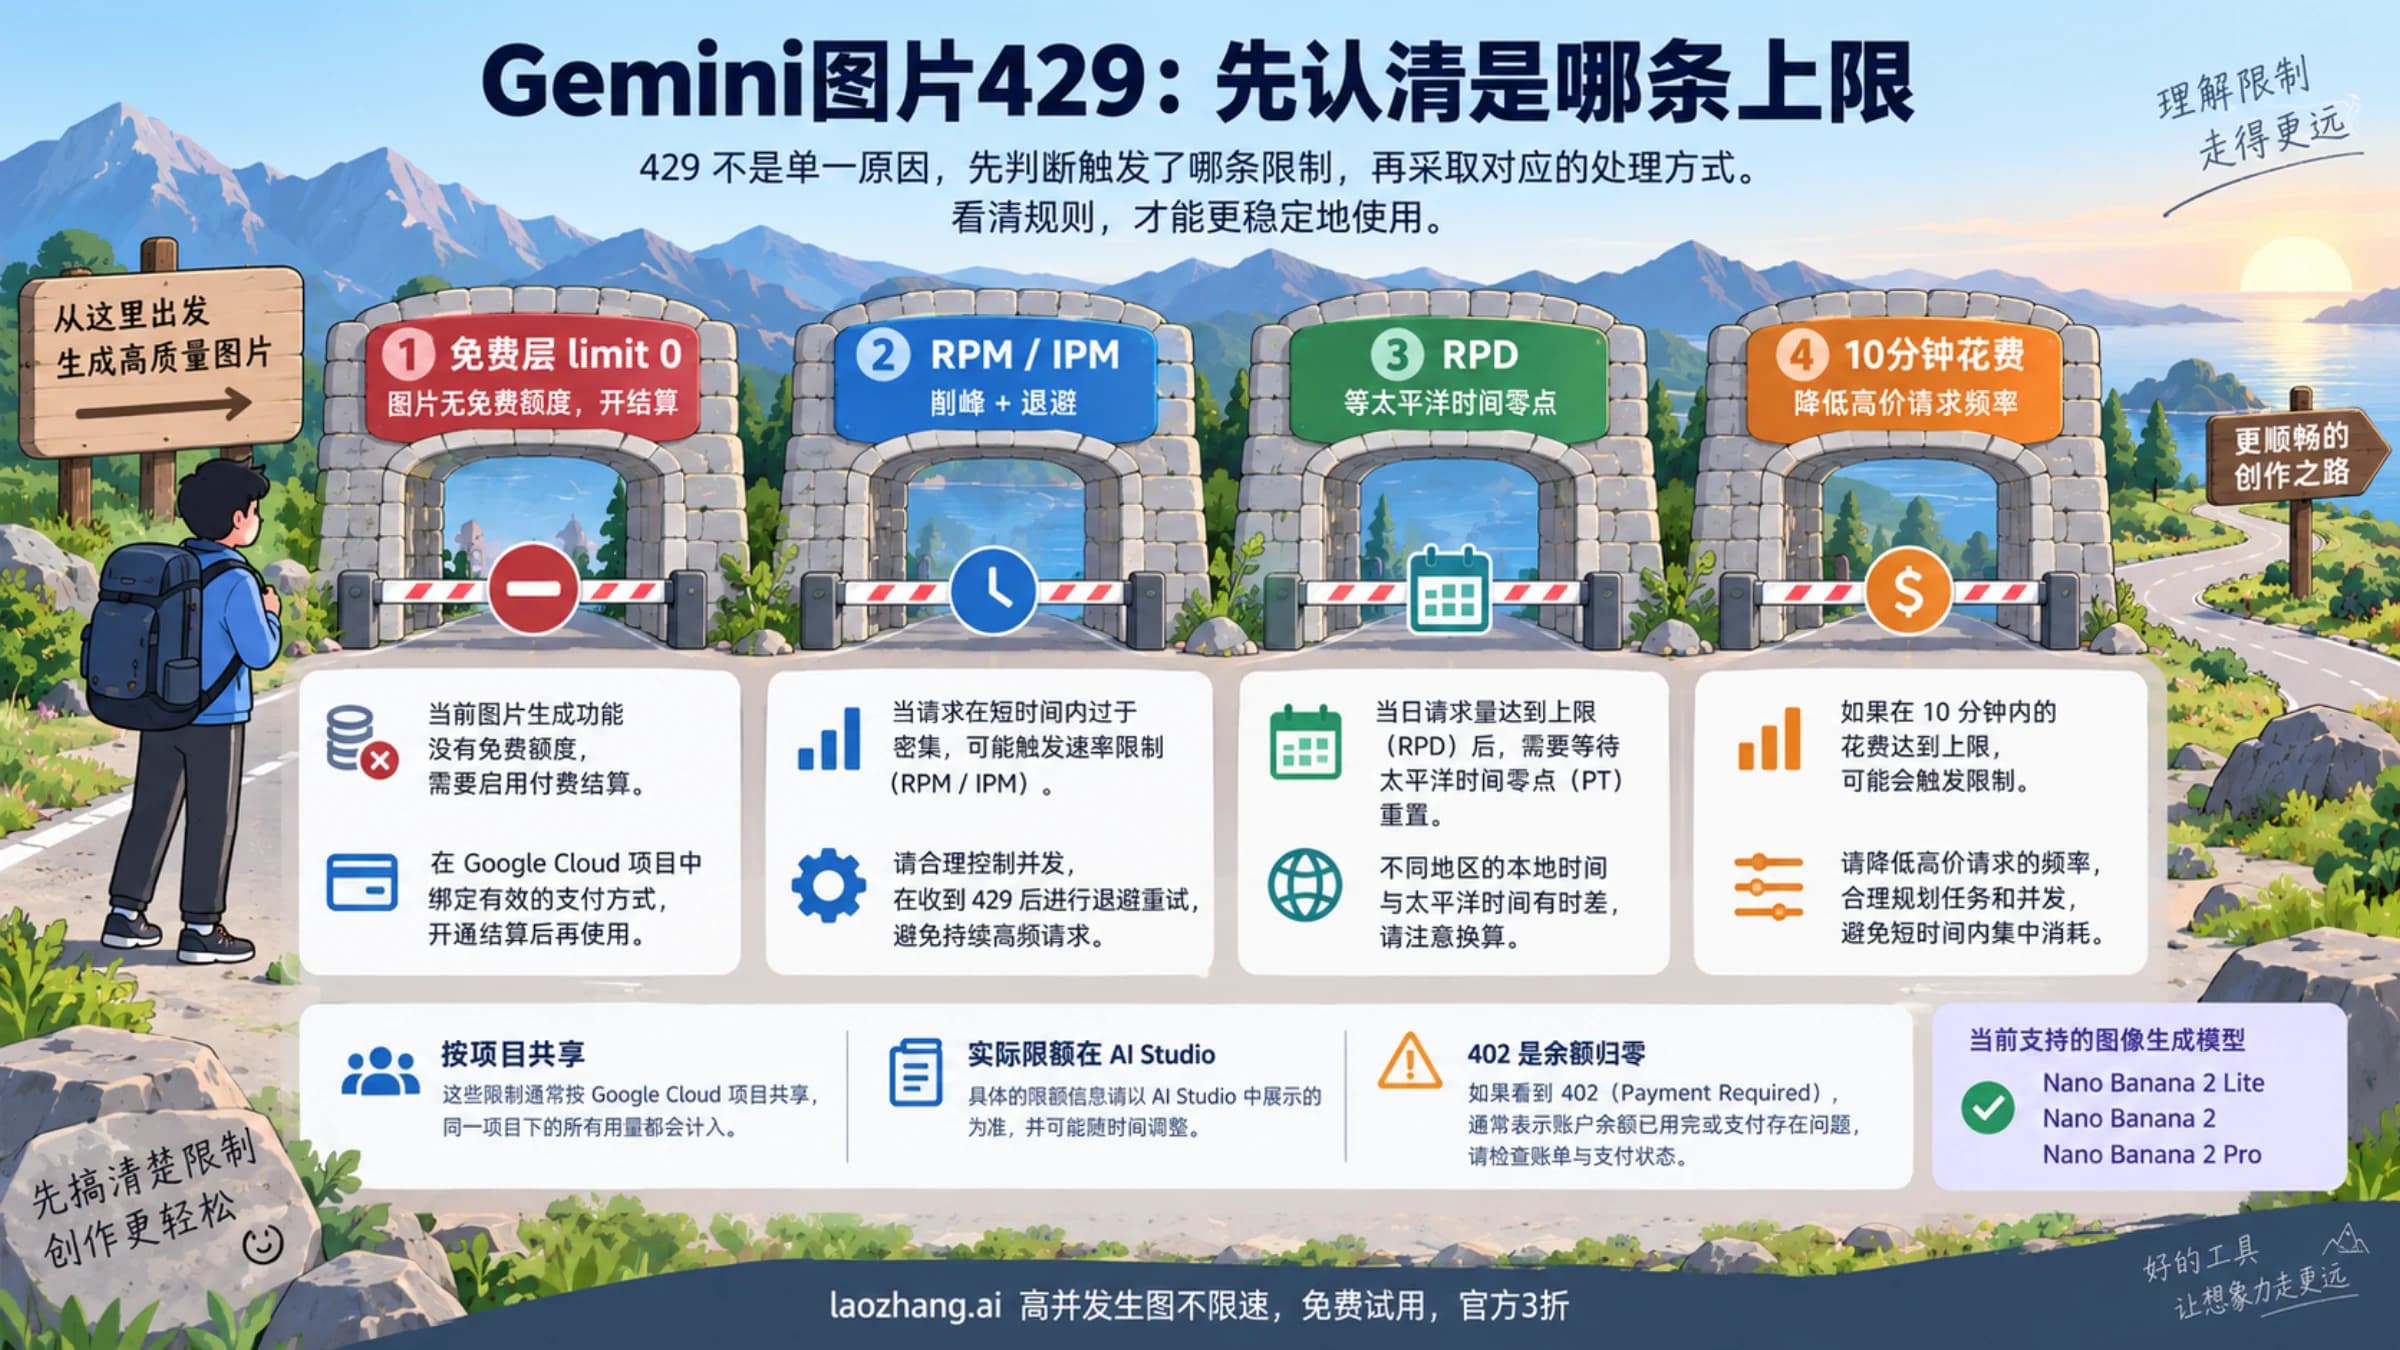
Google 限制按项目执行,涉及 RPM、输入 TPM、RPD 和图片 IPM。多个 key 不会叠加同一个项目的容量;日请求额度按太平洋时间午夜重置,仍需结合当前项目和模型的实际限制判断。Rate limits
排查时记录目标接口、模型、发生时间、并发量及错误正文,先区分瞬时速率限制、日额度耗尽和费用相关限制。前者可以降低并发并有界退避;后两者反复重试通常不能解决。不要把文档中的等级示例当成自己项目的实时额度。
按错误正文决定修请求、查资格还是重试
Interactions 的 error.code 和 error.message 提供比 HTTP 状态更具体的线索。保留脱敏请求信息和响应,再按对应原因处理。Interactions 错误说明
| 错误或症状 | 下一动作 |
|---|---|
400 invalid_request / parameter_unknown | 对照当前 endpoint 检查字段、大小写和类型;不要追加猜测参数 |
400 failed_precondition / 402 payment_required | 查具体资格或计费条件,先解决条件再调用 |
401 authentication / 403 permission_denied | 核对发行方、header、项目和权限;不要把 Google key 发送到服务商 |
404 model_not_found / not_found | 检查模型 ID、路径和实际可用性,别无依据改回 preview |
| 429 不同额度错误 | 区分速率、额度与费用限制,再减并发、等待或处理项目条件 |
| 200 但无图片 | 看原始响应与最终输出类型,区分拦截、模型未生成图片和解析器选错 |
| 500、503、504 | 判断是否暂时故障;若已有交互 ID 或结果,先检查,避免重复生成和费用 |
安全拦截如 image_safety、image_prohibited_content、image_recitation 应按拒绝原因处理输入,不以降低安全控制作为修复步骤。超时后允许的重试也应有次数上限、退避和抖动;超时不证明服务端没执行,所有重试也不保证免费。故障处理与重试
旧 gemini-3-pro-image-preview 已列入迁移记录,当前使用稳定 ID。截至本次核对,Google 没有公布稳定 Pro 的停用日期;新发布的 Nano Banana 2.1 是另一个模型,不能为了让示例运行而悄悄替换 Pro。模型停用与迁移说明
常见问题
Nano Banana Pro 有“官方 JSON 提示词”吗?
官方规定的是接口请求字段。你可以用 JSON 管理主体、文案和构图,再由应用转成 input 文本;任意创意对象不会自动成为官方请求。Pro 模型卡也没有 Structured Output 支持,不能把 JSON 输入组织方法写成输出能力。Pro 模型卡
YAML 能直接发给 Nano Banana Pro 吗?
本教程的 Google 接口提交 application/json。YAML 应先解析为对象、检查类型和业务规则,再映射成官方请求;compile_request.py 提供了这个过程。配置里不要存真实密钥,16:9 等比例值建议明确写成字符串。
PDF 可以直接作为 Pro 的图片输入吗?
不能按当前 Pro 模型卡作出这一承诺。使用文档模型提取并核对事实,必要时将选定页面渲染为图片,再交给 Pro。50 MB、1,000 页是文档路线条件,不能作为 Pro 直接接收 PDF 的依据。PDF 处理指南
返回了多张图,为什么程序只保存一张?
先检查是否只使用 SDK 的 .output_image、首个 Part 或首个输出块。该快捷属性只取最后一张;Interactions 应遍历最终模型输出中的图片内容。本页解析器保存所有返回图片,但不能保证请求指定的数量一定生成。图片输出说明
换成服务商后,Google 密钥和 JSON 还能原样用吗?
不能默认沿用。分别核对服务商的密钥、请求路径、字段、响应格式、尺寸能力和计费规则。本站服务商文档的 Gemini 兼容与 OpenAI 兼容路径也有规格差异,按所选路径构造请求。LaoZhang API Pro 文档
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
- 1.Google 图片生成文档ai.google.dev/gemini-api/docs/image-generation
- 2.Interactions 说明ai.google.dev/gemini-api/docs/interactions-overview
- 3.API 密钥说明ai.google.dev/gemini-api/docs/api-key
- 4.官方价格ai.google.dev/gemini-api/docs/pricing
- 5.Pro 模型卡ai.google.dev/gemini-api/docs/models/gemini-3-pro-image
- 6.PDF 文档处理ai.google.dev/gemini-api/docs/document-processing
- 7.Rate limitsai.google.dev/gemini-api/docs/rate-limits
- 8.Interactions 错误说明ai.google.dev/gemini-api/docs/api-errors
- 9.故障处理与重试ai.google.dev/gemini-api/docs/troubleshooting
- 10.模型停用与迁移说明ai.google.dev/gemini-api/docs/deprecations