Gemini 3.5 Transcribe API 指南:预录转写、实时字幕与验证方法
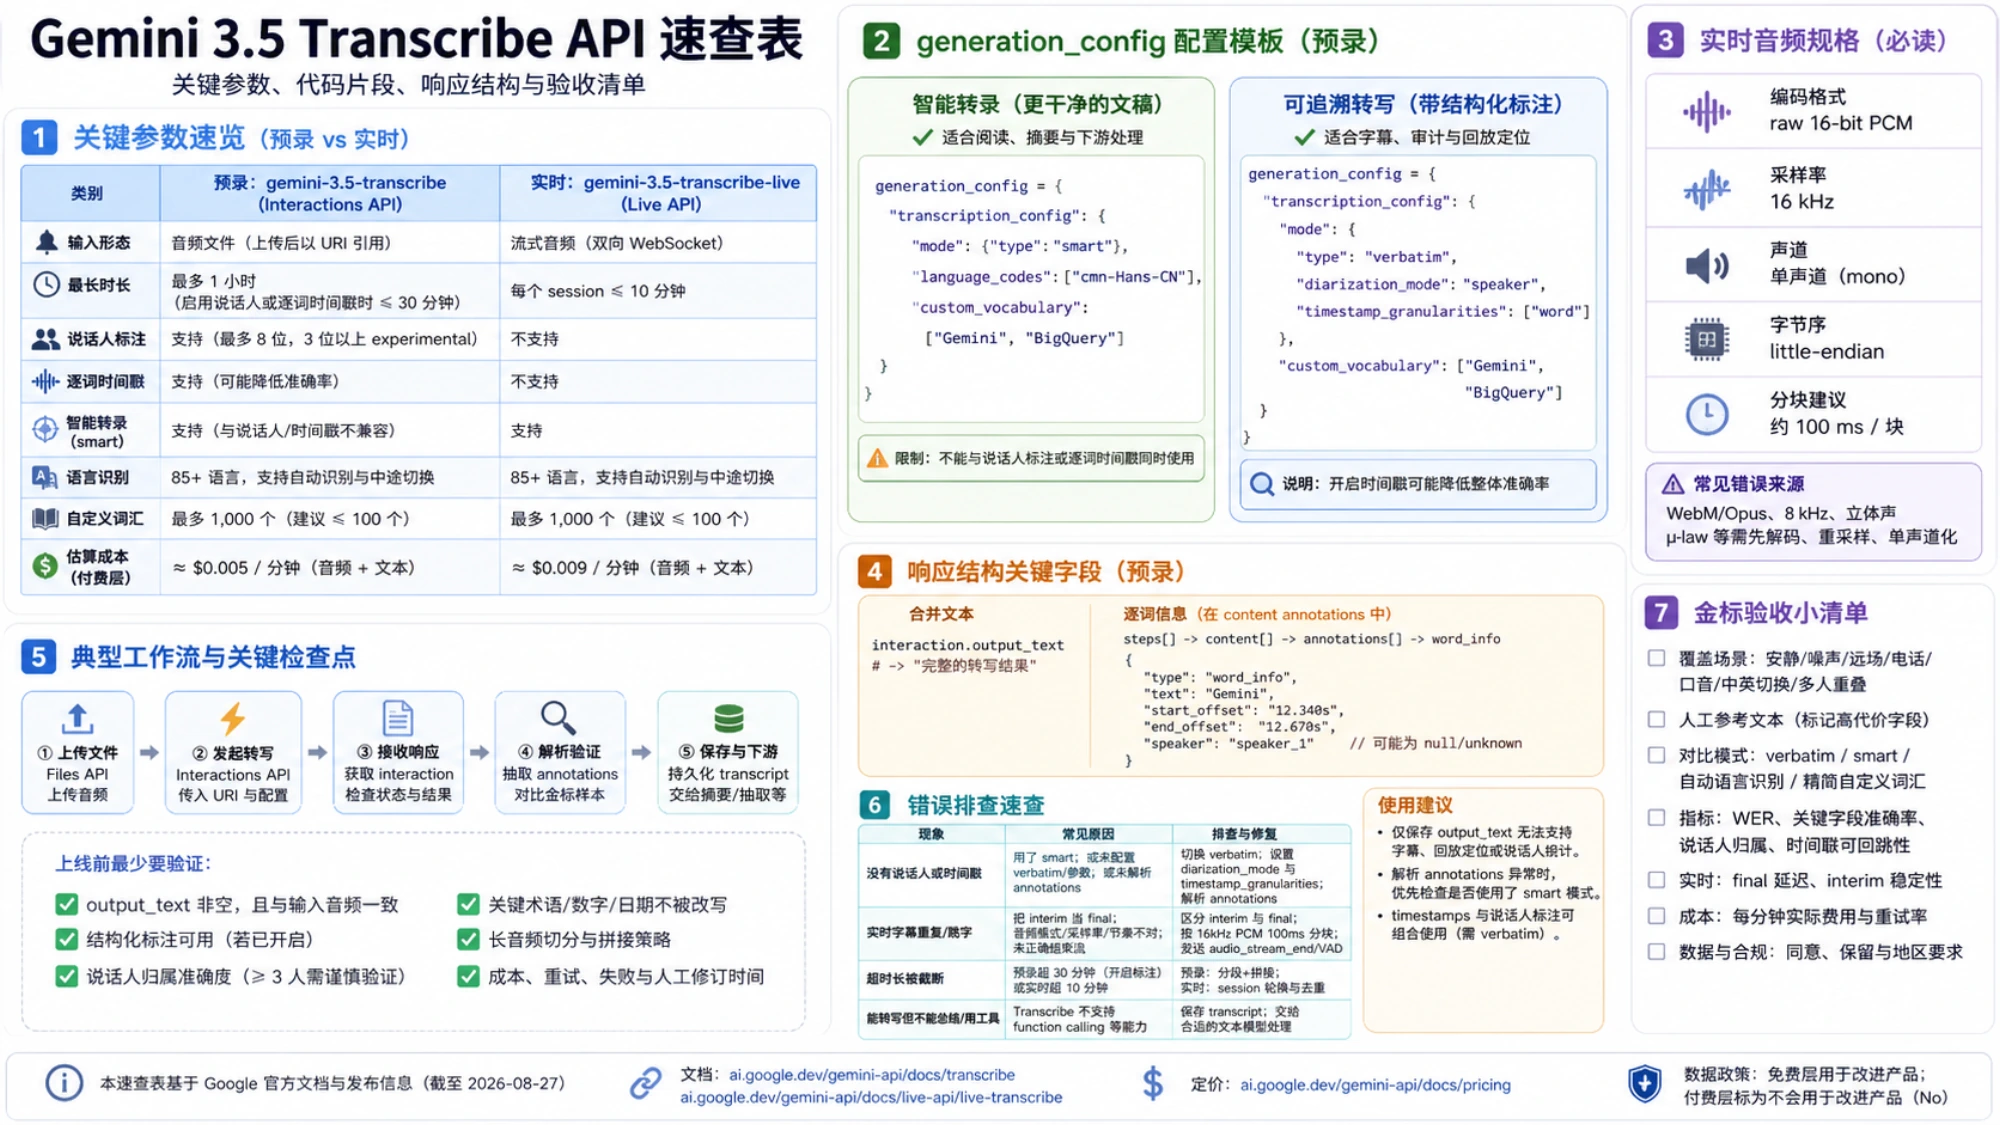
已有录音用 gemini-3.5-transcribe,实时音频用 gemini-3.5-transcribe-live。预录的词表与说话人、逐词时间戳不能同时开启;实时字幕要分别处理临时和最终结果,并在音频结束后限时收尾。
文章目录
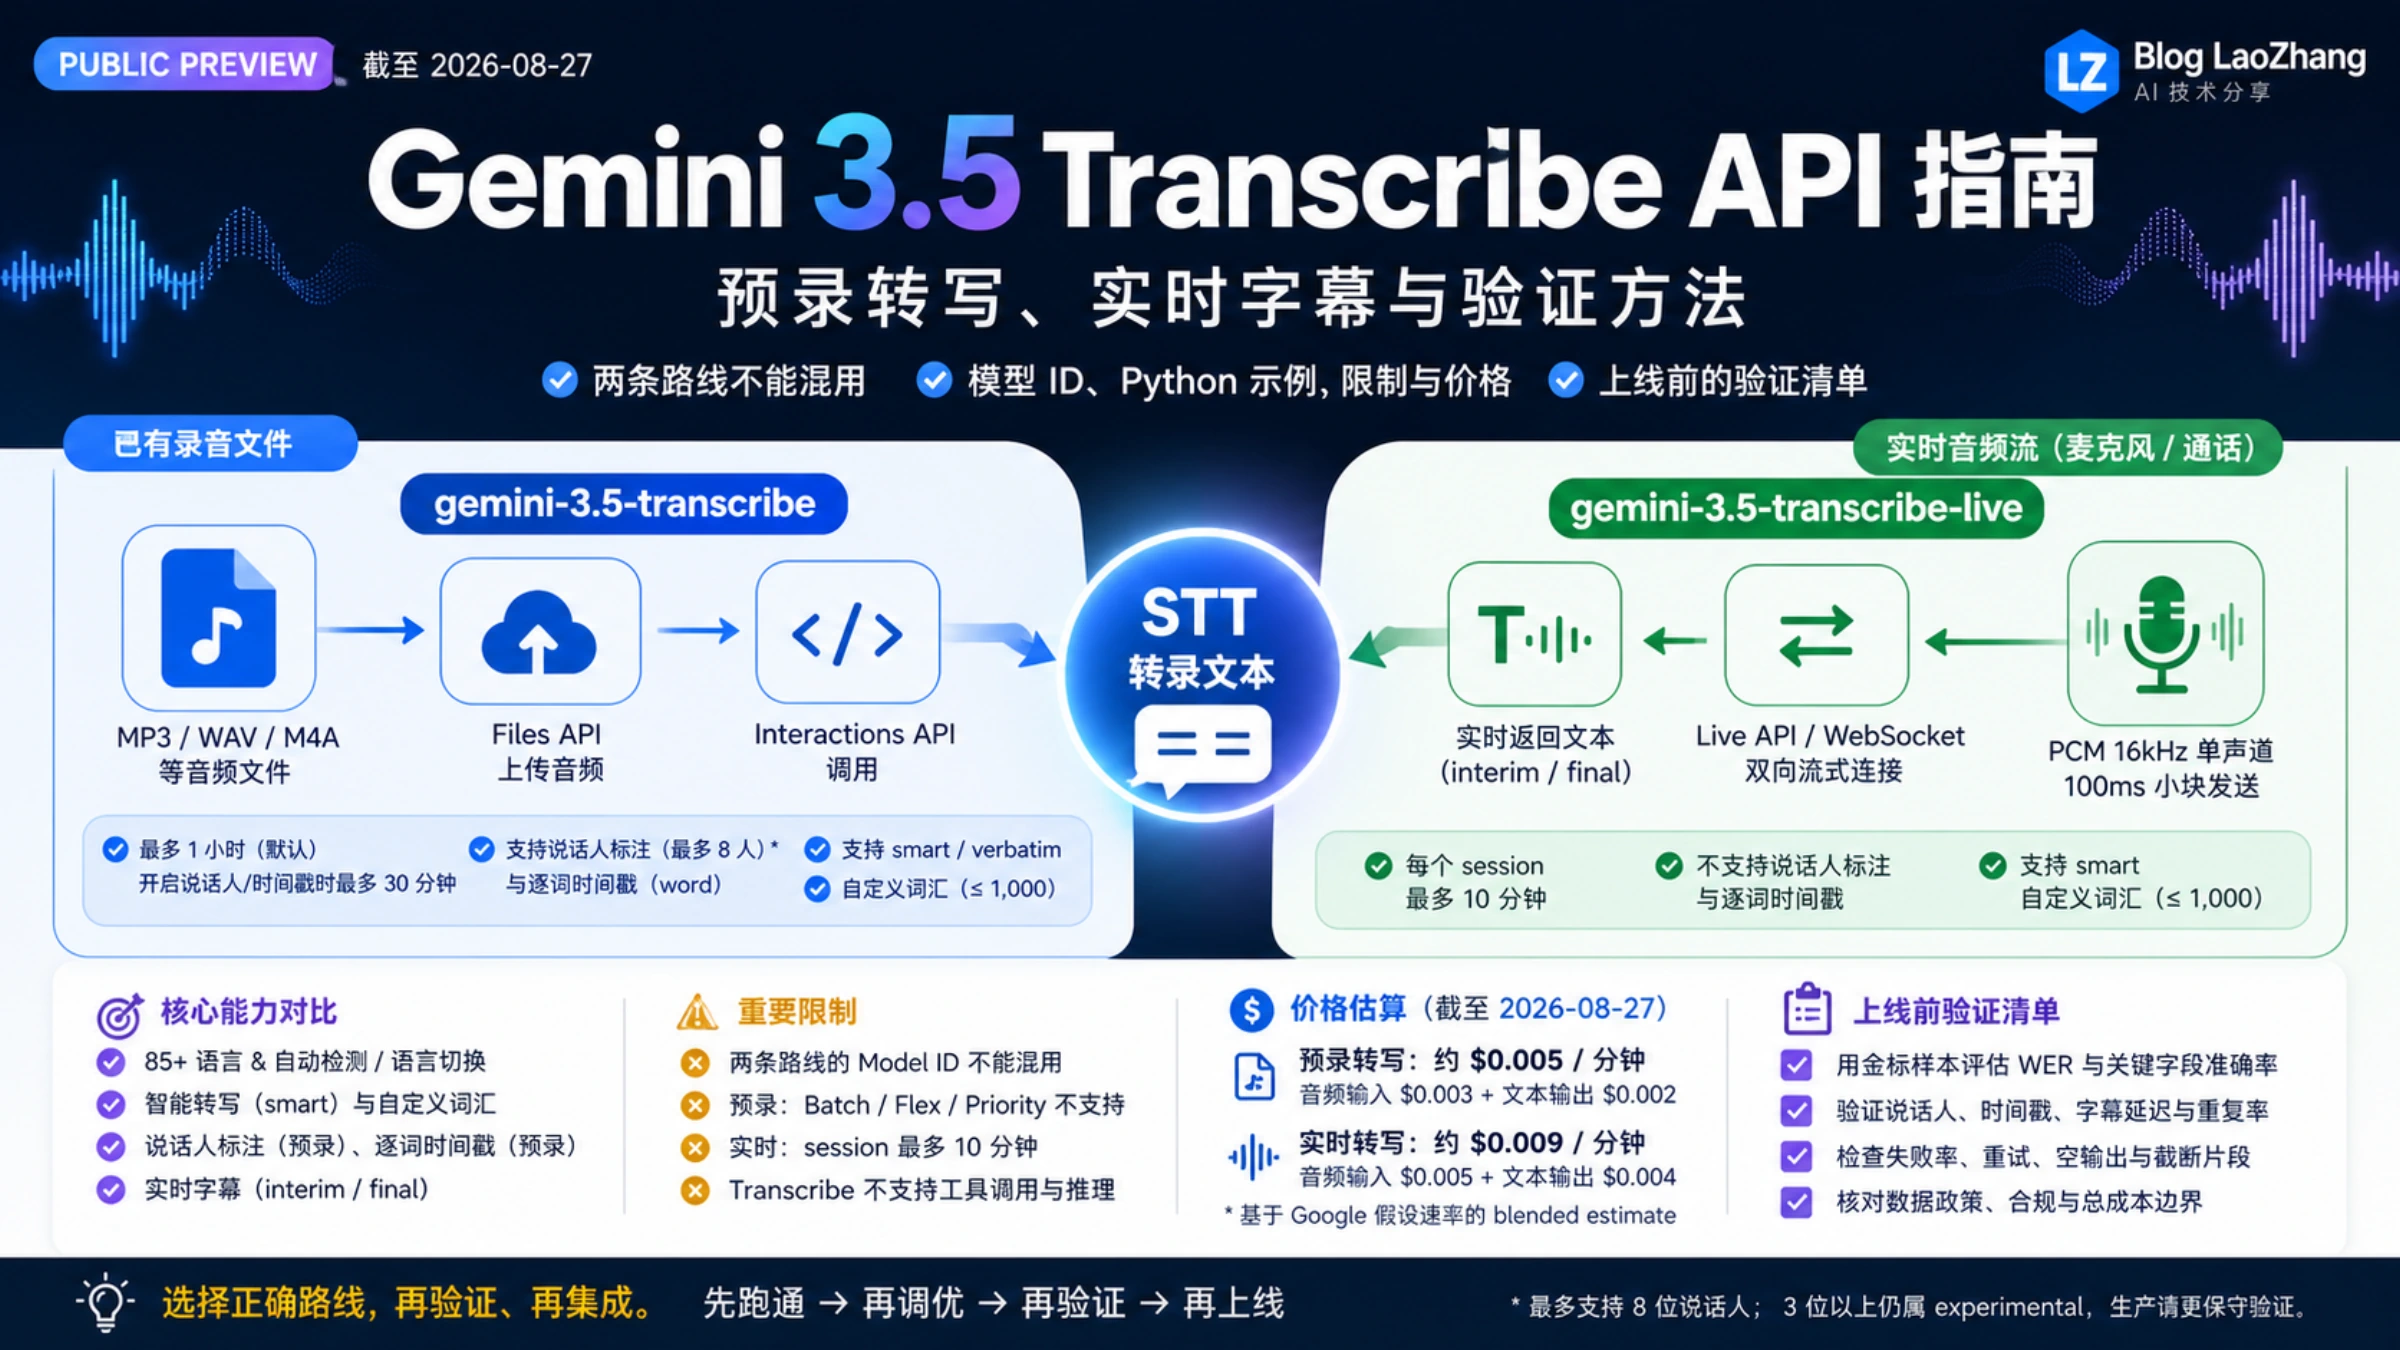
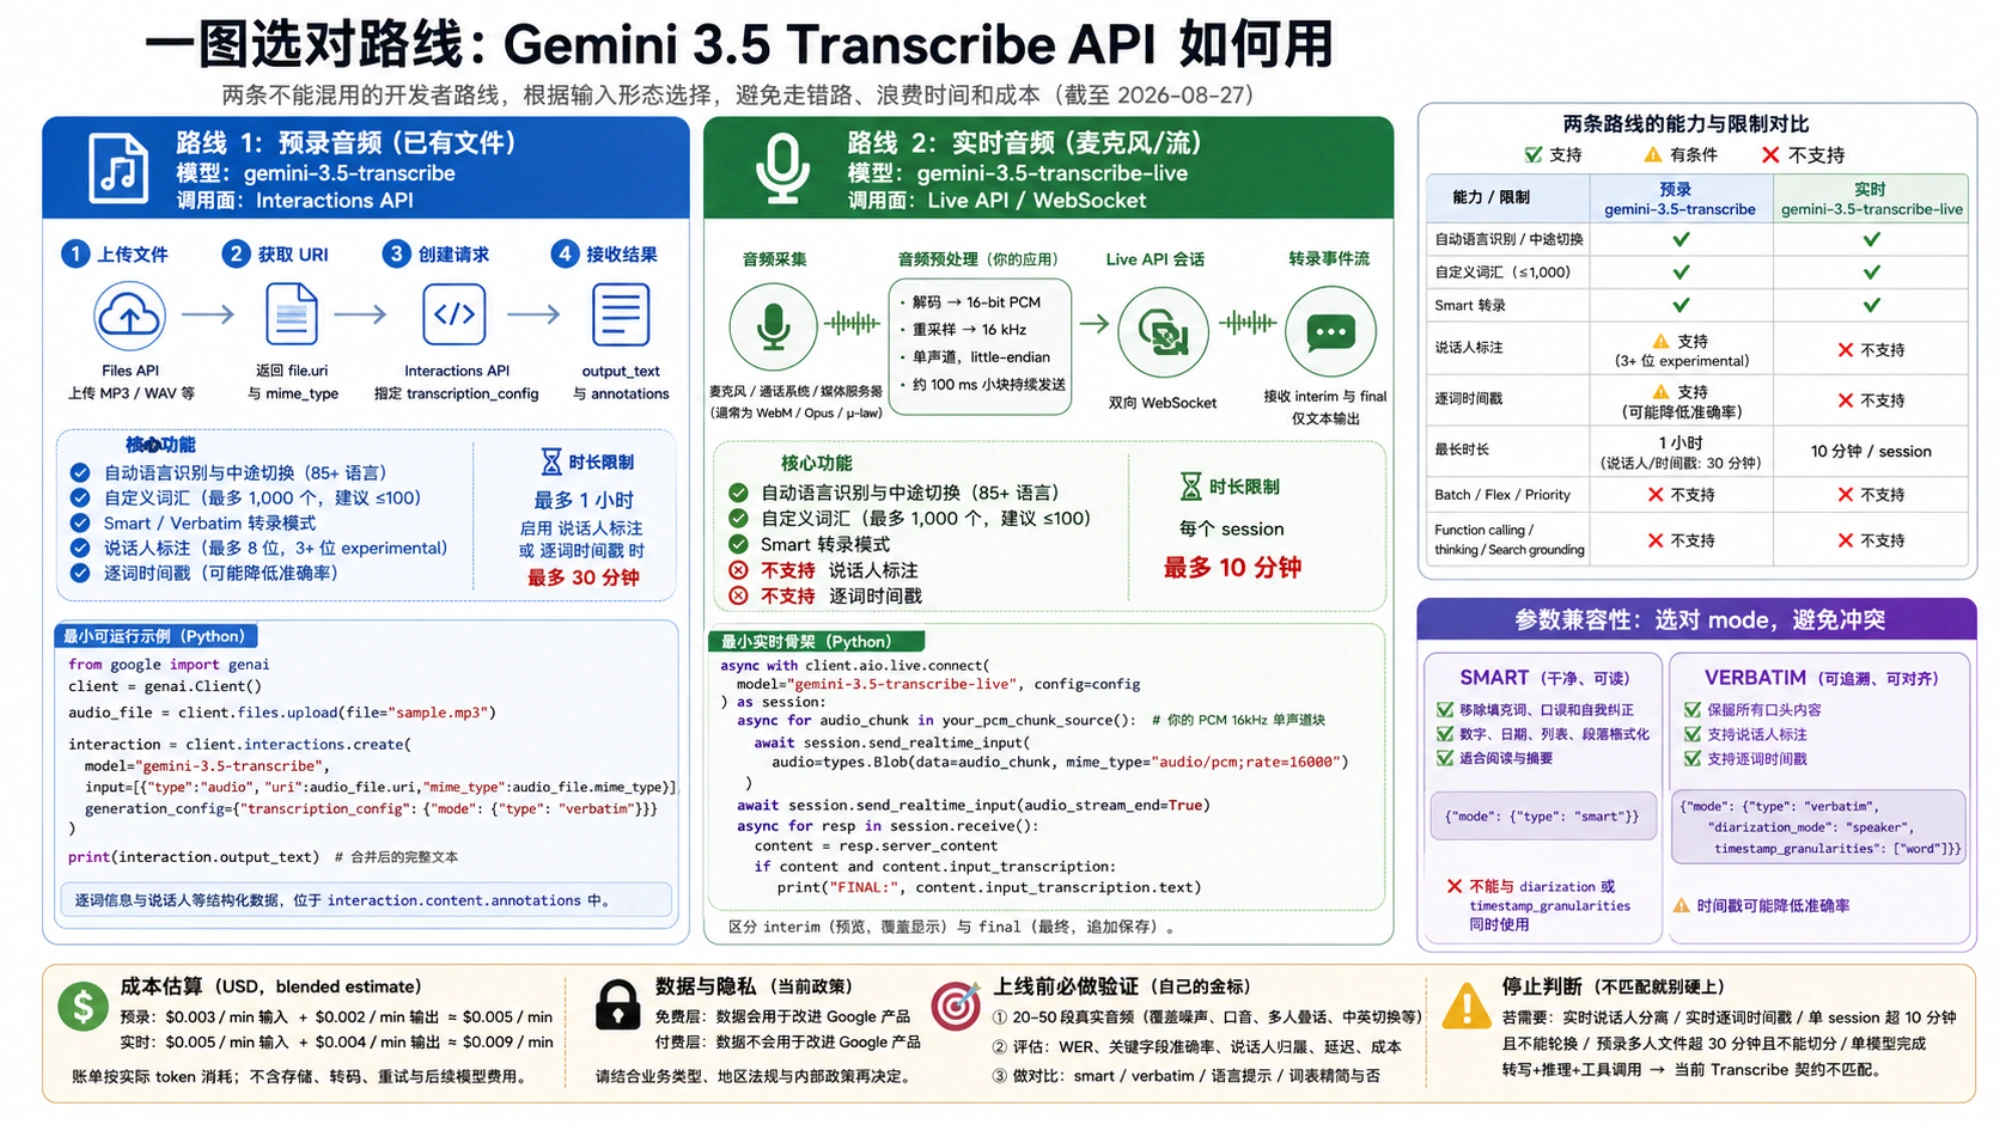
已有录音文件用 gemini-3.5-transcribe,实时字幕用 gemini-3.5-transcribe-live。 预录路线先上传文件,再通过 Interactions API 转写;实时路线通过 Live API 发送原始 PCM 音频,持续接收文字。两者的输入格式、参数写法和输出结构不同,不能只替换模型名。
接入时最容易踩的坑是把所有增强功能一起打开:预录的 custom_vocabulary 不能与说话人标注或逐词时间戳同时使用,smart 也不支持这两类结构化标注。需要可回跳、可区分说话人的录音记录,就选择不带词表的 verbatim 结构化分支;只需要更易读的文稿,则可以选择 smart 加精简词表。这些组合以当前 模型说明和转写接口指南为准。
先按录音文件或实时字幕选接口
| 读者要完成的任务 | 模型与接口 | 直接影响接入的条件 |
|---|---|---|
| 把采访、播客或客服录音转成文本 | gemini-3.5-transcribe;Files + Interactions API | 普通预录最长 1 小时 |
| 给录音添加说话人和逐词时间戳 | 同一预录模型,选择 verbatim 结构化配置 | 最长 30 分钟;不能同时加自定义词表 |
| 边说边显示字幕或语音输入 | gemini-3.5-transcribe-live;Live API | 单 session 最长 10 分钟;没有说话人标注和逐词时间戳 |
| 转写后生成纪要或调用业务工具 | 先完成转写,再交给合适的文本模型 | Transcribe 本身不支持 function calling、thinking 或 Search grounding |
时长、能力与参数限制来自 Gemini 3.5 Transcribe 模型页。实时字幕与语音助手是不同任务:这里的 Live Transcribe 返回文字,不承担与用户对话并生成语音的完整流程。
不要为状态标签改写模型 ID。核对至 2026 年 10 月 6 日,Google 的更新日志把 8 月 26 日的两个模型标为 GA,而同日的发布文章仍保留 public preview 表述。这两处官方措辞尚不一致,也不能据此保证每个账户、项目和地区都已开放。本文采用当前 Developer API 文档中的精确模型名和请求契约。
先跑通预录音频转写
以下是面向读者的 Python 接入示例,前提是运行环境已提供 google-genai SDK、获准使用的后端 API 凭据,以及你有权提交的本地音频。本次没有执行 SDK 导入、文件上传或模型调用;示例依据当前 Audio transcription 指南编写,不能当作真实调用成功记录。
把文件名作为参数传入,先使用最少字段建立基线。保存为 recorded.py 后,例如以 python recorded.py sample.mp3 plain 调用;另外两个 profile 见下一节。
# recorded.py
import argparse
from google import genai

PROFILES = {
    "plain": {},
    "readable": {
        "mode": "smart",
        "language_codes": ["cmn-Hans-CN"],
        "custom_vocabulary": ["Gemini", "BigQuery", "LaoZhang AI"],
    },
    "annotated": {
        "mode": {
            "type": "verbatim",
            "diarization_mode": "speaker",
            "timestamp_granularities": ["word"],
        },
    },
}


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("audio_path")
    parser.add_argument("profile", choices=PROFILES, default="plain", nargs="?")
    args = parser.parse_args()
    client = genai.Client()
    audio = client.files.upload(file=args.audio_path)
    options = {}
    if PROFILES[args.profile]:
        options["generation_config"] = {
            "transcription_config": PROFILES[args.profile]
        }
    result = client.interactions.create(
        model="gemini-3.5-transcribe",
        input=[{"type": "audio", "uri": audio.uri,
                "mime_type": audio.mime_type}],
        **options,
    )
    # 保留完整响应,随后可解析 steps 中的词级标注。
    with open("interaction.json", "w", encoding="utf-8") as output:
        output.write(result.model_dump_json(exclude_none=True))
    print("status:", result.status)
    print(result.output_text)


if __name__ == "__main__":
    main()
这里使用 Files API 返回的 uri 和实际 mime_type,输入是平铺的 audio 对象,不套通用聊天的 role/content 格式,也不改为普通 generateContent。用 REST 实现时,对应的是 POST https://generativelanguage.googleapis.com/v1beta/interactions;认证与字段要按该接口文档处理,不能照搬一个“OpenAI 兼容音频接口”。
成功判断要分开看:上传返回文件信息、interaction 状态完成、输出文本存在,以及听录音后确认文本对应输入。只有前三项通过,仍不能证明姓名、数字或说话人归属正确。保留原音频、完整响应和应用记录,便于复查。
smart 与 verbatim 怎样组合才合法
| profile | 用途 | 当前配置 |
|---|---|---|
plain | 先验证基本转写,再决定要加什么 | 不传可选配置,使用默认 verbatim |
readable | 文本清洗、去口头填充词、整理口误和数字格式 | mode: "smart",可加词表;不加 speaker/word |
annotated | 保留说话人和逐词时间,便于定位录音 | mode: {"type": "verbatim", ...};不加词表 |
预录 smart 是字符串 "smart",不是 {"type": "smart"}。需要说话人或时间戳时才采用上面 verbatim 的对象形式。custom_vocabulary 与 diarization_mode、timestamp_granularities 不兼容;把词表塞进 annotated 分支会违反当前契约,不能靠提示词解除。配置说明
简体普通话的语言提示是 cmn-Hans-CN。中英混说或语言不确定时,可以不传 language_codes,或传空数组自动识别。词表最多 1,000 项,模型页建议通常控制在 100 项以内;应放可能被误听的专有名词,而不是整本行业词典。Smart 的文本更便于阅读,但对填充词、重复和自我纠正的整理不能替代逐字录音记录。语言与词表限制
不只保存 output_text:解析说话人和逐词时间戳
output_text 是合并文本。结构化信息位于 steps[].content[].annotations[],其中 type == "word_info" 的标注包含 text、speaker、start_offset 和 end_offset。时间偏移是类似 "0.100s" 的 Duration 字符串,不是可以直接相加的浮点秒数。响应结构与示例
下面的独立脚本读取上一节保存的 interaction.json,输出每个词及相对当前输入文件的秒数。它保留缺失字段,也保留合法的零秒偏移;没有标注时输出空数组,不从纯文本编造说话人或时间。
# word_rows.py
import json
import re
import sys
from decimal import Decimal


def seconds(value):
    if value is None:
        return None
    if not isinstance(value, str) or not re.fullmatch(r"\d+(?:\.\d+)?s", value):
        raise ValueError(f"非法时间偏移: {value!r}")
    return Decimal(value[:-1])


def word_rows(response):
    rows = []
    for step in response.get("steps") or []:
        for content in step.get("content") or []:
            for item in content.get("annotations") or []:
                if item.get("type") != "word_info":
                    continue
                start = seconds(item.get("start_offset"))
                end = seconds(item.get("end_offset"))
                if start is not None and end is not None and end < start:
                    raise ValueError("词级结束时间早于开始时间")
                rows.append({
                    "text": item.get("text"),
                    "speaker": item.get("speaker"),
                    "start_seconds": str(start) if start is not None else None,
                    "end_seconds": str(end) if end is not None else None,
                })
    return rows


if __name__ == "__main__":
    with open(sys.argv[1], encoding="utf-8") as source:
        print(json.dumps(word_rows(json.load(source)), ensure_ascii=False, indent=2))
以 python word_rows.py interaction.json 查看结果后,再决定字幕断句、每屏字数和重叠显示规则;逐词标注本身不是现成 SRT。长录音如果先切片,每片时间偏移属于该片,拼接时要加上应用保存的片段起点。说话人标签也不能仅凭相同名称跨片合并成同一个人。
说话人能力页面列出最多 8 人,但明确 3 位及以上属于 experimental,不是稳定的八人会议识别承诺;逐词时间戳还可能降低转写准确率。开启任一种结构标注后,输入最长 30 分钟。先用本业务样本检查归属和回跳位置,再决定是否满足上线要求。当前模型边界
实时字幕要处理的是流,不是文件
Live Transcribe 需要 raw signed 16-bit、16 kHz、单声道、little-endian PCM。100 ms 对应 1,600 个采样、3,200 字节。WAV 带容器头,WebM/Opus 是另一种编码,8 kHz 电话音频也需要转换;只把 MIME 改成 audio/pcm;rate=16000 不会完成解码和重采样。实时转写指南
下例读取已经转换好的 .pcm 文件,按约 100 ms 节奏发送,用于解释真实媒体管线接入前的客户端流程。它不是麦克风采集器,也不含转码步骤。若使用 mode,Live 配置的枚举是 "SMART" 或 "VERBATIM",与预录字符串写法不同;本例选 VERBATIM,并使用默认自动 VAD。
收到 interim_input_transcription 时覆盖当前预览,收到 input_transcription 时追加最终片段并清空预览。一个事件可能同时带两者,也可能没有 server_content。不要对最终文本做全局去重:连续两次“好的”可能是两段真实发言。
# live_pcm.py
import argparse
import asyncio
from pathlib import Path
from google import genai
from google.genai import types


class Captions:
    def __init__(self):
        self.preview = ""
        self.final = []

    def apply(self, interim=None, final=None):
        if interim is not None:
            self.preview = interim
        if final is not None:
            self.final.append(final)
            self.preview = ""


async def receive(session, captions):
    # receive() 可按轮次结束;继续接收后续轮次。
    while True:
        received = False
        async for event in session.receive():
            received = True
            content = event.server_content
            if content is None:
                continue
            interim = content.interim_input_transcription
            final = content.input_transcription
            captions.apply(
                interim.text if interim is not None else None,
                final.text if final is not None else None,
            )
            print({"final": captions.final, "preview": captions.preview})
        if not received:
            return "receive_ended"


async def main(pcm_path):
    pcm = Path(pcm_path).read_bytes()
    if not pcm or len(pcm) % 2:
        raise ValueError("PCM 不能为空,字节数必须是 16 位采样的整数倍")
    if pcm[:4] in (b"RIFF", b"OggS") or pcm[:4] == b"\x1aE\xdf\xa3":
        raise ValueError("输入含容器头;先解码为 raw PCM")
    # 9 分钟是本例的应用上限,给发送和收尾留余量。
    if len(pcm) > 16000 * 2 * 540:
        raise ValueError("本例只处理不超过 9 分钟的输入")
    captions = Captions()
    status = "partial"
    client = genai.Client()
    config = types.LiveConnectConfig(
        response_modalities=["TEXT"],
        input_audio_transcription=types.AudioTranscriptionConfig(
            mode="VERBATIM", language_codes=[],
        ),
    )
    async with client.aio.live.connect(
        model="gemini-3.5-transcribe-live", config=config,
    ) as session:
        receiver = asyncio.create_task(receive(session, captions))
        try:
            loop = asyncio.get_running_loop()
            started = loop.time()
            for offset in range(0, len(pcm), 3200):
                if receiver.done():
                    status = "receiver_stopped: " + str(await receiver)
                    break
                await session.send_realtime_input(audio=types.Blob(
                    data=pcm[offset:offset + 3200],
                    mime_type="audio/pcm;rate=16000",
                ))
                due = started + (offset + 3200) / 32000
                await asyncio.sleep(max(0, due - loop.time()))
            else:
                await session.send_realtime_input(audio_stream_end=True)
                try:
                    status = await asyncio.wait_for(receiver, timeout=5)
                except asyncio.TimeoutError:
                    status = "drain_timeout_partial"
        except Exception as exc:
            status = "error_partial: " + type(exc).__name__
        finally:
            if not receiver.done():
                receiver.cancel()
            try:
                await receiver
            except (asyncio.CancelledError, Exception):
                pass
            # 连接退出后仍可检查已提交片段、未定稿预览和终止原因。
            print({"status": status, "final": captions.final,
                   "pending_preview": captions.preview})


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("pcm_path")
    asyncio.run(main(parser.parse_args().pcm_path))
以 python live_pcm.py sample.pcm 运行时,发送的内容必须确实满足 PCM 格式;头部和字节数检查只会拦截部分错误,不能证明任意文件都是 16 kHz 单声道。示例在音频 EOF 后发送 audio_stream_end=True,最多等待 5 秒,然后取消接收任务并关闭连接。这个应用超时不代表服务端承诺的 final 延迟;若仍有预览或等待超时,应把记录标为部分结果,保留已完成片段,不能宣告整段转写完成。
默认自动 VAD 与手动活动边界是不同配置。需要手动方案时,按官方指南关闭自动检测再发送 activity start/end,不能把所有结束信号随意叠加。本例只展示有限长度文件的流式发送与收尾;生产产品还要记录应用自己的 session 编号、片段顺序和断线位置。它们是应用字段,不是服务端返回的词级时间戳,也不保证跨重连恰好处理一次。超过模型的 10 分钟 session 边界时,需要明确轮换和回放策略。VAD 与连接流程
浏览器直连用短期令牌,不能公开长期 API key
上例是后端 SDK 流程。浏览器直连应由可信后端验证客户端,再发放约束模型和配置的短期令牌。当前 ephemeral token 文档限定为 Live API 的 v1beta:默认 1 分钟内启动新 session、30 分钟连接消息有效期、使用次数为 1。短期令牌仍可被提取,只是缩短暴露范围。
令牌的 30 分钟有效期不会把 Transcribe 的单 session 上限从 10 分钟延长到 30 分钟。 后端还需约束令牌用途与允许的配置,避免把长期 key 放进前端 bundle 或长期可复用的连接地址。这里没有发放令牌,也没有验证浏览器、麦克风或重连链路。
成本很低,但不要忽略输出和重试
截至 2026 年 10 月 6 日,以下是 Gemini Developer API 定价页的付费标准价,单位为美元/100 万 token,分别计算音频输入与文本输出:
| 路线 | 音频输入 | 文本输出 | 官方舍入后的每分钟估算 |
|---|---|---|---|
| 预录 Transcribe | $2 | $12 | 约 $0.005 |
| Live Transcribe | $3.50 | $21 | 约 $0.009 |
每分钟数字采用约每秒 25 个音频 token、每分钟 175 个文本 token 的假设,不是固定分钟套餐。预录每分钟未舍入的计算为 1500 × 2 / 1000000 + 175 × 12 / 1000000 = $0.0051;实时为 $0.008925。在这组假设下,100 小时即 6,000 分钟分别约 $30.60 和 $53.55。若直接乘官方舍入数字,则会得到约 $30 和 $54;差异来自舍入,不是另一档费率。
真实调用费用应按实际用量计算:音频输入 token × 输入单价 / 1000000 + 文本输出 token × 输出单价 / 1000000。再单列重试、存储、转码、媒体服务器、下游纪要模型和人工抽检成本。这里没有真实账单或付费调用,也不把通用 Gemini 音频的 token 速率用于这个专用模型的估算。
免费调用与录音数据怎样处理
定价页列出免费层,但免费额度、可用地区和录音可否提交是不同问题。Gemini API 条款通常允许将未付费服务的输入、输出用于改进产品,并可能有人审阅,要求不要提交敏感、机密或个人信息。对 API,启用有效 Cloud Billing 的项目适用付费服务数据规则;输入、输出不用于改进产品,仍有有限的滥用、安全和法律处理及日志范围。
条款对 EEA、瑞士和英国另有数据使用例外,并要求面向这些地区用户的 API 客户端使用付费服务。不能根据文章语言判断地区资格,也不能把定价表的 Yes/No 简化成“免费必训练、付费零保留”或合规保证。客户通话、内部会议等录音需要先确认组织政策、授权和所用项目的实际条款。
Files API 的存储生命周期也要单独处理:单文件最多 2 GB、项目最多 20 GB,上传文件自动在 48 小时后删除。Files 服务本身免费不等于转写推理免费;48 小时文件删除也不代表 interaction、输出和服务日志都只保留 48 小时。上传文件不能从该 API 下载回来,应自行保留获准存储的原始音频。Files API 说明
用自己的金标音频验收,而不是只看 WER 新闻
应用上线需要分别验收基础调用、录音质量和字幕状态。先取得人工参考文本,覆盖实际会遇到的口音、中英混说、噪声、电话编码、多人交叠与专有名词。对姓名、订单号、金额等高代价字段单独统计错误,不能让整体准确率掩盖它们。
- 文稿清洗:比较 plain 与 readable,检查口误修正有没有改变原意。
- 结构化录音:检查说话人归属,点击词级时间能否回到对应位置,并保留原片段起点。
- 实时字幕:测最终字幕延迟、预览替换、真实重复发言、断线和 EOF 后的部分结果。
- 费用:记录实际输入、输出用量及重试,与预算假设对照。
本次离线检查只覆盖公开示例的 Python 语法、三个配置分支、合成 word_info 数据的 Duration 解析、字幕临时/最终状态、合成 PCM 字节数和费用算术。它没有执行 SDK 或模型、听取私人录音、测麦克风、评估 WER、延迟或生产并发,不能证明服务接受了请求或识别质量达标。
常见接入错误与停止判断
请求成功,但没有说话人或时间戳
先确认使用预录模型以及 annotated 分支,不带 custom_vocabulary;再查看完整响应的 steps[].content[].annotations[],而不是只读 output_text。若字段确实缺失,应保存缺失状态并检查服务响应,不能从文本补造 speaker 或时间。Live 模型本身不提供这两类结构。预录指南
开启 smart 后结构化标注消失
Smart 与说话人、逐词时间戳不兼容。需要可定位的录音记录,就用 verbatim 结构化分支;若还要一份易读纪要,在下游另做受控整理,并保留原记录。预录的 smart 参数用小写字符串,Live 的 mode 用大写枚举。预录配置、Live 配置
实时字幕重复、跳字或结束后一直等待
先确认 interim 覆盖预览、final 才追加,并保留合法重复发言;再检查 PCM 解码、采样率、声道、字节序和发送节奏。EOF 要结束音频并限时等待接收,超时保存部分结果。不要用提示词修补音频格式,也不要无限等待一个并不等于关闭连接的 audio_stream_end。实时流程
模型能转写,却不能总结或调用工具
当前原生 Transcribe 不支持 function calling、thinking、Search grounding、file search 或 code execution。先完成并保存 transcript,再交给处理纪要或业务动作的模型。消费端应用的演示与发布时的未来计划不能直接变成这个 API 的能力。模型功能表
如果产品要求实时说话人分离、实时逐词时间戳、不能轮换的超长实时 session,或不能切片的 30 分钟以上结构化录音,应先调整架构或另选 STT 路线。其余场景从 plain 短录音基线开始,选对合法功能分支,再完成真实音频、字幕收尾与实际用量验收,才能判断是否适合生产。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
- 1.模型说明ai.google.dev/gemini-api/docs/models/gemini-3.5-transcribe
- 2.转写接口指南ai.google.dev/gemini-api/docs/transcribe
- 3.更新日志ai.google.dev/gemini-api/docs/changelog
- 4.发布文章blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5-transcribe
- 5.实时转写指南ai.google.dev/gemini-api/docs/live-api/live-transcribe
- 6.ephemeral token 文档ai.google.dev/gemini-api/docs/live-api/ephemeral-tokens
- 7.Gemini Developer API 定价页ai.google.dev/gemini-api/docs/pricing
- 8.Gemini API 条款ai.google.dev/gemini-api/terms
- 9.Files API 说明ai.google.dev/gemini-api/docs/files