Claude Fable 5.1 与 Opus 5:API 价格与任务成本怎么算
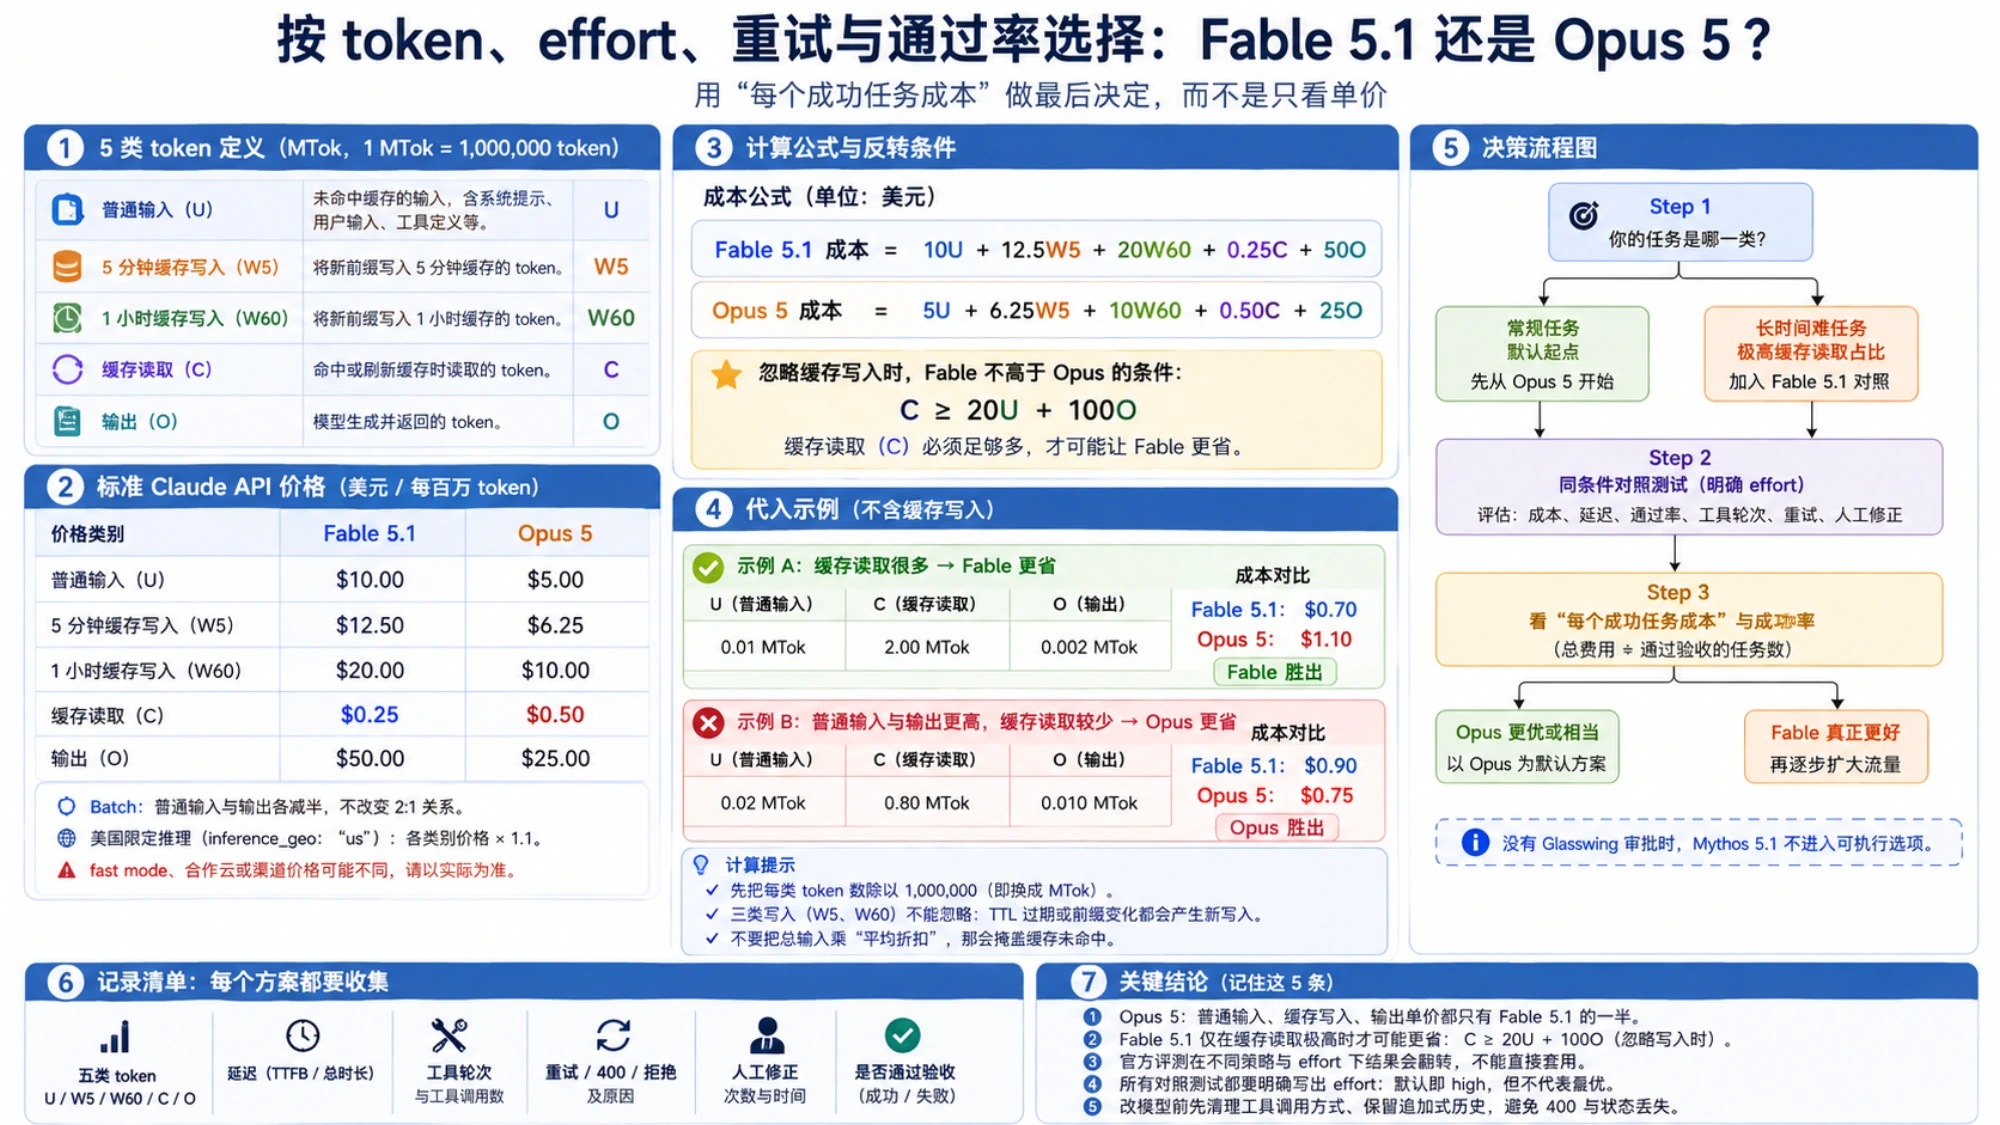
Opus 5 的普通输入输出单价只有 Fable 5.1 的一半,但 Fable 的缓存读取又便宜一半。真正的选择要落到你的 token 构成和成功任务成本。
文章目录
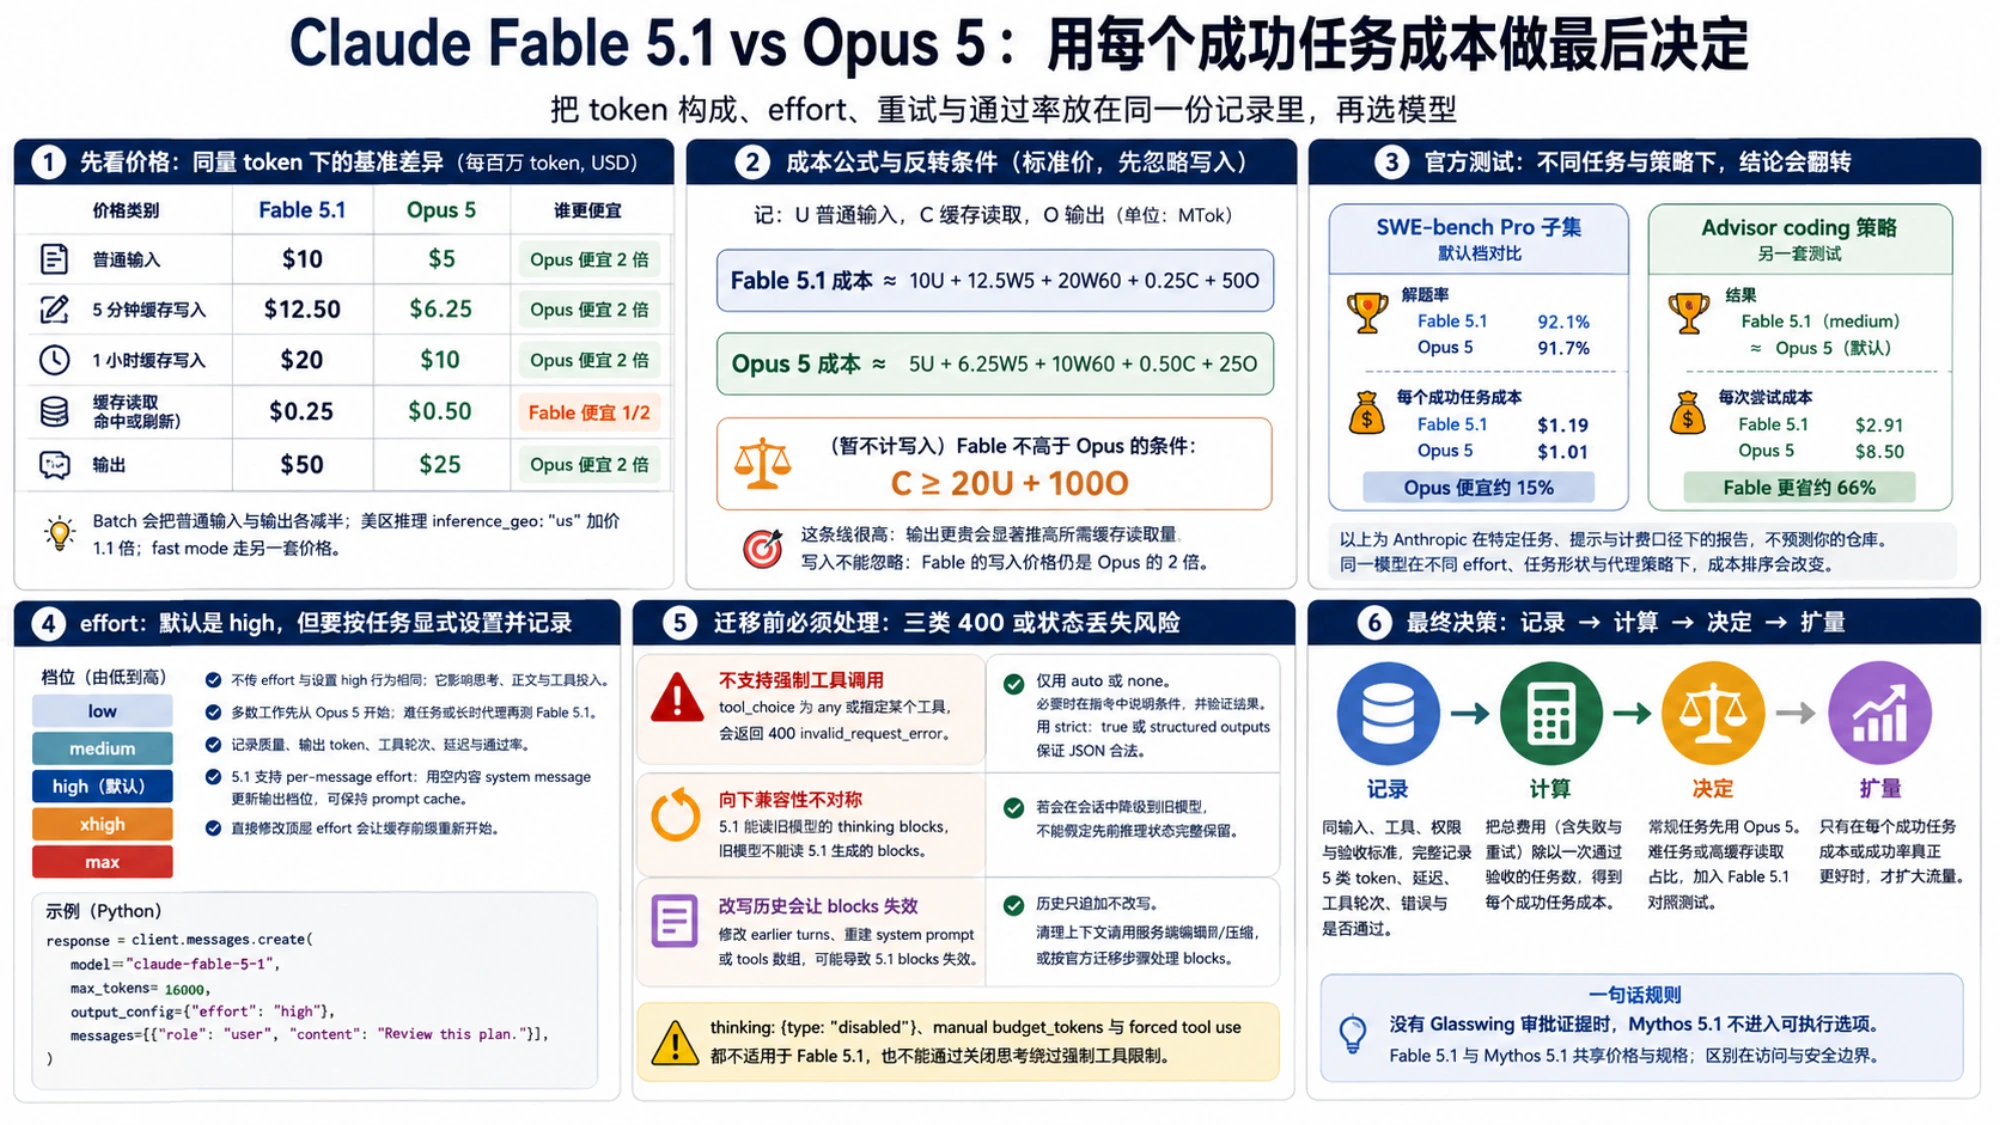
Claude Opus 5 是更稳妥的默认起点:普通输入、缓存写入和输出单价都只有 Claude Fable 5.1 的一半。Fable 5.1 的缓存读取更便宜:每百万 token 为 $0.25,是 Opus 5 的 $0.50 的一半。Anthropic 官方价格表
所以“Fable 贵两倍”和“Fable 的缓存更便宜”可以同时为真。要判断哪一个实际更省,必须把普通输入、缓存写入、缓存读取、输出、effort、重试以及最终是否通过验收放进同一份记录。没有这些数据时,只能决定先测谁,不能宣布绝对赢家。
本文价格与能力按 2026 年 9 月 3 日可见的 Claude Platform 一手文档核对。两款模型都列出 100 万 token 上下文、128K 最大输出,默认推理强度(effort)为 high;合作云、私有折扣和网关账单可能不同,上线当天仍应复核。
普通输入与输出为主时,Opus 5 的单价更低
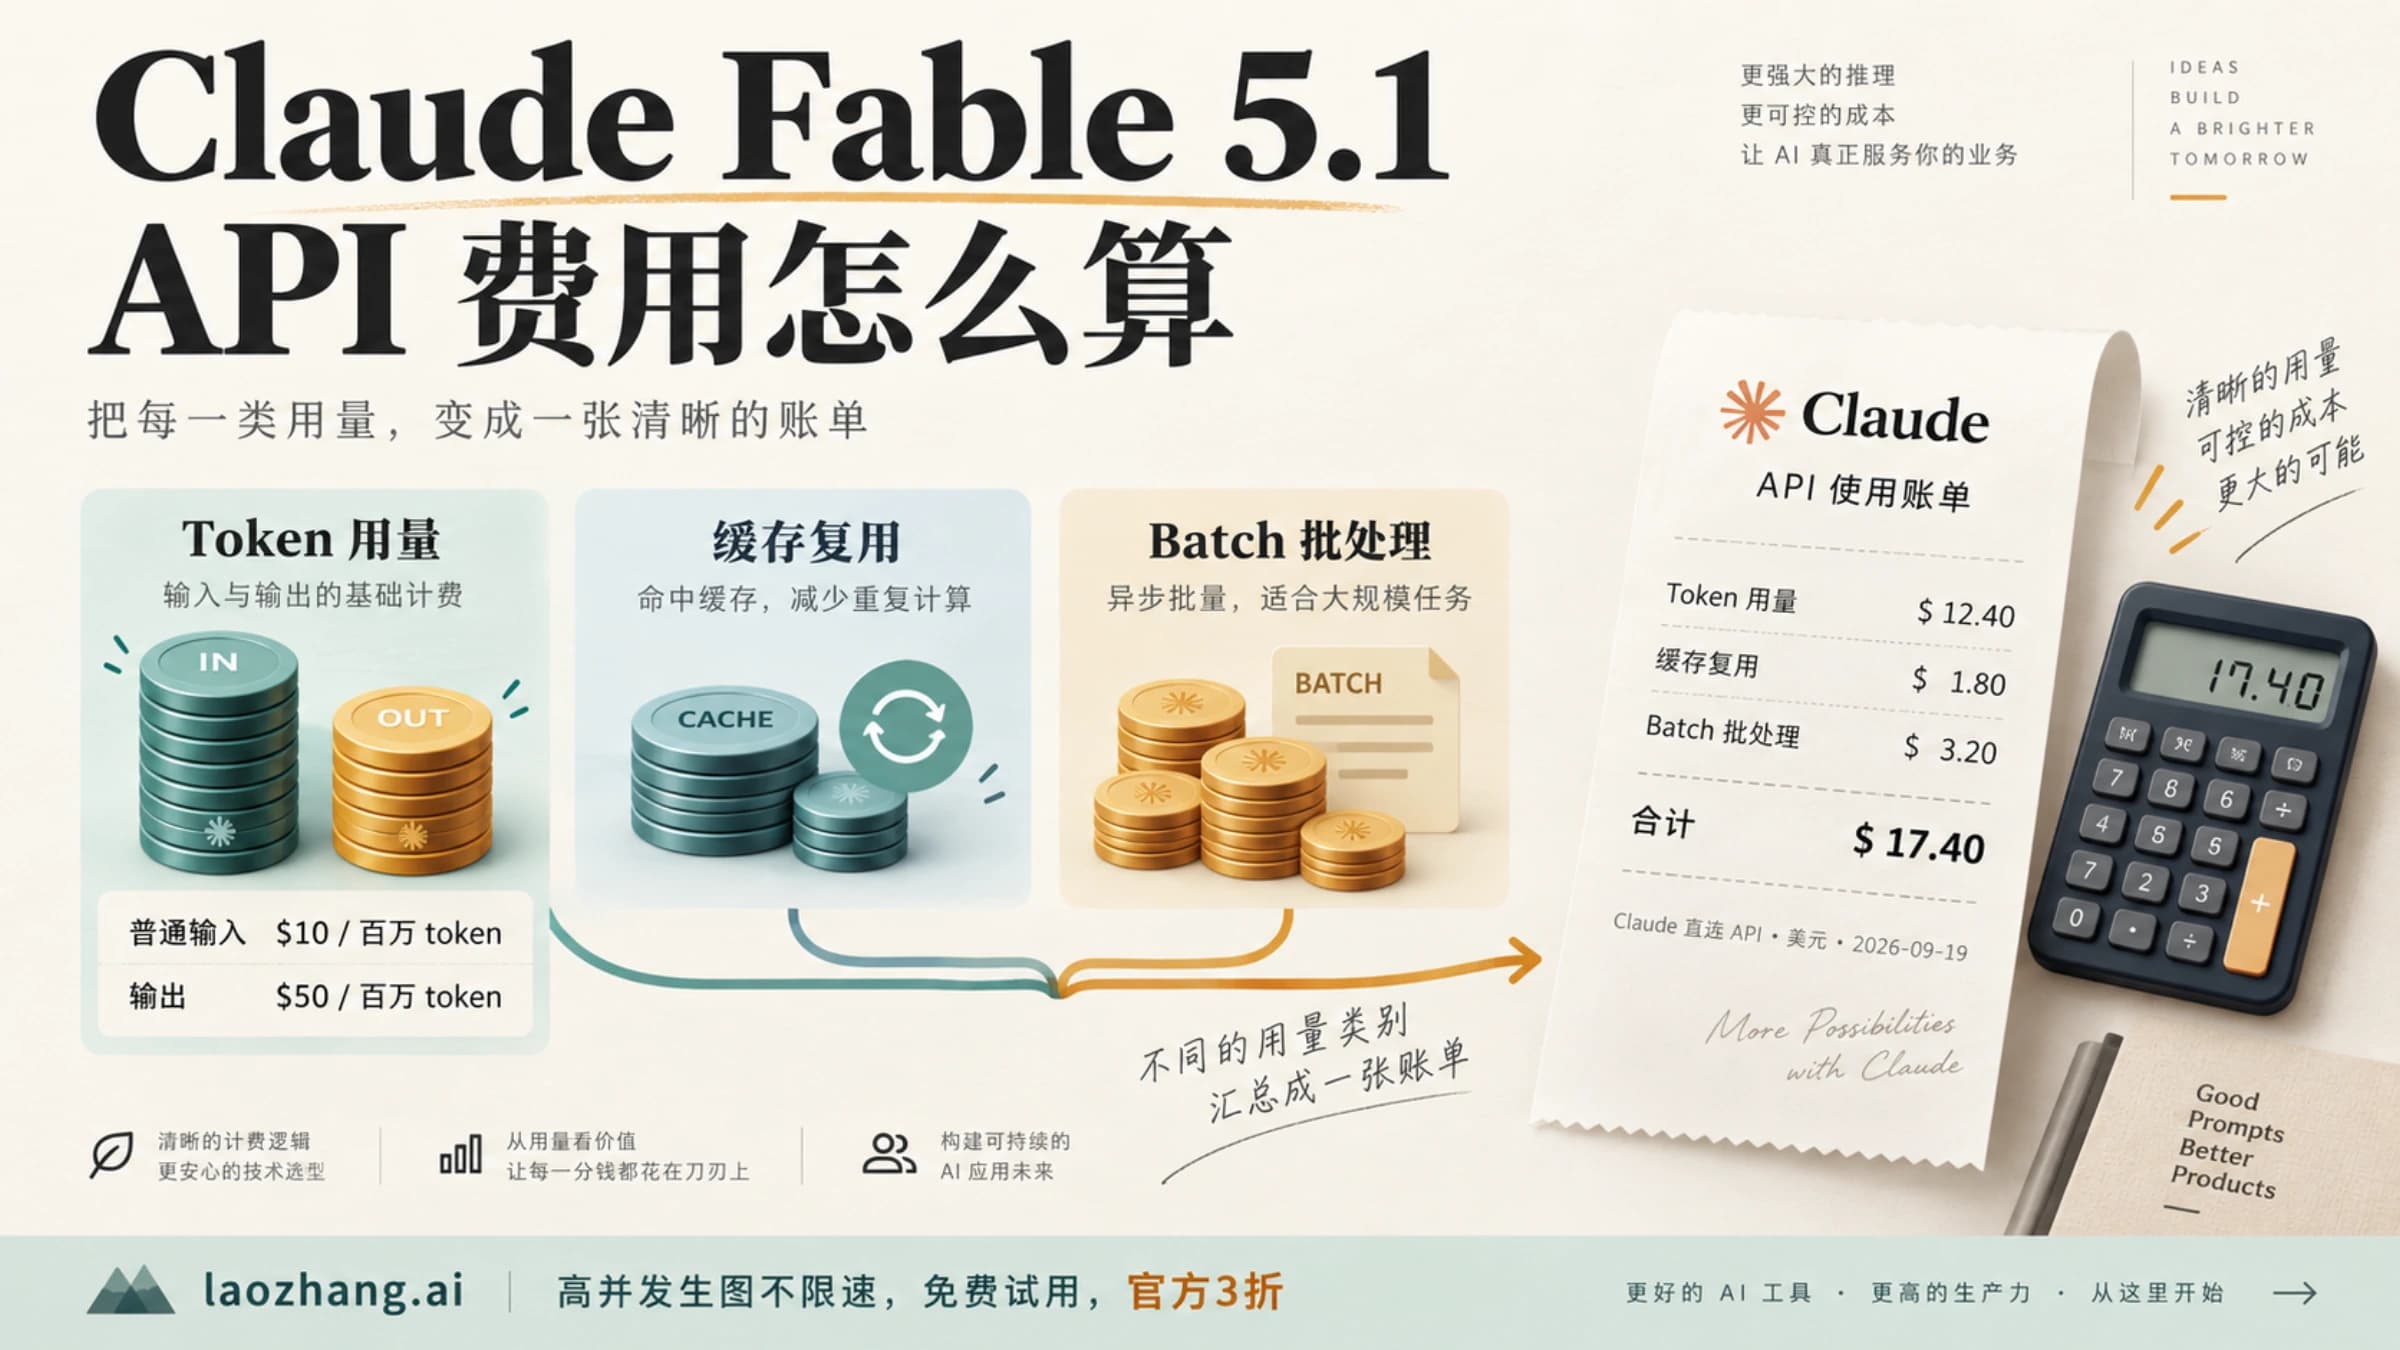
Anthropic 当前价格页把五类 token 分开计价。下面是标准 Claude API 的美元基准:
| 每百万 token | Fable 5.1 | Opus 5 |
|---|---|---|
| 普通输入 | $10 | $5 |
| 5 分钟缓存写入 | $12.50 | $6.25 |
| 1 小时缓存写入 | $20 | $10 |
| 缓存读取(命中或刷新) | $0.25 | $0.50 |
| 输出 | $50 | $25 |
Batch 会把两款模型的普通输入与输出各减半,因此不会改变同量 token 下的 2:1 关系。美国限定推理 inference_geo: "us" 会在受支持的官方接口中,将各类 token 费用乘以 1.1。Opus 5 的 fast mode 则使用另一套价格;云平台或转售渠道也可能另行计价,所以表中数字不是任何账户的最终承诺。
若两款模型生成完全相同的 token 数,而且没有缓存,Fable 5.1 的请求费就是 Opus 5 的两倍。但真实代理任务可能在轮次、工具调用、重试和通过率上不同;同量计算只能说明用量相同时的价格差异。
缓存读取很多时,结论才可能翻转
先将 usage 中的 token 数除以 1,000,000,换成百万 token(MTok),再记为:普通输入 U、5 分钟写入 W5、1 小时写入 W60、缓存读取 C、输出 O。标准价下:
Fable 5.1 = 10U + 12.5W5 + 20W60 + 0.25C + 50O
Opus 5     =  5U +  6.25W5 + 10W60 + 0.50C + 25O
暂时不计缓存写入和其他附加费用,Fable 不高于 Opus 的条件可化成:
C >= 20U + 100O这条线很高,因为输出 token 对 Fable 更贵。例如一组请求累计包含 0.01 MTok 普通输入、2 MTok 缓存读取和 0.002 MTok 输出,暂不计写入:Fable 为 $0.70,Opus 为 $1.10,Fable 胜出。若把缓存读取降到 0.8 MTok,同时把普通输入提高到 0.02 MTok、输出提高到 0.01 MTok,Fable 是 $0.90,Opus 是 $0.75,结果又回到 Opus。
写入不能忽略到最终账单。Fable 的 5 分钟和 1 小时写入仍是 Opus 的两倍;前缀频繁变化、TTL 过期或工具定义变动都会产生新的写入。每项 token 先除以 1,000,000,再按实际 usage 分列。不要把总输入乘一个“平均折扣”,那会掩盖缓存未命中。Claude Code 会话异常变贵时,可另看缓存未命中与 token 成本诊断。
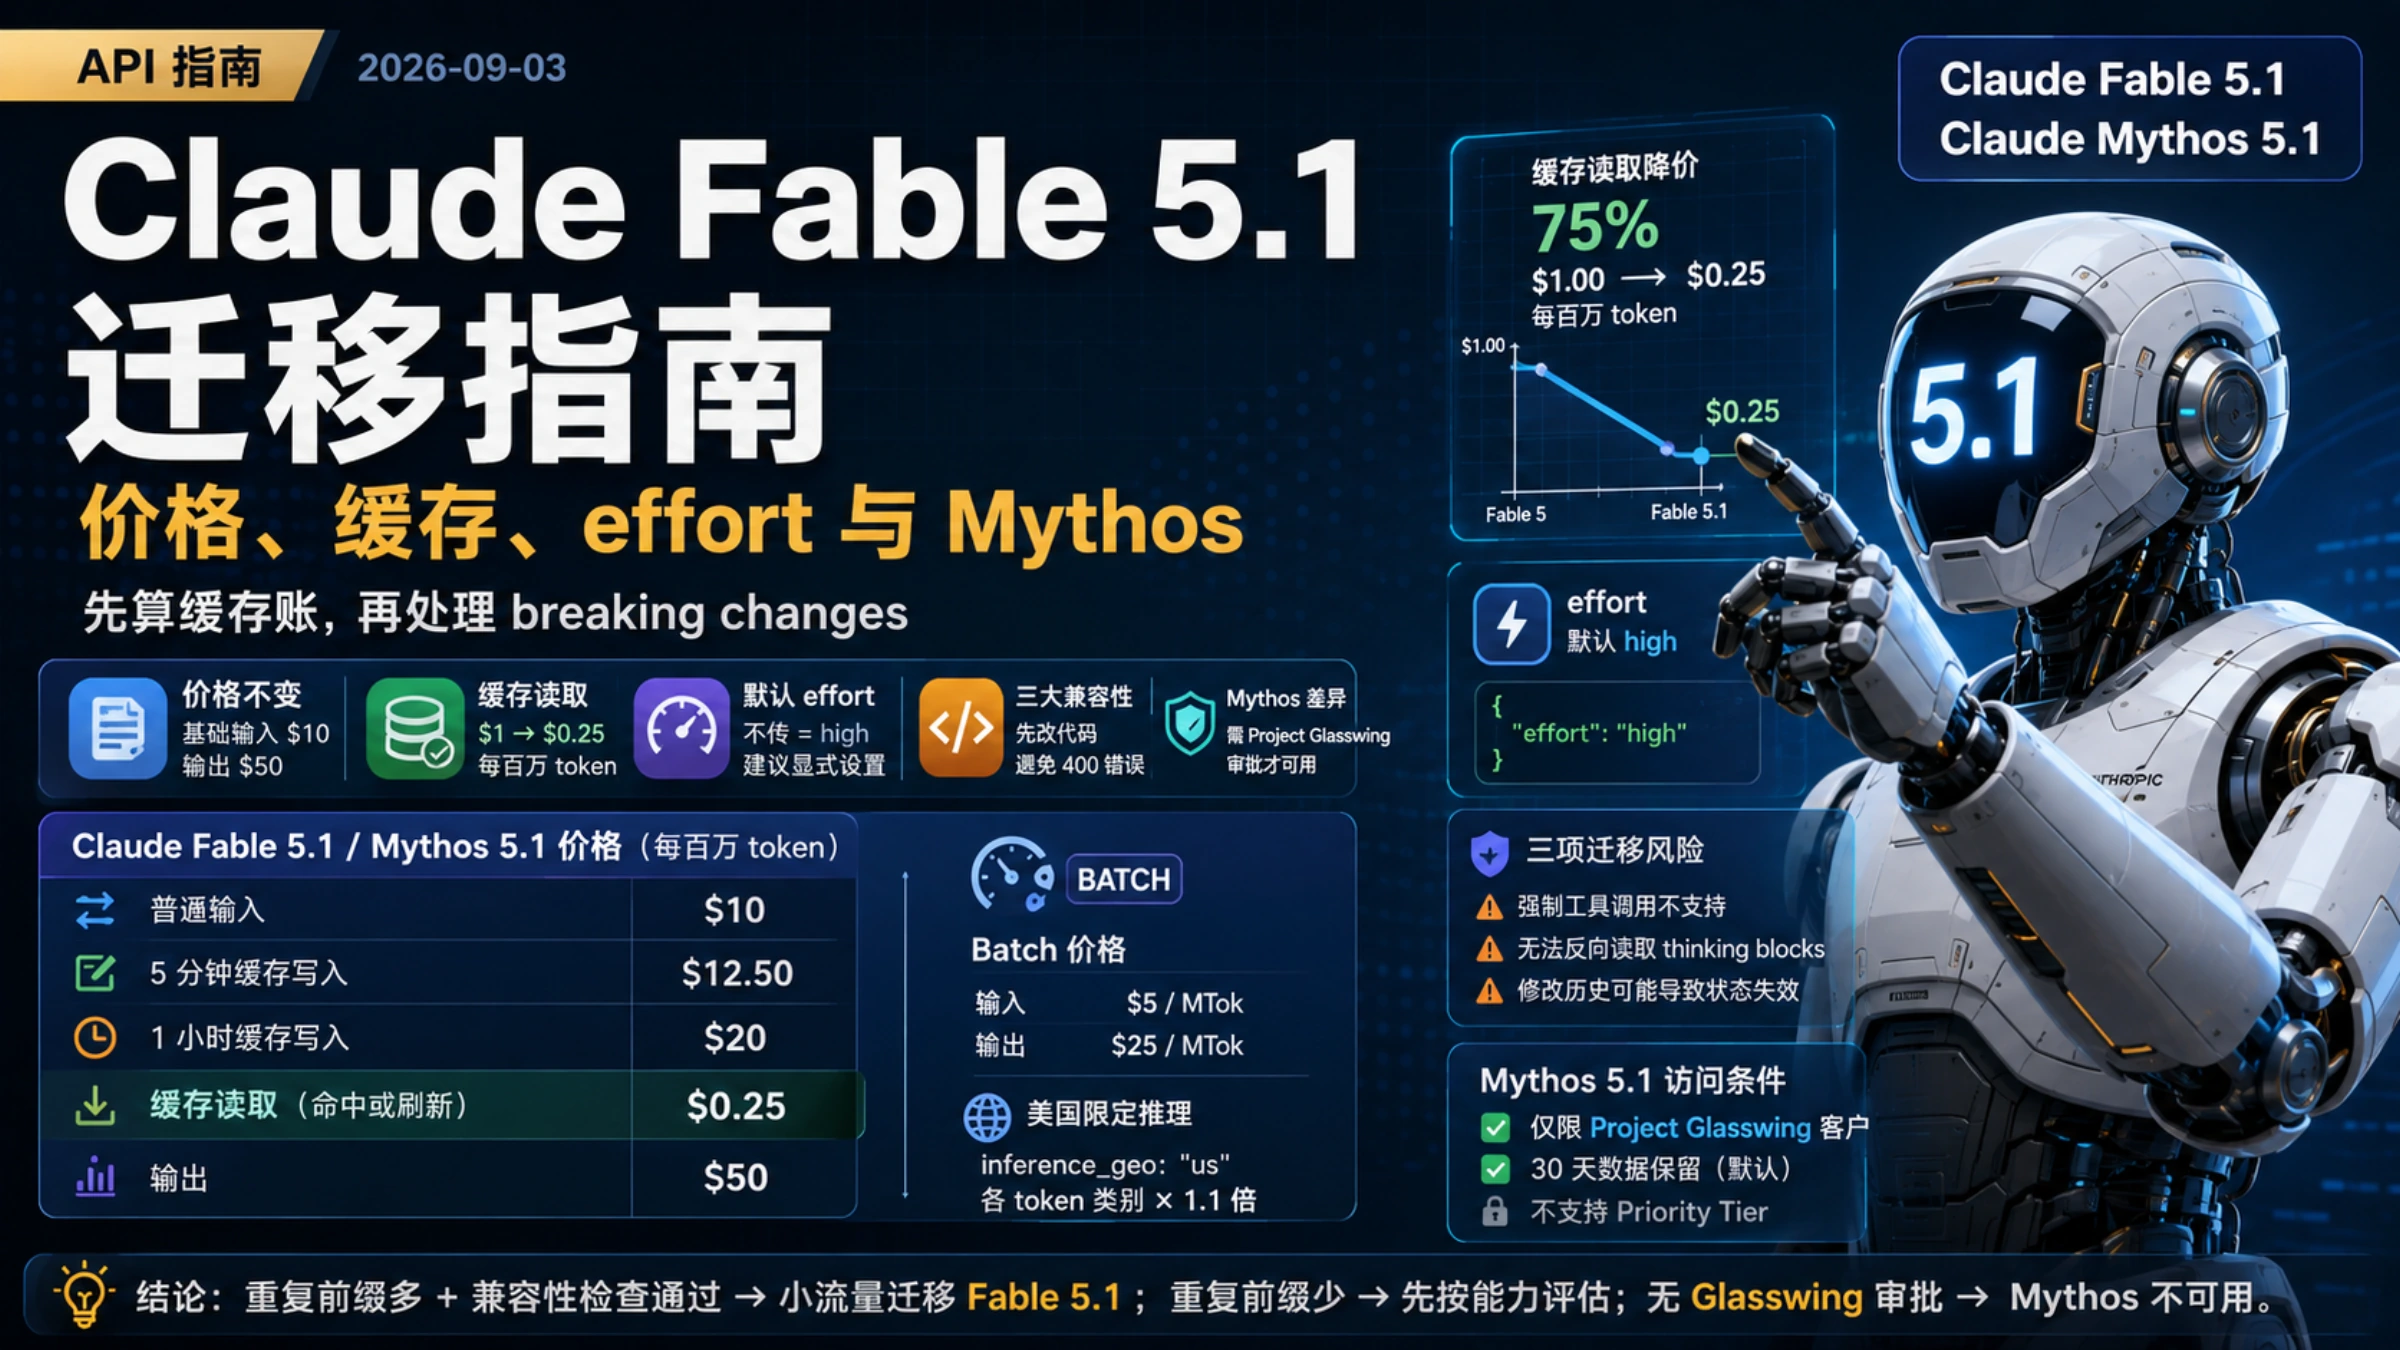
“缓存降价 75%”只是在比较 Fable 5.1 与上一代 Fable 5 的缓存读取价格:$1 降到 $0.25,不代表整款模型降价 75%。
官方评测也没有给出一个固定赢家
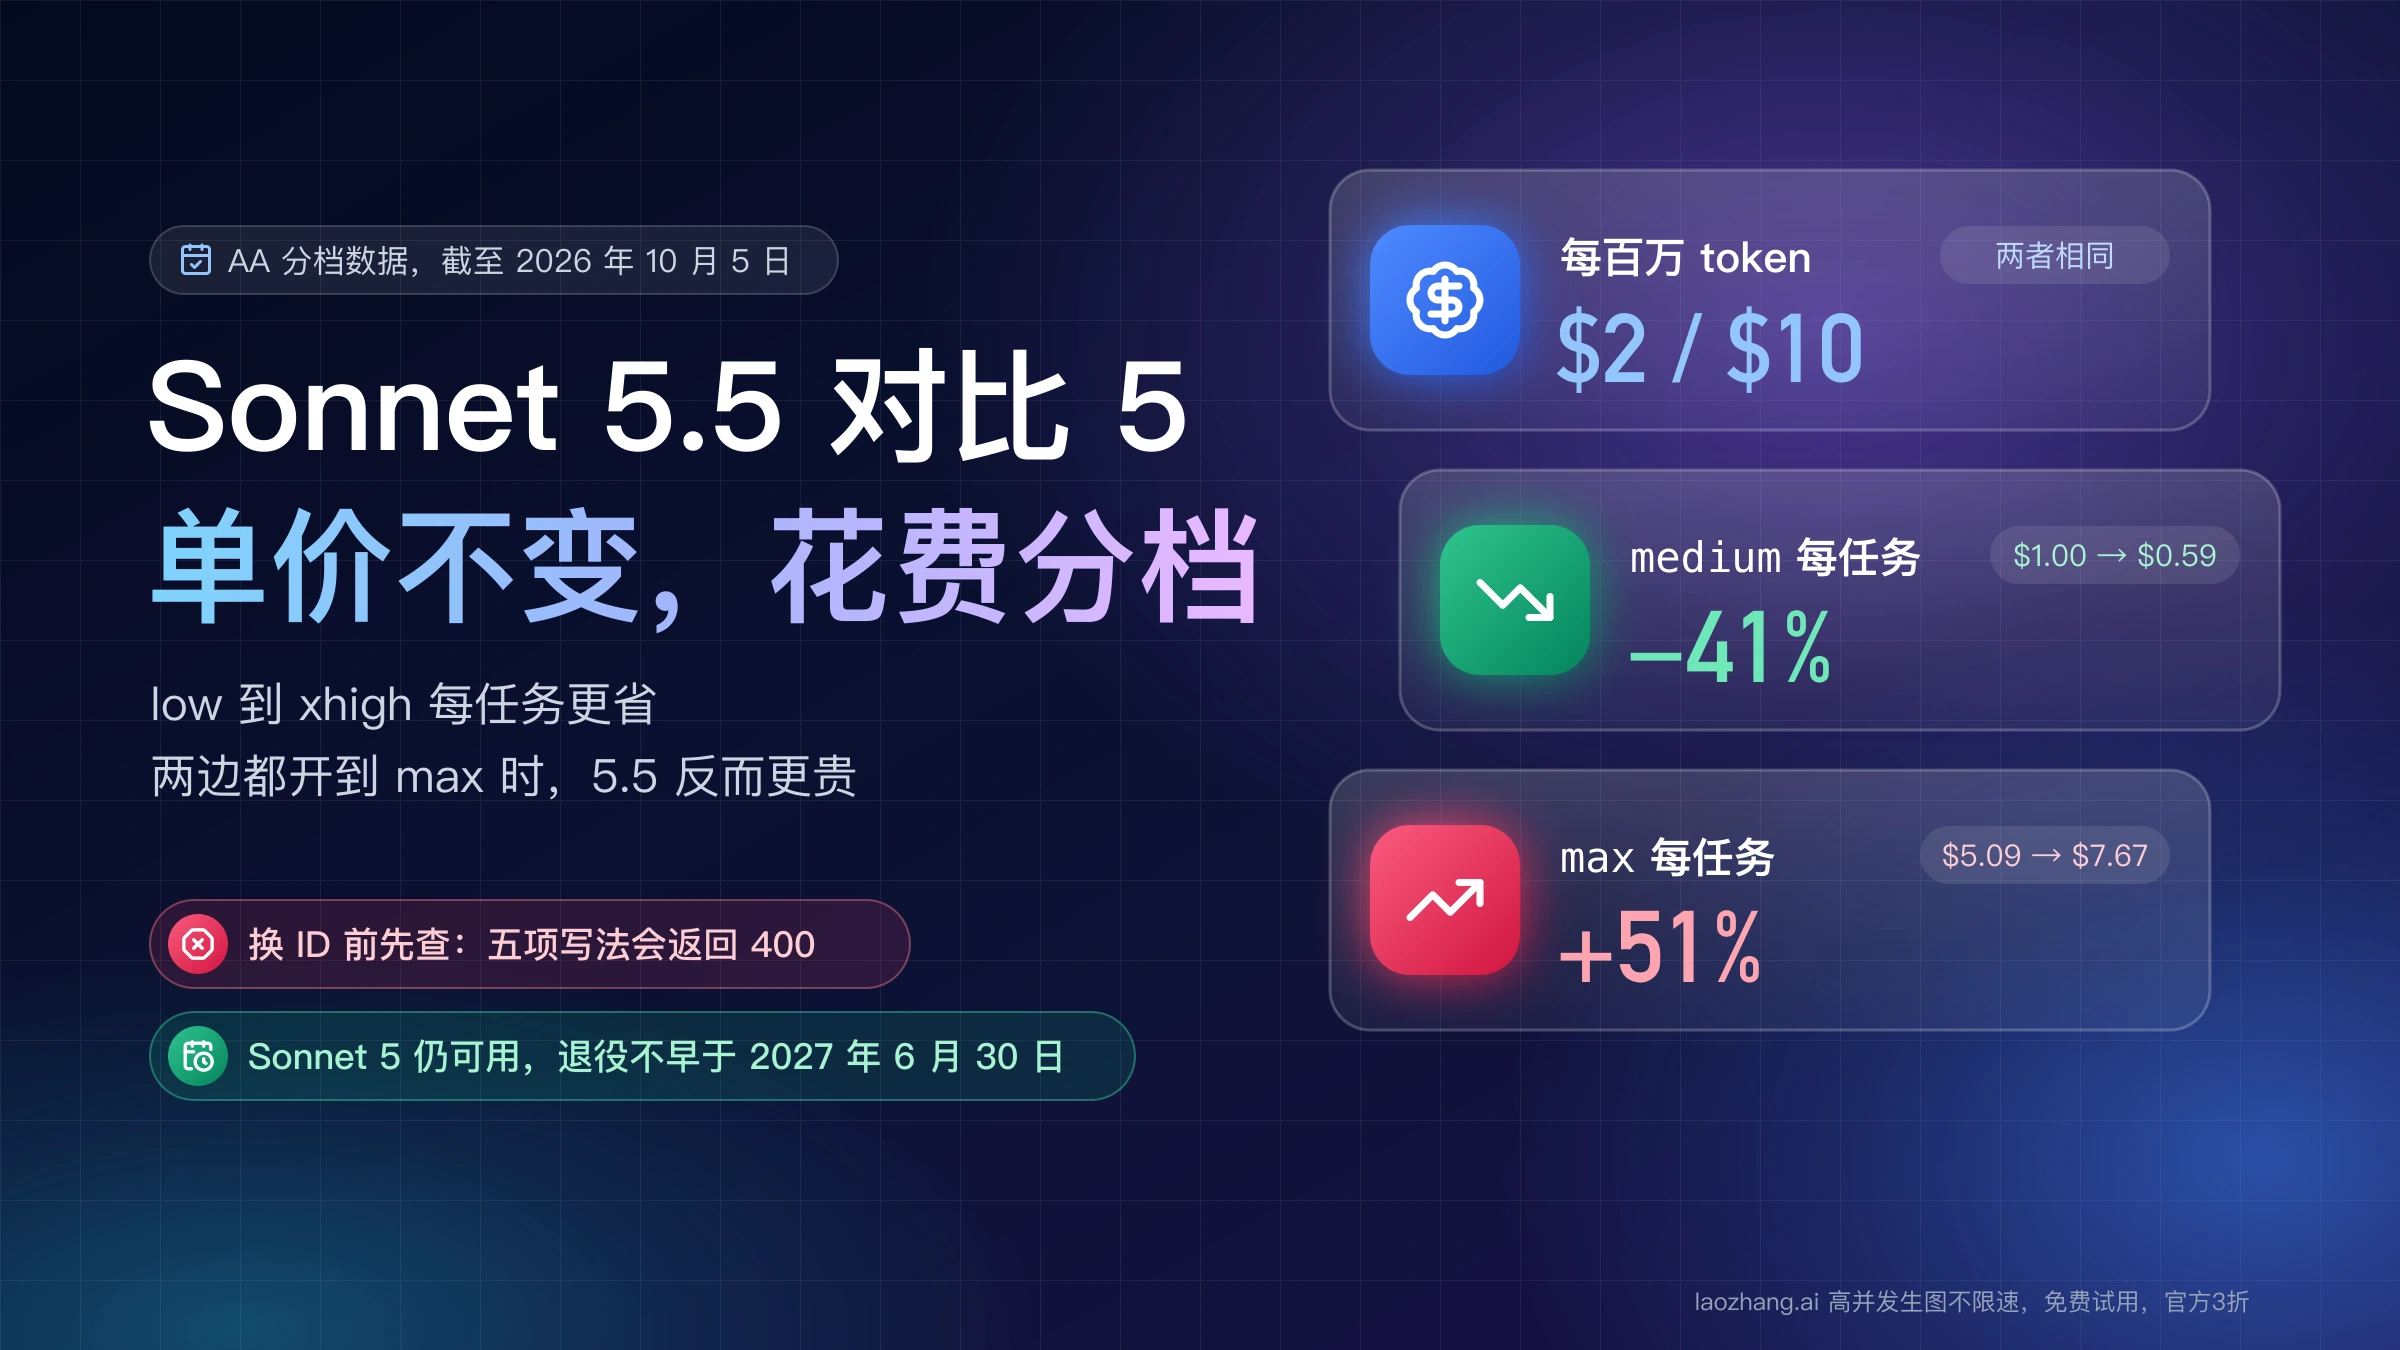
Anthropic 的成本与智能优化指南给出了两个方向不同的自有测试。在它的 SWE-bench Pro 子集中,默认 Fable 5.1 与默认 Opus 5 的解题率为 92.1% 和 91.7%,差异处于运行噪声内;每个成功任务成本约为 $1.19 和 $1.01,Opus 便宜约 15%。但在另一套 Advisor coding 策略中,Fable 5.1 medium 与 Opus 5 默认档达到相当结果,每次尝试约 $2.91 对 $8.50。
这些数字是 Anthropic 在特定任务、提示和计费口径下的报告,不是独立榜单,也不预测你的仓库。它们真正支持的结论是:同一个模型在不同推理强度、任务类型和智能体执行策略下,成本排序会翻转。
默认 effort 是 high,但最好明确写出来
Effort 文档明确说明,API 不传 effort 与设置 high 的行为完全相同。Fable 5.1 支持 low、medium、high、xhigh 和 max 五档;自适应思考始终开启,effort 控制模型对整个响应投入多少工作,包括思考、正文和工具调用。
response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=16000,
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Review this migration plan."}],
)
high 是稳妥起点,不是所有请求的永恒最优值。官方模型页建议多数工作先从 Opus 5 开始;如果 Opus 5 在更高 effort 下仍达不到长时推理或代理任务的验收条件,再测 Fable 5.1。对已知属于长代理循环的工作,也可把 Fable 5.1 low 或 medium 放进第一轮对照。effort 是行为信号,不是严格 token 预算,因此必须记录质量、输出 token、工具轮次和延迟。
5.1 还提供测试版的逐消息推理强度设置(per-message effort):通过内容为空的系统消息更新 output_config.effort,可以保留此前的提示词缓存。反过来,在下一次请求直接修改顶层 effort 会让缓存前缀重新开始。需要动态档位时,先读官方说明并核对所需的测试版请求头,不要只改一个字段就假定缓存仍命中。
改 model ID 前先排除三类 400 或状态丢失
官方迁移指南把 Fable 5 到 5.1 的变化写得比“替换模型名”更严格。
第一,5.1 不支持强制工具调用。tool_choice 为 any,或指定 {type: "tool", name: "..."},会返回 400 invalid_request_error。允许的值是 auto 和 none。如果需要符合指定结构的 JSON,可在 auto 下使用 strict: true,或改用 结构化输出;如果业务必须调用某个工具,应在指令中清楚说明适用条件并验证结果。
第二,Fable 5.1 能读取旧模型的推理内容块(thinking blocks),但旧模型不能反向读取 5.1 生成的推理内容块。若路由器会在一段会话里降级到旧模型,不能假定之前的推理状态完整保留。
第三,自行维护 Messages 会话历史时,如果改写之前的消息、重建系统提示词或 tools 数组,可能使后续的 5.1 推理内容块失效。最安全的迁移基线是让历史只追加,不改写已发送的前缀;需要清理上下文时使用服务端上下文编辑或压缩功能,或按官方迁移步骤处理推理内容块。不同账户的前缀绑定执行时间有差异,因此先用非生产会话观察 400 与 input_transformations。
另外,thinking: {type: "disabled"} 和手工 budget_tokens 都不适用于 Fable 5.1;也不能通过关闭思考来恢复强制工具调用。
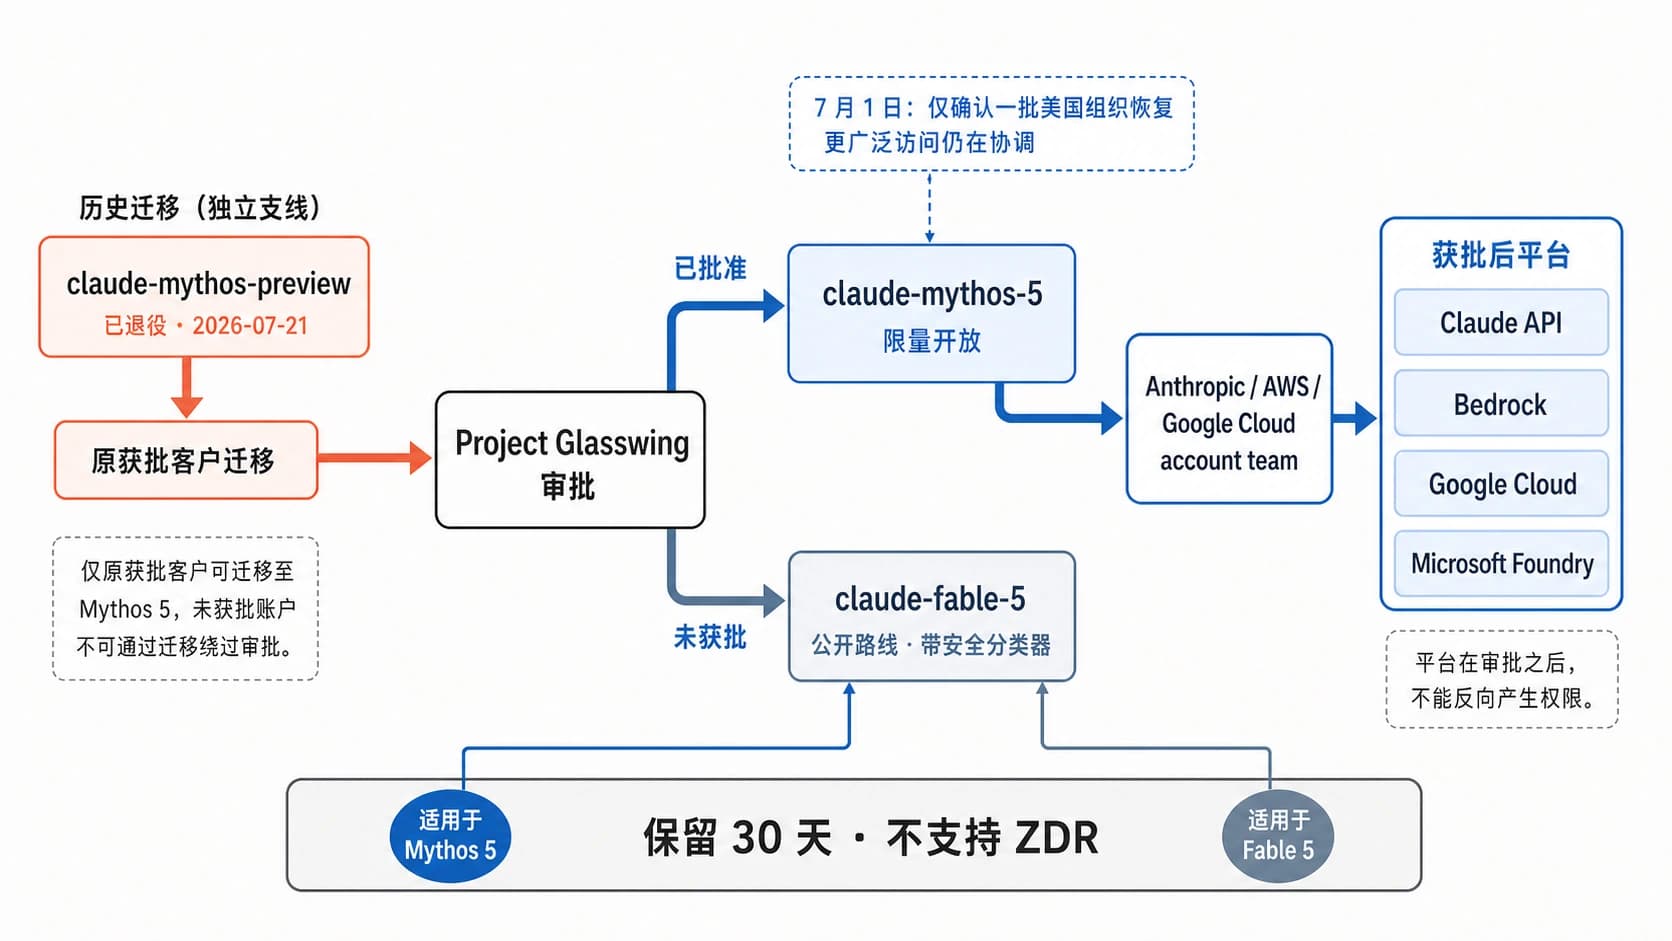
Mythos 5.1 需要单独的访问资格
Fable 5.1 新功能页称 Fable 5.1 与 Mythos 5.1 共享能力、规格和价格。差异主要是访问与安全边界:
claude-fable-5-1面向 Claude API 与官方列出的合作平台客户开放;claude-mythos-5-1只提供给获批的 Project Glasswing 客户;- 两者都要求 30 天数据保留,除非 Anthropic 明确另行授权;
- 两者当前都不支持 Priority Tier。
所以没有账户级审批证据时,不要把 Mythos 写进生产方案,也不要因为某个云目录出现 model ID 就认为已经有权限。需要确认申请条件和平台支持范围时,可阅读Claude Mythos API 权限指南。
用每个成功任务成本做最后决定
选择一小组真实但不含敏感数据的任务,从同一输入、工具、权限和验收标准开始。第一组使用 claude-opus-5,第二组使用 claude-fable-5-1;明确写出 effort,不要在一条长会话中途换模型,因为历史重读和缓存重建会污染比较。记录普通输入、两类缓存写入、缓存读取、输出 token、延迟、工具轮次、拒绝、400、人工修正和是否通过。
不要只除以请求数。把每个方案的总费用(包括失败与重试)除以最终通过验收的任务数;没有任务通过时,单独记录失败,不计算平均完成成本。若 Opus 已经稳定通过,它就是更简单的默认选择;若 Fable 在难任务上减少了足够多的失败、轮次或人工修正,或工作负载确实由重复缓存读取主导,才有证据承担更高的普通 token 单价。
最终规则可以很简单:常规任务先从 Opus 5 开始;长时间难任务或极高缓存读取占比,把 Fable 5.1 以较低 effort 加入同条件测试;只有它的每个成功任务成本或成功率真正更好,才扩大流量。没有 Glasswing 审批时,Mythos 不进入可执行选项。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月3日。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月3日。
- 1.Anthropic 官方价格表platform.claude.com/docs/en/about-claude/pricing
- 2.Anthropic 的成本与智能优化指南platform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence
- 3.Effort 文档platform.claude.com/docs/en/build-with-claude/effort
- 4.官方迁移指南platform.claude.com/docs/en/models/fable-5-1/migration-guide
- 5.Fable 5.1 新功能页platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1