Claude Code 视频剪辑怎么做:它读转写稿不看画面,口播最合适
Claude Code 能剪视频,但不读 mp4:它读带时间戳的转写稿,决定留哪几段,再调用 ffmpeg 剪切、加字幕、出竖版。口播和教程最合适,多机位和调色仍要人工。
文章目录
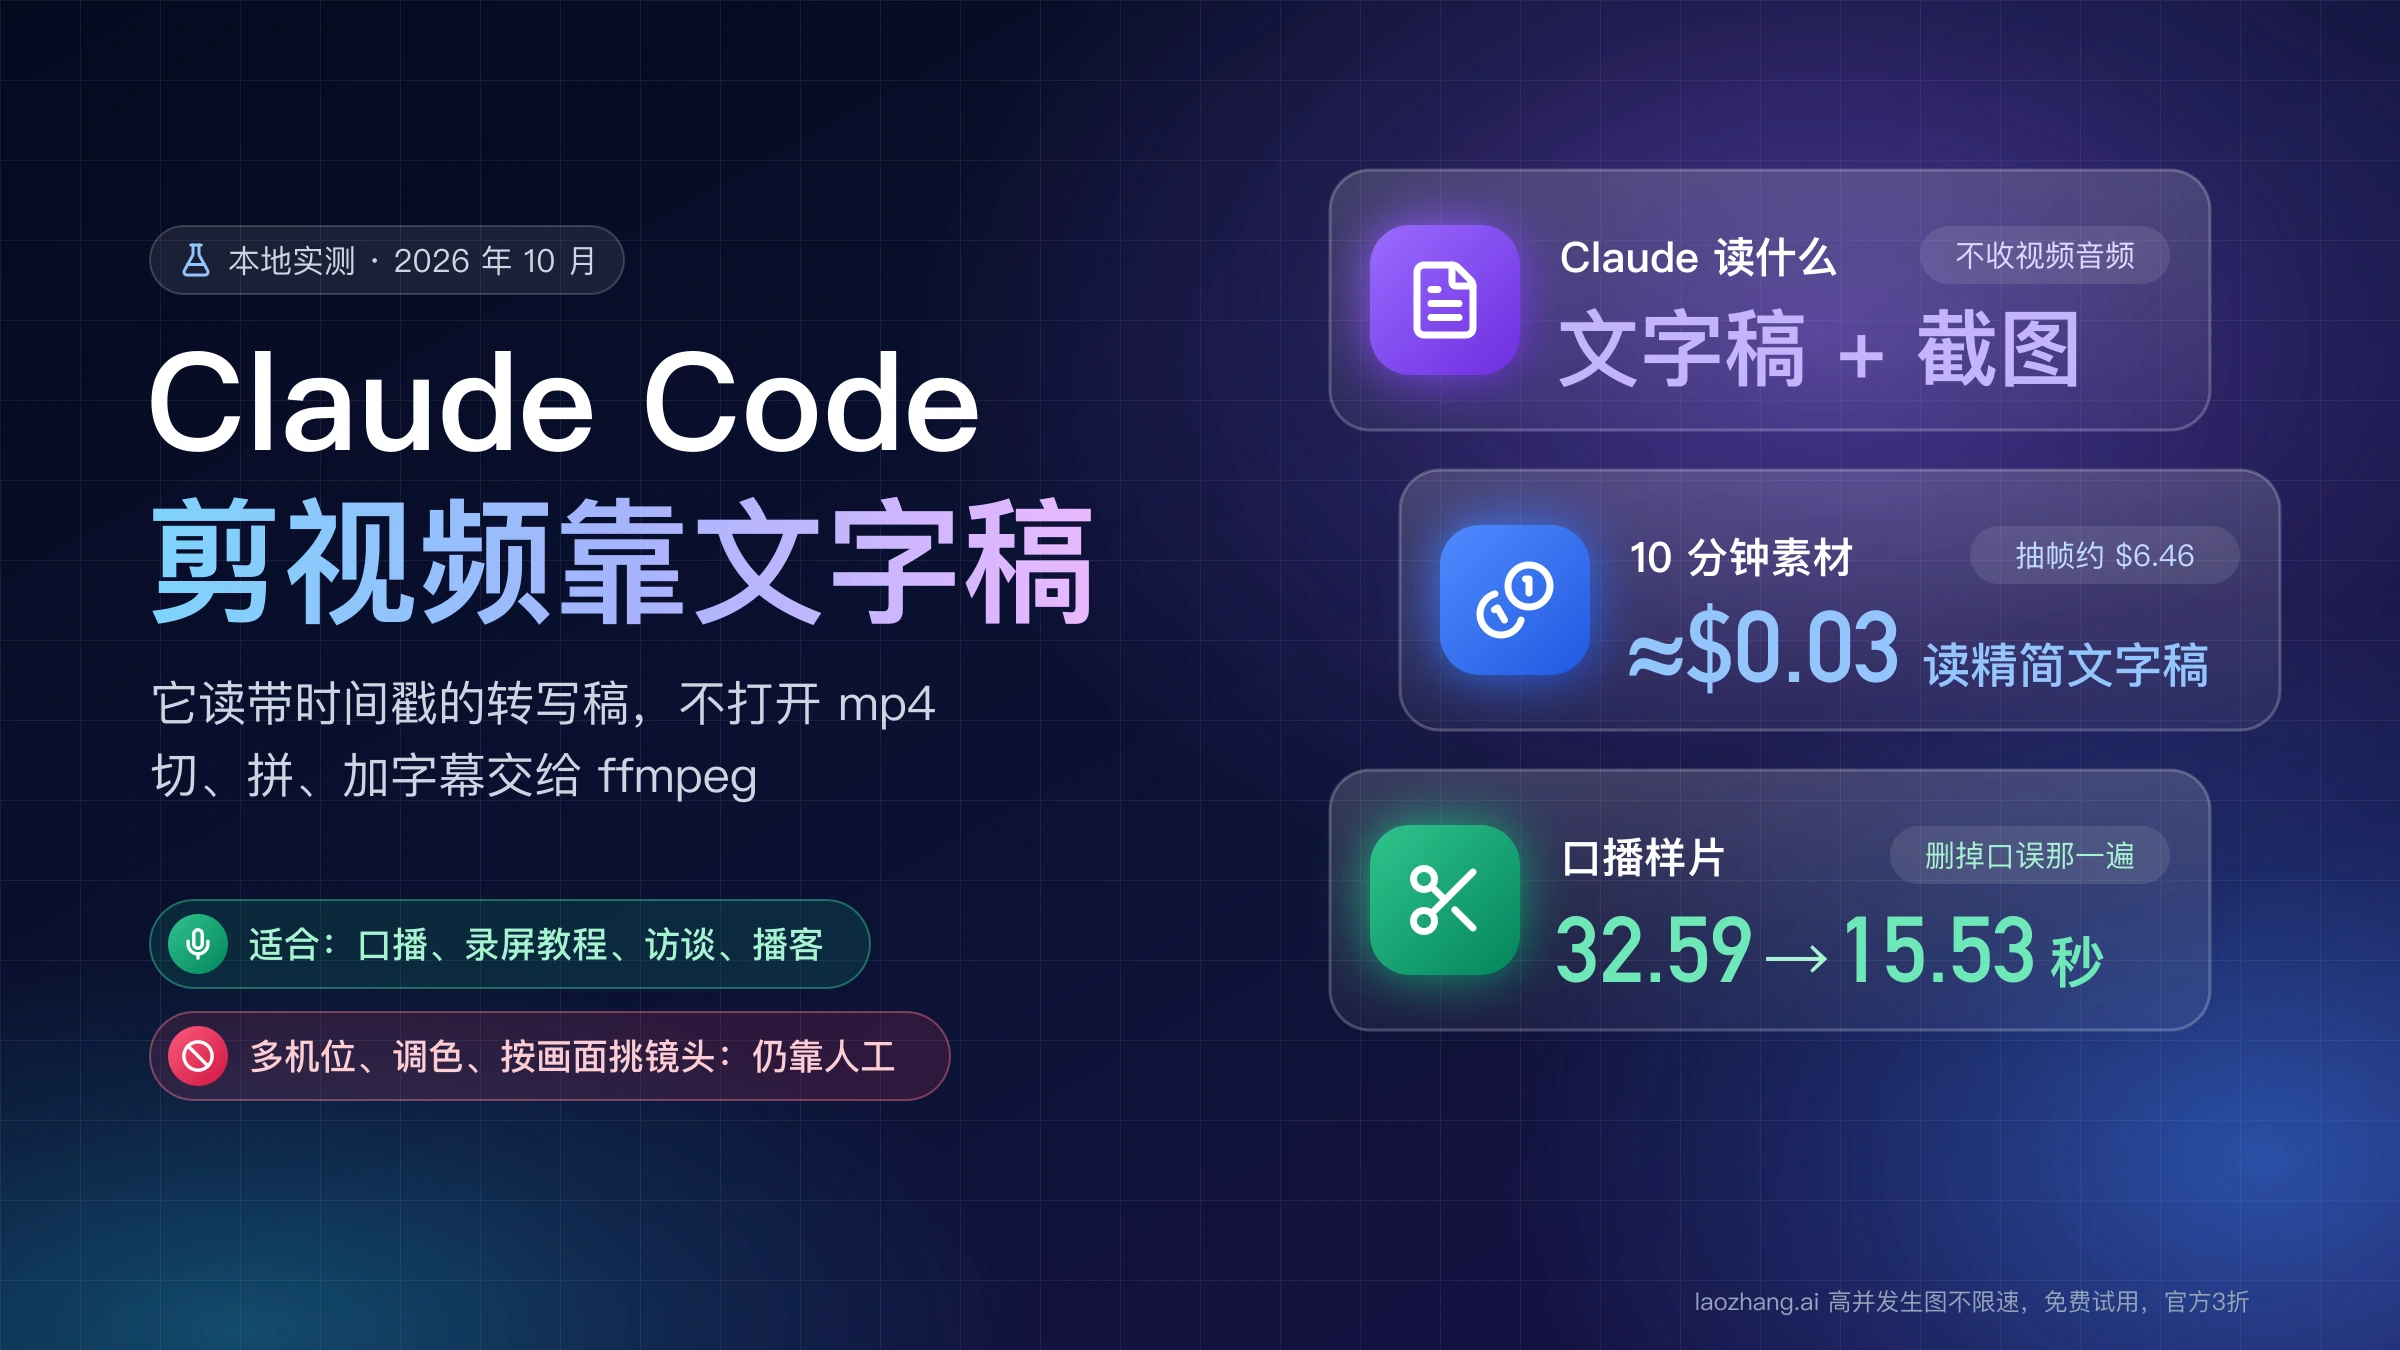
Claude Code 可以剪视频,但方式和"把 mp4 丢给它看"不一样。Claude 不接收视频和音频文件,它读的是素材的转写文字稿(每个词带开始和结束时间),需要时再看几张抽出来的截图,然后写出"保留哪几段"的剪辑表,由 ffmpeg 去切、拼、加字幕。所以它擅长以说话为主的素材:单人口播、录屏教程、访谈、播客。去停顿、删掉说错重来的那一遍、加字幕、出 9:16 竖版都能做;多机位切换、以调色为主的片子、要看画面挑镜头的 Vlog,它没有依据可判断。
路线按素材和预算选:
- 不想多付任何转写费、能接受命令行:本地 Whisper 转写 + ffmpeg 脚本,由 Claude Code 写剪辑表并执行。
- 想要一条龙(去口误、调色、字幕、动画),能接受付费转写:video-use 这个 Claude Code skill,需要 ElevenLabs key。
- 素材里没有重录,只想去掉空白:auto-editor 一条命令。
- 最后要在 Premiere、达芬奇或 Final Cut 里精剪:让工具导出时间线,Claude 只负责粗剪。
这里的"剪"指处理已经拍好的素材。想让 Claude 用代码生成新的动画视频,看 Claude Opus 5.5 能生成视频吗:它写代码做视频,画面靠渲染;claude.ai 里的 Motion 动画是另一项功能,见 Claude Dashboards 和 Motion 怎么用:Pro 能做看板,动画要 Team 起。
Claude 为什么读不了 mp4:只认图片和文字,剪辑靠转写稿
Anthropic 的视觉(Vision)文档列出的输入格式是 JPEG、PNG、GIF 和 WebP,GIF 动图也只取第一帧;Claude Code 工具参考里 Read 工具能返回的是图片、PDF 和 Jupyter notebook。两份文档都没有视频或音频这一项。由此可以推断:Claude 本身不会打开 mp4,也听不到声音,想让它"看"素材,只能先用 ffmpeg 抽帧、用语音识别出文字稿。
所以"一句话让 Claude Code 自动剪视频"背后,实际是四步:
- 用 Whisper 这类语音识别模型转写音频,得到逐词时间戳。
- Claude 读文字稿,判断哪几句是重录、哪里是停顿,写出保留区间(剪辑表,也叫 EDL)。
- ffmpeg 按剪辑表切片、拼接、加淡入淡出。
- 把词的时间映射到新时间线上生成字幕,再按需烧录或出竖版。
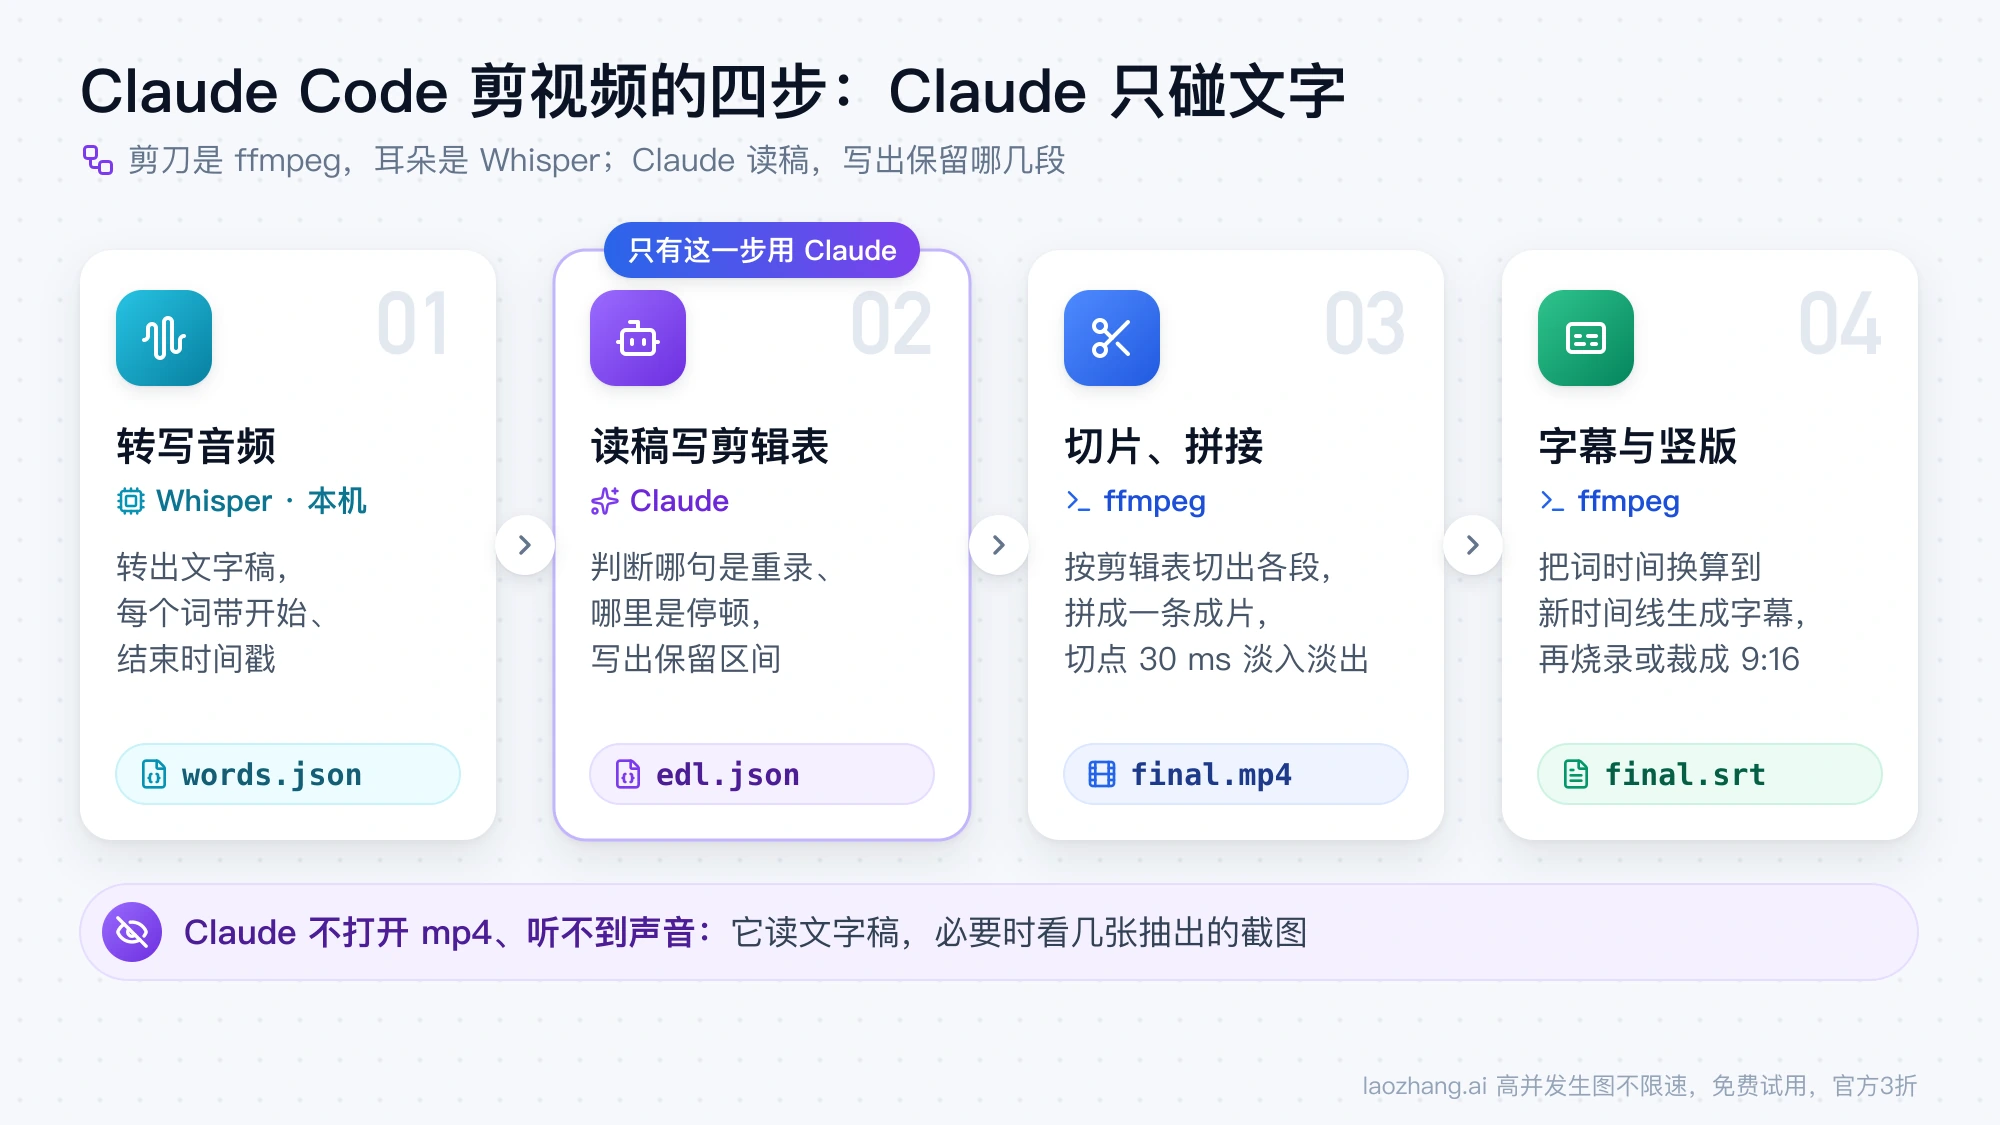
Claude 自己没有剪辑功能,它是在指挥 ffmpeg 和 Whisper。日本 Fyve 在 2026 年 6 月 29 日的 Claude Code 剪视频入门文章里也是这样描述的,并建议把产出当草稿:大约七成自动,三成仍靠手工。
为什么靠转写稿:10 分钟素材抽帧约 $6.46,文字稿约 $0.03–$0.08
图片按 28×28 像素一块计费:一张图的视觉 token 数 = ⌈宽/28⌉ × ⌈高/28⌉。Claude 4.7 及以后的模型(包括 Opus 5.5)走高分辨率档,1920×1080 的一帧不缩放,记 2,691 token;其他模型走标准档,同一帧会缩到 1456×819,记 1,560 token(公式和示例都来自上面的 Vision 文档)。
拿一段 10 分钟的素材,按 Opus 5.5 截至 2026 年 10 月的 API 标价每百万输入 token $4(Claude 价格页)算一遍:
| 给 Claude 的内容 | 计算 | 输入 token | 按 $4/百万 token |
|---|---|---|---|
| 每秒抽 1 帧,1080p 原尺寸 | 600 帧 × 2,691 | 约 161 万 | 约 $6.46 |
| 每秒抽 1 帧,缩到 640×360 | 600 帧 × (23 × 13 = 299) | 约 17.9 万 | 约 $0.72 |
| 逐词 JSON 文字稿 | 约 1,500 词 × 57 字节 ≈ 86 KB ÷ 4 | 约 2.1 万 | 约 $0.084 |
| 精简文字稿(每行"开始 结束 词") | 约 1,500 词 × 20 字节 ≈ 30 KB ÷ 4 | 约 7,500 | 约 $0.03 |
表里的假设:口播每分钟约 150 词;每词 57 字节是下文测试样片的实测值(57 个词的 JSON 共 3,275 字节);按约 4 个字符 1 个 token 估算,这是英文的经验值,中文文字稿的换算不同。这是按公式算的,不是账单;Claude Code 的每一轮还会带上系统提示、工具定义和之前的对话,整段会话花得更多。
结论很直接:全分辨率抽帧比读文字稿贵约 77 到 215 倍,而且就算看了 600 张图,Claude 仍然听不到一句话。video-use 的 README 也用同样的对比解释它为什么只给 Claude 看打包后的文字稿和少量截图。抽帧适合在少数关键点上确认画面,不适合当主要输入。
用 Pro 或 Max 订阅时,这些 token 不会单独出账单,而是消耗用量额度。素材越长,读稿和反复修改越费额度,韩国 Heimdex 在 2026 年 8 月 5 日的 Claude Code 剪辑自动化指南里也提醒过长素材可能把额度用完。套餐怎么选见 Claude Code 价格 2026:Pro、Max、Team、API 和额外用量怎么选;额度掉得异常快时,可以对照 Claude Code Max配额消耗异常?完整诊断与修复指南(2026)排查。
剪辑 skill、脚本和插件怎么选:六条路线的费用与短板
下表是 Claude Code 剪已有素材的几条常见路线。标"已测"的两条在下文的本地测试里实际跑过,其余按各项目自己的文档描述。
| 路线 | 对原始素材做什么 | Claude 之外的费用或 key | 素材在哪处理 | 主要短板 |
|---|---|---|---|---|
| Whisper + ffmpeg 脚本(已测) | 去停顿、按文字稿删重录、字幕、竖版 | 本地模型不按小时收费;Mac 上烧录字幕要装 ffmpeg-full | 本机 | 词边界有偏差,要校正切点;脚本自己维护 |
| video-use(skill) | 去语气词、口误和空白,分段调色,切点 30 ms 淡入淡出,烧录字幕,动画叠加,自查切点最多 3 轮 | ElevenLabs Scribe key,$0.22/小时音频 | 本机渲染,音频上传 ElevenLabs 转写 | 只做口播,B-roll 不支持;本地 Whisper 方案尚未合并 |
| auto-editor(已测) | 按音量或画面变化去掉空白 | 免费(Unlicense) | 本机 | 不懂字词,说错重录的那一遍会留下 |
| ButterCut | 本地 WhisperX 转写 + 画面分析,Claude 出粗剪,导出 XML | 免费(非商用许可,成片可商用);Pro 版 $49/年加多轨 B-roll | 本机,主要面向 Apple Silicon | 要装 Ruby、Python、完整版 FFmpeg 和 WhisperX |
| 剪辑软件 MCP(达芬奇、Premiere、Palmier Pro) | Claude 在真实时间线上排片、打标记、渲染 | 达芬奇要 Studio 版才稳定;Premiere 要订阅加 CEP 面板 | 本机剪辑软件 | 社区项目,只做"初版拼接",不判断剪得好不好 |
| ChatCut 的 Claude Code 插件 | 修剪、降噪、字幕、动效、生成 B-roll、配音,浏览器里有时间线 | ChatCut 月费 $25 / $45 / $88 / $160 | 素材上传到 ChatCut | Claude 用量和 ChatCut 订阅两头付费,素材离开本机 |
几点补充,都会改变选择:
- video-use 的转写只能用 ElevenLabs。 它的 SKILL.md 把"在 CPU 上本地跑 Whisper"列为反面做法(慢,而且会把语气词规整掉)。社区提过多个本地 Whisper、Groq Whisper 和 FunASR 的合并请求,截至 2026 年 10 月 15 日,#12、#28、#114 已关闭未合并,#22、#60、#151、#223 和 FunASR 的 #4 仍未合并。按 ElevenLabs API 价格页,Scribe v2 每小时音频 $0.22,各档同价,免费档大约含 4.5 小时。
- video-use 的边界:俄罗斯 Habr 上 2026 年 5 月 7 日的 video-use 评测文章说,它只适合口播,B-roll 开箱不支持;自查能抓到爆音、字幕被挡这类技术问题,但抓不到"留错了那一条"这类内容问题。作者的结论是偶尔剪一条的话,在达芬奇里手动剪两小时可能更省事。
- 剪辑软件 MCP 都是社区项目,不是 Blackmagic 或 Adobe 出的。davinci-resolve-mcp 在 README 里写明不做"判断剪辑好坏",产出是初版拼接;它通过官方脚本 API 控制达芬奇 Studio,免费版要靠桥接脚本,并说 21.1 起 Python 脚本移到了 Studio 版。Adobe_Premiere_Pro_MCP 通过 CEP 面板控制 Premiere,只在 macOS 上完整验证过。Palmier Pro 是自带 MCP 服务的 Mac 剪辑软件,要求 macOS 26 和 Apple Silicon,v0.7.6 之后的版本不再开源。
按素材对号入座:
- 单人口播、录屏教程,有重录:先用 Whisper + ffmpeg 脚本或 video-use。前者零转写费,后者省去自己写脚本。
- 一条到底、没有重录,只是停顿多:auto-editor 就够了。
- 播客、访谈要交给剪辑师精剪:auto-editor 或 ButterCut 导出时间线,Claude 负责粗剪。
- 已经在用达芬奇 Studio 或 Premiere,想让 Claude 帮忙排片、打标记:试剪辑软件 MCP。
- 不想装任何环境、素材可以上传:ChatCut。
- 多机位、以调色为主、要按画面挑镜头:留在剪辑软件里手工剪,这几条路线都帮不上主要的忙。
skill 怎么装、怎么确认生效,见 Claude Code Skills 推荐:先用哪个、怎么安装与确认生效;MCP 的添加方法见 Claude Code 最值得先加的 MCP(2026):按工作流选第一批集成。
另外三样常被一起提到的工具不剪原始素材:claude-code-video-toolkit 主要用来生成新视频,对已有素材主要是重新配音、加音乐、去水印和裁切拼接,没有去静音和字幕;HyperFrames(Apache-2.0)和 Remotion 用来做叠在成片上的标题、图表和动画,Remotion 对个人和 3 人以内的公司免费,更大的公司要买 Remotion 公司许可;Claude Motion 在 claude.ai 里做动画,不处理上传的视频,也不属于 Claude Code。
本地免费路线实测:Whisper 转写 + ffmpeg 剪掉一段口误
这次测试想回答一个问题:只靠本地工具,Claude Code 能不能认出"说错重来"的那一遍并把它剪掉。在这段样片上能做到,但中途踩了三个坑。
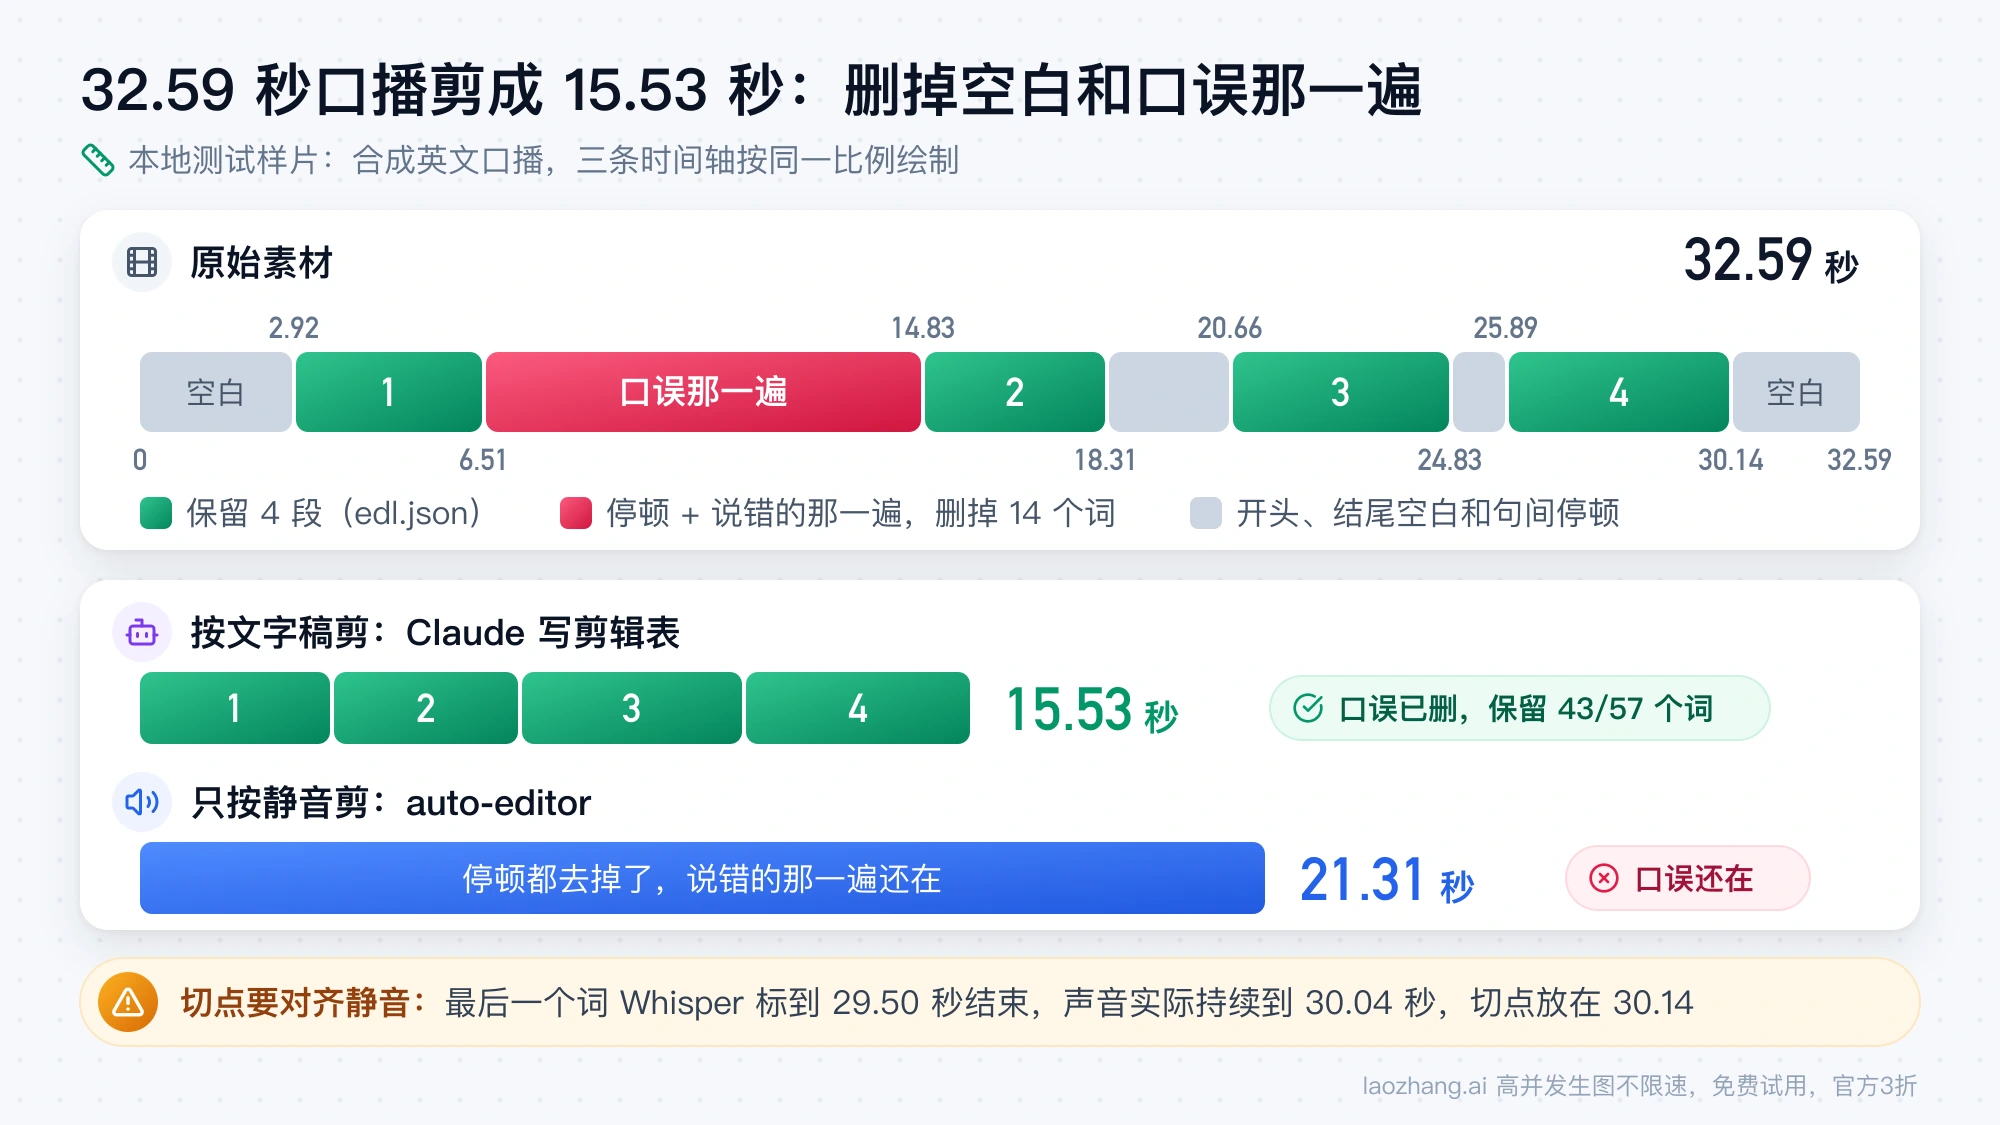
测试素材和环境:合成英文口播,32.59 秒
- 机器:Apple M4,macOS 26.1,Homebrew;Claude Code 会话使用 Opus 5.5。还没装 Claude Code 的话,先看 Claude Code 安装教程:全平台完整设置指南(2026)。
- 素材:32.59 秒、1920×1080、30 fps 的 H.264 视频。声音是 macOS
say合成的英文语音,画面是 ffmpegtestsrc2测试图,没有真人、没有环境噪声,只有一个说话人。 - 内容:开头 3 秒空白,句间有 2.5 秒和 1.2 秒的停顿,结尾空 2.5 秒;中间有一处口误:"First, we cut out the long pauses. Um, wait, let me say that again.",紧接着是说对的一遍。
这是一次单机、单样本的测试。素材是英文合成语音,中文转写没有测,转写准确率不能推广到真实录音、口音、背景音乐或其他语言。
第一步:faster-whisper 生成逐词时间戳
python3 -m venv venv
./venv/bin/pip install faster-whisper "av<19"
./venv/bin/python transcribe.py raw/talk.mp4 base.en
"av<19" 这个版本限制不能省,原因见下一节的第一个故障。transcribe.py 如下:
"""第一步:给原始素材生成逐词时间戳(本地运行,不需要 API key)。"""
import json
import sys
import time

from faster_whisper import WhisperModel

src = sys.argv[1]
model_name = sys.argv[2] if len(sys.argv) > 2 else "base.en"

t0 = time.time()
model = WhisperModel(model_name, device="cpu", compute_type="int8")
segments, info = model.transcribe(src, word_timestamps=True, vad_filter=False)
words = []
for seg in segments:
    for w in seg.words:
        words.append({"start": round(w.start, 2), "end": round(w.end, 2), "word": w.word.strip()})
json.dump(words, open("words.json", "w"), indent=1)
print(f"model={model_name} words={len(words)} audio={info.duration:.1f}s elapsed={time.time()-t0:.1f}s")结果:base.en 模型、CPU int8,32.6 秒音频转出 57 个词,用时 3.0 秒(含加载模型;首次运行会下载约 141 MB 模型,下载时间没算在内)。base.en 和 small.en 名字里的 .en 表示英文模型,中文素材要换不带 .en 的多语言模型并指定语言,这一步未经测试。
第二步:让 Claude Code 读文字稿,写出剪辑表
这一步是整个流程里真正用到 Claude 的地方。在素材目录里打开 Claude Code,可以这样交代(示例写法):
读 words.json,里面是每个词的开始和结束时间。这是一段口播,中间有一处说错后重录。
写 edl.json:每句话只保留最后一次完整说对的版本,去掉开头空白和句间超过 1 秒的停顿,
格式为 [{"start": 秒, "end": 秒}, ...]。
写之前先用 ffmpeg 的 silencedetect 找出静音区间,把每个切点对齐到最近的静音边界。
先列出打算删掉的内容让我确认,再写文件。
Claude 读完文字稿,保留了 4 段:去掉开头 3 秒,整段删除口误那一遍(它重复了"First, we cut out the long pauses"),保留重录的那一遍,压短长停顿。最后用的 edl.json:
[{"start": 2.92, "end": 6.51}, {"start": 14.83, "end": 18.31}, {"start": 20.66, "end": 24.83}, {"start": 25.89, "end": 30.14}]示例里"对齐静音边界"那一句来自第一版的教训:第一版剪辑表直接用 Whisper 的时间加了一点余量,结果切掉了最后一个词的尾音,详见下一节。
第三步:render.py 用一个滤镜图剪完,并生成字幕
render.py 把每个保留区间做 trim/atrim,两端各加 30 ms 音频淡入淡出,再 concat 拼起来;然后把词的时间换算到新时间线,每 2–3 个词一条字幕:
"""第三步:按剪辑表(保留区间)输出 final.mp4 和 final.srt。"""
import json
import subprocess
import sys

src = sys.argv[1]
edl = json.load(open("edl.json"))
words = json.load(open("words.json"))
FADE = 0.03

# 1) 在一个 ffmpeg 滤镜图里完成剪切和拼接
parts, labels = [], []
for i, k in enumerate(edl):
    d = k["end"] - k["start"]
    parts.append(f"[0:v]trim={k['start']}:{k['end']},setpts=PTS-STARTPTS[v{i}]")
    parts.append(
        f"[0:a]atrim={k['start']}:{k['end']},asetpts=PTS-STARTPTS,"
        f"afade=t=in:d={FADE},afade=t=out:st={d - FADE:.3f}:d={FADE}[a{i}]"
    )
    labels.append(f"[v{i}][a{i}]")
graph = ";".join(parts) + ";" + "".join(labels) + f"concat=n={len(edl)}:v=1:a=1[v][a]"
subprocess.run(
    ["ffmpeg", "-v", "error", "-y", "-i", src, "-filter_complex", graph, "-map", "[v]", "-map", "[a]",
     "-c:v", "libx264", "-crf", "20", "-preset", "veryfast", "-c:a", "aac", "-b:a", "160k", "final.mp4"],
    check=True,
)

# 2) 把词的时间换算到新时间线,凑成字幕
# 只要词和某个保留区间有重叠就保留,并把时间夹到区间内
# (Whisper 的词边界会偏几百毫秒,要求完全落在区间内会漏词)
kept = []
for w in words:
    offset = 0.0
    for k in edl:
        overlap = min(w["end"], k["end"]) - max(w["start"], k["start"])
        if overlap > 0:
            s = max(w["start"], k["start"]) - k["start"] + offset
            e = min(w["end"], k["end"]) - k["start"] + offset
            kept.append({"start": s, "end": e, "word": w["word"]})
            break
        offset += k["end"] - k["start"]

def ts(t):
    h, rem = divmod(t, 3600)
    m, s = divmod(rem, 60)
    return f"{int(h):02d}:{int(m):02d}:{int(s):02d},{int(round((s % 1) * 1000)):03d}"

cues, chunk = [], []
for w in kept:
    chunk.append(w)
    if len(chunk) == 3 or w["word"].endswith((".", ",", "?", "!")):
        cues.append(chunk)
        chunk = []
if chunk:
    cues.append(chunk)
with open("final.srt", "w") as f:
    for n, c in enumerate(cues, 1):
        text = " ".join(x["word"] for x in c)
        f.write(f"{n}\n{ts(c[0]['start'])} --> {ts(c[-1]['end'])}\n{text}\n\n")
print(f"segments={len(edl)} kept_words={len(kept)}/{len(words)} cues={len(cues)}")
运行 python3 render.py raw/talk.mp4,4 段渲染用时约 1.5 秒,输出 15.53 秒的 1080p 成片。保留 57 个词中的 43 个,删掉的 14 个正好是口误那一遍;字幕共 18 条。把成片重新转写一遍,整段稿子完整,口误消失,最后一个词也没被切。
字幕部分的第一版有个 bug:只保留开始和结束都落在区间内的词,切点对齐静音边界后,"Hi," 等词被漏掉,只剩 40/57。改成"有重叠就保留,时间夹到区间内"后恢复正常,上面贴的是修好的版本。
第四步:软字幕、烧录字幕和 9:16 竖版
软字幕(播放器里可开关的字幕轨)用标准 ffmpeg 就行:
ffmpeg -i final.mp4 -i final.srt -map 0 -map 1 -c copy -c:s mov_text -metadata:s:s:0 language=eng final_softsubs.mp4很多短视频平台会忽略视频里内嵌的字幕轨,上传时把 .srt 单独传上去更稳。
把字幕烧进画面要用带 libass 的 ffmpeg(Mac 上是 ffmpeg-full,原因见下一节):
/opt/homebrew/opt/ffmpeg-full/bin/ffmpeg -i final.mp4 -vf "subtitles=final.srt:force_style='FontName=Helvetica,FontSize=22,Outline=2'" -c:v libx264 -crf 20 -preset veryfast -c:a copy final_burned.mp4用时 1.67 秒。竖版只要把 -vf 换成下面这串,输出 1080×1920,用时 1.39 秒:
crop=ih*9/16:ih,scale=1080:1920,subtitles=final.srt:force_style='FontName=Helvetica,FontSize=14,MarginV=60,Outline=2'从成片 1.2 秒处抽一帧检查:画面上的测试时间码是 00:00:03.800,字幕是 "this is a",说明切点映射和字幕都对得上。两点限制:中心裁切只适合主体在画面中间的素材,人在画面里走动就要做人脸跟踪(未测);Helvetica 是 macOS 字体,其他系统要换字体名,中文字幕要换成带中文字形的字体(未测)。
实测遇到的三个故障:报错原文和修法
TypeError: open() got an unexpected keyword argument 'metadata_errors'
只执行 pip install faster-whisper 时,装上的是 faster-whisper 1.2.1(2026 年 10 月 15 日 PyPI 上的最新版)和 PyAV 19.0.1,调用 model.transcribe() 就报这个错。把 PyAV 限制在 19 以下即可:
pip install faster-whisper "av<19"装上的是 PyAV 18.1.0,转写恢复正常。PyAV 19.0.0 在 2026 年 9 月 29 日发布,19.0.1 在 10 月 3 日;从报错堆栈看是新版 PyAV 改了接口,faster-whisper 以后的版本可能会修复,到时这个限制就不需要了。
成片最后一个词被切掉:Whisper 词边界偏差约 0.5 秒
第一版剪辑表直接用 Whisper 给的时间加小余量,渲染后重新转写,最后的 "platforms." 被听成了 "platform."。Whisper 标的结束时间是 29.50 秒,而 silencedetect 显示声音实际持续到 30.04 秒;开头的 "Hi," 也有类似偏差(Whisper 标 2.74 秒,实际 3.02 秒才出声)。
修法是先找出静音区间:
ffmpeg -i raw/talk.mp4 -af silencedetect=noise=-40dB:d=0.3 -f null -再把每个切点对齐到最近的静音边界,前后留 ±0.1 秒。改过的剪辑表成片 15.53 秒,尾音完整。
偏差这件事不只出现在这一个样本里。西班牙 Aducti 在 2026 年 9 月 1 日的 Claude Code 剪辑 skill 文章里说,Whisper 会把句前的静音并进句子第一个词,按第一个词剪会留下约 0.5 秒空白,他们同样用 silencedetect 交叉校正;video-use 的 SKILL.md 说 ElevenLabs Scribe 的时间戳也会偏 50–100 ms,建议切点留 30–200 ms 余量,并尽量在 400 ms 以上的静音里下刀。
No such filter: 'subtitles':Homebrew 标准 ffmpeg 没有字幕滤镜
用 brew install ffmpeg 装的标准版(测过 8.0.1_2 和当前的 9.0.2)没有 subtitles、ass、drawtext 三个滤镜,ffmpeg -filters 里查不到。报错有两种写法:
-vf subtitles=final.srt报 "No option name near 'final.srt'" 和 "Error parsing filterchain"。-vf subtitles=filename=final.srt报 "No such filter: 'subtitles'"。
原因是 Homebrew 的 ffmpeg 公式不带 libass 和 freetype。改装 ffmpeg-full:
brew install ffmpeg-full这台机器上用了 2 分 05 秒。ffmpeg-full 多了 libass、freetype、fontconfig、harfbuzz、whisper.cpp 等依赖,有 subtitles、ass、drawtext 和 whisper 滤镜。它是 keg-only,不会进 PATH,要用完整路径 /opt/homebrew/opt/ffmpeg-full/bin/ffmpeg。
装完还出了个连带问题:ffmpeg-full 把共享依赖 libvpx 从 1.15.2 升到 1.17.0,机器上原来那个没更新的 ffmpeg 8.0.1_2 随即启动失败,报 dyld: Library not loaded: /opt/homebrew/opt/libvpx/lib/libvpx.11.dylib。执行 brew upgrade ffmpeg(升到 9.0.2_1,8 秒)就好了,之后 brew linkage --test 没有再发现缺失的库。
Linux 发行版和 Windows 上的 ffmpeg 构建各不相同,很多"full"版本自带 libass,这些平台没有测。只要软字幕,标准 ffmpeg 就够,不必装 ffmpeg-full。
只按静音剪的 auto-editor:一条命令去空白,但口误留着
auto-editor 按音量(或画面变化)判断哪里是空白,不需要文字稿。同一段样片:
brew install auto-editor
auto-editor raw/talk.mp4 --margin 0.2s -o out.mp4 --no-open
auto-editor 31.7.2 用 3.9 秒输出 21.31 秒的成片,停顿都去掉了,但说错的那一遍还在:导出的时间线里有一段从 8.8 秒开始、152 帧长的片段,正是口误那一遍。静音检测不知道哪一遍说错了,这个判断只能靠读文字稿,也就是交给 Claude 的那一步。
安装注意:auto-editor 的 README 写明命令行版"不再发布到 pip",PyPI 上停在 2025 年 11 月 4 日的 29.3.1;Mac 用 brew install auto-editor,其他系统从 GitHub Releases 下载二进制。
不装 Python 也能转写:auto-editor whisper 与 ffmpeg 的 whisper 滤镜
不想折腾 Python 环境时,有两个现成的转写入口,都要先从 Hugging Face 的 whisper.cpp 仓库下载 ggml 格式模型(ggml-base.en.bin,148 MB):
auto-editor whisper raw/talk.mp4 ggml-base.en.bin -f srt --prompt "Claude Code" -o out.srt
/opt/homebrew/opt/ffmpeg-full/bin/ffmpeg -i raw/talk.mp4 -vn -af "whisper=model=ggml-base.en.bin:language=en:destination=ff_whisper.srt:format=srt" -f null -| 转写方式 | 用时 | 输出 | 要注意的地方 |
|---|---|---|---|
faster-whisper base.en(Python) | 3.0 秒 | 逐词时间戳 | 要限制 av<19 |
auto-editor 31.7.2 whisper | 12.2 秒 | 5 条整句字幕 | 每条结束时间都是开始时间加 4–5 秒,不能当切点用 |
ffmpeg-full whisper 滤镜 | 12.95 秒 | SRT 字幕 | 不加提示词时把 "Claude Code" 拆成 "Claude." 和 "code." 两条;编号从 0 开始 |
用时都是同一段 32.6 秒样片在 M4 上的结果。auto-editor 加了 --prompt "Claude Code" 之后,产品名拼写正确。专有名词还有一个现象:small.en 把 "Claude Code" 听成了 "clog code",base.en 在同一段音频上却听对了。一个合成样本说明不了哪个模型更好,只说明字幕里的产品名、人名一定要人工核对,或者用提示词、热词提前告诉模型。
交给 Premiere、达芬奇、Final Cut 精剪:导出时间线或用 MCP
Claude 做粗剪、人在剪辑软件里收尾,是比较稳妥的分工。有三种接法:
- auto-editor 导出时间线。
--export premiere、--export resolve、--export final-cut-pro,以及shotcut、kdenlive。测试里auto-editor raw/talk.mp4 --export resolve -o ae_timeline.fcpxml写出了一份 FCPXML 1.11 时间线,引用的是原始素材,可以直接在剪辑软件里继续剪。它只按静音切,重录要自己在时间线上删。 - ButterCut 导出 XML。 本地用 WhisperX 转写、加画面分析,Claude 和你一起挑出粗剪,再导出给 Final Cut Pro、Premiere 或达芬奇。主要支持 Apple Silicon Mac,Windows 和 Linux 不是重点。
- 剪辑软件 MCP。 Claude 直接在达芬奇或 Premiere 的时间线上操作。达芬奇这条路实际要 Studio 版;Premiere 要装 CEP 面板,部分操作(比如读取已有字幕文本、移除效果)脚本接口做不到,README 自己也写了"不是魔法"。
剪映目前不在这几条路线里:auto-editor 的导出格式不包括剪映,能接 Claude Code 的剪辑软件 MCP 项目也只覆盖达芬奇、Premiere 和 Palmier Pro。
改动剪辑点之后,原来叠在上面的动画、标题时间会跟着错位(Heimdex 的指南也提到这一点),所以动画和字幕放到剪辑定稿之后再做。
交付前检查清单:Claude Code 剪出的成片要人工看哪些地方
自动剪辑出的是初稿,下面这些点要人过一遍:
- 每个切点听一遍:尾音有没有被切、呼吸声和爆音是否突兀。测试里被切掉的正是最后一个词的尾音。
- 留下的是不是对的那一遍:把成片再转写一次,和原稿对照。Habr 的评测指出,video-use 的自查只能发现技术问题,发现不了留错了哪一条。
- 专有名词:产品名、人名、品牌名逐个核对,必要时给转写加提示词。
- 字幕最后加:动画叠层会挡住字幕,video-use 的 SKILL.md 明确要求字幕放在最后一步;它还提醒字体出错时不会报错,只是默默显示不对,所以要抽帧看。
- 竖版构图:中心裁切后人还在不在画面里,字幕会不会压住嘴。
- 长视频的字幕漂移:Fyve 提到长视频容易出现字幕时间漂移,重点抽查后半段。
- 字幕文件格式:ffmpeg whisper 滤镜输出的 SRT 编号从 0 开始,有的播放器或平台要求从 1 开始,上传被拒时重新编号。
- iPhone 播放:Aducti 提到 HEVC 编码的视频要打
hvc1标签,iPhone 不认hev1。
如果同一套规则(切点余量、字幕样式、竖版参数)要反复用,可以把它们写进一个 skill,让 Claude Code 每次按同样的标准剪,写法见 Claude Code Hooks、Skills 与斜杠命令:区别、选型和最小配置。Aducti 就是这样做的:把"在哪里下刀、字幕放多高、最多几个推镜"固定在 skill 里,据其介绍,一条短视频连修改大约 10–15 分钟。
Claude Code 剪视频常见问题
Claude Code 剪视频免费吗?
不完全免费。Claude Code 本身要 Pro、Max 等付费套餐或 API 用量。转写环节可以免费:本地跑 Whisper、faster-whisper、ffmpeg、auto-editor 都不按小时收费。video-use 要付 ElevenLabs Scribe 的转写费($0.22/小时音频,免费档大约含 4.5 小时);ChatCut 在 Claude 用量之外另收 $25 到 $160 的月费。
中文口播能用这套流程吗?
流程本身不分语言:转写、读稿、写剪辑表、ffmpeg 渲染都一样。但上面的测试只用了英文合成语音,中文转写的准确率、中文语气词的识别、中文字幕字体都没有测。要试中文,记得换成不带 .en 的多语言模型并指定中文,字幕字体换成带中文字形的字体,并重点核对同音字和专有名词。
在中国大陆能用 Claude Code 剪视频吗?
Anthropic 的支持国家和地区列表(2026 年 5 月 12 日生效)不包含中国大陆,列表里写明未列出的地区均不支持。ffmpeg、Whisper 模型、auto-editor 这些本地工具本身不需要访问 Anthropic,可以单独用来转写和去静音。
Claude Code 能代替剪辑师吗?
目前不能。各路线的产出都是初稿:达芬奇 MCP 项目自己写明只做初版拼接、不判断剪得好不好;Fyve 估计大约七成自动、三成手工;Habr 的评测说 video-use 只适合口播,挑不出语义上的错误。它能省掉的是去停顿、删重录、对字幕这类机械活,挑镜头、把握节奏和定下最终的画面风格仍然是人的工作。
长素材会不会把 Claude Code 额度用光?
有可能。读文字稿本身不贵(10 分钟约 7,500 到 2.1 万 token),但每轮对话都会带上系统提示、工具定义和历史,反复修改、看截图都会让消耗明显增加。长素材先分段处理,截图只在关键切点上看。
参考来源19
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月15日。
参考来源19
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月15日。
- 1.Anthropic 的视觉(Vision)文档platform.claude.com/docs/en/build-with-claude/vision
- 2.Claude Code 工具参考code.claude.com/docs/en/tools-reference
- 3.Claude Code 剪视频入门文章fyve.co.jp/claude-code/articles/claude-code-video-editing-start
- 4.Claude 价格页claude.com/pricing
- 5.Claude Code 剪辑自动化指南blog.heimdex.co/post/claude-code-video-editing-automation-guide-ko
- 6.video-usegithub.com/browser-use/video-use
- 7.auto-editorgithub.com/WyattBlue/auto-editor
- 8.ButterCutgithub.com/barefootford/buttercut
- 9.ChatCut 的 Claude Code 插件chatcut.io/claude-code-plugin
- 10.ElevenLabs API 价格页elevenlabs.io/pricing/api
- 11.video-use 评测文章habr.com/ru/articles/1032374
- 12.davinci-resolve-mcpgithub.com/samuelgursky/davinci-resolve-mcp
- 13.Adobe_Premiere_Pro_MCPgithub.com/hetpatel-11/Adobe_Premiere_Pro_MCP
- 14.Palmier Progithub.com/palmier-io/palmier-pro
- 15.claude-code-video-toolkitgithub.com/digitalsamba/claude-code-video-toolkit
- 16.HyperFramesgithub.com/heygen-com/hyperframes
- 17.Remotion 公司许可remotion.pro/license
- 18.Claude Code 剪辑 skill 文章aducti.com/recursos/editar-videos-claude-code-skill
- 19.支持国家和地区列表anthropic.com/supported-countries