Claude Code 怎么生成图片:代码渲染还是调图像模型,怎么选
Claude Code 自己不输出像素。流程图、带字封面让它写 SVG 再渲染;照片和插画靠脚本或 MCP 服务器调用外部图像模型,费用按那家 API 另算。
文章目录
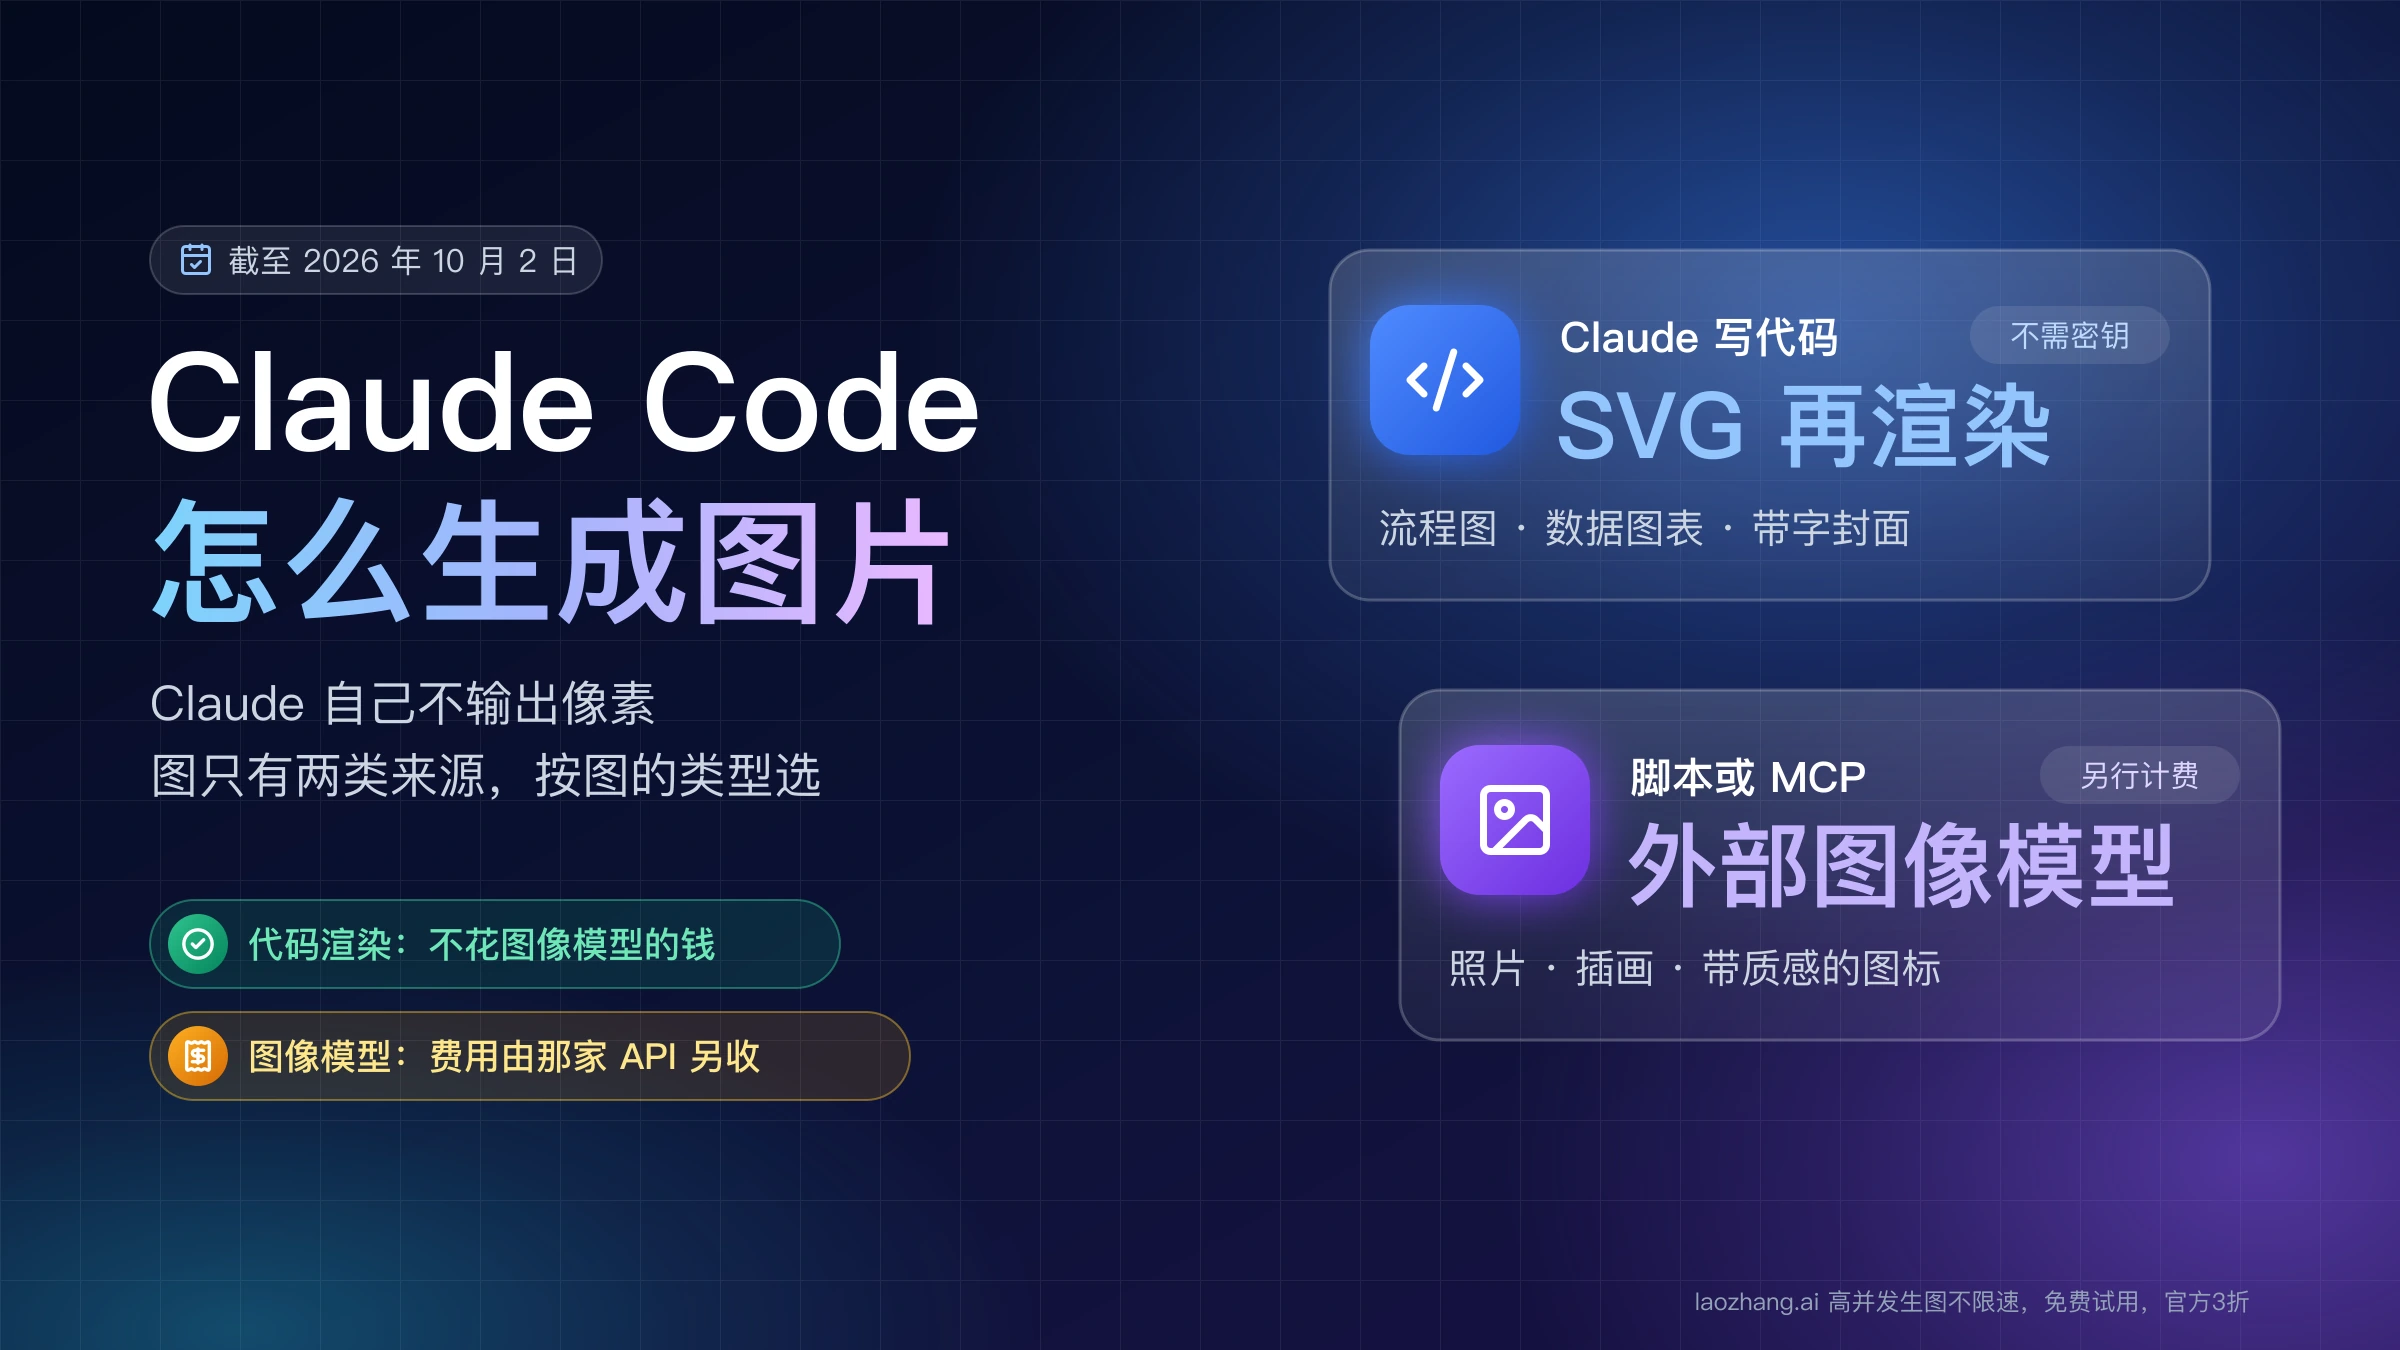
Claude Code 能把图片做出来并存进你的项目,但像素不是 Claude 模型画的。会话里出现的每一张图只有两种来历:一种是 Claude 写了一段代码(SVG、HTML、绘图脚本)并运行它,渲染出图;另一种是 Claude 运行脚本或调用 MCP 服务器,把提示词交给外部的图像模型,再把返回的图片存盘。
选哪一种,看你要的是什么图。流程图、数据图表、带标题文字的封面,用第一种,不花图像模型的钱,文字和尺寸都由你写的代码决定。照片、插画、带质感的图标,只能用第二种,费用由那家图像 API 另行收取,和 Claude 订阅无关。下面按这个顺序把两条路线的做法、费用和权限设置讲清楚。
Claude Code 可以生图吗:模型不出像素,图只有两类来源
不能直接生图。Anthropic 帮助中心的说法是 Claude 不会像图片生成工具那样产出照片或插画,能做的是用 HTML、SVG 画图表和示意图,以及分析你上传的图片(Can Claude produce images?)。API 文档更直接:Claude 是纯图像理解模型,不能生成、编辑或处理图片(Vision 文档)。这一点对所有 Claude 模型和所有订阅档位都成立,换模型、升级套餐不会多出一个出图开关。
截至 2026 年 10 月 2 日,Anthropic 也没有提供自家的图像模型连接器或 skill。连接器目录里与图片有关的 Adobe、Canva、Hugging Face 都是合作方开发的;anthropics/skills 仓库里的 canvas-design、algorithmic-art、slack-gif-creator 三个 skill 靠代码排版和绘制(p5.js、PIL 等),不调用任何图像模型。
所以"用 Claude Code 生成图片"说的其实是分工:Claude 负责理解需求、写提示词或写绘图代码、决定文件存到哪;出像素的要么是渲染器,要么是别家的图像模型。聊天应用里 Claude 能做到哪一步,见Claude能生成图片吗?Claude视觉能力完全指南(2026)。
先按图的类型选路线:图表和带字封面用代码,照片插画调图像模型
判断规则只有一条主线、两个分叉:
| 你的情况 | 选哪条路线 | 花费 | 图存在哪 |
|---|---|---|---|
| 流程图、架构图、数据图表、带标题文字的封面 | Claude 写 SVG,本地渲染成 PNG 或 WebP | 只消耗 Claude Code 本身的用量 | 你指定的项目路径 |
| 照片、插画、质感图标,自己一个人用或想把做法随仓库交给团队 | skill 加一个调用图像 API 的脚本 | 图像 API 按 token 或按张计费 | 脚本的 --out 路径 |
| 照片、插画,想在多个模型之间随手切换,不想维护脚本 | 图像平台的 MCP 服务器(Hugging Face、fal.ai、Replicate) | 平台按模型计费,或消耗每日额度 | 会话的 tool-results 目录,需要再复制到项目 |
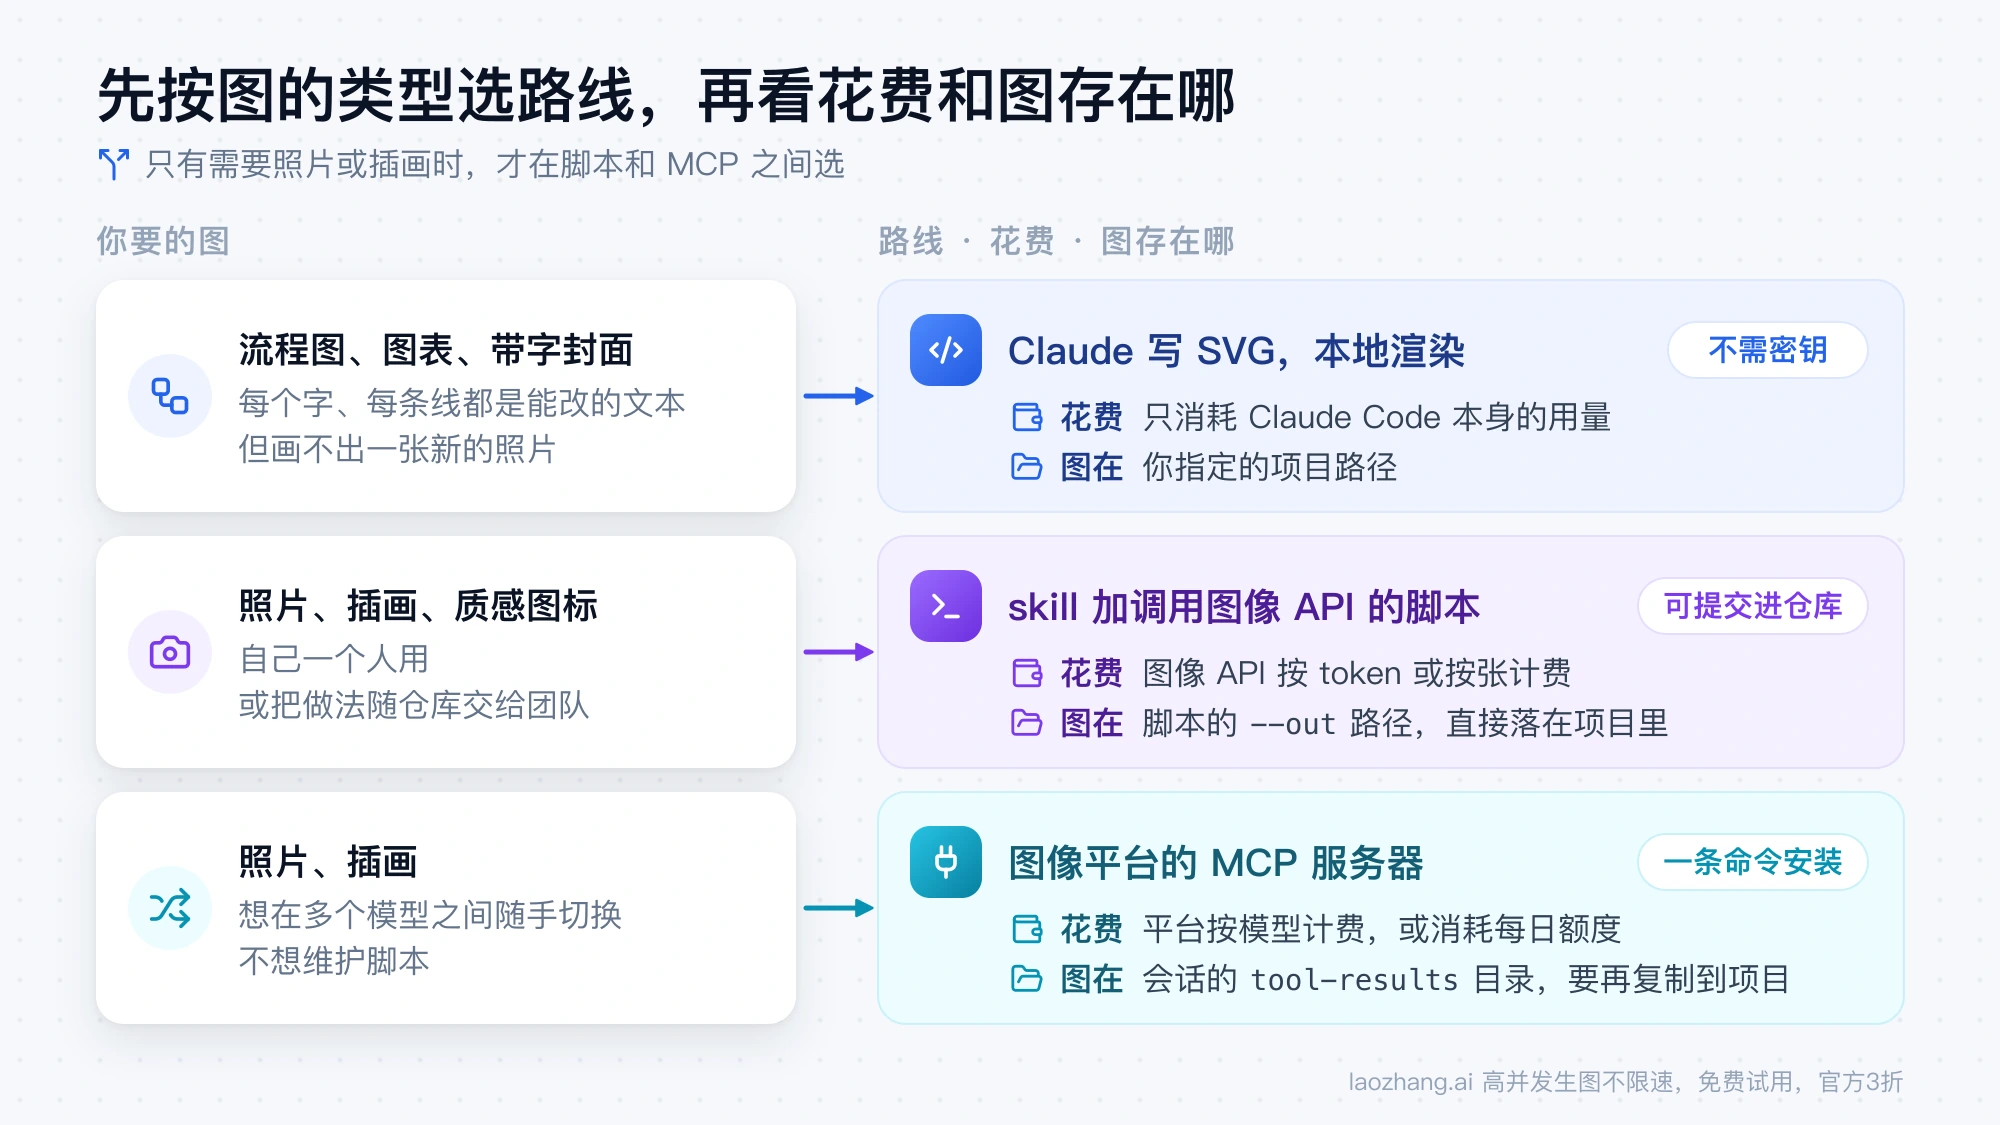
第一个分叉是图的类型。代码渲染的图,每个字、每条线都是你能改的文本,尺寸由渲染命令精确指定,但它画不出一张新的照片;图像模型出的图是一次性的像素,想改一个字或一处布局,只能重新生成。
第二个分叉只在需要图像模型时出现:脚本还是 MCP。脚本放在项目的 .claude/skills/ 下可以提交进仓库,同事拉下代码就能用,密钥各自留在自己的环境变量里;MCP 服务器装起来只要一条命令,能调用的模型多,但图片默认不落在项目目录,密钥的存法也要多留意。两者的差别在后面的章节展开。
让 Claude Code 写 SVG 再渲染:流程图、图表和带字封面
这条路线不需要任何密钥:让 Claude 按你给的尺寸和内容写一个 SVG 文件,再用命令行工具渲染。
rsvg-convert -w 2400 -h 1350 cover.svg -o cover.png
cwebp -q 90 cover.png -o cover.webprsvg-convert(librsvg 自带)按指定宽高输出 PNG,cwebp 再转成 WebP。macOS 上两者都能用 Homebrew 安装(librsvg 和 webp)。在会话里你只需要说清楚三件事:画什么、多大、存到哪。例如"在 docs/img/ 下画一张 2000×1125 的部署流程图,写成 SVG,渲染成 WebP"。
这个博客的文章配图就是这样做的,不调用图像模型:Claude 在 Claude Code 里手写 SVG,rsvg-convert 渲染成精确尺寸的 PNG(封面 2400×1350,正文图 2000×1125),cwebp 转成 WebP。2026 年 10 月 2 日发布的一篇文章共 18 张 WebP,单张在 136 KB 到 192 KB 之间。另一次单独的测试里,一个 911 字节的手写 SVG 渲染成 1600×600 的 PNG 用了 135 毫秒。这些数字来自一个站点、一台机器,说明的是量级:出图以毫秒计,文件小,返工就是改几行文本。
边界同样清楚:这条路线里的任何一步都造不出新的照片或插画。裁剪、缩放、转灰度、换格式可以用 Pillow 之类的库处理已有图片,但"画一只在键盘上睡觉的猫"必须交给图像模型。
用一个 skill 加脚本调用 GPT Image 2.5
需要照片或插画时,最容易掌控的做法是一个 skill 带一个脚本:脚本负责请求图像 API 并把文件写到指定路径,skill 告诉 Claude 什么时候用它、怎么传参数。下面以 OpenAI 的图片接口为例。
脚本:只用标准库,把 base64 解码成文件
OpenAI 当前的图片模型是 gpt-image-2.5-flare(日常、速度快)和 gpt-image-2.5-sunburst(编辑精度更高),接口是 POST /v1/images/generations。响应里没有图片网址,只有 base64 数据(data[0].b64_json,默认 PNG),所以脚本必须自己解码、写文件(OpenAI 图片生成指南)。
把下面的文件存为 .claude/skills/image/scripts/generate.py:
#!/usr/bin/env python3
"""Generate one image with the OpenAI Images API and save it to disk.

Standard library only. Reads the key from OPENAI_API_KEY; never prints it.
"""
import argparse
import base64
import json
import os
import pathlib
import sys
import urllib.error
import urllib.request

MODELS = ("gpt-image-2.5-flare", "gpt-image-2.5-sunburst")


def main() -> int:
    parser = argparse.ArgumentParser()
    parser.add_argument("--prompt", required=True)
    parser.add_argument("--out", required=True, help="output file, e.g. assets/hero.png")
    parser.add_argument("--model", default="gpt-image-2.5-flare", choices=MODELS)
    parser.add_argument("--size", default="1536x1024")
    parser.add_argument("--quality", default="low")
    args = parser.parse_args()

    key = os.environ.get("OPENAI_API_KEY")
    if not key:
        print("OPENAI_API_KEY is not set. Export it in the shell before starting claude.", file=sys.stderr)
        return 2

    out = pathlib.Path(args.out)
    if out.exists():
        print(f"{out} already exists. Choose another --out so nothing is overwritten.", file=sys.stderr)
        return 2

    base = os.environ.get("OPENAI_BASE_URL", "https://api.openai.com/v1").rstrip("/")
    body = json.dumps({
        "model": args.model,
        "prompt": args.prompt,
        "size": args.size,
        "quality": args.quality,
    }).encode()
    request = urllib.request.Request(
        f"{base}/images/generations",
        data=body,
        headers={"Authorization": f"Bearer {key}", "Content-Type": "application/json"},
    )
    try:
        with urllib.request.urlopen(request, timeout=300) as response:
            payload = json.load(response)
    except urllib.error.HTTPError as error:
        print(f"HTTP {error.code}: {error.read().decode(errors='replace')[:600]}", file=sys.stderr)
        return 1
    except urllib.error.URLError as error:
        print(f"Request failed: {error.reason}", file=sys.stderr)
        return 1

    out.parent.mkdir(parents=True, exist_ok=True)
    out.write_bytes(base64.b64decode(payload["data"][0]["b64_json"]))
    print(json.dumps({"saved": str(out), "bytes": out.stat().st_size, "usage": payload.get("usage")}))
    return 0


if __name__ == "__main__":
    sys.exit(main())
几个设计上的取舍:模型用白名单限定在两个 2.5 ID,Claude 传错模型名时在本地就被 argparse 拒绝;默认质量是 low、默认尺寸是官方推荐的 1536x1024,先用最低档看构图;目标文件已存在就退出,不会覆盖你已有的图;密钥只从环境变量读,不打印;成功后输出一行 JSON,包含 saved、bytes 和接口返回的 usage。
这个脚本在 2026 年 10 月 2 日只做过拒绝路径的检查,没有用真实密钥成功生成过图片:
| 条件 | 结果 |
|---|---|
没有设置 OPENAI_API_KEY | 打印提示,退出码 2,不发请求 |
| 假密钥,默认模型 | 请求到达 api.openai.com,返回 HTTP 401 invalid_api_key,退出码 1,不写文件 |
--model dall-e-3 | argparse 报 invalid choice,列出两个允许的 ID |
--out 指向已有文件 | 打印提示,退出码 2,不发请求 |
因此,真实响应里 usage 的结构、单张花费、耗时,以及你的账号是否接受默认参数,都要以你第一次成功调用的输出为准。请求体里的参数取值出自 OpenAI 文档:质量可选 low、medium、high、xhigh、max、auto;尺寸除三个推荐值外可以自定义,边长须为 16 的倍数、比例在 1:3 到 3:1 之间、单边不超过 3840。文档提到复杂的提示词可能要等 2 分钟左右,所以脚本的超时设为 300 秒。
SKILL.md:让 Claude 知道何时出图、怎么传参
项目级 skill 放在 .claude/skills/NAME/SKILL.md,个人级放在 ~/.claude/skills/NAME/SKILL.md。frontmatter 里的 description 决定 Claude 何时主动使用它,你也可以直接输入 /image 触发(Skills 文档)。一个够用的 .claude/skills/image/SKILL.md:
---
name: image
description: 生成照片或插画类位图并保存到项目里。用户要首图、插画、图标底图等需要图像模型的图片时使用;流程图和图表不要用它。
allowed-tools: Bash(python3 ${CLAUDE_SKILL_DIR}/scripts/generate.py *)
---

每次只生成一张图:

```bash
python3 \${CLAUDE_SKILL_DIR}/scripts/generate.py --prompt "提示词" --out assets/名称.png
```

- 默认模型 gpt-image-2.5-flare、尺寸 1536x1024、质量 low。用户明确要求时才改 --model、--size、--quality。
- 脚本拒绝覆盖已有文件,返工时换一个新的 --out。
- 运行后把输出里的 saved、bytes、usage 告诉用户,再用 Read 看一眼生成的图。
- 遇到 HTTP 401 或 403 就停下,把错误原文交给用户,不要重试。
${CLAUDE_SKILL_DIR} 在 skill 正文和 allowed-tools 的 Bash 规则里都会展开成 skill 所在目录,官方给的写法是 Bash(${CLAUDE_SKILL_DIR}/scripts/render.sh *);上面在前面加了 python3,是按同一格式套到这个脚本上的写法。新增或修改 skill 在当前会话里即时生效,只有会话启动时顶层 skills 目录还不存在的情况下,才需要运行 /reload-skills。
然后在启动 claude 之前导出密钥,进入会话后提需求:
export OPENAI_API_KEY="你的密钥"
claude/image 给 README 生成一张首图:清晨的山间木屋,写实摄影风格,存到 assets/hero.pngClaude Code 在启动时读取 shell 的环境变量,所以换了密钥要重启 claude 才生效。
想改用 Gemini 的图片模型(Nano Banana)时,脚本要换成 Google 的接口和模型 ID,完整的 skill 目录、脚本和常见报错见Claude Code 接入 Nano Banana:配置与修复。国内的图像服务同理:只要对方提供 HTTP 接口,脚本的结构不变,改的是请求地址、鉴权头和从响应里取图的那一行,具体写法以该服务的官方文档为准。
用 MCP 服务器出图:Hugging Face、fal.ai、Replicate 的官方命令
不想维护脚本时,可以把图像平台的 MCP 服务器接进 Claude Code,让 Claude 直接调用平台上的模型。下面三条命令分别出自三家的官方文档,这里列出的是文档原文的用法,没有逐条执行验证。
Hugging Face(hf-mcp-server README):
claude mcp add hf-mcp-server -t http "https://huggingface.co/mcp?login"添加后启动 claude 完成登录授权。网址里有 ?,在 zsh 里要加引号。出图靠的是你在 huggingface.co/settings/mcp 里添加的 Spaces,Hugging Face 给的例子里有 FLUX 和 Qwen 的图片 Space。
fal.ai(fal MCP 文档):
claude mcp add --transport http fal-ai https://mcp.fal.ai/mcp --header "Authorization: Bearer YOUR_FAL_KEY"fal 的文档写明 MCP 服务器本身不收费,只为你触发的模型运行付费;工具里有 run_model,也有 get_pricing,可以让 Claude 在运行前先查这个模型一次多少钱。
Replicate(Replicate MCP):
claude mcp add replicate https://mcp.replicate.com/sse --transport sse --scope user添加后在会话里用 /mcp 完成认证。这条命令用的是 SSE 传输,而 Claude Code 的文档已经把 SSE 标为弃用,后续以 Replicate 文档更新为准。
装完用 claude mcp list 看连接状态。另外,claude.ai 里启用的连接器(比如目录里的 Hugging Face、Canva、Adobe)只有在用 claude.ai 账号登录 Claude Code 时才会出现,用 ANTHROPIC_API_KEY 登录时没有。
MCP 返回的图片存在哪:v2.1.283 起落盘到 tool-results 目录
MCP 工具返回 PNG、JPEG、GIF 或 WebP 图片时,Claude 会在对话里直接看到它(可能是缩小过的版本);Claude Code v2.1.283 及以上版本还会把原始字节存成文件,放在 ~/.claude/projects/ 下该会话的 tool-results 目录里,并把路径告诉 Claude(MCP 文档 "Images in tool results")。这个文件不在你的项目里,需要图的时候要明确让 Claude 把它复制到目标路径。版本低于 v2.1.283,或者关闭了会话持久化,就没有这个文件。
还有一个上限要知道:返回图片数据的工具仍然受 MCP 输出 token 上限约束,默认 25,000 token,超过 10,000 会有警告;图片类工具超限时,调高环境变量 MAX_MCP_OUTPUT_TOKENS 是唯一的办法。至于每个第三方 MCP 服务器返回的到底是图片本身还是一个下载链接,各家不同,以第一次调用的实际返回为准;如果是链接,让 Claude 用 curl 下载到项目里即可。
脚本还是 MCP:文件位置、密钥存法、团队共享三处不同
一个人临时出几张图,两者都行;要长期用或者给团队用,差别在这三处。
文件位置。 脚本把图直接写到 --out 指定的项目路径,输出里有文件大小,可以马上提交。MCP 的图在会话目录或远端链接里,多一步复制。
密钥存法。 脚本从环境变量读密钥,仓库里不出现任何密钥。claude mcp add 带 --env KEY=value 或 --header "Authorization: Bearer ..." 时,写进配置文件的是密钥的明文;fal 的官方命令就属于这种。需要随仓库共享的 .mcp.json 支持 ${VAR} 展开,应当写变量名而不是密钥本身。Hugging Face 的 ?login 方式和 Replicate 的 /mcp 认证走的是登录授权,不需要在命令里放密钥。
团队共享。 项目里的 .claude/skills/image/ 提交后,同事拉取即可使用,各自导出自己的密钥。相应地,拉下别人的仓库时要先看一眼里面的 skill:官方文档提醒,项目 skill 的 allowed-tools 不受工作区信任机制约束,仓库里的 skill 可以给自己预先放行工具。个人目录 ~/.claude/skills/ 下的 skill 不会带到 Cowork 或云端会话里。MCP 服务器则按 local、project、user 三种范围添加,只有 project 范围会写进仓库的 .mcp.json。
生成一张图多少钱:各家的计费单位和每日额度
图像模型的费用不走 Claude 订阅,由你接入的那家 API 收取。截至 2026 年 10 月 2 日,各家官方价目如下。
| 服务 | 计费方式 | 不付费能用多少 |
|---|---|---|
| OpenAI GPT Image 2.5(两个模型同价) | 按 token:图片输出每 100 万 token 为 $30,图片输入 $8,文本输入 $5;Batch 的图片输出 $15 | 无;可能还要先完成组织验证 |
Gemini gemini-3.1-flash-image | 按张:0.5K 为 $0.045,1K 为 $0.067,2K 为 $0.101,4K 为 $0.151 | 无,图片模型没有免费层 |
Gemini gemini-3.1-flash-lite-image | 按张:1K 为 $0.0336 | 无 |
Gemini gemini-3-pro-image | 按张:1K 或 2K 为 $0.134,4K 为 $0.24 | 无 |
Cloudflare Workers AI flux-1-schnell | 按 Neurons:每个 512×512 图块 4.80,每步 9.60;超出额度后每 1,000 Neurons 为 $0.011 | 每天 10,000 Neurons,UTC 0 点重置 |
| Hugging Face ZeroGPU Spaces | 按 GPU 时长 | 免费账号每天 5 分钟,PRO 40 分钟,未登录 2 分钟 |
| fal.ai、Replicate | 按模型运行计费 | 各模型价格以平台页面为准,fal 可用 get_pricing 查询 |
来源:OpenAI 价目、Gemini API 价目、Workers AI 价目、ZeroGPU 文档。
OpenAI 没有官方的单张固定价。 一张图耗多少输出 token 取决于尺寸和质量,官方只在交互式计算器里给出,实际花费要看响应里的 usage:把其中的图片输出 token 数乘以 $30 再除以 100 万,就是这一张的输出成本。脚本把 usage 原样打印出来,就是为了让你在第一次调用后拿到自己的数字。不同尺寸和质量档位的估算方法见GPT Image 2.5 Sunburst 价格:官方单图费用与按次计费怎么选。
Cloudflare 的每日额度大约够多少张,可以自己算。 假设一张 1024×1024 的图按 4 个 512×512 图块计、步数取默认的 4:4 × 4.80 + 4 × 9.60 = 57.6 Neurons;10,000 ÷ 57.6 ≈ 173 张。这是按价目表推出来的估算,前提是图块数确实为 4,并且账号下没有别的 Workers AI 调用在消耗同一份额度。额度用完后请求会直接失败,继续用需要 Workers Paid 套餐。官方调用方式是向 https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/black-forest-labs/flux-1-schnell 发 POST 请求,返回 base64 编码的 JPEG,同样可以包成脚本。
Hugging Face 的额度是时长,不是张数。 每天几分钟的 GPU 时间在首次使用 24 小时后重置,能出多少张取决于所用 Space 每次占用多久。网上常见的"不限量出图"说法,在这两家的文档里都找不到依据,能确认的只有上面这两种每日额度。
OpenAI 的准入门槛。 使用 GPT Image 模型前可能需要完成 API 组织验证,要用受支持国家或地区签发的实体证件,而且一个人只能验证一个组织(OpenAI 帮助中心)。Tier 1 的速率上限是每分钟 5 张图。
如果你通不过组织验证、开不了 Gemini 计费,或者就是想要一个固定的按次价格,第三方 API 服务 laozhang.ai 是一个可选项。按它的文档,截至 2026 年 9 月 12 日,gpt-image-2.5-flare-vip 和 gpt-image-2.5-sunburst-vip 每次调用 $0.03,接口与 OpenAI 的图片接口兼容;截至 9 月 24 日,gemini-3.1-flash-image 每次 $0.055,不随分辨率变化。它不是 OpenAI 或 Google,两家的服务条款、数据承诺和 SLA 都不适用。套到上面的脚本上,需要把带 -vip 的模型 ID 加进 MODELS 白名单,并把 OPENAI_BASE_URL 设为 https://api2.laozhang.ai/v1;这个组合没有跑过,先用一次调用确认再依赖它。
密钥放哪、能不能放着让它自己跑:自动放行等于无人值守的付费调用
密钥放在 shell 环境变量里,不要粘贴进对话,也不要写进会被提交的文件。如果项目里有 .env,在设置的 permissions.deny 里加上 Read(./.env),这是官方文档对存放密钥的文件给出的建议写法(权限文档)。
"能不能不用每次都点确认"有两个层次,后果不一样:
- skill 的
allowed-tools:只在调用这个 skill 的那一轮里免确认,你发出下一条消息后授权就清除;它也不限制 Claude 使用其他工具。日常使用停在这一层就够了,你每说一次"出图",它跑一次。 - 权限设置里的 allow 规则:在确认框里选"Yes, and don't ask again",Claude Code 会把规则写进
.claude/settings.local.json,以后这个仓库里的所有会话都不再询问。手写的话形如Bash(python3 .claude/skills/image/scripts/generate.py *),这是把文档里的规则格式套到上面那个脚本路径上的写法。
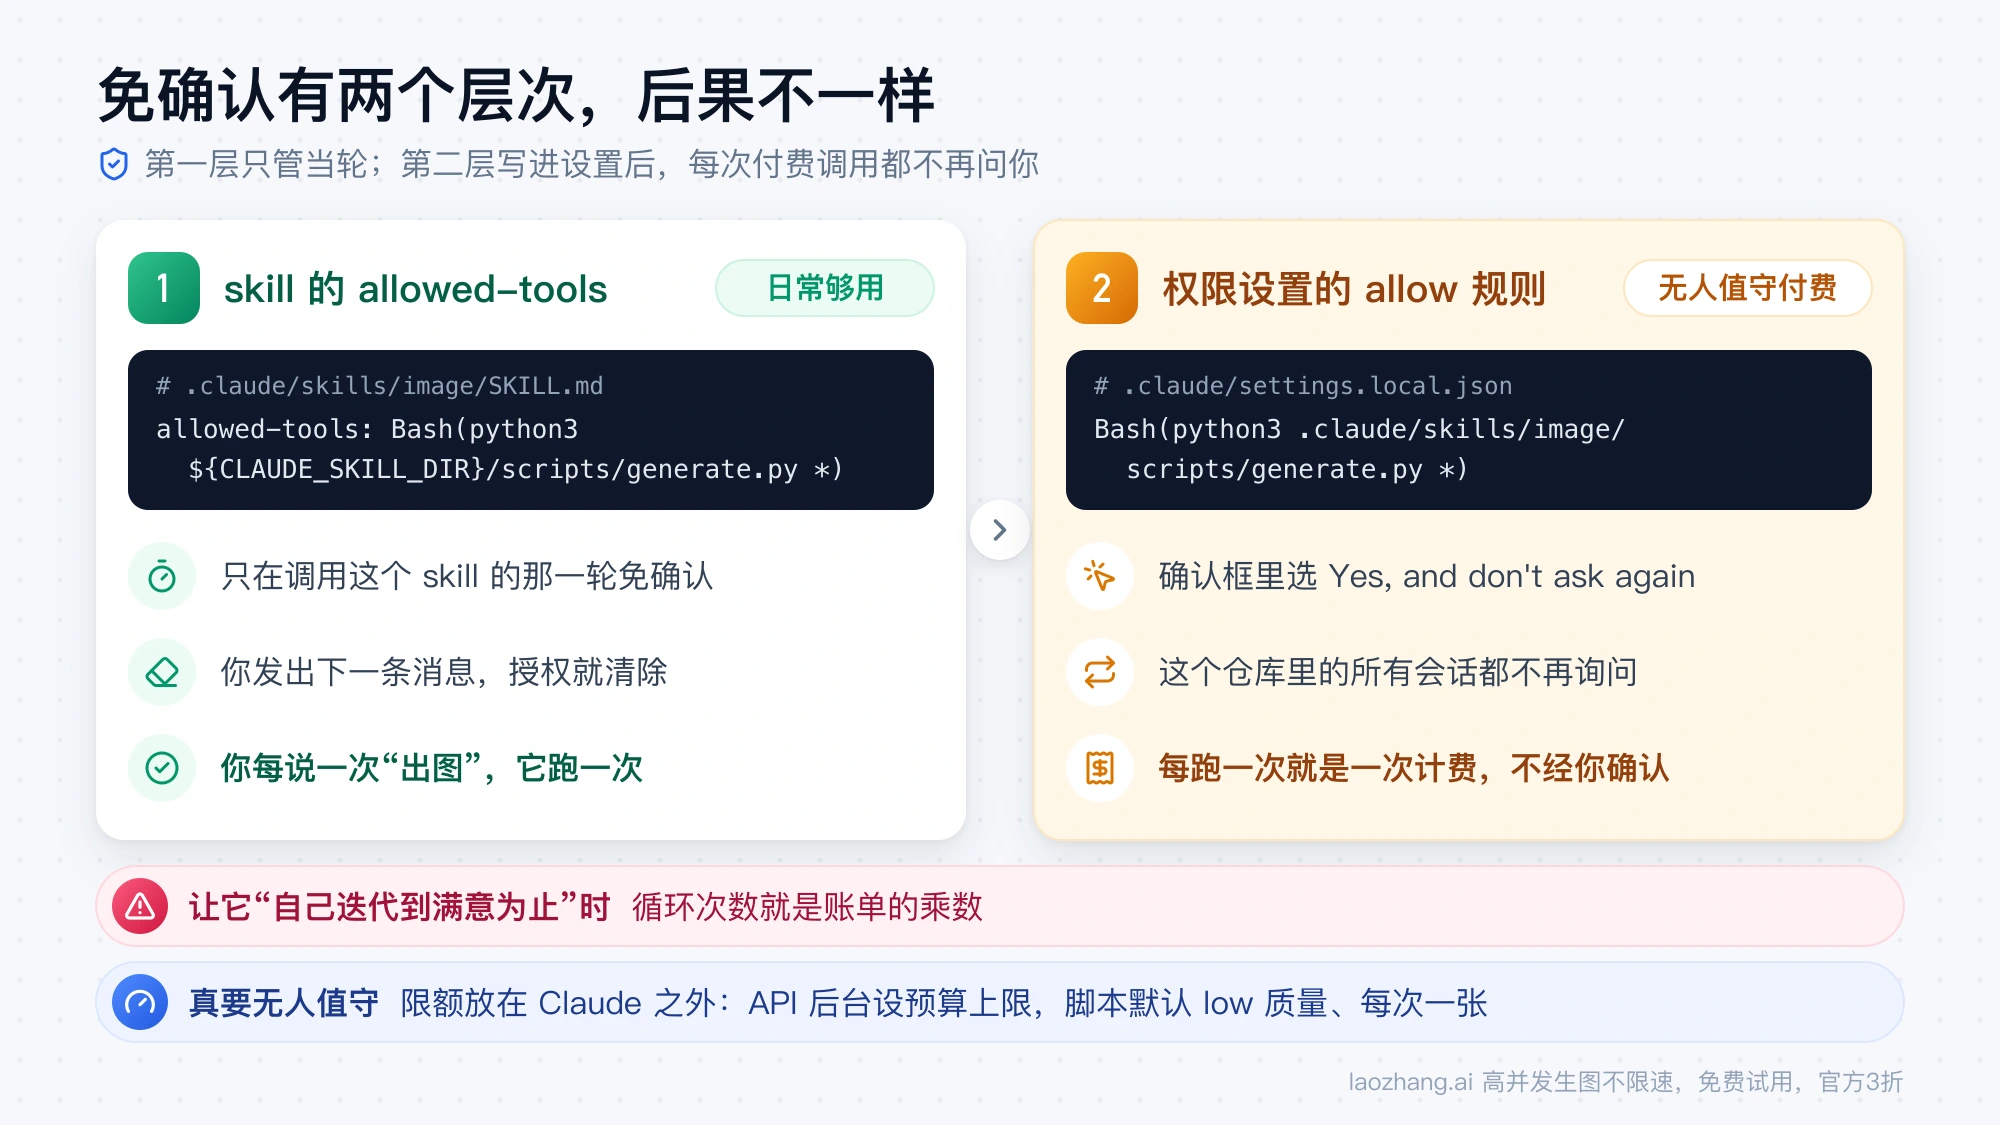
第二层的含义要想清楚:从此 Claude 在任何一轮对话、任何一次长任务里都可以不经你确认调用付费接口,每跑一次就是一次计费。让它"自己迭代到满意为止"时,循环次数就是账单的乘数。官方文档还提醒,约束 Bash 参数的规则本身比较脆弱,不能指望靠规则里的通配符把调用限制在某个尺寸或某个质量档。
真要无人值守,把限额放在 Claude 之外更可靠:图像 API 的后台如果提供预算上限或用量提醒,先设上;脚本默认用 low 质量,并在 skill 里写明"每次只生成一张"。
让 Claude Code 自己看图返工:Read 看到的是缩放后的版本
Claude Code 能看图,所以"生成、看一眼、改提示词再来"的循环是成立的:Read 工具会把 PNG、JPG 等文件作为图像内容交给 Claude,而不是一串字节。你也可以把图片拖进终端、用 Ctrl+V(Windows 和 WSL 上是 Alt+V)粘贴,或者直接给出文件路径(工具参考)。
要注意 Claude 看到的不一定是原图。大图会先被缩放和重新压缩;从 v2.1.196 起,缩放后仍超过 500 KB 的图片会被重新编码成质量更低的 JPEG。所以它适合判断构图、主体对不对、文字有没有明显错误,不适合判断边缘锯齿、细小文字这类像素级问题。需要看细节时,官方建议先裁出关心的区域再让它看。
返工时两条路线的成本完全不同。SVG 路线是改文本再渲染,可以反复改到满意;图像模型路线每返工一次就是一次新的付费调用,而且上面的脚本不覆盖已有文件,每一版都要换一个新的 --out,旧版本留在磁盘上方便对比。
出图失败时先查这几处:401、组织验证、已关停的模型 ID
| 现象 | 原因 | 处理 |
|---|---|---|
脚本提示 OPENAI_API_KEY is not set | 密钥是在启动 claude 之后才导出的,或根本没导出 | 退出会话,在 shell 里导出后重新启动 |
HTTP 401 invalid_api_key | 密钥无效或贴错 | 换有效密钥后重启 claude |
| OpenAI 拒绝使用 GPT Image 模型 | 组织尚未验证 | 在 OpenAI 后台完成组织验证,或换用其他服务 |
| 每分钟只能出几张 | Tier 1 上限为每分钟 5 张图 | 降低并发,不要让 Claude 并行批量生成 |
| Gemini 调用旧模型 ID 失败 | 用了已关停的 ID:gemini-2.5-flash-image 于 2026 年 10 月 2 日关停,preview 版 ID 于 6 月 25 日关停,Imagen 4 的 ID 于 8 月 17 日关停 | 改用 gemini-3.1-flash-image 等正式版 ID(弃用列表) |
| Gemini 图片模型在未开通计费的项目里调不通 | 图片模型没有免费层 | 为该项目开通计费 |
| Cloudflare 请求突然全部失败 | 当天 10,000 Neurons 用完 | 等 UTC 0 点重置,或升级 Workers Paid |
| MCP 工具输出被截断或报超限 | 图片数据超过 MCP 输出 token 上限 | 调高 MAX_MCP_OUTPUT_TOKENS |
| MCP 出了图但项目里找不到 | 文件在会话的 tool-results 目录,或版本低于 v2.1.283 | 升级 Claude Code,让 Claude 把文件复制到项目路径 |
| 脚本提示文件已存在 | 脚本不覆盖已有文件 | 换一个新的 --out |
常见问题
Claude Code 可以读图片吗?
可以,而且这和生成图片是两回事。Claude Code 通过 Read 工具、拖放、粘贴或文件路径读取 PNG、JPG 等图片,能描述内容、对照设计稿写代码、检查生成结果。读图是 Claude 模型自带的能力;出图不是,必须靠渲染代码或外部图像模型。
网上说的借 Codex CLI 用 ChatGPT 订阅出图,可以用吗?
这种做法在中文社区里很常见:在 Claude Code 里调用 Codex CLI,由后者经 ChatGPT 订阅生成图片。它依赖的是另一家产品的订阅和额度规则,不属于上面几条有官方文档可逐项对照的路线,这里不给步骤。要用的话,以 OpenAI 对 Codex 和订阅额度的现行规定为准。
通义万相、豆包、即梦这些国内图像 API 能接进 Claude Code 吗?
能,方式和上面的脚本路线相同。Claude Code 对图像服务没有要求,它只是运行一个脚本;只要服务提供 HTTP 接口,就把脚本里的请求地址、鉴权方式、模型名和取图逻辑换成该服务官方文档里的写法。接口细节和价格以各自的官方文档为准。
有没有现成的作图 skill 可以直接装?
有,社区里围绕各种图像模型的 skill 不少,本质上都是"SKILL.md 加一个调用图像 API 的脚本"。装之前先读它的 SKILL.md 和脚本:看 allowed-tools 放行了什么命令、密钥从哪读、图片发到哪个地址。Anthropic 官方仓库里的图片类 skill 都是代码渲染型的,不调用图像模型。先从哪些 skill 入手,可以参考Claude Code 最值得先用的 Skills(2026):按工作流选官方起步路径。