本地 LLM 编程买哪张 16GB 显卡:先看模型能否运行,再比任务速度
按本文记录的显存带宽与功耗,RTX 5070 Ti 可作为 16GB 本地编程显卡的中档候选。购买前仍应核对当地售价,并确认目标模型、上下文和实际代码任务能否运行;硬件规格不能直接证明任务速度。
文章目录
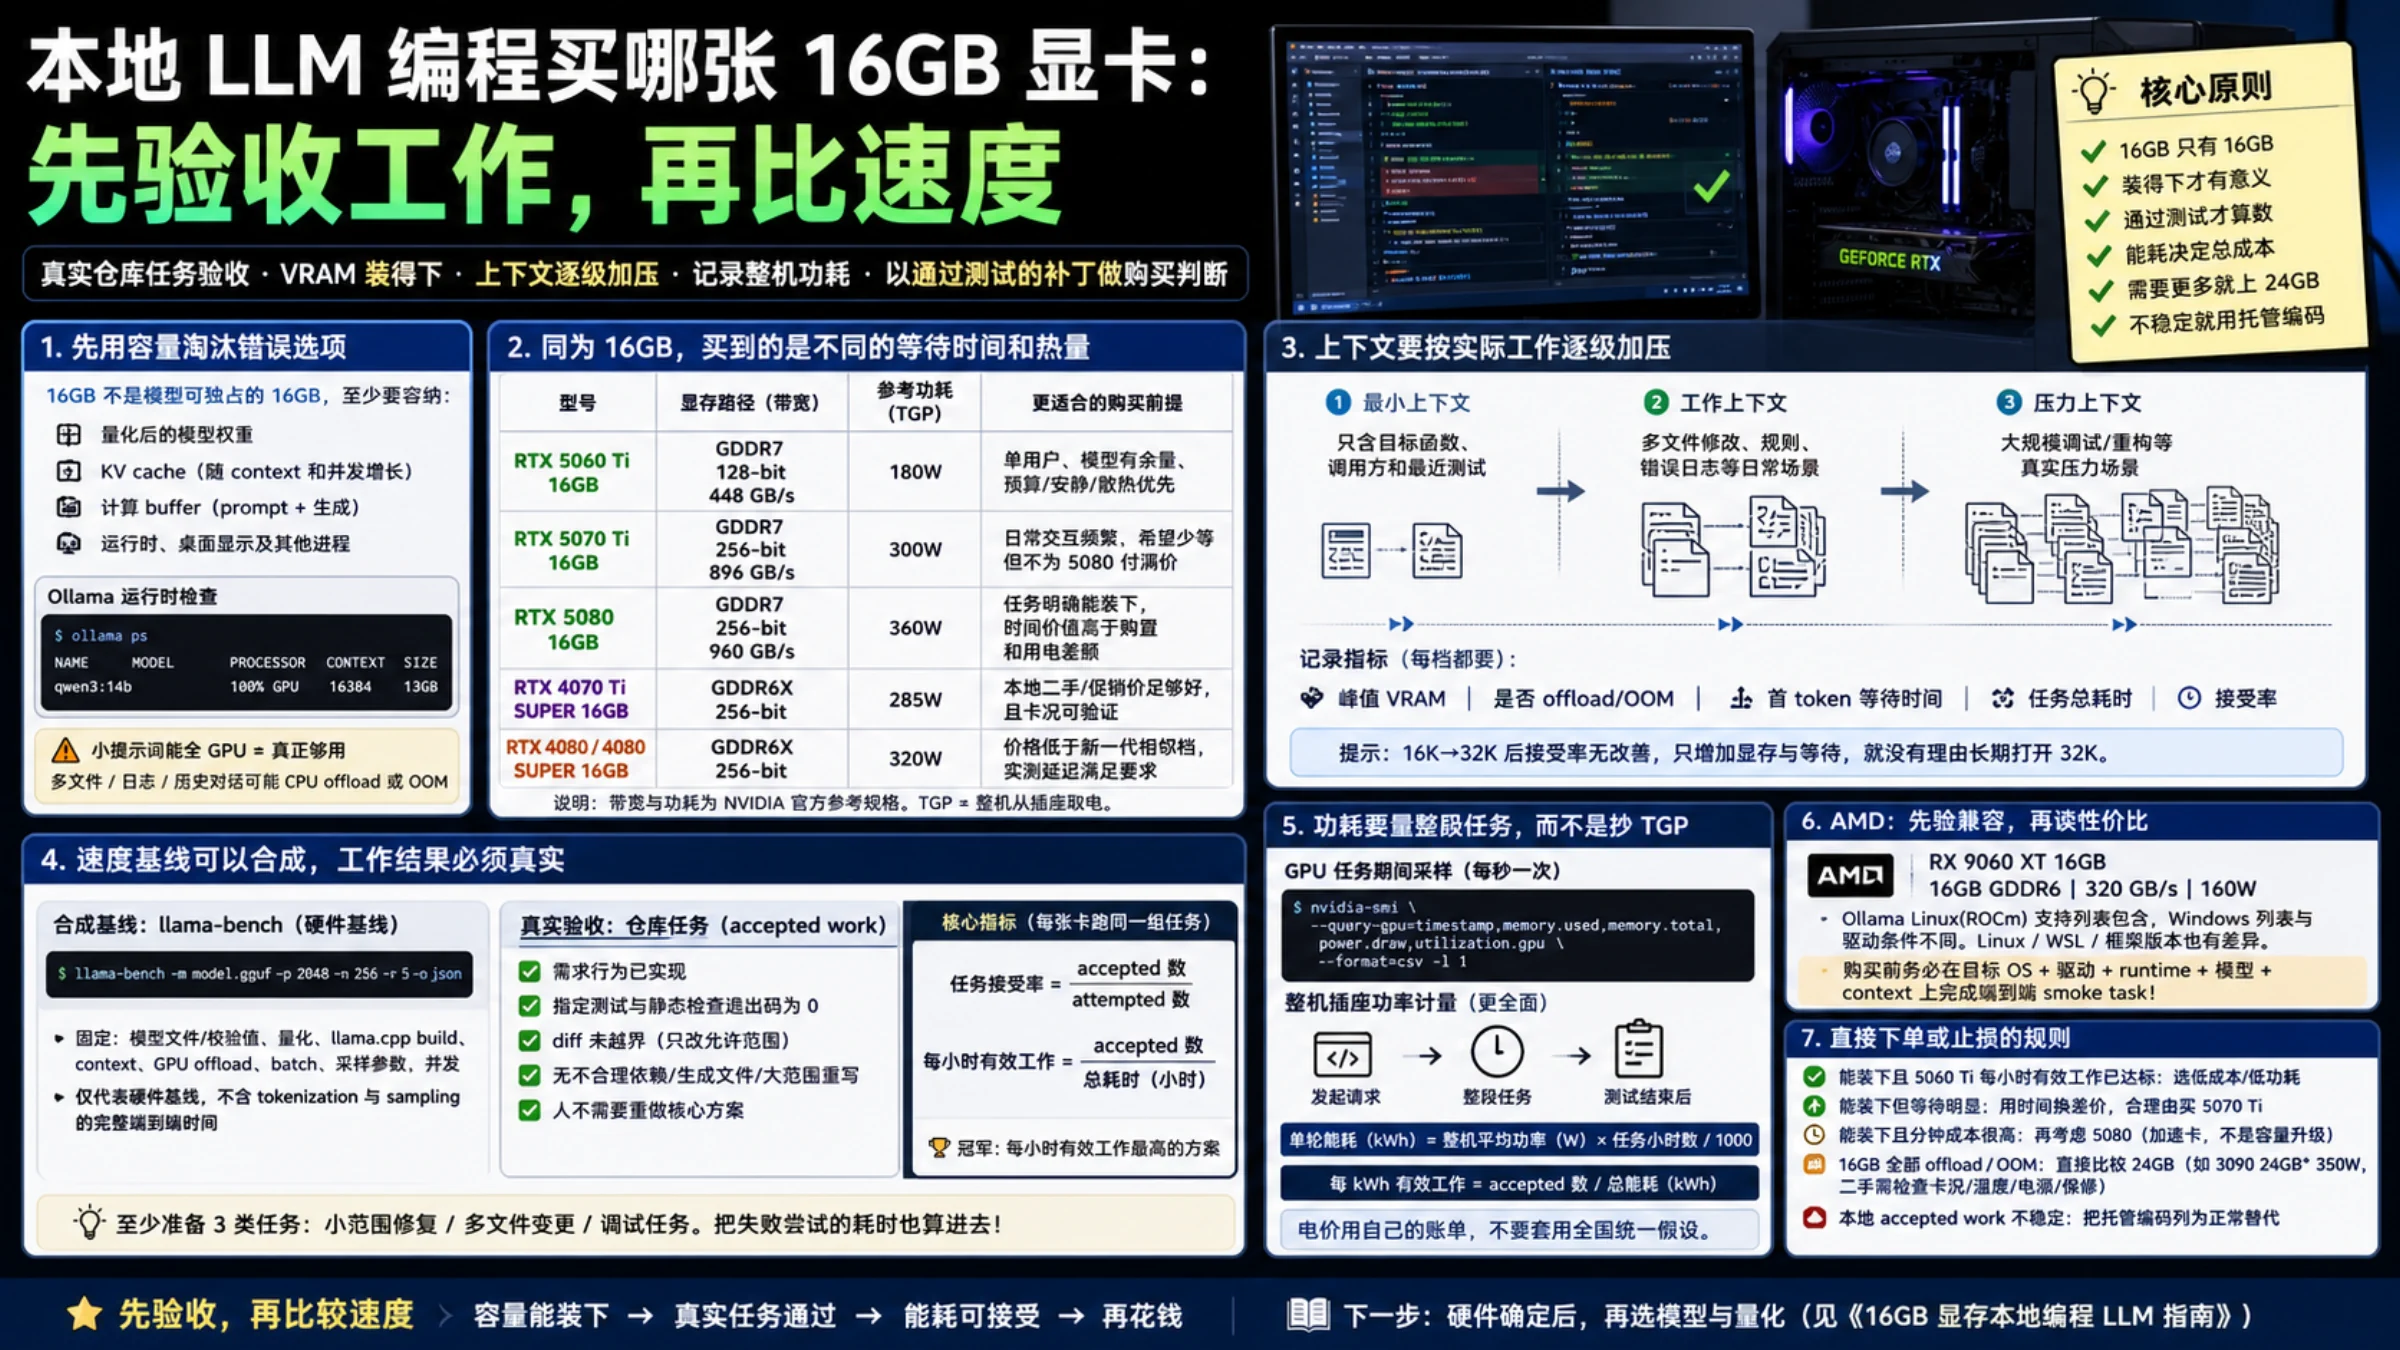
如果你把显存限定为 16GB,RTX 5070 Ti 可以作为本地 LLM 编程的中档候选:它有 256-bit 显存位宽、896 GB/s 的厂商标称带宽和 300W TGP,标称显存带宽接近同为 16GB 的 RTX 5080,但标称功耗更低。这里比较的是硬件规格,不能据此认定实际代码任务更快。NVIDIA 规格对照表
预算和散热优先时选 RTX 5060 Ti 16GB;只有在模型与目标上下文已经确定能装下、等待时间又确实昂贵时,RTX 5080 才有意义。
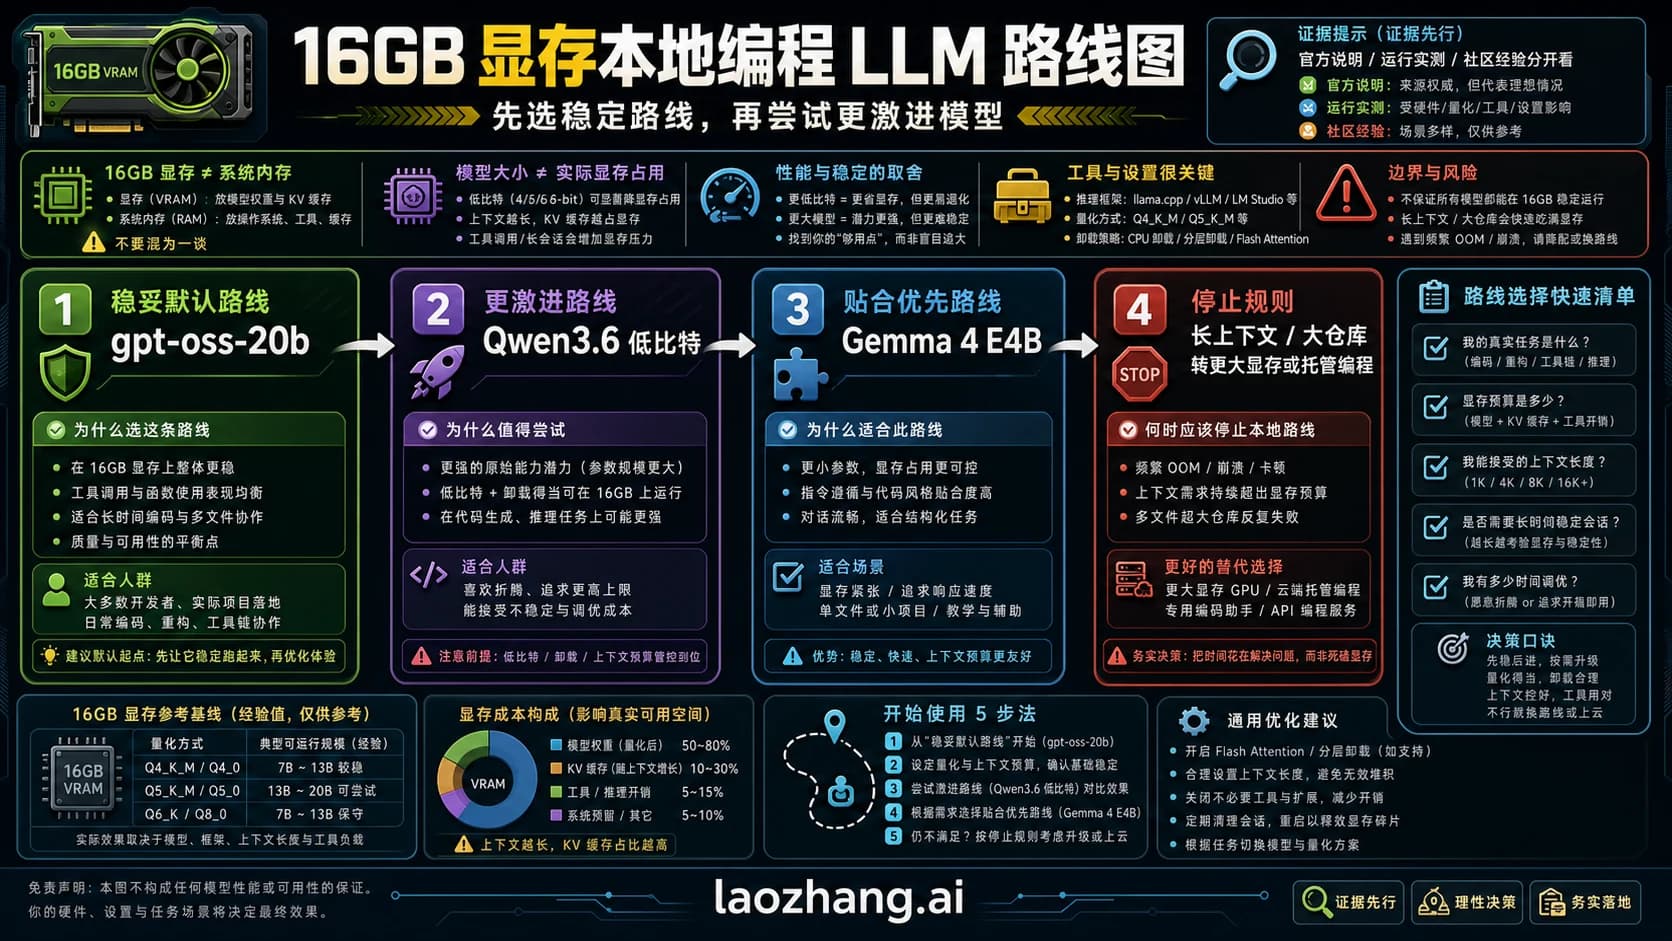
这里最容易买错的一点是:更快的 16GB 仍然只有 16GB。模型权重、KV 缓存和运行时缓冲区在真实上下文下装不下时,5080 不会比 5060 Ti 多出一字节容量。此时该比较的是 24GB 显卡或托管编码,而不是继续给同容量的速度加钱。
先用容量淘汰错误选项
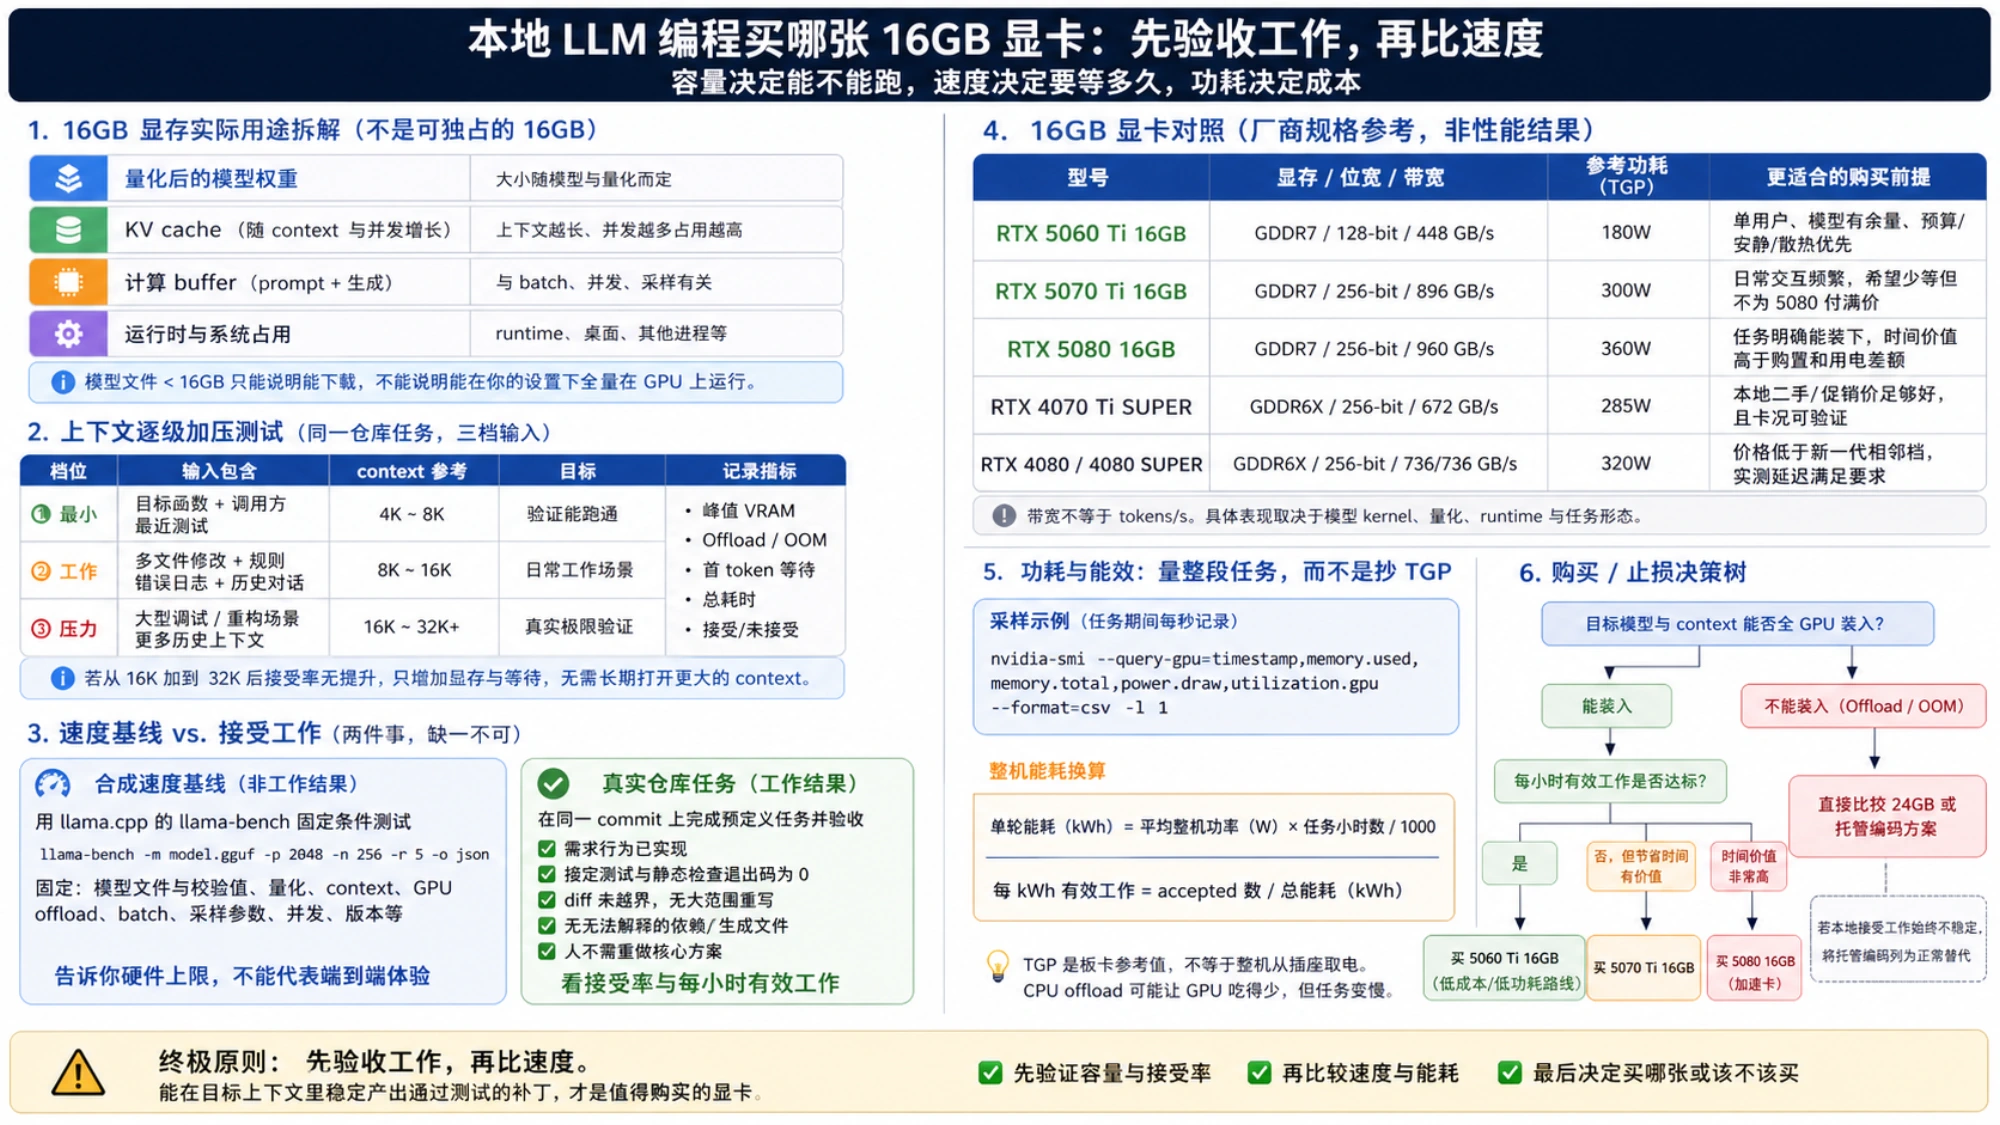
显卡包装上的 16GB 不是模型可独占的 16GB。实际显存至少要容纳:
- 量化后的模型权重;
- 与模型结构、上下文长度和并发有关的 KV 缓存;
- 输入处理与生成需要的计算缓冲区;
- 运行时、桌面显示以及其他进程占用。
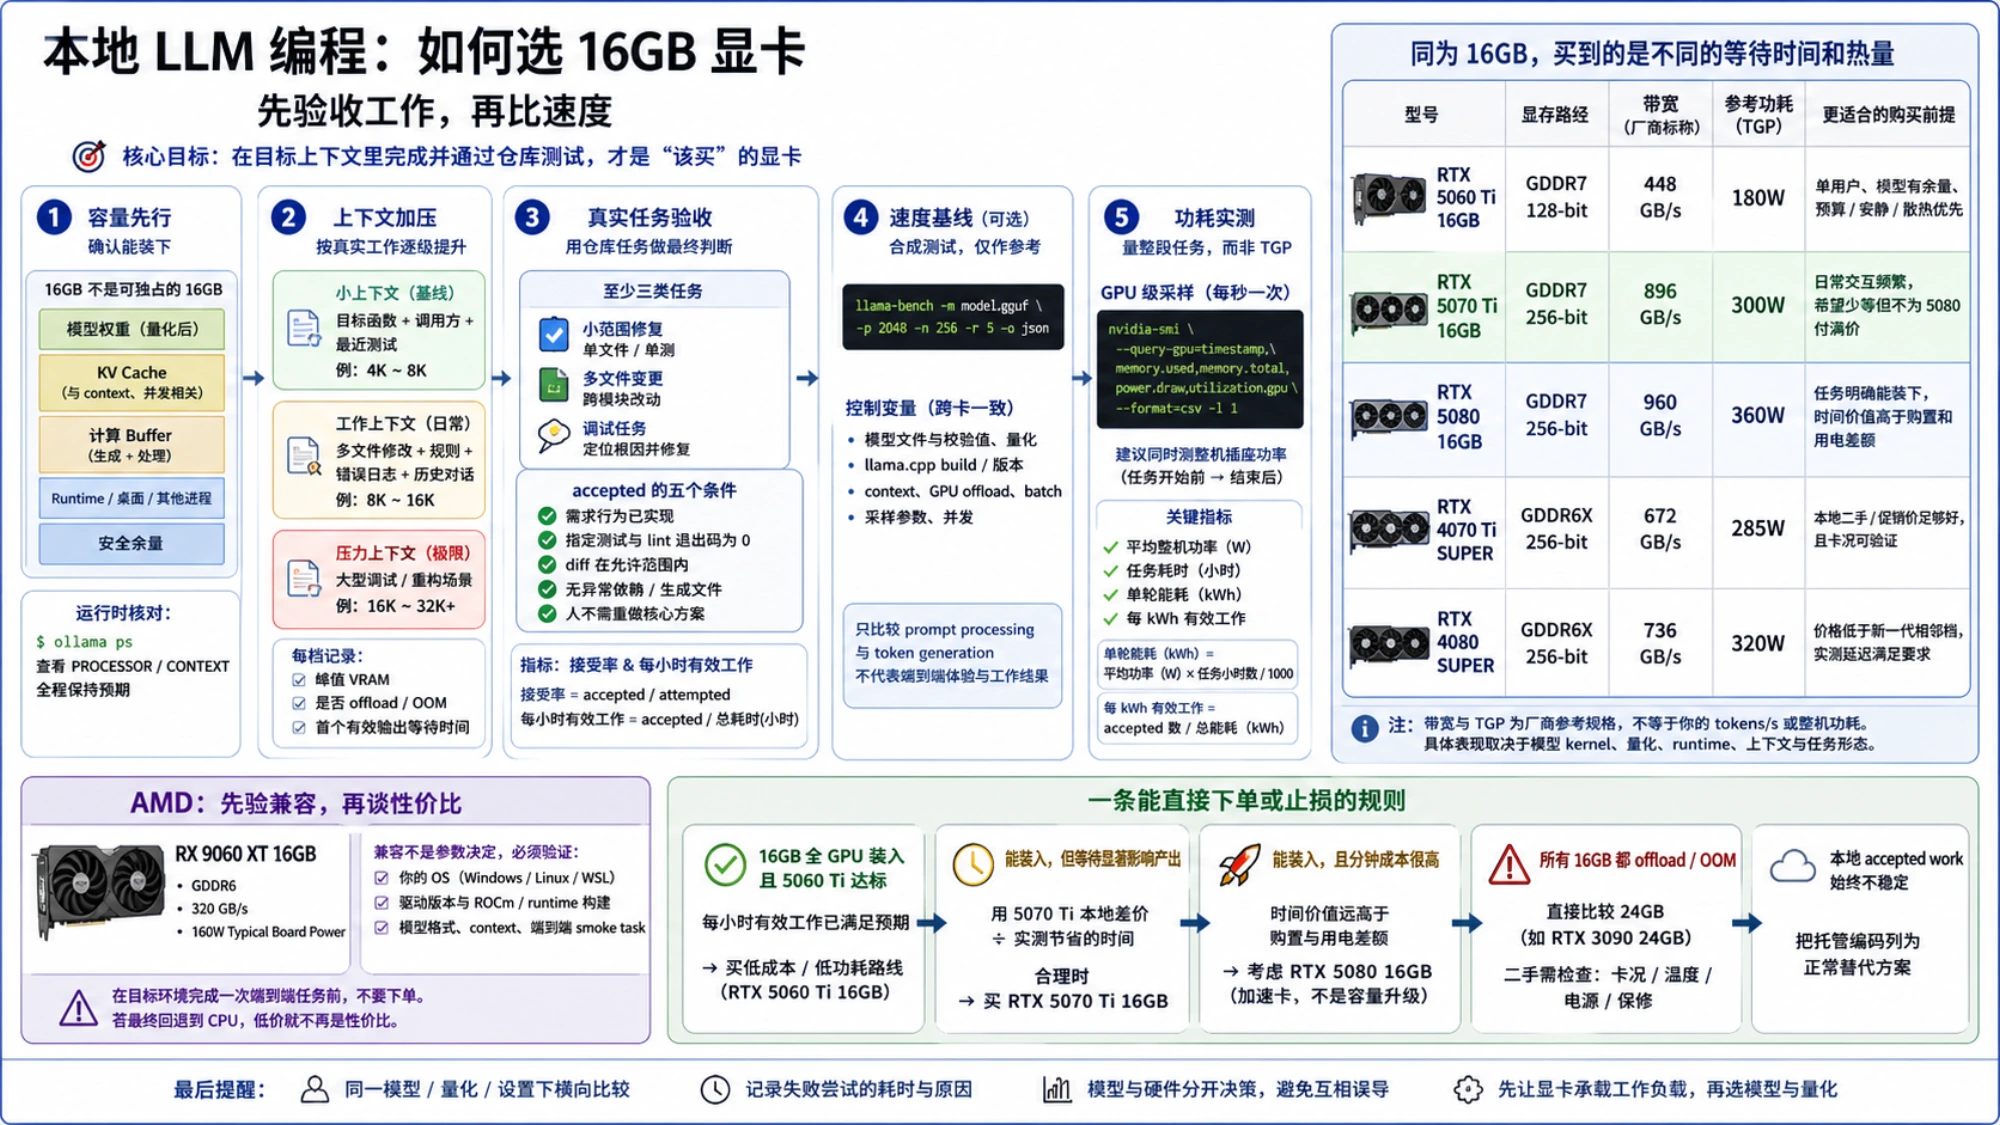
因此“某个模型文件小于 16GB”只能说明文件大小低于标称显存容量,不能证明它在你的设置下能全量上 GPU。Ollama 的当前上下文文档把低于 24 GiB VRAM 的默认上下文设为 4K,并明确说明扩大上下文会增加显存需求。模型运行时先看:
ollama ps重点不是看到一次 100% GPU 就结束,而是确认 PROCESSOR 和 CONTEXT 在目标仓库任务进行时仍符合预期。小提示词能全 GPU,换成多文件、测试日志和历史对话后需要将部分模型计算移到 CPU,购买结论就已经变了。
同为 16GB,买到的是不同的等待时间和热量
NVIDIA 当前规格对照表给出的参考规格如下:
| 型号 | 显存规格 | 参考功耗 | 更适合的购买前提 |
|---|---|---|---|
| RTX 5060 Ti 16GB | GDDR7、128-bit、448 GB/s | 180W TGP | 单用户、模型有余量、预算/安静/散热优先 |
| RTX 5070 Ti 16GB | GDDR7、256-bit、896 GB/s | 300W TGP | 日常交互频繁,希望少等但不为 5080 付满价 |
| RTX 5080 16GB | GDDR7、256-bit、960 GB/s | 360W TGP | 任务明确能装下,时间价值高于购置和用电差额 |
| RTX 4070 Ti SUPER | GDDR6X、256-bit | 285W TGP | 本地二手/促销价足够好,且卡况可验证 |
| RTX 4080 / 4080 SUPER | GDDR6X、256-bit | 320W TGP | 价格低于新一代相邻档,实测延迟满足要求 |
这张表没有“万能赢家”。5060 Ti 的优势是 180W 档位和较低的整机要求;5070 Ti 的优势是相对于 5060 Ti 更高的显存带宽;5080 的 960 GB/s 只比 5070 Ti 的 896 GB/s 高一个较小台阶,却提高到 360W。具体应用仍取决于计算内核、量化、运行时和实际任务,不能从带宽直接换算出 tokens/s。
上下文要按实际工作逐级加压
不要一上来就把模型卡片写的最大上下文拉满,也不要只用 4K 聊天证明显卡“够用”。为同一个仓库任务准备三档输入:
- 只含目标函数、调用方和最近测试的最小上下文;
- 包含日常多文件修改、必要规则与错误日志的工作上下文;
- 覆盖你真实会遇到的大型调试或重构场景的压力上下文。
每一档都记录峰值显存、是否转用 CPU 或出现显存不足(OOM)、首个有效输出等待时间、任务总耗时和最终验收。若从 16K 加到 32K 后接受率没有改善,只增加显存与等待,就没有理由长期打开 32K。反过来,如果 16K 总漏掉关键调用方而 32K 能稳定通过测试,那么额外上下文才是真正的生产能力。
Ollama 的并发说明还指出,并行请求会放大上下文内存分配。一个编辑器单会话的结论不能直接拿去配置多人服务;共享服务也不能用单请求基准测试做容量承诺。
速度基线可以合成,工作结果必须真实
llama.cpp 自带的 llama-bench可以把输入处理与 token 生成分开,并重复运行:
llama-bench -m model.gguf -p 2048 -n 256 -r 5 -o json跨显卡比较时固定同一个模型文件与校验值、量化、llama.cpp 构建版本、上下文、GPU 加载方式、批大小、采样参数和并发。llama-bench 不包含分词与采样的完整端到端时间,所以它只能告诉你硬件基线,不能告诉你代码改对了没有。
真正的验收任务要提前写清楚。例如:在固定的 Git 提交上修复一个解析失败的用例,只允许修改目标模块与对应测试,最后运行指定的单元测试和静态检查。一个结果只有同时满足以下条件才算通过验收的任务:
- 需求行为已经实现;
- 指定测试与静态检查退出码为 0;
- diff 没越过允许文件边界;
- 没有无法解释的依赖、生成文件或大范围重写;
- 人不需要重做核心方案。
至少选一个小范围修复、一个多文件变更和一个调试任务。每张候选卡跑同一组任务,并把失败尝试的耗时也算进去:
任务接受率 = 通过验收的任务数 / 尝试的任务数
每小时有效工作 = 通过验收的任务数 / 总耗时(小时)
一张卡即使生成速度很高,只要频繁丢上下文、产出不可应用的补丁或因将部分模型计算移到 CPU 拖慢循环,每小时有效工作仍可能更少。
功耗要量整段任务,而不是抄 TGP
TGP 适合判断电源、散热和板卡级别,不等于整机从插座取电。将部分模型计算移到 CPU 可能让 GPU 看起来没吃满,却把任务拉得更久;高功耗卡也可能因为更早完成而减少每个通过验收任务的能耗。
NVIDIA 可以在任务期间每秒采样一次:
nvidia-smi \
  --query-gpu=timestamp,memory.used,memory.total,power.draw,utilization.gpu \
  --format=csv -l 1
若你关心电费、房间热量或电源负载,再用插座功率计量整机。采样从发起请求前开始,到测试结束后停止,避免把长时间空闲混入。能耗可以按下式换算:
单轮能耗(kWh)= 整机平均功率(W)× 任务小时数 / 1000
每 kWh 有效工作 = 通过验收的任务数 / 总能耗(kWh)
电价用自己的账单,不要套用全国统一假设。不同厂商的非公版显卡的功耗限制、散热和噪声也应看具体商品,而不是只看 GPU 名称。
选择 AMD 前,先验证软件兼容性
AMD 官方给 RX 9060 XT 16GB标出的规格是 16GB GDDR6、320 GB/s 带宽与 160W 典型板卡功耗。它在容量与功耗上很有吸引力,但硬件参数不等于你的代码模型、编辑器插件和操作系统都能顺利配合。
Ollama 当前硬件支持页在 Linux ROCm 列表中包含 RX 9060 XT,但 Windows 列表与驱动条件不同;AMD 的 Radeon ROCm 文档也把 Linux、WSL 和框架版本拆开。购买前必须在准备使用的操作系统、驱动、运行时版本、模型格式和上下文设置下,完成一次从请求到结果的小型验证任务。若最后回退到 CPU,低价就不再是性价比。
一条能直接下单或止损的规则
- 目标模型与目标上下文全 GPU 装入,5060 Ti 16GB 的每小时有效工作已达标:买低成本/低功耗路线。
- 能装入,但等待明显减少每天产出:用 5070 Ti 的本地差价除以实测节省的时间;合理时买 5070 Ti。
- 能装入且分钟成本很高:再考虑 5080,但把它当加速卡,不当容量升级。
- 需要的上下文在所有 16GB 卡上都需要转用 CPU 或出现显存不足:直接比较 24GB。NVIDIA 规格表中的 RTX 3090 是 24GB、350W,二手购买还必须额外检查卡况、温度、电源和保修。
- 本地任务始终无法稳定通过验收:把托管编码列为正常替代,而不是继续调硬件。
硬件档位确定后,再单独选择模型与量化。相邻的16GB 显存本地编程 LLM 指南负责下一步。先把“显卡能否承载工作负载”和“哪个模型更会写代码”分开,才不会用一张更快的卡掩盖容量问题,也不会让模型榜单替你做错误的硬件决定。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年8月29日。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年8月29日。
- 1.NVIDIA 规格对照表nvidia.com/en-us/geforce/graphics-cards/compare
- 2.上下文文档docs.ollama.com/context-length
- 3.并发说明docs.ollama.com/faq
- 4.llama-benchgithub.com/ggml-org/llama.cpp/blob/master/tools/llama-bench/README.md
- 5.RX 9060 XT 16GBamd.com/en/products/graphics/desktops/radeon/9000-series/amd-radeon-rx-9060xt.html
- 6.硬件支持页docs.ollama.com/gpu
- 7.Radeon ROCm 文档rocm.docs.amd.com/_/downloads/radeon/en/latest/pdf